最佳图像分类模型:如何选择
比较主流图像分类模型,从 ConvNeXt V2 和 DINOv3 到 EfficientNetV2、ViT 和 Ultralytics YOLO26-cls,并了解如何选择。
图像分类模型没有绝对的最佳选择。合适的模型取决于你有多少带标签的数据、模型需要在哪里运行,以及你能否使用该模型的许可证。2026 年,以准确率为优先的工作主要采用大型 Transformer 和自监督主干网络,例如 DINOv3 和 EVA-02。对于在资源有限的硬件上部署,较小且大多基于卷积的模型(例如 ConvNeXt V2、EfficientNetV2、MobileNetV4 和 Ultralytics YOLO26-cls)通常更实用,具体取决于检查点大小、训练设置和目标硬件。请在自己的工作负载上比较它们的准确率和延迟。本指南介绍四类模型,对比十种广泛使用的模型,并提供选择模型的决策路径。
如果你刚开始了解这项任务本身,可以先阅读什么是图像分类。本页将介绍如何选择模型。
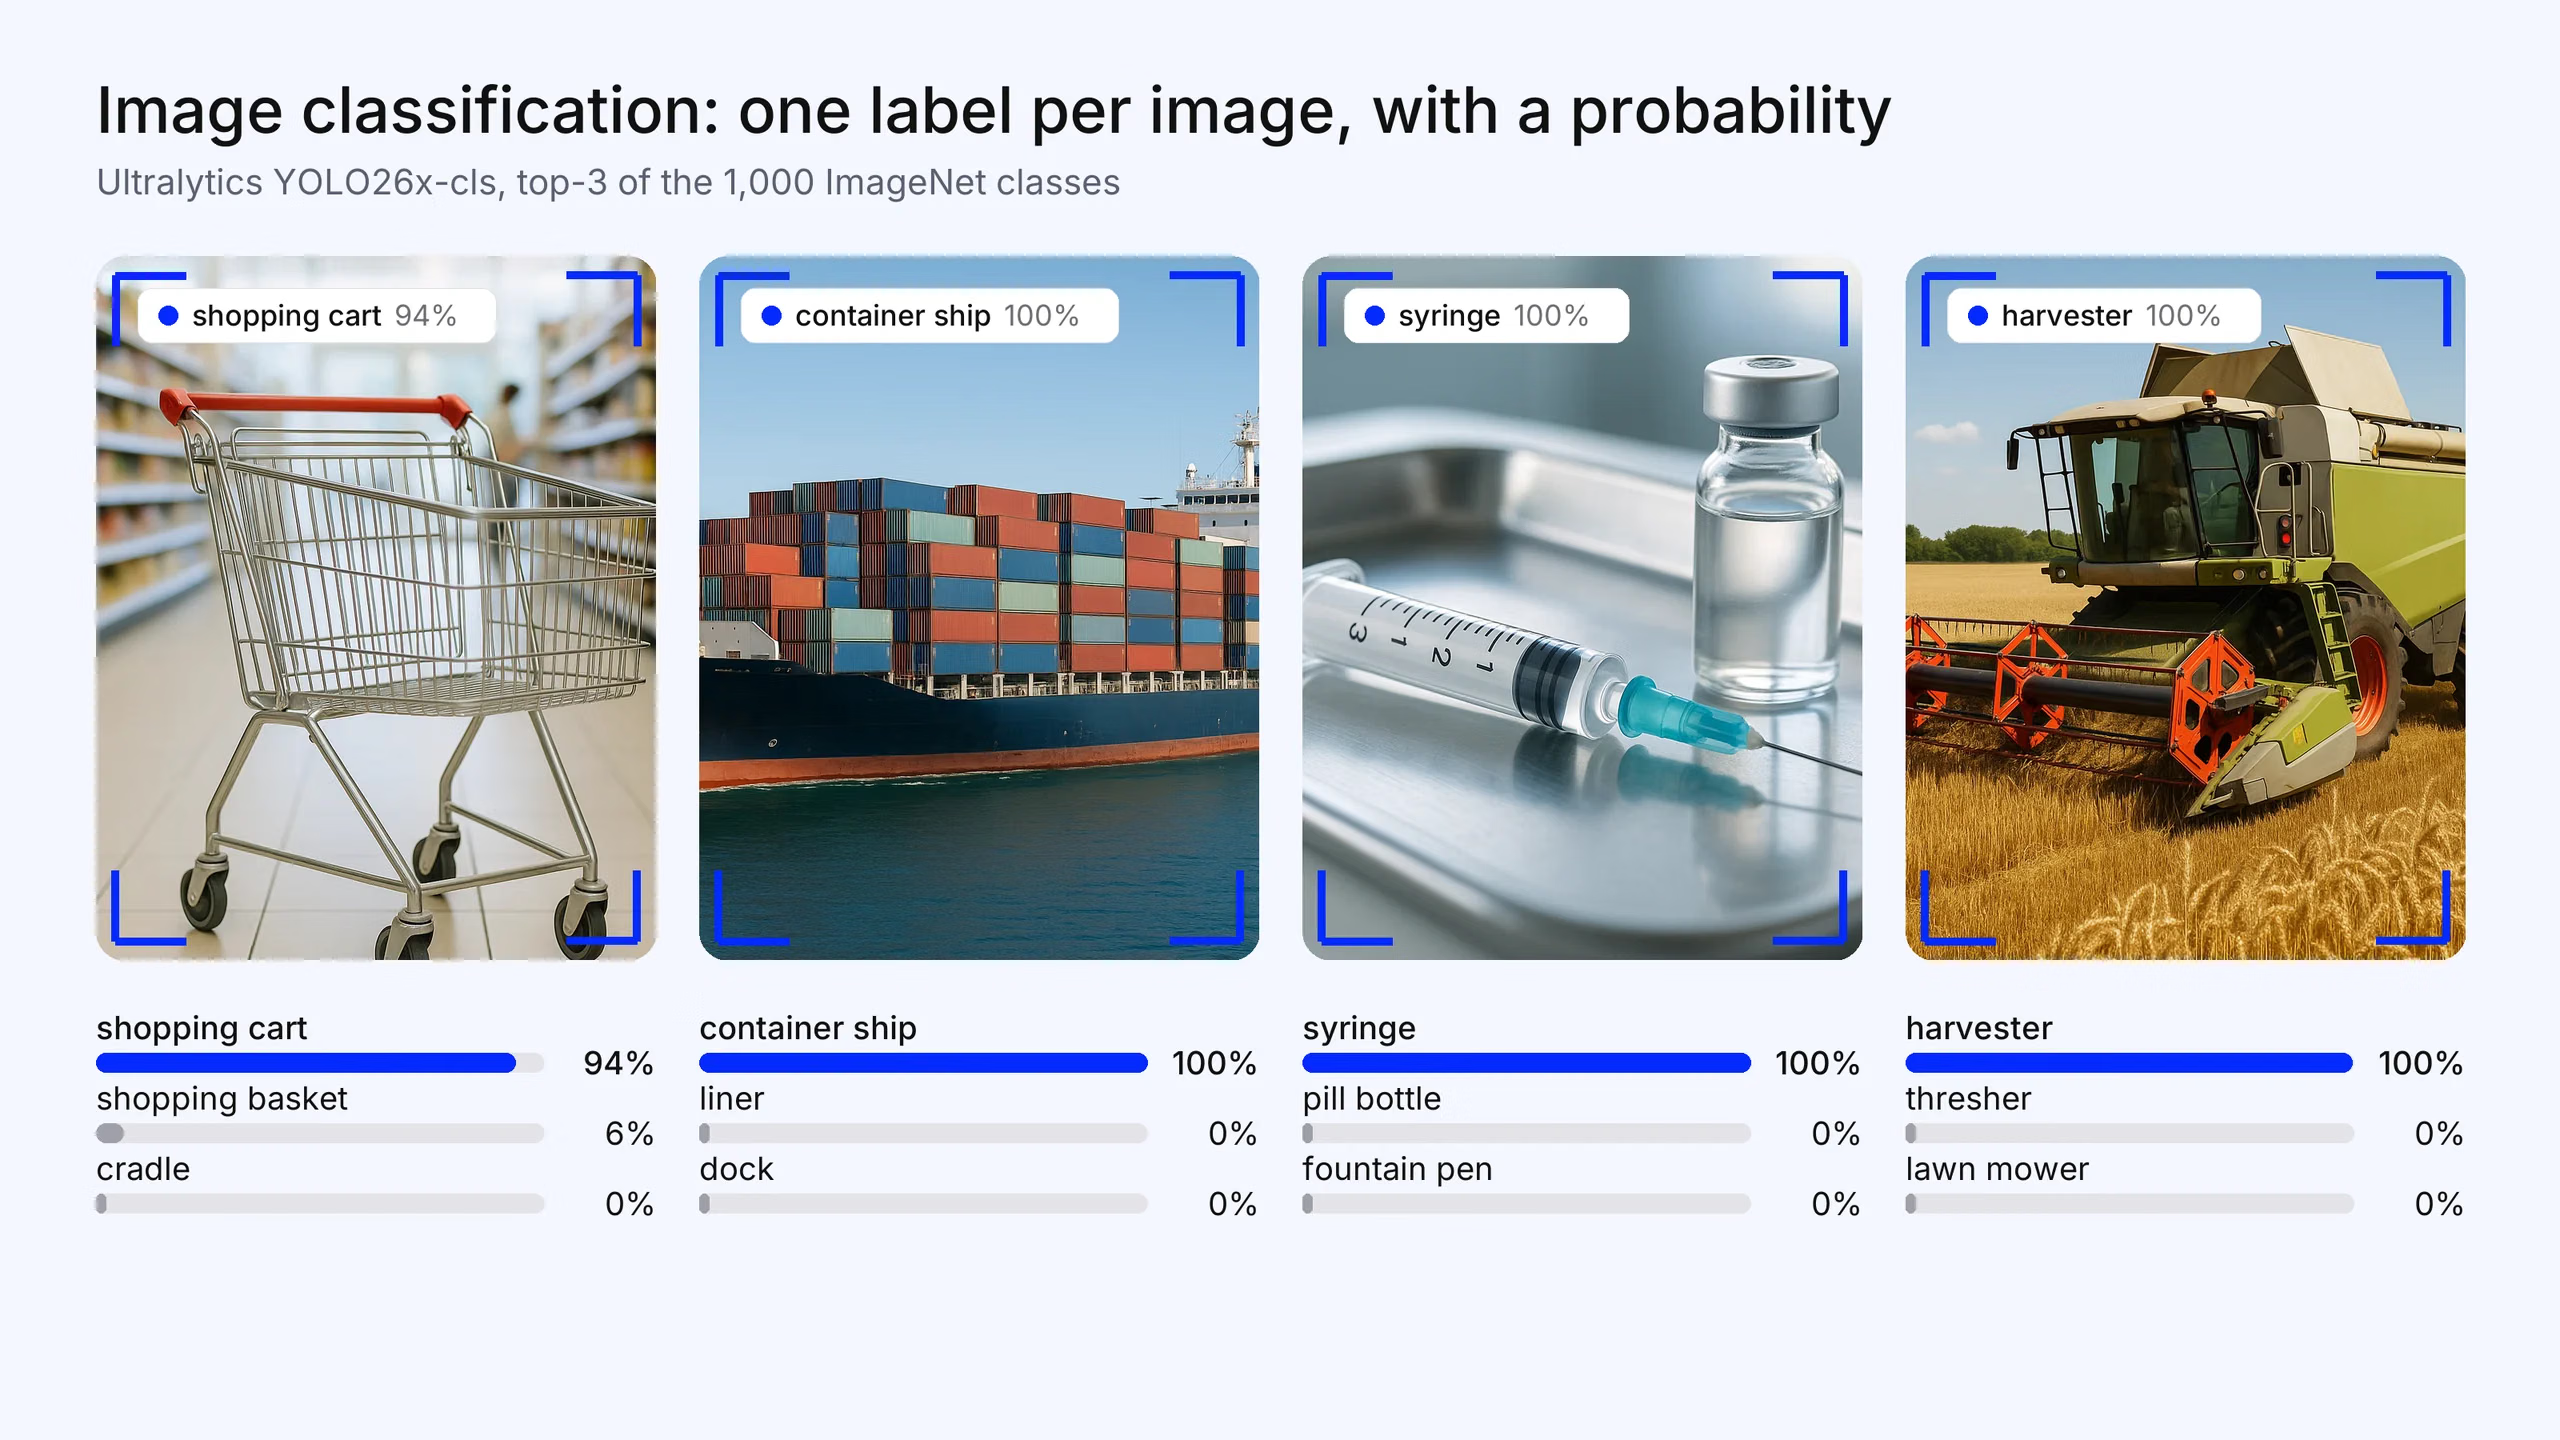
图 1. 图像分类会为整张图像返回一个标签,并给出每个类别的概率:零售、物流、医疗保健和农业示例。Ultralytics YOLO26x-cls 在 1,000 个 ImageNet 类别上预训练后的前三名预测结果。这些照片为本文生成;预测结果来自真实模型输出。
图像分类模型中“最佳”的含义#
排行榜根据模型在 ImageNet 验证集上的 top-1 准确率进行排名。这个数值有参考价值,但它是在固定分辨率和单一数据集上测得的,而且通常依赖非常大规模的预训练。实际项目通常由另外四个因素决定:
- 数据。 你每个类别有多少张带标签的图像,以及这些图像与预训练数据有多相似。
- 算力与延迟。 推理是在数据中心 GPU、CPU,还是手机或摄像头 NPU 上运行。
- 部署路径。 模型能否顺利导出到你需要的运行时,例如 ONNX、TensorRT、Core ML 或 TFLite。
- 许可证。 代码和预训练权重是否分别允许你按预期使用。
在 ImageNet 上低几个百分点,但能在你的图像上良好微调,并在你的硬件上实时运行的模型,通常是更好的选择。
图像分类模型的四大类别#
卷积神经网络 (CNNs)#
CNNs 会在图像上滑动学习到的滤波器,因此假定相邻像素彼此相关。这种内置假设(归纳偏置)让它们能在小型和中型数据集上有效学习,并在普通硬件上高效运行。ResNet 和 EfficientNet 是典型代表。
- 优势: 数据效率高、速度快、易于量化和部署。
- 取舍: 每层可利用的全局上下文较少;与 Transformer 相比,扩大模型规模带来的收益通常更早趋于平缓。
视觉 Transformer(ViTs)#
视觉 Transformer 会将图像拆分为图像块,并通过自注意力将这些图像块作为序列处理,因此每个图像块都可以与其他所有图像块建立联系。ViT 在大规模数据预训练后再迁移时表现最佳。
- 优势: 随着数据量和模型规模增长,性能提升良好;迁移能力强;是自监督和多模态训练的天然基础。
- 取舍: 需要大规模预训练或强正则化;在推理时通常比准确率相近的 CNN 更慢、更占资源。
CNN-Transformer 混合模型#
混合模型在前期阶段使用卷积提取局部细节,在后期阶段使用注意力捕捉全局上下文。CoAtNet 是这一设计的代表:其作者发现,按照合理顺序堆叠卷积层和注意力层,可以提升泛化能力、模型容量和效率。
- 优势: 在中型数据集上取得良好平衡。
- 取舍: 与纯卷积或纯 Transformer 设计相比,实现、调优和导出都更加复杂。
自监督与视觉语言主干网络#
最新一类模型的定义依据不是架构,而是训练方式。自监督模型(例如 DINOv2 和 DINOv3)从无标签图像中学习。SigLIP 2 等视觉语言编码器则从图文对中学习。两者都能生成通用特征,你可以用一个小型线性分类头进行分类;对于视觉语言模型,还可以通过文本提示直接分类,无需任何训练(零样本学习)。Meta 使用 17 亿张图像训练了拥有 70 亿参数的 DINOv3,而 DINOv2 则使用 1.42 亿张图像训练了 11 亿参数的模型。
- 优势: 只需少量带标签数据即可获得强大的特征;一个主干网络可用于多种任务。
- 取舍: 最大的检查点对于边缘设备来说过于庞大;许可证各不相同,需要仔细核查。
图像分类模型对比#
模型按字母顺序列出,并非按排名排列。我们没有列出准确率数据:已发表的 ImageNet 数值会因分辨率、预训练数据和评估方案而异,因此这些行之间的数据无法直接比较。每个模型的论文或文档(见下方链接)都列出了各自的数据。
| 模型 | 类别 | 来源 | 预训练方式 | 最适合 | 主要权衡 |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | 自监督掩码自编码 (FCMAE),随后进行监督微调 | 提供多种尺寸、准确且易于部署的 CNN | ImageNet 权重采用 CC-BY-NC 许可证(仅限非商业用途) |
| DINOv3 | 自监督(ViT 和 ConvNeXt) | Meta | 使用 17 亿张图像进行自监督训练 | 冻结主干网络后特征表现强劲,所需带标签数据很少 | 自定义 DINOv3 许可证;最大模型拥有 70 亿参数 |
| EfficientNetV2 | CNN | 监督式 | 训练速度快,微调效率高 | 设计较早;准确率方面已有更新的主干网络领先 | |
| EVA-02 | ViT | BAAI | 基于 CLIP 特征进行掩码图像建模 | 以准确率为优先的研究与微调 | 大型变体在推理时占用资源较多 |
| MobileNetV4 | CNN 与混合架构(移动端) | 监督式 | 手机、NPU 和边缘加速器 | 准确率上限低于服务器级模型 | |
| ResNet | CNN | Microsoft Research | 监督式 | 基准测试、教学、旧有流程 | 按 FLOP 计算的准确率已不再具有竞争力 |
| SigLIP 2 | 视觉语言模型 (ViT) | 图文对、多语言 | 零样本和开放词汇分类 | 依赖零样本结果前,先在你的目标类别上进行验证 | |
| Swin Transformer | ViT(分层架构) | Microsoft Research | 监督式 | 更高分辨率输入、主干网络复用 | 在准确率相近时,比 CNN 更占资源 |
| Ultralytics YOLO26-cls | CNN | Ultralytics | 在 ImageNet 上进行监督训练 | 快速自定义分类器、边缘端导出、与目标检测共用一个 API | 准确率上限低于大型预训练 Transformer |
| ViT | ViT | 监督式训练,通常使用大型数据集 | 大规模迁移学习 | 缺乏大规模预训练时,需要大量数据 |
模型详解#
按字母顺序列出。
ConvNeXt V2#
ConvNeXt V2 将全卷积掩码自编码器 (FCMAE) 与全局响应归一化层结合起来。它有八种尺寸,从 Atto(370 万参数)到 Huge(6.6 亿参数),因此同一系列既适用于边缘设备,也适用于服务器。当你希望获得 Transformer 时代的准确率,同时保留 CNN 的部署优势时,它是一个很好的默认选择。取舍:代码采用 MIT 许可证,但 ImageNet 预训练权重和微调权重采用 CC-BY-NC 许可证,因此这些权重不能用于商业用途。
DINOv3#
DINOv3 是 Meta 的自监督视觉主干网络。它以 ViT 模型形式发布,涵盖 ViT-S/16 到 ViT-7B/16,还包括供设备端使用的蒸馏版 ConvNeXt 模型。Meta 在冻结主干网络的情况下进行评估,代码库还为 7B 模型提供了 ImageNet 分类头。如果你的带标签数据很少,并且希望获得易于迁移的特征,可以尝试这个模型。取舍:它采用专有的 DINOv3 许可证发布,而非标准开源许可证;其最突出的结果来自最大型号。
EfficientNetV2#
Google 的 EfficientNetV2 采用渐进式学习:训练期间逐步提高图像尺寸,并相应调整正则化。这使它的训练速度更快,参数量也少于早期模型。对于在小型到中型数据集上进行微调,它仍然是可靠的选择。取舍:它早于 2023–2025 年出现的主干网络,在准确率方面已不再领先。要了解原始设计背景,请参阅我们的 EfficientNet 概述。
EVA-02#
EVA-02 是一种纯 Transformer,通过掩码图像建模进行预训练,以重建大型 CLIP 视觉编码器提取的特征。它有四种尺寸,参数量从 600 万到 3.04 亿不等。你可以在 timm 中使用它进行微调。取舍:大型变体的微调和部署成本高,对于简单的领域分类任务来说也过于强大。
MobileNetV4#
MobileNetV4 是 Google 最新的移动端模型系列,旨在适配移动 CPU、DSP、GPU、Apple Neural Engine 和 Google Pixel EdgeTPU,并在这些硬件上高效运行。对于手机或低功耗加速器,它是自然之选。取舍:它牺牲了峰值准确率,以换取更低的延迟。
ResNet#
ResNet 引入了残差连接,至今仍是标准基准,并受到所有框架的支持。取舍:在相同算力下,更新的 CNN 能提供更高的准确率。请参阅什么是 ResNet-50,了解其架构。
SigLIP 2#
SigLIP 2(另请参阅我们的 SigLIP 术语表条目)是 Google 的多语言视觉语言编码器系列。它可以在无需训练的情况下,根据一组文本标签对图像进行分类(方法与 CLIP 类似),其 NaFlex 变体还会保留输入图像的原始宽高比。如果你的标签集经常变化,或目前没有带标签的数据,它最适合这类场景。取舍:零样本效果因领域而异,因此在依赖它之前,请先用你的目标类别(例如缺陷类型)进行验证。如果效果不理想,可以训练分类头或进行微调。
Swin Transformer#
Swin Transformer 在平移后的局部窗口内计算注意力,从而使计算量随图像尺寸线性增长,并适用于更高分辨率的输入。取舍:它比准确率相近的 CNN 更占资源;ConvNeXt 的设计目标就是用纯卷积与其竞争。
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls 是 Ultralytics YOLO26 的分类变体。它有五种尺寸(n、s、m、l、x),参数量从 280 万到 2960 万(融合后),输入尺寸为 224 像素,并在 ImageNet 上进行了预训练。文档报告了各尺寸在 ImageNet 验证集上的 top-1 和 top-5 准确率,以及 CPU 和 GPU 延迟。相同的 Python API 和 CLI 可用于训练、验证和导出分类、目标检测、分割和姿态模型;分类器可导出为 ONNX、TensorRT、Core ML、OpenVINO 和 LiteRT 等格式。早期的 YOLO11-cls 模型也使用相同的五种尺寸和输入尺寸。取舍:
- 准确率上限。 与 EVA-02 或 DINOv3 等大型预训练 Transformer 相比,即使是 x 模型也很小,因此它并非以准确率为优先的研究任务的选择。
- 默认使用正方形裁剪。 训练时使用随机缩放裁剪,验证时使用中心裁剪,这可能会裁掉宽高比极端的图像部分。文档介绍了如何改用普通缩放。
- 许可证。 Ultralytics 模型采用 AGPL-3.0 许可证。闭源商业用途需要 Ultralytics Enterprise 许可证。
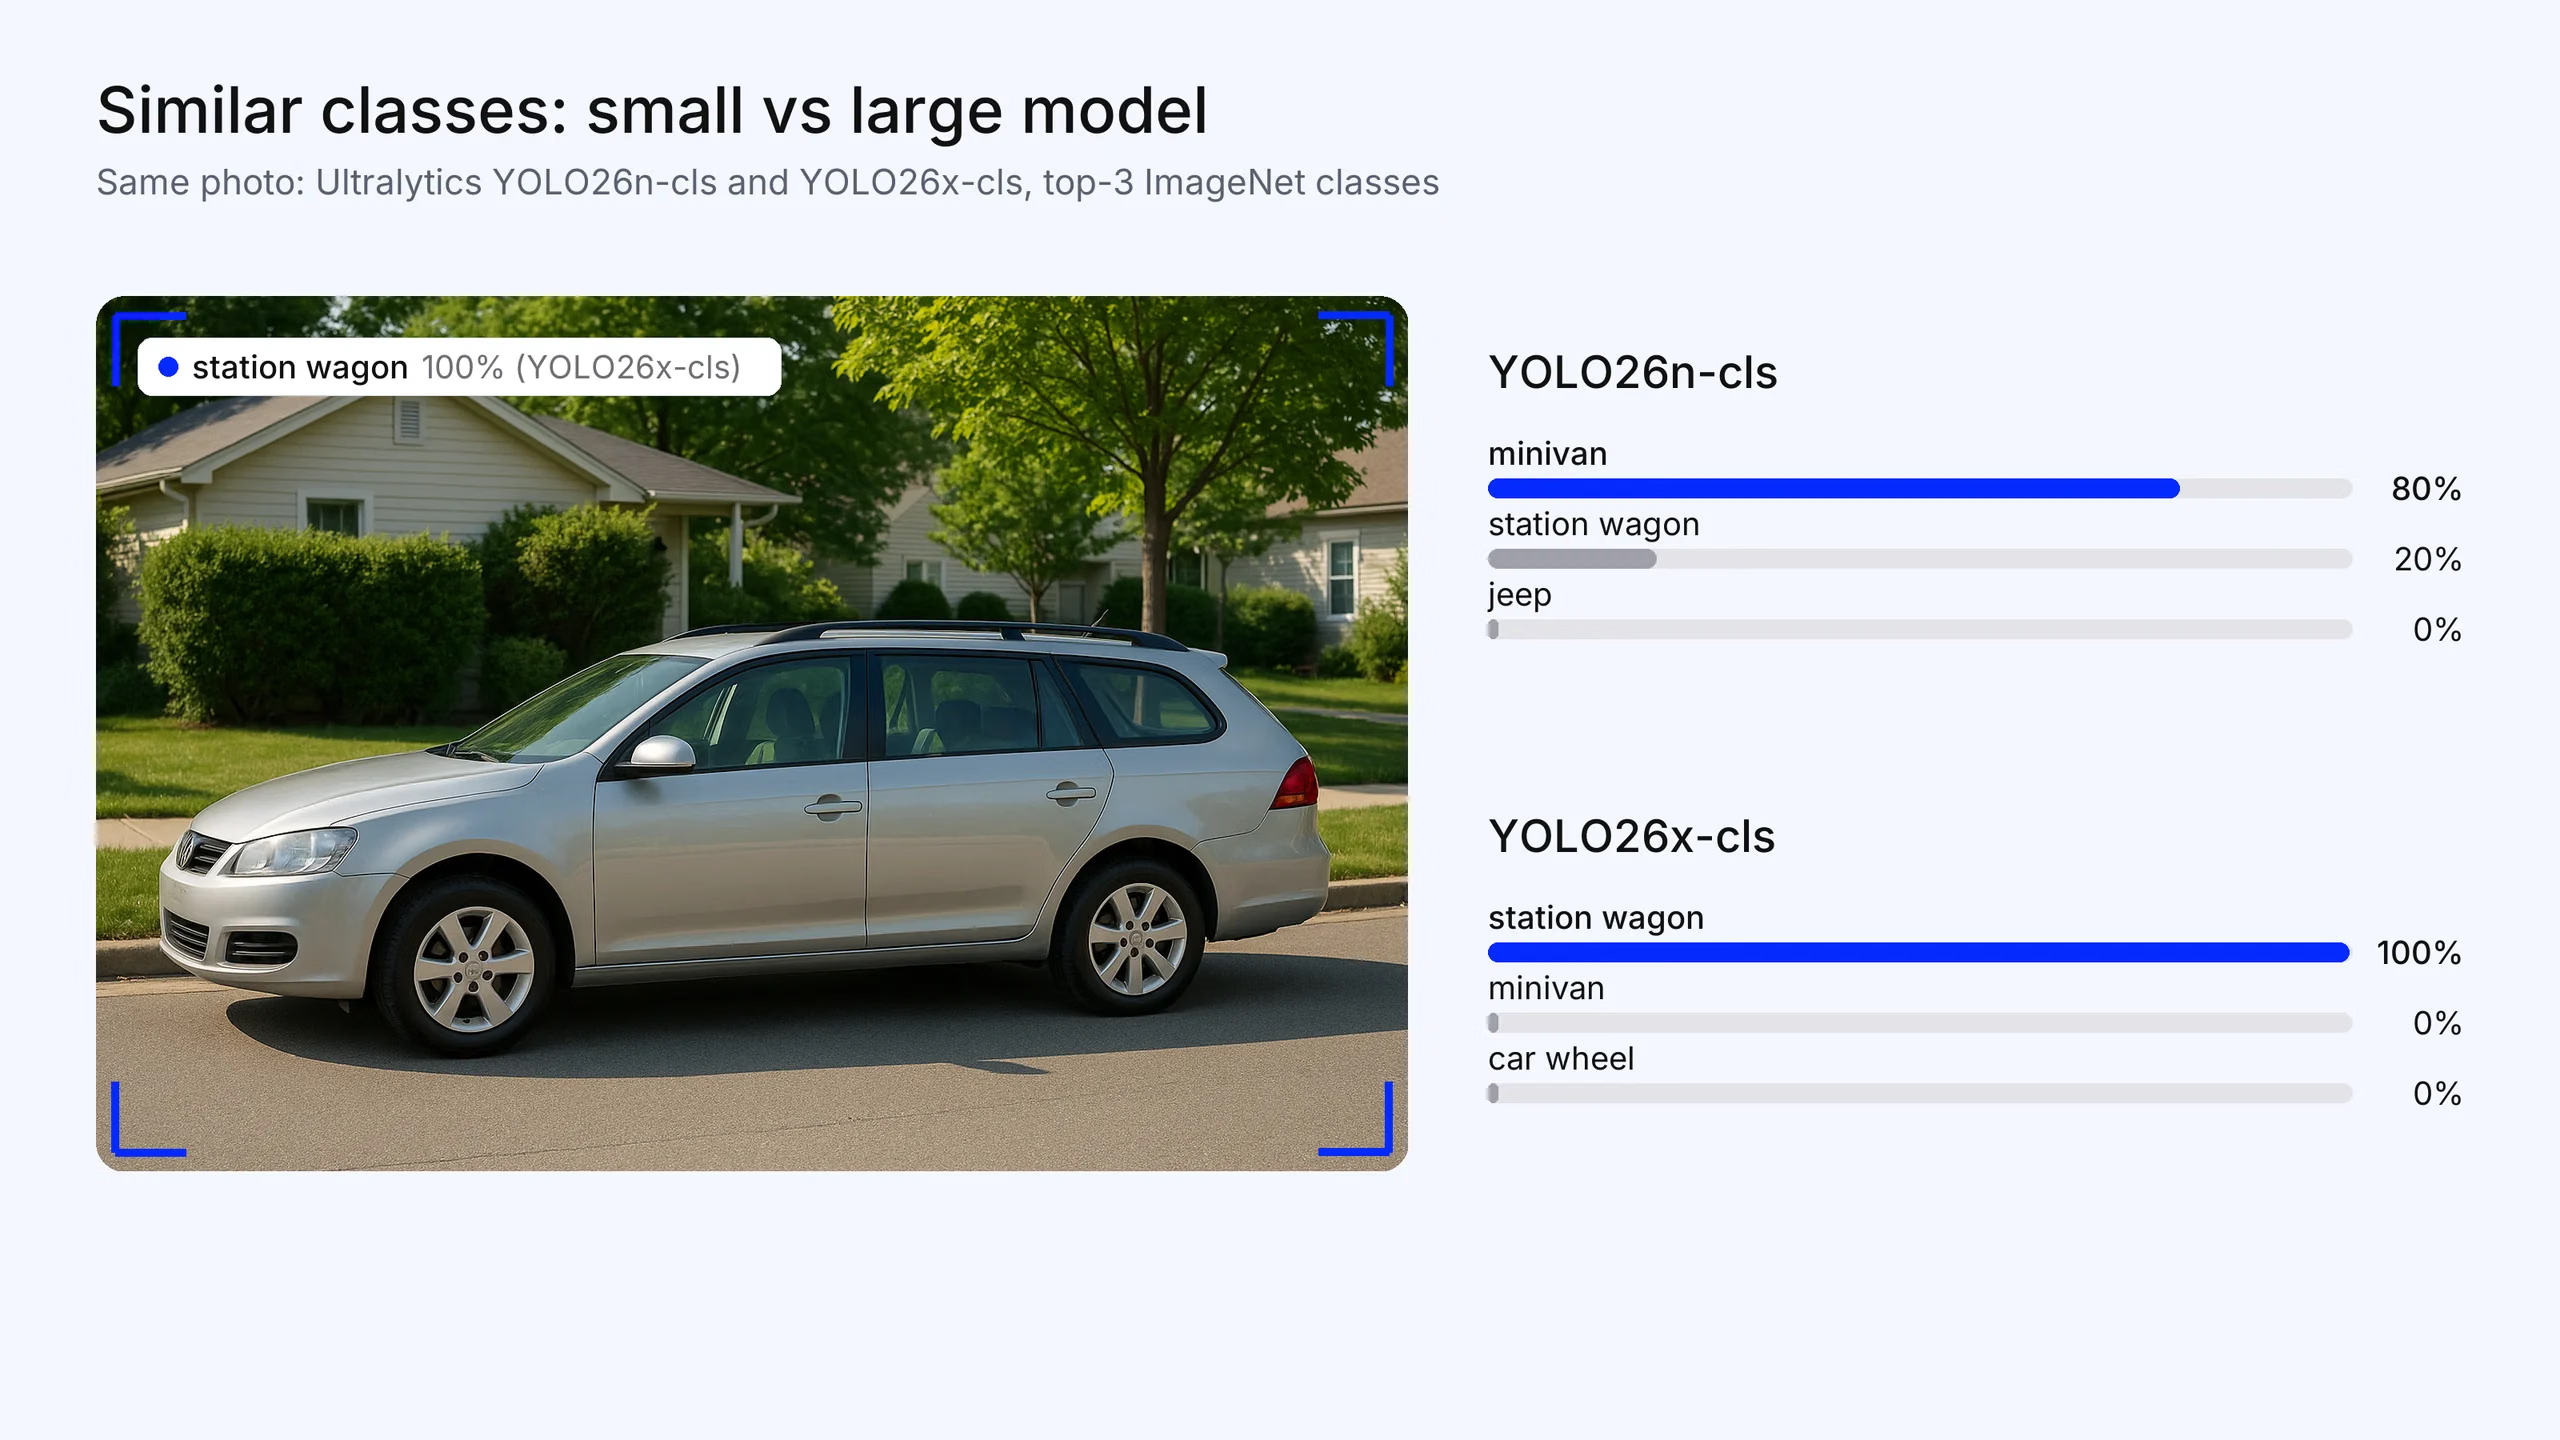
图 2. 相似类别最能体现模型规模的差异。在这张旅行车照片中,Ultralytics YOLO26n-cls 将“minivan”(小型货车)排在第一位(80%),而 YOLO26x-cls 将 station wagon(旅行车)排在第一位(100%,对应 ImageNet 的“beach wagon, station wagon”类别)。你可以在自己的验证集上检查这类细粒度类别。这张照片是为本文生成的;预测结果来自真实模型输出。
ViT#
Google 最初推出的 Vision Transformer 表明,在大量数据上进行预训练后,纯 Transformer 模型处理图像块的效果可以媲美甚至超过 CNN。权衡:如果没有大规模预训练,它在小型数据集上的表现不如 CNN,而且推理时需要更多计算资源。
如何选择图像分类模型#
按顺序回答以下问题:
- 你有带标签的数据吗?如果没有带标签的样本,可以从 SigLIP 2 这类视觉语言模型开始,进行零样本分类。如果只有少量带标签的数据,也可以评估使用冻结 DINOv3 主干网络并训练线性分类头的方案。
- 模型会在哪里运行?如果要在手机或 NPU 上运行,可以优先考虑 MobileNetV4,或 YOLO26n-cls 这类小型 CNN,或小型 ConvNeXt V2。如果要在边缘 GPU 或 CPU 上实时运行,可以考虑 YOLO26-cls、EfficientNetV2 或 ConvNeXt V2。如果要在延迟预算宽裕的服务器上运行,可以考虑 EVA-02、Swin 或 DINOv3 ViT。
- 每个类别有多少带标签的数据?如果每类有数百到几千张图像,使用预训练 CNN 或冻结的自监督主干网络进行迁移学习是最稳妥的方案。如果有数万张或更多图像,完全微调的 Transformer 才开始显现优势。
- 你可以使用该许可证吗?要检查权重的许可证,而不只是代码:ConvNeXt V2 的 ImageNet 权重不能用于商业用途,DINOv3 有自己的许可证,而 Ultralytics 模型采用 AGPL-3.0,除非你持有 Enterprise 许可证。
- 模型能导出到你的运行环境吗?在确定方案前,先确认模型能通过受支持的路径导出到 ONNX、TensorRT、Core ML 或 TFLite。
然后对入围的两三个模型进行微调,并在自己的验证集划分上比较它们。
哪些情况下其他模型会比 YOLO 更适合你#
YOLO26-cls 专为快速、易于部署的自定义分类器打造。对于某些任务,其他模型会是更好的选择:
- 以准确率为先的研究或基准测试:通过 timm 使用 EVA-02、ConvNeXt V2 或 ViT,这些模型有现成的训练方案和权重,可用于复现 ImageNet 级别的结果。
- 标签极少,或需要从一个主干网络开展多种下游任务:使用 DINOv3 特征和线性分类头。
- 开放或经常变化的标签集:使用 SigLIP 2 进行零样本分类。
- Apple Neural Engine 或 EdgeTPU 等手机 NPU:MobileNetV4 正是针对这些硬件目标设计并测试的。
如果你还需要找到物体的位置,而不只是识别图像中有什么,就需要使用检测器。请参阅我们的目标检测模型对比。
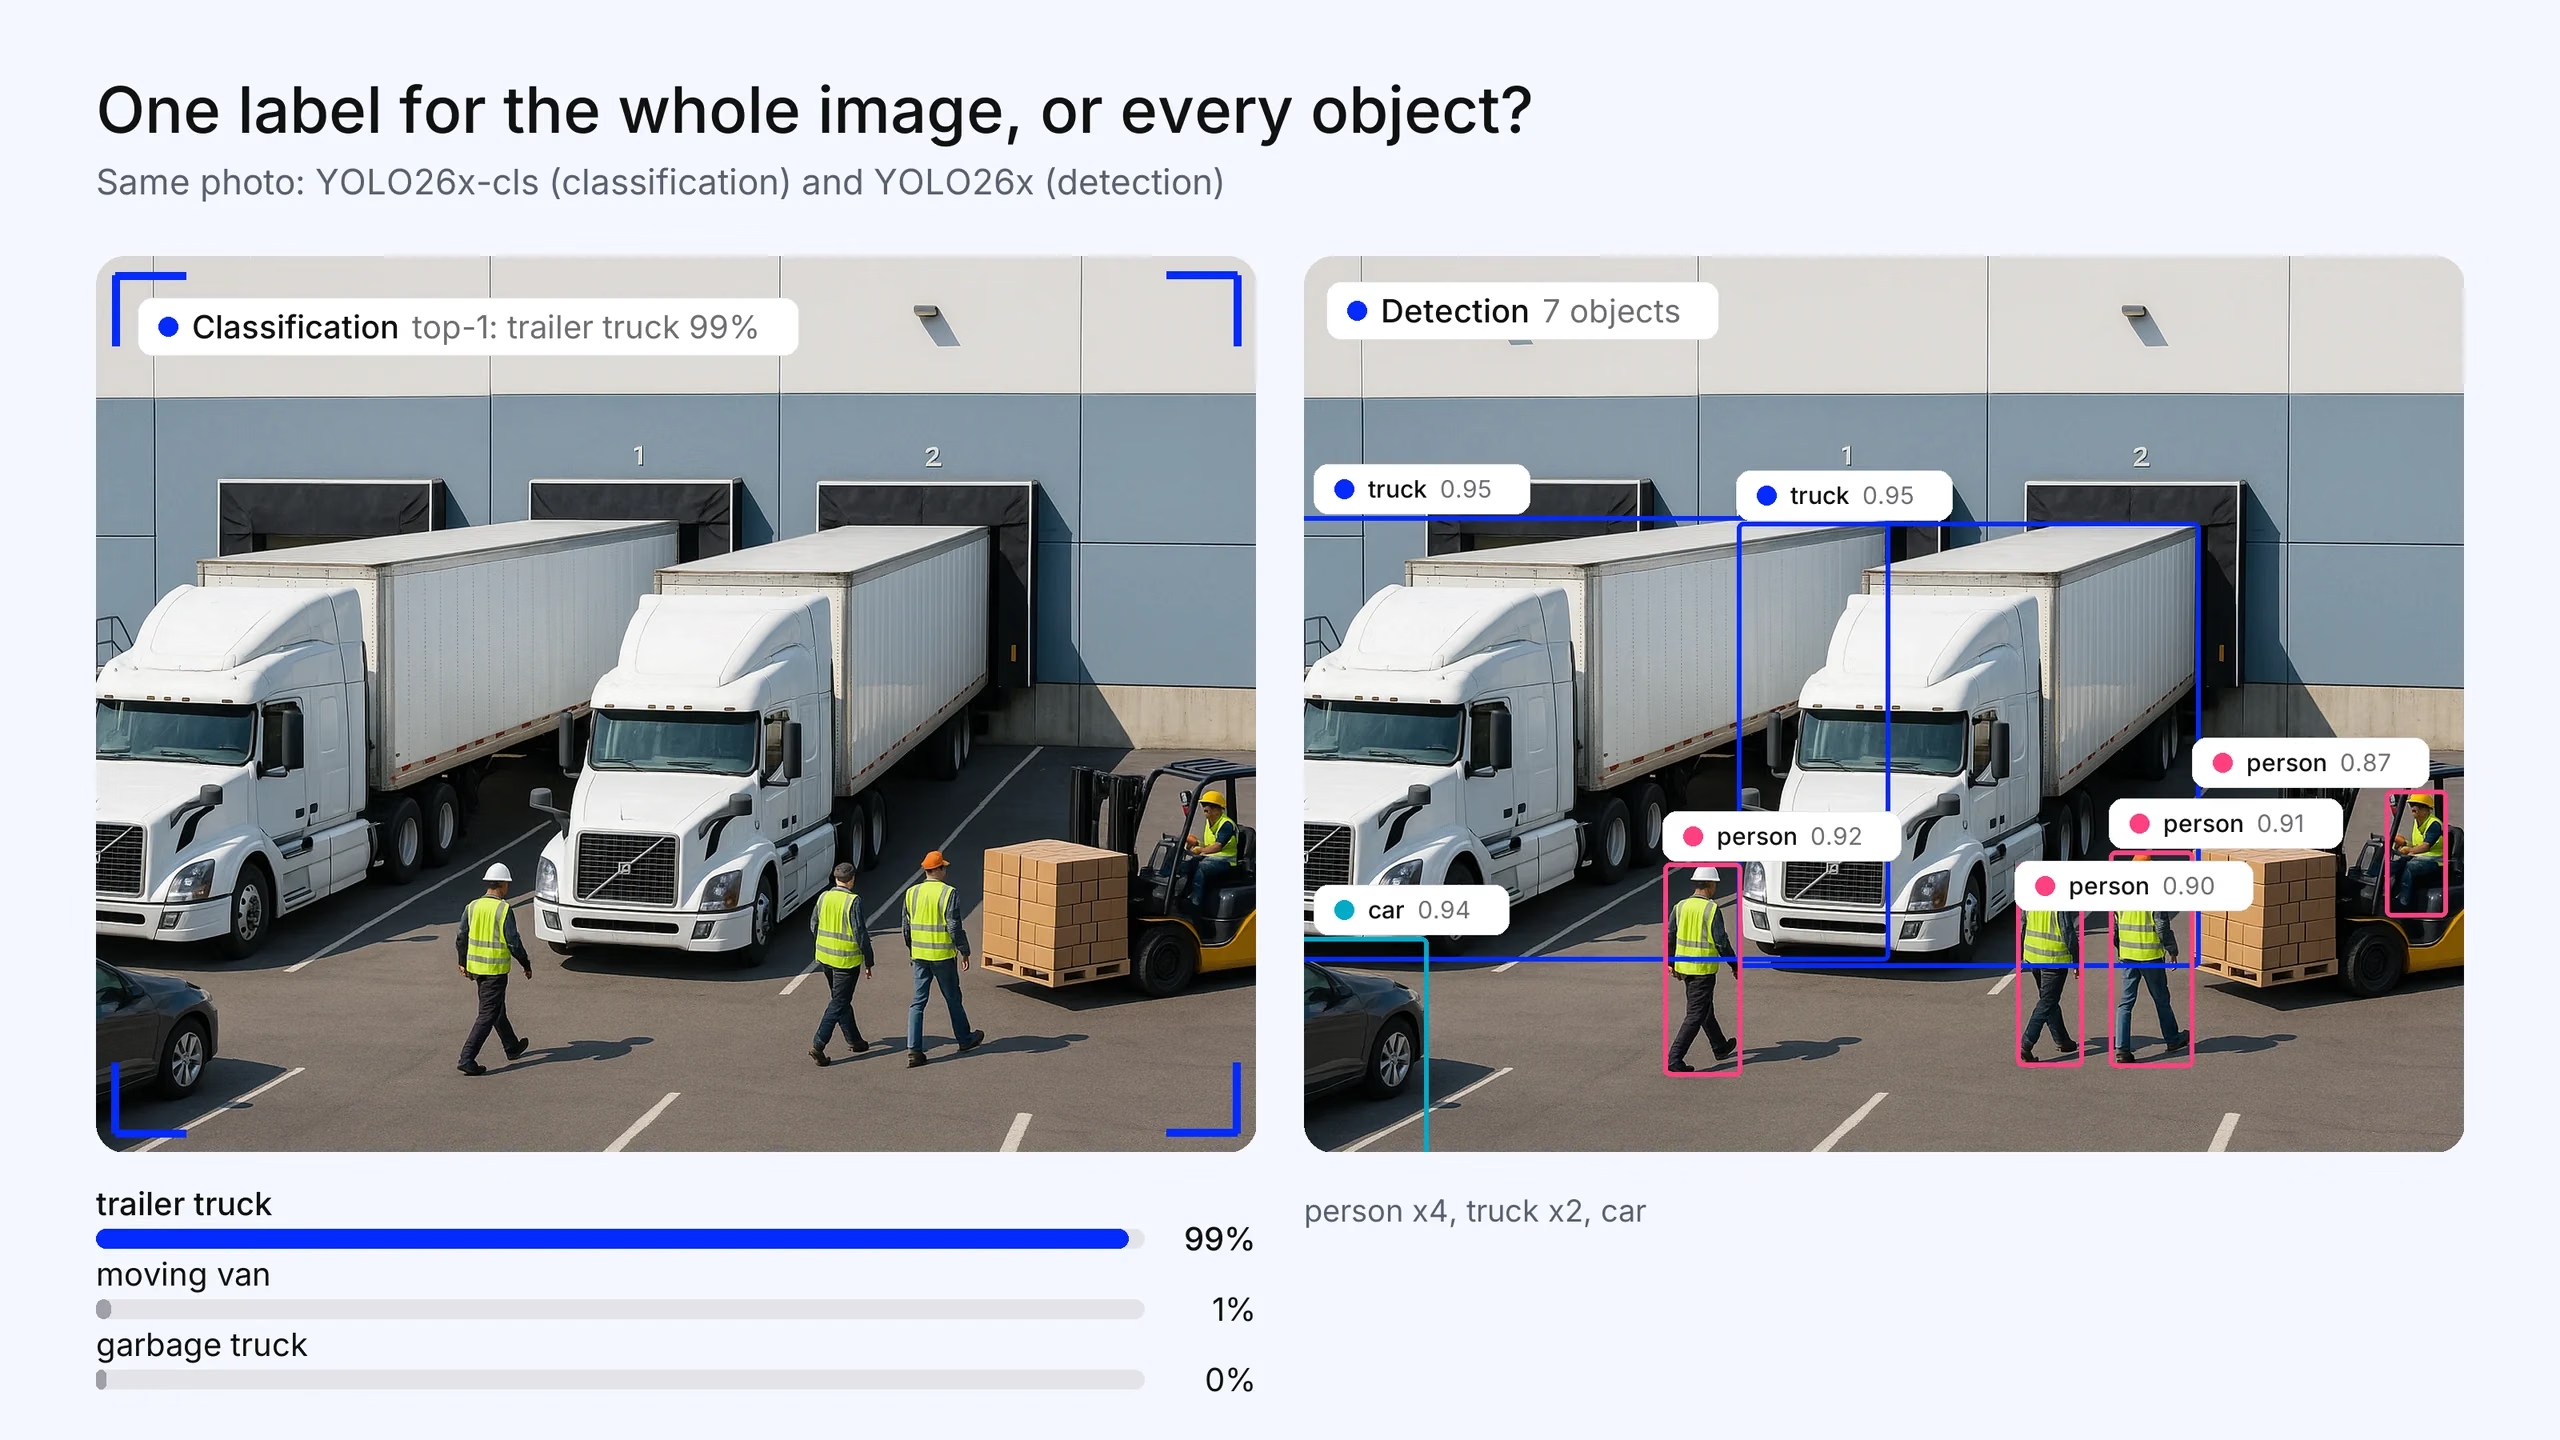
图 3. 在包含许多物体的场景中,分类器仍只返回一个标签:Ultralytics YOLO26x-cls 将这个配送场地以 99% 的置信度标记为“trailer truck”(拖车卡车)。Ultralytics YOLO26x 检测模型找到了 7 个物体:4 个人、2 辆卡车和 1 辆汽车,每个物体都有自己的框(置信度不低于 0.5)。这张照片是为本文生成的;输出结果是真实的。
获取预训练模型并训练自己的模型#
- timm (PyTorch Image Models) 收集了上文中的大多数主干网络,从 ViT 和 ConvNeXt 到 MobileNetV4、EVA 和 DINOv3,并提供训练和评估脚本。代码采用 Apache 2.0 许可证;权重的许可证各不相同。
- Hugging Face 托管了大多数 Transformer 分类模型,包括 SigLIP 2 和 DINOv3,并提供开箱即用的零样本和图像分类流水线。
- Ultralytics Python 软件包可以在按类别整理的图像文件夹上训练 YOLO26-cls。请参阅分类数据集格式和分类任务指南。
- Ultralytics Platform 为相同模型提供标注和云端训练功能。该平台于 2026 年推出,因此比成熟的托管训练服务更新。训练完成后如需部署模型,请参阅我们的计算机视觉推理平台对比。
常见问题
没有一种模型适用于所有情况。对于计算资源充足、以准确率为先的任务,EVA-02 和 DINOv3 这类大型 Transformer 和自监督主干网络值得优先评估。对于在有限硬件上的生产部署,ConvNeXt V2、EfficientNetV2、MobileNetV4 和 Ultralytics YOLO26-cls 这类 CNN 更实用。对于没有带标签数据的分类任务,SigLIP 2 支持零样本分类。
在超大型数据集上预训练且计算资源充足时,Transformer 往往表现更好。在小到中型数据集以及边缘硬件上,CNN 往往更有优势,因为它们对局部结构的内置假设能提高数据效率和运行速度。ConvNeXt 等现代 CNN 缩小了准确率差距,而 CoAtNet 等混合架构则结合了两者。
可以。DINOv3 是通用主干网络。你可以用冻结的模型提取特征,并在其上训练一个小型线性分类器;Meta 的代码库还为其最大的模型提供了 ImageNet 分类头。商用前请查看 DINOv3 License。
主要使用 top-1 准确率(最高分预测正确)和 top-5 准确率(正确类别位于得分最高的五个预测中),通常在 ImageNet 验证集上评估。对于类别不平衡的自定义数据集,按类别计算的精确率、召回率或 F1 比整体准确率更有参考价值。









