语义分割与实例分割:如何选择合适的任务
语义分割为每个像素标注类别;实例分割则区分每个对象。了解你的计算机视觉项目需要哪种任务,以及原因。
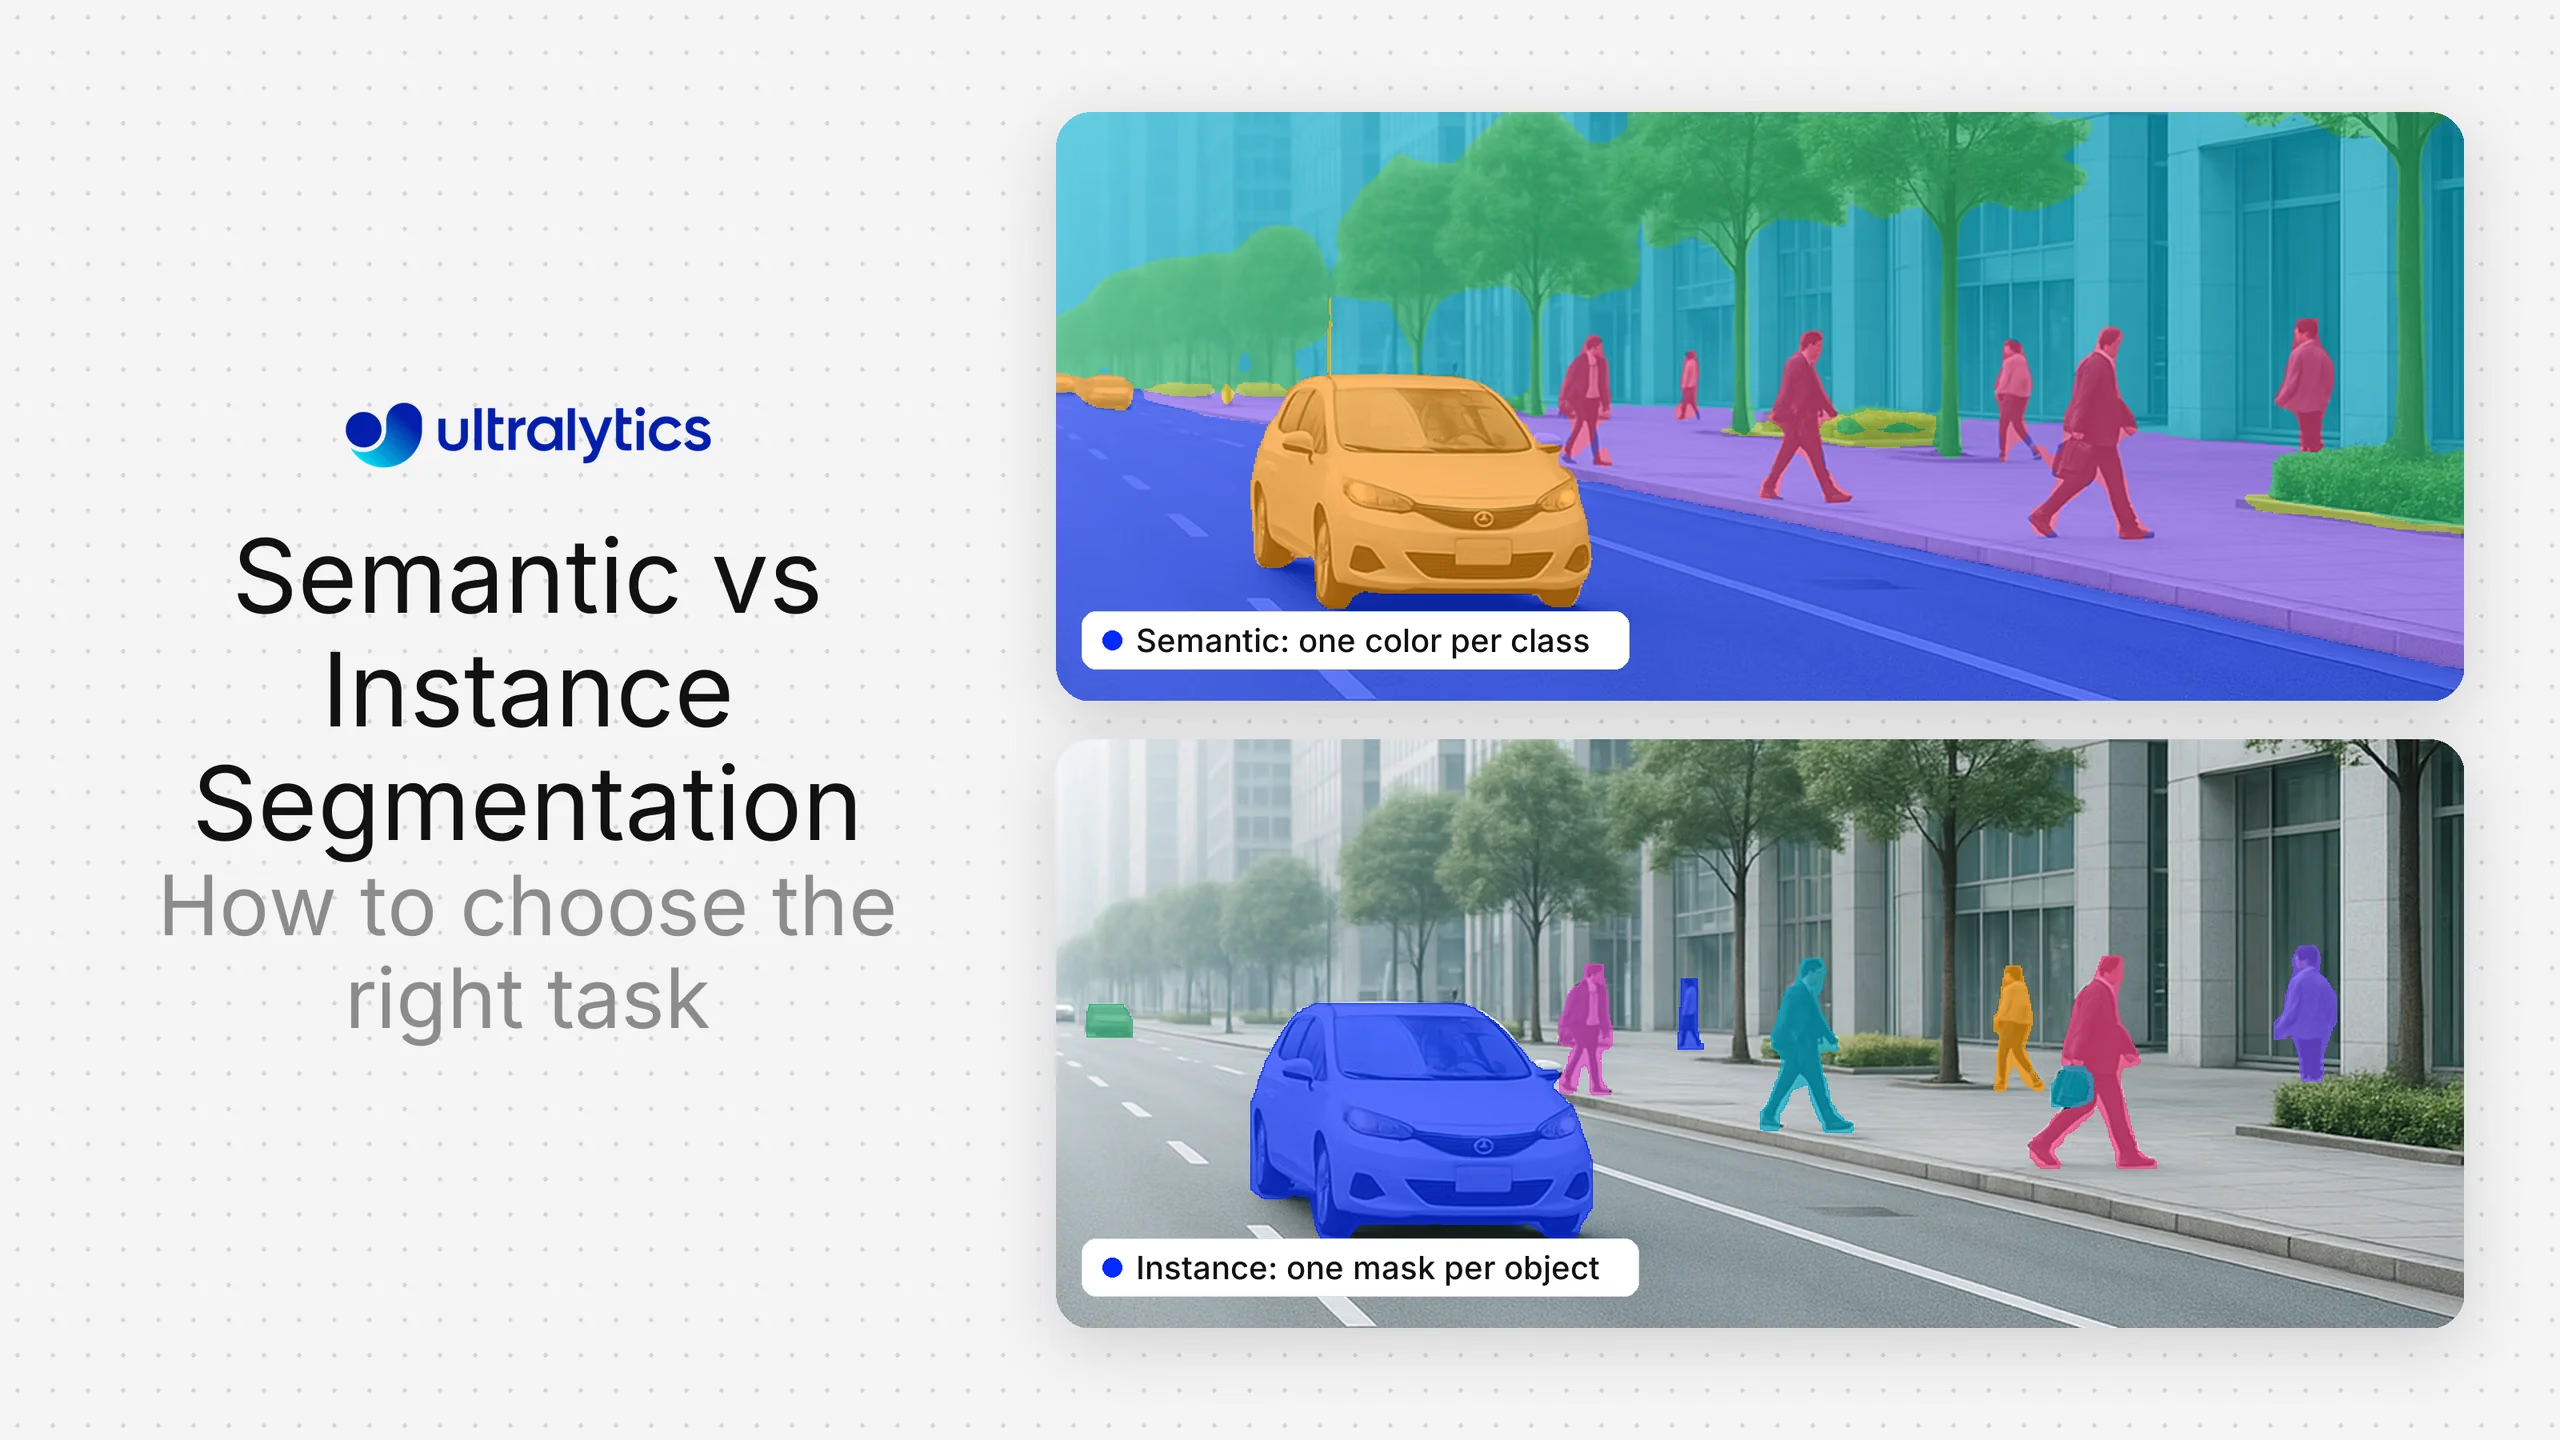
语义分割和实例分割都会在像素级别为图像添加标签,但它们要解决的问题不同。语义分割为每个像素分配一个类别,因此场景中的所有汽车都会合并成一个“汽车”区域。实例分割会区分每个物体,因此每辆汽车都有自己的掩码。如何选择取决于一个问题:你需要知道每个像素处的内容,还是需要知道每个像素属于哪个物体?本指南可以帮助你做出选择,也会介绍每项任务的标注成本和评估方式。Ultralytics YOLO 在同一框架中支持这两项任务。
一句话说明区别#
- 语义分割将每个像素分类为某个类别,例如道路、天空、人或汽车。同一类别的物体会合并为一个区域。请参阅术语表中的语义分割词条。
- 实例分割会找出每个独立物体,并为其分配自己的掩码和 ID。它通常处理可计数的物体,而忽略天空或草地等背景。请参阅术语表中的实例分割词条。
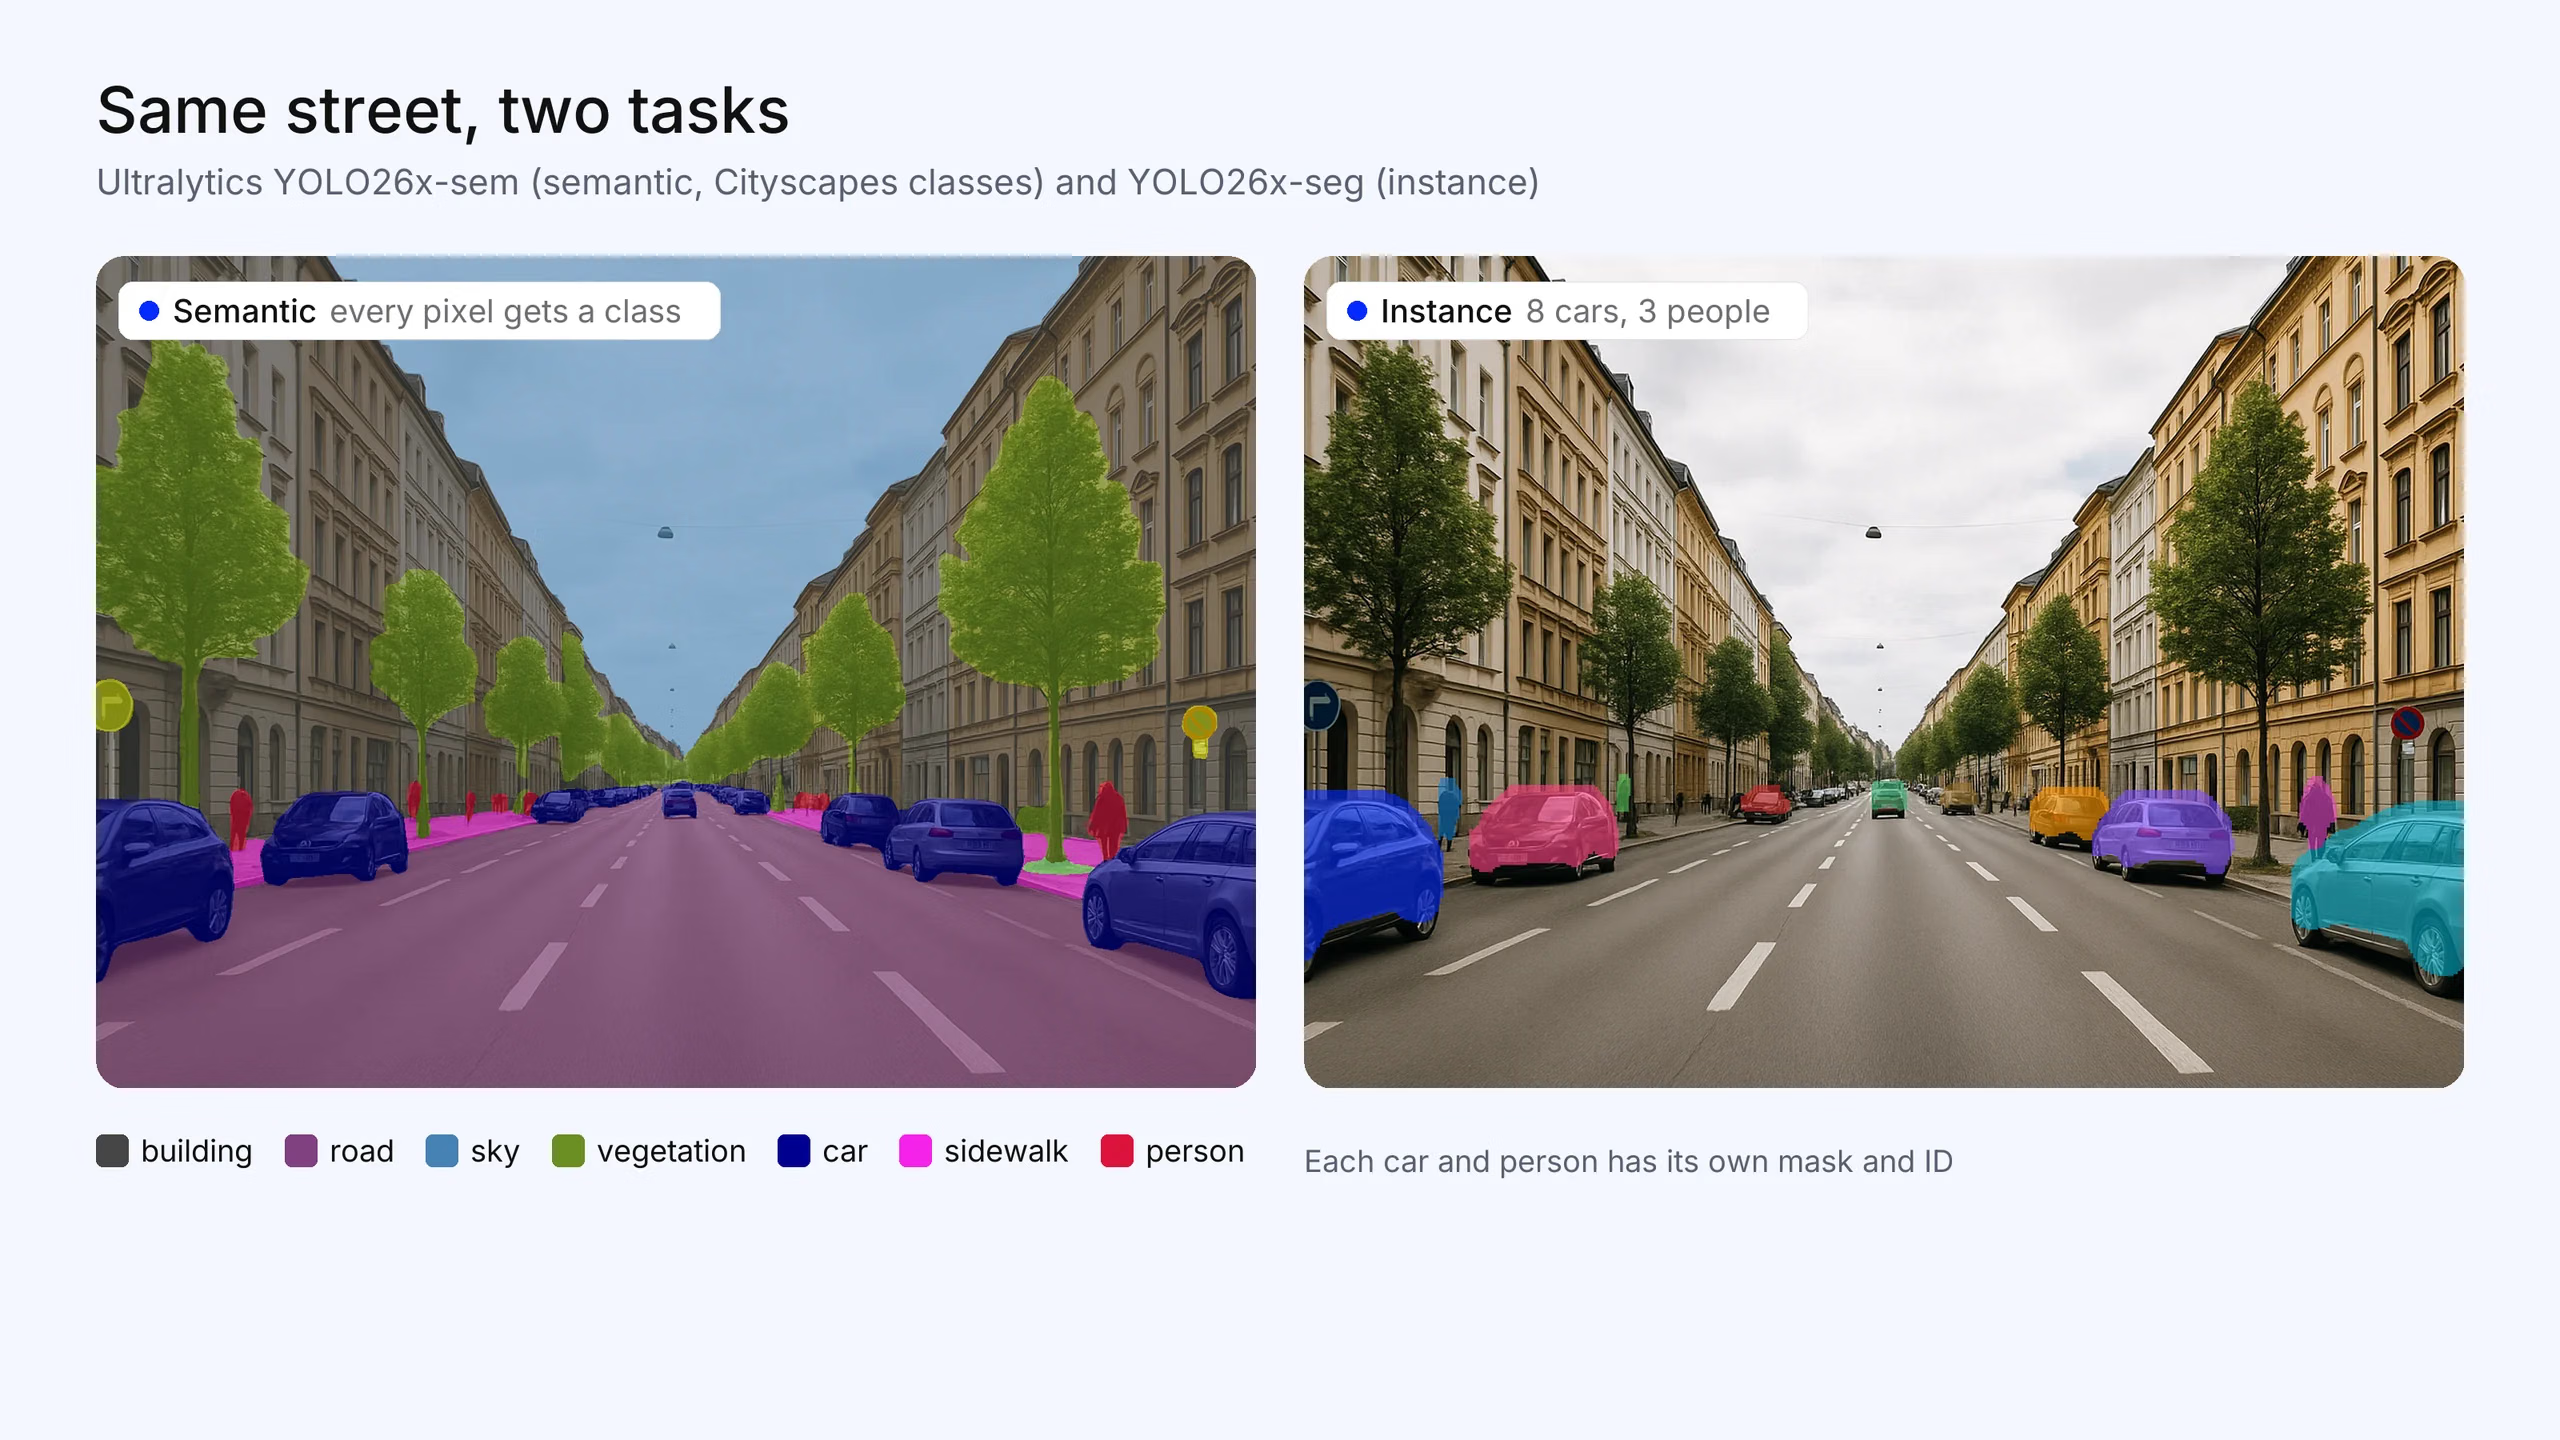
图 1. 同一条街道上的两种任务结果。Ultralytics YOLO26x-sem(Cityscapes 类别)为每个像素添加标签,因此所有汽车都属于同一个“汽车”类别。Ultralytics YOLO26x-seg 为检测到的 8 辆汽车和 3 个人分别生成掩码(置信度不低于 0.5)。这张照片是为本文生成的;掩码来自真实模型输出。
你的项目需要哪项任务?#
先从应用需要回答的问题入手:
| 如果你的应用需要…… | 使用 | 示例 |
|---|---|---|
| 了解场景中某个类别所占的面积 | 语义分割 | 可行驶路面区域、作物与杂草覆盖范围、土地覆盖类型 |
| 像物体一样仔细标注背景区域 | 语义分割 | 扫描图像中的天空、水域、植被、组织类型 |
| 统计物体数量 | 实例分割 | 树上的水果、排队的人 |
| 跨视频帧跟踪物体 | 实例分割,外加跟踪器 | 在场景中移动的人或车辆 |
| 逐个测量或处理物体 | 实例分割 | 机器人从一堆零件中拾取单个零件、测量每个缺陷 |
| 同时实现两者:覆盖整个场景并区分单个物体 | 全景分割 | 自动驾驶中的街景 |
如果你不确定,可以问自己:是否必须区分两个彼此接触且类别相同的物体?如果是,你需要实例分割(或全景分割)。如果不是,语义分割更简单,运行成本通常也更低。
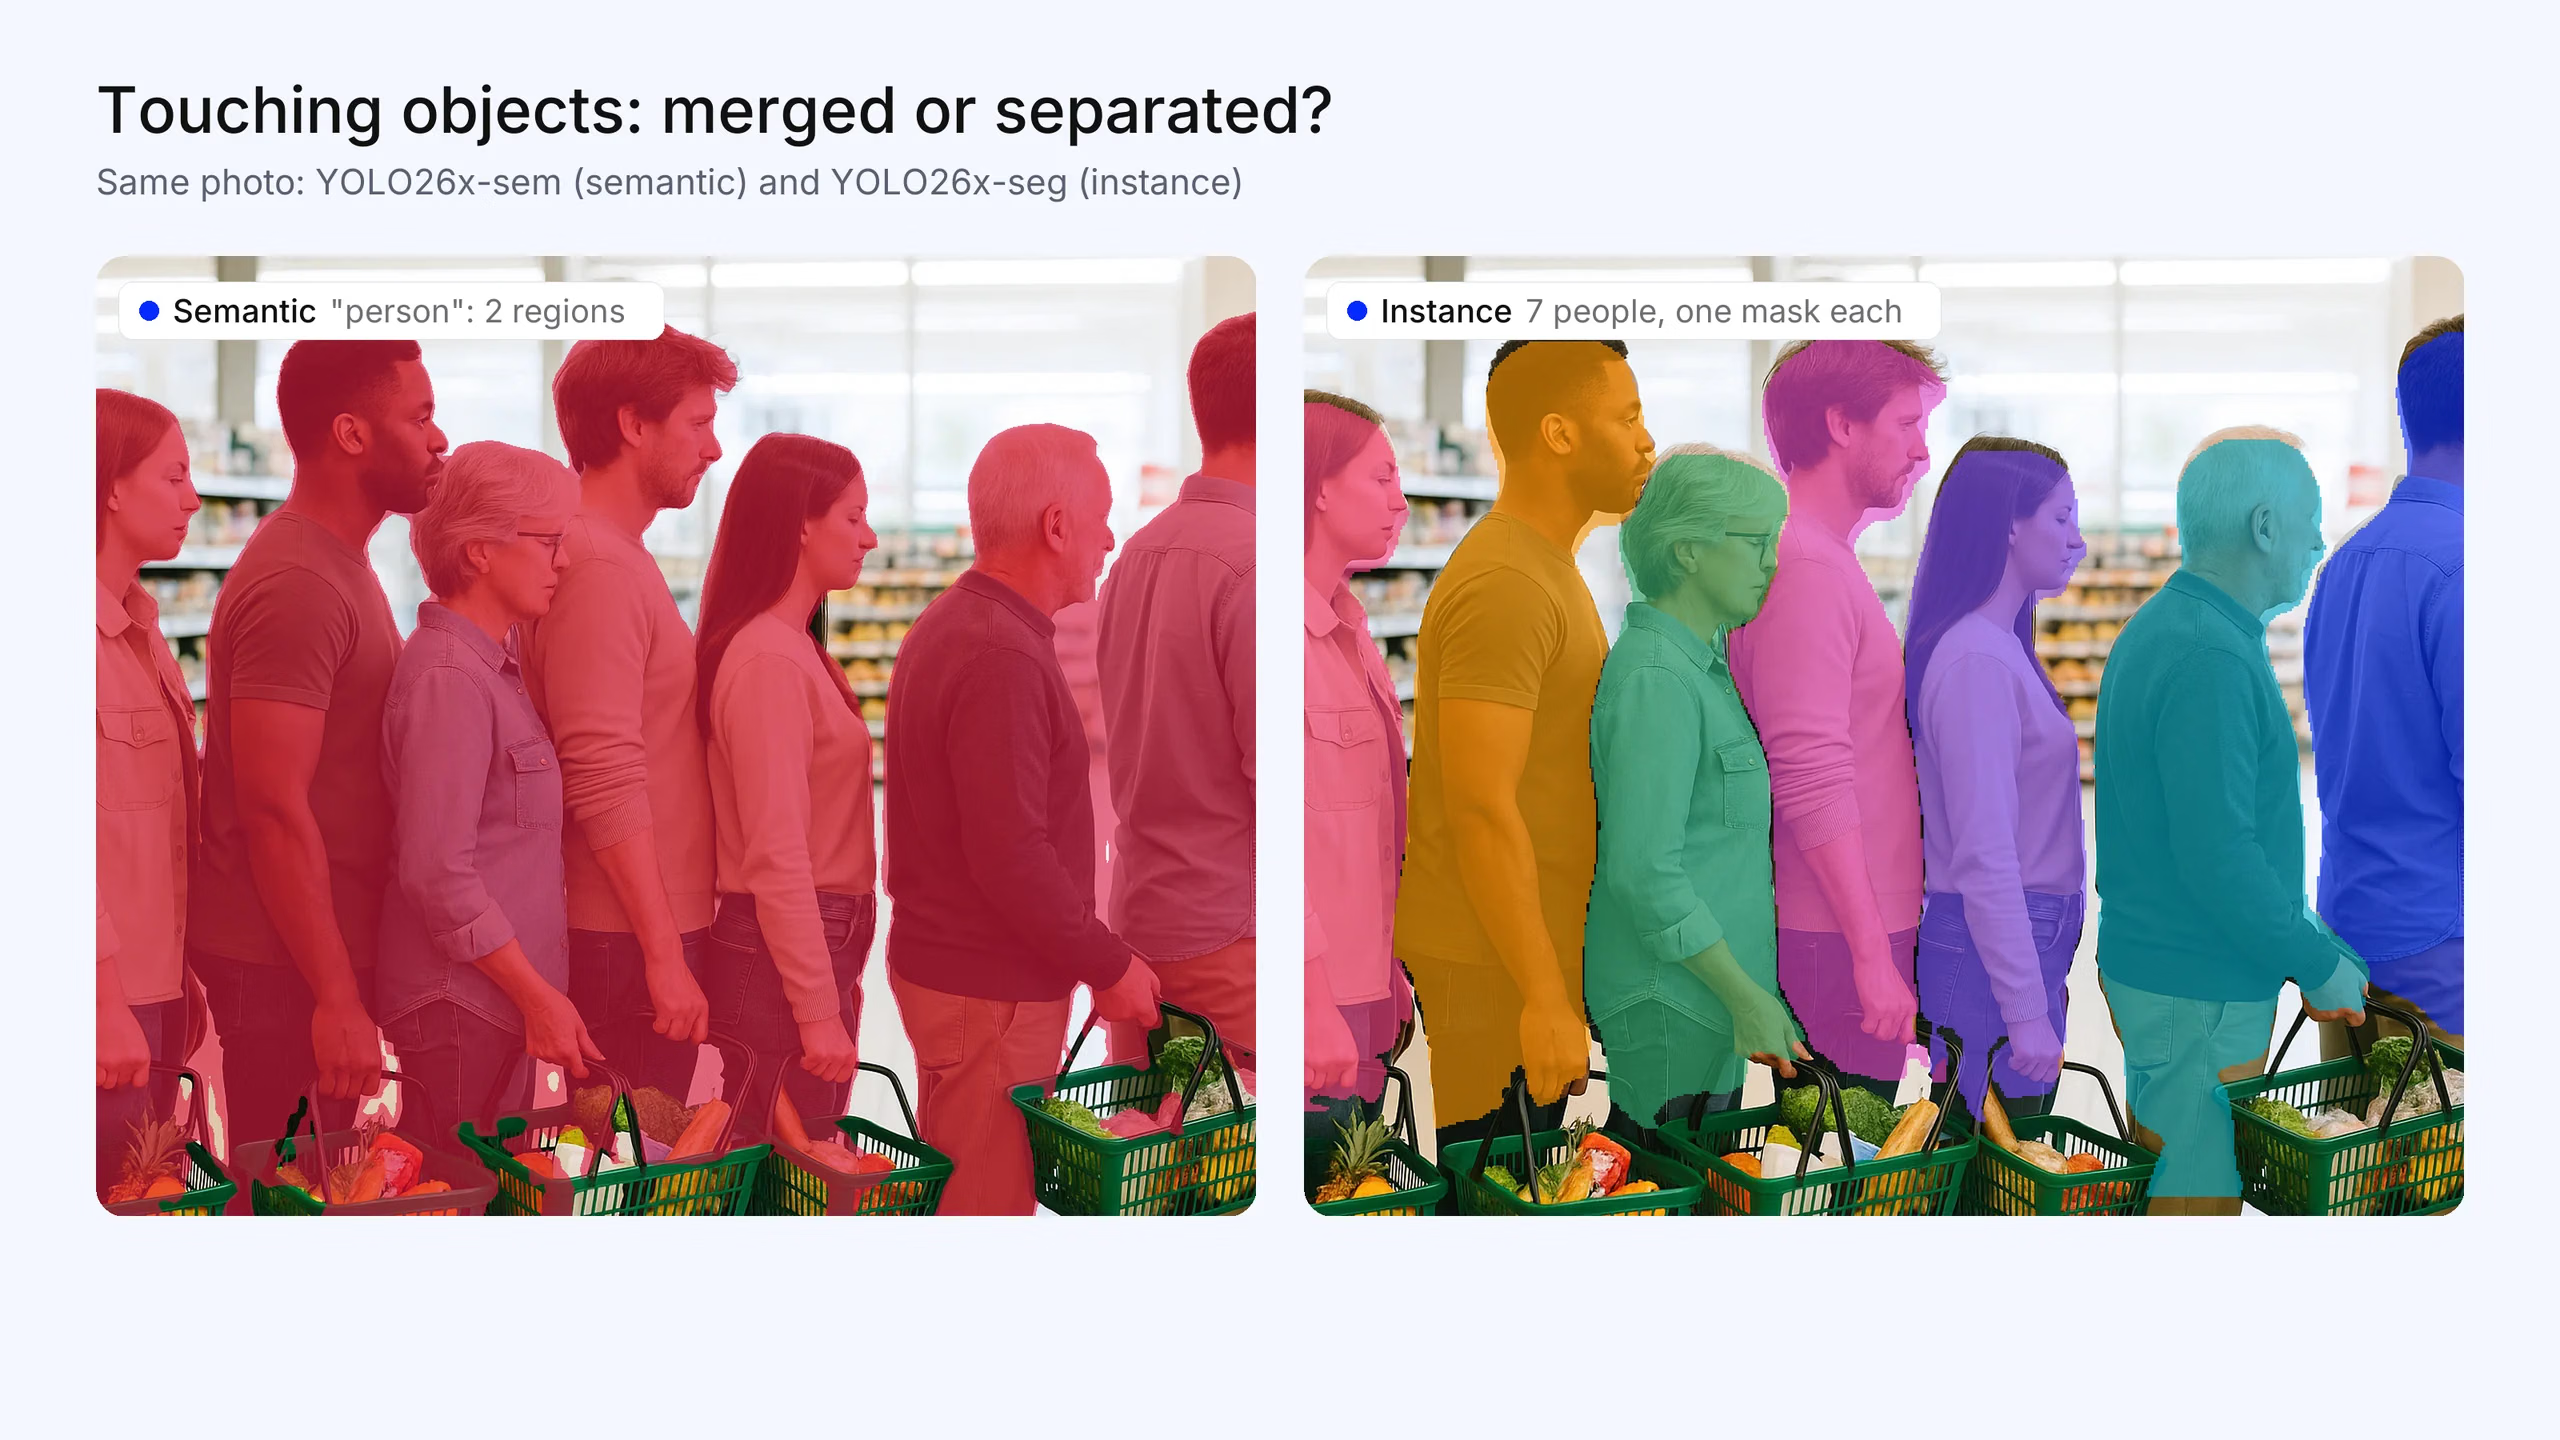
图 2. 七名顾客在收银台队伍中紧挨着站立。在语义分割输出(Ultralytics YOLO26x-sem)中,他们合并成两个连通的“人”区域,因此你无法据此统计人数。实例分割输出(Ultralytics YOLO26x-seg)则将 7 个人全部区分开。这张照片是为本文生成的;掩码来自真实模型输出。
主要区别一览#
| 比较标准 | 语义分割 | 实例分割 |
|---|---|---|
| 回答的问题 | 每个像素属于什么类别? | 每个像素属于哪个物体? |
| 同一类别的物体 | 合并为一个区域 | 彼此分开,每个物体都有自己的掩码和 ID |
| 覆盖范围 | 每个像素,包括背景 | 通常只包括感兴趣的物体 |
| 输出 | 一张与图像大小相同的类别图 | 掩码列表,每个掩码都有类别和置信度 |
| 能统计物体数量吗? | 不能直接统计 | 是 |
| 主要指标 | 平均交并比(mIoU) | 掩码平均精度(mask mAP) |
| 相对复杂度 | 较低:逐像素分类 | 较高:检测加逐物体掩码 |
各项任务的标注成本#
实际选择时,标注工作量往往是决定因素。
- 语义分割数据集为每张图像的每个像素分配类别,包括背景。此类数据集通常以单通道掩码图像的形式存储。每张图像都必须完整标注,不能跳过任何像素,除非明确将其标记为“ignore”(忽略)。
- 实例分割数据集会将每个感兴趣物体分别标出轮廓,形式可以是多边形或掩码。背景可以不标注,但每个物体都需要单独勾画;场景越拥挤,工作量就越大。
这两项任务都很耗费人力。借助辅助标注,只需点击或框选即可生成掩码,从而减少任一任务的工作量。如果你只需要区域级别的结果,就没必要为实例标注付费。
如何评估各项任务#
- 语义分割主要使用 mIoU 评估:预测区域与真实区域的重叠度,并对各类别取平均。评估中也会报告像素准确率。IoU 与检测任务中使用的是同一种重叠度量。
- 实例分割使用 mask mAP 评估,即用于检测的平均精度均值,但计算依据是掩码重叠度。它衡量的是能否找出每个物体,而不只是覆盖正确的像素。
这些指标不能直接相互比较。mIoU 较高并不能说明模型是否区分了各个独立物体。
全景分割:何时需要同时完成两者#
全景分割为每个像素分配类别,并为可计数物体分配实例 ID。道路和天空等背景“stuff”(背景区域)按语义类别标注;汽车和人等前景“things”(物体)则逐个区分。该任务使用全景质量(PQ)评估。如果你需要同时覆盖完整场景并区分每个物体,就应选择全景分割。请参阅全景分割。
简要了解各自的工作方式#
语义分割模型通常采用编码器—解码器网络,为每个像素预测类别。U-Net、DeepLab 和 SegFormer 都是知名示例。实例分割模型通常基于目标检测构建。Mask R-CNN 会在每个检测框内预测掩码;而 YOLACT 和 Ultralytics YOLO 分割模型等单阶段模型则一次性预测框和掩码,可用于实时任务。Mask2Former 等通用架构可以用一个模型处理语义分割、实例分割和全景分割。如需进一步了解实例分割,请参阅什么是实例分割。
Ultralytics YOLO 同时支持两项任务#
Ultralytics YOLO 使用相同的 Python API 和 CLI 运行这两项任务:
- 实例分割使用
segment任务。 - 语义分割使用
semantic任务。YOLO26 语义模型带有-sem后缀,并使用 Cityscapes 和 ADE20K 数据集预训练。任务页面中的表格准确展示了这两项任务在代码中的输出差异。
这两项任务都可以在本地或云端通过 Ultralytics Platform 进行训练。
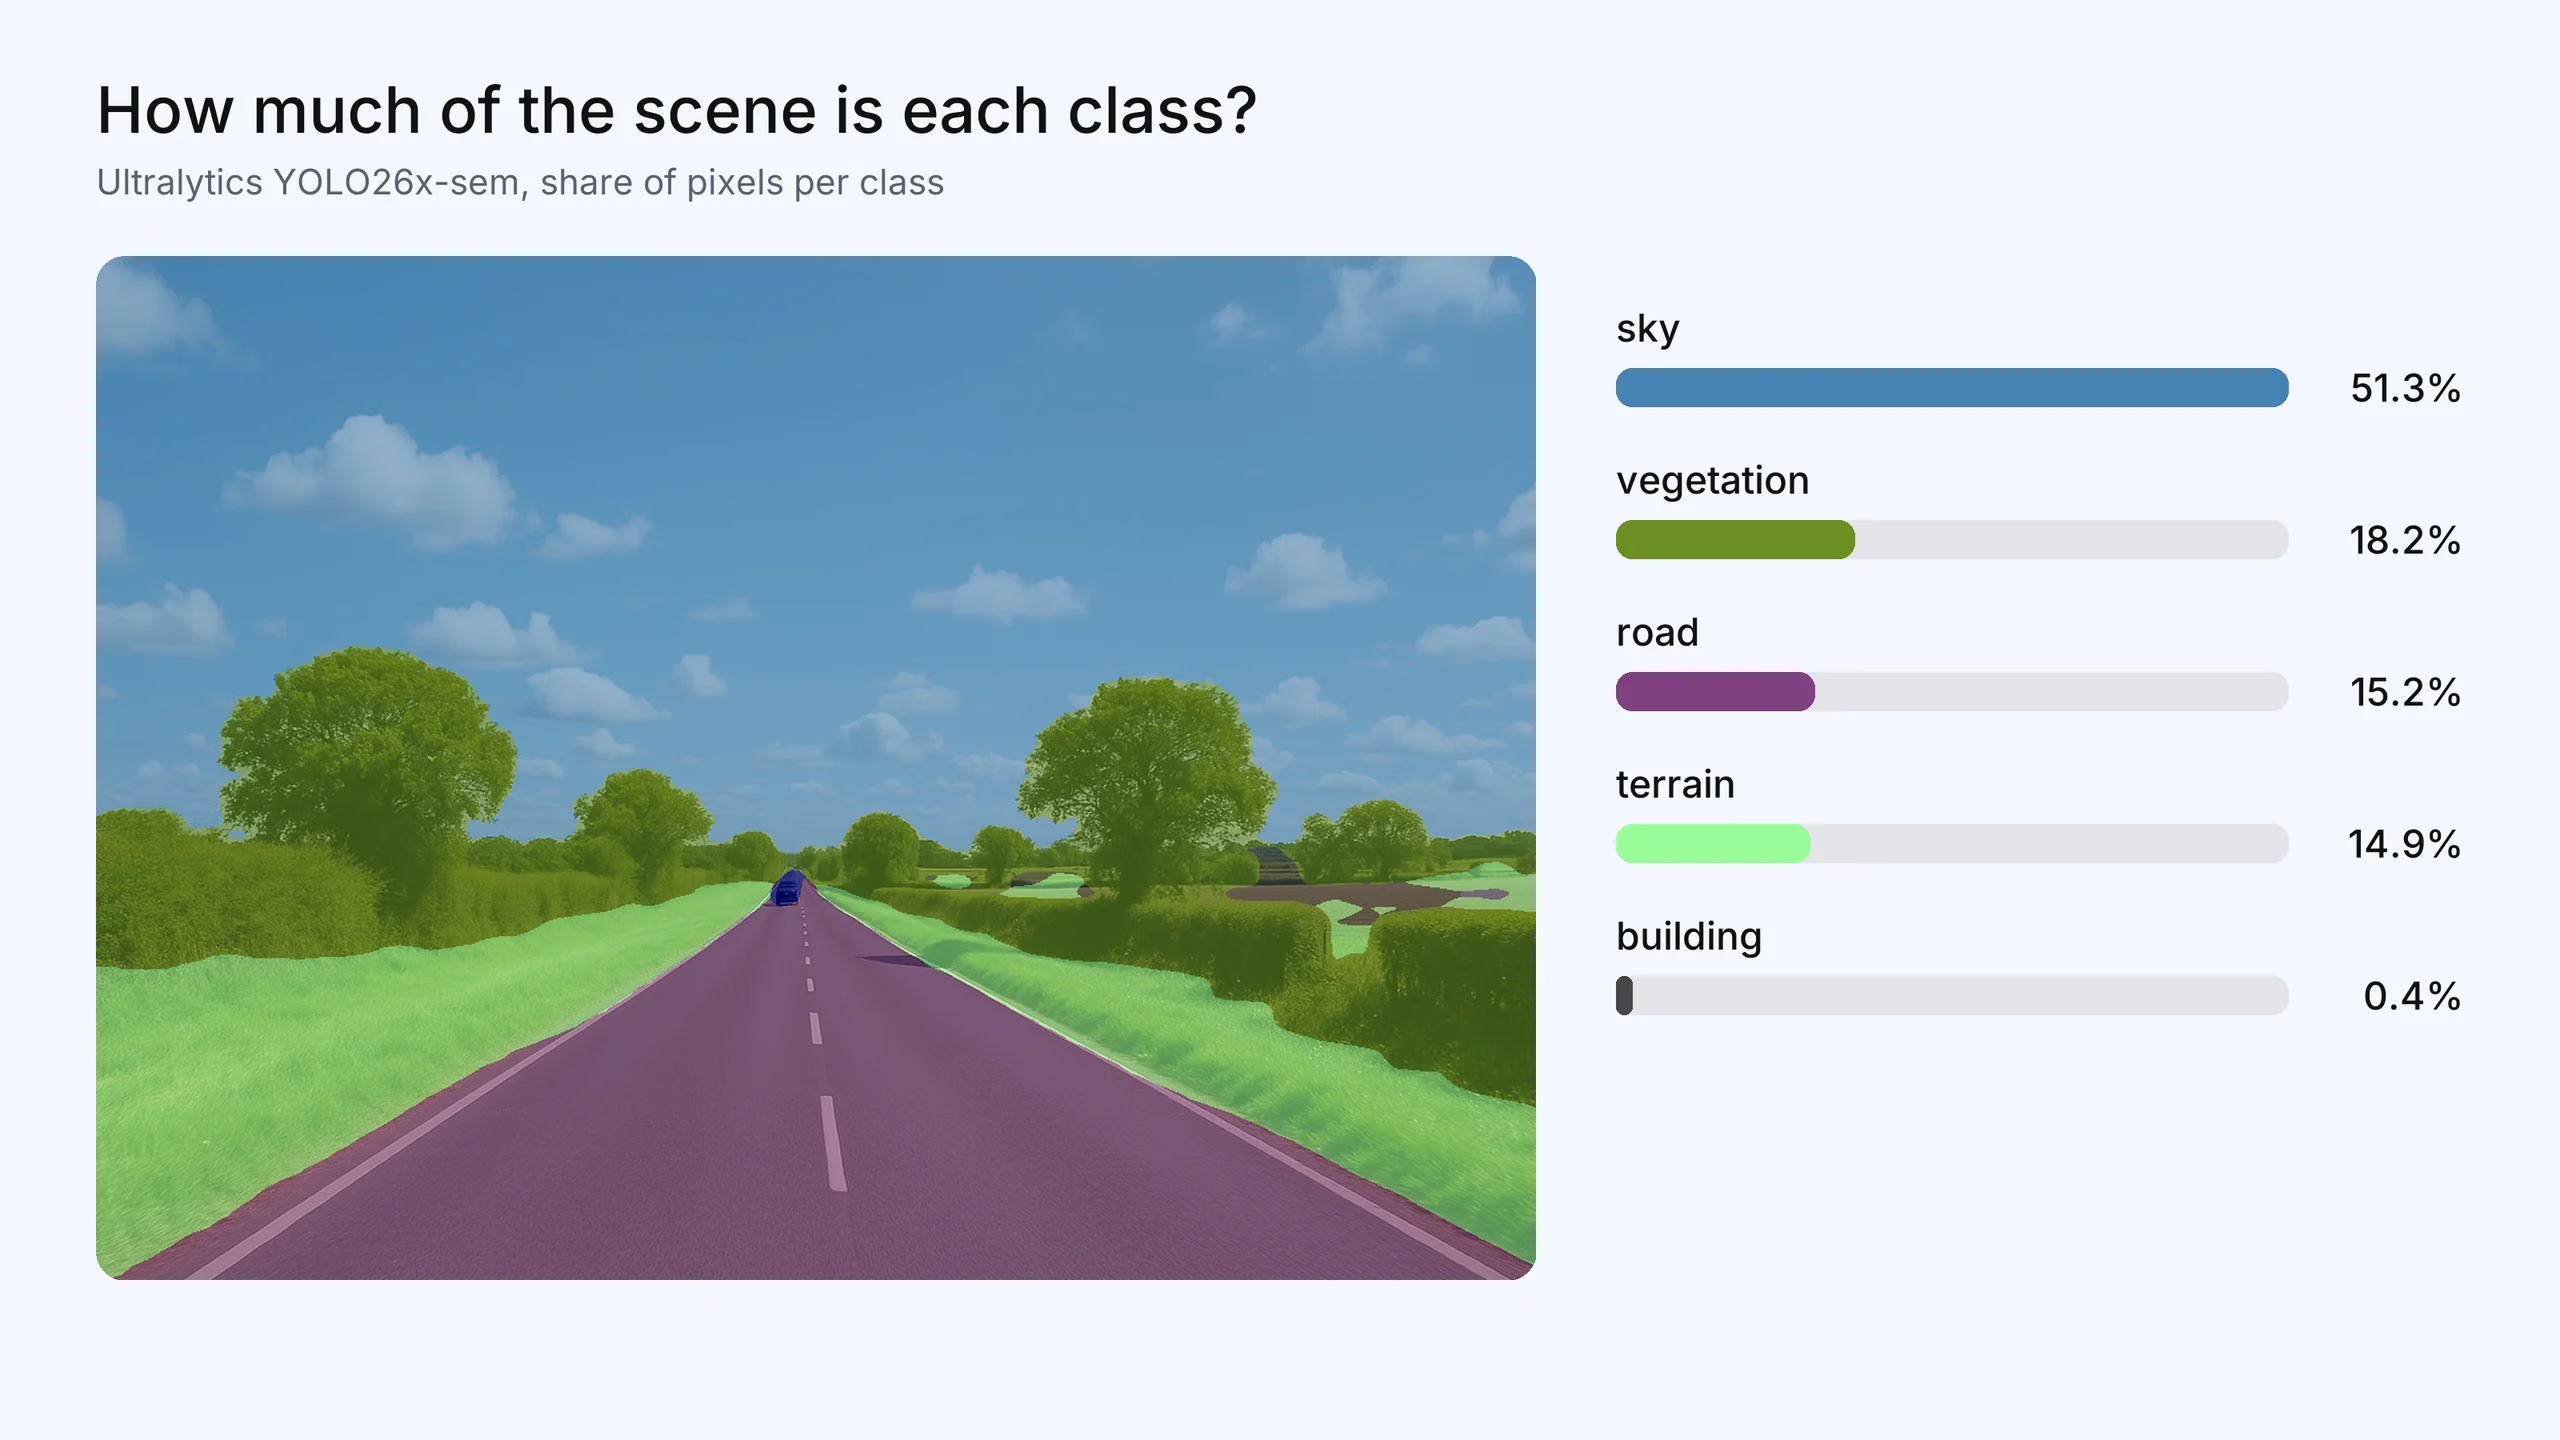
图 3. 语义分割回答了“场景中每个类别各占多少”。Ultralytics YOLO26x-sem 将此画面中的 51.3% 标记为天空、18.2% 标记为植被、15.2% 标记为道路、14.9% 标记为地形。这张照片是为本文生成的;类别图和占比均来自真实模型输出。
常见问题
语义分割为每个像素标注类别,但会将同一类别的所有对象视为一个区域。实例分割会为每个对象生成独立掩码,因此可以分别计数和跟踪同一类别的对象。
先问自己是否需要区分两个相互接触的同类对象。如果需要对单个对象进行计数、跟踪或操作,就使用实例分割。如果只需知道哪些区域属于哪些类别,语义分割就更简单。
Mask R-CNN 是一种实例分割模型。它会检测每个对象,然后在该对象的边界框内预测一个独立的像素掩码。
实例分割通常更难。它不仅要对像素进行分类,还要区分同一类别的不同对象,因此既需要检测,也需要分割。
主要使用平均交并比 (mIoU),即各类别预测区域与真实区域之间重叠程度的平均值。实例分割使用掩码 mAP,全景分割使用全景质量 (PQ)。









