Die besten Tiefenschätzungsmodelle: So triffst du die richtige Wahl
Vergleiche monokulare Tiefenmodelle wie Depth Anything, Depth Pro, Metric3D, UniDepth und Ultralytics YOLO26 für metrische Tiefe, Edge-Geräte und Robotik.
Bei der Wahl eines Tiefenschätzungsmodells kommt es auf drei Dinge an: ob du Entfernungen in Metern oder nur relative Tiefe benötigst, wo das Modell ausgeführt wird und ob die Lizenz deine Nutzung erlaubt. Für relative Tiefe und Forschung sind Depth Anything und Marigold gute Modelle für den Einstieg. Für metrische Tiefe bei unbekannter Kamera solltest du Depth Pro und UniDepth in Betracht ziehen; wenn du die Brennweite deiner Kamera kennst, kommen auch Metric3D v2 und Depth Anything 3 Metric infrage. Für Edge-Geräte solltest du Depth Anything V2 Small sowie die MiDaS v3.1-Modelle Swin2-Tiny und LeViT in die engere Wahl nehmen und anschließend die Latenz auf deinem Gerät messen. Für Tiefenschätzung mit geringer Latenz auf NVIDIA-GPUs parallel zu anderen Ultralytics-YOLO-Aufgaben solltest du auch Ultralytics YOLO26 depth testen. Dieser Leitfaden vergleicht neun monokulare Tiefenmodelle und bietet eine Entscheidungshilfe für die Auswahl.
Wenn du neu bei dieser Aufgabe bist, lies zuerst, was monokulare Tiefenschätzung ist. Auf dieser Seite geht es um die Auswahl eines Modells.
Relative oder metrische Tiefe: Entscheide zuerst, was du brauchst#
- Relative Tiefe zeigt dir, welche Pixel näher oder weiter entfernt sind, allerdings ohne bekannte Maßstabseinheit. Das reicht für das Szenenverständnis, Hintergrundeffekte und die Sortierung von Objekten nach Entfernung.
- Metrische Tiefe gibt Entfernungen in Metern an. Du brauchst sie zum Messen, zur Bewegungsplanung eines Roboters oder zum Kombinieren von Tiefendaten mit anderen Sensoren.
Metrische Modelle erreichen den tatsächlichen Maßstab auf unterschiedliche Weise. Manche schätzen die Brennweite der Kamera selbst, manche benötigen diese als Eingabe, und manche verwenden einen festen Maßstab, den du für deine Kamera kalibrierst. Wie ein Modell seinen Maßstab bestimmt, kann in der Praxis wichtiger sein als ein paar Punkte Benchmarkgenauigkeit. Hintergrund zu den beiden Arten findest du im Glossareintrag zur Tiefenschätzung.
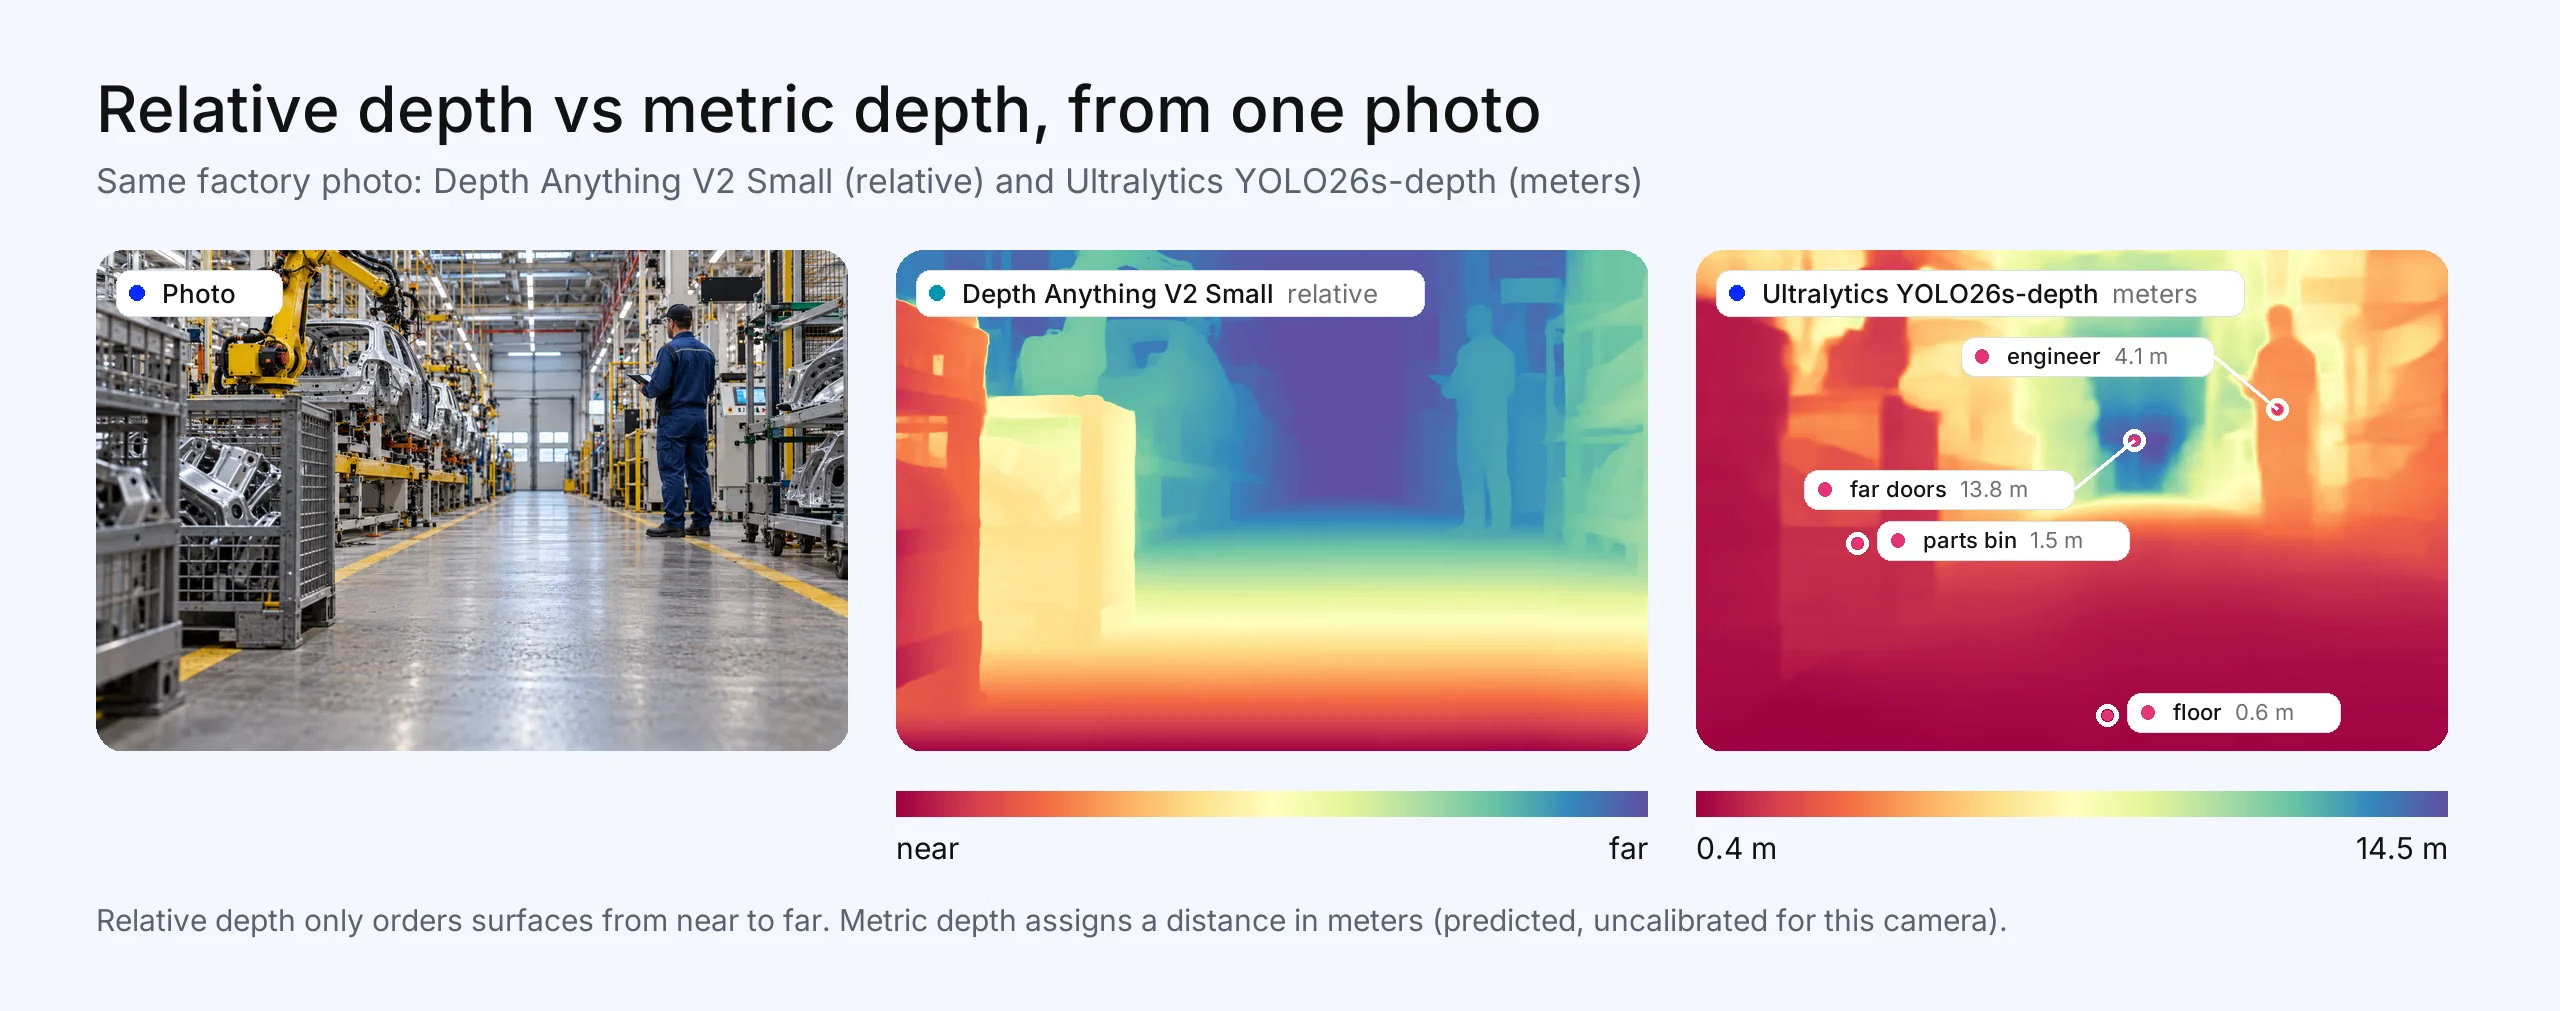
Abb. 1. Dasselbe Fabrikfoto, verarbeitet von Depth Anything V2 Small, das relative Tiefe vorhersagt (näher oder weiter entfernt, ohne Einheiten), und von Ultralytics YOLO26s-depth, das Entfernungen in Metern vorhersagt: etwa 1,5 m bis zum Teilebehälter, 4,1 m bis zum Techniker und 13,8 m bis zu den Türen am Ende. Das Foto wurde für diesen Artikel erstellt; beide Tiefenkarten sind echte Modellausgaben. Die Entfernungen sind Vorhersagen des veröffentlichten Checkpoints, nicht für diese Kamera kalibriert und keine Messwerte.
Tiefenschätzungsmodelle im Vergleich#
Die Modelle sind alphabetisch und nicht nach Rangfolge aufgeführt. Wir verzichten auf Genauigkeitswerte für modellübergreifende Vergleiche, da jede Veröffentlichung ein eigenes Benchmarkverfahren verwendet und die Ergebnisse daher nicht direkt vergleichbar sind. Die Lizenzen wurden im Oktober 2026 geprüft und gelten jeweils für einzelne Checkpoints.
| Modell | Ausgabe | Größen | Lizenz | Am besten geeignet für | Wichtigster Nachteil |
|---|---|---|---|---|---|
| Depth Anything 3 | Relativ; metrisch bei bekannter Brennweite (DA3Metric) | Von Small mit 0,08B bis Giant mit 1,15B sowie ein Nested-Modell mit 1,40B (laut Projektangaben) | Small, Base, Metric-Large und Mono-Large: Apache 2.0. Large, Giant und Nested: CC BY-NC 4.0 | Mehransichtsgeometrie und Kamerapose sowie Tiefe | Größere Modelle sind nicht für die kommerzielle Nutzung freigegeben; DA3Metric-Large benötigt die Brennweite deiner Kamera (das nicht kommerziell nutzbare Nested-Modell gibt direkt Meterwerte aus). |
| Depth Anything V2 | Relativ; separate metrische Checkpoints für Innen- und Außenbereiche | Small 24,8M, Base 97,5M, Large 335,3M | Small: Apache 2.0. Base und Large: CC-BY-NC-4.0 | Robuste relative Tiefe für allgemeine Anwendungen | Nur Small ist für die kommerzielle Nutzung lizenziert; die metrischen Checkpoints sind auf 20 m (Innenbereiche) oder 80 m (Außenbereiche) begrenzt. |
| Depth Pro (Apple) | Metrisch, ohne Kamera-Intrinsik | Ein Modell | Eigene Lizenz von Apple für Code und Gewichte | Präzise metrische Tiefenschätzung aus Fotos mit unbekannten Kameras | Rechenintensiver als Edge-Modelle; prüfe die Lizenzbedingungen für deine Nutzung. |
| Marigold | Relativ (affininvariant) | Basiert auf einem latenten Diffusionsmodell | Code: Apache 2.0. Modelle: RAIL++-M | Feine Details, wenn Geschwindigkeit keine Rolle spielt | Langsamer als einstufige Modelle, besonders mit Ensemble-Verfahren |
| Metric3D v2 | Metrische Tiefe und Oberflächennormalen | ViT-Small, ViT-Large, ViT-giant2 | Code: BSD-2-Clause; prüfe die Bedingungen für den Checkpoint | Metrische Tiefe plus Normalen für die 3D-Rekonstruktion | Benötigt eine korrekte Brennweite, damit der Maßstab stimmt |
| MiDaS | Relativ | v3.1 von BEiT-Large 512 bis hinunter zu Swin2-Tiny 256 und LeViT 224 | MIT | Eine bekannte Baseline mit permissiver Lizenz und integrierten Varianten | Älter als die neueren Foundation-Modelle; das Repository ist archiviert und wird nicht mehr gepflegt |
| Ultralytics YOLO26-Tiefe | Metrisch (Meter), ein einheitlicher globaler Maßstab, den du kalibrieren kannst | n 6.3M bis x 57.0M | AGPL-3.0 oder eine Ultralytics Enterprise-Lizenz | Geringe Latenz bei der Tiefenschätzung auf NVIDIA-GPUs parallel zu anderen YOLO-Aufgaben | Für den absoluten Maßstab ist eine Kalibrierung deiner Kamera nötig; kein Vergleich mit anderen Modellen anhand eines gemeinsamen Genauigkeitsprotokolls |
| UniDepth V2 | Metrische Tiefe plus Kameraintrinsik aus einem Bild | ViT-S-, ViT-B- und ViT-L-Backbones | CC BY-NC 4.0 | Metrische Tiefe bei unbekannter Kamera | Nicht-kommerzielle Lizenz |
| ZoeDepth | Metrisch (Indoor-, Outdoor- oder kombinierte Köpfe), auf Grundlage eines Vortrainings für relative Tiefe | Auf ViT basierend | MIT | Permissive metrische Tiefenschätzung für bekannte Indoor- oder Outdoor-Bereiche | Für bestimmte Indoor- und Outdoor-Bereiche trainiert; das Repository ist archiviert und wird nicht mehr gepflegt |
So wählst du ein Modell zur Tiefenschätzung aus#
Gehe diese Fragen der Reihe nach durch:
- Brauchst du Meterangaben? Falls nicht, beginne mit Depth Anything V2 oder Depth Anything 3 oder mit MiDaS, wenn du eine MIT-Lizenz möchtest.
- Kennst du die Kameraintrinsik? Wenn nicht, wähle ein Modell, das sie schätzt: Depth Pro oder UniDepth. Wenn ja, können Metric3D v2 und Depth Anything 3 Metric sie verwenden.
- Wo soll das Modell laufen? Wenn die Serverlatenz keine Einschränkung ist, eignen sich die großen Foundation-Modelle. Für geringe Latenz bei der Tiefenschätzung auf NVIDIA-GPUs parallel zu anderen YOLO-Aufgaben solltest du Ultralytics YOLO26 depth in Betracht ziehen und die Leistung auf deinem Edge-Gerät messen, zum Beispiel auf NVIDIA Jetson. Weitere Kandidaten sind Depth Anything V2 Small sowie die MiDaS v3.1-Modelle Swin2-Tiny und LeViT. Die CPU-Latenz hängt vom Prozessor, der Laufzeitumgebung, der Eingabeauflösung und dem Modell ab. Miss genau deine Konfiguration; Abb. 3 zeigt ein Beispiel für kleine Ultralytics YOLO26 depth-Modelle. Siehe den Abschnitt zu Edge-Geräten weiter unten.
- Kannst du die Lizenz verwenden? Prüfe den genauen Checkpoint. Bei mehreren Modellfamilien stehen kleine Modelle unter Apache 2.0, während große Modelle nicht kommerziell nutzbar sind.
- Kannst du kalibrieren oder feinabstimmen? Wenn du etwa 50 bis 150 beschriftete Bilder von deiner eigenen Kamera mit einigen Messpunkten pro Bild sammeln kannst, vergleiche in deinen eigenen Szenen ein kalibriertes oder feinabgestimmtes Modell mit einem Zero-Shot-Modell. In den Tests von Ultralytics mit YOLO26s-depth (150 Bilder pro Kamera, 5 Messpunkte pro Bild) brachte diese Kalibrierung den Maßstab auf etwa 1 % Abweichung von einer Anpassung mit vollständigen Ground-Truth-Daten; vor der Kalibrierung betrug die Abweichung 4 % bis 46 %. Dieser Wert misst, wie gut der Maßstab wiederhergestellt wurde, nicht die allgemeine Tiefengenauigkeit.
Teste anschließend zwei oder drei Kandidaten mit Bildern deiner eigenen Kamera und der Auflösung, die du später verwenden wirst.
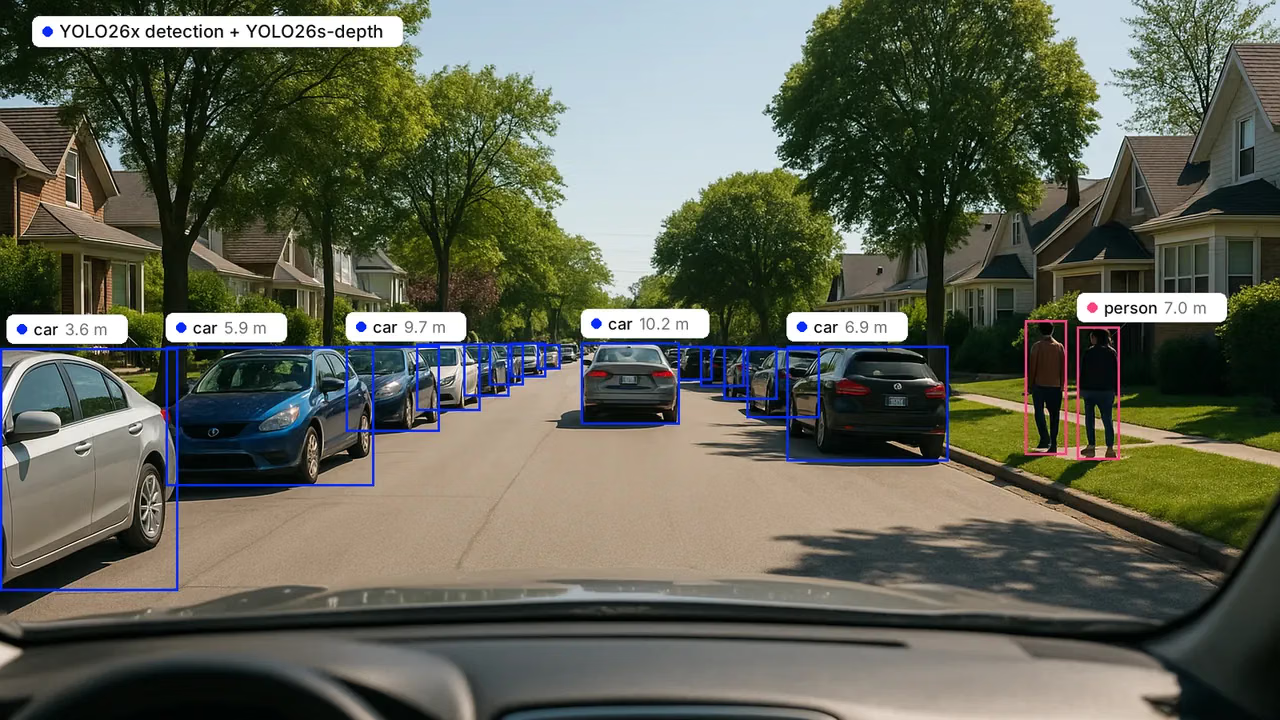
Abb. 2. Vorhergesagte Abstände zu ausgewählten erkannten Autos und Personen, ermittelt durch die Kombination von Ultralytics YOLO26x für die Erkennung mit Ultralytics YOLO26s-depth: 3.6 m bis zum nächsten parkenden Auto, 6.9 m bis zum Auto rechts und 7.0 m bis zur markierten Person rechts. Das Foto wurde für diesen Artikel erstellt; die Boxen und Abstände sind echte Modellausgaben, aber nicht für diese Kamera kalibriert. Es sind Vorhersagen, keine gemessenen Abstände.
Die Modelle im Detail#
Alphabetisch aufgeführt.
Depth Anything 3#
Depth Anything 3 von ByteDance Seed erweitert Depth Anything von einzelnen Bildern auf eine beliebige Anzahl von Ansichten. Die Hauptmodelle schätzen Tiefe und Kamerapose gemeinsam; spezielle Varianten verarbeiten relative monokulare Tiefe (DA3Mono-Large) und metrische monokulare Tiefe (DA3Metric-Large). Ausgabe: relative Tiefe bei den Hauptmodellen und Mono-Modellen; metrische Tiefe mit einer vorgegebenen Brennweite bei DA3Metric-Large oder direkt beim nicht-kommerziellen Nested-Modell. Größen: 0.08B (Small) bis 1.15B (Giant) sowie das 1.40B-Nested-Modell, wie in den Modellkarten des Projekts aufgeführt. Lizenz: Small, Base, Metric-Large und Mono-Large stehen unter Apache 2.0; Large, Giant und Nested unter CC BY-NC 4.0. Optimal für: Szenen mit mehreren Ansichten und die 3D-Rekonstruktion. Kompromiss: Die leistungsstärksten Checkpoints sind nicht kommerziell nutzbar.
Depth Anything V2#
Depth Anything V2 ist ein breit verfügbares offenes Modell für relative Tiefe, das in Innenräumen, im Freien und in ungewöhnlichen Szenen zuverlässige Ergebnisse liefert. Das Projekt veröffentlicht außerdem metrische Checkpoints, die für Innenraumszenen (bis zu 20 m) und Außenaufnahmen (bis zu 80 m) feinabgestimmt wurden. Größen: Small 24.8M, Base 97.5M, Large 335.3M. Lizenz: Small steht unter Apache 2.0; Base und Large unter CC-BY-NC-4.0. Optimal für: allgemeine Schätzung relativer Tiefe. Kompromiss: Für die kommerzielle Nutzung steht dir nur das Small-Modell zur Verfügung, und die metrischen Checkpoints können Tiefen jenseits ihrer festgelegten Höchstwerte nicht vorhersagen.
Depth Pro#
Depth Pro von Apple sagt die metrische Tiefe anhand eines einzelnen Bildes voraus, ohne Kameraintrinsik zu benötigen, und schätzt die Brennweite selbst. Apple gibt an, eine 2.25-Megapixel-Tiefenkarte auf einer Standard-GPU in 0.3 Sekunden zu erstellen; feine Strukturen weisen dabei scharfe Konturen auf. Lizenz: Für den Code und die Gewichte gilt Apples eigene Lizenz. Optimal für: metrische Tiefe aus Fotos, bei denen du die Kamera nicht kontrollierst. Kompromiss: Das Modell ist für Server ausgelegt, nicht für Edge-Geräte. Lies vor der kommerziellen Nutzung die Lizenz.
Marigold#
Marigold nutzt ein vortrainiertes Bild-Diffusionsmodell für die Tiefenschätzung und wurde ausschließlich mit synthetischen Daten trainiert. Es erzeugt sehr detaillierte relative Tiefen. Lizenz: Code unter Apache 2.0, Modelle unter RAIL++-M. Optimal für: Offline-Aufgaben, bei denen Details wichtiger sind als Geschwindigkeit, etwa die Erstellung von Inhalten und Datensätzen. Kompromiss: Das Modell unterstützt Inferenz in einem Schritt; Ensemble-Verfahren zur Verbesserung der Genauigkeit erhöhen die Kosten erheblich. Miss daher, ob es deine Latenzanforderungen erfüllt.
Metric3D v2#
Metric3D v2 sagt metrische Tiefe und Oberflächennormalen anhand eines einzelnen Bildes voraus. Es gibt Checkpoints für ViT-Small, ViT-Large und ViT-giant2, darunter ONNX-Exporte. Lizenz: Der Code steht unter BSD-2-Clause; prüfe die Bedingungen für den verwendeten Checkpoint. Optimal für: 3D-Rekonstruktion und Robotik-Pipelines, die auch Oberflächennormalen benötigen. Kompromiss: Das Modell bildet Bilder auf eine kanonische Kamera ab. Damit der Maßstab stimmt, brauchst du also eine korrekte Brennweite.
MiDaS#
MiDaS von Intels ISL machte die robuste Schätzung relativer Tiefe praxisgerecht, indem es mit einer Mischung aus Datensätzen trainiert wurde. Version 3.1 reicht vom BEiT-Large-Modell für hohe Qualität bis zu den für eingebettete Geräte vorgesehenen Modellen Swin2-Tiny und LeViT. Außerdem gibt es ein älteres kleines MiDaS-v2.1-Modell im OpenVINO-Format für Intel-CPUs sowie Beispiele für Mobilgeräte mit iOS und Android. Lizenz: MIT. Optimal für: eine permissive, gut dokumentierte Baseline. Kompromiss: Das Modell stammt aus der Zeit vor den neueren Foundation-Modellen, und Intel hat das Repository archiviert, sodass es keine Fehlerbehebungen mehr erhält. Vergleiche es anhand deiner eigenen Bilder mit einem neueren Modell.
Ultralytics YOLO26-Tiefe#
Ultralytics YOLO26 unterstützt die Tiefenschätzung (angekündigt im Juli 2026) in fünf Größen von 6.3M (n) bis 57.0M (x) Parametern bei 768 Pixeln. Die Modelle sagen die Tiefe in Metern mit einem Log-Tiefenkopf voraus, der ungefähr 0.02 bis 150 Meter abdeckt. Ein Modell eignet sich damit für Innenräume und Außenszenen. Die veröffentlichten Gewichte verwenden einen einheitlichen globalen Maßstab; für genaue absolute Tiefenwerte mit einer bestimmten Kamera passt model.calibrate() den Maßstab anhand von etwa 50 bis 150 beschrifteten Bildern an. Einige Messpunkte pro Bild genügen, und ein erneutes Training ist nicht nötig. In unserem TensorRT-FP16-Benchmark mit Batchgröße 1 auf einer NVIDIA T4 bei einer Eingabegröße von etwa 768 Pixeln liegt die reine Inferenzlatenz (ohne Vor- und Nachverarbeitung) zwischen 2.7 ms (n) und 13.6 ms (x). Alle fünf Größen hatten eine geringere Latenz als Depth Anything V2 Small. Dies ist ein Latenzvergleich, keine Genauigkeitsbewertung nach einem gemeinsamen Verfahren. Die Modelle lassen sich in ONNX, TensorRT, CoreML, OpenVINO und weitere Formate exportieren und über dieselbe Python-API und CLI wie Modelle für Erkennung, Segmentierung und Pose trainieren. Lizenz: AGPL-3.0 oder eine Ultralytics Enterprise-Lizenz für die kommerzielle Nutzung mit geschlossenem Quellcode. Optimal für: geringe Latenz bei der Tiefenschätzung auf NVIDIA-GPUs parallel zu anderen YOLO-Aufgaben; miss die Leistung auf deinem Edge-Gerät. Kompromisse: Der absolute Maßstab hängt von der Kalibrierung deiner Kamera ab. Außerdem wird die Genauigkeit hier nicht nach einem gemeinsamen Verfahren mit den Foundation-Modellen verglichen. Teste das Modell daher mit deinen eigenen Daten.
UniDepth V2#
UniDepth sagt die metrische Tiefe und die Kameraintrinsik anhand eines einzelnen RGB-Bildes voraus und kann bekannte Intrinsik verwenden. Lizenz: CC BY-NC 4.0. Optimal für: Forschung und Prototypen, die metrische Tiefe von unbekannten Kameras benötigen. Kompromiss: Die Lizenz schließt die kommerzielle Nutzung aus.
ZoeDepth#
ZoeDepth kombiniert das Vortraining für relative Tiefe mit metrischen Köpfen für Innenräume (NYU) und Außenszenen (KITTI). Lizenz: MIT. Optimal für: ein Modell mit permissiver Lizenz für metrische Tiefe, wenn deine Szenen den Indoor- oder Outdoor-Trainingsbereichen ähneln. Kompromiss: Das Modell wurde für bestimmte Indoor- und Outdoor-Bereiche trainiert, während neuere metrische Modelle wie UniDepth und Metric3D v2 für unterschiedliche Kameras entwickelt wurden. Intel hat das Repository archiviert, sodass es keine Fehlerbehebungen mehr erhält.
Tiefenschätzung auf Edge-Geräten#
Bei Edge-Hardware lautet die Frage nicht mehr „am genauesten“, sondern „genau genug bei meiner Bildrate“. Drei Modellgruppen kommen infrage:
- Kleine Varianten großer Modellfamilien. Depth Anything V2 Small (24.8M Parameter, Apache 2.0) ist eine Option mit permissiver Lizenz. Die MiDaS-v3.1-Modelle Swin2-Tiny und LeViT sind für eingebettete Geräte konzipiert.
- Echtzeitmodelle für spezifische Aufgaben. Ultralytics YOLO26 depth erreicht bei Batchgröße 1 auf einer Tesla T4 mit TensorRT FP16 eine reine Inferenzzeit von 2.7 ms (n) bis 13.6 ms (x), ohne Vor- und Nachverarbeitung. Es lässt sich für NVIDIA Jetson in TensorRT, für Apple-Geräte in CoreML und für Intel-CPUs in OpenVINO exportieren. Die Exportunterstützung ist kein Benchmark für Edge-Geräte.
- Leichte Forschungsmodelle. FastDepth (MIT) wurde für eingebettete Systeme entwickelt und auf einer NVIDIA Jetson TX2 vorgeführt. Lite-Mono (MIT) hat 2.2M bis 8.7M Parameter und wurde mit Fahrdaten aus KITTI trainiert.
Miss die Inferenzlatenz nach dem Export auf deinem Zielgerät und bei der Auflösung, die du einsetzen wirst. Informationen zur Auswahl der Hardware findest du unter das passende Edge-Gerät auswählen. Exportoptionen werden in unserem Leitfaden zu Optionen für die Modellbereitstellung beschrieben.
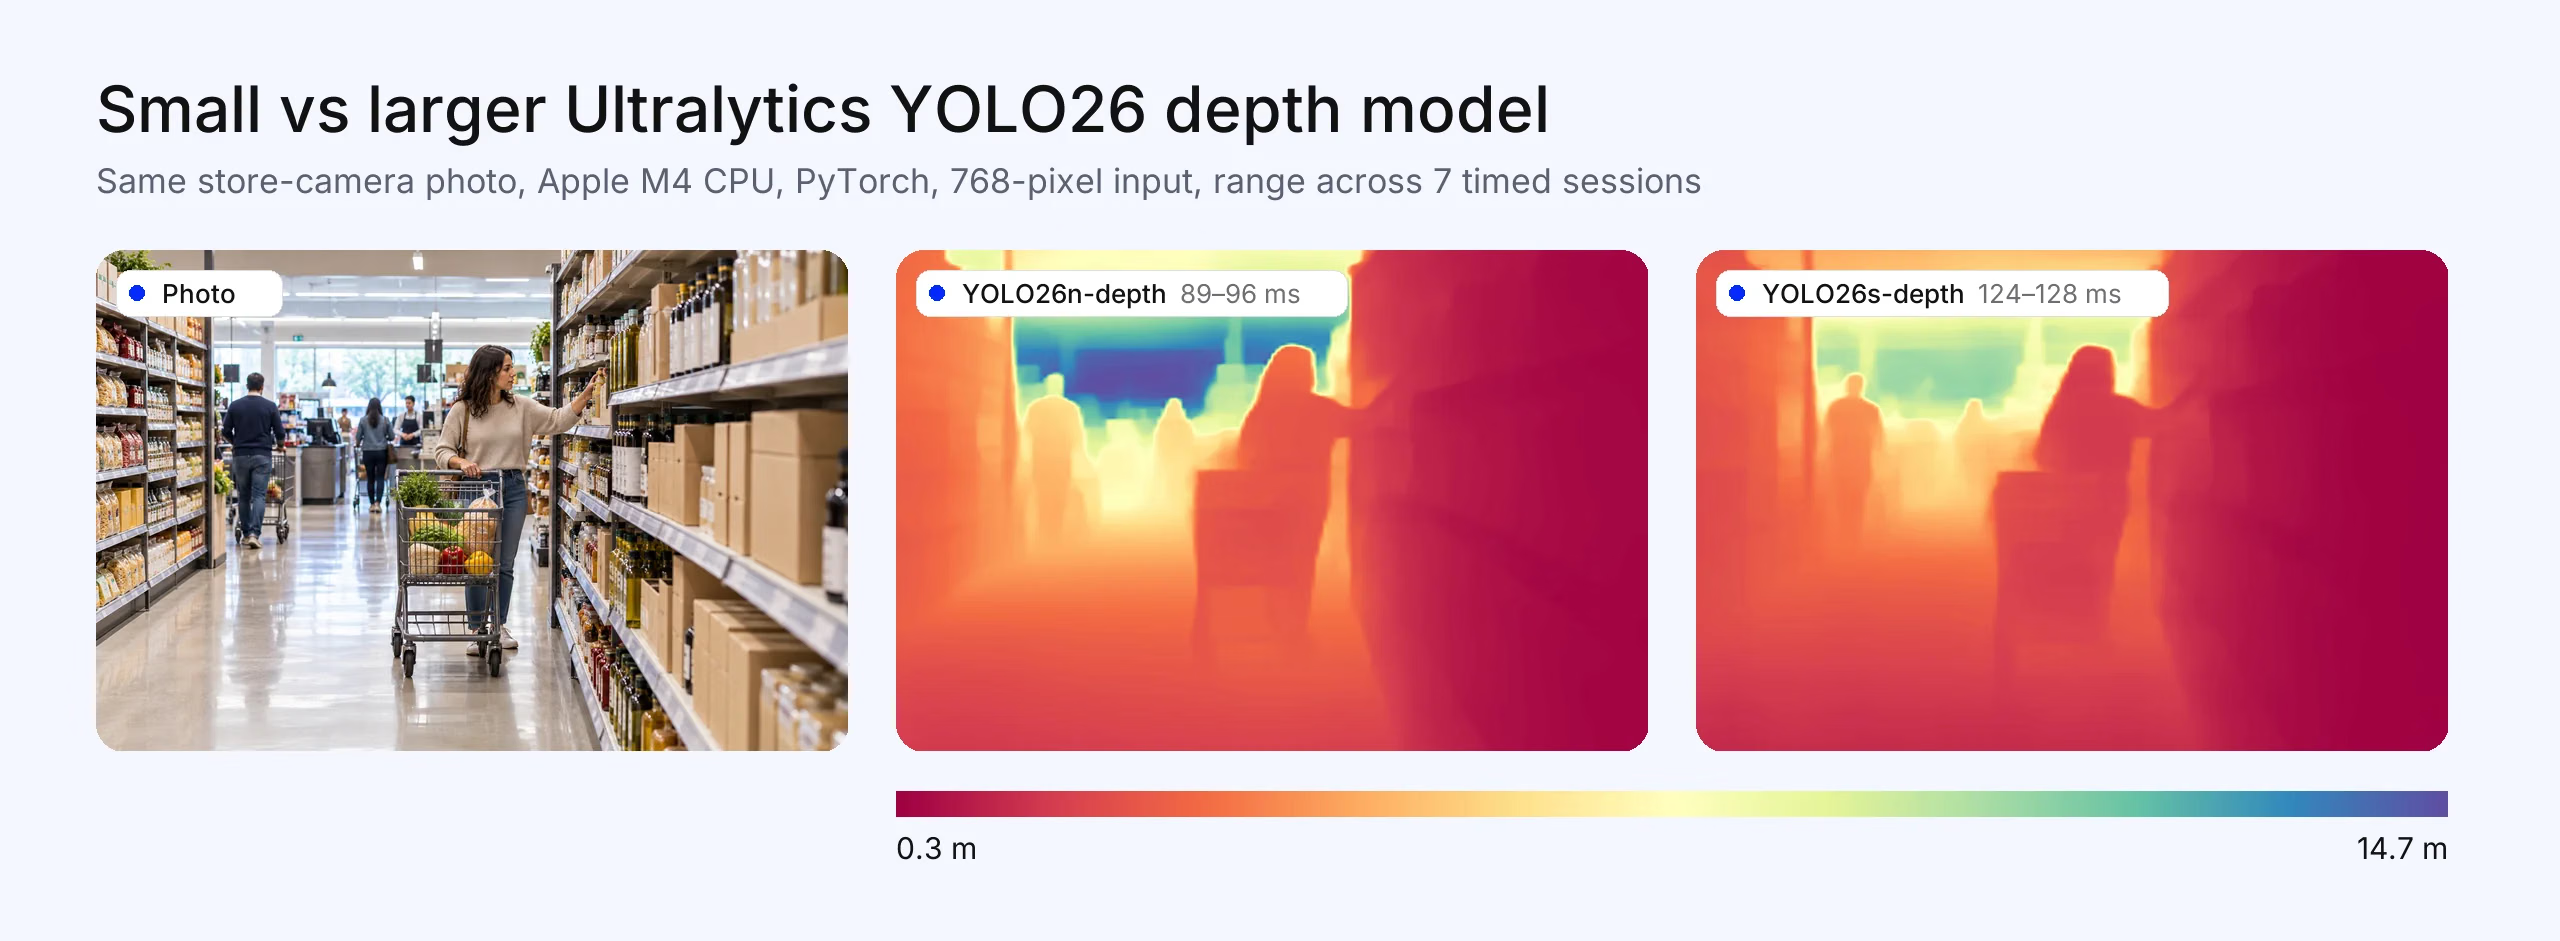
Abb. 3. Ultralytics YOLO26n-depth (89 bis 96 ms) und YOLO26s-depth (124 bis 128 ms) auf demselben Foto eines Geschäfts, gemessen auf einer Apple M4 CPU (PyTorch, Eingabegröße 768 Pixel, vom Bild bis zur fertigen Tiefenkarte). Die Laufzeiten auf Laptops schwanken je nach Hintergrundlast; betrachte sie daher als Bereiche. Das Foto wurde für diesen Artikel erstellt; die Tiefenkarten und Laufzeiten sind real.
Tiefenschätzung für die Robotik#
Roboter benötigen in der Regel metrische Tiefenwerte, die von Bild zu Bild stabil bleiben und mit der Steuerfrequenz des Roboters verfügbar sind. Drei praktikable Wege:
- Monokulare metrische Modelle eignen sich für Roboter mit einer einzelnen RGB-Kamera. Verwende ein Modell, das zu deiner Kamera passt: Metric3D v2 oder Depth Anything 3 Metric mit bekannter Intrinsik oder ein kalibriertes Ultralytics YOLO26 depth-Modell, wenn du geringe Inferenzlatenz direkt auf einer NVIDIA-GPU parallel zu anderen YOLO-Aufgaben benötigst. Miss die Leistung auf dem Computer deines Roboters.
- Stereomodelle wie NVIDIAs FoundationStereo berechnen metrische Tiefenwerte anhand eines kalibrierten Kamerapaars. Die Forschungsimplementierung ist nicht kommerziell nutzbar; NVIDIA bietet eine TAO-Version für die kommerzielle Nutzung an. Unter Stereosicht erfährst du, wie Stereosicht im Vergleich zur monokularen Tiefenschätzung abschneidet.
- Tiefensensoren (Stereo-Tiefenkameras, strukturiertes Licht oder LiDAR) messen die Tiefe direkt.
Wann ein monokulares Modell nicht die richtige Wahl ist: Nutze bei sicherheitskritischen Entscheidungen, etwa zur Kollisionsvermeidung in der Nähe von Personen, einen Tiefensensor oder ein Stereokamerapaar. Verwende die monokulare Tiefenschätzung als Ergänzung, zum Beispiel um Lücken zu füllen, für die der Sensor keine Daten liefert.
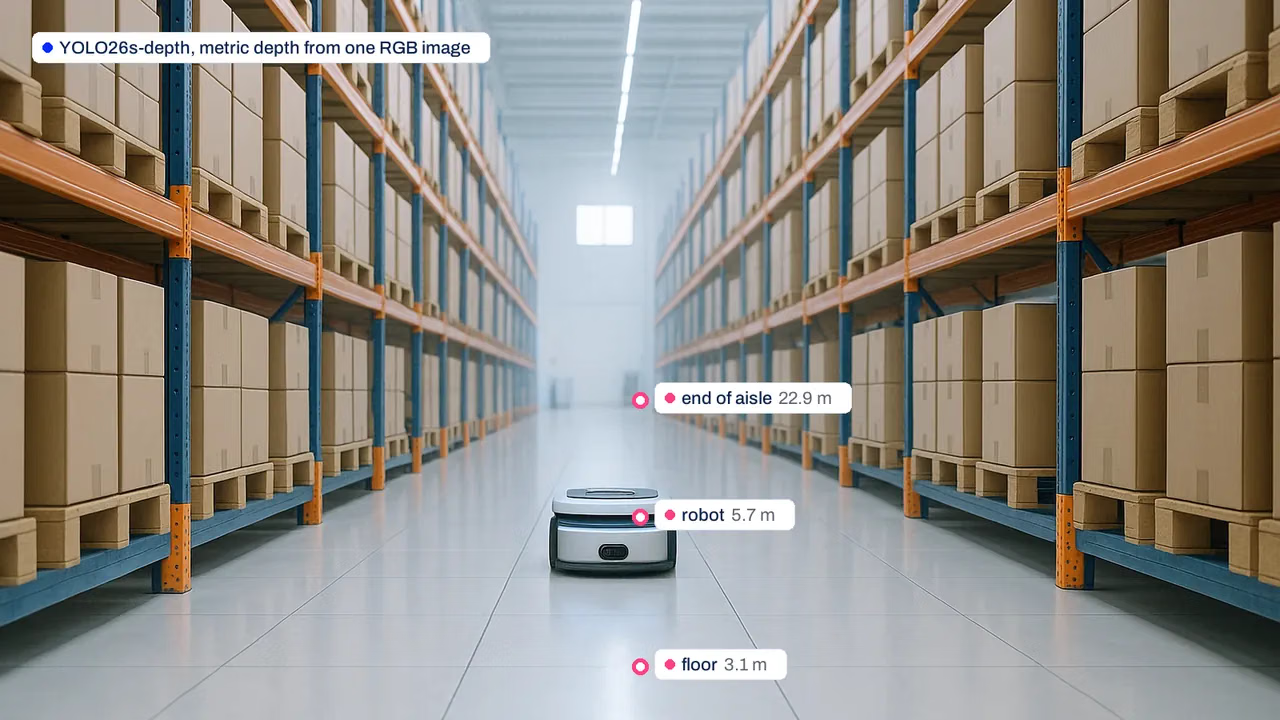
Abb. 4. Vorhergesagte Abstände aus einer einzelnen Tiefenkarte von Ultralytics YOLO26s-depth: 3.1 m bis zu einem Punkt auf dem Boden, 5.7 m bis zum Roboter und etwa 23 m bis zum Ende des Gangs. Das Foto wurde für diesen Artikel erstellt; die Abstände sind echte Modellausgaben, aber nicht für diese Kamera kalibriert. Es handelt sich um Vorhersagen, nicht um Messungen.
So testest du Tiefenmodelle mit deiner eigenen Kamera#
- Sammle etwa 50 bis 150 beschriftete Bilder mit der Kamera, die du einsetzen wirst. Verwende dabei die vorgesehene Auflösung und Objektiveinstellungen und erfasse einige Messpunkte pro Bild. Öffentliche Benchmarks wie NYU Depth V2 (Innenräume) und KITTI (Fahrten) eignen sich für einen ersten Vergleich, entscheidend sind jedoch die Ergebnisse mit deiner eigenen Kamera.
- Ein Entfernungsmesser misst die geradlinige Entfernung, während für die Kalibrierung die Tiefe entlang der Kameraachse benötigt wird: Miss Punkte nahe der Bildmitte, rechne Messungen außerhalb der Bildmitte mithilfe der Kameraintrinsik in Tiefenwerte entlang der Kameraachse um oder erfasse die Tiefe mit einem Tiefensensor.
- Vergleiche die Kandidaten anhand von δ1 und dem absoluten relativen Fehler im Verhältnis zu diesen Messungen und miss die Laufzeit jedes Modells auf dem Zielgerät. Bewerte bei metrischen Modellen die unveränderte Ausgabe, ohne jedes Bild so zu skalieren, dass es den Ground-Truth-Werten entspricht. Eine bildweise Anpassung würde genau die Maßstabsfehler verbergen, die du erkennen musst.
- Kalibriere ein metrisches Modell mit festem Maßstab anhand eines Teils der Daten und teste es mit den übrigen Daten. Bei Ultralytics YOLO26 depth ist diese Funktion als
model.calibrate()enthalten.
Häufig gestellte Fragen
Es gibt kein Modell, das in allen Fällen das beste ist. Depth Anything V2 und Depth Anything 3 sind leistungsstarke Optionen, die du zuerst für die Schätzung relativer Tiefe prüfen solltest. Depth Pro, UniDepth und Metric3D v2 liefern metrische Tiefe aus einem einzelnen Bild. Für geringe Latenz bei der Tiefenschätzung auf NVIDIA-GPUs parallel zu anderen YOLO-Aufgaben solltest du Ultralytics YOLO26 depth testen und die Leistung auf deinem Edge-Gerät messen. Depth Anything V2 Small sowie die MiDaS-v3.1-Modelle Swin2-Tiny und LeViT sind ebenfalls leichtere Optionen zum Testen.
Erstelle eine Auswahlliste mit kleinen Modellen, die sich in deine Laufzeitumgebung exportieren lassen: Ultralytics YOLO26 depth (6.3M bis 57.0M Parameter, Export nach TensorRT, CoreML und OpenVINO), Depth Anything V2 Small (24.8M Parameter) und die MiDaS-v3.1-Modelle Swin2-Tiny oder LeViT. Miss anschließend die Latenz auf deinem eigenen Gerät; Exportunterstützung belegt nicht die Leistung auf Edge-Geräten.
Roboter benötigen in der Regel metrische Tiefenwerte. Metric3D v2 und Depth Anything 3 Metric sagen anhand bekannter Kameraintrinsik die Entfernung in Metern aus einem Bild voraus; UniDepth kann die Intrinsik selbst schätzen. Laut Dokumentation hat Ultralytics YOLO26 depth auf einer T4 mit TensorRT FP16 bei einer Eingabegröße von etwa 768 Pixeln eine reine Inferenzlatenz von 2.7 bis 13.6 ms bei Batchgröße 1, ohne Vor- und Nachverarbeitung. Miss die Leistung auf dem Computer deines eigenen Roboters. Verwende für sicherheitskritische Navigation eine Stereokamera oder einen Tiefensensor und nutze die monokulare Tiefenschätzung als Ergänzung; FoundationStereo ist ein Stereomodell, das du testen kannst.
Die Hauptmodelle von Depth Anything V2 sagen relative Tiefe voraus. Das Projekt veröffentlicht außerdem metrische Checkpoints, die für Innenräume bis zu 20 Meter und Außenszenen bis zu 80 Meter feinabgestimmt wurden.
Prüfe jeden einzelnen Checkpoint. MiDaS und ZoeDepth stehen unter MIT (beide Repositories sind inzwischen archiviert), der Code von Metric3D unter BSD-2-Clause (prüfe die Bedingungen für den Checkpoint), Depth Anything V2 Small und mehrere Modelle von Depth Anything 3 unter Apache 2.0 und die Modelle von Marigold unter RAIL++-M. Depth Anything V2 Base und Large, die größeren Modelle von Depth Anything 3 sowie UniDepth sind nicht kommerziell nutzbar. Ultralytics YOLO26 depth steht unter AGPL-3.0; für die kommerzielle Nutzung mit geschlossenem Quellcode gibt es eine Enterprise-Lizenz. Für Depth Pro gilt Apples eigene Lizenz. Sie erlaubt Nutzung und Weiterverbreitung, gewährt aber keine Patentrechte; prüfe die Lizenz, bevor du das Modell einsetzt.









