Gestión inteligente de conjuntos de datos de visión artificial con Ultralytics Platform
Descubre cómo usar Ultralytics Platform para gestionar mejor los conjuntos de datos de tus proyectos de visión artificial. Haz un seguimiento, compara y mejora tus conjuntos de datos fácilmente.
 Abirami Vina18 min de lectura
La IA de visión, o visión artificial, ha avanzado mucho desde sus inicios y ha pasado de ser una investigación experimental a convertirse en una tecnología clave para aplicaciones del mundo real. Hoy en día, los entusiastas de la IA pueden crear modelos potentes para tareas como la detección de objetos y la segmentación de instancias con herramientas y marcos de trabajo accesibles.
Sin embargo, a medida que estas aplicaciones pasan de la experimentación a la producción, la gestión de conjuntos de datos sigue siendo un reto fundamental que a menudo se pasa por alto. Cuando los conjuntos de datos de visión artificial crecen en tamaño y complejidad, los equipos suelen tener dificultades para mantener anotaciones coherentes, seguir los cambios entre versiones y garantizar la calidad general de los datos.
Incluso los modelos avanzados pueden rendir por debajo de lo esperado en entornos reales si los datos con los que se entrenan están incompletos, desequilibrados o mal gestionados. Esta brecha cada vez mayor entre el rendimiento durante el desarrollo y la fiabilidad en el mundo real hace necesario adoptar un enfoque más estructurado para gestionar los conjuntos de datos.
Otra limitación habitual es que la recopilación de datos, la anotación y el entrenamiento suelen realizarse con herramientas distintas. Un flujo de trabajo fragmentado dificulta la gestión eficiente de los conjuntos de datos, aumenta el riesgo de incoherencias y ralentiza las iteraciones.
Para resolver los cuellos de botella de la IA de visión, como la gestión de conjuntos de datos y los flujos de trabajo fragmentados, hace poco lanzamos Ultralytics Platform. Es un entorno de trabajo integral que reúne la gestión de conjuntos de datos, la anotación, el entrenamiento, la implementación y la supervisión en un único flujo de trabajo unificado.
Al conectar todas las etapas del ciclo de vida de la visión artificial, resulta más fácil hacer un seguimiento de los cambios en los conjuntos de datos, comparar el rendimiento entre versiones y perfeccionar continuamente los datos para obtener mejores resultados.
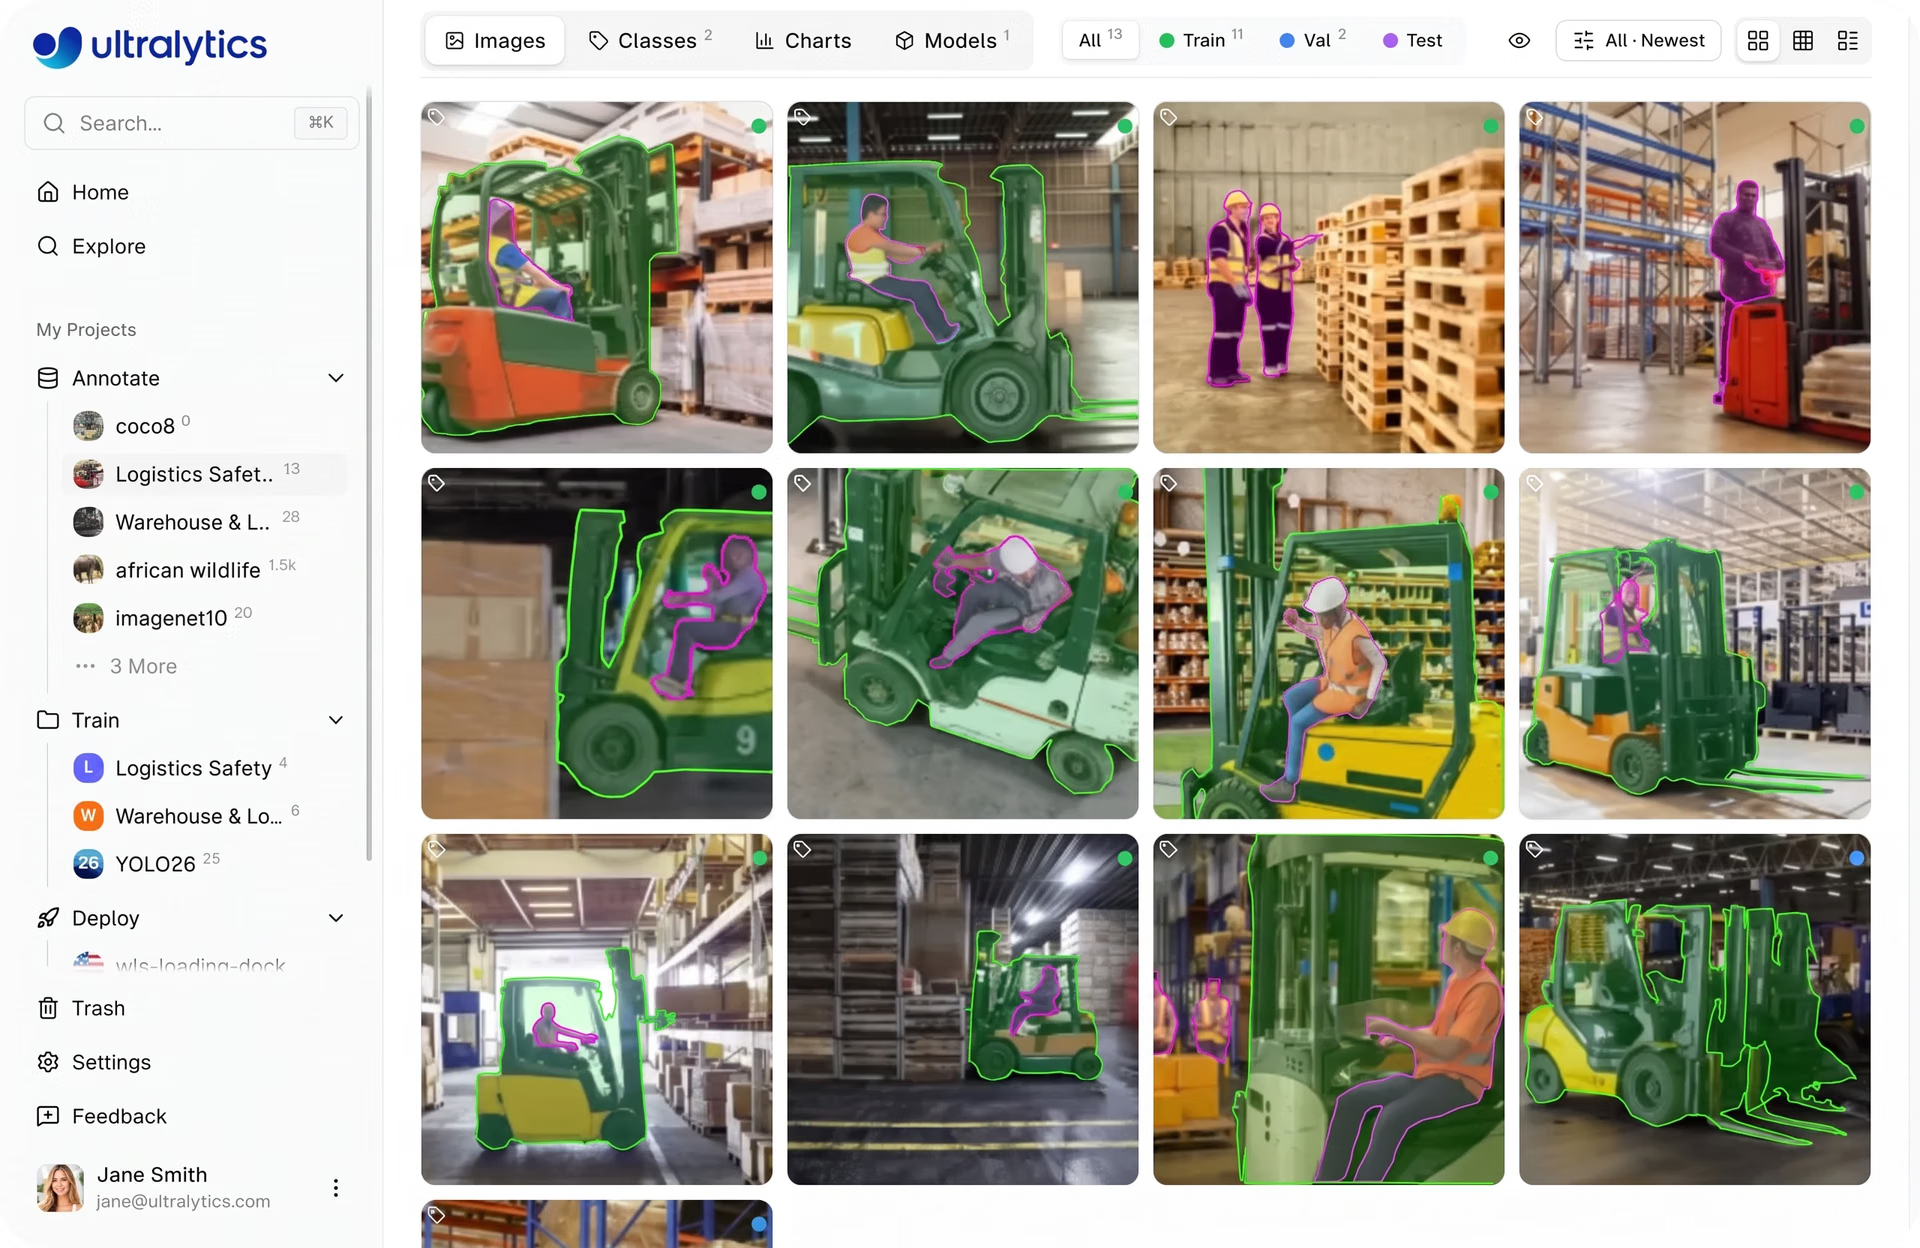
Fig. 1. Ejemplo de visualización de las imágenes de tu conjunto de datos en Ultralytics Platform (Fuente)
En este artículo veremos en detalle cómo Ultralytics Platform te ayuda a hacer un seguimiento de tus conjuntos de datos, compararlos y mejorarlos para crear modelos de visión artificial más fiables.
La importancia de gestionar conjuntos de datos en visión artificial#
El rendimiento de un modelo de visión artificial está estrechamente relacionado con los datos con los que se entrena. La precisión del modelo, es decir, la frecuencia con la que sus predicciones son correctas, depende no solo del algoritmo, sino también de lo bien que el conjunto de datos represente las condiciones del mundo real.
En pocas palabras, un modelo aprende patrones directamente de los datos, por lo que cualquier laguna, sesgo o incoherencia en el conjunto de datos puede influir en sus predicciones. En otras palabras, los datos de baja calidad, las anotaciones incorrectas o una cobertura limitada de las variaciones del mundo real en las imágenes, como los distintos niveles de iluminación, ángulos de los objetos, fondos o grados de oclusión, pueden reducir significativamente la precisión, aunque la arquitectura del modelo sea sólida.
Esto también se aplica al ajuste fino de un modelo, en el que se sigue entrenando un modelo preentrenado con datos nuevos o actualizados para adaptarlo mejor a un caso de uso o entorno específico. Como la precisión del modelo depende tanto de los datos, es esencial gestionarlos correctamente.
La gestión de conjuntos de datos incluye organizar, etiquetar y actualizar continuamente los datos para que sigan siendo precisos y pertinentes. Esto facilita mejorar el rendimiento con el tiempo, especialmente al volver a entrenar o ajustar modelos con datos nuevos.
Cómo afecta la calidad de los conjuntos de datos a la fiabilidad en el mundo real#
Los casos de uso de visión artificial, como los sistemas de videovigilancia, son un buen ejemplo de por qué es vital gestionar correctamente los datos. Estos sistemas deben funcionar de forma fiable en distintas condiciones reales, como diferentes entornos de iluminación, ángulos de cámara, niveles de aglomeración y oclusiones parciales.
Si los datos de entrenamiento no cubren estas variaciones o no ofrecen suficiente diversidad en la apariencia de los objetos en distintas escenas y condiciones, el modelo puede tener dificultades para detectarlos con precisión. Por ejemplo, un modelo entrenado principalmente con escenas bien iluminadas y despejadas puede rendir mal en entornos con poca luz o muy concurridos. En los sistemas de seguridad, esto puede dar lugar a incidentes no detectados o falsas alertas.
Para evitarlo, es importante mantener conjuntos de datos que no solo estén limpios y correctamente etiquetados, sino que también estén bien equilibrados y se actualicen continuamente. Esto implica identificar lagunas en los datos, añadir nuevos ejemplos a medida que cambian las condiciones y asegurarse de que las distintas clases y entornos estén representados de forma equilibrada.
Con un conjunto de datos más completo y estructurado, los modelos están mejor preparados para afrontar la variabilidad del mundo real y generar predicciones más fiables.
Aspectos clave de la gestión de conjuntos de datos#
Entonces, ¿en qué consiste realmente la gestión de conjuntos de datos? Consiste en organizar, etiquetar y mantener los datos para poder utilizarlos eficazmente durante todo el proceso de desarrollo del modelo.
La organización de los datos incluye, por ejemplo, estructurar el conjunto de datos y dividirlo en conjuntos de entrenamiento, validación y prueba. El conjunto de entrenamiento se utiliza para enseñar al modelo; el conjunto de validación, para supervisar el rendimiento y orientar los ajustes durante el desarrollo; y el conjunto de prueba, para evaluar el rendimiento del modelo final con datos completamente nuevos.
Por su parte, etiquetar consiste en anotar imágenes con información como etiquetas de clase, cuadros delimitadores o máscaras de segmentación. Como el modelo aprende a partir de estas anotaciones, la precisión y la coherencia son fundamentales para que aprenda patrones relevantes y genere predicciones fiables.
Además, mantener el conjunto de datos implica revisar y actualizar los datos con el tiempo. Esto puede incluir corregir errores de anotación, eliminar datos de baja calidad o duplicados y añadir nuevos ejemplos para cubrir casos que faltan o condiciones cambiantes.
En términos más generales, la gestión de conjuntos de datos es un proceso continuo. A medida que se evalúan los modelos y se recopilan datos nuevos, es necesario actualizar los conjuntos de datos para que reflejen las condiciones del mundo real y los casos límite. El seguimiento de estas actualizaciones y la comparación de distintas versiones ayudan a los equipos a entender qué mejora el rendimiento y dónde hacen falta más cambios.
Gestión de conjuntos de datos con Ultralytics Platform#
Ultralytics Platform ofrece un flujo de trabajo estructurado para gestionar conjuntos de datos en un único entorno, desde la preparación de datos hasta la exportación. Está diseñada para ayudar tanto a desarrolladores individuales como a equipos, y facilita la gestión coherente de conjuntos de datos, tanto si trabajas por tu cuenta como si colaboras en distintos proyectos.
Cada etapa está diseñada para simplificar la organización, el procesamiento y el uso de los conjuntos de datos durante todo el ciclo de vida del desarrollo de modelos. Al reunir estos pasos en un solo lugar, la plataforma reduce la fragmentación y facilita mantener la coherencia entre los flujos de trabajo.
A continuación, repasaremos los pasos clave y veremos cómo la plataforma facilita cada uno de ellos.
Carga de conjuntos de datos en Ultralytics Platform#
Empezar a trabajar con conjuntos de datos en la plataforma es muy flexible, ya que hay varias formas de importar o reutilizar datos. Puedes subir tus propios datos o empezar más rápido con los conjuntos de datos públicos disponibles en la plataforma. También puedes clonar conjuntos de datos existentes que haya compartido la comunidad y ampliarlos.
Las funciones comunitarias de la plataforma facilitan la exploración y reutilización del trabajo existente. Al acceder a conjuntos de datos creados por otros usuarios, que incluyen millones de imágenes y anotaciones, puedes empezar rápidamente sin tener que recopilar y etiquetar todo por tu cuenta. Al clonar un conjunto de datos, se crea una copia en tu espacio de trabajo que puedes modificar y ampliar sin alterar el original.
Para las cargas, la plataforma admite imágenes individuales, vídeos y archivos de conjuntos de datos como ZIP, TAR o GZ. También admite formatos de conjuntos de datos de uso habitual, como YOLO y COCO, lo que facilita importar conjuntos de datos y anotaciones existentes sin conversiones adicionales. Además, puedes cargar un conjunto de datos con un archivo NDJSON exportado desde la plataforma, lo que facilita recrearlo o reutilizarlo en distintos proyectos.
Una vez cargados los datos, la plataforma los procesa mediante una canalización estructurada. Esto incluye validar los formatos y tamaños de archivo, cambiar el tamaño de las imágenes cuando es necesario, analizar las anotaciones y generar estadísticas del conjunto de datos.
Por ejemplo, los vídeos se convierten en fotogramas para poder utilizarlos en el entrenamiento, mientras que las imágenes se optimizan y preparan para facilitar su exploración y análisis. Una vez procesados, los conjuntos de datos están listos para usarse en tareas de anotación, análisis y entrenamiento de modelos dentro de la plataforma.
Anotación de datos en Ultralytics Platform#
Una vez cargados, los conjuntos de datos se pueden revisar y anotar directamente en la plataforma. La plataforma incluye herramientas integradas de anotación de imágenes para diversas tareas de visión artificial, como la detección de objetos, la segmentación de instancias, la segmentación semántica, la clasificación de imágenes, la estimación de poses y la detección de cuadros delimitadores orientados (OBB).
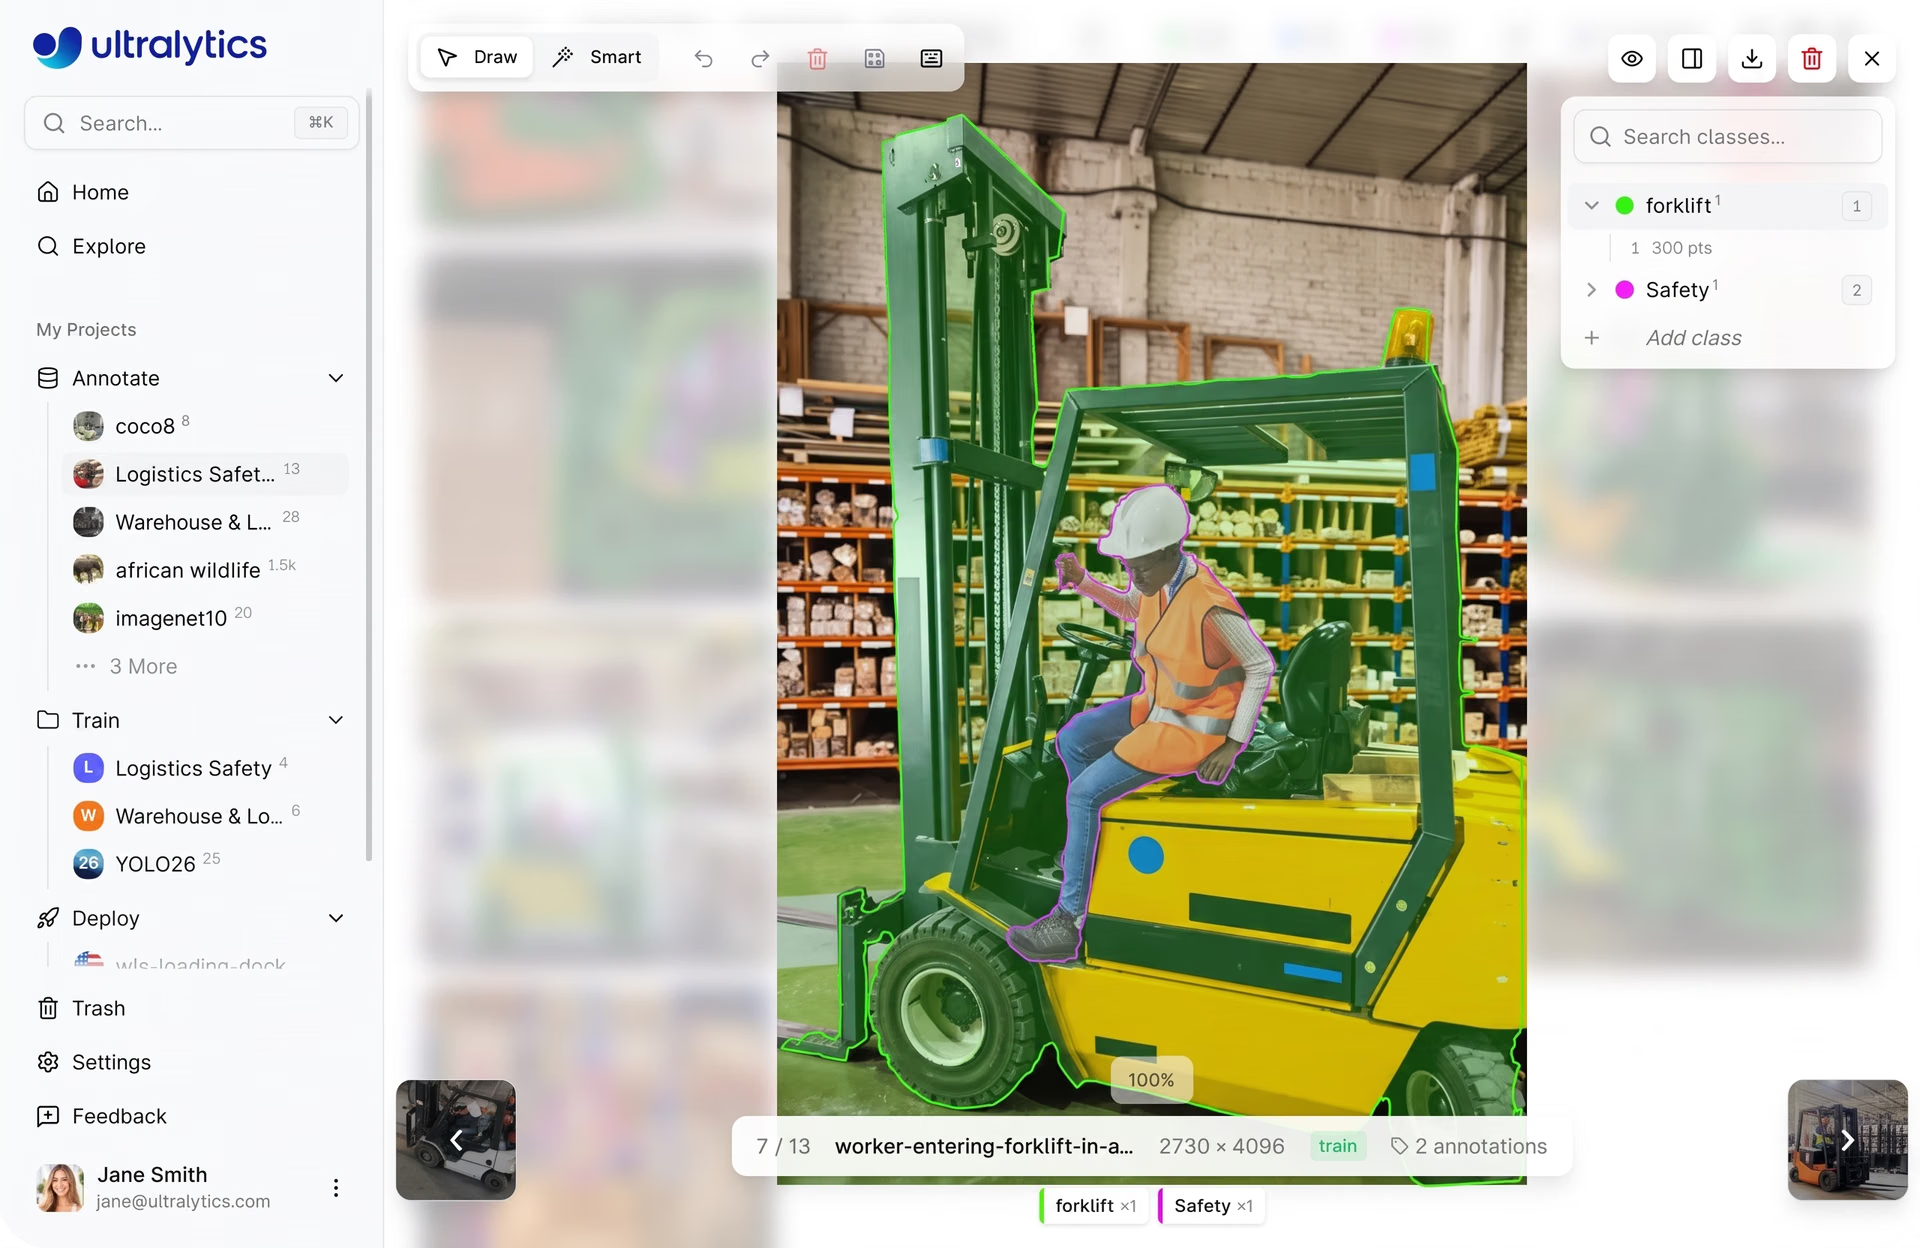
Fig. 2. Uso de Ultralytics Platform para etiquetar datos (Fuente)
Puedes crear anotaciones manualmente con estas herramientas o acelerar el proceso mediante funciones asistidas por IA, como la anotación inteligente basada en SAM. Con SAM, puedes generar máscaras, cuadros delimitadores o cuadros orientados interactuando con la imagen, lo que agiliza el etiquetado sin sacrificar la precisión.
Análisis de la calidad de los conjuntos de datos con Ultralytics Platform#
Además de preparar y anotar los datos, comprender la calidad de los conjuntos de datos es fundamental para crear modelos de visión artificial fiables. Sin una visión clara de factores como la distribución de clases, la calidad de las anotaciones, las divisiones del conjunto de datos y la representación de los datos en distintas condiciones, puede resultar difícil detectar problemas que afecten al rendimiento del modelo.
Ultralytics Platform incluye funciones integradas que ayudan a analizar los conjuntos de datos de forma más eficaz. Puedes consultar esta información directamente en la interfaz del conjunto de datos, en pestañas como Imágenes, Clases y Gráficos.
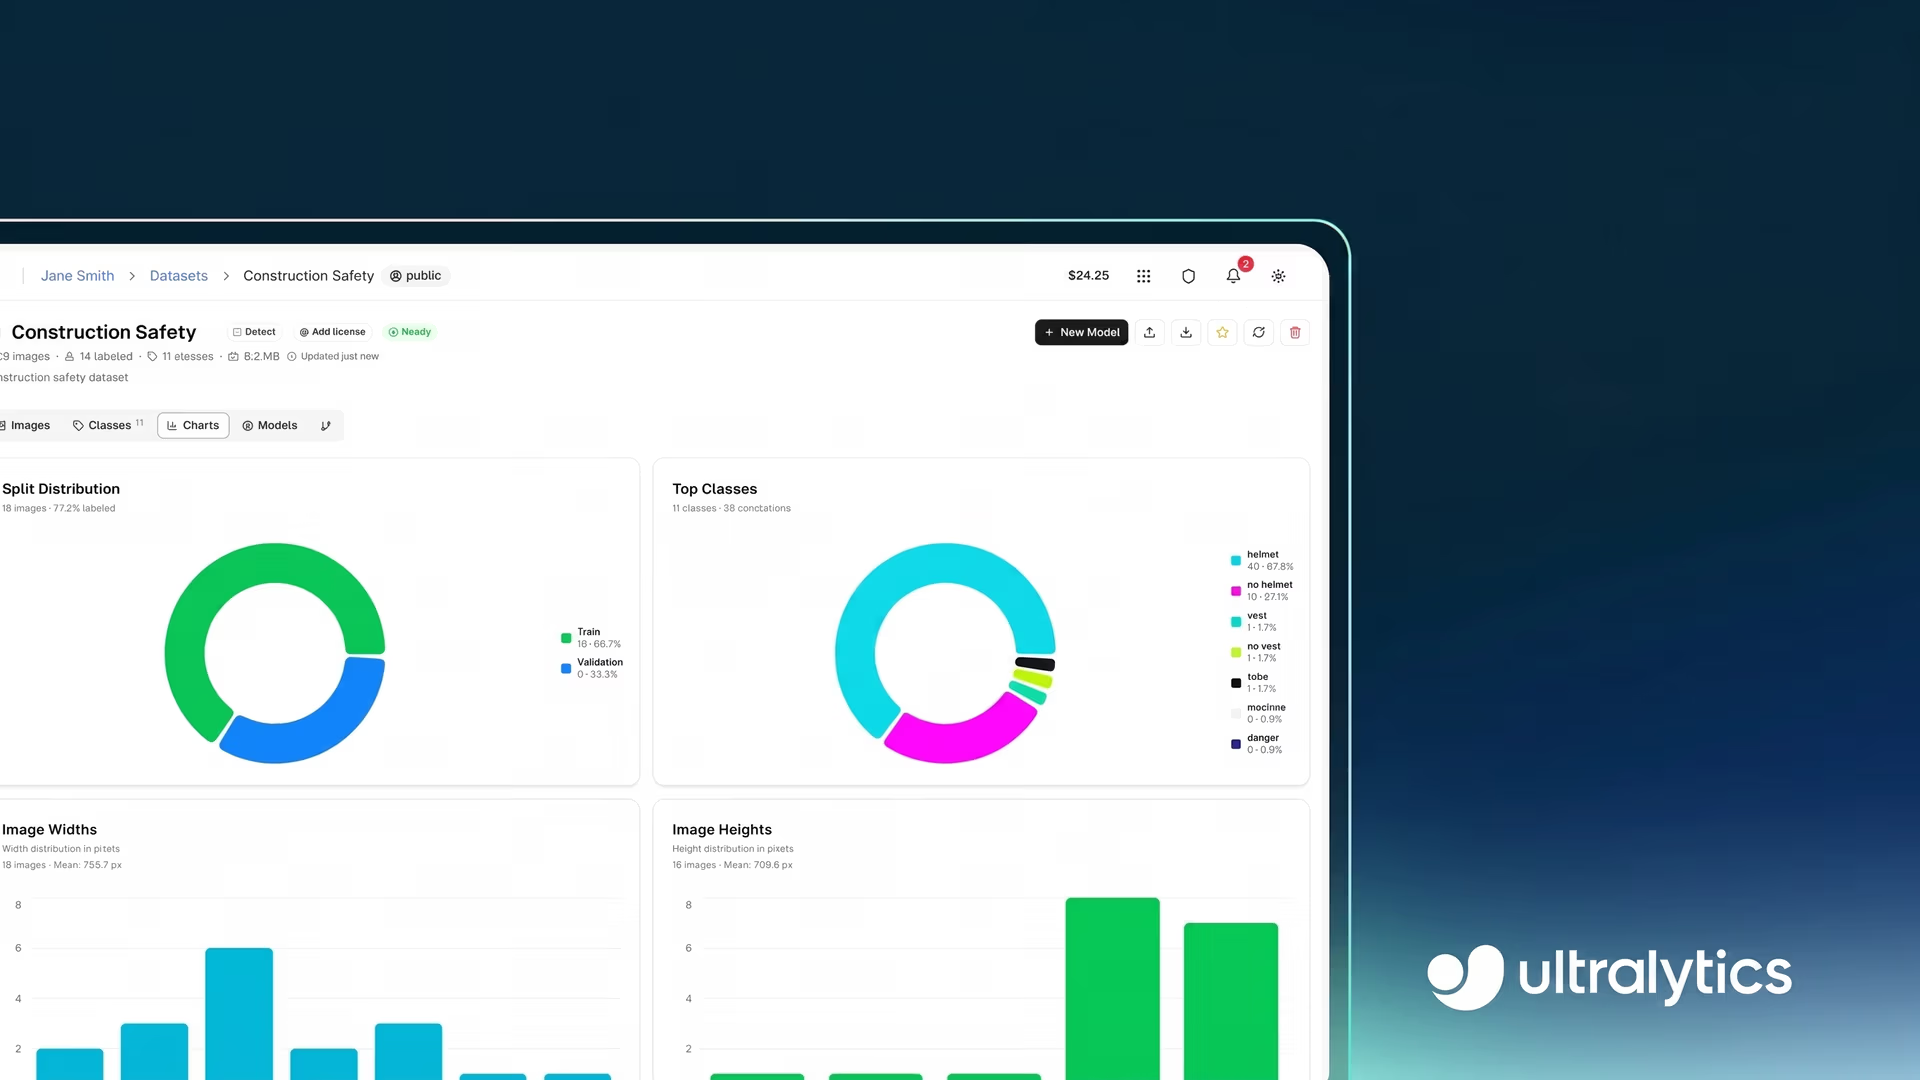
En la pestaña Gráficos, puedes consultar estadísticas del conjunto de datos, como la distribución de las particiones (entrenamiento, validación y prueba), la frecuencia de las clases y mapas de calor de anotaciones que muestran dónde aparecen los objetos en las imágenes.
La pestaña Clases desglosa el número de anotaciones por clase, lo que facilita detectar desequilibrios entre clases. Por su parte, la pestaña Imágenes muestra detalles de cada imagen, como sus dimensiones, el número de anotaciones y la distribución de las etiquetas entre las distintas imágenes.
Esta información facilita la identificación de problemas, como desequilibrios entre clases, escenarios ausentes o distribuciones desiguales de los datos. Por ejemplo, puede que observes que algunas clases tienen muy pocos ejemplos o que la mayoría de las anotaciones se concentran en zonas concretas de una imagen.
Además del análisis de datos, la plataforma permite depurar y aumentar los conjuntos de datos, es decir, perfeccionarlos corrigiendo o eliminando datos problemáticos y creando variaciones de los datos existentes para mejorar el rendimiento del modelo. Puedes aplicar estas mejoras directamente en la plataforma actualizando anotaciones, añadiendo datos nuevos o reorganizando las particiones del conjunto de datos a partir de la información del análisis.
Exportación de conjuntos de datos desde Ultralytics Platform#
Una vez preparado y validado un conjunto de datos, puedes exportarlo para utilizarlo en distintos entornos. Así tienes la flexibilidad de usar tus datos de visión artificial donde prefieras, ya sea para entrenar modelos localmente, en la nube o con otras herramientas y flujos de trabajo.
Ultralytics Platform exporta los conjuntos de datos como archivos Ultralytics NDJSON, un formato que el paquete de Python de Ultralytics puede utilizar directamente para entrenar y que se puede volver a importar a la plataforma. Así resulta fácil integrar conjuntos de datos en distintos flujos de trabajo y herramientas de entrenamiento.
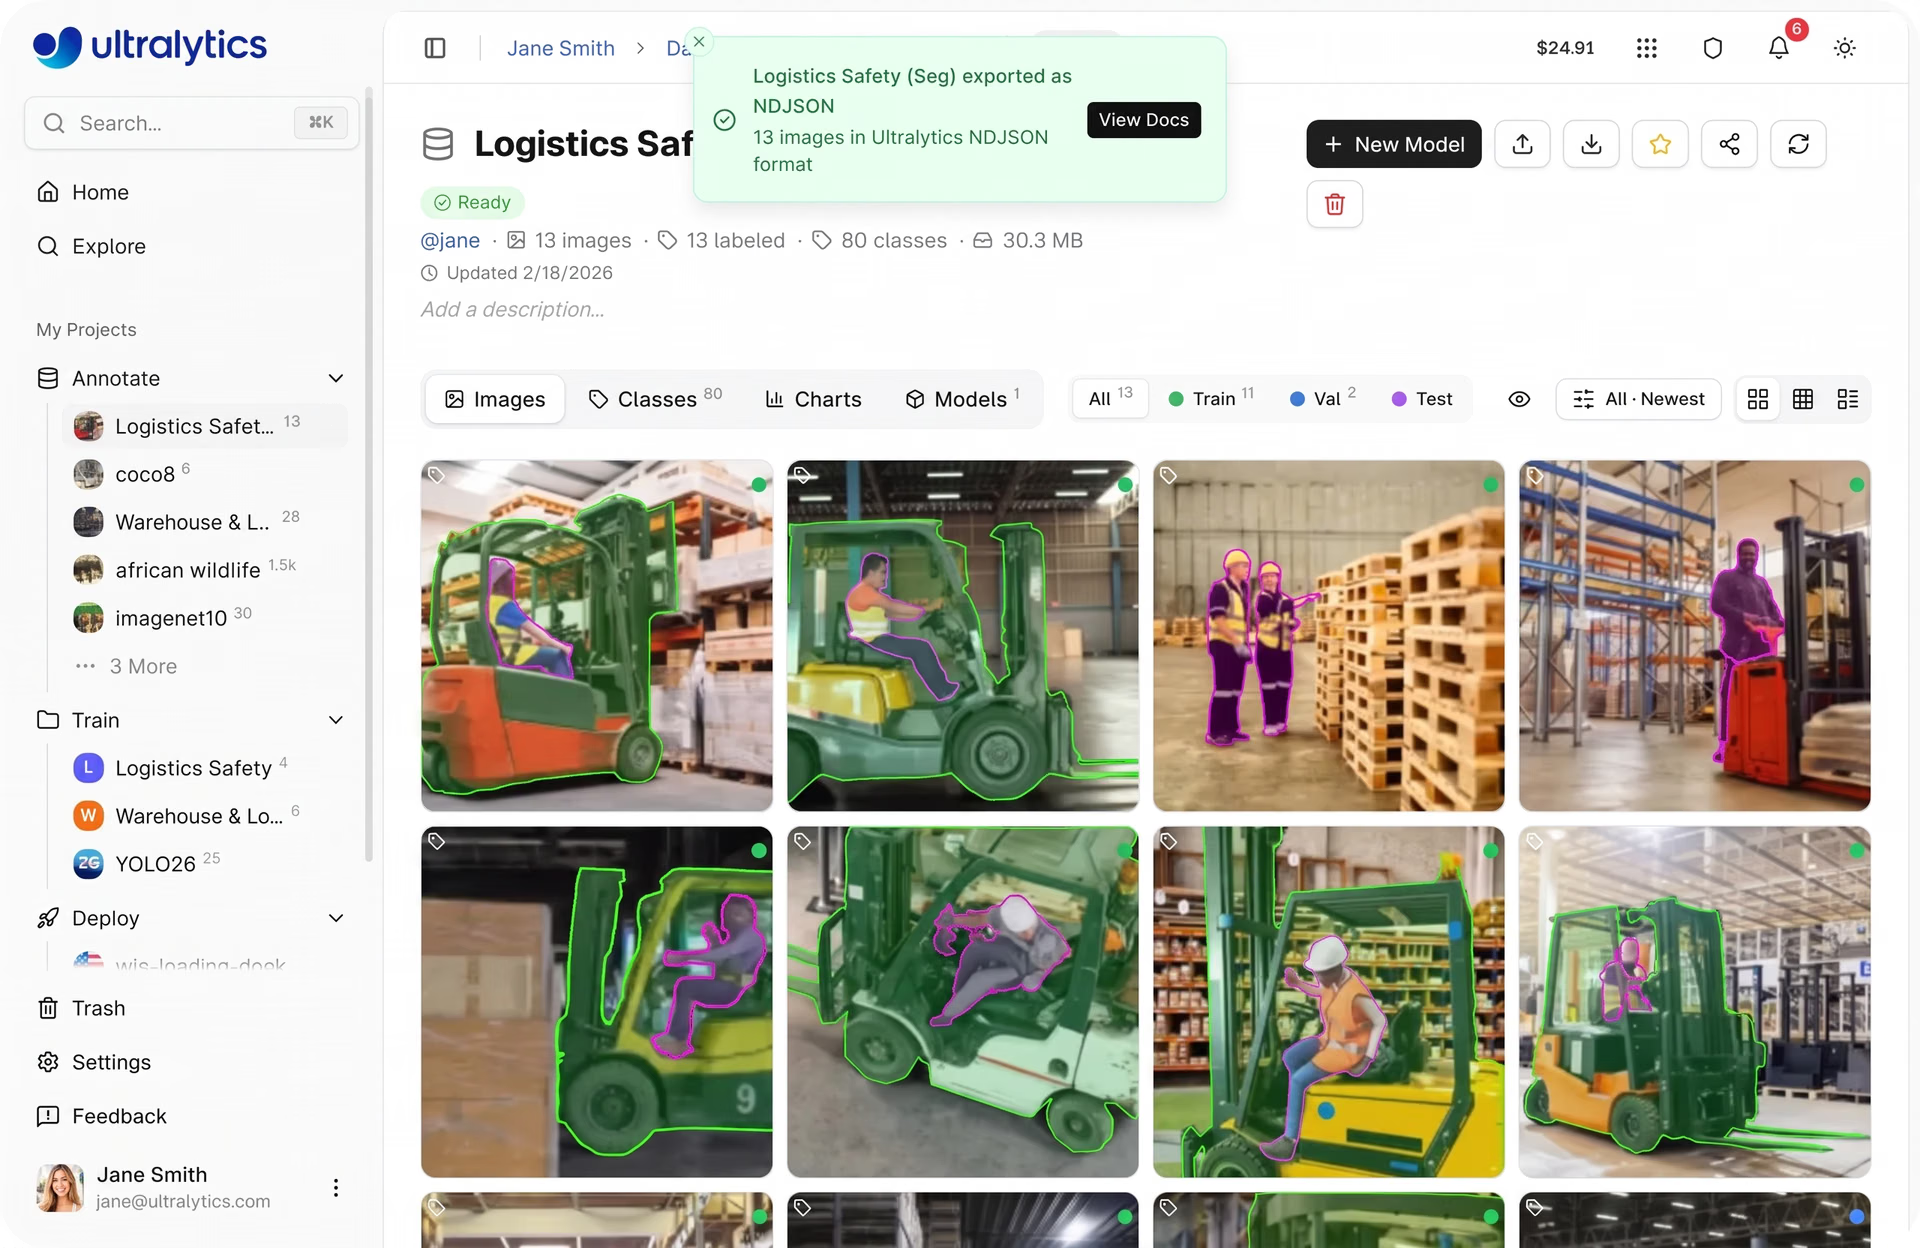
Fig. 3. Exportación de un conjunto de datos desde Ultralytics Platform (Fuente)
Al exportar un conjunto de datos, se crea una instantánea fija de los datos en un momento concreto, con sus imágenes, anotaciones y estructura. Esto resulta útil porque los conjuntos de datos suelen cambiar cuando se añaden datos nuevos, se actualizan anotaciones o se ajustan las particiones. Al exportar una instantánea, puedes conservar la versión exacta del conjunto de datos utilizada en una ejecución de entrenamiento concreta.
Así resulta más sencillo reproducir los resultados más adelante, ya que puedes volver a entrenar un modelo con la misma configuración de datos y comparar el rendimiento entre distintas versiones del conjunto de datos. Por ejemplo, puedes evaluar si añadir imágenes nuevas o corregir anotaciones mejora realmente la precisión del modelo, en lugar de tener que adivinar qué ha cambiado.
Los conjuntos de datos exportados se pueden descargar y utilizar en entornos de entrenamiento locales, en la nube o sin conexión.
Mejora de la calidad de los conjuntos de datos mediante iteraciones en Ultralytics Platform#
En los flujos de trabajo de aprendizaje automático y aprendizaje profundo, la gestión de los conjuntos de datos continúa incluso después de la implementación, porque los datos del mundo real suelen diferir de los utilizados durante el entrenamiento.
Cuando los modelos reciben entradas nuevas, se hacen más evidentes las lagunas en el conjunto de datos —como la ausencia de condiciones de poca luz, distintos ángulos de cámara, oclusiones o escenas concurridas— y los errores de anotación, por lo que es necesario perfeccionar los datos con el tiempo.
Hay varias formas de mejorar un conjunto de datos. Puedes añadir imágenes o vídeos nuevos para cubrir condiciones ausentes, como entornos con poca luz, distintos ángulos de cámara, oclusiones o escenas concurridas, y así reducir los puntos ciegos de los datos.
Al mismo tiempo, asegurarte de que las anotaciones sean precisas y coherentes, por ejemplo, etiquetando correctamente los objetos y usando cuadros delimitadores o máscaras precisos, ayuda al modelo a aprender patrones más fiables.
Esto suele seguir un ciclo sencillo: entrena el modelo, evalúa los resultados, identifica los errores, mejora el conjunto de datos y vuelve a entrenar. Cada paso ayuda a detectar problemas como anotaciones incorrectas, datos ausentes o casos infrarrepresentados.
Imagina que trabajas en un sistema de supervisión en tiempo real de estanterías de tiendas, diseñado para detectar productos. Es posible que las primeras versiones del conjunto de datos no incluyan algunos tipos de productos, condiciones de iluminación o estanterías abarrotadas. Durante la evaluación, quizá observes que el modelo tiene dificultades para detectar productos en estas situaciones.
Para mejorar el rendimiento, puedes recopilar imágenes nuevas que cubran estos escenarios ausentes y actualizar las anotaciones cuando sea necesario. Con el tiempo, repetir este proceso ayuda al modelo a ser más preciso y fiable en condiciones reales.
Ultralytics Platform facilita este flujo de trabajo al conectar las actualizaciones de los conjuntos de datos con el entrenamiento y la evaluación. Gracias al seguimiento integrado de experimentos y a las métricas de rendimiento, resulta más fácil supervisar los avances y mejorar continuamente los conjuntos de datos.
Seguimiento de los cambios en los conjuntos de datos con Ultralytics Platform#
Hemos comentado brevemente cómo evolucionan los conjuntos de datos a lo largo del tiempo como parte del proceso de desarrollo de modelos. A medida que se añaden datos nuevos, se perfeccionan las anotaciones y se actualizan las clases, es fundamental llevar un seguimiento de estos cambios para mantener la calidad de los datos y garantizar un rendimiento coherente del modelo.
Estas son algunas de las principales funciones de Ultralytics Platform para hacer un seguimiento de los conjuntos de datos y controlar sus versiones:
- Control de versiones de conjuntos de datos: Puedes crear versiones fijas de conjuntos de datos como instantáneas NDJSON. Cada versión registra datos clave, como el número de imágenes, clases y anotaciones, así como el tamaño del conjunto de datos en un momento concreto. Estas versiones se guardan y se pueden descargar más adelante, lo que facilita reproducir experimentos y comparar resultados entre distintos estados del conjunto de datos.
- Pestaña Versiones: Todas las versiones de los conjuntos de datos se organizan en la pestaña Versiones, donde puedes consultar el historial de versiones, añadir descripciones de los cambios y seguir la evolución del conjunto de datos.
- Vinculación con modelos: La pestaña Modelos muestra todos los modelos entrenados con un conjunto de datos, incluidas métricas como mAP y los detalles del entrenamiento. Las versiones de los conjuntos de datos se asocian a las ejecuciones de entrenamiento, lo que te ayuda a comprender cómo afectan los cambios en los datos al rendimiento del modelo.
- Pestaña Errores: La pestaña Errores destaca los archivos que han fallado durante el procesamiento, junto con los detalles del error y sugerencias. Así puedes identificar y solucionar problemas como archivos dañados o formatos no compatibles antes del entrenamiento.
- Interfaz del conjunto de datos (pestañas Imágenes y Clases): Estas vistas te permiten explorar imágenes, revisar anotaciones, gestionar etiquetas de clase y analizar la distribución de las clases. Funciones como los filtros, la ordenación y la identificación de imágenes sin anotar facilitan la supervisión de la calidad de los conjuntos de datos a lo largo del tiempo.
- Estadísticas y gráficos: Las visualizaciones de datos integradas, como la distribución de las particiones, la frecuencia de las clases y los mapas de calor de anotaciones, ayudan a seguir los cambios en la distribución de los datos e identificar desequilibrios a medida que evoluciona el conjunto de datos.
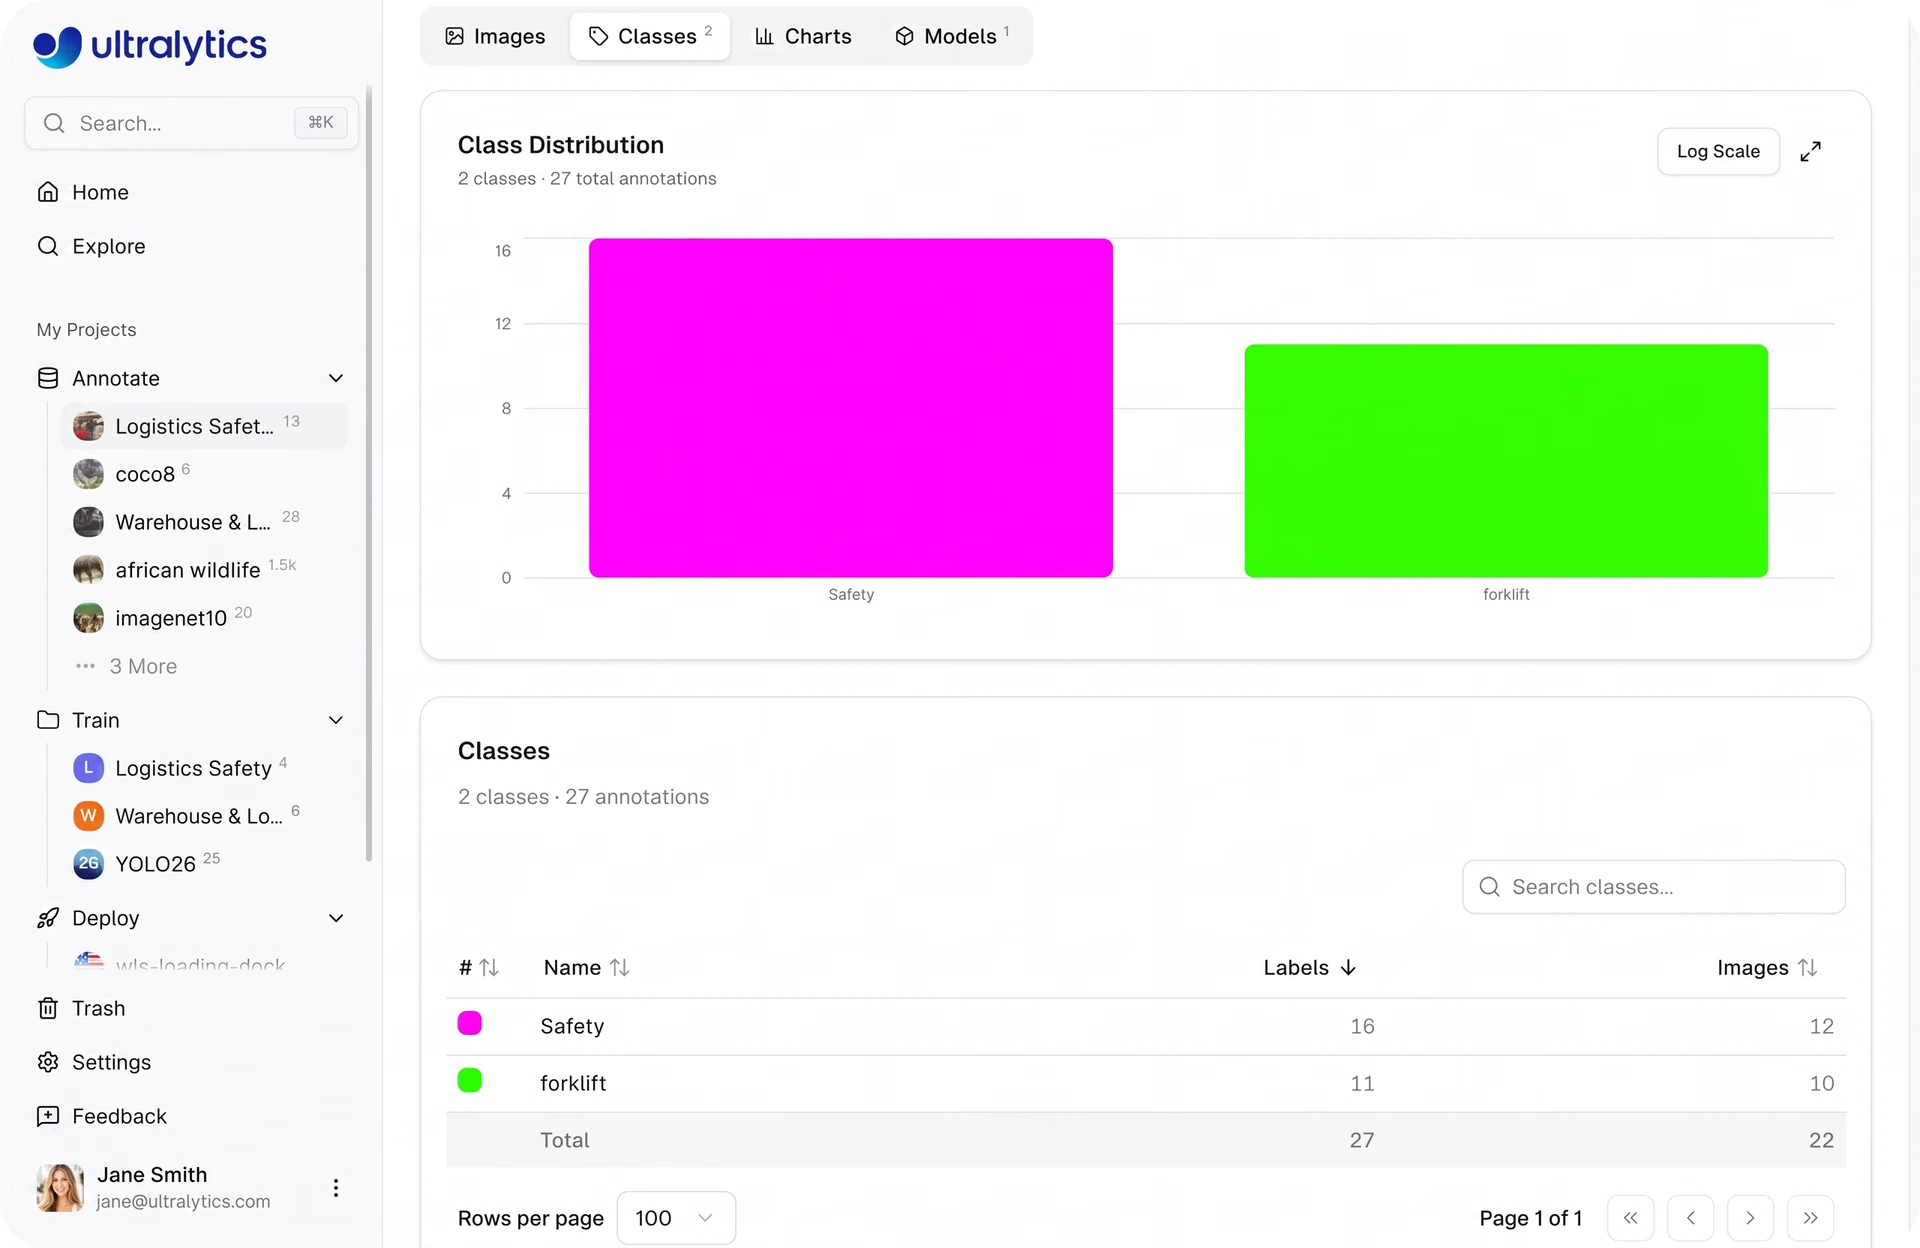
Fig. 4. Ejemplo de análisis de la distribución de clases de un conjunto de datos en Ultralytics Platform (Fuente)
Conexión de los conjuntos de datos con el entrenamiento y la implementación en Ultralytics Platform#
Ultralytics Platform conecta distintas etapas del desarrollo de modelos de IA en una única canalización. Esto agiliza el proceso de transformar datos sin procesar en aplicaciones de IA de visión listas para producción.
Una vez preparados y anotados los conjuntos de datos, puedes utilizarlos para entrenar modelos de visión artificial, como Ultralytics YOLO26, directamente en la plataforma. Durante el entrenamiento, puedes supervisar métricas de rendimiento, hacer un seguimiento de los experimentos y evaluar cuánto aprende el modelo mediante los paneles integrados.
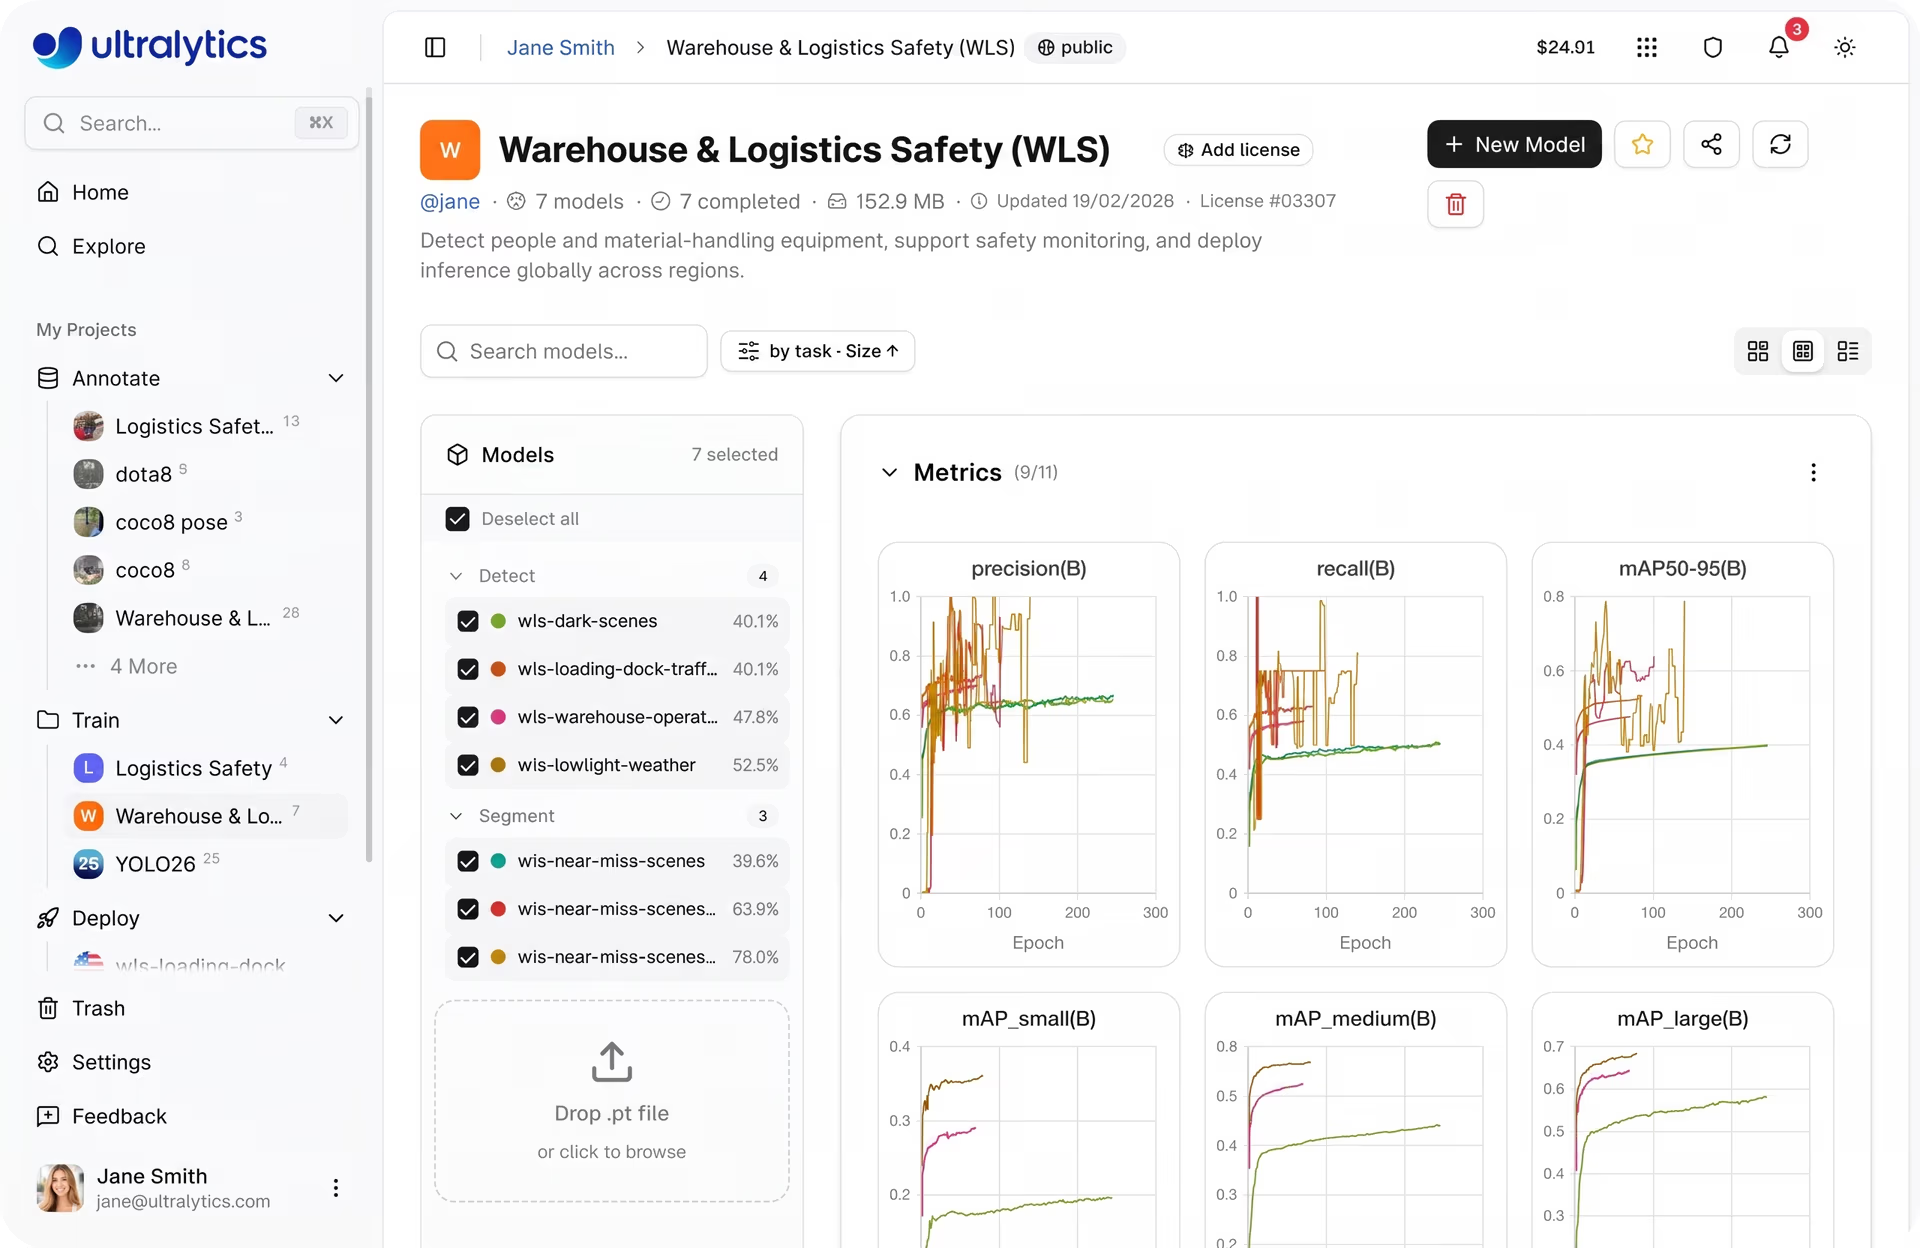
Fig. 5. Vista de las métricas de entrenamiento de modelos en Ultralytics Platform (Fuente)
Después del entrenamiento, puedes probar los modelos con imágenes nuevas directamente en el navegador para evaluar las predicciones e identificar aspectos que mejorar antes de la implementación. Cuando el modelo ofrece buenos resultados, puedes implementarlo en producción.
La plataforma permite exportar modelos a varios formatos o implementarlos mediante servicios de inferencia y puntos de conexión específicos, para ejecutarlos en distintos entornos.
Una vez implementados, las herramientas de supervisión integradas ayudan a hacer un seguimiento del rendimiento del sistema a lo largo del tiempo, incluidas las métricas relacionadas con el uso y el comportamiento del modelo. Esto facilita el mantenimiento y la mejora de los sistemas de IA de visión en aplicaciones reales.
Buenas prácticas para gestionar conjuntos de datos con Ultralytics Platform#
Estos son algunos factores clave que debes tener en cuenta al gestionar tus conjuntos de datos con Ultralytics Platform:
- Usa filtros para detectar carencias: Identifica datos sin etiquetar o poco representados mediante herramientas de filtrado, lo que facilita completar las anotaciones y mejorar la cobertura.
- Corrige los errores cuanto antes: Usa la pestaña Errors para controlar la calidad y detectar cargas fallidas, archivos dañados o formatos no compatibles antes del entrenamiento.
- Actualiza continuamente los conjuntos de datos: Añade datos nuevos, corrige anotaciones e incluye casos límite a medida que aparezcan. Esto ayuda a mejorar la cobertura y garantiza que los modelos rindan de forma fiable en situaciones reales.
- Gestiona cuidadosamente las divisiones de los conjuntos de datos: Asegúrate de que haya un buen equilibrio entre los conjuntos de entrenamiento, validación y prueba. Puedes reorganizar las divisiones manualmente o usar la redistribución automática cuando sea necesario.
Para obtener más información sobre Ultralytics Platform, consulta la documentación oficial de Ultralytics Platform.
Conclusiones clave#
A medida que los proyectos de visión artificial crecen, gestionar los conjuntos de datos de forma eficaz pasa a ser tan importante como desarrollar modelos. Un enfoque estructurado para la gestión de conjuntos de datos ayuda a mejorar la calidad de los datos, agilizar los flujos de trabajo y favorecer un mejor rendimiento de los modelos a lo largo del tiempo.
Ultralytics Platform simplifica este proceso al reunir la gestión de conjuntos de datos, el entrenamiento y el despliegue en un único flujo de trabajo. Al adoptar un enfoque estructurado para la gestión de conjuntos de datos, los equipos pueden reducir la complejidad, mejorar la eficiencia y crear sistemas de visión artificial más escalables y fiables.
Únete a nuestra creciente comunidad y explora nuestro repositorio de GitHub para encontrar recursos de IA. Para empezar a desarrollar con IA visual hoy mismo, consulta nuestras opciones de licencia. Descubre cómo la IA en la agricultura está transformando el sector agrícola y cómo la IA visual en la atención sanitaria está dando forma al futuro en nuestras páginas de soluciones.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









