¿Qué es la optimización de modelos? Guía rápida
Descubre cómo técnicas de optimización de modelos como el ajuste de hiperparámetros, la poda de modelos y la cuantización de modelos pueden mejorar la eficiencia de los modelos de visión artificial.
La optimización de modelos es un proceso cuyo objetivo es mejorar la eficiencia y el rendimiento de los modelos de aprendizaje automático. Al perfeccionar la estructura y el funcionamiento de un modelo, la optimización permite obtener mejores resultados con menos recursos computacionales y reducir el tiempo de entrenamiento y evaluación.
Este proceso es especialmente importante en campos como la visión artificial, donde los modelos suelen necesitar muchos recursos para analizar imágenes complejas. En entornos con recursos limitados, como los dispositivos móviles o los sistemas de computación en el borde, los modelos optimizados pueden funcionar bien con recursos limitados y seguir ofreciendo precisión.
Para optimizar modelos se suelen utilizar varias técnicas, como el ajuste de hiperparámetros, la poda de modelos, la cuantización de modelos y la precisión mixta. En este artículo veremos estas técnicas y las ventajas que aportan a las aplicaciones de visión artificial. ¡Empecemos!
Comprender la optimización de modelos#
Los modelos de visión artificial suelen tener capas profundas y estructuras complejas, ideales para reconocer patrones intrincados en imágenes, pero también pueden exigir mucha potencia de procesamiento. Cuando se implementan en dispositivos con hardware limitado, como los teléfonos móviles o los dispositivos de computación en el borde, pueden encontrarse con ciertos retos o limitaciones.
La escasa potencia de procesamiento, memoria y energía de estos dispositivos puede provocar caídas perceptibles del rendimiento, ya que los modelos tienen dificultades para seguir el ritmo. Las técnicas de optimización de modelos son fundamentales para resolver estos problemas. Ayudan a simplificar el modelo, reducir sus necesidades computacionales y garantizar que siga funcionando eficazmente, incluso con recursos limitados. La optimización de modelos puede lograrse simplificando la arquitectura del modelo, reduciendo la precisión de los cálculos o eliminando componentes innecesarios para que el modelo sea más ligero y rápido.
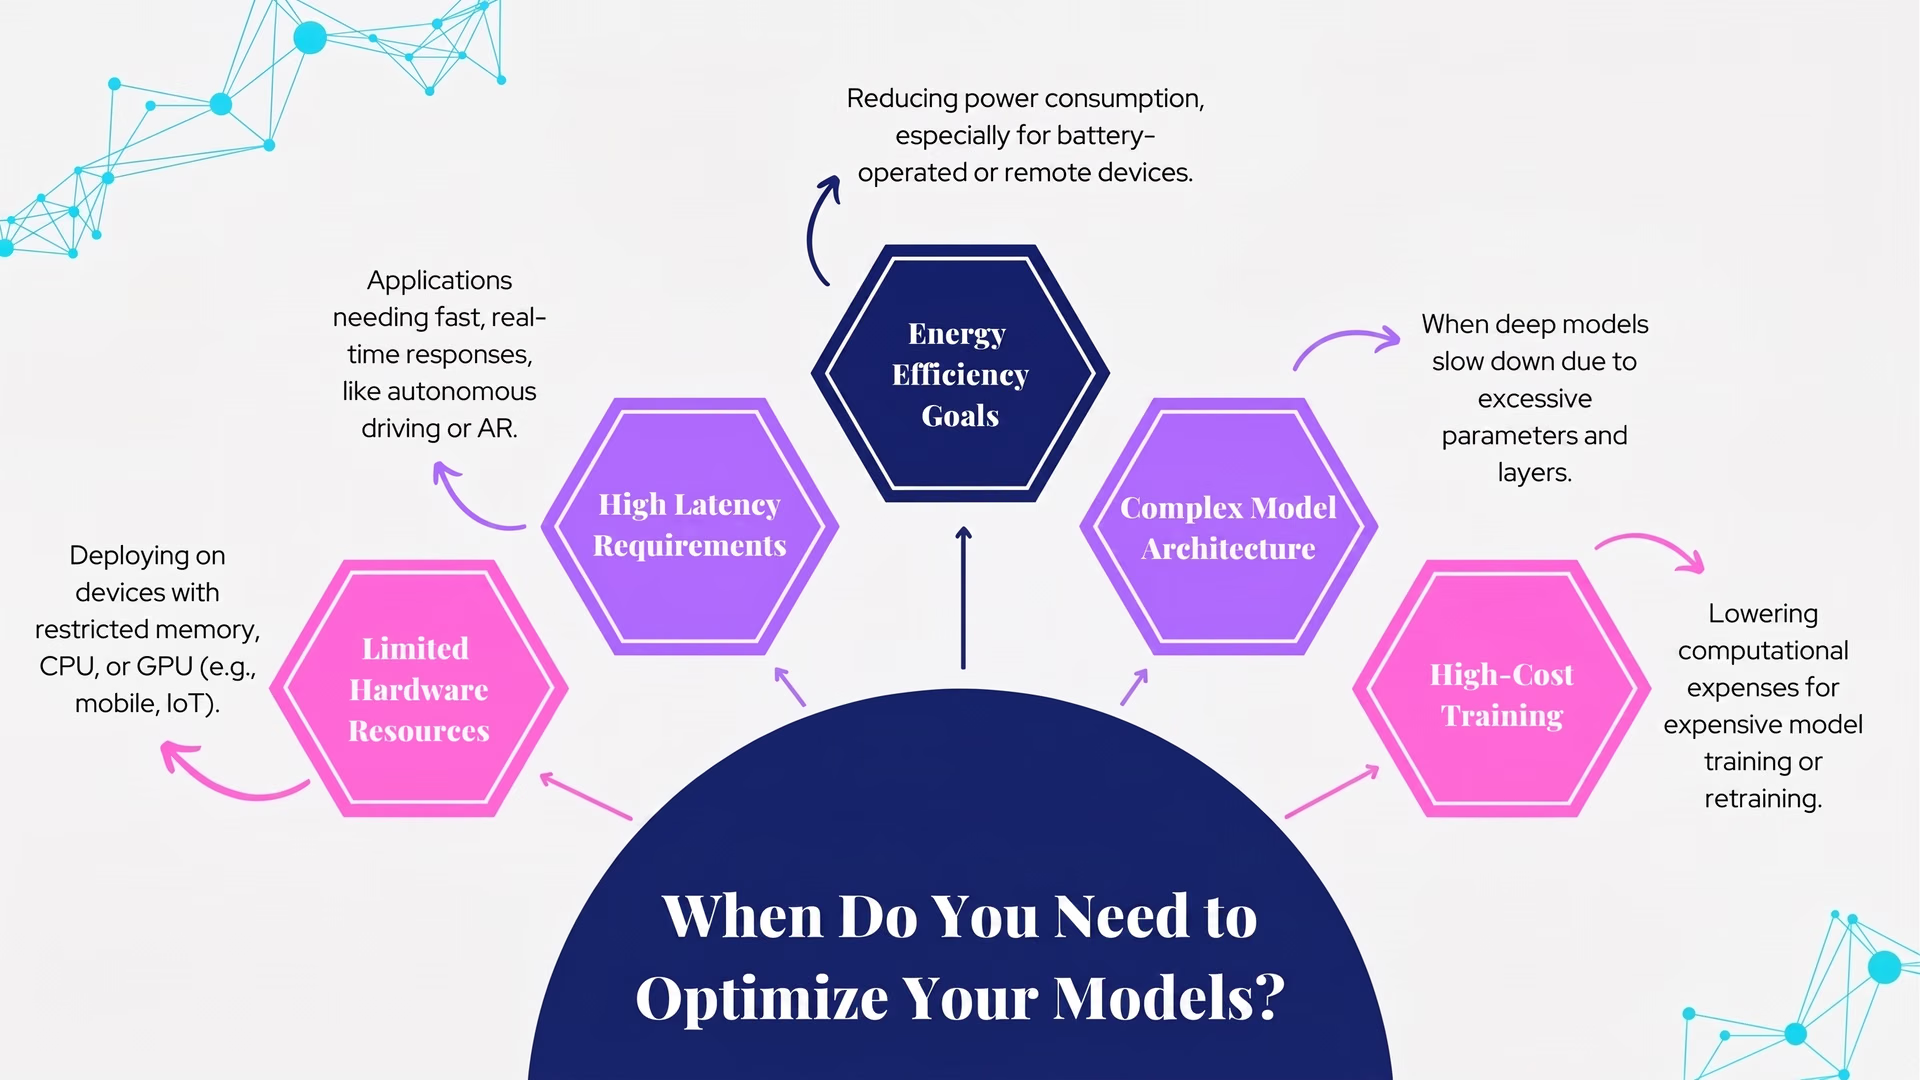
Fig. 1. Motivos para optimizar tus modelos. Imagen del autor.
Estas son algunas de las técnicas de optimización de modelos más habituales, que veremos con más detalle en las siguientes secciones:
- Ajuste de hiperparámetros: Consiste en ajustar sistemáticamente hiperparámetros, como la tasa de aprendizaje y el tamaño del lote, para mejorar el rendimiento del modelo.
- Poda de modelos: Esta técnica elimina pesos y conexiones innecesarios de la red neuronal, lo que reduce su complejidad y coste computacional.
- Cuantización de modelos: La cuantización reduce la precisión de los pesos y las activaciones del modelo, normalmente de 32 bits a 16 u 8 bits, lo que reduce considerablemente la memoria ocupada y los requisitos computacionales.
- Ajustes de precisión: También conocido como entrenamiento con precisión mixta, consiste en utilizar formatos de precisión distintos para diferentes partes del modelo y optimizar el uso de recursos sin comprometer la precisión.
Explicación de los hiperparámetros en los modelos de aprendizaje automático#
Puedes ayudar a un modelo a aprender y rendir mejor ajustando sus hiperparámetros, es decir, los valores que determinan cómo aprende a partir de los datos. El ajuste de hiperparámetros es una técnica para optimizar estos valores y mejorar la eficiencia y la precisión del modelo. A diferencia de los parámetros que el modelo aprende durante el entrenamiento, los hiperparámetros son valores predefinidos que guían el proceso de entrenamiento.
Veamos algunos ejemplos de hiperparámetros que se pueden ajustar:
- Tasa de aprendizaje: Este parámetro controla el tamaño del paso que da el modelo para ajustar sus pesos internos. Una tasa de aprendizaje más alta puede acelerar el aprendizaje, pero conlleva el riesgo de pasar por alto la solución óptima; una tasa más baja puede ofrecer más precisión, pero ser más lenta.
- Tamaño del lote: Define cuántas muestras de datos se procesan en cada paso de entrenamiento. Los lotes más grandes ofrecen un aprendizaje más estable, pero requieren más memoria. Los lotes más pequeños se entrenan más rápido, pero pueden ser menos estables.
- Épocas: Este parámetro permite determinar cuántas veces procesa el modelo el conjunto de datos completo. Un mayor número de épocas puede mejorar la precisión, pero aumenta el riesgo de sobreajuste.
- Tamaño del kernel: Define el tamaño del filtro en las redes neuronales convolucionales (CNNs). Los kernels más grandes capturan patrones más amplios, pero requieren más procesamiento; los kernels más pequeños se centran en detalles más precisos.
Cómo funciona el ajuste de hiperparámetros#
Por lo general, el ajuste de hiperparámetros empieza por definir un intervalo de valores posibles para cada hiperparámetro. A continuación, un algoritmo de búsqueda explora distintas combinaciones dentro de esos intervalos para encontrar los ajustes que ofrecen el mejor rendimiento.
Entre los métodos habituales de ajuste se encuentran la búsqueda en cuadrícula, la búsqueda aleatoria y la optimización bayesiana. La búsqueda en cuadrícula prueba todas las combinaciones posibles de valores dentro de los intervalos especificados. La búsqueda aleatoria selecciona combinaciones al azar y suele encontrar ajustes eficaces más rápidamente. La optimización bayesiana utiliza un modelo probabilístico para predecir valores prometedores de los hiperparámetros a partir de resultados anteriores. Este enfoque suele reducir el número de pruebas necesarias.
Por último, se evalúa el rendimiento del modelo para cada combinación de hiperparámetros. El proceso se repite hasta obtener los resultados deseados.
Hiperparámetros frente a parámetros del modelo#
Al trabajar en el ajuste de hiperparámetros, quizá te preguntes en qué se diferencian los hiperparámetros de los parámetros del modelo.
Los hiperparámetros son valores establecidos antes del entrenamiento que controlan cómo aprende el modelo, como la tasa de aprendizaje o el tamaño del lote. Estos valores se mantienen fijos durante el entrenamiento e influyen directamente en el proceso de aprendizaje. En cambio, el propio modelo aprende los parámetros durante el entrenamiento. Estos incluyen los pesos y los sesgos, que se ajustan mientras se entrena el modelo y, en última instancia, guían sus predicciones. En esencia, los hiperparámetros determinan el proceso de aprendizaje, mientras que los parámetros del modelo son el resultado de dicho proceso.
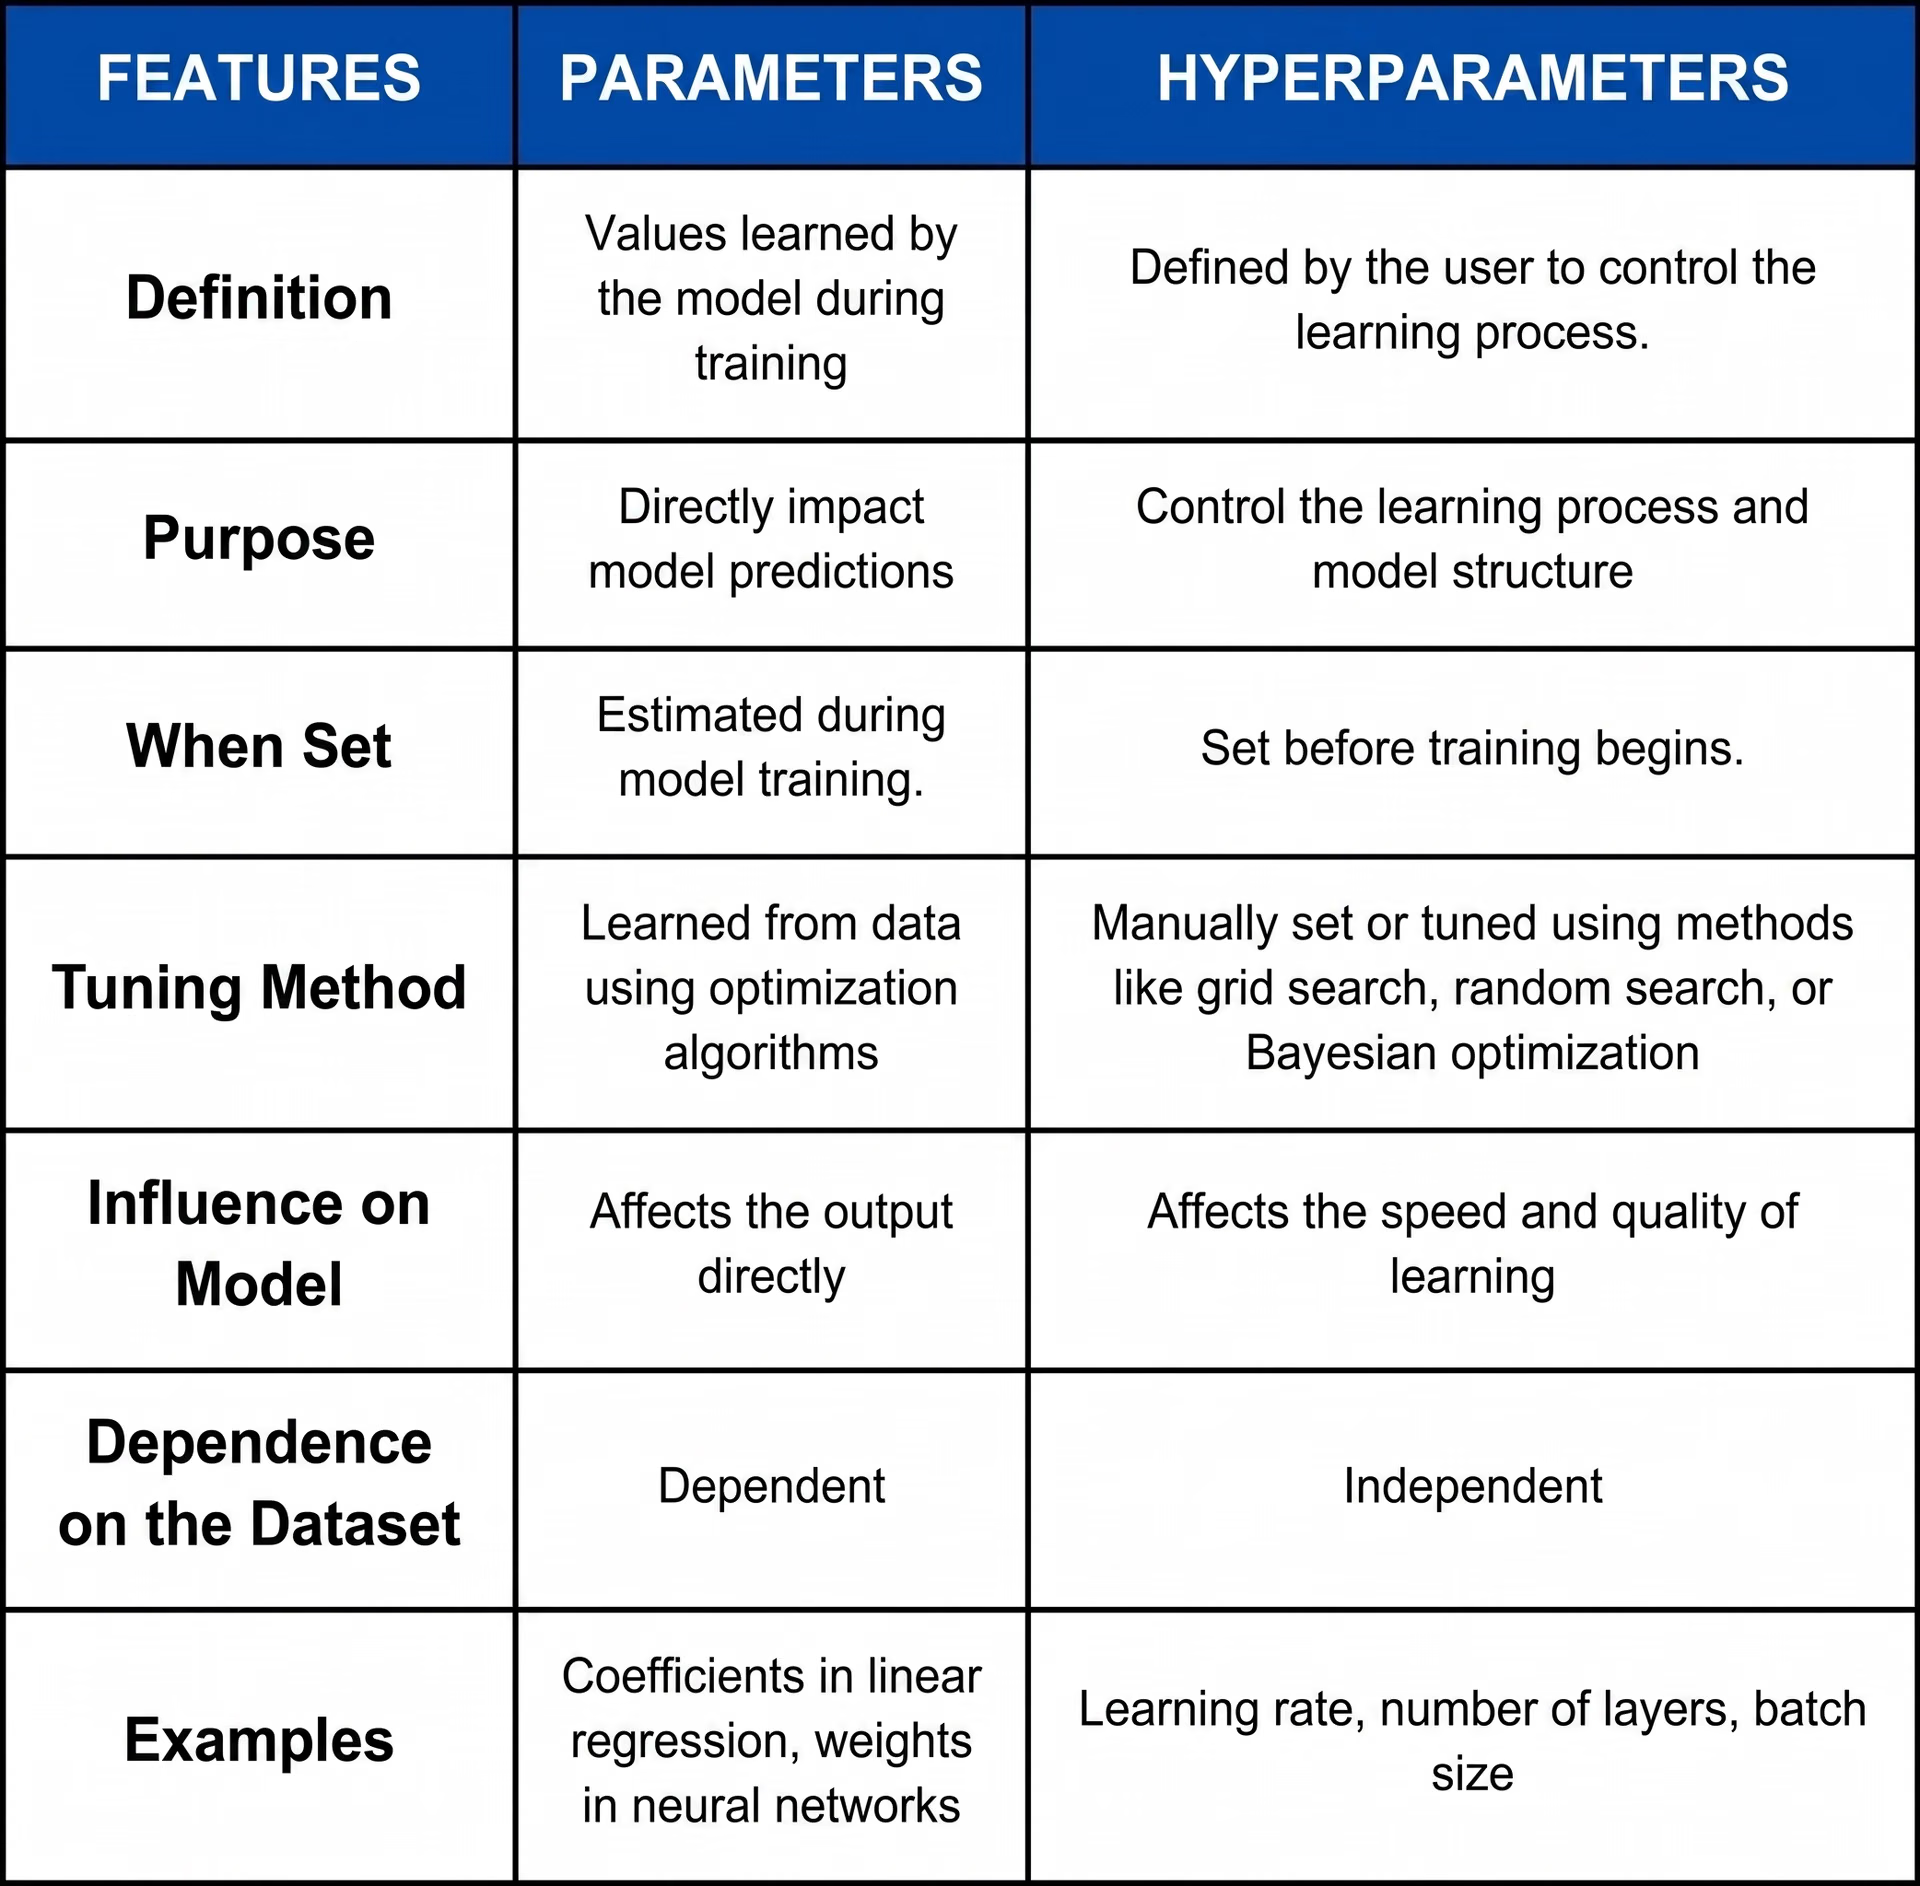
Fig. 2. Comparación de parámetros e hiperparámetros.
Por qué es importante la poda de modelos en el aprendizaje profundo#
La poda de modelos es una técnica para reducir el tamaño que elimina pesos y parámetros innecesarios de un modelo, lo que lo hace más eficiente. En la visión artificial, especialmente en las redes neuronales profundas, una gran cantidad de parámetros, como los pesos y las activaciones (resultados intermedios que ayudan a calcular el resultado final), puede aumentar tanto la complejidad como las necesidades computacionales. La poda ayuda a simplificar el modelo al identificar y eliminar los parámetros que apenas contribuyen al rendimiento, lo que da como resultado un modelo más ligero y eficiente.
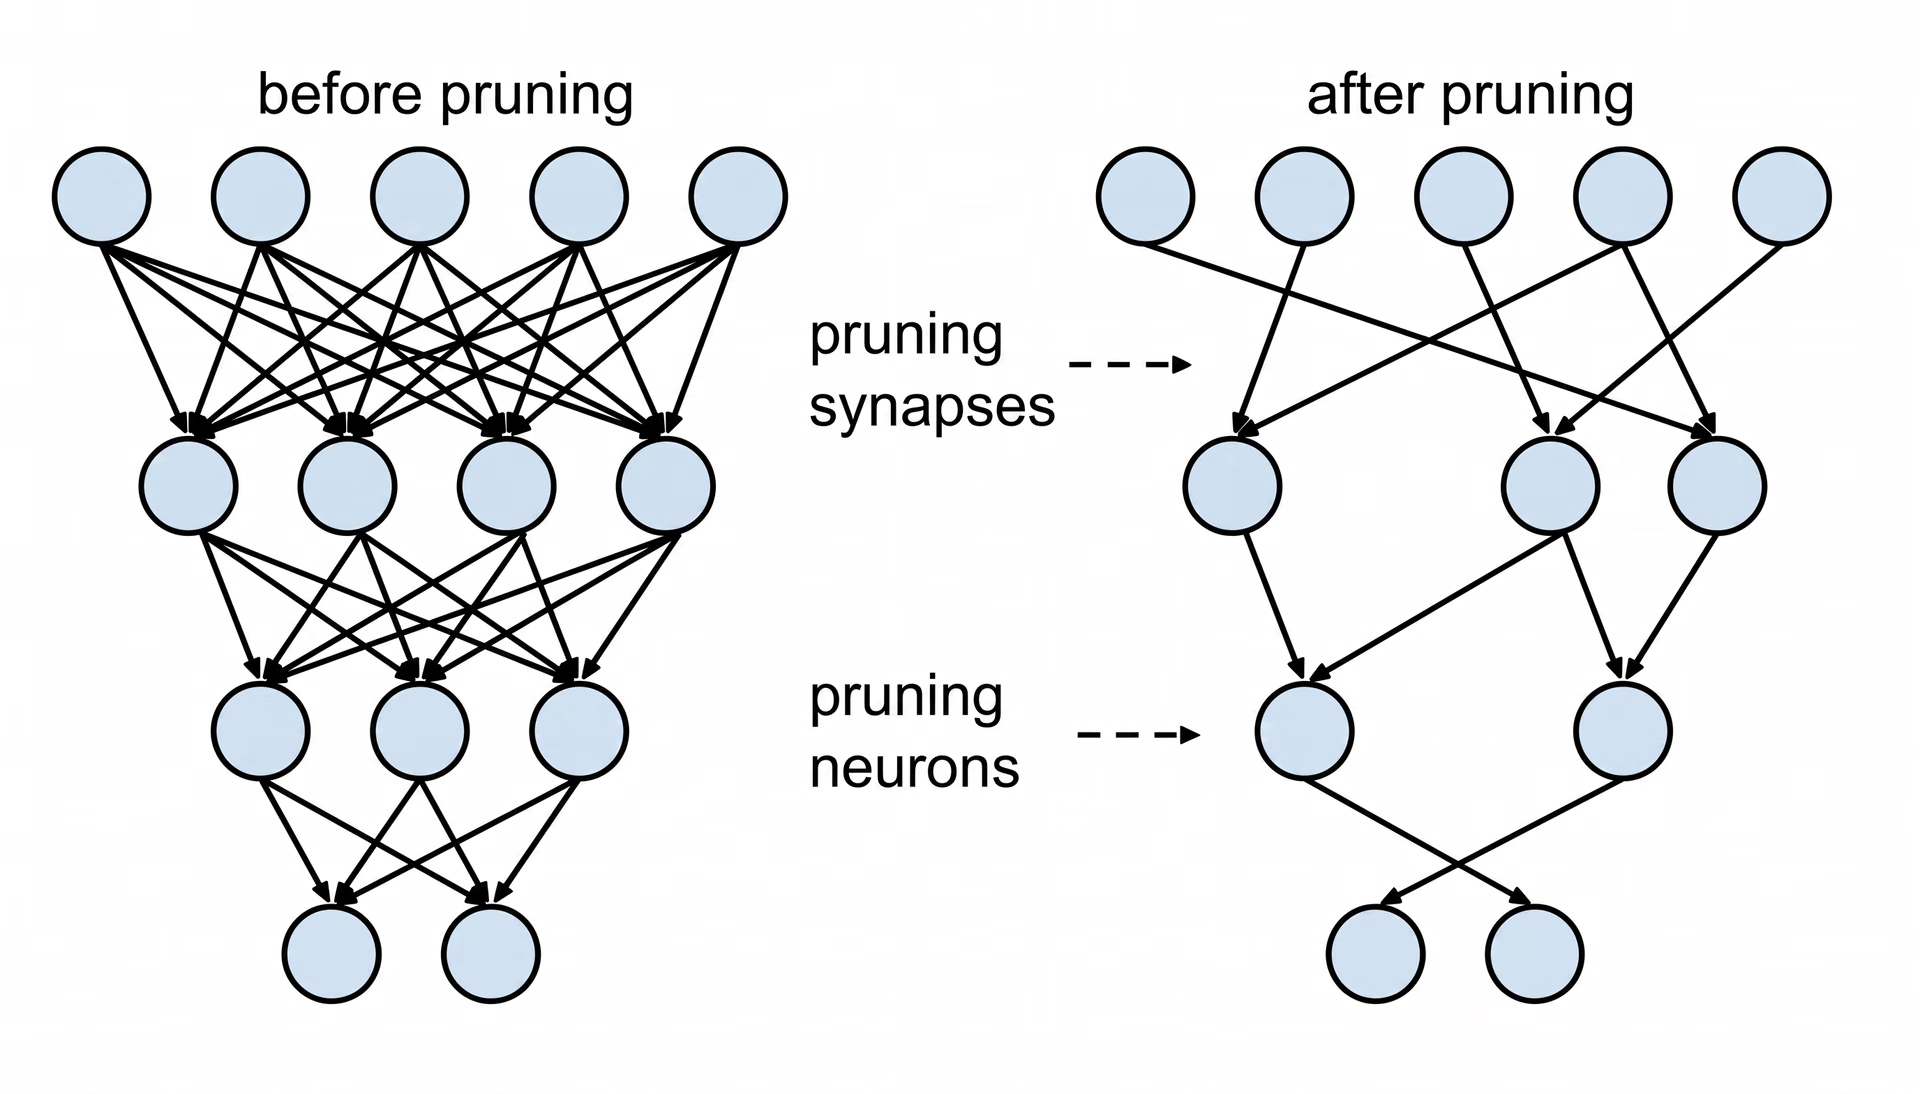
Fig. 3. Antes y después de la poda del modelo.
Una vez entrenado el modelo, se pueden utilizar técnicas como la poda basada en la magnitud o el análisis de sensibilidad para evaluar la importancia de cada parámetro. A continuación, se podan los parámetros de poca importancia mediante una de estas tres técnicas principales: poda de pesos, poda de neuronas o poda estructurada.
La poda de pesos elimina conexiones individuales con un impacto mínimo en el resultado. La poda de neuronas elimina neuronas completas cuyas salidas contribuyen poco a la función del modelo. La poda estructurada elimina secciones más grandes, como filtros convolucionales o neuronas de capas totalmente conectadas, para optimizar la eficiencia del modelo. Una vez finalizada la poda, se vuelve a entrenar el modelo para ajustar con precisión los parámetros restantes y garantizar que mantenga una gran precisión en un formato reducido.
Reducción de la latencia de los modelos de IA mediante la cuantización#
La cuantización de modelos reduce el número de bits utilizados para representar los pesos y las activaciones de un modelo. Normalmente convierte valores de coma flotante de 32 bits de alta precisión a formatos de menor precisión, como enteros de 16 u 8 bits. Al reducir la precisión en bits, la cuantización disminuye considerablemente el tamaño del modelo, la memoria ocupada y el coste computacional.
En visión artificial, los valores de coma flotante de 32 bits son habituales, pero convertirlos a 16 u 8 bits puede mejorar la eficiencia. Hay dos tipos principales de cuantización: la cuantización de pesos y la cuantización de activaciones. La cuantización de pesos reduce la precisión de los pesos del modelo y equilibra la reducción de tamaño con la precisión. La cuantización de activaciones reduce la precisión de las activaciones, lo que disminuye aún más las necesidades de memoria y cálculo.
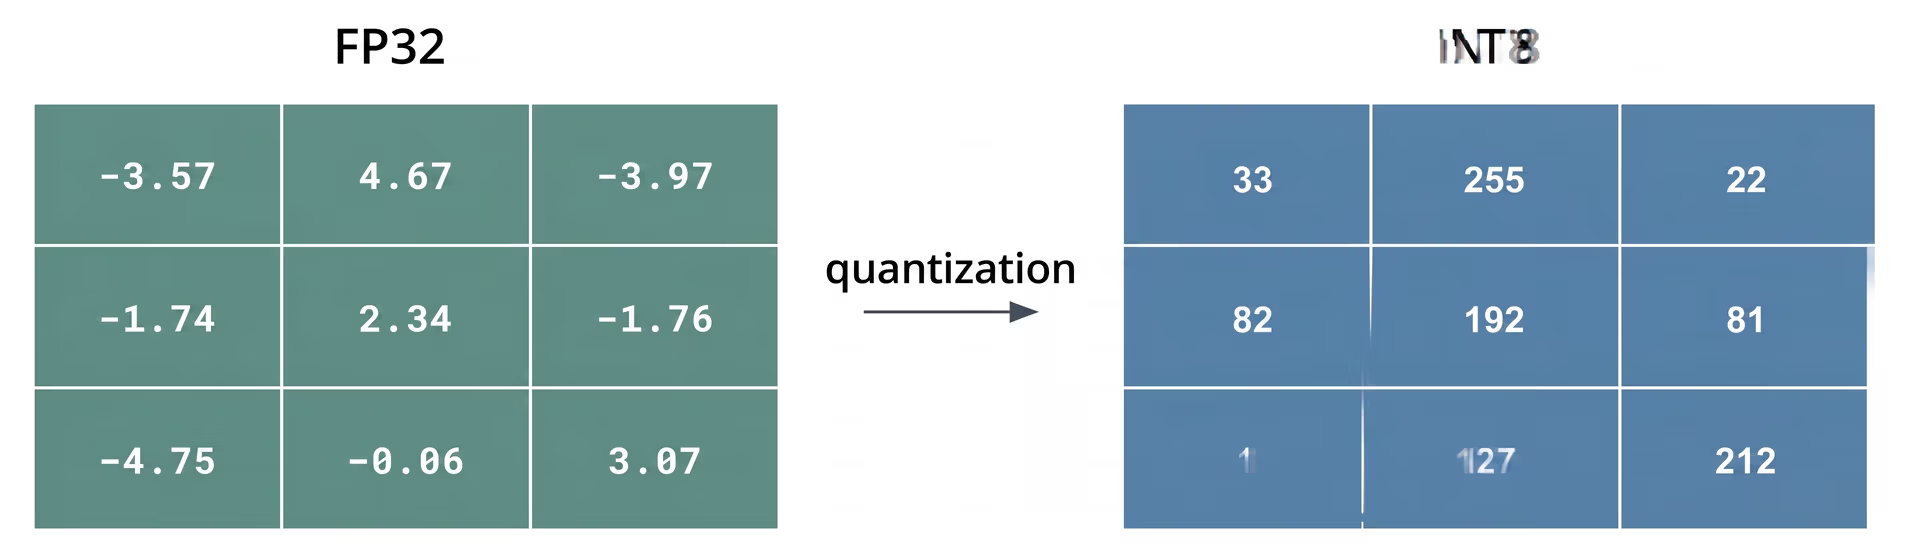
Fig. 4. Un ejemplo de cuantización de coma flotante de 32 bits a entero de 8 bits.
Cómo acelera la precisión mixta las inferencias de IA#
La precisión mixta es una técnica que utiliza distintas precisiones numéricas en varias partes de una red neuronal. Al combinar valores de mayor precisión, como los números de coma flotante de 32 bits, con valores de menor precisión, como los de 16 u 8 bits, la precisión mixta permite que los modelos de visión artificial aceleren el entrenamiento y reduzcan el uso de memoria sin sacrificar precisión.
Durante el entrenamiento, la precisión mixta se consigue utilizando una precisión menor en capas específicas y manteniendo una precisión mayor donde se necesita en toda la red. Esto se hace mediante la conversión de tipos y el escalado de la pérdida. La conversión cambia los tipos de datos entre distintas precisiones según lo requiera el modelo. El escalado de la pérdida ajusta la precisión reducida para evitar el subdesbordamiento numérico y garantizar un entrenamiento estable. La precisión mixta resulta especialmente útil para modelos grandes y tamaños de lote elevados.
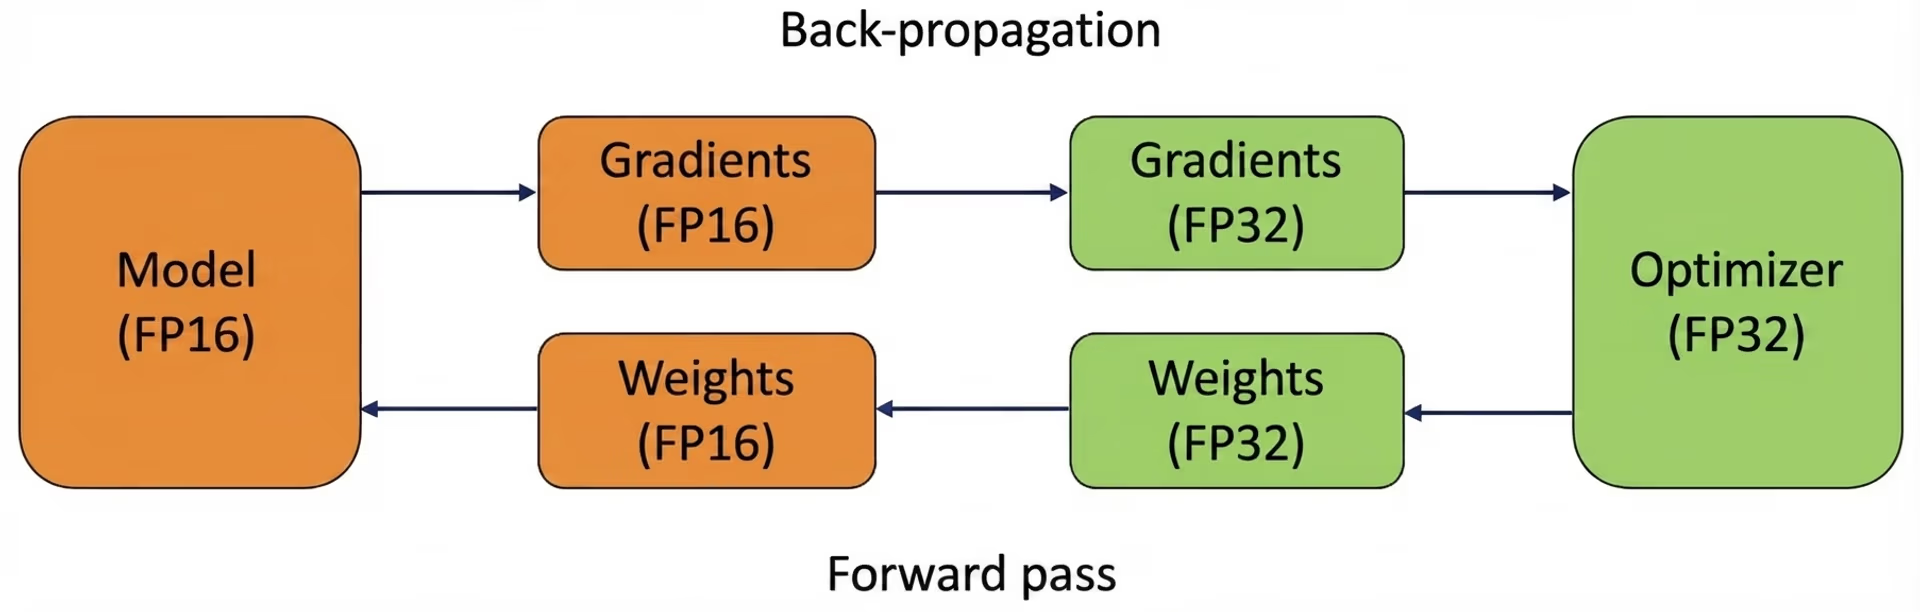
Fig. 5. El entrenamiento con precisión mixta utiliza tipos de coma flotante de 16 bits (FP16) y 32 bits (FP32).
Equilibrio entre la precisión y la eficiencia del modelo#
Ahora que hemos repasado varias técnicas de optimización de modelos, veamos cómo decidir cuál utilizar según tus necesidades específicas. La elección depende de factores como el hardware disponible, las limitaciones de cálculo y memoria del entorno de implementación y el nivel de precisión necesario.
Por ejemplo, los modelos más pequeños y rápidos son más adecuados para dispositivos móviles con recursos limitados, mientras que los modelos más grandes y precisos pueden utilizarse en sistemas de alto rendimiento. Así se adapta cada técnica a distintos objetivos:
- Poda: Es ideal para reducir el tamaño del modelo sin afectar significativamente a la precisión, por lo que resulta perfecta para dispositivos con recursos limitados, como los teléfonos móviles o los dispositivos del Internet de las cosas (IoT).
- Cuantización: Una gran opción para reducir el tamaño del modelo y acelerar la inferencia, especialmente en dispositivos móviles y sistemas integrados con memoria y capacidad de procesamiento limitadas. Funciona bien en aplicaciones donde se aceptan pequeñas reducciones de precisión.
- Precisión mixta: Diseñada para modelos a gran escala, esta técnica reduce el uso de memoria y acelera el entrenamiento en hardware, como las GPU y las TPU, compatible con operaciones de precisión mixta. Se suele utilizar en tareas de alto rendimiento donde la eficiencia es importante.
- Ajuste de hiperparámetros: Aunque requiere muchos recursos de cálculo, es esencial para aplicaciones que exigen una gran precisión, como la imagen médica o la conducción autónoma.
Conclusiones clave#
La optimización de modelos es una parte fundamental del aprendizaje automático, especialmente para implementar IA en aplicaciones del mundo real. Técnicas como el ajuste de hiperparámetros, la poda de modelos, la cuantización y la precisión mixta ayudan a mejorar el rendimiento, la eficiencia y el uso de recursos de los modelos de visión artificial. Estas optimizaciones hacen que los modelos sean más rápidos y requieran menos recursos, lo que resulta ideal para dispositivos con memoria y capacidad de procesamiento limitadas. Además, los modelos optimizados son más fáciles de escalar e implementar en distintas plataformas, lo que permite crear soluciones de IA eficaces y adaptables a una amplia variedad de usos.
Visita el repositorio de GitHub de Ultralytics y únete a nuestra comunidad para obtener más información sobre las aplicaciones de IA en la fabricación y la agricultura.









