Accélérer Ultralytics YOLO26 avec OpenVINO sur Intel Core Ultra Series 3 (Panther Lake)
Découvre comment exporter les modèles Ultralytics YOLO26 au format OpenVINO et accélérer l’inférence sur le matériel Intel, notamment sur CPU, GPU et NPU.
Au cours des dernières années, l’IA et la vision par ordinateur sont passées du stade expérimental à celui d’éléments essentiels des activités quotidiennes des entreprises. En fait, les enquêtes montrent qu’environ 88 % des organisations utilisent déjà l’IA dans au moins un domaine de leur activité.
Cependant, qu’il s’agisse de systèmes de production ou de projets personnels, la capacité à tirer une réelle valeur de cette adoption dépend souvent du fonctionnement concret des modèles une fois déployés. Dans de nombreux cas réels, les modèles de vision par ordinateur comme Ultralytics YOLO26 sont déployés sur des appareils en périphérie et différents types de matériel, souvent des CPU, des GPU intégrés ou des NPU, plutôt que sur des GPU haut de gamme.
C’est là que les performances peuvent commencer à varier et que l’optimisation devient essentielle. Un modèle qui fonctionne bien dans un environnement peut rencontrer des difficultés dans un autre s’il n’est pas correctement optimisé pour le matériel sous-jacent.
Pour simplifier ce processus, le package Python Ultralytics permet d’exporter les modèles YOLO26 vers des formats optimisés comme OpenVINO, afin qu’ils fonctionnent efficacement sur le matériel Intel sans modifier ton workflow.
Par exemple, lorsqu’un modèle Ultralytics YOLO26 est exporté au format OpenVINO, il peut fonctionner plus efficacement sur les processeurs Intel Core Ultra Series 3, avec des vitesses d’inférence sur GPU jusqu’à trois fois supérieures.
Dans cet article, nous allons voir comment l’intégration mise à jour entre Ultralytics et OpenVINO facilite le déploiement des modèles YOLO26 sur le matériel Intel Core Ultra Series 3. C’est parti !
Présentation de l’intégration entre Ultralytics et OpenVINO#
Le package Python Ultralytics fournit une interface unique pour entraîner les modèles Ultralytics YOLO, exécuter l’inférence et les déployer, notamment YOLO26. Il prend en charge un éventail d’intégrations qui facilitent différentes étapes du workflow d’IA visuelle, de l’entraînement et de l’expérimentation au déploiement et à l’optimisation.
L’une des intégrations axées sur le déploiement concerne la boîte à outils OpenVINO, qui te permet d’exporter les modèles Ultralytics YOLO26 vers un format optimisé pour le matériel Intel. Ce processus convertit les modèles YOLO dans un format qui fonctionne plus efficacement sur les CPU, GPU et NPU Intel, notamment sur les systèmes équipés de processeurs Intel® Core™ Ultra™.
L’exécution des modèles sur différents appareils Intel est ainsi simplifiée, sans qu’il soit nécessaire de les ajuster manuellement pour chaque configuration. Que tu travailles sur une machine locale, un appareil en périphérie ou un déploiement à plus grande échelle, tu peux réutiliser le même modèle exporté.
Cette intégration est particulièrement pratique parce qu’elle s’insère parfaitement dans le workflow Ultralytics existant. Tu peux exporter un modèle avec la même interface que celle utilisée pour l’entraînement et l’inférence, sans outils supplémentaires ni configuration complexe.
Une fois exporté, le modèle peut être utilisé pour l’inférence avec le package Python Ultralytics ou le runtime OpenVINO, selon le niveau de contrôle et de flexibilité dont tu as besoin.
Zoom sur OpenVINO et le matériel Intel Panther Lake pour l’inférence IA#
Avant de voir avec quelle efficacité un modèle Ultralytics YOLO26 exporté peut fonctionner sur du matériel Intel, prenons un peu de recul pour comprendre comment OpenVINO et le matériel Intel s’associent afin de permettre une inférence efficace.
OpenVINO est une boîte à outils open source conçue pour optimiser et exécuter l’inférence IA sur le matériel Intel, notamment les CPU, les GPU intégrés et les NPU. Elle fournit un runtime unifié qui permet d’exécuter le même modèle sur ces différentes unités de calcul sans avoir à le réécrire.
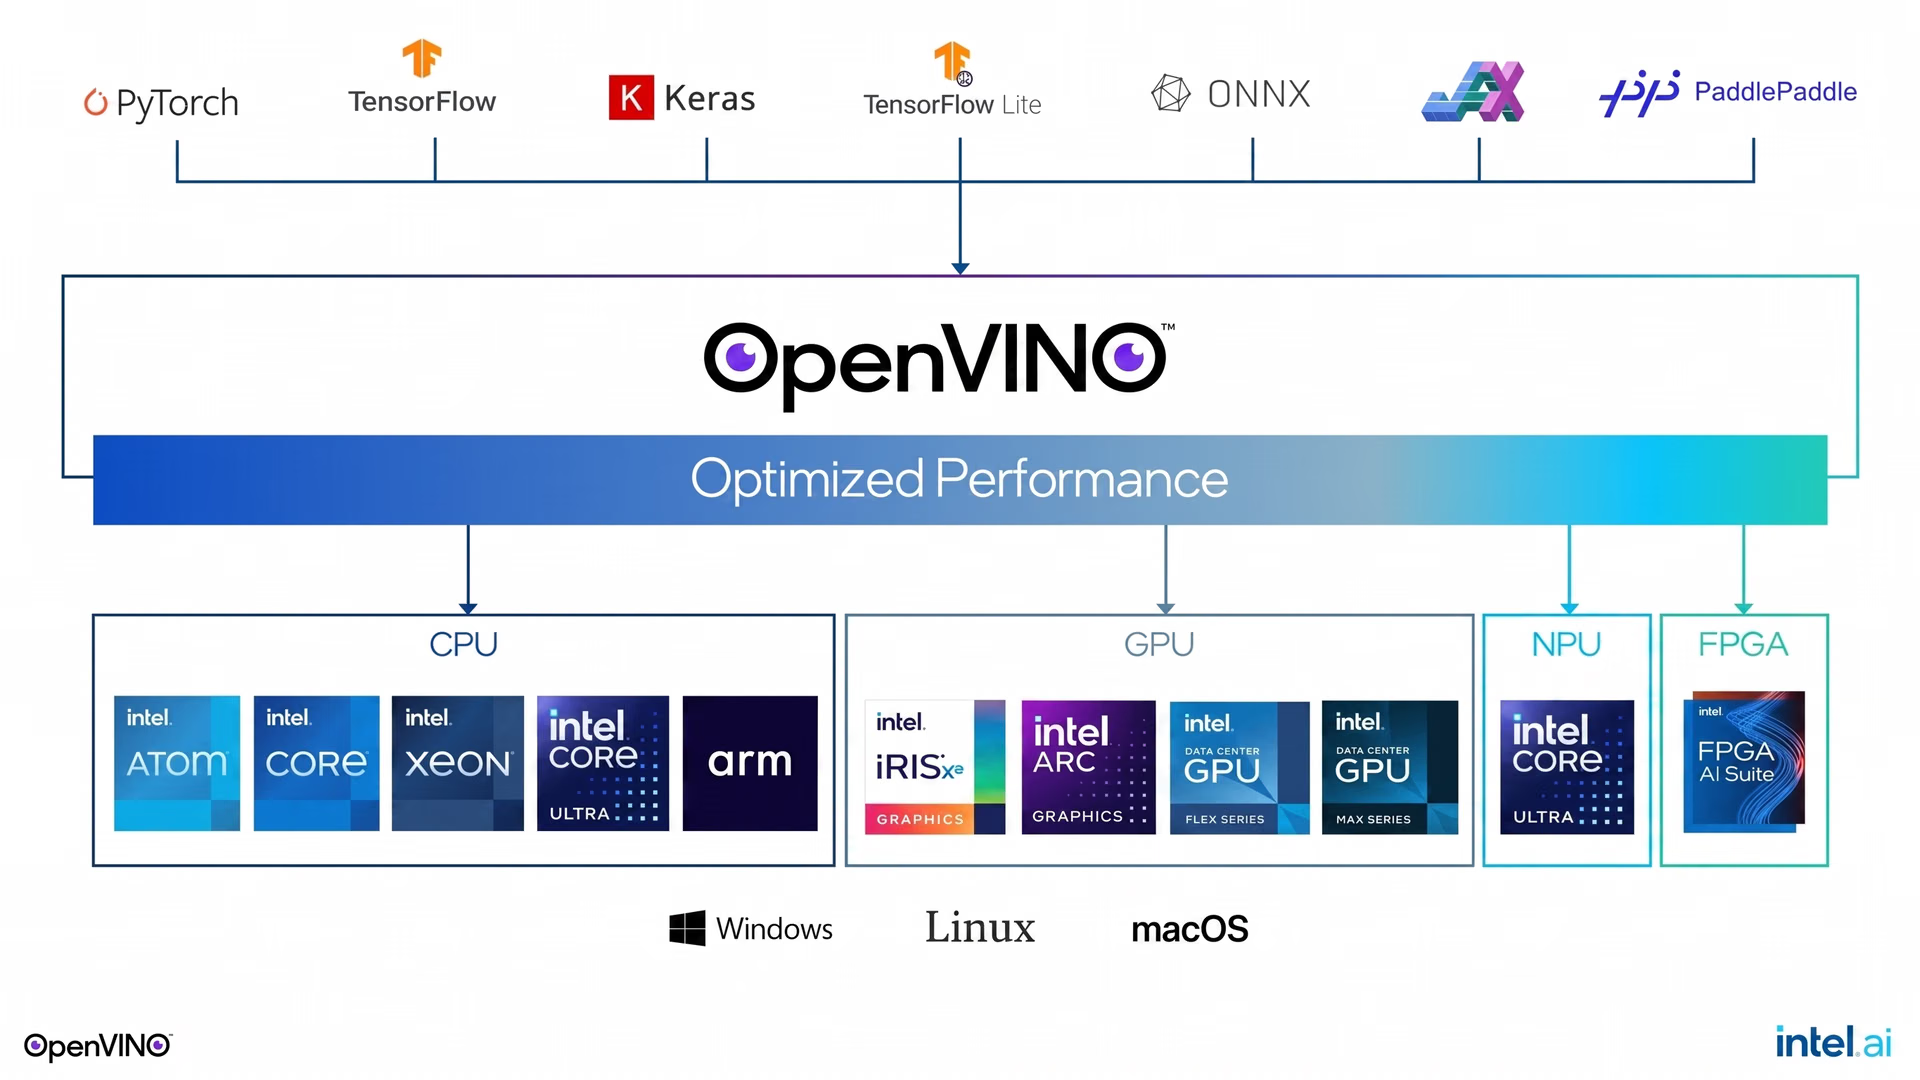
Fig. 1. OpenVINO facilite le déploiement des modèles sur plusieurs types de matériel. (Source)
Sur les nouveaux processeurs Intel® Core™ Ultra™ Series 3 (nom de code Panther Lake), les charges de travail liées à l’IA s’exécutent sur plusieurs unités de calcul au sein d’un même processeur. Chaque puce associe des cœurs CPU pour les tâches généralistes, un GPU intégré pour le traitement parallèle et un NPU dédié, conçu spécifiquement pour l’inférence IA.
OpenVINO fournit une API unifiée qui te permet de cibler n’importe laquelle de ces unités de calcul, qu’il s’agisse du CPU, du GPU ou du NPU, sans modifier ton code. Il te suffit de spécifier au moment de l’exécution l’appareil sur lequel lancer l’inférence, ce qui permet de passer facilement de l’un à l’autre selon tes besoins en performances et en efficacité.
Évaluation comparative d’Ultralytics YOLO26 sur la gamme Intel® Core™ Ultra™#
En découvrant l’intégration entre Ultralytics et OpenVINO, tu te demandes peut-être quels gains de performances tu peux espérer en exportant YOLO26 au format OpenVINO.
La différence de vitesse d’inférence est évidente lorsqu’on compare les modèles YOLO26 dans différents formats et avec différents niveaux de précision. Par exemple, avec la variante nano de YOLO26 (YOLO26n) sur un Intel Core Ultra X7 358H, un processeur Panther Lake, le temps d’inférence passe de 25,18 ms par image avec PyTorch en précision FP32 à 2,64 ms avec OpenVINO, à la même précision, sur le NPU intégré.
Cette vitesse dépasse celle de la référence PyTorch FP32 initiale, ce qui peut faire une différence notable dans les applications en temps réel et en périphérie, où la latence est essentielle. Ces gains sont encore plus visibles lorsque le même modèle s’exécute sur le GPU Intel Arc intégré.
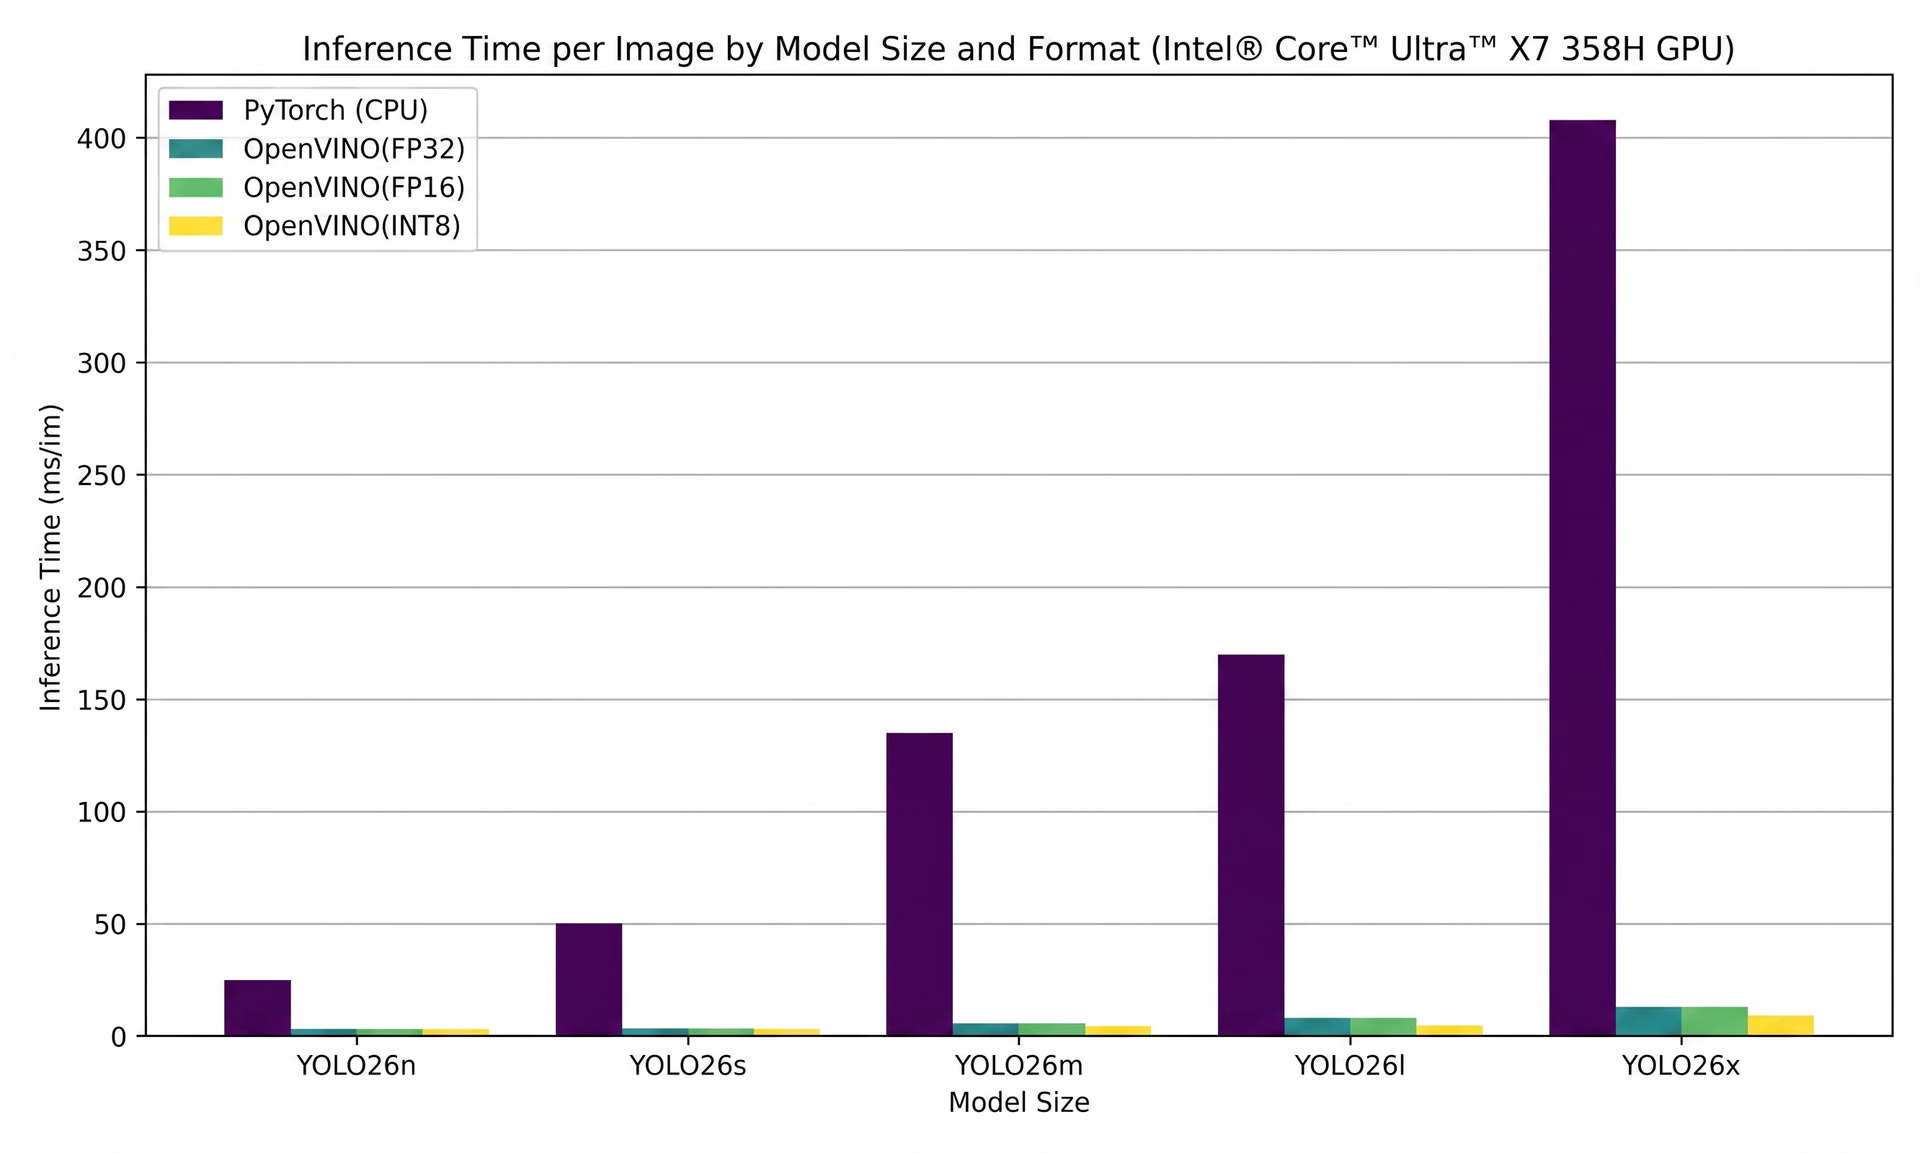
Fig. 2. Évaluation comparative de l’inférence d’Ultralytics YOLO26 sur le GPU Intel Panther Lake avec OpenVINO (Source)
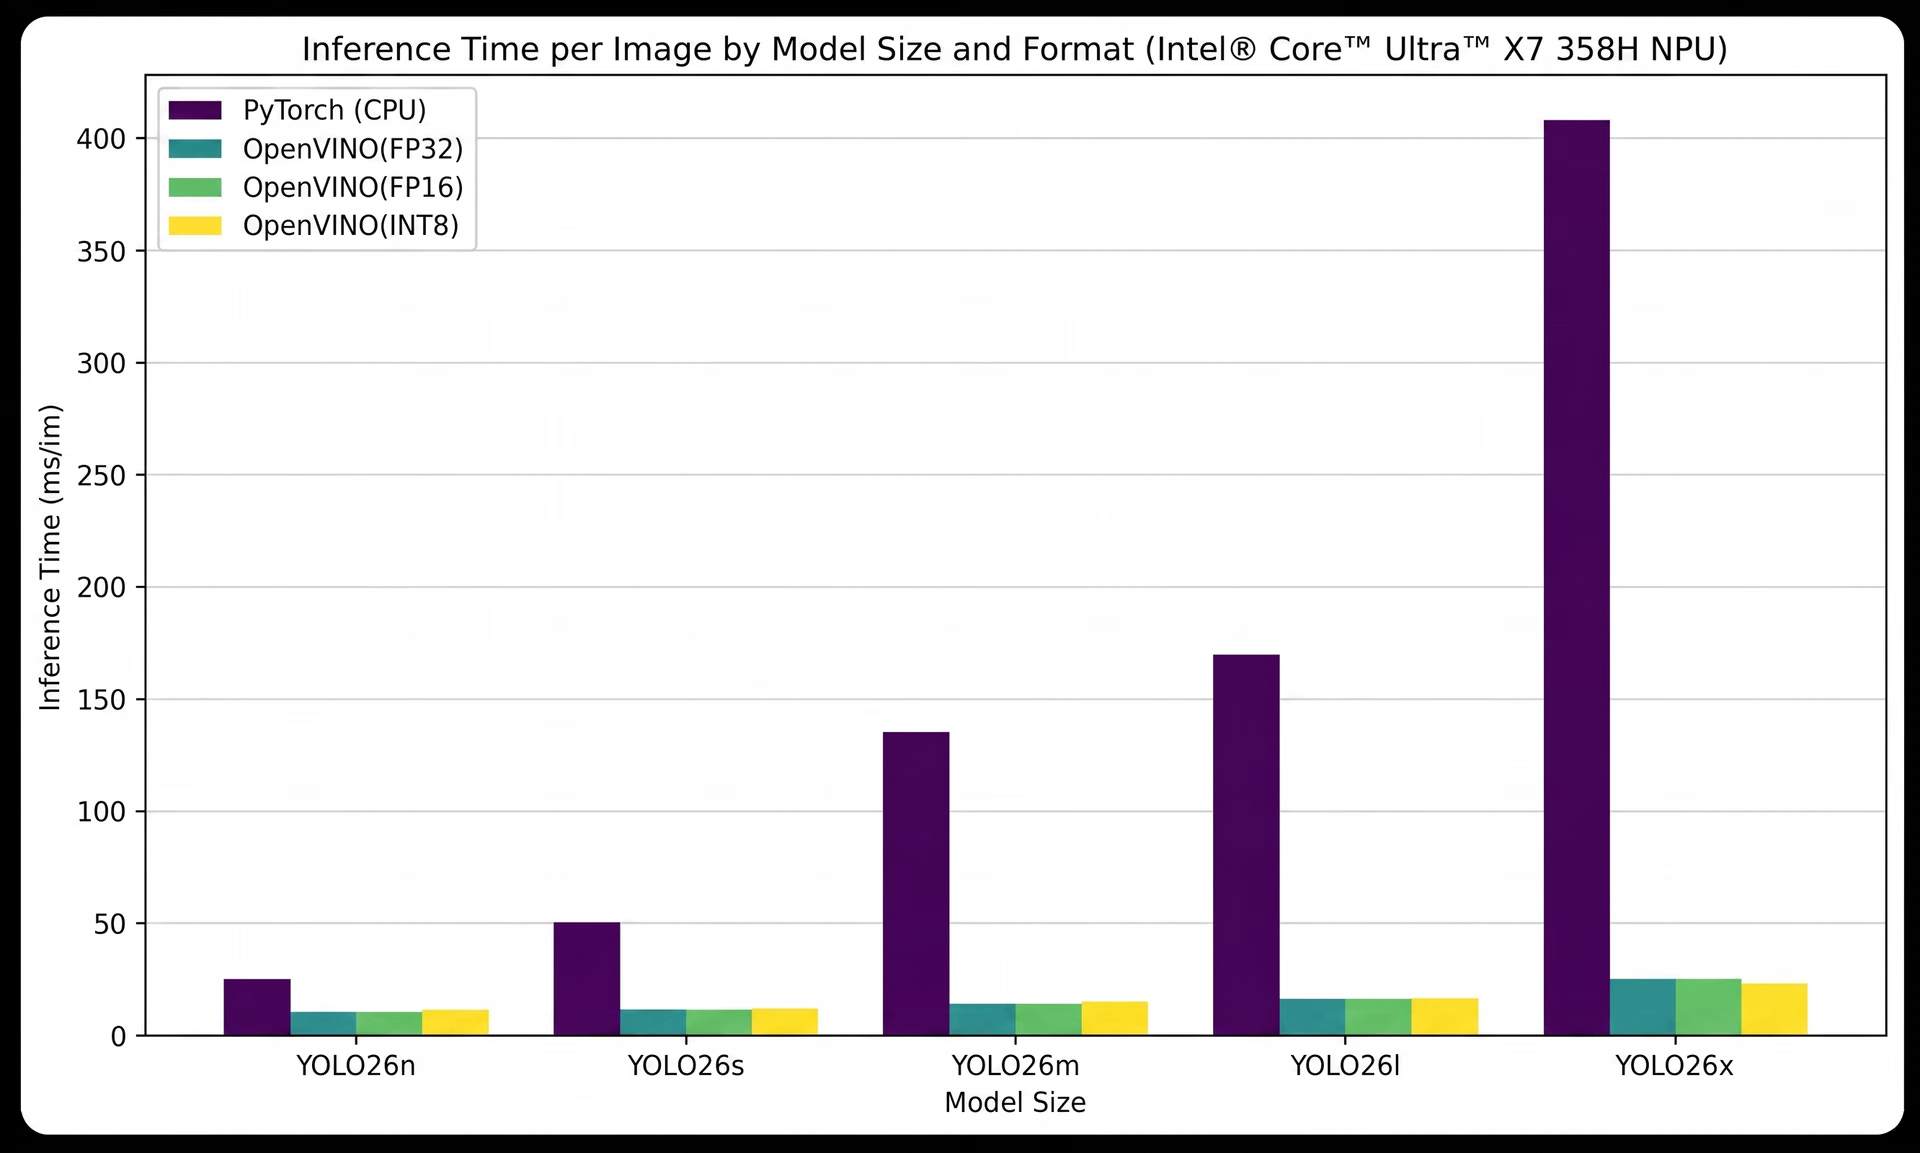
Fig. 3. Évaluation comparative de l’inférence d’Ultralytics YOLO26 sur le NPU Intel Panther Lake avec OpenVINO (Source)
Deux façons d’exporter Ultralytics YOLO26 au format OpenVINO#
Il existe deux principales façons d’exporter les modèles YOLO26 au format OpenVINO. Tu peux utiliser le package Python Ultralytics ou effectuer l’export directement depuis Ultralytics Platform, un espace de travail de bout en bout qui permet de créer et de gérer tous tes workflows de vision par ordinateur au même endroit. Nous allons maintenant détailler ces deux méthodes.
Exporter YOLO26 avec le package Python Ultralytics#
Le package Python Ultralytics permet d’exporter facilement les modèles YOLO26 au format OpenVINO dans le cadre d’un workflow basé sur le code. Comme la même interface sert à l’entraînement et à l’inférence, l’exportation d’un modèle s’intègre naturellement aux pipelines existants, sans outils supplémentaires.
Pour commencer, tu peux installer le package Ultralytics en exécutant la commande « pip install ultralytics » dans un terminal ou une invite de commandes. Si tu travailles dans un environnement interactif comme Jupyter Notebook ou Google Colab, tu peux exécuter la même commande en la faisant précéder d’un point d’exclamation.
Une fois l’installation terminée, tu peux charger un modèle YOLO26 entraîné et l’exporter directement au format OpenVINO. Comme illustré ci-dessous, un modèle YOLO26n préentraîné (yolo26n.pt) est chargé, puis converti au format OpenVINO à l’aide de la méthode export.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
Une fois le code exécuté, le modèle converti est enregistré dans un nouveau répertoire où tu peux l’utiliser pour le déploiement.
Exporter YOLO26 depuis Ultralytics Platform#
Si tu préfères une méthode plus simple, sans code, tu peux exporter les modèles YOLO26 directement depuis Ultralytics Platform. La plateforme rassemble l’ensemble du workflow de vision par ordinateur dans un espace de travail unique, ce qui facilite le passage de l’entraînement au déploiement sans configuration supplémentaire.
Une fois ton modèle prêt, tu peux l’ouvrir sur la plateforme et accéder à l’onglet Export. De là, tu peux sélectionner OpenVINO comme format d’exportation et, si tu le souhaites, ajuster des paramètres comme la taille de l’image ou la précision.
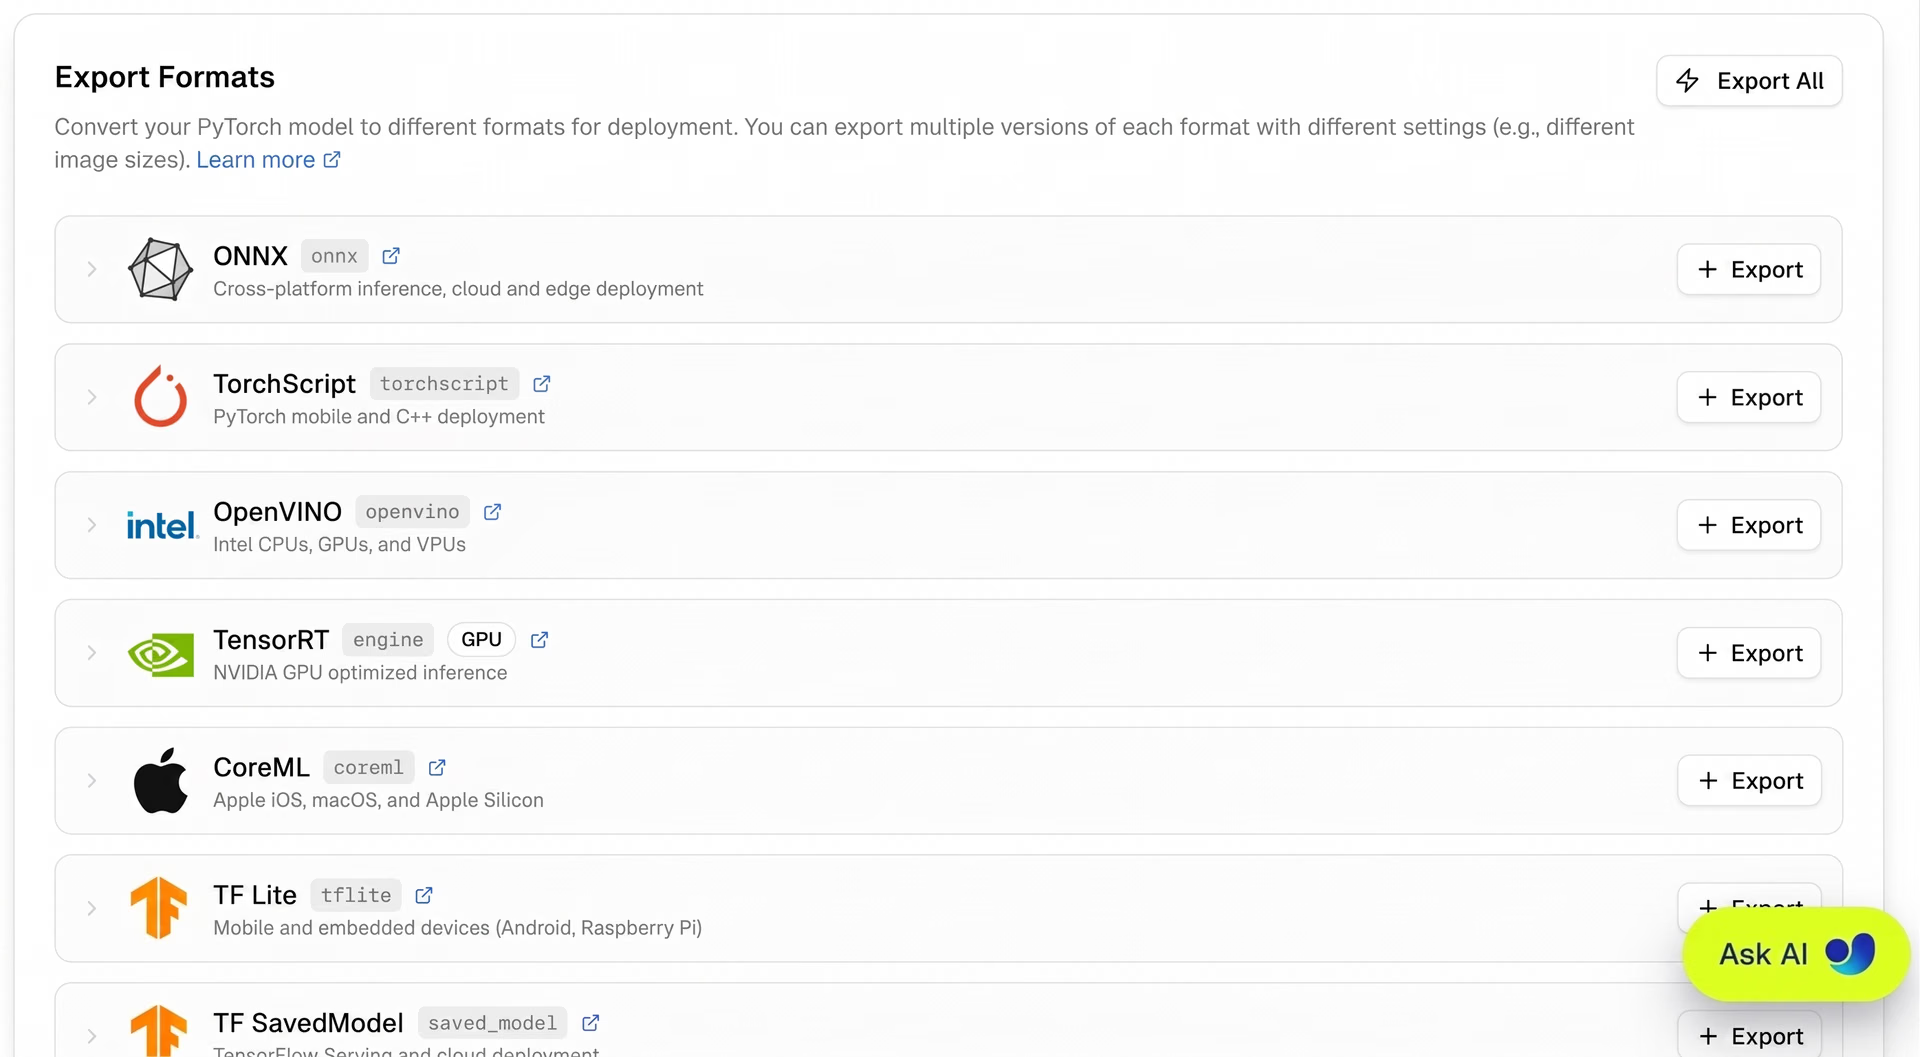
Fig. 4. Exportation de YOLO26 depuis Ultralytics Platform
La plateforme se charge automatiquement de la conversion : tu n’as donc pas à gérer de scripts, de dépendances ni de configuration d’environnement. Une fois l’exportation terminée, tu peux télécharger le modèle optimisé et le déployer sur des CPU, GPU et NPU Intel.
Options de déploiement offertes par l’intégration entre Ultralytics et OpenVINO#
Une fois le modèle YOLO26 exporté au format OpenVINO, tu peux exécuter l’inférence de plusieurs façons, selon ton workflow et le niveau de contrôle souhaité. Tu peux utiliser le package Python Ultralytics pour une approche plus simple et intégrée, ou le runtime OpenVINO natif pour plus de flexibilité et de contrôle.
Exécuter l’inférence avec le package Python Ultralytics#
Une fois ton modèle exporté au format OpenVINO, tu peux exécuter l’inférence avec le package Python Ultralytics. Cette approche est idéale pour les tests rapides et un déploiement simplifié, car elle utilise la même interface que l’entraînement et l’exportation.
Avec cette approche, tu peux charger le modèle OpenVINO exporté depuis son répertoire et exécuter l’inférence sur une entrée comme une image ou une vidéo. Tu peux aussi choisir l’appareil cible en précisant des options comme « intel:cpu », « intel:gpu » ou « intel:npu », selon le matériel disponible sur ton système.
L’extrait de code ci-dessous montre comment charger le modèle exporté et exécuter l’inférence sur une image en ciblant le GPU. Une fois l’inférence terminée, l’image produite est enregistrée dans le répertoire « runs/detect/predict ».
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
Utiliser le package OpenVINO natif pour l’inférence#
Si tu as besoin de mieux contrôler l’exécution de ton modèle en production, tu peux utiliser le runtime OpenVINO natif pour l’inférence. Cette méthode est utile pour intégrer des modèles à des applications plus vastes ou pour ajuster précisément l’exécution de l’inférence sur un matériel spécifique.
OpenVINO fournit une méthode unifiée pour exécuter les modèles sur les CPU, GPU et NPU Intel, ainsi que des fonctionnalités comme l’exécution asynchrone et l’utilisation efficace des ressources de calcul disponibles. Pour configurer cette solution, tu peux travailler directement avec les fichiers du modèle exporté, notamment le fichier .xml qui définit la structure du modèle et le fichier .bin qui contient les poids entraînés.
Selon ton cas d’utilisation, tu peux aussi ajuster des paramètres comme la taille d’entrée ou les étapes de prétraitement. La configuration de l’inférence consiste à initialiser le runtime OpenVINO, à charger et compiler le modèle pour un appareil cible, à préparer les données d’entrée, puis à exécuter l’inférence.
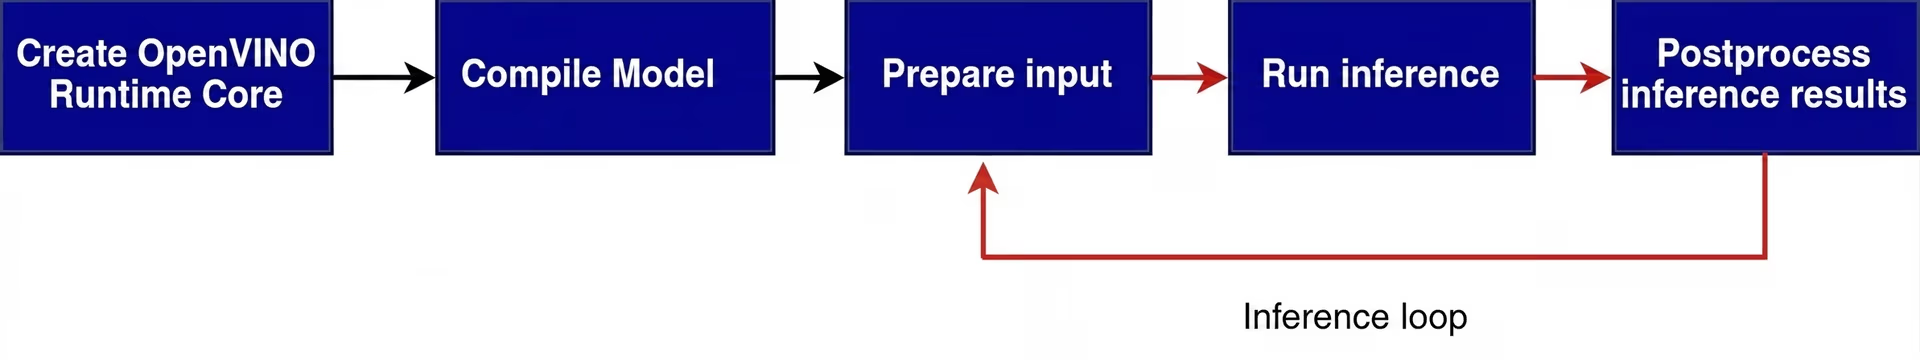
Fig. 5. Exemple de pipeline d’inférence classique avec OpenVINO (Source)
Tu peux ainsi contrôler l’exécution du modèle et son intégration à ton déploiement global. Pour en savoir plus sur la configuration et l’exécution de l’inférence avec le runtime OpenVINO, consulte la documentation officielle d’Ultralytics.
Applications concrètes d’Ultralytics YOLO26 sur du matériel Intel#
La véritable valeur de l’intégration entre Ultralytics et OpenVINO se révèle en production, où une inférence fiable à faible latence peut avoir des retombées concrètes. Voici quelques secteurs clés dans lesquels cette intégration produit des résultats tangibles :
- Industrie manufacturière : en exportant Ultralytics YOLO26 vers OpenVINO, les systèmes de chaîne de production peuvent détecter automatiquement les défauts visuels sur le matériel Intel, comme les composants manquants, les problèmes d’alignement ou les dommages de surface, ce qui contribue à améliorer la qualité des produits et à réduire les erreurs coûteuses.
- Santé : les systèmes d’imagerie médicale et de suivi des patients peuvent exécuter localement les modèles Ultralytics YOLO26 exportés sur du matériel Intel, répondant ainsi à des exigences strictes en matière de confidentialité des données tout en maintenant des performances d’inférence fiables.
- Villes intelligentes : le suivi du trafic et l’analyse des foules peuvent être déployés à l’aide de modèles Ultralytics YOLO26 exportés sur des caméras en périphérie équipées de processeurs Intel. Ils fournissent ainsi des informations en temps réel, notamment le comptage des véhicules, le suivi des piétons et la détection d’incidents.
- Automobile : une faible latence et une bonne efficacité énergétique sont essentielles pour le suivi du conducteur et la détection dans l’habitacle. Le matériel Intel associé aux modèles Ultralytics YOLO26 exportés est donc particulièrement adapté aux systèmes automobiles embarqués.
Pour en savoir plus sur cette intégration, participe à notre série d’ateliers OpenVINO DevCon d’Intel, intitulée « De l’annotation au déploiement : créer un pipeline de détection d’objets avec Geti, Ultralytics YOLO26 et OpenVINO™ ». Notre responsable des partenariats et de l’écosystème, Francesco Mattioli, y retrouvera Adrian Boguszewski, évangéliste des logiciels d’IA chez Intel, pour une démonstration en direct et une présentation de la création de pipelines de vision par ordinateur prêts pour la production et destinés à des scénarios industriels réels. L’atelier présentera un workflow complet de détection d’objets, de bout en bout, de la création du jeu de données et de l’entraînement du modèle à l’optimisation et au déploiement en périphérie.
Avantages du format d’exportation OpenVINO#
Voici quelques-uns des principaux avantages du format d’exportation OpenVINO :
- Accessible et facile à intégrer : grâce à son API unifiée et à plus de 80 notebooks de tutoriels, OpenVINO facilite le passage de l’expérimentation au déploiement sans ajouter de complexité importante.
- Exécuter le même modèle sur différents matériels : OpenVINO te permet d’utiliser un seul modèle exporté sur les matériels Intel pris en charge et de le déployer sur des CPU, GPU ou NPU sans avoir à le réécrire ni à l’adapter à chaque appareil.
- Optimisation intégrée à l’exportation : l’exportation vers OpenVINO convertit les modèles issus de frameworks populaires comme PyTorch et TensorFlow en un format optimisé, prêt pour l’inférence, ce qui élimine le besoin d’étapes de conversion distinctes.
- Meilleure utilisation des ressources matérielles : OpenVINO prend en charge l’inférence asynchrone et l’équilibrage de charge sur le matériel Intel, ce qui contribue à améliorer l’efficacité dans les applications concrètes.
Exécuter Ultralytics YOLO26 avec ExecuTorch et le backend OpenVINO#
Si tu déploies Ultralytics YOLO26 dans des environnements de production plus exigeants, une autre option s’offre à toi : elle associe l’efficacité sur l’appareil à une compression avancée des modèles.
ExecuTorch, le framework d’inférence sur appareil de PyTorch, prend en charge un backend OpenVINO qui te permet de déployer Ultralytics YOLO26 sur du matériel Intel par un autre processus d’exportation et d’exécution.
ExecuTorch se charge de l’exportation du modèle et de son exécution, tandis qu’OpenVINO joue le rôle de couche d’accélération matérielle sous-jacente et gère les calculs proprement dits sur le CPU, le GPU ou le NPU Intel. Les deux fonctionnent de concert pour associer la portabilité et l’efficacité sur appareil d’ExecuTorch aux optimisations propres au matériel fournies par OpenVINO.
Pour en savoir plus sur son fonctionnement et découvrir comment commencer à utiliser Ultralytics YOLO26 avec ExecuTorch et le backend OpenVINO, consulte l’article de blog d’Intel qui présente les dernières nouveautés d’ExecuTorch et OpenVINO.
Points clés à retenir#
L’exportation des modèles YOLO26 par l’intégration entre Ultralytics et OpenVINO améliore les performances sur le matériel Intel sans compliquer ton workflow. Tu peux passer de l’entraînement au déploiement sans remanier ton pipeline. Cette intégration offre ainsi une méthode simple pour exécuter efficacement les modèles sur les CPU, GPU et NPU Intel dans des applications concrètes.
Rejoins notre communauté et explore notre dépôt GitHub pour en savoir plus sur l’IA visuelle. Consulte nos options de licence pour lancer tes projets de vision par ordinateur. Les innovations comme l’IA dans l’industrie manufacturière ou la vision par ordinateur dans le secteur automobile t’intéressent ? Consulte nos pages de solutions pour en découvrir davantage.









