Ultralytics YOLO26 prend désormais en charge l’estimation de profondeur monoculaire
Découvre comment la nouvelle tâche d’estimation de profondeur d’Ultralytics YOLO26 prédit une profondeur métrique pour chaque pixel à partir d’une seule image RGB, sans système stéréo ni LiDAR.
Jusqu’à présent, ajouter la profondeur à un pipeline YOLO signifiait l’assembler soi-même. La méthode établie consistait à utiliser YOLO pour la détection et à l’associer à un modèle de profondeur distinct issu d’un autre projet, comme MiDaS ou Depth Anything. Cela impliquait une deuxième dépendance, un deuxième framework et deux jeux de formats d’entrée et de sortie à harmoniser.
L’estimation de profondeur monoculaire est désormais une tâche native dans Ultralytics YOLO26. Une seule image RGB produit une valeur de distance pour chaque pixel, en utilisant le même paquet, le même flux de travail et le même chemin d’exportation que la détection, la segmentation et l’estimation de pose.
Qu’est-ce que l’estimation de profondeur ?#
L’estimation de profondeur prédit une carte de profondeur par pixel à partir d’une seule image RGB, sans deuxième caméra ni capteur supplémentaire. Chaque pixel de sortie contient une valeur de profondeur en mètres, qui représente la distance estimée entre la caméra et le point de la surface correspondant.
La sortie est une carte dense de nombres à virgule flottante de forme (H, W), alignée sur l’entrée, où chaque pixel représente une distance absolue en mètres : une distance par rapport à la caméra, et non un classement relatif des objets du plus proche au plus éloigné.
La profondeur constitue une tâche autonome avec son propre point de contrôle, et sa sortie se limite à la carte de profondeur ; elle ne renvoie ni boîtes englobantes ni masques de segmentation. Combiner détection et profondeur nécessite donc d’exécuter deux modèles et deux passes avant. La différence avec les pratiques précédentes est que les deux tâches sont désormais réunies dans un seul paquet et partagent une seule installation, une seule interface d’entraînement et de prédiction, un seul chemin d’exportation et une seule version à suivre, au lieu de nécessiter la maintenance d’un deuxième framework en parallèle.
Cette sortie par pixel rend la profondeur utile pour détecter les obstacles et les espaces libres, vérifier les marges de dégagement, comprendre la disposition des scènes et déterminer ce qui se trouve devant quoi.
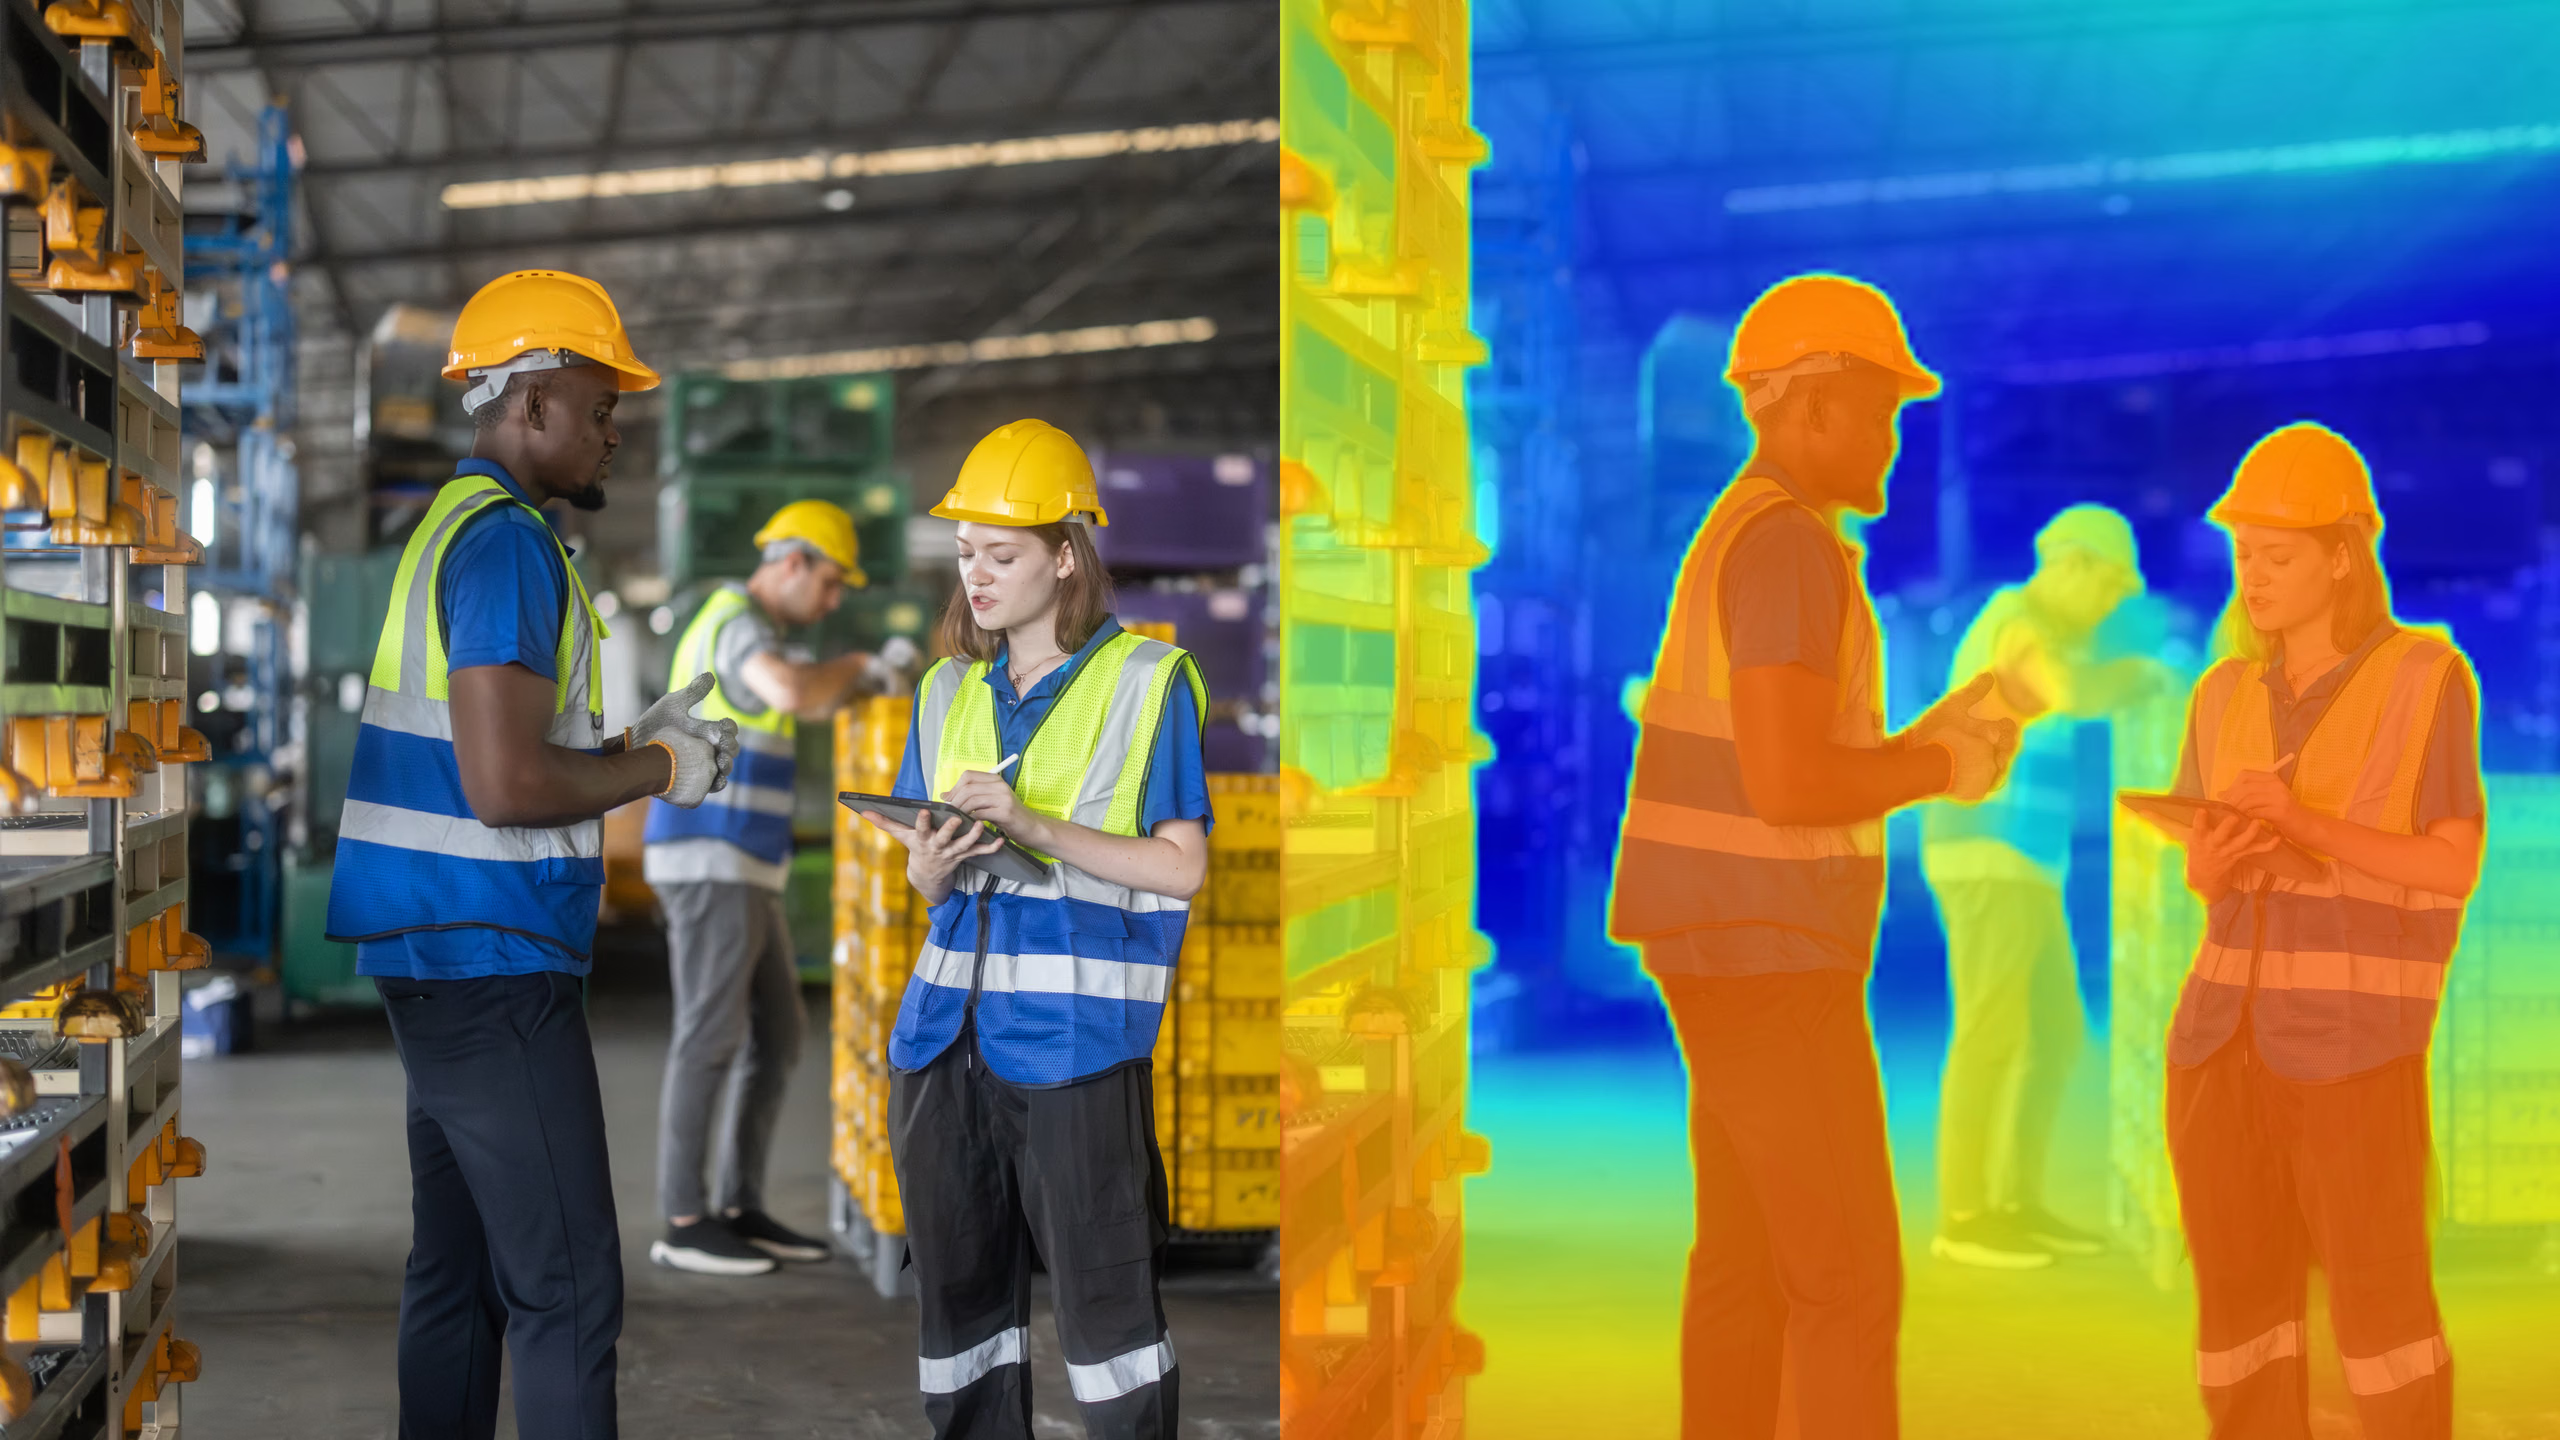 Fig. 1. Estimation de profondeur Ultralytics YOLO26 pour la surveillance de la sécurité et de la conformité.
Ultralytics YOLO26 propose cinq modèles de profondeur préentraînés, de yolo26n-depth à yolo26x-depth, entraînés sur un vaste mélange de plusieurs jeux de données couvrant environ 2,19 millions d’images d’intérieur et d’extérieur. Sur le jeu de données NYU Depth V2, leur précision δ1 va de 0,882 pour le modèle nano à 0,933 pour le modèle extra-large : tu peux donc choisir le compromis entre vitesse et précision qui convient à ta cible de déploiement.
Une profondeur sans limite, par conception#
La plupart des modèles de profondeur plafonnent leurs prédictions à une distance fixe, par exemple de 0 à 10 mètres. Cela fonctionne bien pour les scènes d’intérieur, mais échoue en extérieur. Ultralytics prédit plutôt la profondeur sur une échelle logarithmique sans limite supérieure prédéfinie.
Les tests mettent cette différence en évidence. Un modèle plafonné atteint presque immédiatement un plateau lorsqu’il est entraîné sur des données mixtes d’intérieur et d’extérieur, et s’effondre sur des jeux de données à plus longue portée comme KITTI, où les objets peuvent se trouver à 80 mètres. L’approche d’Ultralytics YOLO26 n’a pas ce plafond : elle continue donc de s’améliorer avec davantage de données et reste performante de quelques centimètres à plusieurs centaines de mètres. Sur KITTI, δ1 atteint 0,942 à une portée de 80 m. Ainsi, une même famille de modèles gère aussi bien une scène de table qu’une scène d’autoroute.
Comparaison entre Ultralytics YOLO26 Depth et Depth Anything V2#
Si tu exécutes aujourd’hui Depth Anything en parallèle de YOLO, la différence se joue sur la vitesse et les coûts de calcul associés. Ultralytics YOLO26 Depth est jusqu’à 20,3× plus rapide que Depth Anything V2 Base et 7,7× plus rapide que Depth Anything V2 Small, tout en reposant sur un modèle bien plus petit : moins de 10 M de paramètres pour la version nano, contre environ 24 M pour le plus petit checkpoint de DA V2.
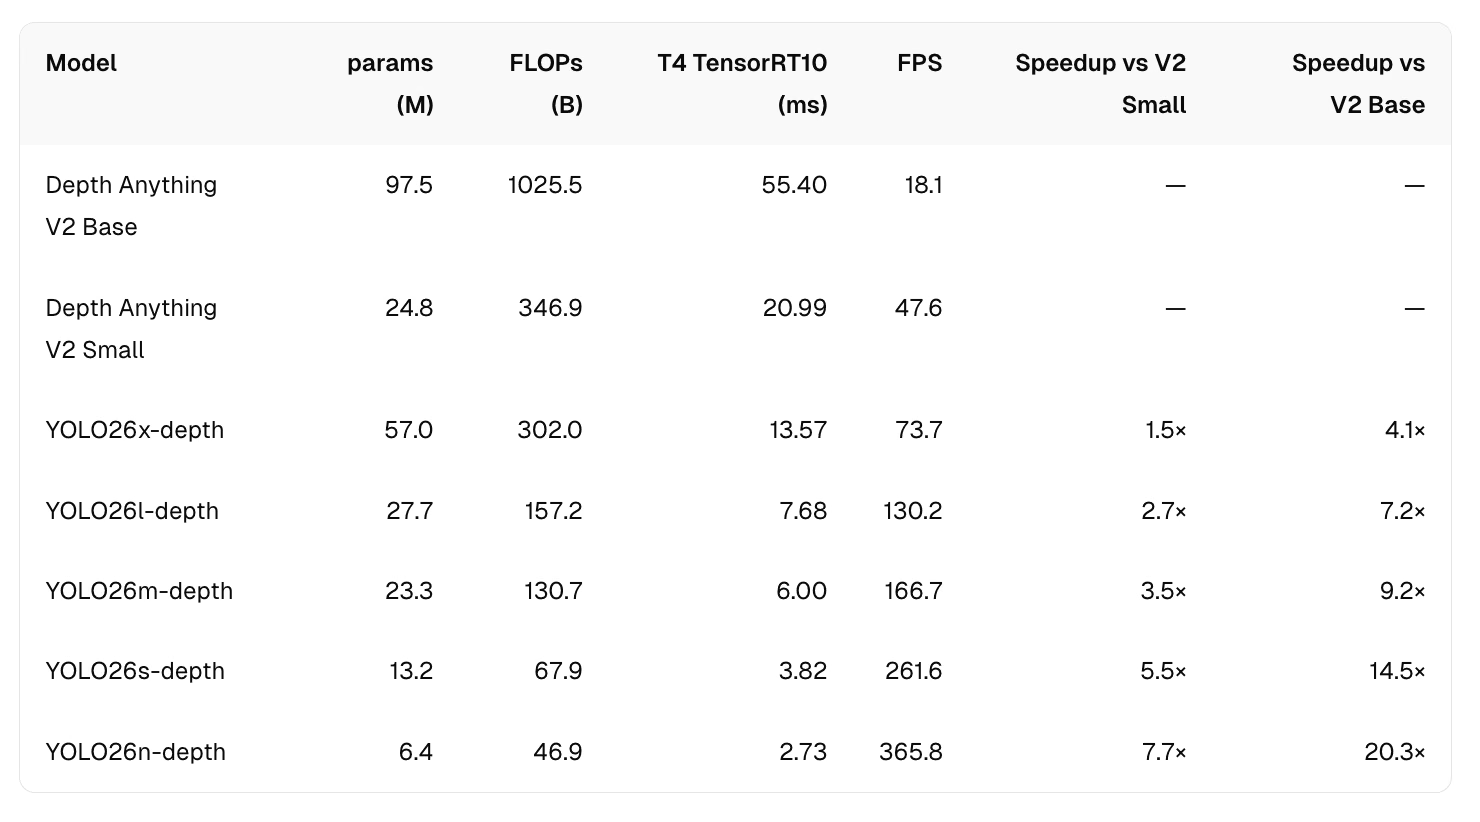 Fig. 2. Tests de vitesse d’Ultralytics YOLO26 Depth face à Depth Anything V2.
C’est là tout l’intérêt de cette conception. Les modèles Depth Anything V2 sont nettement plus volumineux ; Ultralytics YOLO26-Depth vise d’excellentes performances en profondeur dans un format et à une vitesse qui réduisent le calcul par image et permettent un déploiement sur du matériel inaccessible à ces modèles. Les chiffres de précision de chaque modèle sur NYU Depth V2 et KITTI sont publiés dans la documentation : tu peux les comparer aux exigences réelles de ton projet.
Où l’exécuter#
C’est cette différence de taille qui détermine où l’estimation de profondeur peut réellement être utilisée. La plupart des équipes qui évaluent cette technologie ne manquent pas d’idées, mais de puissance de calcul. Les drones basse consommation, les robots quadrupèdes, les objets connectés portables, les caméras embarquées, le matériel de visioconférence et les PC industriels atteignent tous leurs limites de puissance et de coût avant leurs limites de précision.
La profondeur est proposée sous la forme de cinq modèles préentraînés : tu peux choisir la taille adaptée à ta cible plutôt que celle qui remporte un benchmark. Comme la profondeur est une tâche native d’Ultralytics YOLO26, elle utilise le même parcours d’exportation que la détection, la segmentation et l’estimation de pose, avec les formats suivants : ONNX, TensorRT, CoreML, NCNN, LiteRT.
Premiers pas avec l’estimation de profondeur Ultralytics YOLO26#
Le package Python Ultralytics fournit une interface unique et unifiée pour entraîner, valider et lancer l’inférence sur toutes les tâches YOLO26, y compris l’estimation de profondeur. Une seule commande suffit pour exécuter un modèle de profondeur préentraîné :
from ultralytics import YOLO
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-depth.pt")  # charger un modèle officiel
model = YOLO("path/to/best.pt")  # charger un modèle personnalisé

# Effectuer une prédiction avec le modèle
results = model("https://ultralytics.com/images/bus.jpg")  # effectuer une prédiction sur une image

# Accéder aux résultats
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, shape (H, W), mètres
Ou depuis la CLI :
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
La distance absolue dépend de ta caméra et de ta scène. Si la forme de la carte de profondeur est correcte, mais que l’échelle est décalée, model.calibrate() ajuste en quelques secondes deux variables seulement dans la tête de profondeur du modèle — une échelle et un décalage — à partir d’environ 100 images annotées, sans entraînement ni modification du reste du réseau.
Ajustement fin sur tes propres données#
Pour adapter un modèle de profondeur préentraîné à ta caméra ou à ton domaine, pars des poids préentraînés, utilise AdamW et réduis fortement le taux d’apprentissage par rapport à la valeur par défaut pour un entraînement depuis zéro. Ainsi, l’ajustement fin affine le modèle au lieu de l’écraser :
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # partir de poids préentraînés
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100 fois moins que la valeur par défaut pour un entraînement depuis zéro
    warmup_bias_lr=1e-4,  # garder aussi une montée en puissance progressive
)
Comme la tête logarithmique par défaut n’a pas de limite, cette méthode fonctionne directement, que ton jeu de données couvre des distances courtes ou longues, sans nécessiter de réglage max_depth. Si seule l’échelle absolue est incorrecte pour ta caméra, model.calibrate() calcule en quelques secondes une correction légère sous forme fermée à partir d’un petit sous-ensemble annoté, sans toucher aux poids du réseau.
Les jeux de données associent chaque image RVB à un fichier de profondeur .npy dans une arborescence de dossiers correspondante. Ultralytics fournit des configurations intégrées pour NYU Depth V2, KITTI, Hypersim, SUN RGB-D et ARKitScenes, ce qui permet à la plupart des équipes de commencer immédiatement la validation sur un benchmark standard.
Principaux cas d’usage de l’estimation de profondeur#
Comme cette nouvelle fonctionnalité fonctionne à partir d’une simple caméra classique, l’estimation de profondeur monoculaire ouvre d’innombrables possibilités aux produits et aux secteurs qui ne peuvent pas justifier le coût, la consommation d’énergie ou les contraintes d’étalonnage d’un système stéréo ou LiDAR. Voici quelques secteurs et cas d’usage clés qui peuvent en bénéficier :
- Robotique et navigation autonome. Les robots mobiles et les drones peuvent estimer la distance des obstacles et l’espace libre à partir d’une seule caméra embarquée, pour planifier leurs trajectoires en temps réel sans matériel de profondeur dédié.
- Surveillance industrielle et logistique. Vérification des dégagements, détection de l’espace libre et analyse du contexte des rayonnages ou des allées à partir d’une seule caméra fixe, partout où l’ajout d’un deuxième capteur n’est pas pratique.
- Surveillance de la sécurité et de la conformité. Zones de sécurité pour chariots élévateurs et entrepôts, détection d’incidents ferroviaires, détection de personnes ayant chuté ou d’objets laissés sur place à partir des systèmes de vidéosurveillance existants : le contexte de distance est ajouté aux flux des caméras déjà installées, en complément des capteurs de sécurité certifiés existants, et non à leur place.
- Inspection des infrastructures et des actifs. Analyse du dégagement des lignes aériennes, inspection des actifs et de la corrosion par drone et relevés aériens, où une même famille de modèles doit gérer aussi bien les gros plans détaillés que les scènes à longue portée.
- Aide à la conduite et perception automobile. Grâce à une estimation de profondeur sans limite et à longue portée, une même famille de modèles gère aussi bien une scène d’intérieur rapprochée que des scènes de conduite à plus de 80 m.
- RA et contenu spatial. Placer de manière crédible des objets virtuels dans une scène réelle ou appliquer des effets tenant compte de la profondeur commence par déterminer la distance réelle entre chaque pixel et la caméra.
L’estimation de profondeur pour tous les déploiements Ultralytics YOLO26#
L’estimation de profondeur étant désormais une tâche native d’Ultralytics YOLO26, les équipes peuvent exploiter la distance de chaque pixel depuis n’importe quelle caméra RVB, dans tous les secteurs, avec le même flux de travail d’entraînement, de validation, de prédiction et d’exportation qu’elles connaissent déjà pour la détection, la segmentation et l’estimation de pose, tout en réduisant d’une dépendance tierce à maintenir.
Lorsque tu définis le périmètre de ton déploiement avec Ultralytics YOLO26 Depth, voici quelques points clés à garder à l’esprit :
- Ultralytics YOLO Depth est conçu pour les caméras RVB. Toutes les caméras standard conviennent, y compris les webcams, les téléphones, les caméras industrielles et les drones. En revanche, d’autres modalités, comme les nuages de points LiDAR, le radar, le sonar, les bandes thermiques et multispectrales, ou les données de maillage et IFC, ne correspondent pas au format d’entrée du modèle.
- Distance métrique pour les décisions de perception. La sortie indique une distance réelle en mètres, ce qui la rend bien adaptée à la navigation, à la vérification des dégagements et à la surveillance. Toutefois, pour toute application exigeant une tolérance certifiée, les équipements de métrologie dédiés restent l’instrument approprié.
- Inférence image par image. La profondeur est calculée indépendamment pour chaque image, comme pour toutes les autres tâches Ultralytics YOLO26. Elle s’intègre donc à un pipeline existant traitant les images une à une, sans modification. Le raisonnement sur une séquence reste à la charge de ta couche applicative.
- Ultralytics YOLO26-Depth donne ses meilleurs résultats sur les surfaces opaques texturées. Le verre, les miroirs, l’eau stagnante, le métal poli et le ciel dégagé sont intrinsèquement ambigus pour toute méthode utilisant une seule caméra : il est donc conseillé de valider le modèle sur des scènes représentatives de ton environnement.
Tu t’intéresses à l’IA visuelle ? Explore nos options de licence pour intégrer la vision par ordinateur à tes projets. Visite notre dépôt GitHub pour découvrir l’ensemble des tâches et intégrations Ultralytics, et consulte Ultralytics Platform pour commencer à créer tes propres flux de travail de bout en bout en IA visuelle.









