I migliori modelli di rilevamento degli oggetti
Scopri i migliori modelli di rilevamento degli oggetti del 2026, da Ultralytics YOLO a RT-DETR, con un confronto tra architetture, compromessi prestazionali e fattori di distribuzione.
 Abirami Vina13 min di lettura
All'inizio di quest'anno, Andrew Ng, pioniere dell'IA e del machine learning, ha introdotto il concetto di rilevamento agentico degli oggetti. Questo approccio usa un agente di ragionamento per rilevare gli oggetti sulla base di un prompt testuale, senza richiedere grandi quantità di dati di addestramento.
Riuscire a identificare oggetti in immagini e video senza aver bisogno di enormi dataset etichettati è un passo verso sistemi di computer vision più intelligenti e flessibili. Tuttavia, l'IA visiva agentica è ancora agli inizi.
Sebbene sia in grado di gestire attività generiche, come rilevare persone o segnali stradali in un'immagine, le applicazioni di computer vision più precise si basano ancora sui tradizionali modelli di rilevamento degli oggetti. Questi modelli vengono addestrati su dataset ampi ed etichettati con cura per imparare esattamente cosa cercare e dove si trovano gli oggetti.
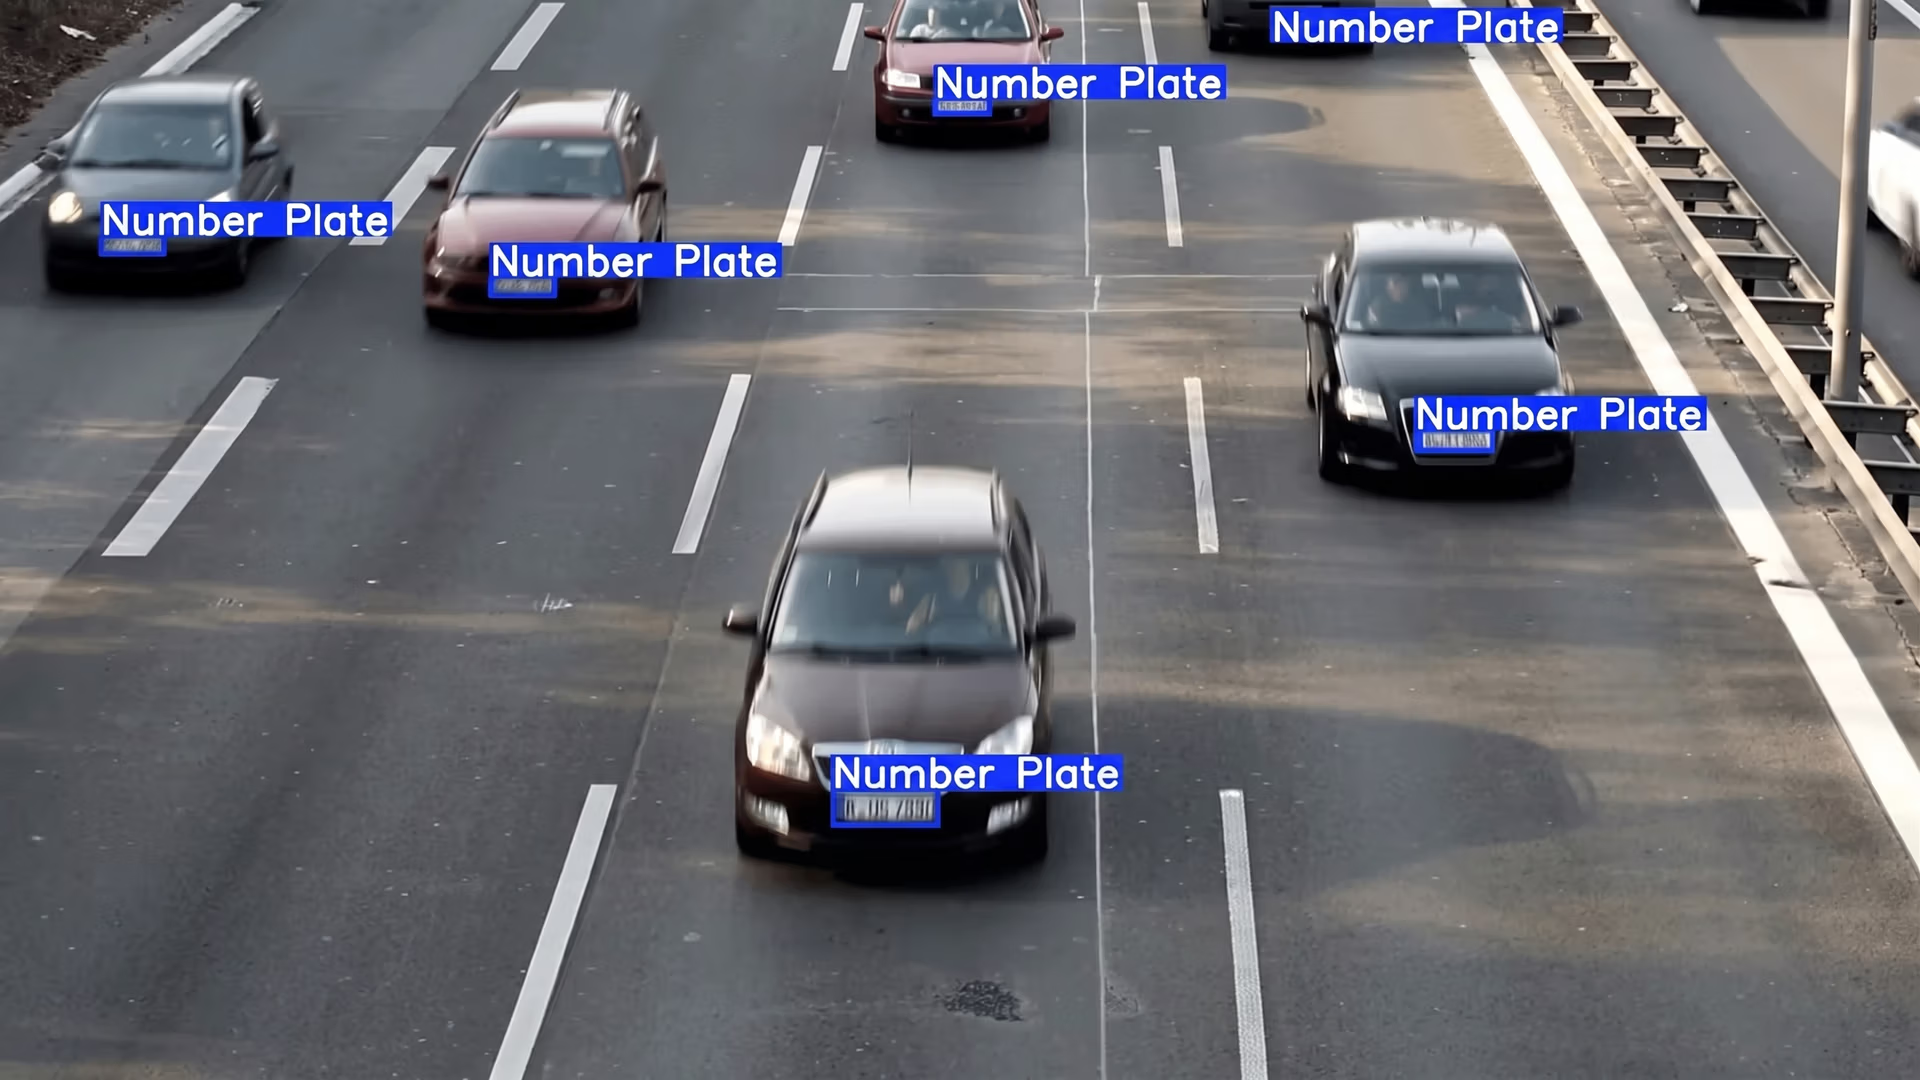
Fig. 1. Esempio di rilevamento degli oggetti. (Fonte)
Il tradizionale rilevamento degli oggetti è essenziale perché offre sia il riconoscimento, ovvero l'identificazione dell'oggetto, sia la localizzazione, cioè la determinazione della sua posizione esatta nell'immagine. Questa combinazione consente alle macchine di svolgere in modo affidabile attività complesse del mondo reale, dai veicoli autonomi all'automazione industriale e alla diagnostica sanitaria.
I modelli di rilevamento degli oggetti continuano a migliorare: diventano più rapidi, più accurati e più adatti agli ambienti reali. In questo articolo illustreremo alcuni dei migliori modelli di rilevamento degli oggetti oggi disponibili.
Perché serve il rilevamento degli oggetti#
Le attività di computer vision, come la classificazione delle immagini, possono stabilire se un'immagine contiene un'auto, una persona o un altro oggetto. Tuttavia, non possono determinare dove si trova l'oggetto nell'immagine.
È qui che entra in gioco il rilevamento degli oggetti. I modelli di rilevamento degli oggetti possono identificare quali oggetti sono presenti e individuarne anche la posizione esatta. Questo processo, noto come localizzazione, consente alle macchine di comprendere le scene con maggiore precisione e reagire nel modo opportuno, che si tratti di fermare un'auto a guida autonoma, guidare un braccio robotico o evidenziare un'area in un'immagine medica.
La diffusione del deep learning ha trasformato il rilevamento degli oggetti. Invece di basarsi su regole codificate manualmente, i modelli moderni imparano schemi direttamente dalle annotazioni e dai dati visivi. Questi dataset insegnano ai modelli l'aspetto degli oggetti, dove tendono a comparire e come affrontare difficoltà come oggetti piccoli, scene affollate o condizioni di illuminazione variabili.
In effetti, i sistemi di rilevamento degli oggetti all'avanguardia riescono a rilevare con precisione più oggetti contemporaneamente. Questo rende il rilevamento degli oggetti una tecnologia fondamentale in applicazioni come la guida autonoma, la robotica, l'assistenza sanitaria e l'automazione industriale.
Come funzionano le attività di rilevamento degli oggetti#
L'input di un modello di rilevamento degli oggetti è un'immagine, che può provenire da una telecamera, da un fotogramma video o persino da una scansione medica. L'immagine di input viene elaborata da una rete neurale, in genere una rete neurale convoluzionale (CNN), addestrata a riconoscere schemi nei dati visivi.
All'interno della rete, l'immagine viene analizzata in più fasi. In base alle caratteristiche rilevate, il modello prevede quali oggetti sono presenti e dove si trovano.
Queste previsioni sono rappresentate da riquadri di delimitazione, ovvero rettangoli disegnati attorno a ogni oggetto rilevato. A ciascun riquadro di delimitazione il modello assegna un'etichetta di classe (ad esempio, auto, persona o cane) e un punteggio di confidenza che indica il grado di certezza della previsione (interpretabile anche come una probabilità).
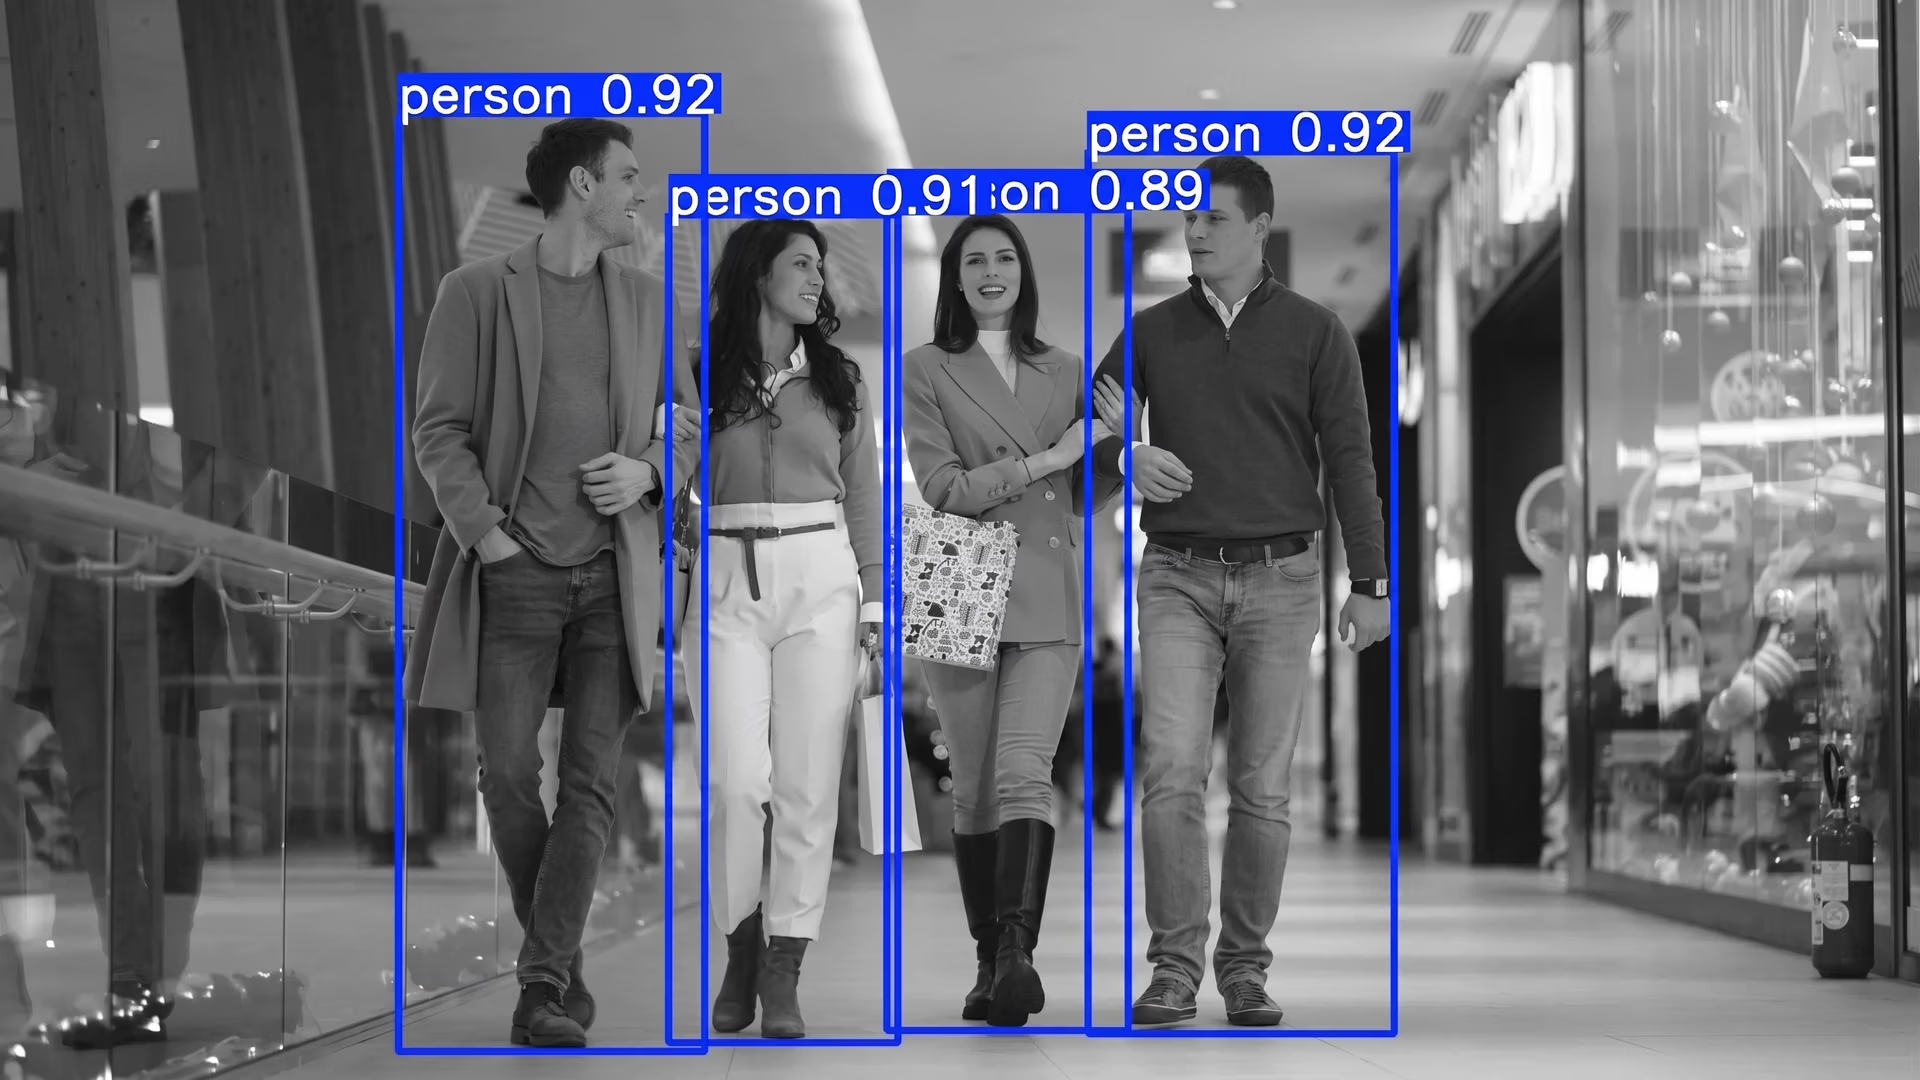
Fig. 2. Le previsioni del rilevamento degli oggetti possono essere visualizzate con riquadri di delimitazione.
Il processo complessivo si basa in larga misura sull'estrazione delle caratteristiche. Il modello impara a identificare schemi visivi utili, come bordi, forme, texture e altre caratteristiche distintive. Questi schemi vengono codificati in mappe di caratteristiche, che aiutano la rete a comprendere l'immagine a diversi livelli di dettaglio.
Rilevamento degli oggetti: a due fasi e a fase singola#
A seconda dell'architettura del modello, i rilevatori di oggetti usano strategie diverse per localizzare gli oggetti, bilanciando velocità, precisione e complessità.
Molti modelli di rilevamento degli oggetti, in particolare i rilevatori a due fasi come Faster R-CNN, si concentrano su parti specifiche dell'immagine chiamate regioni di interesse (ROIs). Concentrandosi su queste aree, il modello dà priorità alle regioni che hanno maggiori probabilità di contenere oggetti, invece di analizzare ogni pixel allo stesso modo.
I modelli a fase singola, invece, come i primi modelli YOLO, non selezionano regioni di interesse specifiche come fanno quelli a due fasi. Suddividono l'immagine in una griglia e usano riquadri predefiniti, chiamati riquadri di ancoraggio, insieme alle mappe di caratteristiche per prevedere gli oggetti nell'intera immagine in un unico passaggio.
Molti modelli moderni di rilevamento degli oggetti, compresi i più recenti modelli Ultralytics YOLO, usano approcci anchor-free. A differenza dei tradizionali modelli a singolo stadio, che si basano su anchor box predefinite, i modelli anchor-free prevedono direttamente posizione e dimensioni degli oggetti a partire dalle mappe di caratteristiche. Ciò può semplificare l'architettura, ridurre il carico computazionale e migliorare le prestazioni, soprattutto nel rilevamento di oggetti di forme e dimensioni diverse.
Uno sguardo ai migliori modelli di rilevamento degli oggetti#
Oggi esistono molti modelli di rilevamento degli oggetti, ognuno progettato con obiettivi specifici. Alcuni sono ottimizzati per le prestazioni in tempo reale, mentre altri puntano alla massima precisione. La scelta del modello giusto per una soluzione di computer vision dipende spesso dal caso d'uso specifico e dai requisiti di prestazioni.
Ora esploriamo alcuni dei migliori modelli di rilevamento degli oggetti del 2026.
1. Modelli Ultralytics YOLO#
Una delle famiglie di modelli di rilevamento degli oggetti più utilizzate oggi è quella dei modelli Ultralytics YOLO. YOLO, acronimo di You Only Look Once, è popolare in diversi settori perché offre prestazioni di rilevamento elevate ed è al contempo veloce, affidabile e facile da usare.
La famiglia Ultralytics YOLO comprende Ultralytics YOLOv5, Ultralytics YOLOv8, Ultralytics YOLO11 e il più recente Ultralytics YOLO26, offrendo diverse opzioni per soddisfare requisiti di prestazioni e casi d'uso differenti. Grazie al design leggero e all'ottimizzazione della velocità, i modelli Ultralytics YOLO sono ideali per il rilevamento in tempo reale e possono essere distribuiti su dispositivi edge con potenza di calcolo e memoria limitate.
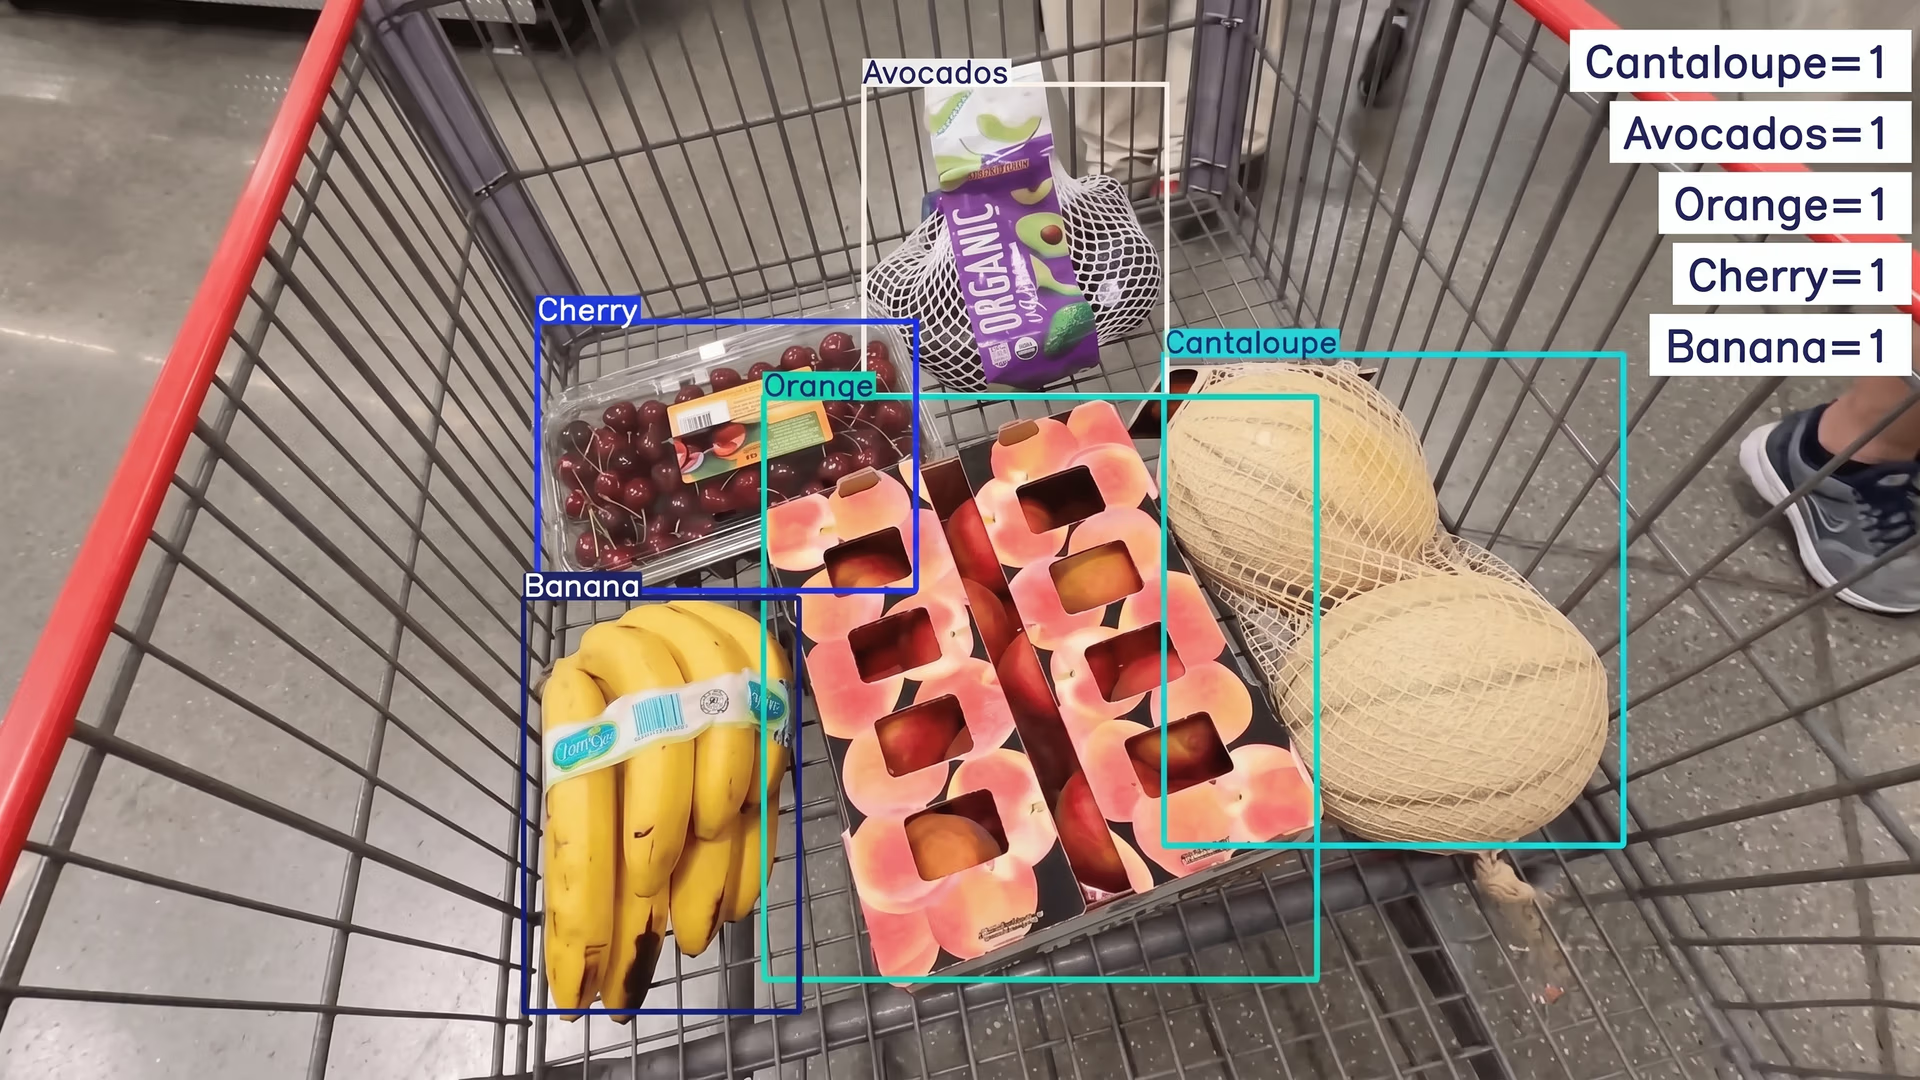
Fig. 3. Uso di Ultralytics YOLO11 per il rilevamento degli oggetti (Fonte)
Oltre al semplice rilevamento degli oggetti, questi modelli sono molto versatili. Supportano anche attività come la segmentazione delle istanze, che delimita gli oggetti a livello di pixel, e la stima della posa, che individua i punti chiave di persone o oggetti. Questa flessibilità rende i modelli Ultralytics YOLO una scelta ideale per un'ampia gamma di applicazioni, dall'agricoltura e la logistica al commercio al dettaglio e alla produzione.
Un altro motivo fondamentale della popolarità dei modelli Ultralytics YOLO è il pacchetto Python Ultralytics, che offre un'interfaccia semplice e intuitiva per addestrare, perfezionare e distribuire i modelli. Gli sviluppatori possono partire da pesi pre-addestrati, personalizzare i modelli per i propri dataset e distribuirli con poche righe di codice.
2. RT-DETR e RT-DETRv2#
RT‑DETR (Transformer per il rilevamento in tempo reale) e il più recente RT‑DETRv2 sono modelli di rilevamento degli oggetti progettati per l'uso in tempo reale. A differenza di molti modelli tradizionali, possono elaborare un'immagine e restituire direttamente i rilevamenti finali senza usare la soppressione non massima (NMS).
NMS è una fase che rimuove i riquadri sovrapposti in eccesso quando un modello prevede più volte lo stesso oggetto. Saltare NMS semplifica e velocizza il processo di rilevamento.
Questi modelli combinano CNN e Transformer. La CNN individua dettagli visivi come bordi e forme, mentre il Transformer è un tipo di rete neurale capace di analizzare l'intera immagine in una volta e comprendere le relazioni tra le diverse parti. Questa comprensione complessiva consente al modello di rilevare oggetti vicini o sovrapposti.
RT‑DETRv2 migliora il modello originale con funzionalità come il rilevamento multiscala, che aiuta a individuare oggetti sia piccoli sia grandi, e una gestione migliore delle scene complesse. Queste modifiche mantengono il modello veloce e ne migliorano la precisione.
3. RF-DETR#
RF‑DETR è un modello basato su Transformer per il tempo reale, progettato per combinare la precisione delle architetture Transformer con la velocità richiesta dalle applicazioni reali. Come RT‑DETR e RT‑DETRv2, usa un Transformer per analizzare l'intera immagine e una CNN per estrarre caratteristiche visive dettagliate, come bordi, forme e texture.
Il modello prevede gli oggetti direttamente dall'immagine di input, saltando i riquadri ancora e la soppressione dei massimi non locali; in questo modo semplifica il processo di rilevamento e mantiene veloce l'inferenza. RF‑DETR supporta anche la segmentazione delle istanze, consentendo di delimitare gli oggetti a livello di pixel oltre a prevedere i riquadri di delimitazione.
4. EfficientDet#
Rilasciato alla fine del 2019, EfficientDet è un modello di rilevamento degli oggetti progettato per offrire scalabilità efficiente e prestazioni elevate. EfficientDet si distingue per la scalabilità composta, un metodo che ridimensiona simultaneamente la risoluzione di input, la profondità della rete e la larghezza della rete, invece di modificare un solo fattore. Questo approccio aiuta il modello a mantenere una precisione stabile, sia quando viene ampliato per attività ad alte prestazioni sia quando viene ridotto per distribuzioni leggere.
Un altro componente chiave di EfficientDet è la rete piramidale delle caratteristiche efficiente (FPN), che consente al modello di analizzare le immagini a più scale. Questa analisi multiscala è fondamentale per rilevare oggetti di dimensioni diverse e permette a EfficientDet di identificare con affidabilità oggetti piccoli e grandi nella stessa immagine.
5. PP-YOLOE+#
Rilasciato nel 2022, PP-YOLOE+ è un modello di rilevamento degli oggetti in stile YOLO, cioè rileva e classifica gli oggetti con un solo passaggio sull'immagine. Questo approccio lo rende rapido e adatto alle applicazioni in tempo reale, mantenendo comunque un'elevata precisione.
Uno dei principali miglioramenti di PP-YOLOE+ è l'apprendimento allineato al compito, che aiuta i punteggi di confidenza del modello a riflettere la precisione con cui vengono localizzati gli oggetti. È particolarmente utile per rilevare oggetti piccoli o sovrapposti.
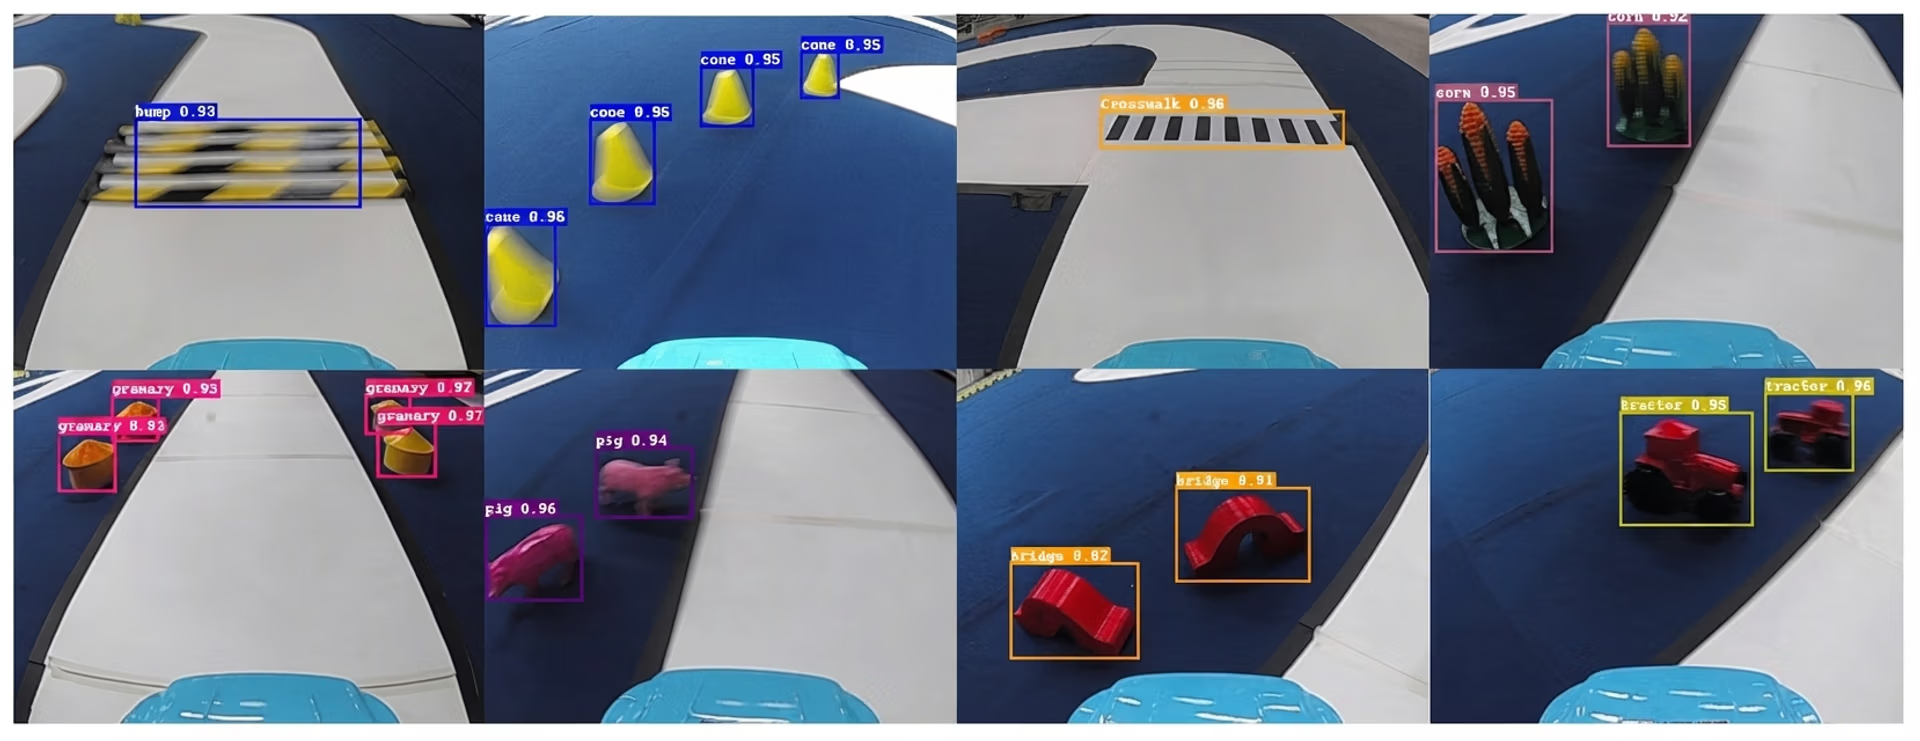
Fig. 4. Rilevamento degli oggetti con PP-YOLOE+ (Fonte)
Il modello utilizza anche un'architettura a testa disaccoppiata, che separa le attività di previsione delle posizioni degli oggetti e delle etichette di classe. Questo gli consente di tracciare riquadri di delimitazione più precisi e classificare correttamente gli oggetti.
6. GroundingDINO#
GroundingDINO è un modello di rilevamento degli oggetti basato su Transformer che combina visione e linguaggio. Invece di affidarsi a un insieme fisso di categorie, consente agli utenti di rilevare oggetti usando prompt testuali in linguaggio naturale.
Allineando le caratteristiche visive di un'immagine alle descrizioni testuali, il modello può localizzare gli oggetti anche se le relative etichette non erano presenti nei dati di addestramento. Puoi quindi fornire al modello descrizioni come «una persona con un casco» o «un'auto rossa vicino a un edificio» e il modello traccerà le bounding box attorno agli oggetti corrispondenti.
Inoltre, grazie al supporto del rilevamento zero-shot, GroundingDINO riduce la necessità di riaddestrare o perfezionare il modello per ogni nuovo caso d'uso, rendendolo flessibile per un'ampia gamma di applicazioni. Per confrontarlo con altri rilevatori open-vocabulary e modelli visione-linguaggio su dataset reali, consulta la classifica VLM.
Metriche comuni per valutare i rilevatori di oggetti#
Quando confronti diversi modelli di rilevamento degli oggetti, potresti chiederti come capire quale offre davvero le prestazioni migliori. È una domanda legittima, perché oltre all'architettura del modello e alla qualità dei dati, molti fattori possono influire sulle prestazioni.
I ricercatori si affidano spesso a benchmark condivisi e metriche standard di prestazione per valutare i modelli in modo coerente, confrontare i risultati e comprendere i compromessi tra velocità e precisione. I benchmark standard sono particolarmente importanti perché molti modelli di rilevamento degli oggetti vengono valutati sugli stessi dataset, come il dataset COCO.
Misurare la precisione e la velocità del rilevamento#
Ecco alcune metriche comuni usate per valutare i modelli di rilevamento degli oggetti:
- Intersezione sull'unione (IoU): questa metrica misura la sovrapposizione tra una bounding box prevista e l'oggetto reale nell'immagine. Confronta la box tracciata dal modello con quella di riferimento, che indica la posizione dell'oggetto secondo l'annotazione del dataset. L'IoU si calcola dividendo l'area di sovrapposizione per l'area dell'unione delle due box. Un IoU più alto indica che la box è posizionata con maggiore precisione, mentre un IoU più basso significa che la previsione è meno precisa. In parole semplici, l'IoU indica quanto le previsioni del modello corrispondono alle posizioni reali degli oggetti.
- Precisione media (mAP): è la metrica principale usata per valutare le prestazioni complessive nel rilevamento degli oggetti. Tiene conto sia del numero di oggetti rilevati correttamente dal modello sia della precisione dei rilevamenti a diversi livelli di confidenza e per diverse categorie di oggetti.
- Fotogrammi al secondo (FPS) e latenza: FPS indica quante immagini o fotogrammi video un modello può elaborare in un secondo. Per esempio, un modello che funziona a 30 FPS può gestire 30 fotogrammi al secondo. Un valore FPS più alto significa che il sistema può rispondere più rapidamente, un aspetto importante per casi d'uso come video in diretta, monitoraggio del traffico o robotica. La latenza, invece, misura quanto tempo impiega il modello a elaborare una singola immagine o un singolo fotogramma, dal momento della ricezione fino alla disponibilità del risultato.
Vantaggi e svantaggi degli algoritmi di rilevamento degli oggetti#
Ecco alcuni dei principali vantaggi dei modelli di rilevamento degli oggetti nelle applicazioni reali:
- Applicabili a diversi settori: il rilevamento degli oggetti può essere impiegato in un'ampia gamma di casi d'uso, dal monitoraggio del traffico e l'analisi del commercio al dettaglio alla sanità, all'agricoltura e alla produzione.
- Riduzione del lavoro manuale: automatizzare le attività di ispezione visiva e monitoraggio riduce la necessità di una supervisione umana continua e aiuta i team a concentrarsi su attività a maggior valore.
- Vantaggi degli ecosistemi open source: le community open source attive e le risorse su GitHub facilitano l'accesso ai modelli preaddestrati, la sperimentazione e la personalizzazione delle soluzioni.
Nonostante questi vantaggi, esistono limiti pratici che possono influire sulle prestazioni dei modelli di rilevamento degli oggetti. Ecco alcuni fattori importanti da considerare:
- Requisiti di dati di alta qualità: i modelli di rilevamento degli oggetti si basano su dataset ampi e ben annotati per l'addestramento. Creare e mantenere questi dati può richiedere molto tempo, essere costoso e risultare difficile da scalare.
- Esigenze di calcolo: i modelli che offrono una maggiore precisione di rilevamento richiedono spesso una notevole potenza di elaborazione, sia durante l'addestramento sia nella distribuzione in tempo reale. In genere è quindi necessario usare GPU ad alte prestazioni, con un possibile aumento dei costi infrastrutturali.
- Sensibilità alle condizioni reali: variazioni di illuminazione, angolazione della fotocamera, condizioni meteorologiche e affollamento delle scene possono influire sulle prestazioni di rilevamento, rendendo necessari test e ottimizzazioni continui.
Punti chiave#
Il modello di rilevamento degli oggetti più adatto al tuo progetto di visione artificiale dipende dal caso d'uso, dalla configurazione dei dati, dai requisiti di prestazione e dai vincoli hardware. Alcuni modelli sono ottimizzati per la velocità, mentre altri puntano sulla precisione; la maggior parte delle applicazioni reali richiede un equilibrio tra entrambe. Grazie ai framework open source e alle community attive su GitHub, è sempre più facile valutare, adattare e distribuire questi modelli per applicazioni pratiche.
Per saperne di più, esplora il nostro repository GitHub. Unisciti alla nostra community e consulta le pagine delle nostre soluzioni per approfondire applicazioni come l'IA in sanità e la visione artificiale nel settore automobilistico. Scopri le nostre opzioni di licenza per iniziare oggi stesso con l'IA per la visione.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









