最適な深度推定モデル:選び方
Depth Anything、Depth Pro、Metric3D、UniDepth、Ultralytics YOLO26などの単眼深度モデルを比較し、メートル単位の深度、エッジデバイス、ロボティクスに適したモデルを検討します。
深度推定モデルを選ぶ際は、主に3つの点を考慮します。距離をメートル単位で求める必要があるか、それとも相対深度で十分か、どこで実行するか、そしてライセンスが用途を許可しているかです。相対深度や研究用途では、まずDepth AnythingとMarigoldを有力候補として評価してください。未知のカメラからメートル単位の深度を得る場合はDepth ProとUniDepthを検討してください。カメラの焦点距離が分かっている場合は、Metric3D v2とDepth Anything 3 Metricも選択肢になります。エッジハードウェア向けには、Depth Anything V2 Small、MiDaS v3.1 Swin2-Tiny、LeViTモデルを候補に絞り、使用するデバイスでレイテンシを測定してください。他のUltralytics YOLOタスクと併せてNVIDIA GPUで低レイテンシの深度推定を行う場合は、Ultralytics YOLO26 depthも評価してください。このガイドでは9つの単眼深度モデルを比較し、選択の判断手順を紹介します。
このタスクを初めて利用する場合は、まず単眼深度推定とは何かをご覧ください。このページではモデルの選び方を説明します。
まず相対深度かメートル単位の深度かを決める#
- 相対深度は、未知のスケールで各ピクセルが近いか遠いかを示します。シーン理解、背景エフェクト、距離に基づくオブジェクトの順位付けにはこれで十分です。
- メートル単位の深度は、距離をメートルで示します。測定、ロボットの動作計画、または他のセンサーとの深度データの統合に必要です。
メートル単位のモデルは、それぞれ異なる方法で実際のスケールを推定します。カメラの焦点距離をモデル自身が推定するもの、ユーザーが指定する必要のあるもの、固定スケールを持ち、使用するカメラに合わせてキャリブレーションするものがあります。モデルがスケールをどのように得るかは、ベンチマーク精度のわずかな差より、実際の運用で重要になる場合があります。2種類の深度について詳しくは、用語集の深度推定をご覧ください。
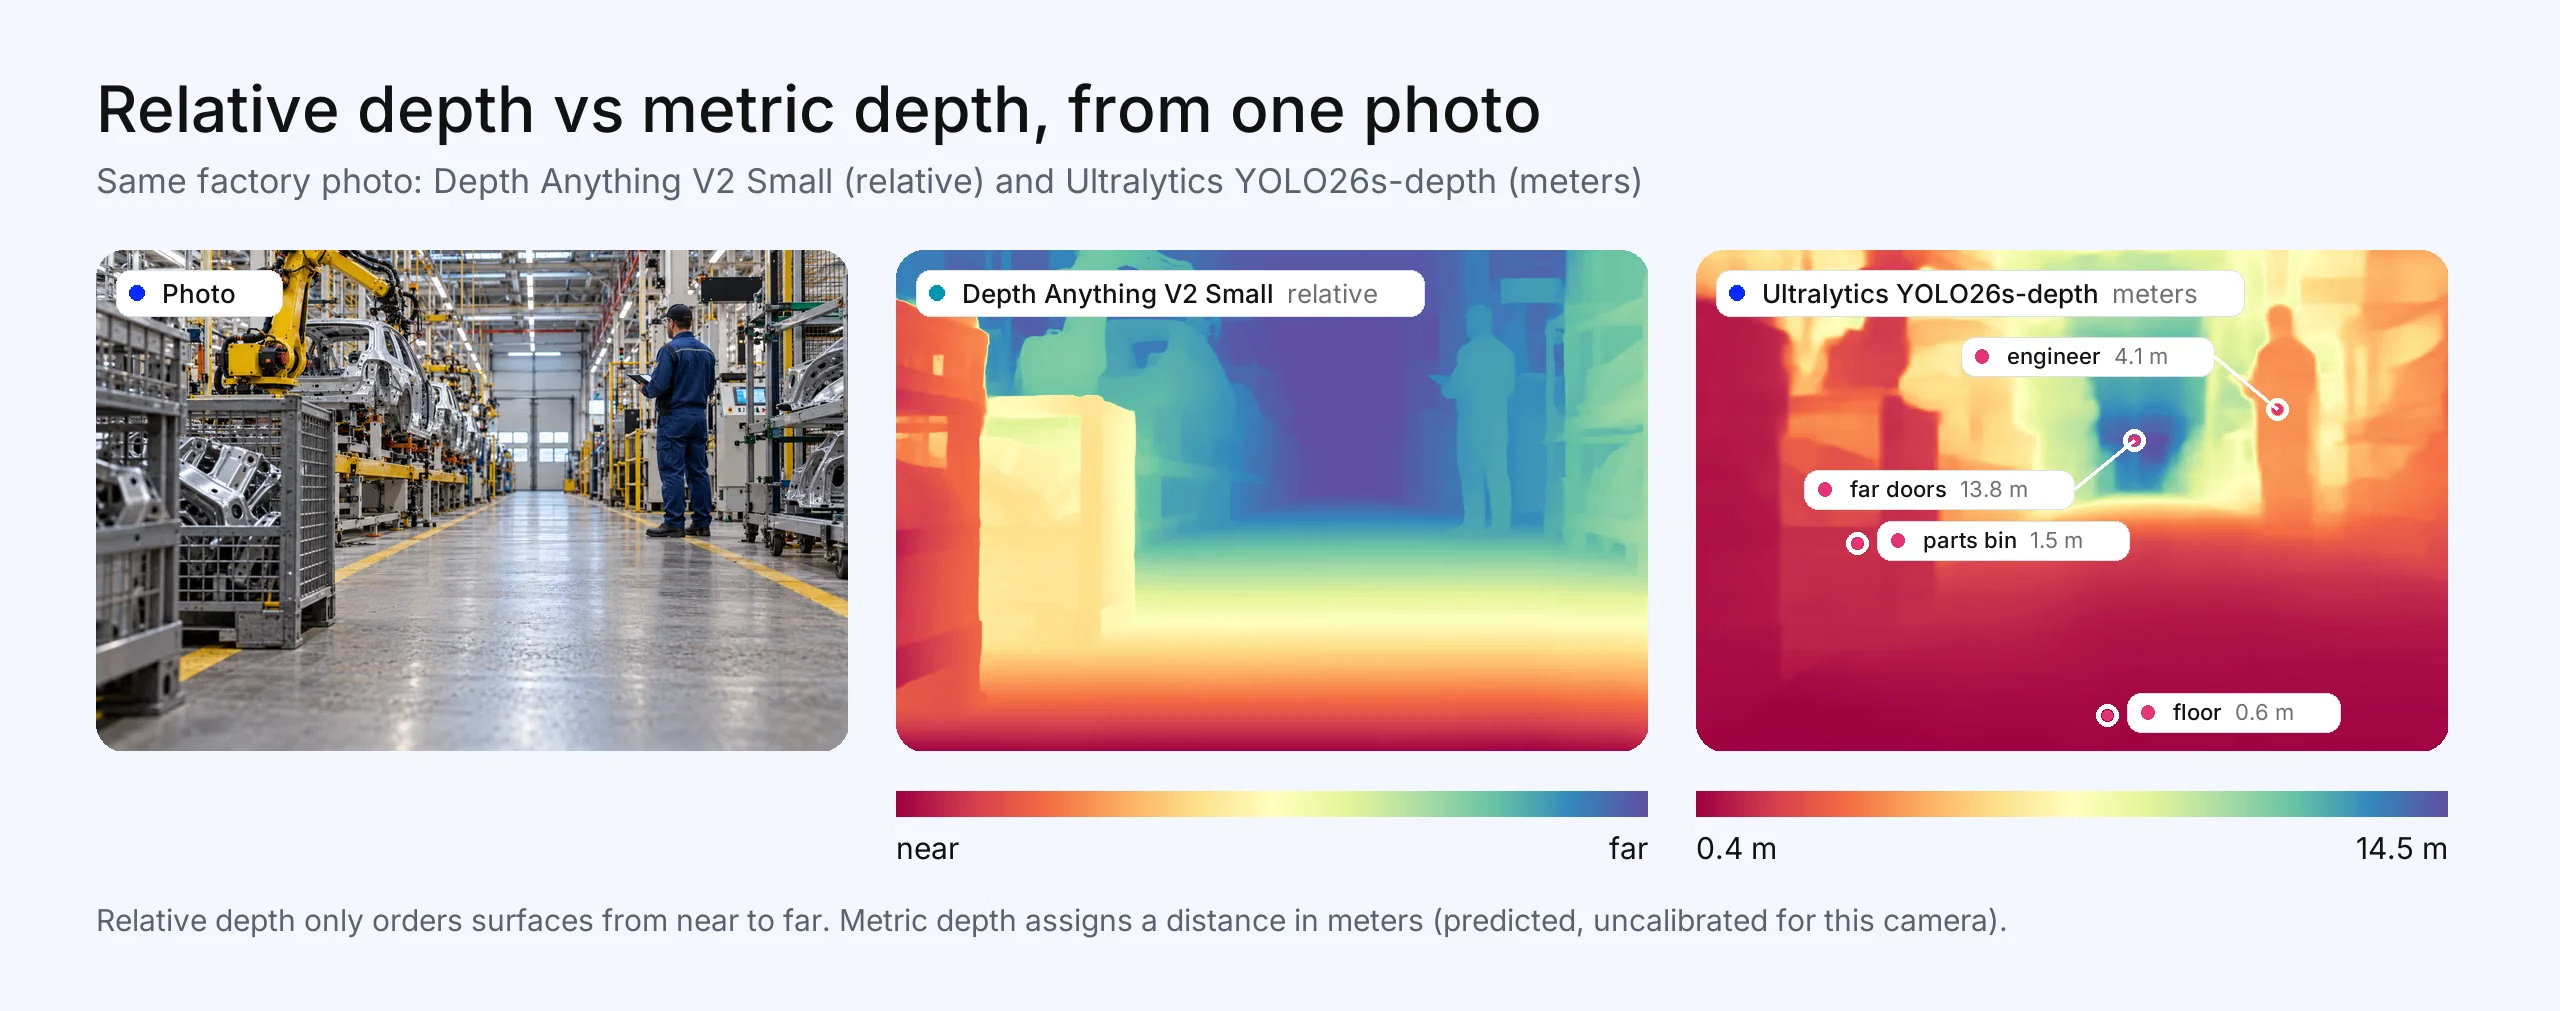
図1. 同じ工場の写真を、相対深度(単位はなく、近いか遠いかを示す)を予測するDepth Anything V2 Smallと、メートル単位で予測するUltralytics YOLO26s-depthで処理したものです。部品箱まで約1.5 m、技術者まで4.1 m、奥のドアまで13.8 mと推定されています。この写真は本記事用に生成したもので、どちらの深度マップも実際のモデル出力です。距離は公開済みチェックポイントによる予測値であり、このカメラ用にキャリブレーションされていないため、実測値ではありません。
深度推定モデルの比較#
モデルは順位付けせず、アルファベット順に記載しています。各論文でベンチマークの手順が異なり、結果を直接比較できないため、モデル間の精度の数値は掲載していません。ライセンスは2026年10月時点で確認しており、チェックポイントごとに適用されます。
| モデル | 出力 | サイズ | ライセンス | 最適な用途 | 主なトレードオフ |
|---|---|---|---|---|---|
| Depth Anything 3 | 相対深度、または既知の焦点距離を用いたメートル単位の深度(DA3Metric) | Small 0.08BからGiant 1.15Bまで、および1.40BのNestedモデル(プロジェクトの記載による) | Small、Base、Metric-Large、Mono-Large:Apache 2.0。Large、Giant、Nested:CC BY-NC 4.0 | 深度に加え、マルチビュー幾何とカメラ姿勢を推定 | 大型モデルは非商用です。DA3Metric-Largeにはカメラの焦点距離が必要です(非商用のNestedモデルは直接メートル単位で出力します)。 |
| Depth Anything V2 | 相対深度、または屋内・屋外用の個別のメートル単位チェックポイント | Small 24.8M、Base 97.5M、Large 335.3M | Small:Apache 2.0。BaseおよびLarge:CC-BY-NC-4.0 | 汎用性に優れた堅牢な相対深度 | 商用利用が許可されているのはSmallのみです。メートル単位のチェックポイントの上限は屋内で20 m、屋外で80 mです。 |
| Depth Pro(Apple) | カメラ内部パラメーターなしでメートル単位の深度を推定 | 1つのモデル | コードと重みにはApple独自のライセンスが適用されます | カメラが不明な写真から高精度なメートル単位の深度を推定 | エッジモデルより高負荷です。用途に適したライセンス条件か確認してください。 |
| Marigold | 相対深度(アフィン不変) | 潜在拡散モデルを基盤に構築 | コード:Apache 2.0。モデル:RAIL++-M | 速度よりも細部の精度を重視する場合 | 特にアンサンブルを行う場合、単一パスのモデルより低速です |
| Metric3D v2 | メートル単位の深度と表面法線 | ViT-Small、ViT-Large、ViT-giant2 | コード: BSD-2-Clause。チェックポイントの利用条件を確認してください | 3D再構成向けのメートル単位の深度と法線 | 正しいスケールを得るには、正確な焦点距離が必要です |
| MiDaS | 相対深度 | BEiT-Large 512からSwin2-Tiny 256、LeViT 224までを含むv3.1 | MIT | 寛容なライセンスと組み込み向けバリアントで知られるベースライン | 新しい基盤モデルより古く、リポジトリはアーカイブされ、メンテナンスも終了しています |
| Ultralytics YOLO26の深度推定 | メートル単位。キャリブレーション可能な単一のグローバルスケールです | n 6.3Mからx 57.0Mまで | AGPL-3.0、またはUltralytics Enterpriseライセンス | NVIDIA GPU上で、ほかのYOLOタスクと並行して低レイテンシの深度推定を実行できます | 絶対スケールにはカメラのキャリブレーションが必要です。また、共通の精度評価プロトコルでほかのモデルと比較されていません |
| UniDepth V2 | 1枚の画像から、メートル単位の深度とカメラの内部パラメーターを推定します | ViT-S、ViT-B、ViT-Lのバックボーン | CC BY-NC 4.0 | カメラが不明な場合のメートル単位の深度推定 | 非営利ライセンス |
| ZoeDepth | 相対深度の事前学習を基盤とした、メートル単位の深度推定(屋内、屋外、または両方のヘッド) | ViTベース | MIT | 既知の屋内または屋外ドメイン向けの、寛容なライセンスのメートル単位深度モデル | 特定の屋内・屋外ドメイン向けに学習されており、リポジトリはアーカイブされ、メンテナンスも終了しています |
深度推定モデルの選び方#
次の質問に順番に答えてください。
- メートル単位の深度が必要ですか? 必要ない場合は、Depth Anything V2またはDepth Anything 3から始めてください。MITライセンスを希望する場合はMiDaSを選びます。
- カメラの内部パラメーターは分かっていますか? 分からない場合は、内部パラメーターを推定するDepth ProまたはUniDepthを選びます。分かっている場合は、Metric3D v2とDepth Anything 3 Metricで利用できます。
- どこで実行しますか? サーバーのレイテンシが制約にならない場合は、大規模な基盤モデルが適しています。NVIDIA GPU上で、ほかのYOLOタスクと並行して低レイテンシの深度推定を行う場合は、Ultralytics YOLO26 depthを検討し、NVIDIA Jetsonなどのエッジデバイスで性能を測定してください。ほかの候補には、Depth Anything V2 Small、MiDaS v3.1のSwin2-TinyモデルとLeViTモデルがあります。CPUのレイテンシは、プロセッサ、ランタイム、入力解像度、モデルによって異なります。実際に使用する構成でベンチマークを実施してください。Fig 3では、小型のUltralytics YOLO26 depthモデルを使った例を示しています。以下のエッジデバイスに関するセクションも参照してください。
- ライセンスを利用できますか? 使用するチェックポイントの利用条件を確認してください。複数のモデル系列では、Apache 2.0ライセンスの小型モデルと、非営利ライセンスの大型モデルが混在しています。
- キャリブレーションまたはファインチューニングができますか? 使用するカメラでラベル付き画像を約50~150枚収集でき、各画像に実測点を数点用意できる場合は、実際のシーンでキャリブレーション済みモデルまたはファインチューニング済みモデルをゼロショットモデルと比較してください。UltralyticsがYOLO26s-depthで行ったテスト(カメラごとに150枚、画像ごとに実測点5点)では、この方法によるキャリブレーションで、スケールの誤差がフルのグラウンドトゥルースフィットに対して約1%以内になりました。キャリブレーション前の誤差は4%~46%でした。この数値はスケールの復元精度を示すもので、深度全体の精度を示すものではありません。
その後、実際のカメラで撮影した画像を使い、デプロイ時の解像度で候補モデルを2~3種類テストしてください。
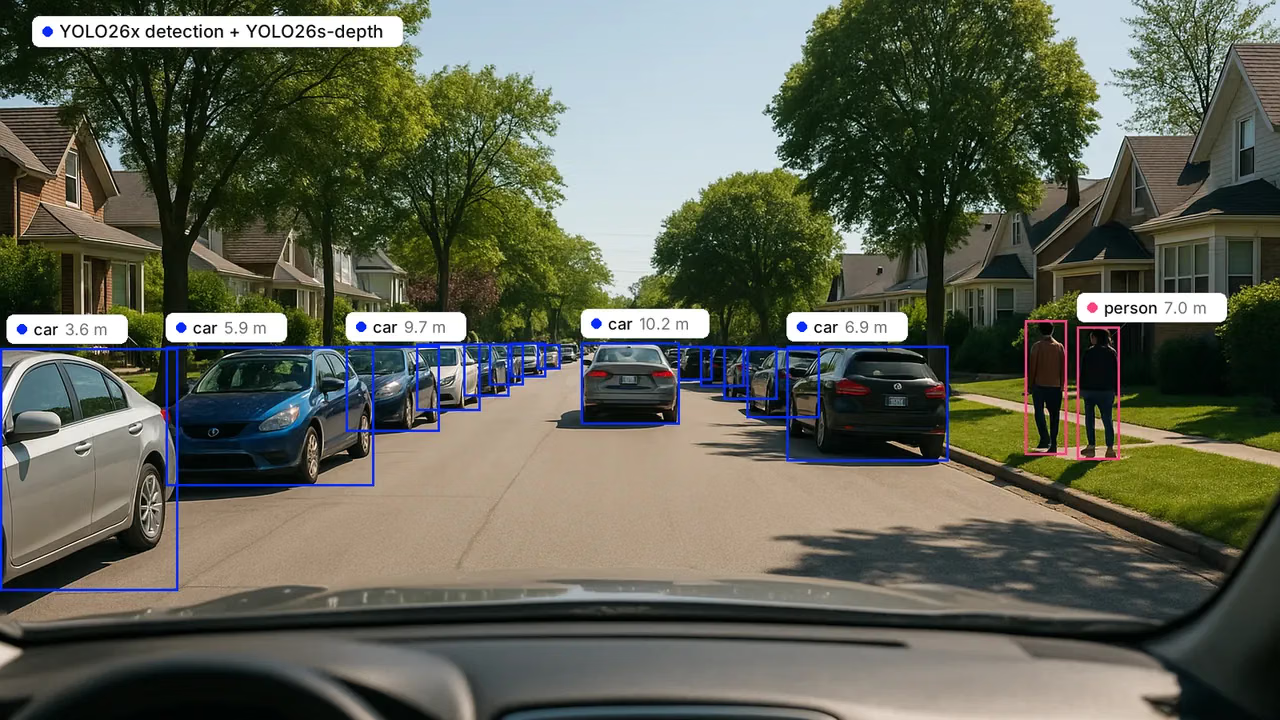
Fig 2. Ultralytics YOLO26xの検出とUltralytics YOLO26s-depthを組み合わせ、検出対象として選択した車と人物までの距離を予測しています。最も近い駐車中の車まで3.6 m、右側の車まで6.9 m、右側のラベル付き人物まで7.0 mです。この写真は記事用に生成したものです。バウンディングボックスと距離は実際のモデル出力ですが、このカメラに対するキャリブレーションは行っていません。これらは予測値であり、実測距離ではありません。
各モデルの詳細#
アルファベット順に掲載しています。
Depth Anything 3#
ByteDance SeedのDepth Anything 3は、Depth Anythingを単一画像から任意の数のビューへと拡張します。主要モデルは深度とカメラ姿勢を同時に推定し、専用バリアントは単眼相対深度(DA3Mono-Large)と単眼メートル深度(DA3Metric-Large)に対応します。出力: 主要モデルとMonoモデルは相対深度を出力し、DA3Metric-Largeは焦点距離を指定するとメートル単位の深度を出力し、非商用のNestedモデルはメートル単位の深度を直接出力します。サイズ: プロジェクトのモデルカードに記載されているサイズは、0.08B(Small)から1.15B(Giant)までで、1.40BのNestedモデルもあります。ライセンス: Small、Base、Metric-Large、Mono-LargeはApache 2.0、Large、Giant、NestedはCC BY-NC 4.0です。最適な用途: マルチビューシーンと3D再構成です。トレードオフ: 最も高性能なチェックポイントは非商用利用に限られます。
Depth Anything V2#
Depth Anything V2は、屋内、屋外、一般的でないシーンでも堅牢な結果を得られる、広く利用可能なオープンモデルです。プロジェクトでは、屋内シーン(最大20 m)と屋外シーン(最大80 m)向けにファインチューニングしたメートル単位のチェックポイントも公開しています。サイズ: Smallは24.8M、Baseは97.5M、Largeは335.3Mです。ライセンス: SmallはApache 2.0、BaseとLargeはCC-BY-NC-4.0です。最適な用途: 汎用的な相対深度推定です。トレードオフ: 商用利用できるのはSmallモデルに限られ、メートル単位のチェックポイントは固定された最大深度を超えて予測できません。
Depth Pro#
AppleのDepth Proは、カメラの内部パラメーターなしで単一画像からメートル単位の深度を予測し、焦点距離も推定します。Appleによると、標準的なGPUで0.3秒以内に225万画素の深度マップを生成でき、細かな構造の境界も明瞭です。ライセンス: コードと重みにはApple独自のライセンスが適用されます。最適な用途: カメラを制御できない環境で撮影した写真から、メートル単位の深度を推定する用途です。トレードオフ: エッジモデルではなく、サーバークラスのモデルです。商用利用の前にライセンスを確認してください。
Marigold#
Marigoldは、事前学習済みの画像拡散モデルを深度推定に転用し、合成データのみで学習されています。非常に詳細な相対深度を生成します。ライセンス: コードはApache 2.0、モデルはRAIL++-Mです。最適な用途: コンテンツ作成やデータセット生成など、速度よりも細部の精度が重要なオフライン作業です。トレードオフ: 1ステップ推論に対応していますが、精度向上のためにアンサンブルを行うとコストが増大するため、必要なレイテンシを満たすか測定してください。
Metric3D v2#
Metric3D v2は、ViT-Small、ViT-Large、ViT-giant2のチェックポイント(ONNXエクスポートを含む)を備え、単一画像からメートル単位の深度と表面法線を予測します。ライセンス: コードはBSD-2-Clauseです。使用するチェックポイントの利用条件を確認してください。最適な用途: 表面法線も必要とする3D再構成やロボティクスのパイプラインです。トレードオフ: 画像を標準カメラにマッピングするため、正しいスケールを得るには正確な焦点距離が必要です。
MiDaS#
IntelのISLが開発したMiDaSは、複数のデータセットを組み合わせて学習することで、堅牢な相対深度推定を実用化しました。バージョン3.1には、精度を重視したBEiT-Largeモデルから、組み込みデバイス向けのSwin2-TinyモデルとLeViTモデルまであります。また、Intel CPU向けのOpenVINO形式の旧MiDaS v2.1小型モデルや、iOSとAndroid向けのモバイル実装例も用意されています。ライセンス: MITです。最適な用途: 寛容なライセンスで、ドキュメントが充実したベースラインです。トレードオフ: 新しい基盤モデルよりも古く、Intelがリポジトリをアーカイブしたため、修正も提供されていません。実際の画像で新しいモデルと比較してください。
Ultralytics YOLO26の深度推定#
Ultralytics YOLO26は、768ピクセルで6.3M(n)から57.0M(x)までの5サイズで深度推定に対応しており、2026年7月に発表されました。深度をメートル単位で予測する対数深度ヘッドを備え、約0.02~150メートルの範囲を扱うため、1つのモデルで屋内と屋外の両方に対応できます。公開済みの重みには単一のグローバルスケールが設定されています。特定のカメラで絶対深度を正確に求めるには、model.calibrate()を使い、再学習せずにラベル付き画像約50~150枚でスケールを調整します。NVIDIA T4で入力約768ピクセル、バッチサイズ1のTensorRT FP16ベンチマークでは、前処理と後処理を除く推論のみのレイテンシは2.7 ms(n)から13.6 ms(x)で、5つのサイズすべてがDepth Anything V2 Smallより低レイテンシでした。これはレイテンシの比較であり、共通条件での精度評価ではありません。モデルはONNX、TensorRT、CoreML、OpenVINOなどの形式にエクスポートでき、検出、セグメンテーション、ポーズ推定と同じPython APIおよびCLIで学習できます。ライセンス: AGPL-3.0、またはクローズドソースの商用利用向けのUltralytics Enterpriseライセンスです。最適な用途: NVIDIA GPU上で、ほかのYOLOタスクと並行して低レイテンシの深度推定を行う用途です。エッジデバイスで性能を測定してください。トレードオフ: 絶対スケールはカメラのキャリブレーションに依存します。また、ここでは基盤モデルと共通プロトコルで精度を比較していないため、独自データでテストしてください。
UniDepth V2#
UniDepthは、単一のRGB画像からメートル単位の深度とカメラの内部パラメーターを予測し、既知の内部パラメーターがある場合はそれを利用できます。ライセンス: CC BY-NC 4.0です。最適な用途: カメラが不明な場合にメートル単位の深度が必要な研究やプロトタイプです。トレードオフ: 商用利用はライセンスで認められていません。
ZoeDepth#
ZoeDepthは、相対深度の事前学習と、屋内(NYU)および屋外(KITTI)シーン向けのメートル単位のヘッドを組み合わせています。ライセンス: MITです。最適な用途: シーンが屋内または屋外の学習ドメインに似ている場合に、寛容なライセンスでメートル単位の深度を推定するモデルとして利用できます。トレードオフ: 特定の屋内・屋外ドメイン向けに学習されている一方、UniDepthやMetric3D v2などの新しいメートル深度モデルは多様なカメラを想定して設計されています。Intelがリポジトリをアーカイブしたため、修正も提供されていません。
エッジデバイスでの深度推定#
エッジハードウェアでは、「最も高精度か」ではなく、「目標フレームレートで十分な精度を得られるか」が重要になります。適したモデルは次の3つのグループに分けられます。
- 大規模モデル系列の小型バージョン。 Depth Anything V2 Small(パラメーター数24.8M、Apache 2.0)は、寛容なライセンスを持つ選択肢の1つです。MiDaS v3.1のSwin2-TinyモデルとLeViTモデルは、組み込みデバイス向けに設計されています。
- リアルタイムタスクモデル。 Ultralytics YOLO26 depthは、Tesla T4でTensorRT FP16を使用した場合、バッチサイズ1で2.7 ms(n)から13.6 ms(x)の推論のみのレイテンシで実行できます。前処理と後処理は含みません。NVIDIA Jetson向けのTensorRT、Appleデバイス向けのCoreML、Intel CPU向けのOpenVINOにエクスポートできますが、エクスポート対応はエッジデバイスでのベンチマークを意味するものではありません。
- 軽量な研究モデル。 FastDepth(MIT)は組み込みシステム向けに開発され、NVIDIA Jetson TX2での動作が実証されています。Lite-Mono(MIT)はパラメーター数が2.2M~8.7Mで、KITTIの走行データを使って学習されています。
エクスポート後、デプロイ時の解像度で、対象デバイス上の推論レイテンシを測定してください。ハードウェアの選定については、適切なエッジデバイスの選び方を参照してください。エクスポートの選択肢については、モデルのデプロイ方法に関するガイドを参照してください。
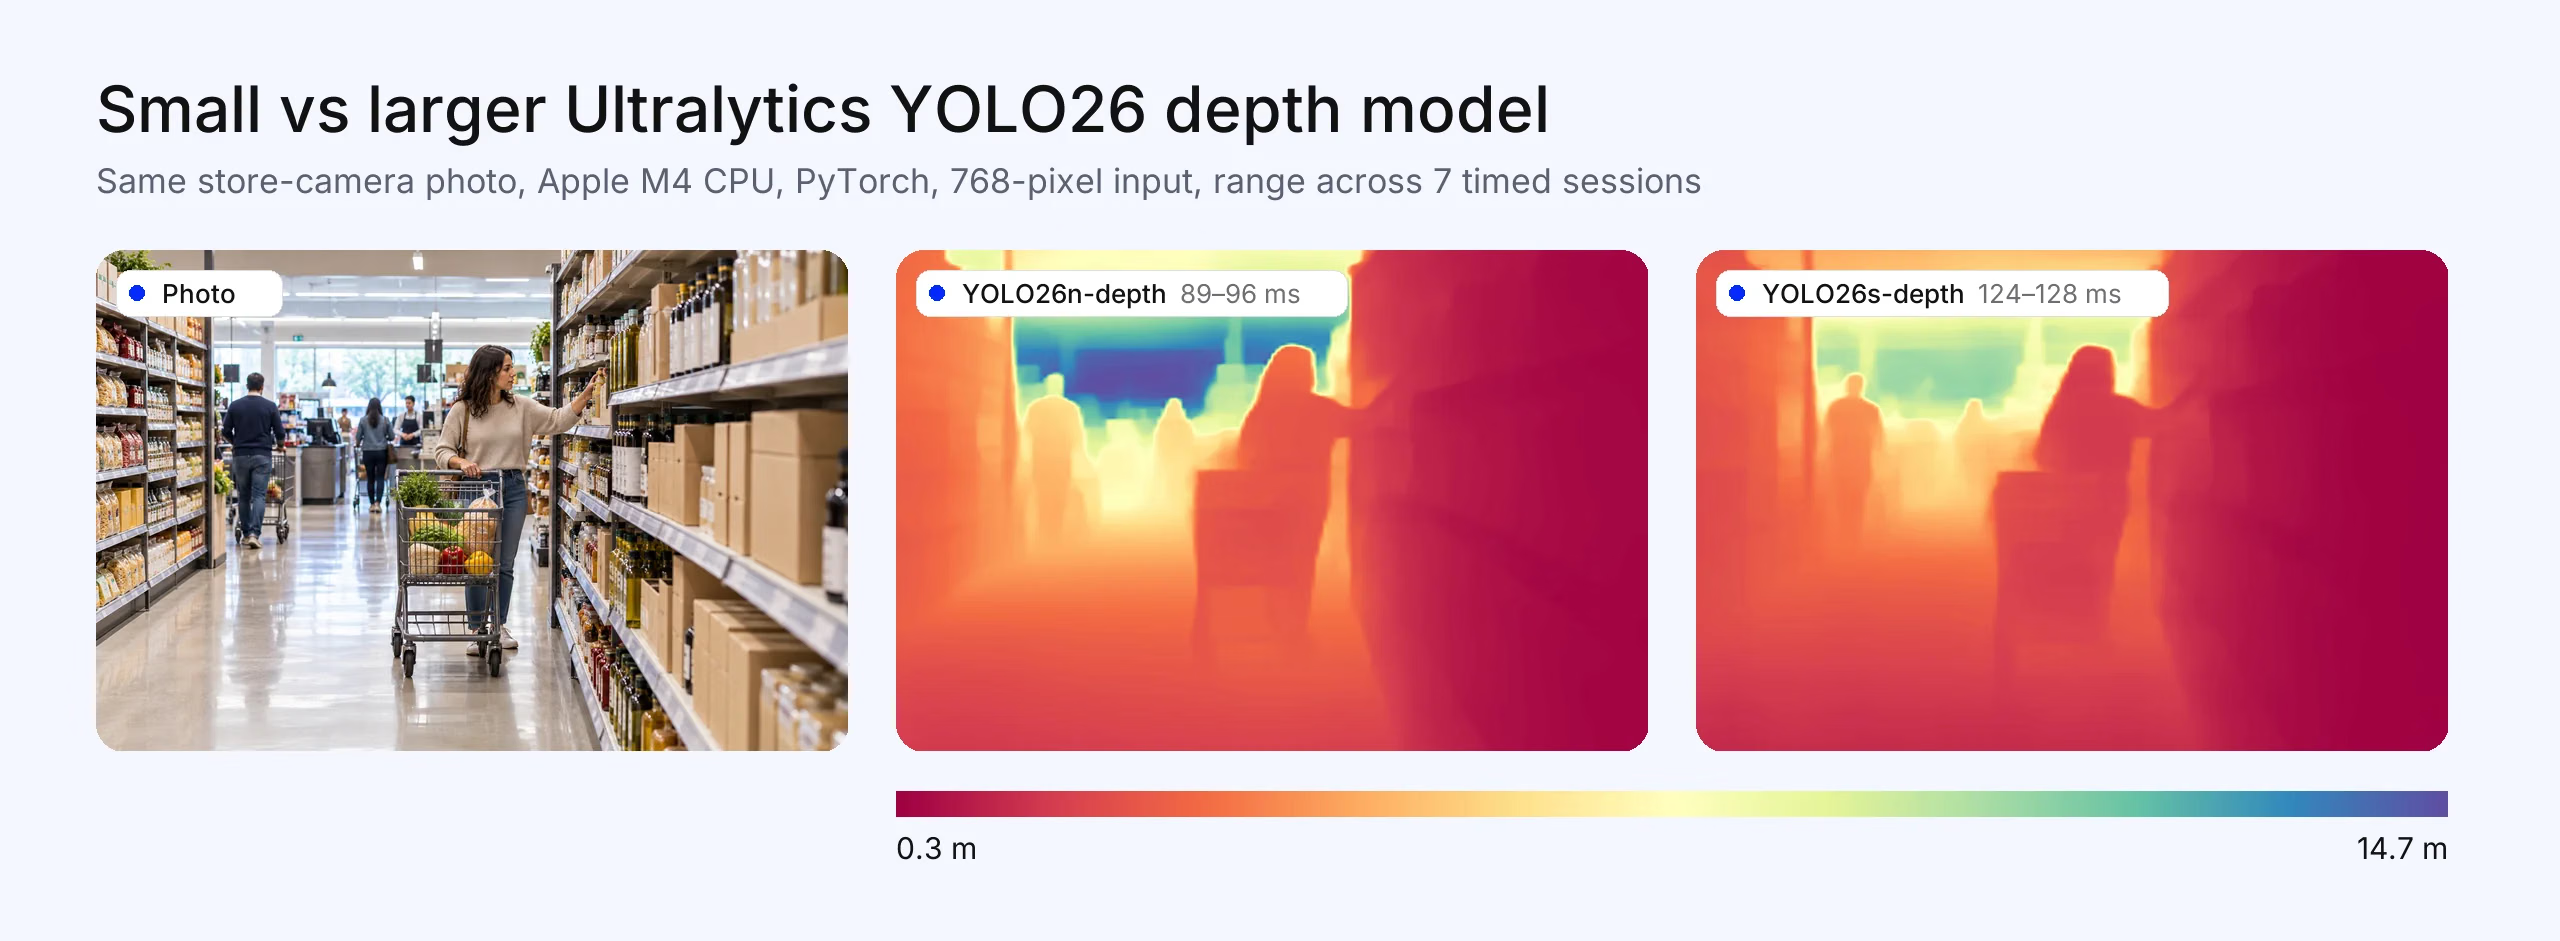
Fig 3. 同じ店舗の写真に対するUltralytics YOLO26n-depth(89~96 ms)とYOLO26s-depth(124~128 ms)の処理時間です。Apple M4 CPU上で、PyTorchを使用し、768ピクセルの入力画像から深度マップの生成完了までを測定しています。バックグラウンド負荷によりノートPCの処理時間は変動するため、範囲として捉えてください。この写真は記事用に生成したものです。深度マップと処理時間は実際の結果です。
ロボティクス向け深度推定#
ロボットでは通常、メートル単位の深度をロボットの制御周期で取得し、フレーム間で安定させる必要があります。実用的な方法は次の3つです。
- 単眼メートル深度モデルは、単一のRGBカメラを搭載したロボットに適しています。カメラに合ったモデルを使用してください。内部パラメーターが既知の場合はMetric3D v2またはDepth Anything 3 Metric、NVIDIA GPU上でほかのYOLOタスクと並行して低レイテンシのオンボード推論が必要な場合はキャリブレーション済みのUltralytics YOLO26 depthモデルを選び、ロボットのコンピューターで性能を測定してください。
- ステレオモデルの一例であるNVIDIAのFoundationStereoは、キャリブレーション済みのカメラペアからメートル単位の深度を計算します。研究用の公開版は非営利利用向けです。NVIDIAは商用利用向けのTAO版も提供しています。ステレオと単眼深度の比較については、ステレオビジョンを参照してください。
- 深度センサー(ステレオ深度カメラ、構造化光、LiDAR)は深度を直接測定します。
単眼モデルが適切でない場合: 人の近くでの衝突回避など、安全性が重要な判断には深度センサーまたはステレオカメラペアを使用してください。単眼深度は、センサーがデータを返さない箇所を補完するなど、補助的に扱います。
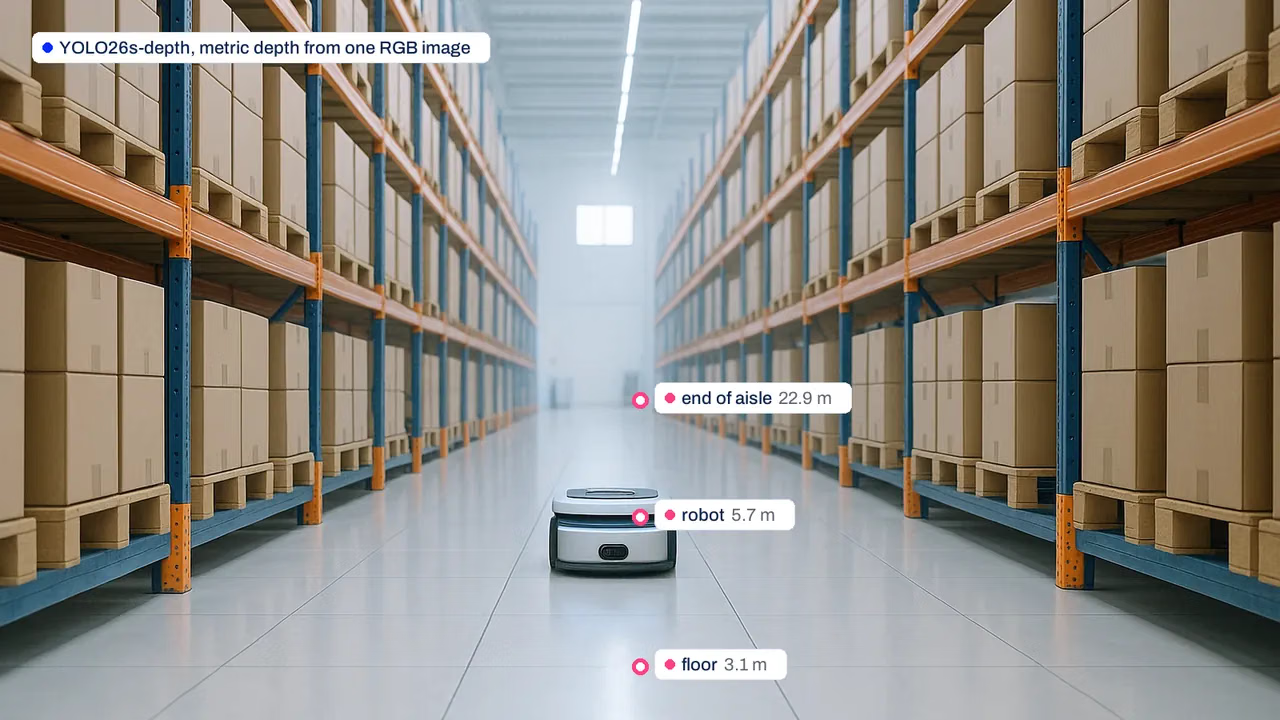
Fig 4. 1つのUltralytics YOLO26s-depth深度マップから読み取った予測距離です。床上の点まで3.1 m、ロボットまで5.7 m、通路の端まで約23 mです。この写真は記事用に生成したものです。数値は実際のモデル出力ですが、このカメラに対するキャリブレーションは行っていないため、測定値ではなく予測値です。
実際のカメラで深度モデルをテストする方法#
- デプロイ時の解像度とレンズ設定で、デプロイ用カメラからラベル付き画像を約50~150枚収集し、各画像に実測点を数点用意してください。NYU Depth V2(屋内)やKITTI(走行)などの公開ベンチマークは最初の比較に役立ちますが、最終的には実際のカメラでの結果を基準にしてください。
- 距離計が測定するのは直線距離ですが、キャリブレーションにはカメラ軸に沿った深度が必要です。画像中央付近の点を測定するか、カメラの内部パラメーターを使って中心から外れた測定値をカメラ軸方向の深度に変換するか、深度センサーで深度を取得してください。
- 測定値に対するδ1と絶対相対誤差で候補モデルを比較し、対象デバイスで各モデルの処理時間も測定してください。メートル深度モデルは、各画像の出力をグラウンドトゥルースに合わせて再スケーリングせずに評価してください。画像ごとのアライメントを行うと、確認すべきスケール誤差が隠れてしまいます。
- 固定スケールのメートル深度モデルでは、データの一部でキャリブレーションし、残りのデータでテストしてください。Ultralytics YOLO26 depthには、この機能が
model.calibrate()として含まれています。
よくある質問
あらゆるケースに最適なモデルはありません。相対深度の評価には、Depth Anything V2とDepth Anything 3が有力な候補です。Depth Pro、UniDepth、Metric3D v2は、単一画像からメートル単位の深度を推定します。NVIDIA GPU上で、ほかのYOLOタスクと並行して低レイテンシの深度推定を行う場合は、Ultralytics YOLO26 depthを評価し、エッジデバイスで性能を測定してください。Depth Anything V2 Small、MiDaS v3.1のSwin2-TinyモデルとLeViTモデルも、テストする価値のある軽量な選択肢です。
小型で、使用するランタイムにエクスポートできるモデルを候補にしてください。Ultralytics YOLO26 depth(パラメーター数6.3M~57.0M、TensorRT、CoreML、OpenVINOへのエクスポートに対応)、Depth Anything V2 Small(パラメーター数24.8M)、MiDaS v3.1のSwin2-TinyモデルまたはLeViTモデルが候補です。その後、実際のデバイスでレイテンシを測定してください。エクスポート対応だけでは、エッジデバイスでの性能は確認できません。
ロボットには通常、メートル単位の深度が必要です。Metric3D v2とDepth Anything 3 Metricは、カメラの内部パラメーターが既知の場合、1枚の画像からメートル単位の深度を予測します。UniDepthは内部パラメーター自体を推定できます。ドキュメントによると、Ultralytics YOLO26 depthはT4でTensorRT FP16を使い、入力約768ピクセル、バッチサイズ1の場合、前処理と後処理を除く推論のみのレイテンシが2.7~13.6 msです。実際のロボット用コンピューターで測定してください。安全性が重要なナビゲーションでは、ステレオカメラまたは深度センサーを使用し、単眼深度は補助的に扱ってください。FoundationStereoは評価対象となるステレオモデルの1つです。
Depth Anything V2の主要モデルが予測するのは相対深度です。プロジェクトでは、屋内シーンで最大20メートル、屋外シーンで最大80メートルまで対応するようファインチューニングしたメートル深度チェックポイントも公開しています。
チェックポイントごとに利用条件を確認してください。MiDaSとZoeDepthはMITライセンスです(両方のリポジトリは現在アーカイブされています)。Metric3DのコードはBSD-2-Clauseですが、チェックポイントの利用条件も確認してください。Depth Anything V2 SmallとDepth Anything 3の複数のモデルはApache 2.0で、MarigoldのモデルにはRAIL++-Mが適用されます。Depth Anything V2 BaseとLarge、Depth Anything 3の大型モデル、UniDepthは非営利利用に限られます。Ultralytics YOLO26 depthはAGPL-3.0で、クローズドソースの商用利用にはEnterpriseライセンスが用意されています。Depth ProにはApple独自のライセンスが適用され、利用と再配布は認められていますが、特許権は許諾されません。製品に組み込む前に確認してください。









