Ultralytics YOLO26を使ったPython OCR:ドキュメント、写真、PDFをあらゆる角度で読み取る
Ultralytics YOLO26-TextとPP-OCRv6を使って、CPUまたはGPU上で、任意の回転角度の画像やPDFページから数行のPythonコードでテキストを読み取れます。TensorRTもオプションで利用できます。
 Jing Qiu14 分で読めます
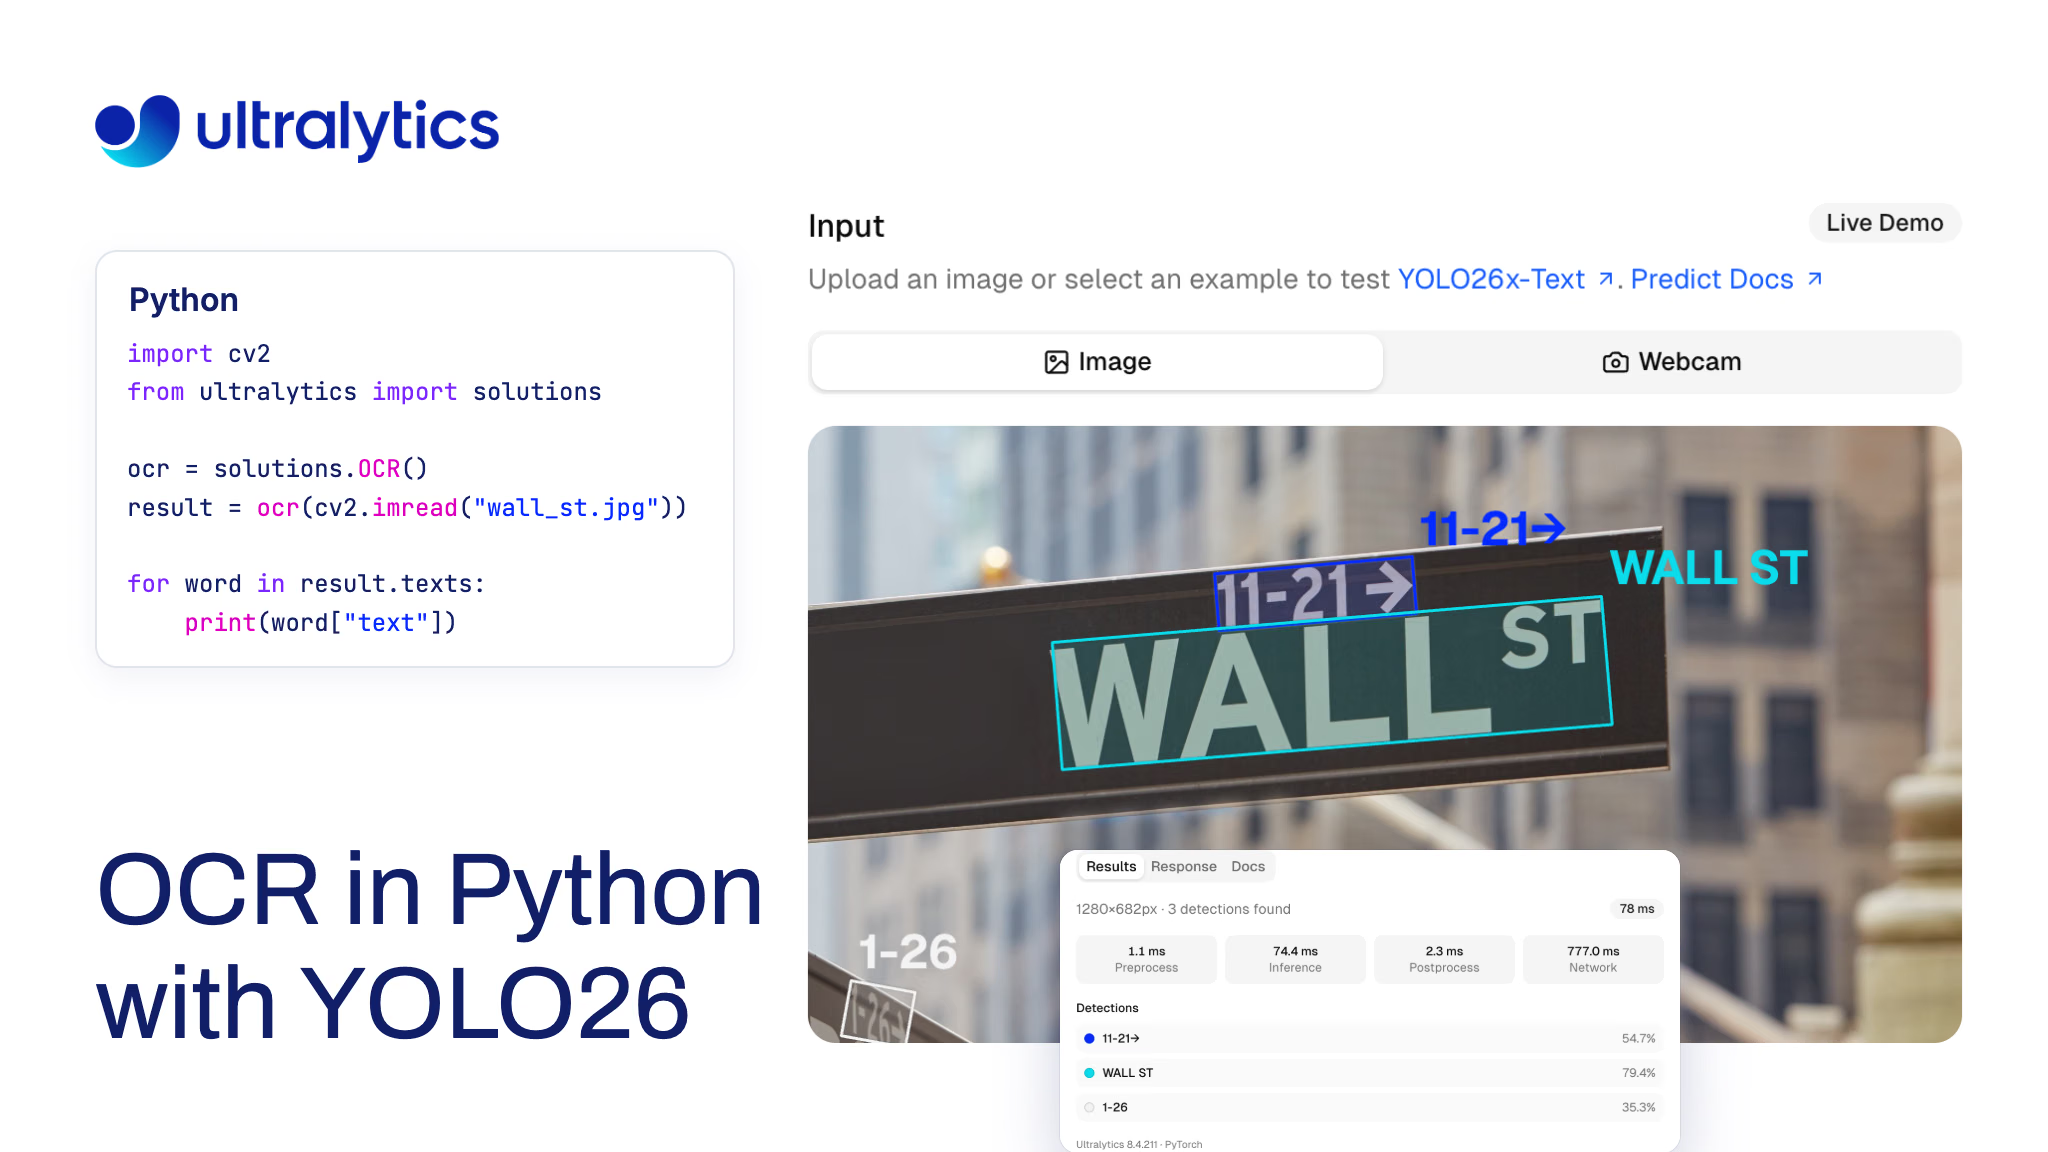
横向きのスキャン画像、標識を撮影したスマートフォンの写真、PDFのページから、どうすればPythonでOCRを実行し、人が読む順序で単語を取り出せるでしょうか。Ultralyticsパッケージなら、1つのクラスで実行できます。solutions.OCR()はUltralytics YOLO26-Textモデルでテキストを検出し、PaddleOCRのPP-OCRv6認識モデルで各単語を読み取り、任意のページ回転角度で、CPUまたはGPU上で、認識した単語を行ごとに返します。
このパイプラインは新しいものです。Ultralytics 8.4.210では、回転処理と読み取り順序に対応するため、ONNX Runtime上のPP-OCRv6を中心にOCRソリューションを再構築しました。8.4.211では、オプションのTensorRT認識モデルを追加しました。画像サイズ1280で実施したベンチマークでは、デフォルト設定で6ページのPDFに対して単語F1スコア0.931、80枚のHierText写真に対して0.722を記録しました。RTX PRO 6000では、キャッシュ済みのFP16 TensorRTエンジンが、1枚の写真で検出した251語を82 msで読み取りました。CUDA上のONNX Runtimeでは249 msでした。
このガイドでは、パイプラインの仕組み、画像やPDFでの実行方法、処理速度、現在読み取れる言語について説明します。Ultralyticsは以下で比較するOCRオプションの1つを提供しているため、比較は各プロジェクトで公開されている機能に基づいています。
YOLO26 OCRは2段階でページを読み取り、その後、単語を順序付けします#
光学文字認識 (OCR)には、テキストを見つけることと、読み取ることの2つの役割があります。Ultralytics OCRソリューションでは、この2つを明確に分けています。
- 検出: YOLO26-Textモデルは回転矩形バウンディングボックス検出器で、テキストの周囲に回転したボックスを描画します。n、s、m、l、xのサイズがあり、デフォルトはxモデルです。
- 認識: PP-OCRv6 mediumが各クロップを読み取ります。Ultralyticsのアセットリリースに含まれるONNX Runtime上で動作するため、PaddlePaddleをインストールする必要はありません。何も読み取れなかったクロップは除外されます。
- 順序付け: 単語を行ごとにまとめ、行番号を付けて上から下、左から右の順に返します。
各単語は、テキスト、認識信頼度、検出信頼度、行番号、元画像座標でのポリゴンを含むレコードとして返されます。2種類の信頼度が別々に保持されるため、検出の信頼度は高くても読み取りの確信度が低い単語を、信頼せずに人による確認に回せます。
2つのステージは独立しています。より小さな検出器、独自の検出モデルまたはセグメンテーションモデル、あるいは別の認識モデルに置き換えても、回転処理と読み取り順序はそのまま機能します。何もインストールする前に、ドキュメント処理ページで同じコードパスをブラウザー上で試せます。
回転したページや上下逆さまのページも正しい順序で読み取れます#
このソリューションは検出したテキストからページの回転角度を推定するため、事前にページの傾きを補正したり回転させたりする必要はありません。
- テキストの方向を特定します。検出したボックスの長辺の角度を、各ボックスの縦横比に応じて重み付けして平均します。1桁の数字など、縦横比が2:1未満のボックスは判定に使用しません。
- ページを回転させます。テキストが左から右に並ぶようにページを回転させ、各単語を正立するようにクロップし、単語を行ごとにまとめます。
- 0°か180°かを判定します。ボックスだけではテキストの上下を判別できないため、幅が最も広い8語を両方向で読み取り、より確信度の高い方を採用します。上下逆さまのテキストは信頼度の低いノイズとして読み取られるため、正しい向きが明確になります。
8件のドキュメントとスクリーンショット、および12枚の写真を90°、180°、270°回転させたところ、単語F1はドキュメントで0.925、写真で0.654でした。空白のIRS Form 8802では、0°、180°、90°でそれぞれ404語、401語、399語を読み取り、最初の行は同一でした。以前のバージョンでは、すべてのページが正立していると仮定していました。
デフォルト設定は推測ではなく、ベンチマークに基づいています#
主なデフォルト設定は、実測に基づいて決定しました。ベンチマークは、製品版Platformイメージを使い、長辺が最大1280ピクセルのJPEGとしてアップロードする条件で、RTX PRO 6000上で実施しました。GoogleのHierTextデータセットから、判読可能な単語の書き起こしが付いた検証用写真80枚と、テキストレイヤーと照合して評価したPDFページ6枚(arXiv論文から4枚、空白のIRS Form 1040と8802)に、合成スクリーンショットと合成画像を加えて使用しました。指標は単語単位のF1スコアで、適合率と再現率のバランスを表します。英数字2文字以上の小文字の単語を数えます。
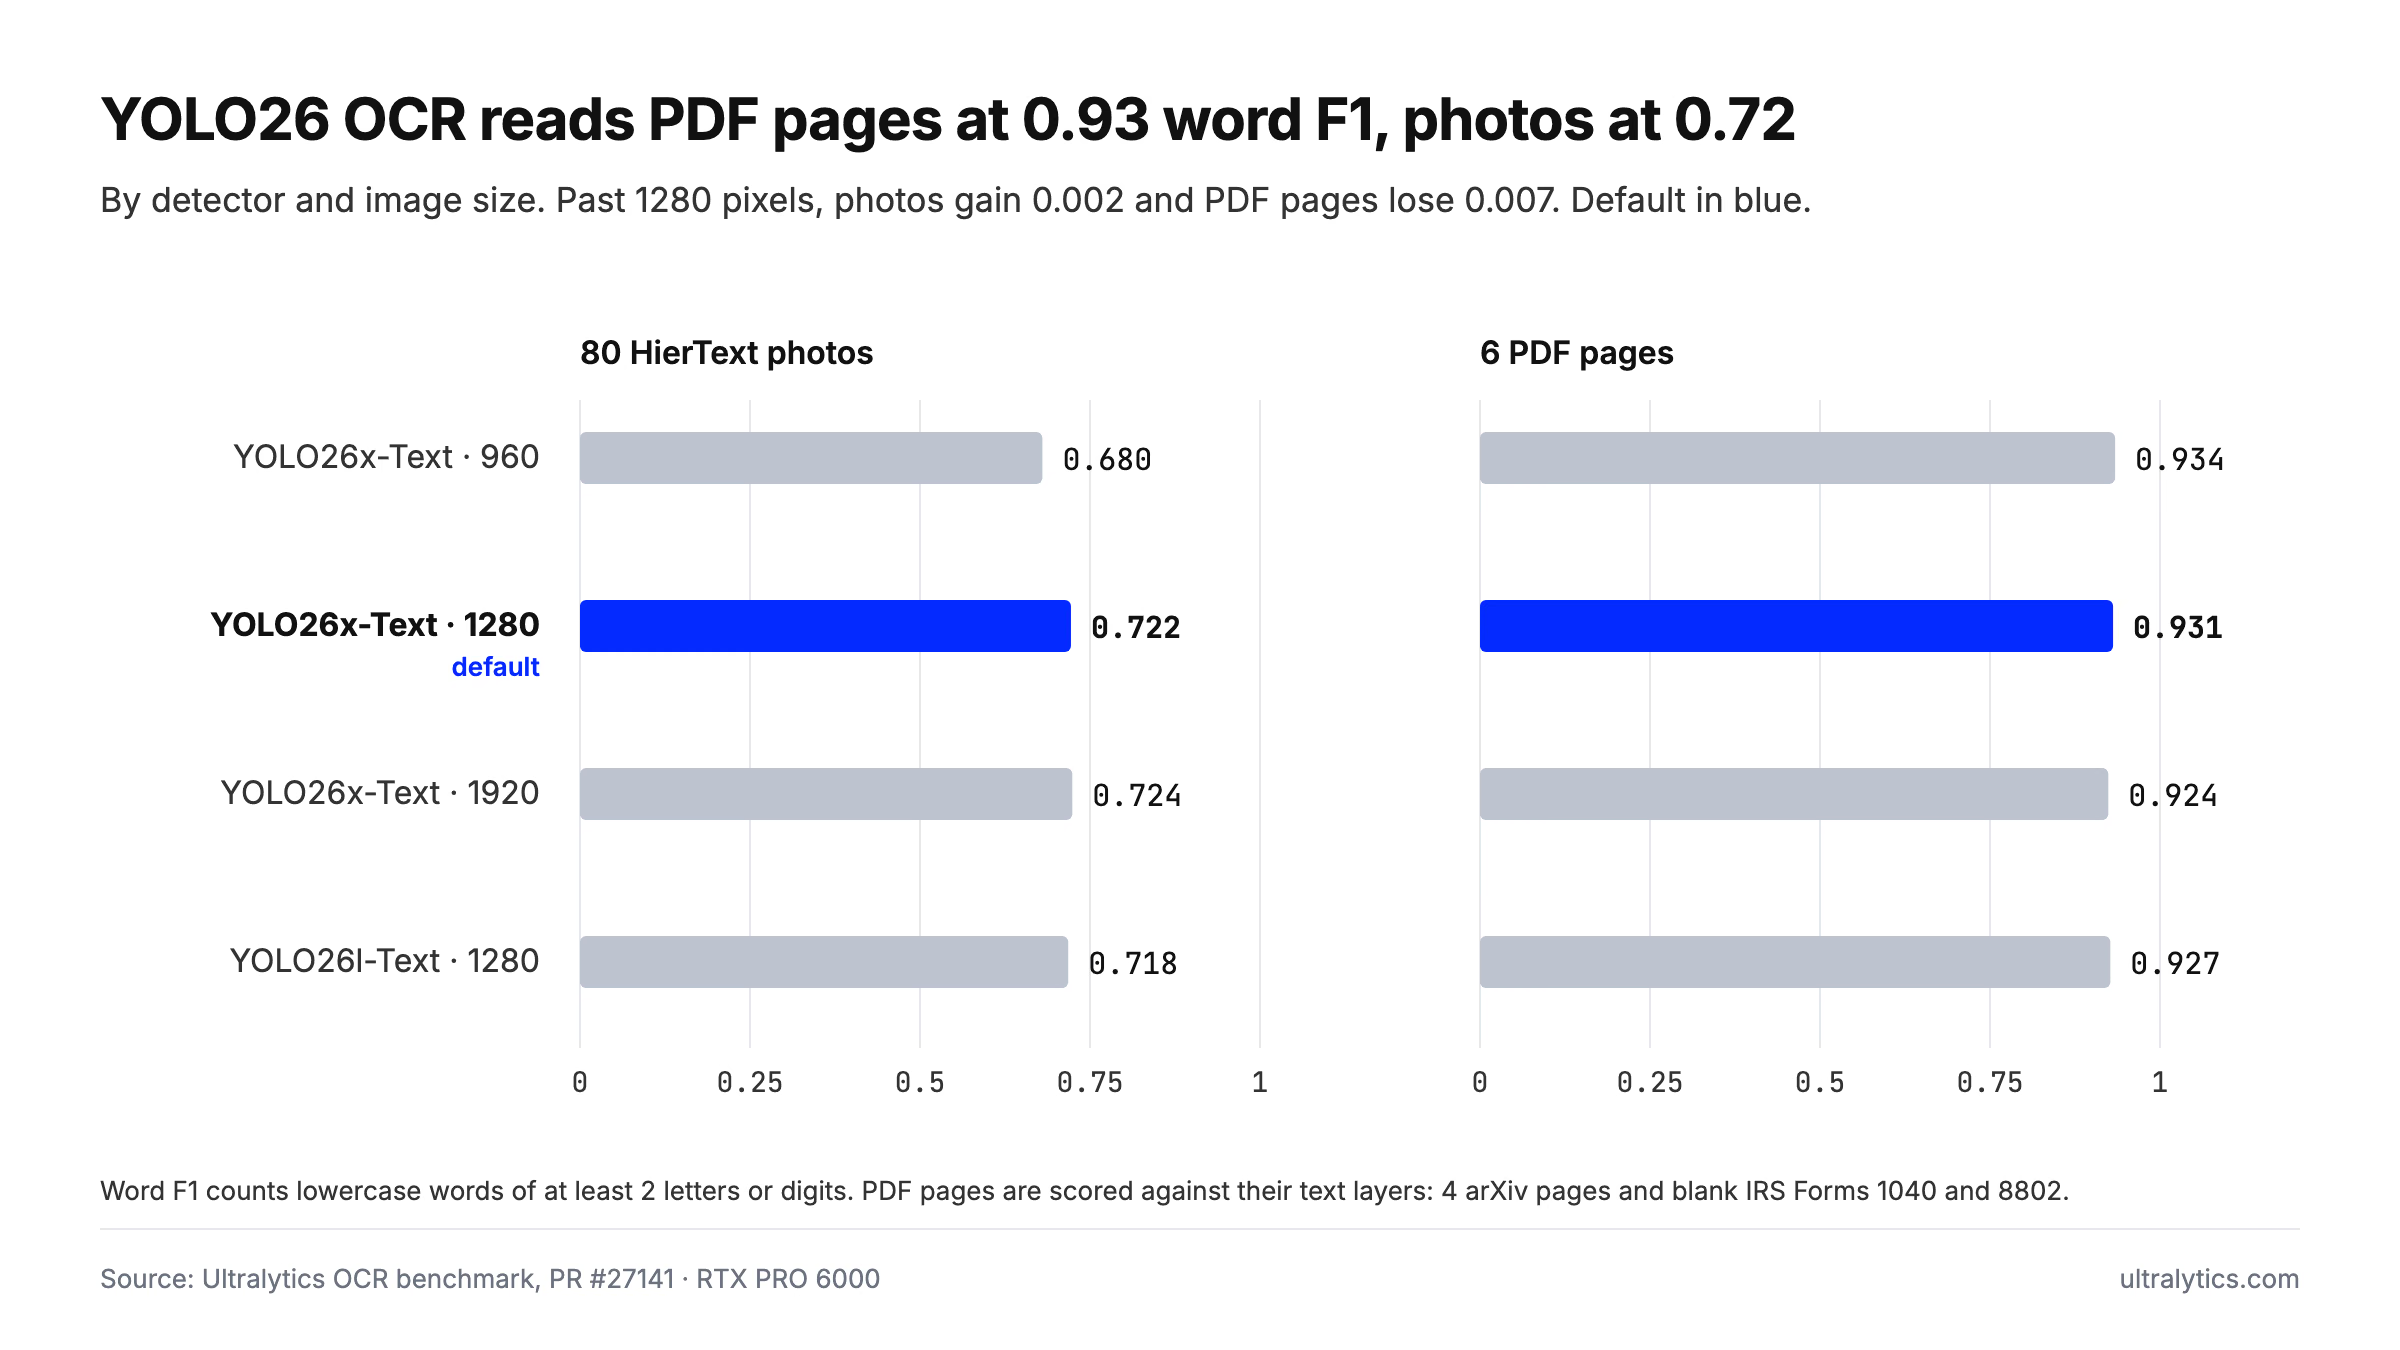
RTX PRO 6000上で、HierText写真80枚とPDFページ6枚を対象に、検出器と画像サイズ別に測定した、YOLO26-TextとPP-OCRv6の単語F1。
どの設定でも、きれいなPDFページはシーンテキストの写真よりはるかに読み取りやすく、数値から次の3つのデフォルト設定を導き出しました。
yolo26x-textをimgsz=1280で使用します。960に下げると写真のF1が0.042低下し、1920に上げると写真では0.002向上する一方、PDFページでは0.007低下しました。小さい画像は1280に拡大せず、モデルの32ピクセルのストライドに合わせて切り上げたサイズで処理します。- 単語単位で読み取ります。写真では、行全体を読むより単語を個別に読む方がF1で4ポイント上回りました。
max_det=1000。高密度のドキュメントページには、通常の検出数である300を超える単語が含まれます。
より軽量な検出器が必要な場合、YOLO26l-Textは両方のデータセットでxモデルとの差を0.5ポイント以内に抑えました。
YOLO26を使ってPythonでOCRを実行する方法#
pip install -U "ultralytics>=8.4.211"でインストールまたはアップグレードします。最初のOCR呼び出しでYOLO26x-TextとPP-OCRv6がダウンロードされ、ONNX Runtimeがインストールされます。CUDAが利用可能な場合はonnxruntime-gpuが使用されます。デフォルトのONNX Runtime認識モデルには、Python 3.11以降とONNX Runtime 1.26以降が必要です。
画像を読み取る#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # 画像サイズ1280のYOLO26x-TextとPP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # 注釈付き画像

for word in result.texts:
print(word["line"], word["text"], round(word["confidence"], 2))コマンドラインからyolo solutions ocr source="path/to/video.mp4"を実行すると、すべてのフレームで同じ処理が行われます。各フレームは追跡せず、個別に読み取られます。
PDFを読み取る#
このソリューションは画像を入力として受け取るため、まずPDFの各ページを画像に変換します。PyMuPDFを使う方法があります。
import cv2
import numpy as np
import pymupdf  # pymupdfをインストール

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # すでに読み取り順に並んでいます
        lines.setdefault(word["line"], []).append(word["text"])
print("\n".join(" ".join(words) for words in lines.values()))result.textsはすでにソートされているため、プレーンテキストの再構築は辞書と結合処理で行えます。ポリゴンを使えばさらに処理を進められます。たとえば、金額が「Total」という単語の隣にあるかを確認できます。
モデル、デバイス、認識モデルを選択する#
- より小さな検出器:
solutions.OCR(model="yolo26s-text.pt")を使うと、より小さく高速な検出器を読み込めます。精度は独自のページで確認してください。5種類すべてのサイズが自動的にダウンロードされます。 - CPUまたはGPU: CUDA GPUが選択され、ONNX RuntimeのCUDA実行プロバイダーが利用可能な場合、認識モデルはCUDA上で動作します。それ以外の場合はCPU上で動作するため、同じスクリプトをノートPCでもサーバーでも実行できます。
- 独自の認識モデル:
recognizerに関数を渡します。この関数は各BGR単語クロップを受け取り、(text, confidence)を返します。ソリューションはその周囲で検出、回転処理、順序付けを引き続き行います。
def recognize(crop):
    # BGR単語クロップに任意の認識モデルを実行
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)高密度写真ではTensorRTにより単語を2.5~3倍高速に読み取れます#
高密度ページのGPUテストでは、検出ではなく認識に大半の時間がかかりました。以前の最適化では、250 msのリクエストのうち検出にかかる時間は約11 msでした。また、TensorRTのプルリクエストでは、残りの認識時間の大半は計算処理ではなく起動オーバーヘッドが支配的な33個の小さなバッチに起因することが示されました。Ultralytics 8.4.211では、これを制御する引数を1つ追加しました。
ocr = solutions.OCR(recognizer="tensorrt") # NVIDIA GPU上のFP16 TensorRTエンジン初回実行時に、FP16のTensorRTエンジンを約30秒で構築し、TensorRTのバージョンとGPUアーキテクチャごとに1つずつ、PP-OCRv6モデルの隣にキャッシュします。2回目以降の読み込み時間は0.05~0.2秒です。このリリースでは、高密度ページでONNX Runtimeより約2.5倍高速と報告されています。
検出後のステップである、単語のクロップ、回転、認識、順序付けを行うread_wordsの処理時間を、シーンテキスト写真4枚で計測しました。195~263語を含む3枚の写真では、FP16エンジンはCUDA上のONNX Runtimeより2.5~3倍高速でした。48語の写真では1.4倍高速でした。
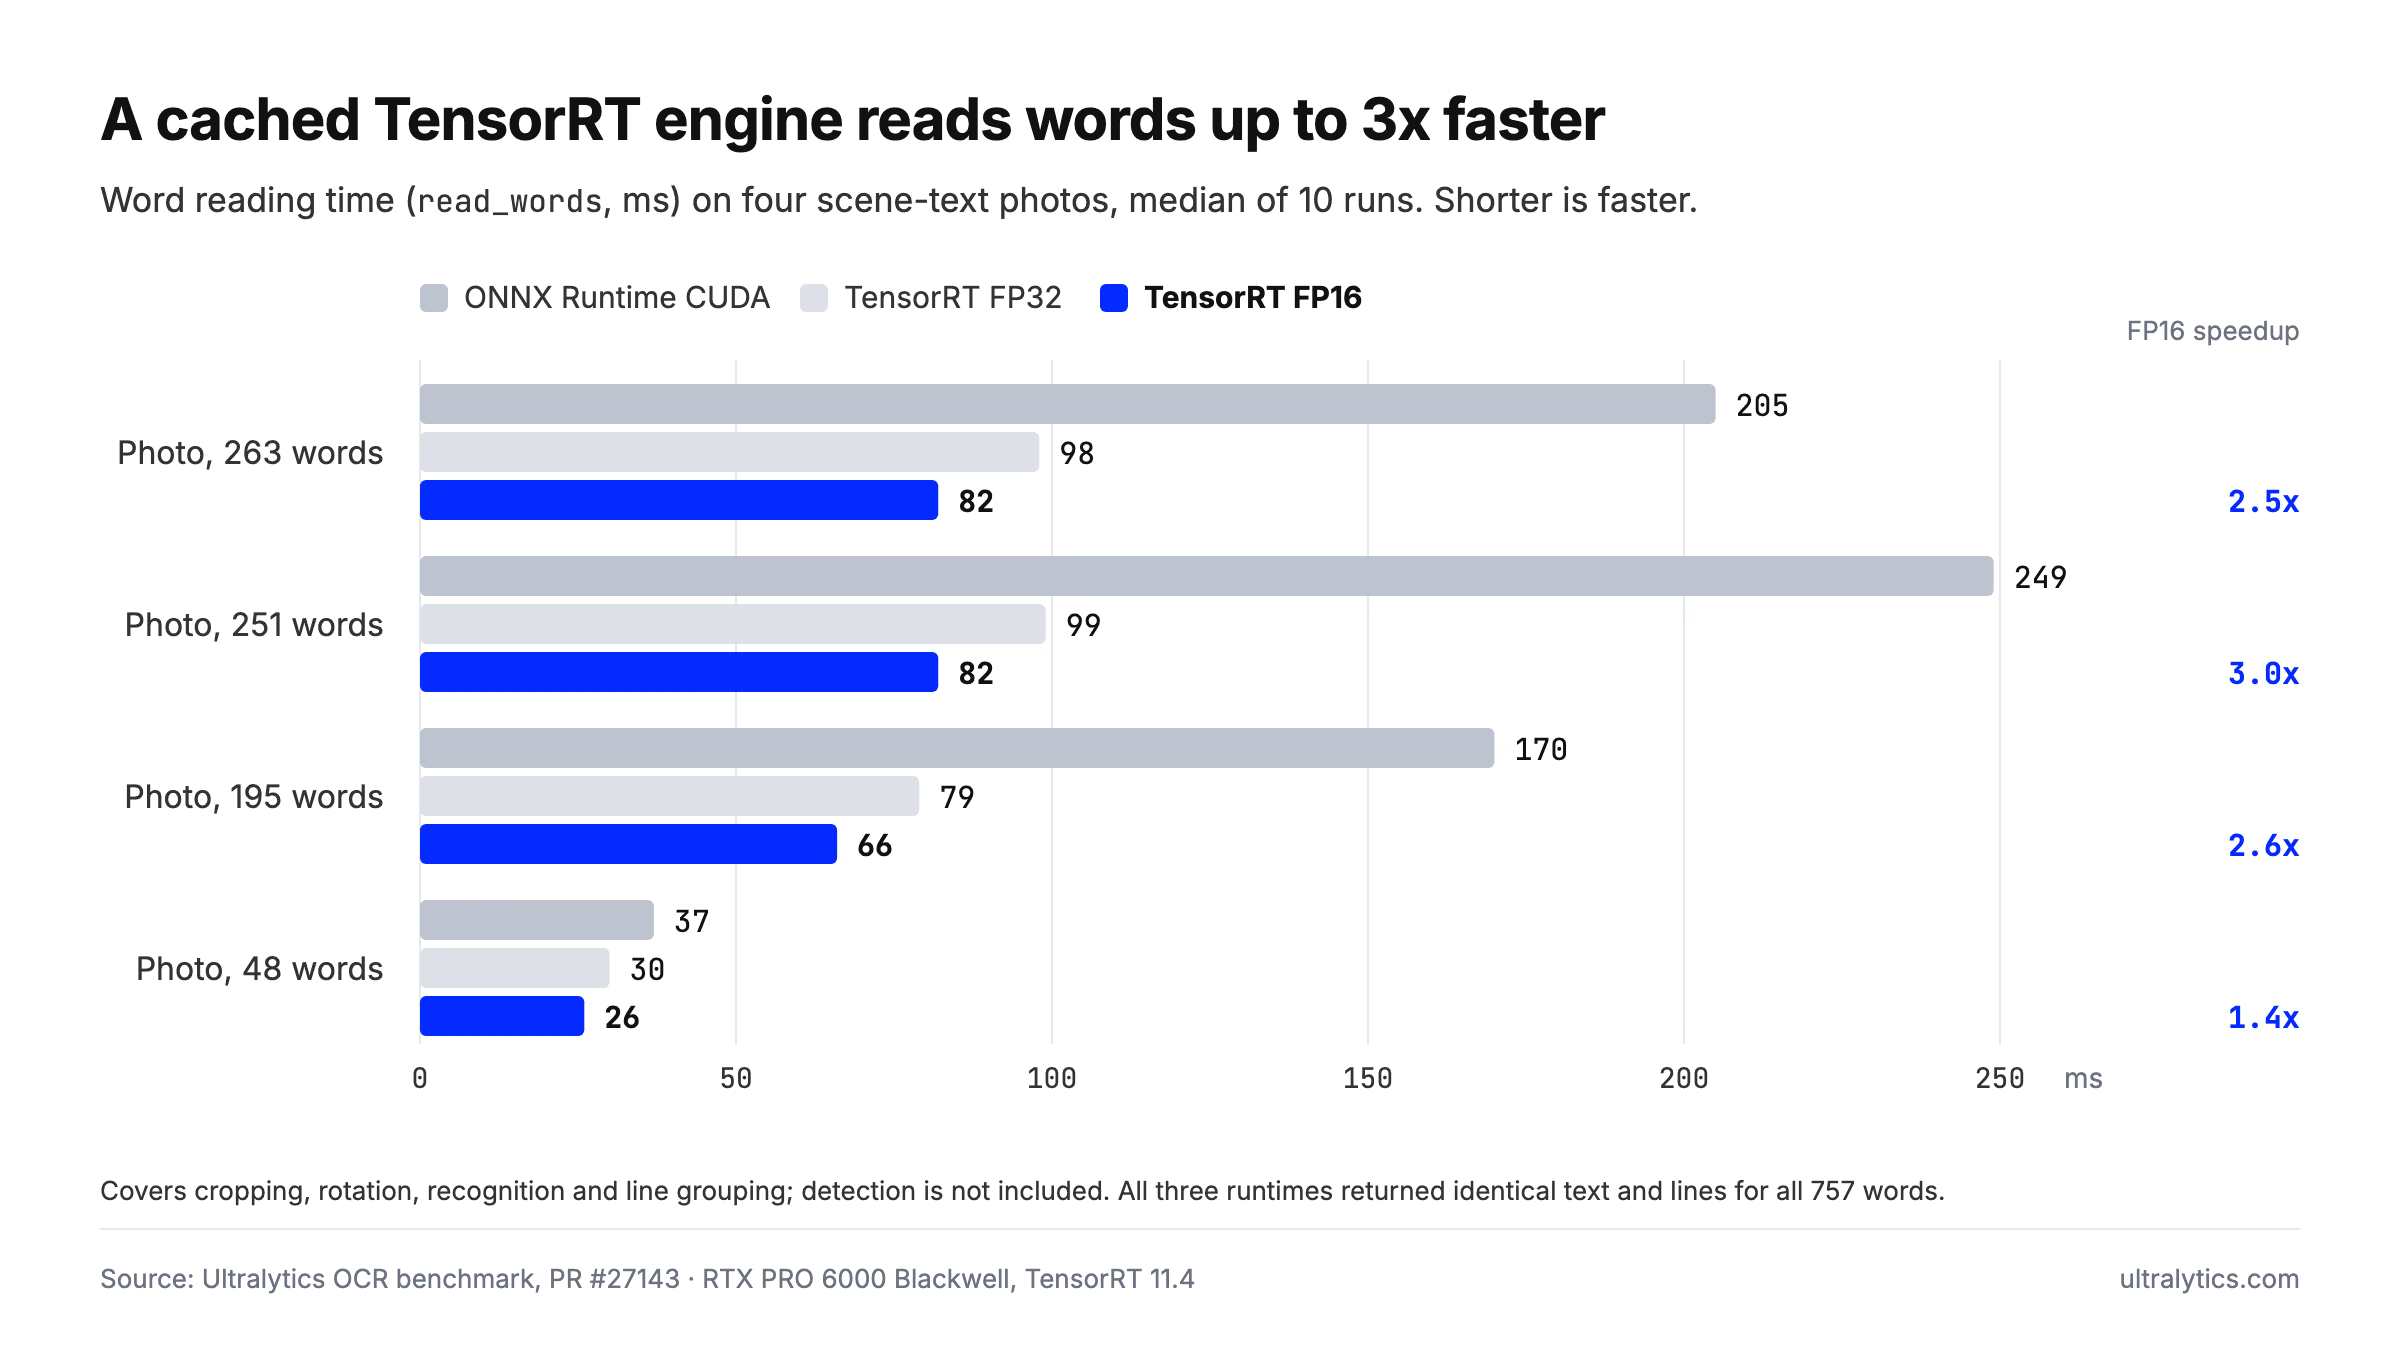
RTX PRO 6000 Blackwell上でTensorRT 11.4を使用し、シーンテキスト写真4枚を読み取る時間。ONNX Runtime CUDA、FP32およびFP16 TensorRTエンジンの10回実行の中央値。
高密度ページでのOCR全体の呼び出し時間は182 msから94 msに短縮されました。この4枚の写真では、速度向上による出力の変化はありませんでした。757語すべてについて、ONNX Runtimeと両方のエンジンが同一のテキストと行のグループ化を返しました。
初回のビルドを待てない場合やNVIDIAハードウェアを使用していない場合は、デフォルトのrecognizer="paddleocr"を使用してください。ビルドは不要で、約1秒で起動します。ONNXとTensorRTの比較では、検出モデルにおける同様のトレードオフを説明し、TensorRT統合ガイドではセットアップ方法を説明しています。
現在、中国語、日本語、ラテン文字に対応しています#
PP-OCRv6が出力できるのは、組み込みの18,708文字だけです。YOLO26-Text検出器はこの文字セットに依存せず、他の文字体系の単語も検出しますが、文字セットに含まれない単語は、見た目の似た文字として返されます。たとえばロシア語のТЕКСТは、多くの場合、高い信頼度で「TEKCT」と読み取られます。
- 対応済み: 簡体字中国語と繁体字中国語(CJK文字約15,600字)、日本語(ひらがな、カタカナ、漢字)、および英語、フランス語、ドイツ語、スペイン語、ポルトガル語、イタリア語、オランダ語、スウェーデン語、フィンランド語、デンマーク語、ノルウェー語、ポーランド語、チェコ語、ハンガリー語、ルーマニア語、トルコ語、クロアチア語、インドネシア語、マレー語などのラテン文字を使用する言語です。ドイツ語の大文字ẞとスペイン語の¡を除き、すべての文字とアクセント付き文字に対応しています。
- 一部対応: ベトナム語は声調付き母音の大半が未対応で、ギリシャ語は基本文字のみ対応しています。
- 未対応: キリル文字、韓国語(ハングル)、アラビア語、ヘブライ語、デーヴァナーガリー文字、タイ語。
未対応の文字体系では、YOLO26-Text検出器をそのまま使用し、recognizerにその文字体系で学習した認識モデルを渡してください。対応言語の一覧はOCRガイドの対応言語セクションにあります。
公開情報に基づくPython OCRライブラリの機能比較#
どのOCRモデルが最適かは一概には言えません。適切なモデルは、ページ、言語、コードの実行環境によって異なります。この表では、2026年11月12日時点で各プロジェクトの公開ページを確認し、測定結果ではなく、公開されている機能を比較しています。選択肢はアルファベット順に並んでいます。
| 選択肢 | 実行環境 | 回転テキスト | 公開資料に記載された対応言語 | 出力 |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_infoは各テキストボックスで90°、180°、270°を試します | キリル文字、アラビア語、デーヴァナーガリー文字、韓国語、タイ語を含む80以上の言語 | ボックス、テキスト、信頼度 |
| PaddleOCR | PaddlePaddle | オプションの方向分類 | 100以上(PP-OCRv6は1つのモデルで50言語に対応) | ボックス、テキスト、信頼度 |
| Tesseract(pytesseract) | ネイティブバイナリ、CPU | 方向と文字体系の検出(image_to_osd)。読み取り前に画像を回転させます | 100+ | テキスト。オプションで単語データも取得できます |
| Ultralytics YOLO26 OCR | PyTorch検出器。認識モデルはONNX Runtime上、またはNVIDIA GPU上のTensorRTで動作します | 検出したテキストからページの回転角度を推定し、0°か180°かを自動判定します | 中国語、日本語、ラテン文字。その他の言語にはカスタム認識モデルを使用します | 読み取り順に並んだ単語を、行番号、ポリゴン、検出と認識それぞれの信頼度とともに返します |
各ツールの現在のオプションは、EasyOCRのドキュメント、PaddleOCRリポジトリ、Tesseractのドキュメント、pytesseractで確認できます。これらのエンジンの仕組みについては、人気のオープンソースOCRモデルの概要をご覧ください。
Ultralyticsの活用方法#
Ultralytics YOLO26 OCRは、スキャンしたフォーム、PDFページ、スクリーンショット、ラベルや標識の写真など、さまざまな入力からテキストを取り出し、確認できる座標と読み取り順の単語を必要とするPython開発者向けに構築されています。予測できない角度でページが届く場合、OCRを自社のマシン上で実行したい場合、またはすでにUltralytics YOLO26モデルを実行していて、同じパッケージでOCRも使いたい場合に適しています。NVIDIA GPUで大量の処理を行う場合は、recognizer="tensorrt"を追加してください。
検出器は一般的なUltralyticsモデルなので、他のモデルと同様に学習、検証、エクスポートができます。Ultralytics PlatformのYOLO26-Textプロジェクトには、nからxまでの5種類すべてのサイズが用意されており、学習曲線を比較したり、プロジェクトを複製してモデルの作成を始めたりできます。
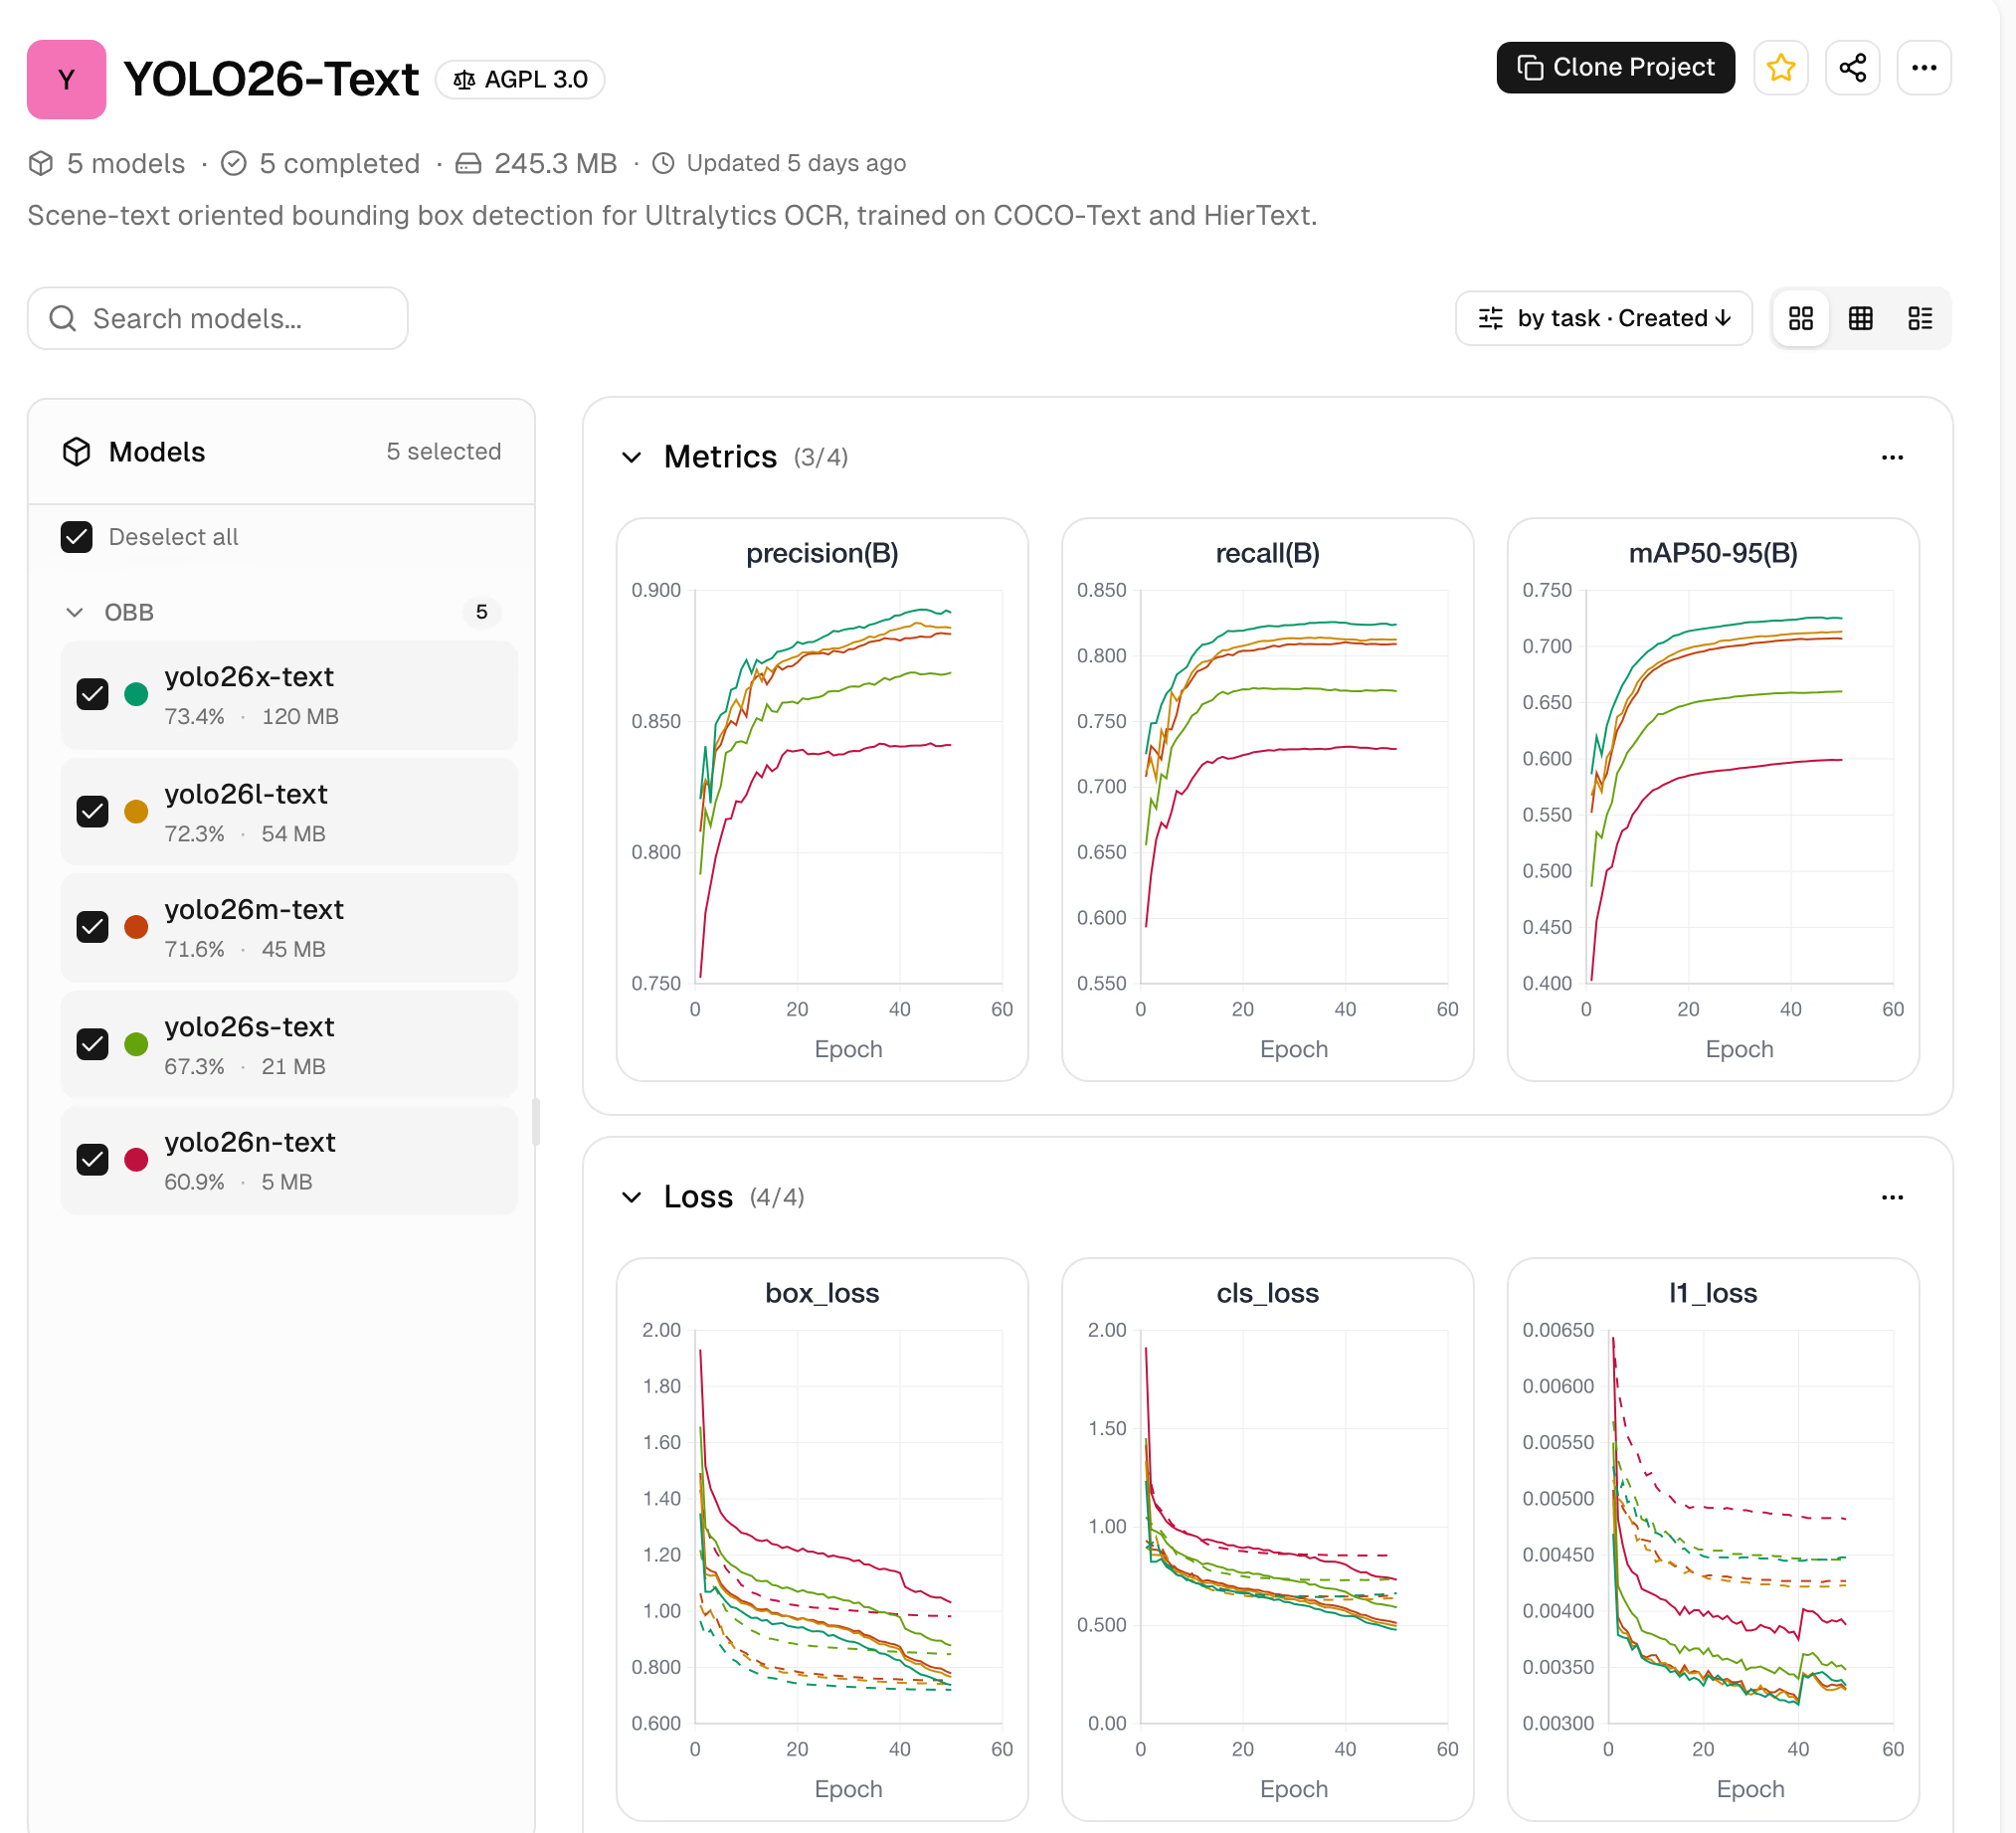
Ultralytics Platform上のYOLO26-Textプロジェクト:学習中の適合率、再現率、mAP50-95、損失曲線と、5種類すべての検出器サイズ。
独自のドキュメントに適応させるには、COCO-TextとHierTextを統合した、65,325枚の画像と約129万個の単語ポリゴンを含むScene Text OBBデータセットから始めてください。
具体的な制限事項は次のとおりです。
- 文字体系。デフォルトの認識モデルは、キリル文字、韓国語、アラビア語、ヘブライ語、デーヴァナーガリー文字、タイ語にはまだ対応していません。検出器を独自の認識モデルと組み合わせるか、これらに対応するエンジンを選んでください。
- 方向の混在。このソリューションはページ内で主流のテキスト方向に合わせてページ全体を回転させます。そのため、縦書きの余白注記など、1ページ内で複数の方向にテキストが並んでいる場合、読み取り精度が低下することがあります。
- エクスポート。認識モデルはエクスポートした検出器ファイルに組み込まれないため、検出器と認識ランタイムを並行してデプロイするか、Pythonソリューションを連携処理に使い続けてください。
- Rust。Ultralytics Inferenceは、
ultralytics-inference predict --ocrを通じて同じPP-OCRv6認識モデルでシーンテキストをRust上で読み取ります。ただし、方向の処理にはPythonソリューションのページ回転処理ではなく、分類器を使用します。 - プライバシー。Pythonソリューションは自社のハードウェア上で動作するため、ページを自社のマシンの外に送信する必要はありません。一方、ブラウザーのデモでは推論のためにページをアップロードします。読み取ってはならないフィールドについては、OCRの実行前に既知の領域を不透明なマスクで覆ってください。
フォームや契約書では、まずカスタムYOLOモデルでフィールド、表、署名、スタンプを検出し、必要な領域だけを読み取ることができます。Ultralytics PlatformのSignatureデータセットとスマートドキュメント分析ガイドがよい出発点です。また、Ultralytics Platformを使うと、ページのラベル付けとモデルの学習を1か所で行えます。手持ちのページでまずOCRを試すには、画像またはPDFをOCRライブデモにドロップしてください。
よくある質問
pip install -U "ultralytics>=8.4.211"でUltralyticsパッケージをインストールし、OpenCVで読み込んだ画像に対してsolutions.OCR()を呼び出します。読み取り順に、認識した単語のテキスト、信頼度、行番号、ポリゴンが返されます。初回実行時にYOLO26-Text検出器とPP-OCRv6認識モデルが自動的にダウンロードされます。適切なモデルは、ドキュメント、言語、ハードウェアによって異なります。人気のオープンソースOCRモデルの概要では、主な選択肢を比較しています。画像サイズ1280、RTX PRO 6000で実施したベンチマークでは、YOLO26x-TextとPP-OCRv6は6ページのPDFで単語F1スコア0.931、80枚のHierText写真で0.722を記録し、あらゆる回転角度のページを読み取ります。キリル文字や韓国語など、まだ対応していない文字体系には、その文字体系で学習した認識モデルを使用してください。
YOLOモデルはテキストを検出しますが、読み取りは行いません。Ultralytics YOLO26-Textはテキストを回転ボックスとして検出し、OCRソリューションは各クロップをPP-OCRv6認識モデルに渡すため、両者を組み合わせることで1回の呼び出しでOCR全体を実行できます。
はい。PyMuPDFの
get_pixmapなどを使ってPDFの各ページを画像にレンダリングし、BGRに変換してsolutions.OCR()に渡します。ブラウザーでは、デモとPlatform PredictタブでPDFを受け付け、最初のページを読み取ります。はい。PP-OCRv6はONNX Runtimeを使ってCPUまたはCUDA GPUで実行でき、同じスクリプトをどちらでも使用できます。オプションのTensorRT認識器にはNVIDIA GPUが必要です。
デフォルトの認識器では、まだ対応していません。PP-OCRv6は中国語、日本語、ラテン文字を使う言語に対応していますが、キリル文字、ハングル、アラビア文字、ヘブライ文字、デーヴァナーガリー文字、タイ文字には対応していません。YOLO26-Text検出器はそのまま使用し、該当する文字体系向けに学習させた認識器を渡すことができます。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









