시맨틱 세그멘테이션과 인스턴스 세그멘테이션: 적합한 작업을 선택하는 방법
시맨틱 세그멘테이션은 모든 픽셀에 클래스를 지정하고, 인스턴스 세그멘테이션은 각 객체를 구분합니다. 컴퓨터 비전 프로젝트에 어떤 방식이 필요한지, 그 이유는 무엇인지 알아보세요.
시맨틱 세그멘테이션과 인스턴스 세그멘테이션은 모두 픽셀 수준에서 이미지에 라벨을 지정하지만, 서로 다른 질문에 답합니다. 시맨틱 세그멘테이션은 모든 픽셀에 클래스를 지정하므로 장면의 모든 자동차가 하나의 "자동차" 영역으로 합쳐집니다. 인스턴스 세그멘테이션은 각 객체를 분리하므로 자동차마다 고유한 마스크가 지정됩니다. 어떤 방식을 선택할지는 한 가지 질문으로 결정할 수 있습니다. 각 픽셀에 무엇이 있는지 알아야 하나요, 아니면 각 픽셀이 어떤 객체에 속하는지 알아야 하나요? 이 가이드는 적절한 방식을 선택하는 데 도움을 드립니다. 또한 각 작업의 라벨링 비용과 평가 방법도 다룹니다. Ultralytics YOLO는 동일한 프레임워크에서 두 작업을 모두 지원합니다.
한 줄로 보는 차이점#
- 시맨틱 세그멘테이션은 모든 픽셀을 도로, 하늘, 사람 또는 자동차와 같은 카테고리로 분류합니다. 같은 클래스에 속하는 객체는 하나의 영역으로 합쳐집니다. 용어 설명은 시맨틱 세그멘테이션을 참조하세요.
- 인스턴스 세그멘테이션은 각각의 개별 객체를 찾아 고유한 마스크와 ID를 부여합니다. 일반적으로 셀 수 있는 객체를 다루며 하늘이나 잔디와 같은 배경은 제외합니다. 용어 설명은 인스턴스 세그멘테이션을 참조하세요.
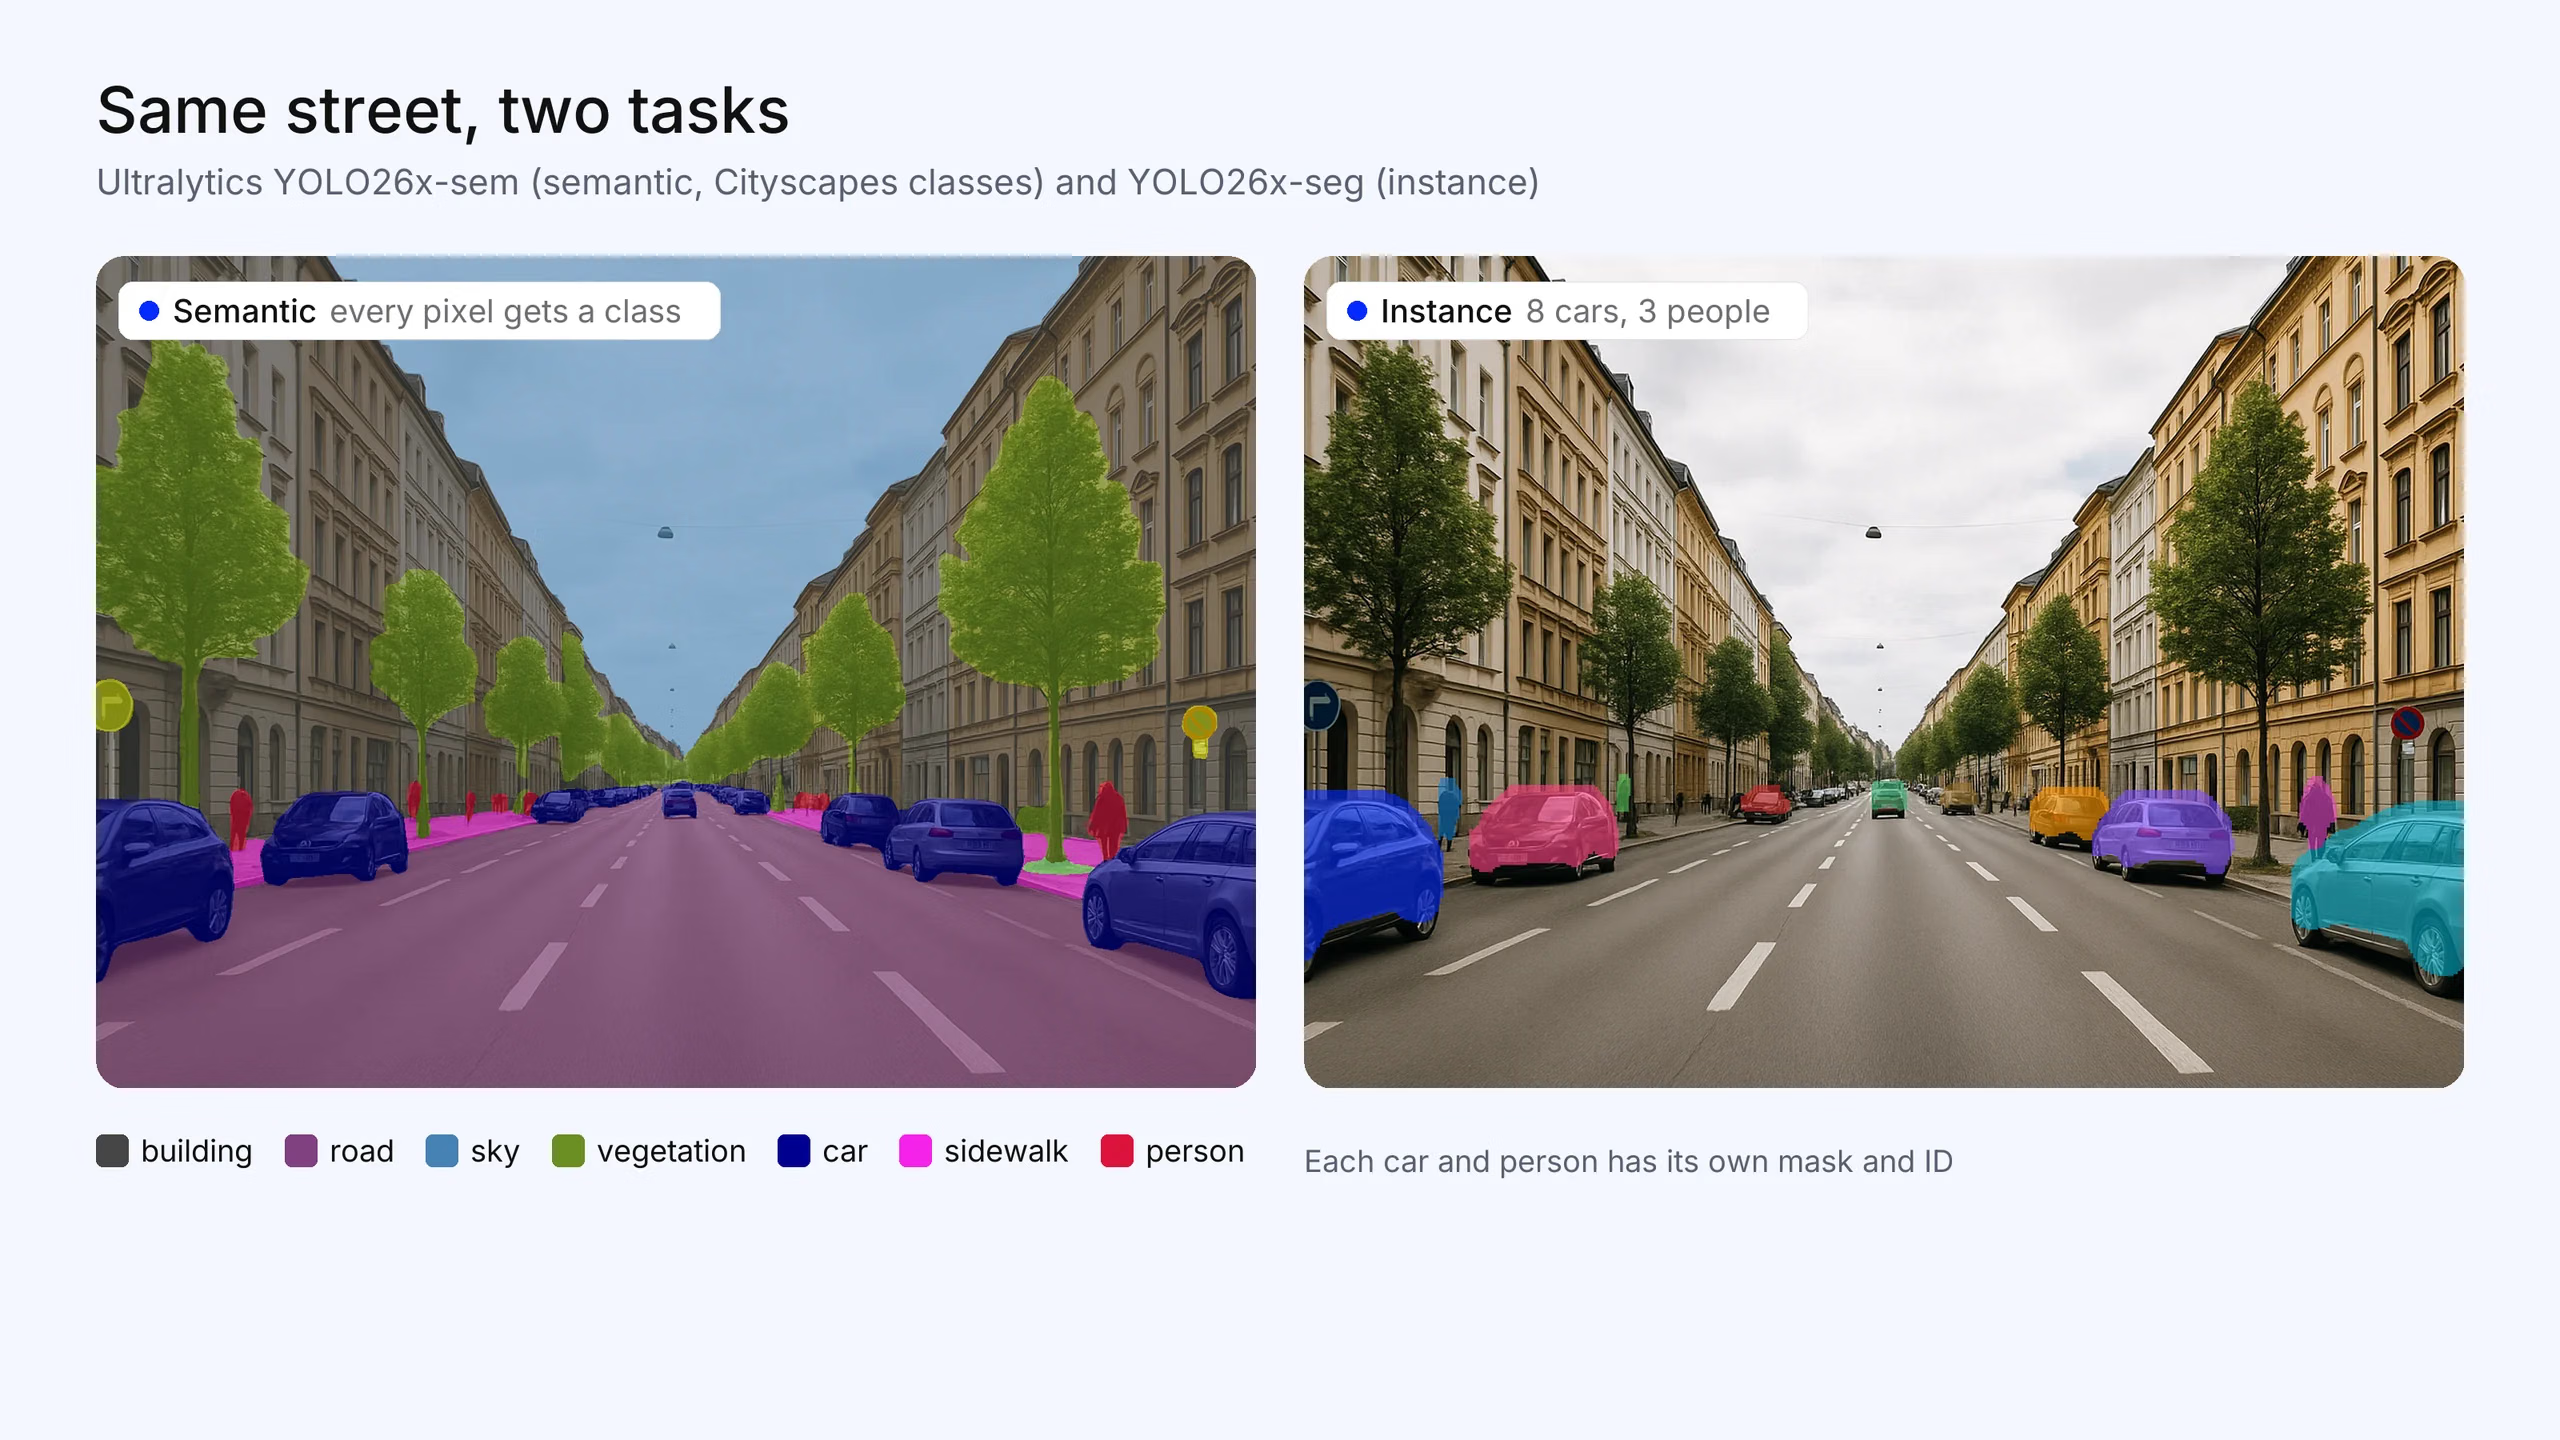
그림 1. 같은 거리에 두 작업을 모두 적용한 결과입니다. Ultralytics YOLO26x-sem(Cityscapes 클래스)은 모든 픽셀에 라벨을 지정하므로 모든 자동차가 하나의 "자동차" 클래스로 표시됩니다. Ultralytics YOLO26x-seg는 탐지한 자동차 8대와 사람 3명 각각에 고유한 마스크를 지정합니다(신뢰도 0.5 이상). 이 사진은 이 글을 위해 생성했으며, 마스크는 실제 모델 출력입니다.
프로젝트에 필요한 작업은 무엇인가요?#
애플리케이션이 답해야 하는 질문부터 시작하세요.
| 애플리케이션에서 필요한 작업… | 사용할 작업 | 예시 |
|---|---|---|
| 장면에서 특정 클래스가 차지하는 면적을 파악하기 | 시맨틱 | 주행 가능한 도로 면적, 작물 대 잡초 비율, 토지 피복 |
| 객체만큼 세밀하게 배경 영역에도 라벨 지정하기 | 시맨틱 | 하늘, 물, 식생, 스캔 이미지의 조직 유형 |
| 객체 수 세기 | 인스턴스 | 나무의 열매, 줄을 선 사람 |
| 비디오 프레임 간 객체 추적하기 | 인스턴스 및 추적기 | 장면을 이동하는 사람 또는 차량 |
| 객체 하나씩 측정하거나 조작하기 | 인스턴스 | 더미에서 부품 하나를 집는 로봇, 결함별 크기 측정 |
| 전체 장면을 빠짐없이 처리하면서 객체도 각각 분리하기 | 파놉틱 | 자율 주행을 위한 도로 장면 |
확신이 서지 않는다면 서로 맞닿은 같은 클래스의 객체 두 개를 구분해야 하는지 생각해 보세요. 그렇다면 인스턴스 세그멘테이션(또는 파놉틱 세그멘테이션)이 필요합니다. 그렇지 않다면 시맨틱 세그멘테이션이 더 간단하고 일반적으로 실행 비용도 낮습니다.
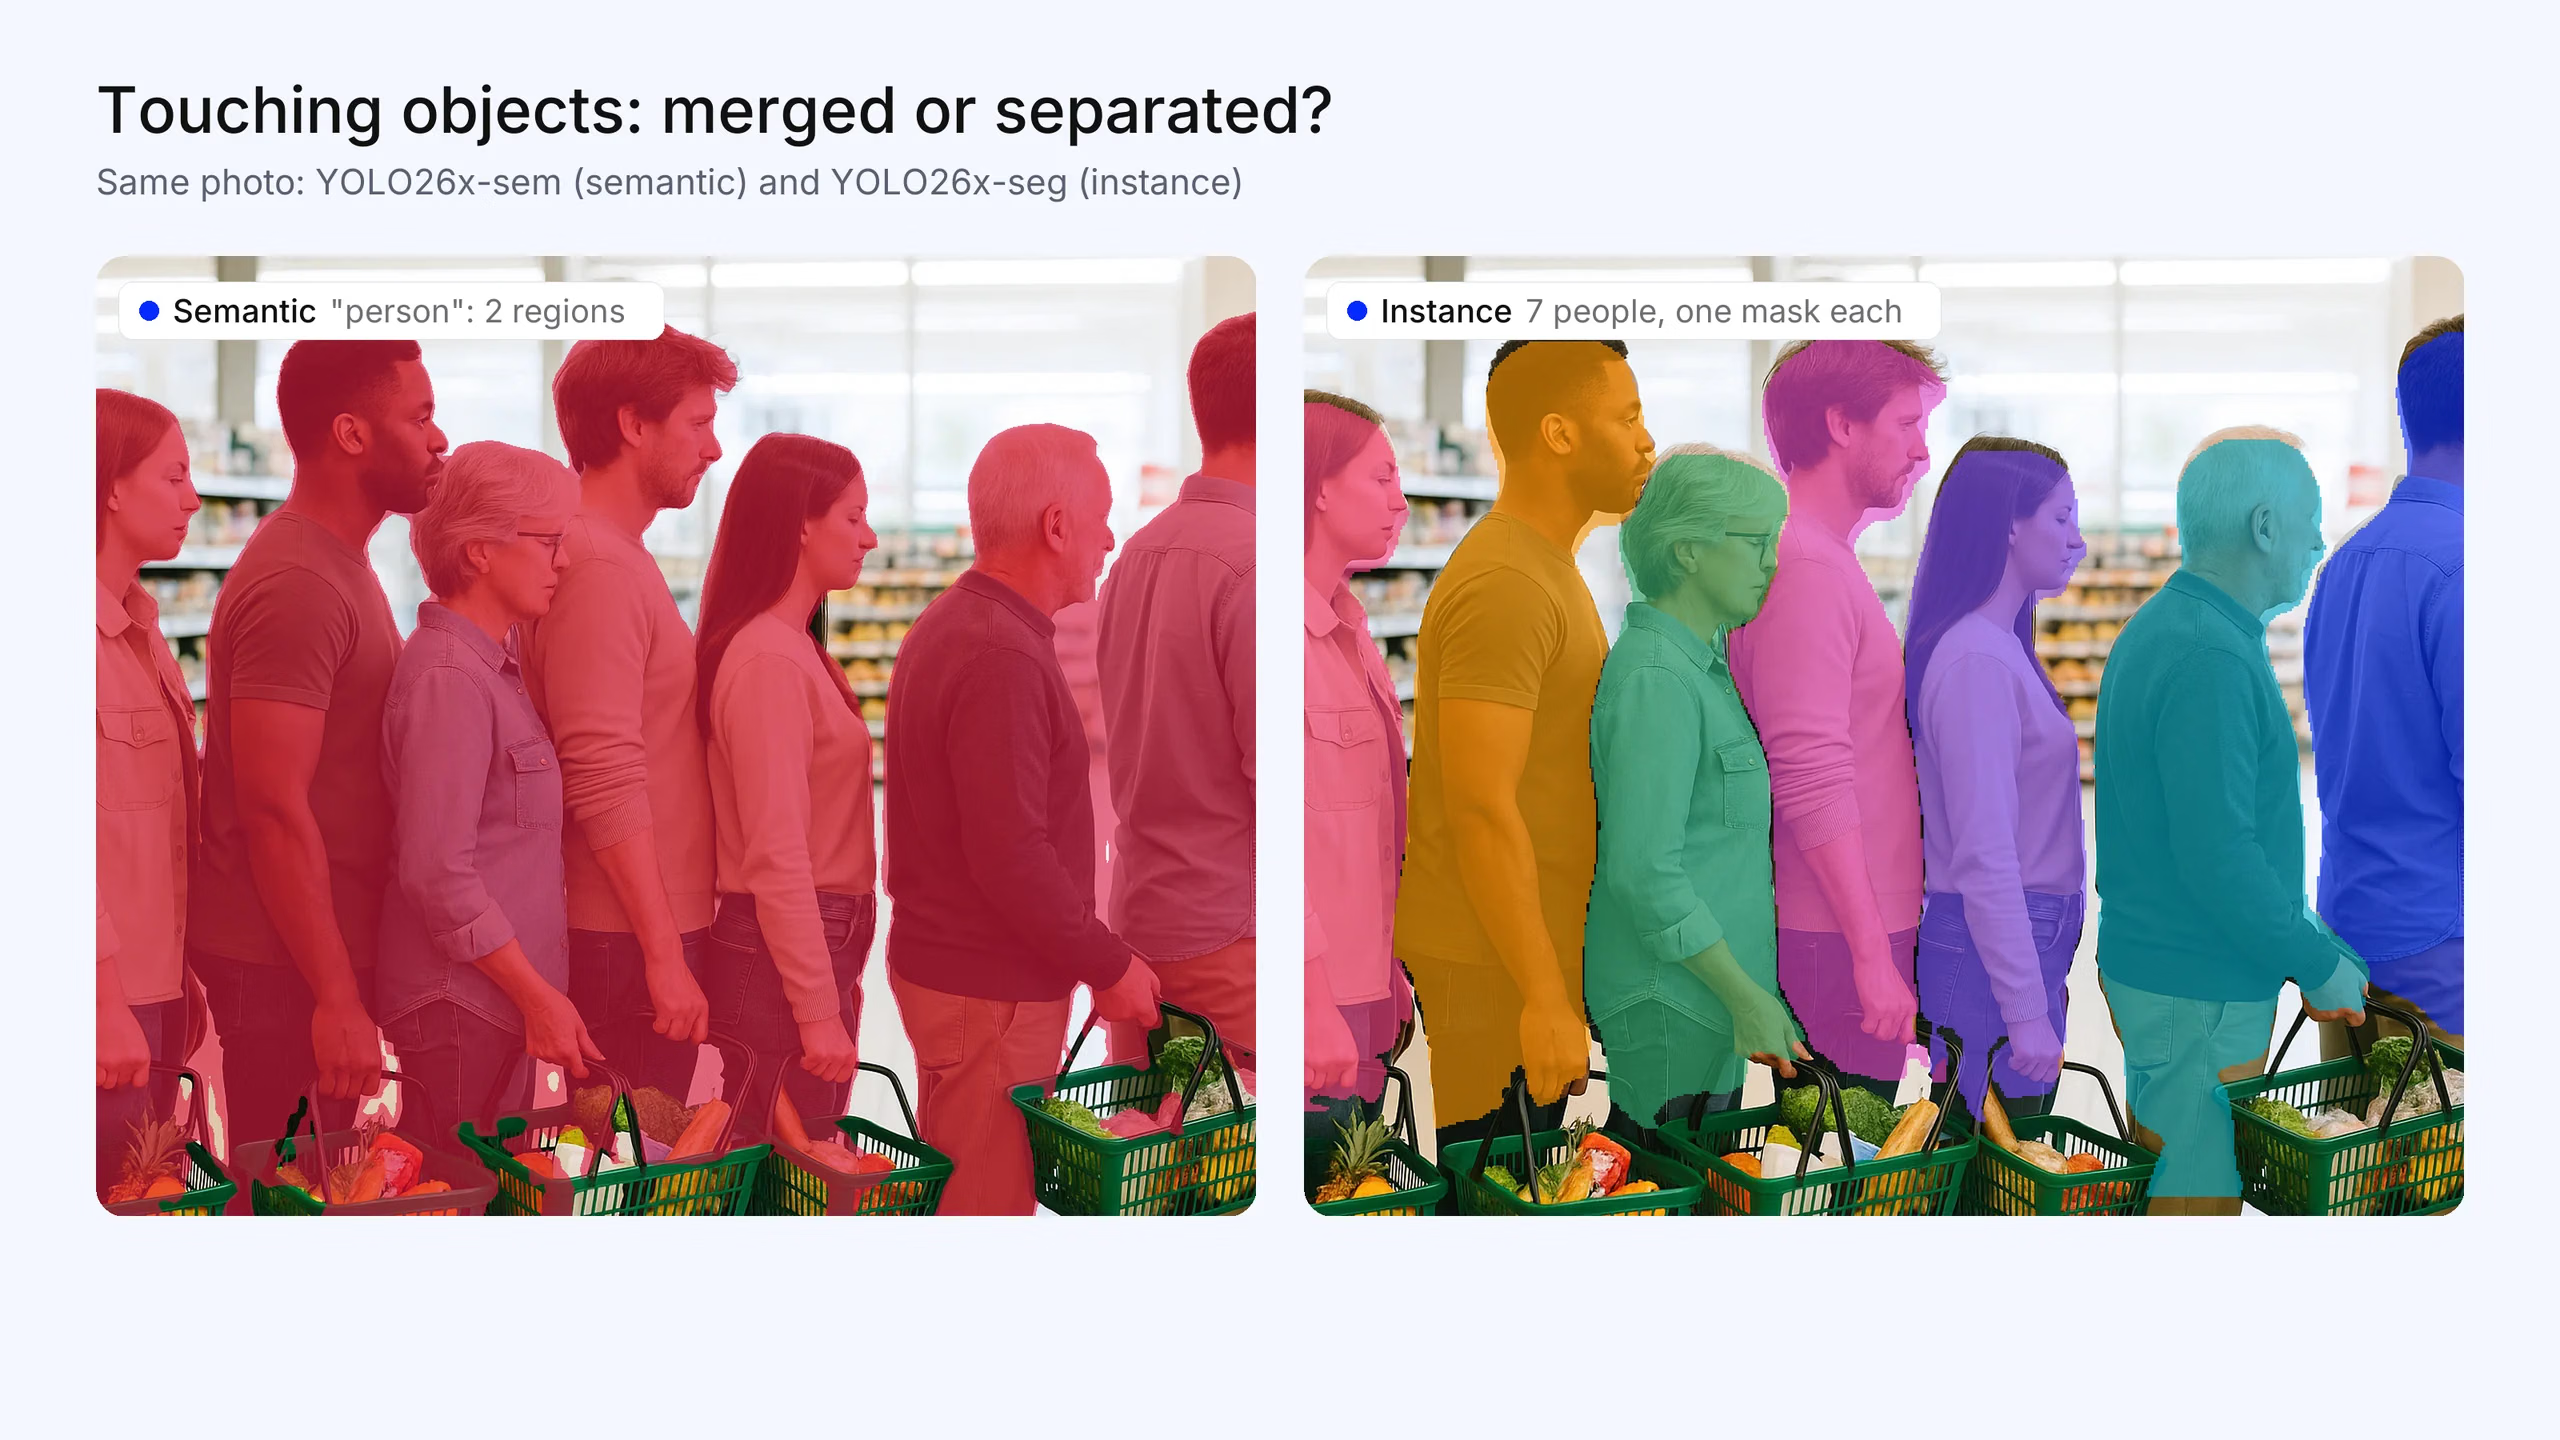
그림 2. 계산대 줄에 가까이 서 있는 쇼핑객 7명입니다. 시맨틱 출력(Ultralytics YOLO26x-sem)에서는 두 개의 연결된 "사람" 영역으로 합쳐져 이 결과만으로는 인원수를 셀 수 없습니다. 인스턴스 출력(Ultralytics YOLO26x-seg)에서는 7명 모두 분리됩니다. 이 사진은 이 글을 위해 생성했으며, 마스크는 실제 모델 출력입니다.
주요 차이점 한눈에 보기#
| 기준 | 시맨틱 세그멘테이션 | 인스턴스 분할 |
|---|---|---|
| 답하는 질문 | 각 픽셀의 클래스는 무엇인가요? | 각 픽셀은 어떤 객체에 속하나요? |
| 같은 클래스에 속하는 객체 | 하나의 영역으로 병합 | 각각 고유한 마스크와 ID로 분리 |
| 적용 범위 | 배경을 포함한 모든 픽셀 | 일반적으로 관심 대상 객체만 |
| 출력 | 이미지와 크기가 같은 단일 클래스 맵 | 클래스 및 신뢰도가 각각 포함된 마스크 목록 |
| 객체 수를 셀 수 있나요? | 직접 셀 수 없음 | 예 |
| 주요 지표 | 평균 교집합 대비 합집합(mIoU) | 마스크 평균 정밀도(mask mAP) |
| 상대적 복잡도 | 낮음: 픽셀별 분류 | 높음: 탐지와 객체별 마스크 생성 |
각 작업의 라벨링 비용#
실제로는 라벨링 작업량에 따라 선택이 결정되는 경우가 많습니다.
- 시맨틱 데이터 세트는 배경을 포함해 모든 이미지의 모든 픽셀에 클래스를 지정합니다. 일반적으로 단일 채널 마스크 이미지로 저장됩니다. 모든 이미지에 라벨을 완전히 지정하므로, 픽셀을 명시적으로 "무시"로 표시하지 않는 한 어떤 픽셀도 건너뛸 수 없습니다.
- 인스턴스 데이터 세트는 관심 객체 각각의 윤곽을 폴리곤이나 마스크로 개별 표시합니다. 배경에는 라벨을 지정하지 않아도 되지만, 모든 객체에 자체 윤곽이 필요하며 객체가 밀집한 장면에서는 작업량이 크게 늘어납니다.
두 작업 모두 노동 집약적입니다. 클릭이나 박스를 마스크로 변환하는 보조 어노테이션은 어느 작업에서든 수고를 줄여줍니다. 영역 수준의 결과만 필요하다면 인스턴스 라벨링에 비용을 들이지 마세요.
각 작업의 평가 방법#
- 시맨틱 세그멘테이션은 주로 mIoU로 측정합니다. 예측 영역과 정답 영역의 겹침을 클래스별로 계산한 뒤 평균을 구합니다. 픽셀 정확도도 보고합니다. IoU는 탐지에서 사용하는 것과 동일한 겹침 측정 방식입니다.
- 인스턴스 세그멘테이션은 마스크 mAP로 측정합니다. 이는 탐지에 사용되는 평균 정밀도를 마스크 겹침을 기준으로 계산한 값입니다. 올바른 픽셀을 덮는 것뿐 아니라 각 객체를 찾아내는 능력도 평가합니다.
이 지표들은 서로 비교할 수 없습니다. mIoU가 높더라도 개별 객체가 분리되었는지는 알 수 없습니다.
파놉틱 세그멘테이션: 두 가지가 모두 필요한 경우#
파놉틱 세그멘테이션은 모든 픽셀에 클래스를 지정하고, 셀 수 있는 객체에는 인스턴스 ID를 부여합니다. 도로와 하늘처럼 배경을 구성하는 "stuff"에는 시맨틱 라벨을 지정합니다. 자동차와 사람처럼 전경을 구성하는 "things"는 하나씩 분리합니다. 평가는 파놉틱 품질(PQ)로 수행합니다. 전체 장면을 빠짐없이 처리하면서 객체별 분리도 동시에 필요한 경우 선택하세요. 파놉틱 세그멘테이션을 참조하세요.
각 작업의 간단한 작동 방식#
시맨틱 세그멘테이션 모델은 일반적으로 모든 픽셀의 클래스를 예측하는 인코더-디코더 네트워크입니다. U-Net, DeepLab, SegFormer가 잘 알려진 예입니다. 인스턴스 세그멘테이션 모델은 보통 객체 탐지 모델을 기반으로 합니다. Mask R-CNN은 탐지된 각 박스 안의 마스크를 예측하며, YOLACT 및 Ultralytics YOLO 세그멘테이션 모델과 같은 단일 단계 모델은 실시간 사용을 위해 한 번의 추론으로 박스와 마스크를 예측합니다. Mask2Former와 같은 범용 아키텍처는 하나의 모델로 시맨틱, 인스턴스, 파놉틱 세그멘테이션을 처리합니다. 인스턴스 세그멘테이션에 대한 자세한 내용은 인스턴스 세그멘테이션이란을 참조하세요.
Ultralytics YOLO에서 두 작업 모두 지원#
Ultralytics YOLO는 동일한 Python API와 CLI로 두 작업을 모두 실행합니다:
- 인스턴스 세그멘테이션에는
segment작업을 사용합니다. - 시맨틱 세그멘테이션에는
semantic작업을 사용합니다. YOLO26 시맨틱 모델에는-sem접미사가 붙으며 Cityscapes와 ADE20K 데이터셋으로 사전 학습됩니다. 작업 페이지에는 두 작업의 출력이 코드에서 정확히 어떻게 다른지 보여 주는 표가 있습니다.
두 작업 모두 로컬 또는 클라우드에서 Ultralytics Platform을 통해 학습할 수 있습니다.
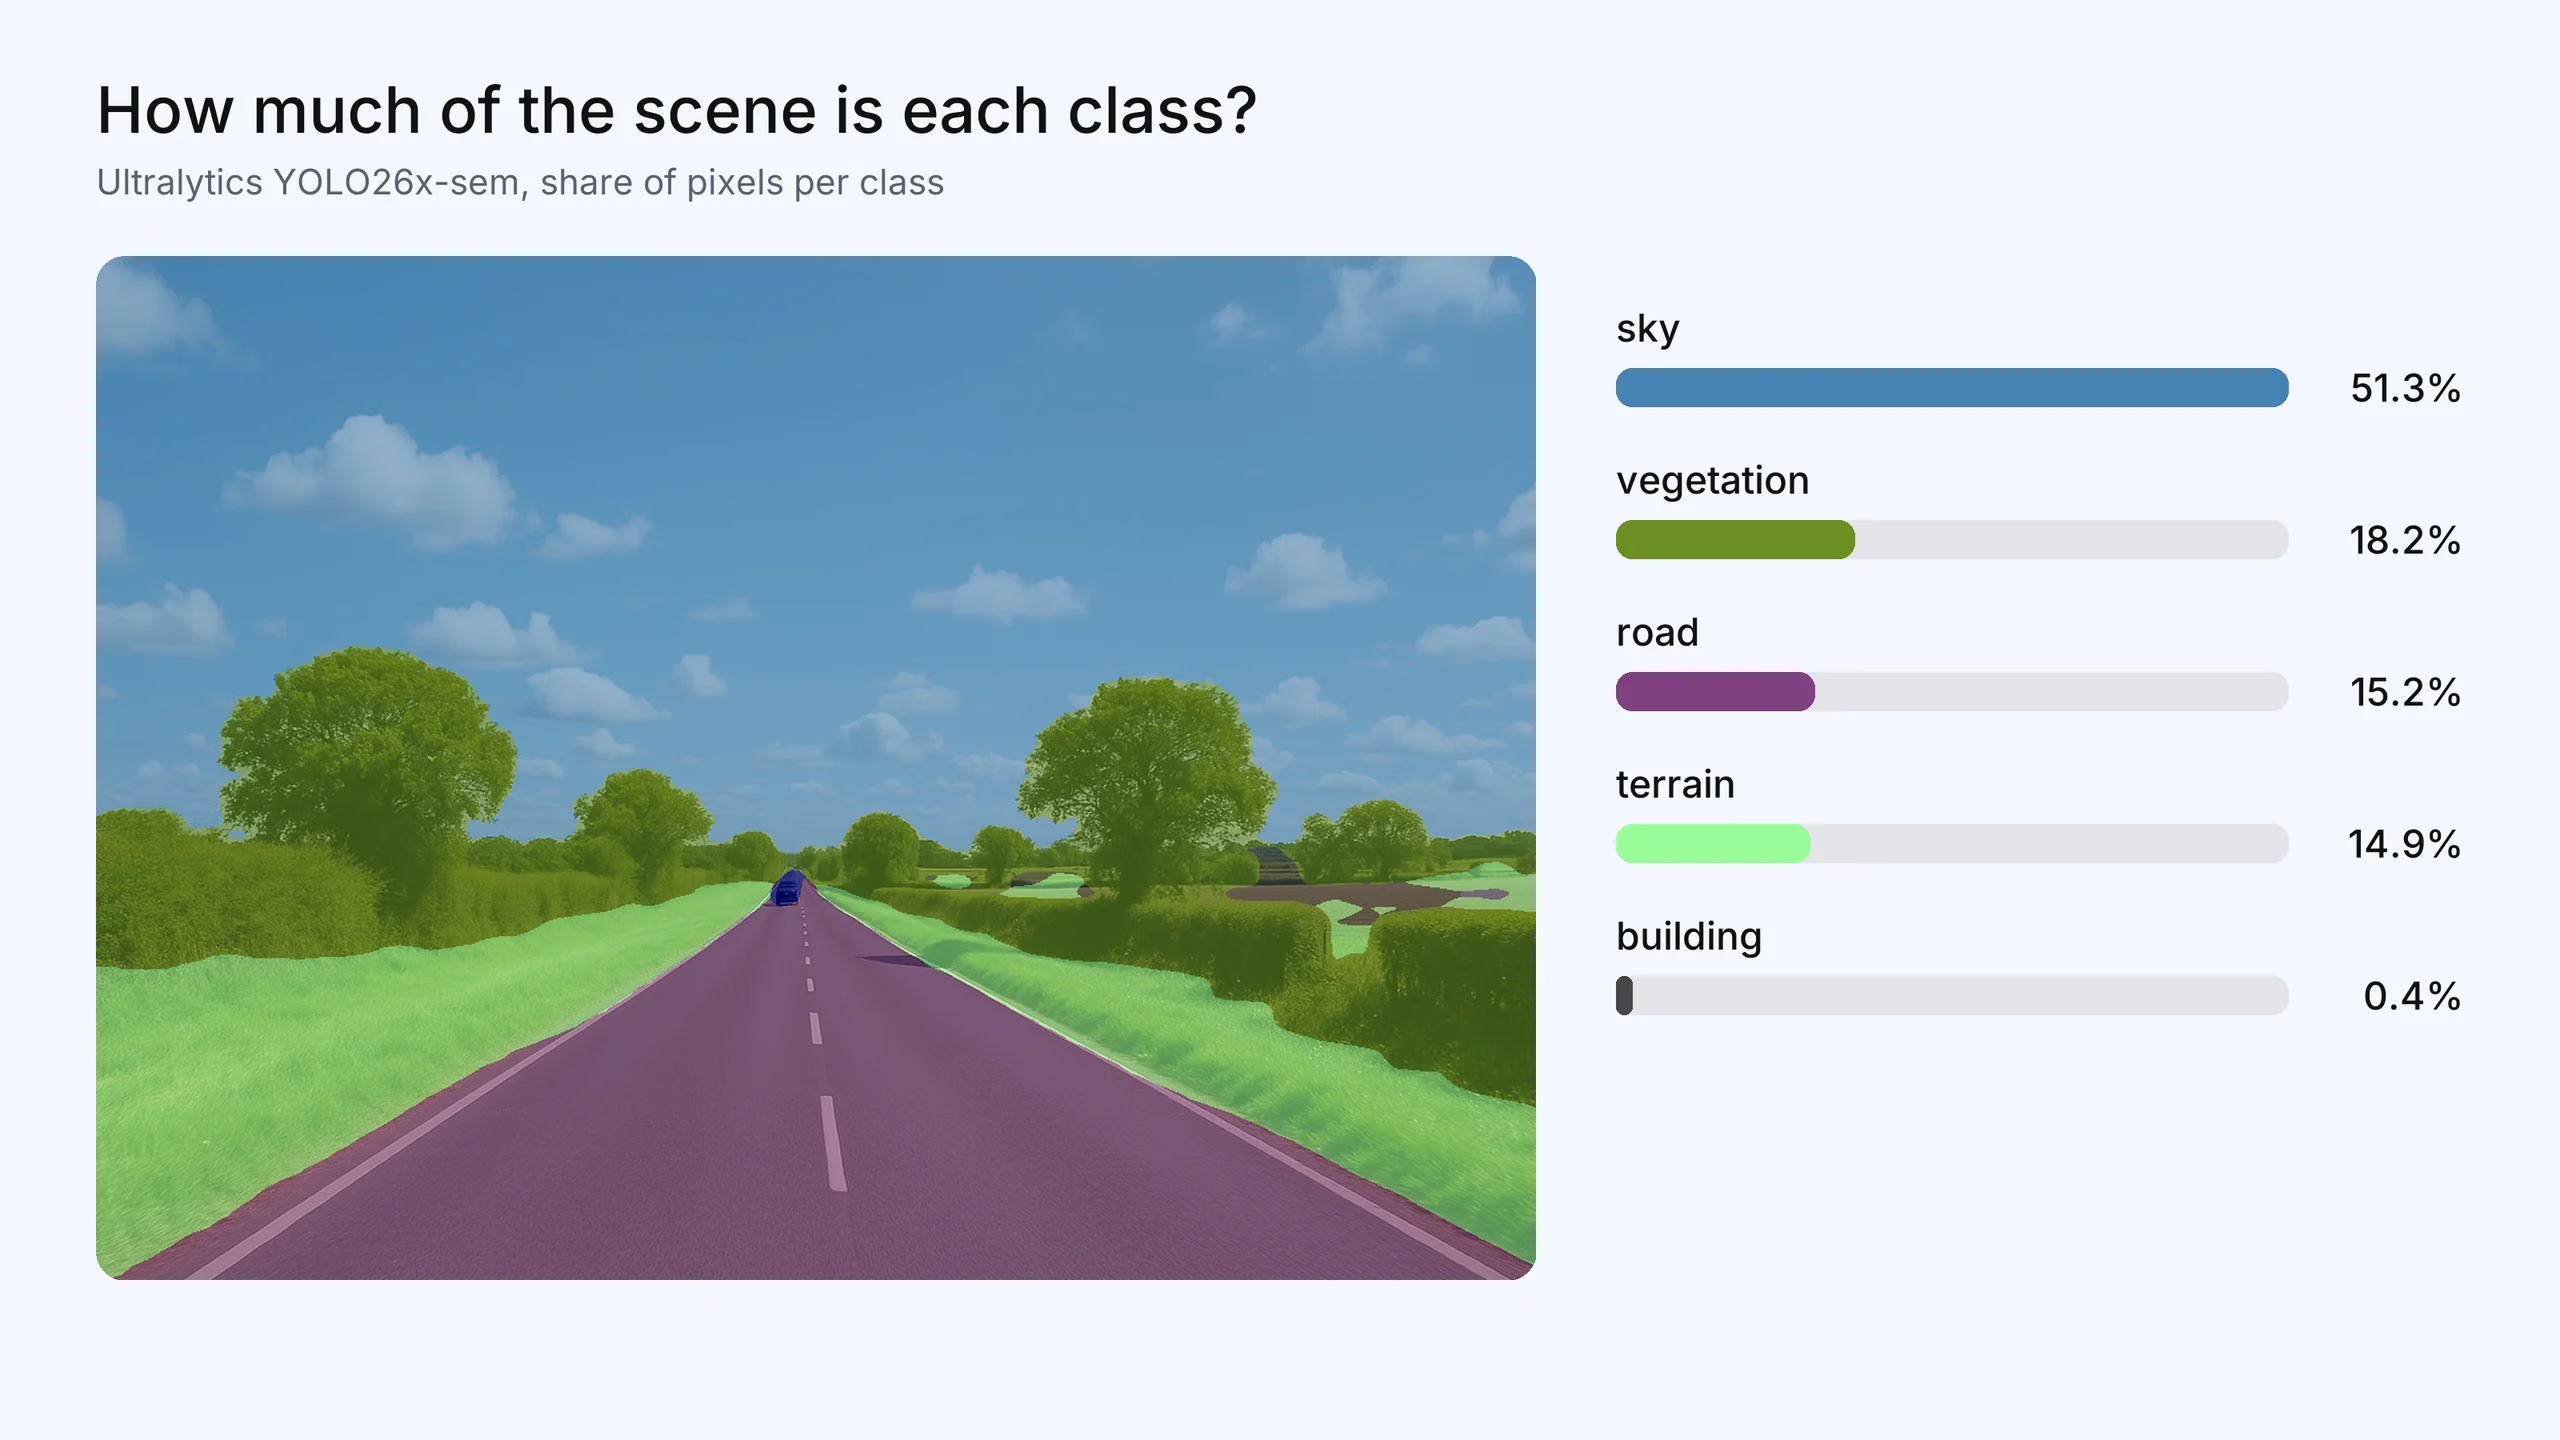
그림 3. 시맨틱 세그멘테이션은 "장면에서 각 클래스가 얼마나 많은 부분을 차지하는가"에 답합니다. Ultralytics YOLO26x-sem은 이 화면의 51.3%를 하늘, 18.2%를 식생, 15.2%를 도로, 14.9%를 지형으로 분류합니다. 사진은 이 글을 위해 생성했으며, 클래스 맵과 비율은 실제 모델 출력입니다.
자주 묻는 질문
시맨틱 세그멘테이션은 모든 픽셀에 클래스를 지정하지만, 같은 클래스에 속하는 모든 객체를 하나의 영역으로 취급합니다. 인스턴스 세그멘테이션은 각 객체를 개별 마스크로 분리하므로 같은 클래스의 객체를 각각 세고 추적할 수 있습니다.
같은 클래스에 속한 두 객체가 서로 맞닿아 있을 때 이를 구분해야 하는지 생각해 보세요. 개별 객체를 세거나 추적하거나 대상으로 동작해야 한다면 인스턴스 세그멘테이션을 사용하세요. 어떤 영역이 어떤 클래스에 속하는지만 알면 된다면 시맨틱 세그멘테이션이 더 간단합니다.
Mask R-CNN은 인스턴스 세그멘테이션 모델입니다. 각 객체를 감지한 다음 해당 객체의 바운딩 박스 안에서 별도의 픽셀 마스크를 예측합니다.
일반적으로 인스턴스 세그멘테이션이 더 어렵습니다. 픽셀을 분류하는 동시에 같은 클래스의 객체들을 분리해야 하므로 세그멘테이션뿐 아니라 객체 감지도 필요합니다.
주로 평균 교집합 대비 합집합(mIoU)으로 측정합니다. 이는 클래스 전반에 걸쳐 예측 영역과 정답 영역이 겹치는 정도의 평균입니다. 인스턴스 세그멘테이션에는 마스크 mAP를 사용하고, 파노픽 세그멘테이션에는 파노픽 품질(PQ)을 사용합니다.









