최고의 이미지 분류 모델: 선택 방법
ConvNeXt V2와 DINOv3부터 EfficientNetV2, ViT, Ultralytics YOLO26-cls까지 주요 이미지 분류 모델을 비교하고, 적합한 모델을 선택하는 방법을 알아보세요.
이미지 분류 모델 중 단 하나만 최고라고 할 수는 없습니다. 적합한 모델은 보유한 라벨링 데이터의 양, 모델을 실행해야 하는 환경, 라이선스 사용 가능 여부에 따라 달라집니다. 2026년 기준으로 정확도를 최우선으로 하는 작업에서는 DINOv3와 EVA-02 같은 대규모 Transformer 및 자기지도 사전 학습 백본이 주목받고 있습니다. 제한된 하드웨어에 배포할 때는 체크포인트 크기, 학습 설정, 대상 하드웨어에 따라 ConvNeXt V2, EfficientNetV2, MobileNetV4, Ultralytics YOLO26-cls와 같은 더 작고 대부분 합성곱 기반인 모델이 실용적인 경우가 많습니다. 실제 작업에서 정확도와 지연 시간을 비교해 보세요. 이 가이드에서는 네 가지 모델 계열을 설명하고 널리 사용되는 모델 10개를 비교한 다음, 적합한 모델을 선택하는 절차를 안내합니다.
작업 자체를 처음 접하신다면 먼저 이미지 분류란 무엇인지부터 살펴보세요. 이 페이지에서는 모델 선택을 다룹니다.
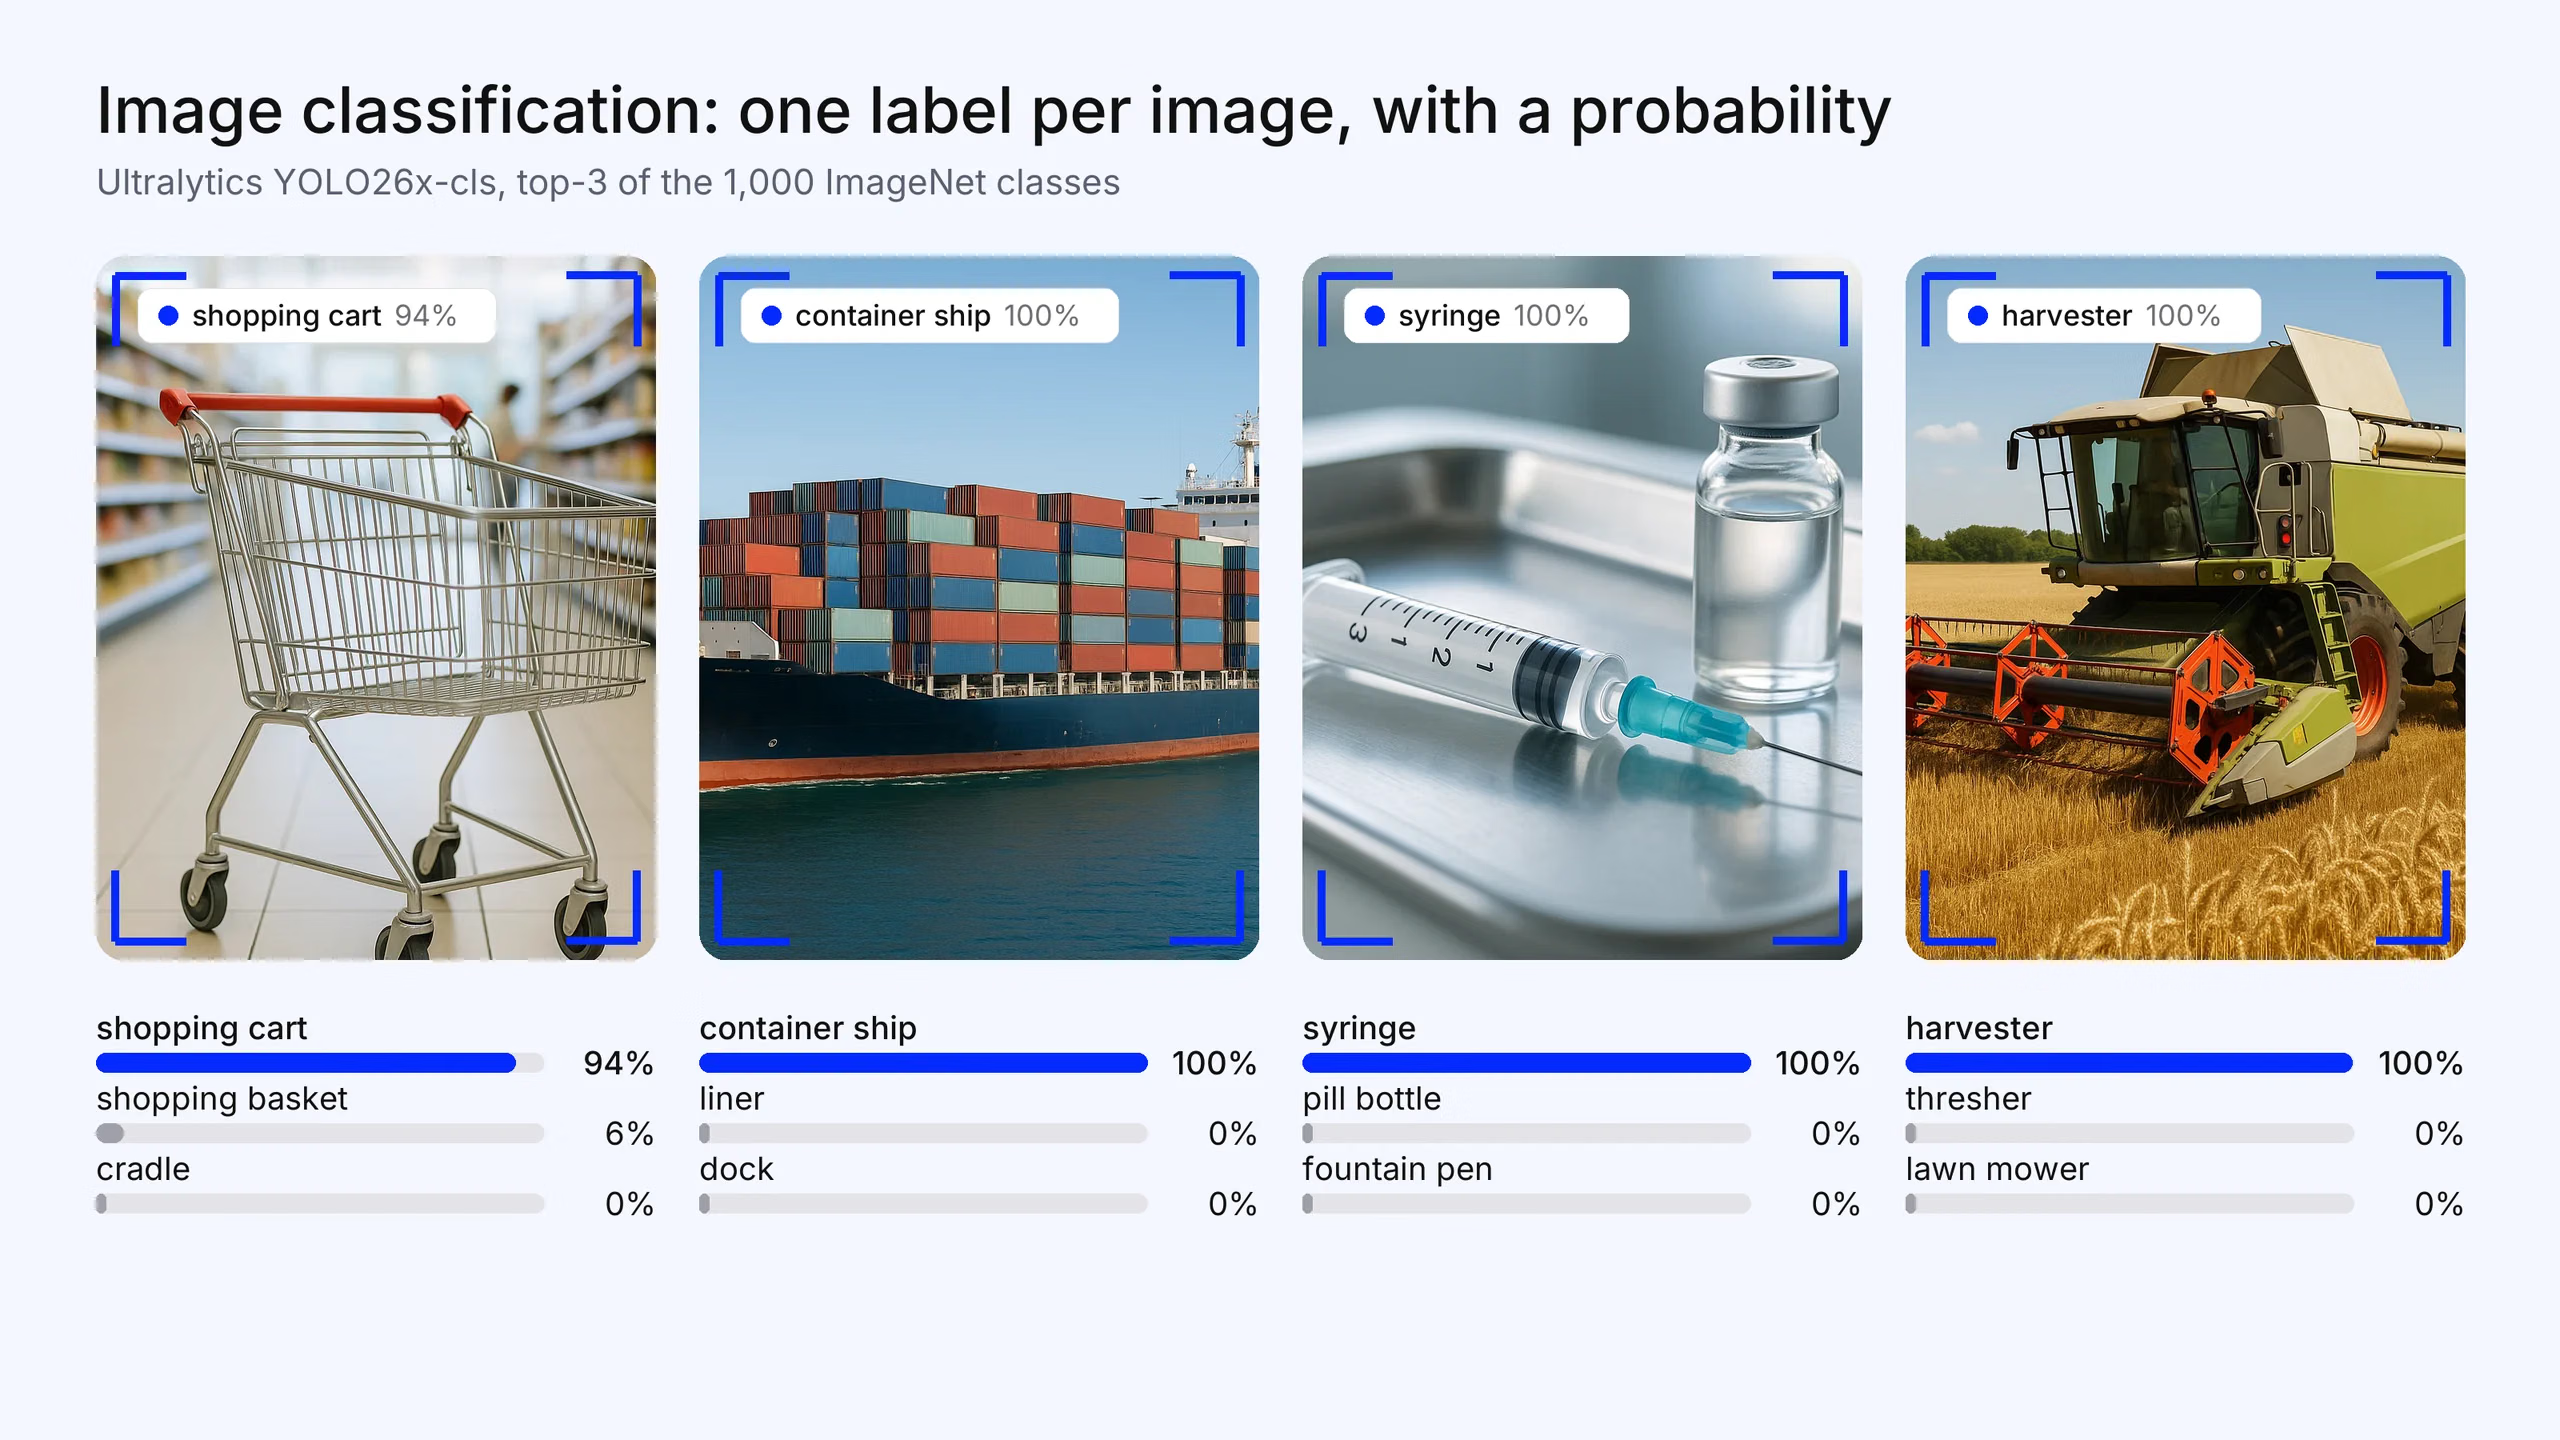
그림 1. 이미지 분류는 이미지 전체에 하나의 레이블을 반환하고 각 클래스에 대한 확률을 함께 제공합니다. 소매, 물류, 의료, 농업 분야의 예시입니다. ImageNet 1,000개 클래스로 사전 학습된 Ultralytics YOLO26x-cls의 상위 3개 예측 결과입니다. 사진은 이 글을 위해 생성했으며, 예측 결과는 실제 모델 출력입니다.
이미지 분류 모델에서 '최고'가 의미하는 것#
리더보드는 ImageNet 검증 세트의 top-1 정확도를 기준으로 모델 순위를 매깁니다. 이 수치는 유용하지만, 고정된 해상도와 단일 데이터 세트에서 측정되며, 사전 학습에 매우 큰 데이터 세트를 사용한 경우가 많습니다. 실제 프로젝트에서는 보통 다음 네 가지 요소가 더 중요합니다.
- 데이터. 클래스별 라벨링 이미지가 얼마나 있는지, 그리고 이미지가 사전 학습 데이터와 얼마나 유사한지 확인합니다.
- 연산 자원과 지연 시간. 추론을 데이터 센터 GPU, CPU, 휴대폰 또는 카메라 NPU 중 어디에서 실행하는지 확인합니다.
- 배포 경로. 모델을 ONNX, TensorRT, Core ML, TFLite와 같이 필요한 런타임으로 원활하게 내보낼 수 있는지 확인합니다.
- 라이선스. 코드와 사전 학습 가중치의 라이선스가 각각 사용 목적을 허용하는지 확인합니다.
ImageNet 성능은 몇 퍼센트포인트 낮더라도 보유 이미지로 파인튜닝이 잘 되고 하드웨어에서 실시간으로 실행되는 모델이 대체로 더 나은 선택입니다.
이미지 분류 모델의 네 가지 계열#
합성곱 신경망(CNNs)#
CNNs는 학습된 필터를 이미지 전반에 적용하므로 인접한 픽셀끼리 관련되어 있다고 가정합니다. 이러한 내재적 가정(귀납적 편향) 덕분에 작은 규모와 중간 규모의 데이터 세트에서도 잘 학습하고, 제한적인 하드웨어에서도 효율적으로 실행할 수 있습니다. 대표적인 예로 ResNet과 EfficientNet이 있습니다.
- 장점: 데이터 효율성이 높고 빠르며, 양자화와 배포가 쉽습니다.
- 단점: 계층별 전역 문맥 정보가 적고, 모델 규모를 키웠을 때의 성능 향상이 Transformer보다 더 일찍 둔화되는 경향이 있습니다.
비전 트랜스포머(ViT)#
비전 Transformer는 이미지를 패치로 나누고 셀프 어텐션을 적용해 시퀀스로 처리하므로 모든 패치가 다른 모든 패치와 연관될 수 있습니다. ViT는 대규모 데이터로 사전 학습한 다음 전이했을 때 가장 좋은 성능을 보입니다.
- 장점: 데이터와 모델 크기를 늘릴 때 성능이 잘 확장되고, 전이 성능이 뛰어나며, 자기지도 및 멀티모달 학습의 자연스러운 기반이 됩니다.
- 단점: 대규모 사전 학습이나 강한 정규화가 필요하며, 일반적으로 정확도가 비슷한 CNN보다 추론 속도가 느리고 연산 부담이 큽니다.
CNN과 Transformer 하이브리드 모델#
하이브리드 모델은 초기 단계에서 합성곱을 사용해 국소 세부 정보를 처리하고, 후반 단계에서 어텐션을 사용해 전역 문맥을 파악합니다. CoAtNet은 대표적인 설계입니다. 저자들은 합성곱 계층과 어텐션 계층을 원칙에 따라 순서대로 쌓으면 일반화 성능, 모델 용량, 효율성이 향상된다는 점을 확인했습니다.
- 장점: 중간 규모 데이터 세트에서 균형이 좋습니다.
- 단점: 순수한 합성곱 방식이나 순수한 어텐션 방식보다 구현, 튜닝, 내보내기가 복잡합니다.
자기지도 및 비전-언어 백본#
가장 새로운 계열은 아키텍처가 아니라 학습 방식으로 구분됩니다. DINOv2와 DINOv3 같은 자기지도 모델은 라벨이 없는 이미지로 학습합니다. SigLIP 2와 같은 비전-언어 인코더는 이미지-텍스트 쌍으로 학습합니다. 두 방식 모두 작은 선형 헤드로 분류할 수 있는 범용 특징을 생성합니다. 비전-언어 모델의 경우 텍스트 프롬프트를 사용하면 학습 없이도 분류할 수 있습니다(제로샷 학습). Meta는 DINOv3를 17억 개 이미지로 70억 개 파라미터 규모로 학습했습니다. DINOv2는 1억 4,200만 개 이미지와 11억 개 파라미터로 학습했습니다.
- 장점: 라벨링 데이터가 적어도 강력한 특징을 얻을 수 있으며, 하나의 백본으로 여러 작업을 처리할 수 있습니다.
- 단점: 가장 큰 체크포인트는 엣지 디바이스에서 사용하기에 지나치게 무겁고, 라이선스는 모델마다 다르므로 확인이 필요합니다.
이미지 분류 모델 비교#
모델은 순위가 아닌 알파벳순으로 나열했습니다. 정확도 수치는 포함하지 않았습니다. 공개된 ImageNet 수치는 해상도, 사전 학습 데이터, 평가 방식에 따라 달라지므로 표의 모델 간에 직접 비교할 수 없습니다. 아래에 연결된 각 모델의 논문이나 문서에서 해당 모델의 수치를 확인할 수 있습니다.
| 모델 | 계열 | 개발 기관 | 사전 학습 | 적합한 용도 | 주요 절충점 |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | 자기지도 마스크드 오토인코딩(FCMAE) 후 지도 파인튜닝 | 다양한 크기로 제공되는 정확도 높은 배포용 CNN | ImageNet 가중치는 CC-BY-NC(비상업적 용도)입니다. |
| DINOv3 | 자기지도(ViT 및 ConvNeXt) | Meta | 17억 개 이미지로 자기지도 학습 | 고정된 백본으로 강력한 특징을 추출하며 라벨링 데이터가 적게 필요합니다. | DINOv3 전용 라이선스이며, 최대 모델은 70억 개 파라미터로 구성됩니다. |
| EfficientNetV2 | CNN | 지도 학습 | 빠른 학습과 효율적인 파인튜닝 | 오래된 설계이며 최신 백본이 정확도 면에서 앞섭니다. | |
| EVA-02 | ViT | BAAI | CLIP 특징을 활용한 마스크드 이미지 모델링 | 정확도 우선 연구 및 파인튜닝 | 대형 변형 모델은 추론 시 연산 부담이 큽니다. |
| MobileNetV4 | CNN 및 하이브리드(모바일) | 지도 학습 | 휴대폰, NPU, 엣지 가속기 | 서버급 모델보다 낮은 정확도 한계 | |
| ResNet | CNN | Microsoft Research | 지도 학습 | 기준 모델, 교육, 레거시 파이프라인 | FLOP당 정확도 면에서 더 이상 경쟁력이 없습니다. |
| SigLIP 2 | 비전-언어(ViT) | 이미지-텍스트 쌍, 다국어 | 제로샷 및 개방형 어휘 분류 | 제로샷 결과에 의존하기 전에 사용하려는 클래스에서 결과를 검증하세요. | |
| Swin Transformer | ViT(계층형) | Microsoft Research | 지도 학습 | 고해상도 입력, 백본 재사용 | 정확도가 비슷한 CNN보다 연산 부담이 큽니다. |
| Ultralytics YOLO26-cls | CNN | Ultralytics | ImageNet으로 지도 학습 | 빠른 맞춤형 분류기, 엣지 내보내기, 탐지와 동일한 API | 대규모 사전 학습 Transformer보다 낮은 정확도 한계 |
| ViT | ViT | 지도 학습(대개 대규모 데이터 세트 사용) | 대규모 전이 학습 | 대규모 사전 학습이 없으면 많은 데이터가 필요합니다. |
모델 상세 정보#
알파벳순으로 나열했습니다.
ConvNeXt V2#
ConvNeXt V2는 완전 합성곱 마스크드 오토인코더(FCMAE)와 전역 응답 정규화 계층을 결합합니다. Atto(370만 개 파라미터)부터 Huge(6억 6,000만 개 파라미터)까지 8가지 크기로 제공되므로, 하나의 계열로 엣지부터 서버까지 아우를 수 있습니다. CNN 배포 방식을 유지하면서 Transformer 시대의 정확도를 원하는 경우 적합한 기본 모델입니다. 단점: 코드는 MIT 라이선스이지만, ImageNet 사전 학습 가중치와 파인튜닝 가중치는 CC-BY-NC 라이선스이므로 상업적으로 사용할 수 없습니다.
DINOv3#
DINOv3는 Meta의 자기지도 비전 백본입니다. ViT-S/16부터 ViT-7B/16까지의 ViT 모델과 온디바이스 사용을 위한 증류 ConvNeXt 모델로 제공됩니다. Meta는 백본을 고정한 상태에서 성능을 평가하며, 저장소에는 7B 모델용 ImageNet 분류 헤드가 포함되어 있습니다. 라벨이 적지만 전이 가능한 특징이 필요한 경우 사용해 볼 만한 모델입니다. 단점: 일반적인 오픈소스 라이선스가 아닌 DINOv3 전용 라이선스로 제공되며, 대표 성능은 가장 큰 모델에서 나온 결과입니다.
EfficientNetV2#
Google의 EfficientNetV2는 점진적 학습 방식을 사용합니다. 학습 중 이미지 크기를 키우고 이에 맞춰 정규화를 조정합니다. 그 결과 이전 모델보다 빠르게 학습하고 더 적은 파라미터를 사용합니다. 작은 규모에서 중간 규모의 데이터 세트로 파인튜닝할 때 여전히 신뢰할 수 있는 선택입니다. 단점: 2023~2025년 백본보다 오래된 모델이며, 정확도 면에서 더 이상 앞서지 않습니다. 기존 설계에 관한 배경은 EfficientNet 개요를 참고하세요.
EVA-02#
EVA-02는 대규모 CLIP 비전 인코더의 특징을 재구성하도록 마스크드 이미지 모델링으로 사전 학습한 기본 Transformer입니다. 600만 개부터 3억 400만 개까지 파라미터 수가 다른 네 가지 크기로 제공됩니다. 파인튜닝에 사용할 수 있도록 timm에 포함되어 있습니다. 단점: 대형 변형 모델은 파인튜닝과 서비스 운영에 비용이 많이 들며, 단순한 도메인 분류에는 지나치게 강력합니다.
MobileNetV4#
MobileNetV4는 모바일 CPU, DSP, GPU, Apple Neural Engine, Google Pixel EdgeTPU에서 효율적으로 작동하도록 설계된 Google의 최신 모바일 모델 계열입니다. 휴대폰이나 저전력 가속기에 자연스러운 선택입니다. 단점: 최고 수준의 정확도를 포기하고 지연 시간을 줄입니다.
ResNet#
ResNet은 잔차 연결을 도입했으며, 모든 프레임워크에서 지원되는 표준 기준 모델로 여전히 사용됩니다. 단점: 최신 CNN은 동일한 연산량으로 더 높은 정확도를 제공합니다. 아키텍처에 대한 설명은 ResNet-50이란 무엇인지를 참고하세요.
SigLIP 2#
SigLIP 2(SigLIP 용어집 항목 참고)는 Google의 다국어 비전-언어 인코더 계열입니다. 학습 없이 텍스트 레이블 목록과 이미지를 비교해 분류할 수 있으며(CLIP과 유사한 접근 방식), NaFlex 변형 모델은 입력의 원본 종횡비를 유지합니다. 레이블 세트가 자주 바뀌거나 아직 라벨링 데이터가 없는 경우 가장 적합합니다. 단점: 제로샷 성능은 도메인마다 다르므로, 결과에 의존하기 전에 사용하려는 클래스(예: 결함 유형)로 검증해야 합니다. 성능이 기대에 미치지 못하면 분류 헤드를 학습하거나 파인튜닝하세요.
Swin Transformer#
Swin Transformer는 이동된 로컬 윈도우 내에서 어텐션을 계산하므로 이미지 크기에 비례해 연산량이 증가하며, 고해상도 입력에 적합합니다. 단점: 정확도가 비슷한 CNN보다 연산 부담이 큽니다. ConvNeXt는 일반 합성곱만으로 Swin Transformer와 경쟁하도록 설계되었습니다.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls는 Ultralytics YOLO26의 분류 변형 모델입니다. 2.8M부터 29.6M까지의 파라미터를 사용하는 다섯 가지 크기(n, s, m, l, x)로 제공되며, 융합 후 기준으로 224픽셀 입력을 받고 ImageNet으로 사전 학습됩니다. 문서에는 ImageNet 검증 세트의 top-1 및 top-5 정확도와 각 크기의 CPU 및 GPU 지연 시간이 보고되어 있습니다. 동일한 Python API와 CLI로 분류, 탐지, 세그멘테이션, 포즈 모델을 학습하고 검증하며 내보낼 수 있습니다. 분류 모델은 ONNX, TensorRT, Core ML, OpenVINO, LiteRT 등을 포함한 형식으로 내보낼 수 있습니다. 이전 YOLO11-cls 모델도 동일한 다섯 가지 크기와 입력 크기를 사용합니다. 단점:
- 정확도 한계. x 모델도 EVA-02나 DINOv3 같은 대규모 사전 학습 Transformer와 비교하면 작으므로, 정확도 우선 연구에는 적합하지 않습니다.
- 기본적으로 정사각형 크롭을 사용합니다. 학습 시에는 무작위 크기 조정 크롭을, 검증 시에는 중앙 크롭을 사용하므로 종횡비가 매우 큰 이미지의 일부가 잘릴 수 있습니다. 문서에서는 기본 크기 조정 방식으로 바꾸는 방법을 설명합니다.
- 라이선스. Ultralytics 모델은 AGPL-3.0 라이선스를 따릅니다. 비공개 소스 상업적 사용에는 Ultralytics Enterprise 라이선스가 필요합니다.
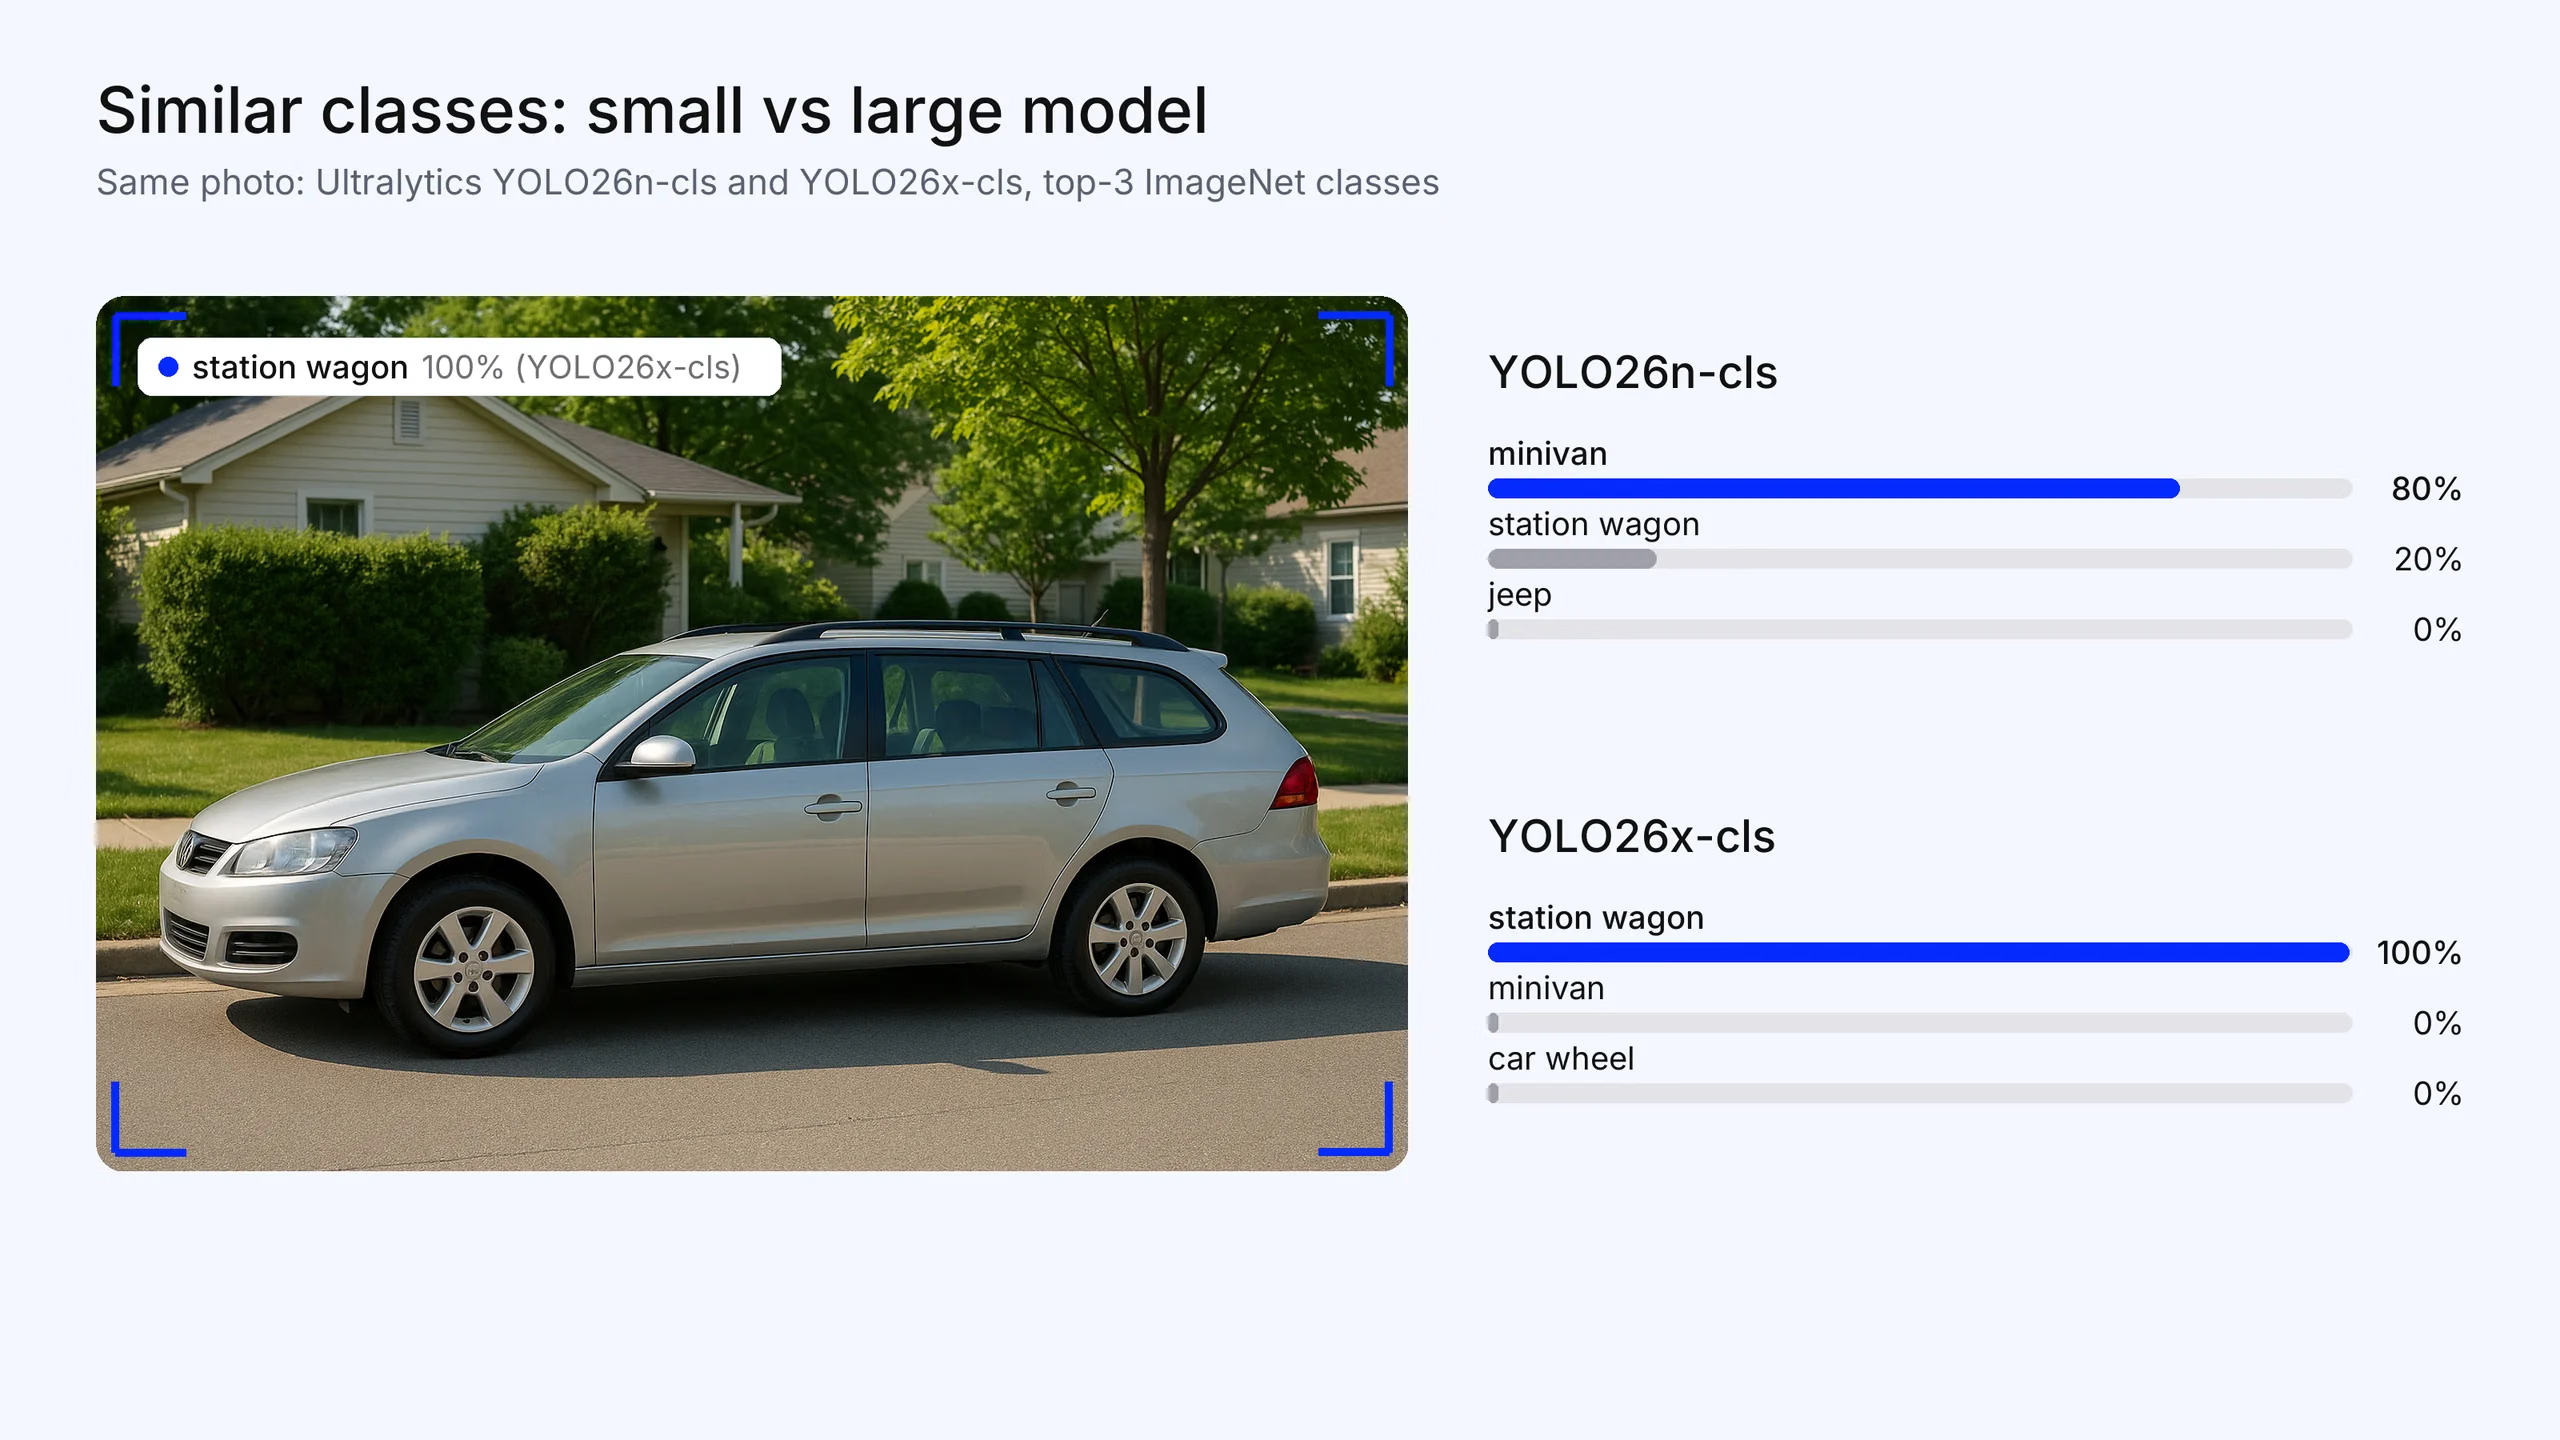
그림 2. 모델 크기의 차이는 유사한 클래스에서 두드러집니다. 스테이션 왜건 사진에서 Ultralytics YOLO26n-cls는 "미니밴"을 1위(80%)로 분류하지만, YOLO26x-cls는 스테이션 왜건을 1위(100%)로 분류합니다(ImageNet의 "beach wagon, station wagon" 클래스). 이처럼 세분화된 클래스는 자체 검증 세트에서 확인해 보세요. 이 사진은 이 글을 위해 생성했으며, 예측 결과는 실제 모델 출력입니다.
ViT#
Google의 최초 비전 트랜스포머는 이미지 패치만 사용하는 순수 Transformer도 대규모 데이터로 사전 학습하면 CNN과 대등하거나 더 나은 성능을 낼 수 있음을 보여주었습니다. 절충점: 대규모 사전 학습 없이는 소규모 데이터 세트에서 CNN보다 성능이 낮고, 추론 시 더 많은 연산이 필요합니다.
이미지 분류 모델 선택 방법#
다음 질문을 순서대로 살펴보세요.
- 라벨이 지정된 데이터가 있나요? 라벨이 지정된 예제가 없다면 SigLIP 2와 같은 비전-언어 모델로 제로샷 분류를 시작하세요. 라벨이 지정된 데이터 세트가 작다면, 학습한 선형 헤드를 적용한 동결 DINOv3 백본도 평가해 보세요.
- 어디에서 실행하나요? 휴대폰이나 NPU에서 실행한다면 MobileNetV4, YOLO26n-cls와 같은 소형 CNN 또는 소형 ConvNeXt V2를 우선 검토하세요. 엣지 GPU 또는 실시간 CPU에서 실행한다면 YOLO26-cls, EfficientNetV2 또는 ConvNeXt V2를 살펴보세요. 지연 시간 제약이 크지 않은 서버에서는 EVA-02, Swin 또는 DINOv3 ViT를 고려해 보세요.
- 클래스당 라벨이 지정된 데이터가 얼마나 있나요? 이미지가 수백 장에서 수천 장 정도라면, 사전 학습된 CNN이나 동결된 자기 지도 백본에서 전이 학습을 수행하는 것이 가장 안전한 방법입니다. 이미지가 수만 장 이상이라면 완전 미세 조정한 Transformer가 효과를 내기 시작합니다.
- 라이선스를 사용할 수 있나요? 코드뿐 아니라 가중치도 확인하세요. ConvNeXt V2의 ImageNet 가중치는 상업적 사용이 불가능하고, DINOv3에는 자체 라이선스가 있으며, Enterprise 라이선스를 보유하지 않은 경우 Ultralytics 모델에는 AGPL-3.0이 적용됩니다.
- 사용 중인 런타임으로 내보낼 수 있나요? 도입을 결정하기 전에 ONNX, TensorRT, Core ML 또는 TFLite로 내보낼 수 있는 지원 경로가 있는지 확인하세요.
그런 다음 최종 후보 모델 두세 개를 미세 조정하고 자체 검증 분할 데이터에서 비교하세요.
YOLO보다 다른 모델이 더 적합한 경우#
YOLO26-cls는 빠르고 쉽게 배포할 수 있는 맞춤형 분류기를 위해 설계되었습니다. 일부 작업에는 다른 모델이 더 적합합니다.
- 정확도 우선 연구 또는 벤치마크 작업: ImageNet 수준의 결과를 재현할 수 있는 학습 레시피와 가중치가 제공되는 EVA-02, ConvNeXt V2 또는 timm을 통한 ViT를 사용하세요.
- 라벨이 매우 적거나 하나의 백본에서 여러 다운스트림 작업을 수행하는 경우: 선형 헤드와 함께 DINOv3 특징을 사용하세요.
- 라벨 세트가 공개되어 있거나 자주 바뀌는 경우: SigLIP 2 제로샷을 사용하세요.
- Apple Neural Engine이나 EdgeTPU와 같은 휴대폰 NPU: MobileNetV4는 바로 이러한 타깃을 대상으로 설계되고 테스트되었습니다.
이미지에 무엇이 있는지만이 아니라 객체의 위치도 찾아야 한다면 디텍터가 필요합니다. 객체 탐지 모델 비교를 확인해 보세요.
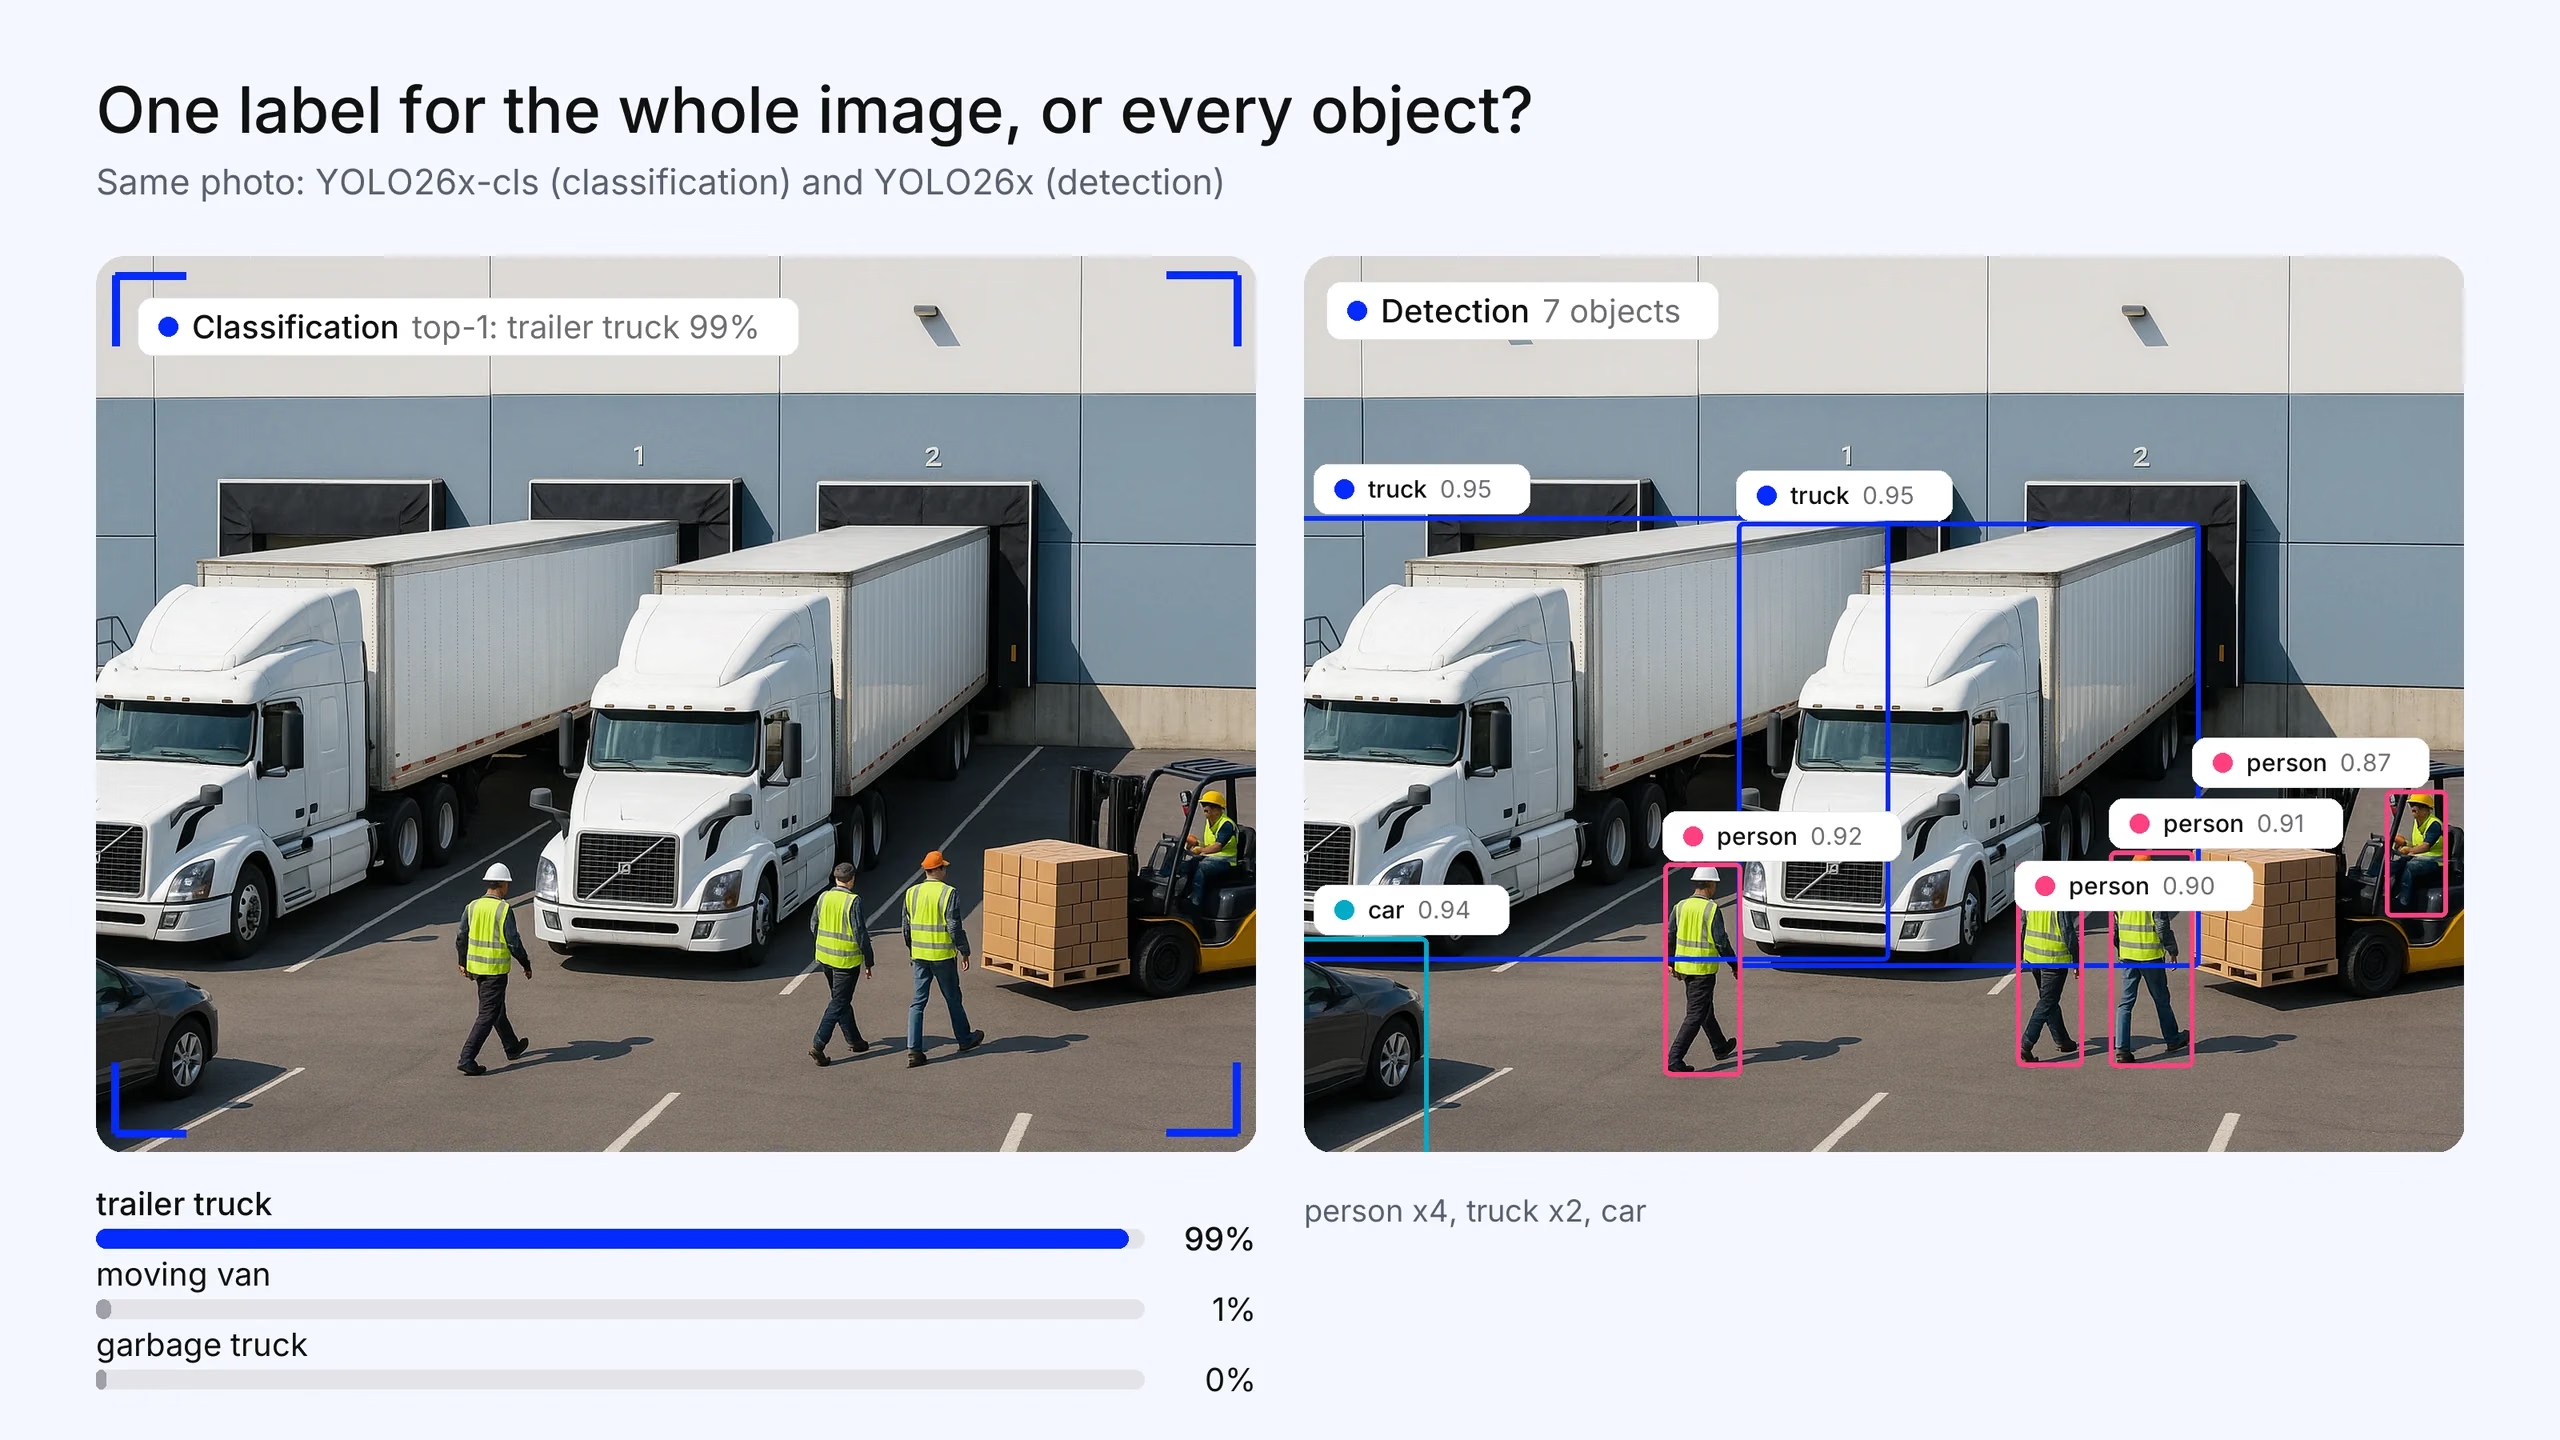
그림 3. 객체가 많은 장면에서도 분류기는 라벨 하나만 반환합니다. Ultralytics YOLO26x-cls는 이 물류 야적장을 "트레일러 트럭"으로 99%의 확률로 분류합니다. Ultralytics YOLO26x 탐지 모델은 객체 7개(사람 4명, 트럭 2대, 자동차 1대)를 찾아 각각에 박스를 표시합니다(신뢰도 0.5 이상). 이 사진은 이 글을 위해 생성했으며, 출력은 실제 결과입니다.
사전 학습된 모델을 구하고 직접 학습하는 방법#
- timm (PyTorch Image Models)에는 ViT와 ConvNeXt부터 MobileNetV4, EVA, DINOv3까지 위에 소개한 대부분의 백본이 포함되어 있으며, 학습 및 평가 스크립트도 제공됩니다. 코드는 Apache 2.0 라이선스이며, 가중치 라이선스는 모델마다 다릅니다.
- Hugging Face에는 SigLIP 2와 DINOv3를 포함한 대부분의 Transformer 분류기가 호스팅되며, 바로 사용할 수 있는 제로샷 및 이미지 분류 파이프라인도 제공됩니다.
- Ultralytics Python 패키지는 클래스별로 정렬된 이미지 폴더를 사용해 YOLO26-cls를 학습합니다. 분류 데이터 세트 형식과 분류 작업 가이드를 확인하세요.
- Ultralytics Platform은 동일한 모델에 어노테이션 및 클라우드 학습 기능을 추가합니다. 2026년에 출시되어 기존 호스팅 학습 서비스보다 최신 플랫폼입니다. 학습 후 모델 서빙에 대해서는 컴퓨터 비전 추론 플랫폼 비교를 확인하세요.
자주 묻는 질문
모든 상황에 적합한 단 하나의 모델은 없습니다. 연산 자원이 충분하고 정확도를 우선시하는 작업에서는 EVA-02 및 DINOv3와 같은 대형 Transformer 및 자기 지도 백본을 먼저 평가해 보세요. 제한된 하드웨어에서 프로덕션용으로 사용한다면 ConvNeXt V2, EfficientNetV2, MobileNetV4 및 Ultralytics YOLO26-cls와 같은 CNN이 더 실용적입니다. 라벨이 지정된 데이터 없이 분류하려면 SigLIP 2의 제로샷 분류 기능을 사용할 수 있습니다.
Transformer는 매우 큰 데이터 세트로 사전 학습하고 연산 자원이 충분할 때 대체로 더 높은 성능을 냅니다. CNN은 소규모에서 중간 규모 데이터 세트와 엣지 하드웨어에서 대체로 더 뛰어납니다. 로컬 구조에 대한 내재적 가정 덕분에 데이터 효율이 높고 빠르기 때문입니다. ConvNeXt와 같은 최신 CNN은 정확도 격차를 줄였으며, CoAtNet과 같은 하이브리드 모델은 두 방식을 결합합니다.
네. DINOv3는 범용 백본입니다. 동결된 모델로 특징을 추출하고 그 위에 소형 선형 분류기를 학습하면 됩니다. Meta의 저장소에는 가장 큰 모델을 위한 ImageNet 분류 헤드도 포함되어 있습니다. 상업적으로 사용하기 전에 DINOv3 라이선스를 확인하세요.
주로 top-1 정확도(최상위 예측이 정답인지 여부)와 top-5 정확도(정답 클래스가 점수가 가장 높은 상위 5개 예측에 포함되는지 여부)를 ImageNet 검증 세트에서 측정합니다. 클래스 불균형이 있는 맞춤형 데이터 세트에서는 전체 정확도보다 클래스별 정밀도, 재현율 또는 F1이 더 유용합니다.









