Ultralytics Platform에서 Amazon S3 데이터로 YOLO를 학습하고 호스팅 API로 배포하는 방법
Amazon S3 버킷의 이미지로 Ultralytics YOLO26을 학습하고 호스팅 API로 배포하는 방법을 Ultralytics Platform에서 단계별로 살펴보고 SageMaker와 비교합니다.
 Miles Deans12 분 읽기
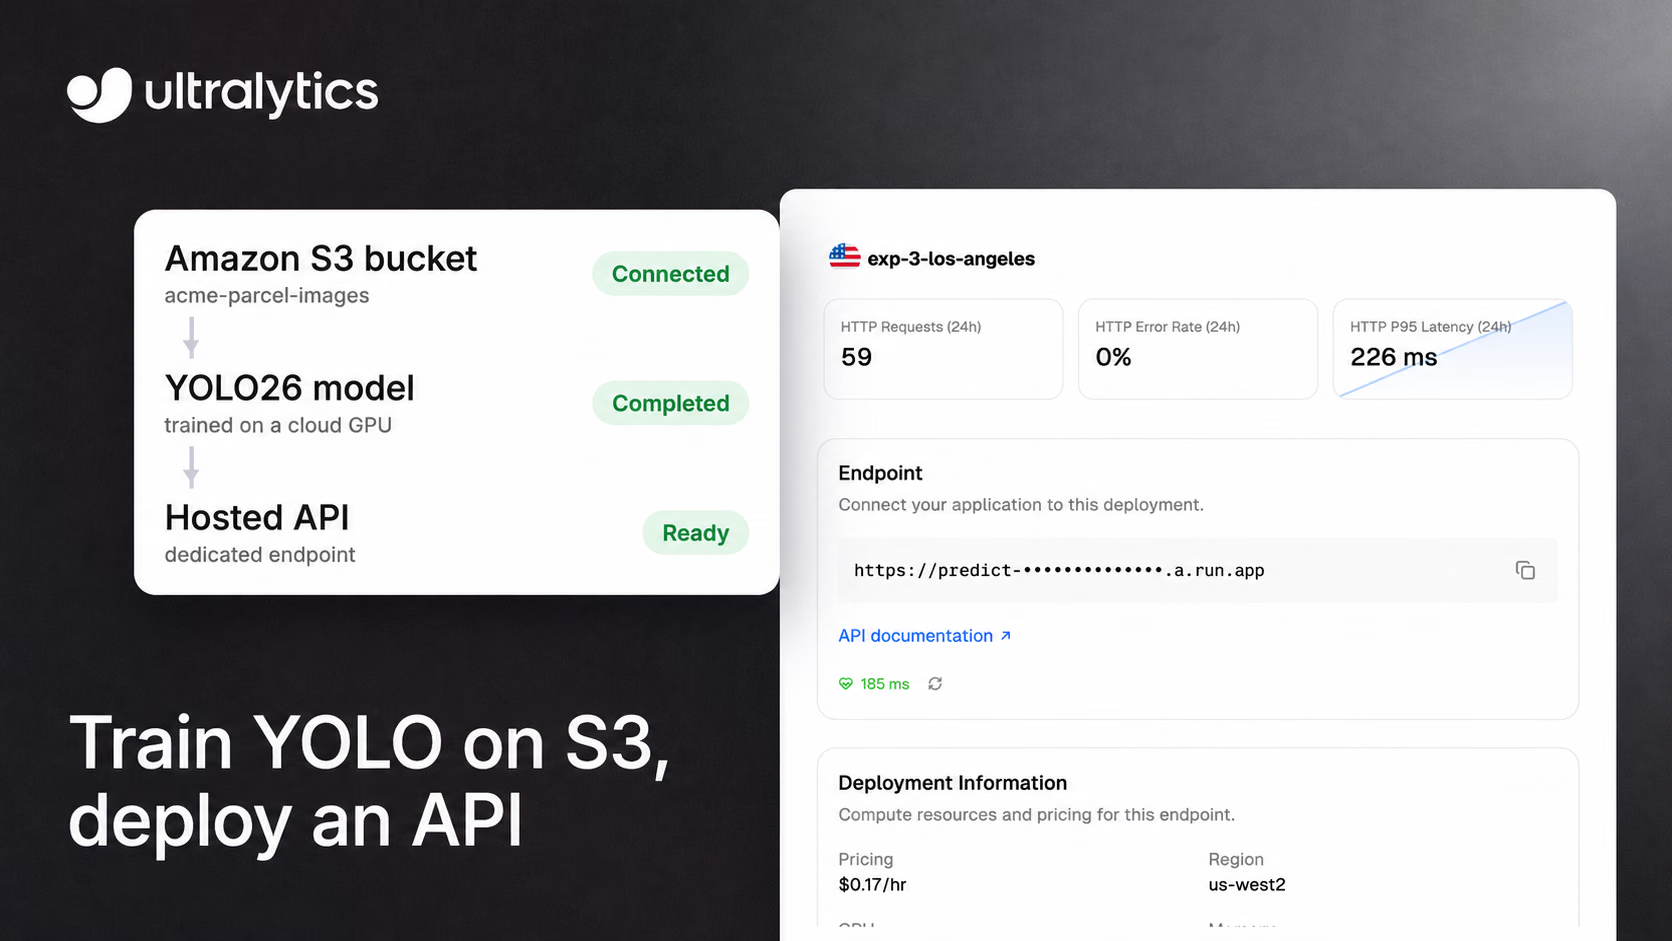
이미 Amazon S3 버킷에 이미지가 있다면 데이터셋을 두 번째로 업로드하지 않고도 해당 이미지로 Ultralytics YOLO 모델을 학습하고 호스팅 API로 배포할 수 있습니다. Ultralytics Platform은 버킷을 제자리에서 인덱싱하고, 클라우드 GPU에서 YOLO26에 레이블을 지정하고 학습할 수 있게 하며, 학습된 모델을 HTTPS로 호출하는 전용 엔드포인트에 배포합니다. 이 가이드에서는 IAM 정책부터 첫 예측까지 각 단계를 안내하고, Amazon SageMaker, Google Vertex AI, Azure Machine Learning의 워크플로와 비교합니다.
같은 흐름을 Google Cloud Storage 및 Azure Blob Storage에서도 사용할 수 있습니다. 이 경우 AWS 액세스 키 대신 서비스 계정 JSON 키 또는 계정 액세스 키 연결 문자열을 사용합니다.
워크플로 구성 방식#
파이프라인은 5단계로 구성됩니다. 원본 이미지는 버킷에 그대로 유지되고, 클라우드 학습에서는 실행 중에만 임시 복사본을 사용합니다.
- 연결: 읽기 전용 IAM 사용자로 S3 버킷을 연결합니다.
- 인덱싱: 폴더를 Platform 데이터셋으로 인덱싱합니다. Platform은 이미지 크기와 찾은 YOLO 레이블을 읽으며, 이미지의 두 번째 사본을 저장하지 않습니다.
- 레이블 지정: 브라우저에서 이미지에 레이블을 지정하거나 버킷에 이미 있는 YOLO 레이블을 그대로 사용합니다.
- 학습: 클라우드 GPU에서 YOLO26 모델을 학습합니다. 학습 실행 중에는 이미지의 임시 복사본을 사용합니다.
- 배포: 42개 리전 중 한 곳의 전용 엔드포인트에 모델을 배포하고 API 키를 사용해 이미지 요청을 보냅니다.
탐지, 세그멘테이션, 포즈, 방향 경계 상자(OBB) 데이터셋은 레이블의 형태를 기준으로 인식되므로, 동일한 단계가 각 컴퓨터 비전 작업에 적용됩니다.
시작하기 전에: 요금제, 권한 및 데이터 경계#
다음 세 가지가 필요합니다.
- Pro 또는 Enterprise 워크스페이스. Amazon S3, Google Cloud Storage, Azure Blob Storage 데이터셋을 사용하려면 Pro 또는 Enterprise 요금제가 필요합니다. Pro는 사용자당 월 $29이며, 클라우드 학습과 같은 사용량 기반 컴퓨팅에 매월 사용자당 $30의 크레딧을 제공합니다.
- 워크스페이스 관리자 또는 소유자 역할. 클라우드 스토리지를 연결하려면 이 역할이 필요합니다.
- 버킷을 나열하고 읽을 수 있는 AWS IAM 사용자.
연결하기 전에 버킷에서 어떤 데이터가 외부로 전송되는지 파악해 두는 것이 좋습니다. Platform은 탐색 및 어노테이션을 위해 요청 시 원본을 스트리밍하며, 인덱싱된 이미지는 Platform 스토리지 할당량에 포함되지 않습니다. 각 연결에는 기본적으로 켜져 있는 AI 기능 스위치가 있습니다. 스위치가 켜져 있으면 Ultralytics GPU가 어노테이션, 유사 이미지 검색, 클라우드 학습을 위해 이미지를 읽을 수 있습니다. 유료 어노테이션 모델에 워크스페이스의 공급자 키를 사용하는 경우 외부 AI 공급자도 이미지를 처리할 수 있으며, 쓰기 액세스가 활성화되어 있으면 이미지 생성에도 이미지를 처리할 수 있습니다. 클라우드 학습은 실행 중에 임시 복사본을 사용하며, 유사 이미지 검색은 이미지가 Platform에서 제거될 때까지 임베딩을 보관합니다. 기능을 끄면 새 AI 작업은 시작되지 않지만 이미 실행 중인 작업은 완료되며, 수동 어노테이션과 로컬 학습은 계속 사용할 수 있습니다. Platform은 객체를 수정하거나 삭제하지 않습니다.
1단계: 읽기 전용 IAM 사용자 만들기#
AWS 콘솔에서 IAM > Users로 이동하고, 콘솔 액세스 권한이 없는 사용자를 만든 다음 버킷에 대한 나열 및 읽기 액세스 권한을 부여하는 정책을 연결합니다.
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}s3:ListAllMyBuckets은 선택 사항입니다. 이 항목을 설정하면 Platform에서 버킷을 검색할 수 있으므로 버킷 이름을 직접 입력할 필요가 없습니다.
그런 다음 사용자의 Security credentials 탭을 열고 액세스 키를 만듭니다. Platform에는 만료 기간이 없는 IAM 사용자 키가 필요합니다. 데이터셋이 연결된 상태에서 만료될 수 있으므로 역할 세션 자격 증명과 IAM Identity Center 키를 비롯한 임시 AWS STS 자격 증명은 거부됩니다. 이 용도로 전용 사용자를 만들고 루트 자격 증명은 절대 사용하지 마세요. Platform은 저장된 키를 AES-256-GCM으로 암호화하고 학습 워크로드에 키를 노출하지 않습니다. IAM에서 키를 비활성화하면 언제든지 액세스 권한을 취소할 수 있습니다.
2단계: Ultralytics Platform에 버킷 연결하기#
- Platform에서 Settings > Integrations로 이동한 다음 Amazon S3를 선택합니다.
- 액세스 키 ID, 비밀 액세스 키, 버킷 리전을 입력합니다(예:
us-east-1). - Find available buckets를 클릭하고 연결할 버킷을 선택합니다. 정책에서 버킷 검색을 허용하지 않는 경우에는 버킷 이름을 직접 입력합니다.
- Connect를 클릭합니다. Platform은 정보를 저장하기 전에 각 버킷을 나열하고 읽을 수 있는지 확인합니다.
연결 하나는 한 리전의 버킷을 읽으므로 데이터가 여러 리전에 분산되어 있다면 리전마다 연결해야 합니다. Amazon S3 통합 가이드에서 이미지 생성에 사용되는 선택적 쓰기 권한을 설명합니다.
3단계: 버킷에서 데이터셋 만들기#
New Dataset을 클릭하고 Cloud 탭을 연 다음 버킷을 선택합니다. 데이터가 있는 폴더로 이동해 데이터셋을 만듭니다. Platform은 폴더를 한 번 나열하고 찾은 항목을 인덱싱합니다.
- 이미지:
.jpg,.jpeg,.png,.webp,.avif객체. - 레이블: YOLO
.txt파일. 표준images/~labels/디렉터리 구조에 따라 연결되거나 각 이미지와 같은 위치에 있는 파일이 연결됩니다. - 클래스: 일반적인 YOLO 데이터셋과 마찬가지로
data.yaml파일에 클래스 이름을 지정합니다. - 분할:
train,val,test폴더 이름을 통해 분할이 자동으로 지정됩니다.
한 번의 가져오기로 최대 500,000개의 객체를 인덱싱할 수 있으므로, 더 큰 버킷은 여러 데이터셋으로 나누세요. 인덱싱된 객체는 변경할 수 없는 것으로 취급하세요. 각 이미지는 S3 객체 ETag에 고정되며, 객체를 덮어쓰면 Platform은 해당 이미지 제공을 중단합니다. 데이터셋을 만들 때 인덱스가 한 번 생성되므로, 나중에 데이터를 추가하려면 새 객체를 업로드하고 새 데이터셋을 만드세요.
4단계: 이미지에 레이블을 지정하거나 확인하기#
데이터셋을 열어 어노테이션 편집기에서 가져온 레이블을 검토합니다. 버킷에 레이블이 아직 없다면 상자와 마스크를 직접 그릴 수 있습니다. 또는 AI 기능을 켜고 스마트 어노테이션(탐지, 세그멘테이션, OBB에는 SAM, 포즈에는 YOLO 사용)과 자동 어노테이션으로 작업 속도를 높일 수 있습니다. 레이블은 Platform에 저장되며 버킷 객체는 변경되지 않습니다.
5단계: 클라우드 GPU에서 YOLO26 학습하기#
데이터셋이나 프로젝트에서 New Model을 클릭하고 기본 모델을 선택한 다음 클라우드 실행을 시작합니다.
- 기본 모델: 공식 Ultralytics 모델(YOLO26 권장) 또는 미세 조정할 사용자 모델 중에서 선택합니다. 데이터셋 작업과 호환되는 모델만 표시됩니다.
- 매개변수: 에포크, 이미지 크기, 배치 크기를 설정하거나 기본값을 그대로 사용합니다.
- GPU: Ultralytics Cloud에서 GPU를 선택합니다. 대화상자에는 시간당 요금이 표시되며, 시작하기 전에 실행 시간과 총비용을 추정합니다. 클라우드 GPU 선택 가이드에서 장단점을 확인할 수 있습니다.
실행 중에는 지표, 콘솔 출력, 시스템 차트가 브라우저로 스트리밍되고 체크포인트는 자동으로 저장됩니다. 학습이 끝나면 모델 페이지에 지표와 검증 결과가 있는 경우 혼동 행렬과 같은 상세 분석이 표시됩니다.
6단계: 모델을 호스팅 API로 배포하기#
모델의 Deploy 탭을 엽니다. 지도와 표에는 현재 위치에서 측정한 지연 시간 순으로 정렬된 42개 리전이 표시됩니다. 원하는 리전에서 Deploy를 클릭하고 CPU, 메모리, 가격을 검토한 다음 Create Deployment를 클릭합니다.
선택한 크기에 따라 요금이 달라집니다.
- 기본 크기(1 vCPU, 2 GiB): 무료이며 유휴 상태일 때 규모가 0으로 축소됩니다.
- 사용자 지정 크기(최대 8 vCPU 및 32 GiB): 인스턴스 하나를 상시 대기 상태로 유지하며, 엔드포인트가 준비된 시점부터 중지할 때까지 유휴 시간도 포함해 표시된 리전별 시간당 요금이 부과됩니다.
각 전용 엔드포인트는 자체 URL과 모니터링 기능을 갖춘 단일 테넌트 서비스이며, 워크스페이스의 API 키 하나에 연결됩니다. 무료 워크스페이스는 배포 3개, Pro는 10개, Enterprise는 무제한으로 실행할 수 있습니다. 공유 추론보다 전용 엔드포인트가 적합한 경우는 전용 추론과 공유 추론 비교 가이드를 참조하세요.
7단계: 엔드포인트 호출하기#
python -m pip install requests을 사용해 Requests를 설치하고 이미지를 image.jpg로 저장합니다. 예시 URL을 배포에서 복사한 URL에 /predict를 추가한 값으로 바꾸고, YOUR_API_KEY을 해당 배포에 연결된 키로 바꿉니다.
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
cURL을 사용한 동일한 요청:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
각 엔드포인트는 /docs의 대화형 API 레퍼런스와 /health 검사 기능도 제공합니다. 직접 요청은 Platform API 속도 제한을 적용받지 않지만, 각 엔드포인트는 인스턴스 하나에서 요청을 처리합니다. 신속히 처리할 수 없는 요청에는 Retry-After 헤더가 포함된 429가 반환되며, 요청 본문은 32 MB로 제한됩니다. 엔드포인트가 활성화되면 배포 페이지에서 요청, 오류, 지연 시간을 모니터링할 수 있습니다.
비용, 제한, 보안 한눈에 보기#
| 항목 | 예상 사항 |
|---|---|
| 요금제 | S3, Google Cloud Storage, Azure Blob 데이터셋에는 Pro(사용자당 월 $29) 또는 Enterprise가 필요합니다. |
| 스토리지 | 인덱싱된 이미지는 버킷에 그대로 유지되며 Platform 스토리지 할당량을 사용하지 않습니다. |
| 학습 | 크레딧에서 GPU 사용 시간만큼 요금이 차감됩니다. 시작 전에 대화상자에서 비용을 추정합니다. |
| 엔드포인트 | 기본 크기는 무료이며 규모가 0으로 축소됩니다. 사용자 지정 크기는 실행 시간에 따라 시간당 요금이 부과됩니다. |
| 가져오기 크기 | 가져오기당 최대 500,000개 객체 |
| 자격 증명 | 만료 기간이 없는 IAM 사용자 키로, 저장 시 암호화되며 학습 워크로드에 노출되지 않습니다. |
| S3 데이터셋에서는 사용할 수 없습니다. | 데이터셋 복제, 버전 스냅샷, 얼굴 흐리게 처리, 다른 데이터셋의 이미지 붙여넣기 |
Ultralytics Platform과 SageMaker, Vertex AI, Azure ML 비교#
범용 클라우드 ML 플랫폼에서도 자체 스토리지의 데이터로 학습하고 모델을 제공할 수 있습니다. 아래 스토리지 및 제공 방식 열은 각 플랫폼의 문서를 기반으로 하며, 마지막 열은 당사의 평가입니다.
| 플랫폼 | 학습 데이터 저장 위치 | 모델 제공 옵션 | 적합한 사용 사례(당사 평가) |
|---|---|---|---|
| Ultralytics YOLO를 사용하는 Ultralytics Platform | S3, Google Cloud Storage 또는 Azure Blob에서 제자리 인덱싱 | 42개 리전의 전용 단일 인스턴스 엔드포인트. 기본 크기는 규모를 0으로 축소합니다. | 학습 또는 제공 코드를 작성하지 않고 버킷에서 API까지 YOLO 탐지, 세그멘테이션, 포즈 또는 OBB를 사용하려는 팀 |
| Amazon SageMaker AI | 학습 작업이 Amazon S3, Amazon EFS 또는 Amazon FSx for Lustre에서 데이터를 읽습니다. | 자동 확장, 서버리스, 비동기 추론을 지원하는 실시간 엔드포인트 | 이미 AWS에서 ML 파이프라인을 운영하며 컨테이너와 제공 옵션을 직접 선택하려는 팀 |
| Google Vertex AI | 서버리스 학습 작업에서 액세스 가능한 Cloud Storage 버킷을 /gcs/ 아래에 마운트합니다. | 온라인 추론을 위한 관리형 엔드포인트 | Google Cloud 데이터와 도구로 표준화한 팀 |
| Azure Machine Learning | 데이터 저장소에서 Blob Storage와 같은 기존 Azure 스토리지를 참조합니다. | 실시간 추론을 위한 관리형 온라인 엔드포인트 | Azure를 표준으로 사용하는 팀 |
SageMaker의 학습 데이터 문서에는 스트리밍 및 다운로드 입력 모드를 지원하는 데이터 소스로 S3, EFS, FSx for Lustre가 나열되어 있습니다. 서버리스 추론은 확장을 관리하므로 콜드 스타트를 허용할 수 있는 유휴 시간이 포함된 트래픽에 적합하며, SageMaker 제공 컨테이너를 사용하거나 자체 컨테이너를 가져올 수 있습니다. Vertex AI는 사전 빌드된 컨테이너 또는 사용자 지정 컨테이너에서 Python 애플리케이션을 사용해 사용자 지정 학습을 실행합니다. Azure Machine Learning은 데이터 저장소를 통해 기존 Azure 스토리지에 연결하고 관리형 온라인 엔드포인트에서 모델을 제공합니다. 이러한 폭넓은 지원은 범용 플랫폼의 강점입니다. 당사의 평가에 따르면 사용자 지정 YOLO 워크플로에는 더 많은 구성이 필요하며, 컨테이너 요구 사항은 선택한 학습 및 제공 옵션에 따라 달라집니다. AWS를 계속 사용하려면 SageMaker 배포 가이드에서 YOLO 모델을 제공하는 방법을 확인하세요.
Ultralytics Platform은 의도적으로 범위를 좁혀 설계되었습니다. Ultralytics YOLO 모델을 중심으로 구축되어 있으므로 위 단계에 따라 학습 스크립트와 제공 컨테이너를 대체할 수 있습니다. 모든 통합에서 임시 STS 자격 증명을 요구하는 조직이나, 높은 동시 부하에서 하나의 엔드포인트를 여러 인스턴스로 확장해야 하는 경우에는 적합하지 않습니다. 추론을 실행할 위치를 아직 결정하지 못했다면 클라우드와 자체 호스팅 비교 가이드에서 비용, 지연 시간, 데이터 제어를 비교해 보세요.
자주 묻는 질문
Ultralytics Platform은 S3 버킷을 연결하고 이미지를 제자리에서 인덱싱한 다음, 클라우드 GPU에서 YOLO26을 학습하고 전용 HTTPS 엔드포인트에 모델을 배포합니다. Amazon SageMaker AI도 S3에서 학습하며, 제공 옵션에 따라 SageMaker 제공 컨테이너 또는 사용자 지정 컨테이너를 사용해 실시간, 서버리스, 비동기 추론을 지원합니다. Google Vertex AI와 Azure Machine Learning도 비슷한 워크플로를 제공하지만 기존 S3 버킷이 아닌 각자의 스토리지인 Cloud Storage와 Azure 스토리지를 중심으로 구축되어 있습니다.
Platform은 데이터셋의 두 번째 사본을 보관하지 않습니다. 이미지를 인덱싱하고 요청 시 원본을 스트리밍합니다. AI 기능이 켜져 있으면 클라우드 학습은 실행 중에 버킷 외부의 임시 복사본을 사용하고, 유사 이미지 검색은 각 이미지의 임베딩을 보관합니다. Platform은 객체를 수정하거나 삭제하지 않습니다.
현재는 사용할 수 없습니다. Platform에는 전용 IAM 사용자의 만료 기간이 없는 액세스 키가 필요하며, 데이터셋이 연결된 동안 만료되는 STS 자격 증명은 거부됩니다. 사용자의 권한은 나열 및 읽기만 가능하도록 제한하고, 액세스를 취소하려면 IAM에서 키를 비활성화하세요.
S3 데이터셋을 사용하려면 Pro(사용자당 월 $29, 사용자당 월 $30 크레딧 포함) 또는 Enterprise 요금제가 필요합니다. 학습에는 GPU 사용 시간에 따라 요금이 부과되며, 시작 전에 학습 대화상자에서 비용을 추정합니다. 기본 엔드포인트 크기는 무료이며 규모가 0으로 축소됩니다. 사용자 지정 크기는 실행 시간에 따라 시간당 요금이 부과됩니다.
예. Google Cloud Storage는 서비스 계정 JSON 키와 Storage Object Viewer 역할을 사용해 연결하고, Azure Blob Storage는 HTTPS 계정 액세스 키 연결 문자열을 사용해 연결합니다(SAS 토큰 문자열은 허용되지 않습니다). 데이터셋, 학습 및 배포 단계는 동일합니다.
데이터셋은 생성 시 한 번 색인되므로 새 객체가 자동으로 추가되지는 않습니다. 기존 객체를 덮어쓰지 말고 새 객체를 추가한 다음, 새 객체가 포함된 새 데이터셋을 만들고 다시 학습하거나 미세 조정하세요.
예. 모델 페이지에서 가중치를 다운로드하거나 모델을 ONNX, TensorRT, CoreML 등의 형식으로 내보낸 다음, Ultralytics Python 패키지를 사용해 자체 서버나 엣지 디바이스에서 실행할 수 있습니다.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









