Ultralytics YOLO26으로 Python에서 OCR 수행하기: 모든 각도의 문서, 사진, PDF 읽기
Ultralytics YOLO26-Text와 PP-OCRv6를 사용하면 CPU 또는 GPU에서 선택적으로 TensorRT를 활용해 Python 몇 줄만으로 어떤 회전 각도의 이미지와 PDF 페이지에서도 텍스트를 읽을 수 있습니다.
 Jing Qiu13 분 읽기
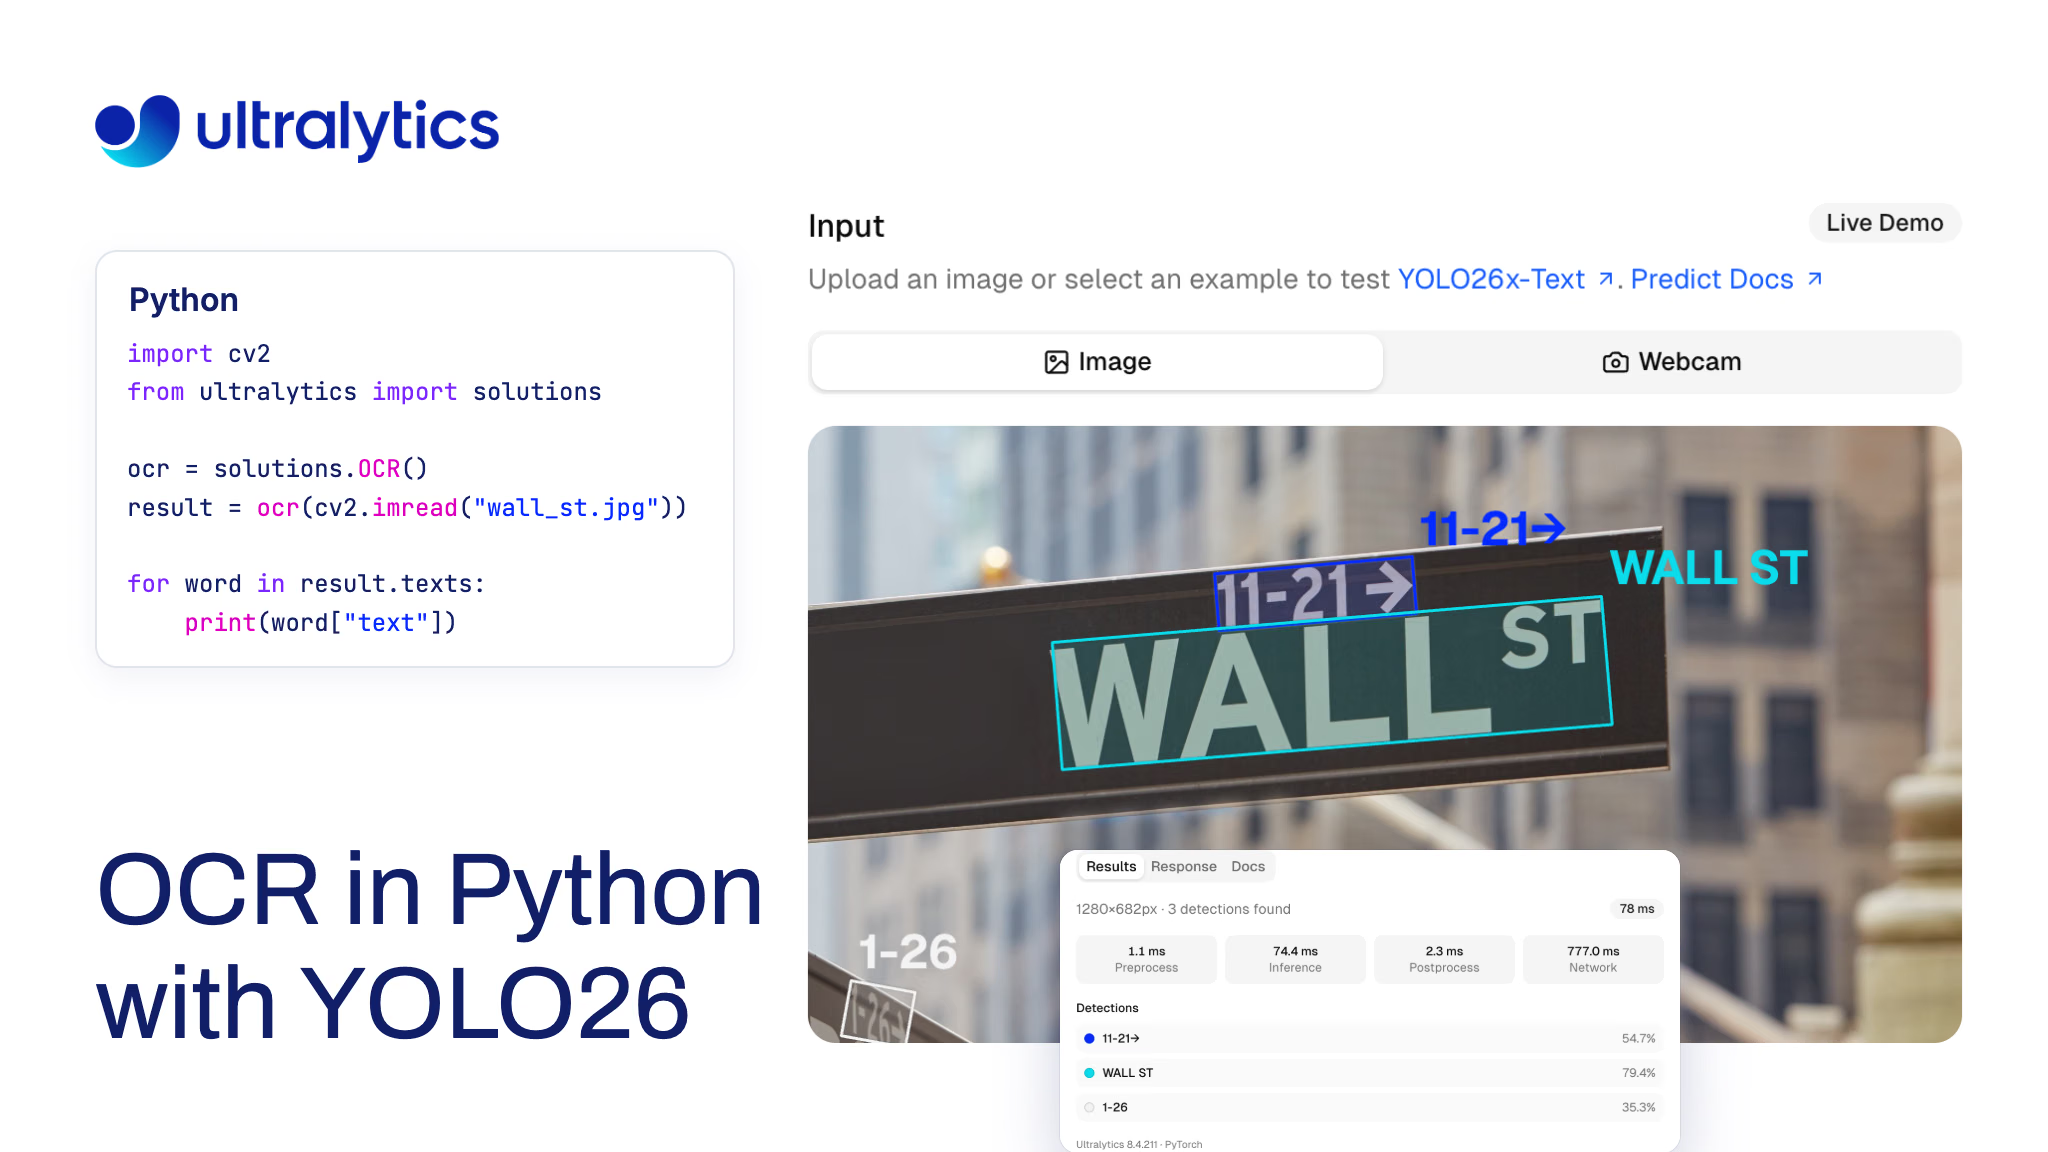
옆으로 회전된 스캔 이미지, 표지판을 휴대폰으로 촬영한 사진 또는 PDF 페이지에서 Python으로 OCR을 실행하고 사람이 읽는 순서대로 단어를 추출하려면 어떻게 해야 할까요? Ultralytics 패키지에서는 클래스 하나만 사용하면 됩니다. solutions.OCR()은 Ultralytics YOLO26-Text 모델로 텍스트를 감지하고, PaddleOCR의 PP-OCRv6 인식기로 각 단어를 읽은 다음, 페이지 회전 각도와 관계없이 CPU 또는 GPU에서 인식된 단어를 줄별로 반환합니다.
이 파이프라인은 새롭게 제공됩니다. Ultralytics 8.4.210은 회전 처리와 읽기 순서를 지원하도록 ONNX Runtime 기반 PP-OCRv6를 중심으로 OCR 솔루션을 재구성했으며, 8.4.211은 TensorRT 인식기를 선택적으로 추가했습니다. 이미지 크기 1280으로 진행한 벤치마크에서 기본 설정은 PDF 페이지 6개에서 단어 F1 0.931, HierText 사진 80개에서 0.722를 기록했습니다. RTX PRO 6000에서 캐시된 FP16 TensorRT 엔진은 사진 한 장에서 감지된 단어 251개를 82ms 만에 읽었습니다. CUDA의 ONNX Runtime은 249ms가 걸렸습니다.
이 가이드에서는 파이프라인의 작동 방식, 이미지와 PDF에서 실행하는 방법, 처리 속도, 현재 지원하는 언어를 살펴봅니다. 아래에서 비교하는 OCR 옵션 중 하나를 Ultralytics가 제공하므로, 비교 내용은 각 프로젝트에 문서화된 기능을 기준으로 합니다.
YOLO26 OCR은 페이지를 두 단계로 읽은 다음 단어의 순서를 정합니다.#
광학 문자 인식(OCR)은 텍스트를 찾은 다음 읽는 두 가지 작업으로 구성됩니다. Ultralytics OCR 솔루션은 이 두 작업을 명확히 분리합니다:
- 감지: YOLO26-Text 모델인 방향성 바운딩 박스 감지기는 텍스트 주위에 회전된 박스를 그립니다. n, s, m, l 및 x 크기로 제공되며, 기본값은 x 모델입니다.
- 인식: PP-OCRv6 medium 모델이 각 크롭을 읽습니다. Ultralytics 에셋 릴리스의 ONNX Runtime에서 실행되므로 PaddlePaddle을 설치할 필요가 없습니다. 아무것도 읽지 못한 크롭은 제외됩니다.
- 정렬: 단어를 줄별로 묶어 위에서 아래로, 왼쪽에서 오른쪽 순서로 반환하며, 각 단어에는 줄 번호가 지정됩니다.
각 단어는 텍스트, 인식 신뢰도, 감지기 신뢰도, 줄 번호, 원본 이미지 좌표계의 다각형이 포함된 레코드로 반환됩니다. 두 신뢰도 값이 별도로 유지되므로, 감지 신뢰도는 높지만 인식이 불확실한 단어를 그대로 신뢰하는 대신 사람의 검토를 위해 전달할 수 있습니다.
두 단계는 독립적으로 작동합니다. 더 작은 감지기, 자체 감지 또는 세그멘테이션 모델, 다른 인식기를 사용할 수 있으며 회전 처리와 읽기 순서는 계속 작동합니다. 설치 전에 문서 처리 페이지에서 브라우저로 같은 코드 경로를 시험해 볼 수도 있습니다.
회전되거나 거꾸로 된 페이지도 올바른 순서로 읽습니다.#
이 솔루션은 감지된 텍스트를 바탕으로 페이지 회전을 계산하므로, 사전에 페이지를 기울기 보정하거나 회전할 필요가 없습니다:
- 텍스트 방향 찾기. 감지된 박스의 긴 변 각도를 평균하며, 각 박스의 길쭉한 정도에 따라 가중치를 적용합니다. 한 자리 숫자처럼 종횡비가 2:1보다 낮은 박스는 판단에서 제외됩니다.
- 페이지 회전하기. 텍스트가 왼쪽에서 오른쪽으로 이어지도록 페이지를 회전하고, 각 단어를 똑바로 세워 크롭한 다음 단어를 줄별로 묶습니다.
- 0° 또는 180° 결정하기. 박스만으로는 텍스트의 위아래 방향을 알 수 없으므로, 가장 넓은 단어 8개를 양방향으로 읽고 더 높은 신뢰도로 읽히는 방향을 선택합니다. 거꾸로 된 텍스트는 신뢰도가 낮은 노이즈처럼 인식되므로 올바른 방향을 쉽게 판별할 수 있습니다.
문서와 스크린샷 8개, 사진 12개를 90°, 180°, 270°로 회전했을 때 단어 F1은 문서에서 0.925, 사진에서 0.654였습니다. 빈 IRS Form 8802에서는 0°, 180°, 90°에서 각각 404개, 401개, 399개의 단어를 읽었으며 첫 번째 줄은 모두 같았습니다. 이전 버전은 모든 페이지가 똑바로 놓여 있다고 가정했습니다.
기본값은 추측이 아니라 벤치마크를 기반으로 합니다.#
주요 기본값은 측정 결과를 바탕으로 설정했습니다. 벤치마크는 프로덕션 Platform 이미지가 적용된 RTX PRO 6000에서 실행했으며, 업로드 이미지는 긴 변이 최대 1280픽셀인 JPEG였습니다. 사람이 읽을 수 있는 단어의 전사 정보가 포함된 Google HierText 데이터셋의 검증 사진 80장, 텍스트 레이어를 기준으로 평가한 PDF 페이지 6개(arXiv 논문에서 4페이지, 빈 IRS Forms 1040 및 8802), 합성 스크린샷 1개, 합성 이미지 1개를 사용했습니다. 지표는 단어 수준의 F1 점수로, 정밀도와 재현율의 균형을 나타냅니다. 영숫자가 2자 이상인 소문자 단어를 기준으로 계산했습니다.
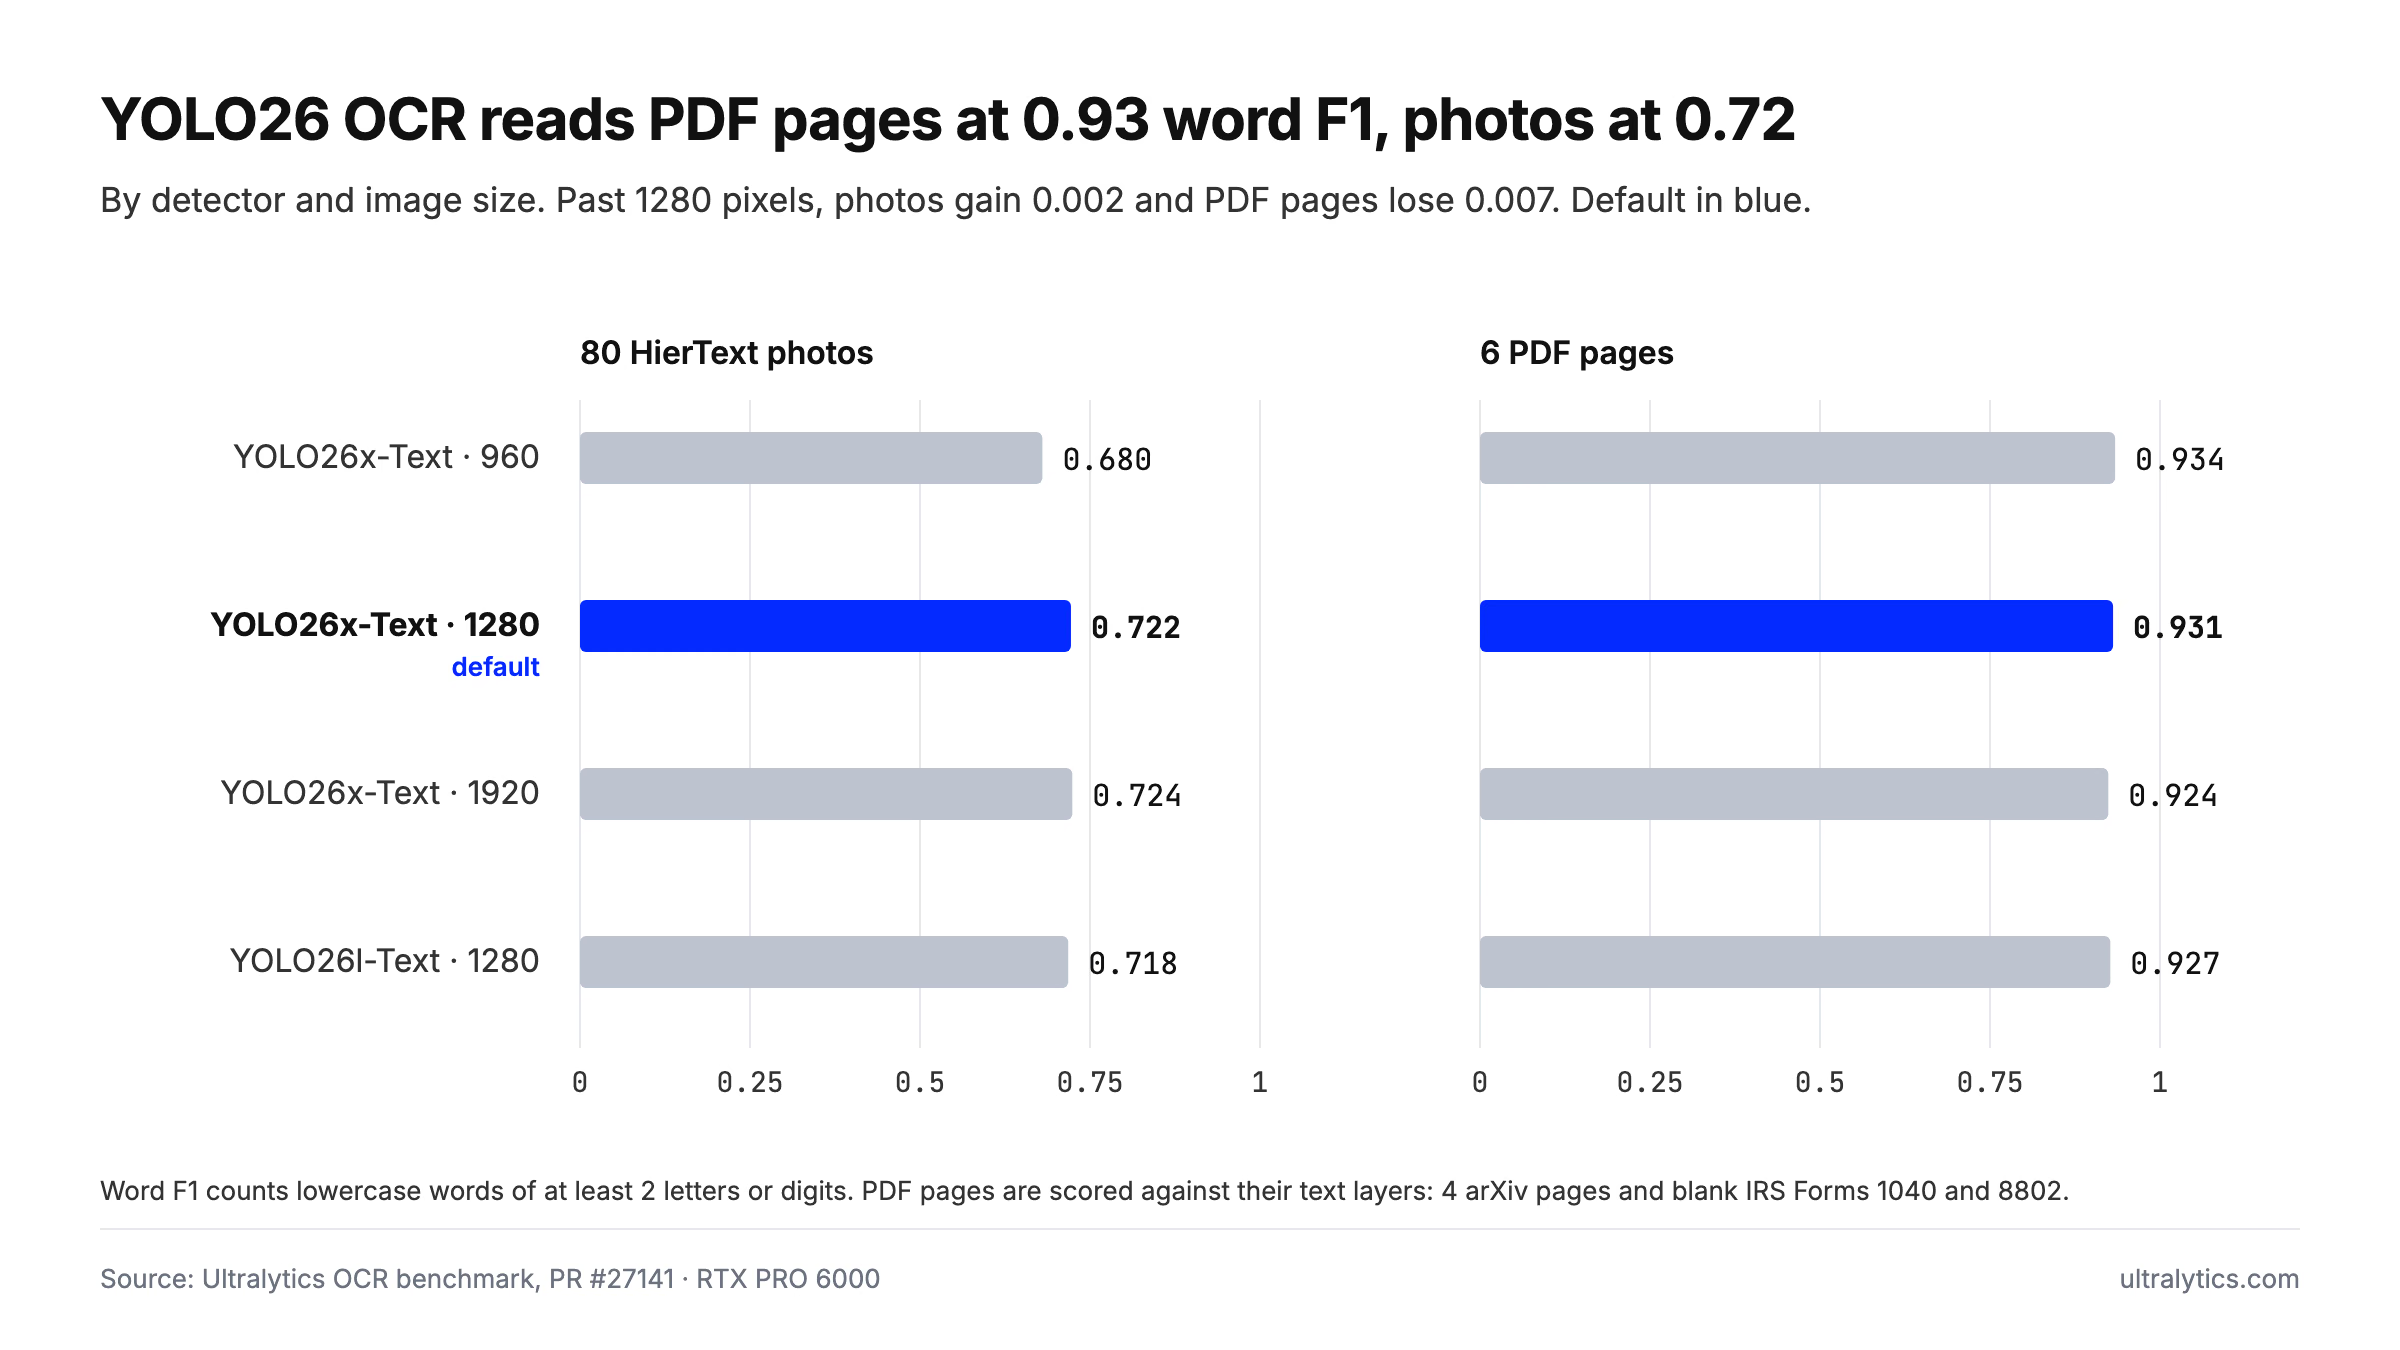
RTX PRO 6000에서 감지기와 이미지 크기별로 측정한, HierText 사진 80장과 PDF 페이지 6장에서 PP-OCRv6와 함께 사용한 YOLO26-Text의 단어 F1.
모든 설정에서 깨끗한 PDF 페이지는 장면 텍스트가 포함된 사진보다 훨씬 잘 읽혔으며, 측정 결과를 바탕으로 세 가지 기본값을 정했습니다:
yolo26x-text은imgsz=1280로 설정합니다. 크기를 960으로 낮추면 사진의 F1이 0.042 하락했고, 1920으로 높이면 사진에서 0.002 상승하는 대신 PDF 페이지에서는 0.007 하락했습니다. 작은 이미지는 1280으로 확대하지 않습니다. 모델의 32픽셀 스트라이드에 맞춰 올림한 자체 크기로 처리합니다.- 단어별로 읽기. 전체 줄을 읽는 것보다 단어 하나씩 읽는 방식이 사진에서 F1 점수가 4포인트 높았습니다.
max_det=1000. 조밀한 문서 페이지에는 일반적인 감지 수 한도인 300개보다 많은 항목이 포함됩니다.
더 가벼운 감지기가 필요하다면 YOLO26l-Text는 두 데이터셋 모두에서 x 모델보다 성능이 0.5포인트 이내로 낮았습니다.
YOLO26으로 Python에서 OCR 실행하기#
pip install -U "ultralytics>=8.4.211"으로 설치하거나 업그레이드합니다. 첫 OCR 호출 시 YOLO26x-Text와 PP-OCRv6를 다운로드하고 ONNX Runtime을 설치합니다. CUDA를 사용할 수 있으면 onnxruntime-gpu을 사용합니다. 기본 ONNX Runtime 인식기에는 Python 3.11 이상과 ONNX Runtime 1.26 이상이 필요합니다.
이미지 읽기#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text, imgsz=1280, PP-OCRv6 사용
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # 주석이 추가된 이미지

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
명령줄에서 yolo solutions ocr source="path/to/video.mp4"을 실행하면 모든 프레임에 동일한 작업을 수행합니다. 각 프레임을 추적 없이 독립적으로 읽습니다.
PDF 읽기#
이 솔루션은 이미지를 입력으로 받으므로 먼저 각 PDF 페이지를 이미지로 렌더링해야 합니다. PyMuPDF를 이용할 수 있습니다:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # 이미 읽기 순서대로 정렬됨
        lines.setdefault(word["line"], []).append(word["text"])
print("\n".join(" ".join(words) for words in lines.values()))result.texts은 이미 정렬되어 있으므로 일반 텍스트를 다시 만드는 작업은 딕셔너리와 조인으로 간단히 처리할 수 있습니다. 다각형 정보를 이용하면 금액이 "Total"이라는 단어 옆에 있는지 확인하는 등 더 많은 작업을 수행할 수 있습니다.
모델, 장치, 인식기 선택하기#
- 더 작은 감지기:
solutions.OCR(model="yolo26s-text.pt")을 사용하면 더 작고 빠른 감지기를 로드할 수 있습니다. 자체 페이지에서 정확도를 확인하세요. 다섯 가지 크기는 모두 자동으로 다운로드됩니다. - CPU 또는 GPU: CUDA GPU를 선택하고 ONNX Runtime의 CUDA 실행 공급자를 사용할 수 있으면 인식기가 CUDA에서 실행되고, 그렇지 않으면 CPU에서 실행됩니다. 따라서 같은 스크립트를 노트북이나 서버에서 실행할 수 있습니다.
- 자체 인식기:
recognizer에 함수를 전달합니다. 이 함수는 각 BGR 단어 크롭을 입력으로 받아(text, confidence)을 반환하며, 솔루션은 해당 함수와 함께 감지, 회전, 정렬을 계속 수행합니다.
def recognize(crop):
    # BGR 단어 크롭에 임의의 인식 모델 실행
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT를 사용하면 조밀한 사진에서 단어를 2.5~3배 더 빠르게 읽습니다.#
조밀한 페이지를 GPU에서 테스트한 결과, 감지보다 인식에 더 많은 시간이 걸렸습니다. 이전 최적화에서는 250ms 요청 중 감지에 약 11ms가 걸렸습니다. TensorRT 풀 리퀘스트에서는 남은 인식 시간의 상당 부분이 연산이 아니라 실행 오버헤드가 주된 원인인 소규모 배치 33개에서 발생하는 것으로 확인했습니다. Ultralytics 8.4.211에서는 이를 위한 인자 하나를 추가했습니다:
ocr = solutions.OCR(recognizer="tensorrt") # NVIDIA GPU의 FP16 TensorRT 엔진첫 실행 시 약 30초 동안 FP16 TensorRT 엔진을 빌드하고 PP-OCRv6 모델 옆에 캐시합니다. TensorRT 버전과 GPU 아키텍처 조합마다 한 번씩 빌드합니다. 이후 로드는 0.05~0.2초가 걸립니다. 릴리스에 따르면 조밀한 페이지에서 ONNX Runtime보다 약 2.5배 빠릅니다.
네 장면 텍스트 사진에서 감지 후 단어를 크롭하고 회전, 인식, 정렬하는 단계인 read_words의 처리 시간을 측정했습니다. 단어가 195~263개인 사진 세 장에서 FP16 엔진은 CUDA의 ONNX Runtime보다 2.5~3배 빨랐으며, 단어가 48개인 사진에서는 1.4배 빨랐습니다:
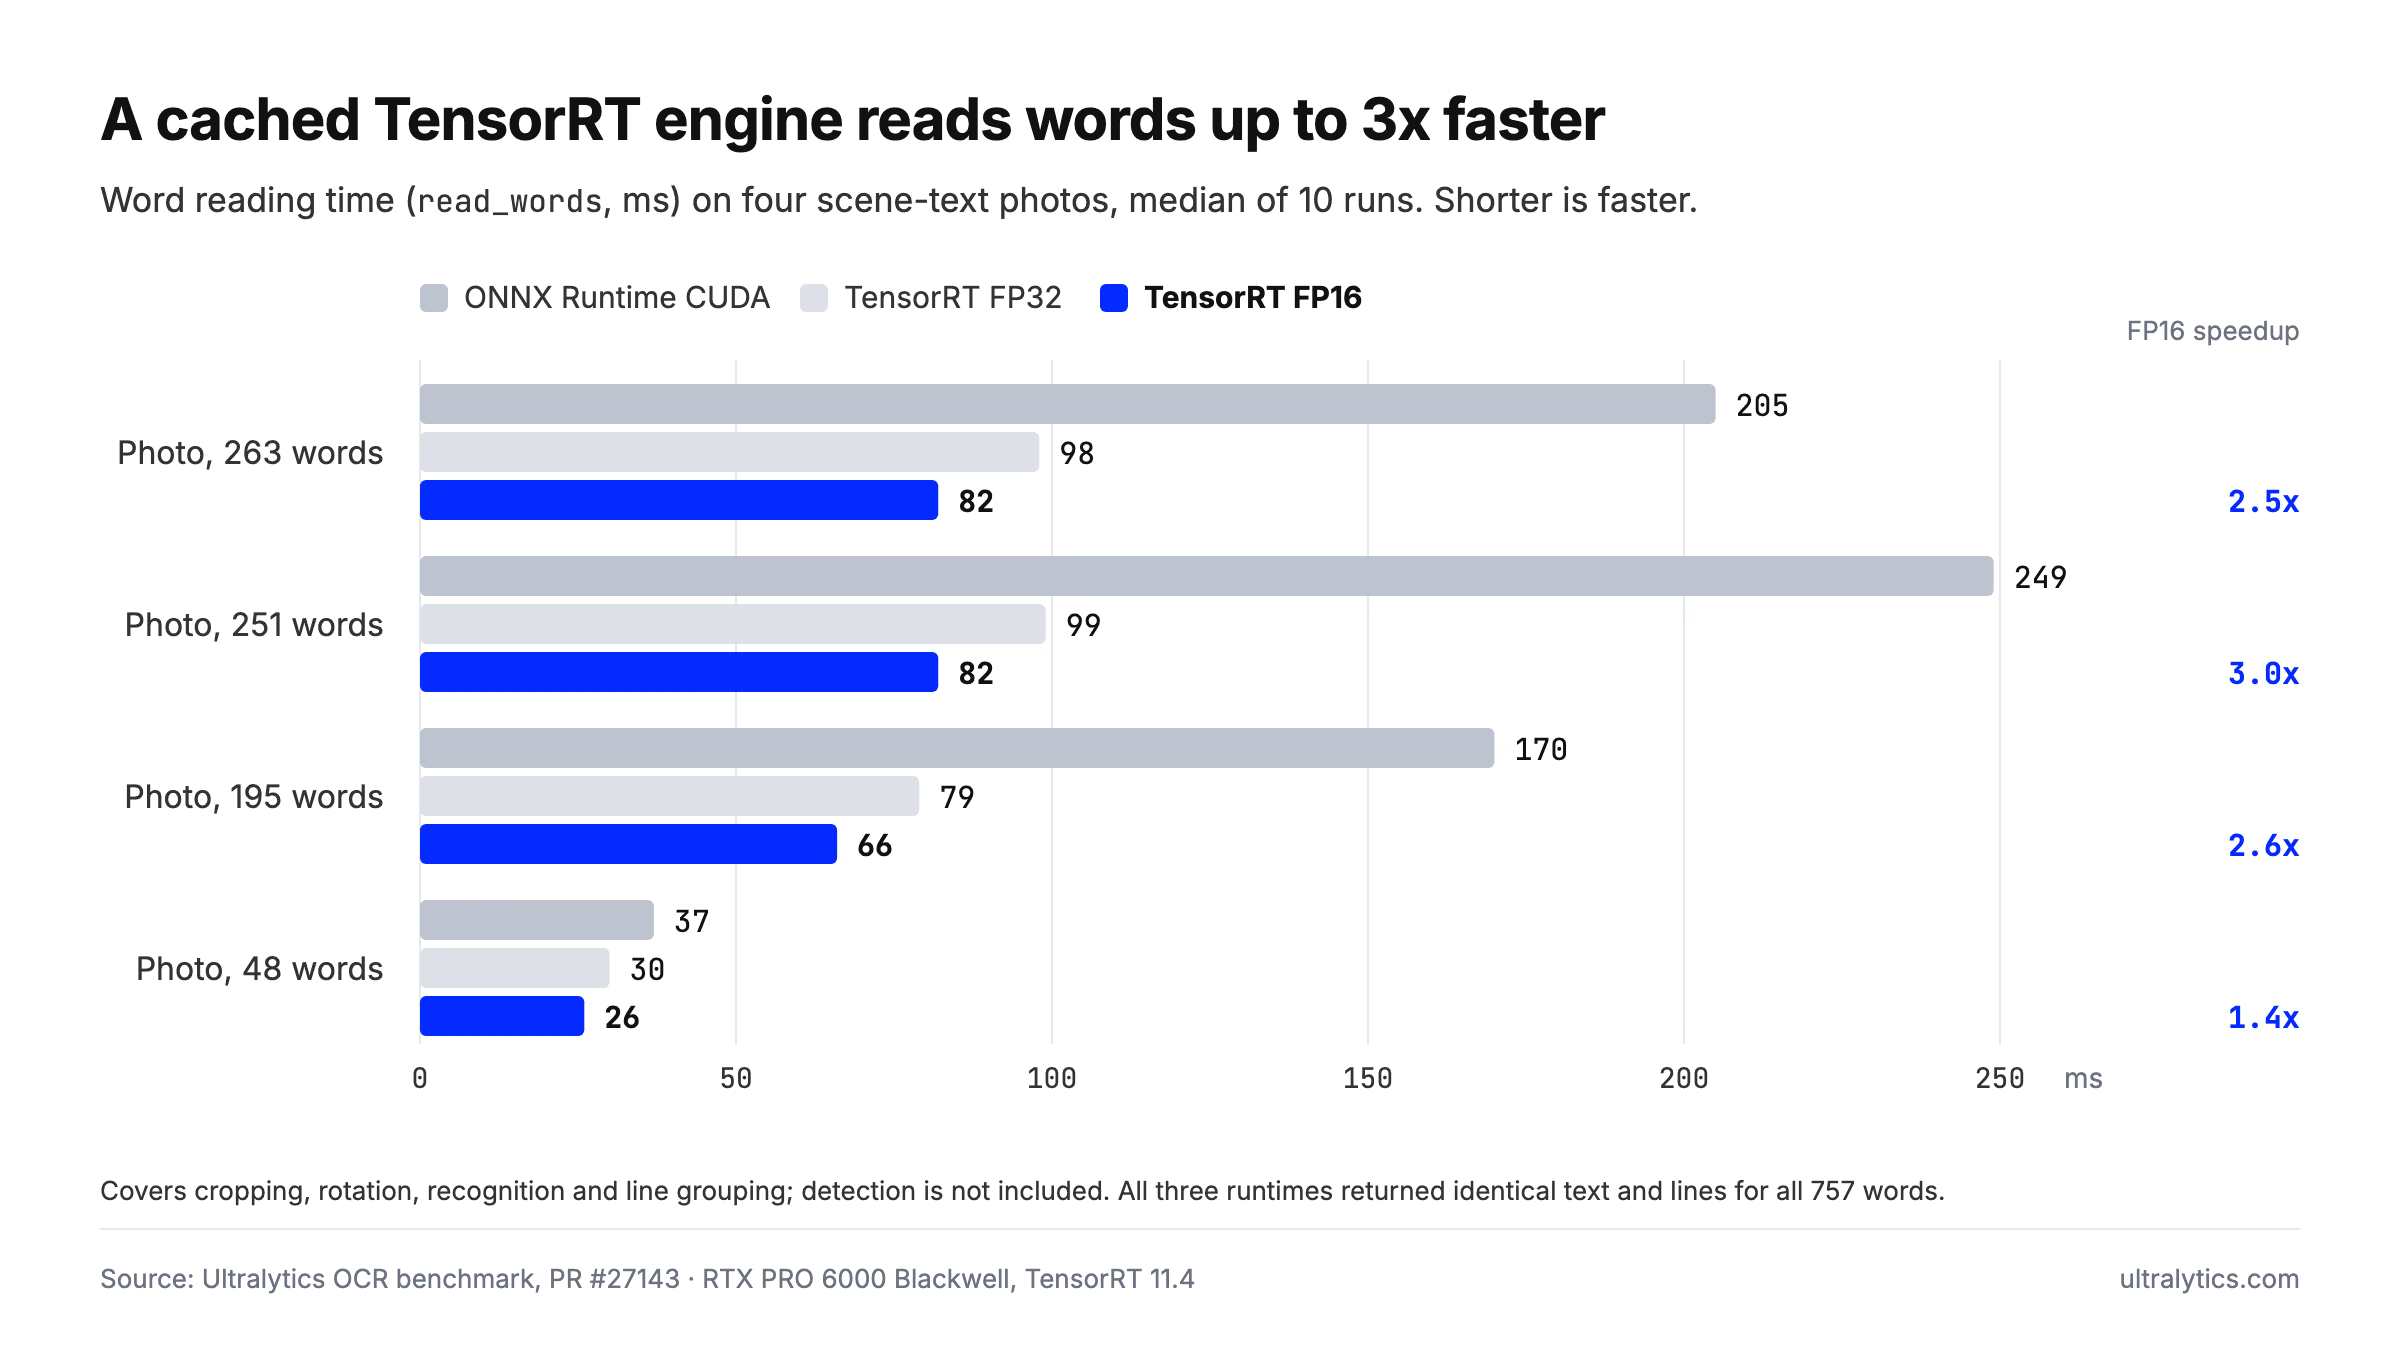
RTX PRO 6000 Blackwell과 TensorRT 11.4에서 실행한 ONNX Runtime CUDA, FP32 및 FP16 TensorRT 엔진의 장면 텍스트 사진 4장에 대한 단어 읽기 시간. 10회 실행의 중앙값입니다.
조밀한 페이지에서 전체 OCR 호출 시간은 182ms에서 94ms로 줄었습니다. 이 사진 네 장에서는 속도 향상이 출력 결과를 바꾸지 않았습니다. 단어 757개 전체에서 ONNX Runtime과 두 엔진은 텍스트와 줄 정렬을 동일하게 반환했습니다.
첫 빌드를 기다릴 수 없거나 NVIDIA 하드웨어를 사용하지 않는 경우 기본 recognizer="paddleocr"을 사용하세요. 별도로 빌드하지 않으며 약 1초 만에 시작합니다. ONNX와 TensorRT 비교에서는 감지 모델에서 동일한 절충점을 다루며, TensorRT 통합 가이드에서는 설정 방법을 설명합니다.
현재 중국어, 일본어, 라틴 문자를 지원합니다.#
PP-OCRv6는 내장 문자 집합 18,708자만 출력할 수 있습니다. YOLO26-Text 감지기는 이 문자 집합에 의존하지 않아 다른 문자 체계의 단어도 계속 찾지만, 문자 집합에 없는 단어는 비슷하게 생긴 문자로 반환됩니다. 예를 들어 러시아어 ТЕКСТ는 높은 신뢰도로 인식되는 경우에도 "TEKCT"로 읽히곤 합니다.
- 지원: 간체 및 번체 중국어(CJK 문자 약 15,600자), 일본어(히라가나, 가타카나, 한자), 영어, 프랑스어, 독일어, 스페인어, 포르투갈어, 이탈리아어, 네덜란드어, 스웨덴어, 핀란드어, 덴마크어, 노르웨이어, 폴란드어, 체코어, 헝가리어, 루마니아어, 터키어, 크로아티아어, 인도네시아어, 말레이어를 포함한 라틴 문자 기반 언어를 지원합니다. 독일어 대문자 ẞ와 스페인어 ¡를 제외한 모든 문자와 악센트 문자를 지원합니다.
- 부분 지원: 베트남어는 성조가 있는 모음 대부분을 지원하지 않으며, 그리스어는 기본 문자만 지원합니다.
- 아직 지원하지 않음: 키릴 문자, 한국어(한글), 아랍어, 히브리어, 데바나가리 문자, 태국어입니다.
지원하지 않는 문자 체계에는 YOLO26-Text 감지기를 그대로 사용하고, 해당 문자 체계로 학습한 인식기를 recognizer으로 전달하면 됩니다. 전체 지원 범위 표는 OCR 가이드의 지원 언어 섹션에서 확인할 수 있습니다.
문서화된 기능 기준으로 비교한 Python OCR 라이브러리#
모든 상황에 가장 적합한 OCR 모델은 없습니다. 적절한 모델은 페이지, 언어, 코드 실행 환경에 따라 다릅니다. 표에서는 각 프로젝트의 공개 페이지를 2026년 11월 12일에 확인하고, 측정 결과가 아니라 문서화된 기능을 비교합니다. 옵션은 알파벳순으로 나열했습니다.
| 옵션 | 런타임 | 회전된 텍스트 | 문서에 명시된 지원 언어 | 출력 |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info은 텍스트 박스별로 90°, 180°, 270°를 시도합니다. | 키릴 문자, 아랍어, 데바나가리 문자, 한국어, 태국어를 포함한 80개 이상 | 박스, 텍스트, 신뢰도 |
| PaddleOCR | PaddlePaddle | 선택적 방향 분류 | 100개 이상(PP-OCRv6는 하나의 모델로 50개 언어 지원) | 박스, 텍스트, 신뢰도 |
| Tesseract (pytesseract) | 네이티브 바이너리, CPU | 방향 및 문자 체계 감지(image_to_osd); 인식 전에 이미지 회전 필요 | 100+ | 텍스트, 선택적 단어 데이터 |
| Ultralytics YOLO26 OCR | PyTorch 감지기; ONNX Runtime 또는 NVIDIA GPU의 TensorRT에서 인식기 실행 | 감지된 텍스트를 바탕으로 페이지 회전을 추정하고 0°와 180°를 자동 판별합니다. | 중국어, 일본어, 라틴 문자. 사용자 지정 인식기를 통해 다른 문자 체계 지원 | 읽기 순서대로 정렬된 단어와 줄 번호, 다각형, 별도로 제공되는 감지 및 인식 신뢰도 |
현재 제공되는 옵션은 EasyOCR 문서, PaddleOCR 저장소, Tesseract 문서, pytesseract에서 확인할 수 있습니다. 이러한 엔진의 작동 방식에 대한 배경 정보는 널리 사용되는 오픈 소스 OCR 모델 개요를 참고하세요.
Ultralytics를 활용할 수 있는 영역#
Ultralytics YOLO26 OCR은 스캔 양식, PDF 페이지, 스크린샷, 라벨 및 표지판 사진 등 다양한 입력에서 텍스트를 추출하고, 읽기 순서와 확인 가능한 좌표를 필요로 하는 Python 개발자를 위해 만들어졌습니다. 페이지의 회전 각도를 예측할 수 없거나 자체 장비에서 OCR을 실행하려는 경우, 또는 이미 Ultralytics YOLO26 모델을 실행하고 있으며 같은 패키지에서 OCR을 사용하려는 경우에 적합합니다. NVIDIA GPU에서 대량으로 처리하려면 recognizer="tensorrt"을 추가하세요.
감지기는 일반적인 Ultralytics 모델이므로 다른 모델과 마찬가지로 학습, 검증, 내보내기가 가능합니다. Ultralytics Platform의 YOLO26-Text 프로젝트에는 n부터 x까지 다섯 가지 크기가 모두 있으며, 학습 곡선을 비교하고 프로젝트를 복제해 이를 시작점으로 사용할 수 있습니다.
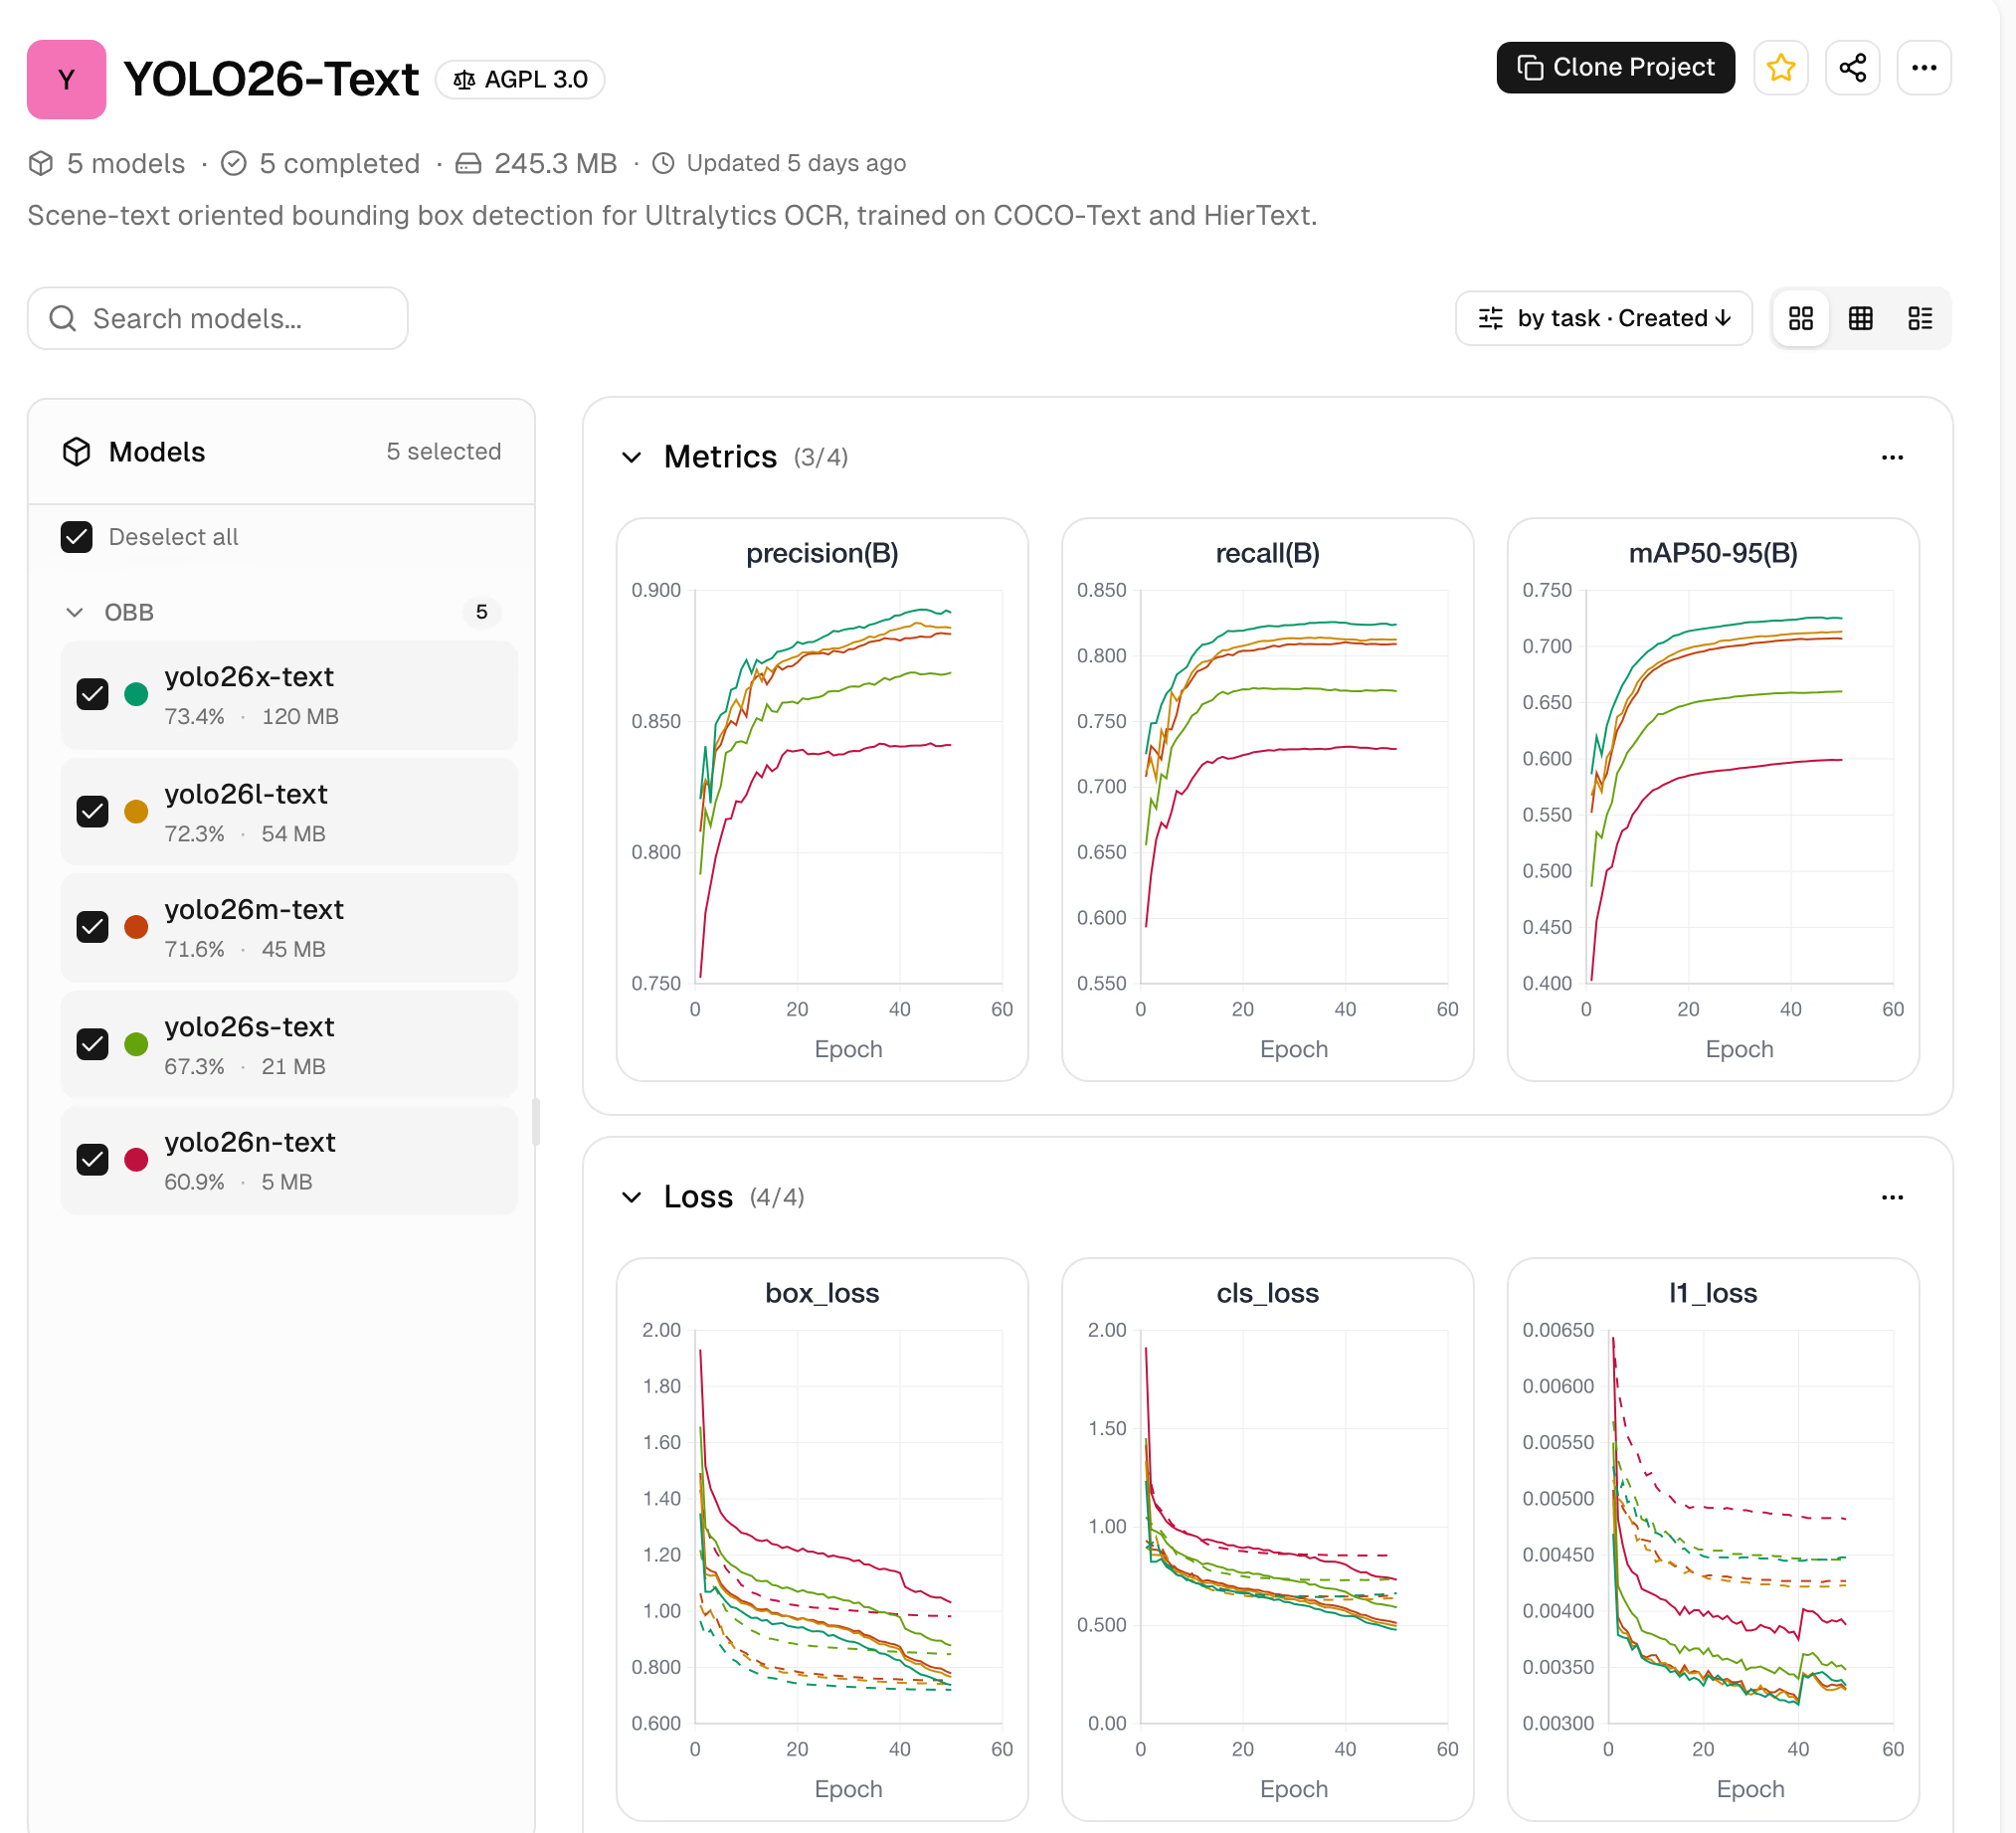
Ultralytics Platform의 YOLO26-Text 프로젝트: 학습 중 정밀도, 재현율, mAP50-95, 손실 곡선과 함께 제공되는 감지기 다섯 가지 크기입니다.
문서에 맞게 조정하려면 COCO-Text와 HierText를 결합해 이미지 65,325장과 단어 다각형 약 129만 개를 포함하는 Scene Text OBB 데이터셋부터 시작하세요.
구체적인 제한 사항은 다음과 같습니다:
- 문자 체계. 기본 인식기는 아직 키릴 문자, 한국어, 아랍어, 히브리어, 데바나가리 문자, 태국어를 읽지 못합니다. 감지기를 자체 인식기와 함께 사용하거나 해당 문자 체계를 지원하는 엔진을 선택하세요.
- 여러 방향의 텍스트. 솔루션은 페이지에서 우세한 텍스트 방향에 맞춰 페이지 전체를 회전하므로, 세로 여백 메모처럼 한 페이지에서 여러 방향으로 이어지는 텍스트는 정확도가 낮아질 수 있습니다.
- 내보내기. 내보낸 감지기 파일에는 인식기가 포함되지 않으므로 감지기와 인식 런타임을 나란히 배포하거나 Python 솔루션을 연결 계층으로 유지하세요.
- Rust. Ultralytics Inference는
ultralytics-inference predict --ocr을 통해 동일한 PP-OCRv6 인식기로 Rust에서 장면 텍스트를 읽습니다. 다만 방향 처리는 Python 솔루션의 페이지 회전 단계가 아니라 분류기를 사용합니다. - 개인정보 보호. Python 솔루션은 자체 하드웨어에서 실행되므로 페이지를 외부로 전송할 필요가 없습니다. 브라우저 데모에서는 추론을 위해 페이지를 업로드합니다. 읽으면 안 되는 필드는 OCR 실행 전에 알려진 영역을 불투명 마스크로 덮으세요.
양식과 계약서에서는 사용자 지정 YOLO 모델로 필드, 표, 서명, 도장을 먼저 찾아 필요한 영역만 읽을 수 있습니다. Ultralytics Platform의 Signature 데이터셋과 스마트 문서 분석 가이드를 시작점으로 활용할 수 있으며, Ultralytics Platform에서 페이지 라벨링과 모델 학습을 한곳에서 진행할 수 있습니다. 먼저 자체 페이지에서 OCR을 확인하려면 이미지나 PDF를 실시간 OCR 데모에 업로드하세요.
자주 묻는 질문
pip install -U "ultralytics>=8.4.211"으로 Ultralytics 패키지를 설치한 다음 OpenCV로 불러온 이미지에solutions.OCR()을 호출합니다. 읽기 순서대로 정렬된 인식 단어와 함께 텍스트, 신뢰도, 줄 번호, 다각형을 반환합니다. 첫 실행 시 YOLO26-Text 감지기와 PP-OCRv6 인식기가 자동으로 다운로드됩니다.문서, 언어, 하드웨어에 따라 다릅니다. 널리 사용되는 오픈 소스 OCR 모델 개요에서 주요 옵션을 비교합니다. 이미지 크기 1280과 RTX PRO 6000으로 진행한 벤치마크에서 PP-OCRv6와 함께 사용한 YOLO26x-Text는 PDF 페이지 6개에서 단어 F1 0.931, HierText 사진 80개에서 0.722를 기록했으며, 모든 회전 각도의 페이지를 읽습니다. 아직 지원하지 않는 키릴 문자나 한국어와 같은 문자 체계에는 해당 문자 체계로 학습한 인식기를 사용하세요.
YOLO 모델은 텍스트를 감지하지만 읽지는 않습니다. Ultralytics YOLO26-Text는 텍스트를 방향성 박스로 감지하고, OCR 솔루션은 각 크롭을 PP-OCRv6 인식기에 전달합니다. 따라서 두 모델을 함께 사용하면 한 번의 호출로 전체 OCR을 수행할 수 있습니다.
네. 예를 들어 PyMuPDF의
get_pixmap을 사용해 PDF의 각 페이지를 이미지로 렌더링하고, BGR로 변환한 다음solutions.OCR()에 전달하면 됩니다. 브라우저에서는 데모와 Platform Predict 탭에서 PDF를 업로드할 수 있으며 첫 페이지를 읽습니다.네. PP-OCRv6는 CPU 또는 CUDA GPU에서 ONNX Runtime을 사용해 실행되며, 동일한 스크립트가 두 환경에서 모두 작동합니다. 선택 사항인 TensorRT 인식기에는 NVIDIA GPU가 필요합니다.
기본 인식기로는 아직 지원되지 않습니다. PP-OCRv6는 중국어, 일본어 및 라틴 문자 기반 언어를 지원하지만 키릴 문자, 한글, 아랍 문자, 히브리 문자, 데바나가리 문자 또는 태국 문자는 지원하지 않습니다. YOLO26-Text 검출기를 그대로 사용하고 해당 문자 체계로 학습된 인식기를 전달할 수 있습니다.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









