Segmentação semântica vs. segmentação de instâncias: como escolher a tarefa certa
A segmentação semântica atribui uma classe a cada pixel; a segmentação de instâncias separa cada objeto. Descobre qual delas o teu projeto de visão computacional precisa e porquê.
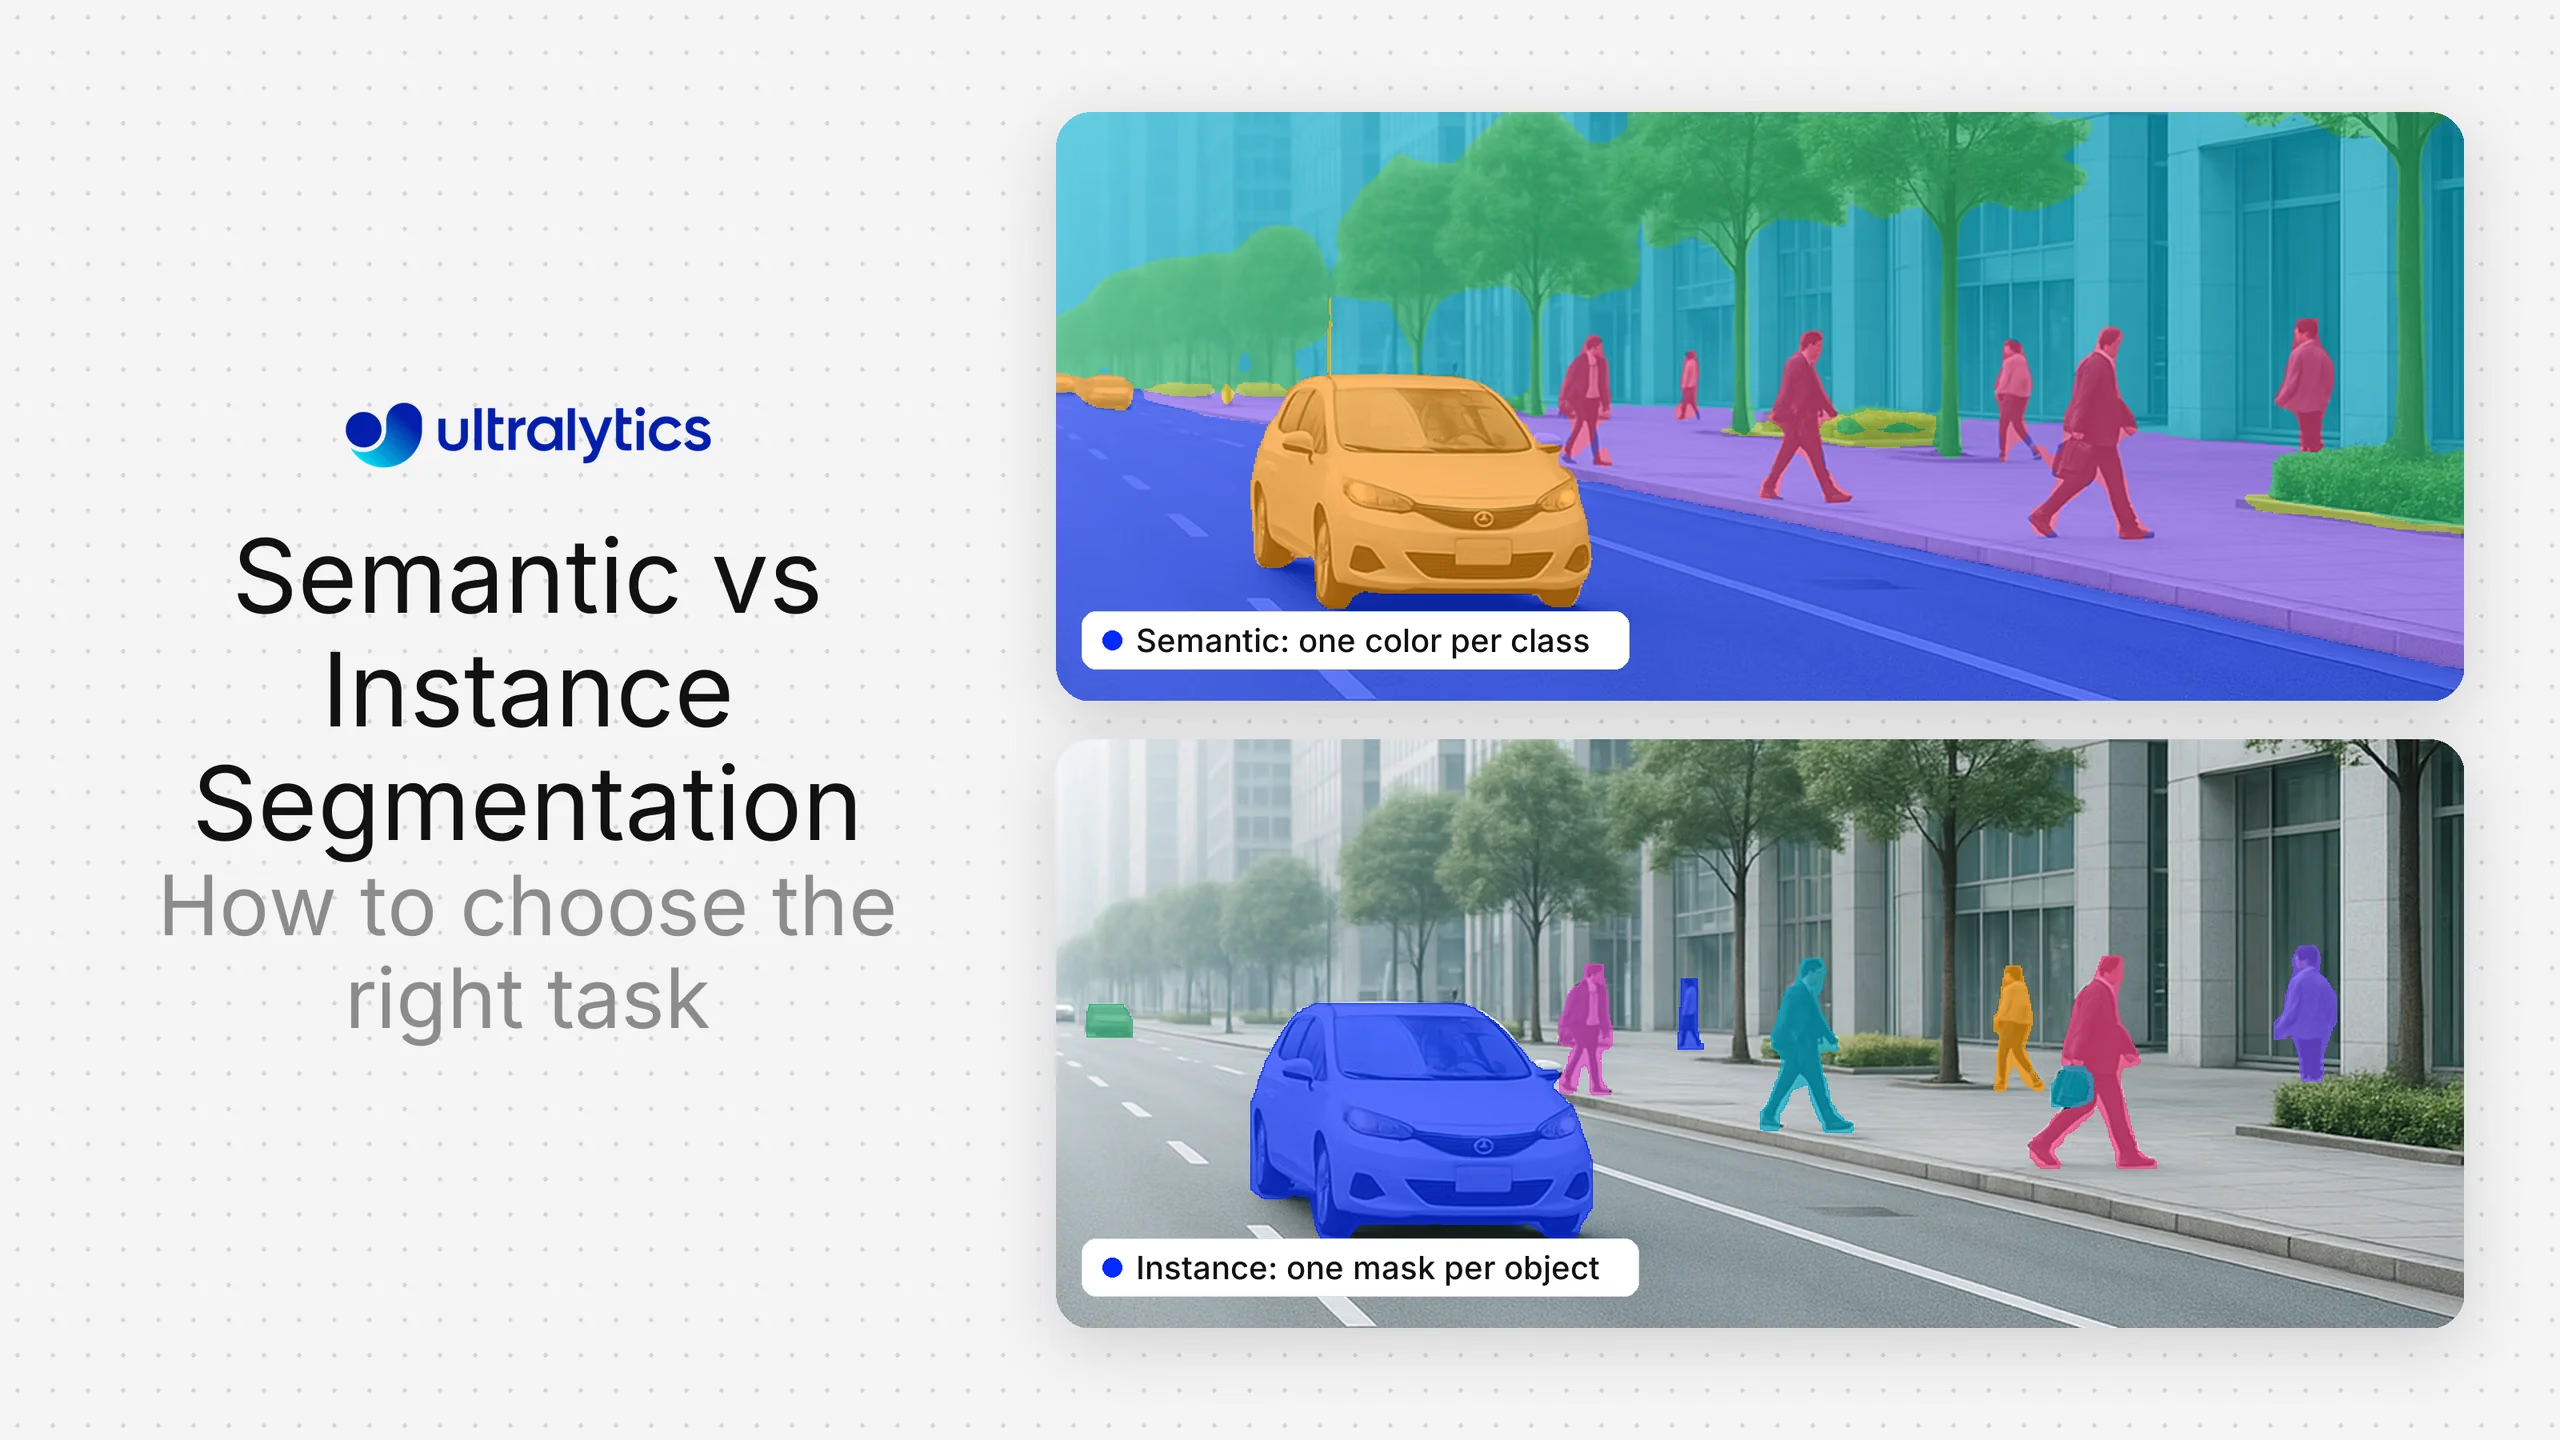
A segmentação semântica e a segmentação de instâncias atribuem rótulos às imagens ao nível do píxel, mas respondem a perguntas diferentes. A segmentação semântica atribui uma classe a cada píxel, pelo que todos os carros numa cena passam a fazer parte de uma única região "carro". A segmentação de instâncias separa cada objeto, atribuindo a cada carro a sua própria máscara. A escolha entre as duas resume-se a uma pergunta: precisas de saber o que está em cada píxel ou a que objeto pertence cada píxel? Este guia ajuda-te a fazer essa escolha. Também aborda o custo de anotação de cada tarefa e a forma de avaliar cada uma. O Ultralytics YOLO suporta ambas as tarefas no mesmo framework.
A diferença numa frase#
- A segmentação semântica classifica cada píxel numa categoria, como estrada, céu, pessoa ou carro. Os objetos da mesma classe são agrupados numa única região. Consulta a entrada do glossário sobre segmentação semântica.
- A segmentação de instâncias deteta cada objeto individual e atribui-lhe a sua própria máscara e ID. Normalmente, abrange objetos contáveis e ignora o fundo, como o céu ou a relva. Consulta a entrada do glossário sobre segmentação de instâncias.
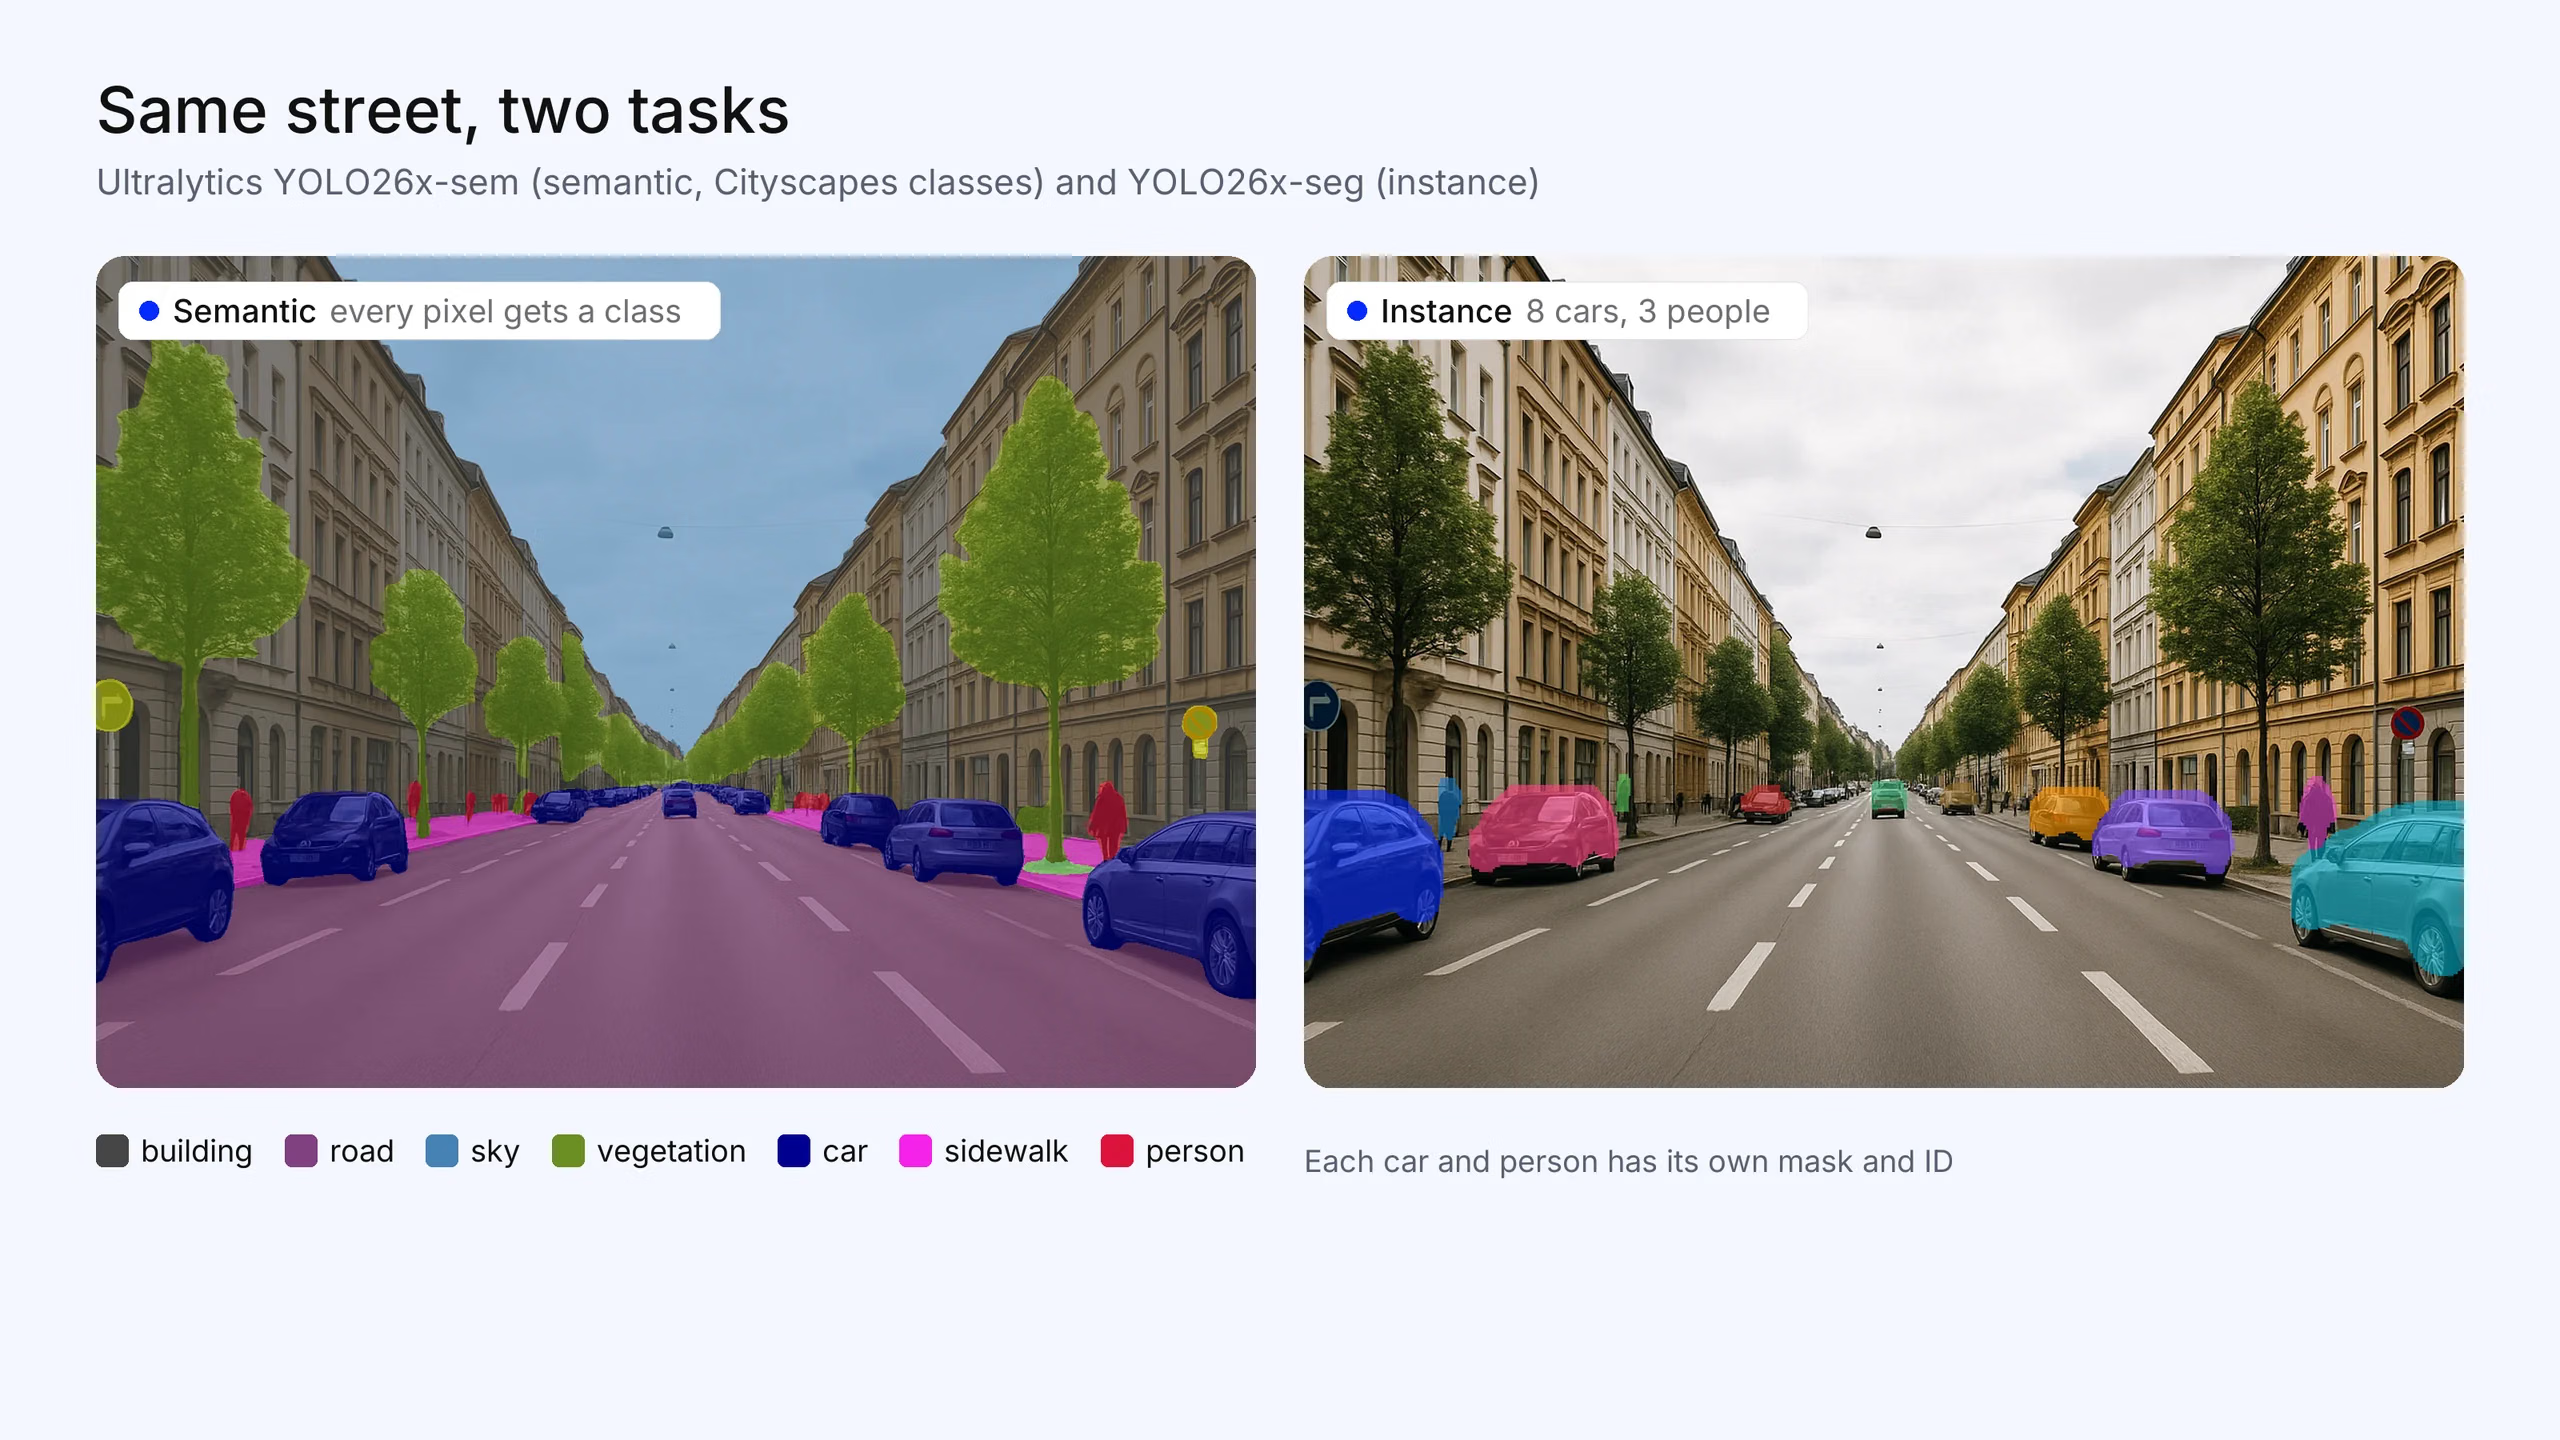
Fig. 1. A mesma rua com as duas tarefas. O Ultralytics YOLO26x-sem (classes Cityscapes) classifica cada píxel, por isso todos os carros partilham a classe "carro". O Ultralytics YOLO26x-seg atribui uma máscara própria a cada um dos 8 carros e das 3 pessoas que detetou (confiança igual ou superior a 0,5). A foto foi gerada para este artigo; as máscaras são saídas reais do modelo.
De que tarefa precisa o teu projeto?#
Começa pela pergunta a que a tua aplicação tem de responder:
| Se a tua aplicação precisar de… | Usa | Exemplo |
|---|---|---|
| Saber que área da cena pertence a uma determinada classe | Semântica | Área de estrada transitável, cobertura de culturas versus ervas daninhas, cobertura do solo |
| Classificar as regiões de fundo com o mesmo cuidado que os objetos | Semântica | Céu, água, vegetação, tipos de tecido numa imagem médica |
| Contar objetos | De instâncias | Fruta numa árvore, pessoas numa fila |
| Acompanhar objetos ao longo dos fotogramas de um vídeo | De instâncias, mais um rastreador | Pessoas ou veículos em movimento numa cena |
| Medir ou agir sobre um objeto de cada vez | De instâncias | Um robô a escolher uma peça de uma pilha, medir cada defeito |
| Fazer ambas as coisas: cobrir toda a cena e separar os objetos | Panótica | Cenas de rua para condução autónoma |
Se não tiveres a certeza, pergunta-te se é necessário distinguir dois objetos da mesma classe que se tocam. Se sim, precisas de segmentação de instâncias (ou panótica). Se não, a segmentação semântica é mais simples e, geralmente, mais barata de executar.
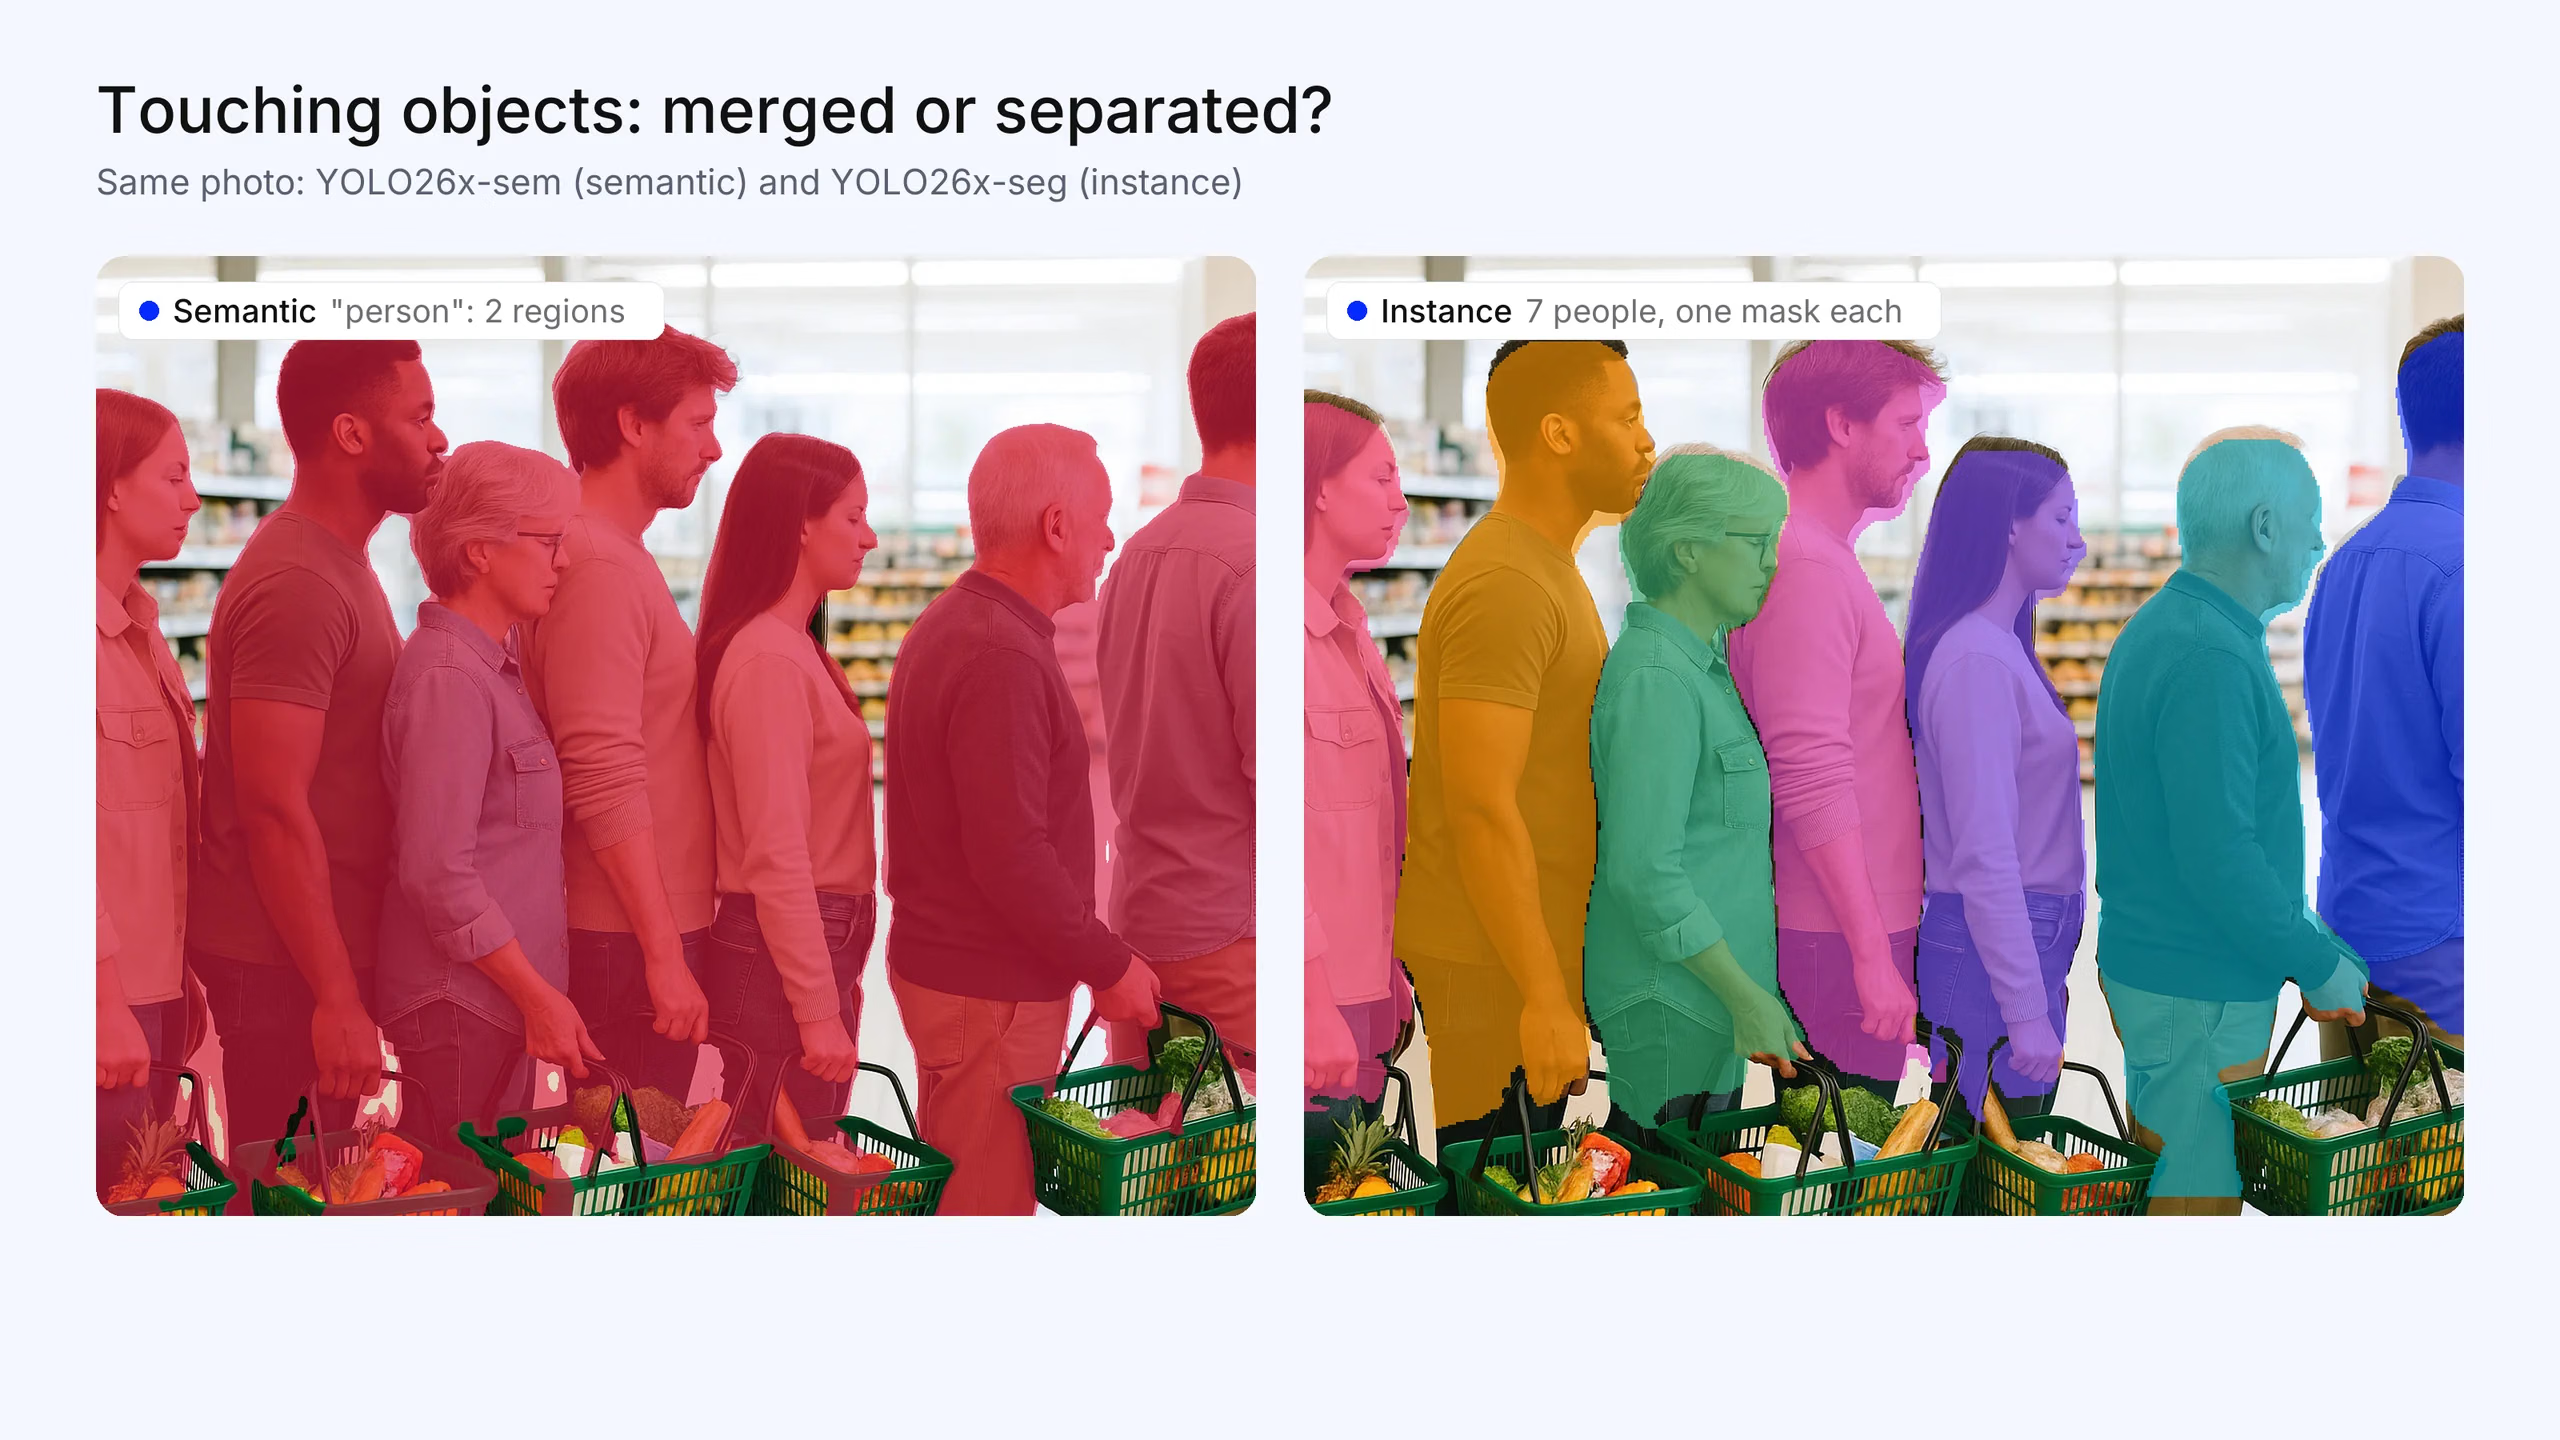
Fig. 2. Sete clientes de pé, muito próximos uns dos outros, numa fila de supermercado. Na saída semântica (Ultralytics YOLO26x-sem), são agrupados em duas regiões contíguas da classe "pessoa", pelo que não é possível contá-los a partir dessa saída. A saída de instâncias (Ultralytics YOLO26x-seg) separa os 7 clientes. A foto foi gerada para este artigo; as máscaras são saídas reais do modelo.
Principais diferenças em resumo#
| Critério | Segmentação semântica | Segmentação de instâncias |
|---|---|---|
| Pergunta a que responde | A que classe pertence cada píxel? | A que objeto pertence cada píxel? |
| Objetos da mesma classe | Agrupados numa única região | Separados, cada um com a sua própria máscara e ID |
| Cobertura | Todos os píxeis, incluindo o fundo | Normalmente, apenas os objetos de interesse |
| Saída | Um mapa de classes com as dimensões da imagem | Uma lista de máscaras, cada uma com uma classe e uma confiança |
| É possível contar objetos? | Não diretamente | Sim |
| Métrica principal | Interseção sobre União média (mIoU) | Precisão Média média das máscaras (mask mAP) |
| Complexidade relativa | Menor: classificação por píxel | Maior: deteção mais máscaras por objeto |
Custo de anotação de cada tarefa#
Na prática, é muitas vezes o esforço de anotação que determina a escolha.
- Os conjuntos de dados semânticos atribuem uma classe a cada píxel de cada imagem, incluindo o fundo. Normalmente, são armazenados como imagens de máscara de canal único. Todas as imagens são totalmente anotadas, por isso nenhum píxel pode ser ignorado, a menos que seja explicitamente marcado como "ignorar".
- Os conjuntos de dados de instâncias contornam cada objeto de interesse separadamente, como um polígono ou uma máscara. O fundo pode ficar sem anotação, mas cada objeto precisa do seu próprio contorno, e as cenas com muitos objetos aumentam o trabalho.
Ambas as tarefas exigem muito trabalho. A anotação assistida, em que um clique ou uma caixa se transforma numa máscara, reduz o esforço em qualquer uma delas. Se só precisas de respostas ao nível da região, não gastes recursos em rótulos de instâncias.
Como se avalia cada tarefa#
- A segmentação semântica é avaliada principalmente com mIoU: a sobreposição entre as regiões previstas e as reais, calculada como média entre as classes. Também se indica a precisão ao nível do píxel. IoU é a mesma medida de sobreposição usada na deteção.
- A segmentação de instâncias é avaliada com mask mAP, a média da Precisão Média usada na deteção, mas calculada com base na sobreposição das máscaras. Esta métrica recompensa a deteção de cada objeto, não apenas a cobertura dos píxeis certos.
Estas métricas não são comparáveis entre si. Um mIoU elevado não indica se os objetos individuais foram separados.
Segmentação panótica: quando precisas das duas#
A segmentação panótica atribui uma classe a cada píxel e, no caso dos objetos contáveis, um ID de instância. Elementos do fundo, como a estrada e o céu, são classificados semanticamente. Elementos em primeiro plano, como carros e pessoas, são separados individualmente. A avaliação usa a Qualidade Panótica (PQ). Escolhe esta opção quando precisas, ao mesmo tempo, de cobrir toda a cena e separar cada objeto. Consulta segmentação panótica.
Como funciona cada uma, em resumo#
Os modelos de segmentação semântica são normalmente redes codificador-descodificador que preveem uma classe para cada píxel. U-Net, DeepLab e SegFormer são exemplos conhecidos. Os modelos de segmentação de instâncias costumam basear-se na deteção de objetos. O Mask R-CNN prevê uma máscara dentro de cada caixa detetada, enquanto modelos de fase única, como YOLACT e os modelos de segmentação Ultralytics YOLO, preveem caixas e máscaras numa única passagem para utilização em tempo real. Arquiteturas universais, como Mask2Former, permitem realizar segmentação semântica, de instâncias e panótica com um único modelo. Para saber mais sobre segmentação de instâncias, consulta o que é a segmentação de instâncias.
Ambas as tarefas no Ultralytics YOLO#
O Ultralytics YOLO executa ambas as tarefas com a mesma API Python e CLI:
- A segmentação de instâncias usa a tarefa
segment. - A segmentação semântica usa a tarefa
semantic. Os modelos semânticos YOLO26 têm o sufixo-seme vêm pré-treinados com Cityscapes e ADE20K. A página da tarefa inclui uma tabela que mostra exatamente como as saídas das duas tarefas diferem no código.
Ambas podem ser treinadas localmente ou na nuvem na Ultralytics Platform.
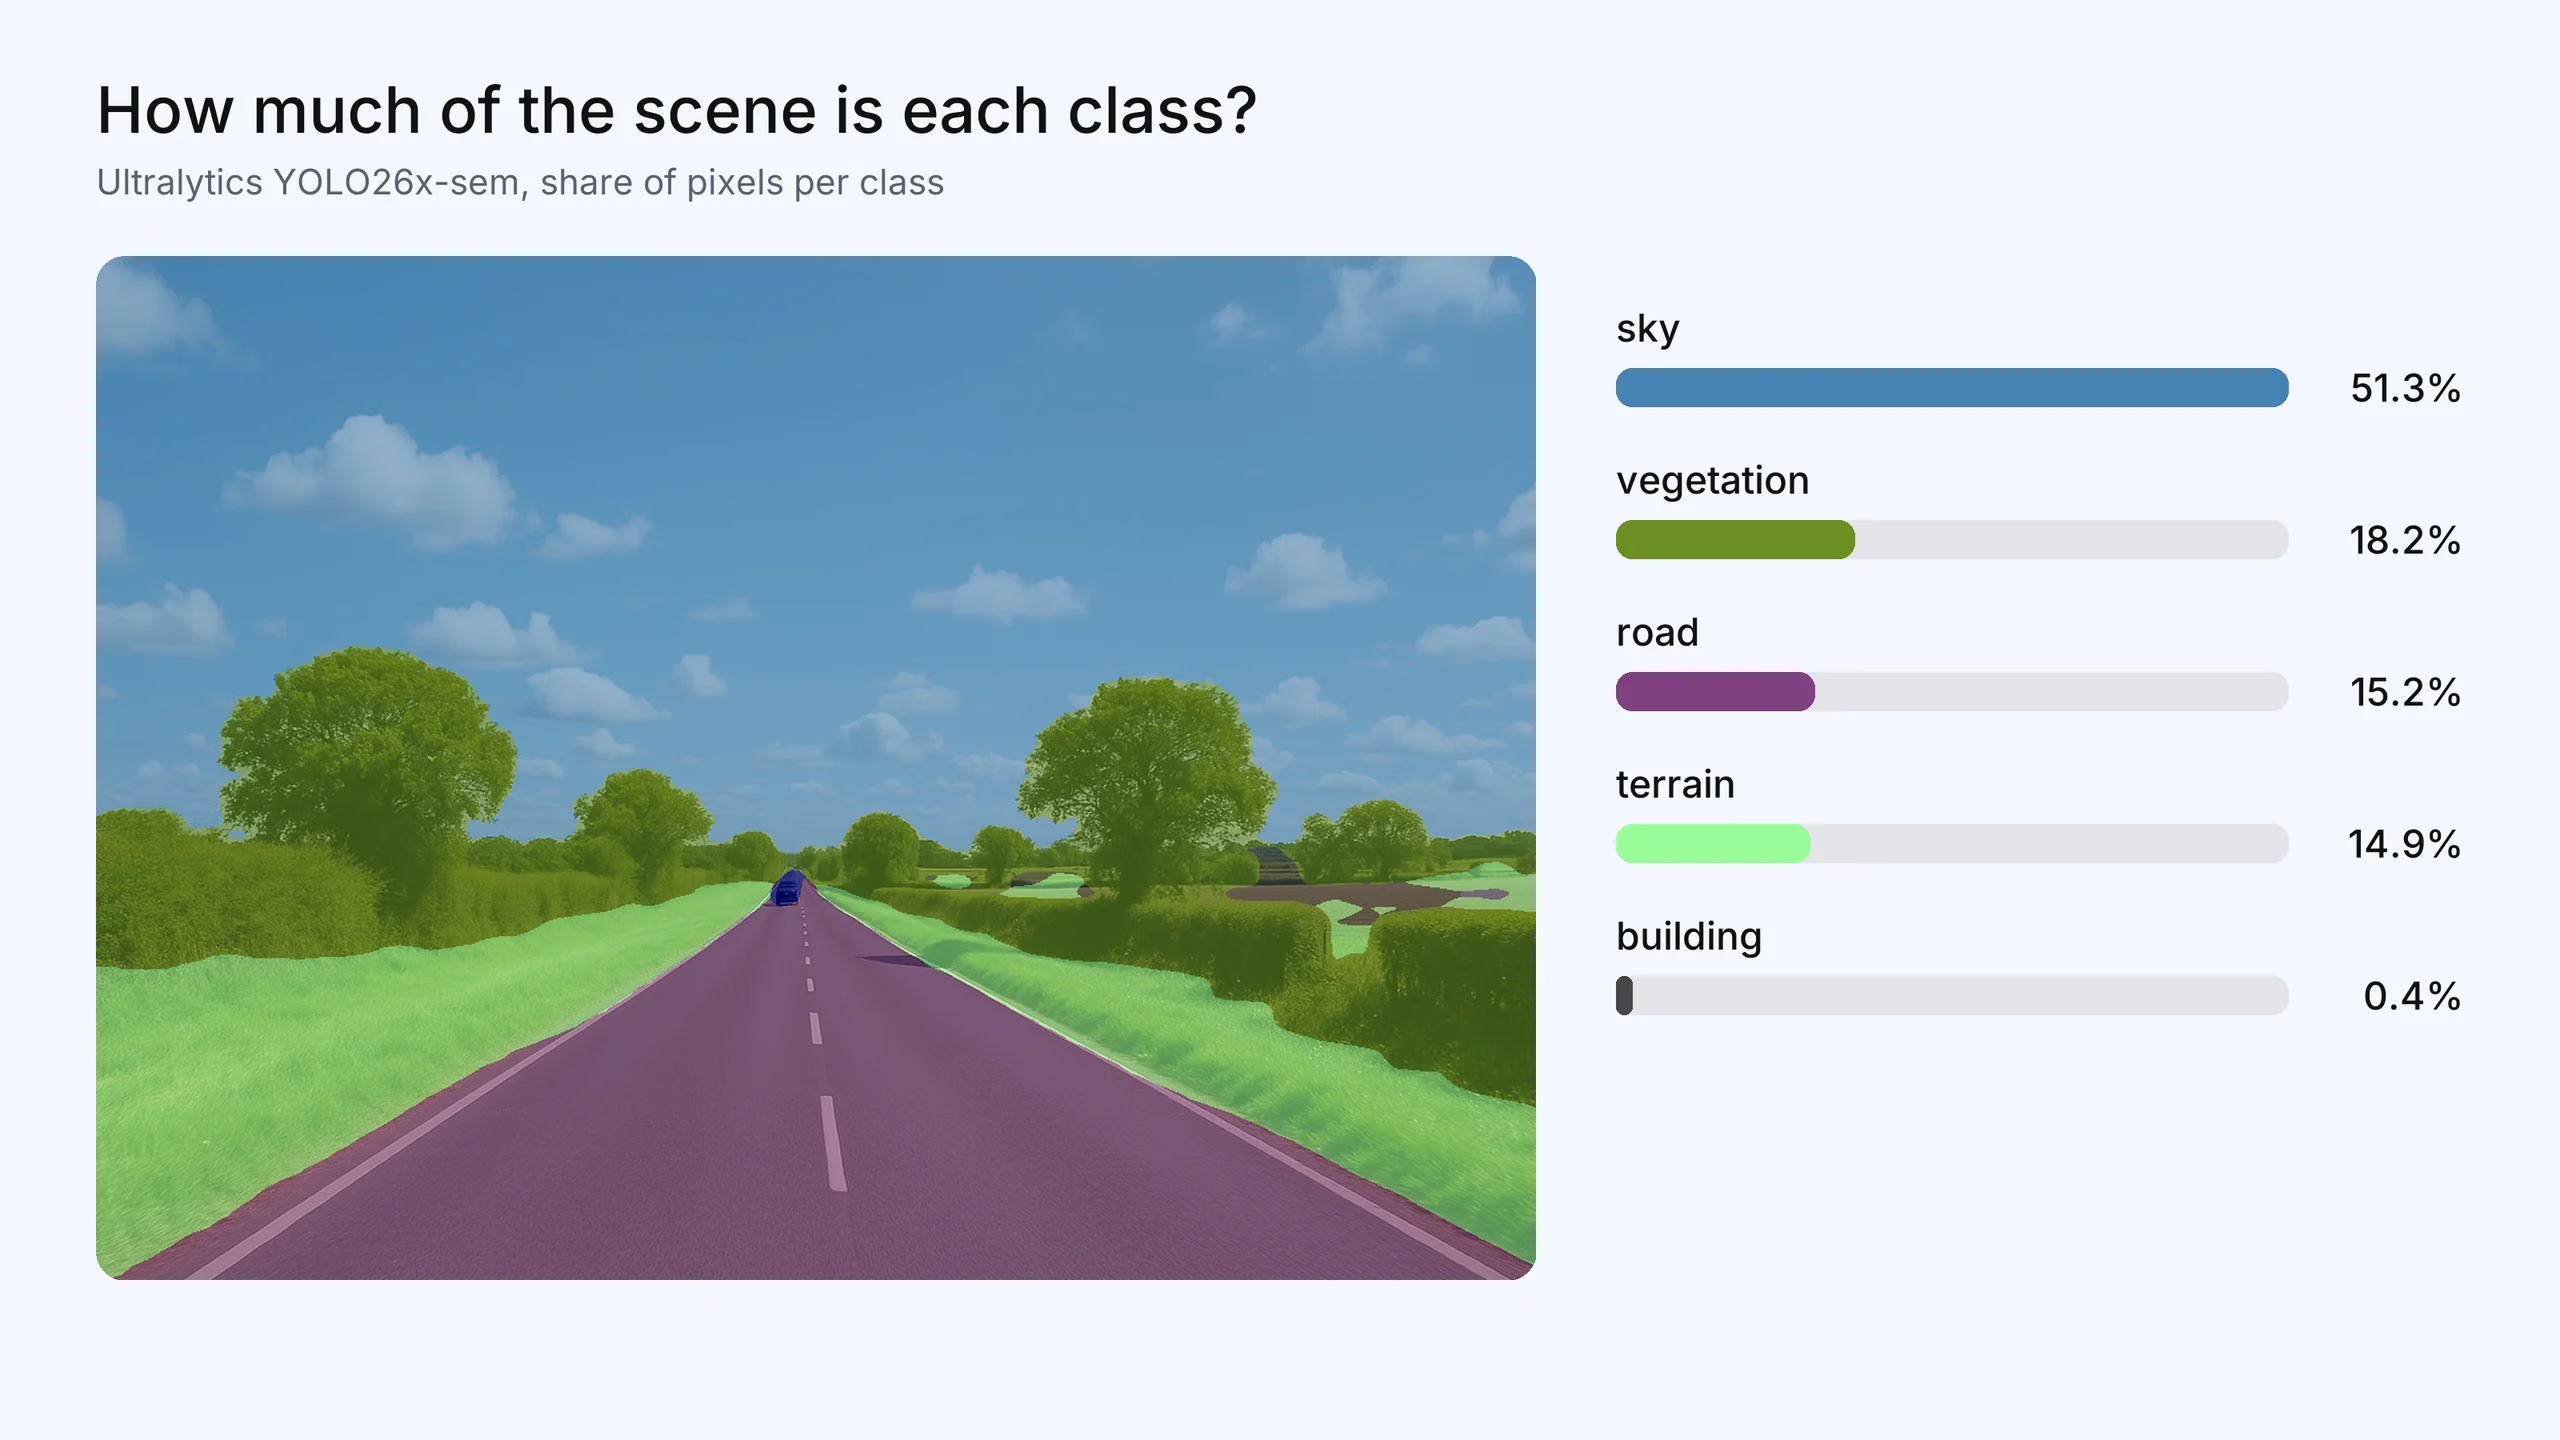
Fig. 3. A segmentação semântica responde à pergunta "que proporção da cena pertence a cada classe". O Ultralytics YOLO26x-sem classifica 51.3% desta imagem como céu, 18.2% como vegetação, 15.2% como estrada e 14.9% como terreno. A foto foi gerada para este artigo; o mapa de classes e as proporções são saídas reais do modelo.
Perguntas frequentes
A segmentação semântica atribui uma classe a cada pixel, mas trata todos os objetos da mesma classe como uma única região. A segmentação de instâncias separa cada objeto em sua própria máscara, permitindo contar e acompanhar individualmente objetos da mesma classe.
Pergunta-te se é preciso distinguir dois objetos da mesma classe que estão encostados. Se precisas contar, acompanhar ou agir sobre objetos individuais, usa a segmentação de instâncias. Se só precisas saber quais regiões pertencem a cada classe, a segmentação semântica é mais simples.
Mask R-CNN é um modelo de segmentação de instâncias. Ele deteta cada objeto e, em seguida, prevê uma máscara de pixels separada dentro da caixa delimitadora desse objeto.
Em geral, a segmentação de instâncias é mais difícil. Ela precisa classificar os pixels e também separar objetos da mesma classe, o que exige deteção além da segmentação.
Principalmente com a interseção sobre união média (mIoU), que corresponde à sobreposição média entre regiões previstas e reais em todas as classes. A segmentação de instâncias usa mAP de máscaras, e a segmentação panóptica usa qualidade panóptica (PQ).









