Melhores modelos de classificação de imagens: como escolher
Compara os principais modelos de classificação de imagens, de ConvNeXt V2 e DINOv3 a EfficientNetV2, ViT e Ultralytics YOLO26-cls, e aprende a escolher.
Não existe um único melhor modelo de classificação de imagens. O modelo certo depende da quantidade de dados rotulados que tens, do local onde o modelo tem de ser executado e da compatibilidade da licença com o teu uso. Em 2026, o trabalho que prioriza a precisão centra-se em backbones Transformer de grande dimensão e auto-supervisionados, como DINOv3 e EVA-02. Para implementação em hardware limitado, os modelos mais pequenos, na sua maioria convolucionais, como ConvNeXt V2, EfficientNetV2, MobileNetV4 e Ultralytics YOLO26-cls, são muitas vezes mais práticos, dependendo do tamanho do checkpoint, da configuração do treino e do hardware de destino. Compara a precisão e a latência com a tua própria carga de trabalho. Este guia explica as quatro famílias de modelos, compara dez modelos amplamente utilizados e apresenta um processo de decisão para escolher um.
Se ainda estás a conhecer a própria tarefa, começa por o que é a classificação de imagens. Esta página trata da escolha de um modelo.
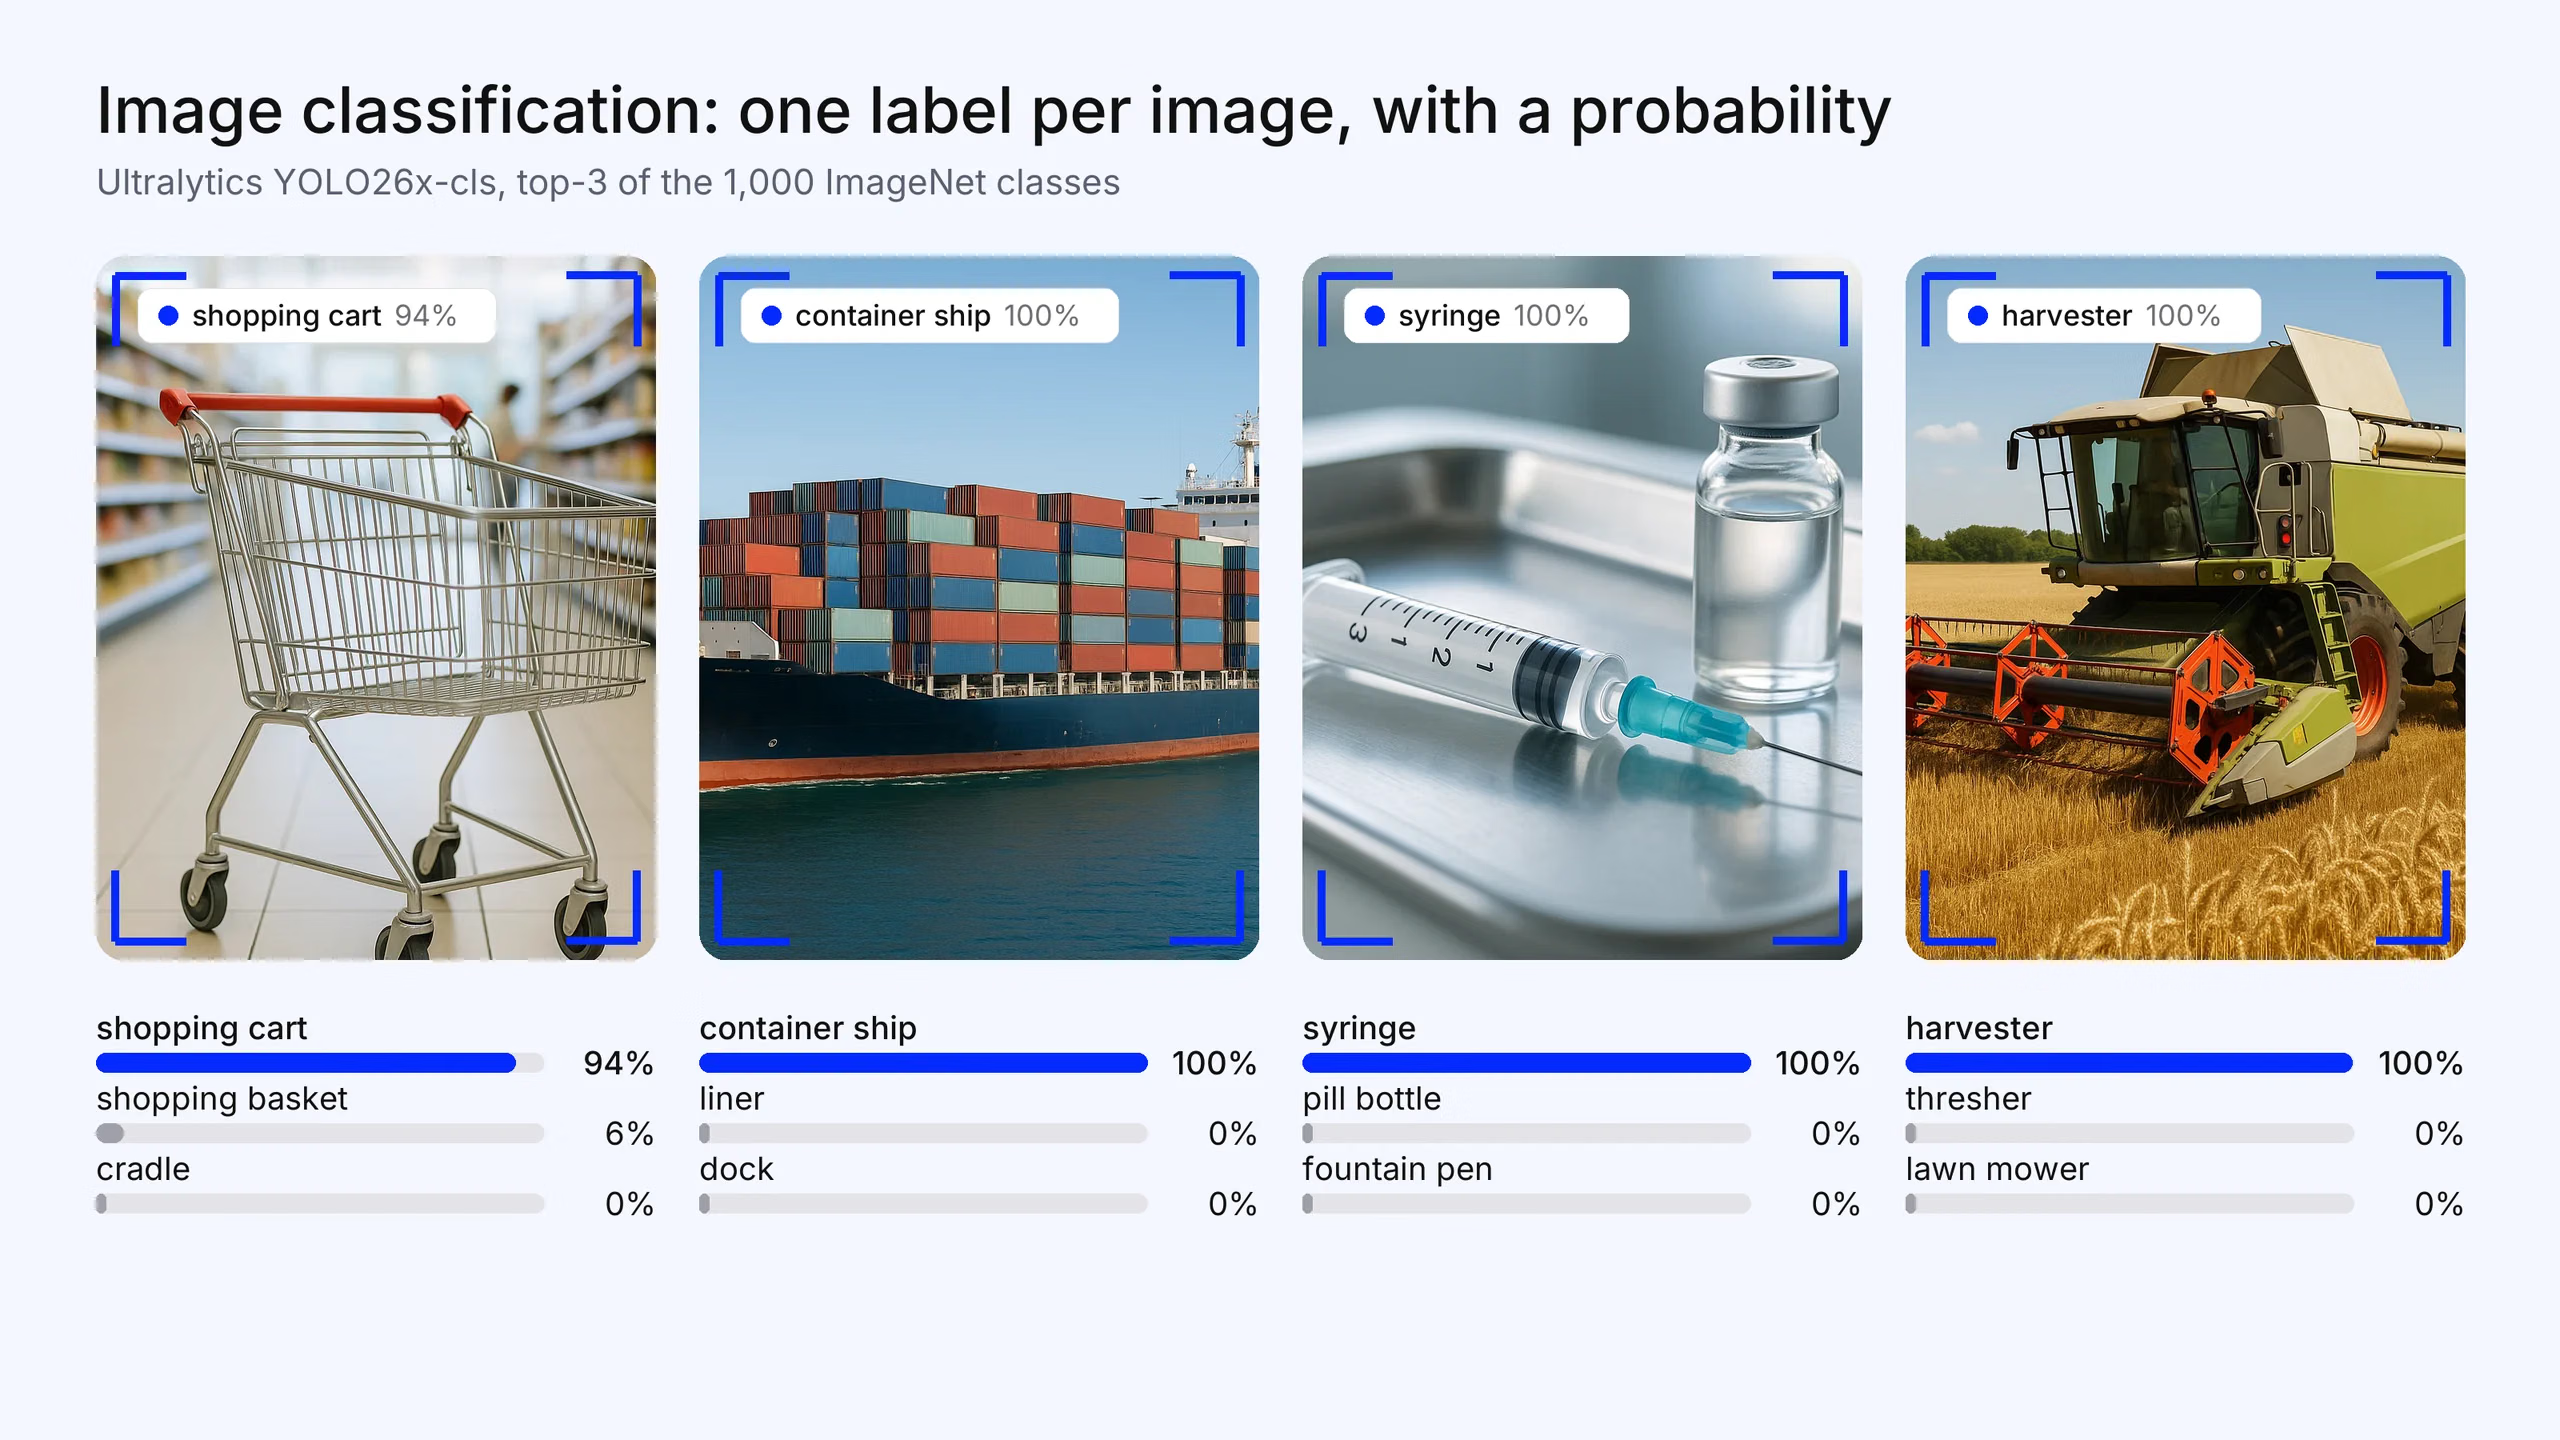
Fig. 1. A classificação de imagens devolve um rótulo para a imagem inteira, com uma probabilidade para cada classe: exemplos de retalho, logística, cuidados de saúde e agricultura. As três principais previsões são do Ultralytics YOLO26x-cls, pré-treinado nas 1.000 classes do ImageNet. As fotografias foram geradas para este artigo; as previsões são resultados reais do modelo.
O que significa «melhor» para um modelo de classificação de imagens#
As tabelas de classificação ordenam os modelos pela precisão top-1 no conjunto de validação do ImageNet. Esse valor é útil, mas é medido com uma resolução fixa, num único conjunto de dados e, muitas vezes, com um pré-treino de grande dimensão. Normalmente, são quatro outros fatores que determinam um projeto real:
- Dados. Quantas imagens rotuladas tens por classe e quão semelhantes são aos dados de pré-treino.
- Capacidade de computação e latência. Se a inferência é executada numa GPU de centro de dados, numa CPU ou numa NPU de telemóvel ou câmara.
- Caminho de implementação. Se o modelo pode ser exportado sem problemas para o ambiente de execução de que precisas, como ONNX, TensorRT, Core ML ou TFLite.
- Licença. Se o código e, separadamente, os pesos pré-treinados permitem o teu uso.
Um modelo com uma precisão alguns pontos inferior no ImageNet, mas que se ajusta bem às tuas imagens e funciona em tempo real no teu hardware, costuma ser a melhor escolha.
As quatro famílias de modelos de classificação de imagens#
Redes neurais convolucionais (CNNs)#
As CNNs deslizam filtros aprendidos pela imagem, partindo do princípio de que os píxeis próximos estão relacionados. Esta suposição incorporada (um viés indutivo) permite-lhes aprender bem com conjuntos de dados pequenos e médios e funcionar eficientemente em hardware modesto. ResNet e EfficientNet são os exemplos clássicos.
- Pontos fortes: eficientes em termos de dados, rápidas e fáceis de quantizar e implementar.
- Compromissos: menos contexto global por camada; os ganhos com o aumento de escala tendem a estabilizar mais cedo do que nos Transformer.
Transformers de visão (ViTs)#
Um Transformer de visão divide uma imagem em patches e processa-os como uma sequência com autoatenção, permitindo que cada patch se relacione com todos os outros. Os ViT têm melhores resultados quando são pré-treinados com grandes quantidades de dados e depois transferidos.
- Pontos fortes: escala bem com os dados e o tamanho do modelo; forte capacidade de transferência; base natural para treino auto-supervisionado e multimodal.
- Compromissos: precisa de pré-treino em grande escala ou de regularização intensa; normalmente é mais lento e pesado na inferência do que uma CNN com precisão semelhante.
Modelos híbridos de CNN e Transformer#
Os modelos híbridos usam convoluções nas primeiras etapas para captar detalhes locais e atenção nas etapas posteriores para obter contexto global. CoAtNet é o modelo de referência: os autores descobriram que empilhar camadas de convolução e atenção numa ordem bem definida melhora a generalização, a capacidade e a eficiência.
- Pontos fortes: bom equilíbrio em conjuntos de dados de dimensão média.
- Compromissos: mais complexo de implementar, ajustar e exportar do que qualquer uma das abordagens puras.
Backbones auto-supervisionados e de visão-linguagem#
A família mais recente não se define pela arquitetura, mas pela forma como é treinada. Os modelos auto-supervisionados, como DINOv2 e DINOv3, aprendem com imagens sem rótulos. Os codificadores de visão-linguagem, como SigLIP 2, aprendem com pares de imagem e texto. Ambos produzem características de uso geral que podes classificar com uma pequena camada linear ou, no caso dos modelos de visão-linguagem, com prompts de texto e sem qualquer treino (aprendizagem zero-shot). A Meta treinou o DINOv3 com 7 mil milhões de parâmetros em 1,7 mil milhões de imagens, face aos 1,1 mil milhões de parâmetros e 142 milhões de imagens do DINOv2.
- Pontos fortes: características robustas com poucos dados rotulados; um único backbone serve várias tarefas.
- Compromissos: os checkpoints maiores são demasiado pesados para dispositivos de edge; as licenças variam e têm de ser verificadas.
Comparação de modelos de classificação de imagens#
Os modelos estão listados por ordem alfabética, não por classificação. Não incluímos valores de precisão: os valores publicados para o ImageNet variam consoante a resolução, os dados de pré-treino e o protocolo de avaliação, pelo que não são comparáveis entre estas linhas. O artigo ou a documentação de cada modelo, com ligação abaixo, apresenta os respetivos valores.
| Modelo | Família | Origem | Pré-treino | Ideal para | Principal desvantagem |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Autoencodificação mascarada auto-supervisionada (FCMAE), seguida de ajuste fino supervisionado | CNN precisa e implementável, disponível em vários tamanhos | Os pesos do ImageNet têm licença CC-BY-NC (não comercial) |
| DINOv3 | Auto-supervisionado (ViT e ConvNeXt) | Meta | Auto-supervisionado em 1,7 mil milhões de imagens | Características robustas com o backbone congelado e poucos dados rotulados | Licença DINOv3 personalizada; o maior modelo tem 7B parâmetros |
| EfficientNetV2 | CNN | Supervisionado | Treino rápido, ajuste fino eficiente | Arquitetura mais antiga; os backbones mais recentes lideram em precisão | |
| EVA-02 | ViT | BAAI | Modelação de imagens mascaradas com características CLIP | Investigação e ajuste fino com prioridade na precisão | As variantes de grande dimensão são pesadas durante a inferência |
| MobileNetV4 | CNN e híbrido (dispositivos móveis) | Supervisionado | Telemóveis, NPUs e aceleradores edge | Limite máximo de precisão inferior ao dos modelos de servidor | |
| ResNet | CNN | Microsoft Research | Supervisionado | Referências de base, ensino, pipelines legados | Já não é competitivo em precisão por FLOP |
| SigLIP 2 | Visão-linguagem (ViT) | Pares de imagem e texto, multilingues | Classificação zero-shot e de vocabulário aberto | Valida os resultados zero-shot nas classes que pretendes usar antes de te baseares neles | |
| Swin Transformer | ViT (hierárquico) | Microsoft Research | Supervisionado | Entradas de resolução mais alta, reutilização do backbone | Mais pesado do que as CNNs com precisão semelhante |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Supervisionado no ImageNet | Classificadores personalizados rápidos, exportação para edge, uma API partilhada com a deteção | Limite máximo de precisão inferior ao dos Transformer pré-treinados de grande dimensão |
| ViT | ViT | Supervisionado, muitas vezes em grandes conjuntos de dados | Aprendizagem por transferência em grande escala | Exige muitos dados sem pré-treino de grande dimensão |
Os modelos em mais detalhe#
Listados por ordem alfabética.
ConvNeXt V2#
ConvNeXt V2 combina um autoencoder convolucional mascarado (FCMAE) com uma camada de Normalização da Resposta Global. Está disponível em oito tamanhos, de Atto (3,7M parâmetros) a Huge (660M), pelo que uma única família abrange desde dispositivos edge a servidores. É uma opção padrão robusta quando pretendes precisão ao nível dos Transformer, mas com a facilidade de implementação das CNNs. Compromisso: o código tem licença MIT, mas os pesos pré-treinados e ajustados no ImageNet têm licença CC-BY-NC, que exclui o uso comercial desses pesos.
DINOv3#
DINOv3 é o backbone de visão auto-supervisionado da Meta. Foi disponibilizado como modelos ViT, de ViT-S/16 a ViT-7B/16, além de modelos ConvNeXt destilados para uso no dispositivo. A Meta avalia o modelo com o backbone congelado, e o repositório inclui uma cabeça de classificação ImageNet para o modelo 7B. É o modelo a experimentar quando tens poucos rótulos e queres características transferíveis. Compromisso: é disponibilizado sob a sua própria Licença DINOv3, em vez de uma licença de código aberto padrão, e os resultados mais destacados provêm do maior modelo.
EfficientNetV2#
EfficientNetV2, da Google, usa aprendizagem progressiva: aumenta o tamanho das imagens durante o treino e ajusta a regularização em conformidade. Isso permite um treino mais rápido e menos parâmetros do que nos modelos anteriores. Continua a ser uma opção fiável para ajuste fino em conjuntos de dados pequenos a médios. Compromisso: é anterior aos backbones de 2023–2025 e já não lidera em precisão. Para conheceres o projeto original, consulta a nossa visão geral do EfficientNet.
EVA-02#
EVA-02 é um Transformer convencional pré-treinado com modelação de imagens mascaradas para reconstruir características a partir de um codificador visual CLIP de grande dimensão. Existem quatro tamanhos, de 6M a 304M parâmetros. Está disponível no timm para ajuste fino. Compromisso: as variantes grandes são dispendiosas de ajustar e servir, além de serem excessivas para classificadores de domínio simples.
MobileNetV4#
MobileNetV4 é a família móvel mais recente da Google, concebida para ser eficiente em CPUs móveis, DSPs, GPUs, Apple Neural Engine e Google Pixel EdgeTPU. É a escolha natural para um telemóvel ou acelerador de baixo consumo. Compromisso: abdica da precisão máxima em favor da latência.
ResNet#
ResNet introduziu ligações residuais e continua a ser a referência padrão, com suporte em todas as frameworks. Compromisso: as CNNs mais recentes oferecem maior precisão com a mesma capacidade de computação. Consulta o que é ResNet-50 para conheceres a arquitetura.
SigLIP 2#
SigLIP 2 (consulta a nossa entrada no glossário sobre SigLIP) é a família de codificadores de visão-linguagem multilingues da Google. Pode classificar imagens com base numa lista de rótulos de texto sem treino (com uma abordagem semelhante à do CLIP), e a sua variante NaFlex mantém a proporção nativa da imagem de entrada. É a opção mais adequada quando o conjunto de rótulos muda frequentemente ou ainda não tens dados rotulados. Compromisso: a qualidade zero-shot varia consoante o domínio, por isso valida-a nas classes que pretendes usar (por exemplo, tipos de defeitos) antes de te baseares nela. Se os resultados forem insuficientes, treina uma cabeça de classificação ou faz ajuste fino.
Swin Transformer#
Swin Transformer calcula a atenção em janelas locais deslocadas, o que mantém a capacidade de computação linear em relação ao tamanho da imagem e é adequado para entradas de resolução mais alta. Compromisso: é mais pesado do que uma CNN com precisão semelhante; o ConvNeXt foi concebido para competir com ele usando convoluções convencionais.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls é a variante de classificação do Ultralytics YOLO26. Está disponível em cinco tamanhos (n, s, m, l, x), de 2,8M a 29,6M parâmetros (com fusão), aceita entradas de 224 píxeis e é pré-treinado no ImageNet. A documentação apresenta a precisão top-1 e top-5 no conjunto de validação do ImageNet, bem como a latência em CPU e GPU para cada tamanho. A mesma API de Python e CLI permitem treinar, validar e exportar modelos de classificação, deteção, segmentação e pose; os classificadores podem ser exportados para formatos como ONNX, TensorRT, Core ML, OpenVINO e LiteRT. Os modelos YOLO11-cls anteriores usam os mesmos cinco tamanhos e o mesmo tamanho de entrada. Compromissos:
- Limite máximo de precisão. Mesmo o modelo x é pequeno em comparação com Transformer pré-treinados de grande dimensão, como EVA-02 ou DINOv3, pelo que não é a opção indicada para investigação que prioriza a precisão.
- Recortes quadrados por predefinição. O treino usa um recorte redimensionado aleatoriamente e a validação, um recorte central, o que pode cortar partes de imagens com proporções extremas. A documentação mostra como substituir esse processo por um redimensionamento simples.
- Licença. Os modelos Ultralytics têm licença AGPL-3.0. O uso comercial em código fechado requer uma licença Ultralytics Enterprise.
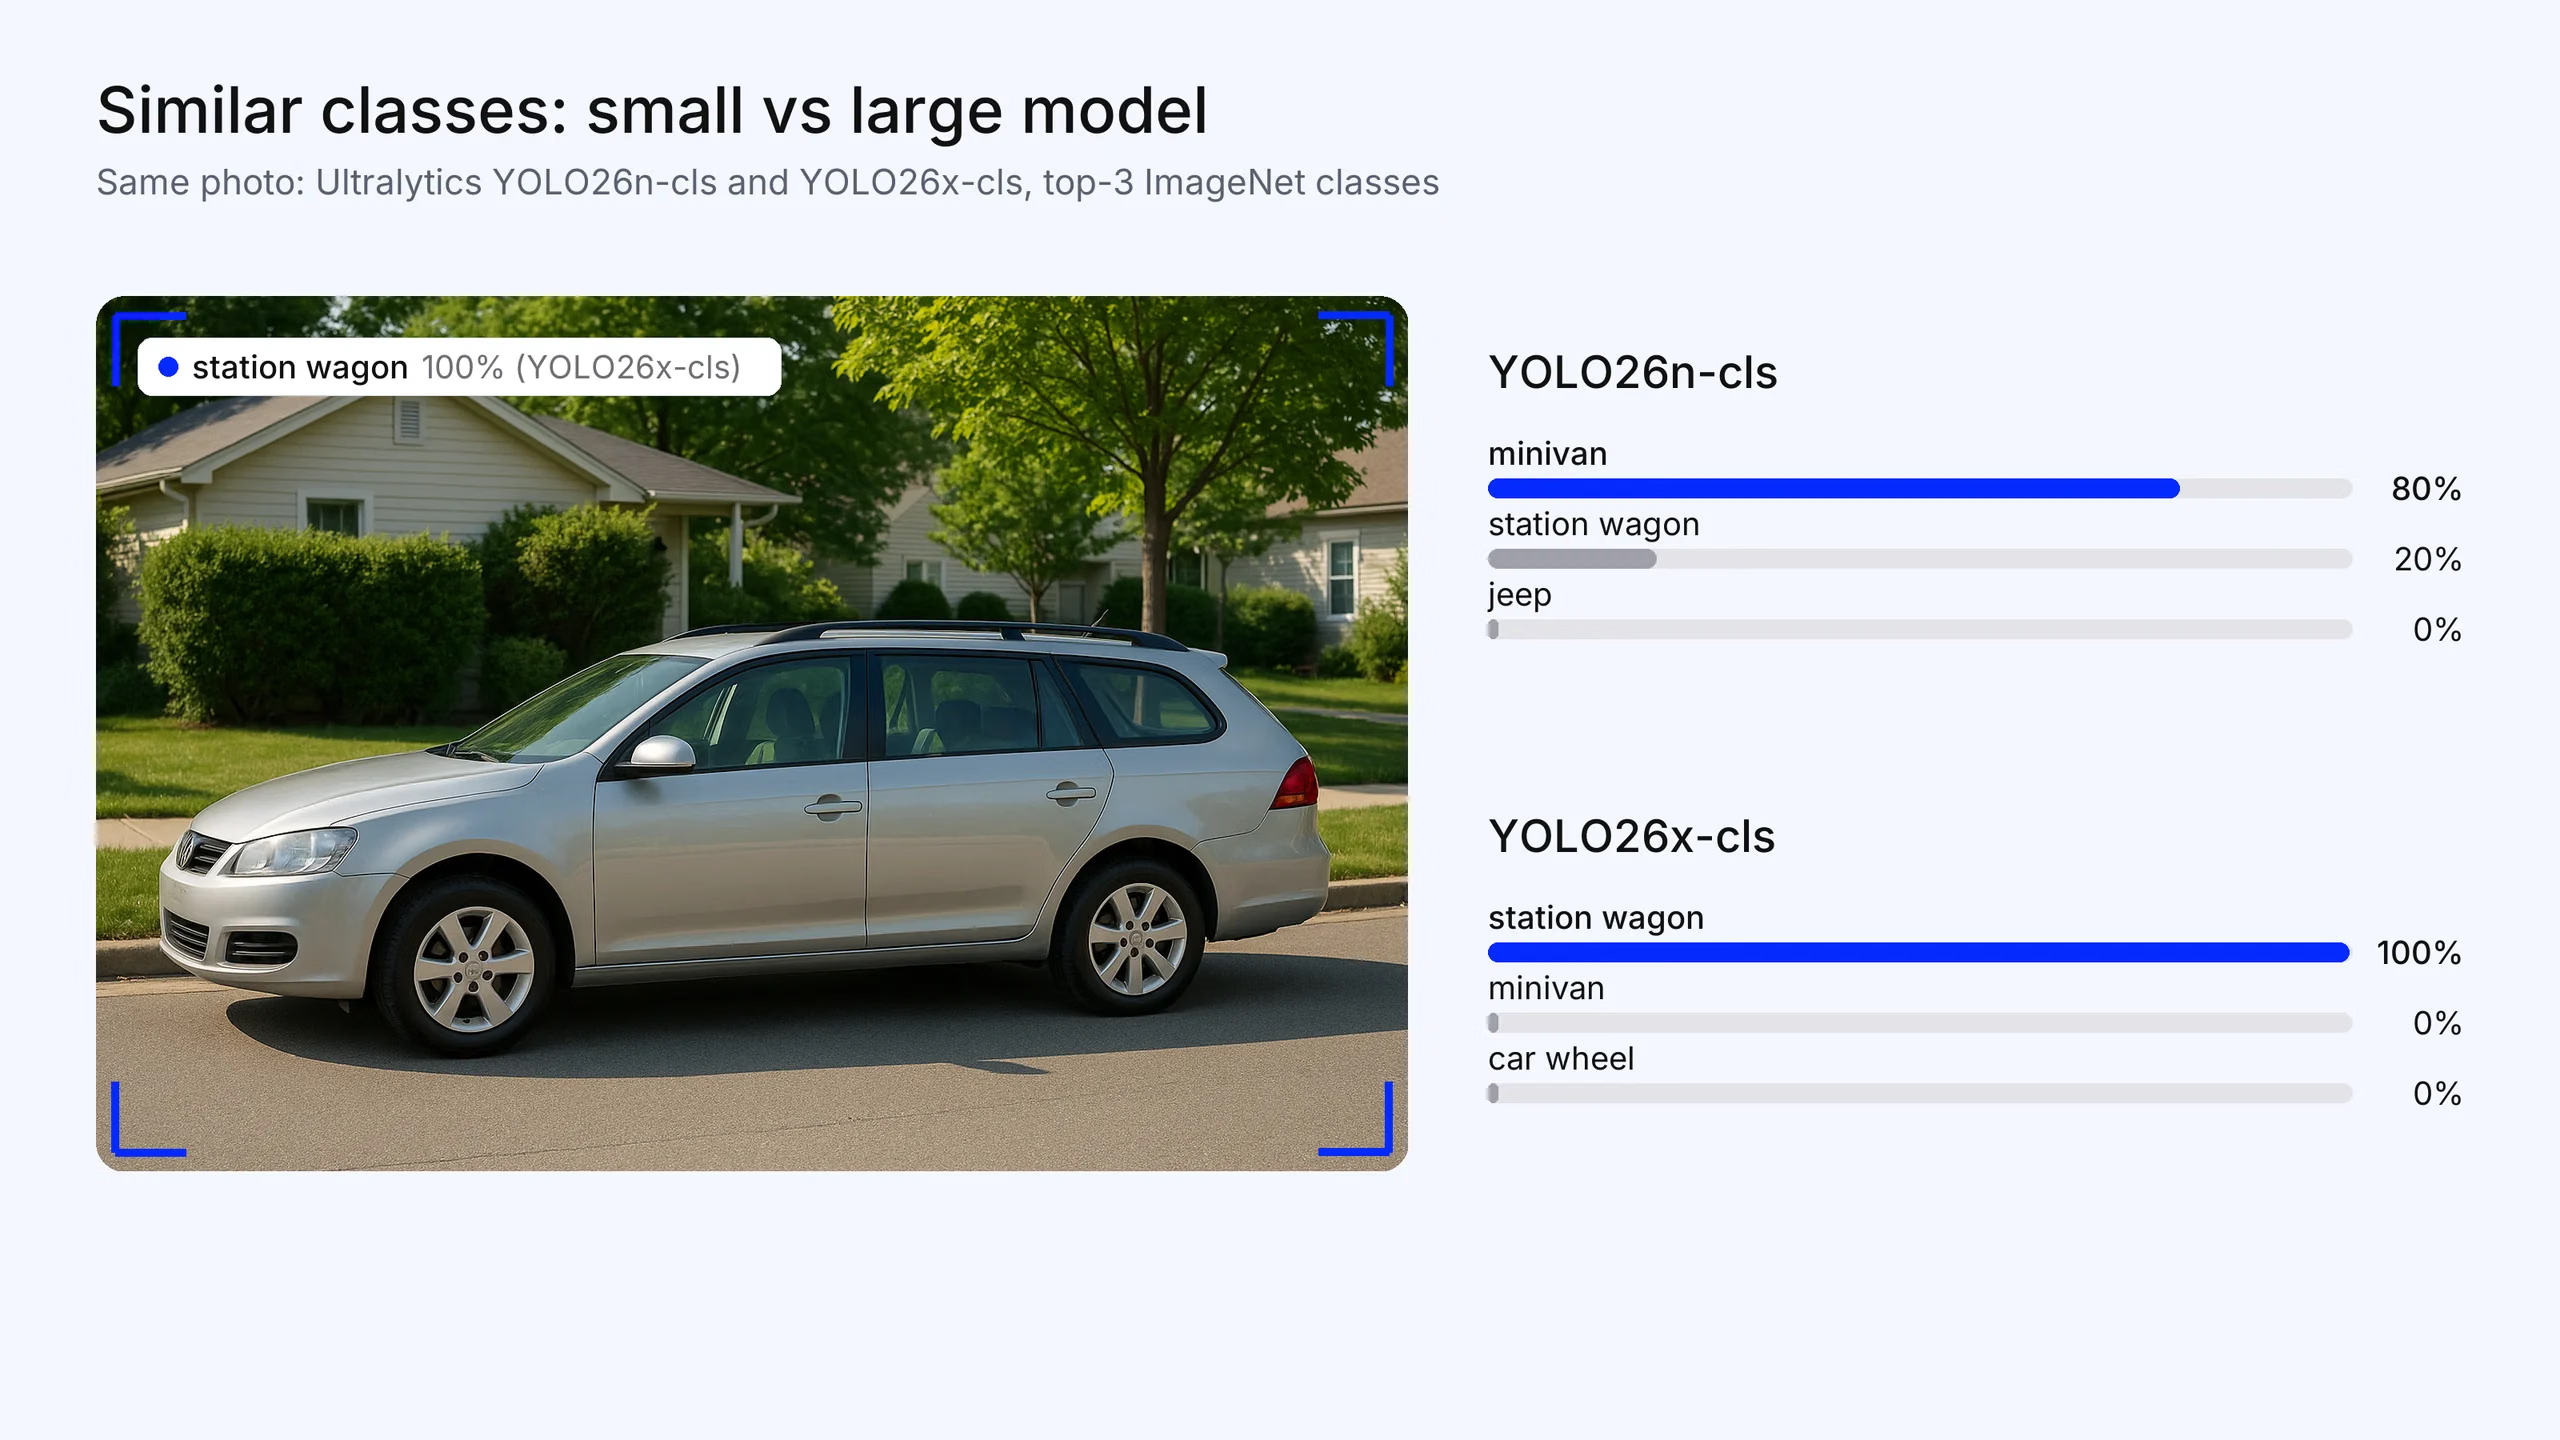
Fig. 2. É nas classes semelhantes que o tamanho do modelo faz diferença. Nesta foto de uma perua, o Ultralytics YOLO26n-cls classifica primeiro como "minivan" (80%), enquanto o YOLO26x-cls classifica primeiro como perua (100%, exibida como a classe "beach wagon, station wagon" do ImageNet). Testa classes detalhadas como estas no teu próprio conjunto de validação. A foto foi gerada para este artigo; as previsões são saídas reais do modelo.
ViT#
O Vision Transformer original do Google mostrou que um Transformer puro aplicado a fragmentos de imagem pode igualar ou superar as CNNs quando pré-treinado com grandes volumes de dados. Compensação: sem pré-treino em grande escala, tem desempenho inferior ao das CNNs em conjuntos de dados pequenos e exige mais computação durante a inferência.
Como escolher um modelo de classificação de imagens#
Responde a estas perguntas pela ordem apresentada:
- Tens dados rotulados? Se não tens exemplos rotulados, começa com um modelo de visão-linguagem, como o SigLIP 2, para classificação zero-shot. Com um conjunto de dados pequeno e rotulado, avalia também um backbone DINOv3 congelado com uma cabeça linear treinada.
- Onde será executado? Num telemóvel ou NPU, considera o MobileNetV4 ou uma CNN pequena, como o YOLO26n-cls ou um ConvNeXt V2 pequeno. Para execução em tempo real numa GPU de borda ou CPU, considera o YOLO26-cls, o EfficientNetV2 ou o ConvNeXt V2. Num servidor sem um limite rigoroso de latência, considera o EVA-02, o Swin ou um ViT DINOv3.
- Quantos dados rotulados tens por classe? Com centenas a alguns milhares de imagens, a aprendizagem por transferência a partir de uma CNN pré-treinada ou de um backbone autossupervisionado congelado é a opção mais segura. Com dezenas de milhares de imagens ou mais, o ajuste fino completo dos Transformers começa a compensar.
- Podes usar a licença? Verifica os pesos, não apenas o código: os pesos ImageNet do ConvNeXt V2 são para uso não comercial, o DINOv3 tem a sua própria licença e os modelos Ultralytics usam AGPL-3.0, a menos que tenhas uma licença Enterprise.
- É possível exportá-lo para o teu ambiente de execução? Confirma que existe um caminho compatível para ONNX, TensorRT, Core ML ou TFLite antes de te comprometeres.
Depois, ajusta dois ou três dos modelos pré-selecionados e compara-os no teu próprio subconjunto de validação.
Quando outro modelo é mais adequado do que o YOLO#
O YOLO26-cls foi criado para classificadores personalizados rápidos e fáceis de implementar. Para alguns trabalhos, outro modelo é a melhor opção:
- Investigação ou benchmarks com prioridade na precisão: usa o EVA-02, o ConvNeXt V2 ou um ViT através do timm, que disponibiliza receitas e pesos para reproduzir resultados ao nível do ImageNet.
- Poucos rótulos ou muitas tarefas a jusante a partir de um único backbone: usa características do DINOv3 com uma cabeça linear.
- Conjuntos de rótulos abertos ou que mudam frequentemente: usa o SigLIP 2 em modo zero-shot.
- NPUs para telemóveis, como o Apple Neural Engine ou o EdgeTPU: o MobileNetV4 foi concebido e testado especificamente nestas plataformas.
Se também precisas de localizar objetos, e não apenas de saber o que aparece na imagem, precisas de um detetor. Consulta a nossa comparação de modelos de deteção de objetos.
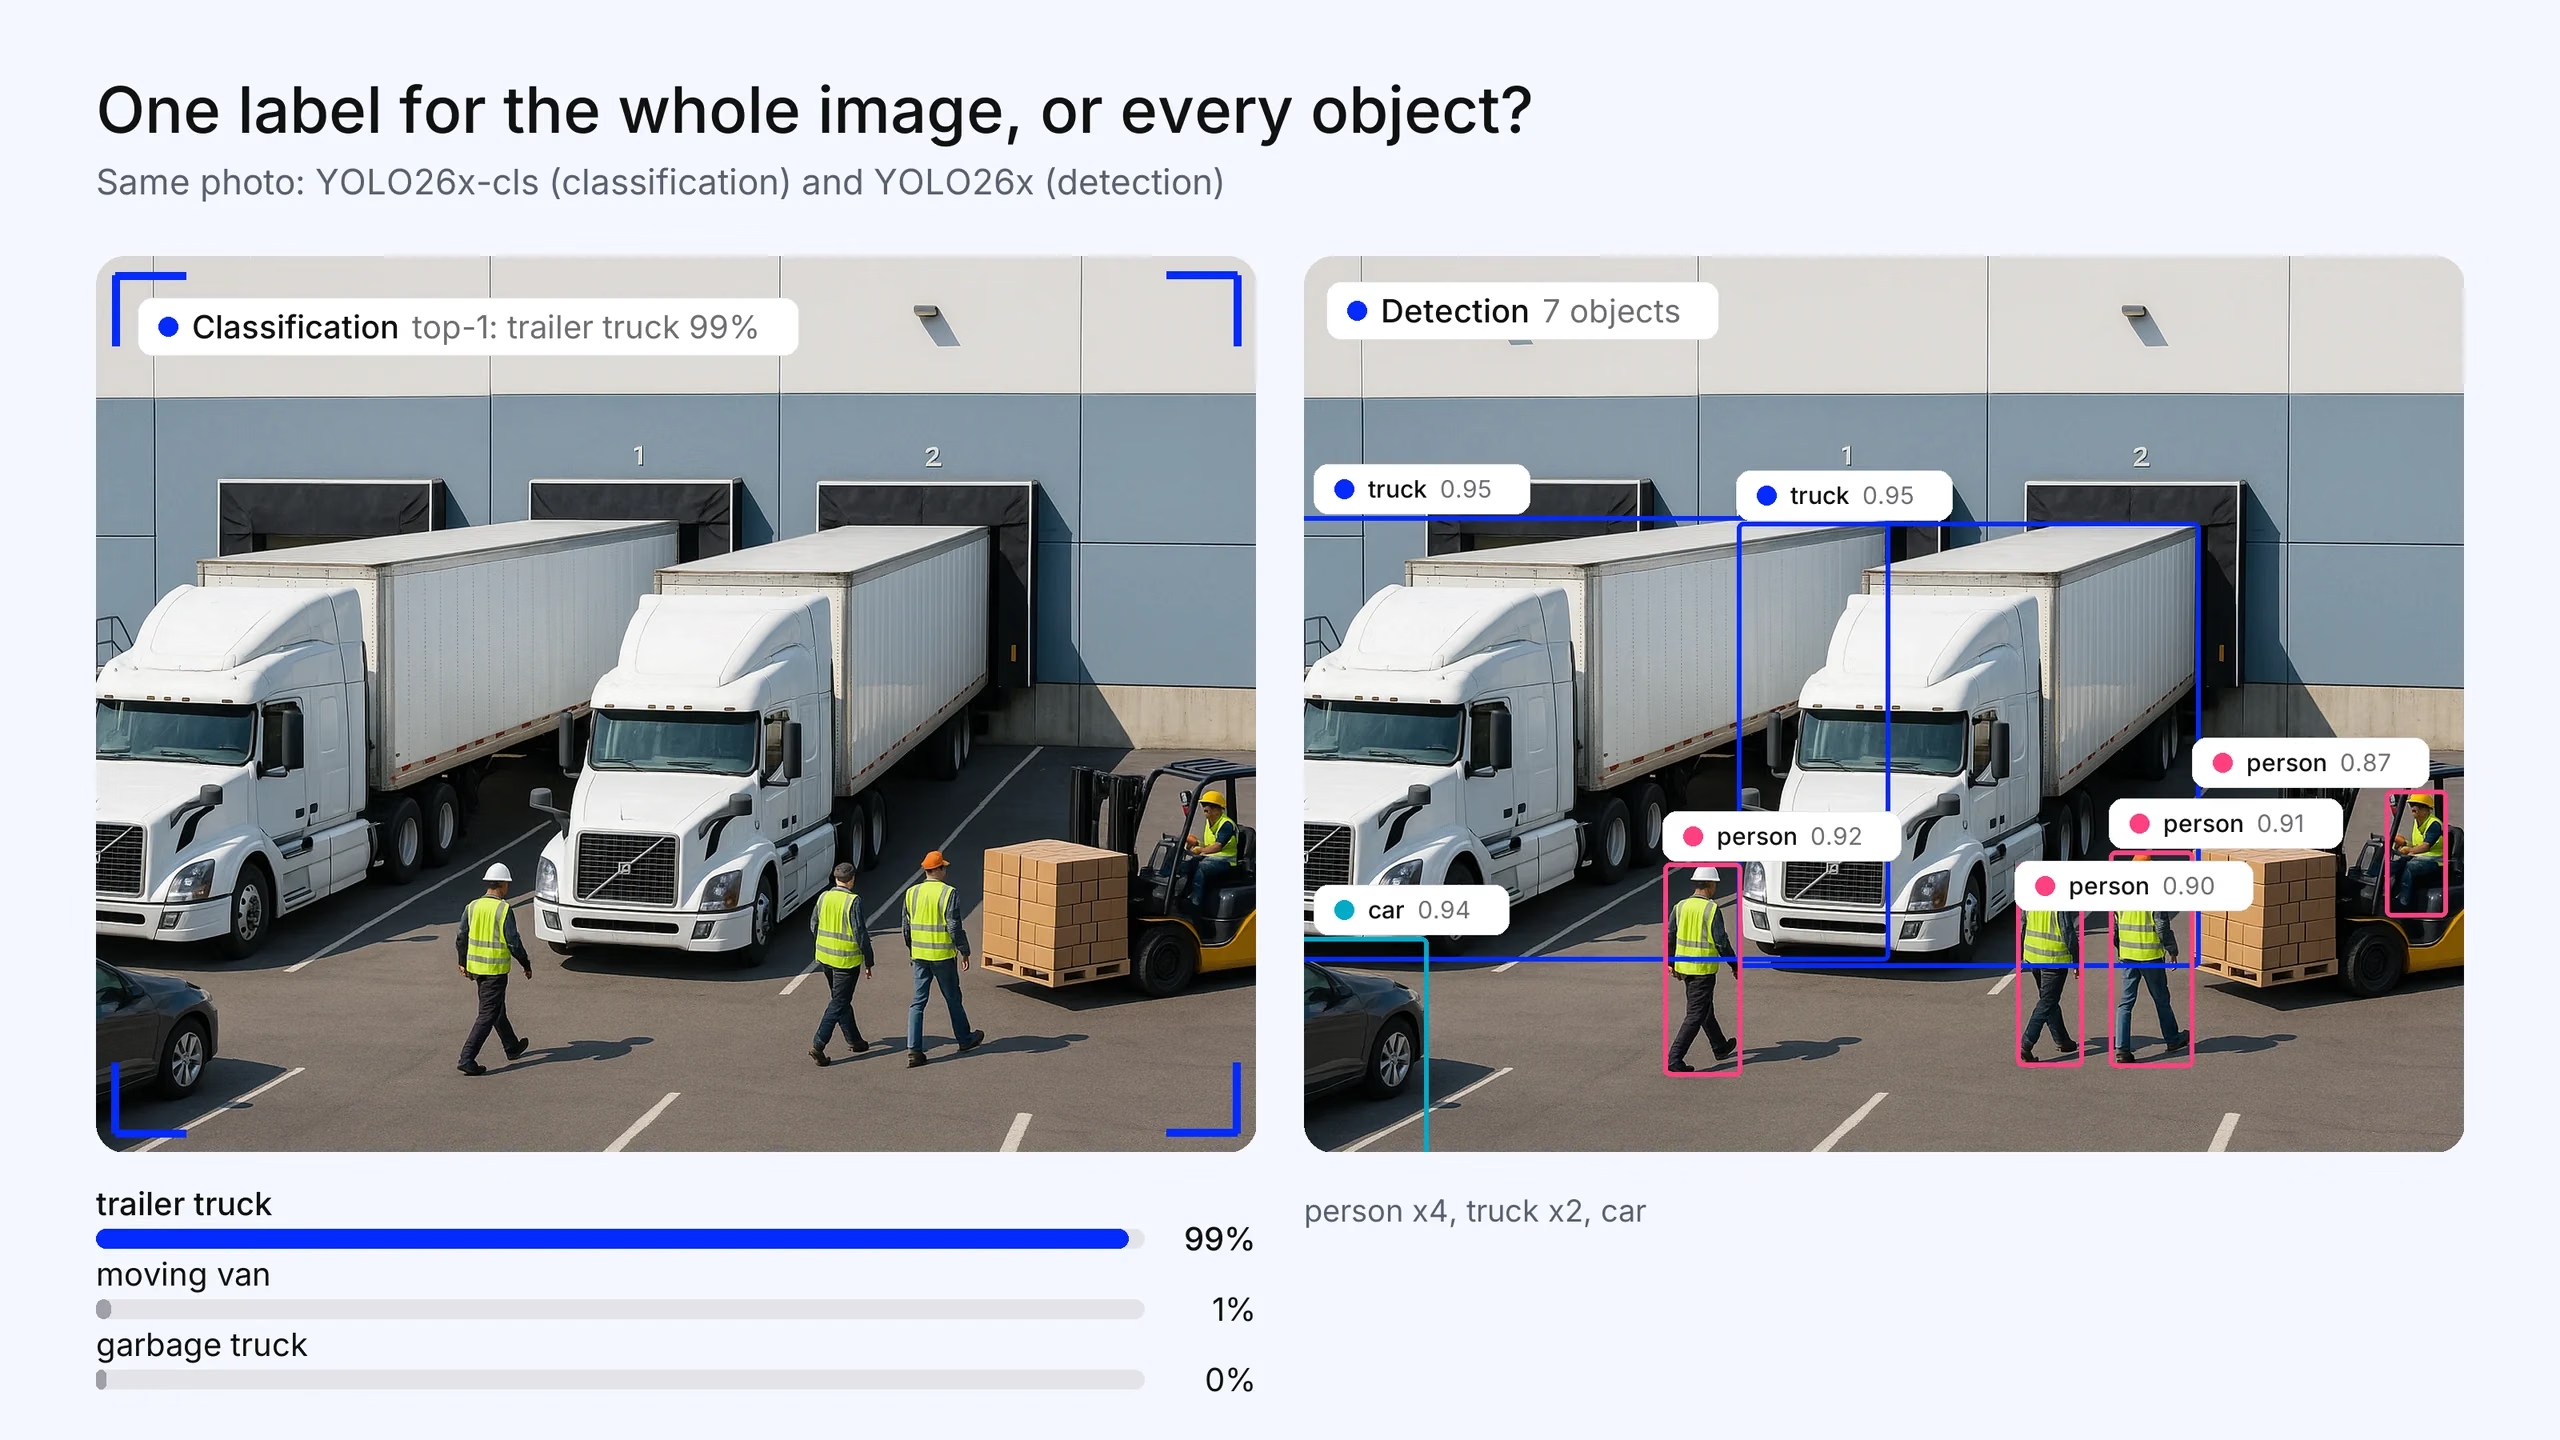
Fig. 3. Numa cena com muitos objetos, um classificador continua a devolver um único rótulo: o Ultralytics YOLO26x-cls classifica este pátio de distribuição como "camião com reboque" com 99% de confiança. O Ultralytics YOLO26 para deteção encontra 7 objetos: 4 pessoas, 2 camiões e um carro, cada um com a sua própria caixa (confiança igual ou superior a 0,5). A foto foi gerada para este artigo; as saídas são reais.
Onde obter modelos pré-treinados e treinar os teus próprios modelos#
- timm (PyTorch Image Models) reúne a maioria dos backbones acima, desde ViT e ConvNeXt a MobileNetV4, EVA e DINOv3, com scripts de treino e avaliação. O código está sob Apache 2.0; as licenças dos pesos variam.
- Hugging Face aloja a maioria dos classificadores Transformer, incluindo SigLIP 2 e DINOv3, com pipelines prontos a usar para tarefas zero-shot e classificação de imagens.
- O pacote Ultralytics para Python treina o YOLO26-cls com uma pasta de imagens organizadas por classe. Consulta o formato de conjunto de dados de classificação e o guia da tarefa de classificação.
- A Ultralytics Platform acrescenta anotação e treino na nuvem para os mesmos modelos. Foi lançada em 2026, por isso é mais recente do que os serviços de treino alojados já estabelecidos. Para disponibilizar modelos após o treino, consulta a nossa comparação de plataformas de inferência de visão computacional.
Perguntas frequentes
Não existe um modelo ideal para todos os casos. Para trabalhos com prioridade na precisão e muitos recursos computacionais, as opções a avaliar primeiro são backbones Transformer de grande dimensão e autossupervisionados, como EVA-02 e DINOv3. Para produção em hardware limitado, as CNNs, como ConvNeXt V2, EfficientNetV2, MobileNetV4 e Ultralytics YOLO26-cls, são mais práticas. Para classificar sem dados rotulados, o SigLIP 2 permite a classificação zero-shot.
Os Transformers tendem a ter melhores resultados quando são pré-treinados em conjuntos de dados muito grandes e a computação não é uma limitação. As CNNs tendem a ter melhores resultados em conjuntos de dados pequenos a médios e em hardware de borda, porque as suas pressuposições incorporadas sobre a estrutura local permitem-lhes aprender com menos dados e ser rápidas. CNNs modernas, como ConvNeXt, reduziram a diferença de precisão, e arquiteturas híbridas, como CoAtNet, combinam as duas abordagens.
Sim. O DINOv3 é um backbone de uso geral. Extrais características com o modelo congelado e treinas um pequeno classificador linear por cima; o repositório da Meta também inclui uma cabeça de classificação ImageNet para o seu maior modelo. Consulta a licença do DINOv3 antes de o usares comercialmente.
Principalmente com a precisão top-1 (a previsão mais bem classificada está correta) e a precisão top-5 (a classe correta está entre as cinco previsões com maior pontuação), normalmente no conjunto de validação ImageNet. Em conjuntos de dados personalizados desequilibrados, a precisão, a revocação ou a pontuação F1 por classe são mais informativas do que a precisão global.









