Como treinar o YOLO com dados do Amazon S3 e implantar uma API hospedada com a Ultralytics Platform
Treine o Ultralytics YOLO26 com imagens no seu bucket do Amazon S3 e implante-o como uma API hospedada com a Ultralytics Platform, passo a passo, em comparação com o SageMaker.
 Miles Deans14 min de leitura
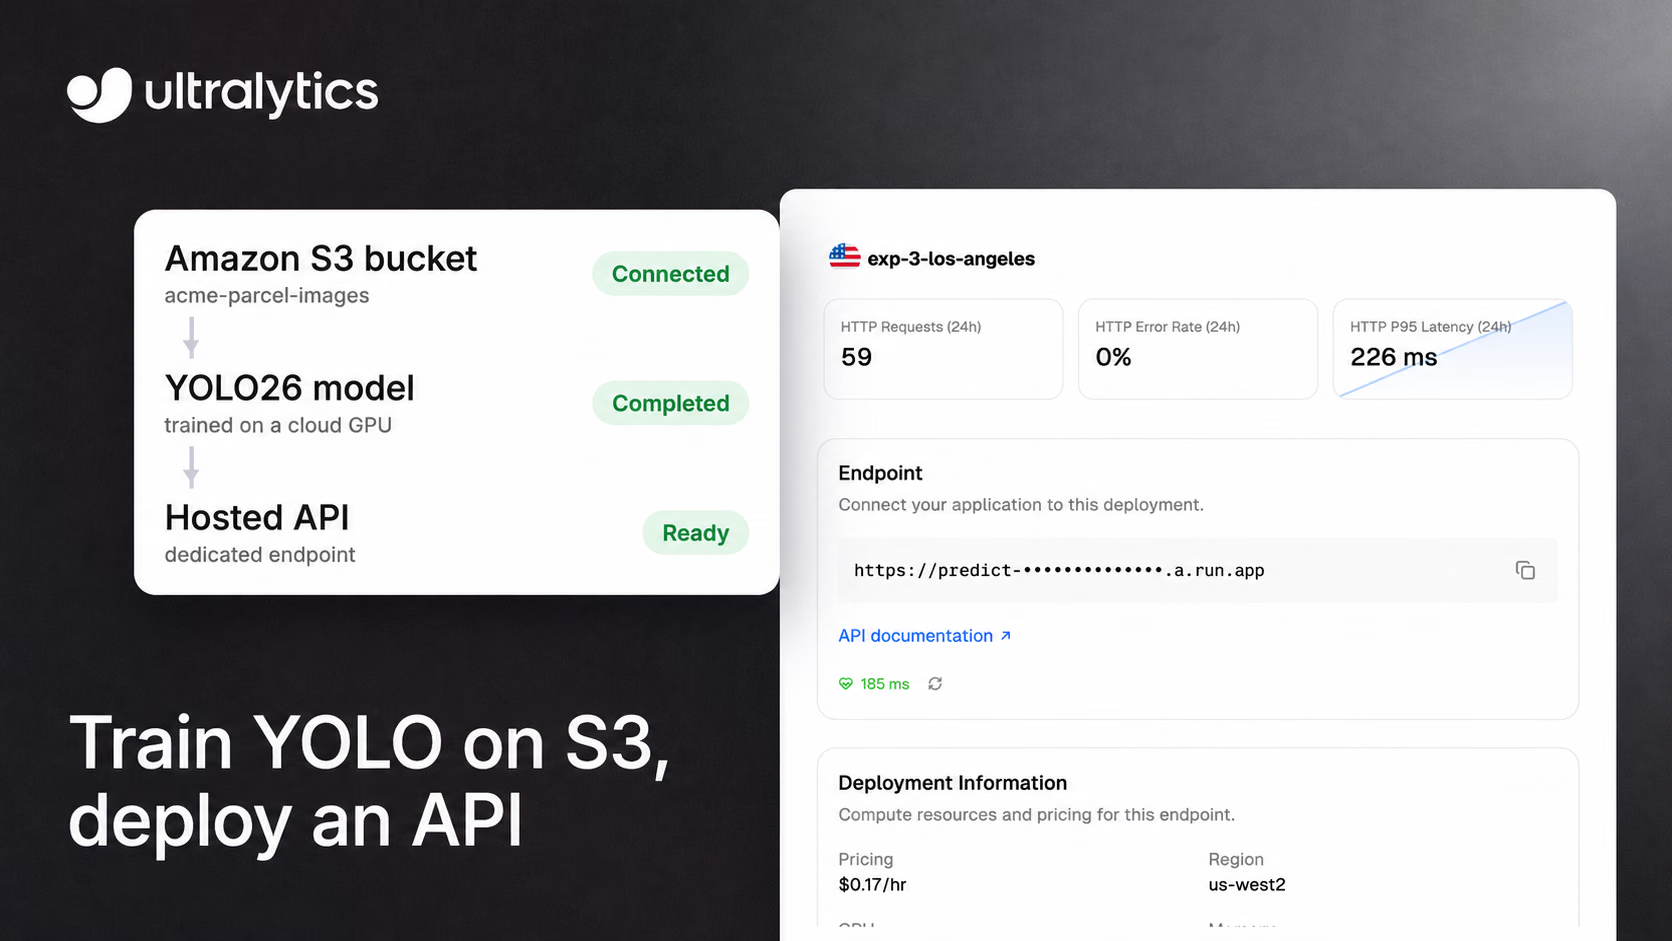
Se suas imagens já estiverem em um bucket do Amazon S3, você poderá treinar um modelo Ultralytics YOLO com elas e implantá-lo como uma API hospedada sem enviar uma segunda cópia do conjunto de dados. A Ultralytics Platform indexa o bucket no local, permite rotular e treinar o YOLO26 em uma GPU na nuvem e implanta o modelo treinado em um endpoint dedicado que você acessa por HTTPS. Este guia apresenta cada etapa, da política do IAM à sua primeira previsão, e compara o fluxo de trabalho com o Amazon SageMaker, o Google Vertex AI e o Azure Machine Learning.
O mesmo fluxo funciona com o Google Cloud Storage e o Azure Blob Storage, usando uma chave JSON de conta de serviço ou uma cadeia de conexão com chave de acesso da conta em vez da chave de acesso da AWS.
Como o fluxo de trabalho se encaixa#
O pipeline tem cinco etapas. As imagens originais permanecem no seu bucket, e o treinamento na nuvem usa cópias temporárias durante a execução:
- Conectar um bucket do S3 com um usuário do IAM somente leitura.
- Indexar uma pasta como conjunto de dados da Platform. A Platform lê as dimensões das imagens e quaisquer rótulos YOLO encontrados, sem armazenar uma segunda cópia das imagens.
- Rotular imagens no navegador ou manter os rótulos YOLO que já estão no bucket.
- Treinar um modelo YOLO26 em uma GPU na nuvem. O treinamento usa cópias temporárias das imagens durante a execução.
- Implantar o modelo em um endpoint dedicado em uma das 42 regiões e enviar imagens para ele usando uma chave de API.
Os conjuntos de dados de detecção, segmentação, pose e caixa delimitadora orientada (OBB) são reconhecidos pelo formato dos rótulos, então as mesmas etapas se aplicam a cada tarefa de visão computacional.
Antes de começar: planos, permissões e limites dos dados#
Você precisa de três coisas:
- Um espaço de trabalho Pro ou Enterprise. Os conjuntos de dados do Amazon S3, Google Cloud Storage e Azure Blob Storage exigem um plano Pro ou Enterprise. O Pro custa US$ 29 por usuário por mês e inclui US$ 30 de crédito mensal por usuário para computação medida, como treinamento na nuvem.
- A função de administrador ou proprietário do espaço de trabalho, necessária para conectar o armazenamento na nuvem.
- Um usuário do AWS IAM que possa listar e ler o bucket.
É útil saber o que sai do bucket antes de conectá-lo. A Platform transmite os originais sob demanda para navegação e anotação, e as imagens indexadas não contam para a cota de armazenamento da Platform. Cada conexão tem uma opção Recursos de IA, ativada por padrão. Enquanto estiver ativada, as GPUs da Ultralytics poderão ler imagens para anotação, busca por imagens semelhantes e treinamento na nuvem. Provedores externos de IA também poderão processar imagens para modelos de anotação pagos usando a chave do provedor do seu espaço de trabalho e para geração de imagens quando o acesso de gravação estiver ativado. O treinamento na nuvem usa cópias temporárias durante a execução; a busca por imagens semelhantes mantém os embeddings até que as imagens saiam da Platform. Desative essa opção para impedir o início de novos trabalhos de IA (os trabalhos já em execução serão concluídos), enquanto a anotação manual e o treinamento local continuam funcionando. A Platform nunca modifica nem exclui seus objetos.
Etapa 1: criar um usuário do IAM somente leitura#
No console da AWS, acesse IAM > Usuários, crie um usuário sem acesso ao console e associe uma política que conceda acesso para listar e ler o bucket:
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
s3:ListAllMyBuckets é opcional. Isso permite que a Platform descubra seus buckets, para que você não precise digitar os nomes.
Em seguida, abra a guia Credenciais de segurança do usuário e crie uma chave de acesso. A Platform precisa de uma chave de usuário do IAM de longa duração: ela rejeita credenciais temporárias do AWS STS, incluindo credenciais de sessão de função e chaves do IAM Identity Center, pois elas expirariam enquanto o conjunto de dados ainda estivesse conectado. Use um usuário dedicado para isso, nunca as credenciais da conta raiz. A Platform criptografa a chave em repouso com AES-256-GCM e nunca a expõe às cargas de trabalho de treinamento; você pode revogar o acesso a qualquer momento desativando a chave no IAM.
Etapa 2: conectar o bucket à Ultralytics Platform#
- Na Platform, acesse Configurações > Integrações e selecione Amazon S3.
- Insira o ID da chave de acesso, a chave de acesso secreta e a região do bucket, por exemplo,
us-east-1. - Clique em Encontrar buckets disponíveis e selecione os buckets para conectar ou digite o nome de um bucket se a política não permitir a descoberta.
- Clique em Conectar. A Platform verifica se consegue listar e ler cada bucket antes de salvar qualquer informação.
Uma conexão lê buckets em uma única região; portanto, crie uma conexão por região se seus dados estiverem distribuídos por várias regiões. O guia de integração do Amazon S3 explica a permissão de gravação opcional usada para gerar imagens.
Etapa 3: criar um conjunto de dados a partir do bucket#
Clique em Novo conjunto de dados, abra a guia Nuvem, escolha o bucket, navegue até a pasta com seus dados e crie o conjunto de dados. A Platform lista a pasta uma vez e indexa o que encontra:
- Imagens: objetos
.jpg,.jpeg,.png,.webpe.avif. - Rótulos: arquivos YOLO
.txt, associados pelo layout padrãoimages/alabels/ou como arquivos ao lado de cada imagem. - Classes: um arquivo
data.yamlfornece os nomes das classes, como em um conjunto de dados YOLO comum. - Divisões: os nomes de pastas
train,valetestatribuem divisões automaticamente.
Uma única importação indexa até 500.000 objetos; portanto, divida buckets maiores entre vários conjuntos de dados. Trate os objetos indexados como imutáveis: cada imagem fica vinculada ao ETag do objeto S3, e a Platform deixa de disponibilizar uma imagem que tenha sido sobrescrita. Para adicionar dados posteriormente, envie novos objetos e crie um novo conjunto de dados, pois o índice é criado uma única vez, quando o conjunto de dados é criado.
Etapa 4: rotular ou verificar as imagens#
Abra o conjunto de dados para revisar os rótulos importados no editor de anotação. Se o bucket ainda não tiver rótulos, você poderá desenhar caixas e máscaras manualmente ou, com os recursos de IA ativados, usar a anotação inteligente (SAM para detecção, segmentação e OBB; YOLO para pose) e a anotação automática para agilizar o trabalho. Os rótulos são armazenados na Platform, e os objetos do seu bucket permanecem inalterados.
Etapa 5: treinar o YOLO26 em uma GPU na nuvem#
Clique em Novo modelo no conjunto de dados ou em um projeto, escolha um modelo base e inicie uma execução na nuvem:
- Modelo base: escolha um modelo oficial da Ultralytics (recomendamos o YOLO26) ou um dos seus próprios modelos para ajustar. Só são listados os modelos compatíveis com a tarefa do conjunto de dados.
- Parâmetros: defina o número de épocas, o tamanho da imagem e o tamanho do lote ou mantenha os valores padrão.
- GPU: escolha uma GPU da Ultralytics Cloud. A janela mostra a tarifa por hora e estima a duração e o custo total da execução antes de você começar. Nosso guia para escolher uma GPU na nuvem ajuda a avaliar as opções.
As métricas, a saída do console e os gráficos do sistema são transmitidos para o navegador enquanto a execução está ativa, e os pontos de verificação são salvos automaticamente. Quando o treinamento termina, a página do modelo mostra as métricas e, quando os resultados de validação estão disponíveis, uma análise detalhada, como uma matriz de confusão.
Etapa 6: implantar o modelo como uma API hospedada#
Abra a guia Implantar do modelo. Um mapa e uma tabela listam 42 regiões, ordenadas pela latência medida a partir da sua localização. Clique em Implantar na região desejada, confira a CPU, a memória e o preço e clique em Criar implantação.
O tamanho escolhido determina como você será cobrado:
- Tamanho padrão (1 vCPU, 2 GiB): gratuito e reduzido a zero quando estiver ocioso.
- Tamanhos personalizados (até 8 vCPU e 32 GiB): mantêm uma instância aquecida e são cobrados pela tarifa regional por hora exibida, desde que estejam prontos até você interromper o endpoint, inclusive durante o tempo ocioso.
Cada endpoint dedicado é um serviço de locatário único, com URL e monitoramento próprios, e está vinculado a uma chave de API do seu espaço de trabalho. Os espaços de trabalho gratuitos podem executar 3 implantações; o Pro, 10; e o Enterprise, um número ilimitado. Para saber quando um endpoint dedicado é uma opção melhor do que a inferência compartilhada, consulte nosso guia sobre inferência dedicada e compartilhada.
Etapa 7: chamar o endpoint#
Instale o Requests com python -m pip install requests e salve uma imagem como image.jpg. Substitua a URL de exemplo pela URL copiada da sua implantação, seguida de /predict, e substitua YOUR_API_KEY pela chave vinculada a essa implantação:
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
A mesma solicitação com cURL:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
Cada endpoint também disponibiliza uma referência interativa da API em /docs e uma verificação /health. As solicitações diretas ignoram o limite de taxa da API da Platform, mas cada endpoint é atendido por uma única instância: solicitações que não possam ser atendidas rapidamente recebem um 429 com um cabeçalho Retry-After, e o corpo das solicitações tem limite de 32 MB. Quando o endpoint estiver ativo, você poderá monitorar as solicitações, os erros e a latência na página da implantação.
Custos, limites e segurança em resumo#
| Item | O que esperar |
|---|---|
| Plano | Pro (US$ 29 por usuário por mês) ou Enterprise para conjuntos de dados do S3, Google Cloud Storage e Azure Blob |
| Armazenamento | As imagens indexadas permanecem no seu bucket e não consomem a cota de armazenamento da Platform |
| Treinamento | Cobrado pelo tempo de uso da GPU com créditos; a janela estima o custo antes de você começar |
| Endpoint | Tamanho padrão gratuito com redução a zero; tamanhos personalizados cobrados por hora enquanto estiverem em execução |
| Tamanho da importação | Até 500.000 objetos por importação |
| Credenciais | Chave de usuário do IAM de longa duração, criptografada em repouso e nunca exposta às cargas de trabalho de treinamento |
| Indisponível em conjuntos de dados do S3 | Clonagem de conjuntos de dados, instantâneos de versões, desfoque de rostos, colagem de imagens de outros conjuntos de dados |
Ultralytics Platform em comparação com SageMaker, Vertex AI e Azure ML#
As plataformas de ML de uso geral na nuvem também podem treinar com dados armazenados em seus próprios serviços de armazenamento e disponibilizar o modelo. As colunas de armazenamento e disponibilização abaixo se baseiam na documentação de cada plataforma; a última coluna apresenta nossa avaliação.
| Plataforma | Onde ficam os dados de treinamento | Opções de disponibilização | Uso recomendado (nossa avaliação) |
|---|---|---|---|
| Ultralytics Platform com Ultralytics YOLO | Indexação no local a partir do S3, Google Cloud Storage ou Azure Blob | Endpoints dedicados de instância única em 42 regiões; redução a zero no tamanho padrão | Equipes que querem usar YOLO para detecção, segmentação, pose ou OBB — do bucket à API — sem escrever código de treinamento ou disponibilização |
| Amazon SageMaker AI | Os trabalhos de treinamento leem dados do Amazon S3, Amazon EFS ou Amazon FSx for Lustre | Endpoints em tempo real com escalabilidade automática, sem servidor e inferência assíncrona | Equipes que já executam pipelines de ML na AWS e querem escolher seus próprios contêineres e opções de disponibilização |
| Google Vertex AI | Os trabalhos de treinamento sem servidor montam buckets acessíveis do Cloud Storage em /gcs/ | Endpoints gerenciados para inferência online | Equipes que padronizaram o uso de dados e ferramentas do Google Cloud |
| Azure Machine Learning | Os armazenamentos de dados fazem referência a serviços de armazenamento existentes do Azure, como o Blob Storage | Endpoints online gerenciados para inferência em tempo real | Equipes que padronizaram o uso do Azure |
A documentação de dados de treinamento do SageMaker lista S3, EFS e FSx for Lustre como fontes com modos de entrada por streaming e download. A inferência sem servidor gerencia a escalabilidade para você e é adequada para tráfego com períodos ociosos que tolera inicializações a frio; você pode usar um contêiner fornecido pelo SageMaker ou trazer o seu próprio. O Vertex AI executa treinamento personalizado a partir de um aplicativo Python em um contêiner pré-criado ou em um contêiner personalizado, e o Azure Machine Learning conecta-se ao armazenamento Azure existente por meio de armazenamentos de dados e disponibiliza modelos em endpoints online gerenciados. Essa abrangência é o ponto forte de uma plataforma de uso geral. Na nossa avaliação, um fluxo de trabalho YOLO personalizado exige mais configuração; os requisitos dos contêineres dependem das opções de treinamento e disponibilização selecionadas. Se quiser continuar na AWS, nosso guia de implantação no SageMaker mostra como disponibilizar um modelo YOLO lá.
A Ultralytics Platform foi projetada para um escopo mais específico. Ela é desenvolvida em torno dos modelos Ultralytics YOLO, então as etapas acima substituem o script de treinamento e o contêiner de disponibilização. Ela é menos adequada se sua organização exigir credenciais STS temporárias para cada integração ou se um endpoint precisar se escalar para muitas instâncias sob alta carga simultânea. Se ainda estiver decidindo onde executar a inferência, nosso guia sobre nuvem e hospedagem própria compara custo, latência e controle dos dados.
Perguntas frequentes
A Ultralytics Platform conecta um bucket do S3, indexa as imagens no local, treina o YOLO26 em uma GPU na nuvem e implanta o modelo em um endpoint HTTPS dedicado. O Amazon SageMaker AI também treina com dados do S3 e oferece inferência em tempo real, sem servidor e assíncrona, com contêineres fornecidos pelo SageMaker ou personalizados, dependendo da opção de disponibilização. O Google Vertex AI e o Azure Machine Learning oferecem fluxos de trabalho semelhantes, baseados no próprio armazenamento, no Cloud Storage e no armazenamento Azure, em vez de um bucket do S3 existente.
A Platform não mantém uma segunda cópia do seu conjunto de dados: ela indexa as imagens e transmite os originais sob demanda. Com os recursos de IA ativados, o treinamento na nuvem usa cópias temporárias fora do seu bucket durante a execução, e a busca por imagens semelhantes mantém um embedding de cada imagem. A Platform nunca modifica nem exclui seus objetos.
Não no momento. A Platform exige uma chave de acesso de longa duração de um usuário dedicado do IAM e rejeita credenciais STS, pois elas expiram enquanto o conjunto de dados está conectado. Limite o usuário às permissões de leitura e listagem e desative a chave no IAM para revogar o acesso.
Os conjuntos de dados do S3 exigem um plano Pro (US$ 29 por usuário por mês, com US$ 30 de crédito mensal por usuário) ou Enterprise. O treinamento é cobrado pelo tempo de uso da GPU, e a janela de treinamento estima o custo antes de você começar. O tamanho padrão do endpoint é gratuito e reduz a zero; os tamanhos personalizados são cobrados por hora enquanto estiverem em execução.
Sim. O Google Cloud Storage conecta-se usando uma chave JSON de conta de serviço e a função Storage Object Viewer, e o Azure Blob Storage conecta-se usando uma cadeia de conexão HTTPS com chave de acesso à conta (cadeias com tokens SAS não são aceitas). As etapas de conjunto de dados, treinamento e implantação são as mesmas.
Um conjunto de dados é indexado uma única vez, quando é criado, por isso os novos objetos não são detectados automaticamente. Adiciona novos objetos em vez de substituir os existentes, cria um novo conjunto de dados que os inclua e treina ou ajusta o modelo novamente.
Sim. Transfere os pesos ou exporta o modelo para formatos como ONNX, TensorRT e CoreML na página do modelo e, em seguida, executa-o nos teus próprios servidores ou dispositivos de borda com o pacote Python da Ultralytics.
Escrito por
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









