OCR em Python com Ultralytics YOLO26: lê documentos, fotografias e PDFs em qualquer ângulo
Lê texto em imagens e páginas de PDF em qualquer rotação com Ultralytics YOLO26-Text e PP-OCRv6 em poucas linhas de Python, na CPU ou GPU, com TensorRT opcional.
 Jing Qiu15 min de leitura
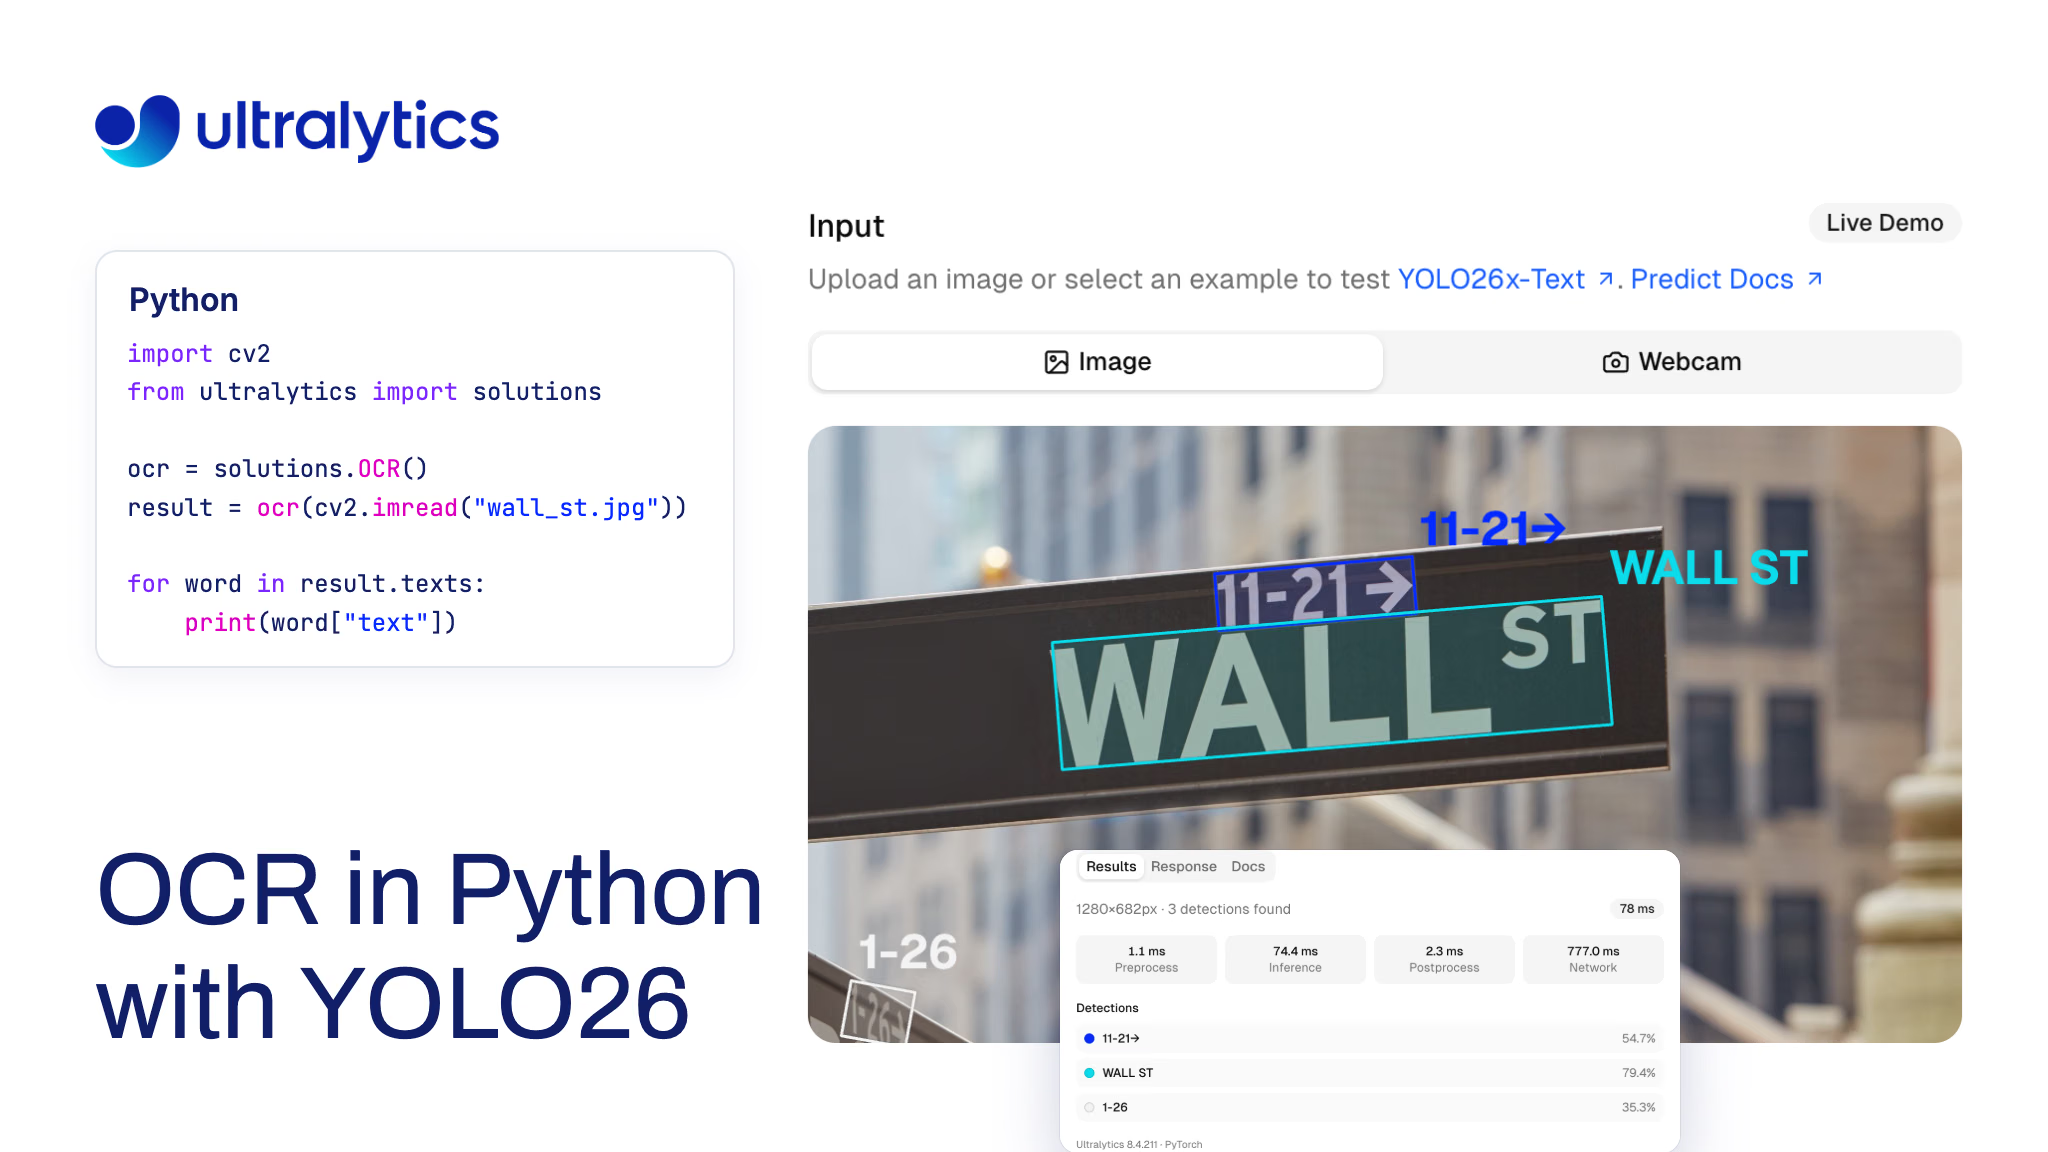
Como executar OCR em Python numa digitalização de lado, numa fotografia de uma placa tirada com o telemóvel ou numa página de um PDF, e obter as palavras pela ordem em que uma pessoa as leria? Com o pacote Ultralytics, basta uma classe: solutions.OCR() deteta texto com um modelo YOLO26-Text da Ultralytics, lê cada palavra com o reconhecedor PP-OCRv6 do PaddleOCR e devolve as palavras reconhecidas, linha por linha, em qualquer rotação da página, na CPU ou GPU.
Este pipeline é novo. A Ultralytics 8.4.210 reconstruiu a solução de OCR em torno do PP-OCRv6 no ONNX Runtime, com tratamento de rotação e ordem de leitura, e a 8.4.211 adicionou um reconhecedor TensorRT opcional. No nosso benchmark, com tamanho de imagem 1280, a configuração predefinida obteve F1 de palavras de 0.931 em seis páginas de PDF e 0.722 em 80 fotografias do HierText. Numa RTX PRO 6000, um mecanismo TensorRT FP16 em cache leu as 251 palavras detetadas numa fotografia em 82 ms, contra 249 ms com ONNX Runtime na CUDA.
Este guia explica como funciona o pipeline, como o executar em imagens e PDFs, a que velocidade funciona e que idiomas lê atualmente. A Ultralytics disponibiliza uma das opções de OCR comparadas abaixo, por isso a comparação limita-se às capacidades documentadas de cada projeto.
O OCR do YOLO26 lê uma página em duas etapas e, em seguida, ordena as palavras#
O reconhecimento ótico de caracteres (OCR) tem duas funções: encontrar o texto e, depois, lê-lo. A solução de OCR da Ultralytics separa-as claramente:
- Deteção: um modelo YOLO26-Text, um detetor de caixas delimitadoras orientadas, desenha caixas rodadas à volta do texto. Está disponível nos tamanhos n, s, m, l e x, sendo o modelo x a opção predefinida.
- Reconhecimento: o PP-OCRv6 medium lê cada recorte. É executado no ONNX Runtime a partir da versão de recursos da Ultralytics, por isso não precisas de instalar o PaddlePaddle. Os recortes sem texto reconhecível são descartados.
- Ordenação: as palavras são agrupadas em linhas e devolvidas de cima para baixo e da esquerda para a direita, cada uma identificada com o número da linha.
Cada palavra é devolvida como um registo com o texto, a confiança do reconhecimento, a confiança do detetor, o número da linha e um polígono nas coordenadas da imagem original. Como as duas confianças são mantidas separadas, podes enviar para revisão humana uma palavra que foi detetada com confiança, mas lida com incerteza, em vez de confiares nela.
As duas etapas são independentes. Podes substituir o detetor por um modelo mais pequeno, um modelo de deteção ou segmentação teu, ou outro reconhecedor, e o tratamento de rotação e a ordem de leitura continuam a funcionar. Podes experimentar o mesmo fluxo de código no navegador, na nossa página de processamento de documentos, antes de instalar qualquer coisa.
Páginas rodadas e invertidas são lidas pela ordem correta#
A solução determina a rotação da página a partir do texto que deteta, por isso não precisas de corrigir a inclinação nem de rodar as páginas previamente:
- Determina a direção do texto. Calcula a média do ângulo do lado maior das caixas detetadas, ponderada pelo alongamento de cada uma. As caixas com alongamento inferior a 2:1, como as de um único algarismo, não são consideradas.
- Roda a página. Roda a página para que o texto siga da esquerda para a direita, recorta cada palavra na vertical e agrupa as palavras em linhas.
- Determina se é 0° ou 180°. Uma caixa não permite saber se o texto está virado para cima, por isso a solução lê as 8 palavras mais largas nos dois sentidos e mantém a rotação que obtém maior confiança. O texto invertido é lido como ruído de baixa confiança, o que faz com que a resposta correta se destaque.
Quando rodámos 8 documentos e capturas de ecrã, além de 12 fotografias, para 90°, 180° e 270°, o F1 de palavras foi de 0.925 nos documentos e 0.654 nas fotografias. Num formulário IRS 8802 em branco, a solução leu 404, 401 e 399 palavras a 0°, 180° e 90°, com linhas iniciais idênticas. A versão anterior partia do princípio de que todas as páginas estavam na vertical.
Os valores predefinidos resultam de um benchmark, não de um palpite#
Definimos os principais valores predefinidos com base em medições. O benchmark foi executado numa RTX PRO 6000 com a imagem de produção da Platform e carregamentos em JPEG com, no máximo, 1280 píxeis no lado maior. Utilizou 80 fotografias de validação do conjunto de dados HierText da Google, com as transcrições de palavras legíveis, 6 páginas de PDF avaliadas em relação às respetivas camadas de texto (4 de um artigo do arXiv, mais formulários IRS 1040 e 8802 em branco), uma captura de ecrã sintética e uma imagem sintética. A métrica é a pontuação F1 ao nível das palavras, o equilíbrio entre precisão e revocação, contando palavras em minúsculas com pelo menos 2 caracteres alfanuméricos.
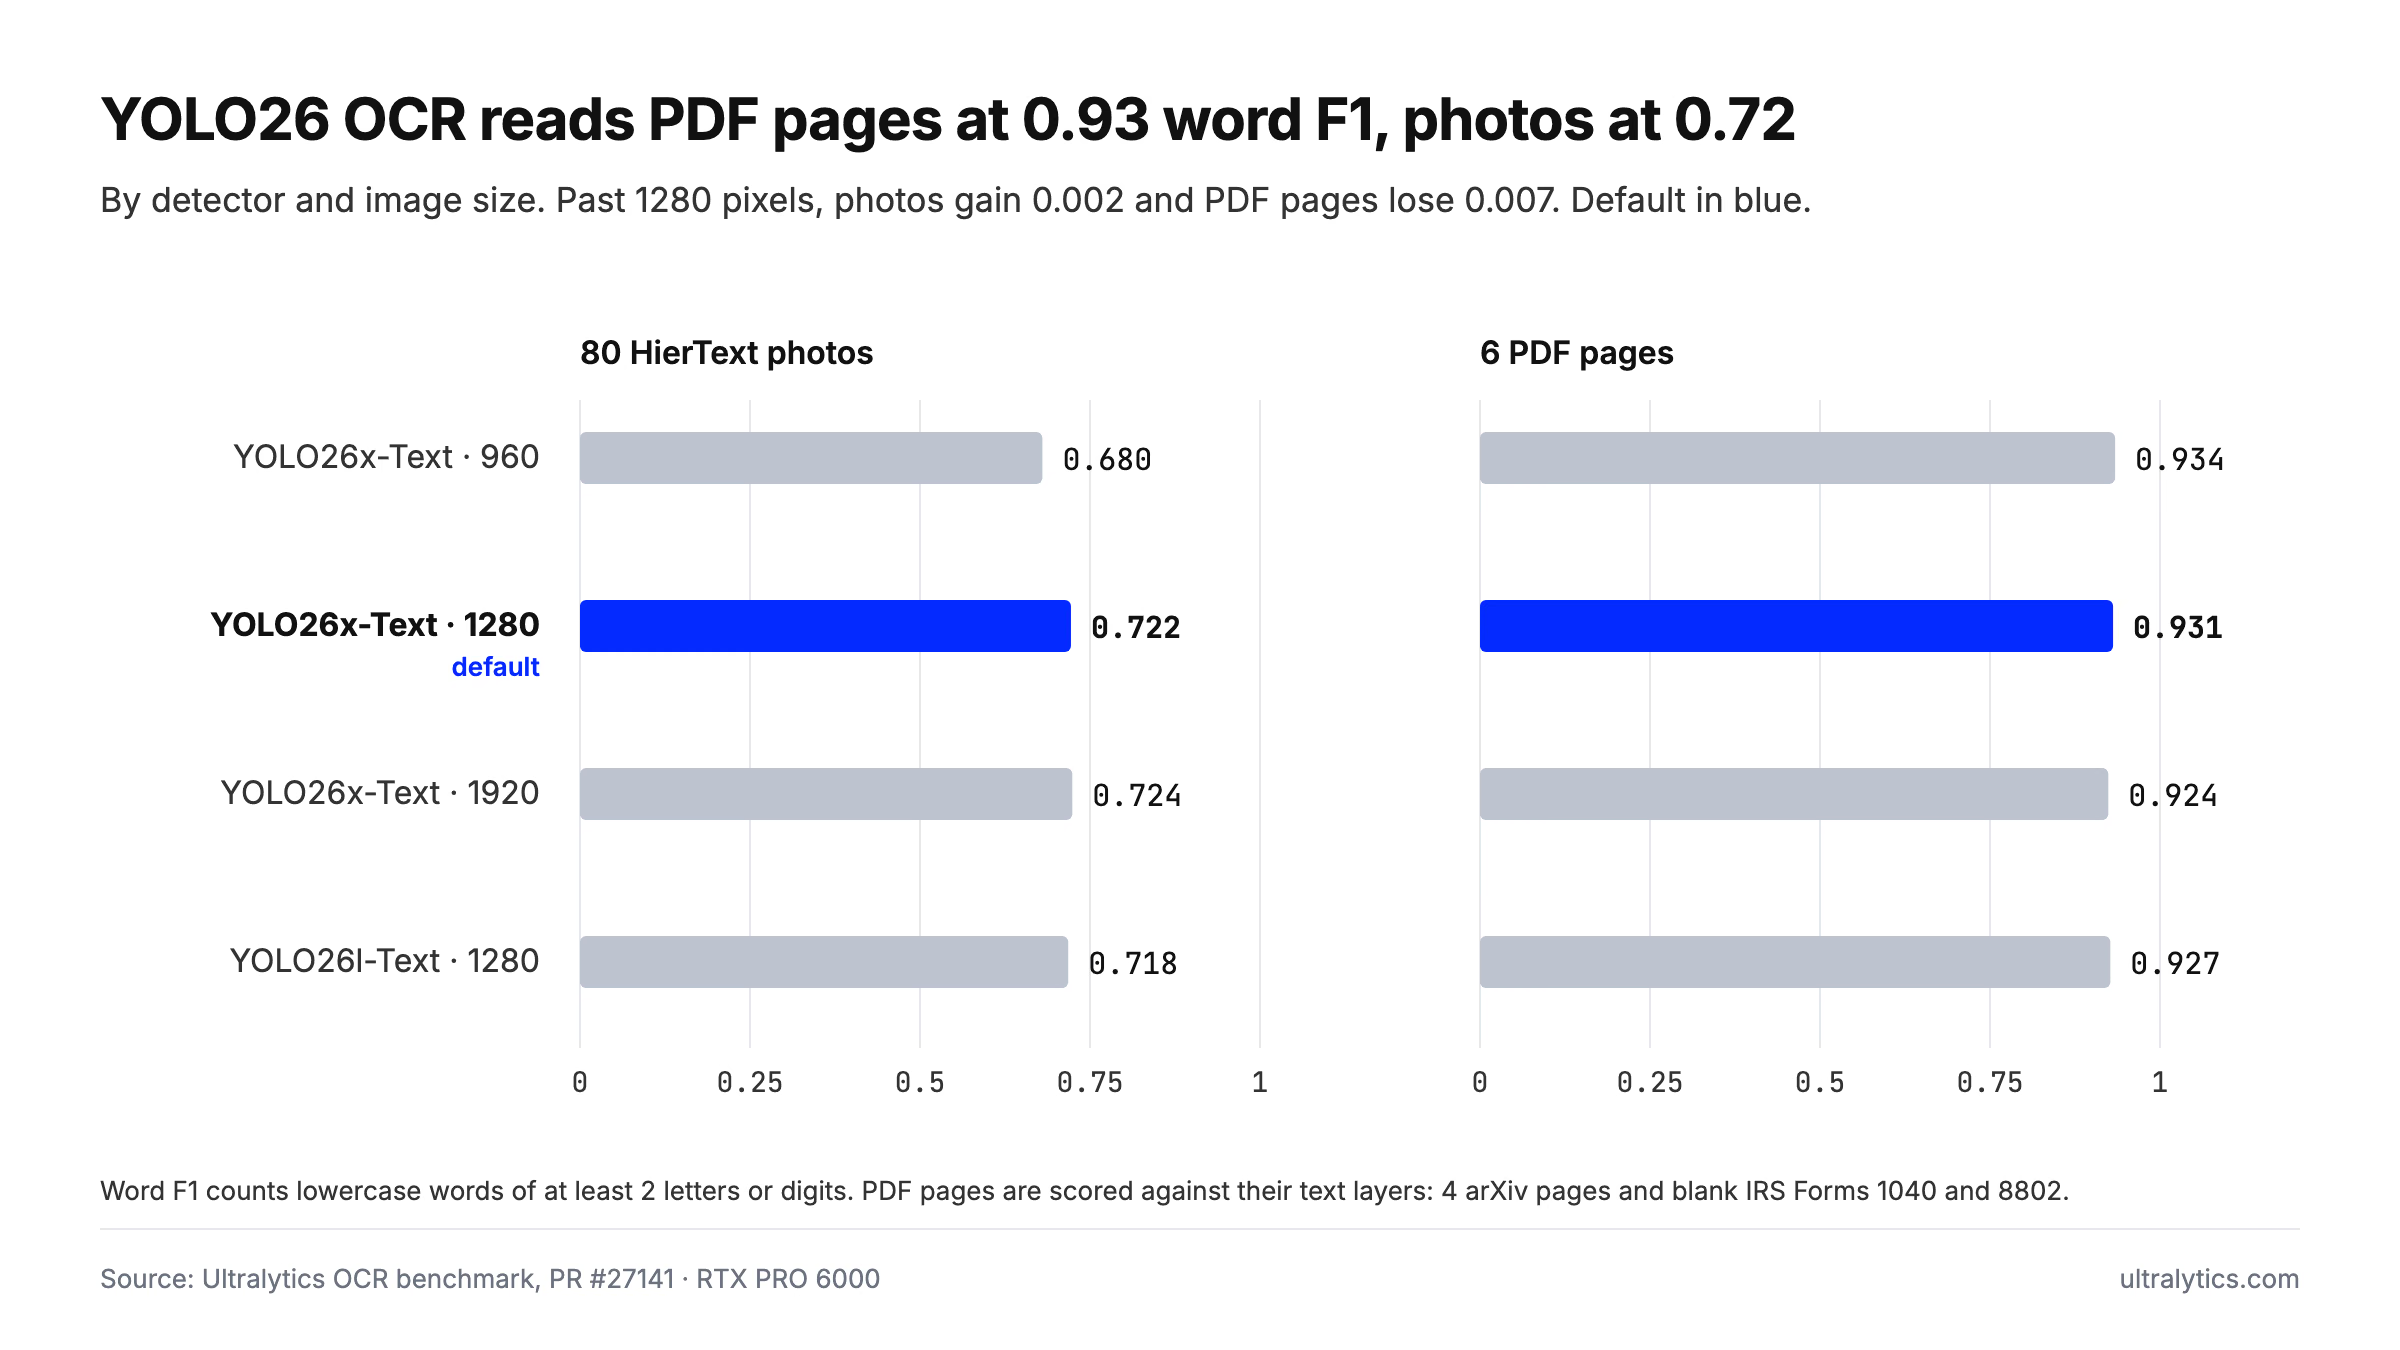
F1 de palavras do YOLO26-Text com PP-OCRv6 em 80 fotografias do HierText e 6 páginas de PDF, por detetor e tamanho de imagem, numa RTX PRO 6000.
As páginas de PDF nítidas são lidas muito melhor do que as fotografias com texto em cena em todas as configurações, e os números indicam três valores predefinidos:
yolo26x-textaimgsz=1280. Reduzir para 960 custou 0.042 de F1 nas fotografias, enquanto 1920 acrescentou 0.002 nas fotografias e perdeu 0.007 nas páginas de PDF. As imagens mais pequenas não são ampliadas para 1280; são processadas no tamanho original, arredondado para cima até ao passo de 32 píxeis do modelo.- Lê palavra por palavra. Ler palavras isoladas superou a leitura de linhas completas em 4 pontos F1 nas fotografias.
max_det=1000. Uma página de documento densa contém mais do que as 300 deteções habituais.
Se precisares de um detetor mais leve, o YOLO26l-Text ficou a menos de meio ponto do modelo x nos dois conjuntos.
Como executar OCR em Python com YOLO26#
Instala ou atualiza com pip install -U "ultralytics>=8.4.211". A primeira chamada de OCR transfere YOLO26x-Text e PP-OCRv6 e instala o ONNX Runtime, utilizando onnxruntime-gpu quando a CUDA está disponível. O reconhecedor predefinido do ONNX Runtime requer Python 3.11+ e ONNX Runtime 1.26+.
Lê uma imagem#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text com imgsz=1280 e PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # imagem anotada

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
A partir da linha de comandos, yolo solutions ocr source="path/to/video.mp4" faz o mesmo em cada fotograma. Cada fotograma é lido de forma independente, sem rastreamento.
Lê um PDF#
A solução recebe imagens, por isso renderiza primeiro cada página do PDF. O PyMuPDF é uma forma de o fazer:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # já está pela ordem de leitura
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Como result.texts já está ordenado, reconstruir texto simples resume-se a criar um dicionário e juntar os elementos. Os polígonos permitem ir mais longe, por exemplo, verificar se um valor está junto à palavra "Total".
Escolhe o modelo, o dispositivo e o reconhecedor#
- Detetor mais pequeno:
solutions.OCR(model="yolo26s-text.pt")carrega um detetor mais pequeno e rápido; verifica a sua precisão nas tuas próprias páginas. Os cinco tamanhos são transferidos automaticamente. - CPU ou GPU: o reconhecedor é executado na CUDA quando é selecionada uma GPU CUDA e o fornecedor de execução CUDA do ONNX Runtime está disponível; caso contrário, é executado na CPU. Assim, o mesmo script funciona num portátil ou num servidor.
- O teu próprio reconhecedor: passa uma função como
recognizer. Esta recebe cada recorte de palavra BGR e devolve(text, confidence), enquanto a solução continua a fazer a deteção, a rotação e a ordenação à sua volta.
def recognize(crop):
    # Executa qualquer modelo de reconhecimento no recorte de palavra BGR
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
O TensorRT lê palavras 2,5 a 3 vezes mais depressa em fotografias densas#
Nos nossos testes de GPU com páginas densas, o reconhecimento, e não a deteção, consumiu a maior parte do tempo. Uma otimização anterior mediu a deteção em cerca de 11 ms de um pedido de 250 ms, e o pedido de alteração do TensorRT identificou grande parte do tempo restante de reconhecimento em 33 pequenos lotes, dominados pela sobrecarga de lançamento em vez do cálculo. A Ultralytics 8.4.211 adiciona um argumento para isto:
ocr = solutions.OCR(recognizer="tensorrt") # Mecanismo TensorRT FP16 em GPUs NVIDIAA primeira execução cria um mecanismo FP16 TensorRT em cerca de 30 segundos e guarda-o em cache junto ao modelo PP-OCRv6, uma vez por versão do TensorRT e arquitetura da GPU. Os carregamentos seguintes demoram 0,05 a 0,2 segundos. A versão indica que é cerca de 2,5 vezes mais rápido do que o ONNX Runtime em páginas densas.
Medimos read_words, a etapa após a deteção que recorta, roda, reconhece e ordena as palavras, em quatro fotografias com texto em cena. Nas três fotografias com 195 a 263 palavras, o mecanismo FP16 foi 2,5 a 3 vezes mais rápido do que o ONNX Runtime na CUDA; numa fotografia com 48 palavras, foi 1,4 vezes mais rápido:
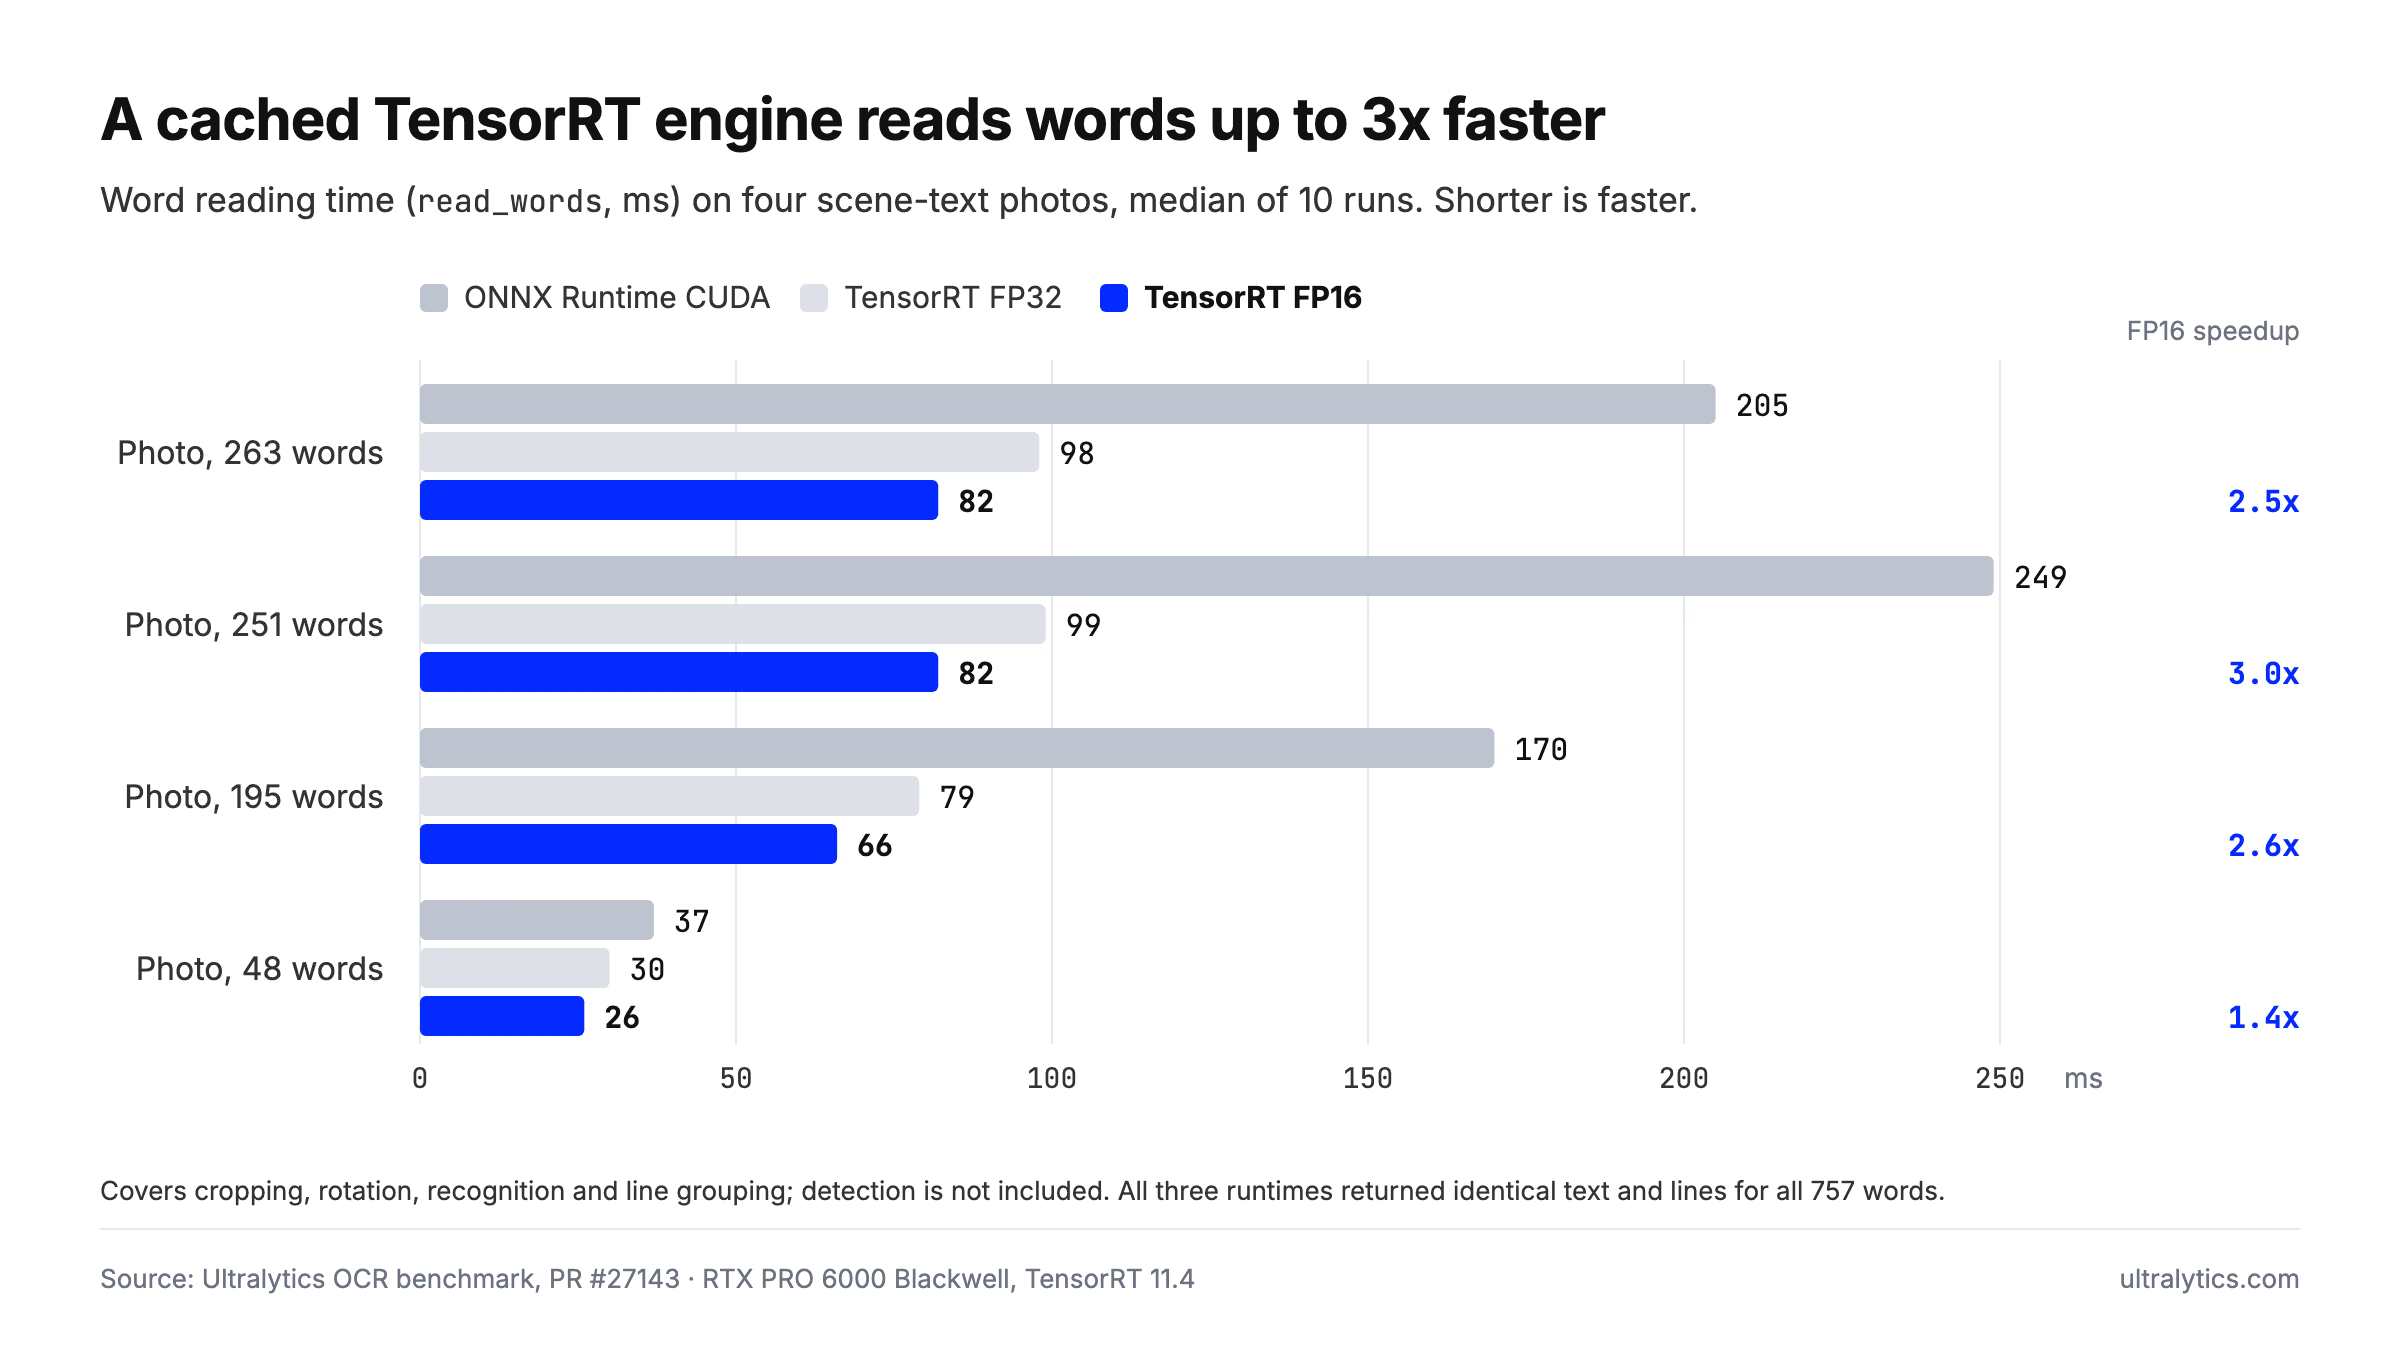
Tempo de leitura de palavras em quatro fotografias com texto em cena, usando ONNX Runtime CUDA e mecanismos TensorRT FP32 e FP16; mediana de 10 execuções numa RTX PRO 6000 Blackwell com TensorRT 11.4.
Uma chamada completa de OCR numa página densa passou de 182 ms para 94 ms. Nestas quatro fotografias, o aumento de velocidade não alterou o resultado: para as 757 palavras, o ONNX Runtime e ambos os mecanismos devolveram texto e agrupamento de linhas idênticos.
Mantém o valor predefinido recognizer="paddleocr" quando não puderes esperar pela primeira compilação ou não estiveres a usar hardware NVIDIA. Não compila nada e inicia em cerca de um segundo. A nossa comparação entre ONNX e TensorRT aborda o mesmo compromisso para modelos de deteção, e o guia de integração do TensorRT explica a configuração.
Atualmente, são suportadas as escritas chinesa, japonesa e latina#
O PP-OCRv6 só consegue produzir caracteres do seu conjunto incorporado de 18,708 caracteres. O detetor YOLO26-Text não depende desse conjunto e continua a encontrar palavras noutras escritas, mas as palavras fora do conjunto são devolvidas como caracteres semelhantes. Por exemplo, o texto russo ТЕКСТ é lido como "TEKCT", muitas vezes com elevada confiança.
- Suportados: chinês simplificado e tradicional (cerca de 15 600 caracteres CJK), japonês (hiragana, katakana e kanji) e idiomas com escrita latina, incluindo inglês, francês, alemão, espanhol, português, italiano, neerlandês, sueco, finlandês, dinamarquês, norueguês, polaco, checo, húngaro, romeno, turco, croata, indonésio e malaio. Todas as letras e letras acentuadas estão abrangidas, exceto o ẞ maiúsculo alemão e o ¡ espanhol.
- Parcialmente suportados: vietnamita, em que faltam a maioria das vogais com tons, e grego, em que só estão abrangidas as letras básicas.
- Ainda não suportados: cirílico, coreano (hangul), árabe, hebraico, devanágari e tailandês.
Para uma escrita não suportada, mantém o detetor YOLO26-Text e passa um reconhecedor treinado para essa escrita como recognizer. A tabela completa de cobertura está na secção de idiomas suportados do guia de OCR.
Comparação de bibliotecas de OCR em Python pelas capacidades documentadas#
Não existe um único melhor modelo de OCR; o modelo adequado depende das tuas páginas, dos teus idiomas e do ambiente em que o código é executado. A tabela compara as capacidades documentadas, não resultados medidos, com base nas páginas públicas de cada projeto, conforme consultadas em 12 de novembro de 2026. As opções estão listadas por ordem alfabética.
| Opção | Ambiente de execução | Texto rodado | Idiomas, conforme documentados | Saída |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info experimenta 90°, 180° e 270° em cada caixa de texto | Mais de 80, incluindo cirílico, árabe, devanágari, coreano e tailandês | Caixas, texto e confiança |
| PaddleOCR | PaddlePaddle | Classificação de orientação opcional | Mais de 100 (o PP-OCRv6 abrange 50 num único modelo) | Caixas, texto e confiança |
| Tesseract (pytesseract) | Binário nativo, CPU | Deteção de orientação e escrita (image_to_osd); roda a imagem antes de a ler | 100+ | Texto, com dados de palavras opcionais |
| OCR do Ultralytics YOLO26 | Detetor PyTorch; reconhecedor no ONNX Runtime ou TensorRT em GPUs NVIDIA | Rotação da página estimada a partir do texto detetado; a solução determina automaticamente se é 0° ou 180° | Escritas chinesa, japonesa e latina; outras através de um reconhecedor personalizado | Palavras pela ordem de leitura, com números de linha, polígonos e confiança de deteção e reconhecimento separadas |
Consulta a documentação do EasyOCR, o repositório do PaddleOCR, a documentação do Tesseract e o pytesseract para verificar as opções atuais. Para saber como estes motores funcionam, consulta a nossa visão geral dos modelos de OCR populares de código aberto.
Onde a Ultralytics se encaixa#
O OCR do Ultralytics YOLO26 foi criado para programadores Python que precisam de extrair texto de entradas variadas, como formulários digitalizados, páginas de PDF, capturas de ecrã e fotografias de etiquetas e placas, com palavras pela ordem de leitura e coordenadas que podem verificar. É uma boa opção quando as páginas chegam em ângulos imprevisíveis, quando queres executar OCR nas tuas próprias máquinas ou quando já executas modelos Ultralytics YOLO26 e queres OCR no mesmo pacote. Adiciona recognizer="tensorrt" para grandes volumes em GPUs NVIDIA.
O detetor é um modelo normal da Ultralytics, por isso podes treiná-lo, validá-lo e exportá-lo como qualquer outro. O projeto YOLO26-Text na Ultralytics Platform contém os cinco tamanhos, de n a x, onde podes comparar as curvas de treino e clonar o projeto para começar a partir desses modelos.
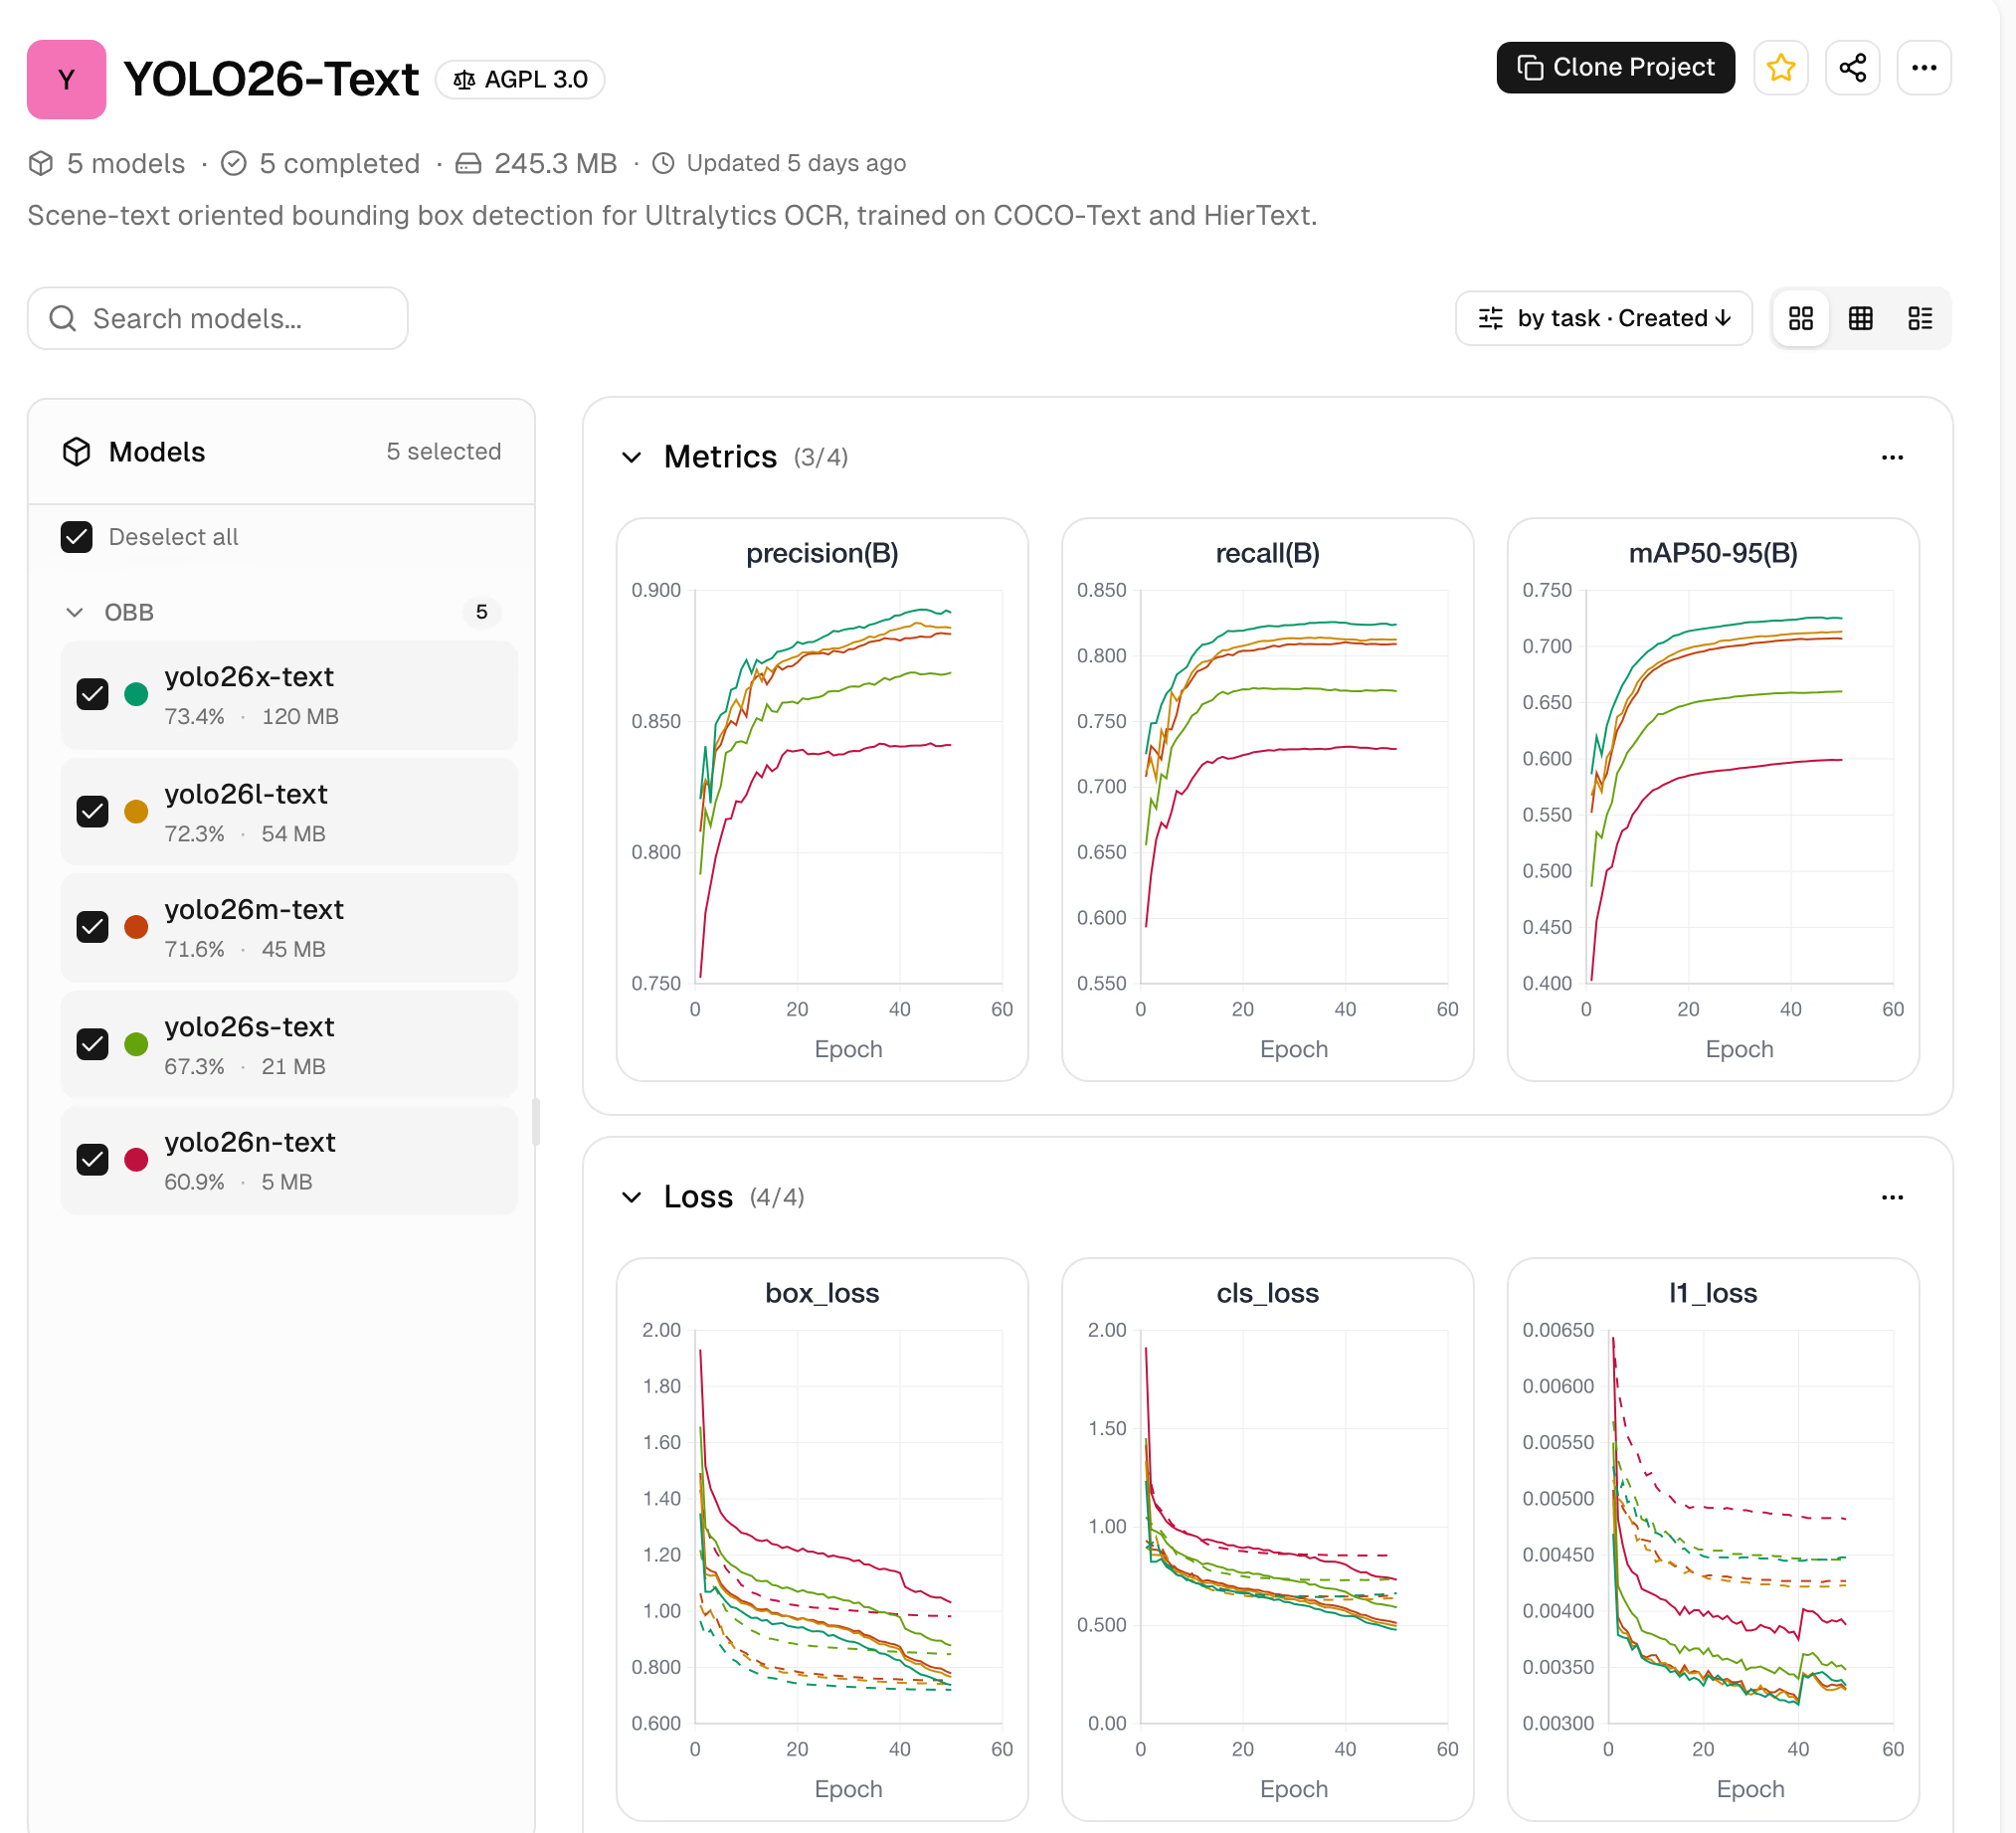
O projeto YOLO26-Text na Ultralytics Platform: os cinco tamanhos do detetor com as respetivas curvas de precisão, revocação, mAP50-95 e perda durante o treino.
Para o adaptar aos teus documentos, começa pelo conjunto de dados Scene Text OBB, que combina COCO-Text e HierText em 65,325 imagens com cerca de 1,29 milhões de polígonos de palavras.
As limitações são específicas:
- Escritas. O reconhecedor predefinido ainda não lê cirílico, coreano, árabe, hebraico, devanágari ou tailandês. Combina o detetor com o teu próprio reconhecedor ou escolhe um motor que as suporte.
- Direções mistas. A solução roda a página inteira de acordo com a direção dominante do texto, pelo que o texto que segue várias direções numa página, como uma nota vertical na margem, pode ser lido com menos precisão.
- Exportação. O reconhecedor não está incorporado num ficheiro de detetor exportado, por isso implementa o detetor e o ambiente de execução do reconhecimento lado a lado ou mantém a solução Python como elemento de ligação.
- Rust. O Ultralytics Inference lê texto em cena em Rust com o mesmo reconhecedor PP-OCRv6 através de
ultralytics-inference predict --ocr, mas trata a orientação com um classificador em vez da etapa de rotação da página da solução Python. - Privacidade. A solução Python é executada no teu próprio hardware, por isso as páginas não têm de sair das tuas máquinas; a demonstração no navegador carrega as páginas para fazer inferência. Para campos que não devem ser lidos, cobre as regiões conhecidas com uma máscara opaca antes de executar o OCR.
Em formulários e contratos, um modelo YOLO personalizado pode encontrar primeiro campos, tabelas, assinaturas e carimbos, para que só leias as regiões de que precisas. O conjunto de dados Signature na Ultralytics Platform e o nosso guia de análise inteligente de documentos são bons pontos de partida, e a Ultralytics Platform permite-te etiquetar páginas e treinar esse modelo num só lugar. Para testar primeiro o OCR na tua própria página, arrasta uma imagem ou um PDF para a demonstração de OCR ao vivo.
Perguntas frequentes
Instala o pacote Ultralytics com
pip install -U "ultralytics>=8.4.211"e, em seguida, chamasolutions.OCR()numa imagem carregada com OpenCV. A solução devolve as palavras reconhecidas, com o respetivo texto, confiança, número da linha e polígono, pela ordem de leitura. Na primeira execução, transfere automaticamente o detetor YOLO26-Text e o reconhecedor PP-OCRv6.Depende dos teus documentos, idiomas e hardware; a nossa visão geral dos modelos de OCR populares de código aberto compara as principais opções. No nosso benchmark, com tamanho de imagem 1280 numa RTX PRO 6000, o YOLO26x-Text com PP-OCRv6 obteve F1 de palavras de 0.931 em seis páginas de PDF e 0.722 em 80 fotografias do HierText, e lê páginas em qualquer rotação. Para escritas que ainda não abrange, como cirílico ou coreano, utiliza um reconhecedor treinado para essa escrita.
Um modelo YOLO deteta texto, mas não o lê. O Ultralytics YOLO26-Text deteta texto em caixas orientadas, e a solução de OCR passa cada recorte ao reconhecedor PP-OCRv6, pelo que, em conjunto, fazem OCR completo numa só chamada.
Sim. Renderiza cada página do PDF como uma imagem, por exemplo, com
get_pixmapdo PyMuPDF, converte-a para BGR e passa-a parasolutions.OCR(). No navegador, a demonstração e o separador Platform Predict aceitam um PDF e leem a primeira página.Sim. O PP-OCRv6 funciona com ONNX Runtime na CPU ou em GPUs CUDA, e o mesmo script funciona em ambos. O reconhecedor opcional do TensorRT requer uma GPU NVIDIA.
Ainda não com o reconhecedor predefinido. O PP-OCRv6 abrange chinês, japonês e idiomas que usam o alfabeto latino, mas não cirílico, hangul, árabe, hebraico, devanágari ou tailandês. Podes manter o detetor YOLO26-Text e passar-lhe um reconhecedor treinado para esse sistema de escrita.
Escrito por
Engenheiro sênior de machine learning · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









