Сегментация Ultralytics YOLO в плотных сценах: 1 000 масок
В Ultralytics 8.4.213 модель YOLO26n-seg предсказывает и суммирует 1 000 масок на синтетическом изображении 1080p за 56.4 мс на RTX PRO 6000 — вместо 821.2 мс.
 Glenn Jocher11 мин. чтения
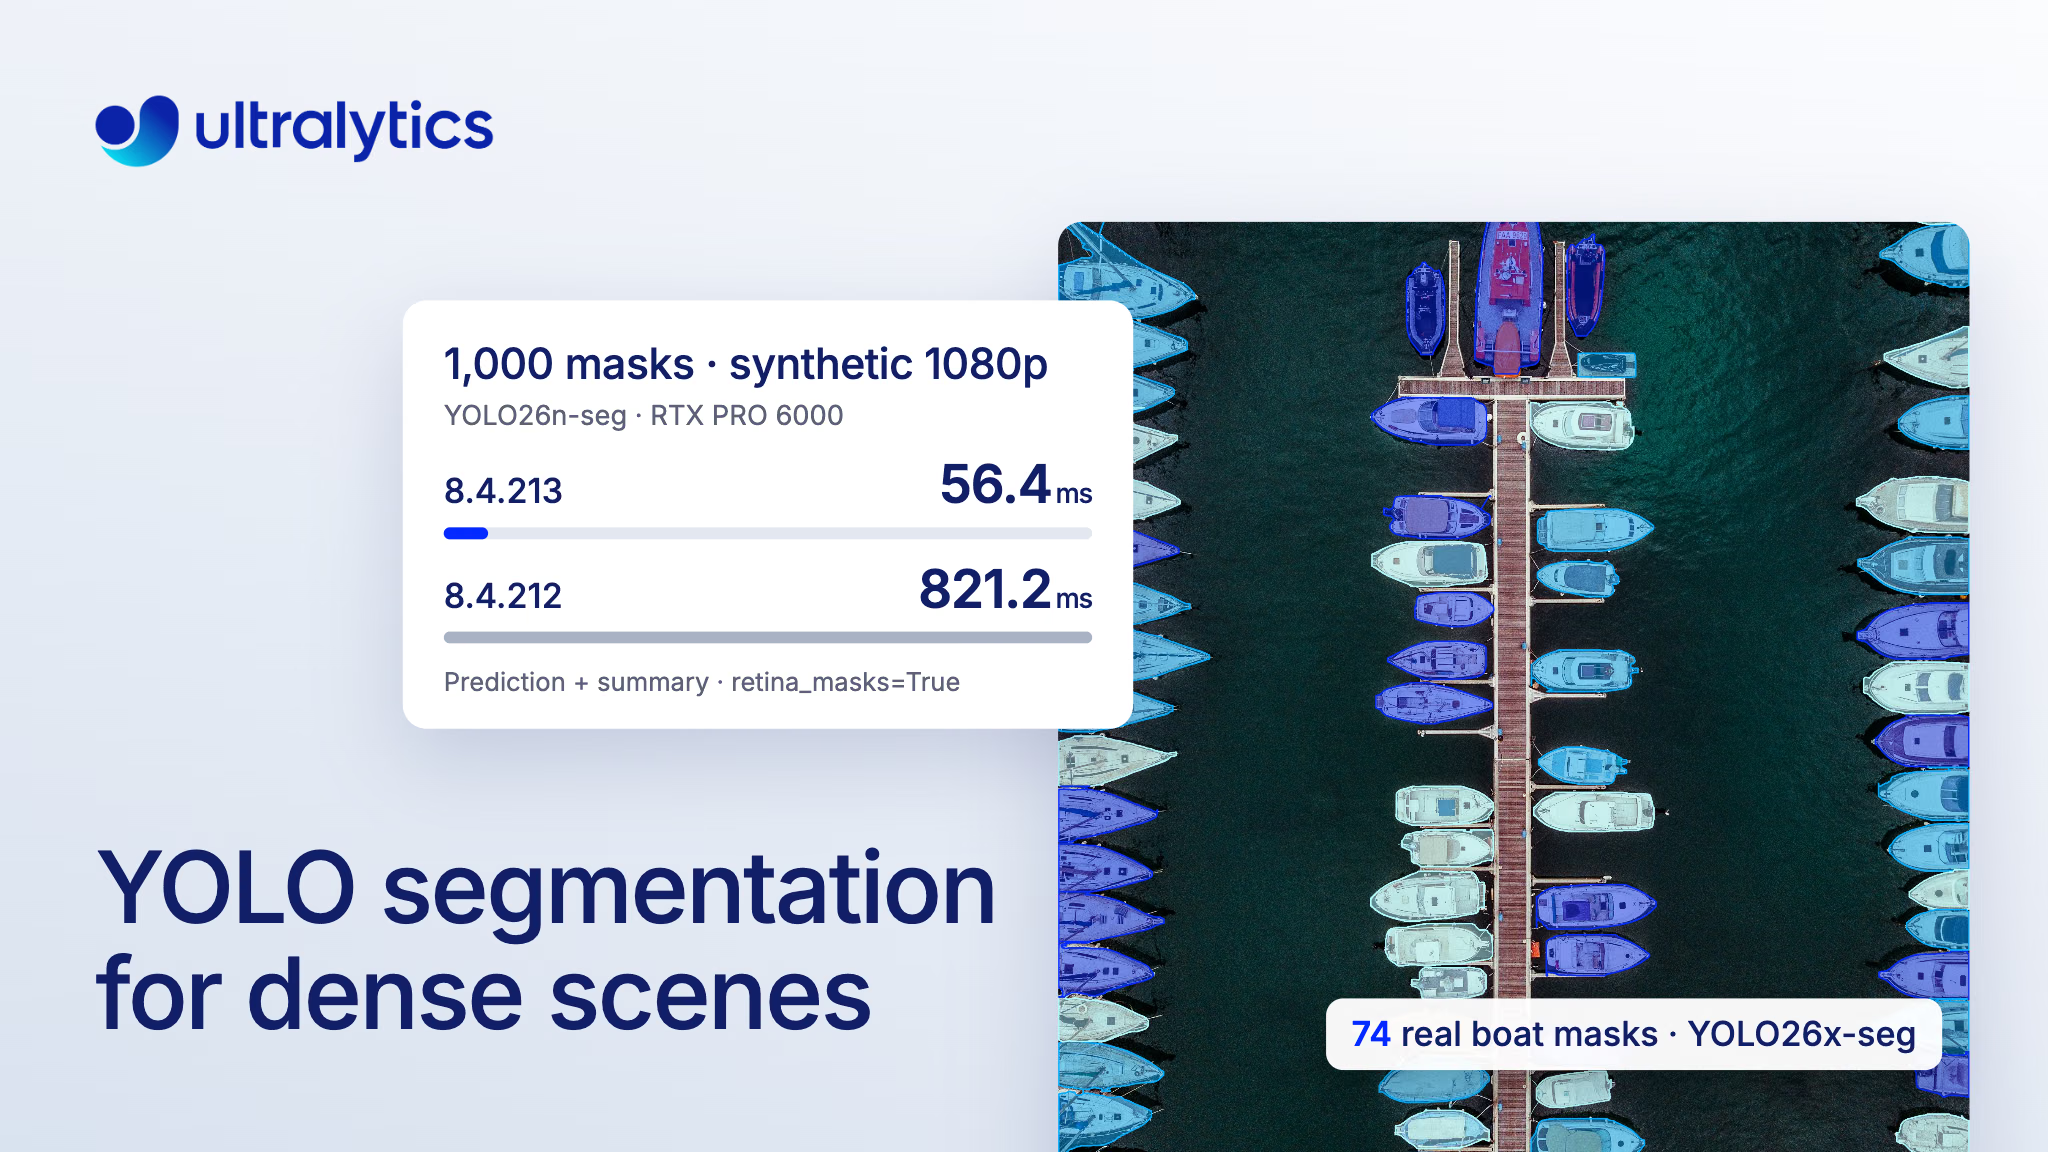
Выпуск Ultralytics 8.4.213 от 14 ноября 2026 года ускоряет сегментацию YOLO в плотных сценах: большие стеки масок декодируются внутри рамки каждого обнаруженного объекта. Если ты сегментируешь полки, посылки, толпы или аэрофотоснимки, то, вероятно, уже сталкивался с ситуацией, когда модель сегментации находит объекты, но на этап обработки масок после этого не хватает времени или памяти; этот выпуск значительно отодвигает этот предел. В нашем бенчмарке на синтетическом плотно заполненном изображении 1080p модель YOLO26n-seg вернула 1 000 масок экземпляров полного разрешения (retina_masks=True) и сформировала сводку результатов за 56.4 мс, используя пиковые 321 MiB памяти GPU на RTX PRO 6000; в версии 8.4.212 обработка занимала 821.2 мс и использовала 4 291 MiB.
Сама модель не изменилась. Изменился способ, которым сегментация YOLO преобразует выходные данные модели в маски: теперь большие стеки масок декодируются внутри рамки каждого объекта, а не по всему кадру. В Ultralytics Platform вкладка Predict и API возвращают до 1 000 результатов на изображение. В этой статье рассказываем, почему обработка плотных сцен требовала много ресурсов, что изменилось в 8.4.213, какие результаты получены и как самостоятельно запускать предсказания с 1 000 масками.
В плотных сценах раньше приходилось обрабатывать пиксели за пределами каждой рамки#
Сегментация экземпляров присваивает каждому объекту собственную маску. Это нужно, чтобы измерять площадь, вырезать объекты или различать соприкасающиеся предметы. Модель сегментации YOLO предсказывает небольшой набор общих масок-прототипов и несколько коэффициентов для каждого обнаружения, а постобработка объединяет их в отдельную маску для каждого объекта.
До сих пор на этом этапе каждая маска создавалась в размере кадра: по умолчанию — в размере входного изображения модели, а при использовании retina_masks=True или тайлинга — в размере исходного изображения. Для N объектов в кадре размером H x W выделялся стек N x H x W, который обрезался, фильтровался и сканировался, хотя за пределами рамки объекта каждая маска состояла только из нулей. В плотной сцене с разрешением 1080p суммарная площадь 1 000 рамок с учетом перекрытий примерно вдвое превышает площадь кадра, но площадь стека составляла 1 000 площадей кадра. Затраты росли пропорционально max_det и размеру изображения, а не количеству рамок на изображении.
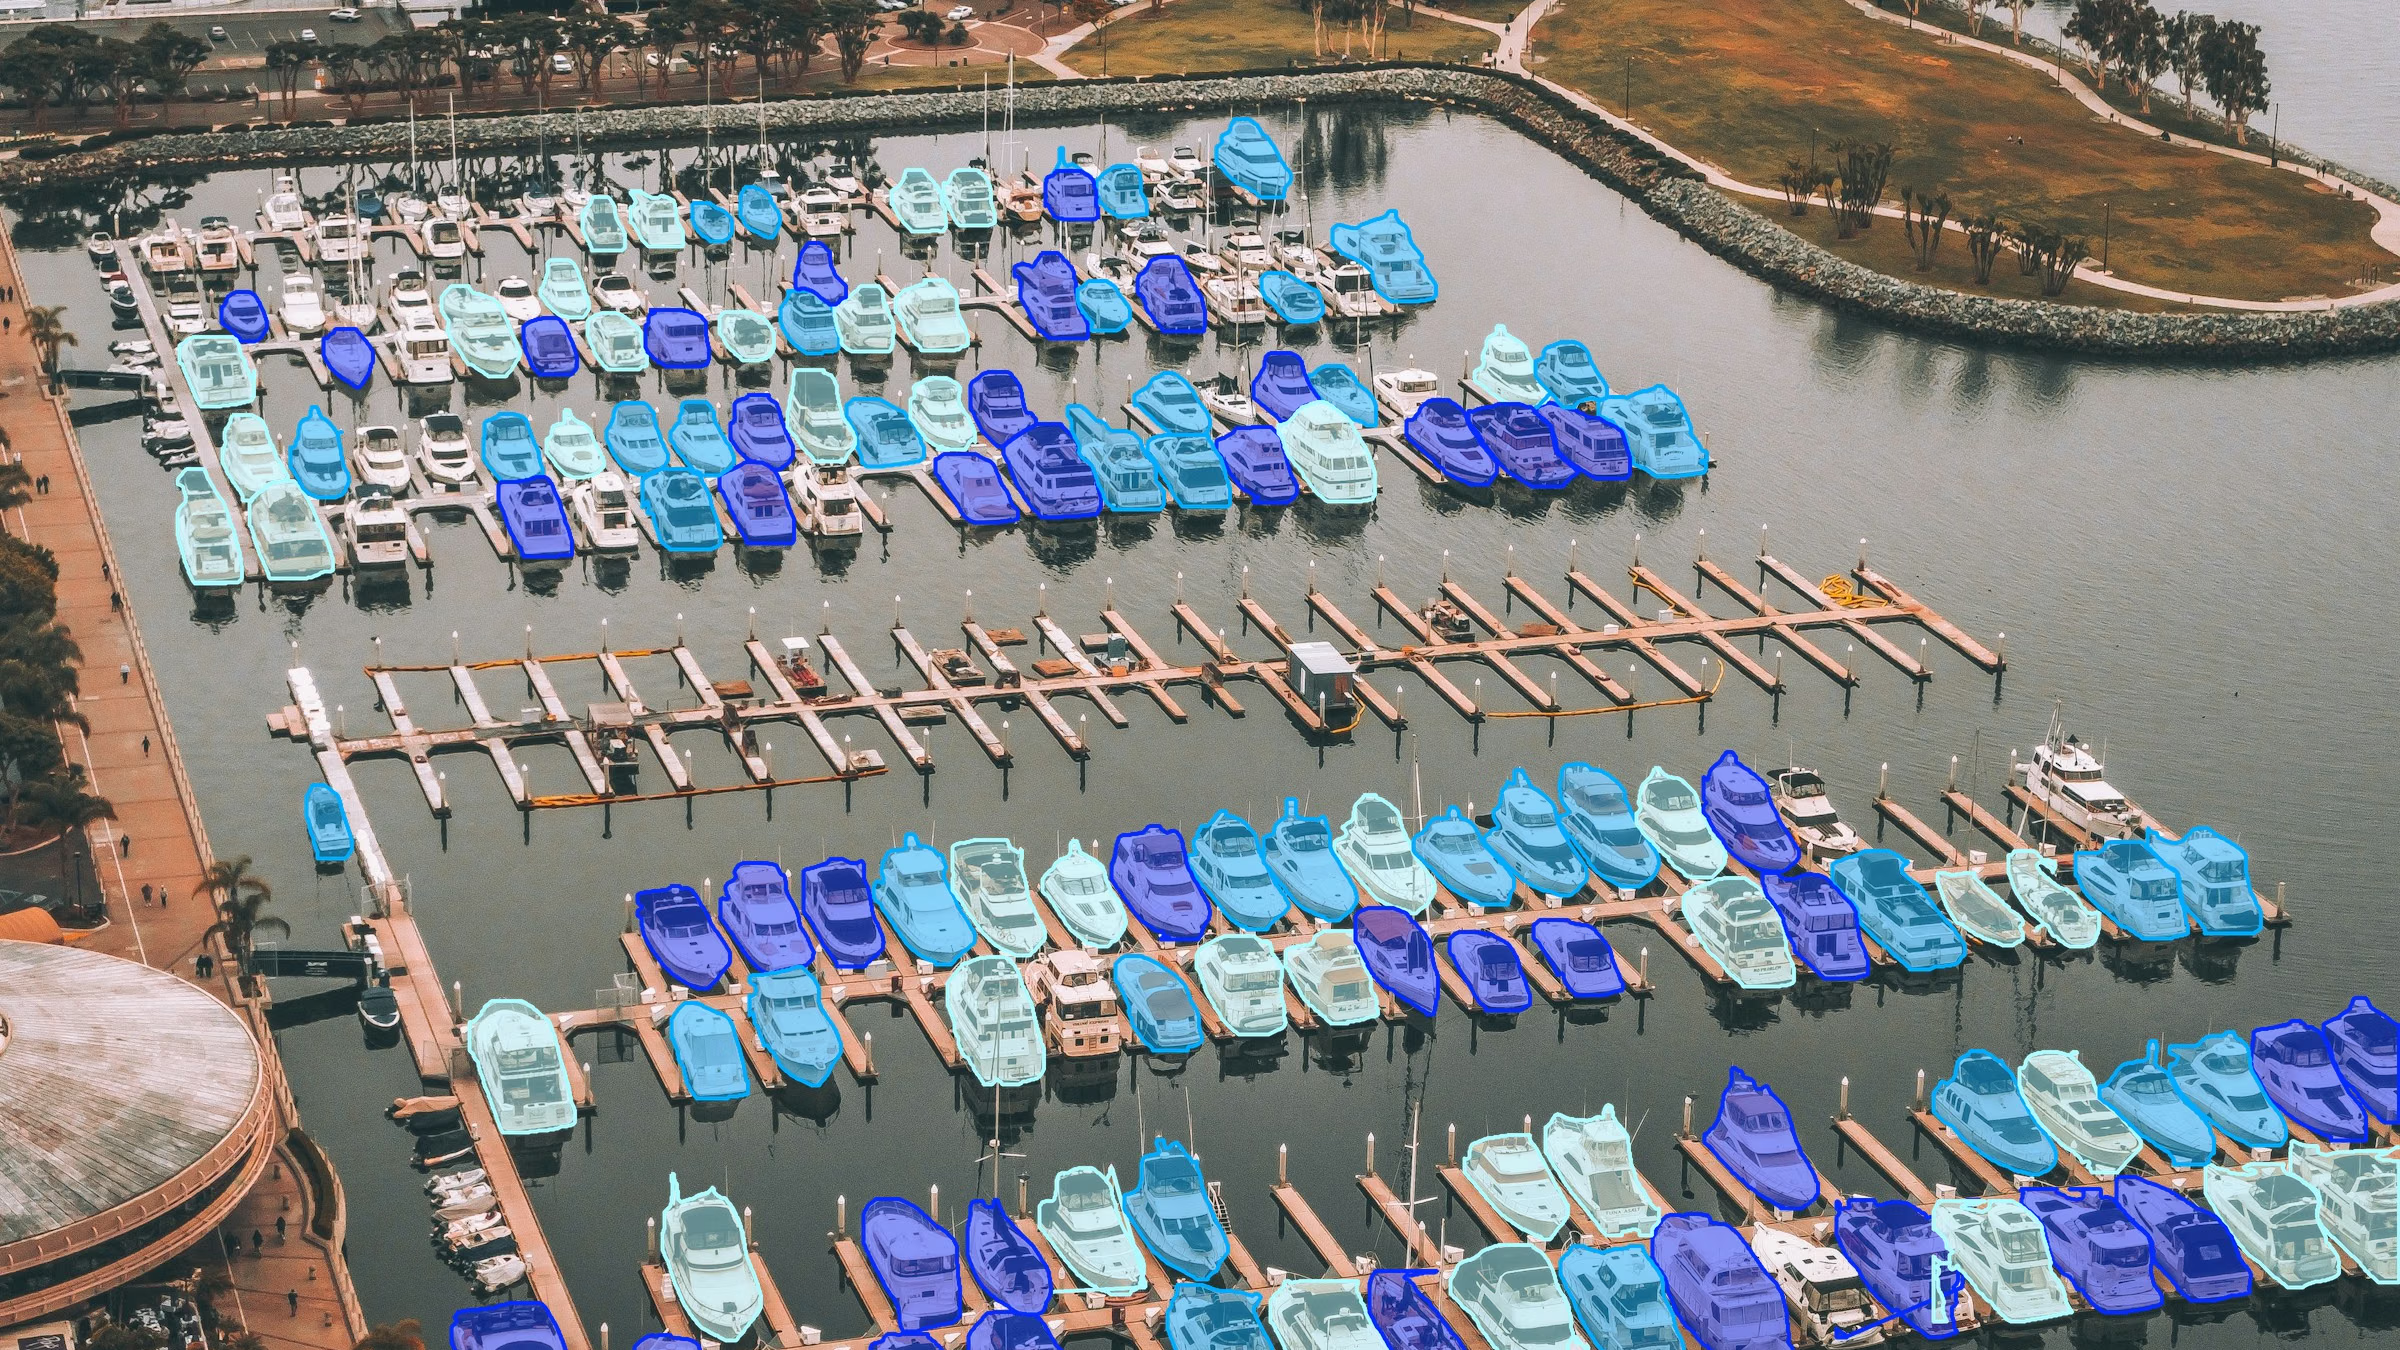
YOLO26x-seg вернула 127 масок лодок на этом снимке гавани; показаны обрезанные маски (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Фото: Unsplash.
Поэтому для сегментации было непрактично повышать max_det выше значения по умолчанию — 300, а большие изображения с множеством объектов могли исчерпать память. Плотно заставленные товарами полки, например в наборе данных SKU-110K, груды посылок и аэрофотоснимки — именно те сцены, для которых нужно обрабатывать больше 300 объектов.
Ultralytics 8.4.213 декодирует большие стеки масок внутри каждой рамки#
Новый алгоритм из PR #27197 интерполирует логиты прототипов только в пикселях каждой рамки. Он использует разделяемую билинейную выборку — такую же, как при интерполяции в PyTorch, — и объединяет рамки похожего размера в пакеты. Для больших стеков стоимость декодирования теперь зависит от суммарной площади рамок.
На практике важны три детали:
- Переключение происходит при превышении фиксированного размера стека масок. Предиктор сегментации использует локальные маски в рамках, когда плотный стек превысил бы 33 554 432 пикселя на CUDA или 4 194 304 пикселя на CPU и других устройствах. Для стеков меньшего размера сохраняется прежний плотный алгоритм, который работает не медленнее, а иногда быстрее при небольшом количестве масок.
- При таком алгоритме контуры строятся непосредственно по локальным маскам в рамках.
masks.xyиmasks.xynотслеживают полигоны для каждой рамки, поэтомуsummary(),to_json()иsave_txtне создают полный стек. - Формат выходных данных не изменился.
masks.dataпо-прежнему возвращает плотный тензор N x H x W. При использовании локального алгоритма в рамках он создаётся при первом обращении к нему.
Чтение плотного тензора по-прежнему требует выделения памяти, но в PR измерили снижение затрат: на GPU чтение masks.data для 300 масок при разрешении 1080p с retina_masks=True стало занимать 9,1 мс и 795 МиБ вместо 14,1 мс и 1 366 МиБ.
На GPU обработка 1 000 масок при разрешении 1080p ускорилась с 821,2 до 56,4 мс#
В PR приведены результаты бенчмарка YOLO26n-seg при выполнении полного model.predict(...) и result.summary() (рамки и полигоны); указана медиана для прогретых запусков, по одному процессу на строку. Плотные сцены — это синтетические изображения, составленные из тайлов, при conf=0.01 и imgsz=1280; типичная сцена — стандартный bus.jpg с настройками по умолчанию и 5 масками. «До» означает версию 8.4.212. Эти измерения показывают затраты на постобработку и включают предсказание и сводку результатов; это не показатель общей скорости инференса.
| Сцена (GPU, RTX PRO 6000) | Маски | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Типичная (bus.jpg) | 5 | Ложь | 4,3 мс, 59 МиБ | 4,4 мс, 59 МиБ |
| 1920 x 1080 | 300 | Ложь | 118,5 мс, 1 673 МиБ | 16,3 мс, 174 МиБ |
| 1920 x 1080 | 300 | Истина | 248,7 мс, 1 366 МиБ | 18,0 мс, 201 МиБ |
| 1920 x 1080 | 1,000 | Истина | 821,2 мс, 4 291 МиБ | 56,4 мс, 321 МиБ |
| 4000 x 3000 | 300 | Истина | 1 352,1 мс, 7 070 МиБ | 26,5 мс, 172 МиБ |
| 4000 x 3000 | 1,000 | Истина | 4 323,1 мс, 23 305 МиБ | 130,7 мс, 258 МиБ |
Время и пиковое потребление памяти GPU, PyTorch 2.15.0 с CUDA 13.2. Источник: PR #27197.
Результат для типичного изображения с пятью масками не изменился — так и задумано. Ускорение заметно там, где раньше разрастался стек, и особенно велико для масок в полном разрешении, обработка которых раньше обходилась дороже всего.
Большим изображениям требуется лишь малая доля прежнего объёма памяти#
Для изображения размером 4000 x 3000 пикселей с 1 000 предсказанными масками старый алгоритм использовал до 23 305 МиБ памяти GPU. Новый алгоритм использовал максимум 258 МиБ и завершал работу за 130,7 мс вместо 4 323,1 мс. Благодаря такому снижению у тебя остаётся больше памяти GPU для остальной части конвейера при работе с 12-мегапиксельными кадрами с дронов, спутников и систем инспекции.
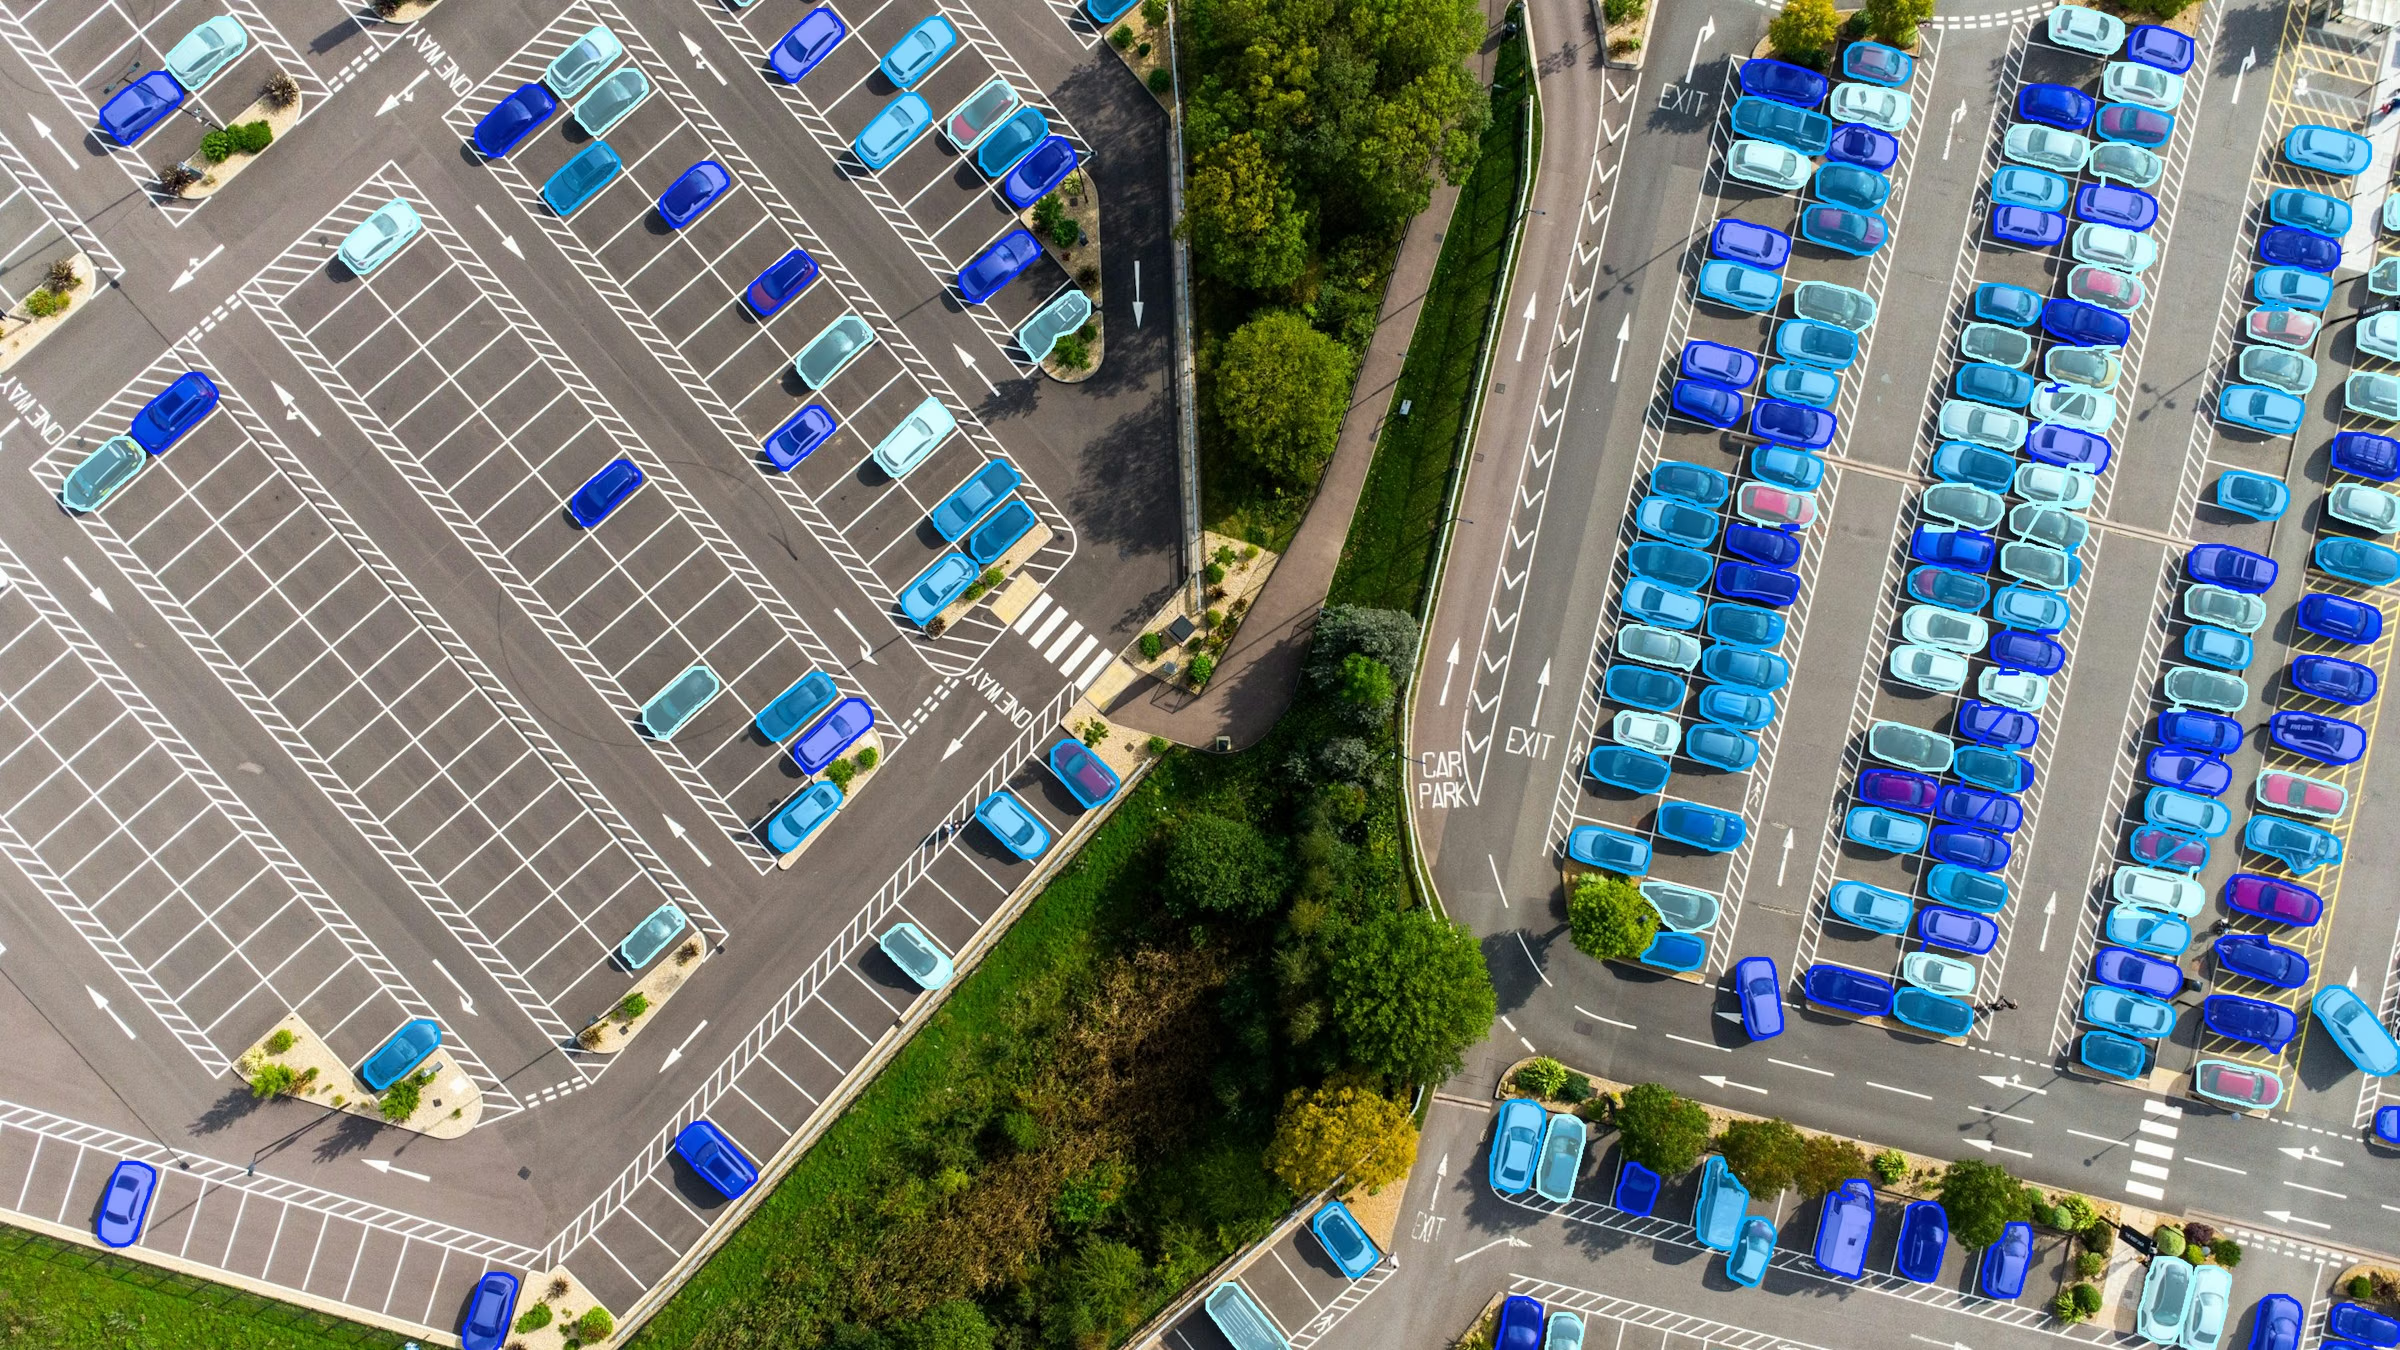
YOLO26x-seg вернула 222 маски автомобилей на этом аэрофотоснимке (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Фото: Unsplash.
Предсказания на CPU тоже стали намного быстрее#
На CPU Linux x86 с 8 потоками процесс использует около 840 МиБ ещё до создания масок. При разрешении 1080p и 1 000 масках в полном разрешении пиковое потребление памяти процессом снизилось с 5 217 до 1 072 МиБ, а время сократилось, как показано ниже.
300 и 1 000 масок при разрешении 1920 x 1080, а также 300 масок при разрешении 4000 x 3000 (12 Мп). YOLO26n-seg, предсказание и сводка результатов; версия 8.4.212 до изменения и 8.4.213 после. Источник: PR #27197.
Маски совпадают с результатами 8.4.212, за исключением незначительных различий по краям в одном режиме#
Ускоренный алгоритм полезен, только если возвращает тот же результат. В PR сравнили 8.4.213 с 8.4.212 на 96 предсказаниях, используя YOLO26n-seg и YOLO11n-seg на двух изображениях шести размеров, conf со значениями 0.25 и 0.01, оба режима масок и принудительно включённый алгоритм с локальными масками в рамках:
- Маски по умолчанию (
retina_masks=False): рамки, маски и полигоны идентичны; различий нет среди 7,6 миллиона пикселей масок. - Маски в полном разрешении (
retina_masks=True): результаты идентичны в случаях, когда старый код выполнял интерполяцию один раз. Для изображений с другими пропорциями различаются 0,07 % пикселей масок (18 105 из 24,8 миллиона); все различия приходятся на края масок, поскольку старый код выполнял там интерполяцию дважды, а новый однократно выбирает значения прототипов в точных координатах. - Apple MPS: маски, рамки и полигоны идентичны для плотной сцены с разрешением 1080p и 179 масками в обоих режимах масок.
Как сегментировать 1 000 объектов на изображение в Python#
Обнови пакет с помощью pip install -U ultralytics (версия 8.4.213 или новее), а затем увеличь max_det выше значения по умолчанию — 300. Остальной код можно не менять.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # Классы COCO; загрузи собственную обученную модель для полок или посылок
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # один массив (P, 2) на объект, в пикселях исходного изображения
rows = r.summary()  # рамки и полигоны
max_det — это верхний предел, а не целевое значение: количество возвращаемых объектов по-прежнему зависит от модели, изображения и порога уверенности. Чтобы получить максимум от этого изменения:
- По возможности считывай контуры.
masks.xy(в пикселях) иmasks.xyn(нормализованные) строятся по локальным маскам в рамках при использовании алгоритма для больших стеков; то же относится кto_json()иsave_txt. В справочнике по Results перечислены все атрибуты. - Для вычислений непосредственно по пикселям считывай
masks.data. Площадь и перекрытия проще всего вычислять по плотному тензору; для вырезания объектов также можно использовать контурыmasks.xy. В уроке Академии о работе с масками в коде показано, когда использовать каждый вариант, а в руководстве по изоляции объектов вырезанные объекты создаются по контурам. - Используй
retina_masks=True, если нужны маски в разрешении исходного изображения. В бенчмарке на GPU с 300 масками при разрешении 1080p обработка теперь занимает 18,0 мс против 16,3 мс для масок по умолчанию. Если работаешь с мелкими объектами в очень больших кадрах, посмотри нашу статью о детекции мелких объектов с помощью разбиения изображения на тайлы и руководство по тайлингу изображений высокого разрешения. При предсказании с тайлингом возвращаются маски размером с исходное изображение, поэтому для такого запуска по-прежнему требуется память, пропорциональная размеру исходного изображения. - Настрой
confиiouдля плотных сцен. Увеличениеmax_detпозволяет сохранить больше обнаружений, которые уже прошлиconf; снижениеconfпозволяет учитывать менее уверенные обнаружения. В описании настроек предсказания рассматриваютсяconf,iouиmax_det, а в нашем руководстве по порогу IoU для NMS объясняется, как обрабатывать соприкасающиеся объекты.
Изменение затрагивает постобработку на Python, поэтому оно применимо к модели PyTorch и экспортированным моделям, запущенным через API predict от Ultralytics. В PR тестировались YOLO26n-seg и YOLO11n-seg; та же постобработка используется во всех моделях сегментации YOLO26 и YOLO11 — от YOLO26n-seg с 2,7 млн параметров после объединения слоёв до YOLO26x-seg с 62,8 млн. Чтобы обучить такую модель на собственных плотных данных, следуй нашему руководству по обучению YOLO26 на собственных данных для сегментации экземпляров.
Ultralytics Platform теперь возвращает до 1 000 результатов на изображение#
Теперь в Ultralytics Platform тоже действует тот же верхний предел. Вкладка Predict модели возвращает до 1 000 результатов на изображение; то же касается REST API, на котором она работает. Исключение — модели RT-DETR: для них предел составляет 300, то есть количество запросов в декодере.
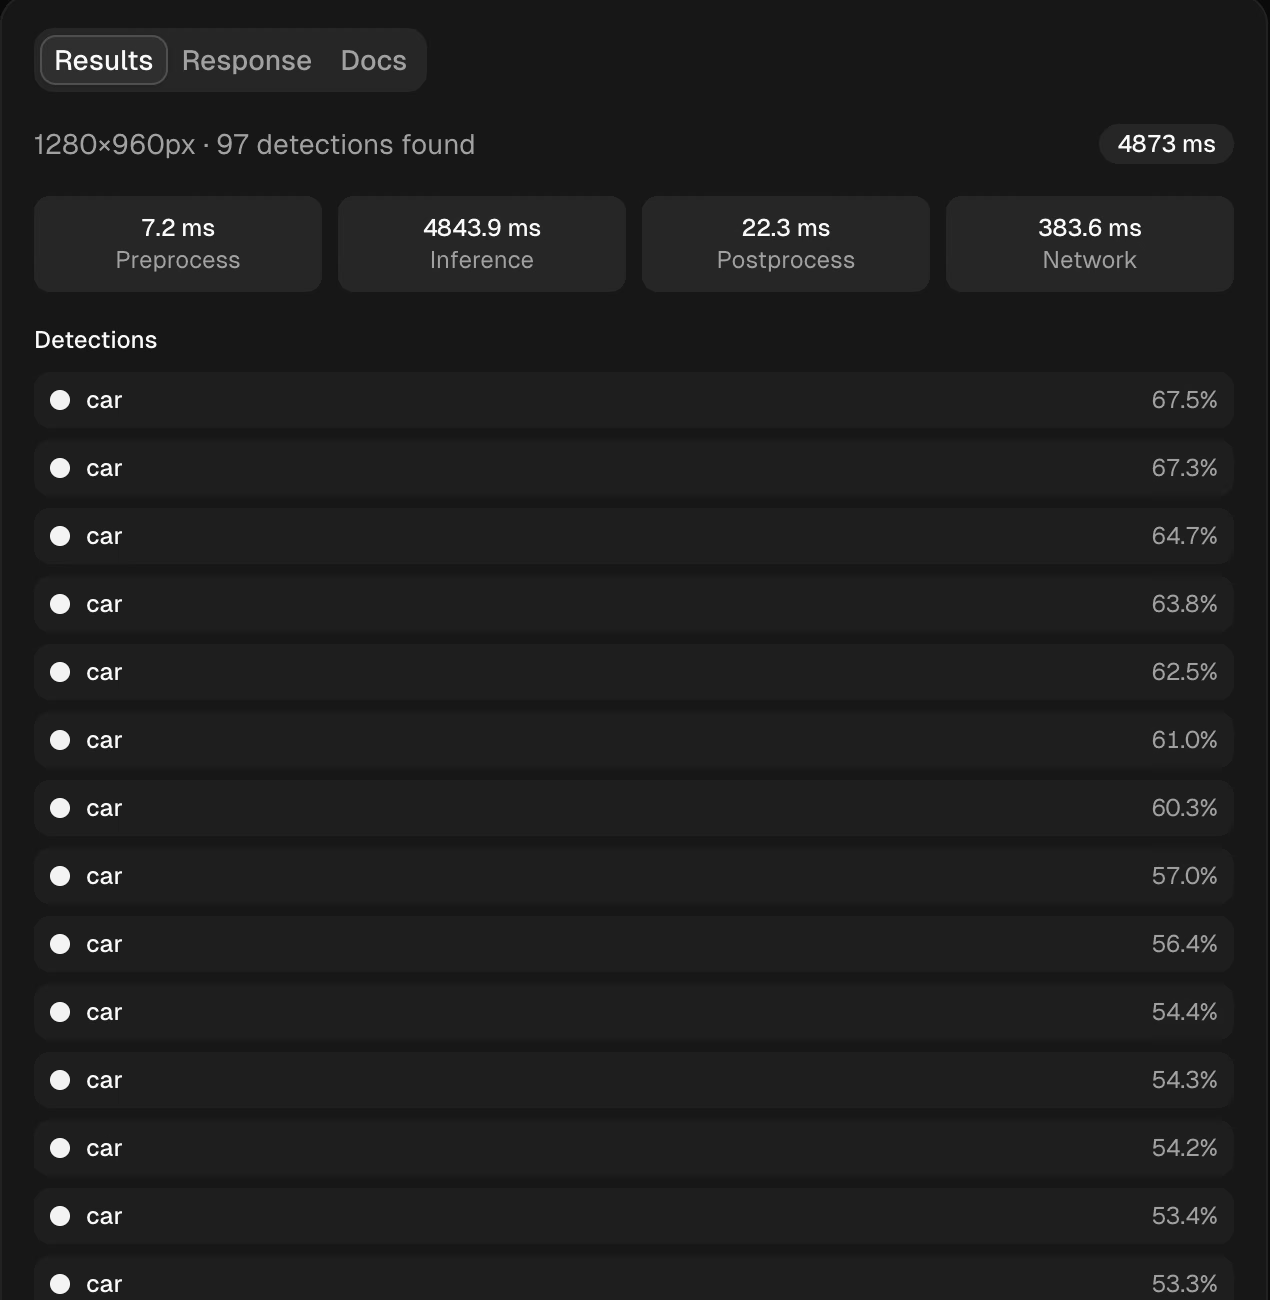
Вкладка Predict для YOLO26x-seg при размере изображения 1280: на аэрофотоснимке выше показано 97 обнаруженных автомобилей. Подробное описание панели см. в документации по инференсу в Platform.
Панель результатов рассчитана на длинные списки. Если результатов больше 10, на изображении отображаются рамки без меток, чтобы не закрывать объекты; в списке указаны названия результатов, а на увеличенном изображении остаются метки. Наведи курсор на строку, чтобы выделить соответствующий объект, или на объект, чтобы найти его строку.
Чтобы проверить это на собственных данных, начни с набора данных Package-Seg для сегментации посылок, обучи модель в облаке и запусти её во вкладке Predict или за выделенной конечной точкой.
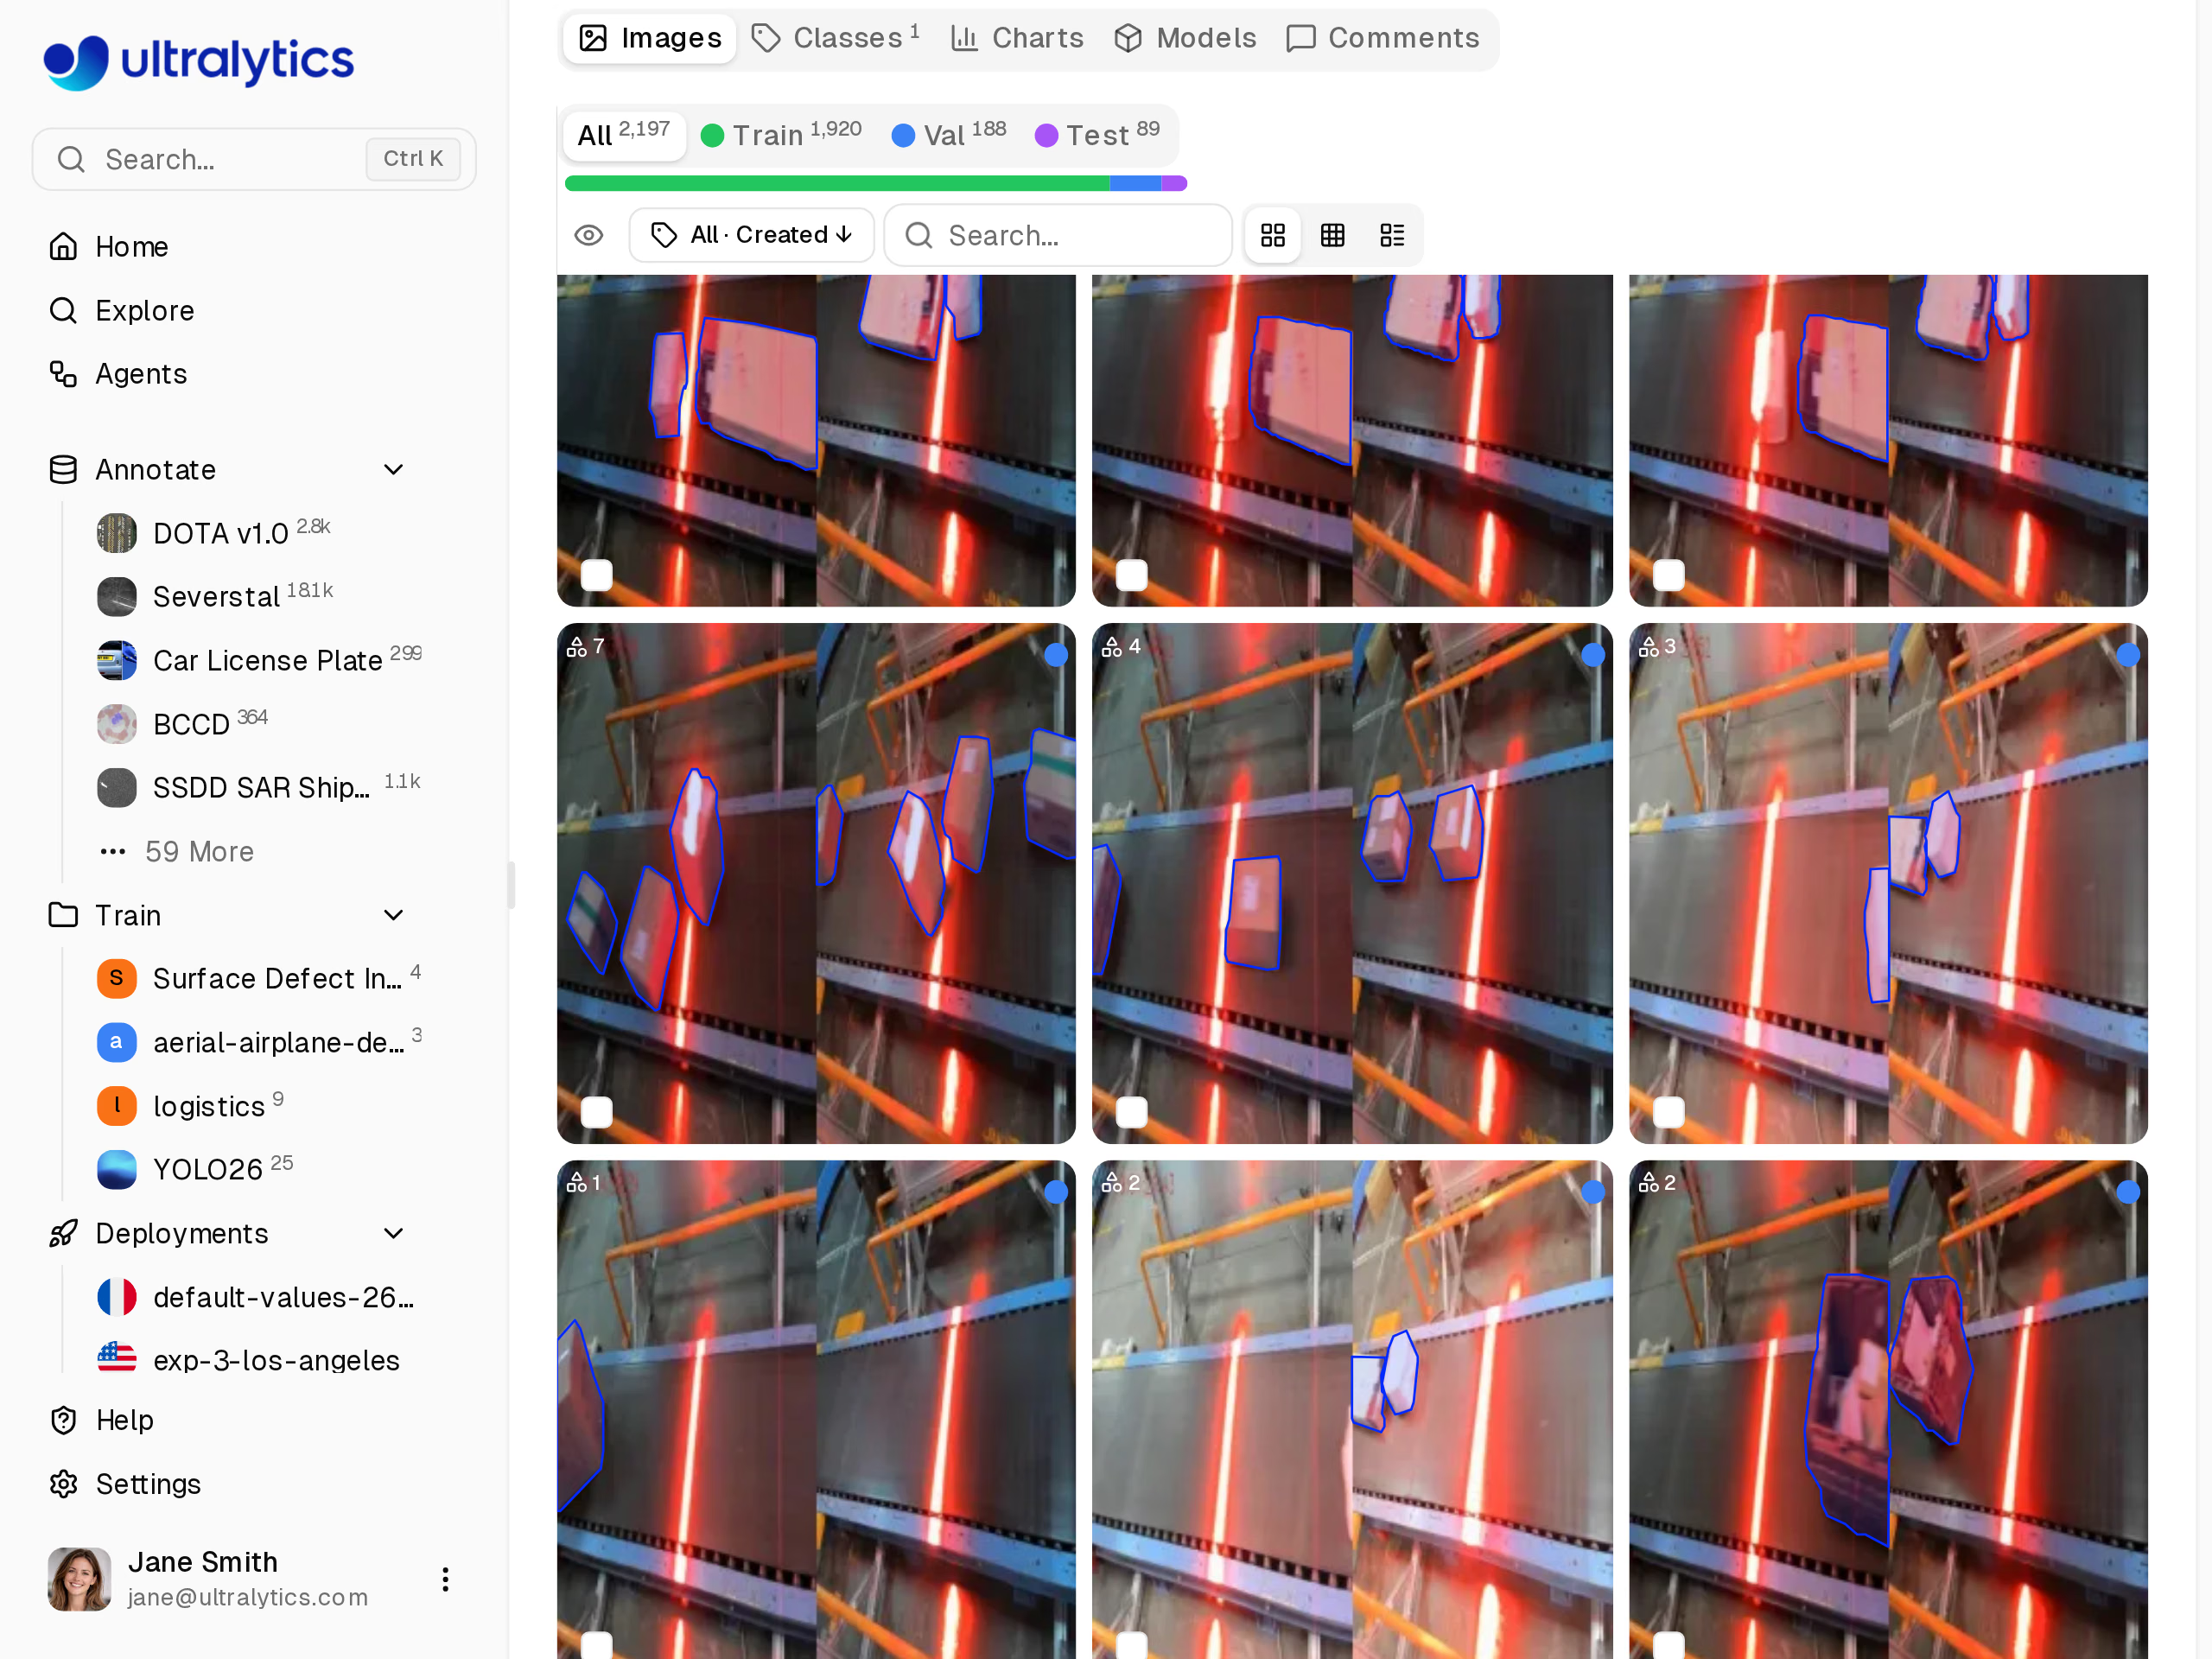
Набор данных Package-Seg на Ultralytics Platform — готовая отправная точка для сегментации в логистике.
Кому стоит обновиться#
Обновись уже сейчас, если сегментируешь плотные сцены или большие изображения: торговые полки, сортируемые посылки, аэрофотоснимки и съёмку с дронов, микроскопию клеток или любые другие данные, для обработки которых приходилось ограничивать max_det, уменьшать размер изображения или отключать retina_masks, чтобы уложиться в доступную память. Теперь от этих обходных решений можно отказаться.
Если стеки масок не превышают порог, продолжает использоваться прежний плотный алгоритм. Учти, что порог зависит от произведения количества объектов на размер изображения, поэтому даже несколько масок на очень большом изображении могут его превысить. Если твой конвейер всегда считывает masks.data, плотный тензор всё равно создаётся; в тесте из PR для 300 масок при разрешении 1080p на GPU это заняло меньше времени и памяти, чем раньше. Если хочешь вспомнить, нужна ли тебе сегментация экземпляров, см. статью о семантической сегментации и сегментации экземпляров.
Часто задаваемые вопросы
Сегментация YOLO — это задача сегментации экземпляров в Ultralytics YOLO: для каждого объекта модель возвращает класс, рамку, оценку уверенности и попиксельную маску. Модели сегментации YOLO26 выпускаются в пяти размерах — от YOLO26n-seg до YOLO26x-seg; они предварительно обучены на 80 классах COCO и готовы к дообучению на твоих данных.
max_detзадаёт верхний предел, который по умолчанию равен 300; количество возвращаемых объектов также зависит от модели, изображения и порога уверенности. Начиная с версии 8.4.213, для нагрузок, подобных тестовой, можно установить предел 1 000: на синтетическом изображении с разрешением 1080p YOLO26n-seg предсказала и обработала сводку для 1 000 масок в полном разрешении за 56,4 мс, использовав максимум 321 МиБ памяти на RTX PRO 6000. Ultralytics Platform возвращает до 1 000 результатов на изображение.В предыдущих версиях каждая маска создавалась в размере кадра, поэтому объём памяти рос пропорционально произведению количества объектов на площадь кадра. В синтетическом тесте с изображением размером 4000 x 3000 и 1 000 масками в полном разрешении пиковое потребление памяти GPU составило 23 305 МиБ. Версия 8.4.213 декодирует большие стеки внутри каждой рамки и в том же случае использовала максимум 258 МиБ.
Обновись до версии
ultralytics8.4.213 или новее; других изменений кода не требуется, поскольку алгоритм с локальными масками в рамках включается автоматически для больших стеков масок.masks.dataпо-прежнему сохраняет прежний плотный формат, поэтому существующий код продолжит работать; чтениеmasks.xyили вызовsummary()вместо этого позволяют не создавать такой тензор при использовании этого алгоритма.retina_masks=Trueвозвращает маски с разрешением исходного изображения, а не с размером входного изображения модели, чтобы плотная маска была совмещена с исходным изображением. При 300 масках на синтетическом изображении с разрешением 1080p предсказание YOLO26n-seg и формирование сводки результатов на RTX PRO 6000 заняли 248,7 мс в версии 8.4.212 и 18,0 мс в версии 8.4.213 при включённой настройке.
Автор
Основатель и генеральный директор · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









