Data Curation
Курация данных — это непрерывный процесс организации, проверки, документирования и поддержки надежных датасетов для машинного обучения и оценки.
Курирование данных — это непрерывный процесс отбора, организации, проверки, документирования и сопровождения данных, позволяющий сохранить их полезность для конкретной цели. В машинном обучении оно определяет, на каких примерах обучается модель и какие данные используются для её оценки. Курируемый набор данных включает релевантные примеры, согласованную разметку для задач с учителем, контекстную информацию и версии с историей изменений.
Курирование, очистка и предобработка#
Курирование охватывает весь жизненный цикл набора данных. Очистка данных исправляет ошибки и удаляет непригодные записи; предобработка данных преобразует входные данные с помощью таких операций, как изменение размера или нормализация. Аннотация данных, также называемая разметкой данных, добавляет целевые значения, используемые в обучении с учителем. Курирование координирует эти действия, определяя, какие примеры включать, как задавать категории и как изменять коллекцию со временем. Согласованные определения категорий и правила разметки помогают моделям выявлять надёжные закономерности между изображениями и целевыми значениями.
Благодаря этому курирование становится практической составляющей ИИ, ориентированного на данные, который улучшает системы за счёт улучшения данных.
Как работает курирование данных#
Процесс начинается со спецификации набора данных: задачи предсказания, целевых категорий, условий эксплуатации и критериев включения. Для обнаружения объектов она включает правила для ограничивающих рамок и частично видимых объектов. Анализ частоты категорий и условий съёмки выявляет смещение набора данных, в том числе недостаточно представленные классы или среды.
Проверки качества сочетают автоматизированный анализ и проверку человеком. Проверка файлов выявляет нечитаемые изображения; проверка аннотаций — недопустимые координаты и несогласованные классы. Хеши файлов обнаруживают точные копии, а эмбеддинги — числовые представления содержимого изображений — помогают находить визуально похожие примеры. При проверке ошибки, которые можно исправить, отделяют от непригодных записей, сохраняя корректные сложные примеры, характерные для задачи.
Проверка хешей файлов позволяет оставить по одному пути для каждого уникального файла. В этом примере проверяются изображения из пакета ultralytics, установленного с помощью pip install ultralytics:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
Количество показывает, сколько файлов осталось после удаления точных дубликатов; совпадающие значения означают, что у всех проверенных файлов разные хеши.
Разделение обеспечивает независимость обучающих данных, валидационных данных и тестовых данных. Соседние кадры видео содержат одни и те же элементы сцены, поэтому распределение таких кадров по разным выборкам приводит к утечке данных и завышает оценочные показатели. Группировка по сессии записи, камере или месту съёмки позволяет оценивать именно нужную способность к обобщению. Зафиксированная версия набора данных сохраняет эти распределения вместе с разметкой.
Ultralytics Platform помогает курировать данные с помощью диаграмм распределения классов и кластеризации изображений, выявляя пробелы в охвате, дубликаты и выбросы. Инструменты управления наборами данных позволяют командам проверять эти группы и обновлять изображения, метки и распределение по выборкам.
Чем занимается специалист по курированию данных#
Специалист по курированию данных отвечает за сохранение смысла и пригодности коллекции. В его обязанности входят документирование источников, согласование правил аннотирования, разрешение разногласий по разметке и регистрация изменений. Метаданные — информация, описывающая примеры, — фиксируют время получения данных, сенсор, местоположение и статус аннотирования. Поддержка повторно используемых данных включает сохранение описаний и сопроводительной документации.
Происхождение данных описывает, откуда взялись примеры и как они преобразовывались. Связь версий наборов данных с отслеживанием экспериментов делает сравнение моделей воспроизводимым. После развёртывания активное обучение помогает выбирать информативные примеры для проверки; мониторинг выявляет дрейф данных, который может стать поводом собрать новые данные.
Примеры в компьютерном зрении#
В области автомобильного восприятия исходная коллекция BDD100K включает 100 000 видеозаписей поездок в разных регионах США, при разной погоде, днём и ночью. Атрибуты условий окружающей среды помогают оценивать модели в различных условиях съёмки. Версия набора данных на Platform содержит 99 996 ключевых кадров для обнаружения объектов.
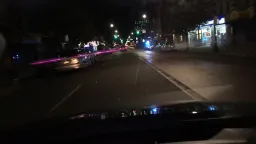 Предпросмотр BDD100K, индекс 1
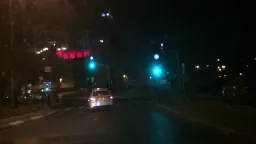 Предпросмотр BDD100K, индекс 2
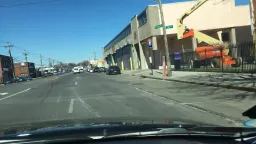 Предпросмотр BDD100K, индекс 3
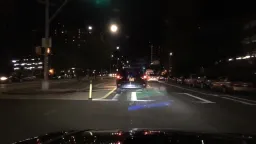 Предпросмотр BDD100K, индекс 4
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
Для классификации изображений в рамках коррекции ciFAIR почти дублирующиеся изображения заменили в исходных тестовых выборках CIFAR-10 и CIFAR-100. Совпадения с обучающими изображениями или другими тестовыми изображениями затрагивали соответственно 3.25% и 10% исходных тестовых выборок. При неизменной обучающей выборке ошибка классификации ResNeXt-29 (8x64d) выросла с 3.56% на CIFAR-10 до 3.95% на ciFAIR-10.









