Yoğun sahnelerde Ultralytics YOLO segmentasyonu: 1.000 maske
Ultralytics 8.4.213'te YOLO26n-seg, sentetik bir 1080p görüntüde 1.000 maskeyi RTX PRO 6000 üzerinde 56.4 ms'de tahmin edip özetliyor; önceki süre 821.2 ms idi.
 Glenn Jocher10 dakikalık okuma
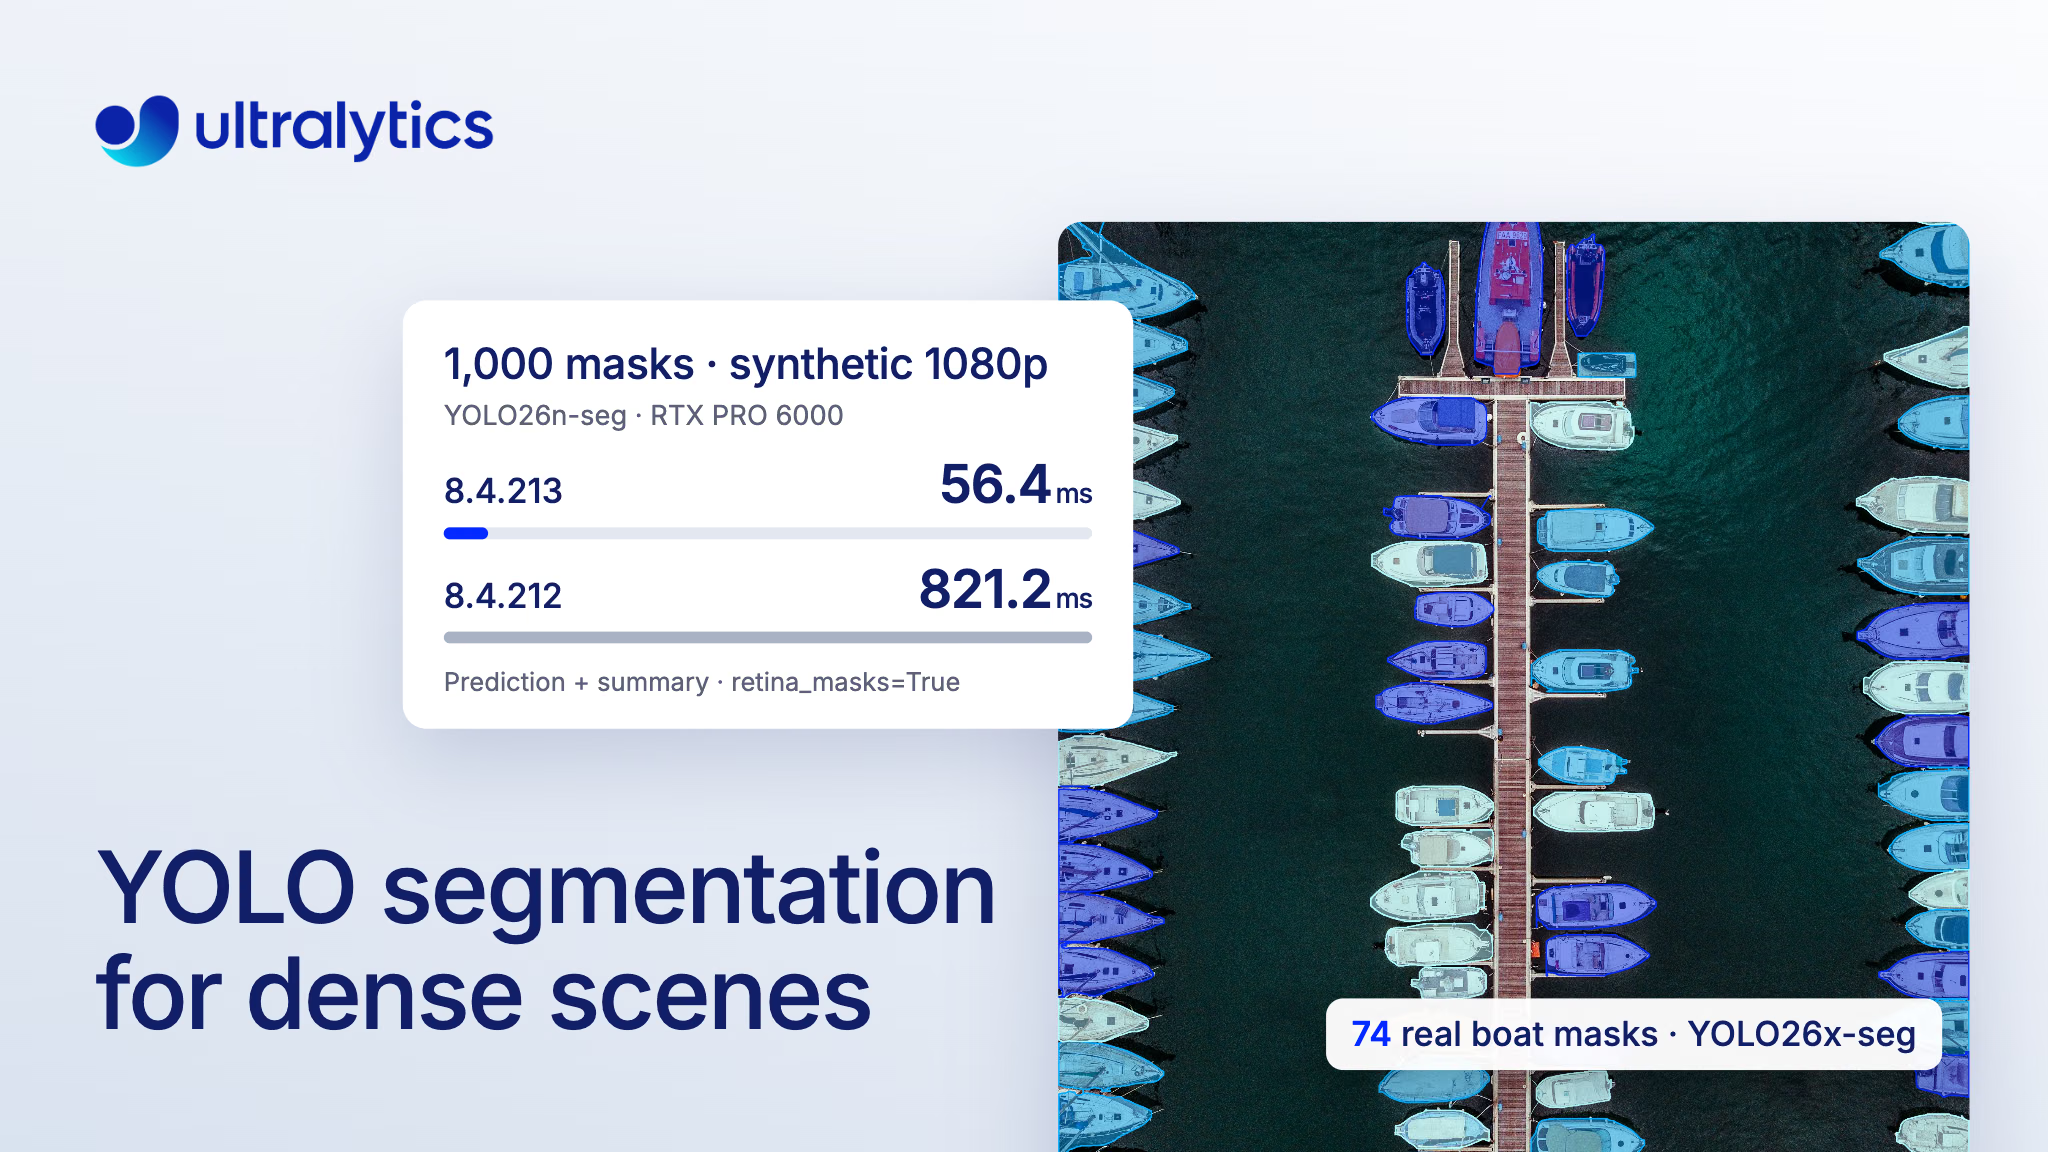
14 Kasım 2026'da yayımlanan Ultralytics 8.4.213, her algılama kutusunun içindeki büyük maske yığınlarını çözümleyerek yoğun sahnelerde YOLO segmentasyonunu hızlandırıyor. Rafları, paketleri, kalabalıkları veya hava görüntülerini segmentlere ayırıyorsan, segmentasyon modelinin nesneleri bulduğu ancak ardından gelen maske adımının zaman ya da bellek yetersizliği nedeniyle tamamlanamadığı noktaya muhtemelen ulaşmışsındır; bu sürüm o noktayı çok daha ileri taşıyor. Sentetik, yoğun biçimde döşenmiş bir 1080p görüntü üzerindeki kıyaslamamızda YOLO26n-seg, RTX PRO 6000 üzerinde 1.000 tam çözünürlüklü örnek maskesini (retina_masks=True), tahmin ve sonuç özetlemesi dahil, 56.4 ms'de ve en yüksek 321 MiB GPU belleği kullanımıyla döndürdü; 8.4.212'de bu değerler 821.2 ms ve 4.291 MiB idi.
Modelin kendisi değişmedi. Değişen şey, YOLO segmentasyonunun model çıktısını maskelere dönüştürme biçimi: büyük maske yığınları artık tüm kare boyunca değil, her nesnenin kutusunun içinde çözümleniyor. Ultralytics Platform üzerinde Tahmin sekmesi ve API, görüntü başına 1.000'e kadar sonuç döndürüyor. Bu yazıda yoğun sahnelerin neden maliyetli olduğunu, 8.4.213 sürümünün neleri farklı yaptığını, ölçülen sonuçları ve 1.000 maskeli tahminleri kendin nasıl çalıştırabileceğini ele alıyoruz.
Yoğun sahnelerde her kutunun dışındaki pikseller için de işlem yapmak gerekiyordu#
Örnek segmentasyonu, her nesneye kendine ait bir maske verir; alanı ölçmek, nesneleri ayırmak veya birbirine değen öğeleri birbirinden ayırt etmek için buna ihtiyaç duyarsın. YOLO segmentasyon modeli, az sayıda ortak prototip maske ve her algılama için birkaç katsayı tahmin eder; ardından son işleme bunları birleştirerek her nesne için bir maske oluşturur.
Şimdiye kadar bu adım, her maskeyi kare boyutunda oluşturuyordu: varsayılan olarak modelin çıkarım boyutunda veya retina_masks=True ya da döşeme kullanıldığında özgün görüntü boyutunda. H x W boyutlarındaki bir karede N nesne için N x H x W boyutunda bir yığın ayırıyor, kırpıyor, filtreliyor ve tarıyordu; oysa her maske kendi sınırlayıcı kutusunun dışındaki her yerde sıfır değerindeydi. Yoğun bir 1080p sahnede, çakışmalar hesaba katıldığında 1.000 kutunun toplam alanı kare alanının yaklaşık iki katı olsa da yığının alanı kare alanının 1.000 katıydı. Maliyet, görüntüdeki kutu sayısı yerine max_det ve görüntü boyutuyla artıyordu.
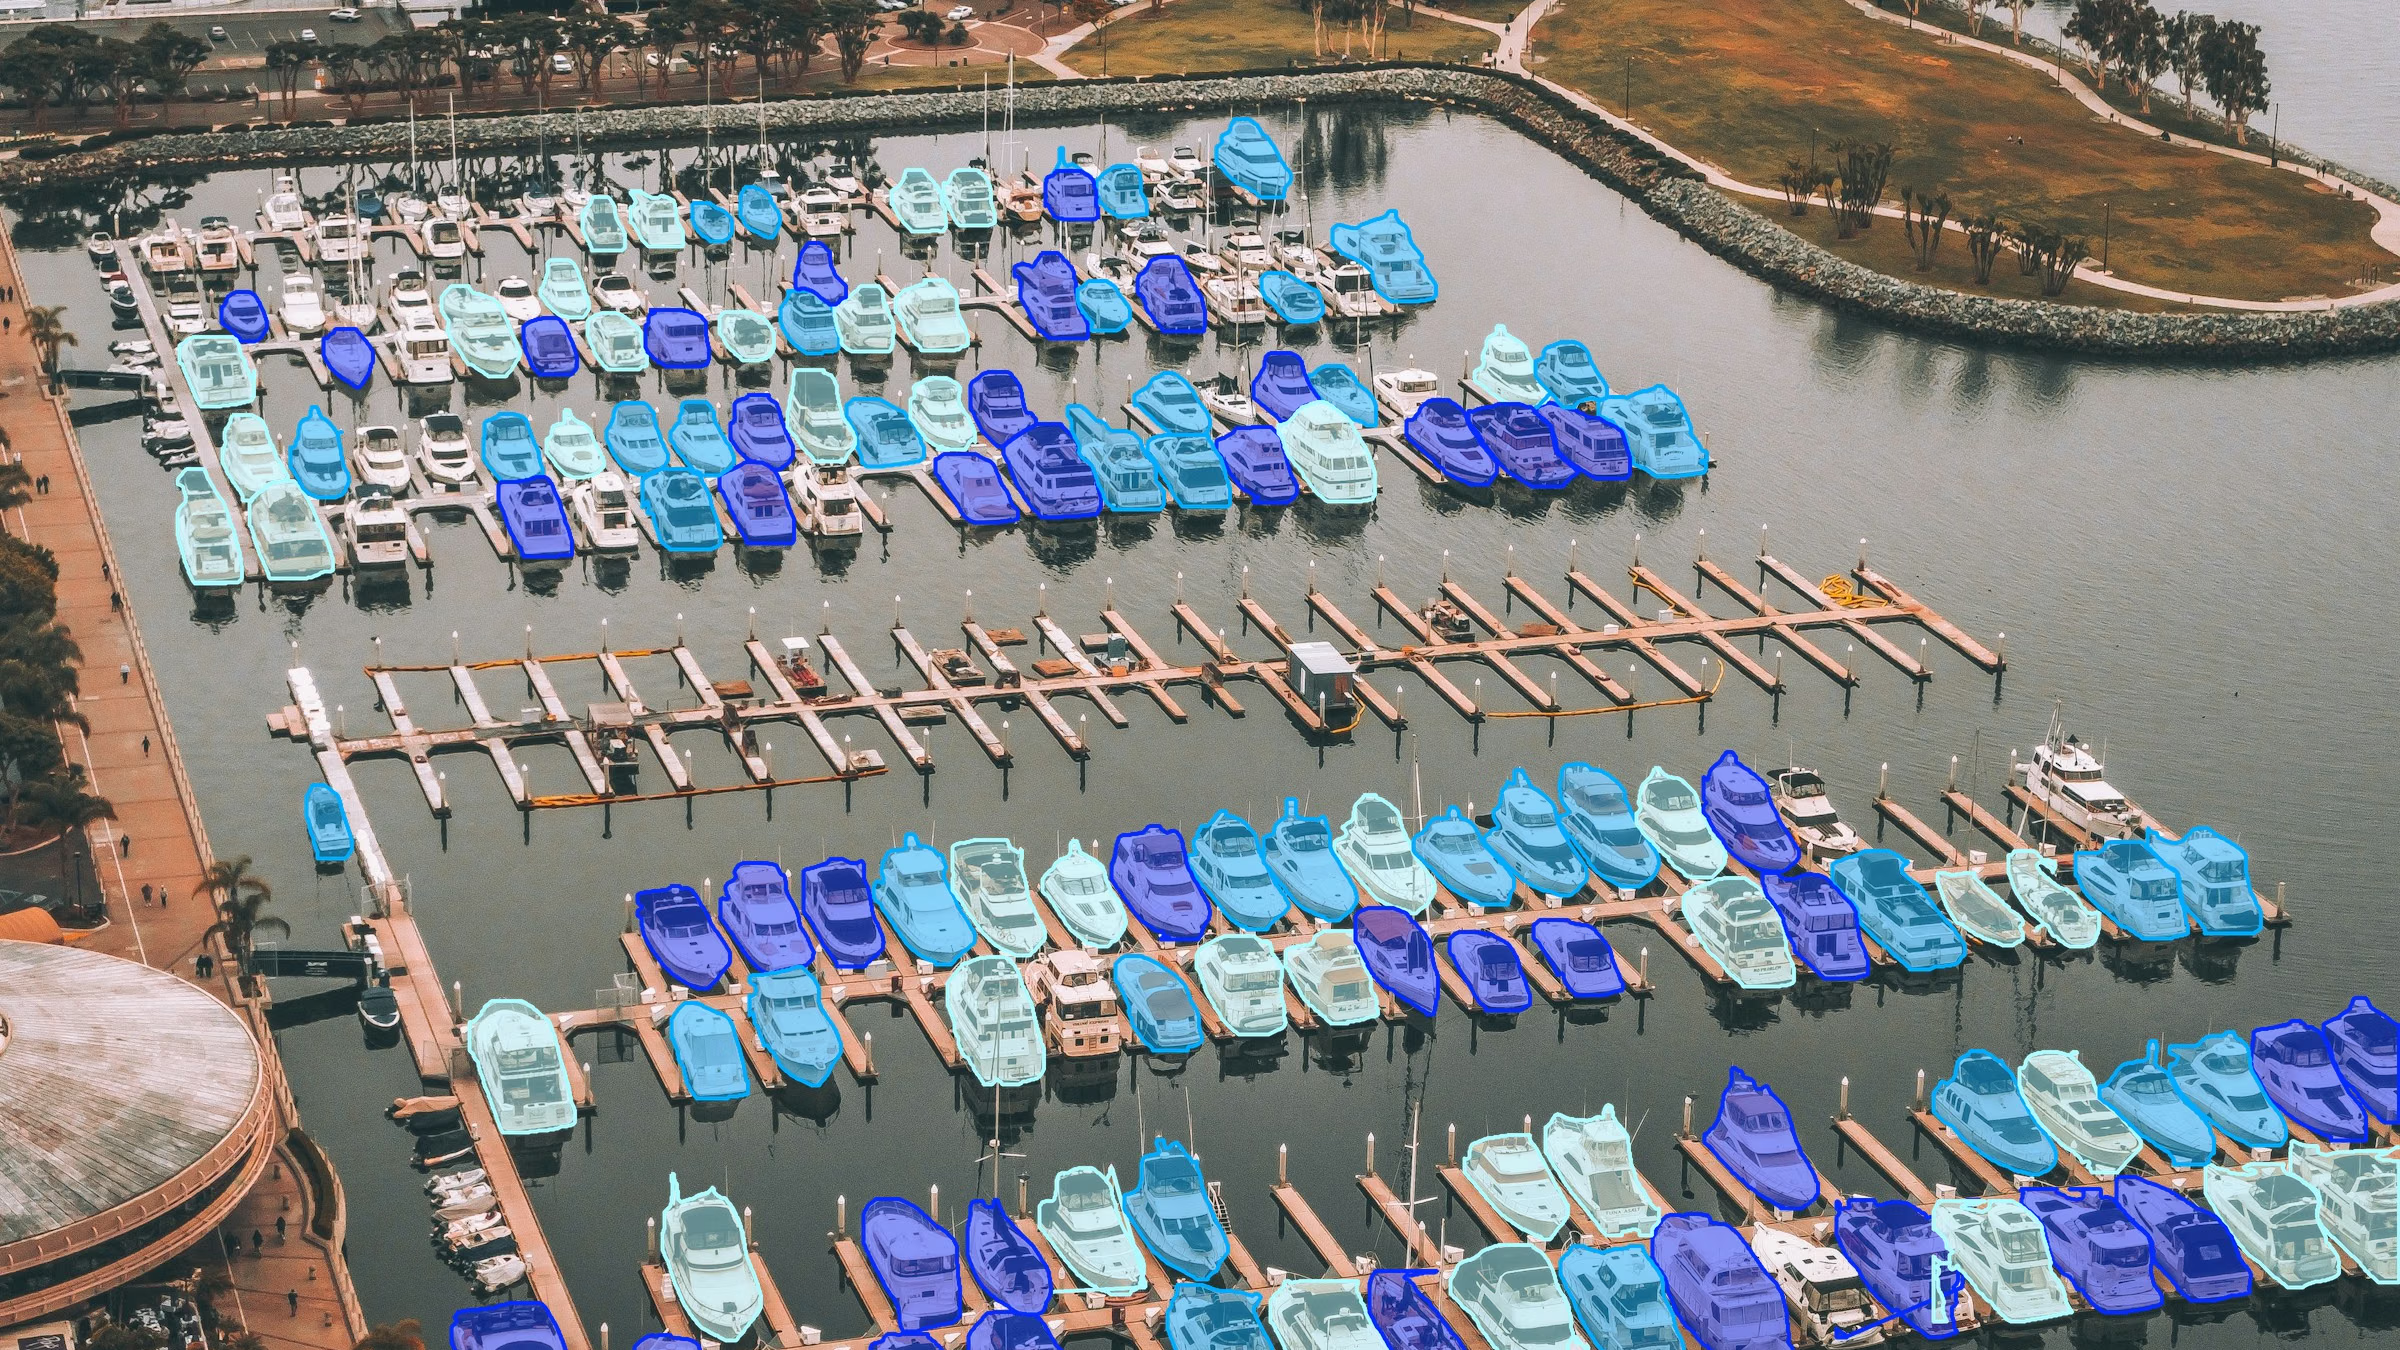
YOLO26x-seg, bu marina fotoğrafında kırpılmış olarak gösterilen 127 tekne maskesi döndürdü (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Fotoğraf: Unsplash.
Bu nedenle max_det değerini varsayılan 300'ün üzerine çıkarmak segmentasyon için kullanışsızdı ve çok sayıda örnek içeren büyük görüntüler belleği tüketebiliyordu. SKU-110K gibi yoğun perakende rafları, paket yığınları ve havadan çekilmiş kareler, 300'den fazla nesne için alana ihtiyaç duyduğun sahnelerdir.
Ultralytics 8.4.213 büyük maske yığınlarını her kutunun içinde çözümlüyor#
PR #27197 ile gelen yeni yol, prototip logitlerini yalnızca her kutunun piksellerinde enterpole eder. PyTorch'un enterpolasyonunun kullandığı örneklemeyle aynı olan ayrılabilir çift doğrusal örneklemeyi kullanır ve benzer boyuttaki kutuları birlikte toplu olarak işler. Büyük yığınlarda çözümleme maliyeti artık kutuların toplam alanına bağlıdır.
Uygulamada üç ayrıntı önemlidir:
- Sabit bir maske yığını boyutu aşıldığında devreye girer. Segmentasyon tahmincisi, yoğun yığın CUDA üzerinde 33.554.432 pikseli veya CPU ve diğer cihazlarda 4.194.304 pikseli aştığında kutu yerel maskeleri kullanır. Daha küçük yığınlarda, az sayıda maske için aynı hızda veya daha hızlı olan mevcut yoğun yol kullanılır.
- Bu yolda dış hatlar doğrudan kutu yerel maskelerden çıkarılır.
masks.xyvemasks.xynher kutu için çokgenleri izler; böylecesummary(),to_json()vesave_txttam yığını oluşturmaz. - Çıktı biçimi değişmedi.
masks.datahâlâ yoğun bir N x H x W tensörü döndürür. Kutu yerel yolunda tensör, ilk kez okuduğunda oluşturulur.
Yoğun tensörü okumak hâlâ bellekte yer ayırmayı gerektirir, ancak PR'da bu maliyetin azaldığı ölçüldü: GPU'da, 1080p çözünürlükte 300 maske için retina_masks=True ile masks.data okuma süresi ve belleği 14,1 ms ve 1.366 MiB'den 9,1 ms ve 795 MiB'ye düştü.
1080p'de 1.000 maske GPU'da 821,2 ms'den 56,4 ms'ye indi#
PR, YOLO26n-seg modelini model.predict(...) ile result.summary() (kutular ve çokgenler) işlemlerinin tamamını çalıştırarak karşılaştırıyor ve her satırda tek bir işlemle yapılan ısınma turlarının medyanını raporluyor. Yoğun sahneler, conf=0.01 ve imgsz=1280 boyutlarında döşenmiş sentetik bir görüntüdür; tipik sahne ise varsayılan ayarlarda, 5 maskeli standart bus.jpg görüntüsüdür. “Önce”, 8.4.212 sürümünü ifade eder. Bunlar genel bir çıkarım hızı ölçümü değil, tahmin ve özetleme işlemlerinin son işlem ağırlıklı ölçümleridir.
| Sahne (GPU, RTX PRO 6000) | Maskeler | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Tipik (bus.jpg) | 5 | Yanlış | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | Yanlış | 118,5 ms, 1.673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | Doğru | 248,7 ms, 1.366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | Doğru | 821,2 ms, 4.291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | Doğru | 1.352,1 ms, 7.070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | Doğru | 4.323,1 ms, 23.305 MiB | 130,7 ms, 258 MiB |
Süre ve GPU tepe belleği; CUDA 13.2 ile PyTorch 2.15.0. Kaynak: PR #27197.
Tasarıma uygun olarak, tipik beş maskeli görüntü değişmedi. Kazançlar, eski yığının büyüdüğü durumlarda ortaya çıkıyor ve daha önce en maliyetli durum olan tam çözünürlüklü maskelerde en yüksek seviyeye ulaşıyor.
Büyük görüntüler belleğin çok daha azını kullanıyor#
4000 x 3000 piksel boyutunda ve tahmin edilen 1.000 maskeli görüntüde eski yol, GPU belleğini en fazla 23.305 MiB'ye çıkardı. Yeni yol 258 MiB'ye ulaştı ve 4.323,1 ms yerine 130,7 ms'de tamamlandı. Bu azalma, 12 megapiksellik drone, uydu ve denetim kareleriyle çalışırken işlem hattının geri kalanı için daha fazla GPU belleği bırakıyor.
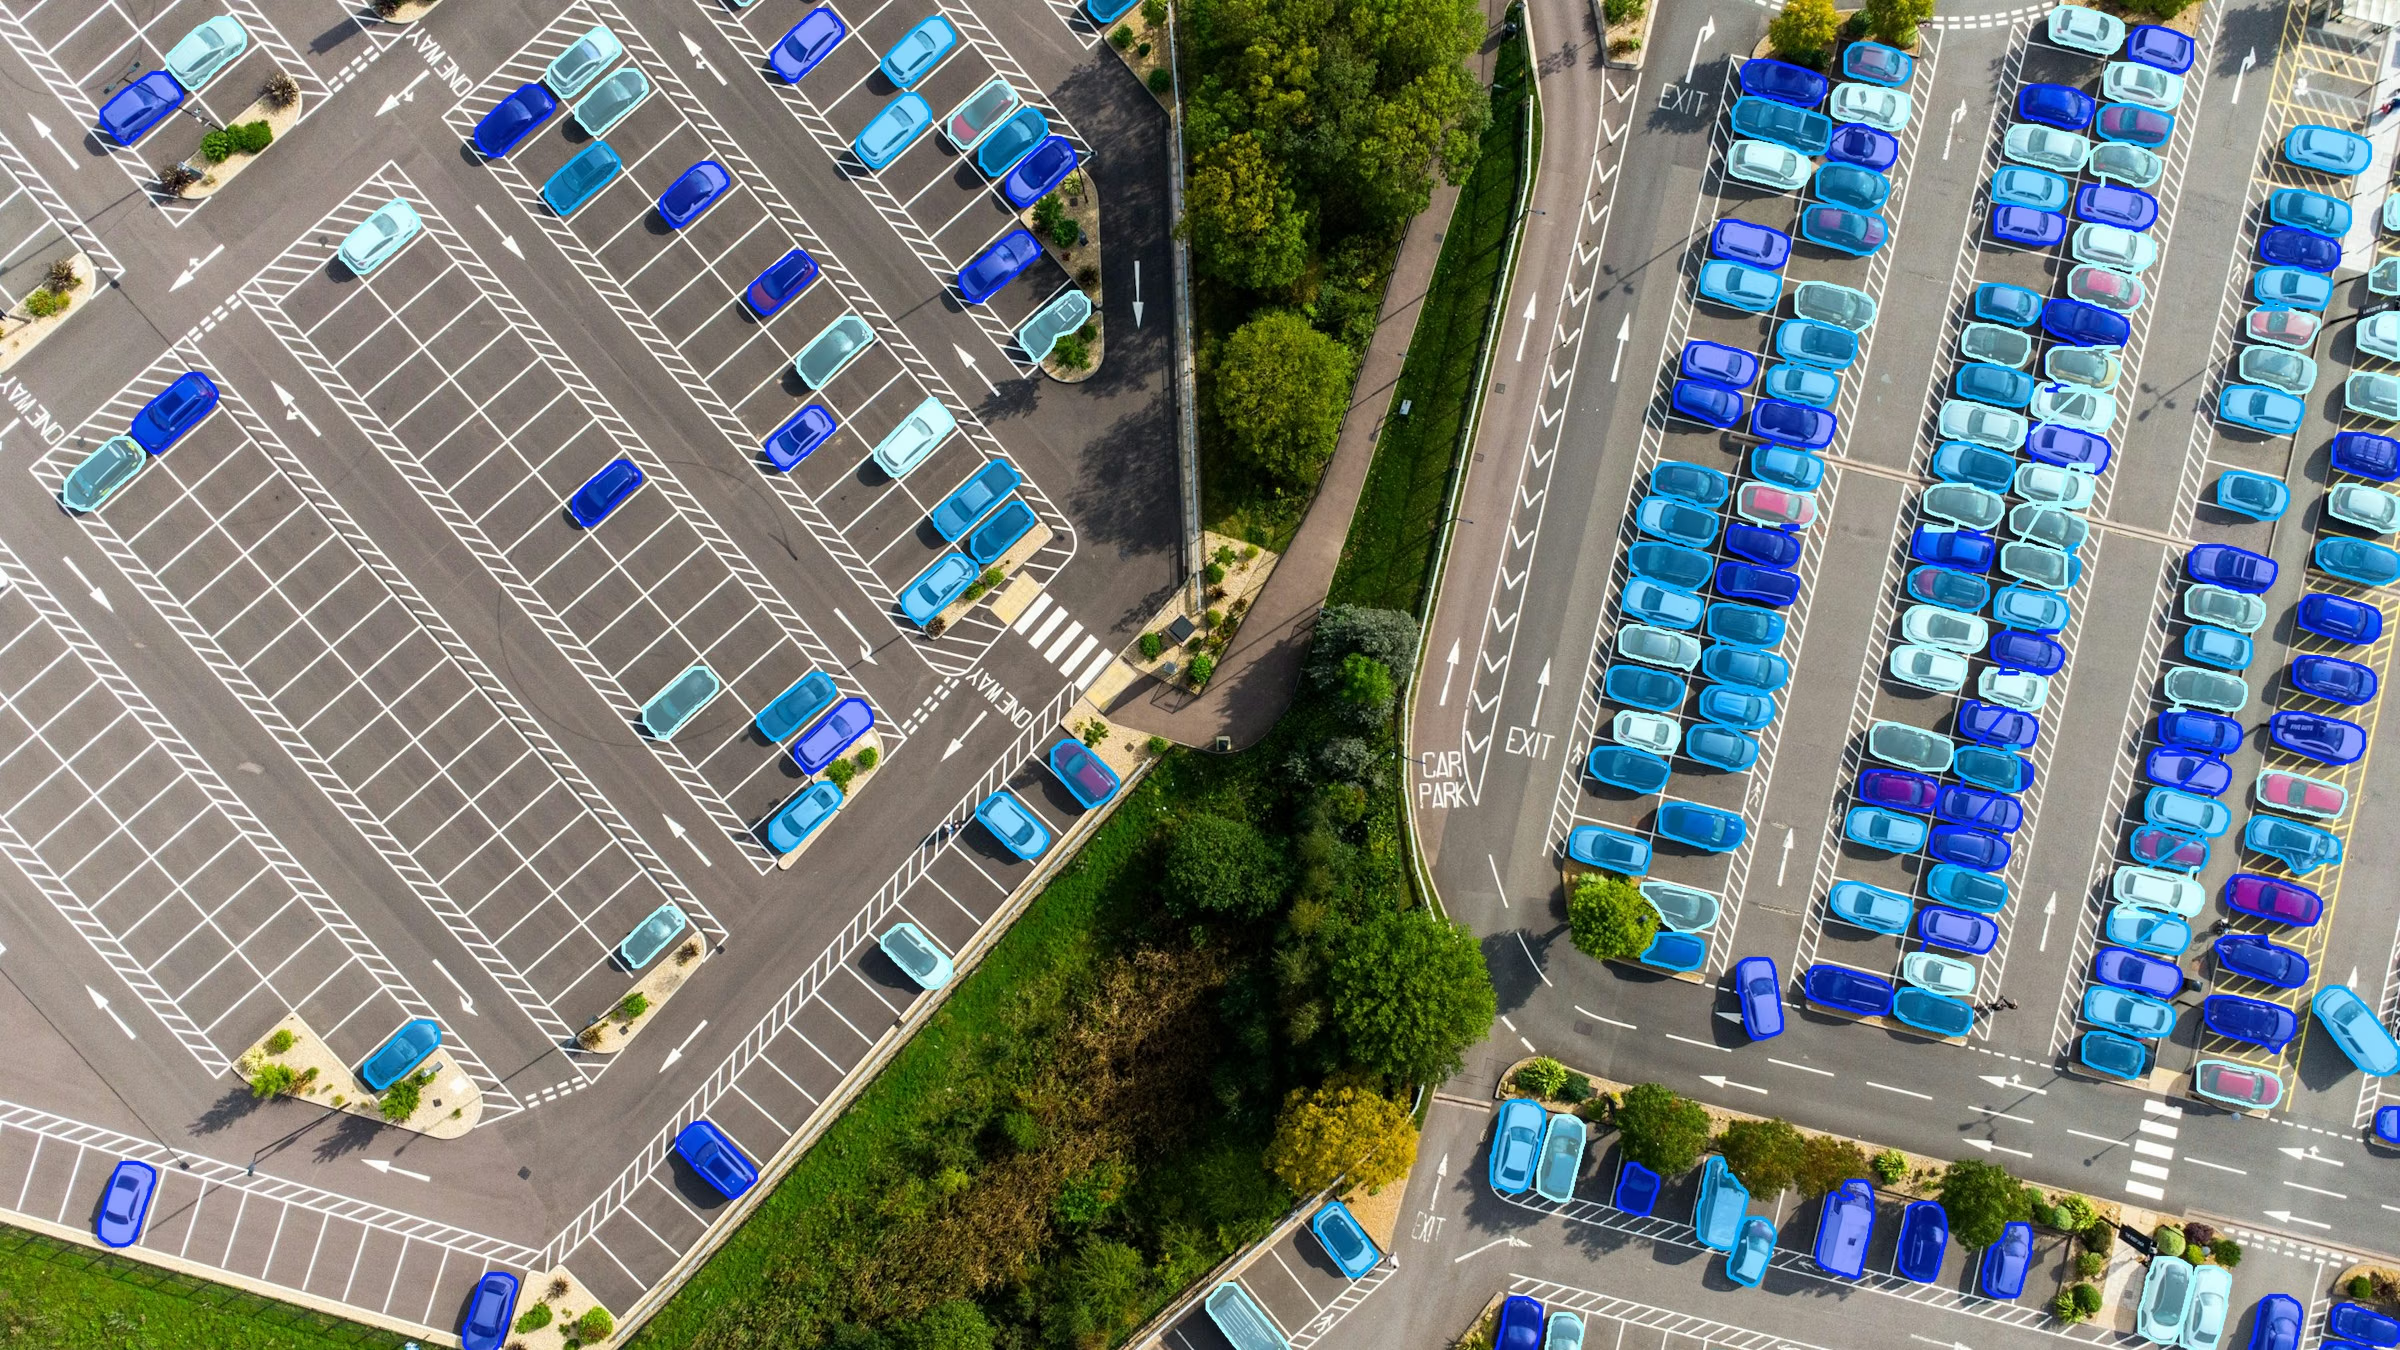
YOLO26x-seg, bu havadan çekilmiş karede 222 araç maskesi döndürdü (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Fotoğraf: Unsplash.
CPU tahminleri de çok hızlanıyor#
8 iş parçacıklı bir Linux x86 CPU'da, herhangi bir maske oluşturulmadan önce süreç yaklaşık 840 MiB bellek kullanıyor. 1080p çözünürlükte 1.000 tam çözünürlüklü maske için süreç belleğinin tepe değeri 5.217 MiB'den 1.072 MiB'ye düştü; süre de aşağıda gösterildiği gibi azaldı.
1920 x 1080 boyutunda 300 ve 1.000 maske ile 4000 x 3000 (12MP) boyutunda 300 maske. YOLO26n-seg, tahmin ve özetleme; önce 8.4.212, sonra 8.4.213. Kaynak: PR #27197.
Maskeler 8.4.212 ile eşleşiyor; bir modda kenarlarda küçük farklar var#
Daha hızlı bir yol, ancak aynı sonucu veriyorsa işe yarar. PR, YOLO26n-seg ve YOLO11n-seg kullanarak 96 tahmin üzerinde 8.4.213'ü 8.4.212 ile karşılaştırdı: iki görüntü, altı boyut, conf için 0,25 ve 0,01 değerleri, her iki maske modu ve zorla etkinleştirilen kutu yerel yolu:
- Varsayılan maskeler (
retina_masks=False): kutular, maskeler ve çokgenler aynı; 7,6 milyon maske pikselinin 0'ı farklı. - Tam çözünürlüklü maskeler (
retina_masks=True): eski kodun bir kez enterpolasyon yaptığı durumlarda tamamen aynı. Diğer görüntü şekillerinde maske piksellerinin %0,07'si (24,8 milyon pikselin 18.105'i) farklıdır ve bunların tümü maske kenarlarındadır; çünkü eski kod bu piksellerde iki kez enterpolasyon yaparken yeni kod prototipleri tam koordinatta bir kez örnekler. - Apple MPS: 179 maskeli yoğun bir 1080p sahnede, her iki maske modunda da maskeler, kutular ve çokgenler aynı.
Python'da görüntü başına 1.000 nesne nasıl segmente edilir#
pip install -U ultralytics (8.4.213 veya üzeri) sürümüne yükselt, ardından max_det değerini varsayılan 300'ün üzerine çıkar. Kodunun geri kalanı aynı kalır.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # COCO sınıfları; raflar veya paketler için kendi eğittiğin modeli yükle
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # Her nesne için özgün görüntü piksellerinde bir (P, 2) dizisi
rows = r.summary()  # Kutular ve çokgenler
max_det bir hedef değil, üst sınırdır: döndürülen nesne sayısı yine modele, görüntüye ve güven eşiğine bağlıdır. Bu değişiklikten en iyi şekilde yararlanmak için:
- Mümkün olduğunda dış hatları oku.
masks.xy(piksel) vemasks.xyn(normalize edilmiş) değerleri, büyük yığın yolundato_json()vesave_txtgibi kutu yerel maskelerden elde edilir. Results başvuru belgesi tüm öznitelikleri listeler. - Doğrudan piksel işlemleri için
masks.datadeğerini oku. Alanları ve çakışmaları yoğun tensör üzerinde hesaplamak en kolay yoldur; nesne kesitlerimasks.xykonturlarından da elde edilebilir. Akademi dersimiz, kodda maske kullanmayı ve her görünümün ne zaman kullanılacağını gösterir; nesne yalıtımı kılavuzumuz ise konturlardan nesne kesitleri oluşturur. - Kaynak çözünürlükte maskelere ihtiyacın varsa
retina_masks=Truedeğerini kullan. 1080p GPU kıyaslamasında, 300 maske için bu ayar artık 18,0 ms sürüyor; varsayılan maskeler ise 16,3 ms sürüyor. Çok büyük karelerdeki küçük nesneler için görüntü döşemeyle küçük nesne algılama yazımıza ve yüksek çözünürlüklü döşeme kılavuzumuza bak. Döşemeli tahmin, kaynak boyutunda maskeler döndürdüğünden döşemeli bir çalıştırmada da özgün görüntüyle orantılı bellek gerekir. - Kalabalık sahneler için
confveioudeğerlerini ayarla.max_detdeğerini artırmak,confeşiğini zaten geçen algılamaların daha fazlasını tutar;confdeğerini düşürmek ise güveni daha düşük olanları da kabul eder. Tahmin ayarlarıconf,iouvemax_detkonularını açıklar; NMS IoU eşiği kılavuzumuz ise birbirine değen nesnelerin nasıl ele alınacağını anlatır.
Değişiklik Python son işlem aşamasında yer alır; bu nedenle PyTorch modeli ve Ultralytics predict API'si üzerinden çalıştırılan dışa aktarılmış modeller için geçerlidir. PR'da YOLO26n-seg ve YOLO11n-seg test edildi; aynı son işleme, birleştirilmiş 2,7 milyon parametreli YOLO26n-seg'den 62,8 milyon parametreli YOLO26x-seg'e kadar tüm YOLO26 ve YOLO11 segmentasyon modellerinde kullanılır. Kendi yoğun verilerin üzerinde model eğitmek için örnek segmentasyonu amacıyla YOLO26'yı özel verilerle eğitme kılavuzumuzu izle.
Ultralytics Platform artık görüntü başına 1.000'e kadar sonuç döndürüyor#
Aynı üst sınır artık Ultralytics Platform için de geçerli. Bir modelin Tahmin sekmesi görüntü başına 1.000'e kadar sonuç döndürüyor; arka plandaki REST API de aynı şekilde çalışıyor. RT-DETR modelleri, kod çözücülerindeki sorgu sayısı olan 300 ile sınırlı istisnadır.
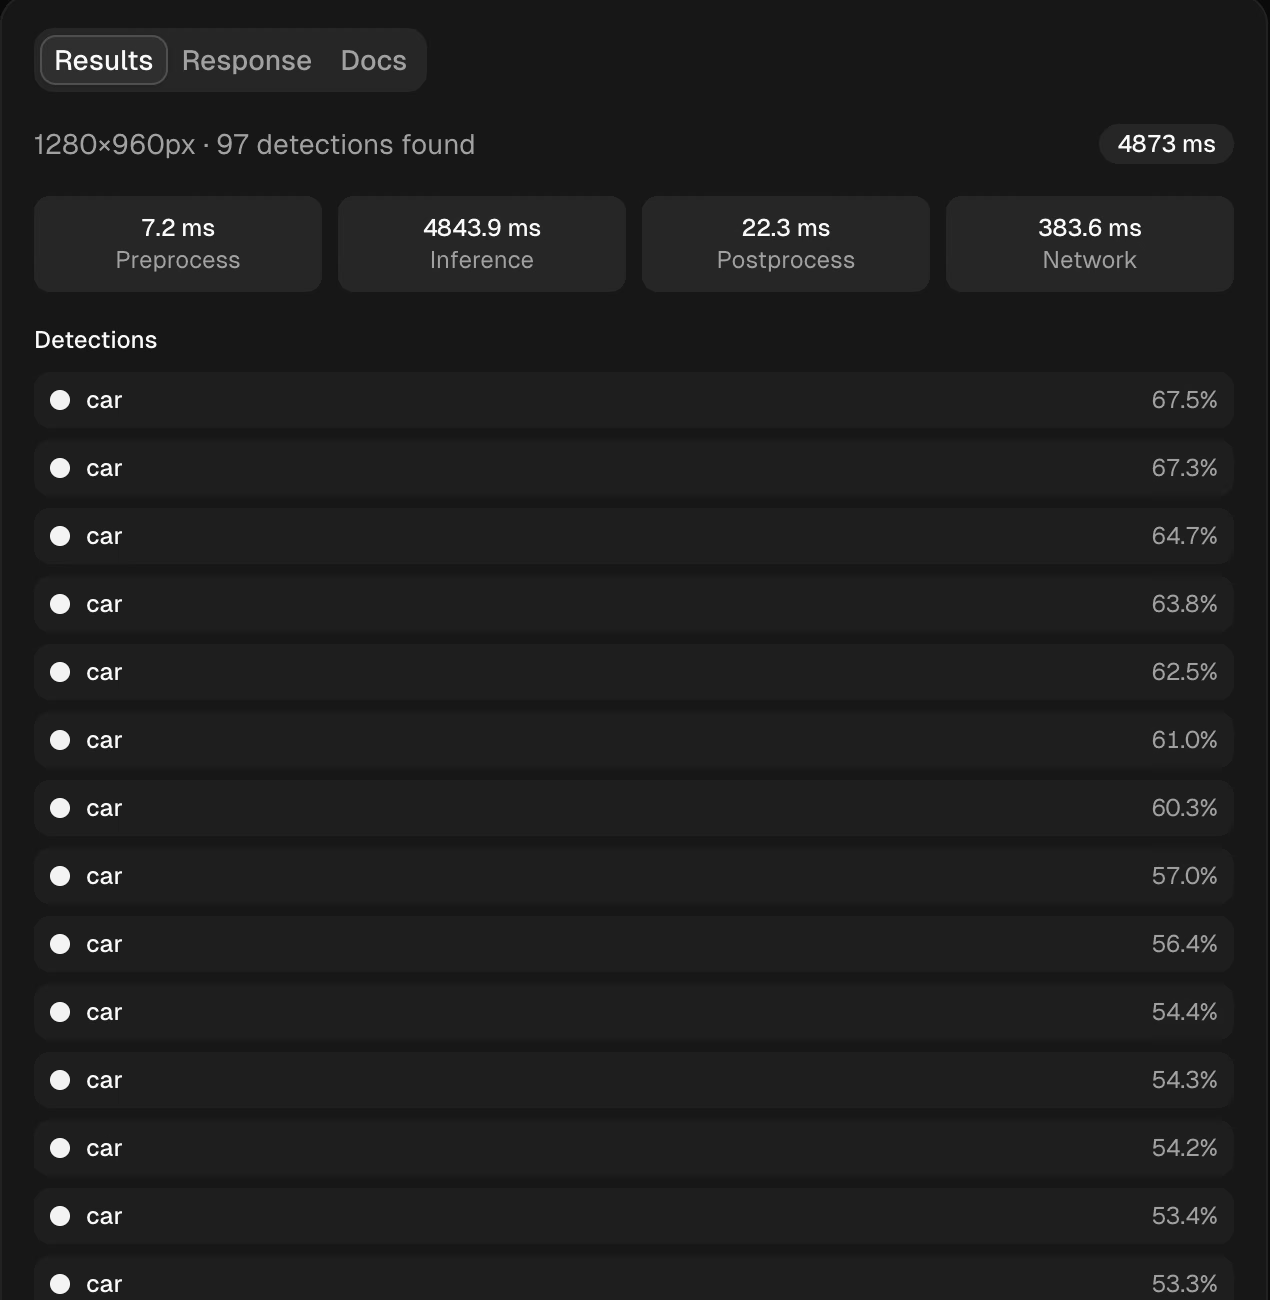
Yukarıdaki havadan çekilmiş fotoğrafta 97 araç algılamasını listeleyen, görüntü boyutu 1280 olan YOLO26x-seg Tahmin sekmesi. Platform çıkarım belgeleri paneli ayrıntılı biçimde açıklar.
Sonuç paneli, uzun listeler için tasarlandı. 10'dan fazla sonuç varsa görüntüde nesneleri kapatmaması için etiketler olmadan kutular gösterilir, listede her sonuç adlandırılır ve büyütülmüş görüntüde etiketler korunur. Nesnesini vurgulamak için bir satırın veya satırını bulmak için bir nesnenin üzerine gel.
Kendi verilerinde denemek için Package-Seg paket segmentasyonu veri kümesini temel al, bulutta eğit ve sonucu Tahmin sekmesinde veya özel bir uç nokta üzerinden çalıştır.
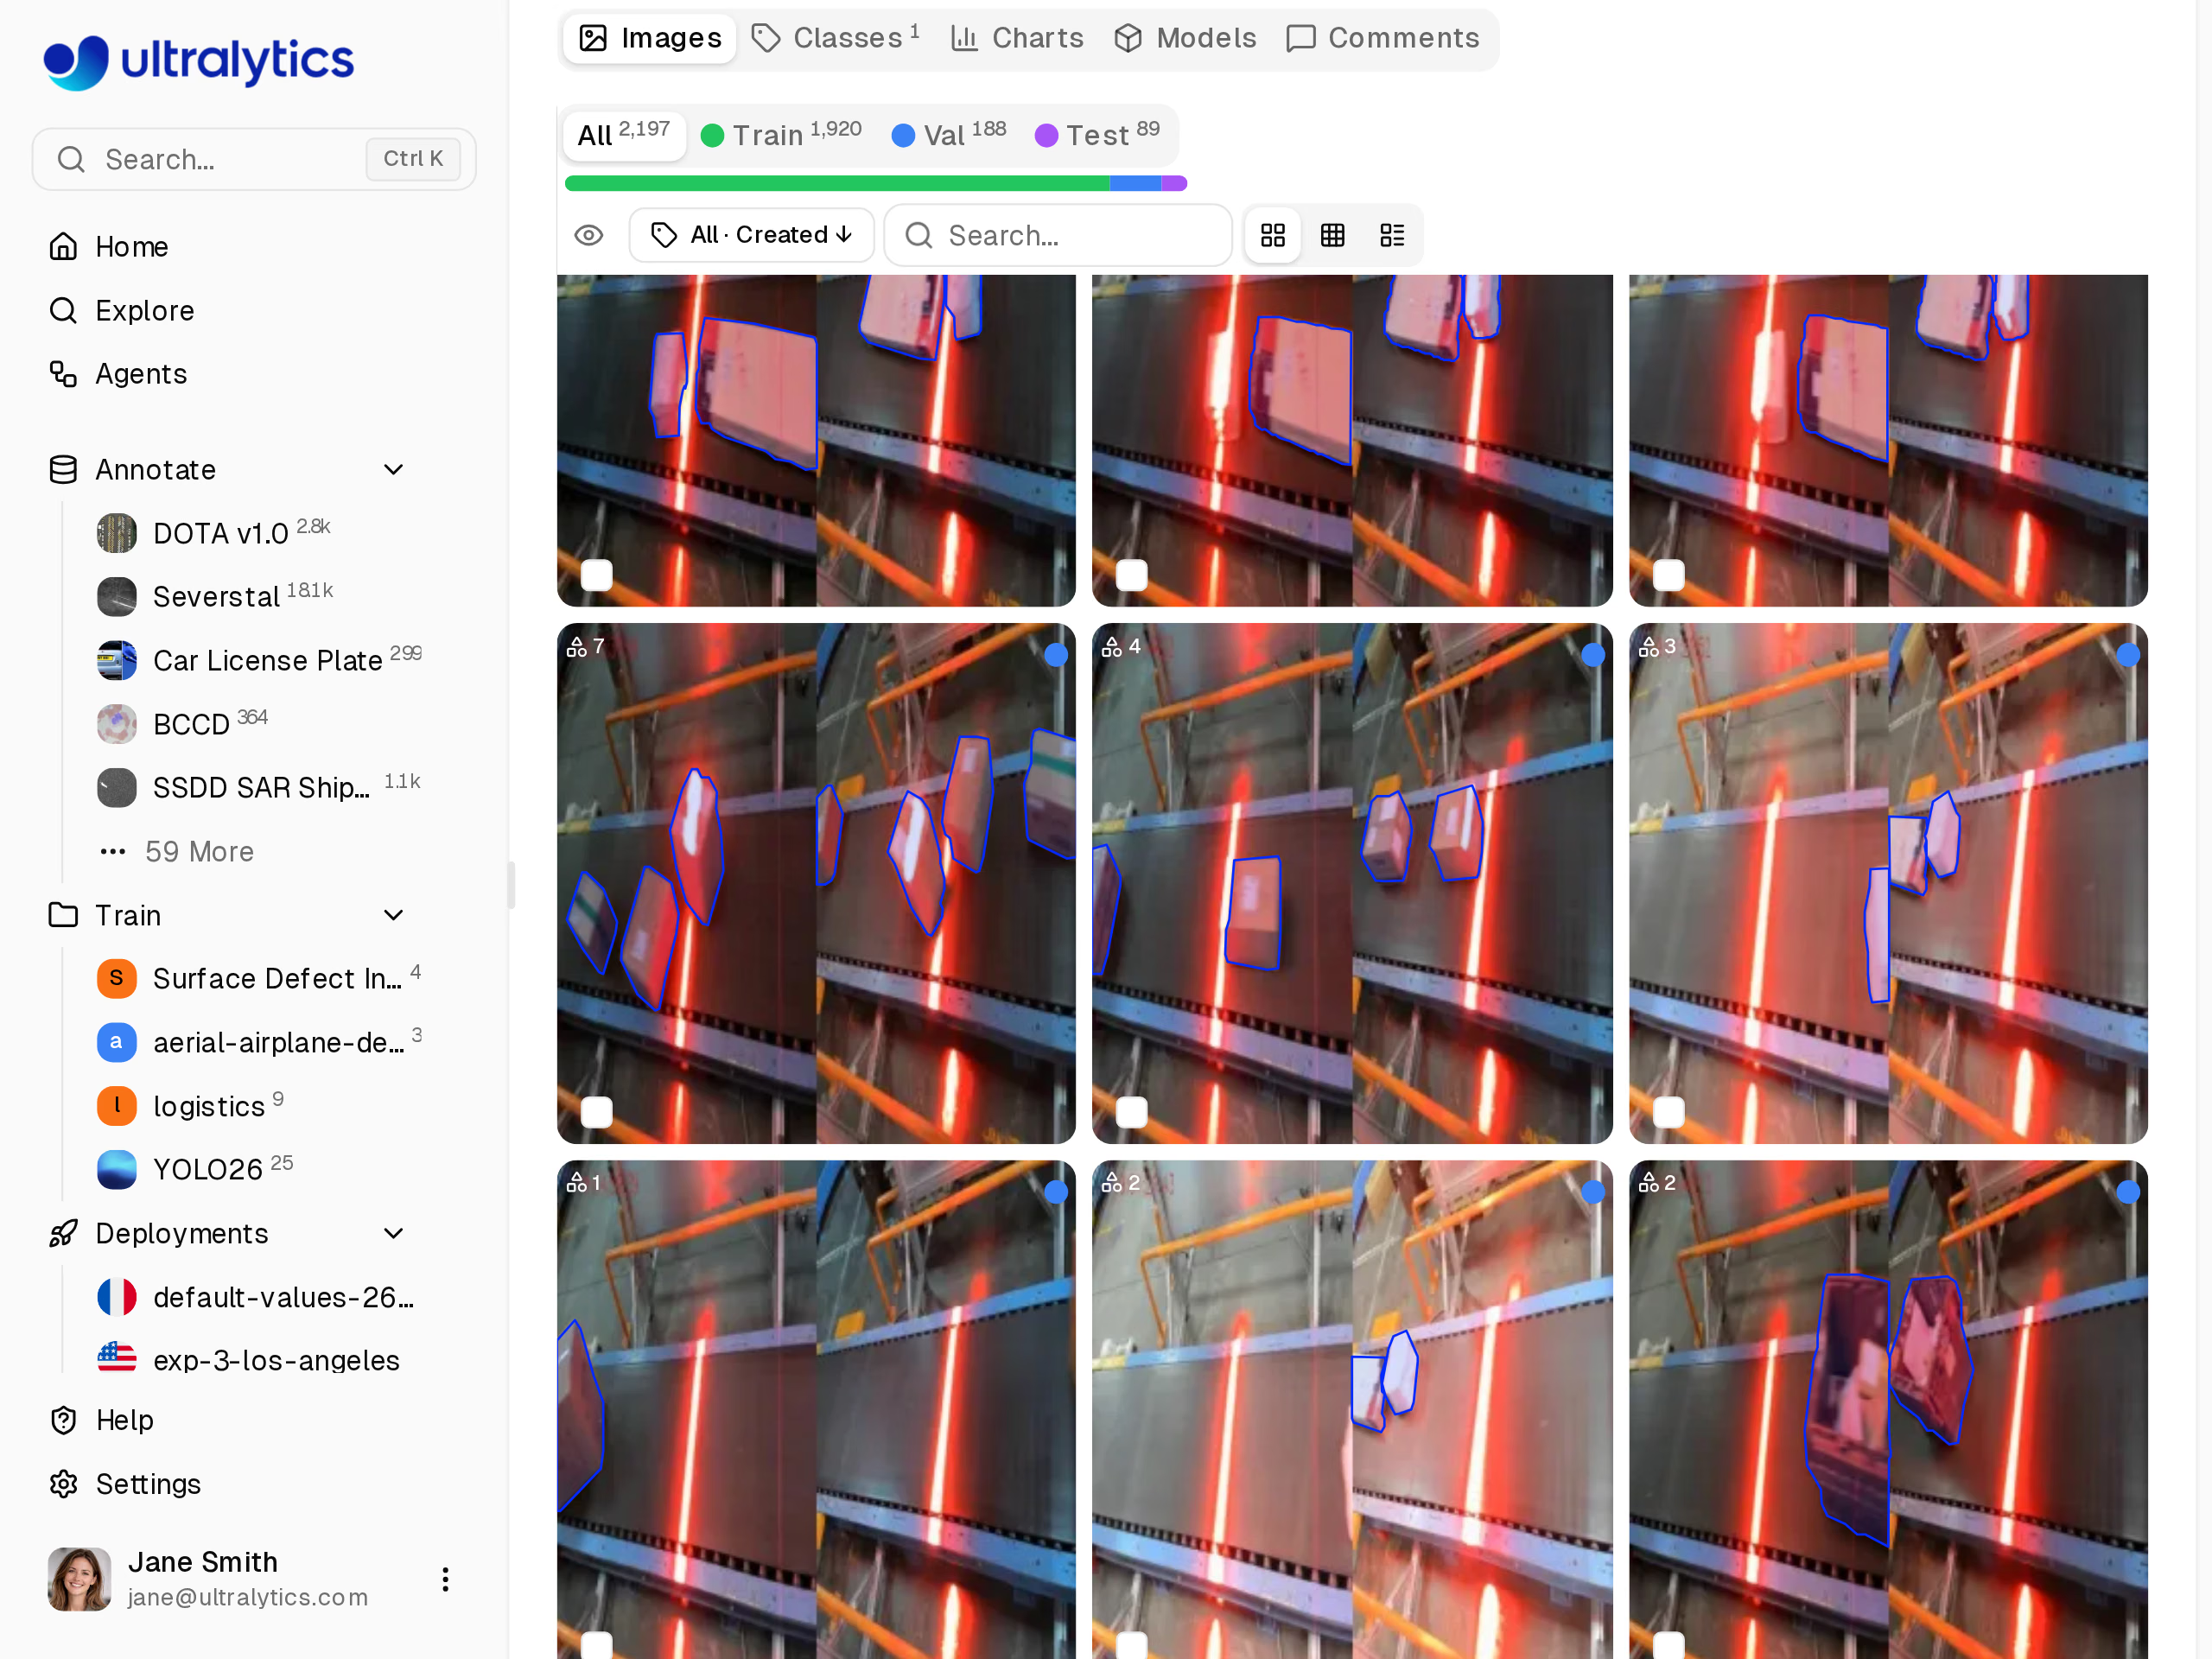
Lojistik segmentasyonu için kullanıma hazır bir başlangıç noktası olan, Ultralytics Platform üzerindeki Package-Seg veri kümesi.
Kimler yükseltmeli#
Kalabalık sahneleri veya büyük görüntüleri segmentlere ayırıyorsan hemen yükselt: perakende rafları, paket tasnifi, havadan ve drone ile yapılan ölçümler, hücre mikroskopisi veya belleği aşmamak için max_det değerini sınırladığın, görüntü boyutunu küçülttüğün ya da retina_masks değerini düşürdüğün her durum. Bu geçici çözümleri artık yeniden değerlendirebilirsin.
Maske yığınların eşik değerinin altında kalıyorsa mevcut yoğun yol kullanılmaya devam eder; eşik nesne sayısı ile görüntü boyutunun çarpımına bağlı olduğundan, çok büyük bir görüntüde yalnızca birkaç maske olsa bile eşiğin aşılabileceğini unutma. İşlem hattın her zaman masks.data değerini okuyorsa yoğun tensör yine oluşturulur; ancak PR'ın 1080p GPU testinde 300 maske için bu işlem öncekinden daha az zaman ve bellek kullandı. Örnek maskelerine gerçekten ihtiyacın olup olmadığını gözden geçirmek için semantik ve örnek segmentasyonu yazısına bak.
Sık sorulan sorular
YOLO segmentasyonu, Ultralytics YOLO içindeki örnek segmentasyonu görevidir: model her nesne için bir sınıf, kutu, güven puanı ve piksel maskesi döndürür. YOLO26 segmentasyon modelleri YOLO26n-seg'den YOLO26x-seg'e kadar beş boyutta sunulur; COCO'nun 80 sınıfıyla önceden eğitilmiştir ve kendi verilerinle ince ayar yapmaya hazırdır.
max_detüst sınırı belirler; varsayılan değer 300'dür. Döndürülen sayı ayrıca modele, görüntüye ve güven eşiğine bağlıdır. 8.4.213 sürümünden itibaren kıyaslama testindekiler gibi iş yüklerinde 1.000'lik bir üst sınır uygulanabilir: sentetik bir 1080p görüntüde YOLO26n-seg, RTX PRO 6000 üzerinde 321 MiB tepe bellek kullanarak 1.000 tam çözünürlüklü maskeyi 56,4 ms'de tahmin edip özetledi. Ultralytics Platform görüntü başına 1.000'e kadar sonuç döndürür.Önceki sürümler her maskeyi kare boyutunda oluşturduğundan bellek, nesne sayısı ile kare alanının çarpımı kadar artıyordu. Sentetik 4000 x 3000 kıyaslama testinde, 1.000 tam çözünürlüklü maskeyle GPU belleği en fazla 23.305 MiB'ye ulaştı. 8.4.213 sürümü büyük yığınları her kutunun içinde çözümlüyor ve aynı durumda bellek kullanımını en fazla 258 MiB'ye çıkarıyor.
ultralyticssürümünü 8.4.213 veya üzerine yükselt; büyük maske yığınlarında kutu yerel yol otomatik olarak devreye girdiği için başka bir kod değişikliği gerekmez.masks.dataaynı yoğun biçimi korur, bu yüzden mevcut kodun çalışmaya devam eder; bu yoldamasks.xyokumak veyasummary()çağırmak yerine bunları kullanmak, yoğun tensörün oluşturulmasını önler.retina_masks=True, modelin çıkarım boyutu yerine maskeleri özgün görüntü çözünürlüğünde döndürür; böylece yoğun maske özgün görüntüyle hizalanır. Sentetik bir 1080p görüntüde 300 maske için, bu ayar açıkken YOLO26n-seg tahmini ve özetlemesi RTX PRO 6000 üzerinde 8.4.212 sürümünde 248,7 ms, 8.4.213 sürümünde ise 18,0 ms sürdü.
Yazan
Kurucu ve CEO · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









