Phân đoạn Ultralytics YOLO trong cảnh dày đặc: 1.000 mask
Trong Ultralytics 8.4.213, YOLO26n-seg dự đoán và tổng hợp 1.000 mask trên ảnh 1080p tổng hợp trong 56.4 ms trên RTX PRO 6000, giảm từ 821.2 ms.
 Glenn Jocher14 phút đọc
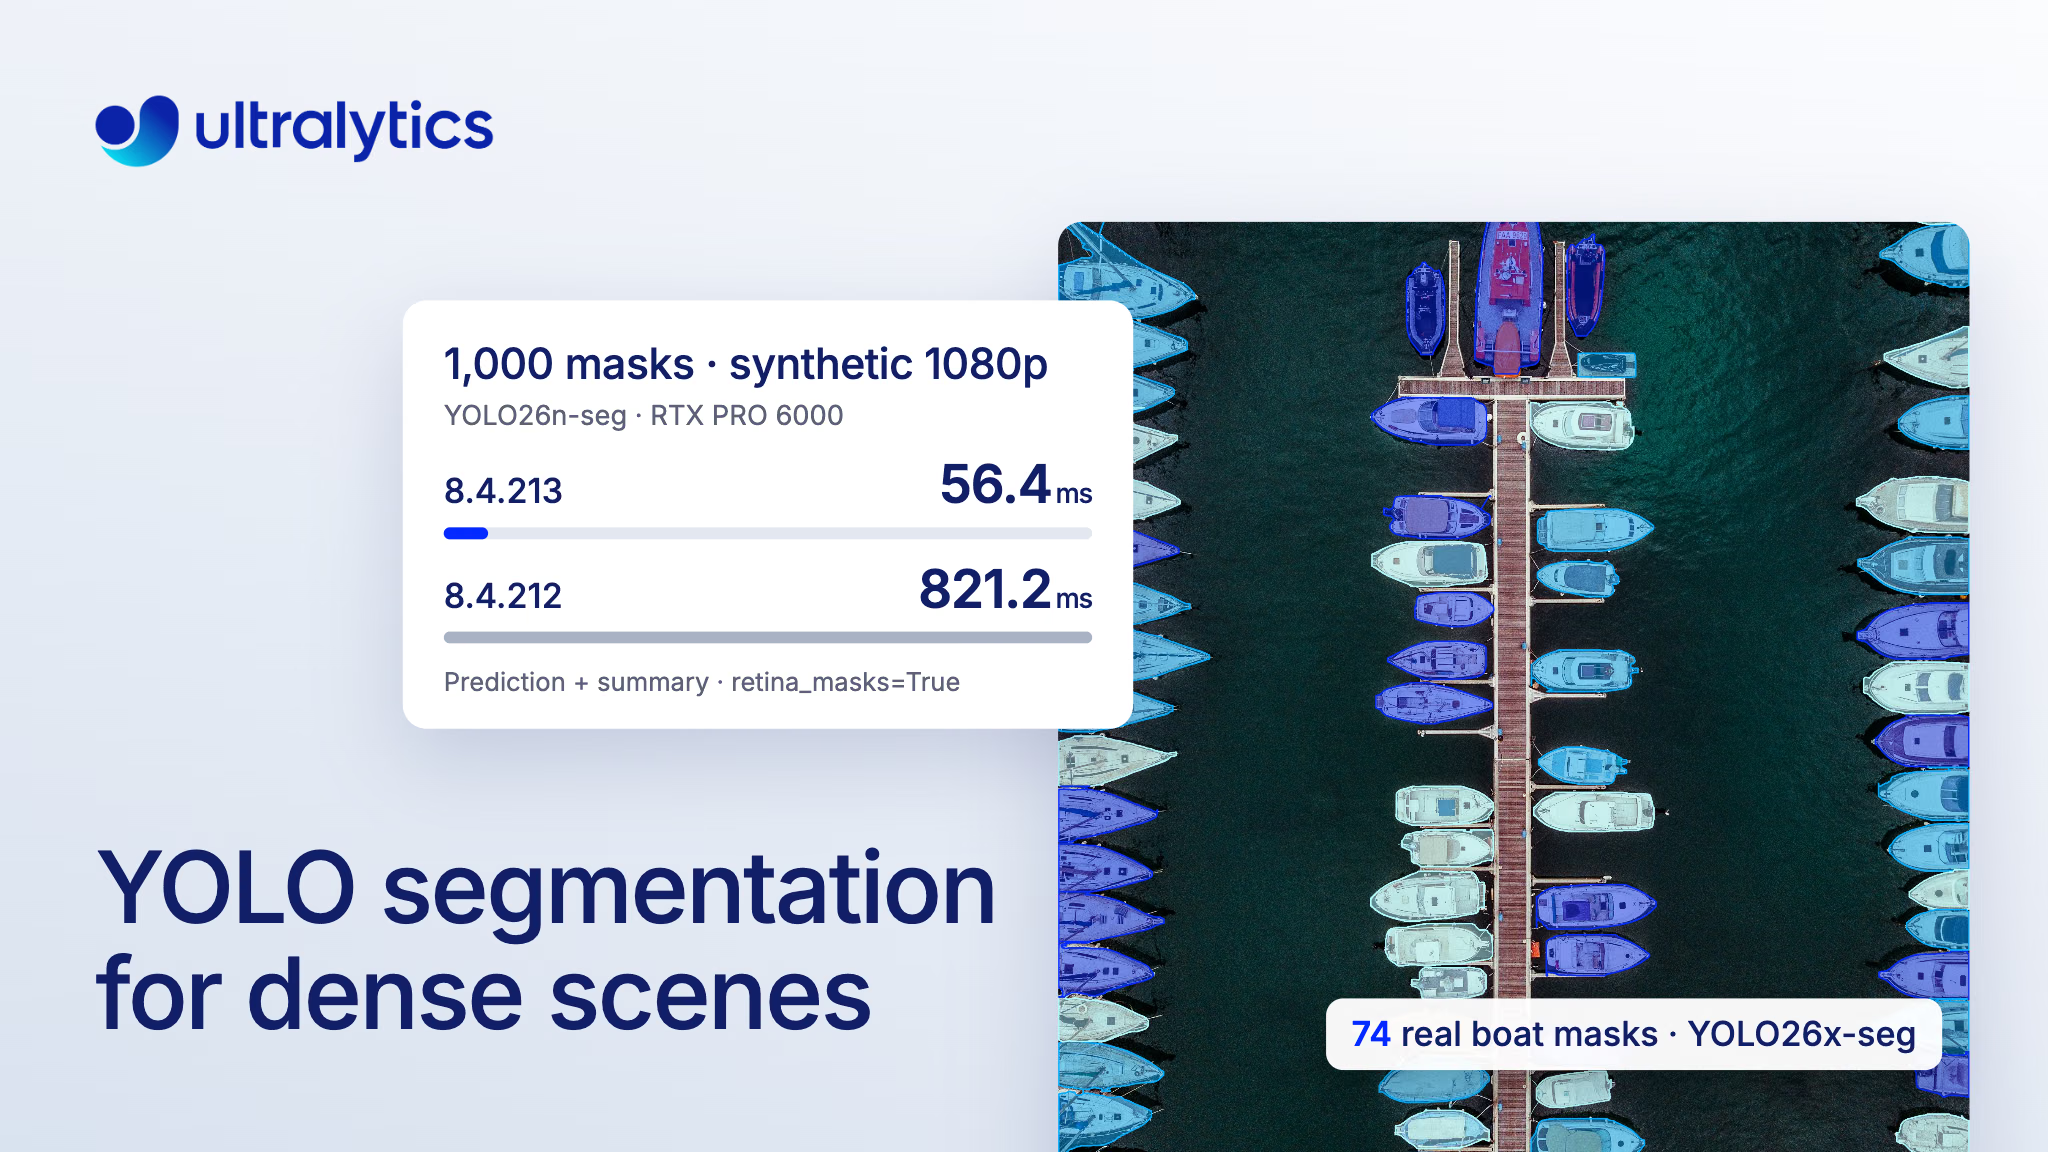
Ultralytics 8.4.213, phát hành ngày 14 tháng 11 năm 2026, tăng tốc phân đoạn YOLO trong cảnh dày đặc bằng cách giải mã các cụm mask lớn bên trong từng bounding box phát hiện. Nếu bạn phân đoạn kệ hàng, bưu kiện, đám đông hoặc ảnh chụp từ trên không, có lẽ bạn đã gặp tình huống model phân đoạn tìm thấy vật thể nhưng bước xử lý mask tiếp theo lại thiếu thời gian hoặc bộ nhớ; bản phát hành này giúp đẩy giới hạn đó xa hơn đáng kể. Trong benchmark trên ảnh 1080p tổng hợp được chia ô dày đặc, YOLO26n-seg trả về 1.000 mask instance độ phân giải đầy đủ (retina_masks=True), với thời gian gồm dự đoán và tổng hợp kết quả là 56.4 ms, đồng thời sử dụng tối đa 321 MiB bộ nhớ GPU trên RTX PRO 6000; giảm từ 821.2 ms và 4,291 MiB ở phiên bản 8.4.212.
Bản thân model không thay đổi. Điều thay đổi là cách YOLO segmentation chuyển đầu ra của model thành mask: các stack mask lớn giờ được giải mã bên trong box của từng đối tượng thay vì trên toàn bộ khung hình. Trong Ultralytics Platform, tab Predict và API trả về tối đa 1.000 kết quả mỗi ảnh. Bài viết này giải thích vì sao các cảnh dày đặc tốn nhiều tài nguyên, 8.4.213 xử lý khác đi như thế nào, các kết quả đo được và cách tự chạy dự đoán 1.000 mask.
Trước đây, các cảnh dày đặc phải xử lý cả những pixel nằm ngoài mọi box#
Instance segmentation tạo mask riêng cho từng đối tượng, cần thiết để đo diện tích, tách đối tượng hoặc phân biệt các vật thể chạm nhau. Model YOLO segmentation dự đoán một tập nhỏ các mask prototype dùng chung cùng một vài hệ số cho mỗi detection, sau đó bước hậu xử lý kết hợp chúng thành một mask cho mỗi đối tượng.
Cho đến nay, bước này tạo mỗi mask ở kích thước khung hình: mặc định là kích thước inference của model, hoặc kích thước ảnh gốc khi dùng retina_masks=True hoặc tiling. Với N đối tượng trên khung hình H x W, hệ thống cấp phát, crop, lọc và quét một stack N x H x W, dù mỗi mask đều bằng 0 bên ngoài bounding box của nó. Trong cảnh 1080p dày đặc, tổng diện tích của 1.000 box, tính cả phần chồng lấn, xấp xỉ gấp đôi diện tích khung hình, nhưng stack lại lớn gấp 1.000 lần diện tích khung hình. Chi phí tăng theo max_det và kích thước ảnh thay vì theo số lượng box trong ảnh.
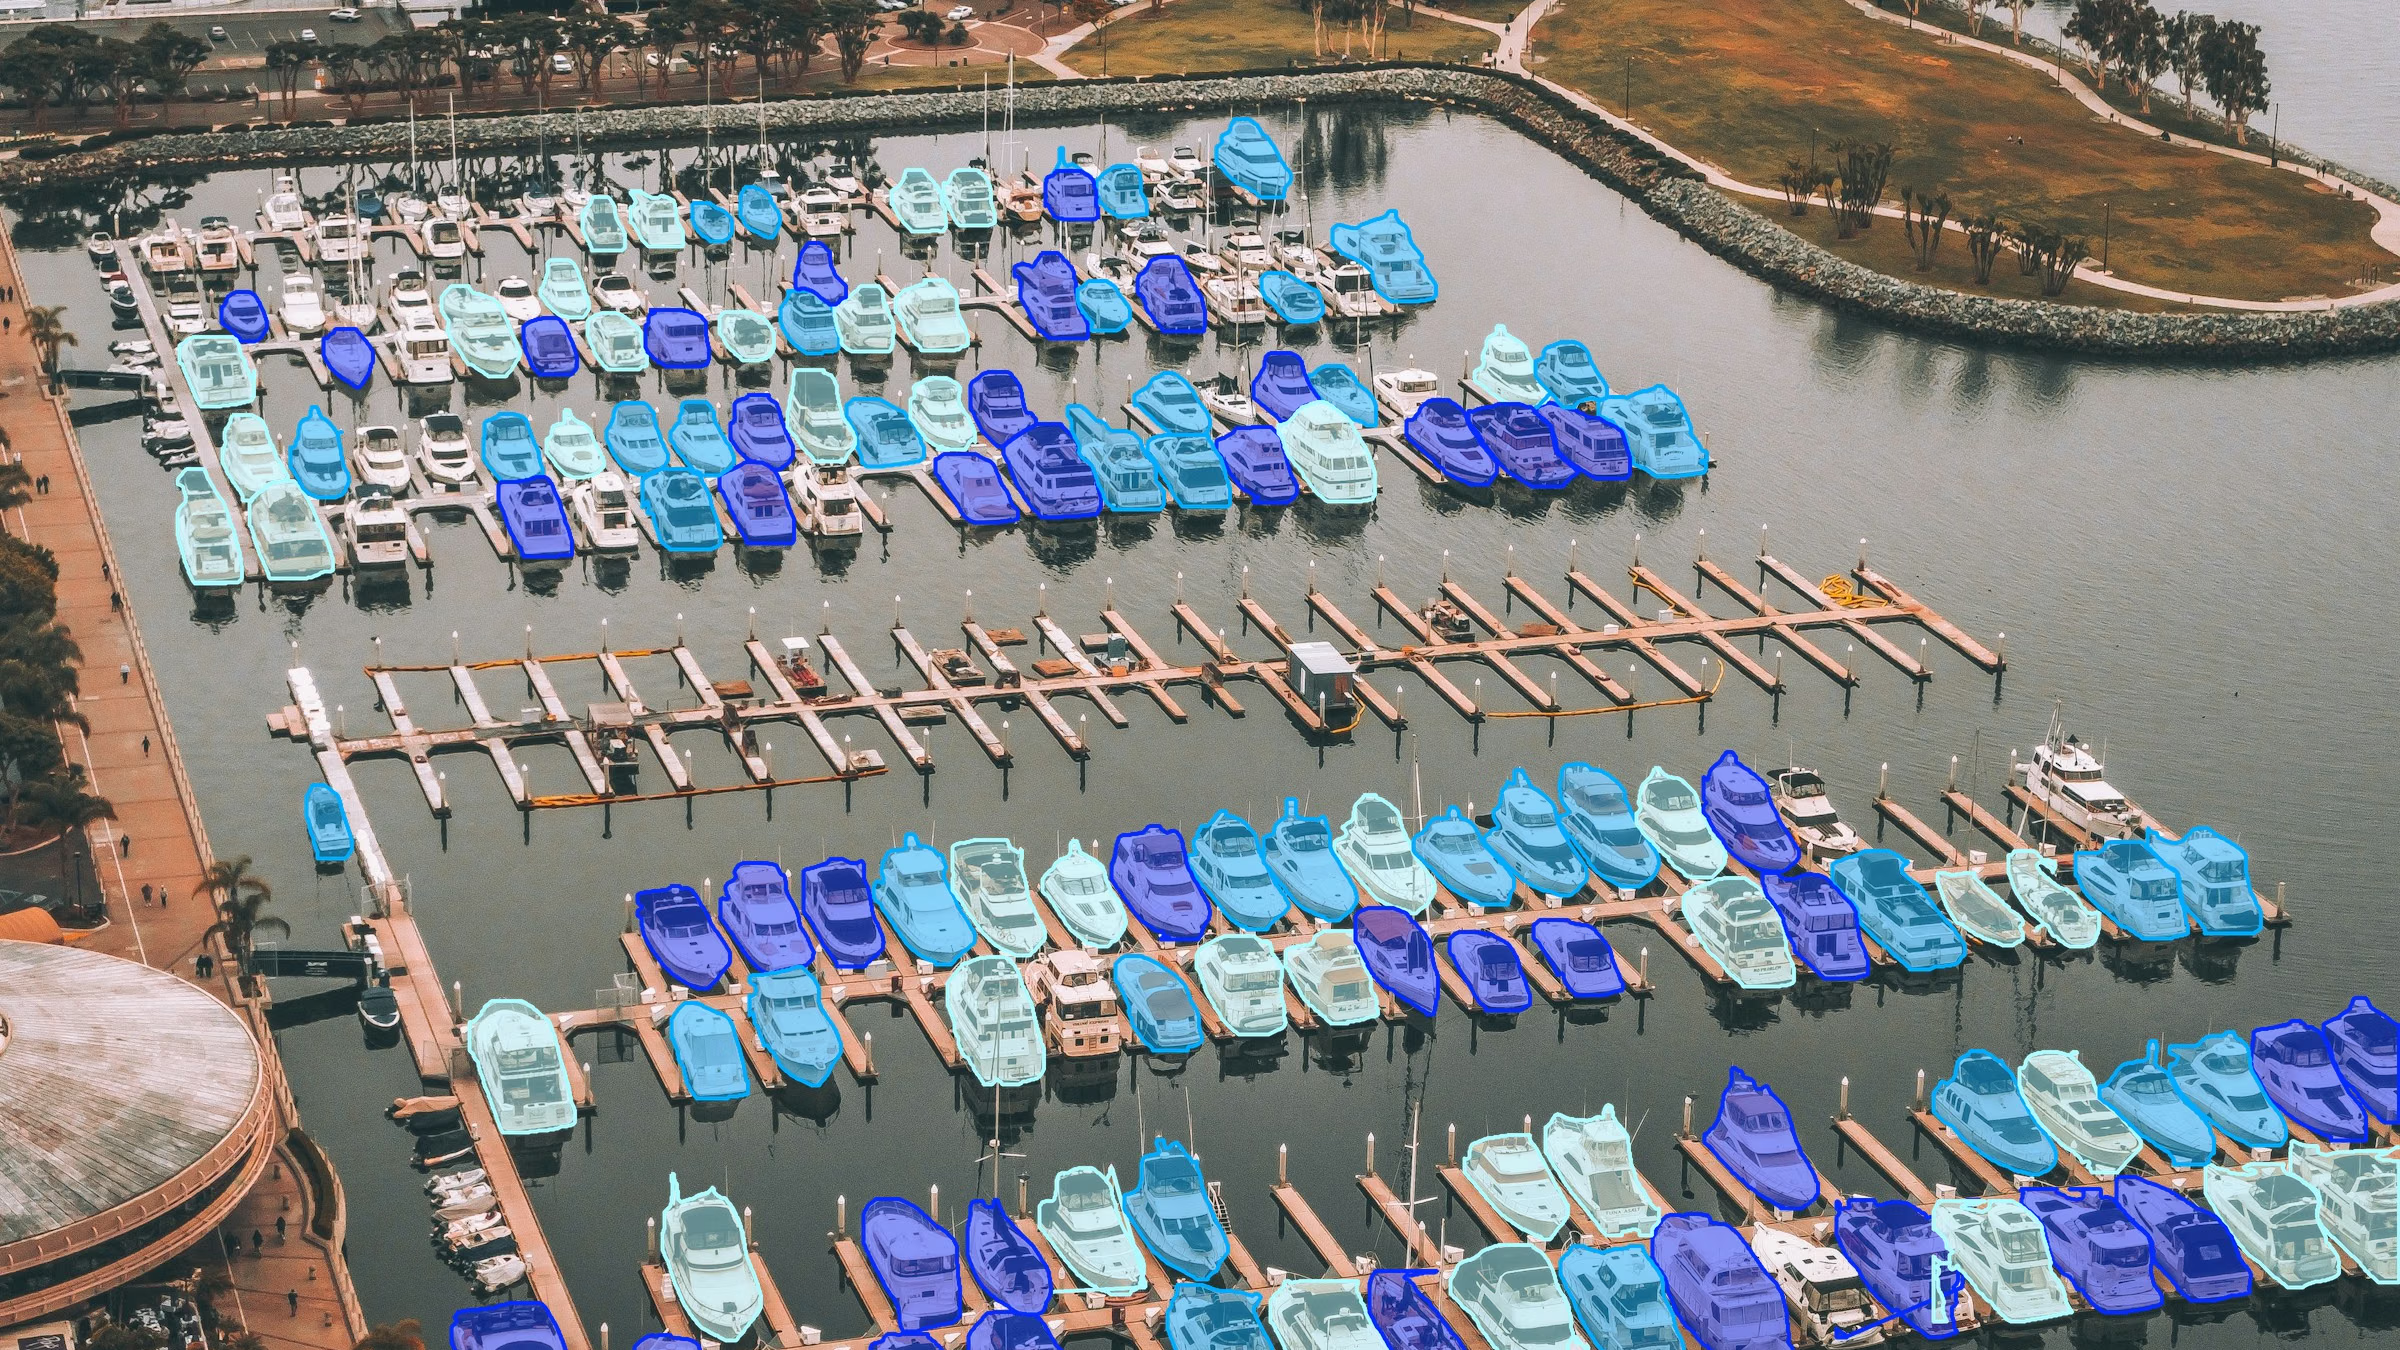
YOLO26x-seg trả về 127 mask thuyền trong ảnh bến du thuyền này, hiển thị ở dạng crop (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Ảnh: Unsplash.
Đó là lý do việc tăng max_det vượt mức mặc định 300 trước đây không thực tế với segmentation, và vì sao ảnh lớn có nhiều instance có thể làm cạn bộ nhớ. Kệ bán lẻ dày đặc như SKU-110K, các đống bưu kiện và khung hình chụp từ trên cao chính là những cảnh cần giới hạn cao hơn 300 đối tượng.
Ultralytics 8.4.213 giải mã các stack mask lớn bên trong từng box#
Luồng xử lý mới, từ PR #27197, nội suy logits prototype chỉ tại các pixel thuộc từng box. Luồng này sử dụng lấy mẫu song tuyến tính tách rời, cùng phương pháp lấy mẫu mà phép nội suy của PyTorch sử dụng, và gom các box có kích thước tương tự để xử lý theo batch. Với các stack lớn, chi phí giải mã giờ đây tỷ lệ thuận với tổng diện tích các box.
Ba chi tiết quan trọng trong thực tế:
- Tự động chuyển sang luồng này khi stack mask vượt một ngưỡng cố định. Segmentation predictor sử dụng mask cục bộ theo box khi stack dày đặc vượt 33.554.432 pixel trên CUDA hoặc 4.194.304 pixel trên CPU và các thiết bị khác. Các stack nhỏ hơn vẫn dùng luồng dày đặc hiện tại, vốn nhanh tương đương hoặc nhanh hơn khi chỉ có một vài mask.
- Trong luồng đó, đường viền được tạo trực tiếp từ mask cục bộ theo box.
masks.xyvàmasks.xyntruy vết polygon cho từng box, vì vậysummary(),to_json()vàsave_txtkhông tạo stack đầy đủ. - Định dạng đầu ra không thay đổi.
masks.datavẫn trả về tensor dày đặc N x H x W. Trong luồng xử lý cục bộ theo box, tensor được tạo ở lần đầu bạn đọc dữ liệu.
Việc đọc tensor dày đặc vẫn tốn chi phí cấp phát, nhưng PR đo được mức giảm đáng kể: trên GPU, đọc masks.data cho 300 mask ở 1080p với retina_masks=True giảm từ 14,1 ms và 1.366 MiB xuống còn 9,1 ms và 795 MiB.
1.000 mask ở 1080p giảm từ 821,2 ms xuống 56,4 ms trên GPU#
PR benchmark YOLO26n-seg chạy toàn bộ model.predict(...) cùng result.summary() (box và polygon), báo cáo trung vị của các lượt chạy đã làm nóng với một process cho mỗi hàng. Cảnh dày đặc là ảnh tổng hợp dạng lưới ở conf=0.01 và imgsz=1280; cảnh thông thường là bus.jpg tiêu chuẩn ở các thiết lập mặc định, với 5 mask. “Trước” là 8.4.212. Đây là các phép đo nặng về hậu xử lý, tính cả dự đoán và tổng hợp kết quả, không phải con số tốc độ inference tổng quát.
| Cảnh (GPU, RTX PRO 6000) | Mask | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Thông thường (bus.jpg) | 5 | Sai | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | Sai | 118,5 ms, 1.673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | Đúng | 248,7 ms, 1.366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | Đúng | 821,2 ms, 4.291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | Đúng | 1.352,1 ms, 7.070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | Đúng | 4.323,1 ms, 23.305 MiB | 130,7 ms, 258 MiB |
Thời gian và bộ nhớ GPU đỉnh, PyTorch 2.15.0 với CUDA 13.2. Nguồn: PR #27197.
Ảnh thông thường với năm mask không thay đổi, đúng như thiết kế. Cải thiện thể hiện rõ khi stack cũ trở nên lớn, và lớn nhất với mask ở độ phân giải đầy đủ—trường hợp tốn kém nhất trước đây.
Ảnh lớn chỉ cần một phần nhỏ bộ nhớ#
Ở độ phân giải 4000 x 3000 pixel với 1.000 mask được dự đoán, luồng cũ đạt mức đỉnh 23.305 MiB bộ nhớ GPU. Luồng mới đạt đỉnh 258 MiB và hoàn tất trong 130,7 ms thay vì 4.323,1 ms. Mức giảm này dành thêm bộ nhớ GPU cho các phần còn lại của pipeline khi xử lý khung hình 12 megapixel từ drone, vệ tinh và hoạt động kiểm tra.
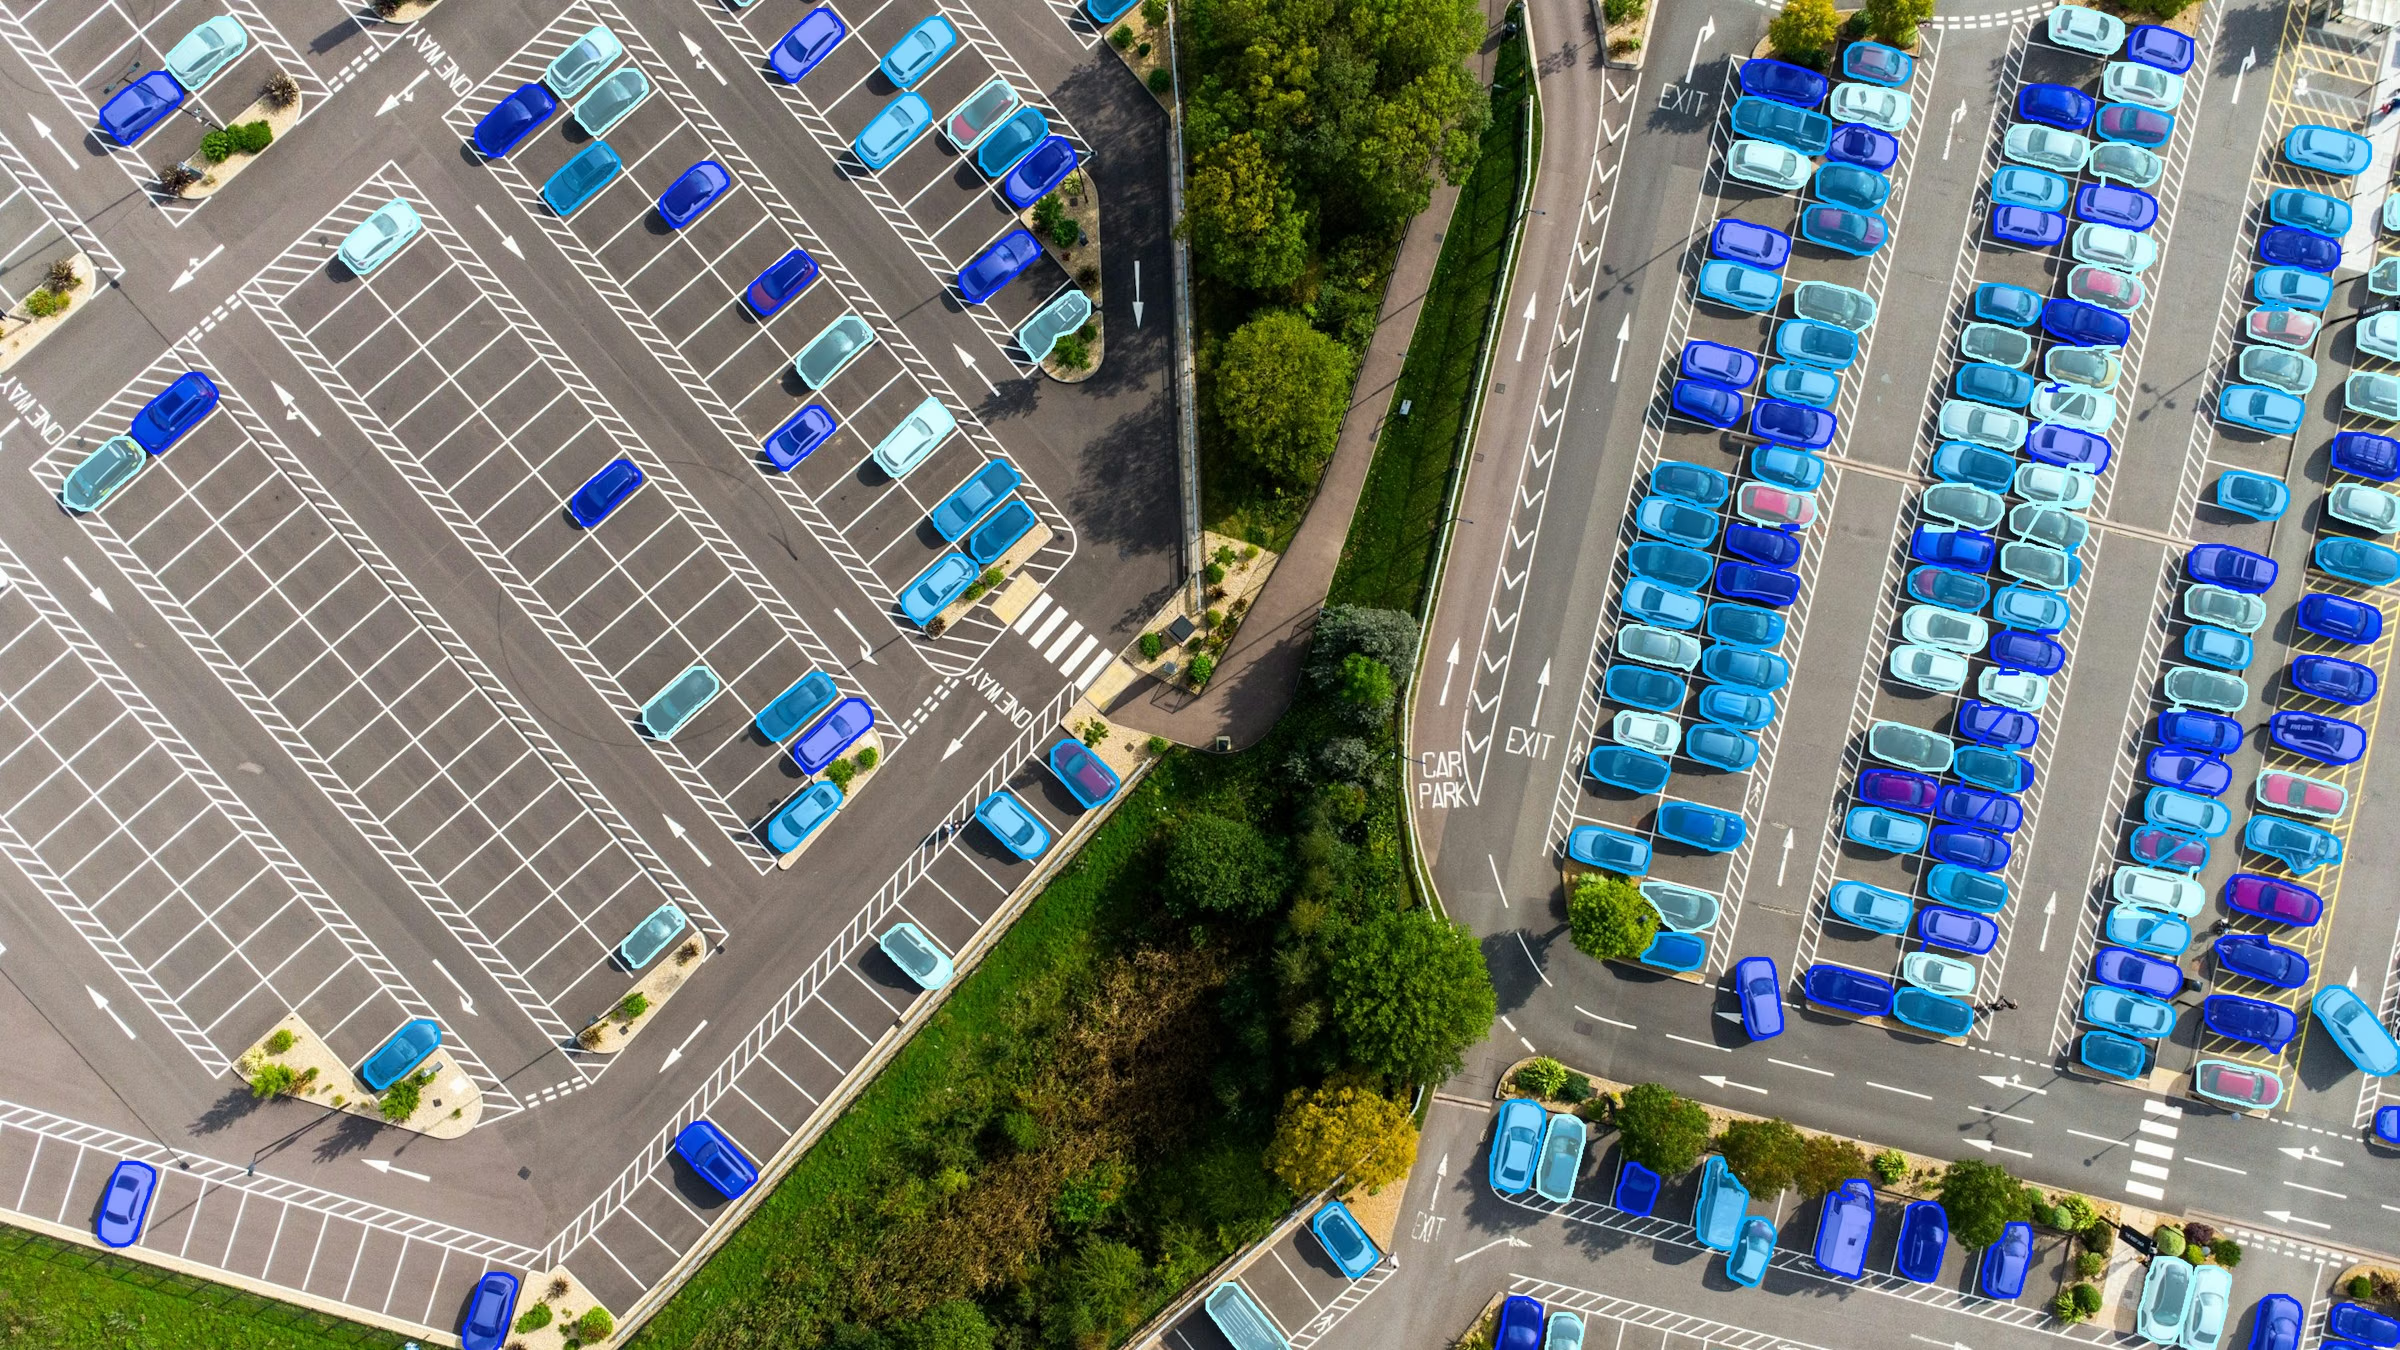
YOLO26x-seg trả về 222 mask ô tô trong khung hình chụp từ trên cao này (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Ảnh: Unsplash.
Dự đoán trên CPU cũng nhanh hơn đáng kể#
Trên CPU Linux x86 với 8 luồng, process sử dụng khoảng 840 MiB trước khi tạo bất kỳ mask nào. Với ảnh 1080p và 1.000 mask ở độ phân giải đầy đủ, bộ nhớ process đỉnh giảm từ 5.217 MiB xuống 1.072 MiB, đồng thời thời gian giảm như bên dưới.
300 và 1.000 mask ở 1920 x 1080, cùng 300 mask ở 4000 x 3000 (12MP). YOLO26n-seg, dự đoán cộng tổng hợp kết quả, 8.4.212 trước khi cập nhật và 8.4.213 sau khi cập nhật. Nguồn: PR #27197.
Mask khớp với 8.4.212, với sai khác nhỏ ở đường biên trong một chế độ#
Luồng nhanh hơn chỉ hữu ích nếu trả về cùng kết quả. PR so sánh 8.4.213 với 8.4.212 trên 96 dự đoán, sử dụng YOLO26n-seg và YOLO11n-seg trên hai ảnh ở sáu kích thước, conf là 0.25 và 0.01, cả hai chế độ mask, đồng thời buộc bật luồng cục bộ theo box:
- Mask mặc định (
retina_masks=False): box, mask và polygon giống hệt nhau; không có pixel nào khác biệt trong 7,6 triệu pixel mask. - Mask ở độ phân giải đầy đủ (
retina_masks=True): giống hệt nhau khi code cũ chỉ nội suy một lần. Với các hình dạng ảnh còn lại, 0,07% pixel mask khác biệt (18.105 trên 24,8 triệu), tất cả đều nằm ở đường biên mask, vì code cũ nội suy hai lần trong các trường hợp đó, còn code mới lấy mẫu prototype một lần tại tọa độ chính xác. - Apple MPS: mask, box và polygon giống hệt nhau trên cảnh 1080p dày đặc có 179 mask, ở cả hai chế độ mask.
Cách segmentation 1.000 đối tượng mỗi ảnh bằng Python#
Nâng cấp bằng pip install -U ultralytics (8.4.213 trở lên), sau đó tăng max_det vượt mức mặc định 300. Phần còn lại của code giữ nguyên.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # Các lớp COCO; nạp model đã huấn luyện của riêng bạn cho kệ hàng hoặc bưu kiện
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # một mảng (P, 2) cho mỗi đối tượng, theo pixel của ảnh gốc
rows = r.summary()  # box và polygon
max_det là giới hạn tối đa, không phải mục tiêu: số đối tượng được trả về vẫn phụ thuộc vào model, ảnh và ngưỡng confidence. Để tận dụng tối đa thay đổi này:
- Đọc đường viền khi có thể.
masks.xy(pixel) vàmasks.xyn(đã chuẩn hóa) được tạo từ mask cục bộ theo box trong luồng xử lý stack lớn, tương tựto_json()vàsave_txt. Tài liệu tham khảo Results liệt kê mọi thuộc tính. - Đọc
masks.datađể tính toán trực tiếp trên pixel. Việc tính diện tích và phần chồng lấn đơn giản nhất trên tensor dày đặc; cũng có thể tạo vùng cắt từ contourmasks.xy. Bài học Academy về sử dụng mask trong code trình bày khi nào nên dùng từng dạng, còn hướng dẫn tách riêng đối tượng tạo vùng cắt từ contour. - Dùng
retina_masks=Truekhi cần mask ở độ phân giải ảnh gốc. Trong benchmark GPU với 300 mask ở 1080p, chế độ này hiện mất 18,0 ms so với 16,3 ms cho mask mặc định. Với các đối tượng nhỏ trong khung hình rất lớn, hãy xem bài viết về phát hiện đối tượng nhỏ bằng image tiling và hướng dẫn tiling độ phân giải cao. Dự đoán có tiling trả về mask theo kích thước ảnh gốc, vì vậy lượt chạy có tiling vẫn cần bộ nhớ tỷ lệ thuận với ảnh gốc. - Điều chỉnh
confvàioucho cảnh đông đúc. Tăngmax_detsẽ giữ lại nhiều detection hơn trong số các detection đã vượt quaconf; giảmconfsẽ chấp nhận các detection có độ tin cậy thấp hơn. Thiết lập predict đề cập đếnconf,iouvàmax_det, còn hướng dẫn về ngưỡng NMS IoU giải thích cách xử lý các đối tượng chạm nhau.
Thay đổi này nằm trong bước hậu xử lý Python, nên áp dụng cho model PyTorch và các model đã export được chạy thông qua API predict của Ultralytics. PR đã kiểm thử YOLO26n-seg và YOLO11n-seg; cùng bước hậu xử lý này áp dụng cho mọi model segmentation YOLO26 và YOLO11, từ YOLO26n-seg với 2,7M tham số sau khi hợp nhất đến YOLO26x-seg với 62,8M. Để huấn luyện model trên dữ liệu dày đặc của riêng bạn, hãy làm theo hướng dẫn huấn luyện YOLO26 tùy chỉnh cho instance segmentation.
Ultralytics Platform hiện trả về tối đa 1.000 kết quả mỗi ảnh#
Giới hạn tương tự hiện cũng áp dụng trong Ultralytics Platform. Tab Predict của model trả về tối đa 1.000 kết quả mỗi ảnh, tương tự REST API phía sau tab này. Các model RT-DETR là ngoại lệ, giới hạn ở 300—theo số lượng query trong decoder của chúng.
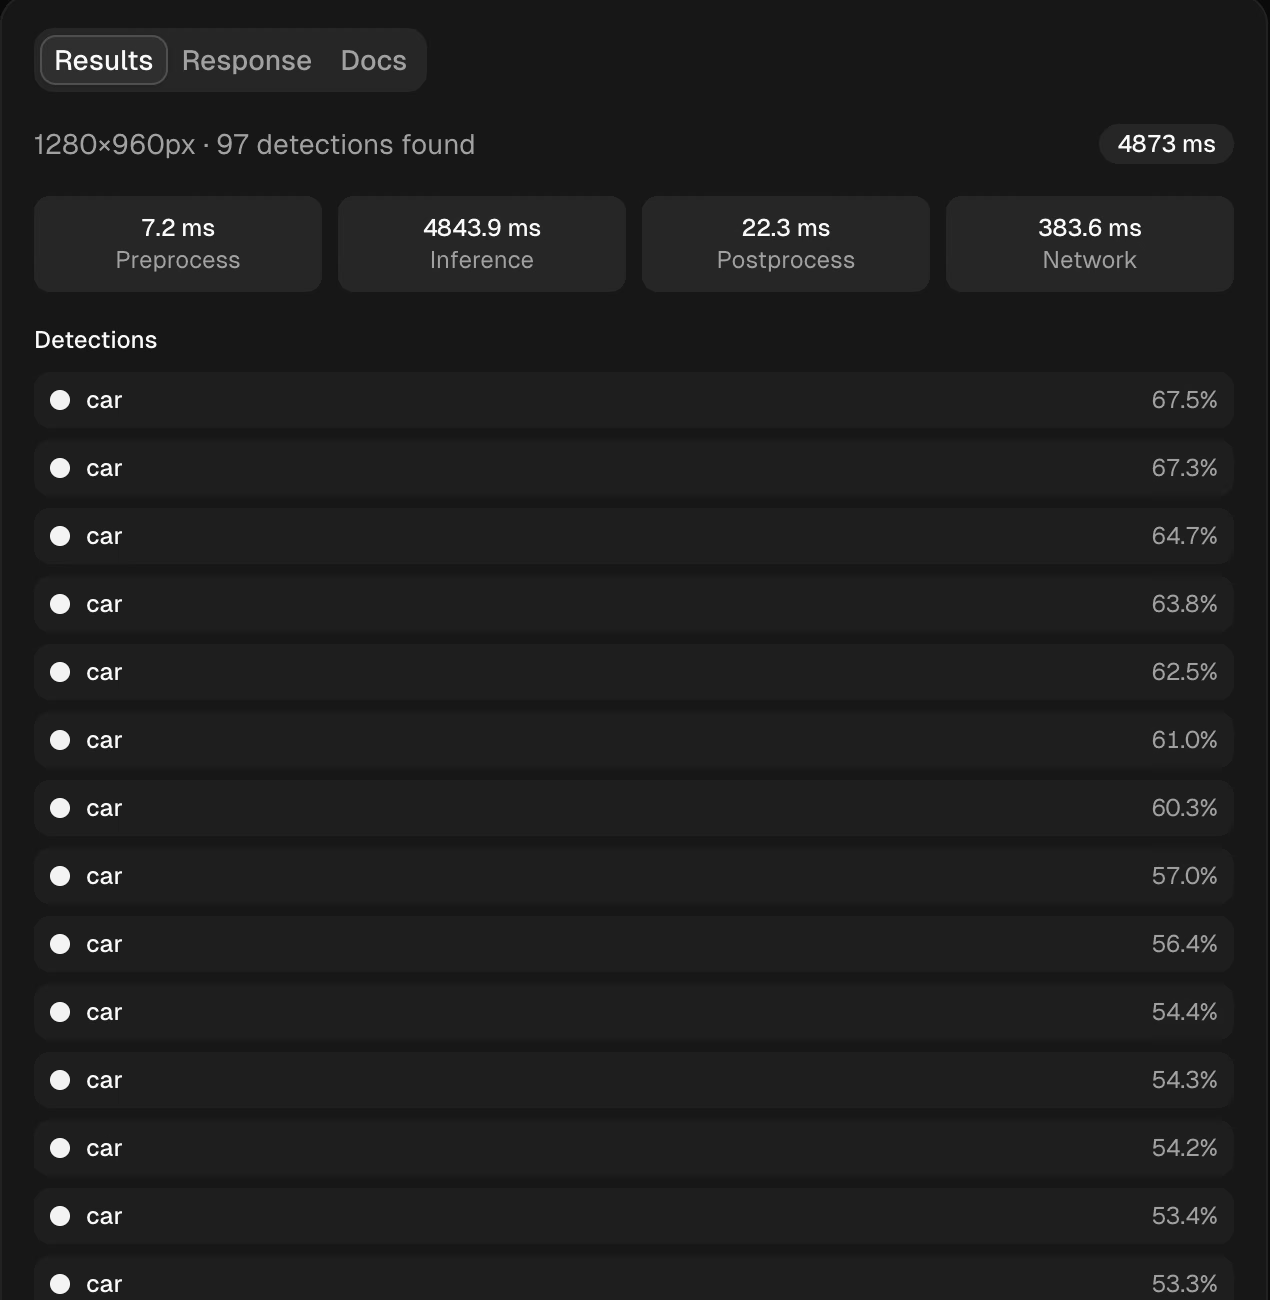
Tab Predict của YOLO26x-seg ở kích thước ảnh 1280, liệt kê 97 detection ô tô trong ảnh chụp từ trên cao ở trên. Tài liệu inference của Platform trình bày chi tiết bảng này.
Bảng kết quả được thiết kế cho danh sách dài. Khi có hơn 10 kết quả, ảnh hiển thị box không có nhãn để tránh che khuất đối tượng, danh sách hiển thị tên từng kết quả và ảnh phóng to giữ nguyên nhãn. Di chuột lên một hàng để làm nổi bật đối tượng tương ứng, hoặc di chuột lên đối tượng để tìm hàng tương ứng.
Để thử trên dữ liệu của riêng bạn, hãy bắt đầu với dataset phân đoạn bưu kiện Package-Seg, huấn luyện trên cloud rồi chạy kết quả trong tab Predict hoặc thông qua endpoint chuyên dụng.
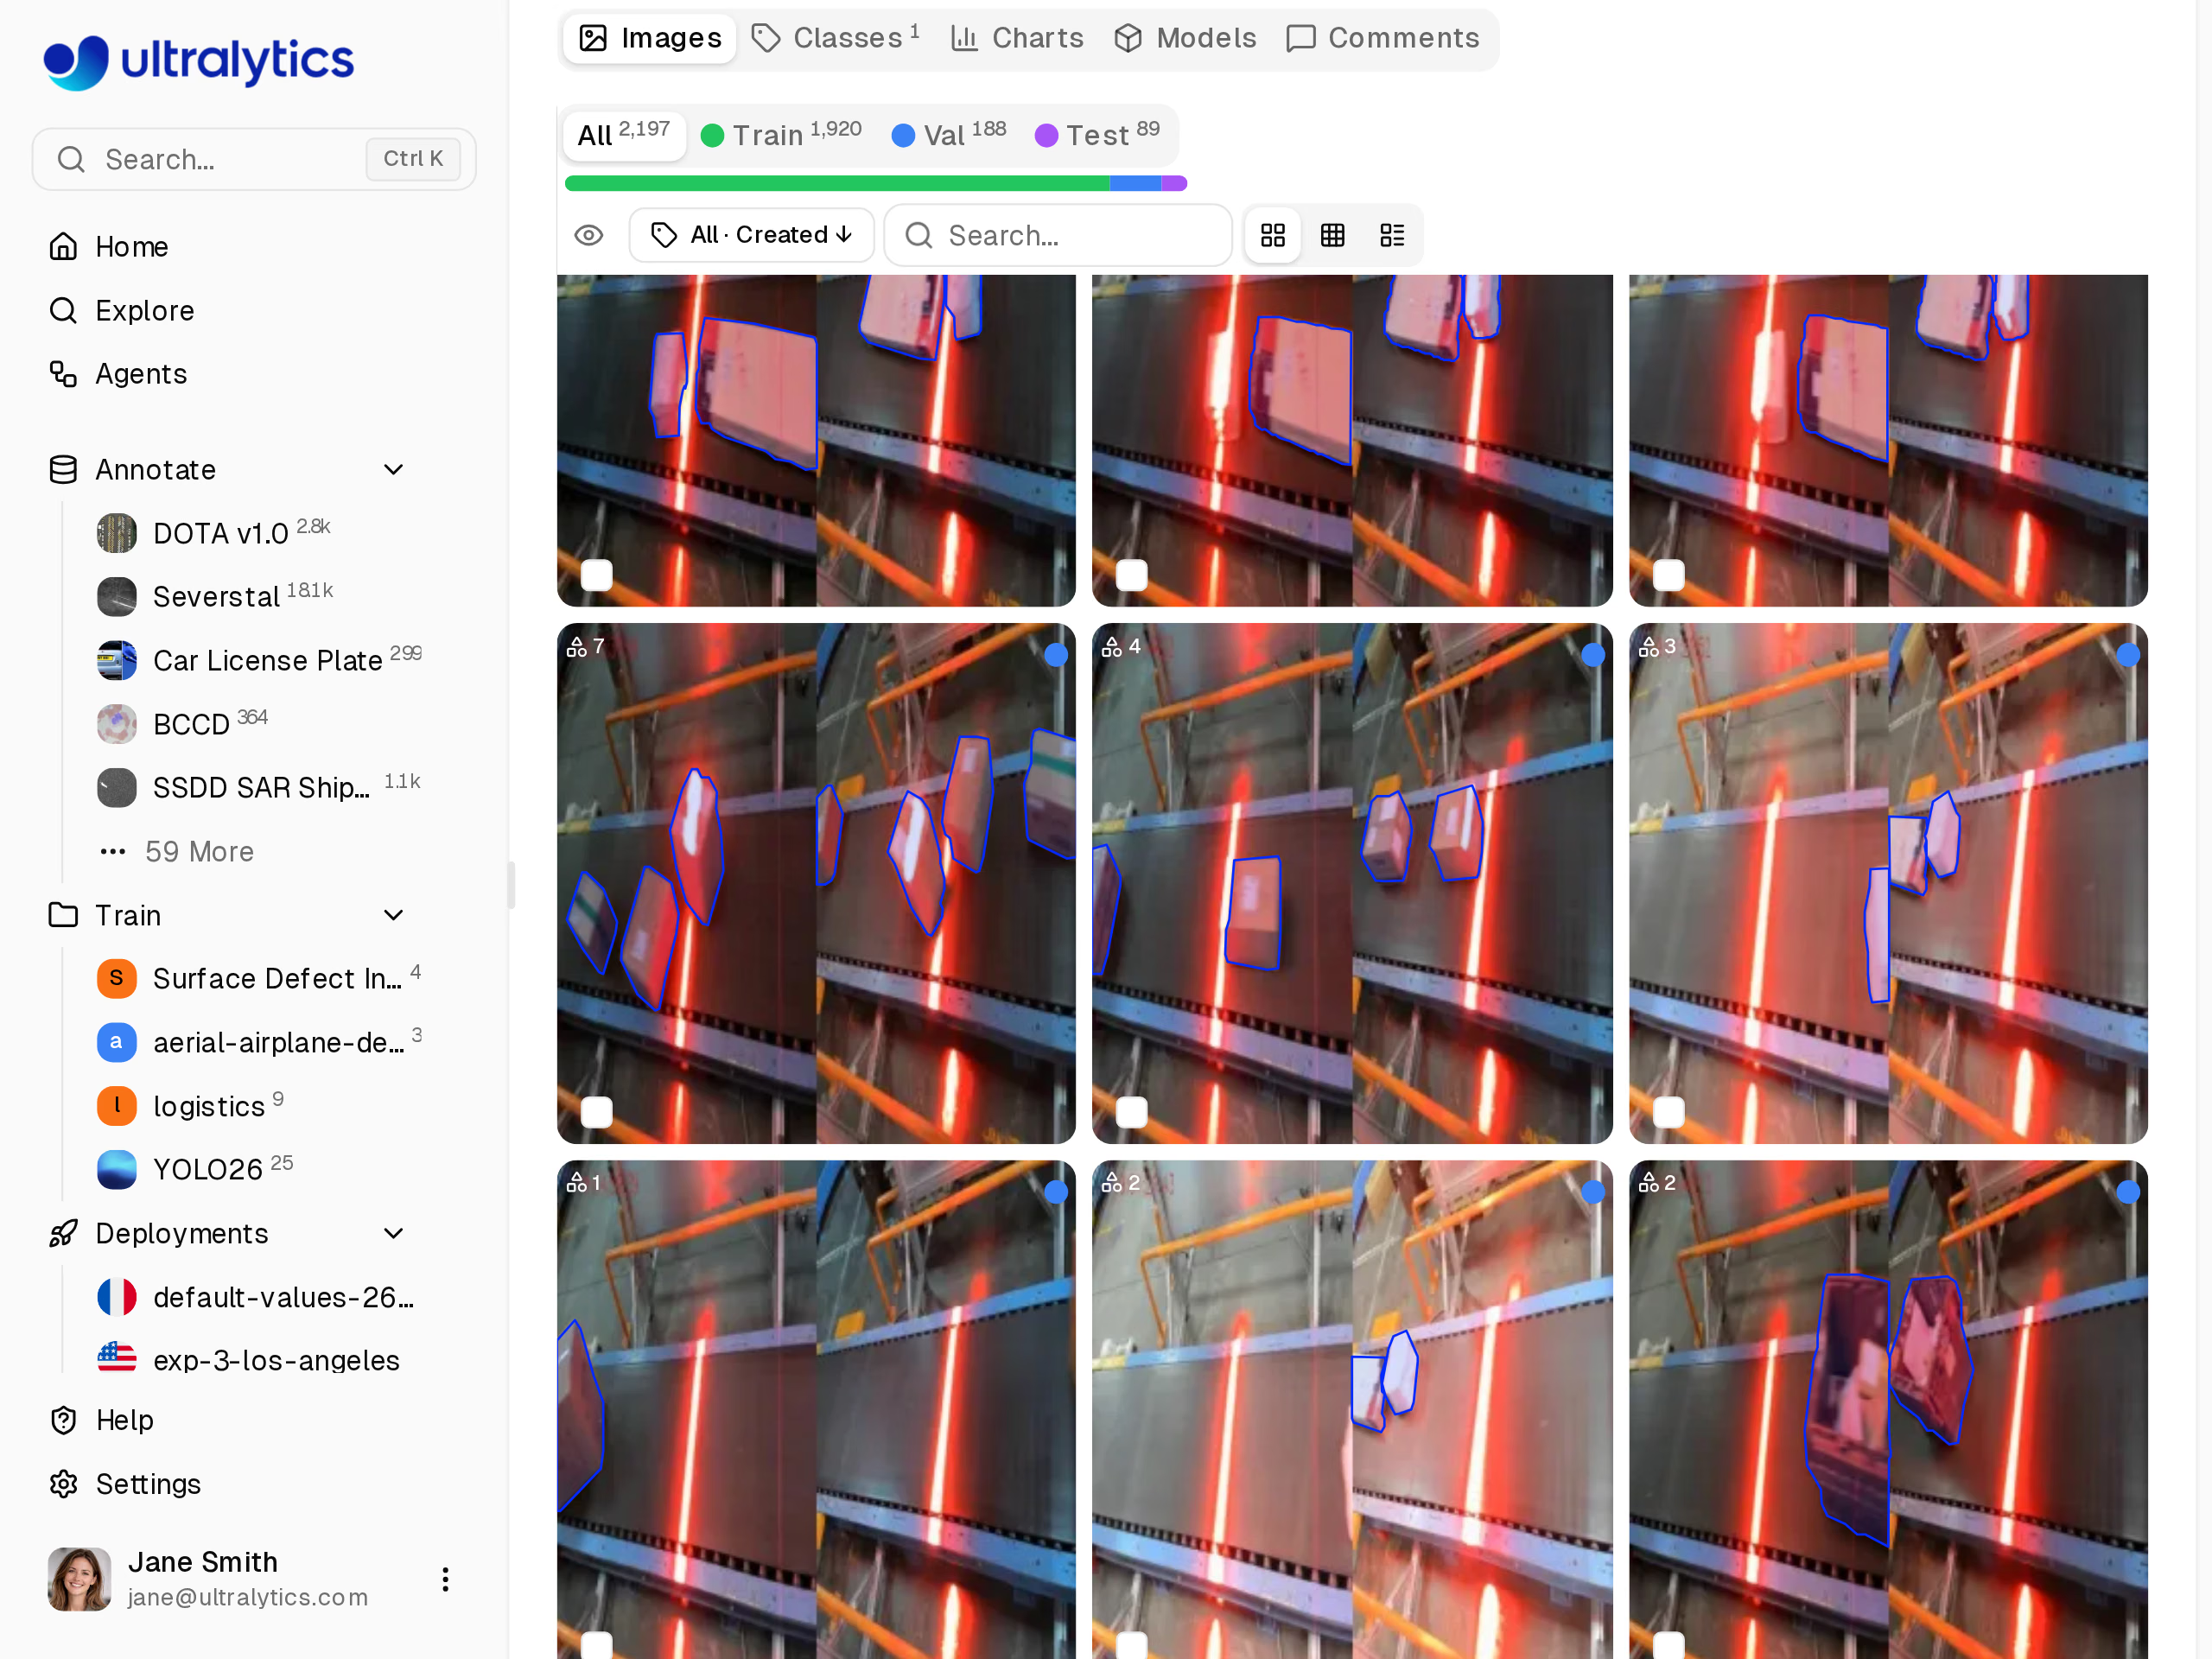
Dataset Package-Seg trên Ultralytics Platform, điểm khởi đầu có sẵn để triển khai segmentation trong logistics.
Ai nên nâng cấp#
Hãy nâng cấp ngay nếu bạn phân đoạn các cảnh đông đúc hoặc ảnh lớn: kệ bán lẻ, phân loại bưu kiện, khảo sát trên không và bằng drone, kính hiển vi tế bào, hoặc bất kỳ trường hợp nào bạn phải giới hạn max_det, giảm kích thước ảnh hay bỏ retina_masks để không vượt quá bộ nhớ. Giờ bạn có thể xem xét lại các giải pháp tạm thời đó.
Nếu stack mask của bạn vẫn thấp hơn ngưỡng, chúng tiếp tục dùng luồng dày đặc hiện tại; lưu ý rằng ngưỡng được tính bằng số đối tượng nhân với kích thước ảnh, nên chỉ vài mask trên ảnh rất lớn cũng có thể vượt ngưỡng. Nếu pipeline luôn đọc masks.data, bạn vẫn tạo tensor dày đặc; trong bài kiểm thử GPU 1080p với 300 mask của PR, thao tác này tốn ít thời gian và bộ nhớ hơn trước. Để ôn lại xem bạn có thực sự cần instance mask hay không, hãy xem semantic segmentation và instance segmentation.
Câu hỏi thường gặp
YOLO segmentation là tác vụ instance segmentation trong Ultralytics YOLO: với mỗi đối tượng, model trả về một lớp, một box, điểm confidence và mask pixel. Các model YOLO26 segmentation có năm kích thước, từ YOLO26n-seg đến YOLO26x-seg, được pretrained trên 80 lớp của COCO và sẵn sàng fine-tune trên dữ liệu của riêng bạn.
max_detđặt giới hạn tối đa, mặc định là 300; số lượng được trả về còn phụ thuộc vào model, ảnh và ngưỡng confidence. Kể từ 8.4.213, giới hạn 1.000 trở nên khả thi với các workload như trong benchmark: trên ảnh 1080p tổng hợp, YOLO26n-seg dự đoán và tổng hợp kết quả cho 1.000 mask ở độ phân giải đầy đủ trong 56,4 ms, với bộ nhớ đỉnh 321 MiB trên RTX PRO 6000. Ultralytics Platform trả về tối đa 1.000 kết quả mỗi ảnh.Các phiên bản trước tạo mọi mask ở kích thước khung hình, nên bộ nhớ tăng theo số lượng đối tượng nhân với diện tích khung hình. Trong benchmark tổng hợp ở 4000 x 3000 với 1.000 mask ở độ phân giải đầy đủ, mức sử dụng bộ nhớ GPU đạt đỉnh 23.305 MiB. Phiên bản 8.4.213 giải mã các stack lớn bên trong từng box và chỉ đạt đỉnh 258 MiB trong cùng trường hợp.
Nâng cấp lên
ultralytics8.4.213 trở lên; không cần thay đổi code nào khác, vì luồng cục bộ theo box tự động bật với các stack mask lớn.masks.datavẫn giữ nguyên định dạng dày đặc, nên code hiện có tiếp tục hoạt động; thay vào đó, đọcmasks.xyhoặc gọisummary()sẽ tránh tạo tensor này trong luồng đó.retina_masks=Truetrả về mask ở độ phân giải ảnh gốc thay vì kích thước inference của model, nhờ đó mask dày đặc khớp với ảnh gốc. Với 300 mask trên ảnh 1080p tổng hợp, quá trình dự đoán cộng tổng hợp kết quả của YOLO26n-seg trên RTX PRO 6000 mất 248,7 ms ở 8.4.212 và 18,0 ms ở 8.4.213 khi bật thiết lập này.
Được viết bởi
Nhà sáng lập kiêm CEO · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









