Data Curation
Quản lý dữ liệu là quá trình liên tục tổ chức, xác thực, lập tài liệu và duy trì các bộ dữ liệu đáng tin cậy cho machine learning và đánh giá.
Tuyển chọn dữ liệu là quá trình liên tục gồm chọn, sắp xếp, kiểm tra, lập tài liệu và duy trì dữ liệu để dữ liệu luôn hữu ích cho một mục đích cụ thể. Trong machine learning, quá trình này định hình các ví dụ mà model học từ đó và bằng chứng được dùng để đánh giá model. Bộ dữ liệu được tuyển chọn kết hợp các mẫu phù hợp, nhãn nhất quán cho các tác vụ học có giám sát, thông tin ngữ cảnh và các phiên bản có thể truy xuất.
Tuyển chọn, làm sạch và tiền xử lý#
Tuyển chọn dữ liệu bao quát toàn bộ vòng đời của bộ dữ liệu. Làm sạch dữ liệu sửa lỗi và loại bỏ các bản ghi không thể sử dụng; tiền xử lý dữ liệu biến đổi đầu vào thông qua các thao tác như thay đổi kích thước hoặc chuẩn hóa. Gắn nhãn dữ liệu, còn gọi là dán nhãn dữ liệu, bổ sung các mục tiêu được dùng trong học có giám sát. Quá trình tuyển chọn điều phối các hoạt động này, đồng thời xác định mẫu nào được đưa vào, cách định nghĩa danh mục và cách bộ sưu tập thay đổi theo thời gian. Các định nghĩa danh mục và quy tắc gắn nhãn nhất quán giúp model học được mối quan hệ đáng tin cậy giữa ảnh và mục tiêu.
Nhờ đó, tuyển chọn dữ liệu trở thành một thành phần thiết thực của AI lấy dữ liệu làm trung tâm, phương pháp cải thiện hệ thống bằng cách nâng cao chất lượng dữ liệu.
Quy trình tuyển chọn dữ liệu#
Quy trình bắt đầu bằng bản đặc tả bộ dữ liệu, trong đó nêu rõ tác vụ dự đoán, danh mục mục tiêu, điều kiện vận hành và tiêu chí đưa mẫu vào. Với phát hiện đối tượng, nội dung này bao gồm các quy tắc về bounding box và đối tượng bị che khuất một phần. Việc xem xét tần suất danh mục và điều kiện thu thập giúp phát hiện thiên lệch bộ dữ liệu, bao gồm các lớp hoặc môi trường chưa được đại diện đầy đủ.
Các bước kiểm tra chất lượng kết hợp kiểm tra tự động với đánh giá của con người. Kiểm tra tệp giúp phát hiện ảnh không thể đọc; kiểm tra chú thích giúp xác định tọa độ không hợp lệ và lớp không nhất quán. Hàm băm của tệp giúp phát hiện các bản sao giống hệt nhau, trong khi embedding—biểu diễn dạng số của nội dung ảnh—giúp tìm các mẫu có hình ảnh tương tự. Quá trình đánh giá phân biệt lỗi có thể sửa với bản ghi không thể sử dụng, đồng thời giữ lại các mẫu hợp lệ, khó, có tính đại diện cho tác vụ.
Kiểm tra hàm băm tệp có thể giữ lại một đường dẫn cho mỗi tệp duy nhất. Ví dụ này kiểm tra ảnh đi kèm gói ultralytics, được cài đặt bằng pip install ultralytics:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
Các số lượng cho biết còn lại bao nhiêu tệp sau khi loại bỏ các bản trùng khớp chính xác; số lượng bằng nhau nghĩa là tất cả tệp được lấy mẫu đều có hàm băm riêng biệt.
Việc phân chia giúp bảo đảm tính độc lập của dữ liệu huấn luyện, dữ liệu validation và dữ liệu kiểm tra. Các khung hình video gần nhau có chung nội dung cảnh, vì vậy việc phân bổ chúng vào các tập khác nhau gây ra rò rỉ dữ liệu và làm điểm đánh giá tăng cao. Nhóm dữ liệu theo phiên ghi hình, camera hoặc địa điểm giúp kết quả đánh giá phản ánh đúng tác vụ khái quát hóa mong muốn. Một phiên bản bộ dữ liệu cố định lưu giữ các phân bổ đó cùng với nhãn tương ứng.
Ultralytics Platform hỗ trợ tuyển chọn dữ liệu bằng biểu đồ phân bố lớp và phân cụm ảnh, giúp phát hiện các khoảng trống về độ bao phủ, bản trùng lặp và ngoại lệ. Các công cụ quản lý bộ dữ liệu cho phép nhóm kiểm tra các nhóm này và cập nhật ảnh, nhãn cũng như phân bổ tập dữ liệu.
Công việc của người quản lý dữ liệu#
Người quản lý dữ liệu duy trì ý nghĩa và khả năng sử dụng của bộ sưu tập. Trách nhiệm bao gồm lập tài liệu về nguồn dữ liệu, điều phối hướng dẫn gắn nhãn, giải quyết bất đồng về nhãn và ghi lại các thay đổi. Siêu dữ liệu—thông tin mô tả các mẫu—ghi nhận thời gian thu thập, cảm biến, địa điểm và trạng thái chú thích. Duy trì dữ liệu có thể tái sử dụng bao gồm việc lưu giữ mô tả và tài liệu hỗ trợ.
Nguồn gốc dữ liệu ghi lại nơi các mẫu bắt nguồn và cách chúng được biến đổi. Liên kết các phiên bản bộ dữ liệu với theo dõi thử nghiệm giúp tái lập các phép so sánh model. Sau khi triển khai, học chủ động ưu tiên các mẫu có nhiều thông tin để đánh giá; hoạt động giám sát phát hiện độ trôi dữ liệu, từ đó có thể thúc đẩy việc thu thập dữ liệu mới.
Ví dụ trong thị giác máy tính#
Trong nhận thức cho ô tô, bộ sưu tập BDD100K gốc gồm 100.000 video lái xe tại nhiều địa điểm ở Hoa Kỳ, trong các điều kiện thời tiết khác nhau và cả ban ngày lẫn ban đêm. Các thuộc tính môi trường của bộ dữ liệu hỗ trợ đánh giá trên nhiều điều kiện thu thập khác nhau. Phiên bản Platform có 99.996 ảnh khung hình chính dùng cho tác vụ phát hiện.
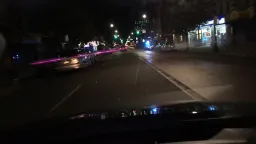 Bản xem trước BDD100K 1
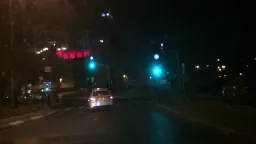 Bản xem trước BDD100K 2
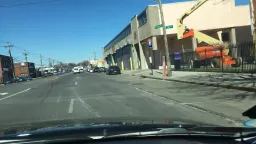 Bản xem trước BDD100K 3
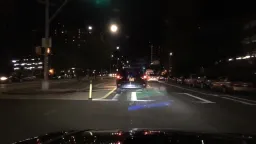 Bản xem trước BDD100K 4
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
Với phân loại ảnh, bản hiệu chỉnh ciFAIR đã thay thế các mẫu gần trùng lặp trong các tập kiểm tra gốc của CIFAR-10 và CIFAR-100. Các mẫu trùng với ảnh huấn luyện hoặc ảnh kiểm tra khác chiếm lần lượt 3.25% và 10% trong các tập kiểm tra ban đầu. Khi giữ nguyên tập huấn luyện, tỷ lệ lỗi phân loại của ResNeXt-29 (8x64d) tăng từ 3.56% trên CIFAR-10 lên 3.95% trên ciFAIR-10.









