التجزؤ الدلالي مقابل تجزؤ المثيلات: كيف تختار المهمة المناسبة؟
يُسنِد التجزؤ الدلالي تصنيفًا إلى كل بكسل، بينما يفصل تجزؤ المثيلات كل كائن على حدة. تعرّف على المهمة التي يحتاج إليها مشروع الرؤية الحاسوبية لديك، والسبب.
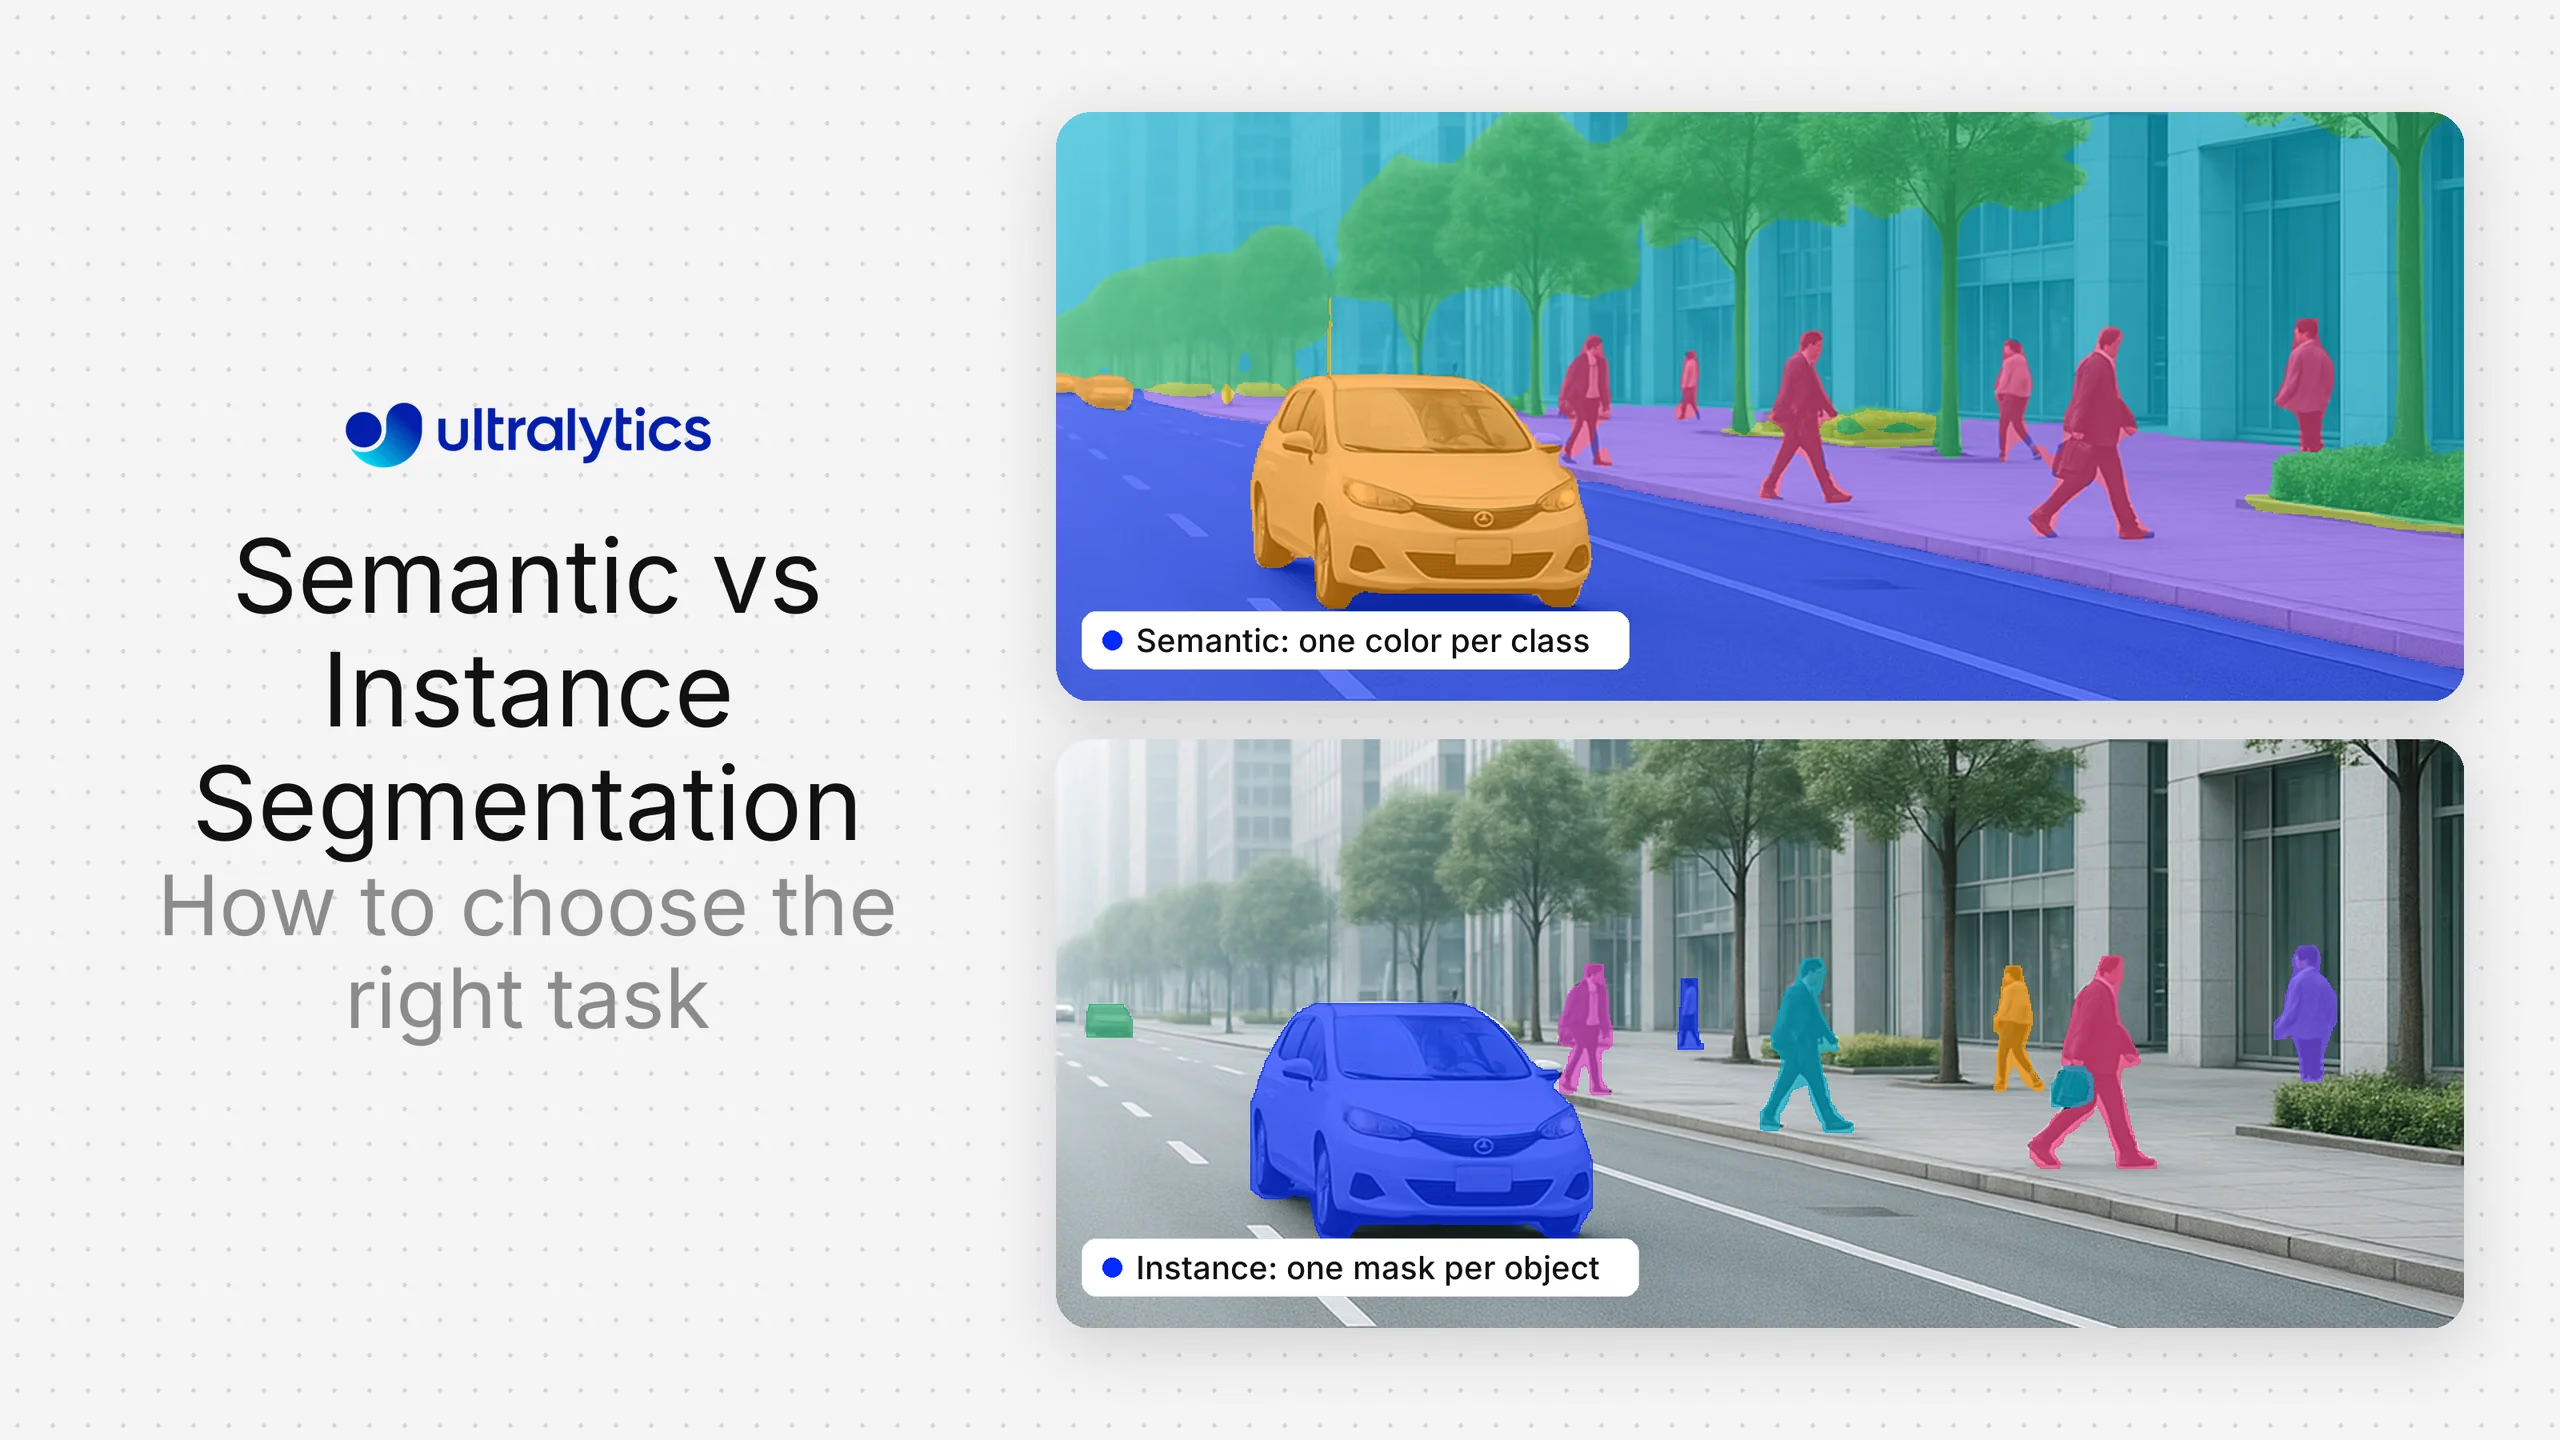
يضع كل من التقسيم الدلالي وتقسيم الكائنات صورًا في فئات على مستوى البكسل، لكنهما يجيبان عن سؤالين مختلفين. التقسيم الدلالي يعيّن فئة لكل بكسل، فتندمج كل السيارات في المشهد ضمن منطقة واحدة باسم «سيارة». أما تقسيم الكائنات فيفصل كل كائن، بحيث تحصل كل سيارة على قناع خاص بها. ويتوقف الاختيار بينهما على سؤال واحد: هل تحتاج إلى معرفة ما الموجود عند كل بكسل، أم إلى أي كائن ينتمي كل بكسل؟ يساعدك هذا الدليل على الاختيار، كما يوضح تكلفة توسيم كل مهمة وكيفية تقييمها. يدعم Ultralytics YOLO المهمتين ضمن الإطار نفسه.
الفرق في سطر واحد#
- التقسيم الدلالي يصنّف كل بكسل ضمن فئة، مثل الطريق أو السماء أو شخص أو سيارة. وتندمج الكائنات التي تنتمي إلى الفئة نفسها في منطقة واحدة. راجع مدخل المسرد التقسيم الدلالي.
- تقسيم الكائنات يحدد كل كائن على حدة ويمنحه قناعه ومعرّفه الخاصين. ويشمل عادةً الكائنات القابلة للعد، ويتجاهل الخلفية مثل السماء أو العشب. راجع مدخل المسرد تقسيم الكائنات.
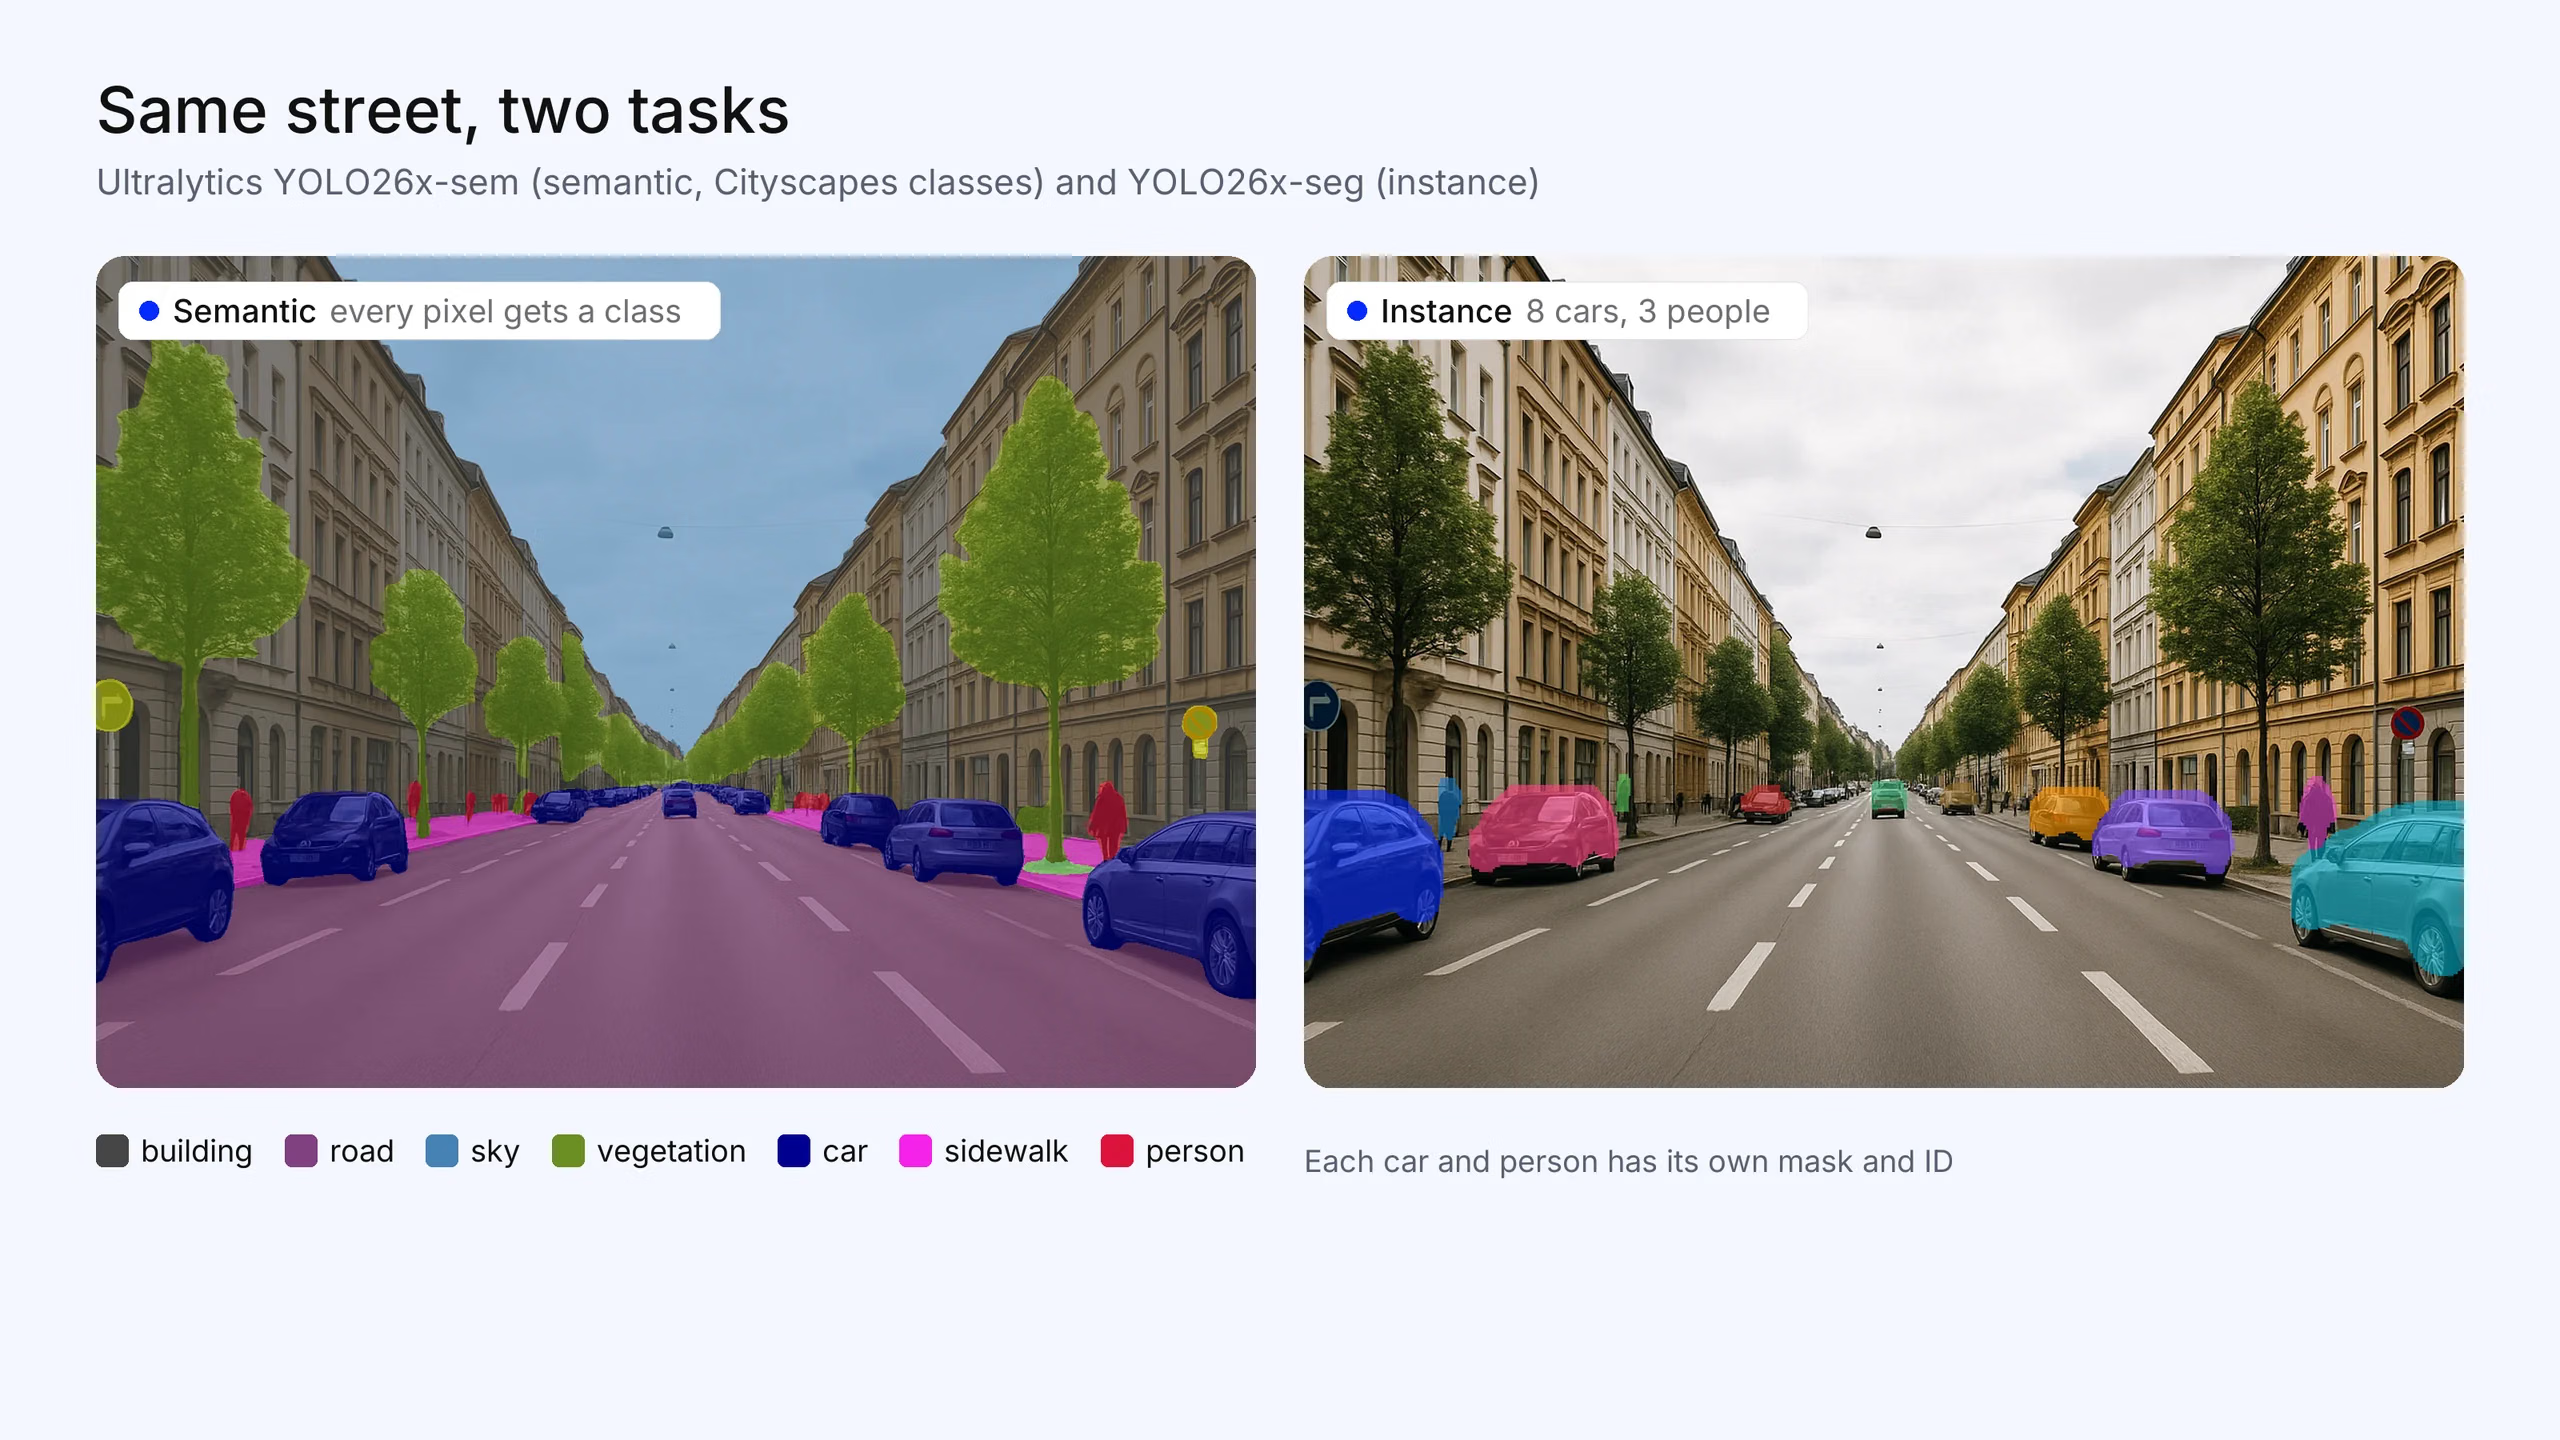
الشكل 1. الشارع نفسه مع تطبيق المهمتين. يصنّف Ultralytics YOLO26x-sem (فئات Cityscapes) كل بكسل، لذا تشترك جميع السيارات في فئة «سيارة» واحدة. ويمنح Ultralytics YOLO26x-seg كلًا من السيارات الثماني والأشخاص الثلاثة الذين اكتشفهم قناعًا خاصًا (بدرجة ثقة 0.5 أو أعلى). أُنشئت الصورة لهذا المقال؛ أما الأقنعة فهي نتائج حقيقية للنموذج.
ما المهمة التي يحتاج إليها مشروعك؟#
ابدأ بالسؤال الذي يجب أن يجيب عنه تطبيقك:
| إذا كان تطبيقك يحتاج إلى… | استخدم | مثال |
|---|---|---|
| معرفة نسبة المشهد التي تشغلها فئة معينة | دلالي | مساحة الطريق الصالحة للقيادة، نسبة تغطية المحاصيل مقابل الأعشاب، الغطاء الأرضي |
| توسيم مناطق الخلفية بدقة مماثلة لتوسيم الكائنات | دلالي | السماء والماء والغطاء النباتي وأنواع الأنسجة في صورة فحص |
| عدّ الكائنات | الكائنات | ثمار على شجرة، أشخاص في طابور |
| تتبّع الكائنات عبر إطارات الفيديو | الكائنات، مع أداة تتبّع | أشخاص أو مركبات تتحرك عبر مشهد |
| قياس كائن واحد أو اتخاذ إجراء بشأنه في كل مرة | الكائنات | روبوت يلتقط قطعة واحدة من كومة، أو يقيس حجم كل عيب |
| تنفيذ الأمرين: تغطية المشهد بالكامل و فصل الكائنات | شامل | مشاهد الشوارع للقيادة الذاتية |
إذا لم تكن متأكدًا، فاسأل ما إذا كان لا بد من التمييز بين كائنين متلامسين من الفئة نفسها. إذا كانت الإجابة نعم، فأنت بحاجة إلى تقسيم الكائنات (أو التقسيم الشامل). أما إذا كانت لا، فالتقسيم الدلالي أبسط وأقل تكلفة عادةً.
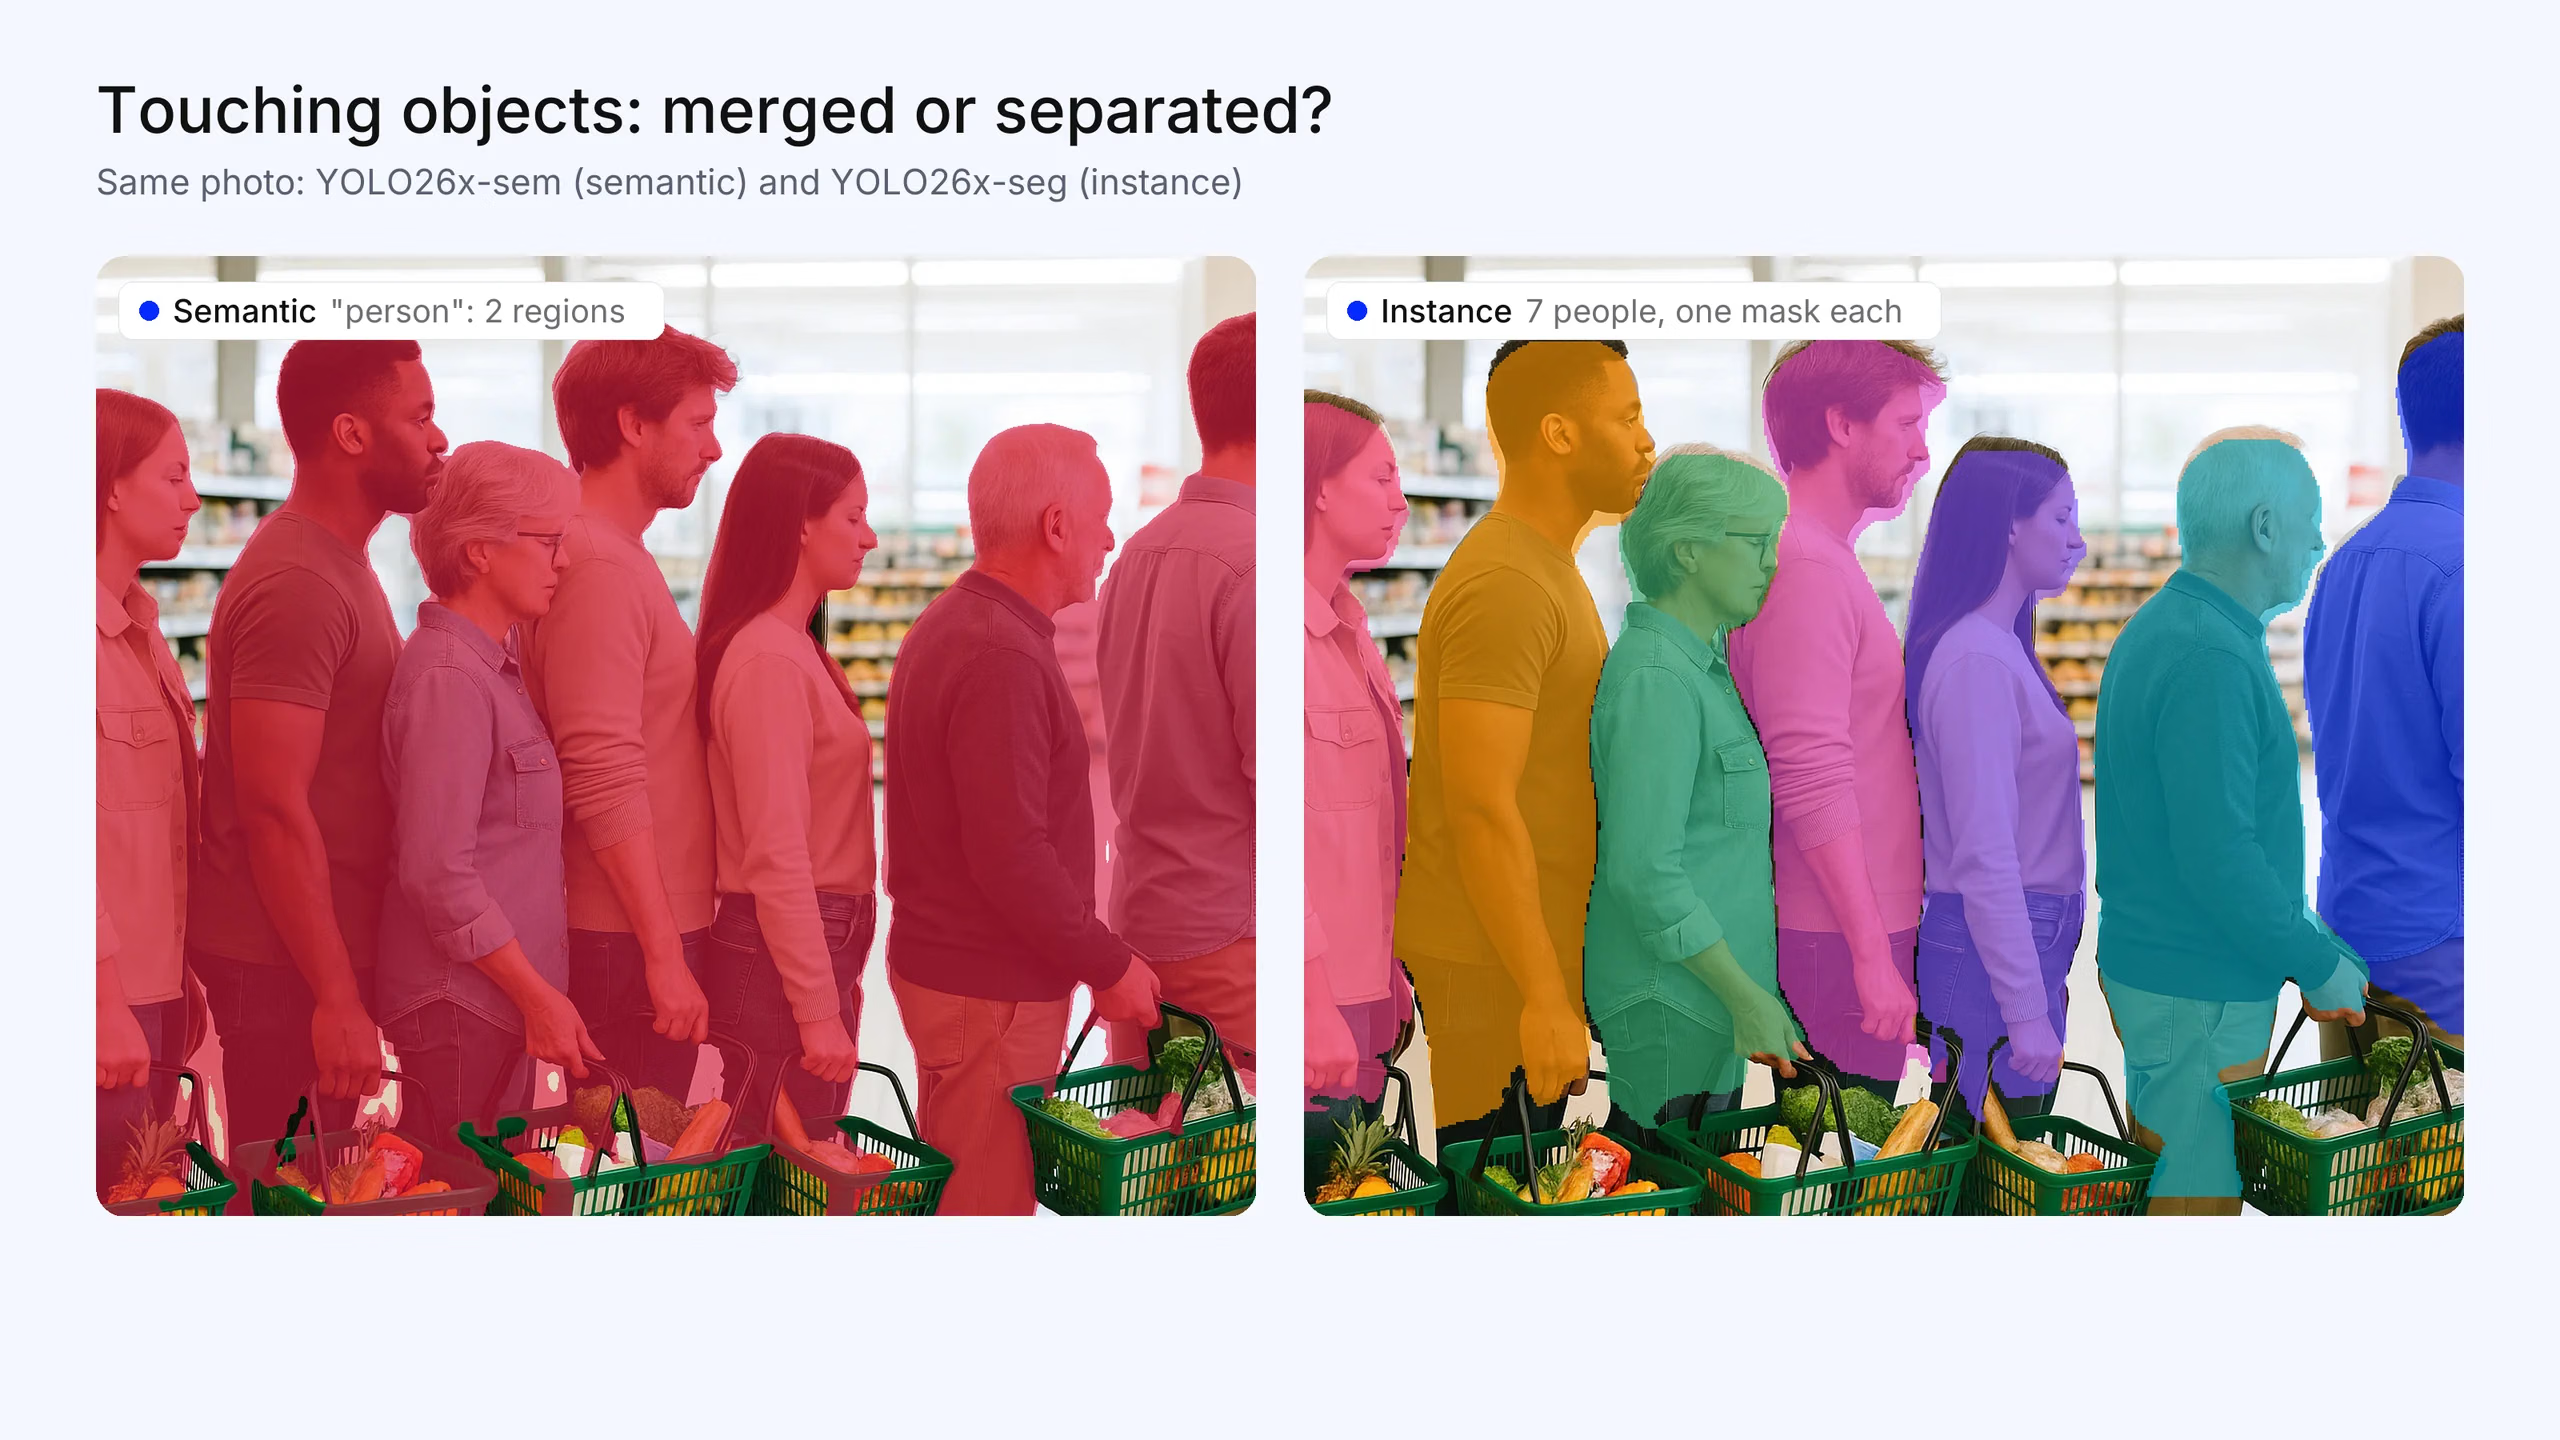
الشكل 2. سبعة متسوقين يقفون متقاربين في طابور الدفع. في ناتج التقسيم الدلالي (Ultralytics YOLO26x-sem)، يندمجون في منطقتين متصلتين من فئة «شخص»، لذا لا يمكن عدّهم منه. أما ناتج تقسيم الكائنات (Ultralytics YOLO26x-seg) فيفصل الأشخاص السبعة جميعًا. أُنشئت الصورة لهذا المقال؛ أما الأقنعة فهي نتائج حقيقية للنموذج.
الفروق الرئيسية بنظرة سريعة#
| المعيار | التقسيم الدلالي | تجزئة المثيلات |
|---|---|---|
| السؤال الذي تجيب عنه | ما فئة كل بكسل؟ | إلى أي كائن ينتمي كل بكسل؟ |
| الكائنات من الفئة نفسها | تندمج في منطقة واحدة | تُفصل، ولكل منها قناع ومعرّف خاصان بها |
| التغطية | كل بكسل، بما في ذلك الخلفية | عادةً الكائنات موضع الاهتمام فقط |
| الناتج | خريطة فئات واحدة بحجم الصورة | قائمة أقنعة، لكل منها فئة ودرجة ثقة |
| هل يمكن عدّ الكائنات؟ | ليس مباشرةً | نعم |
| المقياس الرئيسي | متوسط التقاطع على الاتحاد (mIoU) | متوسط الدقة (mask mAP) للأقنعة |
| التعقيد النسبي | أقل: تصنيف لكل بكسل | أعلى: اكتشاف مع أقنعة لكل كائن |
تكلفة توسيم كل مهمة#
غالبًا ما يكون جهد التوسيم هو العامل الحاسم عمليًا في الاختيار.
- مجموعات البيانات الدلالية تعيّن فئة لكل بكسل في كل صورة، بما في ذلك الخلفية. وتُخزّن عادةً على هيئة صور أقنعة ذات قناة واحدة. تُوسم كل صورة بالكامل، لذا لا يجوز تخطي أي بكسل ما لم يُحدّد صراحةً على أنه «تجاهل».
- مجموعات بيانات الكائنات تحدد حدود كل كائن موضع اهتمام على حدة، باستخدام مضلع أو قناع. يمكن ترك الخلفية من دون توسيم، لكن يجب تحديد حدود كل كائن، وتضاعف المشاهد المزدحمة حجم العمل.
كلتا المهمتين تتطلبان جهدًا كبيرًا. ويقلل التوسيم بمساعدة الأدوات، حيث تتحول نقرة أو مربع إلى قناع، الجهد المطلوب لأي من المهمتين. إذا كانت الإجابات على مستوى المناطق كافية، فلا تتحمل تكلفة وسوم الكائنات.
كيفية تقييم كل مهمة#
- يُقاس التقسيم الدلالي أساسًا بمقياس mIoU: مقدار التداخل بين المناطق المتنبأ بها والمناطق الحقيقية، بعد حساب المتوسط عبر الفئات. ويُبلّغ أيضًا عن دقة البكسل. ويمثل IoU مقياس التداخل نفسه المستخدم في الاكتشاف.
- يُقاس تقسيم الكائنات بمقياس mask mAP، أي متوسط الدقة المستخدم في الاكتشاف لكن بحسابه على تداخل الأقنعة. ويكافئ هذا المقياس اكتشاف كل كائن، لا مجرد تغطية البكسلات الصحيحة.
لا يمكن مقارنة هذه المقاييس بعضها ببعض. فارتفاع mIoU لا يخبرك ما إذا كانت الكائنات الفردية قد فُصلت.
التقسيم الشامل: عندما تحتاج إلى المهمتين#
التقسيم الشامل يعيّن فئة لكل بكسل، ومعرّف كائن للكائنات القابلة للعد. وتُوسم عناصر الخلفية «stuff»، مثل الطريق والسماء، دلاليًا. أما عناصر المقدمة «things»، مثل السيارات والأشخاص، فتُفصل واحدًا واحدًا. ويُقاس هذا التقسيم بمقياس الجودة الشاملة (PQ). اختره عندما تحتاج في الوقت نفسه إلى تغطية المشهد بالكامل وفصل كل كائن. راجع التقسيم الشامل.
آلية عمل كل منهما بإيجاز#
عادةً ما تكون نماذج التقسيم الدلالي شبكات مشفّر-مفكّك تتنبأ بفئة كل بكسل. ومن أمثلتها المعروفة U-Net وDeepLab وSegFormer. أما نماذج تقسيم الكائنات فتعتمد عادةً على اكتشاف الأجسام. يتنبأ Mask R-CNN بقناع داخل كل مربع مكتشف، بينما تتنبأ نماذج المرحلة الواحدة مثل YOLACT ونماذج تقسيم Ultralytics YOLO بالمربعات والأقنعة في تمريرة واحدة للاستخدام الفوري. وتتعامل البنى العامة مثل Mask2Former مع التقسيم الدلالي وتقسيم الكائنات والتقسيم الشامل باستخدام نموذج واحد. لمزيد من المعلومات عن تقسيم الكائنات، راجع ما تقسيم الكائنات؟.
المهمتان في Ultralytics YOLO#
ينفّذ Ultralytics YOLO المهمتين باستخدام واجهة Python وCLI نفسيهما:
- تستخدم عملية تقسيم المثيلات مهمة
segmenttask. - تستخدم عملية التقسيم الدلالي مهمة
semantictask. وتحمل نماذج YOLO26 الدلالية اللاحقة-sem، وتأتي مدرّبة مسبقًا على Cityscapes وADE20K. تتضمن صفحة المهمة جدولًا يوضح بدقة اختلاف مخرجات المهمتين في الشيفرة.
يمكن تدريب كليهما محليًا أو سحابيًا على منصة Ultralytics.
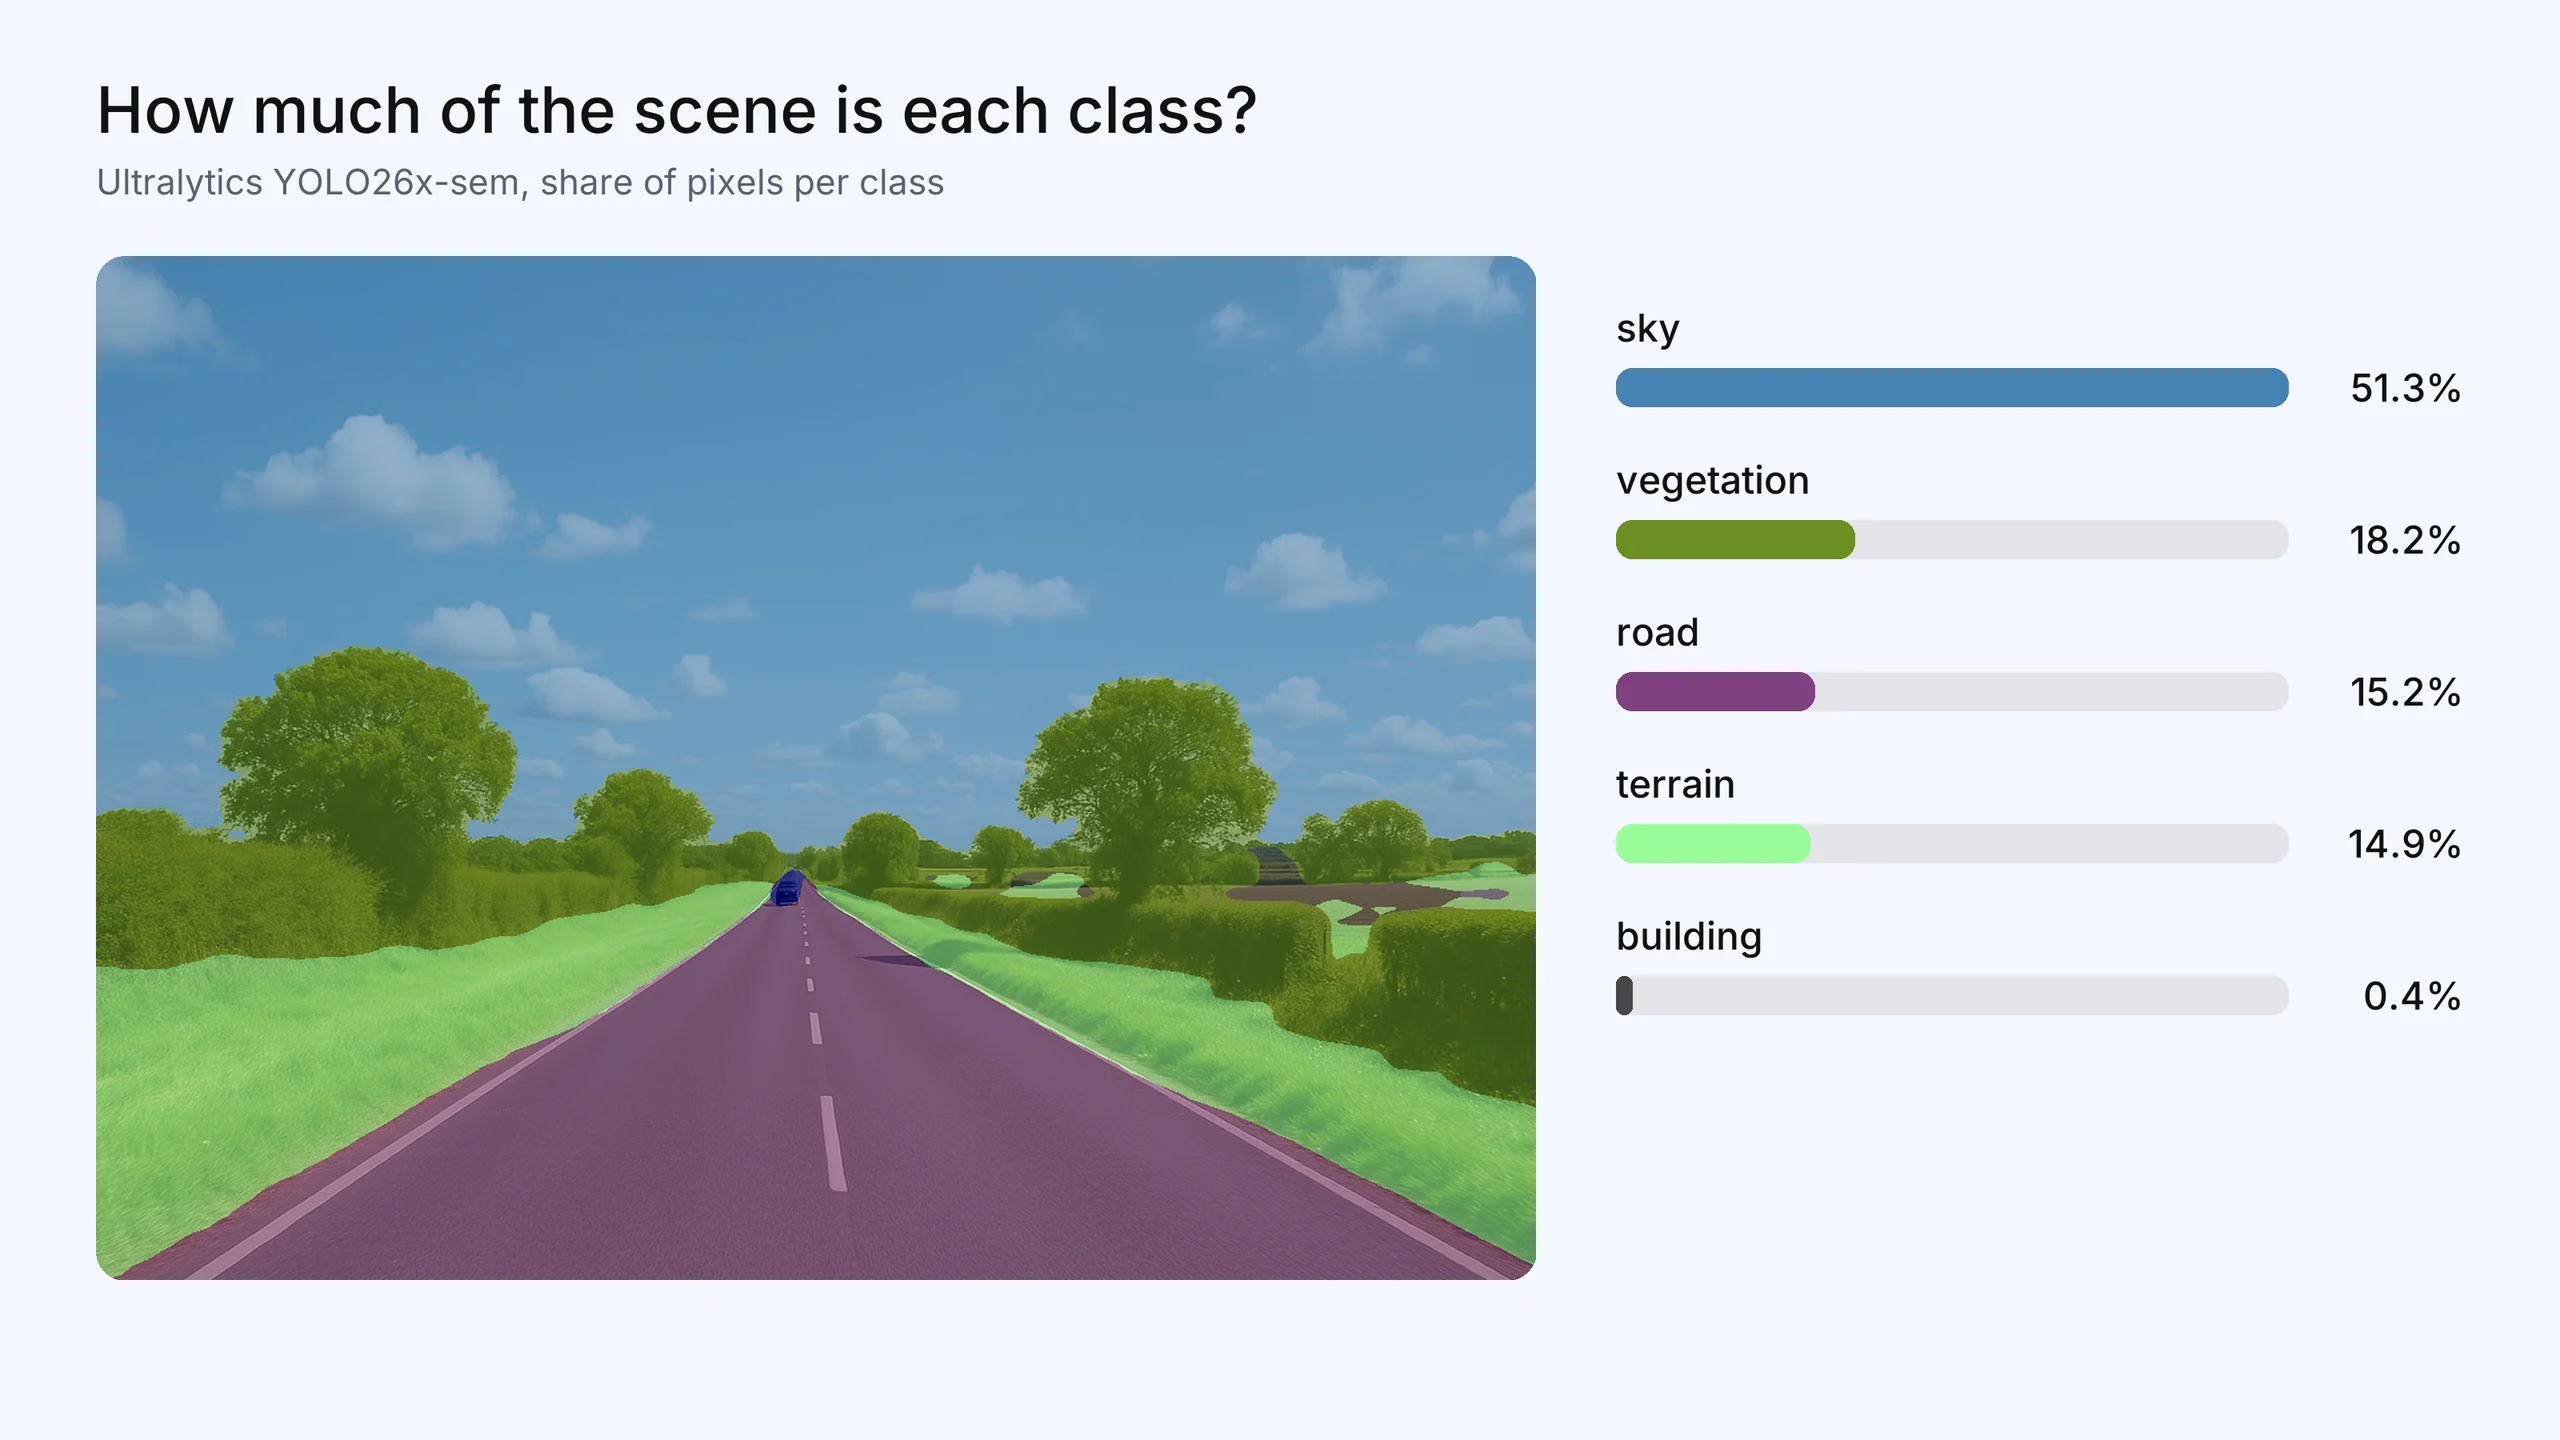
الشكل 3. يجيب التقسيم الدلالي عن سؤال «ما مقدار المشهد الذي تمثله كل فئة؟». يصنّف Ultralytics YOLO26x-sem نسبة 51.3% من هذا المشهد على أنها سماء، و18.2% على أنها غطاء نباتي، و15.2% على أنها طريق، و14.9% على أنها تضاريس. أُنشئت الصورة لهذه المقالة؛ أما خريطة الفئات والنسب فهي مخرجات حقيقية للنموذج.
الأسئلة الشائعة
يصنّف التقسيم الدلالي كل وحدة بكسل ضمن فئة، لكنه يتعامل مع جميع الكائنات من الفئة نفسها بوصفها منطقة واحدة. أما تقسيم المثيلات فيفصل كل كائن في قناع مستقل، ما يتيح عدّ الكائنات من الفئة نفسها وتتبعها كلًّا على حدة.
اسأل ما إذا كان يلزم التمييز بين كائنين متلامسين من الفئة نفسها. إذا كنت بحاجة إلى عدّ كائنات فردية أو تتبعها أو التعامل معها، فاستخدم تقسيم المثيلات. أما إذا كنت تحتاج فقط إلى معرفة الفئة التي تنتمي إليها كل منطقة، فالتقسيم الدلالي أبسط.
Mask R-CNN نموذج لتقسيم المثيلات. إذ يكتشف كل كائن، ثم يتنبأ بقناع مستقل لوحدات البكسل داخل المربع المحيط بذلك الكائن.
يكون تقسيم المثيلات أصعب عمومًا. فهو يتطلب تصنيف وحدات البكسل وفصل الكائنات المنتمية إلى الفئة نفسها بعضها عن بعض، ما يستلزم الكشف إلى جانب التقسيم.
يُقاس غالبًا بمتوسط التقاطع على الاتحاد (mIoU)، وهو متوسط التداخل بين المناطق المتوقعة والحقيقية عبر الفئات. ويُقيّم تقسيم المثيلات باستخدام mAP للأقنعة، بينما يُقيّم التقسيم الشامل باستخدام جودة التقسيم الشامل (PQ).









