أفضل نماذج تصنيف الصور: كيف تختار؟
قارن أبرز نماذج تصنيف الصور، من ConvNeXt V2 وDINOv3 إلى EfficientNetV2 وViT وUltralytics YOLO26-cls، وتعرّف على كيفية الاختيار بينها.
لا يوجد نموذج واحد هو الأفضل لتصنيف الصور. يعتمد الاختيار المناسب على كمية البيانات المصنفة المتاحة لديك، ومكان تشغيل النموذج، وما إذا كان الترخيص يتيح لك استخدامه. في عام 2026، تتمحور الأعمال التي تعطي الأولوية للدقة حول البنى الأساسية الكبيرة القائمة على Transformer والتعلم الذاتي الإشراف، مثل DINOv3 وEVA-02. أما للنشر على الأجهزة محدودة الموارد، فغالبًا ما تكون النماذج الأصغر، المعتمدة في معظمها على الالتفاف، مثل ConvNeXt V2 وEfficientNetV2 وMobileNetV4 وUltralytics YOLO26-cls، أكثر عملية، وفقًا لحجم نقطة التحقق وإعداد التدريب والجهاز المستهدف. قارن دقتها وزمن الاستجابة على عبء العمل الخاص بك. يشرح هذا الدليل عائلات النماذج الأربع، ويقارن عشرة نماذج واسعة الاستخدام، ويقدم مسارًا لاتخاذ القرار واختيار أحدها.
إذا كنت جديدًا على المهمة نفسها، فابدأ بـما هو تصنيف الصور. تركز هذه الصفحة على اختيار نموذج.
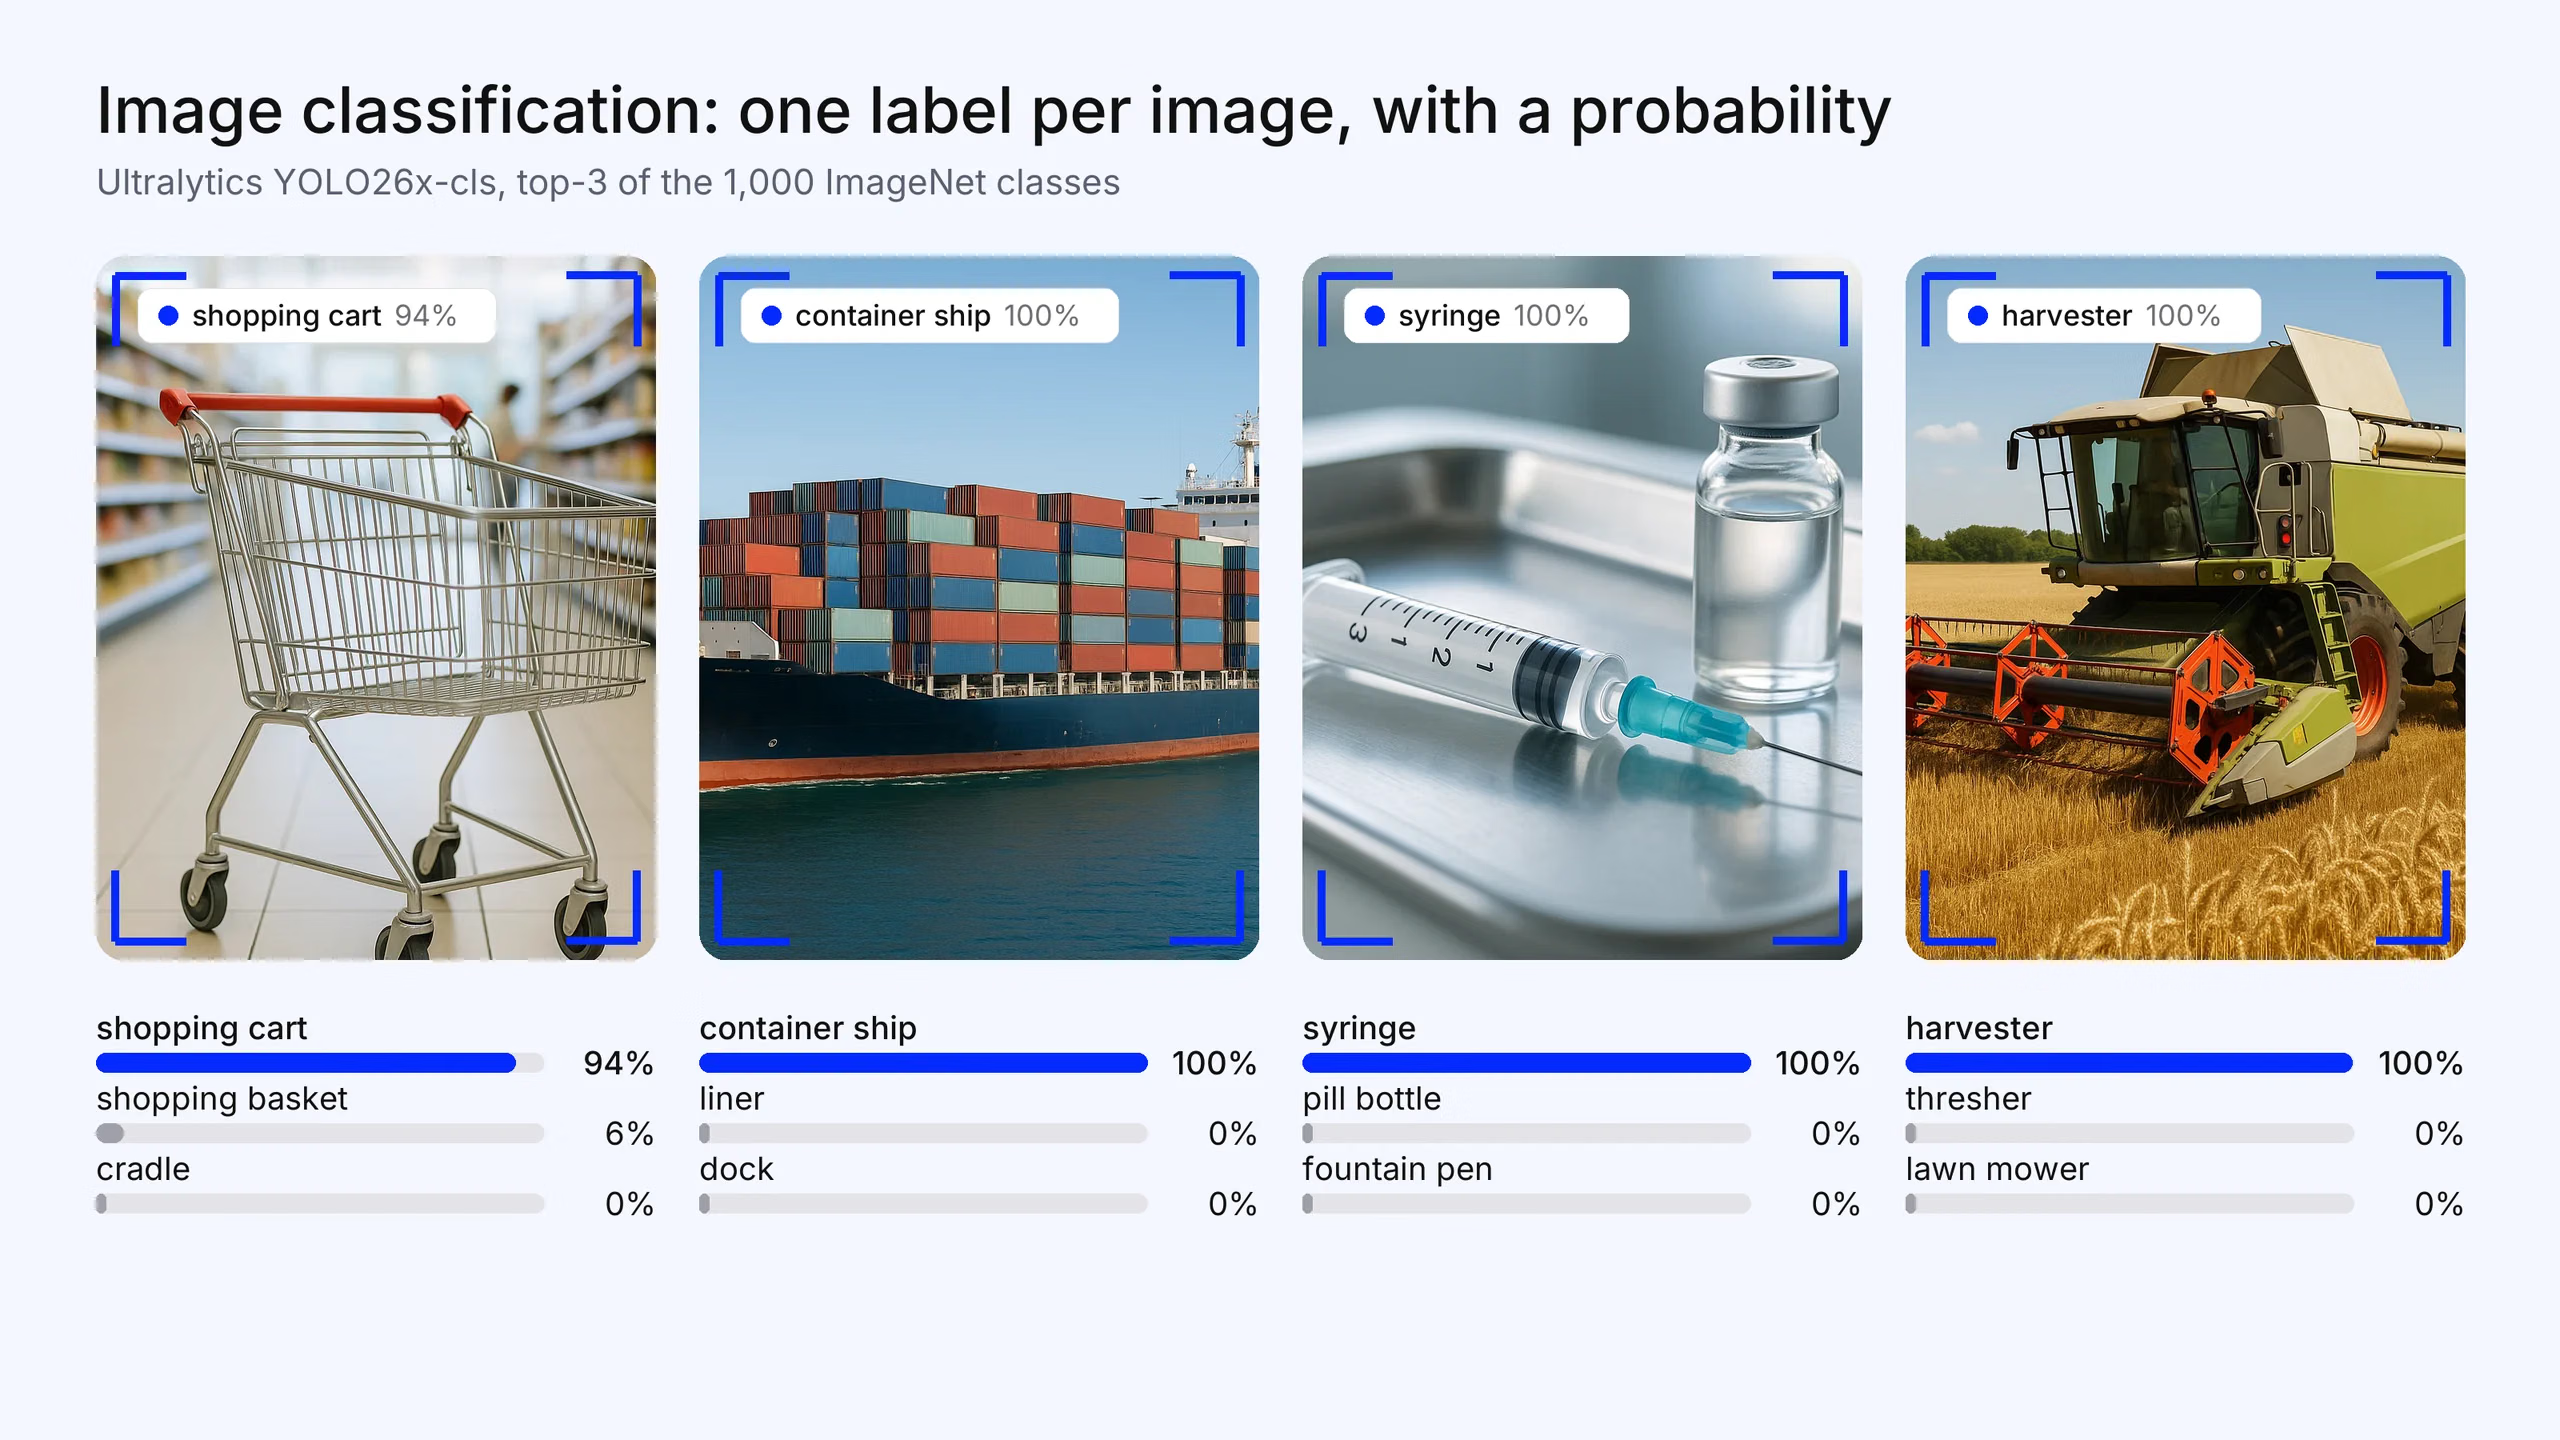
الشكل 1. يعيد تصنيف الصور تسمية واحدة للصورة بأكملها، مع احتمال لكل فئة: أمثلة من قطاعات البيع بالتجزئة والخدمات اللوجستية والرعاية الصحية والزراعة. أفضل 3 تنبؤات من Ultralytics YOLO26x-cls، المدرّب مسبقًا على فئات ImageNet البالغ عددها 1,000. أُنشئت الصور لهذه المقالة؛ أما التنبؤات فهي مخرجات فعلية للنموذج.
ما المقصود بـ«الأفضل» في نموذج تصنيف الصور؟#
ترتب لوحات الصدارة النماذج حسب دقة top-1 على مجموعة التحقق من ImageNet. هذا الرقم مفيد، لكنه يُقاس بدقة ثابتة وعلى مجموعة بيانات واحدة، وغالبًا بعد تدريب مسبق واسع النطاق. وعادةً ما تحسم أربعة عوامل أخرى نجاح المشروع الفعلي:
- البيانات. عدد الصور المصنفة المتاحة لديك لكل فئة، ومدى قربها من بيانات التدريب المسبق.
- الحوسبة وزمن الاستجابة. ما إذا كان الاستدلال سيعمل على GPU في مركز بيانات، أو CPU، أو هاتف أو NPU في كاميرا.
- مسار النشر. مدى سهولة تصدير النموذج إلى بيئة التشغيل التي تحتاج إليها، مثل ONNX أو TensorRT أو Core ML أو TFLite.
- الترخيص. ما إذا كان الكود، والأوزان المدرّبة مسبقًا كلٌ على حدة، يسمحان بالاستخدام الذي تريده.
عادةً ما يكون النموذج الأقل ببضع نقاط على ImageNet، الذي يُضبط بدقة على صورك ويعمل آنياً على أجهزتك، هو الخيار الأفضل.
العائلات الأربع لنماذج تصنيف الصور#
الشبكات العصبية الالتفافية (CNNs)#
تُمرر CNNs المرشحات المتعلّمة على الصورة، لذا تفترض ترابط البكسلات المتجاورة. ويساعدها هذا الافتراض المضمّن (الانحياز الاستقرائي) على التعلم بفاعلية من مجموعات البيانات الصغيرة والمتوسطة وتشغيلها بكفاءة على الأجهزة محدودة الإمكانات. ومن أمثلتها الكلاسيكية ResNet وEfficientNet.
- نقاط القوة: كفاءة في استخدام البيانات، وسرعة، وسهولة التكميم والنشر.
- المقايضات: سياق عالمي أقل لكل طبقة؛ وتميل مكاسب التوسيع إلى التسطح في وقت أبكر مقارنةً بنماذج Transformer.
محولات الرؤية (ViTs)#
يقسم محول الرؤية الصورة إلى رقع ويعالجها كتسلسل باستخدام الانتباه الذاتي، بحيث يمكن لكل رقعة الارتباط بكل رقعة أخرى. ويحقق ViT أفضل أداء عند تدريبه مسبقًا على كميات كبيرة من البيانات ثم نقله إلى مهام أخرى.
- نقاط القوة: يتوسع جيدًا مع البيانات وحجم النموذج؛ ونقل تعلّم قوي؛ وهو الأساس الطبيعي للتدريب بالتعلم الذاتي الإشراف ومتعدد الوسائط.
- المقايضات: يحتاج إلى تدريب مسبق واسع النطاق أو تنظيم مكثف؛ وعادةً ما يكون أبطأ وأثقل أثناء الاستدلال من CNN مماثل له في الدقة.
النماذج الهجينة من CNN وTransformer#
تستخدم النماذج الهجينة الالتفاف في المراحل المبكرة لالتقاط التفاصيل المحلية، والانتباه في المراحل اللاحقة لاستخلاص السياق العالمي. ويُعد CoAtNet التصميم المرجعي؛ إذ وجد مؤلفوه أن ترتيب طبقات الالتفاف والانتباه وفق منهجية مدروسة يحسن التعميم والسعة والكفاءة.
- نقاط القوة: توازن جيد لمجموعات البيانات متوسطة الحجم.
- المقايضات: أكثر تعقيدًا في التنفيذ والضبط والتصدير من أي من التصميمين الخالصين.
البنى الأساسية للتعلم الذاتي الإشراف والرؤية واللغة#
لا تحدد بنية أحدث عائلة من النماذج، بل طريقة تدريبها. تتعلم نماذج التعلم الذاتي الإشراف، مثل DINOv2 وDINOv3، من الصور غير المصنفة. أما مشفّرات الرؤية واللغة، مثل SigLIP 2، فتتعلم من أزواج الصور والنصوص. وينتج كلا النوعين سمات متعددة الأغراض يمكن تصنيفها باستخدام رأس خطي صغير، أو، في حالة نماذج الرؤية واللغة، باستخدام مطالبات نصية ومن دون أي تدريب (التعلم دون أمثلة). درّبت Meta نموذج DINOv3 باستخدام 7 مليارات معلمة على 1.7 مليار صورة، مقارنةً بـ1.1 مليار معلمة و142 مليون صورة في DINOv2.
- نقاط القوة: سمات قوية مع قدر قليل من البيانات المصنفة؛ وبنية أساسية واحدة تخدم مهام متعددة.
- المقايضات: نقاط التحقق الأكبر حجمًا أثقل بكثير من أن تعمل على الأجهزة الطرفية؛ وتختلف التراخيص ويجب التحقق منها.
مقارنة نماذج تصنيف الصور#
تُسرد النماذج أبجديًا، لا حسب الترتيب. لم ندرج أرقام الدقة: تختلف أرقام ImageNet المنشورة باختلاف الدقة وبيانات التدريب المسبق ومنهجية التقييم، لذا لا يمكن مقارنتها بين هذه الصفوف. وتعرض ورقة كل نموذج أو وثائقه، المرتبطة أدناه، أرقامه الخاصة.
| النموذج | العائلة | الجهة | التدريب المسبق | الأنسب لـ | المقايضة الرئيسية |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | ترميز تلقائي مقنّع بالتعلم الذاتي الإشراف (FCMAE)، ثم ضبط دقيق خاضع للإشراف | CNN دقيقة وقابلة للنشر بأحجام متعددة | أوزان ImageNet بترخيص CC-BY-NC (للاستخدام غير التجاري) |
| DINOv3 | التعلم الذاتي الإشراف (ViT وConvNeXt) | Meta | تدريب ذاتي الإشراف على 1.7 مليار صورة | سمات قوية عند تجميد النموذج، مع قدر قليل من البيانات المصنفة | ترخيص DINOv3 مخصص؛ ويضم أكبر نموذج 7 مليارات معلمة |
| EfficientNetV2 | CNN | خاضع للإشراف | تدريب سريع وضبط دقيق فعّال | تصميم أقدم؛ تتفوق البنى الأساسية الأحدث في الدقة | |
| EVA-02 | ViT | BAAI | نمذجة الصور المقنّعة باستخدام سمات CLIP | الأبحاث التي تعطي الأولوية للدقة والضبط الدقيق | المتغيرات الكبيرة ثقيلة أثناء الاستدلال |
| MobileNetV4 | CNN وهجين (للأجهزة المحمولة) | خاضع للإشراف | الهواتف وNPUs ومسرّعات الحوسبة الطرفية | حد أقصى للدقة أقل من نماذج فئة الخوادم | |
| ResNet | CNN | Microsoft Research | خاضع للإشراف | النماذج المرجعية والتعليم ومسارات العمل القديمة | لم يعد منافسًا في الدقة لكل FLOP |
| SigLIP 2 | الرؤية واللغة (ViT) | أزواج الصور والنصوص، متعددة اللغات | التصنيف دون أمثلة والتصنيف بمفردات مفتوحة | تحقق من نتائج التصنيف دون أمثلة على الفئات المستهدفة قبل الاعتماد عليها | |
| Swin Transformer | ViT (هرمي) | Microsoft Research | خاضع للإشراف | مدخلات بدقة أعلى وإعادة استخدام البنية الأساسية | أثقل من CNNs عند دقة مماثلة |
| Ultralytics YOLO26-cls | CNN | Ultralytics | تدريب خاضع للإشراف على ImageNet | مصنفات مخصصة سريعة، وتصدير للأجهزة الطرفية، وواجهة API واحدة مع الكشف | حد أقصى للدقة أقل من محولات Transformer كبيرة مدرّبة مسبقًا |
| ViT | ViT | تدريب خاضع للإشراف، غالبًا على مجموعات بيانات كبيرة | نقل التعلم على نطاق واسع | يتطلب بيانات كثيرة في غياب التدريب المسبق الواسع |
تفاصيل النماذج#
مرتبة أبجديًا.
ConvNeXt V2#
يجمع ConvNeXt V2 بين مرمّز تلقائي مقنّع كامل الالتفاف (FCMAE) وطبقة لتطبيع الاستجابة العامة. ويتوفر بثمانية أحجام، من Atto (3.7 ملايين معلمة) إلى Huge (660 مليونًا)، ما يتيح لعائلة واحدة تغطية الأجهزة الطرفية والخوادم. وهو خيار افتراضي قوي عندما تريد دقة بمستوى نماذج Transformer مع سهولة نشر CNN. المقايضة: الكود مرخّص بموجب MIT، لكن الأوزان المدربة مسبقًا والمضبوطة بدقة على ImageNet مرخّصة بموجب CC-BY-NC، ما يمنع الاستخدام التجاري لتلك الأوزان.
DINOv3#
DINOv3 هو بنية Meta الأساسية للرؤية بالتعلم الذاتي الإشراف. ويصدر على هيئة نماذج ViT من ViT-S/16 إلى ViT-7B/16، إضافةً إلى نماذج ConvNeXt مقطّرة للاستخدام على الجهاز. تقيّمه Meta مع تجميد البنية الأساسية، ويضم المستودع رأس تصنيف ImageNet لنموذج 7B. وهو النموذج الذي يُنصح بتجربته عندما تكون التسميات قليلة وتحتاج إلى سمات قابلة للنقل. المقايضة: يصدر بموجب ترخيص DINOv3 الخاص به، لا بموجب ترخيص مفتوح المصدر قياسي، كما أن النتائج الرئيسية مستمدة من أكبر نموذج.
EfficientNetV2#
يستخدم EfficientNetV2 من Google التعلم التدريجي: إذ يزيد حجم الصورة أثناء التدريب ويضبط التنظيم ليتناسب معه. وهذا يجعله أسرع تدريبًا وأقل استهلاكًا للمعلمات من النماذج السابقة. ولا يزال خيارًا موثوقًا للضبط الدقيق على مجموعات البيانات الصغيرة إلى متوسطة الحجم. المقايضة: يسبق البنى الأساسية التي ظهرت بين 2023 و2025، ولم يعد متصدرًا من حيث الدقة. للاطلاع على خلفية التصميم الأصلي، راجع نظرة عامة على EfficientNet.
EVA-02#
EVA-02 هو نموذج Transformer تقليدي مدرّب مسبقًا بنمذجة الصور المقنّعة لإعادة بناء السمات من مشفّر رؤية CLIP كبير. ويتوفر بأربعة أحجام تتراوح بين 6 ملايين و304 ملايين معلمة. كما يتوفر في timm للضبط الدقيق. المقايضة: يتطلب ضبط المتغيرات الكبيرة وتقديمها موارد كثيرة، وهي مبالغ فيها لمصنفات المجالات البسيطة.
MobileNetV4#
MobileNetV4 أحدث عائلات Google للأجهزة المحمولة، وقد صُمم لتحقيق الكفاءة على وحدات CPU وDSP وGPU في الأجهزة المحمولة، وعلى Apple Neural Engine وGoogle Pixel EdgeTPU. وهو الخيار الطبيعي للهاتف أو لمسرّع منخفض الطاقة. المقايضة: يضحي بأقصى دقة لصالح زمن الاستجابة.
ResNet#
قدّم ResNet الوصلات المتبقية، ولا يزال النموذج المرجعي القياسي الذي تدعمه جميع أطر العمل. المقايضة: تحقق CNNs الأحدث دقة أعلى بالموارد الحاسوبية نفسها. راجع ما هو ResNet-50 للتعرف على البنية.
SigLIP 2#
SigLIP 2 (راجع مدخل مسرد SigLIP) هو عائلة Google من مشفّرات الرؤية واللغة متعددة اللغات. ويمكنه تصنيف الصور مقابل قائمة من التسميات النصية دون تدريب (بنهج مشابه لـ CLIP)، كما يحافظ المتغير NaFlex على نسبة الأبعاد الأصلية للمدخل. وهو الأنسب عندما تتغير مجموعة التسميات لديك كثيرًا أو عندما لا تتوفر لديك بيانات مصنفة بعد. المقايضة: تختلف جودة التصنيف دون أمثلة باختلاف المجال، لذا تحقّق من أدائه على الفئات المستهدفة (مثل أنواع العيوب) قبل الاعتماد عليه. وإذا لم يحقق النتائج المطلوبة، فدرّب رأس تصنيف أو اضبط النموذج بدقة.
Swin Transformer#
يحسب Swin Transformer الانتباه داخل نوافذ محلية متداخلة، ما يجعل الحوسبة خطية بالنسبة إلى حجم الصورة ويلائم المدخلات الأعلى دقة. المقايضة: هو أثقل من CNN مماثل له في الدقة؛ وقد صُمم ConvNeXt لمنافسته باستخدام الالتفافات التقليدية.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls هو متغير التصنيف من Ultralytics YOLO26. ويتوفر بخمسة أحجام (n وs وm وl وx)، من 2.8 مليون إلى 29.6 مليون معلمة (بعد الدمج)، ويقبل مدخلات بحجم 224 بكسل، وهو مدرّب مسبقًا على ImageNet. وتعرض الوثائق دقة top-1 وtop-5 على مجموعة التحقق من ImageNet، إلى جانب زمن الاستجابة على CPU وGPU لكل حجم. وتُستخدم واجهة Python وCLI نفسيهما لتدريب نماذج التصنيف والكشف والتجزؤ وتقدير الوضعية والتحقق منها وتصديرها، كما يمكن تصدير المصنفات إلى تنسيقات تشمل ONNX وTensorRT وCore ML وOpenVINO وLiteRT. وتستخدم نماذج YOLO11-cls السابقة الأحجام الخمسة نفسها وحجم الإدخال نفسه. المقايضات:
- حد الدقة الأقصى. حتى نموذج x صغير مقارنةً بمحولات Transformer الكبيرة المدرّبة مسبقًا، مثل EVA-02 أو DINOv3، لذا فهو ليس الخيار المناسب للأبحاث التي تعطي الأولوية للدقة.
- اقتصاص مربّع افتراضيًا. يستخدم التدريب اقتصاصًا عشوائيًا مع تغيير الحجم، بينما يستخدم التحقق اقتصاصًا مركزيًا؛ وقد يؤدي ذلك إلى اقتطاع أجزاء من الصور ذات نسب الأبعاد المتطرفة. وتوضح الوثائق كيفية استخدام تغيير الحجم العادي بدلًا من ذلك.
- الترخيص. نماذج Ultralytics مرخّصة بموجب AGPL-3.0. ويتطلب الاستخدام التجاري المغلق المصدر ترخيص Ultralytics Enterprise.
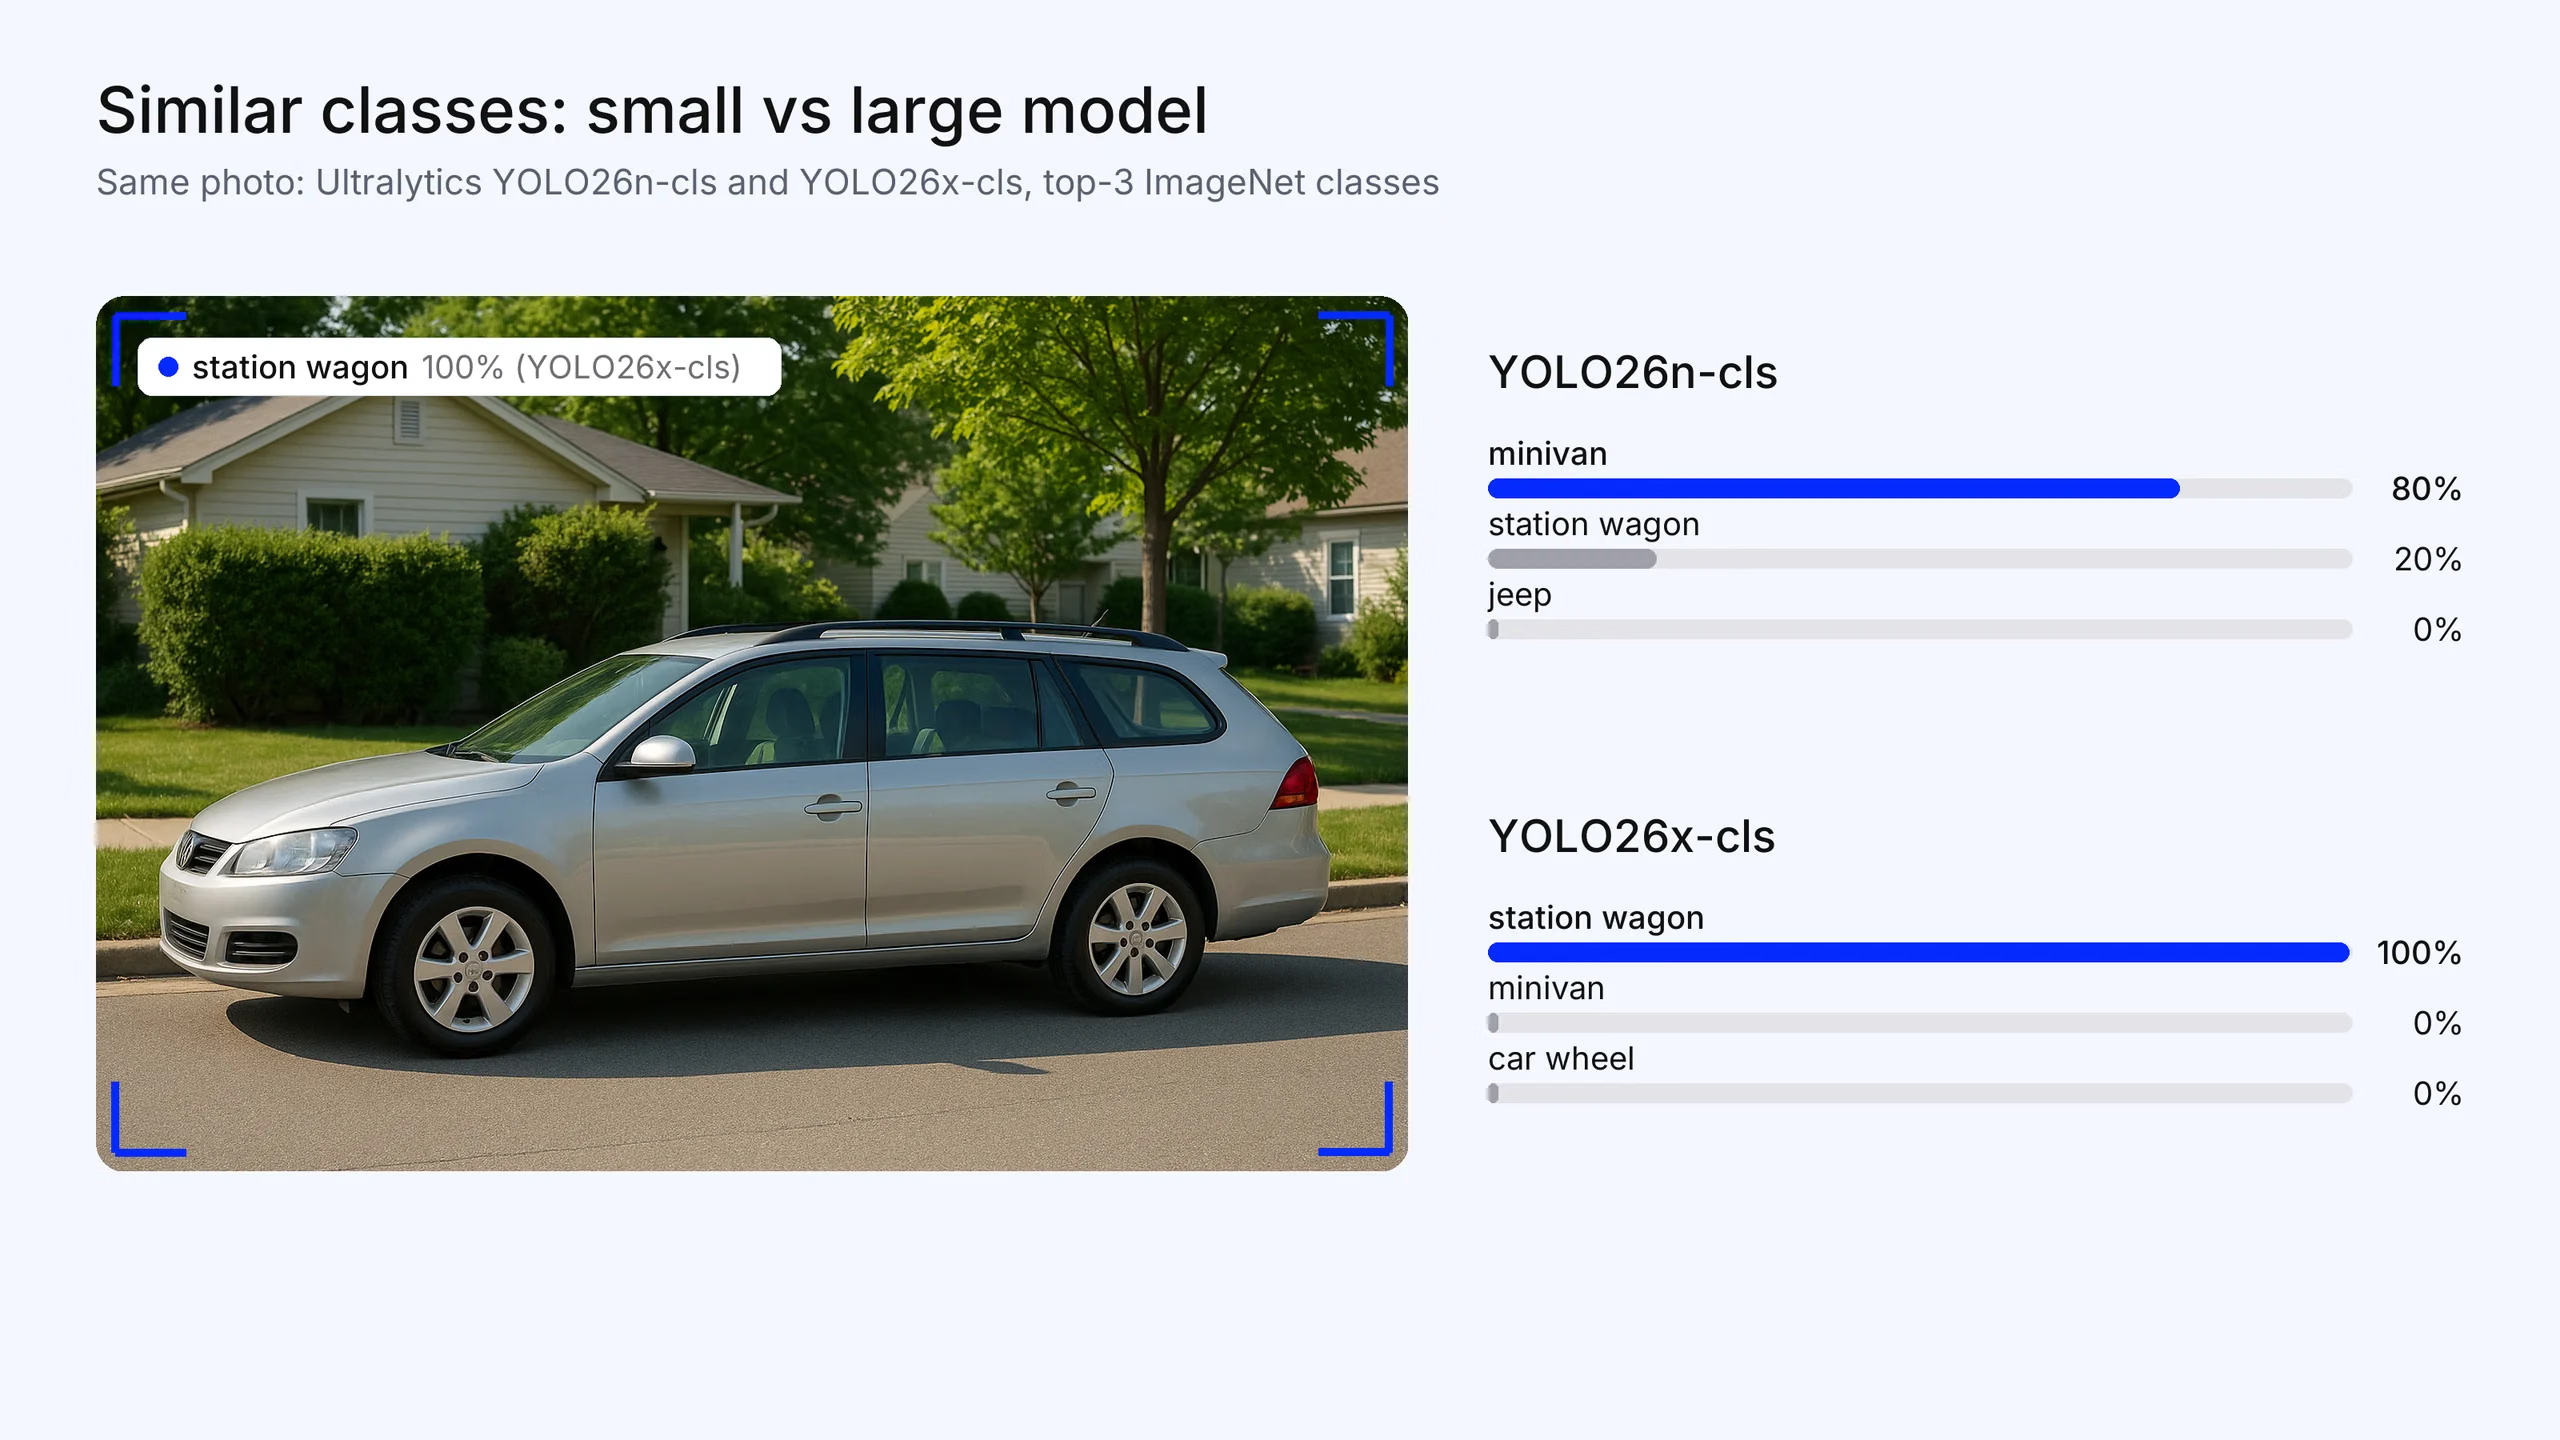
الشكل 2. تظهر أهمية حجم النموذج عند التمييز بين الفئات المتشابهة. في هذه الصورة لسيارة ستيشن واغن، يصنّف Ultralytics YOLO26n-cls «ميني فان» في المرتبة الأولى (80%)، بينما يصنّف YOLO26x-cls سيارة ستيشن واغن في المرتبة الأولى (100%، ضمن فئة ImageNet المسماة «beach wagon, station wagon»). اختبر فئات دقيقة كهذه على مجموعة التحقق الخاصة بك. أُنشئت الصورة لهذا المقال؛ أما التنبؤات فهي نتائج حقيقية للنموذج.
ViT#
أظهر Vision Transformer الأصلي من Google أن Transformer خالصًا يعمل على رقع الصور يمكنه مجاراة CNNs أو التفوق عليها عند تدريبه مسبقًا على كميات كبيرة من البيانات. المقايضة: من دون تدريب مسبق على نطاق واسع، يكون أداؤه أدنى من CNNs على مجموعات البيانات الصغيرة، كما يتطلب حوسبة أكبر أثناء الاستدلال.
كيفية اختيار نموذج لتصنيف الصور#
أجب عن هذه الأسئلة بالترتيب:
- هل لديك بيانات موسومة؟ إذا لم تتوفر أمثلة موسومة، فابدأ بنموذج للرؤية واللغة مثل SigLIP 2 للتصنيف دون أمثلة. وإذا كانت لديك مجموعة بيانات صغيرة موسومة، فقيّم أيضًا العمود الفقري المجمّد DINOv3 مع رأس خطي مدرّب.
- أين سيعمل النموذج؟ على هاتف أو NPU، أدرج MobileNetV4 أو شبكة CNN صغيرة مثل YOLO26n-cls أو ConvNeXt V2 صغيرًا ضمن قائمة المرشحين. للاستدلال الفوري على GPU طرفي أو CPU، انظر إلى YOLO26-cls أو EfficientNetV2 أو ConvNeXt V2. أما على خادم من دون قيود صارمة على زمن الاستجابة، ففكّر في EVA-02 أو Swin أو DINOv3 ViT.
- كمية البيانات الموسومة لكل فئة؟ عند توفر مئات الصور إلى بضعة آلاف منها، يكون التعلّم بالنقل انطلاقًا من CNN مدرّبة مسبقًا أو عمود فقري مجمّد ذاتي الإشراف الخيار الأكثر أمانًا. وعند توفر عشرات الآلاف من الصور أو أكثر، تبدأ المحولات المضبوطة بالكامل في تحقيق فوائد ملموسة.
- هل يمكنك استخدام الترخيص؟ تحقّق من الأوزان، لا من الشيفرة فقط: أوزان ImageNet الخاصة بـ ConvNeXt V2 غير تجارية، ولـ DINOv3 ترخيصه الخاص، أما نماذج Ultralytics فتخضع لترخيص AGPL-3.0 ما لم تكن تحمل ترخيص Enterprise.
- هل يمكن تصديره إلى بيئة التشغيل لديك؟ تأكد من وجود مسار مدعوم إلى ONNX أو TensorRT أو Core ML أو TFLite قبل الالتزام.
بعد ذلك، اضبط نموذجين أو ثلاثة من النماذج المرشحة ضبطًا دقيقًا، وقارن بينها باستخدام مجموعة التحقق الخاصة بك.
متى يكون نموذج آخر أنسب لك من YOLO#
صُمم YOLO26-cls لإنشاء مصنّفات مخصصة سريعة وسهلة النشر. وفي بعض المهام، يكون اختيار نموذج آخر أفضل:
- الأبحاث أو أعمال المقارنة المعيارية التي تعطي الأولوية للدقة: استخدم EVA-02 أو ConvNeXt V2 أو ViT عبر timm، حيث تتوفر وصفات التدريب والأوزان اللازمة لإعادة إنتاج نتائج بمستوى ImageNet.
- عدد قليل جدًا من الوسوم، أو مهام لاحقة متعددة انطلاقًا من عمود فقري واحد: استخدم ميزات DINOv3 مع رأس خطي.
- مجموعات وسوم مفتوحة أو كثيرة التغيّر: استخدم SigLIP 2 للتصنيف دون أمثلة.
- وحدات NPU في الهواتف مثل Apple Neural Engine أو EdgeTPU: صُمم MobileNetV4 واختُبر للعمل تحديدًا على هذه المنصات.
إذا كنت تحتاج أيضًا إلى تحديد مواقع الأجسام، لا إلى معرفة ما تعرضه الصورة فحسب، فأنت بحاجة إلى كاشف. اطّلع على مقارنتنا بين نماذج اكتشاف الأجسام.
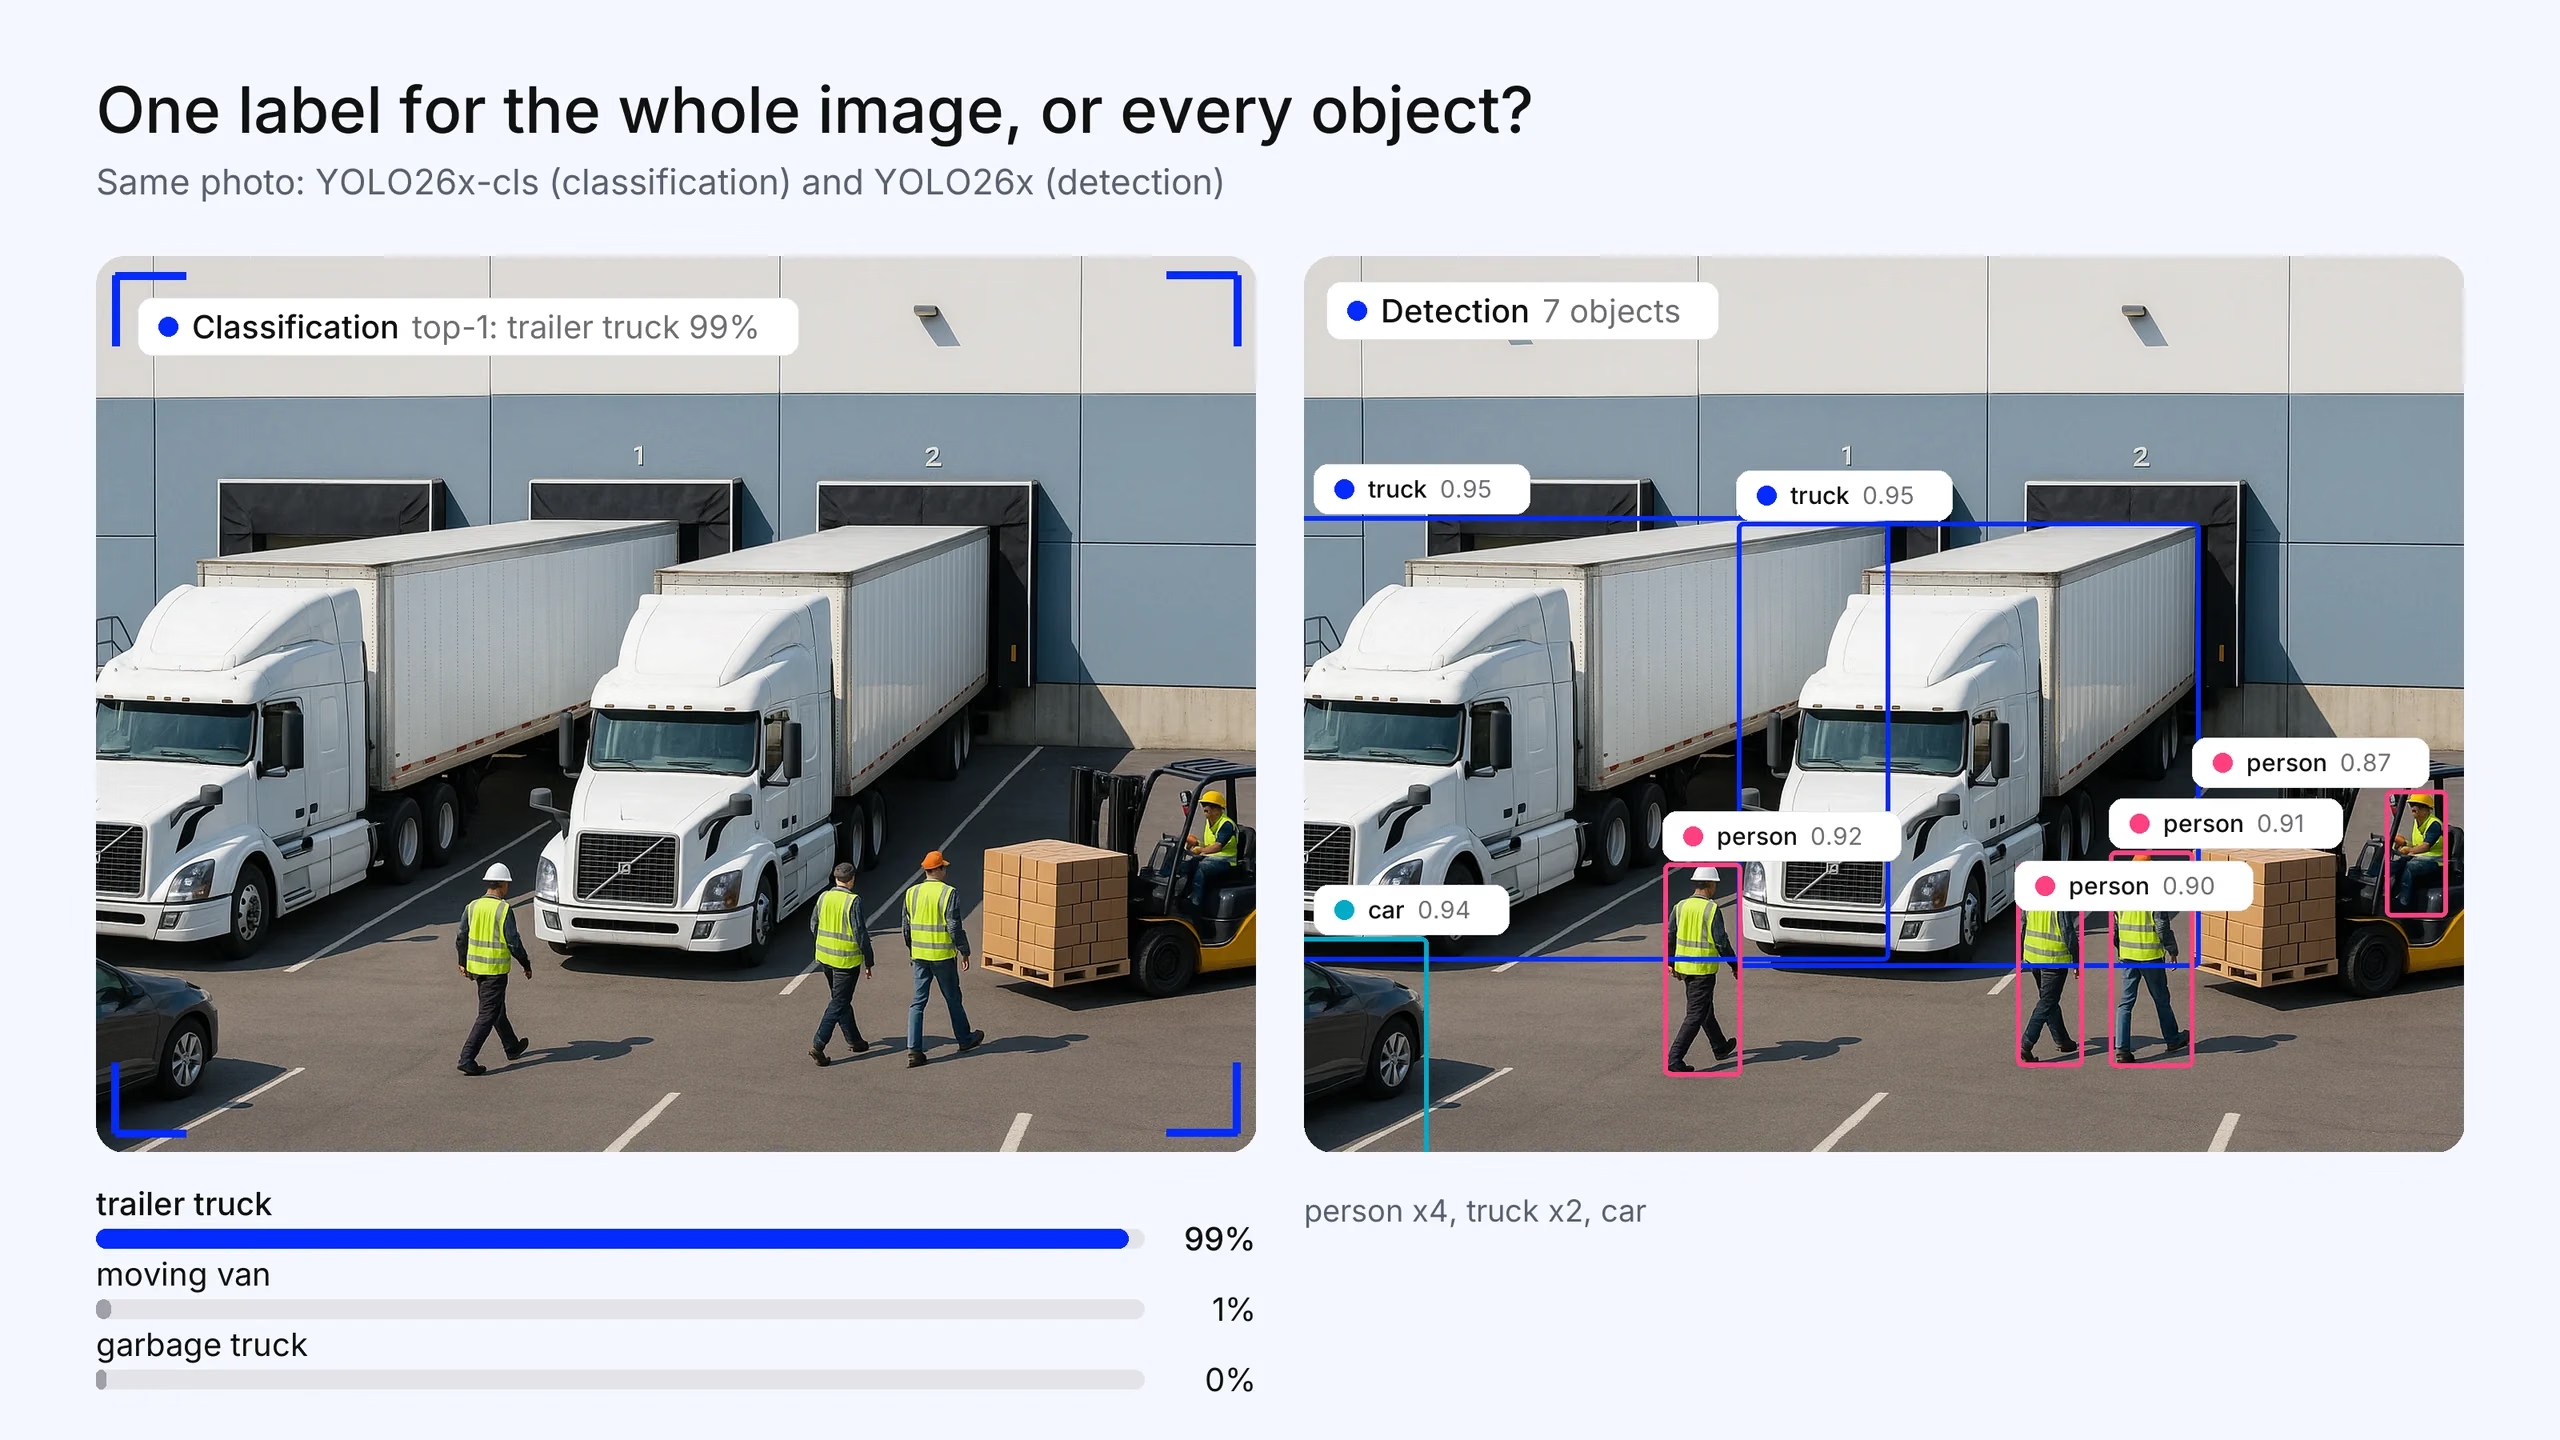
الشكل 3. في مشهد يضم أجسامًا كثيرة، لا يزال المصنّف يعرض وسمًا واحدًا: يصنّف Ultralytics YOLO26x-cls ساحة التوزيع هذه على أنها «شاحنة بمقطورة» بنسبة 99%. ويكتشف Ultralytics YOLO26x سبعة أجسام: 4 أشخاص وشاحنتين وسيارة، ولكل منها مربع خاص بها (بدرجة ثقة 0.5 أو أعلى). أُنشئت الصورة لهذا المقال؛ أما النتائج فهي حقيقية.
أين تجد نماذج مدرّبة مسبقًا وكيف تدرّب نموذجك#
- يجمع timm (نماذج الصور لـ PyTorch) معظم الأعمدة الفقرية المذكورة أعلاه، بدءًا من ViT وConvNeXt وصولًا إلى MobileNetV4 وEVA وDINOv3، إلى جانب نصوص التدريب والتقييم. الشيفرة مرخّصة بموجب Apache 2.0؛ وتختلف تراخيص الأوزان.
- تستضيف Hugging Face معظم مصنّفات Transformer، بما فيها SigLIP 2 وDINOv3، مع مسارات جاهزة للتصنيف دون أمثلة وتصنيف الصور.
- تدرّب حزمة Python الخاصة بـ Ultralytics نموذج YOLO26-cls باستخدام مجلد صور مرتبة حسب الفئة. اطّلع على تنسيق مجموعة بيانات التصنيف ودليل مهمة التصنيف.
- تضيف منصة Ultralytics إمكانات التوسيم والتدريب السحابي للنماذج نفسها. أُطلقت المنصة في عام 2026، لذا فهي أحدث من خدمات التدريب المستضافة الراسخة. ولتقديم النماذج بعد تدريبها، اطّلع على مقارنتنا بين منصات استدلال الرؤية الحاسوبية.
الأسئلة الشائعة
لا يوجد نموذج واحد هو الأفضل في جميع الحالات. للأعمال التي تعطي الأولوية للدقة مع توفر قدر كبير من الحوسبة، ابدأ بتقييم الأعمدة الفقرية الكبيرة المعتمدة على Transformer والتعلّم الذاتي الإشراف، مثل EVA-02 وDINOv3. أما للإنتاج على أجهزة محدودة الموارد، فشبكات CNN مثل ConvNeXt V2 وEfficientNetV2 وMobileNetV4 وUltralytics YOLO26-cls أكثر عملية. وللتصنيف من دون بيانات موسومة، يتيح SigLIP 2 التصنيف دون أمثلة.
تميل محولات الرؤية إلى التفوق عند تدريبها مسبقًا على مجموعات بيانات كبيرة جدًا وعندما لا تكون الحوسبة محدودة. أما شبكات CNN فتميل إلى التفوق على مجموعات البيانات الصغيرة والمتوسطة وعلى الأجهزة الطرفية، لأن افتراضاتها المضمّنة بشأن البنية المحلية تجعلها أكثر كفاءة في استخدام البيانات وأسرع. وقد قلّصت شبكات CNN الحديثة مثل ConvNeXt فجوة الدقة، فيما تجمع النماذج الهجينة مثل CoAtNet بين النهجين.
نعم. DINOv3 عمود فقري متعدد الأغراض. تستخرج الميزات باستخدام النموذج المجمّد وتدرّب مصنّفًا خطيًا صغيرًا فوقه، كما يتضمن مستودع Meta رأسًا لتصنيف ImageNet خاصًا بأكبر نماذجه. تحقّق من ترخيص DINOv3 قبل الاستخدام التجاري.
تُقاس أساسًا بدقة أفضل تنبؤ واحد (top-1)، أي عندما يكون التنبؤ الأعلى صحيحًا، وبدقة أفضل خمسة تنبؤات (top-5)، أي عندما تكون الفئة الصحيحة ضمن التنبؤات الخمسة الأعلى تقييمًا، وعادةً ما يكون ذلك على مجموعة التحقق من ImageNet. وفي مجموعات البيانات المخصصة غير المتوازنة، تكون مقاييس الدقة والاستدعاء أو F1 لكل فئة أكثر إفادة من الدقة الإجمالية.









