كيفية اختيار نموذج VLM للتوسيم التلقائي باستخدام الدقة والاستدعاء
اختر نموذج VLM للتوسيم التلقائي استنادًا إلى الدقة والاستدعاء: ما النماذج التي تنتج عددًا أقل من الصناديق الزائدة، وما النماذج التي تفوّت عددًا أقل من الكائنات، وكيف تختبرها على بياناتك؟
 Sergiu Waxmann14 دقيقة قراءة
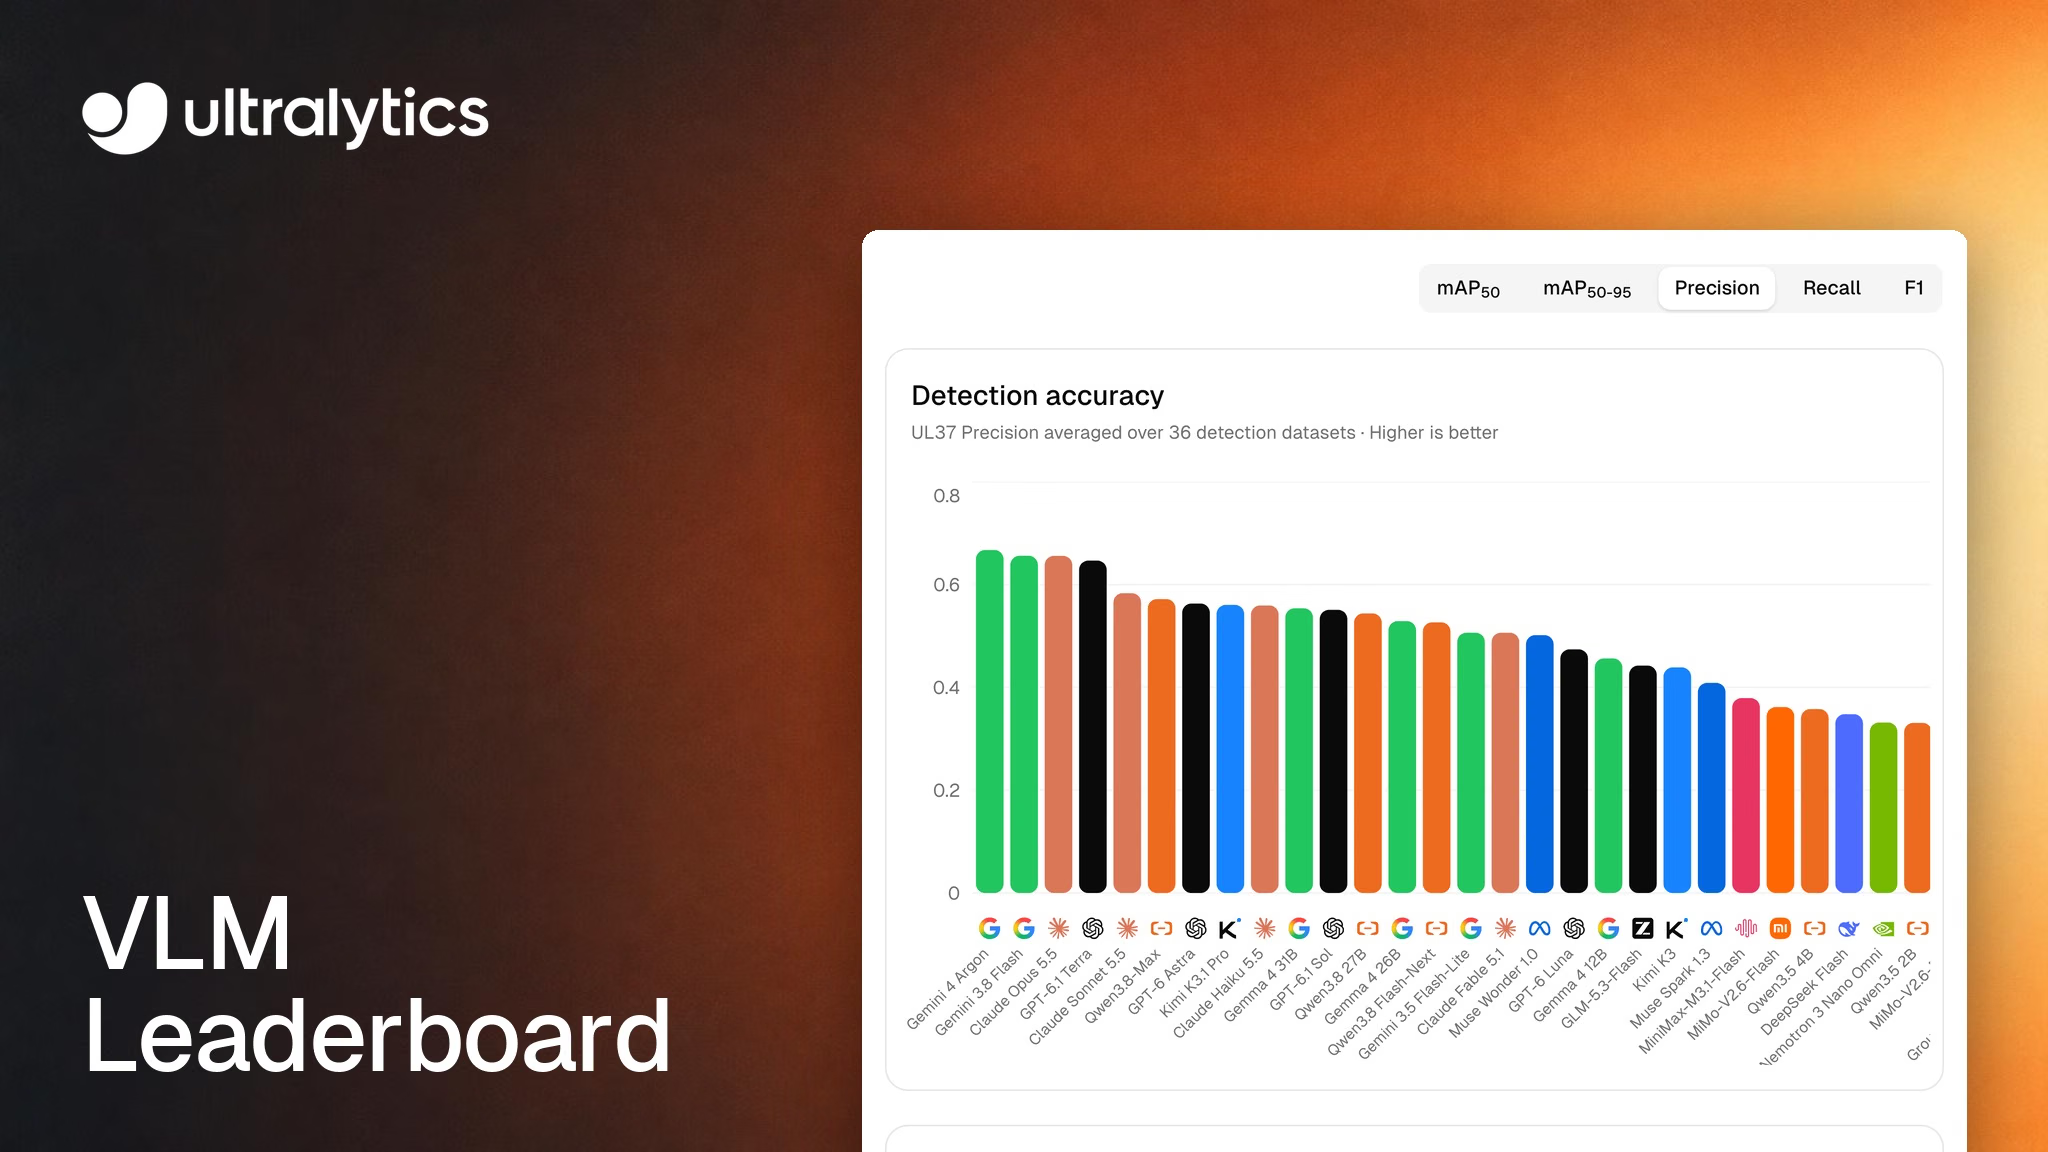
يتوقف اختيار نموذج للتوسيم التلقائي لمجموعة بيانات على نوع التنظيف الذي يفضّل المراجعون إجراءه: حذف الصناديق الزائدة أم إضافة الصناديق التي أغفلها النموذج. تعرض لوحة صدارة VLM من Ultralytics الآن هذه المفاضلة لكل نموذج، مع الدقة (نسبة صناديق النموذج الصحيحة) والاستدعاء (نسبة الكائنات الموسومة التي يعثر عليها)، استنادًا إلى نتائج المعايير المنشورة في 28 أكتوبر 2026.
للحصول على المسودات الأولية الأنظف، ابدأ بـ Gemini 4 Argon. ولتفويت أقل عدد من الكائنات، ابدأ بـ GPT-6 Astra. ولتحقيق أفضل توازن وأقل تكلفة بين النماذج الستة الأعلى تقييمًا، اختر GPT-6.1 Terra. وإذا لم يكن لديك مفتاح API خاص بمزوّد ذكاء اصطناعي، فابدأ بـ Qwen3.8 27B المستضاف، أو SAM 3.1 Text للمشاهد المزدحمة التي تفضّل تنقيحها بحذف الصناديق الزائدة.
يشرح هذا الدليل كيفية قراءة الأرقام، والحالات التي يناسب فيها كل نموذج، وكيفية التحقق من اختيارك باستخدام صورك. تتغير التصنيفات والأسعار بعد كل تشغيل، لذا اعتبر الأرقام الواردة هنا أمثلة من أكتوبر 2026، وراجع لوحة الصدارة للاطلاع على النتائج الحالية.
لا تتيح النماذج التي تستجيب لفئات محددة شريطًا لضبط الثقة، لذا يصبح اختيار النموذج هو عتبة الضبط لديك#
عند استخدام نموذج Ultralytics YOLO في محرر التعليقات التوضيحية، يمكنك ضبط المفاضلة بنفسك. ارفع عتبة الثقة لتحصل على صناديق خاطئة أقل، مقابل زيادة الكائنات الفائتة؛ واخفضها لتحصل على العكس. أما نماذج اللغة والرؤية (VLMs) التي تستجيب لفئات محددة، فتعمل بطريقة مختلفة. وكما توضح وثائق محرر التعليقات التوضيحية، تكتشف هذه النماذج فئات مجموعة بياناتك باستخدام عتبات خاصة بكل نموذج، ولا تُرجع درجات ثقة؛ لذلك تخفي Ultralytics Platform إعدادَي الثقة وIoU عند تحديد أحدها.
يغيّر ذلك دلالة الدقة والاستدعاء في لوحة الصدارة. وفقًا لمنهجية المعيار، تُحتسب الدقة والاستدعاء بناءً على كل صندوق يُرجعه النموذج عند IoU بقيمة 0.5، من دون نقطة تشغيل مخفية. وهما يصفان الصناديق التي يتلقاها المراجعون فعليًا.
المعيار الذي تستند إليه لوحة الصدارة هو UL37 v2: 10 صور من كل مجموعة من مجموعات بيانات اكتشاف الكائنات الحقيقية الـ36 على Platform، بالإضافة إلى 10 صور مرجعية من COCO 2017 تُقيّم منفصلة، أي 370 صورة و7,268 صندوقًا. تمر كل صورة عبر مسار الإنتاج نفسه المستخدم في Smart وBatch Annotation، مع أسماء الفئات الخاصة بمجموعة البيانات، وتحسّن SAM 3.1 صناديق كل نموذج باستثناء صناديق SAM 3. ويستخدم التقييم مقاييس الاكتشاف الخاصة بحزمة Ultralytics نفسها، وهي الشيفرة المستخدمة للتحقق من نماذج YOLO، كما تُمنح كل مجموعة بيانات الوزن نفسه عند حساب المتوسط.
تقيس الدقة الصناديق غير المطابقة، ويقيس الاستدعاء الكائنات غير المطابقة#
الدقة هي نسبة صناديق النموذج التي تطابق كائنًا موسومًا من الفئة الصحيحة عند IoU بقيمة 0.5. أما الاستدعاء فهو نسبة الكائنات الموسومة التي طابقها النموذج. ومن منظور المراجعة:
- انخفاض الدقة يعني وجود صناديق أكثر تستلزم الحذف أو إعادة التوسيم أو تغيير الحجم حتى تصبح مطابقة.
- انخفاض الاستدعاء يعني وجود كائنات موسومة أكثر تستلزم إضافة صندوق لها أو تغيير حجمه أو إعادة توسيمه.
- F1 هو المتوسط التوافقي للقيمتين، 2 x P x R / (P + R)، أي رقم واحد يلخصهما معًا. لكنه لا يقيس المدة التي تستغرقها المراجعة.
- mAP50 وmAP50-95 يرتّبان النماذج وفق متوسط الدقة عبر الفئات، عند IoU بقيمة 0.5 وعبر العتبات الأكثر صرامة من 0.50 إلى 0.95. ويُستخدم mAP50 لترتيب لوحة الصدارة.
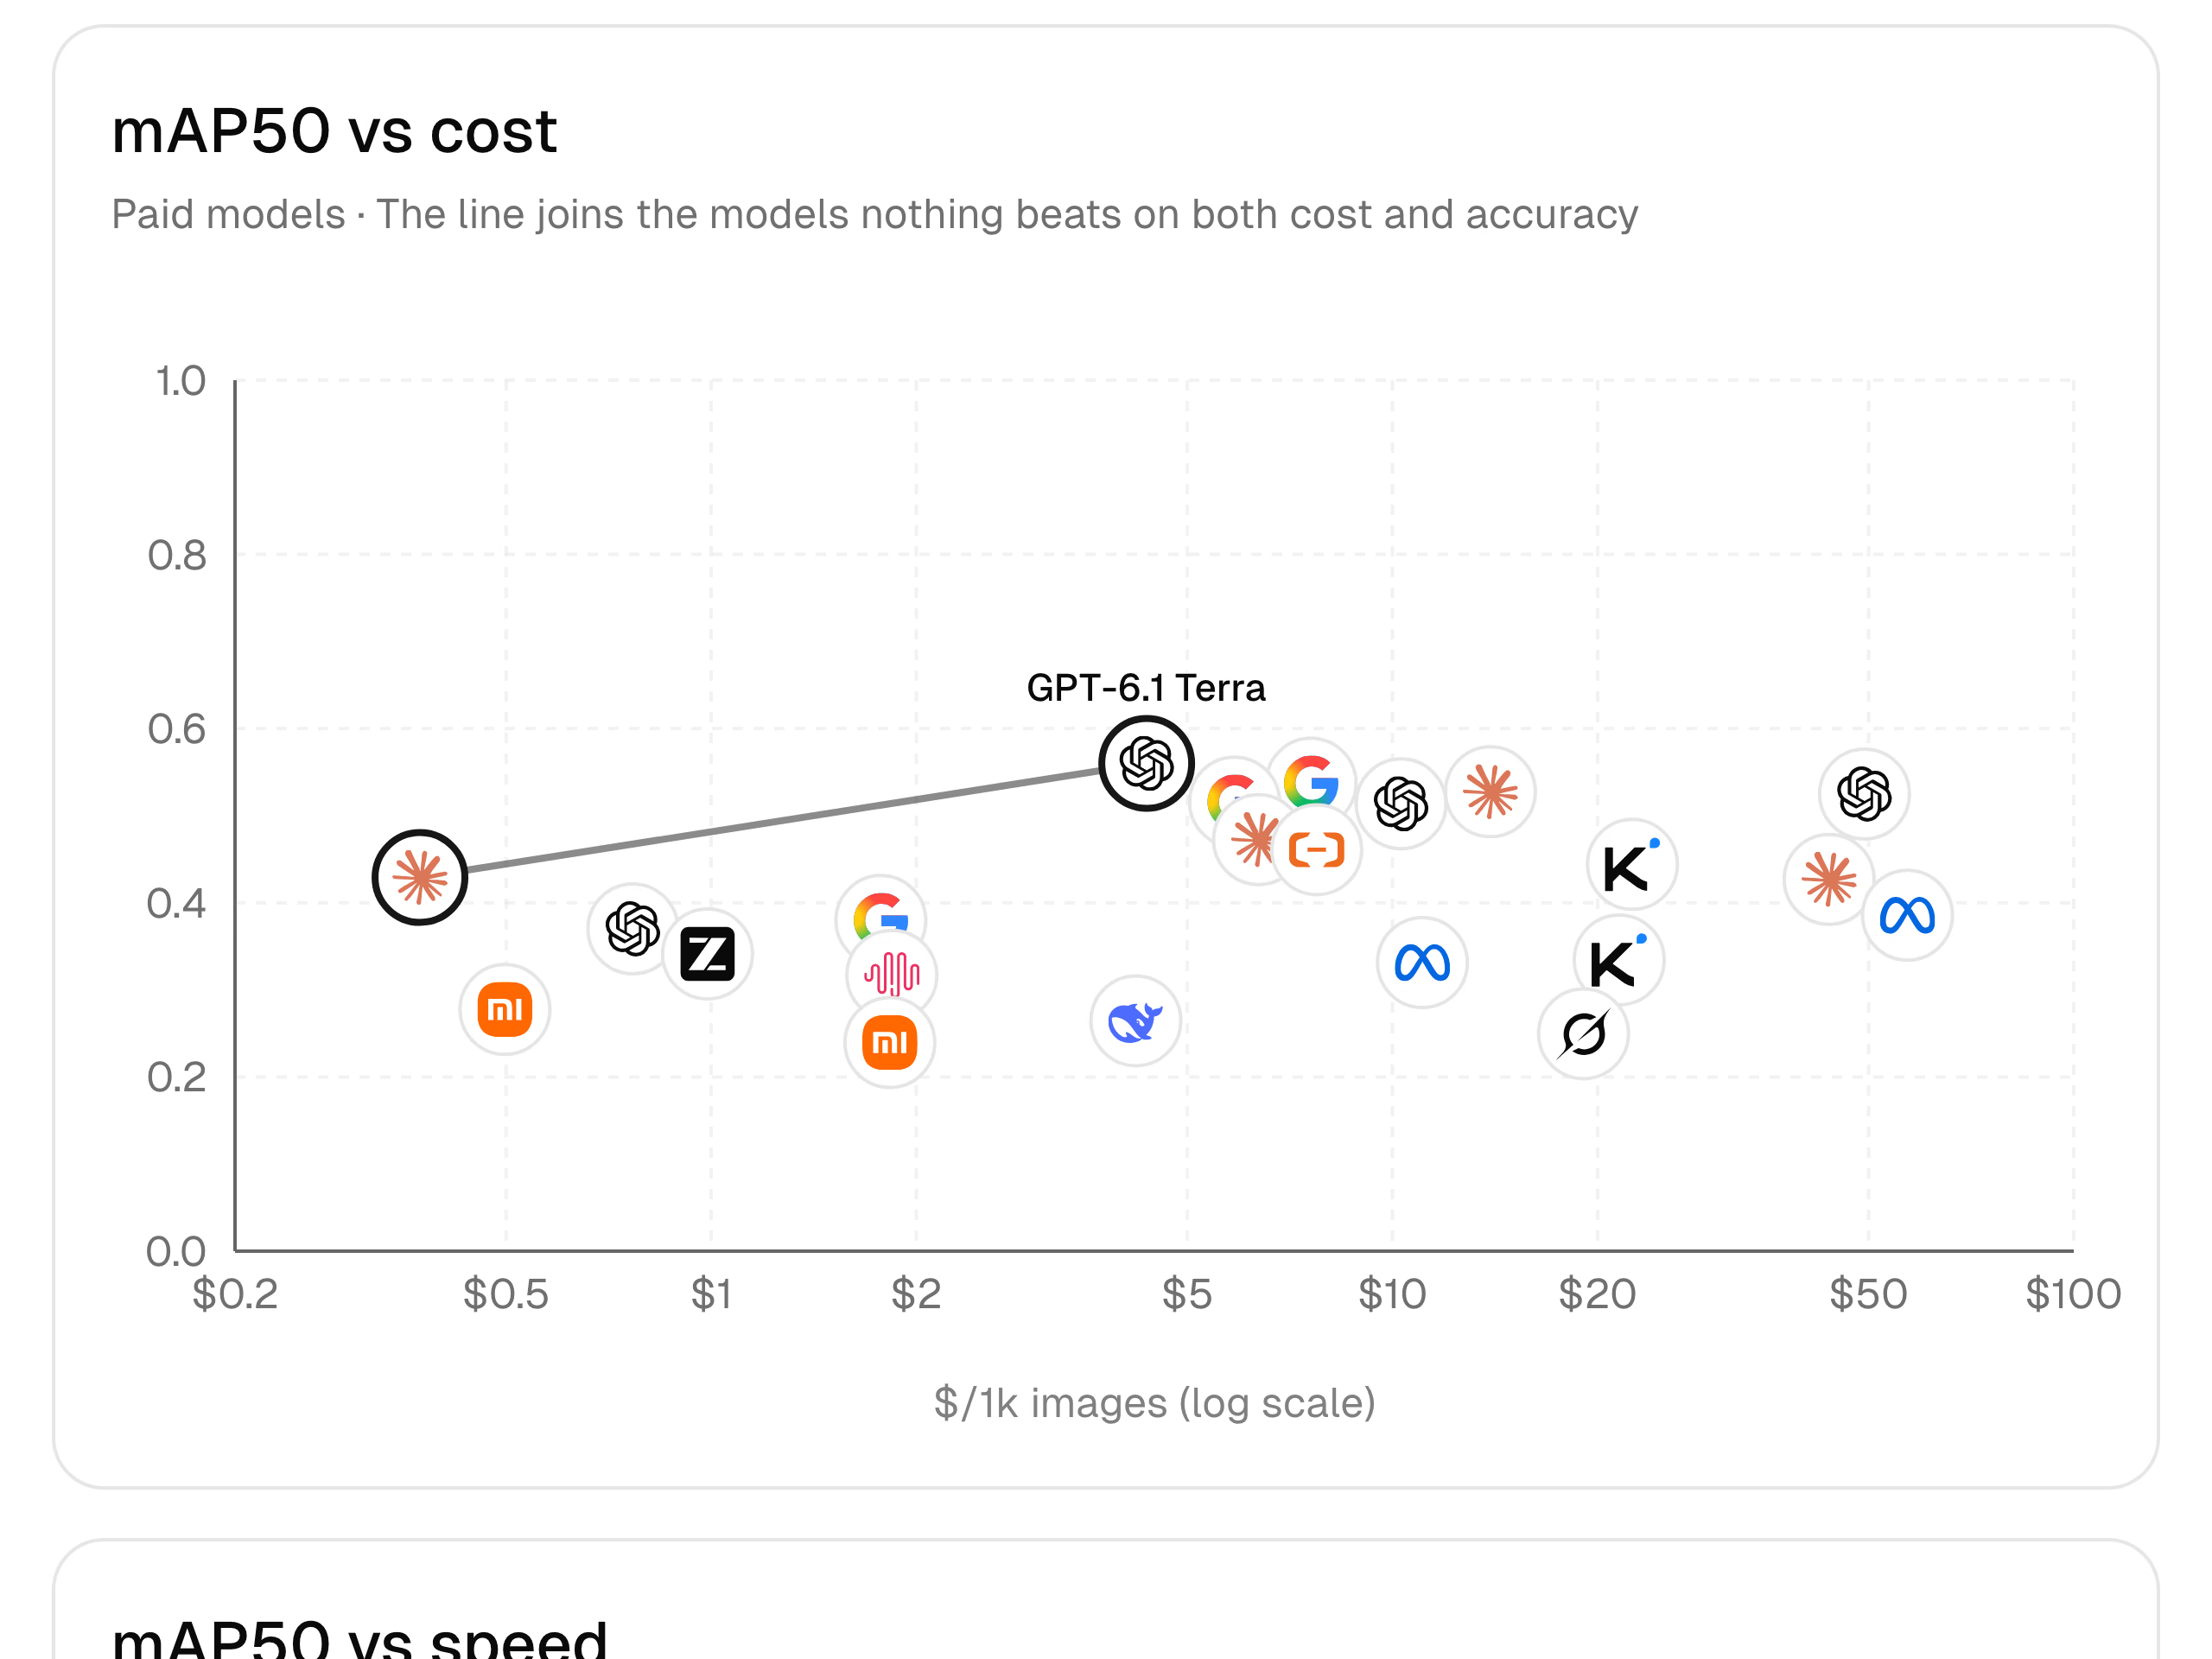
فيما يلي النماذج الستة التي تتجاوز نتيجتها 0.51 في mAP50. تُقدّر التكلفة استنادًا إلى استخدام الرموز الذي يبلّغ عنه المزوّد لكل 1,000 صورة موسومة بنجاح في المعيار، أما زمن الاستجابة فهو وسيط زمن الطلب:
| النموذج | mAP50 | mAP50-95 | الإحكام | الاستدعاء | F1 | تكلفة المزوّد / 1k صورة (استخدام المعيار) | زمن الاستجابة |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*يستند تقدير Gemini 4 Argon إلى أسعار Google التمهيدية، السارية حتى 30 نوفمبر 2026. وابتداءً من 1 ديسمبر، يتضاعف السعر القياسي لدى Google ليبلغ نحو 15 دولارًا لكل 1,000 صورة عند مستوى الاستخدام نفسه. وتضيف Batch Annotation على Ultralytics Platform تكلفة قدرها 1.00 دولار لكل 1,000 صورة تتم معالجتها لأي نموذج، بما في ذلك النماذج المستضافة.
تنقسم النماذج الستة إلى مجموعتين. يحقق Argon وOpus 5.5 وGemini 3.8 Flash دقة تتراوح بين 0.66 و0.67، مع استدعاء أقل من 0.60: تطابق نسبة كبيرة من صناديقها، لكنها تطابق عددًا أقل من الكائنات الموسومة. أما Astra وSol فيحققان استدعاء يتراوح بين 0.62 و0.63، ودقة بين 0.55 و0.56: إذ يطابقان نسبة أكبر من الكائنات الموسومة، بينما تطابق نسبة أقل من صناديقهما. ويقع Terra بين المجموعتين ويتصدر mAP50 وF1.
أعطِ الأولوية للدقة عندما تكون الصناديق الزائدة مكلفة التنقيح#
حقق Gemini 4 Argon أعلى دقة إجمالية بين النماذج الأربعين في المعيار، إذ بلغت 0.667. لكن ذلك يأتي مقابل متوسط استدعاء قدره 0.585، وهو أقل من النماذج المتصدرة في الاستدعاء.
تكون الدقة الأهم عندما يصعب اكتشاف الصناديق غير المطابقة. ففي صورة مزدحمة، يتعين على المراجع العثور على صندوق خاطئ بين صناديق صحيحة كثيرة قبل تصحيحه. وتُظهر الأرفف التجارية الكثيفة في SKU110K مدى تذبذب الدقة في مثل هذه الصور: ففي نتائج GPT-6.1 Terra، سجّل Terra دقة قدرها 0.79 واستدعاء قدره 0.73، مقابل 0.49 و0.77 على التوالي لـ GPT-6.1 Sol.
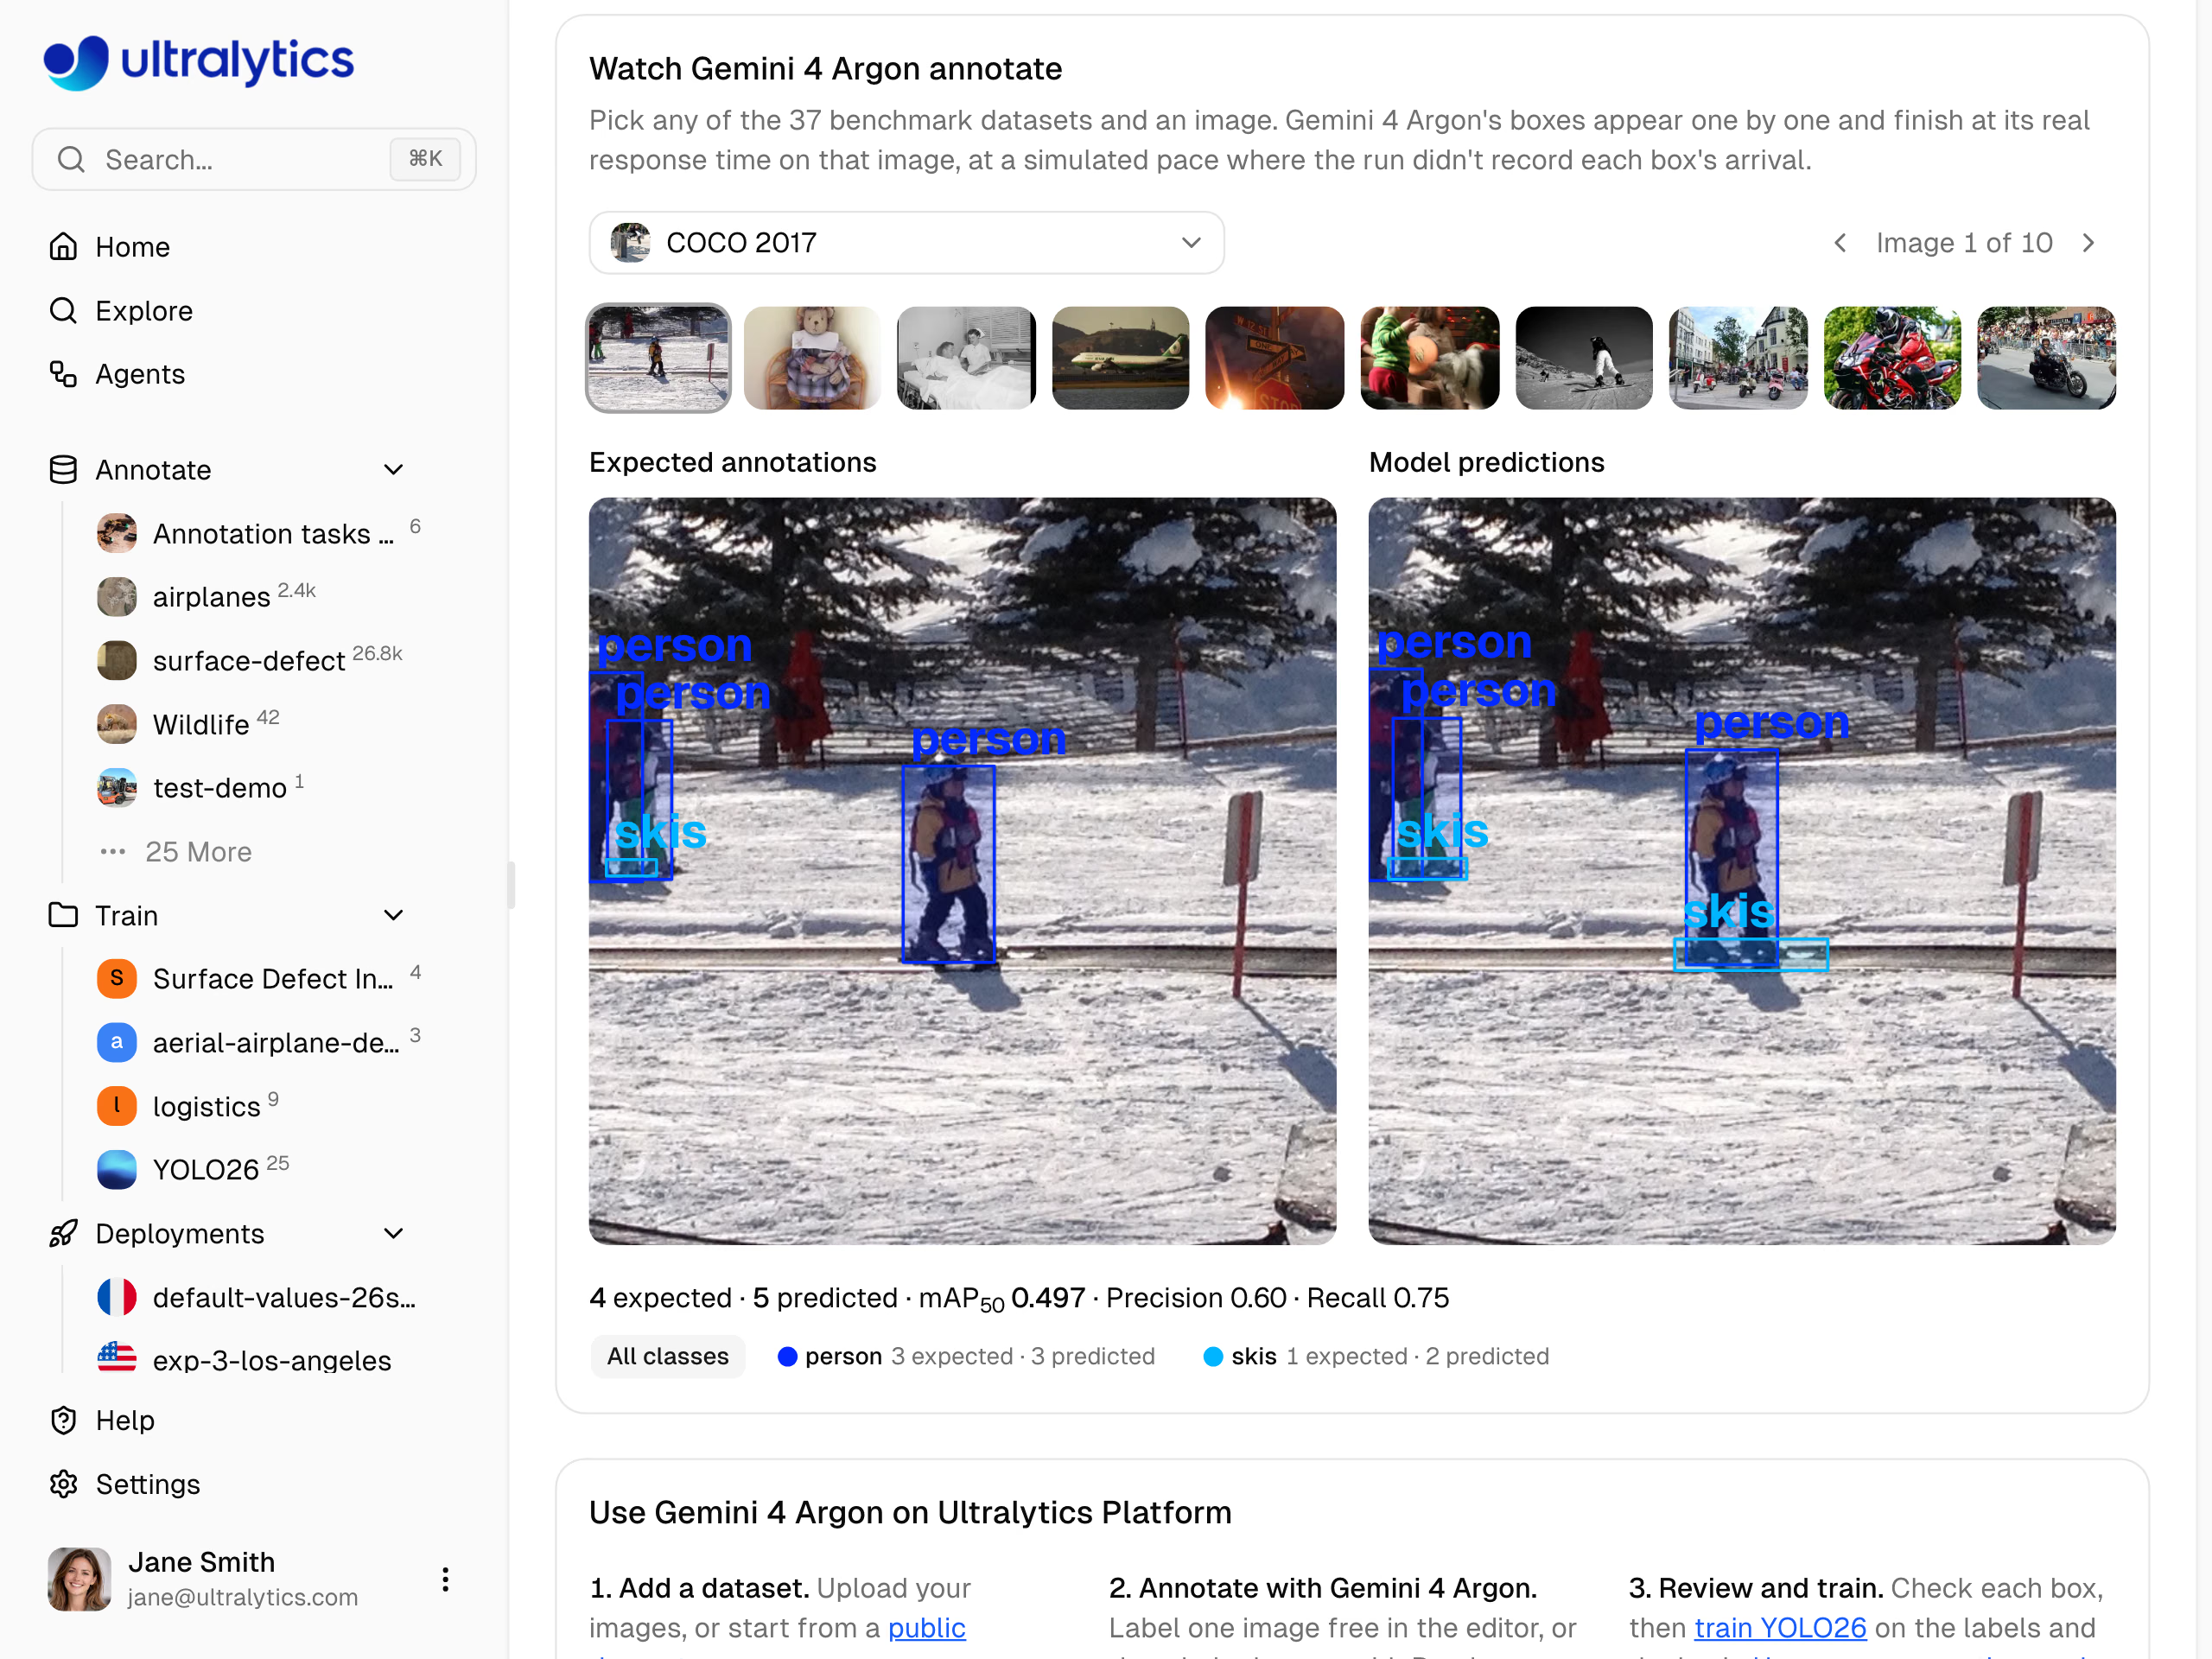
Gemini 4 Argon: تنبأ بـ5 صناديق لأربعة كائنات موسومة، بدقة 0.60 واستدعاء 0.75.
لم تسجّل Argon أيضًا أي طلبات فاشلة في المعيار، كما أن وسيط زمنها البالغ 4.6 ثانية هو الأسرع بين النموذجين الأولين. اخترها عندما تشبه بياناتك المجالات التي تتفوق فيها، وهي الصور الجوية وتحت الماء والحرارية والأشعة السينية الأمنية (حيث تحقق أفضل mAP50 في صور الفحص الأمني لمجموعة IEDXray، بقيمة 0.298)، وعندما يفضّل فريقك إكمال وسم بعض الكائنات التي فاتت النموذج بدلًا من البحث عن الصناديق الزائدة.
أعطِ الأولوية للاستدعاء عندما يكون تفويت كائن خطأً مكلفًا#
يحقق GPT-6 Astra أعلى متوسط استدعاء في لوحة الصدارة، وهو 0.627. أما دقته البالغة 0.56 فهي ثمن ذلك.
يكون التوسيم الذي يولي الأولوية للاستدعاء منطقيًا عندما تكون كلفة الكائن غير الموسوم أعلى. فالعيب أو الآفة التي يفوت رصدها في مجموعة التدريب تعلّم الكاشف أن الكائن جزء من الخلفية، والعثور على صندوق مفقود يعني فحص كل صورة بحثًا عن شيء لم يُحدَّد. تحقق Astra أفضل mAP50 في 7 من مجموعات البيانات الـ36، بما فيها صور الأشعة السينية للصدر في TBX11K (0.330)، وصور الأشعة السينية لمعاصم الأطفال في GRAZPEDWRI-DX (0.354)، وعيوب أسطح لوحات الدارات المطبوعة في DsPCBSD+ (0.394): وهذا سبب لاختبارها على بيانات مشابهة، لا دليل على أنها ستفوّت عددًا أقل من الكائنات في بياناتك.
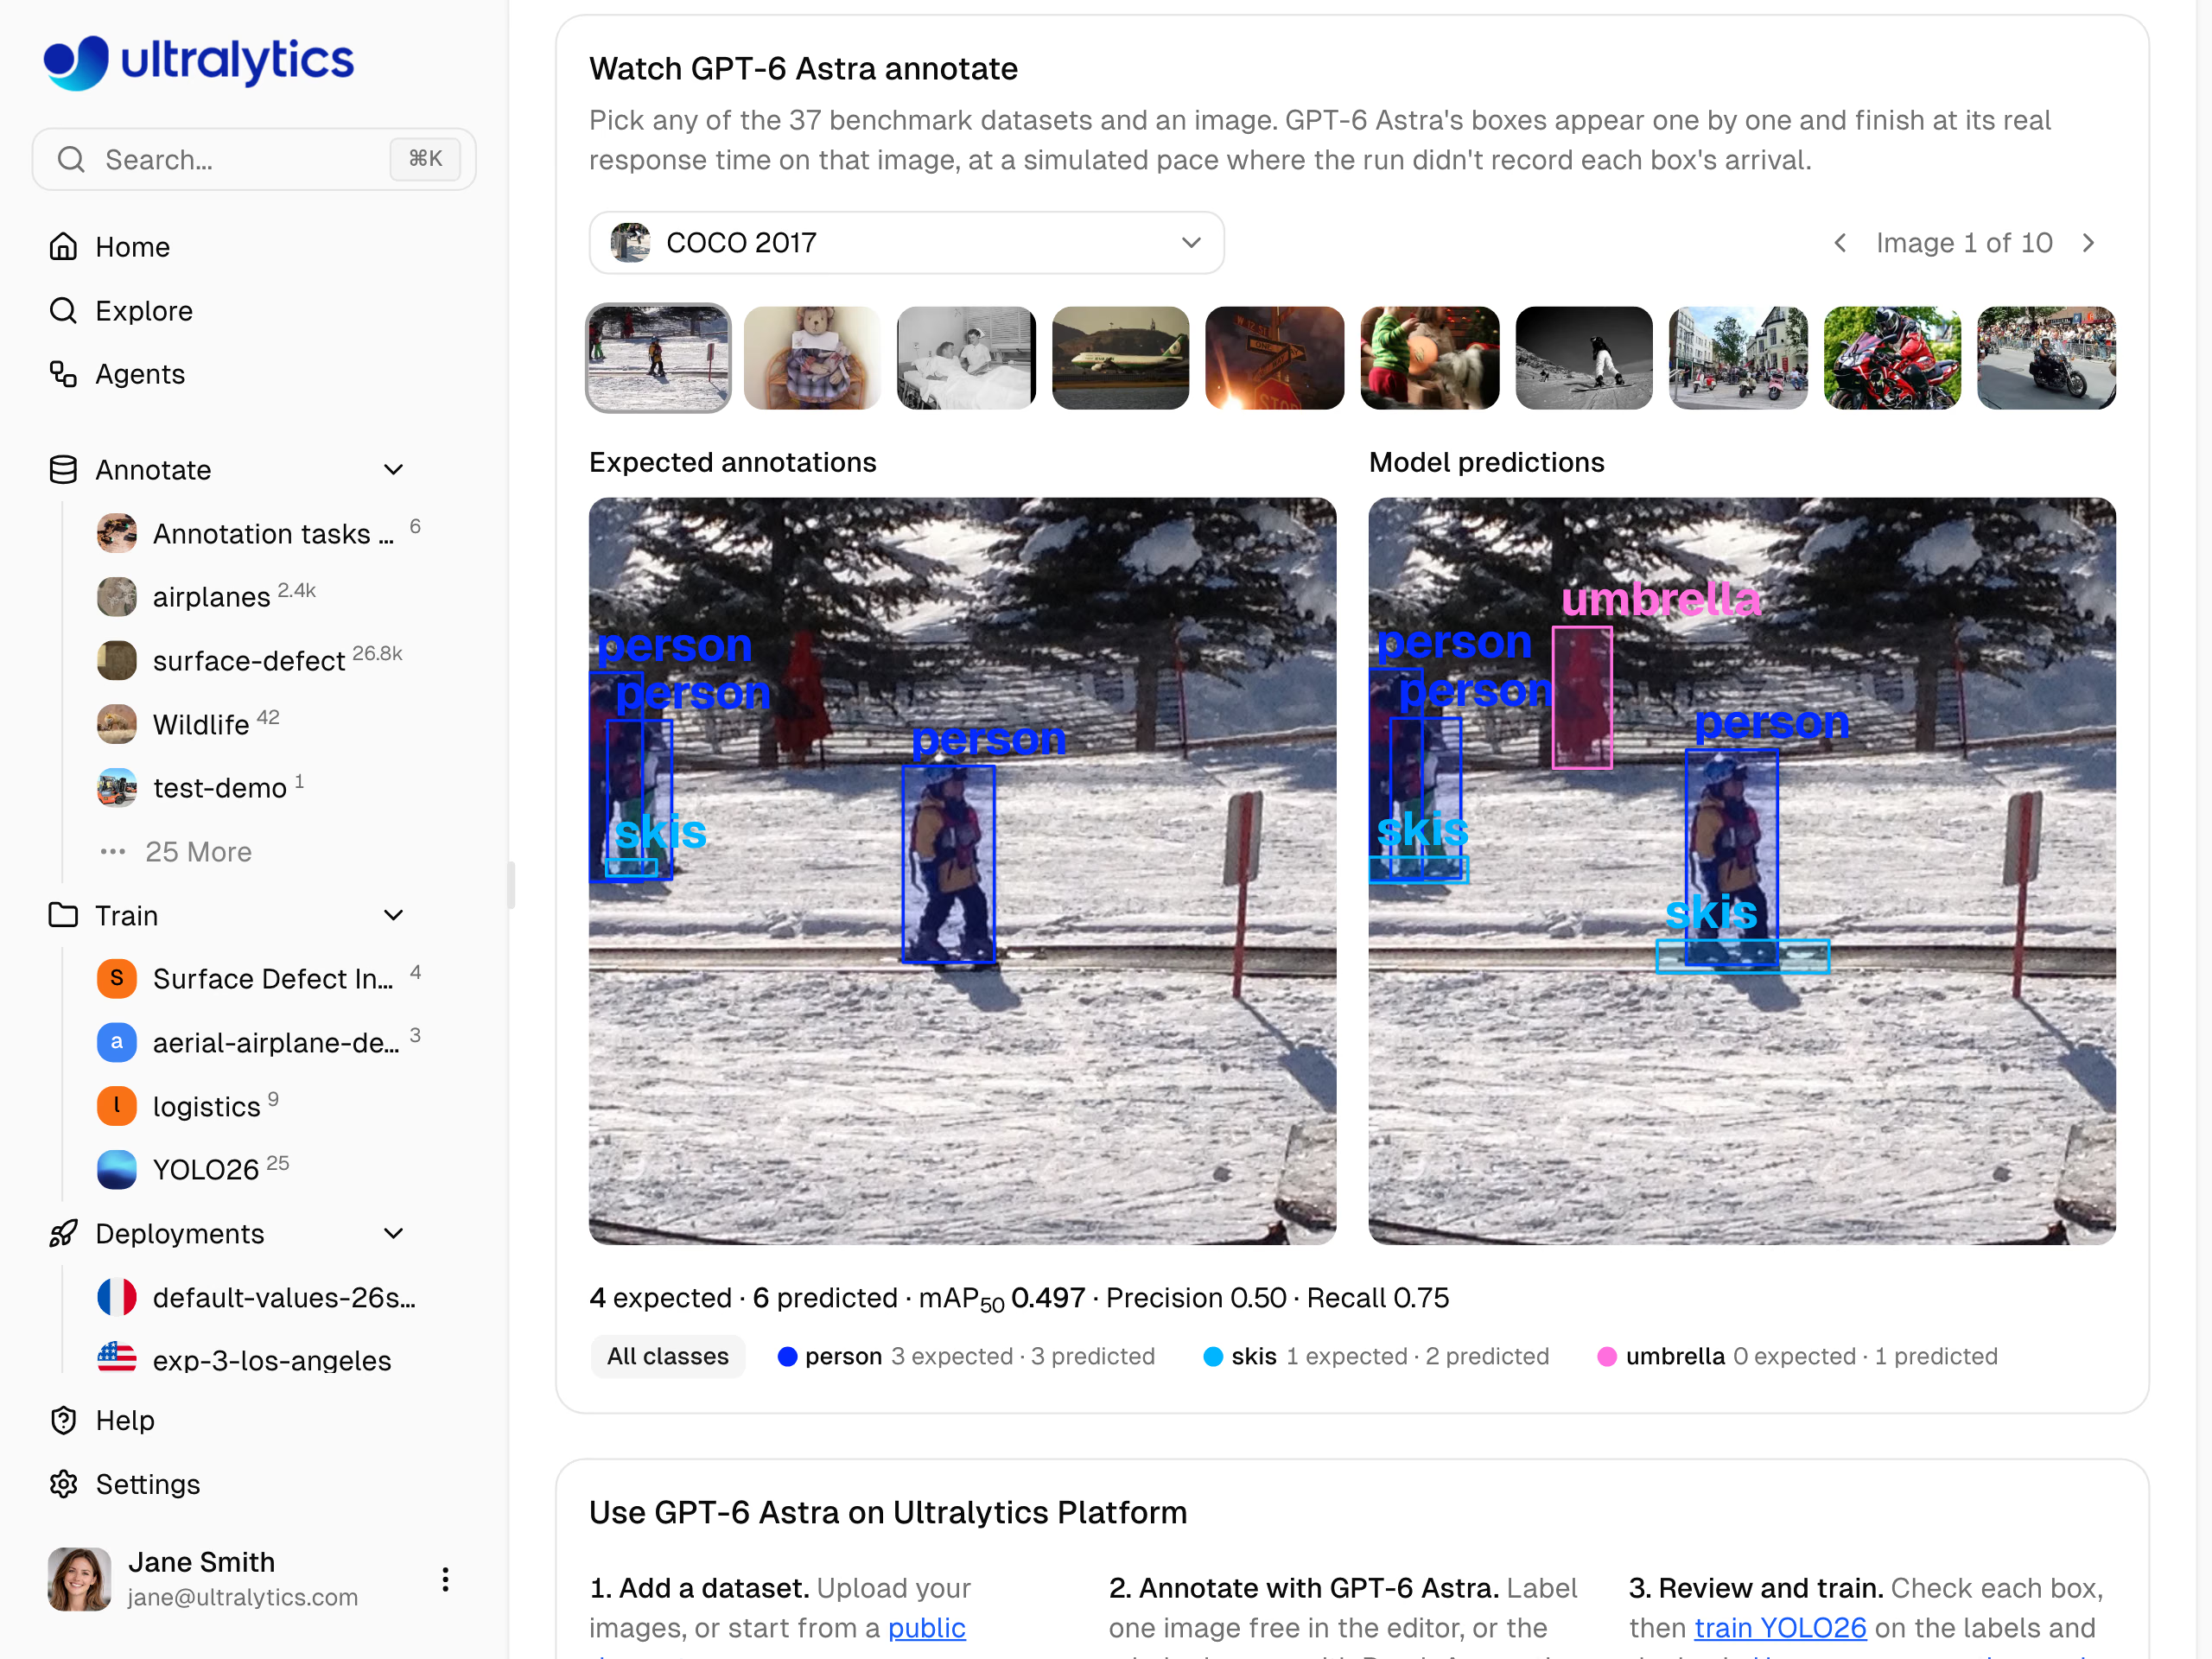
GPT-6 Astra: 6 صناديق للكائنات الأربعة نفسها، بما فيها مظلة أغفلتها تسميات COCO، بدقة 0.50 واستدعاء 0.75.
يحقق Astra أعلى تقدير للتكلفة بين النماذج الستة الأولى، بواقع 49.31 دولارًا لكل 1,000 صورة، مع وسيط زمن استجابة قدره 11.6 ثانية وطلبات فاشلة على 1% من الصور. ويقترب نموذجان آخران من OpenAI من حيث الاستدعاء: GPT-6.1 Sol بقيمة 0.62 وتكلفة تقديرية 10.30 دولارات، وGPT-6.1 Terra بقيمة 0.61 وتكلفة تقديرية 4.36 دولارات.
وازن بين الخطأين باستخدام mAP50-95 وF1#
يتصدر GPT-6.1 Terra لوحة الصدارة بنتيجة 0.560 في mAP50 و0.345 في mAP50-95. وتقع دقته البالغة 0.646 واستدعاؤه البالغ 0.613 ضمن بضع نقاط من النماذج المتصدرة، كما أن نتيجة F1 البالغة 0.63 هي الأعلى بين النماذج الستة، متقدمة قليلًا على Argon وOpus 5.5 اللذين سجّلا 0.62. وبما أن نتائج F1 متقاربة إلى هذا الحد، وأن F1 لا يقول شيئًا عن وقت المراجعة، فدع نتائج المجال واختبار صورك تحسم الاختيار بينها.
وتمنح صدارته في mAP50-95 مؤشرًا إضافيًا. إذ يكافئ mAP50-95 النماذج التي تلائم صناديقها المطابقة الكائنات بدقة، إلى جانب النماذج التي تعثر على الكائنات الصحيحة، لأنه يحسب المتوسط عبر عتبات التداخل حتى 0.95؛ وTerra يتصدر هذا المقياس أيضًا. كما أنه الأقل تكلفة تقديريًا بين النماذج الستة الأولى، ولم يسجل أي طلبات فاشلة، وتصفه لوحة الصدارة بأنه «أفضل قيمة».
التوسيم من دون مفتاح لمزوّد خدمة: النماذج المستضافة وكواشف المفردات المفتوحة#
لا ترغب جميع الفرق في استخدام مفتاح مدفوع لمزوّد خدمة. تعمل النماذج المستضافة على Platform من دونه، وتروي أعمدتها قصة مختلفة:
- SAM 3.1 Text: 0.332 mAP50، ودقة 0.19، واستدعاء 0.47، و0.2 ثانية للصورة. وهو أفضل النماذج الأربعين على VisDrone (0.479 mAP50) وفي بيانات حركة المرور Fisheye8K (0.478).
- Qwen3.8 27B: 0.351 mAP50، ودقة 0.54، واستدعاء 0.40، و1.5 ثانية.
- Gemma 4 26B: 0.344 mAP50، ودقة 0.53، واستدعاء 0.39، و0.9 ثانية.
تُستضاف كواشف المفردات المفتوحة أيضًا. في هذا المعيار، سجّل OWLv2 Large نتيجة 0.133 في mAP50، وسجّل Grounding DINO Base نتيجة 0.104، وكلاهما بزمن 0.2 ثانية للصورة، مقارنةً بـ0.332 لـ SAM 3.1 Text. تقيس هذه النتائج مسار Platform الذي يستجيب للفئات ويستخدم تحسين الصناديق بواسطة SAM 3.1، لا الإعداد الأصلي لكل نموذج.
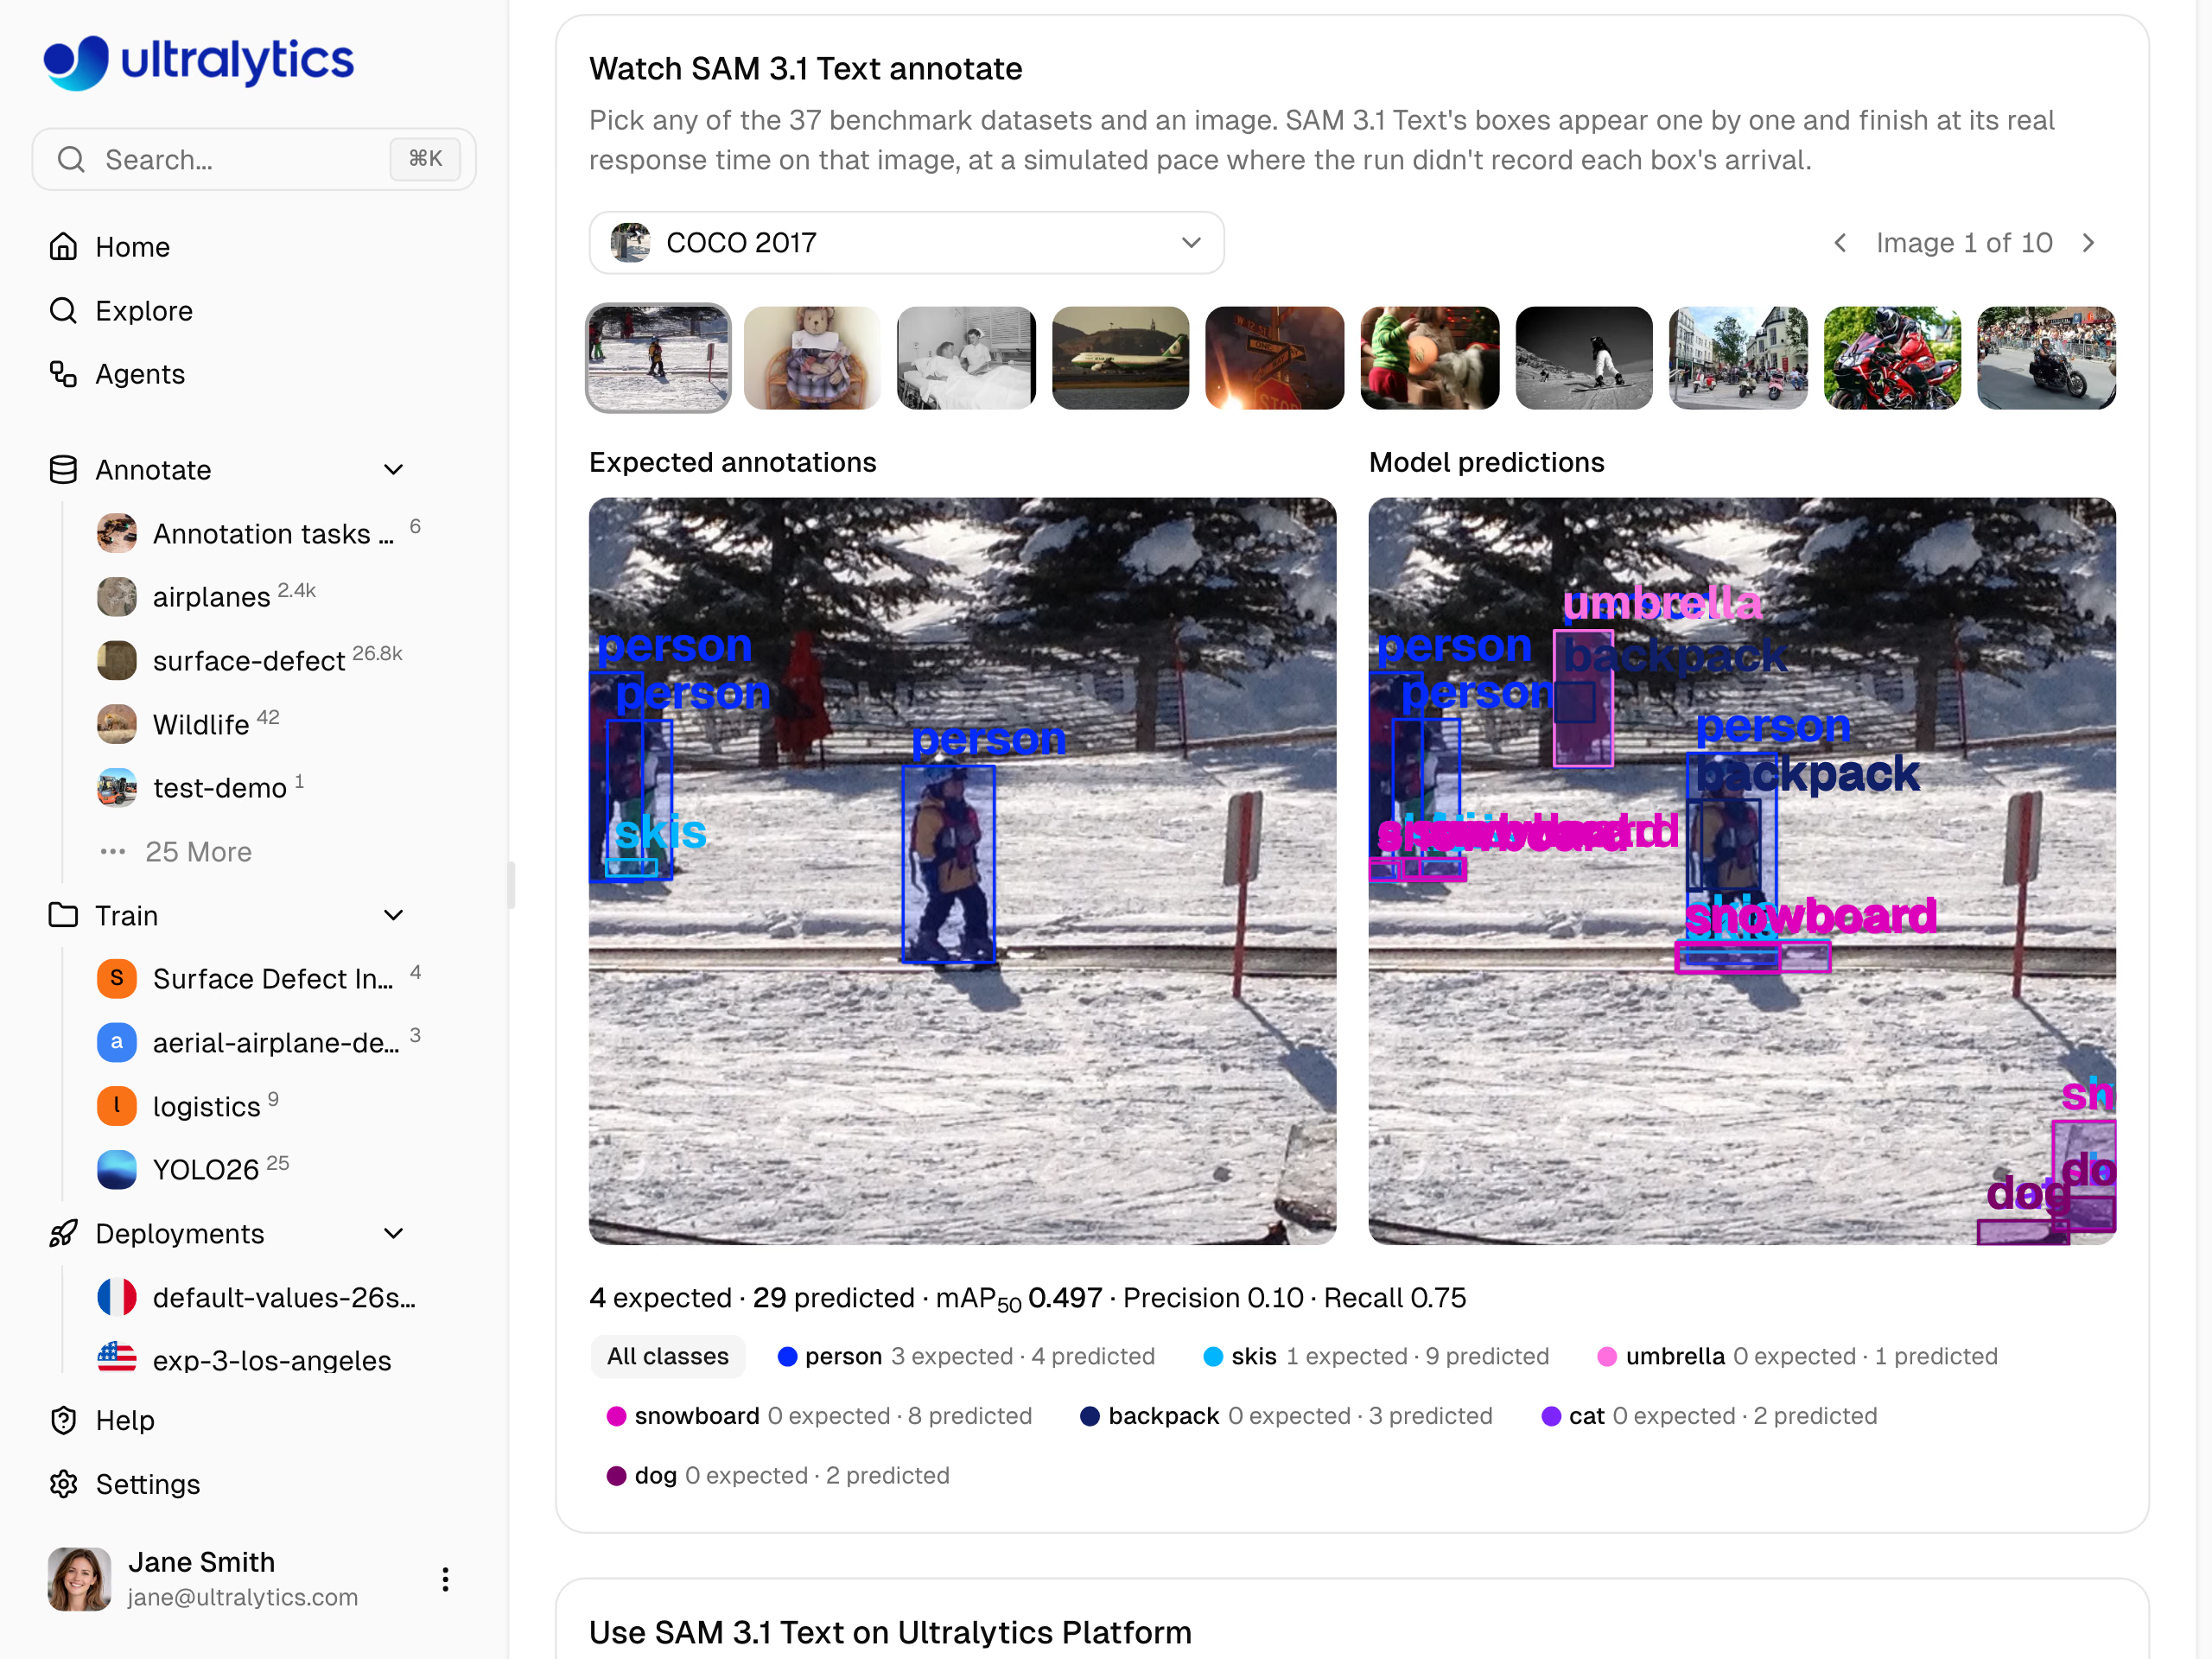
SAM 3.1 Text: 29 صندوقًا لأربعة كائنات، بدقة 0.10 واستدعاء 0.75. عثرت عمليات إعادة التشغيل الثلاث على 3 من أصل 4 كائنات؛ والاختلاف هو عدد الصناديق الزائدة التي يحذفها المراجعون.
يناسب SAM 3.1 Text المشاهد الجوية ومشاهد المرور المزدحمة التي يتوقع فيها المراجعون تنقيح مسودة سخية. أما Qwen3.8 27B وGemma 4 26B فينتميان إلى المجموعة الحذرة لكن بدقة أقل. ومن بين النماذج المدفوعة منخفضة التكلفة، يحقق Claude Haiku 5.5 نتيجة 0.429 في mAP50، بدقة 0.56 واستدعاء 0.47، وتكلفة تقديرية قدرها 0.37 دولار لكل 1,000 صورة؛ وهو النموذج الآخر الذي تصفه لوحة الصدارة بأنه «أفضل قيمة».
تخفي المتوسطات العامة للمجموعة مجال بياناتك، لذا راجع جدول مجموعات البيانات#
يُحسب متوسط دقة كل نموذج واستدعائه عبر 36 مجموعة بيانات، بينما تنتمي بياناتك إلى مجال واحد. يسرد جدول مجموعات البيانات في لوحة صدارة VLM متوسط الدقة والاستدعاء لكل مجموعة عبر النماذج الأربعين، بدءًا بالأصعب، إلى جانب أفضل نموذج لكل مجموعة.
ابحث عن مؤشرات التحذير. في Airbus Oil Storage Detection، التي تتضمن 2,267 خزانًا موسومًا ضمن صورها العشر، يبلغ متوسط الدقة 0.39 والاستدعاء 0.11 للنماذج، وأفضل mAP50 هو 0.347 لـ Gemini 4 Argon. وفي DeepPCB، يبلغ متوسط الدقة والاستدعاء 0.03 و0.04، ويبرز GPT-6.1 Sol بنتيجة 0.393 في mAP50.
اعتبر هذه الأرقام قائمة مختصرة، لا حكمًا نهائيًا. تنص المنهجية على أن 10 صور لكل مجموعة بيانات تكفي لترتيب النماذج والمجالات، لكنها لا تكفي لاعتماد نتيجة مجموعة بيانات واحدة، كما أن عمليات التشغيل المتكررة تُحرّك الأرقام الفردية بضع نقاط. تعرض صفحة كل نموذج على Platform إعادة تشغيل لصناديقه المسجلة إلى جانب الصناديق المتوقعة في مجموعات بيانات المعيار وCOCO، ما يتيح لك فحص المجموعة الأقرب إلى بياناتك قبل بدء التشغيل.
طابِق النموذج مع سير عمل المراجعة لديك في خمس خطوات#
ابدأ بأولوياتك عند الاختيار، ثم تحقّق من اختيارك باستخدام صورك:
| أولويتك | القائمة المختصرة (نتائج أكتوبر 2026) |
|---|---|
| إعطاء الأولوية للدقة | Gemini 4 Argon |
| إعطاء الأولوية للاستدعاء | GPT-6 Astra أو GPT-6.1 Sol |
| الموازنة بين كليهما | GPT-6.1 Terra |
| من دون مفتاح لمزوّد خدمة | المستضاف: Qwen3.8 27B أو SAM 3.1 Text |
يعمل التوسيم الذي يستجيب لفئات محددة على مجموعات بيانات الاكتشاف التي تضم من فئة واحدة إلى 200 فئة.
- أنشئ قائمة مختصرة من لوحة الصدارة. رشّح لوحة صدارة VLM لاكتشاف الكائنات لعرض النماذج المدفوعة أو المستضافة (واستبعد أي نموذج يحمل علامة «غير متاح على المنصة»)، واقرأ العمود المطابق لأولويتك، ثم راجع جدول مجموعات البيانات للاطلاع على مجالك.
- أضف مفتاحًا لمزوّد خدمة. لاستخدام نموذج مدفوع، احفظ مفتاحك ضمن الإعدادات > مفاتيح API في مساحة العمل التي تضم مجموعة البيانات. يحاسبك المزوّد مباشرةً على استخدام مفتاحك؛ وتشرح وثائق مفاتيح المزوّد خطوات الإعداد.
- اختبر على عينة تمت مراجعتها. اختر بضع صور تمثل بياناتك ووسمتها يدويًا. افتح محرر التعليقات التوضيحية، وانتقل إلى وضع Smart، واختر النموذج من المزوّد الخاص به في منتقي النماذج، ثم اضغط Predict (
P). أحصِ الصناديق التي تحذفها، والصناديق التي تضيفها، والدقائق التي تستغرقها المراجعة. - وسّم مجموعة البيانات. في صفحة مجموعة البيانات، اختر المزيد من الإجراءات > Batch Annotation، المتاحة لمجموعات البيانات المستضافة على Platform التي تضم حتى ثلاث قنوات صور. يوسم هذا الخيار الصور غير الموسومة افتراضيًا، ولا يغيّر الوسوم الموجودة، ويحفظ إصدارًا من مجموعة البيانات أولًا كي تتمكن من التراجع. راجع التكلفة التقديرية في مربع الحوار قبل البدء: تبلغ تكلفة Batch Annotation دولارًا واحدًا لكل 1,000 صورة تتم معالجتها، بالإضافة إلى رسوم المزوّد إن وجدت.
- راجع النتائج، ثم درّب النموذج. تحقق من الصناديق مع مراعاة نقطة ضعف نموذجك، واحفظها، ثم درّب نموذج Ultralytics YOLO على النتائج في مساحة العمل نفسها.
للاطلاع على الخلفية، اقرأ كيف تستخدم Ultralytics Platform الذكاء الاصطناعي لأتمتة التوسيم ولماذا تظل المراجعة بمشاركة الإنسان جزءًا من العمل. ولمقارنة التوسيم التلقائي بالتعلم النشط عبر الأدوات، اقرأ مقارنتنا بين التوسيم التلقائي والتعلم النشط.
قائمة مختصرة حسب الفريق (نتائج أكتوبر 2026)#
- للمراجعين الذين يفضلون إكمال المسودة على تنقيحها: Gemini 4 Argon، النموذج الأعلى دقة إجمالًا، والأقوى في بيانات الصور الجوية وتحت الماء والحرارية والأشعة السينية الأمنية.
- للكائنات النادرة التي يفسد تفويتها بيانات التدريب: GPT-6 Astra لتحقيق أقصى استدعاء، أو GPT-6.1 Sol القريب منه.
- للتوسيم العام من دون تفضيل واضح: GPT-6.1 Terra، المتصدر في mAP50 وmAP50-95 وF1.
- للفرق التي لا تملك مفتاحًا لمزوّد خدمة: SAM 3.1 Text لتمرير أول يعطي الأولوية للاستدعاء في المشاهد المزدحمة، أو Qwen3.8 27B للحصول على مسودة أكثر حذرًا.
أيًا كان اختيارك، تساعدك لوحة الصدارة على توقع ما ستتطلبه المراجعة قبل البدء. وللتعرّف على الأساس النظري لهذه المقاييس، يغطي دليلنا عن الدقة والصحة والاستدعاء المبادئ الأساسية، بينما يتعمق درس Academy حول قراءة مقاييس الاكتشاف أكثر.
الأسئلة الشائعة
أعطِ الأولوية للدقة عندما يكون حذف الصناديق الخاطئة هو التصحيح الأبطأ، مثل الصور المزدحمة التي يختبئ فيها صندوق زائد بين صناديق صحيحة. وأعطِ الأولوية للاستدعاء عندما تكون تكلفة تفويت كائن أعلى، كما في حالة العيوب أو الآفات النادرة، لأن الكائن غير الموسوم يعلّم الكاشف أنه خلفية. ثم تحقّق من اختيارك باستخدام عينة من صورك راجعتها يدويًا.
تُرجع النماذج التي تستجيب لفئات محددة صناديق من دون درجات ثقة، وتستخدم عتبات خاصة بكل نموذج؛ لذلك تخفي Platform إعدادَي الثقة وIoU عند تحديد أحدها. وعليه، تحسب الدقة والاستدعاء في لوحة الصدارة كل صندوق يُرجعه النموذج عند IoU بقيمة 0.5. ولتغيير التوازن بين الصناديق غير المطابقة والكائنات غير المطابقة، اختر نموذجًا مختلفًا.
استخدم mAP50 لمعرفة ما إذا كان النموذج يعثر على الكائنات الصحيحة ويضع وسومًا لها، واستخدم mAP50-95 لإضافة عتبات تداخل أكثر صرامة تكافئ الصناديق الملائمة بدقة. ويعكس المقياسان أيضًا الكائنات الفائتة والإيجابيات الكاذبة، لذا اقرأهما إلى جانب الدقة والاستدعاء. في نتائج أكتوبر 2026، يتصدر GPT-6.1 Terra المقياسين بنتيجتي 0.560 و0.345.
نعم. يحقق أفضل نموذج على UL37 v2 متوسطًا قدره 0.560 في mAP50 (أكتوبر 2026)، بينما يقل متوسط النماذج الأربعين عن 0.05 في أصعب مجموعات البيانات، مثل عيوب لوحات الدوائر المطبوعة وأشعة الصدر. راجع كل صورة، وركّز على نقطة ضعف النموذج: الصناديق الزائدة في نموذج يميل إلى الاستدعاء، والكائنات الفائتة في نموذج يميل إلى الدقة.
تتكون التكلفة من جزأين. تبلغ تكلفة Batch Annotation على Ultralytics Platform دولارًا واحدًا لكل 1,000 صورة تتم معالجتها (بحد أدنى 0.01 دولار) لأي نموذج، بما في ذلك النماذج المستضافة، كما أن التنبؤات الفردية بنموذج مستضاف في المحرر مجانية. وتُحاسب النماذج المدفوعة أيضًا من المزوّد مباشرةً على مفتاح API الخاص بك. في معيار أكتوبر 2026، تراوحت تقديرات المزوّد للنماذج الواردة في هذا الدليل بين 0.37 دولار لكل 1,000 صورة (Claude Haiku 5.5) و49.31 دولارًا (GPT-6 Astra). وعند إيقاف التشغيل، تُحاسب على الصور التي تمت معالجتها بالفعل.
نعم. تعمل النماذج المستضافة مثل SAM 3.1 Text وQwen3.8 27B وGemma 4 26B على Ultralytics Platform من دون مفتاح لمزوّد خدمة، وكذلك نماذج YOLO الخاصة بك. وتظل تكلفة التشغيل الدفعي دولارًا واحدًا لكل 1,000 صورة تتم معالجتها، ويعرض مربع الحوار التكلفة التقديرية قبل كل تشغيل.
يعتمد ذلك على المهمة. يستطيع VLM يستجيب لفئات محددة إعداد مسودة للوسوم الخاصة بفئات جديدة اعتمادًا على أسمائها وحدها، لكن النماذج الستة الأعلى نتيجة في معيار أكتوبر 2026 استغرقت من 2.7 إلى 11.6 ثانية للصورة، وتُحاسب بحسب الرموز. وللاكتشاف في الزمن الحقيقي، من الأساليب الشائعة استخدام VLM للتوسيم التلقائي، ومراجعة الوسوم، ثم تدريب نموذج Ultralytics YOLO عليها. ويمكن أيضًا استخدام نموذج YOLO سبق أن درّبته لتوسيم صور جديدة تلقائيًا في المحرر نفسه.
بقلم
مهندس برمجيات رئيسي · Ultralytics
التعليقات2
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









