OCR in Python mit Ultralytics YOLO26: Dokumente, Fotos und PDFs in beliebiger Ausrichtung auslesen
Lies Text in Bildern und PDF-Seiten bei beliebiger Drehung mit Ultralytics YOLO26-Text und PP-OCRv6 in wenigen Python-Zeilen auf CPU oder GPU und optional mit TensorRT.
 Jing Qiu13 Min. Lesezeit
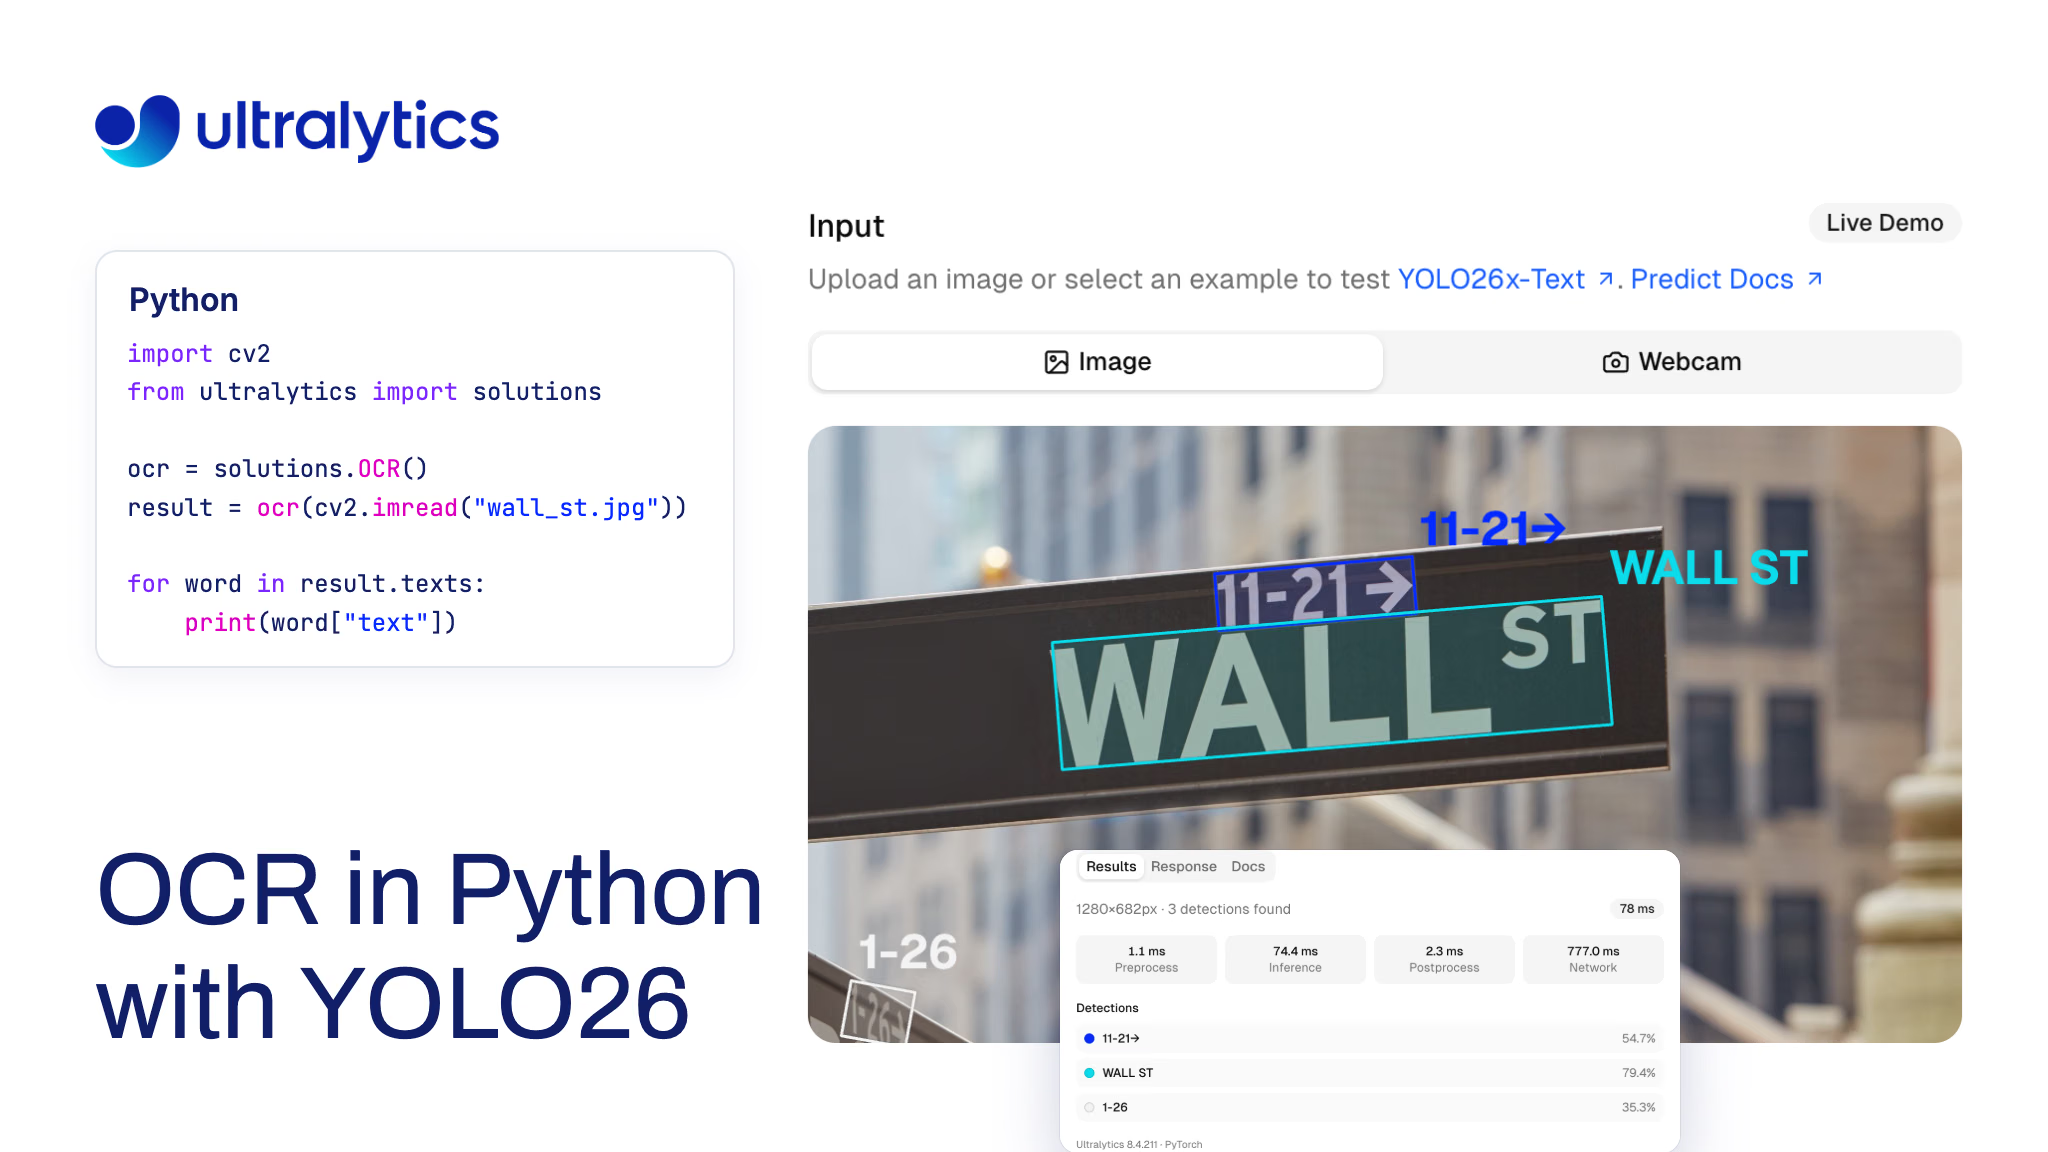
Wie führst du OCR in Python für einen seitlich gedrehten Scan, ein Handyfoto von einem Schild oder eine PDF-Seite aus und erhältst die Wörter in der Reihenfolge zurück, in der man sie lesen würde? Mit dem Ultralytics-Paket brauchst du dafür nur eine Klasse: solutions.OCR() erkennt Text mit einem Ultralytics-Modell YOLO26-Text, liest jedes Wort mit dem PP-OCRv6-Erkennungsmodell von PaddleOCR und gibt die erkannten Wörter zeilenweise zurück – bei jeder Seitendrehung und auf CPU oder GPU.
Diese Pipeline ist neu. Ultralytics 8.4.210 hat die OCR-Lösung mit PP-OCRv6 auf ONNX Runtime, Drehungserkennung und Lesereihenfolge neu aufgebaut. 8.4.211 hat ein optionales TensorRT-Erkennungsmodell ergänzt. In unserem Benchmark mit einer Bildgröße von 1280 erreichte die Standardeinstellung einen Wort-F1-Wert von 0,931 auf sechs PDF-Seiten und 0,722 auf 80 HierText-Fotos. Auf einer RTX PRO 6000 erkannte eine zwischengespeicherte FP16-TensorRT-Engine die 251 in einem Foto erkannten Wörter in 82 ms, gegenüber 249 ms mit ONNX Runtime auf CUDA.
Diese Anleitung erklärt, wie die Pipeline funktioniert, wie du sie auf Bildern und PDFs ausführst, wie schnell sie ist und welche Sprachen sie derzeit lesen kann. Ultralytics entwickelt eine der unten verglichenen OCR-Optionen. Der Vergleich beschränkt sich daher auf die dokumentierten Funktionen der einzelnen Projekte.
YOLO26 OCR liest eine Seite in zwei Schritten aus und ordnet anschließend die Wörter#
Die optische Zeichenerkennung (OCR) hat zwei Aufgaben: den Text finden und ihn anschließend lesen. Die Ultralytics-OCR-Lösung trennt diese Aufgaben klar:
- Erkennung: Ein YOLO26-Text-Modell, ein Detektor für orientierte Begrenzungsrahmen, zeichnet gedrehte Rahmen um Text. Es ist in den Größen n, s, m, l und x verfügbar; standardmäßig wird das x-Modell verwendet.
- Texterkennung: PP-OCRv6 medium liest jeden Ausschnitt aus. Es läuft mit ONNX Runtime aus der Ultralytics-Assets-Version, sodass du PaddlePaddle nicht installieren musst. Ausschnitte, in denen kein Text erkannt wird, werden verworfen.
- Sortierung: Die Wörter werden zu Zeilen gruppiert und von oben nach unten sowie von links nach rechts zurückgegeben. Jedes Wort ist mit seiner Zeilennummer versehen.
Jedes Wort wird als Datensatz mit Text, Konfidenzwert der Texterkennung, Konfidenzwert des Detektors, Zeilennummer und Polygon in den Koordinaten des Originalbilds zurückgegeben. Da die beiden Konfidenzwerte getrennt gespeichert werden, kannst du ein sicher erkanntes, aber unsicher gelesenes Wort zur menschlichen Prüfung weiterleiten, statt dich darauf zu verlassen.
Die beiden Stufen bleiben unabhängig. Du kannst einen kleineren Detektor, ein eigenes Erkennungs- oder Segmentierungsmodell oder ein anderes Texterkennungsmodell einsetzen; die Drehungserkennung und Lesereihenfolge funktionieren weiterhin. Du kannst denselben Codepfad in unserem Browser auf der Dokumentenverarbeitungsseite ausprobieren, bevor du etwas installierst.
Gedrehte und auf dem Kopf stehende Seiten in der richtigen Reihenfolge auslesen#
Die Lösung ermittelt die Seitendrehung anhand des erkannten Texts. Du musst die Seiten daher nicht vorher begradigen oder drehen:
- Textrichtung ermitteln. Die Lösung berechnet den gewichteten Mittelwert der Winkel der langen Seiten der erkannten Rahmen. Das Gewicht richtet sich danach, wie langgestreckt die einzelnen Rahmen sind. Rahmen mit einem Seitenverhältnis unter 2:1, etwa bei einzelnen Ziffern, werden nicht berücksichtigt.
- Seite drehen. Die Seite wird so gedreht, dass der Text von links nach rechts verläuft. Anschließend werden die Wörter aufrecht ausgeschnitten und zu Zeilen gruppiert.
- 0° oder 180° bestimmen. An einem Rahmen lässt sich nicht erkennen, ob der Text richtig herum steht. Deshalb liest die Lösung die 8 breitesten Wörter in beiden Ausrichtungen und behält die Drehung mit den höheren Konfidenzwerten bei. Auf dem Kopf stehender Text wird als Rauschen mit niedriger Konfidenz erkannt, sodass die richtige Ausrichtung hervorsticht.
Als wir 8 Dokumente und Bildschirmfotos sowie 12 Fotos um 90°, 180° und 270° drehten, lag der Wort-F1-Wert bei 0,925 für Dokumente und 0,654 für Fotos. Auf einem leeren IRS-Formular 8802 las die Lösung bei 0°, 180° und 90° jeweils 404, 401 und 399 Wörter aus; die ersten Zeilen waren identisch. Bei der vorherigen Version wurde vorausgesetzt, dass jede Seite richtig ausgerichtet war.
Die Standardeinstellungen beruhen auf einem Benchmark, nicht auf einer Vermutung#
Wir haben die wichtigsten Standardeinstellungen anhand von Messungen festgelegt. Der Benchmark lief auf einer RTX PRO 6000 mit dem produktiven Platform-Image; die Uploads wurden als JPEG mit höchstens 1280 Pixeln an der längsten Seite übertragen. Verwendet wurden 80 Validierungsfotos aus dem HierText-Datensatz von Google mit Transkriptionen lesbarer Wörter, 6 PDF-Seiten, die anhand ihrer Textebenen bewertet wurden (4 aus einer arXiv-Arbeit sowie leere IRS-Formulare 1040 und 8802), ein synthetischer Screenshot und ein synthetisches Bild. Als Metrik diente der Wort- F1-Wert, der Präzision und Trefferquote ausgleicht. Gezählt wurden kleingeschriebene Wörter mit mindestens 2 alphanumerischen Zeichen.
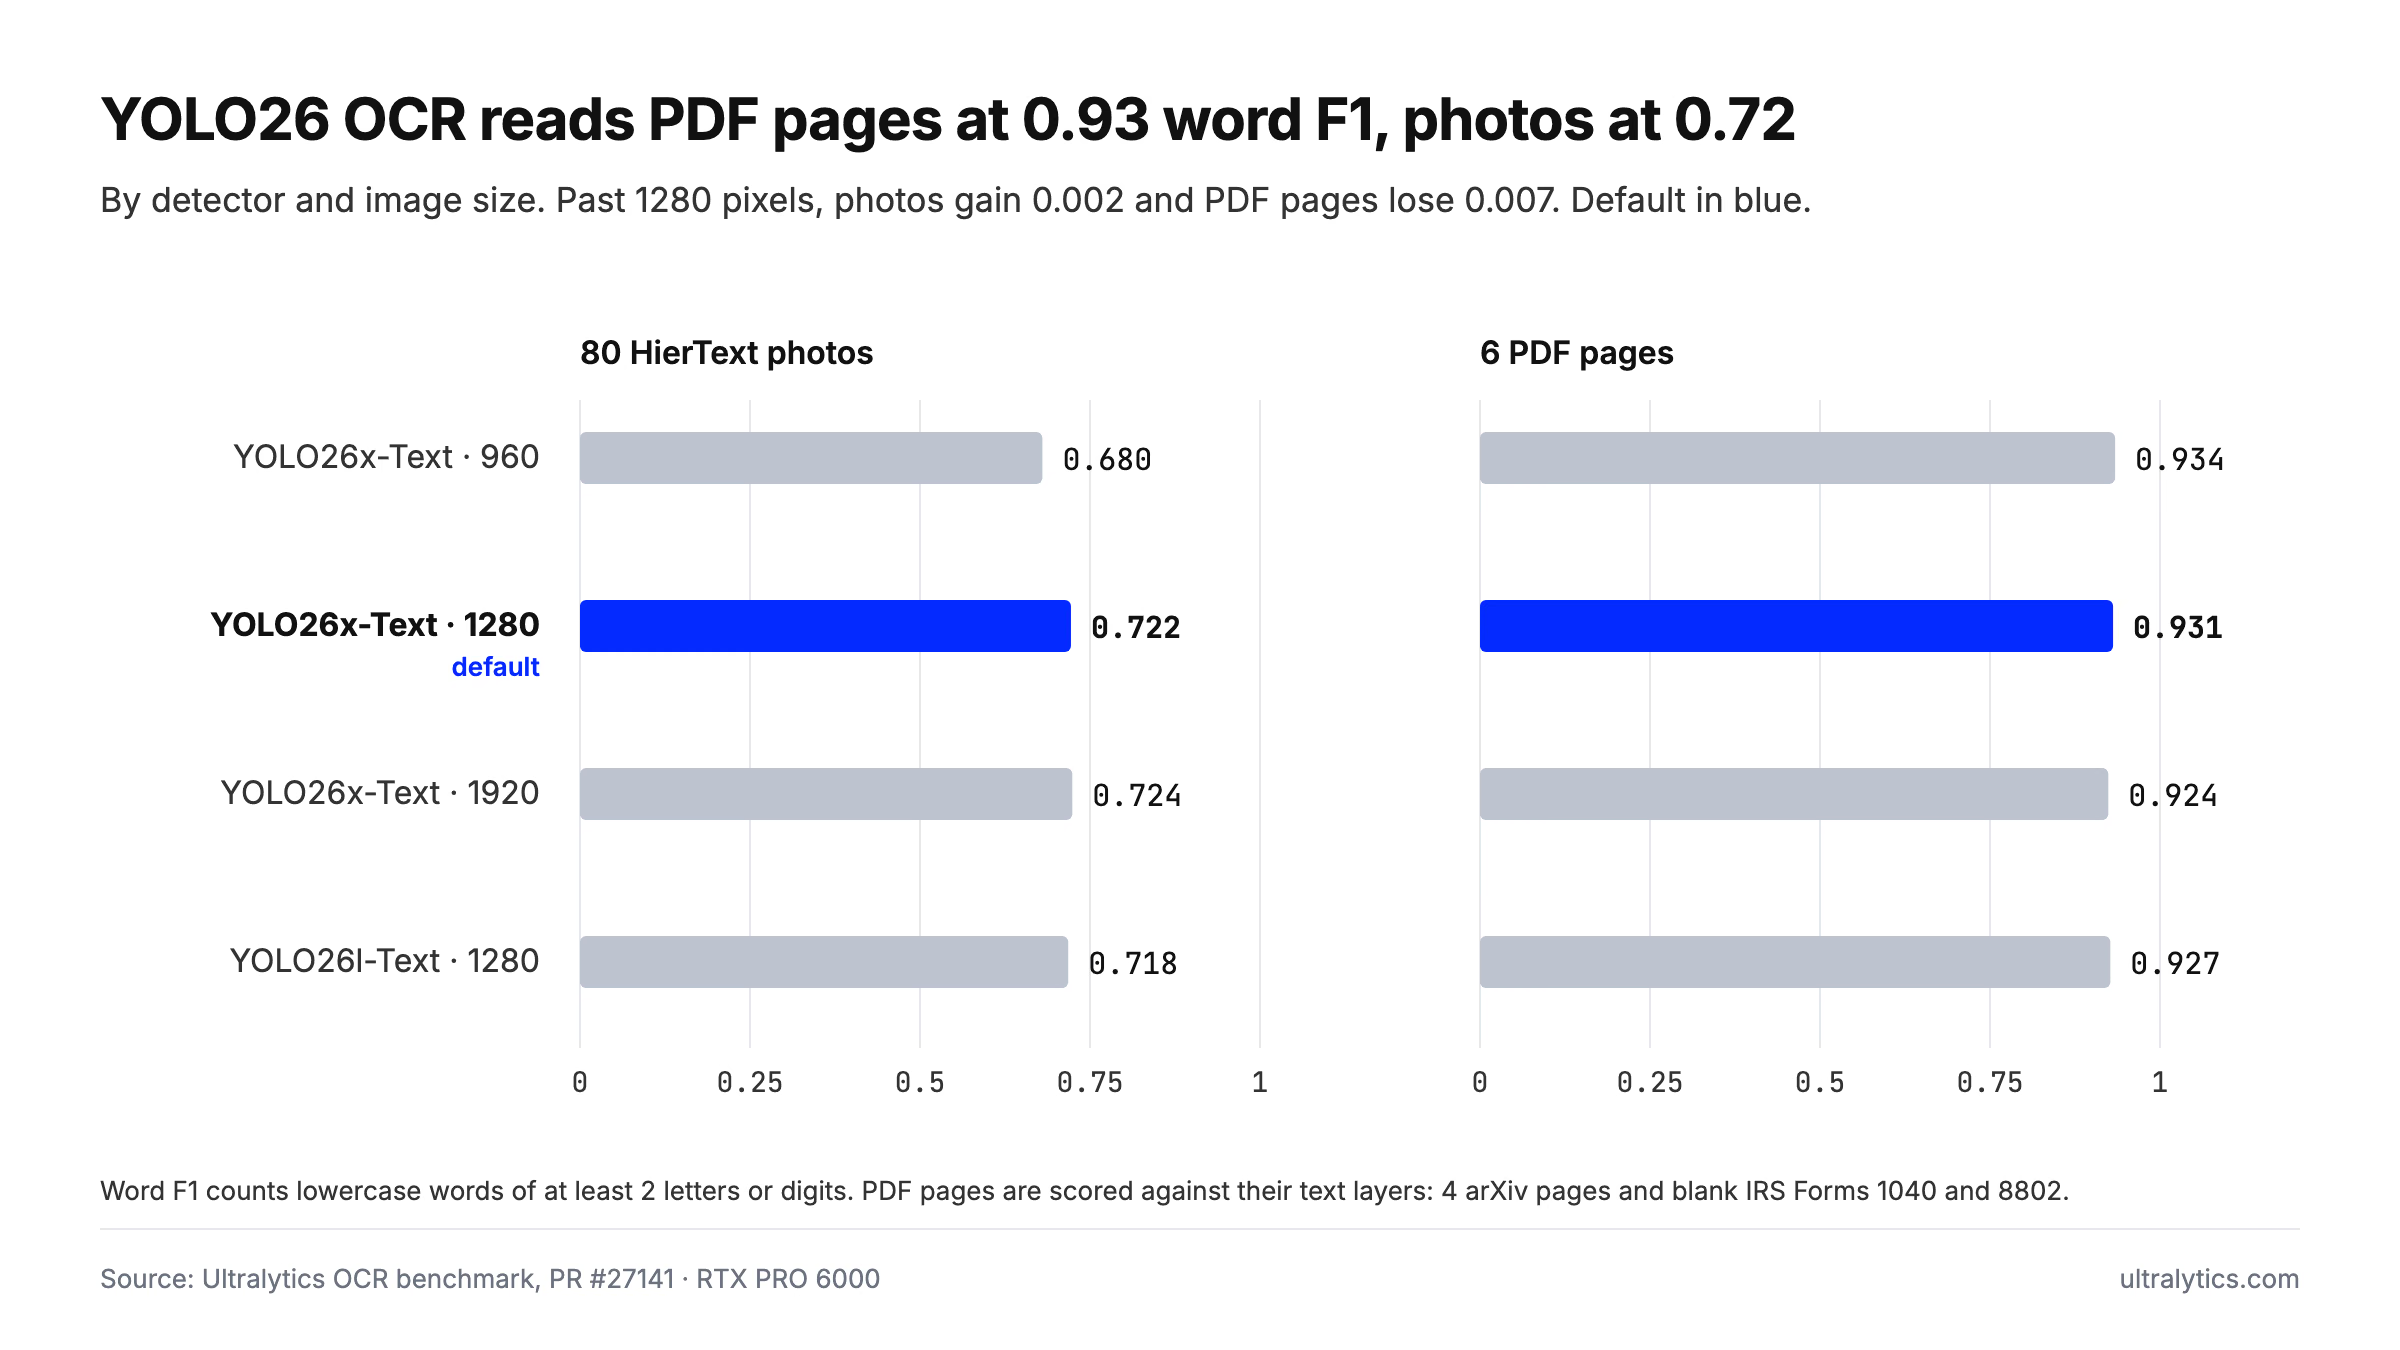
Wort-F1-Wert von YOLO26-Text mit PP-OCRv6 auf 80 HierText-Fotos und 6 PDF-Seiten, aufgeschlüsselt nach Detektor und Bildgröße, auf einer RTX PRO 6000.
Saubere PDF-Seiten werden bei jeder Einstellung deutlich besser ausgelesen als Fotos mit Text aus realen Umgebungen. Aus den Messwerten ergeben sich drei Standardeinstellungen:
yolo26x-textbeiimgsz=1280. Die Verringerung auf 960 kostete bei Fotos 0,042 F1-Punkte, während 1920 bei Fotos 0,002 Punkte hinzugewann und bei PDF-Seiten 0,007 Punkte einbüßte. Kleinere Bilder werden nicht auf 1280 vergrößert, sondern mit ihrer ursprünglichen Größe verarbeitet, aufgerundet auf den 32-Pixel-Schritt des Modells.- Wort für Wort lesen. Das Lesen einzelner Wörter erzielte bei Fotos einen um 4 F1-Punkte höheren Wert als das Lesen ganzer Zeilen.
max_det=1000. Auf eine dichte Dokumentseite passen mehr als die üblichen 300 Erkennungen.
Wenn du einen leichteren Detektor brauchst, lag YOLO26l-Text bei beiden Datensätzen weniger als einen halben Punkt unter dem x-Modell.
OCR mit YOLO26 in Python ausführen#
Installiere oder aktualisiere das Paket mit pip install -U "ultralytics>=8.4.211". Beim ersten OCR-Aufruf werden YOLO26x-Text und PP-OCRv6 heruntergeladen und ONNX Runtime installiert. Wenn CUDA verfügbar ist, kommt onnxruntime-gpu zum Einsatz. Für das standardmäßige ONNX-Runtime-Erkennungsmodell brauchst du Python 3.11+ und ONNX Runtime 1.26+.
Ein Bild auslesen#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text mit imgsz=1280 und PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # Bild mit Anmerkungen

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Über die Befehlszeile führt yolo solutions ocr source="path/to/video.mp4" denselben Vorgang für jedes Einzelbild aus. Jedes Einzelbild wird unabhängig und ohne Nachverfolgung verarbeitet.
Ein PDF auslesen#
Die Lösung verarbeitet Bilder. Rendere daher zuerst jede PDF-Seite als Bild. Eine Möglichkeit dafür ist PyMuPDF:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # bereits in Lesereihenfolge
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Da result.texts bereits sortiert ist, lässt sich Klartext mit einem Wörterbuch und einer Verknüpfung zusammensetzen. Mithilfe der Polygone kannst du noch mehr tun, zum Beispiel prüfen, ob ein Betrag neben dem Wort „Total“ steht.
Modell, Gerät und Erkennungsmodell auswählen#
- Kleinerer Detektor:
solutions.OCR(model="yolo26s-text.pt")lädt einen kleineren, schnelleren Detektor. Prüfe seine Genauigkeit anhand deiner eigenen Seiten. Alle fünf Größen werden automatisch heruntergeladen. - CPU oder GPU: Das Erkennungsmodell läuft auf CUDA, wenn eine CUDA-GPU ausgewählt und der CUDA-Ausführungstreiber von ONNX Runtime verfügbar ist; andernfalls läuft es auf der CPU. Dasselbe Skript funktioniert also auf einem Laptop oder Server.
- Eigenes Erkennungsmodell: Übergib eine Funktion als
recognizer. Sie erhält jeden BGR-Wortausschnitt und gibt(text, confidence)zurück. Die Lösung übernimmt weiterhin Erkennung, Drehung und Sortierung.
def recognize(crop):
    # Beliebiges Texterkennungsmodell auf den BGR-Wortausschnitt anwenden
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT liest Wörter auf dichten Fotos 2,5- bis 3-mal schneller aus#
In unseren GPU-Tests mit dichten Seiten nahm die Texterkennung den größten Teil der Laufzeit in Anspruch, nicht die Erkennung. Eine frühere Optimierung maß für die Erkennung etwa 11 ms bei einer Anfrage von 250 ms. Der TensorRT-Pull-Request führte einen großen Teil der verbleibenden Zeit für die Texterkennung auf 33 kleine Stapel zurück, bei denen der Startaufwand statt der Berechnung den Ausschlag gab. Ultralytics 8.4.211 ergänzt dafür ein Argument:
ocr = solutions.OCR(recognizer="tensorrt") # FP16-TensorRT-Engine auf NVIDIA-GPUsBeim ersten Durchlauf wird in etwa 30 Sekunden eine FP16-TensorRT-Engine erstellt und neben dem PP-OCRv6-Modell zwischengespeichert – einmal pro TensorRT-Version und GPU-Architektur. Spätere Ladevorgänge dauern 0,05 bis 0,2 Sekunden. Laut Versionshinweisen ist sie auf dichten Seiten etwa 2,5-mal schneller als ONNX Runtime.
Wir haben read_words gemessen – den Schritt nach der Erkennung, bei dem Wörter ausgeschnitten, gedreht, erkannt und sortiert werden – und dafür vier Fotos mit Text aus realen Umgebungen verwendet. Bei den drei Fotos mit 195 bis 263 Wörtern war die FP16-Engine 2,5- bis 3-mal schneller als ONNX Runtime auf CUDA; bei einem Foto mit 48 Wörtern war sie 1,4-mal schneller:
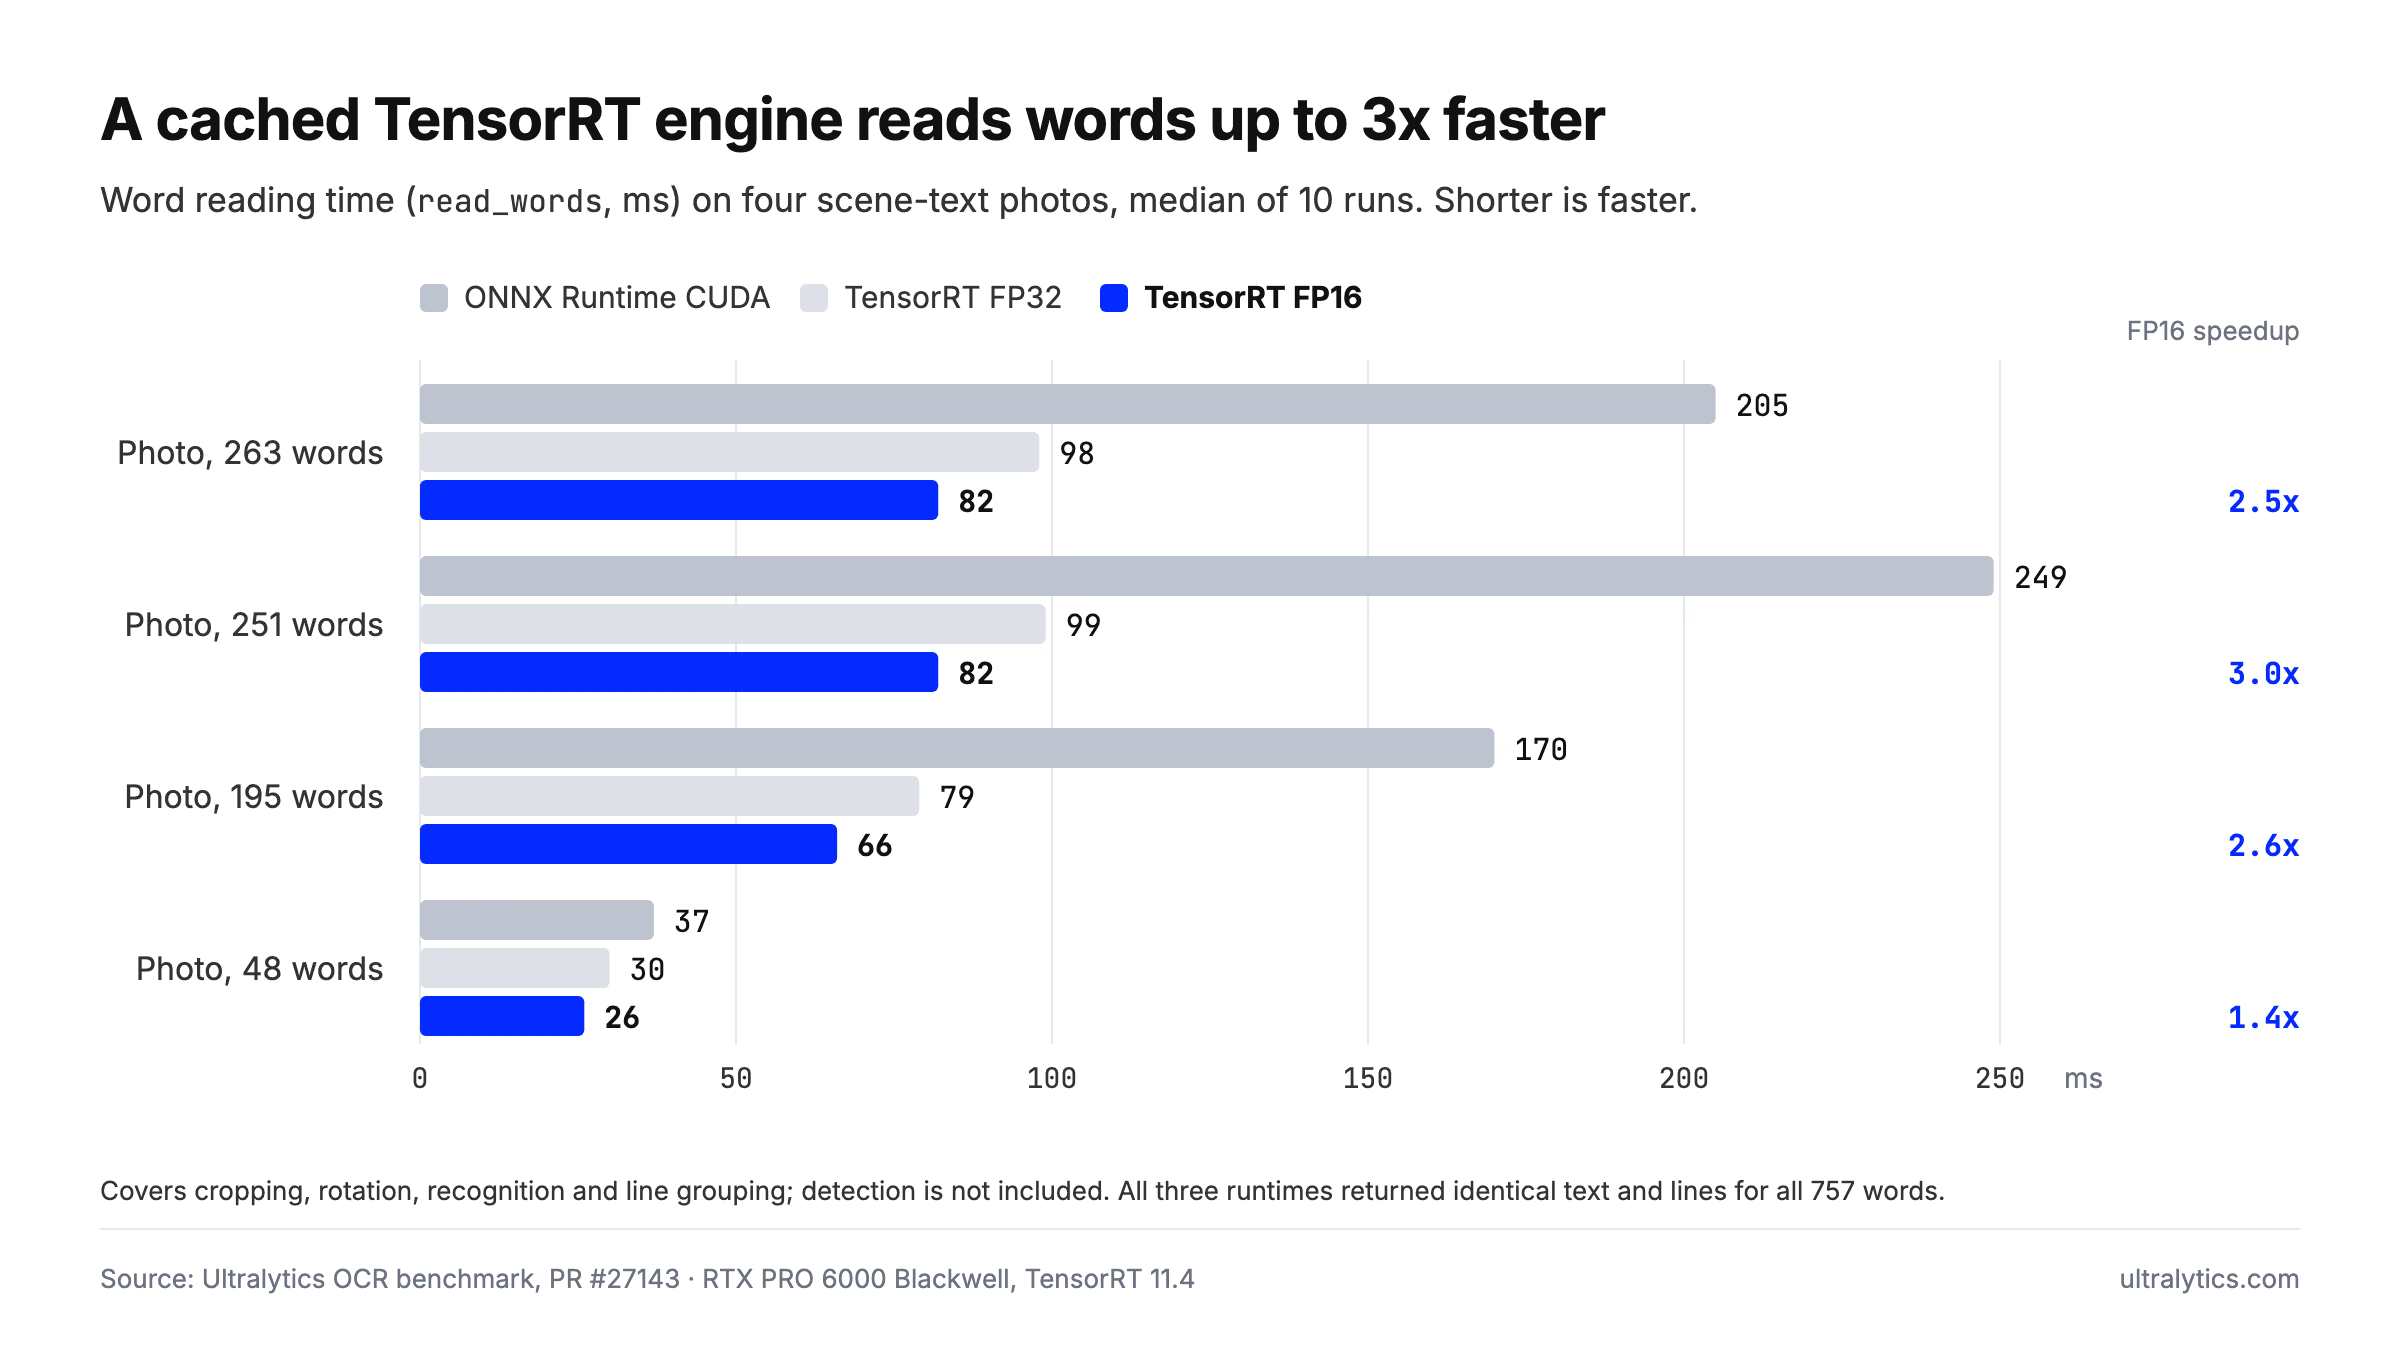
Wortlesezeit auf vier Fotos mit Text aus realen Umgebungen mit ONNX Runtime CUDA und FP32- und FP16-TensorRT-Engines; Median aus 10 Durchläufen auf einer RTX PRO 6000 Blackwell mit TensorRT 11.4.
Bei einer dichten Seite sank die Laufzeit eines vollständigen OCR-Aufrufs von 182 ms auf 94 ms. Bei diesen vier Fotos änderte die höhere Geschwindigkeit die Ausgabe nicht: Für alle 757 Wörter lieferten ONNX Runtime und beide Engines identischen Text und dieselbe Zeilengruppierung.
Verwende weiterhin das standardmäßige recognizer="paddleocr", wenn du nicht auf den ersten Engine-Aufbau warten kannst oder keine NVIDIA-Hardware verwendest. Es erstellt keine Engine und startet in etwa einer Sekunde. Unser Vergleich von ONNX und TensorRT zeigt denselben Zielkonflikt für Erkennungsmodelle; die TensorRT-Integrationsanleitung erklärt die Einrichtung.
Chinesische, japanische und lateinische Schrift werden derzeit unterstützt#
PP-OCRv6 kann nur Zeichen aus seinem integrierten Zeichensatz mit 18.708 Zeichen ausgeben. Der YOLO26-Text-Detektor ist nicht von diesem Zeichensatz abhängig und findet weiterhin Wörter in anderen Schriften. Zeichen außerhalb des Zeichensatzes werden jedoch durch ähnlich aussehende Zeichen ersetzt. Das russische ТЕКСТ wird zum Beispiel als „TEKCT“ gelesen, oft mit hoher Konfidenz.
- Unterstützt: Vereinfachtes und traditionelles Chinesisch (etwa 15.600 CJK-Zeichen), Japanisch (Hiragana, Katakana und Kanji) sowie Sprachen mit lateinischer Schrift, darunter Englisch, Französisch, Deutsch, Spanisch, Portugiesisch, Italienisch, Niederländisch, Schwedisch, Finnisch, Dänisch, Norwegisch, Polnisch, Tschechisch, Ungarisch, Rumänisch, Türkisch, Kroatisch, Indonesisch und Malaiisch. Alle Buchstaben und Buchstaben mit Akzenten werden abgedeckt, außer dem deutschen Großbuchstaben ẞ und dem spanischen ¡.
- Teilweise unterstützt: Vietnamesisch, bei dem die meisten Vokale mit Tonzeichen fehlen, und Griechisch, bei dem nur Grundbuchstaben abgedeckt sind.
- Noch nicht unterstützt: Kyrillisch, Koreanisch (Hangul), Arabisch, Hebräisch, Devanagari und Thai.
Verwende bei einer nicht unterstützten Schrift weiterhin den YOLO26-Text-Detektor und übergib als recognizer ein für diese Schrift trainiertes Erkennungsmodell. Die vollständige Übersicht findest du im Abschnitt zu unterstützten Sprachen der OCR-Anleitung.
OCR-Bibliotheken für Python im Vergleich nach dokumentierten Funktionen#
Es gibt nicht das eine beste OCR-Modell. Welches Modell passt, hängt von deinen Seiten, Sprachen und der Laufzeitumgebung ab. Die Tabelle vergleicht die dokumentierten Funktionen und keine Messergebnisse. Grundlage sind die öffentlichen Seiten der einzelnen Projekte, wie sie am 12. November 2026 geprüft wurden. Die Optionen sind alphabetisch sortiert.
| Option | Laufzeitumgebung | Gedrehter Text | Dokumentierte Sprachen | Ausgabe |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info probiert für jedes Textfeld 90°, 180° und 270° aus | 80+, darunter Kyrillisch, Arabisch, Devanagari, Koreanisch und Thai | Rahmen, Text und Konfidenz |
| PaddleOCR | PaddlePaddle | Optionale Ausrichtungsklassifizierung | 100+ (PP-OCRv6 deckt 50 in einem Modell ab) | Rahmen, Text und Konfidenz |
| Tesseract (pytesseract) | Native Binärdatei, CPU | Ausrichtungs- und Schrifterkennung (image_to_osd); Bild vor dem Lesen drehen | 100+ | Text, optional mit Wortdaten |
| Ultralytics YOLO26 OCR | PyTorch-Detektor; Erkennungsmodell mit ONNX Runtime oder TensorRT auf NVIDIA-GPUs | Seitendrehung anhand des erkannten Texts geschätzt; 0° oder 180° wird automatisch bestimmt | Chinesisch, Japanisch und lateinische Schriften; weitere Schriften mit einem eigenen Erkennungsmodell | Wörter in Lesereihenfolge mit Zeilennummern, Polygonen und getrennten Konfidenzwerten für Erkennung und Texterkennung |
Die aktuelle Funktionsauswahl findest du in der Dokumentation von EasyOCR, im PaddleOCR-Repository, in der Tesseract-Dokumentation und bei pytesseract. Hintergrundinformationen zur Funktionsweise dieser Engines findest du in unserem Überblick über beliebte OCR-Modelle mit offenem Quellcode.
Wo Ultralytics ins Spiel kommt#
Ultralytics YOLO26 OCR richtet sich an Python-Entwickler, die Text aus unterschiedlichen Eingaben wie gescannten Formularen, PDF-Seiten, Screenshots und Fotos von Etiketten und Schildern in Lesereihenfolge und mit überprüfbaren Koordinaten auslesen müssen. Die Lösung eignet sich, wenn Seiten in unvorhersehbaren Winkeln eintreffen, du OCR auf deinen eigenen Rechnern ausführen möchtest oder bereits Ultralytics YOLO26-Modelle nutzt und OCR im selben Paket haben möchtest. Ergänze recognizer="tensorrt" für hohe Verarbeitungsmengen auf NVIDIA-GPUs.
Der Detektor ist ein gewöhnliches Ultralytics-Modell und lässt sich wie jedes andere trainieren, validieren und exportieren. Im YOLO26-Text-Projekt auf Ultralytics Platform findest du alle fünf Größen von n bis x. Dort kannst du ihre Trainingskurven vergleichen und das Projekt klonen, um mit diesen Modellen zu starten.
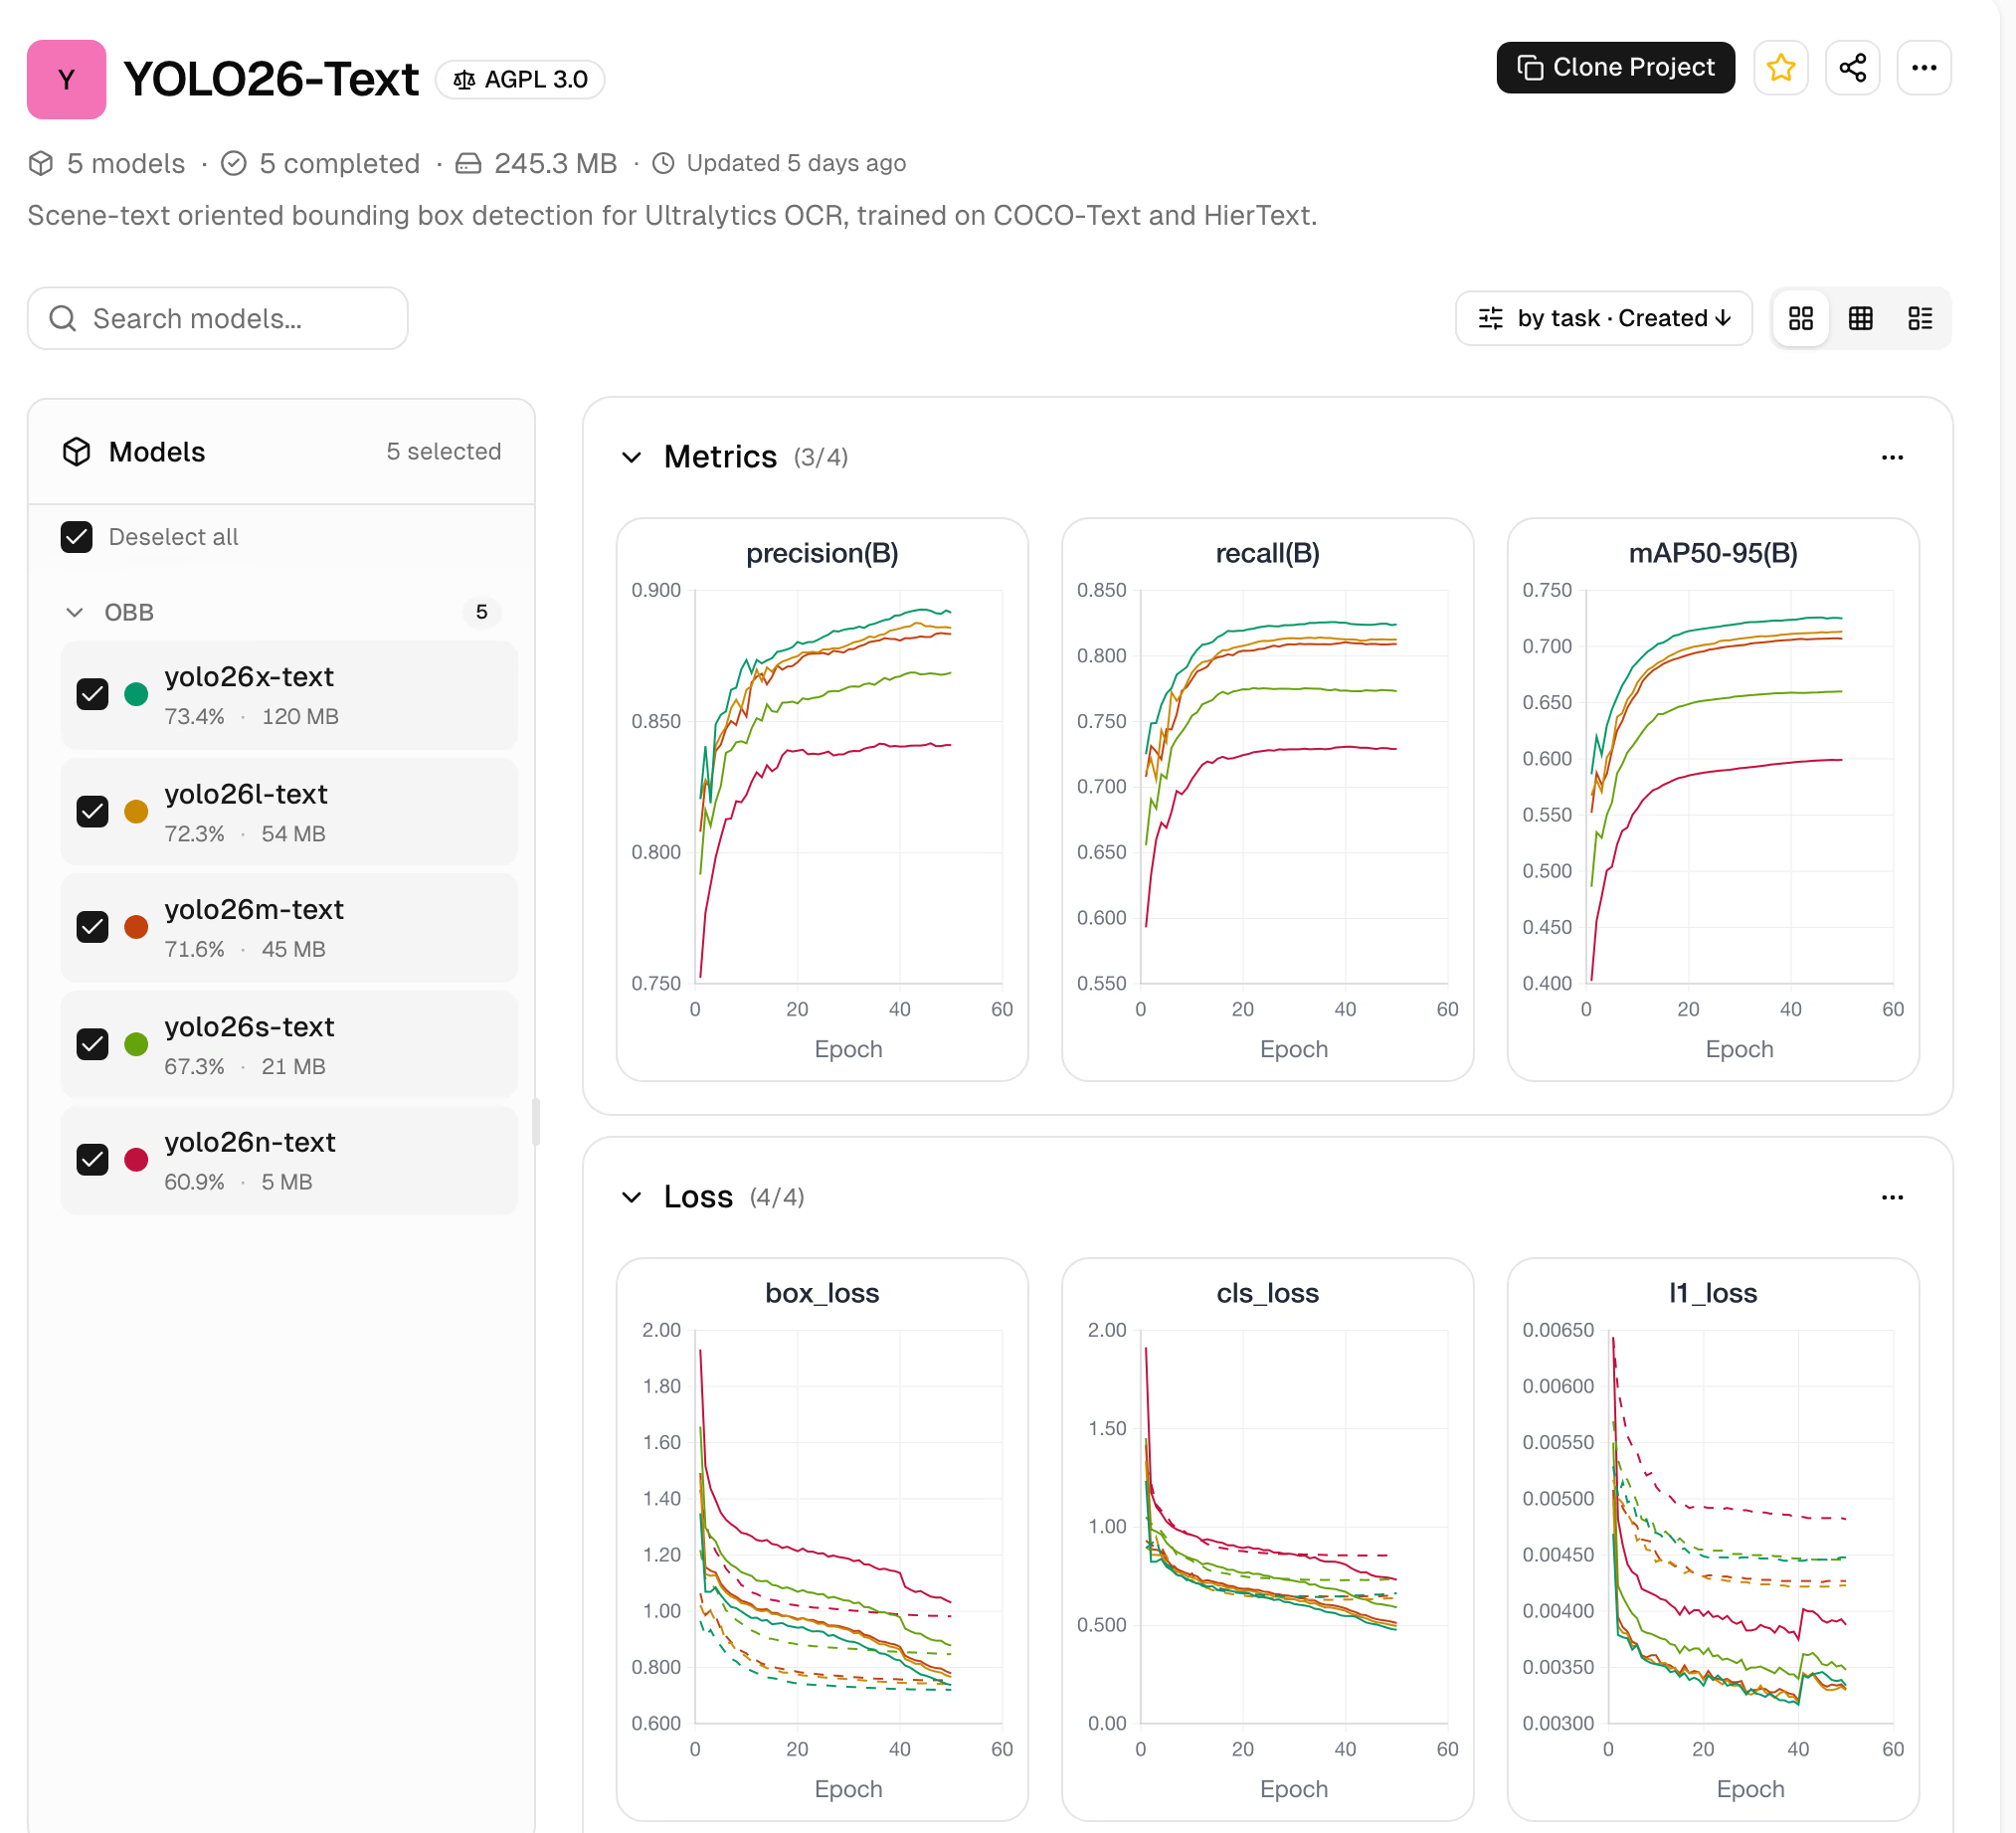
Das YOLO26-Text-Projekt auf Ultralytics Platform: alle fünf Detektorgrößen mit ihren Kurven für Präzision, Trefferquote, mAP50-95 und Verlust während des Trainings.
Um das Modell an deine Dokumente anzupassen, verwende zunächst den Scene-Text-OBB-Datensatz. Er vereint COCO-Text und HierText in 65.325 Bildern mit etwa 1,29 Millionen Wortpolygonen.
Die Einschränkungen sind konkret:
- Schriften. Das standardmäßige Erkennungsmodell kann Kyrillisch, Koreanisch, Arabisch, Hebräisch, Devanagari und Thai noch nicht lesen. Kombiniere den Detektor mit einem eigenen Erkennungsmodell oder wähle eine Engine, die diese Schriften abdeckt.
- Unterschiedliche Leserichtungen. Die Lösung dreht die gesamte Seite entsprechend der vorherrschenden Textrichtung. Text, der auf einer Seite in mehreren Richtungen verläuft, etwa eine vertikale Randnotiz, kann daher schlechter gelesen werden.
- Export. Das Erkennungsmodell ist nicht in einer exportierten Detektordatei enthalten. Stelle daher Detektor und Erkennungslaufzeit nebeneinander bereit oder verwende die Python-Lösung als Verbindungsschicht.
- Rust. Ultralytics Inference liest Text aus realen Umgebungen in Rust mit demselben PP-OCRv6-Erkennungsmodell über
ultralytics-inference predict --ocraus. Die Ausrichtung wird jedoch mit einem Klassifikator statt mit dem Schritt zur Seitendrehung der Python-Lösung behandelt. - Datenschutz. Die Python-Lösung läuft auf deiner eigenen Hardware, sodass die Seiten deine Rechner nicht verlassen müssen. Bei der Browserdemo werden Seiten zur Inferenz hochgeladen. Decke Bereiche mit vertraulichen Feldern, die nicht gelesen werden dürfen, vor dem OCR-Lauf mit einer undurchsichtigen Maske ab.
Bei Formularen und Verträgen kann ein eigenes YOLO-Modell zuerst Felder, Tabellen, Unterschriften und Stempel finden, sodass du nur die benötigten Bereiche ausliest. Der Unterschriftendatensatz auf Ultralytics Platform und unsere Anleitung zur intelligenten Dokumentenanalyse sind gute Ausgangspunkte. Mit Ultralytics Platform kannst du Seiten an einem Ort beschriften und das Modell trainieren. Um OCR zuerst auf einer eigenen Seite auszuprobieren, ziehe ein Bild oder PDF in die Live-OCR-Demo.
Häufig gestellte Fragen
Installiere das Ultralytics-Paket mit
pip install -U "ultralytics>=8.4.211"und rufe anschließendsolutions.OCR()für ein mit OpenCV geladenes Bild auf. Die Lösung gibt die erkannten Wörter mit Text, Konfidenz, Zeilennummer und Polygon in Lesereihenfolge zurück. Beim ersten Durchlauf werden der YOLO26-Text-Detektor und das PP-OCRv6-Erkennungsmodell automatisch heruntergeladen.Das hängt von deinen Dokumenten, Sprachen und deiner Hardware ab. Unser Überblick über beliebte OCR-Modelle mit offenem Quellcode vergleicht die wichtigsten Optionen. In unserem Benchmark mit einer Bildgröße von 1280 auf einer RTX PRO 6000 erreichte YOLO26x-Text mit PP-OCRv6 einen Wort-F1-Wert von 0,931 auf sechs PDF-Seiten und 0,722 auf 80 HierText-Fotos. Außerdem liest das Modell Seiten in jeder Ausrichtung aus. Für noch nicht abgedeckte Schriften wie Kyrillisch oder Koreanisch verwendest du ein dafür trainiertes Erkennungsmodell.
Ein YOLO-Modell erkennt Text, liest ihn aber nicht aus. Ultralytics YOLO26-Text erkennt Text als orientierte Rahmen. Die OCR-Lösung übergibt jeden Ausschnitt an das PP-OCRv6-Erkennungsmodell. Zusammen führen sie so einen vollständigen OCR-Aufruf aus.
Ja. Wandle jede PDF-Seite in ein Bild um, zum Beispiel mit
get_pixmapvon PyMuPDF, konvertiere es in BGR und übergib es ansolutions.OCR(). Im Browser akzeptieren die Demo und der Tab „Platform Predict“ ein PDF und lesen die erste Seite aus.Ja. PP-OCRv6 läuft mit ONNX Runtime auf der CPU oder auf CUDA-GPUs, und dasselbe Skript funktioniert auf beiden. Für den optionalen TensorRT-Erkenner ist eine NVIDIA-GPU erforderlich.
Mit dem standardmäßigen Erkenner noch nicht. PP-OCRv6 unterstützt Chinesisch, Japanisch und Sprachen mit lateinischer Schrift, aber weder Kyrillisch noch Hangul, Arabisch, Hebräisch, Devanagari oder Thai. Du kannst weiterhin den YOLO26-Textdetektor verwenden und einen für das jeweilige Schriftsystem trainierten Erkenner übergeben.
Verfasst von
Senior Machine-Learning-Engineer · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









