Ultralytics YOLO26 ahora admite la estimación monocular de profundidad
Descubre cómo la nueva tarea de estimación de profundidad de Ultralytics YOLO26 predice la profundidad a escala métrica para cada píxel a partir de una única imagen RGB, sin necesidad de un sistema estéreo ni de LiDAR.
Hasta ahora, añadir profundidad a un flujo de trabajo de YOLO implicaba montarlo por tu cuenta. Lo habitual era ejecutar YOLO para la detección y combinarlo con un modelo de profundidad independiente de otro proyecto, como MiDaS o Depth Anything. Eso suponía una segunda dependencia, un segundo marco de trabajo y dos conjuntos de formatos de entrada y salida que había que conciliar.
La estimación monocular de profundidad ya es una tarea nativa de Ultralytics YOLO26. Una sola imagen RGB produce un valor de distancia para cada píxel mediante el mismo paquete, flujo de trabajo y ruta de exportación que la detección, la segmentación y la pose.
¿Qué es la estimación de profundidad?#
La estimación de profundidad predice un mapa de profundidad por píxel a partir de una sola imagen RGB, sin necesidad de una segunda cámara ni de sensores adicionales. Cada píxel de salida contiene un valor de profundidad en metros que representa la distancia estimada entre la cámara y ese punto de la superficie.
El resultado es un mapa denso de valores de coma flotante con forma (H, W), alineado con la entrada, donde cada píxel contiene una distancia absoluta en metros; es decir, una distancia desde la cámara, no un orden relativo de qué está más cerca o más lejos.
La profundidad es una tarea independiente, con su propio punto de control, y su único resultado es el mapa de profundidad; no devuelve cuadros delimitadores ni máscaras de segmentación. Por tanto, combinar la detección con la profundidad requiere ejecutar dos modelos y realizar dos pasadas hacia delante. La diferencia con la práctica anterior es que ahora ambos forman parte de un único paquete y comparten una instalación, una interfaz de entrenamiento y predicción, una ruta de exportación y una sola versión que mantener, en lugar de tener que mantener un segundo marco de trabajo junto al primero.
Este resultado por píxel es lo que hace útil la profundidad para detectar obstáculos y espacio libre, comprobar distancias de seguridad, analizar la distribución de la escena y entender qué hay delante de qué.
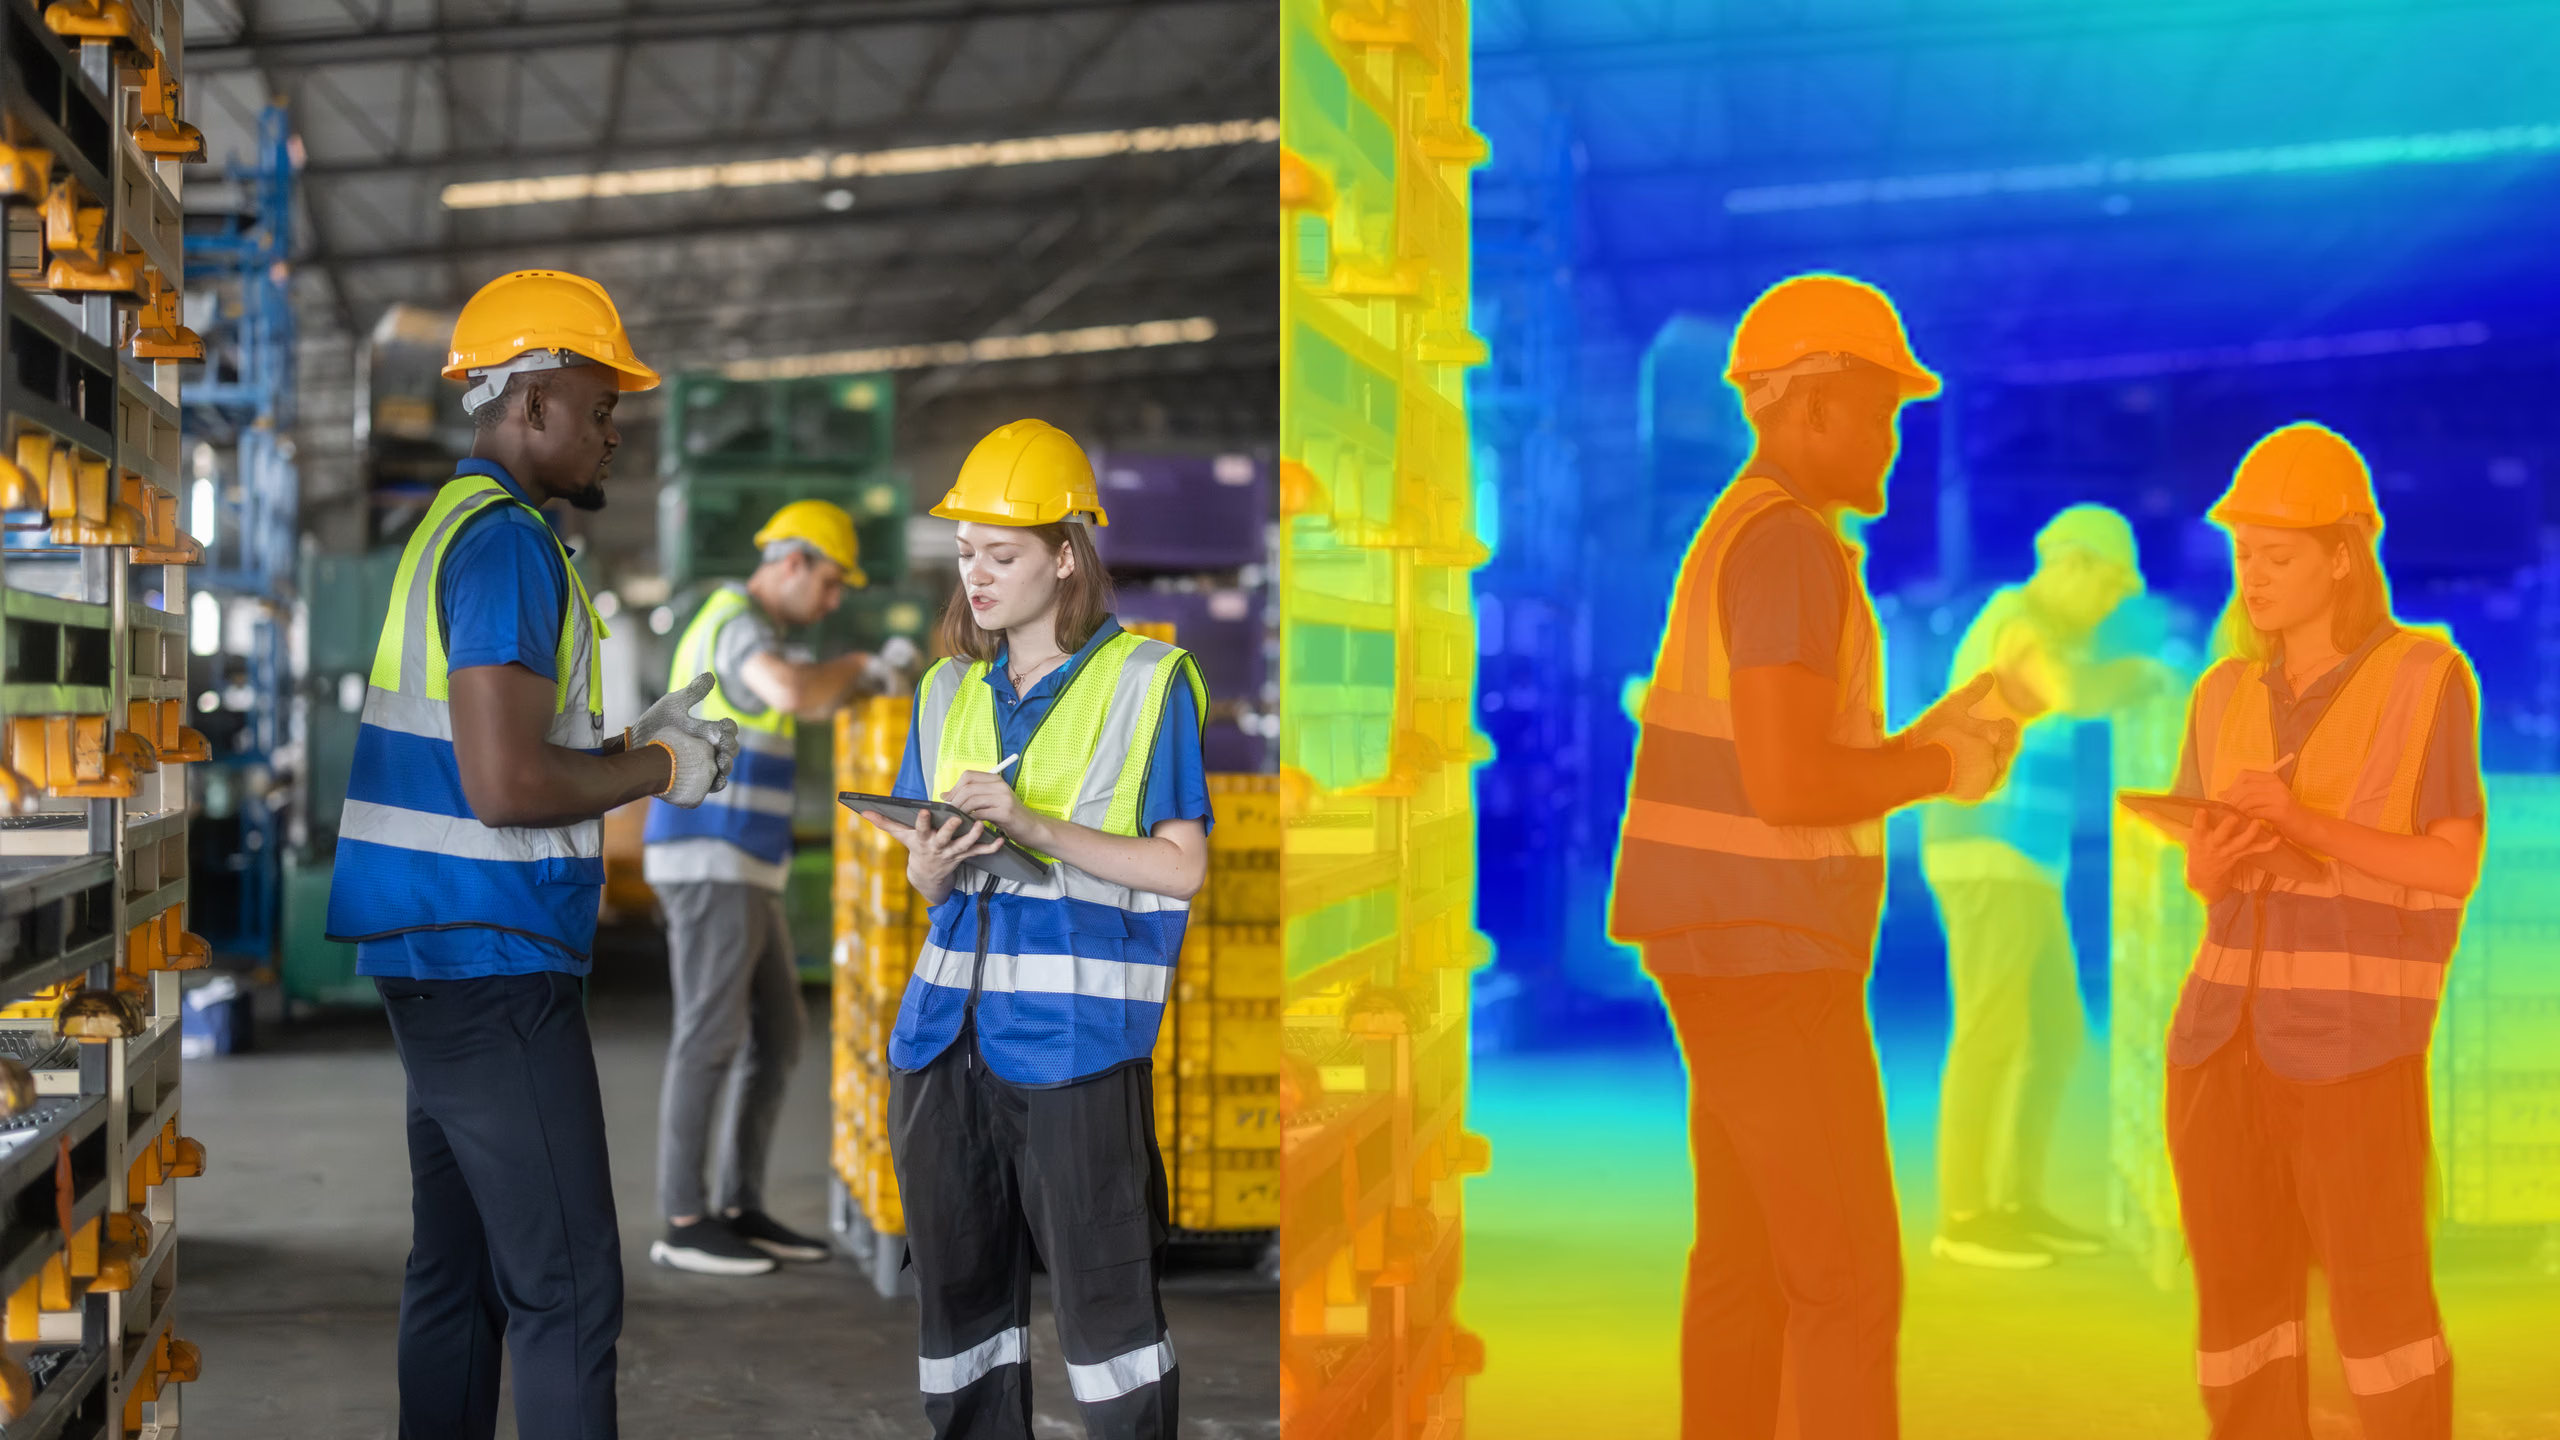 Fig. 1. Estimación de profundidad de Ultralytics YOLO26 para la supervisión de la seguridad y el cumplimiento normativo.
Ultralytics YOLO26 incluye cinco modelos de profundidad preentrenados, desde yolo26n-depth hasta yolo26x-depth, entrenados con una amplia combinación de conjuntos de datos que abarca aproximadamente 2,19 millones de imágenes de interiores y exteriores. En el conjunto NYU Depth V2, la precisión δ1 va desde 0,882 en el modelo nano hasta 0,933 en el modelo extragrande, para que puedas elegir el equilibrio entre velocidad y precisión que mejor se adapte a tu objetivo de despliegue.
Profundidad ilimitada por diseño#
La mayoría de los modelos de profundidad limitan sus predicciones a un rango fijo, como 0–10 metros, lo que funciona bien en escenas de interior, pero falla en exteriores. Ultralytics predice la profundidad en una escala logarítmica abierta, sin un límite máximo fijo.
La diferencia se aprecia en las pruebas. Un modelo con límite alcanza una meseta casi de inmediato cuando se entrena con datos mixtos de interior y exterior, y se viene abajo con conjuntos de datos de mayor alcance, como KITTI, donde los objetos pueden estar a 80 metros. El enfoque de Ultralytics YOLO26 no tiene ese límite, así que sigue mejorando con más datos y funciona bien desde unos pocos centímetros hasta varios cientos de metros. En KITTI, δ1 alcanza 0,942 con un alcance de 80 m. Esto significa que una misma familia de modelos gestiona igual de bien una escena sobre una mesa y una escena de autopista.
Comparativa de profundidad de Ultralytics YOLO26 y Depth Anything V2#
Si hoy ejecutas Depth Anything junto con YOLO, la diferencia está en la velocidad y en el coste de computación asociado. La estimación de profundidad de Ultralytics YOLO26 es hasta 20,3 veces más rápida que Depth Anything V2 Base y 7,7 veces más rápida que Depth Anything V2 Small, con un modelo mucho más pequeño: menos de 10 millones de parámetros en la versión nano, frente a los aproximadamente 24 millones del modelo más pequeño de DA V2.
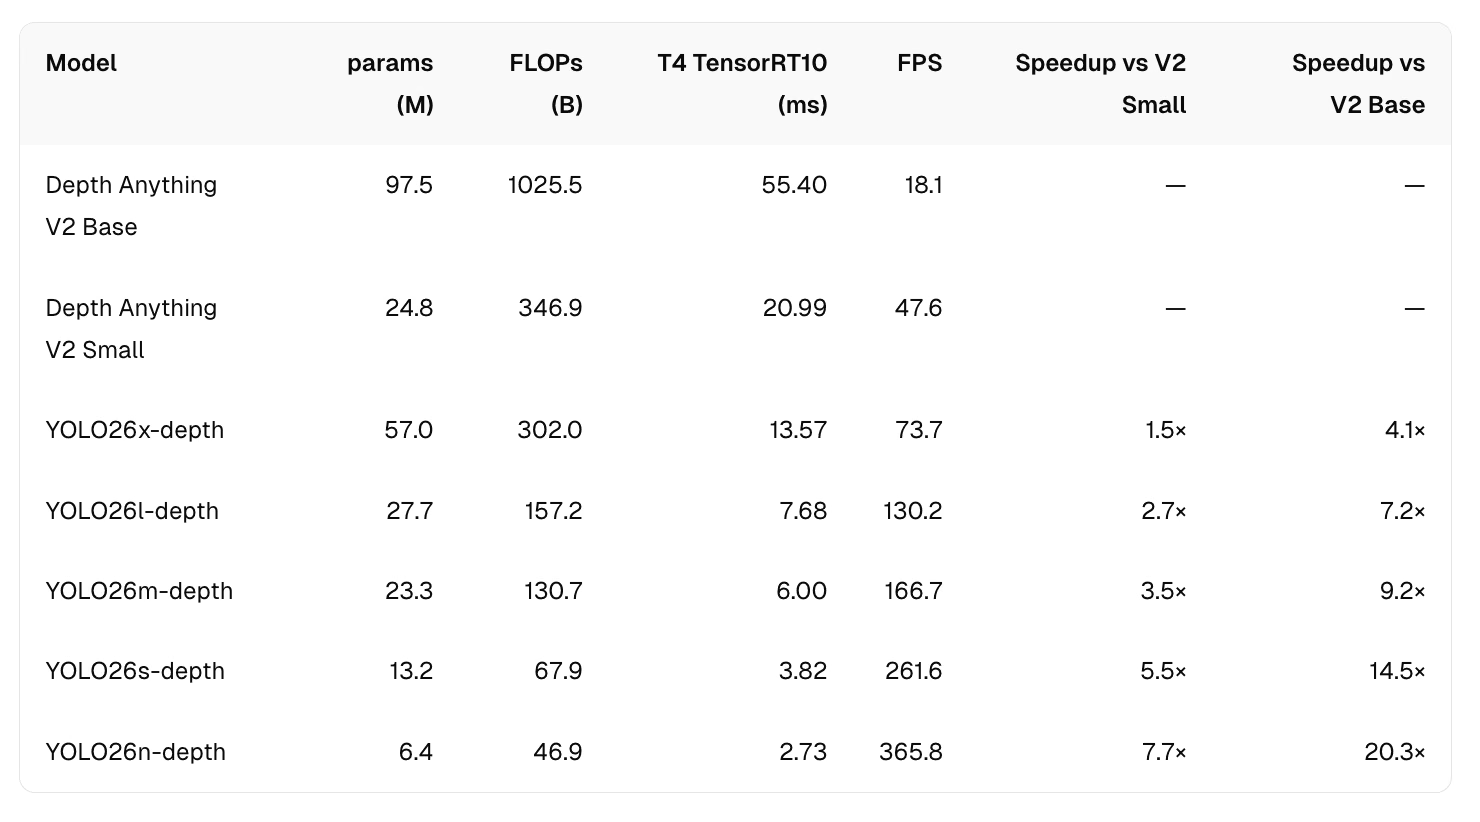 Fig. 2. Pruebas de velocidad de la estimación de profundidad de Ultralytics YOLO26 frente a Depth Anything V2.
Esa diferencia es precisamente el objetivo del diseño. Los modelos de Depth Anything V2 son considerablemente más grandes; Ultralytics YOLO26-Depth ofrece un alto rendimiento en profundidad con un tamaño y una velocidad que reducen el coste de computación por fotograma y permiten desplegarlo en hardware al que esos modelos no pueden llegar. La documentación publica las cifras de precisión por modelo en NYU Depth V2 y KITTI, para que puedas compararlas con tus requisitos reales.
Dónde se ejecuta#
Esa diferencia de tamaño es lo que determina dónde se puede utilizar realmente la estimación de profundidad. A la mayoría de los equipos que evalúan esta tecnología no les faltan ideas, sino capacidad de computación. Los drones de bajo consumo, los robots cuadrúpedos, los dispositivos ponibles, las cámaras para salpicadero, los equipos para videoconferencias y los PC industriales alcanzan antes su límite de potencia y coste que su límite de precisión.
La estimación de profundidad incluye cinco modelos preentrenados, para que puedas elegir el tamaño que se ajuste al objetivo en lugar del que gane una prueba de rendimiento. Como la profundidad es una tarea nativa de Ultralytics YOLO26, utiliza la misma vía de exportación que la detección, la segmentación y la estimación de pose, con los siguientes formatos: ONNX, TensorRT, CoreML, NCNN, LiteRT.
Primeros pasos con la estimación de profundidad de Ultralytics YOLO26#
El paquete de Python de Ultralytics ofrece una interfaz única y unificada para entrenar, validar y ejecutar inferencias en todas las tareas de YOLO26, incluida la estimación de profundidad. Para ejecutar un modelo de profundidad preentrenado, basta con un comando:
from ultralytics import YOLO
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-depth.pt")  # cargar un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Predecir con el modelo
results = model("https://ultralytics.com/images/bus.jpg")  # predecir sobre una imagen

# Acceder a los resultados
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, forma (H, W), metros
O desde la CLI:
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
La distancia absoluta depende de la cámara y de la escena. Si la forma del mapa de profundidad es correcta, pero la escala no, model.calibrate() ajusta dos variables de la cabeza de profundidad del modelo —una escala y un desplazamiento— usando unos 100 fotogramas etiquetados. Lo hace en segundos, sin entrenamiento y sin modificar el resto de la red.
Ajuste fino con tus propios datos#
Para adaptar un modelo de profundidad preentrenado a tu cámara o dominio, parte de los pesos preentrenados, usa AdamW y reduce la tasa de aprendizaje muy por debajo del valor predeterminado para entrenar desde cero, de modo que el ajuste fino refine el modelo en lugar de sobrescribirlo:
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # partir de pesos preentrenados
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100 veces por debajo del valor predeterminado para entrenar desde cero
    warmup_bias_lr=1e-4,  # mantener también un calentamiento gradual
)
Como la cabeza logarítmica predeterminada no tiene límites, funciona sin ajustes adicionales tanto con conjuntos de datos de corto alcance como de largo alcance, sin necesidad de ajustar max_depth. Si solo falla la escala absoluta con tu cámara específica, model.calibrate() ajusta una corrección ligera y de forma cerrada usando una pequeña partición etiquetada. Lo hace en segundos y sin tocar los pesos de la red.
Los conjuntos de datos emparejan cada imagen RGB con un archivo de profundidad .npy en una estructura de carpetas equivalente. Ultralytics incluye configuraciones integradas para NYU Depth V2, KITTI, Hypersim, SUN RGB-D y ARKitScenes, así que la mayoría de los equipos puede empezar a validar de inmediato con un banco de pruebas estándar.
Principales casos de uso de la estimación de profundidad#
Como esta nueva función puede trabajar con una única cámara convencional, la estimación monocular de profundidad abre innumerables oportunidades para productos e industrias que, de otro modo, no podrían justificar el coste, el consumo energético o la carga de calibración de un sistema estéreo o LiDAR. Veamos algunos sectores y casos de uso que pueden beneficiarse de esta función:
- Robótica y navegación autónoma. Los robots móviles y los drones pueden estimar la distancia a los obstáculos y el espacio libre a partir de una única cámara a bordo, lo que permite planificar rutas en tiempo real sin hardware de profundidad específico.
- Percepción industrial y logística. Comprobación de holguras, detección de espacio libre y análisis del contexto de estanterías o pasillos mediante una única cámara fija, en cualquier lugar donde no resulte práctico añadir un segundo sensor.
- Supervisión de la seguridad y el cumplimiento normativo. Zonas de seguridad para carretillas elevadoras y almacenes, detección de incidentes ferroviarios, detección de personas caídas y de objetos abandonados mediante sistemas CCTV existentes: se añade información de distancia a cámaras ya instaladas, junto con los sensores de seguridad certificados existentes y no en sustitución de estos.
- Inspección de infraestructuras y activos. Análisis de la distancia de seguridad respecto a líneas aéreas, inspección de activos y corrosión con drones y trabajos de levantamiento aéreo, donde una misma familia de modelos debe gestionar tanto los detalles de cerca como las escenas de largo alcance.
- Asistencia a la conducción y percepción automovilística. La salida de profundidad ilimitada y de largo alcance permite que una misma familia de modelos gestione tanto una escena interior cercana como escenas de conducción a más de 80 m.
- RA y contenido espacial. Para colocar objetos virtuales de forma creíble en una escena real o aplicar efectos que tengan en cuenta la profundidad, primero hay que saber a qué distancia de la cámara está cada píxel.
Estimación de profundidad para todos los despliegues de Ultralytics YOLO26#
Ahora que la estimación de profundidad es una tarea nativa de Ultralytics YOLO26, los equipos pueden aprovechar la distancia por píxel de cualquier cámara RGB en distintos sectores, con el mismo flujo de trabajo de entrenamiento, validación, predicción y exportación que ya conocen de la detección, la segmentación y la estimación de pose, y con una dependencia de terceros menos que mantener.
Al planificar tu despliegue con la estimación de profundidad de Ultralytics YOLO26, ten en cuenta algunos puntos clave:
- Ultralytics YOLO Depth está diseñado para cámaras RGB. Funciona con cualquier cámara estándar, incluidas cámaras web, teléfonos, cámaras industriales y drones. Sin embargo, otras modalidades, como nubes de puntos LiDAR, radar, sonar, bandas térmicas y multiespectrales, o datos de mallas e IFC, quedan fuera del formato de entrada del modelo.
- Distancia métrica para tomar decisiones de percepción. La salida es una distancia real en metros, por lo que resulta adecuada para navegación, comprobación de holguras y supervisión. Sin embargo, para cualquier aplicación que requiera una tolerancia certificada, el instrumento adecuado sigue siendo un equipo de metrología específico.
- Inferencia por imagen. La profundidad se calcula de forma independiente en cada fotograma, como en las demás tareas de Ultralytics YOLO26, por lo que se integra en un flujo de procesamiento por fotograma existente sin necesidad de cambios. El razonamiento a lo largo de una secuencia sigue correspondiendo a la capa de aplicación.
- Ultralytics YOLO26-Depth ofrece mejores resultados con superficies opacas y con textura. El vidrio, los espejos, el agua en reposo, el metal pulido y el cielo abierto son intrínsecamente ambiguos para cualquier método basado en una sola cámara, así que conviene validar el modelo con escenas representativas de tu entorno.
¿Te interesa la IA visual? Explora nuestras opciones de licencia para incorporar la visión artificial a tus proyectos. Visita nuestro repositorio de GitHub para descubrir toda la variedad de tareas e integraciones de Ultralytics y echa un vistazo a Ultralytics Platform para empezar a crear tus propios flujos de trabajo integrales de IA visual.









