5 raisons pour lesquelles les modèles de vision par ordinateur échouent en production
Découvre pourquoi les modèles de vision par ordinateur échouent en production, des écarts entre les données à la latence, et comment les équipes peuvent améliorer leurs performances dans des systèmes d’IA pour la vision en conditions réelles.
 Abirami Vina10 min de lecture
La vision par ordinateur est désormais une technologie clé de l’intelligence artificielle, adoptée dans la plupart des secteurs. Elle permet aux machines d’interpréter et d’analyser des données visuelles pour diverses tâches. Ces systèmes prennent en charge de nombreuses applications concrètes, de l’imagerie médicale et de la robotique à la fabrication et à l’automatisation du commerce de détail.
Cependant, la création d’un système de vision par ordinateur n’est pas toujours simple. Elle implique généralement le développement d’un modèle d’IA visuelle, entraîné à identifier des motifs dans des images et des vidéos afin de prendre en charge des tâches comme la détection et le suivi d’objets.
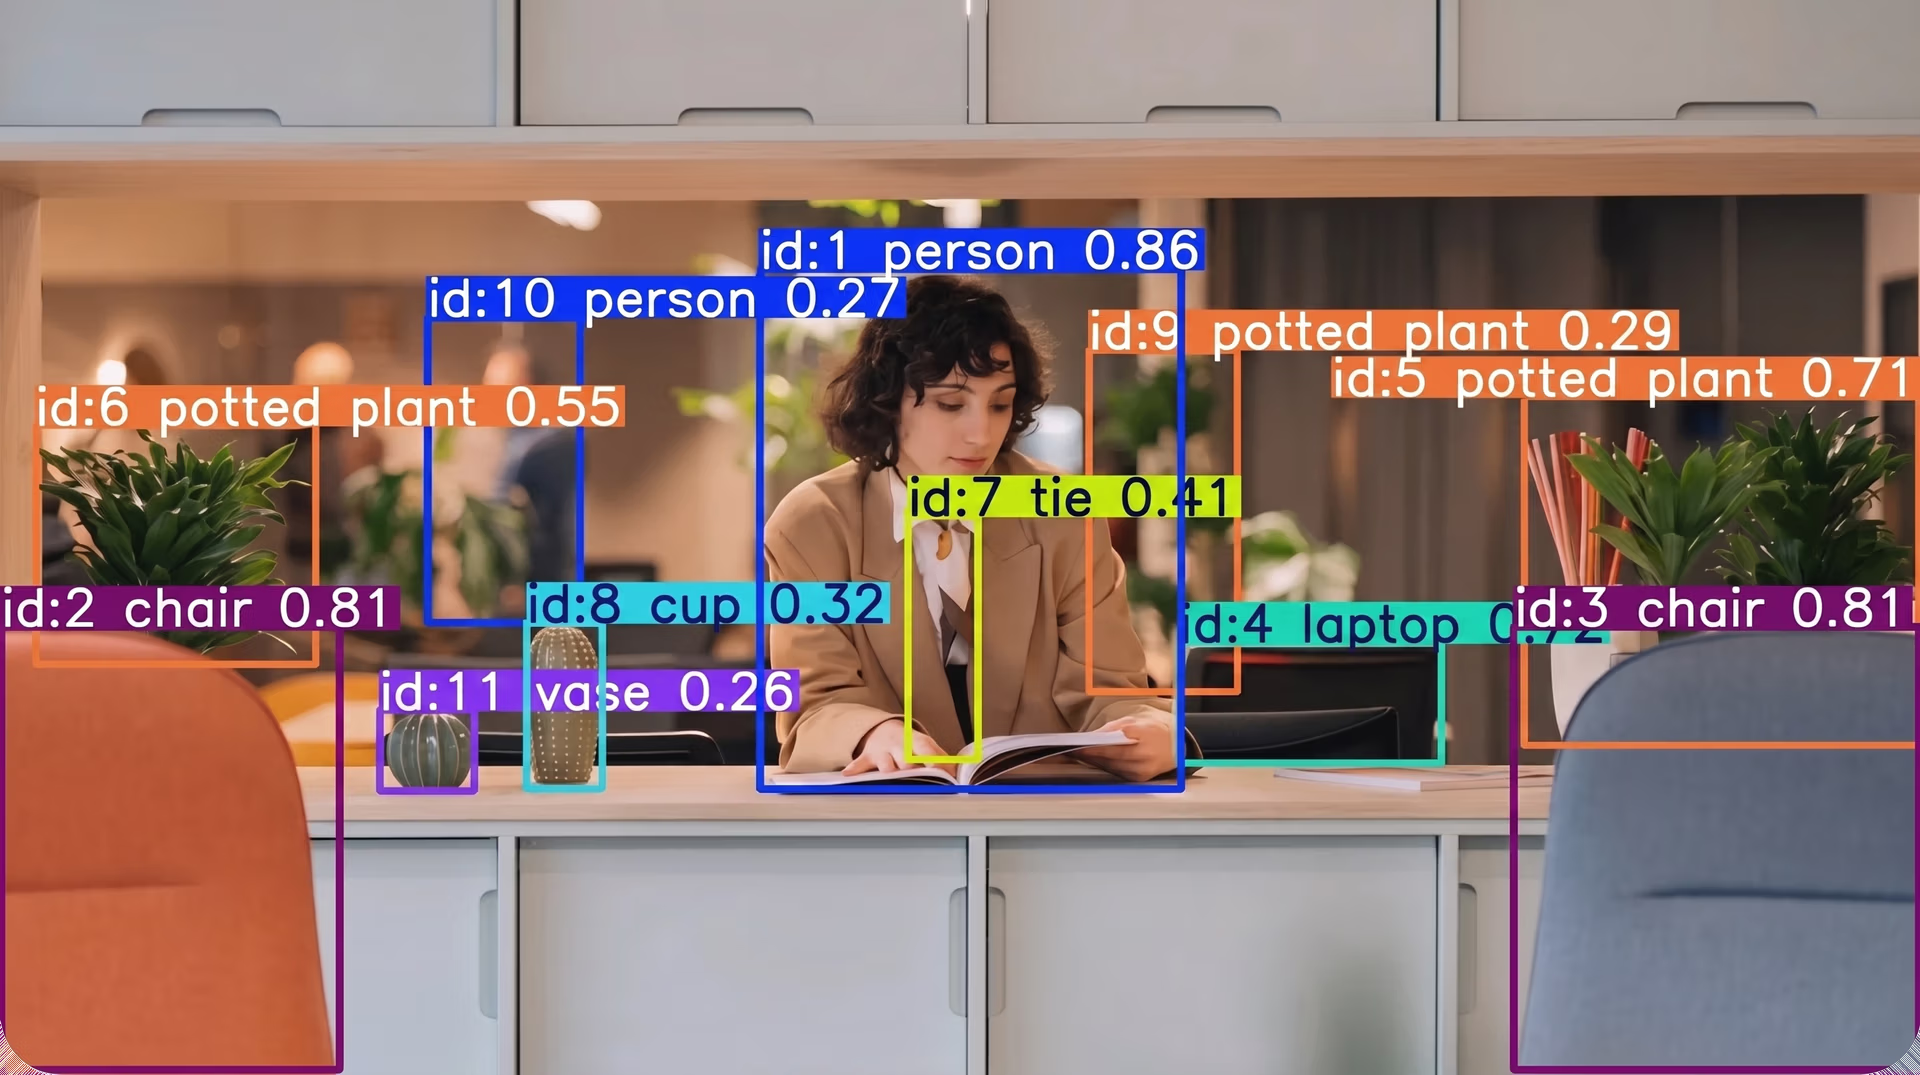
Fig. 1. Exemple de détection et de suivi d’objets (Source)
Bien qu’ils soient devenus plus avancés au fil des ans, les modèles de vision par ordinateur peuvent encore se comporter différemment pendant le développement et après leur déploiement dans des environnements réels. En effet, le déploiement de modèles en dehors de cadres de développement contrôlés entraîne de nouveaux défis, souvent inattendus.
Des facteurs comme le manque de diversité des jeux de données, une surveillance insuffisante des modèles et les contraintes d’infrastructure peuvent entraîner un comportement différent du même modèle dans le monde réel après son déploiement.
Dans cet article, nous allons examiner cinq raisons courantes pour lesquelles les modèles de vision par ordinateur peuvent ne pas être performants en production.
L’écart entre l’entraînement et la production des modèles#
L’entraînement des modèles se déroule généralement dans un environnement contrôlé. À cette étape, les développeurs en IA travaillent avec des jeux de données d’entraînement soigneusement préparés.
Ces vastes collections de données visuelles comprennent des annotations bien structurées, ou étiquettes, qui décrivent le contenu de chaque image. L’entraînement se déroule également dans des conditions cohérentes, ce qui permet aux modèles d’IA visuelle d’apprendre efficacement les motifs visuels.
Pour s’assurer que ces motifs sont appris correctement, les modèles peuvent être évalués systématiquement pendant le développement à l’aide de métriques d’évaluation standard et de jeux de données de référence. Comme les jeux de données d’entraînement, ces jeux de données de référence sont eux aussi soigneusement préparés.
Cependant, les données rencontrées par les systèmes de vision par ordinateur dans le monde réel peuvent être très différentes de celles utilisées pendant l’entraînement et l’évaluation. Une fois déployés, ces modèles fonctionnent rarement dans des conditions contrôlées.
Ils peuvent alors traiter des images et des vidéos provenant d’environnements imprévisibles, où l’éclairage change constamment, les angles de caméra varient et les arrière-plans évoluent au fil du temps. Par exemple, un modèle d’IA visuelle entraîné pour la détection du trafic peut avoir du mal à détecter les véhicules la nuit s’il a été entraîné et évalué principalement à partir d’images prises de jour.
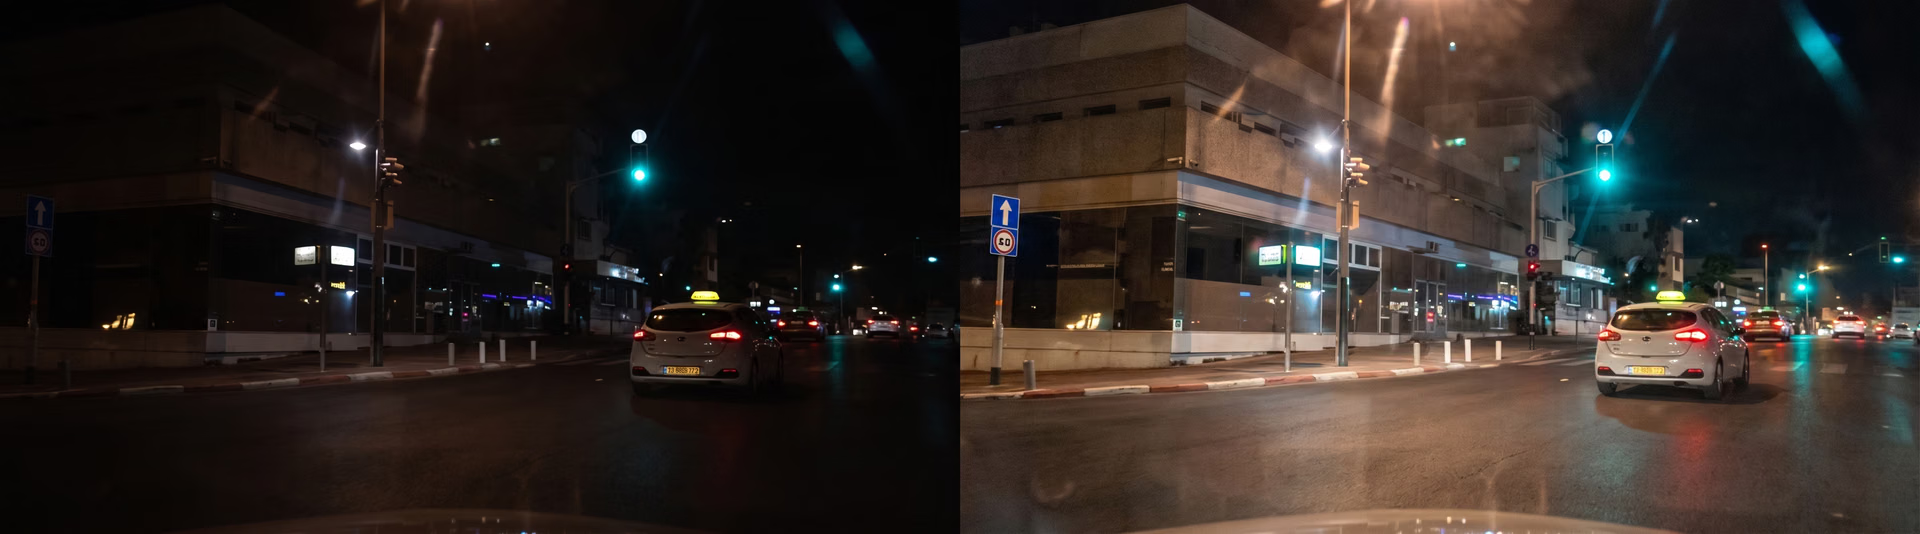
Fig. 2. Même après amélioration, les images nocturnes sont difficiles à interpréter pour les modèles entraînés sur des images prises de jour. (Source)
Cette différence entre le développement et le déploiement en conditions réelles constitue l’écart entre l’entraînement et la production. En raison de cet écart, de nombreux problèmes des modèles ne deviennent visibles qu’après leur déploiement, d’où l’importance de comprendre tôt le passage du laboratoire à la production pour créer des systèmes de vision par ordinateur plus fiables et robustes.
5 raisons courantes pour lesquelles les modèles de vision par ordinateur échouent en production#
Examinons maintenant de plus près cinq raisons courantes pour lesquelles les modèles de vision par ordinateur échouent en production.
1. Jeux de données d’entraînement de mauvaise qualité#
Les jeux de données jouent un rôle central dans l’entraînement des modèles de vision par ordinateur, car ils déterminent ce que le modèle apprend pendant l’entraînement et comment il réagit aux données du monde réel après son déploiement. C’est particulièrement important en apprentissage supervisé, où les modèles apprennent à partir d’exemples étiquetés qui indiquent ce que représente chaque image.
De nombreux modèles d’apprentissage profond, notamment les réseaux neuronaux convolutifs (CNNs), s’appuient sur ces exemples étiquetés pour reconnaître les motifs dans les données visuelles. Cependant, lorsque le jeu de données d’entraînement ne reflète pas les conditions du monde réel, le modèle peut apprendre des motifs qui ne représentent pas pleinement l’apparence des objets en dehors des données d’entraînement.
Par exemple, un modèle entraîné sur un jeu de données de grandes fissures pourrait ne pas détecter un type rare de petite fissure dans des processus de fabrication réels. De même, la qualité des annotations peut aussi influencer le comportement du modèle. Des étiquettes incohérentes ou des détails manquants dans les données étiquetées peuvent amener le modèle à apprendre des informations erronées pendant l’entraînement.
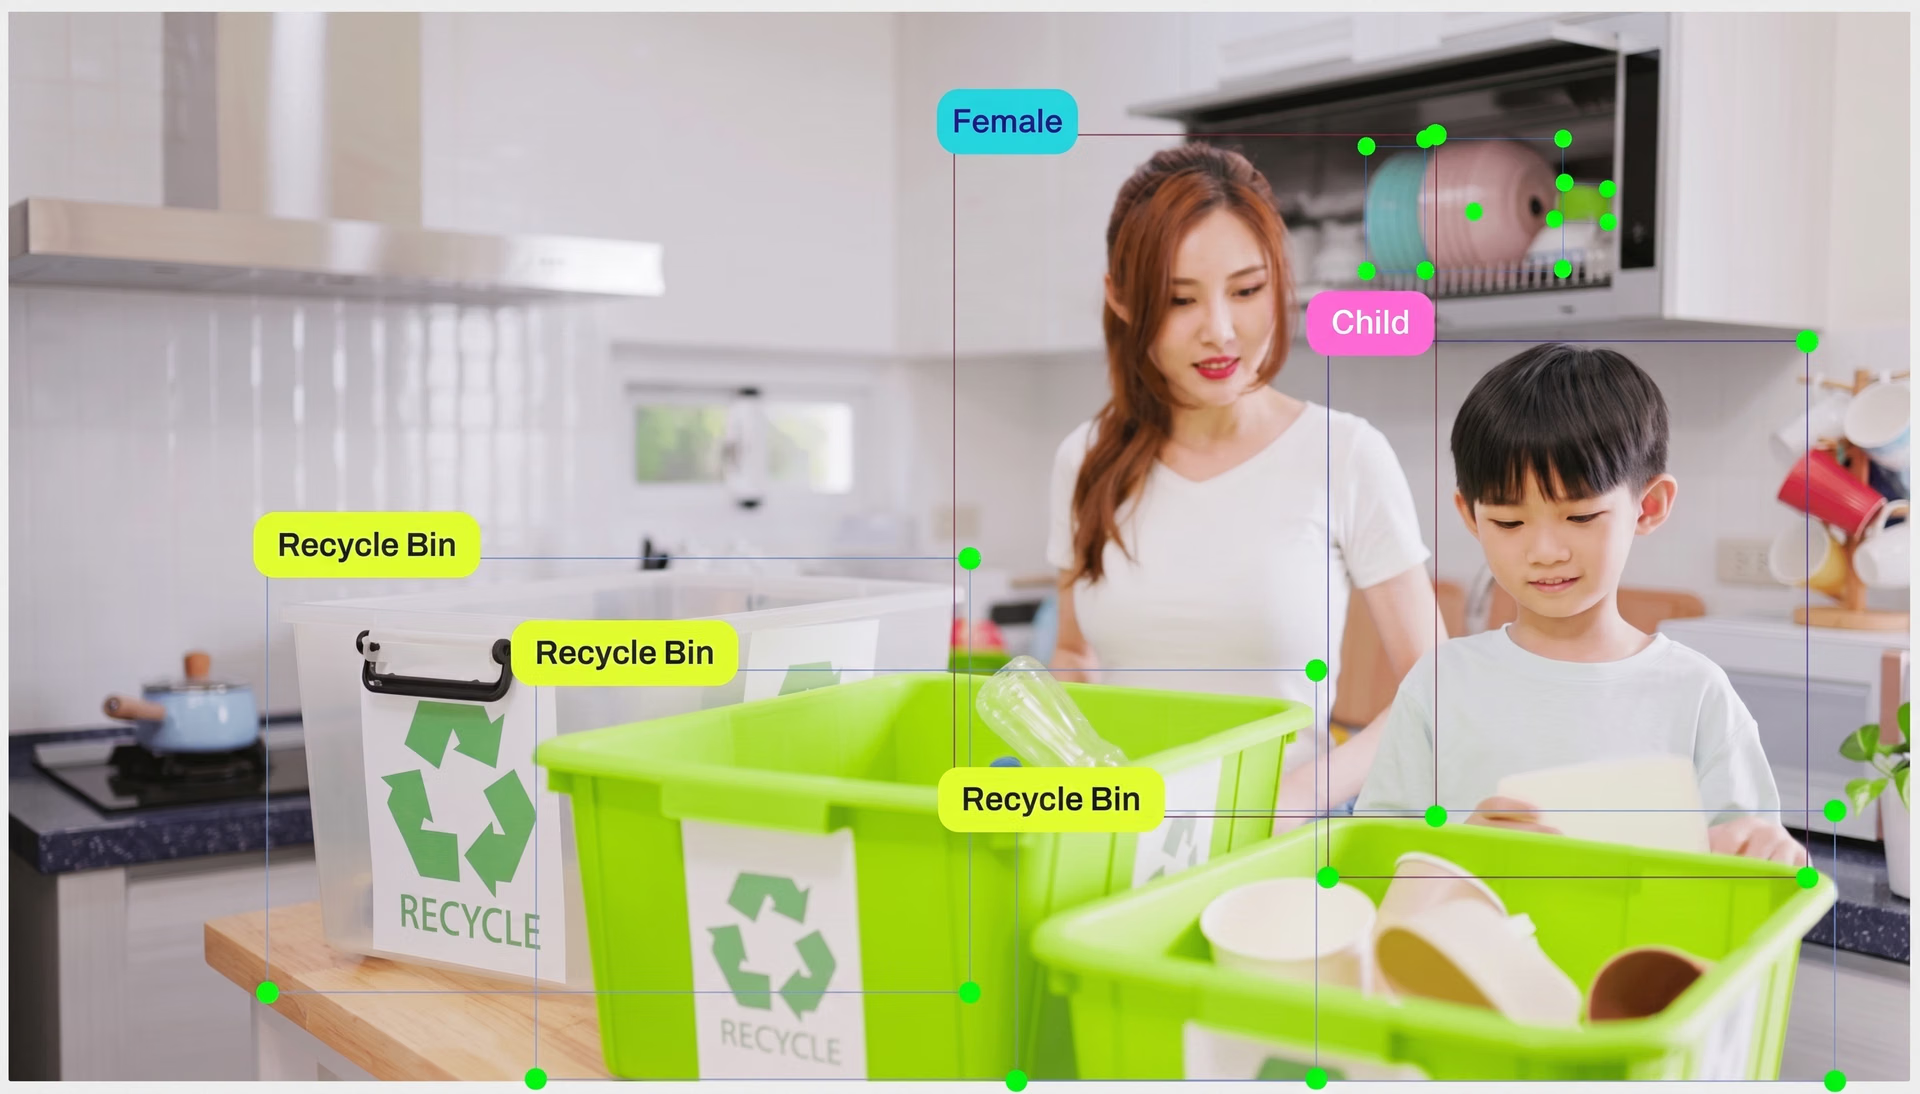
Fig. 3. Exemple d’annotations d’images (Source)
Dans l’ensemble, la qualité et la diversité des données d’entraînement sont essentielles et peuvent déterminer les performances d’un modèle dans des applications réelles. Lorsque les jeux de données sont représentatifs et correctement étiquetés, un modèle offre généralement des performances plus fiables une fois déployé.
2. Surapprentissage et généralisation#
Les modèles d’apprentissage automatique, comme les modèles de vision, apprennent des motifs à partir de jeux de données d’entraînement. Mais il arrive qu’un modèle s’appuie trop sur quelques motifs.
Au lieu d’apprendre des relations visuelles plus générales, il peut finir par mémoriser les motifs limités des données d’entraînement. Ce comportement est appelé surapprentissage.
Le surapprentissage se produit généralement lorsque les jeux de données d’entraînement sont petits ou manquent de diversité. Dans ce cas, le modèle devient performant pour reconnaître les images qu’il a déjà vues, mais a du mal à interpréter de nouvelles données ou des entrées inconnues.
Par conséquent, un modèle peut être performant sur les données de test (car elles ressemblent aux données d’entraînement), mais se comporter différemment dans de nouvelles conditions après son déploiement. C’est pourquoi la généralisation est essentielle. En termes simples, elle désigne la capacité d’un modèle à appliquer ce qu’il a appris pendant l’entraînement à de nouveaux scénarios.
Pour limiter le surapprentissage, les praticiens entraînent souvent les modèles sur des jeux de données plus variés et appliquent une augmentation des données, une méthode qui modifie légèrement les images d’entraînement afin d’accroître la diversité des données. Sans ces précautions, les performances du modèle peuvent rapidement chuter dès que le système commence à fonctionner dans des environnements réels.
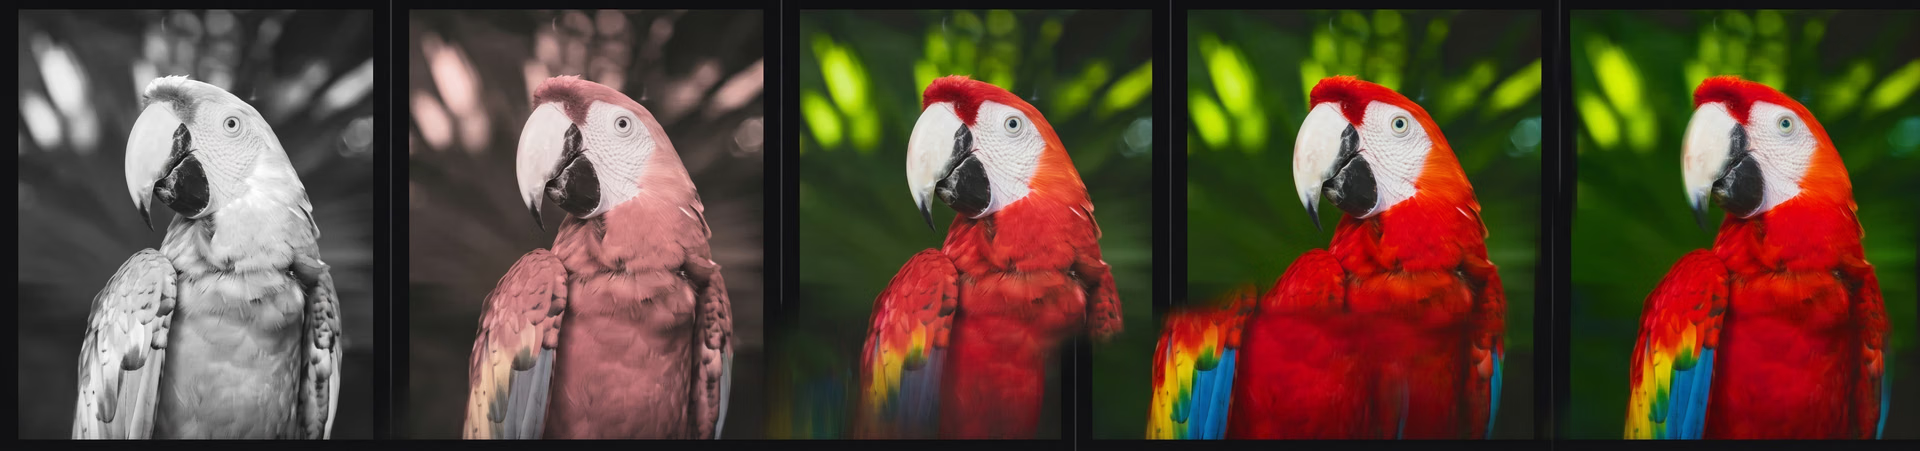
Fig. 4. L’augmentation des données peut aider à créer des variantes d’une même image dans un jeu de données. (Source)
3. Cas limites cachés dans les environnements réels#
Même lorsque les modèles de vision par ordinateur se généralisent bien à de nouvelles données, les environnements réels peuvent toujours présenter des cas limites inattendus. Il s’agit de situations inhabituelles qui diffèrent des motifs typiques appris par le modèle pendant l’entraînement.
Beaucoup de ces scénarios sont difficiles à reproduire pendant le développement, car ils se produisent rarement, sont difficiles à recréer ou peuvent coûter cher à collecter sous forme de données d’entraînement. Par exemple, les objets peuvent prendre des formes inhabituelles, se déplacer de façon imprévisible ou être partiellement masqués par d’autres objets.
Les changements d’éclairage, d’angle de caméra ou d’arrière-plan peuvent également créer des situations qui compliquent la reconnaissance. Ces cas limites ne deviennent souvent visibles qu’après le déploiement du système dans des applications réelles.
En robotique et dans l’automatisation de la fabrication, par exemple, les objets peuvent être placés ou positionnés différemment de ce qui était prévu, créant des situations que le modèle n’a pas été conçu pour gérer. Ainsi, des prédictions qui semblaient fiables pendant les tests peuvent devenir moins cohérentes lorsque le système fonctionne dans des environnements réels.
4. Manque de surveillance et de débogage après le déploiement#
Au-delà du développement d’un modèle d’IA visuelle, il est essentiel de surveiller et d’améliorer ses performances. Cependant, une fois le système en service, l’attention se porte souvent sur son maintien en fonctionnement plutôt que sur le suivi attentif de ses performances dans le temps. Les changements de comportement du modèle peuvent alors passer inaperçus.
Parallèlement, des facteurs comme les changements dans les données entrantes, les configurations des caméras ou les environnements opérationnels peuvent progressivement affecter la précision avec laquelle le modèle détecte ou classe les objets. Ces changements ne sont pas toujours évidents et peuvent passer inaperçus pendant l’exploitation quotidienne.
La surveillance des sorties du modèle et du comportement global du système peut aider les équipes à repérer ces problèmes plus tôt. Des vérifications régulières, des routines de validation et des processus de débogage permettent aux équipes d’examiner les résultats inhabituels et de comprendre ce qui peut en être la cause.
Dans des domaines comme la fabrication, un modèle peut soudainement mal identifier des objets sur une chaîne de montage après une modification de la configuration des caméras. Le suivi du comportement d’un système d’IA visuelle déployé facilite la réaction à ces changements et permet de maintenir des performances stables dans des environnements réels.
5. Contraintes d’infrastructure et latence#
De nombreux systèmes de vision par ordinateur doivent fonctionner en temps réel, ce qui peut exercer une forte pression sur le matériel, les réseaux et les chaînes de traitement. Lorsque les ressources sont limitées, des retards de calcul ou une latence réseau peuvent survenir, ralentir l’arrivée des prédictions et nuire aux performances globales du système.
Dans certains cas, les modèles avancés d’apprentissage profond peuvent également poser des défis d’infrastructure. Par exemple, les architectures fondées sur des Transformers sont conçues pour traiter de grandes quantités de données visuelles et apprendre des relations complexes au sein des images, mais elles nécessitent souvent d’importantes ressources de calcul. Leur exécution peut exiger un matériel plus puissant ou plus coûteux.
Sans optimisation appropriée, même les modèles qui s’exécutent rapidement pendant les tests peuvent ralentir ou se comporter de manière incohérente après leur déploiement. Pour remédier à cela, les équipes optimisent souvent les chaînes de traitement, réduisent autant que possible la complexité des modèles et trouvent un équilibre entre précision et vitesse.
Cela peut consister à compresser de grands modèles pour en créer des versions plus légères, à utiliser des architectures plus efficaces ou à traiter les images à une résolution plus faible afin que le système fonctionne correctement sur le matériel disponible. Dans bien des cas, les équipes choisissent également des modèles légers et plus rapides comme Ultralytics YOLO26 pour respecter les contraintes de déploiement.
Bonnes pratiques pour prévenir les défaillances des modèles de vision par ordinateur#
Voici quelques bonnes pratiques qui peuvent contribuer à réduire les défaillances lors du déploiement de modèles de vision par ordinateur en production :
- Utilise des stratégies de déploiement progressif : introduis progressivement les modèles en production afin que les équipes puissent observer leur comportement et apporter des ajustements si nécessaire.
- Intègre des boucles de rétroaction : collecte de nouvelles images et examine les prédictions incorrectes afin de réentraîner les modèles avec des jeux de données actualisés et d’améliorer leurs performances au fil du temps.
- Documente les limites des modèles : consigne clairement les situations dans lesquelles le modèle peut rencontrer des difficultés afin que les équipes puissent anticiper les problèmes éventuels lors du déploiement.
- Anticiper la variabilité du monde réel : Prévoir les variations d’éclairage, d’angle de caméra, de position des objets ou de conditions d’arrière-plan peut aider les modèles à rester stables dans différents scénarios opérationnels.
Points clés à retenir#
Les modèles de vision par ordinateur échouent rarement parce que leurs algorithmes sont faibles. Dans la plupart des cas, le véritable défi vient des environnements dans lesquels ces systèmes fonctionnent. Les modèles qui obtiennent de bons résultats pendant l’entraînement sont souvent confrontés à des conditions imprévisibles dans le monde réel, susceptibles d’influencer leur comportement.
C’est pourquoi la création de systèmes d’IA visuelle fiables ne se limite pas à l’entraînement d’un modèle. Elle consiste également à préparer soigneusement les jeux de données, à surveiller les performances du modèle après son déploiement et à adapter continuellement les systèmes aux conditions du monde réel.
Tu souhaites approfondir l’IA visuelle ? Rejoins notre communauté et découvre des applications comme l’IA dans l’automobile et la vision par ordinateur dans la logistique. Consulte nos options de licence pour démarrer tes projets de vision par ordinateur. Visite notre dépôt GitHub pour en savoir plus.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









