Points de terminaison d’inférence dédiés ou inférence partagée pour le déploiement
Découvre quand choisir des points de terminaison d’inférence dédiés sur Ultralytics Platform pour un déploiement évolutif et à faible latence de l’IA pour la vision, plutôt que l’inférence partagée.
Nous avons récemment lancé Ultralytics Platform, une solution de bout en bout qui rassemble l’ensemble du workflow de vision par ordinateur au même endroit, de la préparation des jeux de données et de l’entraînement des modèles à l’inférence, au déploiement et au suivi.
Conçue à partir des retours de la communauté de la vision par ordinateur, la plateforme vise à simplifier chaque étape du développement en proposant des fonctionnalités intégrées qui prennent en charge tout le cycle de vie des applications d’IA pour la vision.
Par exemple, une fois qu’un modèle est entraîné, l’étape suivante consiste à le déployer pour pouvoir l’utiliser afin d’exécuter l’inférence et de produire des prédictions dans des applications concrètes. La plateforme simplifie ce processus en proposant plusieurs options de déploiement.
Tu peux exporter les modèles pour les exécuter dans ton propre environnement, utiliser l’inférence partagée pour effectuer rapidement des tests ou déployer des points de terminaison dédiés pour des applications évolutives prêtes pour la production. Chacune de ces options de déploiement te permet d’exécuter l’inférence IA, mais elles sont conçues pour différentes étapes et différents cas d’usage.
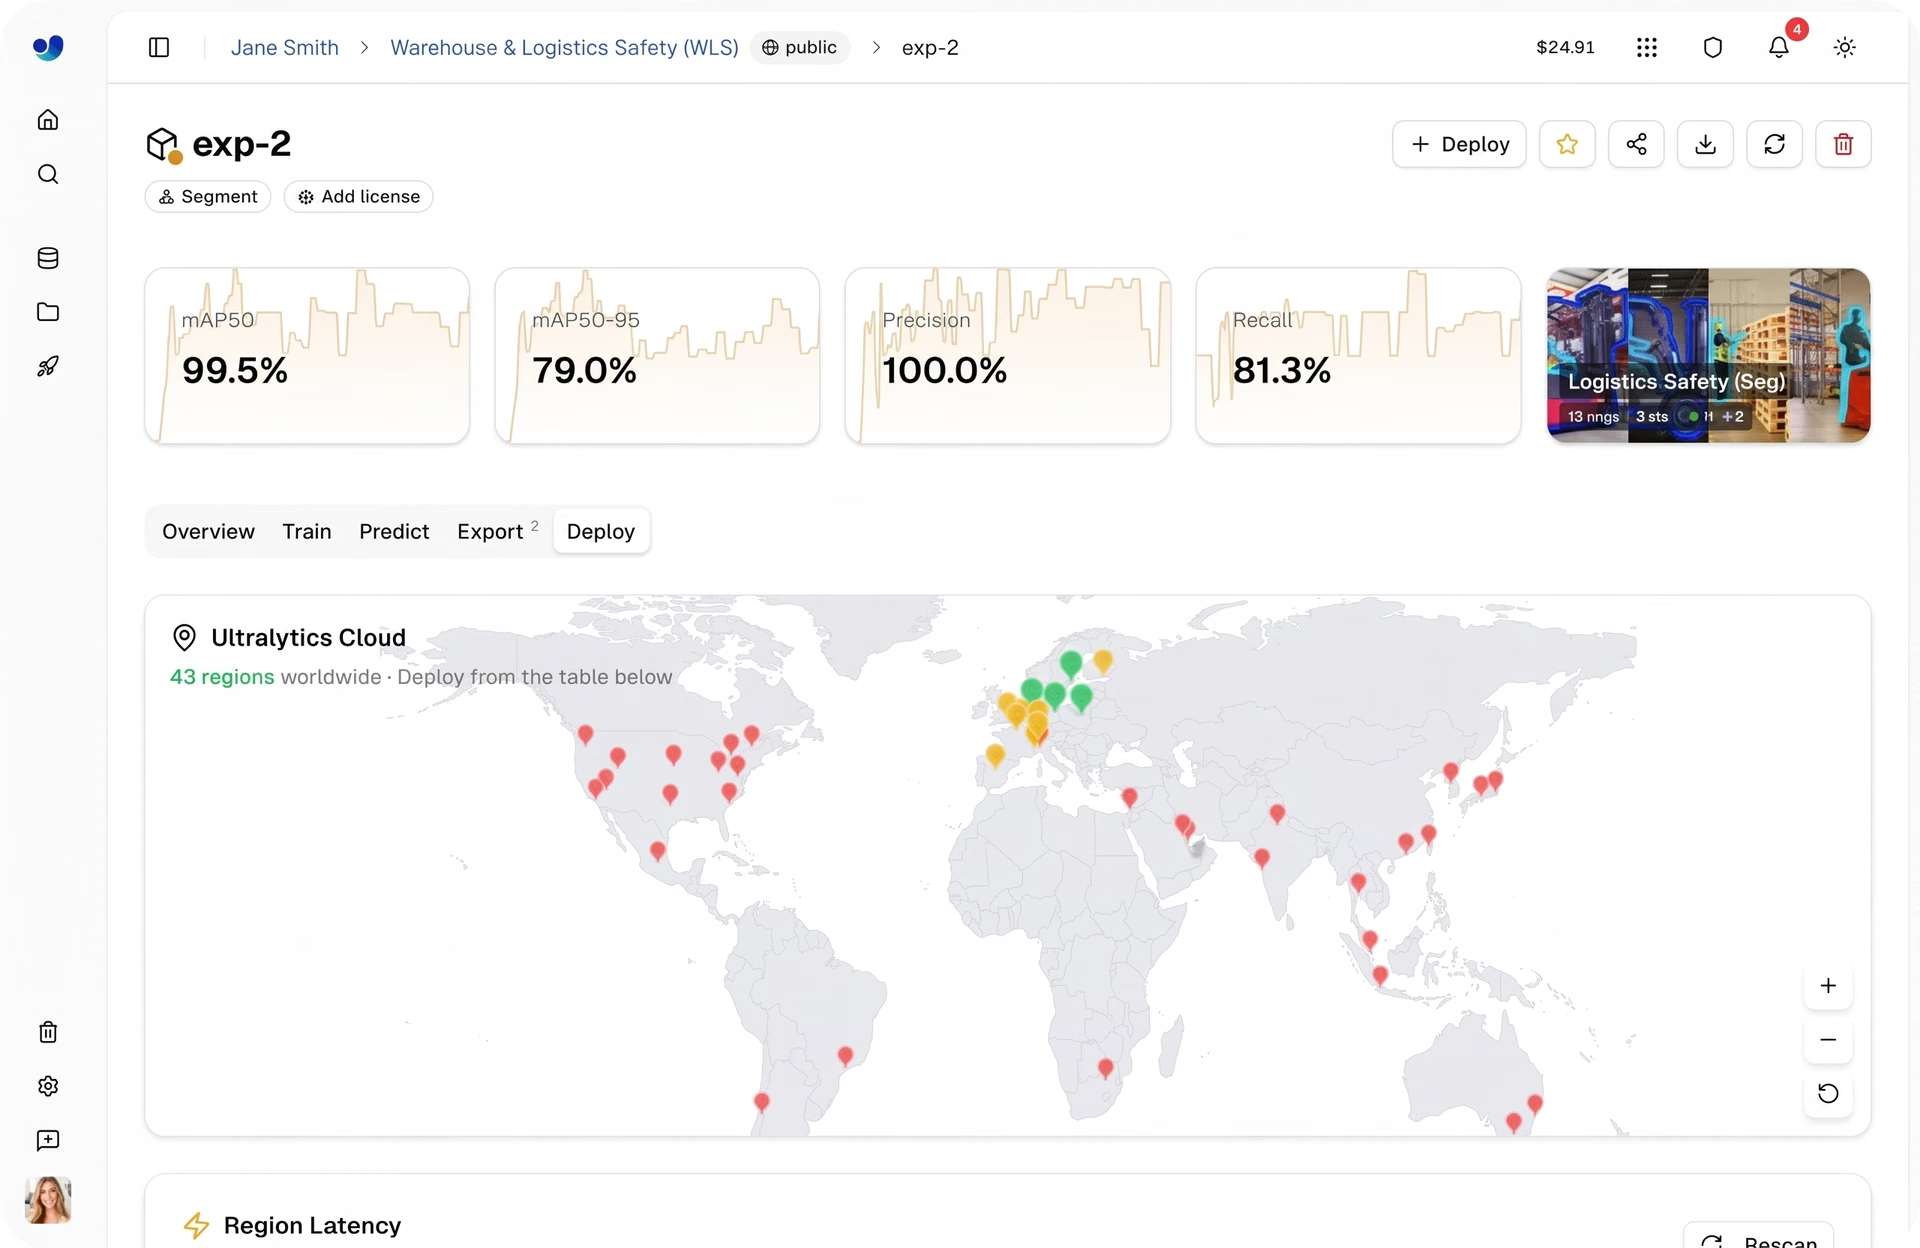
Fig. 1. Ultralytics Platform permet le déploiement évolutif de modèles d’IA pour la vision à l’échelle mondiale (Source)
L’exportation de modèles te donne un contrôle total pour les exécuter sur ta propre infrastructure, l’inférence partagée simplifie les tests et les expérimentations sans configuration, et les points de terminaison dédiés sont conçus pour des charges de travail de production fiables et à grande échelle.
À première vue, l’inférence partagée et les points de terminaison dédiés peuvent sembler assez similaires. Les deux te permettent d’envoyer des requêtes API à ton modèle et de recevoir des prédictions structurées, ce qui facilite l’intégration de l’IA pour la vision dans les applications.
Cependant, à mesure que tes charges de travail augmentent et que tes applications de vision par ordinateur commencent à traiter des requêtes d’inférence en temps réel, les différences entre ces options deviennent plus importantes. Dans cet article, nous examinerons de plus près l’inférence partagée et les points de terminaison dédiés, leurs différences, les situations où utiliser chacune de ces options et les raisons pour lesquelles les points de terminaison dédiés deviennent le meilleur choix à mesure que tes applications passent à l’échelle supérieure.
Présentation du déploiement avec l’inférence partagée#
L’inférence partagée est un moyen simple d’exécuter l’inférence IA sur tes modèles sans configurer d’infrastructure ni te soucier des types de GPU, de l’intégration aux frameworks ou de la configuration de l’environnement d’exécution. Une fois ton modèle entraîné ou affiné, tu peux l’utiliser pour générer des prédictions directement sur la plateforme.
Dans cette configuration, ton modèle s’exécute sur des ressources de calcul partagées entre plusieurs locataires, dans quelques régions principales comme les États-Unis, l’Europe et l’Asie-Pacifique. Les requêtes sont automatiquement acheminées vers les services disponibles : tu n’as donc pas besoin de configurer des instances GPU ou des environnements d’exécution. Tout est pris en charge pour toi, ce qui facilite la prise en main.
Lorsque tu utilises l’inférence partagée, tu envoies des requêtes à ton modèle via une REST API à l’aide d’outils comme Python ou la CLI, et tu reçois des sorties JSON structurées, telles que les objets détectés, les scores de confiance et d’autres détails sur les prédictions. Tu peux ainsi tester facilement les modèles et les intégrer dans des applications.
Comme le système est partagé, il est conçu pour le développement, les tests et une utilisation légère. Il convient bien à la validation des prédictions et à la création des premières intégrations. En revanche, les performances peuvent varier selon la charge du système, et l’utilisation est limitée à 20 requêtes par minute et par clé API, ce qui rend cette solution moins adaptée aux charges de travail de production à haut débit.
Dans l’ensemble, l’inférence partagée convient surtout au développement en phase initiale, lorsque l’objectif est de comprendre et d’améliorer ton modèle avant de passer à des applications de plus grande envergure.
Déploie des modèles à l’échelle mondiale avec des points de terminaison dédiés#
Les points de terminaison dédiés sont des services d’inférence à locataire unique où tes modèles d’IA pour la vision s’exécutent sur des ressources de calcul isolées. Au lieu de partager l’infrastructure, chaque point de terminaison dispose de son propre environnement d’exécution et de ressources configurables, comme le CPU et la mémoire, ce qui te donne davantage de contrôle sur les performances.
Lorsque tu déploies un modèle sur un point de terminaison dédié, celui-ci reçoit une URL API unique et utilise ta clé API pour l’authentification, ce qui facilite son intégration aux applications. Ces points de terminaison peuvent être déployés dans 43 régions du monde, ce qui te permet d’exécuter l’inférence plus près de tes utilisateurs et de réduire la latence.
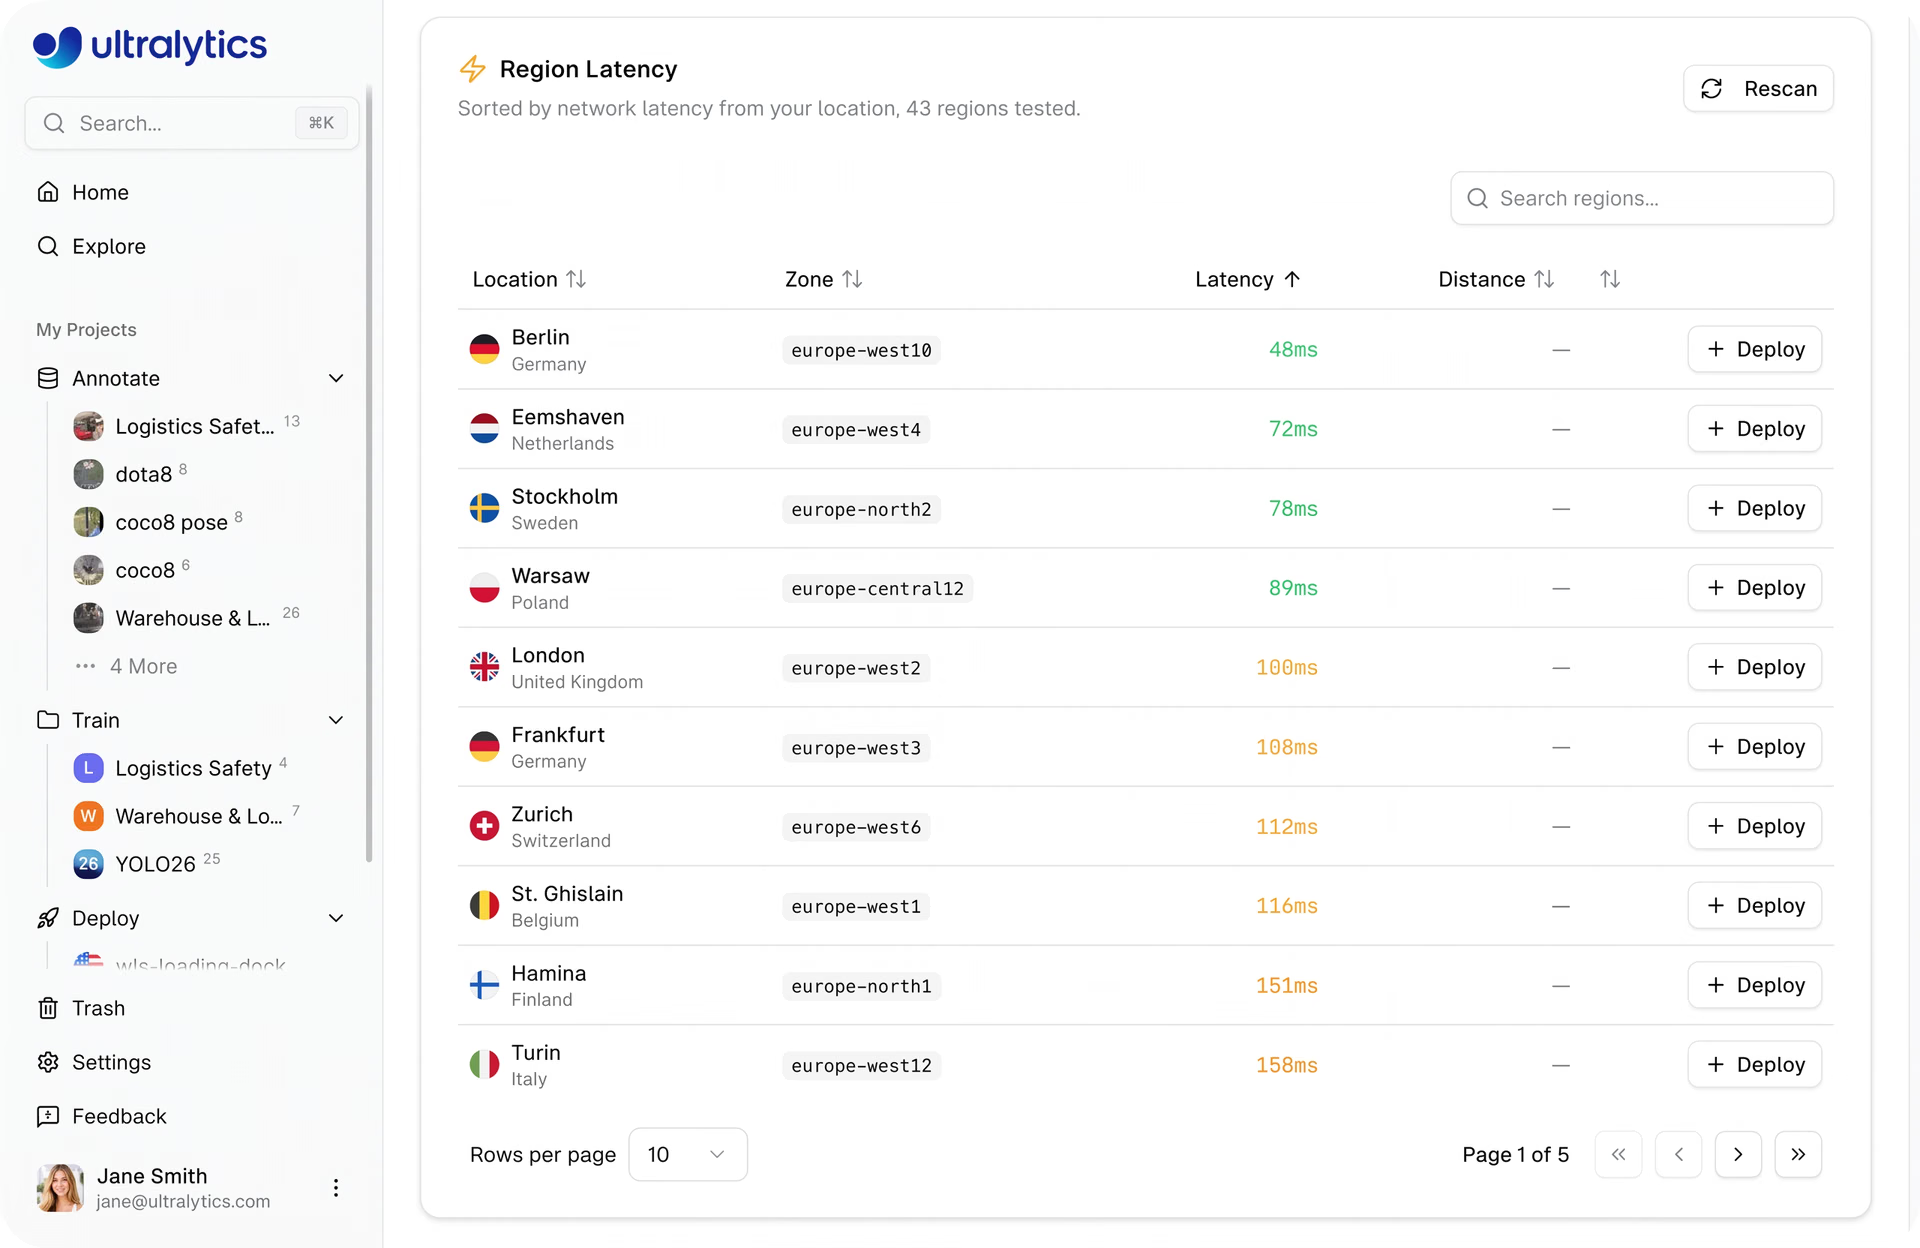
Fig. 2. Tu peux déployer des points de terminaison dédiés dans 43 régions du monde (Source)
La mise à l’échelle automatique est l’un des principaux avantages. Les points de terminaison s’adaptent automatiquement aux requêtes entrantes, en augmentant leur capacité pour gérer un trafic plus important et en la réduisant lorsque la demande baisse. Comme la mise à l’échelle à zéro est activée par défaut, les points de terminaison peuvent s’arrêter lorsqu’ils sont inactifs et redémarrer en cas de besoin, ce qui contribue à optimiser l’utilisation des ressources.
En d’autres termes, les points de terminaison dédiés sont conçus pour les charges de travail de production. Par rapport à l’inférence partagée, ils offrent une latence faible et constante, un débit supérieur et une meilleure fiabilité.
De plus, les points de terminaison dédiés n’ont pas de limites de débit. Les requêtes sont envoyées directement à ton point de terminaison : le trafic que tu peux gérer dépend donc de ta configuration et de la mise à l’échelle, et non de limites fixes.
En outre, le suivi, les journaux et les vérifications d’état intégrés, ainsi que le comportement prévisible de l’environnement d’exécution et du démarrage, facilitent le suivi des performances et le maintien de déploiements stables dans toutes les offres. Avec l’offre Free, les démarrages à froid prennent généralement entre 5 et 45 secondes, tandis que les points de terminaison de l’offre Pro restent actifs, ce qui permet une inférence plus rapide et plus prévisible.
En bref, les points de terminaison dédiés sont idéaux pour les applications d’IA pour la vision en temps réel qui nécessitent une inférence fiable, évolutive et performante.
Inférence partagée et points de terminaison dédiés : principales différences#
Voici une comparaison plus détaillée de l’inférence partagée et des points de terminaison dédiés :
- Latence : dans les environnements partagés, la latence peut varier en raison du partage des ressources, tandis que les points de terminaison dédiés offrent des réponses plus constantes et à faible latence.
- Régions : l’inférence partagée est disponible dans quelques régions (États-Unis, UE, Asie-Pacifique), tandis que les points de terminaison dédiés peuvent être déployés dans 43 régions du monde.
- Évolutivité : la mise à l’échelle n’est pas configurable avec l’inférence partagée, tandis que les points de terminaison dédiés s’adaptent automatiquement au trafic entrant.
- Limites de débit : l’inférence partagée est limitée à 20 requêtes ou appels API par minute et par clé API, tandis que les points de terminaison dédiés ne sont soumis à aucune limite de débit imposée par la plateforme.
- Tarification : l’inférence partagée est incluse sans frais supplémentaires pour les tests et le développement, tandis que les points de terminaison dédiés offrent davantage de contrôle et d’évolutivité, leur coût dépendant de la configuration des ressources et des besoins de déploiement.
Pourquoi les points de terminaison dédiés conviennent mieux aux charges de travail de production#
À mesure que les applications d’IA et d’apprentissage automatique passent des tests à une utilisation concrète, les performances, l’évolutivité et la fiabilité deviennent essentielles. C’est pourquoi les points de terminaison dédiés offrent des avantages évidents par rapport à l’inférence partagée.
Avec les points de terminaison dédiés, ton modèle préentraîné ou personnalisé s’exécute sur ses propres ressources de calcul, de sorte que ses performances ne sont pas affectées par les autres utilisateurs. Cela contribue à maintenir une latence faible et constante, ce qui est important pour les applications en temps réel comme l’analyse vidéo et les systèmes de surveillance.
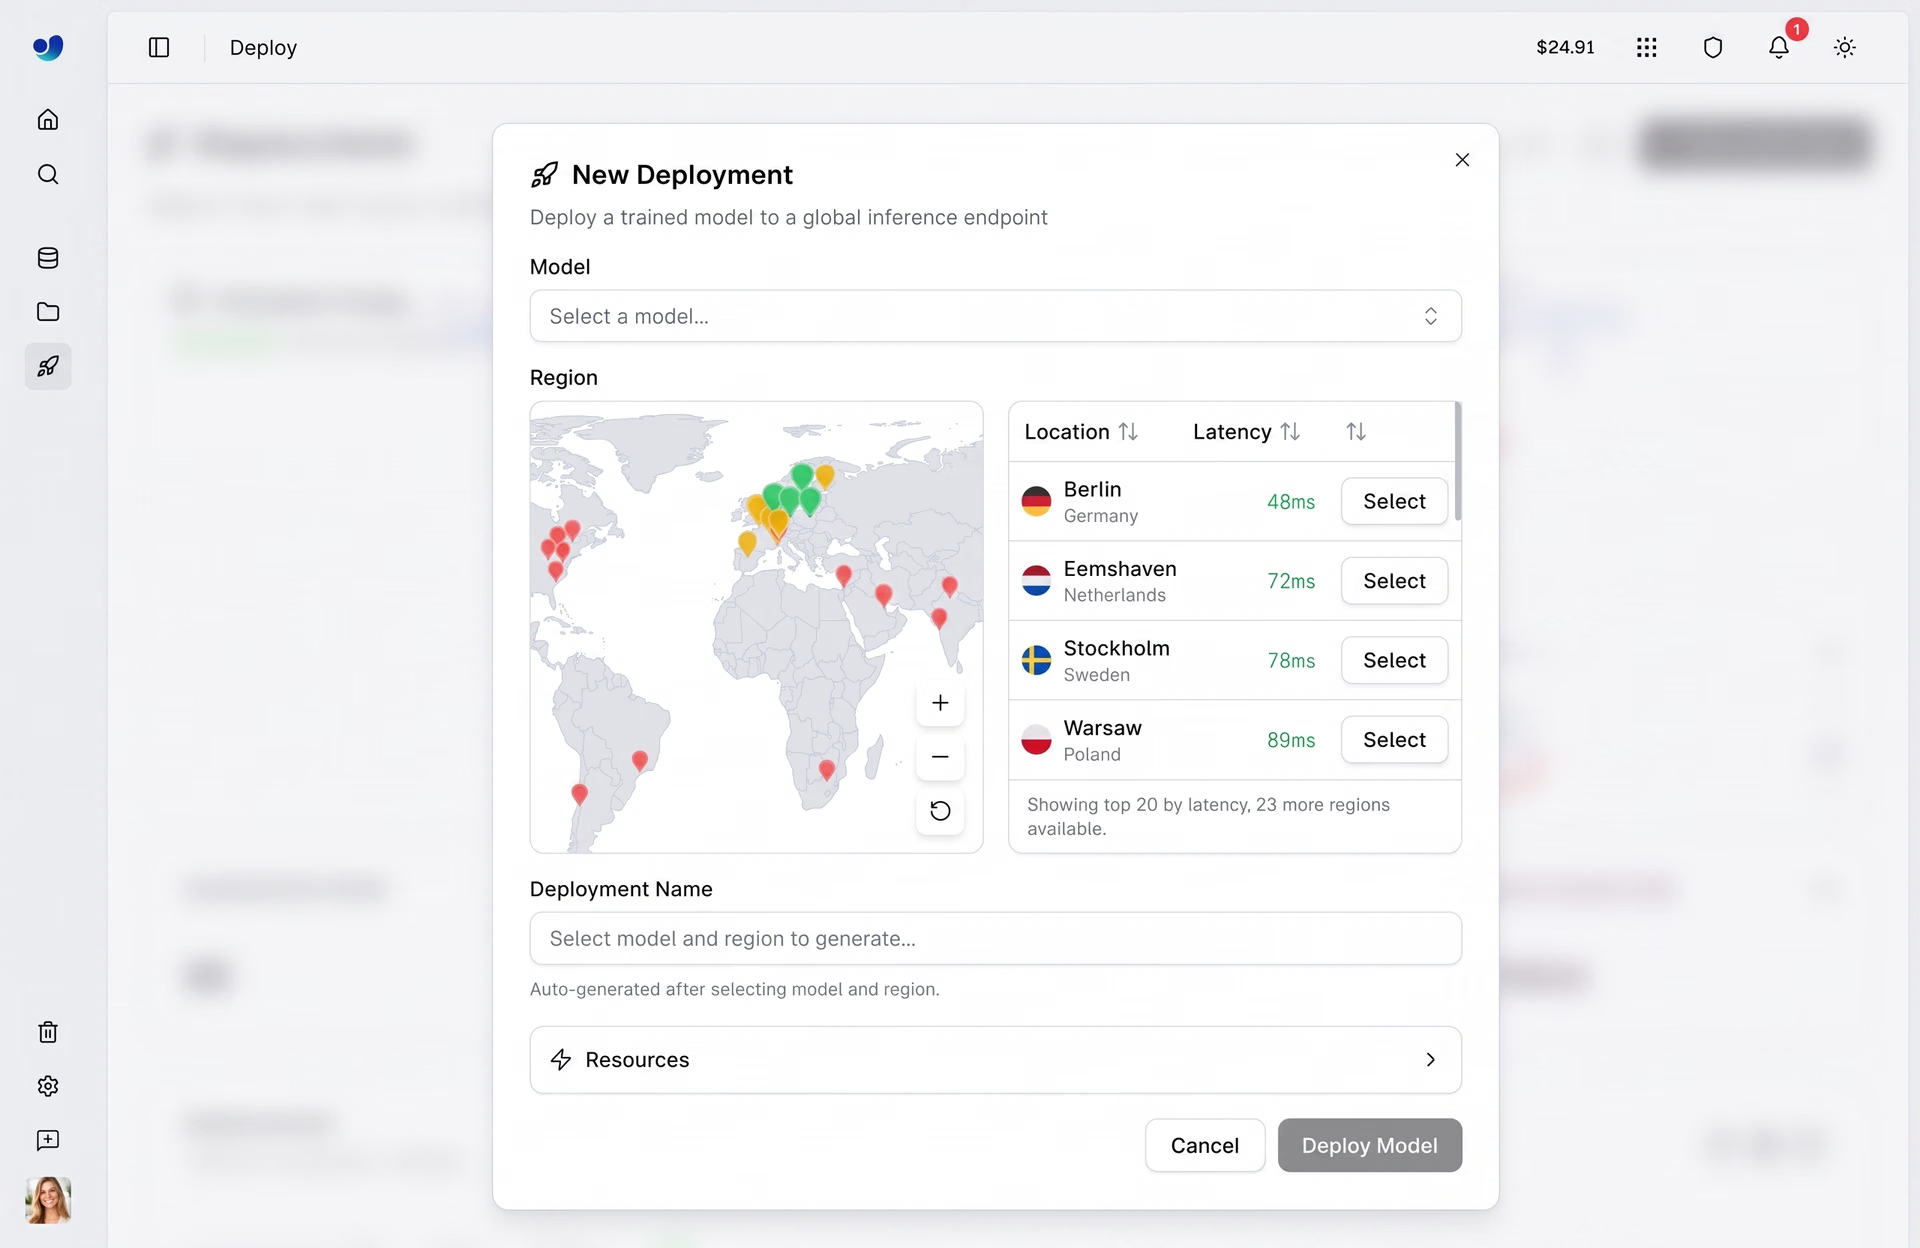
Fig. 3. Aperçu du déploiement à l’aide d’un point de terminaison d’inférence dédié (Source)
Par exemple, imagine un système d’analyse du commerce de détail qui traite les flux vidéo en direct de caméras installées dans plusieurs magasins. En déployant des points de terminaison dans 43 régions du monde, l’inférence peut s’exécuter plus près de chaque magasin, réduisant ainsi la latence et améliorant les temps de réponse.
Avec l’inférence partagée, où les ressources sont mutualisées et les régions limitées, les performances peuvent varier pendant les périodes de forte activité.
Les points de terminaison dédiés peuvent également gérer un trafic plus important et s’adapter automatiquement à la demande. Grâce au suivi, aux journaux et aux vérifications d’état intégrés, ils offrent des performances plus prévisibles et conviennent donc bien aux charges de travail d’IA continues et à grande échelle.
Quelle place occupe l’inférence partagée dans le workflow d’IA pour la vision ?#
En examinant les différences entre l’inférence partagée et les points de terminaison dédiés, tu te demandes peut-être quelle place occupe l’inférence partagée dans le workflow global de vision par ordinateur.
Reprenons l’exemple de l’analyse du commerce de détail. Avant de déployer une solution de vision dans plusieurs magasins, les équipes doivent généralement tester ses performances sur des données réelles et l’affiner en fonction des résultats.
L’inférence partagée simplifie ce processus : tu peux envoyer des images échantillons ou des images vidéo extraites des caméras des magasins, puis examiner rapidement les prédictions sans configurer d’infrastructure. Cette méthode est particulièrement utile pour tester le comportement du modèle, déboguer les prédictions incorrectes et valider les résultats dans différentes conditions, par exemple lorsque l’éclairage ou l’agencement des magasins change.
En procédant par itérations de cette manière, les équipes peuvent améliorer la précision et la fiabilité du modèle avant son passage en production. Lorsque le modèle donne de bons résultats dans ces scénarios de test, il peut ensuite être déployé sur des points de terminaison dédiés pour une utilisation en temps réel dans plusieurs sites.
L’inférence partagée peut également convenir aux applications utilisées rarement ou à faible volume. Par exemple, un petit magasin peut l’utiliser pour analyser occasionnellement la fréquentation ou examiner l’activité des clients à certains moments, sans avoir besoin d’un déploiement complet à grande échelle. Dans ces cas, elle offre un moyen simple et économique d’exécuter l’inférence à la demande.
Cas d’usage concrets des points de terminaison dédiés#
À mesure que les applications d’IA dépassent le stade des tests, le choix du déploiement commence à influer directement sur les performances, l’évolutivité et l’expérience utilisateur. Les points de terminaison dédiés peuvent être largement utilisés dans de nombreux secteurs, car ils offrent des performances stables, une faible latence et la capacité de gérer des charges de travail à grande échelle.
Voici quelques cas d’usage courants qui montrent comment les points de terminaison dédiés peuvent être utilisés dans des applications concrètes :
- Commerce de détail et analyse vidéo : une chaîne de magasins peut utiliser la vision par ordinateur pour suivre les déplacements des clients, repérer les produits populaires et surveiller l’activité des magasins en temps réel. Les points de terminaison dédiés garantissent une inférence rapide et constante dans plusieurs magasins, même aux heures de pointe.
- Industrie manufacturière et contrôle qualité : sur une chaîne de production, les modèles peuvent détecter les défauts ou les anomalies au fur et à mesure que les produits avancent dans le système. Les points de terminaison dédiés prennent en charge une inférence continue en temps réel, ce qui aide les équipes à repérer rapidement les problèmes et à maintenir la qualité des produits sans ralentir les opérations.
- Santé et imagerie médicale : les professionnels de santé et les laboratoires de diagnostic peuvent s’appuyer sur des modèles de vision pour analyser des images médicales comme des radiographies ou des scans. Les points de terminaison dédiés offrent des performances fiables et constantes, ce qui est essentiel pour traiter des données sensibles et établir des diagnostics urgents.
- Automatisation des entrepôts et de la logistique : les grands entrepôts exploitent souvent plusieurs systèmes identiques, comme des tapis roulants et des lignes de tri, qui sont autant de répliques d’une même configuration. Les modèles de vision par ordinateur peuvent surveiller chaque réplique pour détecter des problèmes comme les bourrages ou les colis mal acheminés. Les points de terminaison dédiés garantissent une inférence constante en temps réel sur toutes les répliques.
Passer de l’inférence partagée aux points de terminaison dédiés#
L’un des principaux avantages d’Ultralytics Platform est la simplicité avec laquelle tu peux passer de l’inférence partagée aux points de terminaison dédiés à mesure que ton application se développe. Au lieu de changer d’outils ou de reconstruire ta configuration, tu peux passer à un déploiement prêt pour la production dans le même environnement.
Après avoir testé ton modèle avec l’inférence partagée, passer à un point de terminaison dédié est une étape suivante simple. Tu peux déployer le même modèle sur un point de terminaison, choisir ta région et tes ressources de calcul, puis mettre à jour l’URL du point de terminaison dans ton application. L’intégration globale reste similaire : tu n’as donc que peu, voire aucun changement à apporter à la façon dont tu envoies les requêtes ou traites les réponses.
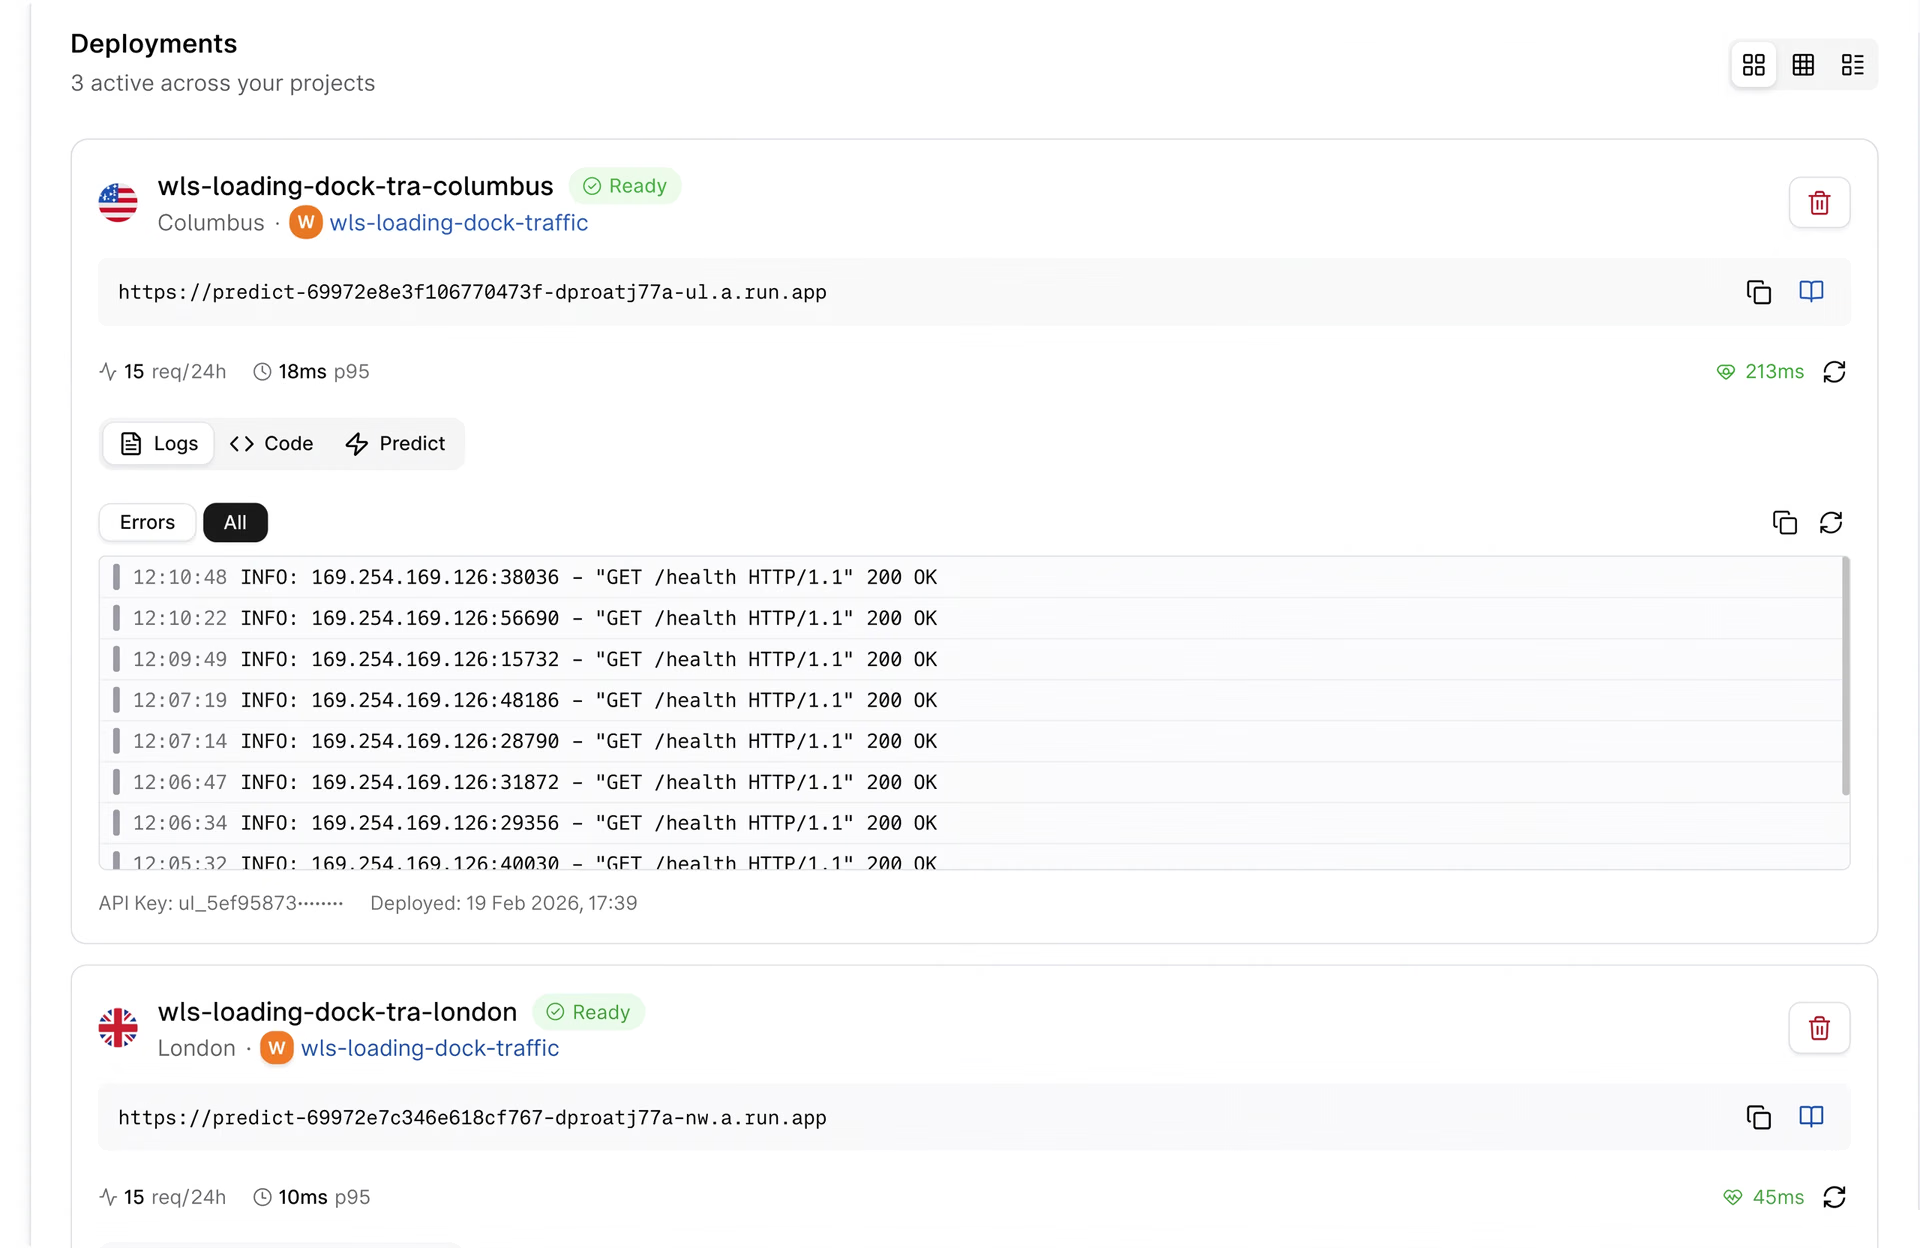
Fig. 4. Consultation de l’URL d’un point de terminaison dédié sur Ultralytics Platform (Source)
Tu peux ainsi passer des tests à la production en quelques clics. À mesure que ta charge de travail augmente ou que ton application exige des performances plus constantes, tu peux passer aux points de terminaison dédiés sans perturber ton workflow existant.
Pour en savoir plus sur le déploiement de modèles à l’aide de points de terminaison dédiés sur Ultralytics Platform, consulte la documentation officielle d’Ultralytics Platform.
Points clés à retenir#
L’inférence partagée est un excellent point de départ pour les tests et l’expérimentation, mais les charges de travail de production exigent plus de constance et d’évolutivité. À mesure que les applications se développent, les points de terminaison dédiés offrent les performances et la fiabilité nécessaires à une utilisation concrète. Ils constituent donc le meilleur choix pour la plupart des déploiements de production.
Rejoins notre communauté et découvre notre dépôt GitHub pour en savoir plus sur les modèles de vision par ordinateur. Lis nos pages de solutions consacrées à des applications comme l’IA dans l’agriculture et la vision par ordinateur en robotique. Consulte nos options de licence et lance-toi dans l’IA pour la vision.








