Gestion intelligente des jeux de données en vision par ordinateur avec Ultralytics Platform
Découvre comment utiliser Ultralytics Platform pour mieux gérer les jeux de données dans tes projets de vision par ordinateur. Suis, compare et améliore tes jeux de données facilement.
 Abirami Vina19 min de lecture
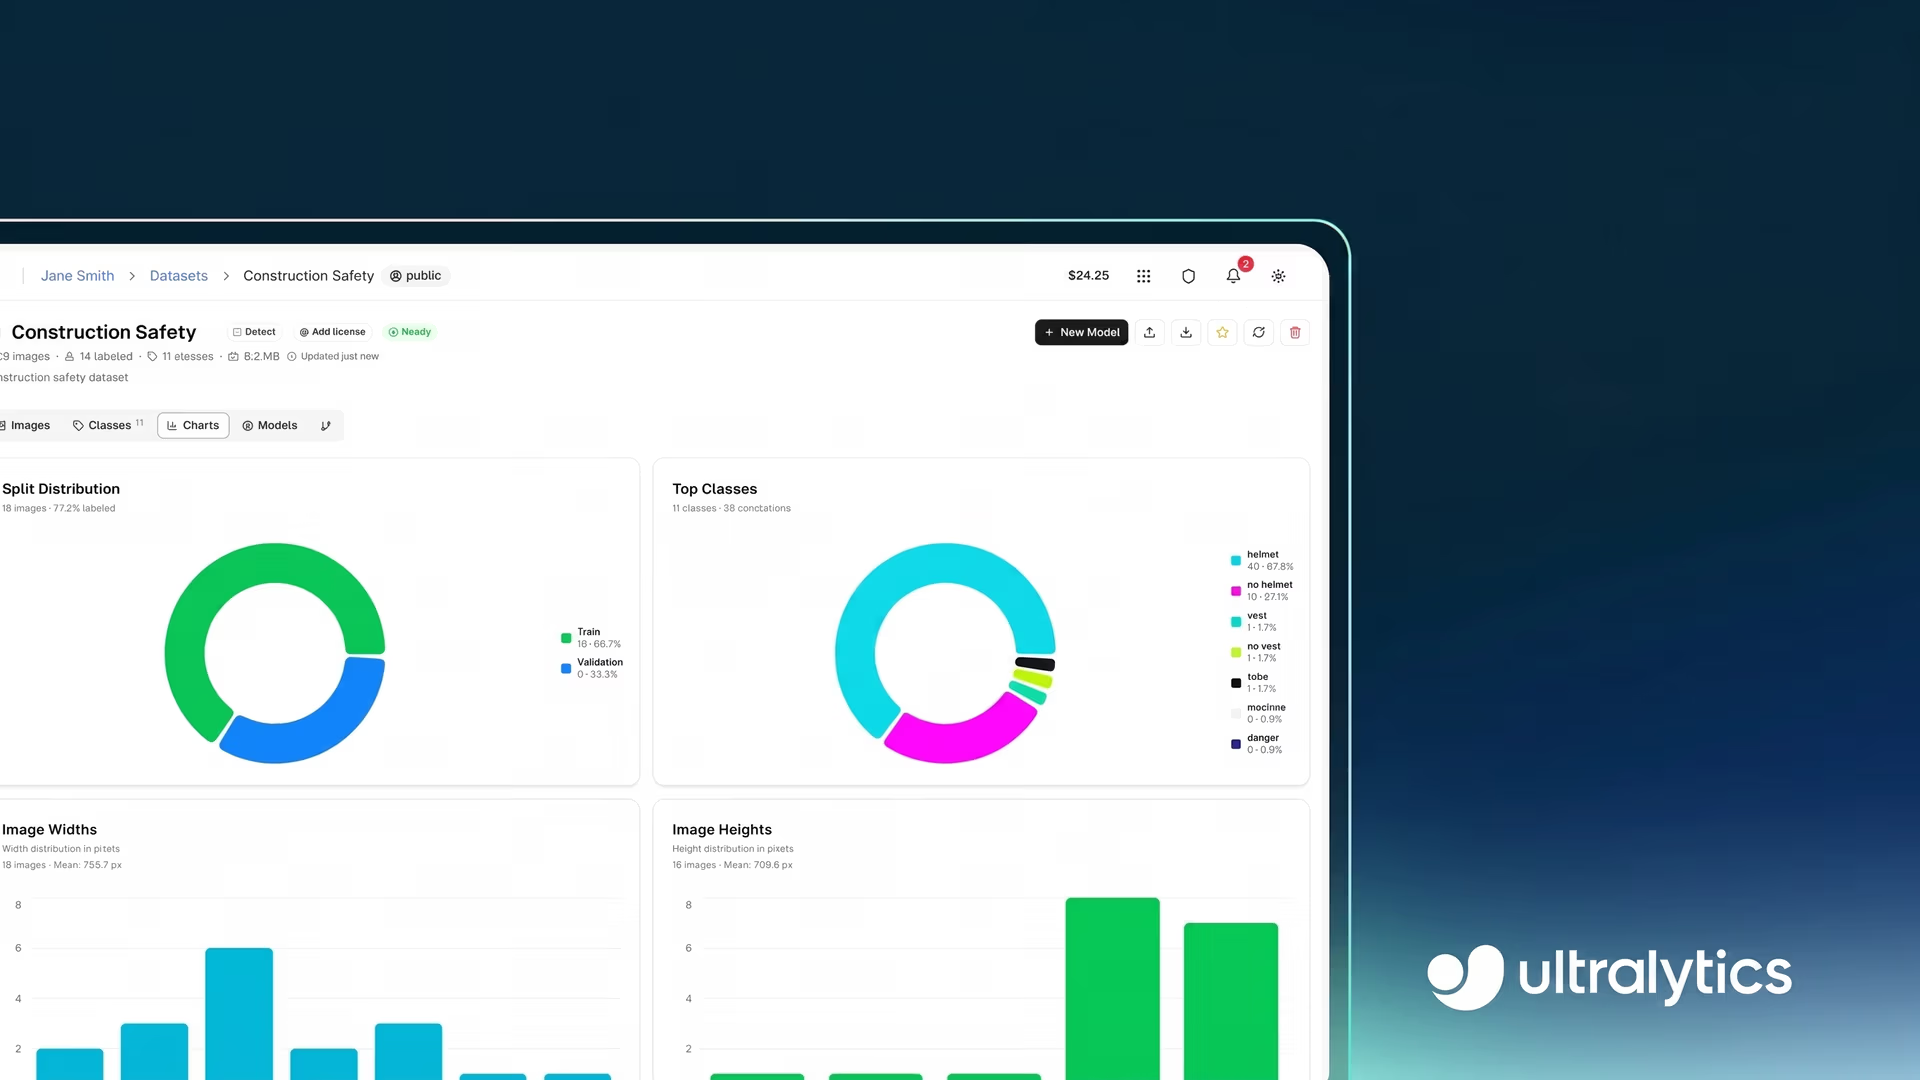
L’IA de vision, ou vision par ordinateur, a beaucoup évolué depuis ses débuts, passant de la recherche expérimentale à une technologie clé qui alimente des applications concrètes. Aujourd’hui, les passionnés d’IA peuvent créer des modèles performants pour des tâches comme la détection d’objets et la segmentation d’instances à l’aide d’outils et de frameworks accessibles.
Cependant, à mesure que ces applications passent de l’expérimentation à la production, la gestion des jeux de données reste un défi crucial, souvent négligé. À mesure que les jeux de données de vision par ordinateur gagnent en taille et en complexité, les équipes peinent souvent à maintenir la cohérence des annotations, à suivre les modifications d’une version à l’autre et à garantir la qualité globale des données.
Même les modèles avancés peuvent être moins performants dans des environnements réels si les données sur lesquelles ils ont été entraînés sont incomplètes, déséquilibrées ou mal gérées. Cet écart croissant entre les performances en développement et la fiabilité en conditions réelles explique la nécessité d’une approche plus structurée de la gestion des jeux de données.
Autre problème fréquent : la collecte des données, leur annotation et l’entraînement sont souvent gérés avec des outils distincts. Un flux de travail fragmenté complique la gestion efficace des jeux de données, augmente le risque d’incohérences et ralentit les itérations.
Pour résoudre les blocages de l’IA de vision liés à la gestion des jeux de données et aux flux de travail fragmentés, nous avons récemment lancé Ultralytics Platform. Il s’agit d’un espace de travail de bout en bout qui rassemble la gestion des jeux de données, l’annotation, l’entraînement, le déploiement et la surveillance dans un flux de travail unifié.
En reliant chaque étape du cycle de vie de la vision par ordinateur, il devient plus facile de suivre les modifications des jeux de données, de comparer les performances entre les versions et d’affiner continuellement tes données pour obtenir de meilleurs résultats.
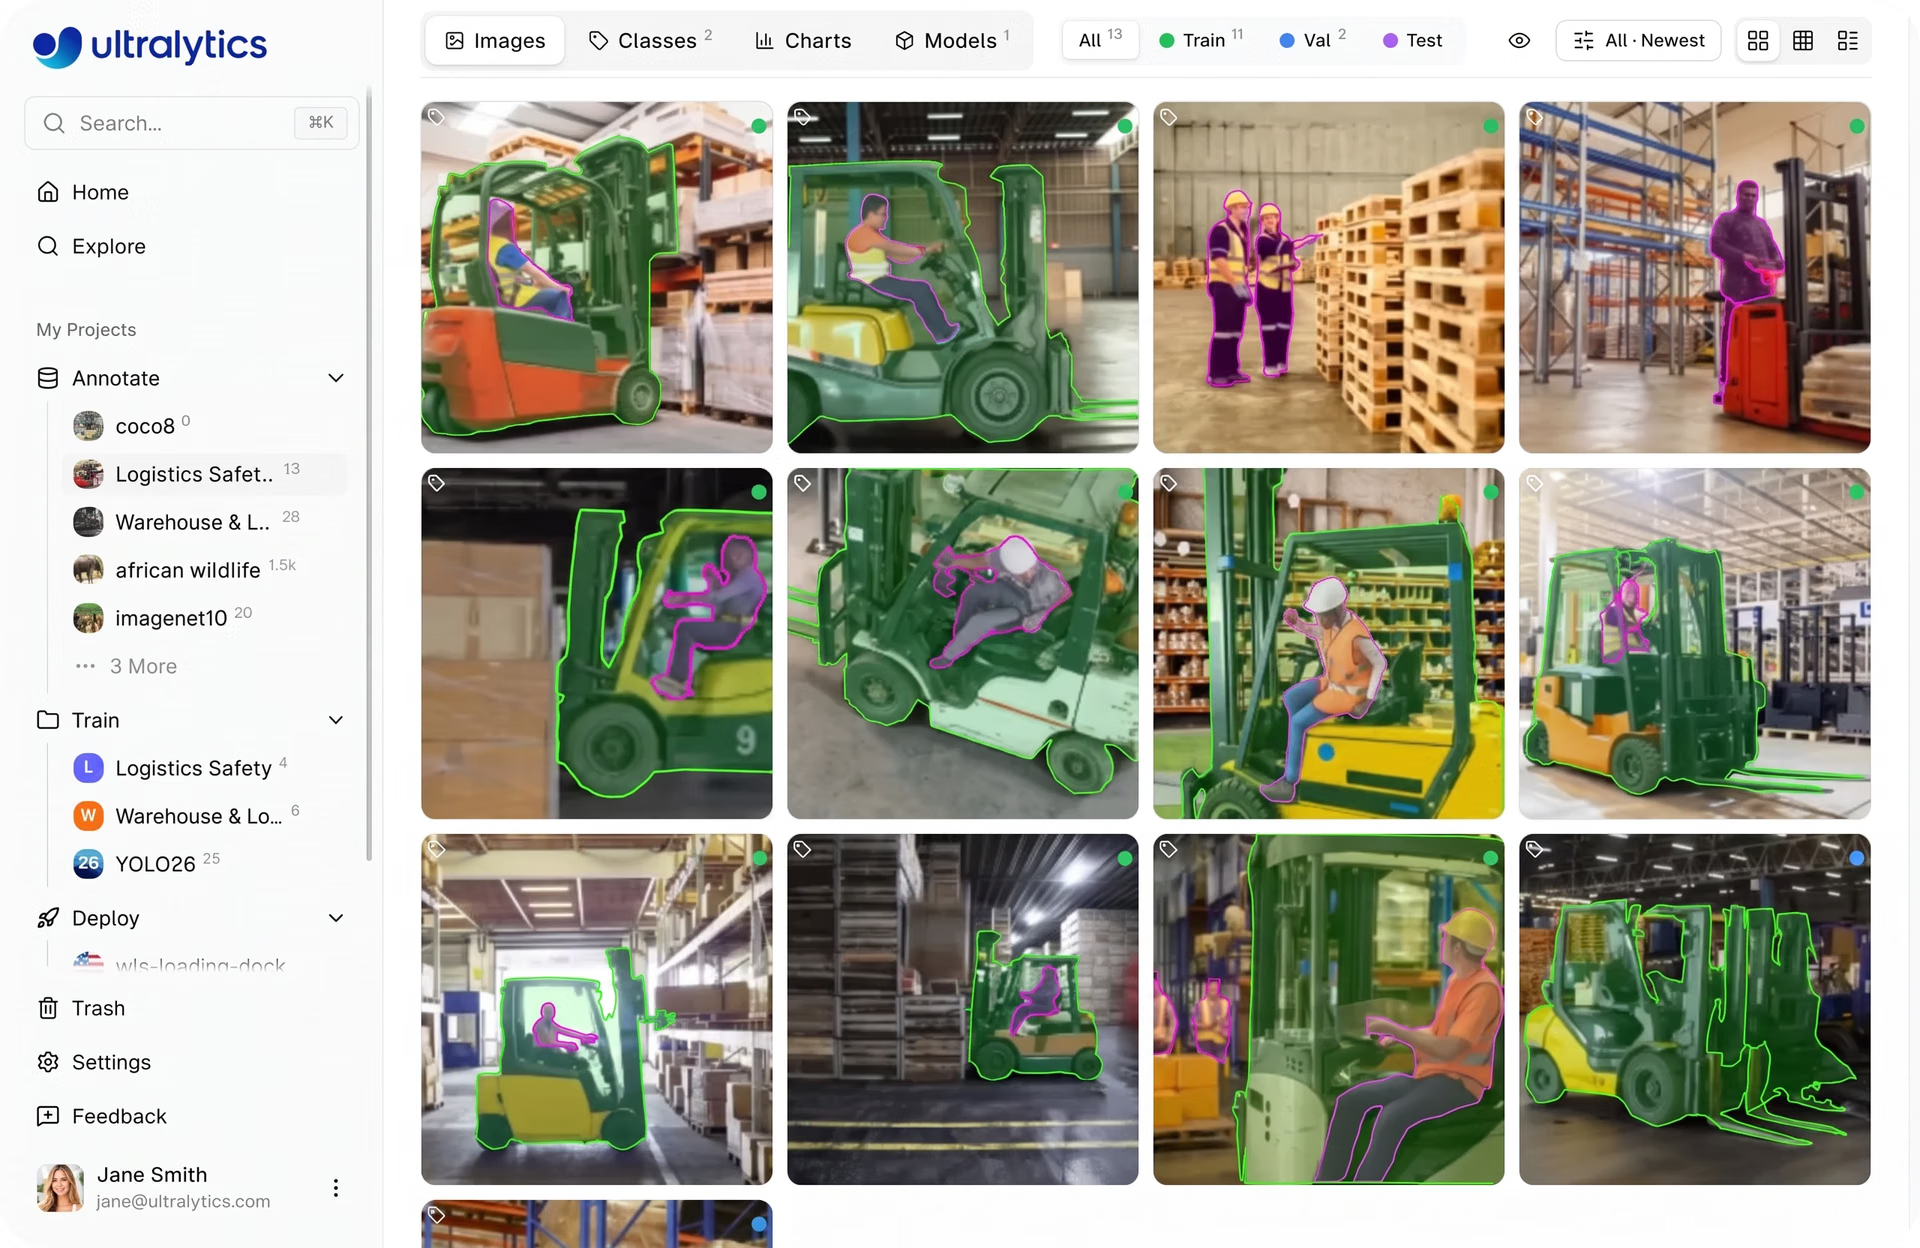
Fig. 1. Exemple de consultation des images de ton jeu de données dans Ultralytics Platform (Source)
Dans cet article, nous verrons comment Ultralytics Platform t’aide à suivre, comparer et améliorer tes jeux de données afin de créer des modèles de vision par ordinateur plus fiables.
L’importance de la gestion des jeux de données en vision par ordinateur#
Les performances d’un modèle de vision par ordinateur sont étroitement liées aux données sur lesquelles il est entraîné. La précision du modèle, c’est-à-dire la fréquence à laquelle ses prédictions sont correctes, dépend non seulement de l’algorithme, mais aussi de la capacité du jeu de données à représenter les conditions réelles.
En termes simples, un modèle apprend directement des motifs à partir des données. Les lacunes, les biais ou les incohérences du jeu de données peuvent donc influencer ses prédictions. Autrement dit, des données de mauvaise qualité, des annotations incorrectes ou une couverture limitée des variations réelles dans les images — comme les conditions d’éclairage, les angles des objets, les arrière-plans ou les niveaux d’occultation — peuvent réduire considérablement la précision, même si l’architecture du modèle est robuste.
Cela vaut aussi pour le fine-tuning, qui consiste à poursuivre l’entraînement d’un modèle préentraîné avec des données nouvelles ou mises à jour afin de mieux l’adapter à un cas d’usage ou à un environnement précis. Puisque la précision du modèle dépend autant des données, leur bonne gestion devient essentielle.
La gestion des jeux de données consiste à organiser, étiqueter et mettre continuellement à jour les données afin qu’elles restent exactes et pertinentes. Cela facilite l’amélioration des performances au fil du temps, notamment lors du réentraînement ou du fine-tuning des modèles avec de nouvelles données.
Comment la qualité des jeux de données influe sur la fiabilité en conditions réelles#
Les cas d’usage de la vision par ordinateur, comme les systèmes de vidéosurveillance, montrent bien pourquoi une bonne gestion des données est essentielle. Ces systèmes doivent fonctionner de manière fiable dans diverses conditions réelles, notamment avec différents éclairages, angles de caméra, niveaux d’affluence et occultations partielles.
Si les données d’entraînement ne couvrent pas ces variations ou ne présentent pas suffisamment de diversité dans l’apparence des objets selon les scènes et les conditions, le modèle risque d’avoir du mal à détecter les objets avec précision. Par exemple, un modèle entraîné principalement sur des scènes bien éclairées et dégagées peut être peu performant en faible luminosité ou dans des lieux bondés. Dans les systèmes de sécurité, cela peut entraîner des événements non détectés ou de fausses alertes.
Pour éviter cela, il est important de maintenir des jeux de données non seulement propres et correctement annotés, mais aussi bien équilibrés et continuellement mis à jour. Cela implique de repérer les lacunes des données, d’ajouter de nouveaux exemples à mesure que les conditions évoluent et de veiller à représenter équitablement les différentes classes et les différents environnements.
Avec un jeu de données plus complet et mieux structuré, les modèles sont mieux à même de gérer la variabilité du monde réel et de produire des prédictions plus fiables.
Principaux aspects de la gestion des jeux de données#
À quoi ressemble concrètement la gestion des jeux de données ? Elle consiste à organiser, étiqueter et entretenir les données afin qu’elles puissent être utilisées efficacement tout au long du processus de développement du modèle.
L’organisation des données consiste, par exemple, à structurer le jeu de données et à le répartir en ensembles d’entraînement, de validation et de test. L’ensemble d’entraînement sert à enseigner au modèle, l’ensemble de validation sert à surveiller ses performances et à orienter les ajustements pendant le développement, et l’ensemble de test sert à évaluer les performances du modèle final sur des données entièrement inédites.
L’annotation consiste quant à elle à ajouter aux images des informations telles que les étiquettes de classe, les boîtes englobantes ou les masques de segmentation. Comme le modèle apprend à partir de ces annotations, leur exactitude et leur cohérence sont essentielles pour l’aider à apprendre des motifs pertinents et à produire des prédictions fiables.
En outre, l’entretien du jeu de données consiste à examiner et à mettre à jour les données au fil du temps. Cela peut inclure la correction des erreurs d’annotation, la suppression des données de mauvaise qualité ou en double, ainsi que l’ajout de nouveaux exemples pour couvrir les cas manquants ou les conditions changeantes.
Plus généralement, la gestion des jeux de données est un processus continu. À mesure que les modèles sont évalués et que de nouvelles données sont collectées, les jeux de données doivent être mis à jour pour refléter les conditions réelles et les cas limites. Le suivi de ces mises à jour et la comparaison des différentes versions aident les équipes à comprendre ce qui améliore les performances et les changements qui restent nécessaires.
Gestion des jeux de données avec Ultralytics Platform#
Ultralytics Platform propose un flux de travail structuré pour gérer les jeux de données dans un environnement unique, de la préparation des données à leur exportation. La plateforme est conçue pour les développeurs individuels comme pour les équipes, et facilite une gestion cohérente des jeux de données, que tu travailles seul ou en collaboration sur plusieurs projets.
Chaque étape est conçue pour simplifier l’organisation, le traitement et l’utilisation des jeux de données tout au long du cycle de développement du modèle. En regroupant ces étapes au même endroit, la plateforme réduit la fragmentation et facilite le maintien de la cohérence entre les flux de travail.
Passons maintenant en revue les principales étapes et la manière dont la plateforme accompagne chacune d’elles.
Téléverser des jeux de données dans Ultralytics Platform#
Pour démarrer avec les jeux de données sur la plateforme, tu disposes de plusieurs moyens d’importer ou de réutiliser des données. Tu peux téléverser tes propres données ou commencer plus rapidement en utilisant les jeux de données publics disponibles sur la plateforme. Tu peux également cloner des jeux de données existants partagés par la communauté et les enrichir.
Les fonctionnalités communautaires de la plateforme facilitent la découverte et la réutilisation de travaux existants. En accédant aux jeux de données créés par d’autres utilisateurs, qui comprennent des millions d’images et d’annotations, tu peux démarrer rapidement sans avoir à tout collecter et annoter toi-même. Le clonage d’un jeu de données en crée une copie dans ton espace de travail, que tu peux modifier et enrichir tout en préservant l’original.
Pour l’importation, la plateforme prend en charge les images individuelles, les vidéos et les archives de jeux de données, comme les fichiers ZIP, TAR ou GZ. Elle prend également en charge des formats de jeux de données courants comme YOLO et COCO, ce qui facilite l’importation de jeux de données et d’annotations existants sans conversion supplémentaire. Tu peux aussi importer un jeu de données à l’aide d’un fichier NDJSON exporté depuis la plateforme, ce qui facilite la recréation ou la réutilisation de jeux de données dans différents projets.
Une fois les données téléversées, la plateforme les traite au moyen d’un pipeline structuré. Cela comprend la validation des formats et des tailles de fichiers, le redimensionnement des images au besoin, l’analyse des annotations et la génération de statistiques sur le jeu de données.
Par exemple, les vidéos sont converties en images afin de pouvoir être utilisées pour l’entraînement, tandis que les images sont optimisées et préparées pour faciliter leur consultation et leur analyse. Après le traitement, les jeux de données sont prêts à être utilisés pour l’annotation, l’analyse et l’entraînement des modèles sur la plateforme.
Annotation des données sur Ultralytics Platform#
Une fois importés, les jeux de données peuvent être examinés et annotés directement dans la plateforme. Celle-ci comprend des outils intégrés d’annotation d’images pour diverses tâches de vision par ordinateur, comme la détection d’objets, la segmentation d’instances, la segmentation sémantique, la classification d’images, l’estimation de pose et la détection de boîtes englobantes orientées (OBB).
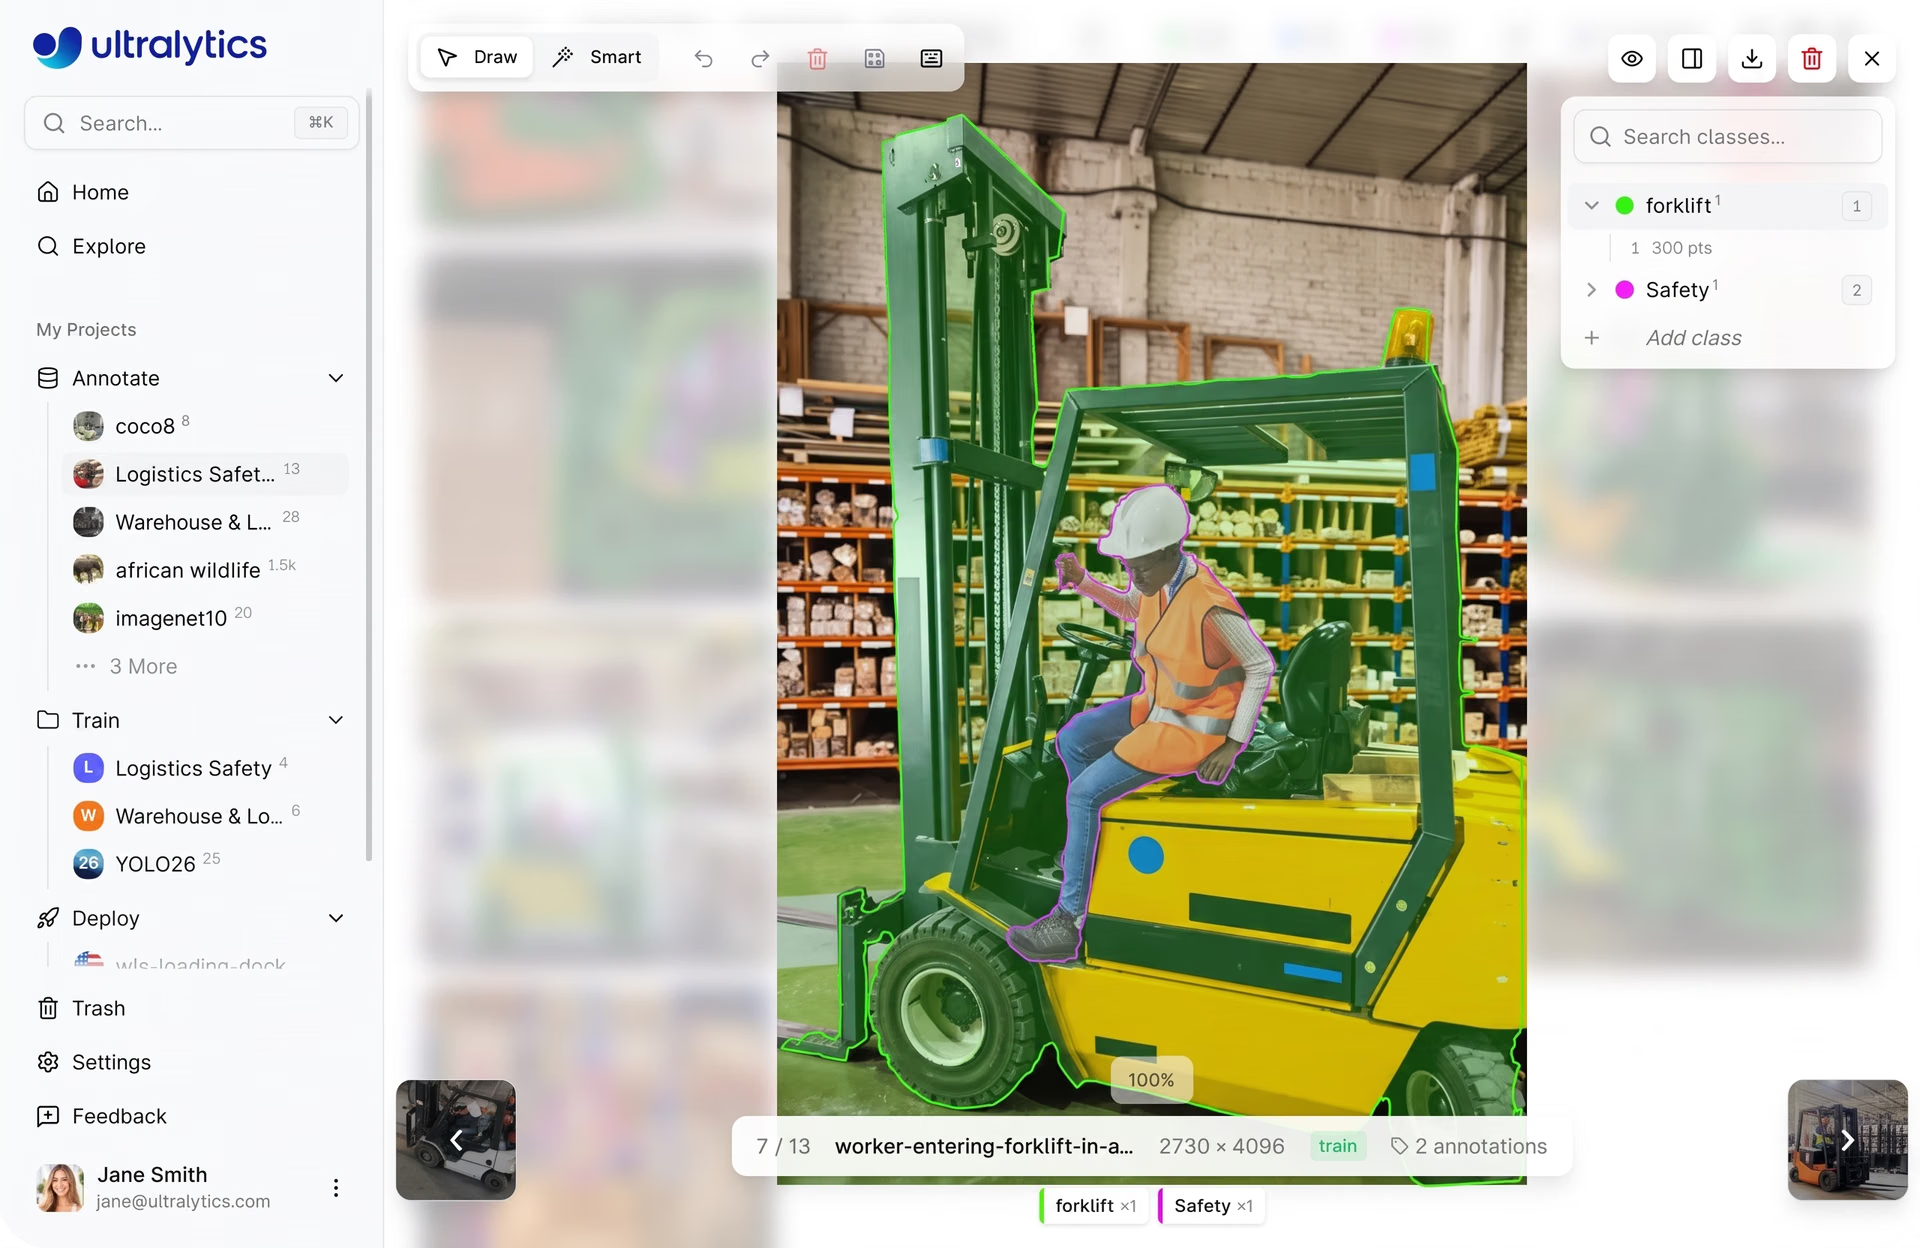
Fig. 2. Étiquetage des données avec Ultralytics Platform (Source)
Les annotations peuvent être créées manuellement avec ces outils ou réalisées plus rapidement grâce à des fonctionnalités assistées par l’IA, comme l’annotation intelligente optimisée par SAM. Avec SAM, tu peux générer des masques, des boîtes englobantes ou des boîtes orientées en interagissant avec l’image, ce qui accélère l’étiquetage tout en préservant sa précision.
Analyser la qualité des jeux de données avec Ultralytics Platform#
Outre la préparation et l’annotation des données, comprendre la qualité des jeux de données est essentiel pour créer des modèles de vision par ordinateur fiables. Sans visibilité claire sur des facteurs comme la répartition des classes, la qualité des annotations, le découpage du jeu de données et la représentation des données selon les différentes conditions, il peut être difficile de repérer les problèmes qui nuisent aux performances du modèle.
Ultralytics Platform intègre des fonctionnalités qui facilitent l’analyse des jeux de données. Ces informations sont accessibles directement dans l’interface du jeu de données, dans des onglets comme Images, Classes et Graphiques.
Dans l’onglet Graphiques, tu peux consulter des statistiques à l’échelle du jeu de données, comme la répartition des ensembles (entraînement, validation et test), la fréquence des classes et les cartes thermiques des annotations, qui indiquent où les objets apparaissent dans les images.
L’onglet Classes présente une répartition du nombre d’annotations par classe, ce qui facilite la détection des déséquilibres entre classes. L’onglet Images affiche quant à lui des informations propres à chaque image, comme ses dimensions, le nombre d’annotations et la répartition des étiquettes entre les images.
Ces informations facilitent le repérage de problèmes tels que les déséquilibres entre classes, les scénarios manquants ou une répartition inégale des données. Tu peux, par exemple, remarquer que certaines classes comportent très peu d’exemples ou que la plupart des annotations se concentrent dans des zones précises d’une image.
Au-delà de l’analyse des données, la plateforme prend en charge la curation et l’augmentation des jeux de données, c’est-à-dire leur affinement par la correction ou la suppression des données problématiques et la création de variantes à partir des données existantes pour améliorer les performances du modèle. Ces améliorations peuvent être apportées directement sur la plateforme en mettant à jour les annotations, en ajoutant de nouvelles données ou en réorganisant les ensembles du jeu de données à partir des résultats de l’analyse.
Exporter des jeux de données depuis Ultralytics Platform#
Une fois préparé et validé, un jeu de données peut être exporté pour être utilisé dans différents environnements. Tu peux ainsi utiliser tes données de vision par ordinateur où tu le souhaites, que ce soit pour entraîner des modèles en local, dans le cloud ou avec d’autres outils et flux de travail.
Ultralytics Platform exporte les jeux de données sous forme de fichiers Ultralytics NDJSON, un format que le package Python d’Ultralytics peut utiliser directement pour l’entraînement et qui peut être réimporté dans la plateforme. Il est ainsi facile d’intégrer des jeux de données à différents workflows et outils d’entraînement.
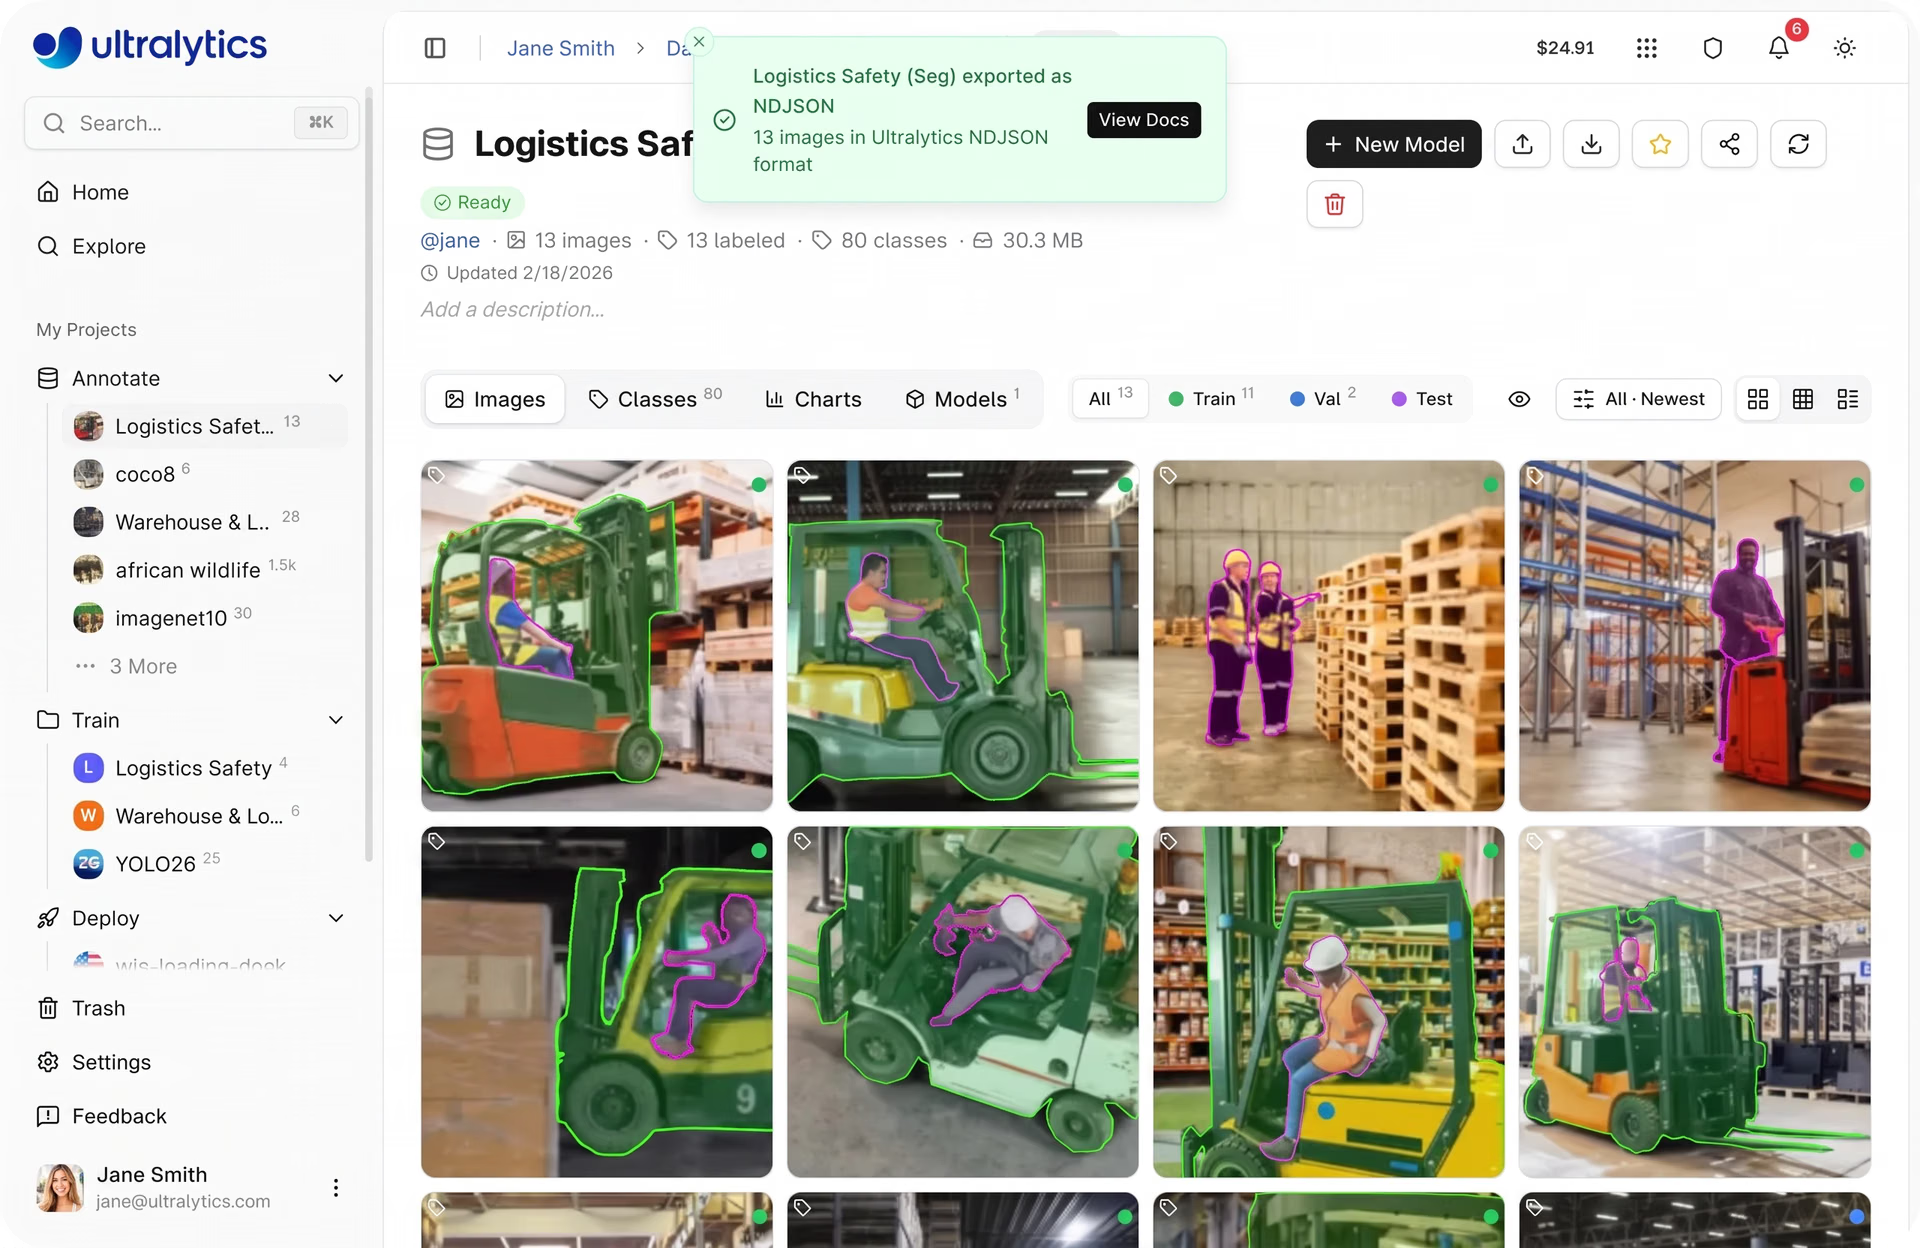
Fig. 3. Exportation d’un jeu de données depuis Ultralytics Platform (Source)
L’exportation d’un jeu de données crée un instantané immuable des données à un moment précis, comprenant ses images, ses annotations et sa structure. C’est utile, car les jeux de données évoluent souvent à mesure que de nouvelles données sont ajoutées, que les annotations sont mises à jour ou que les ensembles sont réorganisés. En exportant un instantané, tu peux conserver exactement la version du jeu de données utilisée pour un entraînement donné.
Cela facilite la reproduction ultérieure des résultats, puisque tu peux entraîner de nouveau un modèle avec la même configuration de données et comparer les performances de différentes versions du jeu de données. Tu peux, par exemple, vérifier si l’ajout de nouvelles images ou la correction des annotations améliore réellement la précision du modèle, plutôt que de deviner ce qui a changé.
Les jeux de données exportés peuvent être téléchargés et utilisés dans des environnements d’entraînement locaux, cloud ou hors ligne.
Améliorer la qualité des jeux de données par itérations sur Ultralytics Platform#
Dans les flux de travail d’apprentissage automatique et d’apprentissage profond, la gestion des jeux de données se poursuit même après le déploiement, car les données du monde réel diffèrent souvent de celles utilisées pendant l’entraînement.
Lorsque les modèles reçoivent de nouvelles entrées, les lacunes du jeu de données deviennent plus évidentes : conditions manquantes comme les environnements faiblement éclairés, angles de caméra différents, occultations ou scènes bondées, ainsi que les erreurs d’annotation. Il devient donc nécessaire d’affiner les données au fil du temps.
Il existe plusieurs façons d’améliorer un jeu de données. Tu peux ajouter de nouvelles images ou vidéos pour couvrir les conditions manquantes, comme les environnements faiblement éclairés, les angles de caméra différents, les occultations ou les scènes bondées, afin de réduire les angles morts dans les données.
Parallèlement, veiller à ce que les annotations soient exactes et cohérentes — avec des objets correctement étiquetés et des boîtes englobantes ou des masques précis, par exemple — aide le modèle à apprendre des motifs plus fiables.
Cela suit généralement une boucle simple : entraîner le modèle, évaluer les résultats, repérer les erreurs, améliorer le jeu de données, puis réentraîner le modèle. Chaque étape aide à mettre en évidence des problèmes comme des annotations incorrectes, des données manquantes ou des cas sous-représentés.
Imaginons que tu travailles sur un système de surveillance des rayons en magasin en temps réel, destiné à détecter les produits. Les premières versions du jeu de données peuvent ne pas inclure certains types de produits, conditions d’éclairage ou configurations de rayons bondés. Pendant l’évaluation, tu peux constater que le modèle a du mal à détecter les articles dans ces situations.
Pour améliorer les performances, tu peux collecter de nouvelles images couvrant ces scénarios manquants et mettre à jour les annotations si nécessaire. En répétant ce processus au fil du temps, tu aideras le modèle à devenir plus précis et plus fiable dans des conditions réelles.
Ultralytics Platform prend en charge ce flux de travail en reliant les mises à jour des jeux de données à l’entraînement et à l’évaluation. Grâce au suivi des expériences et aux métriques de performance intégrés, il devient plus facile de suivre les progrès et d’améliorer continuellement les jeux de données au fil du temps.
Suivre les modifications des jeux de données avec Ultralytics Platform#
Nous avons brièvement vu comment les jeux de données évoluent au fil du temps dans le cadre du développement des modèles. À mesure que de nouvelles données sont ajoutées, que les annotations sont affinées et que les classes sont mises à jour, le suivi de ces changements devient essentiel pour maintenir la qualité des données et garantir la cohérence des performances du modèle.
Voici quelques fonctionnalités clés d’Ultralytics Platform qui facilitent le suivi et le contrôle de version des jeux de données :
- Gestion des versions des jeux de données : Tu peux créer des versions figées des jeux de données sous forme d’instantanés NDJSON. Chaque version saisit des informations clés, comme le nombre d’images, de classes et d’annotations, ainsi que la taille du jeu de données à un moment précis. Ces versions sont stockées et peuvent être téléchargées ultérieurement, ce qui facilite la reproduction des expériences et la comparaison des résultats entre différents états du jeu de données.
- Onglet Versions : Toutes les versions des jeux de données sont organisées dans l’onglet Versions, où tu peux consulter l’historique, ajouter des descriptions aux modifications et suivre l’évolution du jeu de données au fil du temps.
- Liaison avec les modèles : L’onglet Modèles affiche tous les modèles entraînés sur un jeu de données, ainsi que des métriques comme mAP et les détails de l’entraînement. Les versions des jeux de données sont associées aux exécutions d’entraînement, ce qui t’aide à comprendre l’incidence des modifications des données sur les performances du modèle.
- Onglet Erreurs : L’onglet Erreurs met en évidence les fichiers dont le traitement a échoué, avec les détails des erreurs et des suggestions. Tu peux ainsi repérer et corriger des problèmes tels que des fichiers corrompus ou des formats non pris en charge avant l’entraînement.
- Interface du jeu de données (onglets Images et Classes) : Ces vues te permettent de parcourir les images, d’examiner les annotations, de gérer les étiquettes de classe et d’analyser la répartition des classes. Des fonctionnalités comme le filtrage, le tri et le repérage des images non annotées simplifient le suivi de la qualité du jeu de données au fil du temps.
- Statistiques et graphiques : Les visualisations de données intégrées, comme la répartition des ensembles, la fréquence des classes et les cartes thermiques des annotations, aident à suivre les changements dans la distribution des données et à repérer les déséquilibres à mesure que le jeu de données évolue.
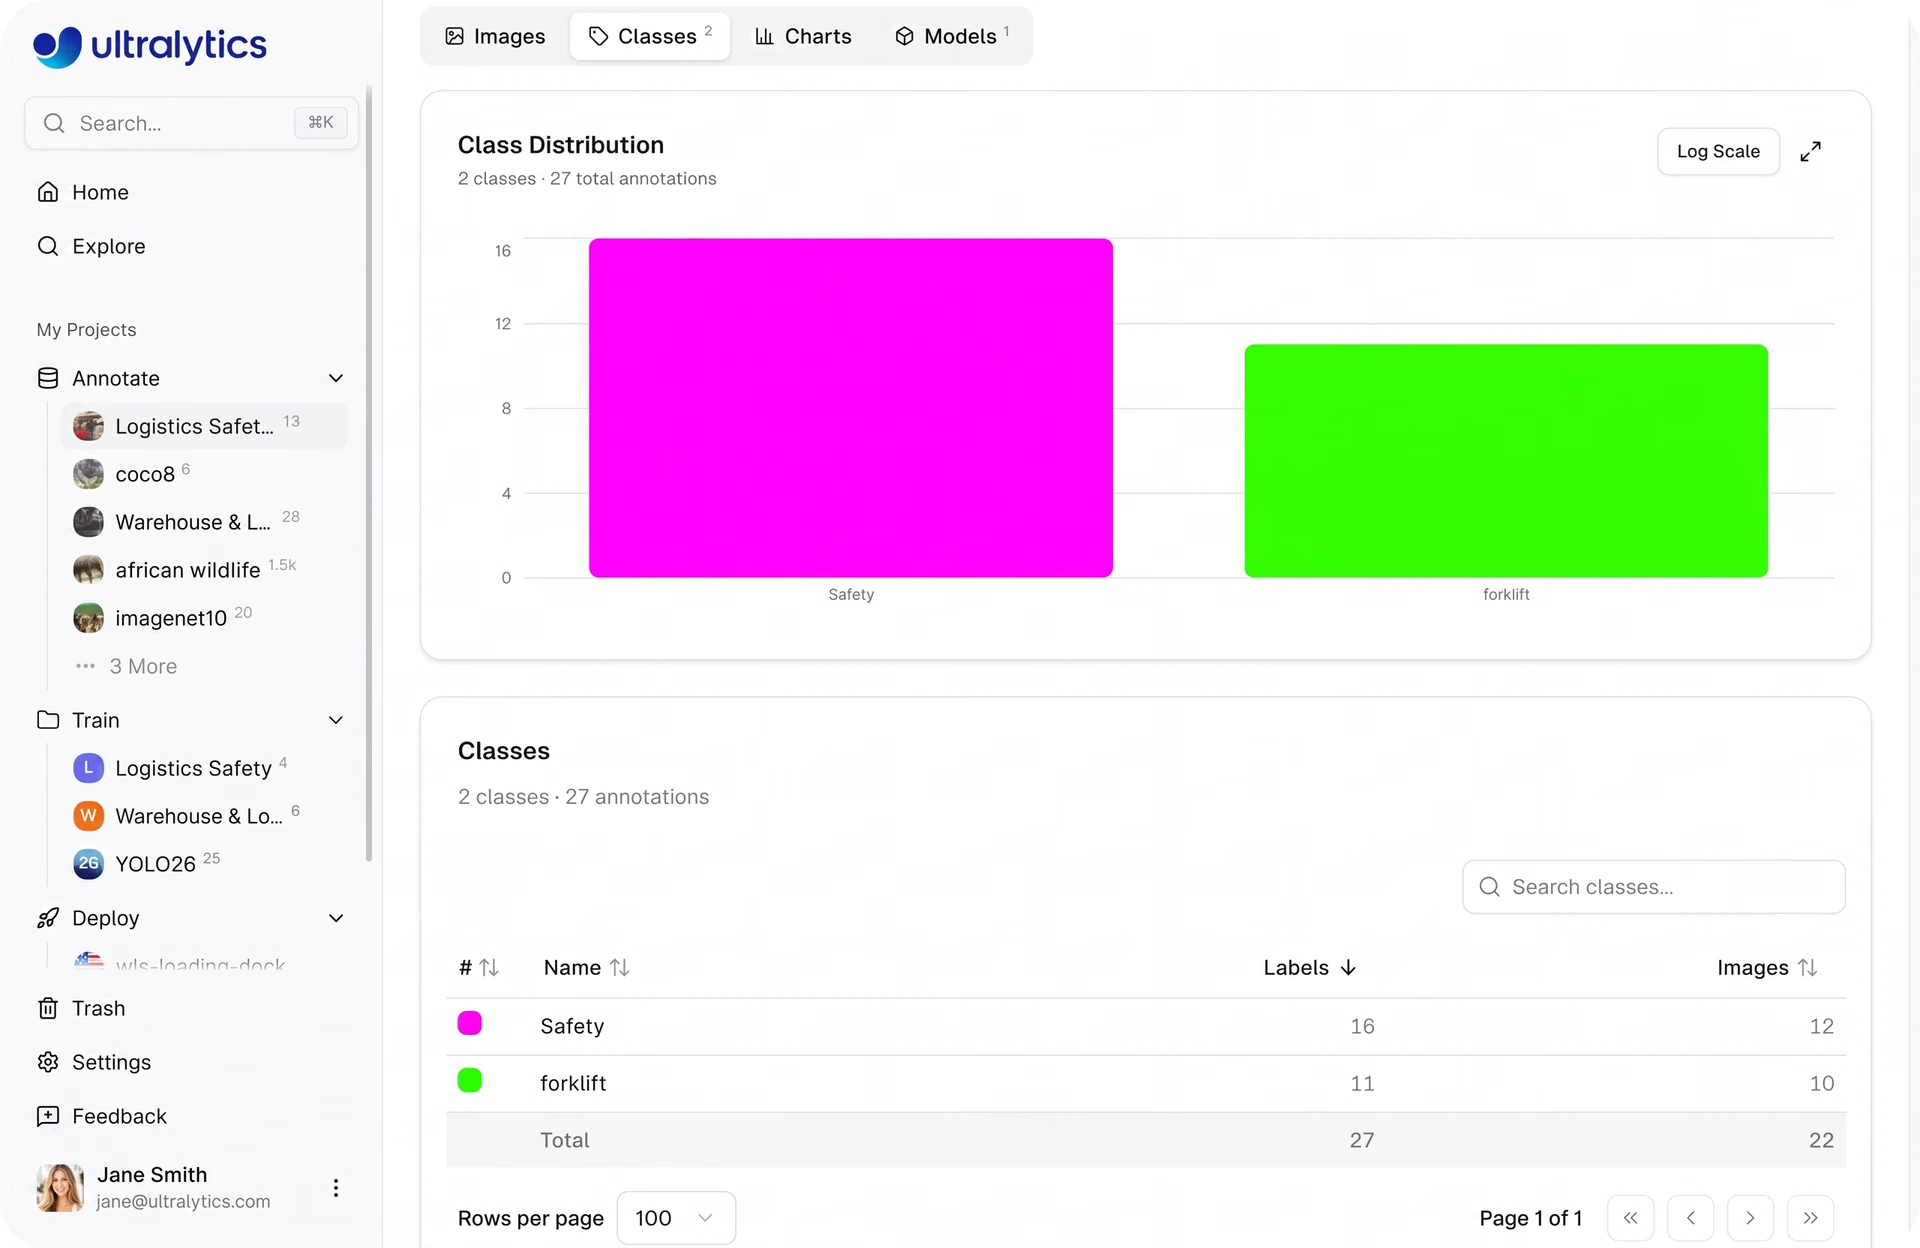
Fig. 4. Exemple d’analyse de la répartition des classes d’un jeu de données sur Ultralytics Platform (Source)
Relier les jeux de données à l’entraînement et au déploiement sur Ultralytics Platform#
Ultralytics Platform relie les différentes étapes du développement des modèles d’IA au sein d’un pipeline unique. La plateforme simplifie le passage des données brutes aux applications d’IA de vision prêtes pour la production.
Une fois préparés et annotés, les jeux de données peuvent être utilisés pour entraîner des modèles de vision par ordinateur, comme Ultralytics YOLO26, directement sur la plateforme. Pendant l’entraînement, tu peux suivre les métriques de performance, tracer les expériences et évaluer la qualité de l’apprentissage du modèle grâce aux tableaux de bord intégrés.
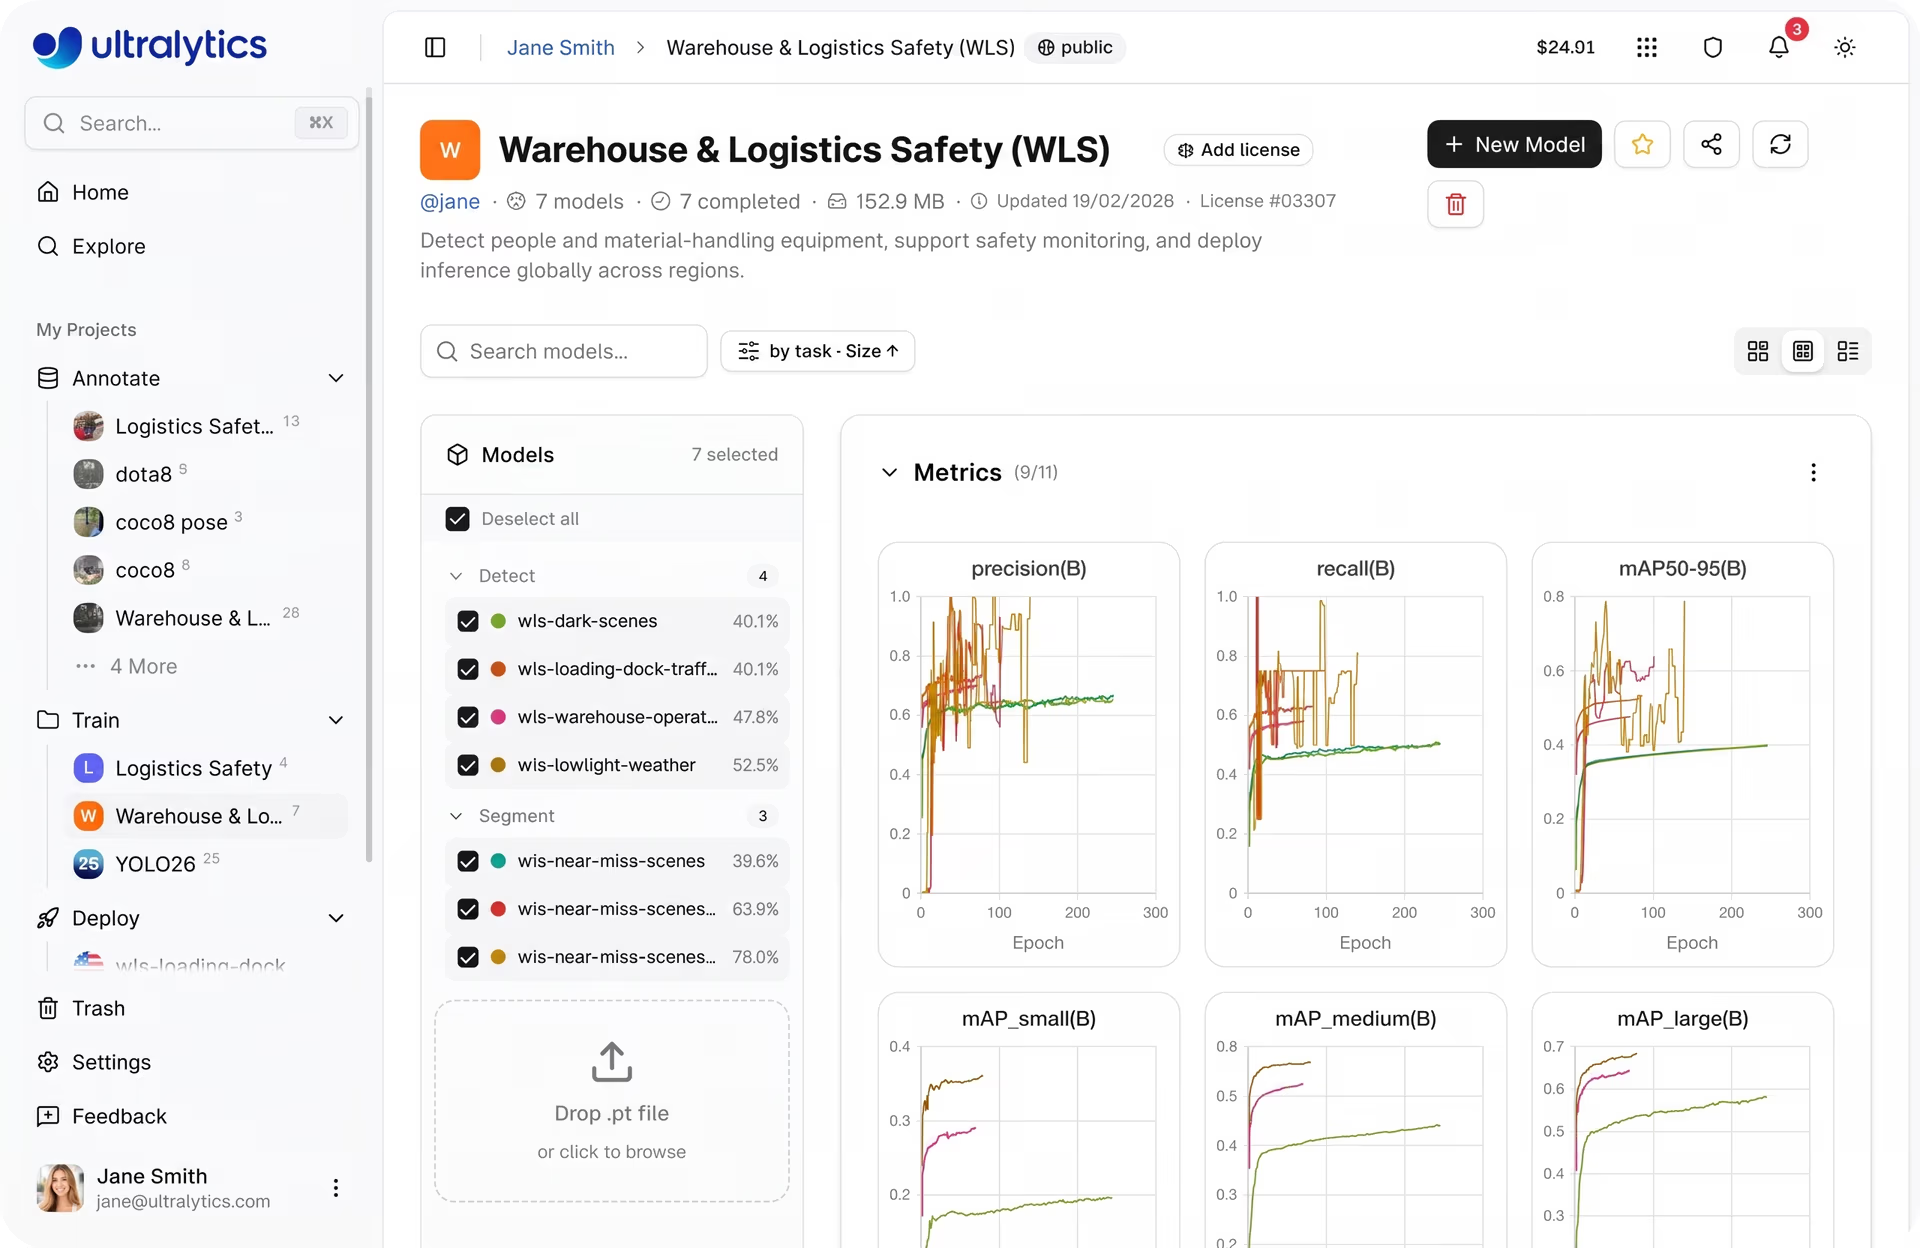
Fig. 5. Aperçu de la consultation des métriques d’entraînement d’un modèle sur Ultralytics Platform (Source)
Après l’entraînement, tu peux tester les modèles sur de nouvelles images directement dans le navigateur pour évaluer les prédictions et repérer les points à améliorer avant le déploiement. Lorsque le modèle donne de bons résultats, il peut être déployé en production.
La plateforme permet d’exporter les modèles dans plusieurs formats ou de les déployer au moyen de services d’inférence et de points de terminaison dédiés, afin de les exécuter dans différents environnements.
Après le déploiement, les outils de surveillance intégrés permettent de suivre les performances du système au fil du temps, notamment les métriques liées à l’utilisation et au comportement du modèle. La maintenance et l’amélioration des systèmes d’IA de vision dans des applications réelles s’en trouvent simplifiées.
Bonnes pratiques de gestion des jeux de données avec Ultralytics Platform#
Voici quelques facteurs clés à garder à l’esprit lorsque tu gères tes jeux de données avec Ultralytics Platform :
- Utilise des filtres pour repérer les lacunes : Repère les données non étiquetées ou sous-représentées à l’aide des outils de filtrage, afin de compléter plus facilement les annotations et d’améliorer la couverture.
- Corrige les erreurs rapidement : utilise l’onglet Errors pour le contrôle qualité afin de détecter les échecs de téléversement, les fichiers corrompus ou les formats non pris en charge avant l’entraînement.
- Mets continuellement les jeux de données à jour : ajoute de nouvelles données, corrige les annotations et ajoute les cas limites au fur et à mesure. Cela contribue à améliorer la couverture et à garantir la fiabilité des modèles dans des situations réelles.
- Gère soigneusement les partitions des jeux de données : veille à maintenir un bon équilibre entre les ensembles d’entraînement, de validation et de test. Tu peux réorganiser les partitions manuellement ou utiliser une redistribution automatique si nécessaire.
Pour en savoir plus sur Ultralytics Platform, consulte la documentation officielle d’Ultralytics Platform.
Points clés à retenir#
À mesure que les projets de vision par ordinateur prennent de l’ampleur, la gestion efficace des jeux de données devient aussi importante que le développement des modèles. Une approche structurée de la gestion des jeux de données contribue à améliorer la qualité des données, à rationaliser les flux de travail et à favoriser de meilleures performances des modèles au fil du temps.
Ultralytics Platform simplifie ce processus en regroupant la gestion des jeux de données, l’entraînement et le déploiement dans un flux de travail unique. En adoptant une approche structurée de la gestion des jeux de données, les équipes peuvent réduire la complexité, améliorer leur efficacité et créer des systèmes de vision par ordinateur plus évolutifs et fiables.
Rejoins notre communauté en pleine croissance et explore notre dépôt GitHub pour trouver des ressources sur l’IA. Pour développer dès aujourd’hui avec l’IA visuelle, consulte nos options de licence. Découvre comment l’IA dans l’agriculture transforme les pratiques agricoles et comment la vision par ordinateur dans le secteur de la santé façonne l’avenir en consultant nos pages de solutions.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









