Entraîne plus rapidement des modèles YOLO avec Ultralytics Platform
Découvre comment entraîner plus rapidement des modèles YOLO avec Ultralytics Platform, un environnement de bout en bout conçu pour accélérer le passage des données au déploiement.
La semaine dernière, Ultralytics a présenté l’Ultralytics Platform, un espace de travail unifié conçu pour simplifier la manière dont les équipes développent, entraînent et déploient des modèles de vision par ordinateur. Au lieu de jongler entre plusieurs outils, la plateforme regroupe tout au même endroit. Passer de l’idée au déploiement de modèles d’IA pour la vision devient simple et sans contraintes.
C’est essentiel, car la vision par ordinateur devient rapidement un élément central de nombreux secteurs. Elle alimente des applications comme l’inspection industrielle, l’analyse du commerce de détail et la navigation autonome.
Transformer ces applications reposant sur la vision en systèmes fiables dépend de la qualité de l’entraînement des modèles. L’entraînement d’un modèle consiste à apprendre à partir de données annotées afin que le modèle puisse reconnaître des motifs et produire des prédictions précises. En général, des modèles bien entraînés offrent de meilleures performances et des résultats plus fiables dans les applications du monde réel.
Cependant, entraîner un modèle de vision par ordinateur n’est pas toujours simple. Cela comprend différents aspects, comme la configuration des environnements, la sélection des ressources de calcul appropriées, le réglage des hyperparamètres et le suivi de plusieurs expériences d’entraînement. Lorsque ces étapes sont réparties entre différents outils et systèmes, le workflow d’entraînement devient rapidement complexe et difficile à gérer.
Ultralytics Platform résout ce problème en regroupant l’ensemble du processus d’entraînement dans un tableau de bord unifié. Tu peux configurer, exécuter et surveiller les tâches d’entraînement au même endroit, que tu travailles dans le cloud, en local ou sur Google Colab.
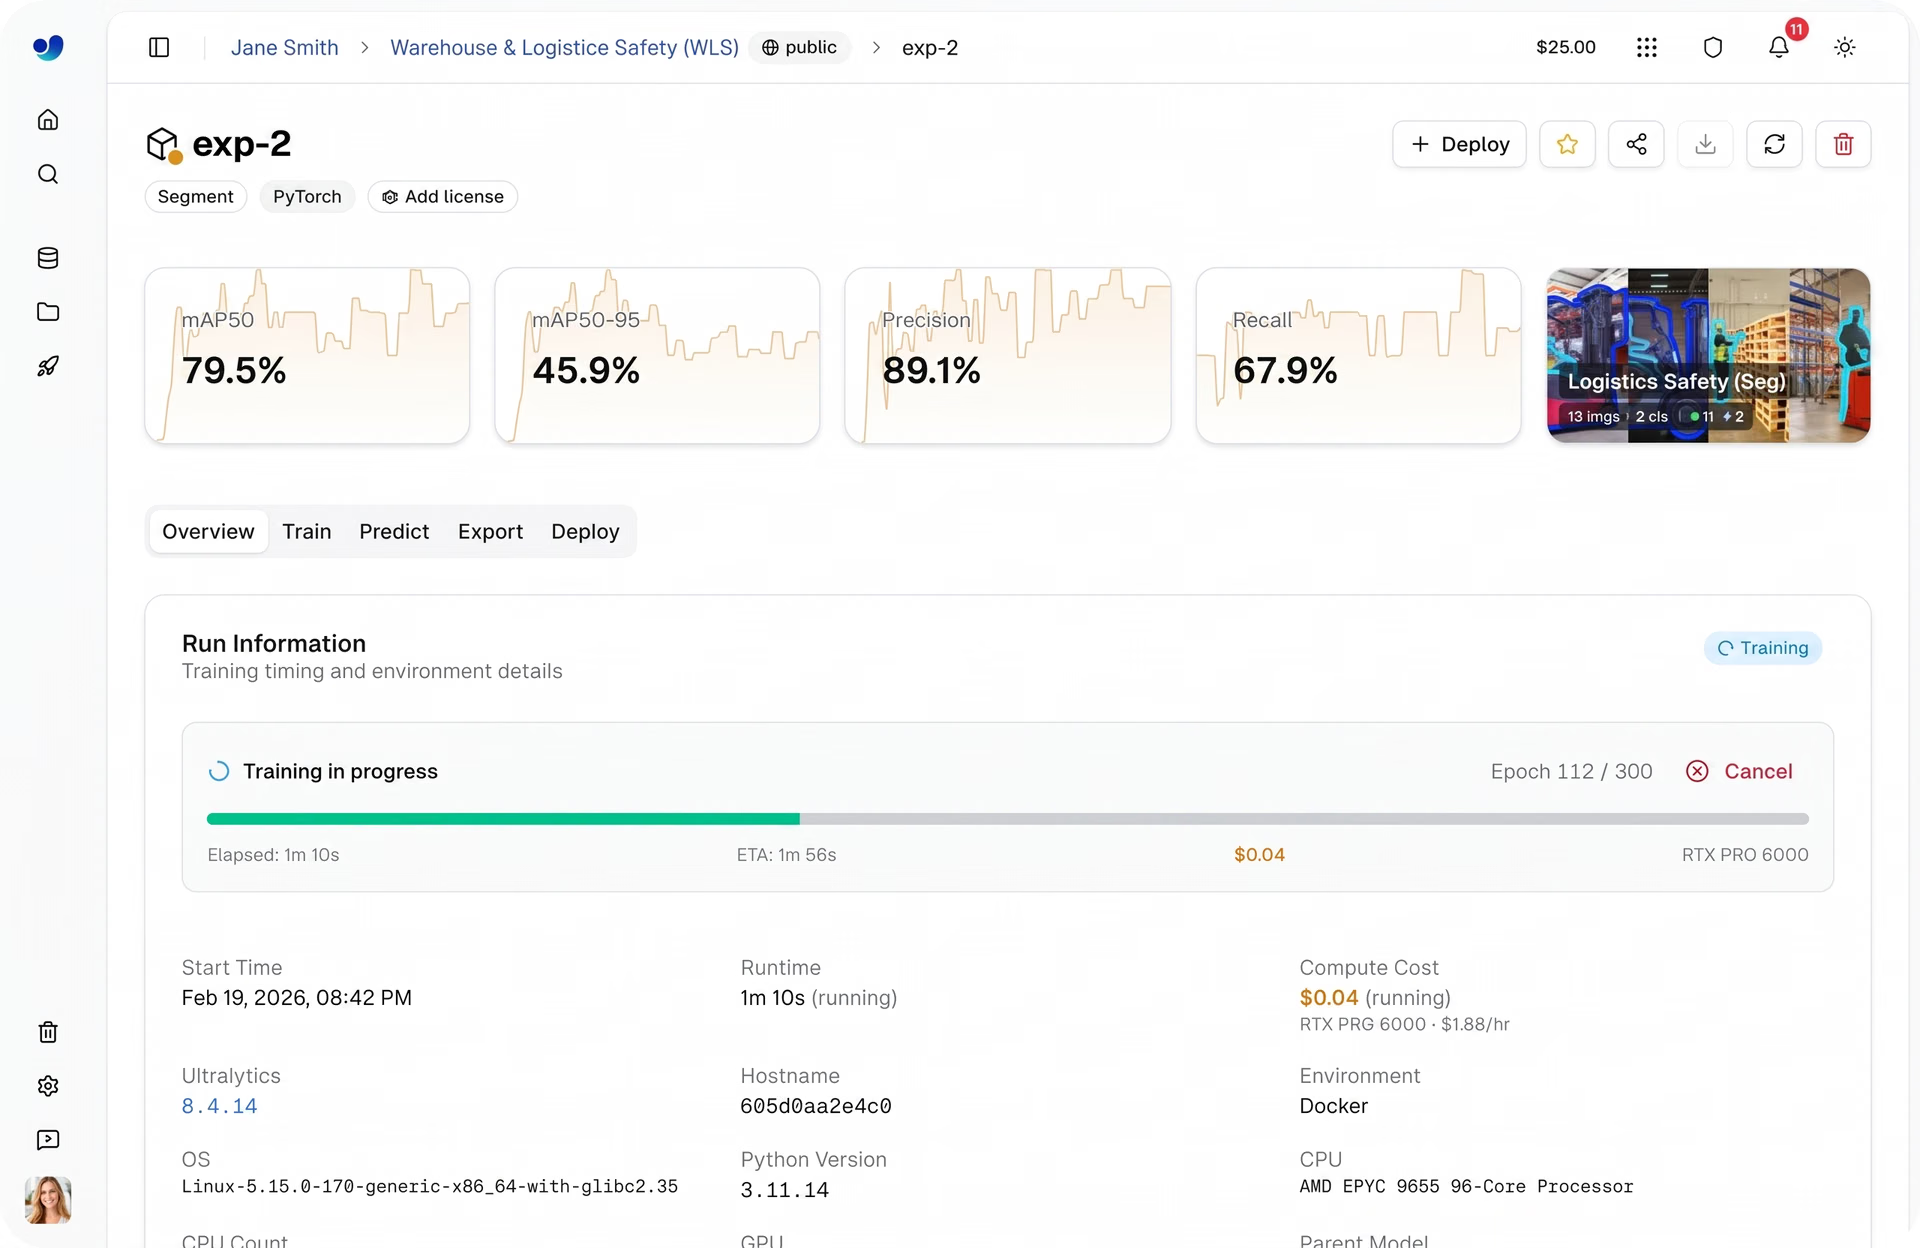
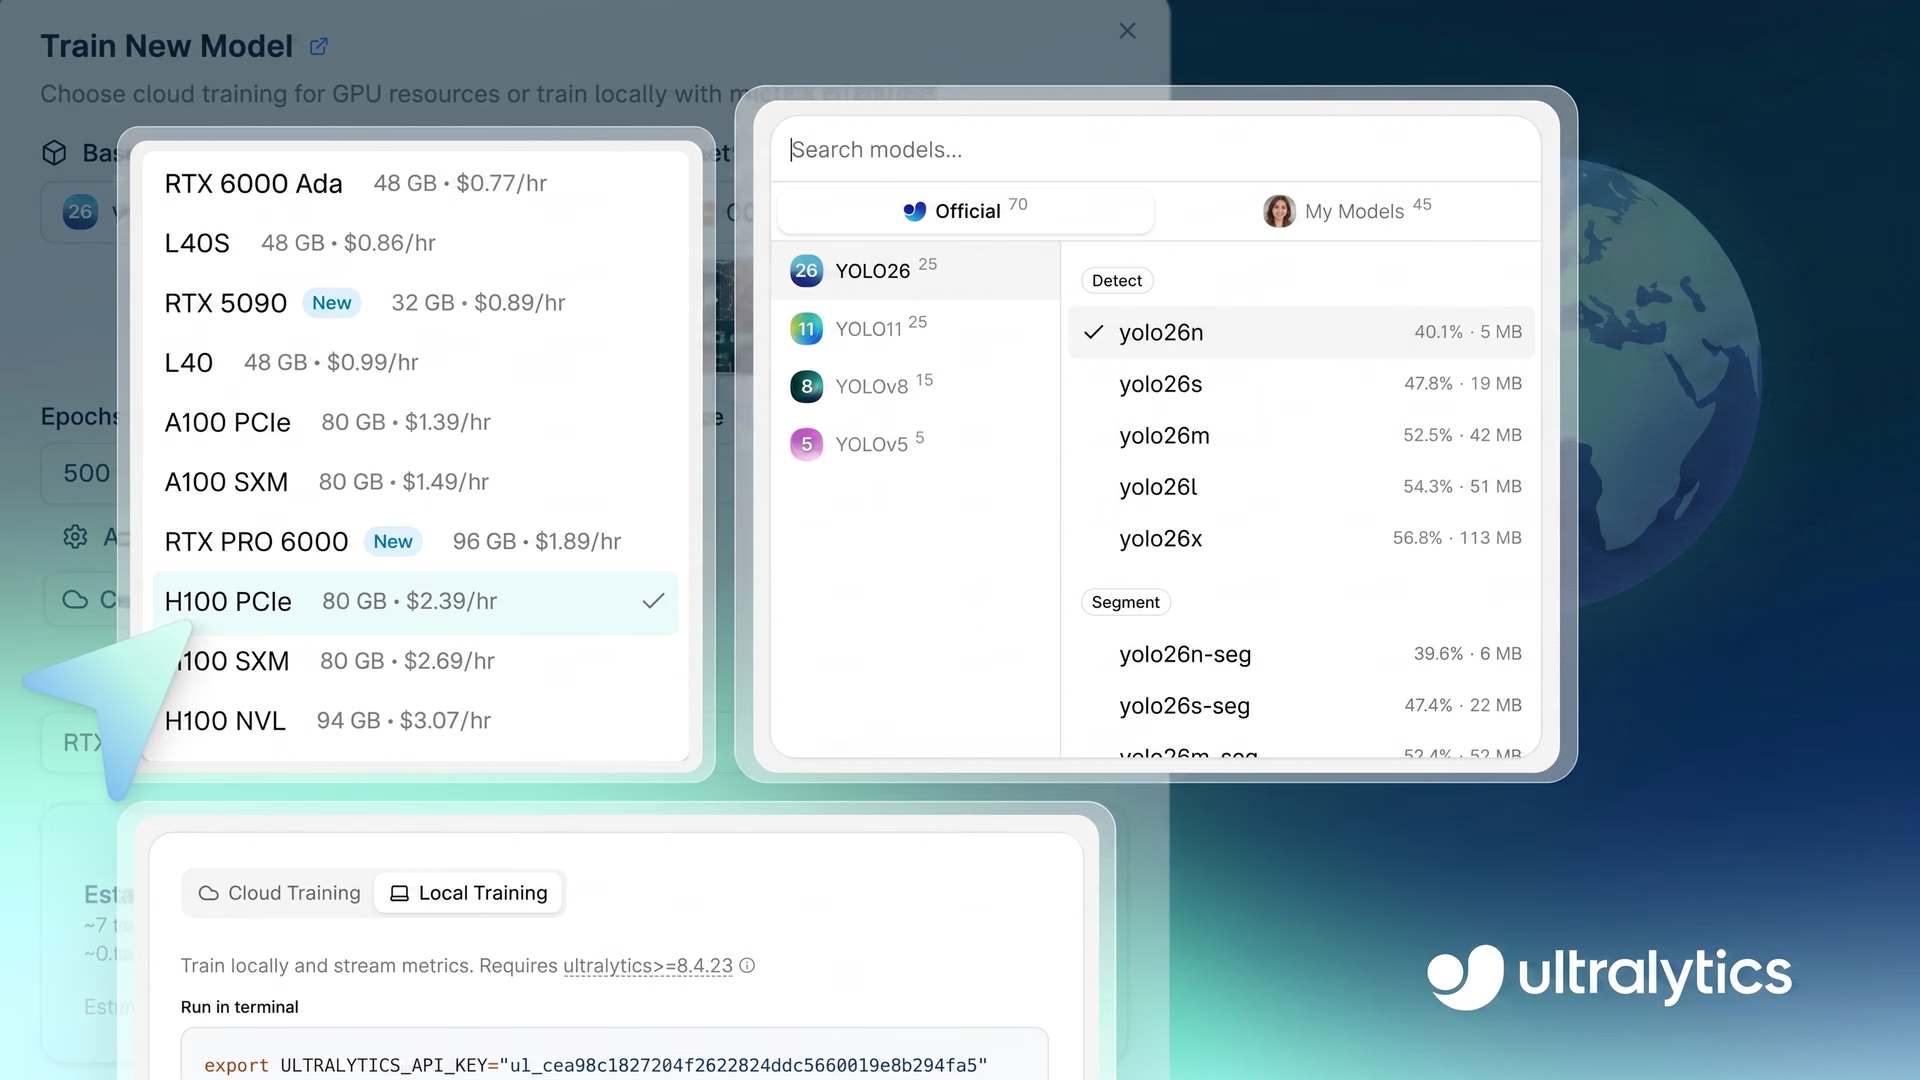
Fig. 1. Aperçu de l’entraînement de modèles dans Ultralytics Platform (Source)
Dans cet article, nous allons voir comment Ultralytics Platform rationalise l’entraînement des modèles et pourquoi elle peut te donner un avantage dans tes projets d’IA pour la vision. Commençons !
Les modèles de vision par ordinateur apprennent à partir des données grâce à l’entraînement des modèles#
Avant d’examiner le fonctionnement de l’entraînement des modèles sur Ultralytics Platform, prenons un peu de recul pour voir ce qu’est l’entraînement d’un modèle et ce qu’il implique.
L’entraînement d’un modèle est le processus par lequel un modèle de vision par ordinateur apprend à interpréter des données visuelles. Il analyse des images ou des vidéos et ajuste progressivement ses paramètres internes afin d’effectuer avec précision des tâches de vision comme la détection d’objets, la classification d’images et la segmentation d’instances. Au fil du temps, le modèle s’améliore en apprenant directement les motifs présents dans les données qu’il observe.
La qualité de l’entraînement dépend fortement des jeux de données. Tu peux considérer un jeu de données comme un ensemble de cartes mémoire qu’un enseignant utiliserait pour former un élève, chaque exemple aidant le modèle à apprendre ce qu’il doit rechercher.
Un jeu de données de vision par ordinateur typique comprend des images, généralement dans des formats comme JPG ou PNG, ainsi que des annotations qui décrivent le contenu de chaque image. Ces annotations, souvent stockées dans des fichiers JSON ou TXT, fournissent les labels et le contexte dont le modèle a besoin pour apprendre efficacement.
Mais l’entraînement ne consiste pas simplement à fournir des données à un modèle. Il comprend plusieurs étapes clés, de la préparation du jeu de données à la sélection du modèle approprié et à la configuration du processus d’entraînement. Examinons maintenant quelques-unes de ces étapes plus en détail.
Comment les jeux de données sont préparés#
Tu pourrais penser qu’une fois le jeu de données à ta disposition, tu peux immédiatement commencer à entraîner un modèle, mais tu dois d’abord suivre quelques étapes, comme diviser le jeu de données.
En général, un jeu de données est divisé en trois parties : l’ensemble d’entraînement, l’ensemble de validation et l’ensemble de test. Les images d’entraînement servent à apprendre au modèle les motifs présents dans les données, tandis que l’ensemble de validation aide à surveiller et à affiner les performances pendant l’entraînement.
L’ensemble de test est utilisé à la fin pour évaluer les performances du modèle sur des données entièrement nouvelles et jamais vues. Cette organisation permet de vérifier que le modèle ne se contente pas de mémoriser les données, mais qu’il peut aussi généraliser à des situations réelles.
Sélectionner le modèle adapté à l’entraînement#
Une autre étape importante avant l’entraînement consiste à choisir le modèle que tu veux utiliser. Dans de nombreux cas, cela signifie sélectionner un modèle pré-entraîné. Les modèles Ultralytics YOLO, par exemple, sont déjà entraînés sur de grands jeux de données et ont appris des motifs visuels généraux, ce qui en fait un excellent point de départ.
L’utilisation de ces modèles est un exemple d’apprentissage par transfert, qui consiste à s’appuyer sur des connaissances existantes et à adapter le modèle à ta tâche spécifique. Cette approche permet d’accélérer l’entraînement et d’améliorer les résultats, notamment lorsque tu travailles avec peu de données.
Ces modèles existent également dans différentes tailles, chacune offrant un compromis entre vitesse et précision. Les modèles plus petits sont plus rapides et plus efficaces, tandis que les modèles plus grands tendent à fournir une meilleure précision, mais nécessitent davantage de ressources de calcul.
Configurer les paramètres d’entraînement des modèles de vision#
Une fois que tu disposes d’un jeu de données préparé et que tu as sélectionné un modèle, l’étape suivante consiste à configurer la manière dont le modèle apprend.
Un modèle de vision par ordinateur est entraîné à l’aide d’un ensemble de paramètres qui déterminent comment il traite les données, met à jour ses poids et s’améliore au fil du temps. Ces réglages influencent directement la vitesse d’entraînement et la précision finale, ce qui les rend essentiels pour obtenir de bons résultats.
Voici quelques-uns des paramètres d’entraînement les plus couramment utilisés :
- Époques : ce paramètre indique combien de fois le modèle parcourt l’intégralité du jeu de données pendant l’entraînement. Augmenter le nombre d’époques donne au modèle davantage d’occasions d’apprendre les motifs présents dans les données.
- Taille du batch : il s’agit du nombre d’images traitées simultanément lors d’une seule étape d’entraînement. Des batchs plus volumineux peuvent accélérer l’entraînement, mais nécessitent davantage de mémoire.
- Taille des images : elle définit la résolution des images d’entrée utilisées pendant l’entraînement. Des résolutions plus élevées peuvent améliorer la précision de la détection, mais augmentent le coût de calcul.
- Taux d’apprentissage : il s’agit de la vitesse à laquelle le modèle met à jour ses paramètres internes pendant l’entraînement. Des valeurs trop élevées ou trop faibles peuvent rendre l’entraînement instable.
- Optimiseur : il s’agit de l’algorithme chargé de mettre à jour les paramètres du modèle en fonction de l’erreur calculée à chaque itération d’entraînement.
Dans les workflows basés sur Ultralytics YOLO, ces configurations sont généralement définies dans un fichier YAML. Ce fichier indique les chemins des jeux de données, les noms des classes et la manière dont les données sont réparties. Il sert de configuration centrale pour indiquer au modèle comment interpréter le jeu de données.
Des workflows fragmentés à une expérience unifiée avec Ultralytics Platform#
Nous venons de présenter certaines des étapes clés de l’entraînement d’un modèle de vision par ordinateur, de la préparation des jeux de données à la sélection d’un modèle et à la configuration des paramètres d’entraînement. En pratique, le processus va souvent plus loin : il comprend le suivi des expériences, la comparaison de plusieurs exécutions d’entraînement et l’amélioration continue des modèles au fil du temps.
Ces étapes sont rarement gérées au même endroit. Les jeux de données peuvent être préparés dans un outil, les exécutions d’entraînement réalisées dans un autre environnement et le suivi des expériences géré séparément. À mesure que les projets grandissent, cette fragmentation ajoute de la complexité, ralentit les itérations et rend l’organisation globale plus difficile.
Ultralytics Platform élimine cette complexité en regroupant l’ensemble du workflow d’entraînement dans un seul environnement. Au lieu de passer d’un outil à l’autre, tu peux gérer les jeux de données, configurer l’entraînement, exécuter des expériences et surveiller les résultats au même endroit.
Voyons maintenant comment Ultralytics Platform rend l’entraînement des modèles plus intelligent.
Options d’entraînement prises en charge par Ultralytics Platform#
Dans les applications du monde réel, l’entraînement d’un modèle de vision par ordinateur nécessite souvent des environnements flexibles. Selon la taille de ton jeu de données, la complexité du modèle et le matériel disponible, tu peux choisir d’exécuter l’entraînement dans le cloud, sur une machine locale ou dans des environnements de notebooks externes.
Ultralytics Platform prend en charge les options d’entraînement suivantes pour répondre à ces besoins :
- Entraînement dans le cloud : l’entraînement s’exécute sur des unités de traitement graphique (GPUs) cloud gérées par Ultralytics. Cette option est idéale pour les jeux de données volumineux ou les modèles plus complexes qui nécessitent d’importantes ressources de calcul.
- Entraînement local : cette option utilise le matériel disponible sur ta machine et convient parfaitement aux expérimentations rapides, aux tests de configurations ou aux jeux de données plus petits. Pour les workloads plus évolutifs, l’entraînement peut également être exécuté dans ton propre environnement cloud, comme AWS ou GCP.
- Google Colab : avec Ultralytics Platform, tu peux exécuter l’entraînement dans l’environnement de notebook hébergé de Google Colab, ce qui permet un workflow flexible dans le navigateur, sans configurer de machine locale.
Explorer l’entraînement dans le cloud sur Ultralytics Platform#
Pour les projets de vision par ordinateur, entraîner des modèles en local ou dans des environnements de notebooks n’est pas toujours facile.
Par exemple, avec l’entraînement local, les performances dépendent entièrement de ton matériel, ce qui peut limiter la puissance de calcul et ralentir les expérimentations. Les GPUs sont essentiels pour un entraînement efficace, mais toutes les configurations n’y donnent pas accès de manière fiable.
Les environnements de notebooks comme Google Colab offrent une alternative en fournissant des GPUs dans le cloud, mais les sessions sont souvent temporaires et peuvent interrompre les longues exécutions d’entraînement. À mesure que les jeux de données grandissent et que les workflows se complexifient, ces limites peuvent rapidement devenir des goulots d’étranglement, rendant l’entraînement plus lent et moins fiable.
Ultralytics Platform répond à ce problème grâce à son option d’entraînement dans le cloud. Elle fournit un environnement prêt à l’emploi dans lequel les dépendances Python et les frameworks comme PyTorch sont préconfigurés, ce qui te permet de commencer l’entraînement sans configuration supplémentaire.
Depuis un seul tableau de bord, tu peux lancer des tâches d’entraînement et suivre leur progression en temps réel. Tu peux ainsi te concentrer plus facilement sur l’amélioration de tes modèles plutôt que sur la gestion de l’infrastructure.
Voyons maintenant comment commencer un entraînement dans le cloud sur Ultralytics Platform.
Étape 1 : sélectionner un modèle de base#
La première étape consiste à choisir un modèle de base pour ton exécution d’entraînement. Tu peux sélectionner un modèle Ultralytics YOLO pré-entraîné, cloner un modèle de la communauté ou importer tes propres poids pré-entraînés pour répondre à des besoins spécifiques.
La plateforme prend en charge tous les modèles Ultralytics YOLO, notamment Ultralytics YOLO26, Ultralytics YOLO11, Ultralytics YOLOv8 et Ultralytics YOLOv5, chacun étant disponible dans différentes variantes de taille, comme nano (n), small (s), medium (m), large (l) et extra-large (x). Les différentes variantes offrant un compromis entre vitesse et précision, tu peux choisir un modèle adapté à tes exigences en matière de performances et de calcul.
Ces modèles prennent en charge diverses tâches de vision par ordinateur que les utilisateurs d’Ultralytics YOLO connaissent déjà, notamment la détection d’objets, la segmentation d’instances, la classification d’images, la détection de boîtes englobantes orientées (OBB) et l’estimation de pose.
Si tu as des besoins spécifiques, tu peux également importer tes propres poids de modèle pré-entraîné. Tu peux ainsi poursuivre l’entraînement ou affiner un modèle existant, comme un détecteur d’objets, directement sur la plateforme au lieu de repartir de zéro. C’est particulièrement utile si tu as déjà entraîné un modèle ailleurs ou si tu veux l’adapter à un cas d’usage plus précis.
Étape 2 : sélectionner un jeu de données#
L’étape suivante consiste à sélectionner un jeu de données pour l’entraînement. Sur Ultralytics Platform, tu peux utiliser des jeux de données existants comme le jeu de données COCO, cloner des jeux de données de la communauté ou importer ton propre jeu de données personnalisé, adapté à ton application spécifique.
La plateforme prend en charge les formats d’annotation courants comme Ultralytics YOLO et COCO. Elle peut également gérer l’importation d’images brutes si tu prévois d’annoter des données personnalisées directement sur la plateforme.
Une fois importés, les jeux de données sont automatiquement traités : validation, normalisation, analyse des labels et génération de statistiques. Tu bénéficies ainsi immédiatement d’une visibilité sur tes données, notamment sur la répartition des classes et la structure du jeu de données, et tu peux vérifier que tout est prêt pour l’entraînement.
Les jeux de données sont également automatiquement associés aux exécutions d’entraînement, ce qui te permet de suivre les données utilisées pour chaque modèle et de maintenir la cohérence entre les expériences.
Étape 3 : configurer les paramètres d’entraînement#
Après avoir choisi le jeu de données, tu peux configurer les paramètres d’entraînement qui contrôlent la manière dont le modèle apprend. Ils comprennent le nombre d’époques, la taille du batch, la taille des images et le nom de l’exécution utilisé dans le journal d’entraînement. Beaucoup de ces paramètres influencent à la fois la durée d’entraînement et les performances finales du modèle.
Pour un entraînement plus contrôlé, la plateforme te permet également d’ajuster des paramètres avancés comme le taux d’apprentissage, le type d’optimiseur, les réglages d’augmentation des couleurs et d’autres options d’entraînement. Ces réglages peuvent affiner le processus d’entraînement afin d’améliorer la précision et la stabilité du modèle.
Étape 4 : sélectionner un GPU#
Tu peux ensuite sélectionner la configuration GPU pour ton exécution d’entraînement. Le choix du GPU approprié dépend de facteurs comme la taille du jeu de données, la taille du batch, la résolution des images et la complexité du modèle. Trouver le bon équilibre permet de conserver un entraînement efficace sans utiliser plus de ressources de calcul que nécessaire.
Ultralytics Platform propose 22 options de GPU offrant différents niveaux de VRAM (mémoire d’un GPU) et de puissance de calcul, pour prendre en charge aussi bien les petites tâches que les workloads à grande échelle.
Tu peux ainsi adapter le matériel à tes besoins spécifiques, que tu entraînes des modèles légers ou que tu travailles avec des jeux de données volumineux et complexes. Pour en savoir plus, consulte la liste des GPUs disponibles sur la page de documentation sur l’entraînement de Platform d’Ultralytics.
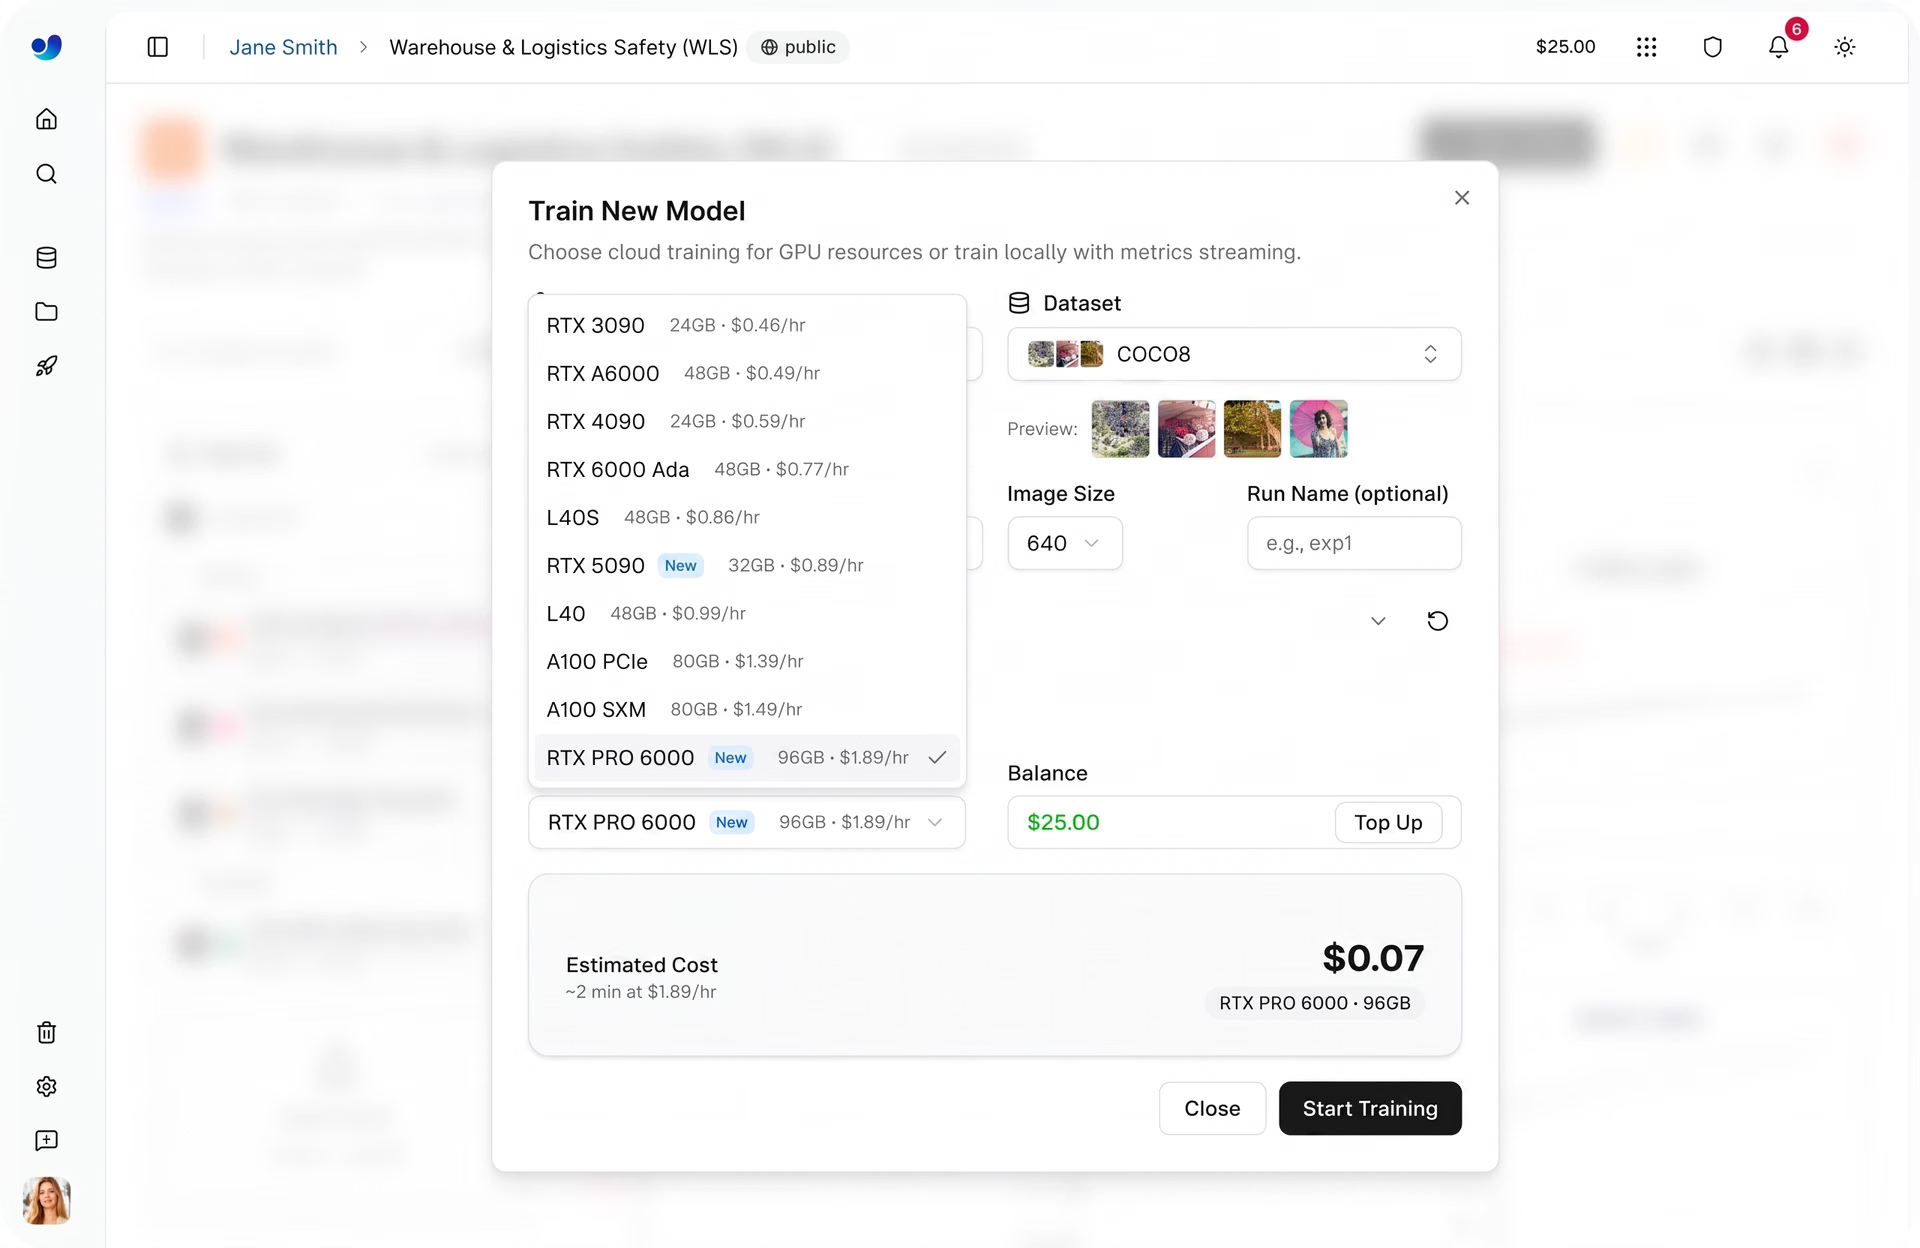
Fig. 2. Quelques-unes des options de GPU proposées par Ultralytics Platform (Source)
Étape 5 : démarrer l’entraînement dans le cloud#
Une fois le modèle, le jeu de données, les paramètres d’entraînement et l’option de calcul sélectionnés, lancer une exécution d’entraînement est rapide. Depuis le tableau de bord, tu peux démarrer l’entraînement d’un simple clic, puis la plateforme se charge du reste en initialisant l’environnement et en exécutant la tâche sur le GPU sélectionné.
Dès que l’entraînement commence, tu peux suivre sa progression directement sur la plateforme. L’onglet Train offre une visibilité en temps réel sur les métriques clés, notamment les métriques de performance, les courbes de perte, l’utilisation du système et les journaux d’entraînement en direct.
Pour en savoir plus sur l’entraînement en local ou l’utilisation de Google Colab avec Ultralytics Platform, tu peux consulter d’autres tutoriels dans la documentation Platform officielle d’Ultralytics.
Évaluer et comparer les modèles sur Ultralytics Platform#
Une fois l’entraînement terminé, l’étape suivante consiste à évaluer les performances de ton modèle. Sur Ultralytics Platform, tu peux comparer plusieurs exécutions d’entraînement au sein d’un projet, ce qui te donne une vision claire des performances de chaque expérience.
Lors du développement de modèles, l’entraînement est souvent répété plusieurs fois avec différents réglages, comme une modification du taux d’apprentissage, de la taille du batch ou de la taille du modèle, afin d’améliorer les résultats. Chacune de ces exécutions produit un modèle légèrement différent, d’où l’importance de les comparer.
Les projets servent de centre de regroupement pour organiser les modèles et les expériences. Tu peux suivre la progression, examiner les résultats et rester concentré sans passer d’un outil ou d’une vue à l’autre.
Depuis cette vue unifiée, tu peux également analyser des métriques de performance clés comme la précision, le rappel et la mAP (précision moyenne) afin de comprendre les performances de ton modèle pour les différentes classes. Tu peux aussi comparer les exécutions d’entraînement côte à côte pour identifier les configurations qui offrent les meilleurs résultats.
Pour compléter ces métriques, tu peux utiliser l’onglet Predict afin de tester rapidement les modèles entraînés sur des images ou des données d’exemple, ce qui t’aide à valider visuellement les performances et à détecter d’éventuels problèmes.
Grâce à ces informations, tu peux sélectionner le modèle le plus performant, généralement enregistré comme checkpoint « best.pt », puis passer à l’étape suivante : poursuivre l’évaluation, utiliser le modèle pour effectuer des inférences ou déployer le modèle via la plateforme.
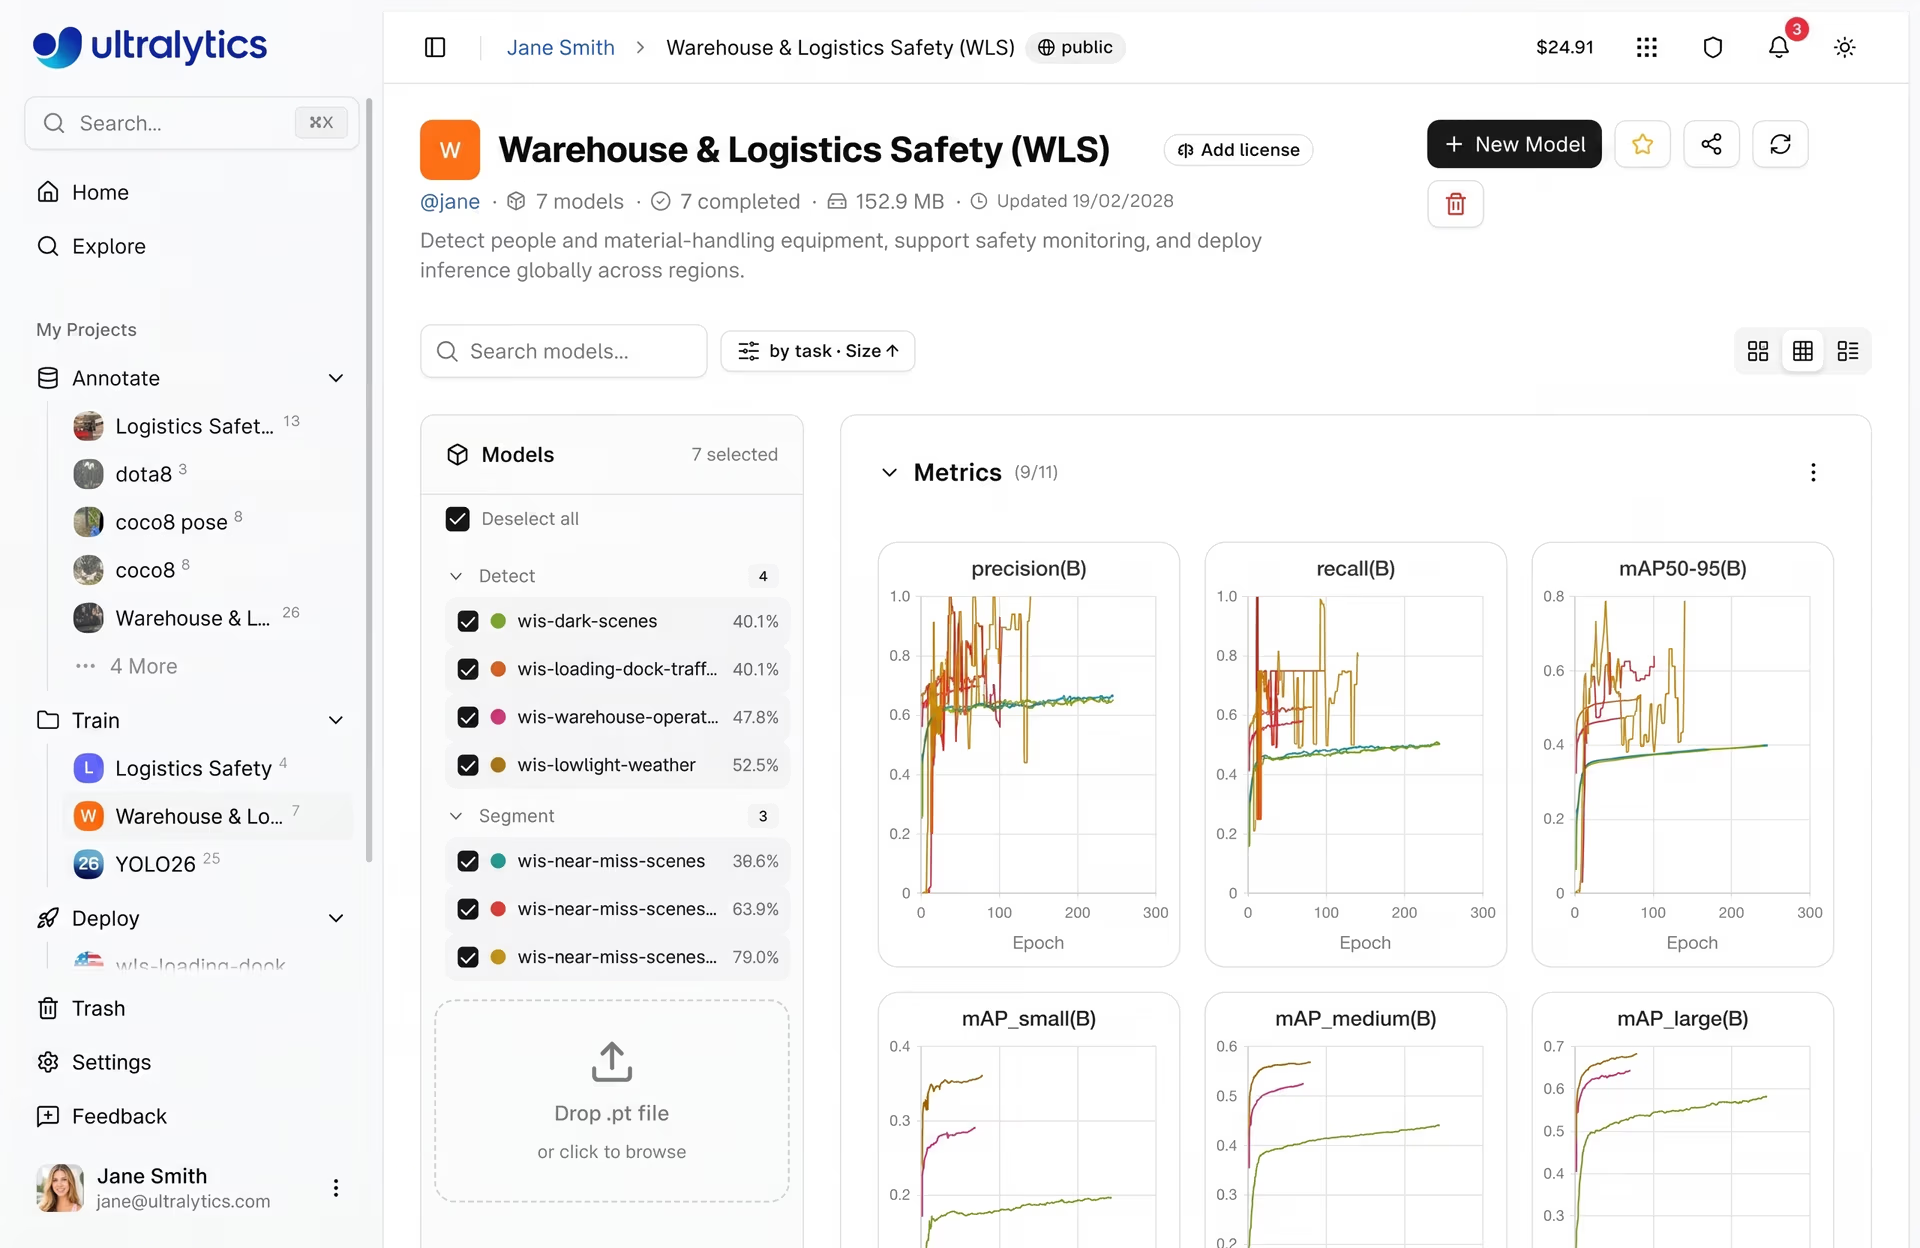
Fig. 3. Exemple d’affichage des métriques sur Ultralytics Platform (Source)
Estimer le coût de l’entraînement dans Ultralytics Platform#
L’entraînement de modèles de détection d’objets dans le cloud entraîne des coûts de calcul, en particulier lorsque tu utilises des GPUs hautes performances. Pour simplifier cette gestion, Ultralytics Platform fournit une estimation des coûts avant le début de l’entraînement.
Cette estimation te donne une visibilité claire sur l’utilisation prévue, ce qui t’aide à planifier les workloads, à gérer les budgets et à éviter les dépenses inattendues avant de lancer une tâche d’entraînement. Voici comment vérifier les coûts estimés avant de commencer l’entraînement.
Comment le temps d’entraînement est estimé#
Pour estimer précisément le coût, la plateforme calcule d’abord la durée d’une seule époque d’entraînement. Celle-ci dépend de facteurs comme la taille du jeu de données, la taille du modèle, la résolution des images, la taille du batch et la vitesse du GPU sélectionné.
À partir de ces éléments, elle détermine le temps estimé par époque et l’extrapole à l’ensemble de l’exécution d’entraînement. La durée totale est calculée en additionnant le temps de toutes les époques et un léger temps de démarrage.
Ce temps supplémentaire couvre des tâches comme l’initialisation de l’environnement, le chargement des jeux de données et la préparation du GPU, afin que l’estimation reflète l’intégralité du processus d’entraînement, et pas seulement la boucle d’entraînement.
Comment le coût de l’entraînement est calculé#
Une fois la durée totale de l’entraînement estimée, la plateforme la convertit en coût à l’aide du tarif horaire du GPU sélectionné.
En combinant la durée de l’entraînement et le tarif du GPU, nous pouvons obtenir une estimation claire du coût de l’exécution avant même son démarrage.
Connaître les coûts à l’avance permet d’ajuster facilement ta configuration, par exemple en réglant les paramètres d’entraînement ou en sélectionnant un autre GPU, afin de mieux équilibrer performances et coûts.
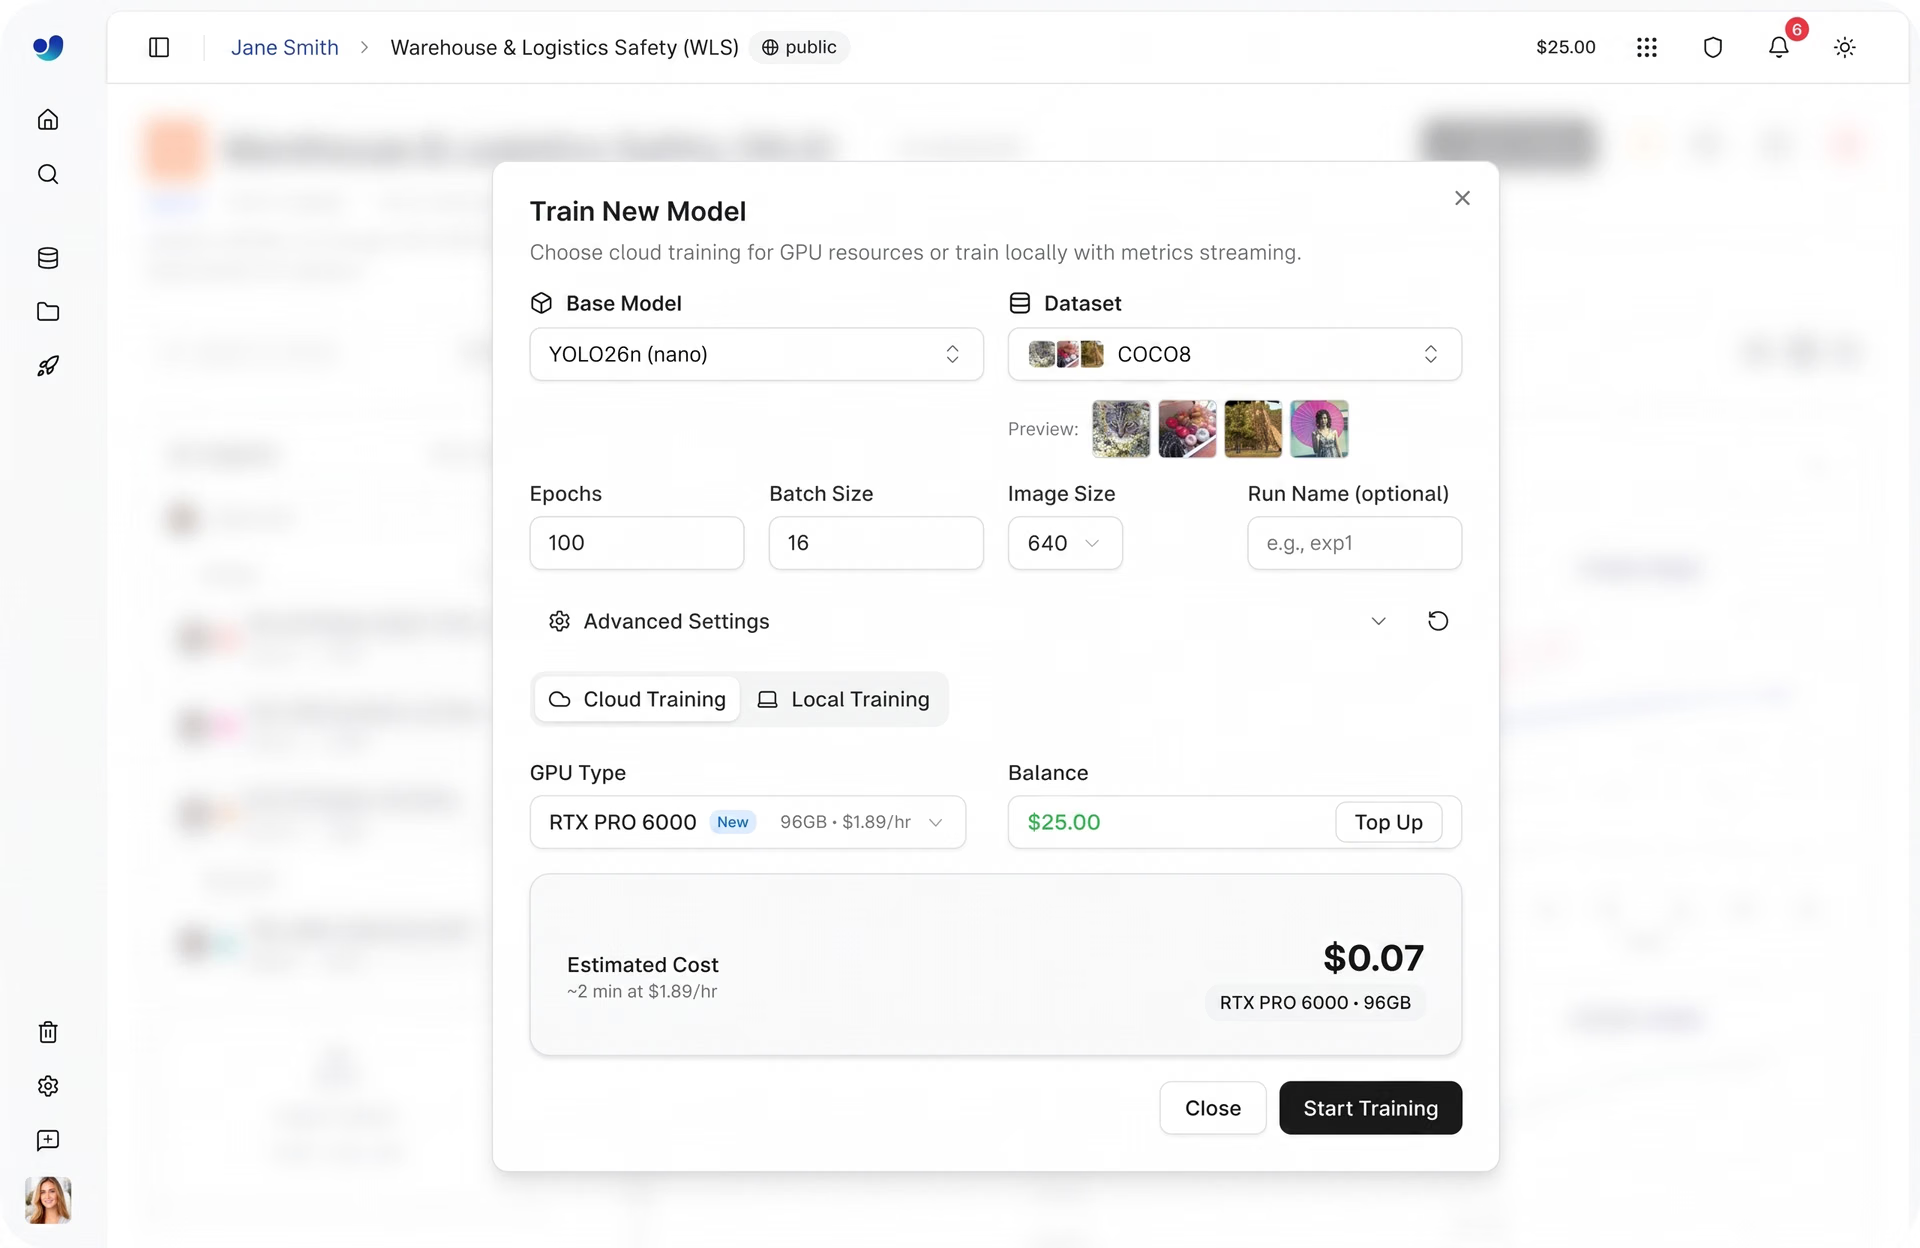
Fig. 4. Configuration de l’entraînement d’un modèle et estimation des coûts dans Ultralytics Platform (Source)
Principaux avantages d’Ultralytics Platform pour l’entraînement des modèles#
Jusqu’à présent, nous avons présenté les principales étapes de l’entraînement des modèles de vision par ordinateur et la manière dont elles s’articulent sur Ultralytics Platform.
Au-delà de ces fonctionnalités essentielles, d’autres capacités améliorent le workflow d’entraînement. Voici un aperçu de certains des principaux avantages d’Ultralytics Platform pour l’entraînement des modèles :
- Reproductibilité intégrée des expériences : chaque exécution d’entraînement est automatiquement journalisée avec sa configuration complète, notamment le modèle, le jeu de données, les paramètres et la configuration de calcul. Tu peux ainsi revisiter facilement les expériences et reproduire les résultats de manière fiable.
- Suivi de l'entraînement au fil du temps : Au lieu de consulter uniquement les résultats finaux, tu peux suivre l'évolution des performances au fil des époques, ce qui t'aide à mieux comprendre le comportement du modèle pendant l'entraînement.
- Réduction de la charge opérationnelle : En gérant en arrière-plan la configuration de l'environnement, la gestion des dépendances et l'infrastructure, la plateforme te permet de te concentrer davantage sur le développement du modèle et moins sur la configuration.
- Organisation centralisée des expériences : Les projets constituent un espace unique pour gérer les modèles, les jeux de données et les exécutions d'entraînement, ce qui aide à garder les expériences structurées à mesure que les workflows gagnent en complexité.
Points clés à retenir#
L'entraînement est l'une des étapes les plus importantes du cycle de vie d'un modèle de machine learning. Il détermine avec quelle précision un modèle peut reconnaître et interpréter des données visuelles.
En regroupant la configuration des données d'entraînement, le suivi, la comparaison des expériences et l'estimation des coûts dans un même environnement, Ultralytics Platform simplifie la création de modèles de vision par ordinateur performants et leur préparation au déploiement.
Consulte notre communauté grandissante et notre dépôt GitHub pour en savoir plus sur la vision par ordinateur. Si tu souhaites créer des solutions de vision, découvre nos options de licence. Explore nos pages de solutions pour en savoir plus sur les avantages de la vision par ordinateur dans l'industrie manufacturière et de l'IA dans l'agriculture.








