Ultralytics PlatformでビジョンAIのトレーニングに使うクラウドGPUの選び方
データセットのサイズ、モデルの複雑さ、コストなどを考慮し、Ultralytics Platformでのコンピュータービジョンのトレーニングに最適なクラウドGPUを選ぶ方法をご紹介します。
先月、データセット管理からモデルのトレーニング、デプロイまで、コンピュータービジョンのワークフロー全体を効率化するエンドツーエンドの環境、Ultralytics Platformを発表しました。Ultralytics Platformは、ビジョンAIモデルの構築と拡張に必要なすべてを、統合された単一の環境にまとめています。
このワークフローの重要な部分がモデルのトレーニングです。トレーニングではニューラルネットワークがデータからパターンを学習して正確な予測を行いますが、適切な計算リソースを利用できることが重要な役割を果たします。以前の記事では、Ultralytics Platformがクラウドのグラフィックスプロセッシングユニット(GPU)を活用したモデルのトレーニングをどのようにサポートし、ユーザーがローカルインフラを管理せずにコンピュータービジョンモデルをトレーニングできるかを紹介しました。
強力なNVIDIA GPUをオンデマンドで利用することで、学生やスタートアップから研究者、大規模組織まで、幅広いユーザーがこれまで以上に効率的にAIワークロードを実行できます。クラウドトレーニングは簡単に始められますが、適切なGPUの選択には、データセットのサイズ、モデルの複雑さ、コストなどを考慮する必要があります。
現在は、コスト効率に優れたRTX GPUから高性能なNVIDIA H100、次世代のBlackwellハードウェアまで幅広い選択肢があり、適切な構成を選ぶことがモデル開発とコストの両方に大きな影響を与えます。
この記事では、Ultralytics Platformでのコンピュータービジョン向けクラウドGPUトレーニングと、ワークロードに適したハードウェアの選び方を見ていきます。それでは始めましょう。
Ultralytics Platformでのクラウドトレーニングの概要#
Ultralytics Platformでのクラウドトレーニングに適したGPUの選び方を詳しく見る前に、まずクラウドトレーニングの仕組みを確認しましょう。
クラウドGPUトレーニングとは何ですか?#
クラウドGPUトレーニングとは、自分のローカルハードウェアやワークステーションに頼るのではなく、クラウドコンピューティング環境でホストされているGPUを使って機械学習モデルやディープラーニングモデルをトレーニングすることです。Ultralytics Platformでは、強力なGPUをオンデマンドで利用してトレーニングジョブをリモート実行できるため、自分で環境を用意する必要がありません。
これにより、ワークロードに応じてリソースを簡単に拡張できます。システムの性能に制限されることなく、必要に応じてより強力なGPUを選んだり、容量を増やしたりできます。必要に応じて拡張または縮小できる、リモートデータセンターの強力なマシン、つまりノードを利用するようなものと考えることができます。
また、高価なハードウェアのセットアップや保守も不要になります。GPUの購入、ドライバーのインストール、互換性の問題への対処も必要ありません。
Ultralytics Platformは、リソースのプロビジョニングから環境のセットアップ、オーケストレーション、トレーニングジョブの実行まで、すべてをマネージドクラウドサービスで処理するため、モデルのトレーニング、実験、改善に集中できます。
Ultralytics Platformでのモデルのトレーニング方法#
Ultralytics PlatformでのGPUアクセラレーション対応トレーニングのワークフローはシンプルです。まず、いくつかの方法でデータセットを取り込めます。
独自のデータをアップロードしたり、プラットフォームで利用できる公開データセットを使ったり、コミュニティが共有したデータセットを複製して既存の作業を基に構築したりできます。データセットを複製するとワークスペースにコピーが作成され、元のデータセットを変更せずに編集や拡張を行えます。
データセットを選択したら、画像とアノテーションを確認・整理し、適切な構造になっていることを確かめます。プラットフォームにはアノテーションツールも組み込まれており、物体検出、セグメンテーション、分類などのタスク用にデータへラベルを付けたり、AI支援機能で作業を効率化したりできます。
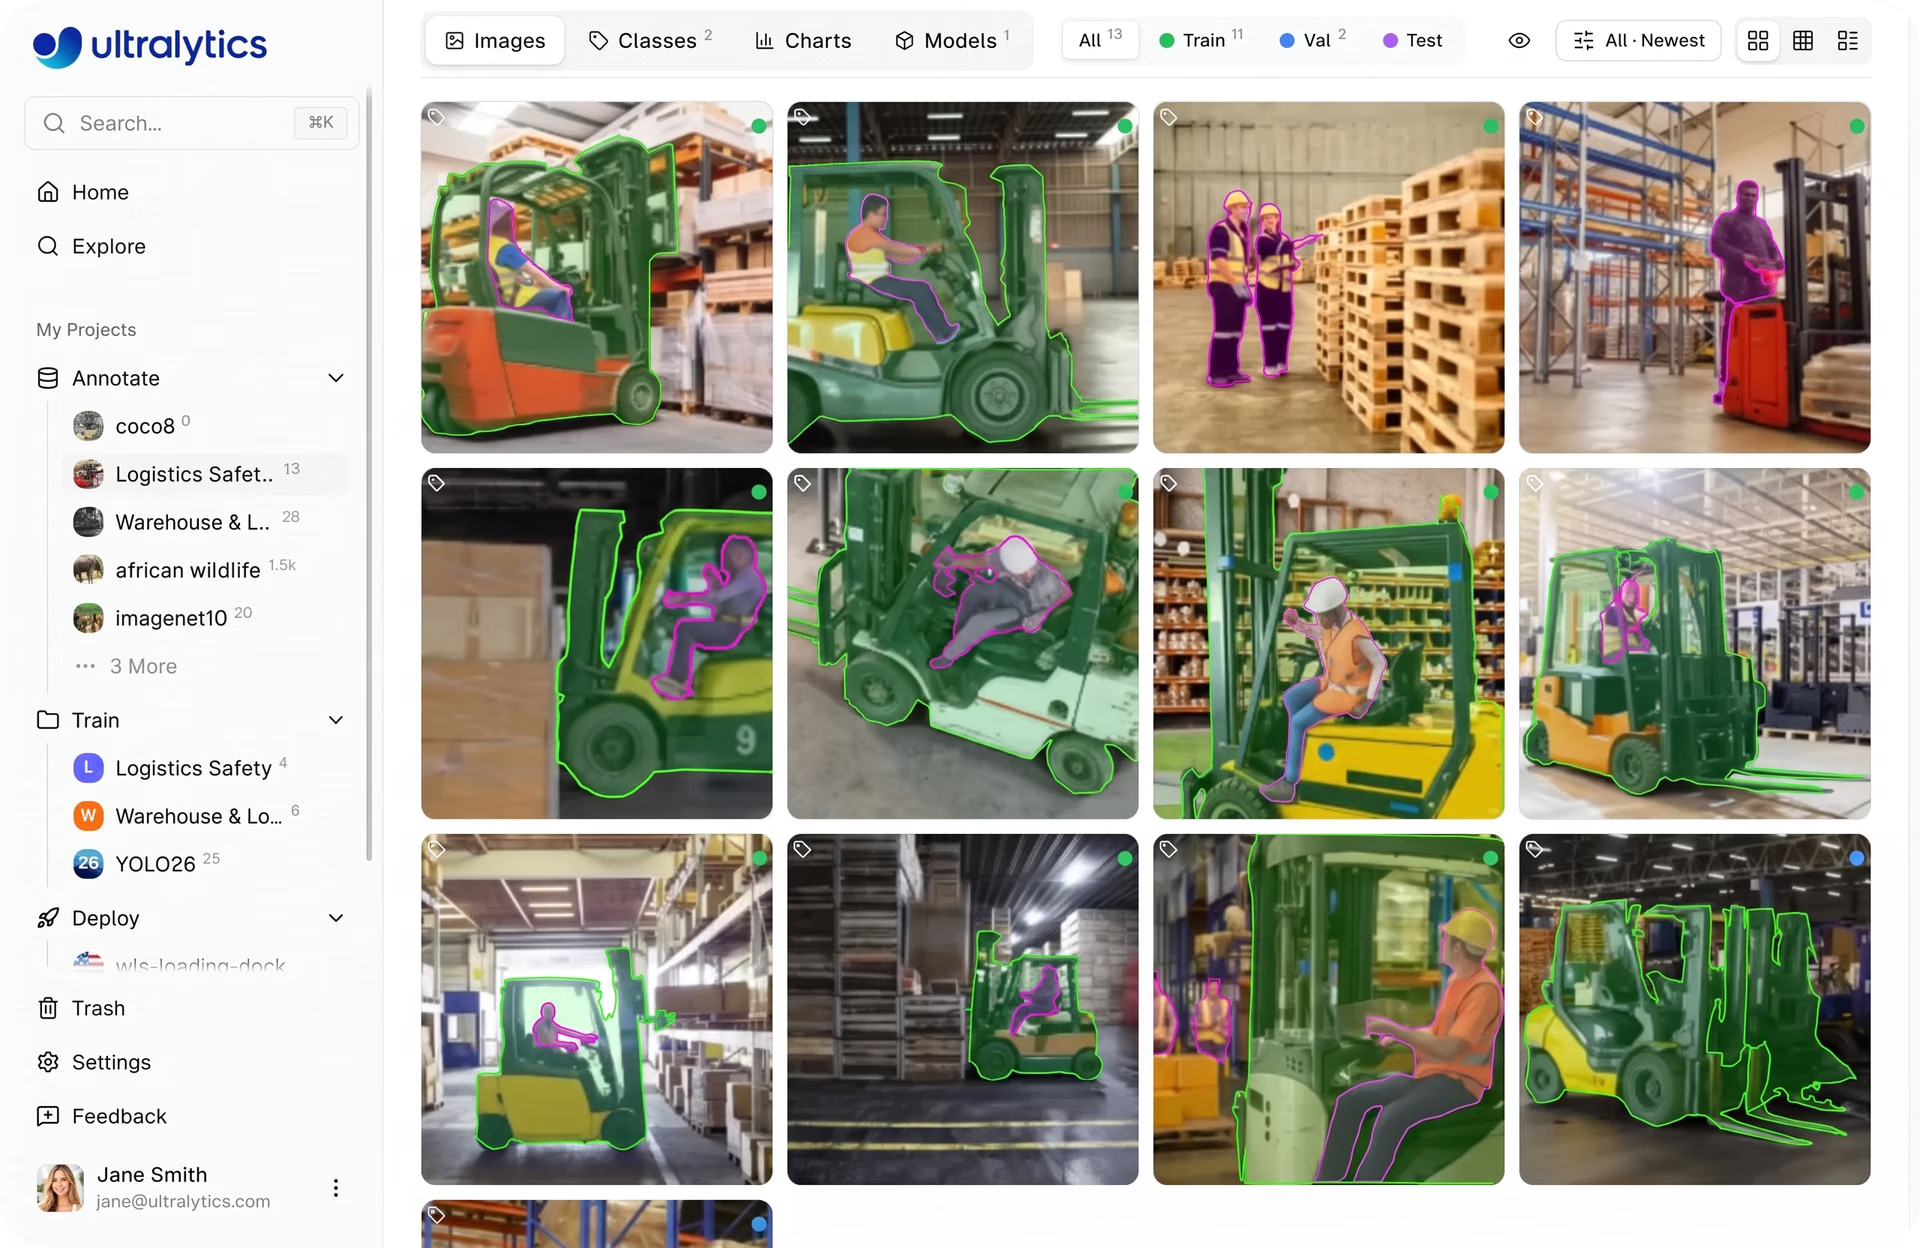
図1. Ultralytics Platform内でのデータセットの表示(出典)
次に、トレーニング実行を管理するためのプロジェクトを選択または作成できます。プロジェクトを使うと、モデルの整理と比較、性能指標の追跡、関連する実験の一元管理ができます。
そこからクラウドトレーニングに進み、モデルを選択してパラメーターを設定し、性能と予算のニーズに合わせてGPUを選びます。基盤となるクラウドインフラはプラットフォームが管理します。
選択したGPUインスタンスをプロビジョニングし、データセットを準備して、クラウド上でトレーニングジョブを実行します。トレーニングの進行中は、セットアップ、CUDA環境、PyTorchやTensorFlowなどのフレームワーク、ハードウェアを管理する必要なく、指標、ログ、システム性能をリアルタイムで監視できます。
Ultralytics PlatformのGPUトレーニングの主な機能#
Ultralytics PlatformのクラウドGPUトレーニングの主な機能をご紹介します。
- ワンクリックトレーニング: 最小限のセットアップでトレーニングジョブを開始し、複雑な設定を行わずにデータセットからモデルのトレーニングへすばやく進めます。
- オンデマンドGPU: ニーズに応じてさまざまなGPUオプションから選択でき、長期契約を結ばずに必要に応じてリソースを拡張できます。
- リアルタイム監視: ライブチャートとログでトレーニングの進捗を追跡し、GPU使用率やメモリなどのシステム指標をリアルタイムで確認できます。
- 自動チェックポイント: トレーニングの進捗は定期的に保存されるため、必要に応じて作業を簡単に再開または復元できます。
- 簡単なデプロイ: トレーニングが完了したら、共有推論API、専用エンドポイント、または外部システムで使用するためのエクスポートを通じて、トレーニング済みモデルをデプロイし、アプリケーションやワークフローで利用できます。これらのデプロイ方法により低レイテンシの推論が可能になり、動画分析、自動化システム、対話型AIソリューションなどのリアルタイムアプリケーションを実現できます。
Ultralytics Platformで利用できる各種クラウドGPU#
プラットフォームでのトレーニングの仕組みを確認したところで、利用可能なさまざまなGPUオプションを見ていきましょう。選択するGPUは、モデルのトレーニング速度、性能、コストに影響します。
Ultralytics Platformでは幅広いGPUを利用できます。RTX 2000 AdaやRTX A4500などの選択肢から、RTX 4000 Ada、RTX A5000、RTX 3090、RTX A6000などを経て、RTX 4090やRTX PRO 6000などのより強力な選択肢まで揃っています。
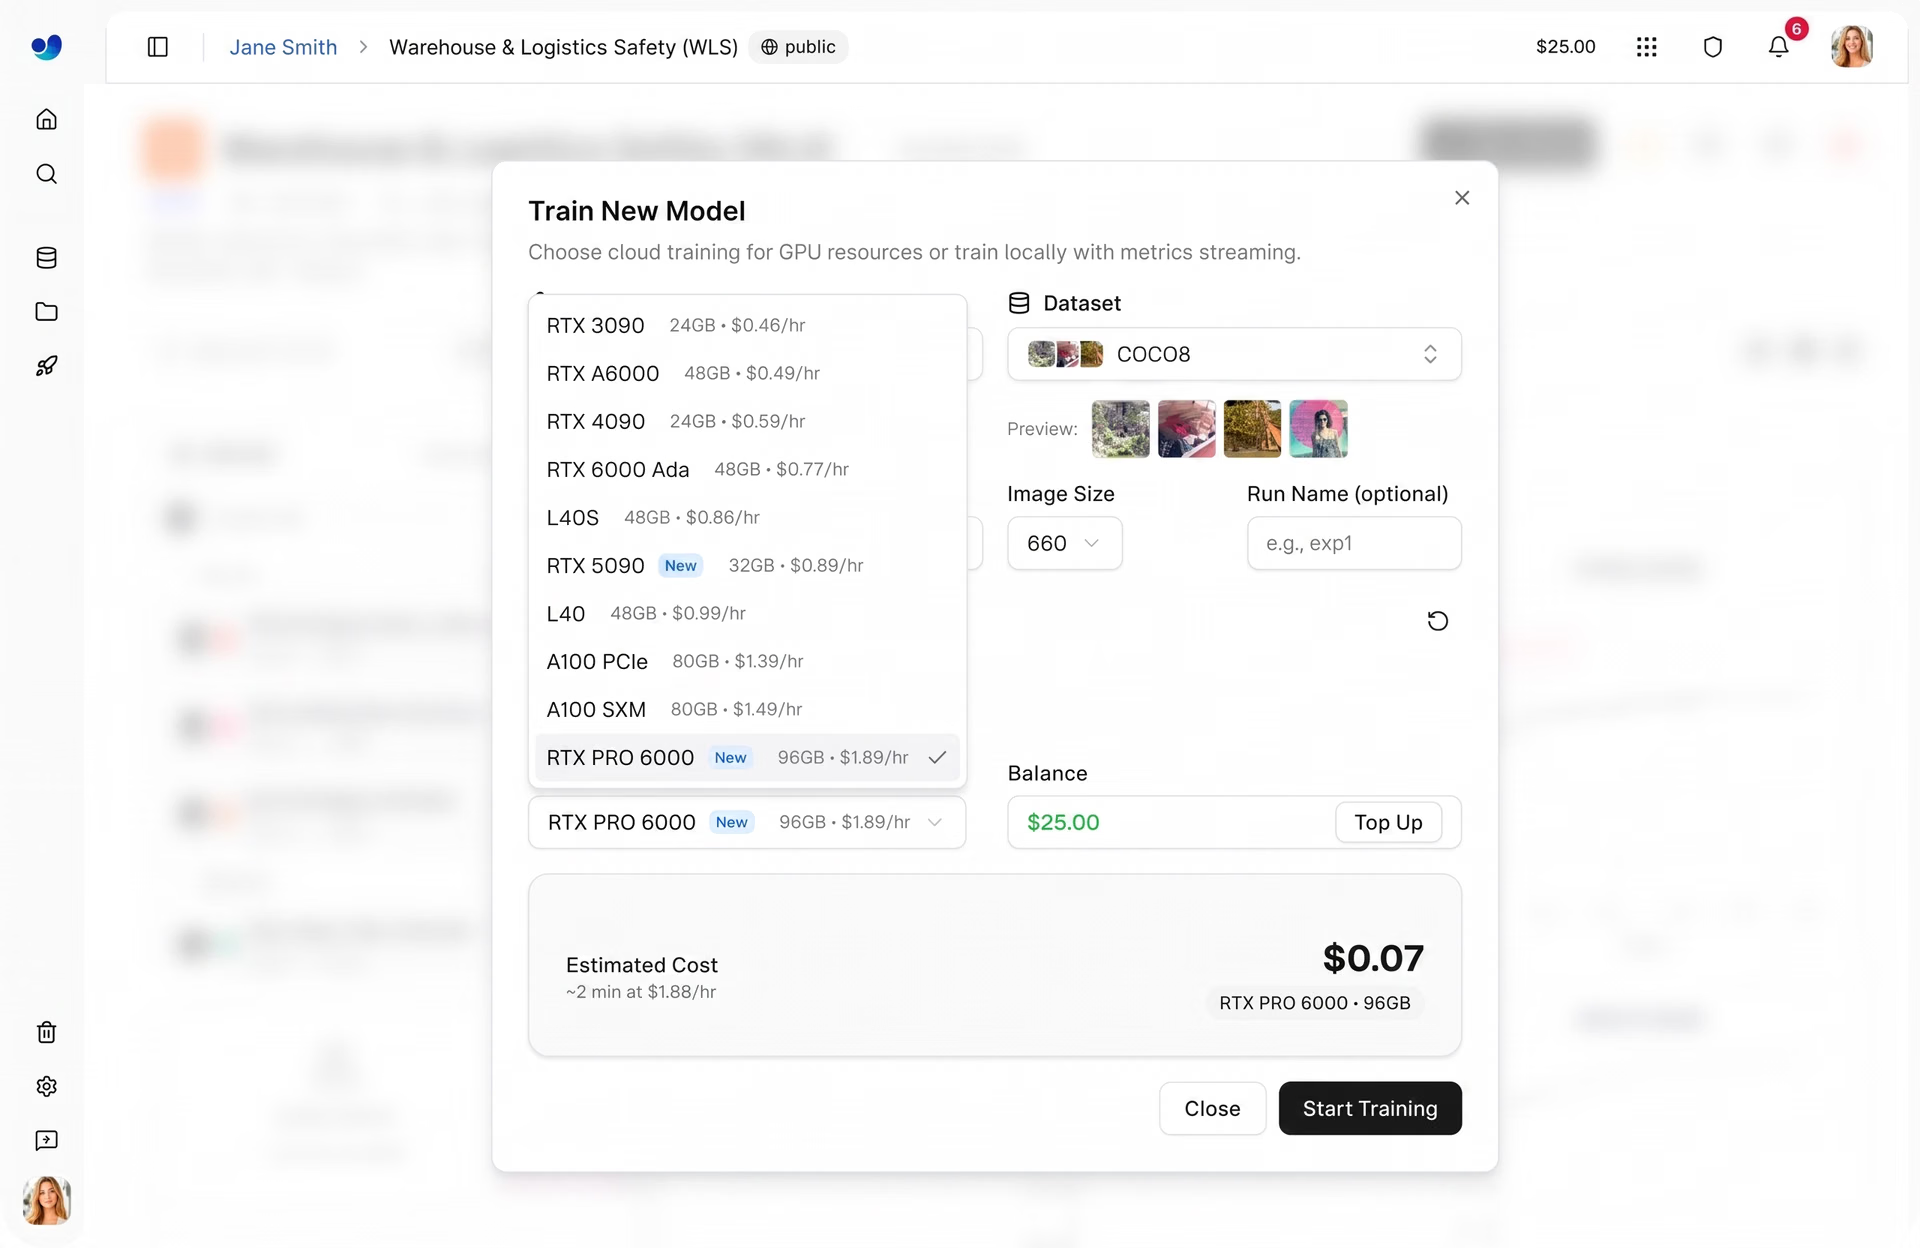
図2. Ultralytics PlatformがサポートするさまざまなGPUオプションの例(出典)
ほとんどのユーザーにとって、RTX PRO 6000はバランスの取れた標準的な選択肢です。細かな調整をあまり必要とせず、さまざまなワークロードで安定した性能を発揮します。RTX 4090も人気のある選択肢で、価格に対して高い性能を提供します。
簡単な実験、プロトタイピング、軽量なデータセットを扱うといった小規模なタスクには、RTX 2000 AdaやRTX A4500などのGPUが適しています。ワークロードが大きくなるにつれて、RTX 4000 Ada、RTX A5000、RTX 3090などが一般的なトレーニングでより安定した性能を提供します。
ハイエンドのA100(Ampere)、H100およびH200(Hopper)、B200(Blackwell)などのGPUは、大規模ワークロード向けに設計されています。非常に大規模なモデルのトレーニング、膨大なデータセットの処理、速度と性能が重要なジョブの実行に最適です。
GPUの種類と用途を理解する#
次に、さまざまな種類のGPUを比較し、それぞれがどの用途に適しているかを見ていきましょう。
NVIDIAのRTX GPUは一般にコスト効率が高く、日常的なトレーニング、実験、小〜中規模のワークロードによく使われます。性能と利用しやすさのバランスが取れているため、幅広い用途に適しています。
一方、A100、A40、L40などのGPUは、より負荷の高いワークロードや大規模なトレーニング向けに設計されています。特に大規模なデータセットや複雑なモデルを扱う場合に、高い安定性とスケーラビリティを提供します。
さらにハイエンドのH100やNVIDIAのBlackwellアーキテクチャをベースとするGPUは、より新しいAIハードウェアです。高性能なワークロード向けに設計されており、通常は大規模なトレーニング、高度な研究、時間制約の厳しいタスクに使用されます。
Ultralytics Platformで利用できる幅広いGPUオプションは、さまざまなワークロードに柔軟に対応します。要件に応じて小規模な構成から始め、必要に応じて拡張できます。
プロジェクトに適したクラウドGPUの選び方#
Ultralytics Platformでクラウドトレーニング用のGPUを選ぶ際は、データセットのサイズ、モデルの複雑さ、コストなど、いくつかの要因を考慮する必要があります。それぞれの要因を確認していきましょう。
データセットのサイズに合わせてGPU性能を選ぶ#
GPUを選ぶ主な要因の1つはデータセットのサイズです。データセットのサイズはトレーニング時間と必要な計算リソースに影響します。
通常1,000枚未満の小規模なデータセットであれば、RTX 2000のような軽量GPUで十分なことがよくあります。簡単な実験や短時間のトレーニング実行に適しています。
約1,000〜10,000枚の中規模データセットには、RTX 4090やRTX A6000などのGPUが性能と効率のバランスに優れており、長時間待つことなくスムーズにトレーニングできます。
10,000枚を超える大規模データセットでは、妥当なトレーニング時間を保つために、より強力なハードウェアが必要になる可能性があります。H100 GPUなどは、負荷の高いワークロードの処理や効率的なスケーリングに適しています。
全体として、必要な計算能力と並列処理能力をデータセットのサイズに合わせることが重要です。
モデルのサイズと複雑さに基づいてGPUを選ぶ#
GPUを選ぶうえでもう1つ重要な要因は、ビジョンAIモデルのサイズと複雑さです。モデルのサイズによって必要な計算能力は異なります。
たとえば、小規模なモデルは必要なGPU計算能力が少なく、RTX 2000 Ada、RTX A4500、またはより高速な結果が必要な場合はRTX 4090でも効率的に動作します。こうしたGPUは、簡単な実験、プロトタイピング、単純なタスクに最適で、高い計算コストをかけずにすばやく反復し、アイデアを試せます。
一方、より大規模で複雑なモデルには、大幅に多くのメモリと処理能力が必要です。RTX A6000、RTX PRO 6000、H100などのハイエンドGPUは、こうしたワークロードに適しています。より大きなアーキテクチャに対応してトレーニング時間を短縮し、メモリの問題を防げます。これは高解像度画像、大きなバッチサイズ、より高度なモデル設計を扱う場合に特に重要です。
バッチサイズとGPUメモリの比較#
同様に、バッチサイズもモデルのトレーニングで重要な役割を果たします。バッチサイズとは、1回のステップでモデルが一度に処理するトレーニングサンプルの数です。
バッチサイズを大きくすると、一度により多くのデータを処理できるためトレーニング効率が向上する場合がありますが、より多くのGPUメモリ(VRAM)も必要になります。一般に、メモリ帯域幅の大きいGPUは大きなバッチサイズに対応できますが、メモリの少ないGPUではバッチサイズを小さくする必要があります。
たとえば、RTX A6000、RTX PRO 6000、A100などはメモリ容量が大きいため大きなバッチサイズを容易に処理できますが、RTX 4090やRTX 2000 Adaなどでは、ワークロードに応じてバッチサイズを小さくする必要がある場合があります。
ただし、常に最も大型のGPUが必要とは限りません。ハイエンドGPUは速度と容量を向上させる一方で、コストも高くなります。多くの場合、小型GPUでバッチサイズを調整するほうが効率的です。
最終的には、モデルとデータセットに合わせて、バッチサイズ、利用可能なGPUメモリ、コストの適切なバランスを見つけることが目標です。
トレーニング構成がGPU性能に与える影響#
GPU性能に影響するもう1つの要因は、トレーニング構成です。これには、エポック数、画像サイズ、モデルのトレーニング方法を制御するその他の設定などのパラメーターが含まれます。
たとえば、画像サイズを大きくすると、1ステップあたりの計算量が増加します。その結果、トレーニングが遅くなり、良好な性能を維持するためにより多くの計算能力やメモリが必要になる場合があります。
同様に、エポック数を増やすとトレーニング全体の時間が長くなり、性能の低いハードウェアでは特にその影響が大きくなります。エポックとは、トレーニング中にデータセット全体を1回処理することです。
データ拡張などの手法も、トレーニング中に追加の処理を発生させます。データ拡張では、反転、回転、スケーリングなどの変換を適用してデータの多様性を高め、モデル性能を改善します。モデルのロバスト性を向上できる一方で、トレーニング速度が低下する場合もあります。
一般に、より強力なGPUはこうした増加した負荷を効率的に処理できますが、影響の度合いは全体的な構成とワークロードによって異なります。
コストとトレーニング時間のバランス#
プロジェクト用のGPUを選ぶ際は、トレーニング速度とGPUの料金の間でトレードオフが生じることがよくあります。
Ultralytics Platformでは、トレーニングジョブを開始する前に、コストを簡単に見積もり、把握できます。データセットのサイズ、モデル、GPUなどの構成に基づいて、推定コストとトレーニング時間を事前に確認できます。
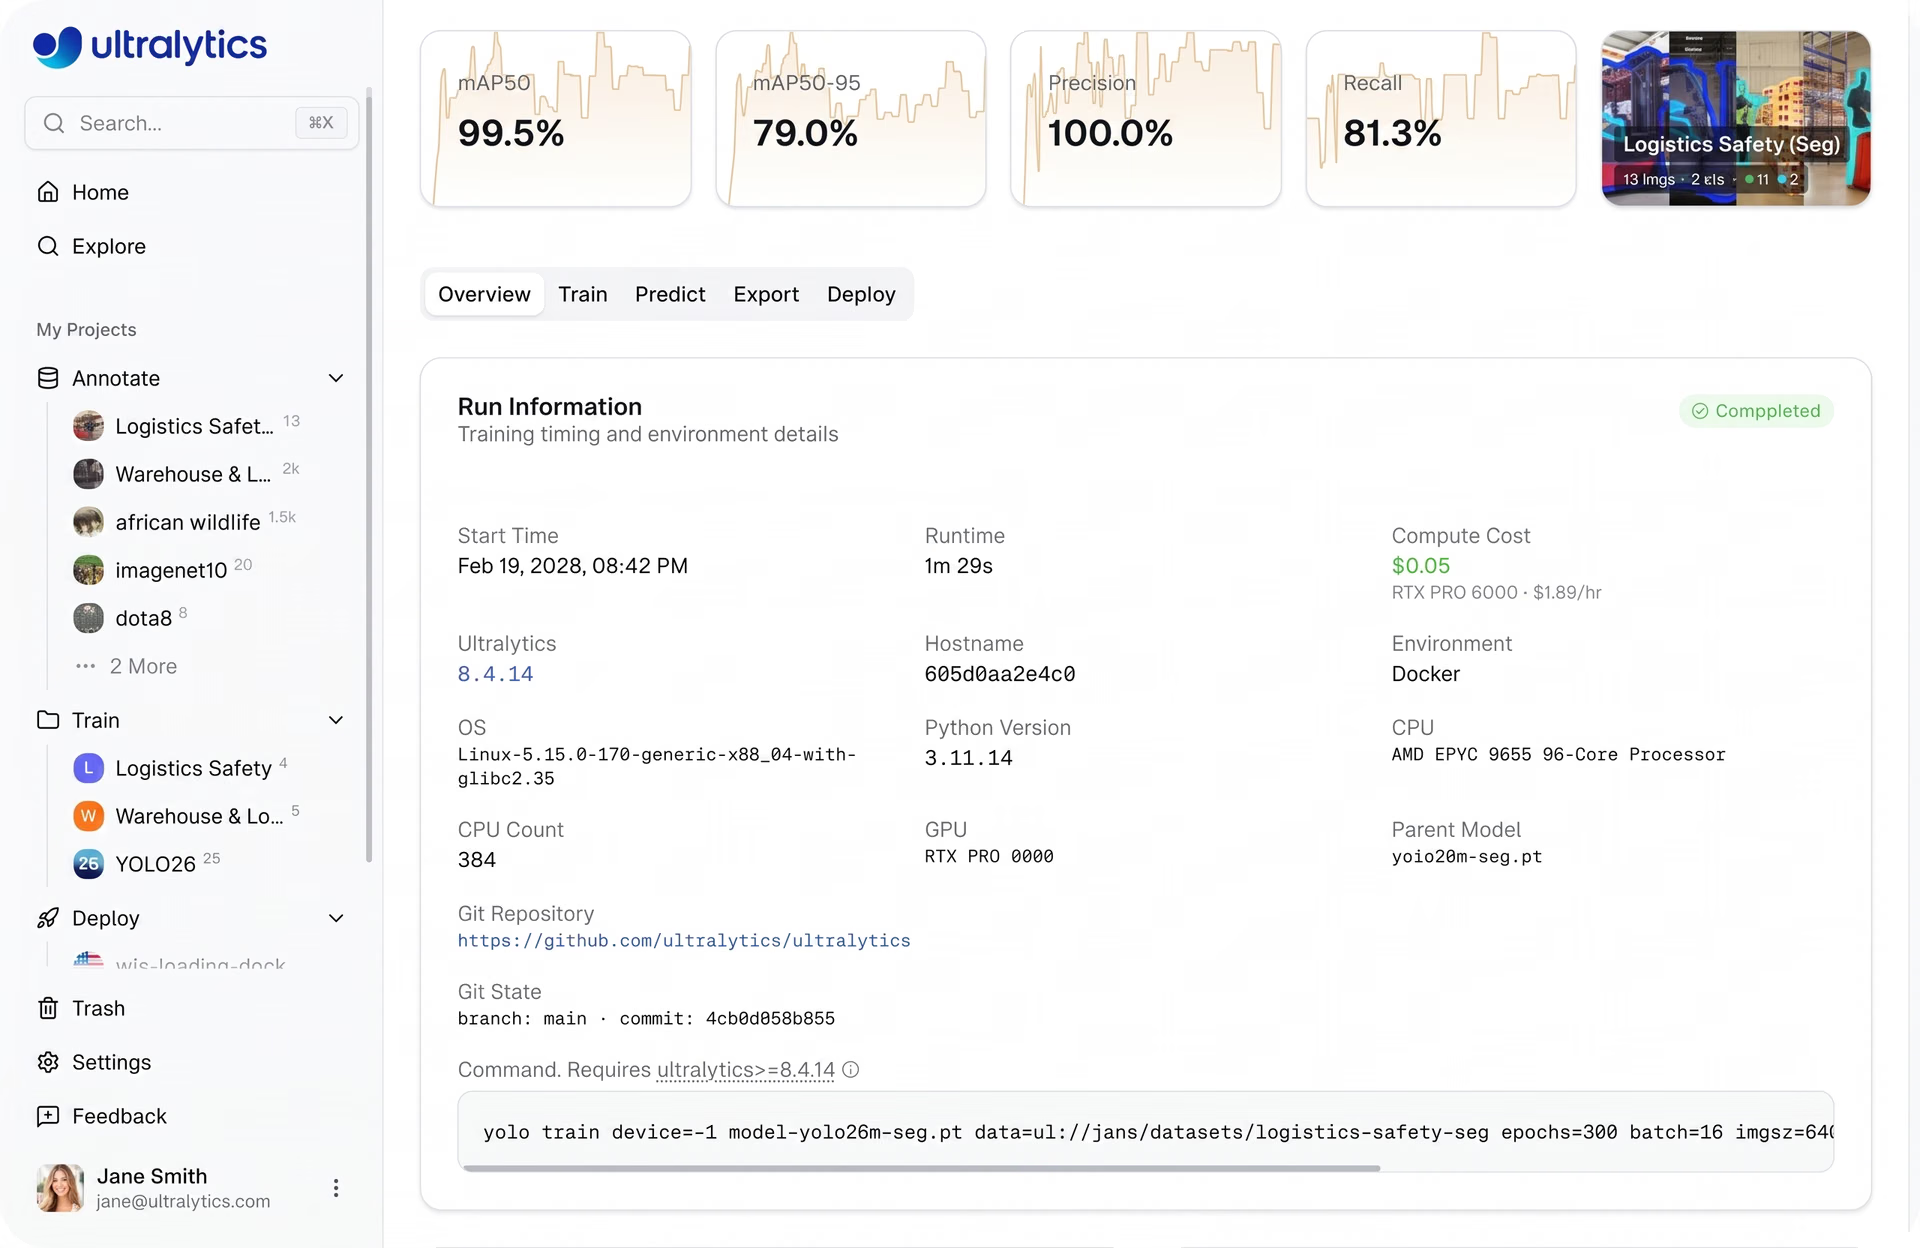
図3. Ultralytics Platformではクラウドコストを簡単に見積もり、把握できます。(出典)
高速なGPUは通常、時間あたりのコストが高くなりますが、トレーニング全体の時間を短縮できます。RTX 4090、RTX PRO 6000、H100などのGPUは、性能が高いため、一般にトレーニングをより短時間で完了できます。
低速なGPUは時間あたりのコストが低い傾向にありますが、トレーニングの完了までに時間がかかります。たとえば、RTX 2000 AdaやRTX A4500などのGPUは、コストの低さを優先する小規模なワークロードや長時間実行するジョブによく使われます。
さらに、H200やB200などの最上位GPUの一部はProプランまたはEnterpriseプランでのみ利用できますが、その他のほとんどのオプションはFreeプランでも利用できます。
コスト最適化戦略を見る#
適切なGPUを選ぶだけでなく、トレーニングコストを抑えるための実践的な方法がいくつかあります。特に効果的なのは、規模を拡大する前に小規模なテスト実行から始めることです。
本格的なトレーニングにすぐ取り掛かるのではなく、まずはエポック数を少なくして、セットアップが想定どおりに動作することを確認してください。これにより、データ、アノテーション、モデル設定をすばやく検証でき、有用な結果が得られない可能性のある実行に時間や計算リソースを費やさずに済みます。
トレーニングの進行中はメトリクスを確認し、性能が頭打ちになったり改善しなくなったりした場合は、早めに実行を停止してください。トレーニング曲線を監視すると、続行するかセットアップを調整するかを判断しやすくなります。
バッチサイズや画像サイズなどのパラメーターを調整することもできます。値を小さくするとメモリと計算リソースの使用量が減るため、設定を変えて試したり、小規模なシミュレーションを実行したりしてから規模を拡大しやすくなります。
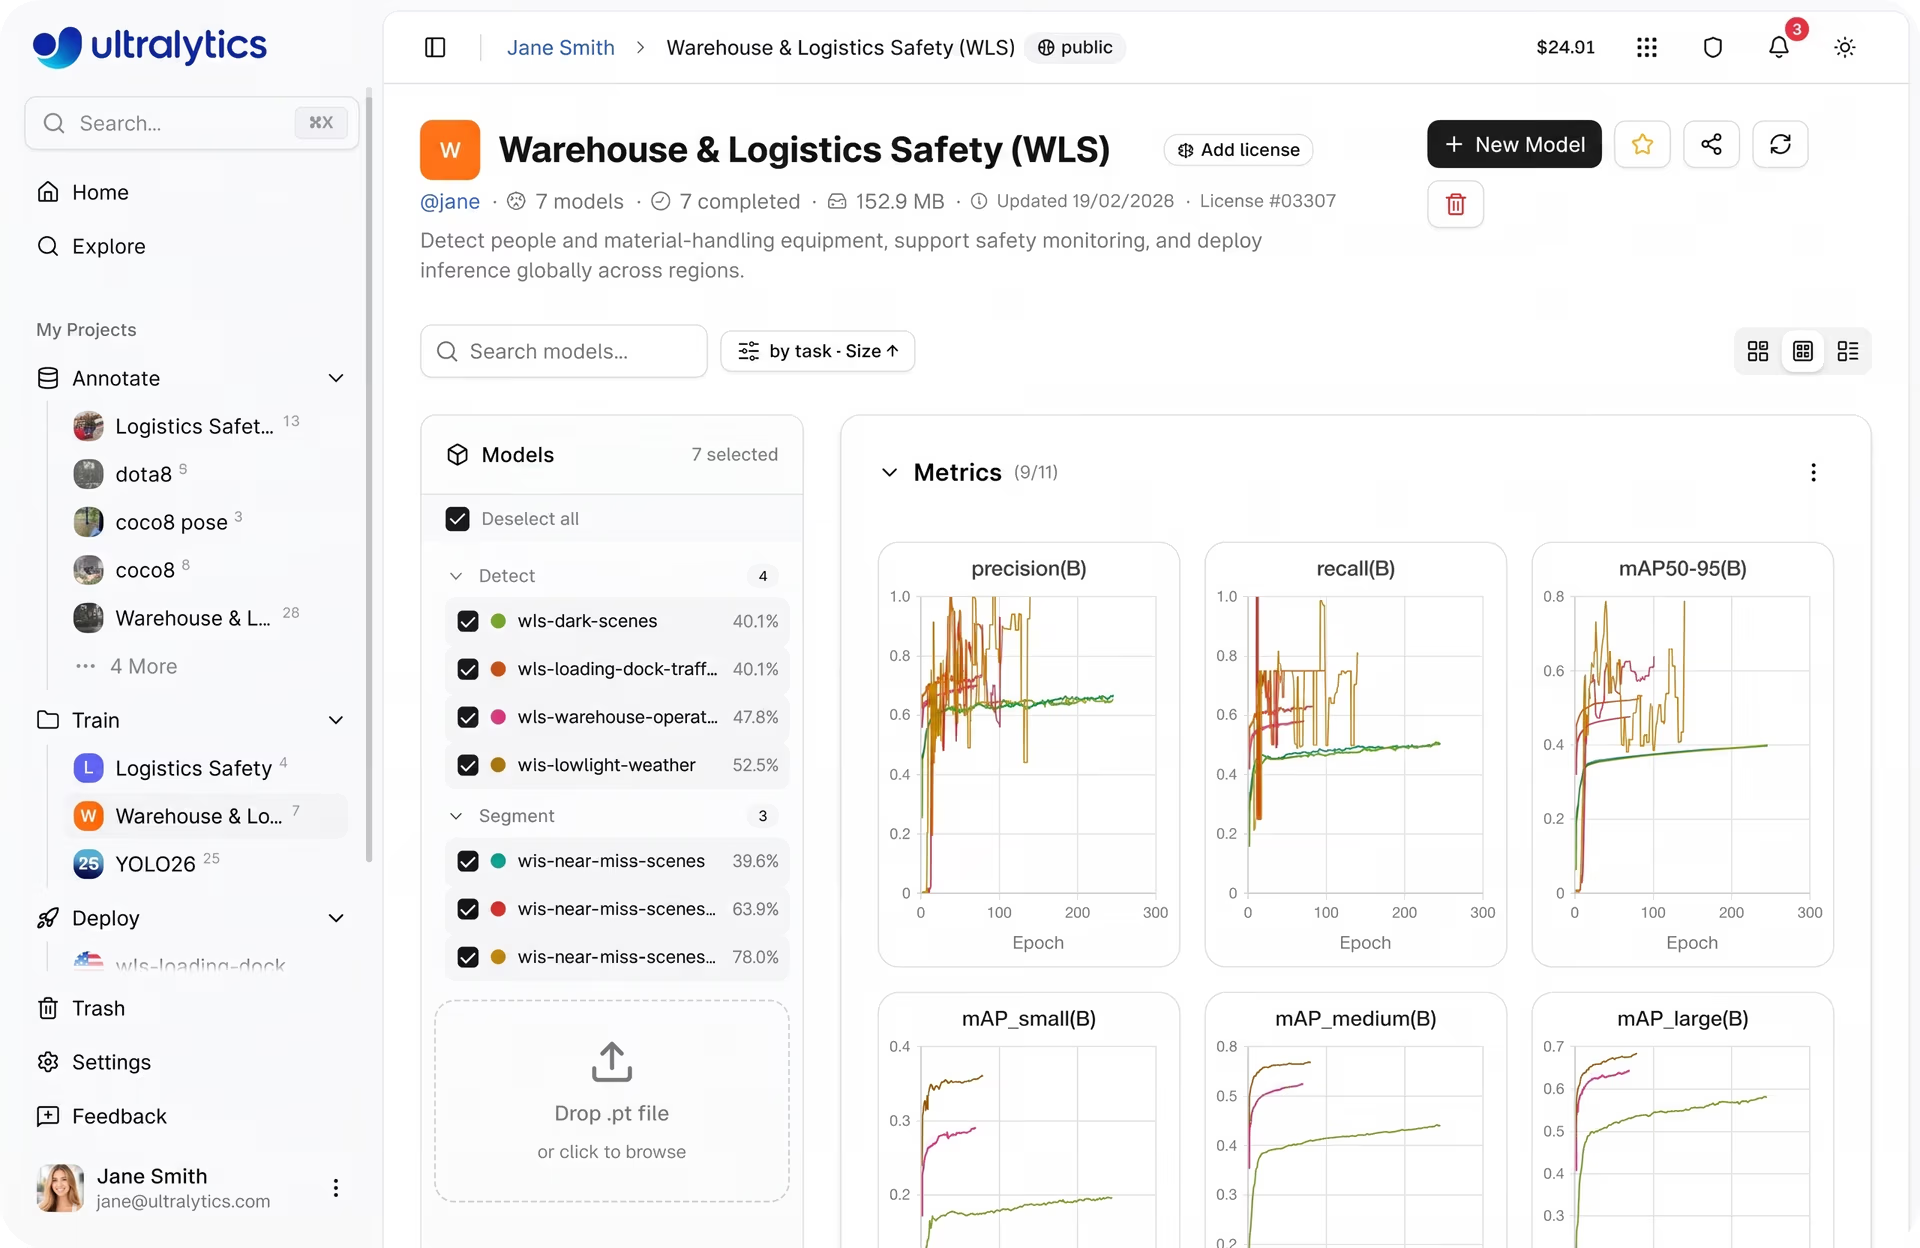
図4. Ultralytics Platformのトレーニングメトリクスの可視化(出典)
さらに、Ultralytics Platformを使うとコスト管理を簡素化できます。組み込みのコスト見積もり機能を利用して、ジョブを開始する前に予想費用を把握できます。
従量課金制のクレジットベースのシステムでは、実際に使用した計算時間分のみをお支払いいただきます。そのため、予算内に収めやすく、トレーニングのセットアップに確信が持てた段階で規模を拡大できます。
コンピュータービジョンのクラウドGPUトレーニングに関するベストプラクティス#
Ultralytics PlatformでクラウドGPUトレーニングを行う際は、次のベストプラクティスを参考にしてください。
- トレーニング前にデータセットを検証する:開始前に、データセットがクリーンで、適切にアノテーションされ、一貫性があることを確認してください。問題を早期に発見することで、計算リソースの浪費を防ぎ、モデルの性能を向上させられます。
- まずは短時間の実験を行う:小規模なテスト実行と少ないエポック数から始め、セットアップを検証してください。長時間で高コストなトレーニングジョブに取り掛かる前に、問題を早期に特定できます。これは、すべてが想定どおりに動作した後に再利用・拡張できるテンプレートを作成するようなものです。
- 主要なメトリクスを監視する:トレーニング中は、loss、mAP、precision、recallなどのメトリクスを追跡してください。これらのメトリクスはモデル性能を評価するベンチマークとなり、調整または停止するタイミングの判断に役立ちます。
- データ処理パイプラインを効率化する:データの読み込みと前処理を効率的に行えるようにしてください。これらの処理はCPUリソースを使用するため、ボトルネックとなり、トレーニング全体の性能に影響する可能性があります。
- 組み込みツールを活用する:グラフ、コンソールログ、システムメトリクスを使用してトレーニングをリアルタイムで監視し、すばやく適切な判断を行ってください。
重要なポイント#
Ultralytics Platformでコンピュータービジョンに適したクラウドGPUを選ぶには、データセットのサイズ、モデルの複雑さ、トレーニング設定など、ワークロードを理解することが重要です。クラウドインフラストラクチャと仮想マシンを基盤とするさまざまなGPUオプションから、バランスの取れた構成で始め、モデルのトレーニングやファインチューニングのニーズに応じて拡張できます。適切なハードウェアと、監視やコスト管理などの優れたプラクティスを組み合わせることで、高性能コンピューティングの柔軟性を最大限に活用しながら、最先端の人工知能モデルを効率よくトレーニングできます。
コンピュータービジョンについて詳しく知るには、活発なコミュニティとGitHubリポジトリをご覧ください。ビジョンソリューションの構築をお考えの場合は、ライセンスオプションをご確認ください。ソリューションのページでは、製造業におけるコンピュータービジョンと農業におけるAIのメリットについてご紹介しています。









