Ultralytics PlatformがAIを使ってアノテーションを自動化する方法
Ultralytics PlatformがAIを活用してアノテーションを自動化し、大規模なデータセットを管理し、一貫性を高め、コンピュータービジョン開発を加速する方法をご紹介します。
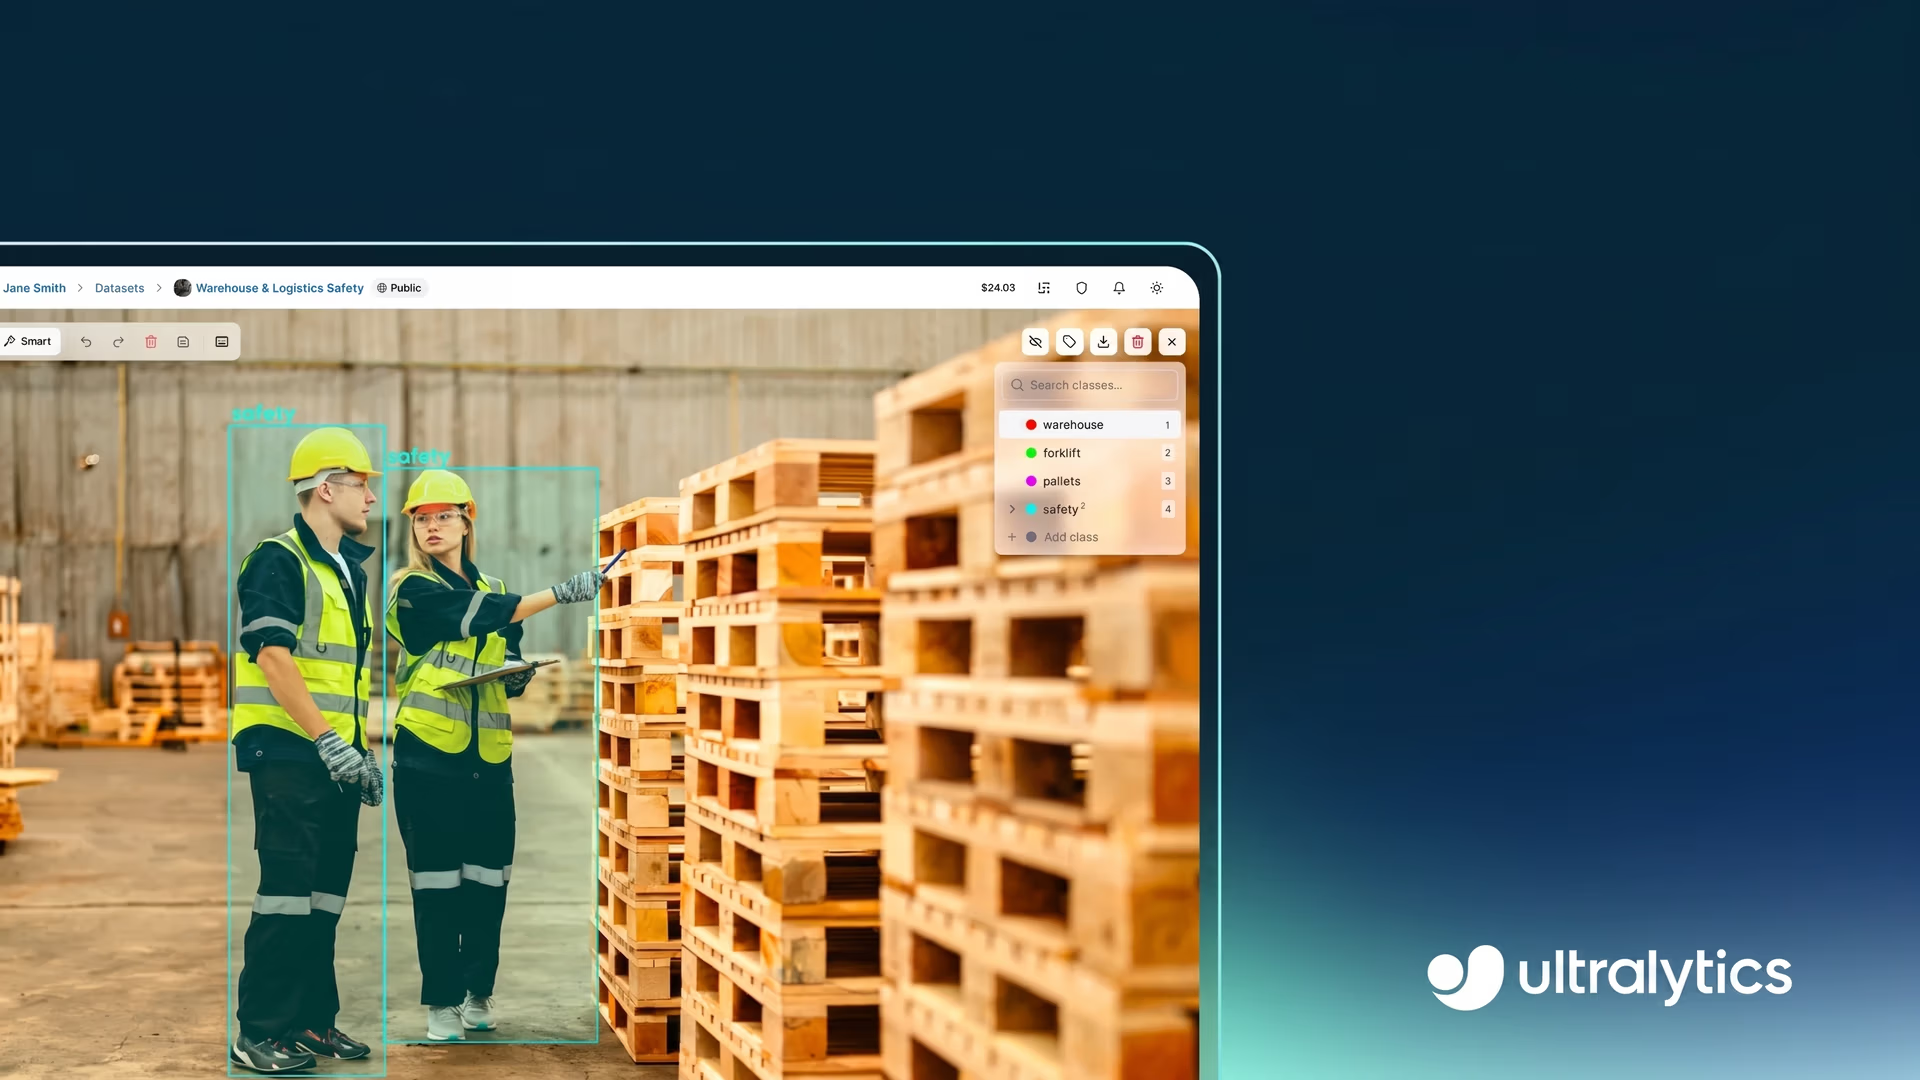
画像や動画を分析するコンピュータービジョンソリューションは、製造業から医用画像まで、さまざまな業界のワークフローに広く取り入れられています。たとえば製造業では、コンベヤーベルト上を移動する製品の表面欠陥を検出するために、微妙なパターンを見分けられるコンピュータービジョンモデルが必要です。
このようなモデルを適切に動作させるには、それぞれの欠陥が明確に識別されたラベル付きデータでトレーニングする必要があります。これにより、モデルは注目すべき特徴を学習し、類似するパターンを認識できるようになります。
こうしたラベルを作成するプロセスをデータアノテーションと呼びます。特に、画像アノテーションと動画アノテーションでは、画像や動画フレーム内のバウンディングボックスの描画、形状の輪郭指定、特定領域へのラベル付けを行います。
小規模なデータセットであれば対応できますが、データが増えるとすぐに作業が難しくなります。数千枚の画像にラベルを付けるには継続的な手作業が必要となり、アノテーションが大きなボトルネックになります。従来のツールは処理が遅く、分断されており、スケールしにくいことがよくあります。
オールインワンのビジョンAIプラットフォームであるUltralytics Platformは、AIアシストアノテーションによってこうした課題の解決を支援します。AIを使って初期ラベルを自動生成し、すばやく確認・調整できるため、手作業を減らし、効率を高められます。
この記事では、Ultralytics PlatformでAIアシストアノテーションがどのように機能し、ラベリングプロセスを改善するのかを解説します。さっそく見ていきましょう。
データアノテーションプロセスの概要#
Ultralytics PlatformでAIを活用したアノテーションがどのように機能するかを説明する前に、まずデータアノテーションについて詳しく見ていきましょう。
データアノテーションはデータラベリングとも呼ばれ、機械学習モデルのトレーニングに使用できるよう、生データに構造化されたラベルを付与するプロセスです。コンピュータービジョンでは、これらのラベルによって画像や動画内の対象物、領域、特徴を定義します。
トレーニング中、モデルやアルゴリズムは入力データをこれらのラベルに対応付ける方法を学習するため、アノテーションの品質はモデル性能を左右する重要な要素です。正確で一貫性のあるラベル付きデータセットがあれば、モデルは正しいパターンを学習できます。一方、品質が低い、または一貫性のないアノテーションは、信頼性の低い予測につながる可能性があります。
たとえば、欠陥検出のユースケースでは、コンベヤーベルト上の製品画像に、欠陥の位置を示し、欠陥の種類をラベル付けできます。これにより、モデルは欠陥の見た目を学習し、新しい画像で欠陥を識別できるようになります。
一般的なアノテーションタスク#
次に、コンピュータービジョンで画像にアノテーションを付ける一般的な方法をいくつか見ていきましょう。これらの方法は、物体検出、インスタンスセグメンテーション、画像分類などのタスク向けに視覚データをラベル付けするために使われます。各アノテーション方法は、物体の位置特定、形状の把握、重要な構造の識別など、それぞれ異なる役割を果たします。
バウンディングボックス#
バウンディングボックスは、画像内の物体の位置を示すために物体の周囲に描く単純な四角形です。コンピュータービジョンでデータにラベルを付ける最も一般的な方法の1つです。
こうしたボックス付きの画像でトレーニングすると、物体検出モデルはさまざまな物体を認識し、画像内の位置を把握できるようになります。これにより、複数の物体を同時に検出し、それぞれの位置を特定できます。
たとえば、コンピュータービジョンを使って分析する野球の試合を考えてみましょう。各フレームで選手、バット、ボールの周囲にボックスを描くと、モデルは試合を通じてこれらの物体を検出し、識別できます。
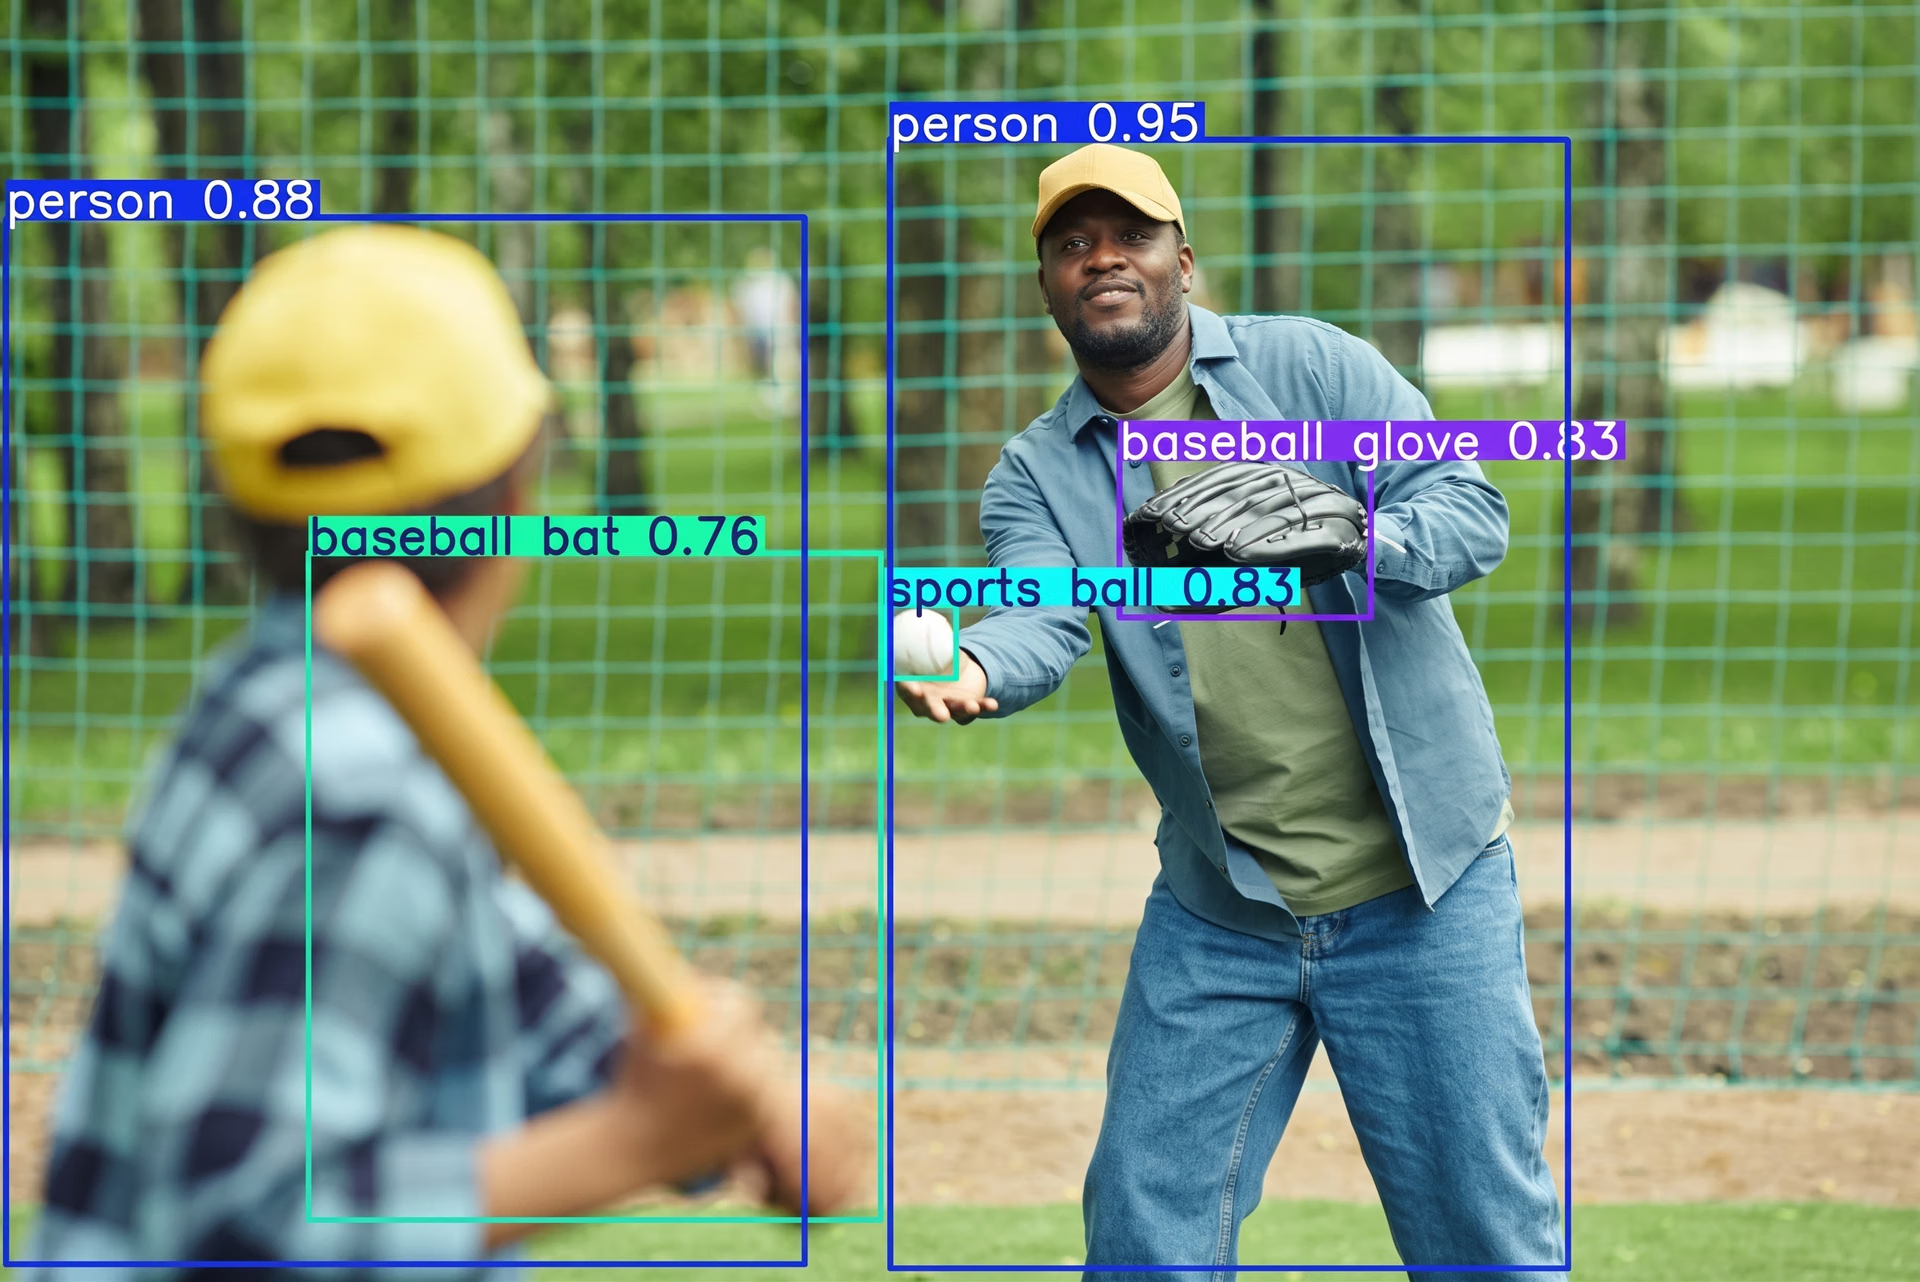
図1. バウンディングボックスを使って複数の物体にラベルを付け、位置を特定できます。(出典)
ポリゴンまたはセグメンテーションマスク#
セグメンテーションマスクとも呼ばれるポリゴンは、物体をピクセルレベルでラベル付けするため、バウンディングボックスより詳細な情報を提供します。大まかな四角形を描くのではなく、画像内の各物体の正確な形状と輪郭を捉えます。そのため、より詳細な理解が必要なタスクに適しています。
たとえば自動運転では、セグメンテーションマスクはセマンティックセグメンテーションなどのタスクに使用され、各ピクセルに道路や空などのカテゴリを割り当てます。また、インスタンスセグメンテーションでは、車両や歩行者などの個々の物体を別々に識別します。
画像内の人物などのオブジェクトを背景から切り離す必要がある背景除去などのタスクにも使用されます。
キーポイント#
キーポイントは、人体の関節や動物の体の部位など、オブジェクト上の特定の点を示すために使用されます。これらの点を特定することで、モデルはオブジェクトの構造や、各部位の相対的な位置関係を理解できます。
コンピュータービジョンでは、これは姿勢推定と呼ばれ、キーポイントの位置を特定し、それらの相互関係を理解することを目的としています。これらの点を時間の経過とともに追跡することで、動きや姿勢の変化を分析できます。
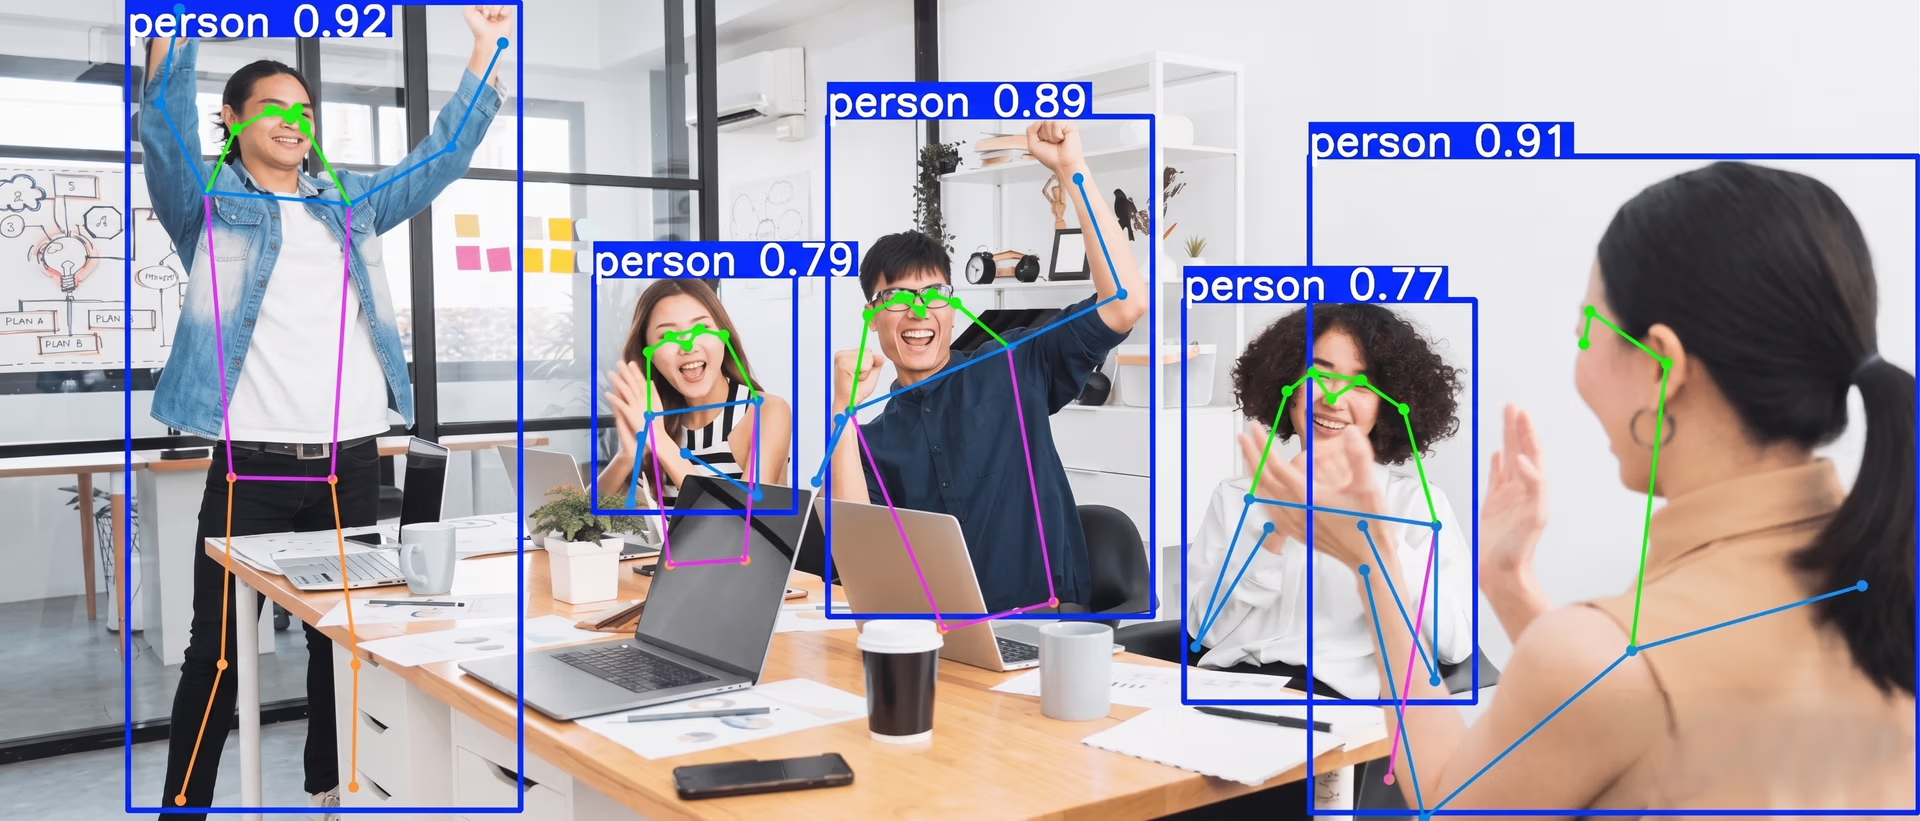
図2. キーポイントアノテーションを使用して、人体の姿勢推定に向けて関節を示すことができます。(出典)
一般的な例として、動画内で身体の関節に印を付け、人の動きを分析する方法があります。これらの重要な点に注目することで、モデルは人の姿勢や、時間の経過に伴う姿勢の変化を捉えられます。
回転境界ボックス(OBB)#
画像内のすべてのオブジェクトが正確に整列しているわけではありません。現実世界の多くの場面では、オブジェクトが傾いたり、回転したり、さまざまな角度から見えたりします。
標準的なバウンディングボックスは、不要な背景を含んだり、オブジェクトに十分沿わなかったりするため、このようなケースへの対応が難しいことがよくあります。回転境界ボックスは、オブジェクトの向きに合わせた回転長方形を使用することで、この問題に対処します。その結果、よりタイトで正確なアノテーションが可能になります。
この手法は回転境界ボックス(OBB)検出で使用され、モデルはオブジェクトの位置と向きの両方を特定します。例として、建物、船舶、車両などのオブジェクトがさまざまな角度で写る航空画像があります。回転ボックスを使うと、シーン内の実際の形状と向きを捉えやすくなります。
分類ラベル#
分類ラベルは、特定のオブジェクトや領域を示すのではなく、画像全体に単一のラベルを割り当てる点で、他のアノテーション手法とは異なります。画像内のどこに何があるかではなく、画像に何が写っているかを特定する場合に使用されます。
たとえば、画像全体の内容に基づいて、「猫」または「犬」とラベル付けできます。そのため、画像の大まかな理解で十分なタスクでは、画像分類が役立ちます。
従来のアノテーションツールの制約#
従来のラベリングツールの多くは、複数の手順と分断されたワークフローに依存しています。AI開発チームは、ラベリング、保存、検証のために複数のアノテーションプラットフォームを切り替える必要があることが多く、AIプロジェクトの進行が遅くなります。
ほとんどのツールが対応するアノテーションの種類やデータの種類は限られているため、チームはバウンディングボックス、セグメンテーション、キーポイントごとに異なるツールを使うことになります。このように分断された環境は、特にコンピュータービジョンを始めたばかりのチームにとって、管理が難しい場合があります。
手作業も大きな課題です。1枚の画像のアノテーションに数分しかかからない場合でも、大規模なデータセットではすぐに時間がかかるようになります。特に、似た画像に対して同じ作業を繰り返す場合に顕著です。
データセットの拡大に伴い、チームはファイルの管理、データセットのバージョン追跡、アノテーション間の一貫性の維持も行う必要があります。その結果、データ管理に費やす時間が増え、モデルのパフォーマンス改善に充てる時間が減ってしまいます。
より効率的な方法は、Ultralytics Platform内でAI支援アノテーションを使用することです。AIでラベルを生成・調整することで、手作業を減らしながら速度と一貫性を高めます。また、データセット管理、アノテーション、モデルのトレーニング、デプロイ、監視を単一の環境に統合できます。
Ultralytics Platformによるアノテーションプロセス#
Ultralytics Platformは、アノテーションをコンピュータービジョンのワークフローの他の工程に直接つなげることで、アノテーションを効率化します。個別のツールに頼る代わりに、チームは単一の環境でデータ、アノテーション、モデルを扱えます。
物体検出、画像分類、インスタンスセグメンテーション、姿勢推定、回転境界ボックス検出など、幅広いコンピュータービジョンタスクに対応しています。
この環境では、複数の方法でアノテーションを行えます。チームは、細かく制御できる手動ラベリング、ポイントを使った対話型ラベリングが可能なSAM搭載のスマートアノテーション、またはアノテーションを自動生成してレビュー・調整できるYOLOベースのスマートアノテーションを利用できます。この柔軟性により、さまざまなデータセットやアノテーション要件に対応しやすくなります。
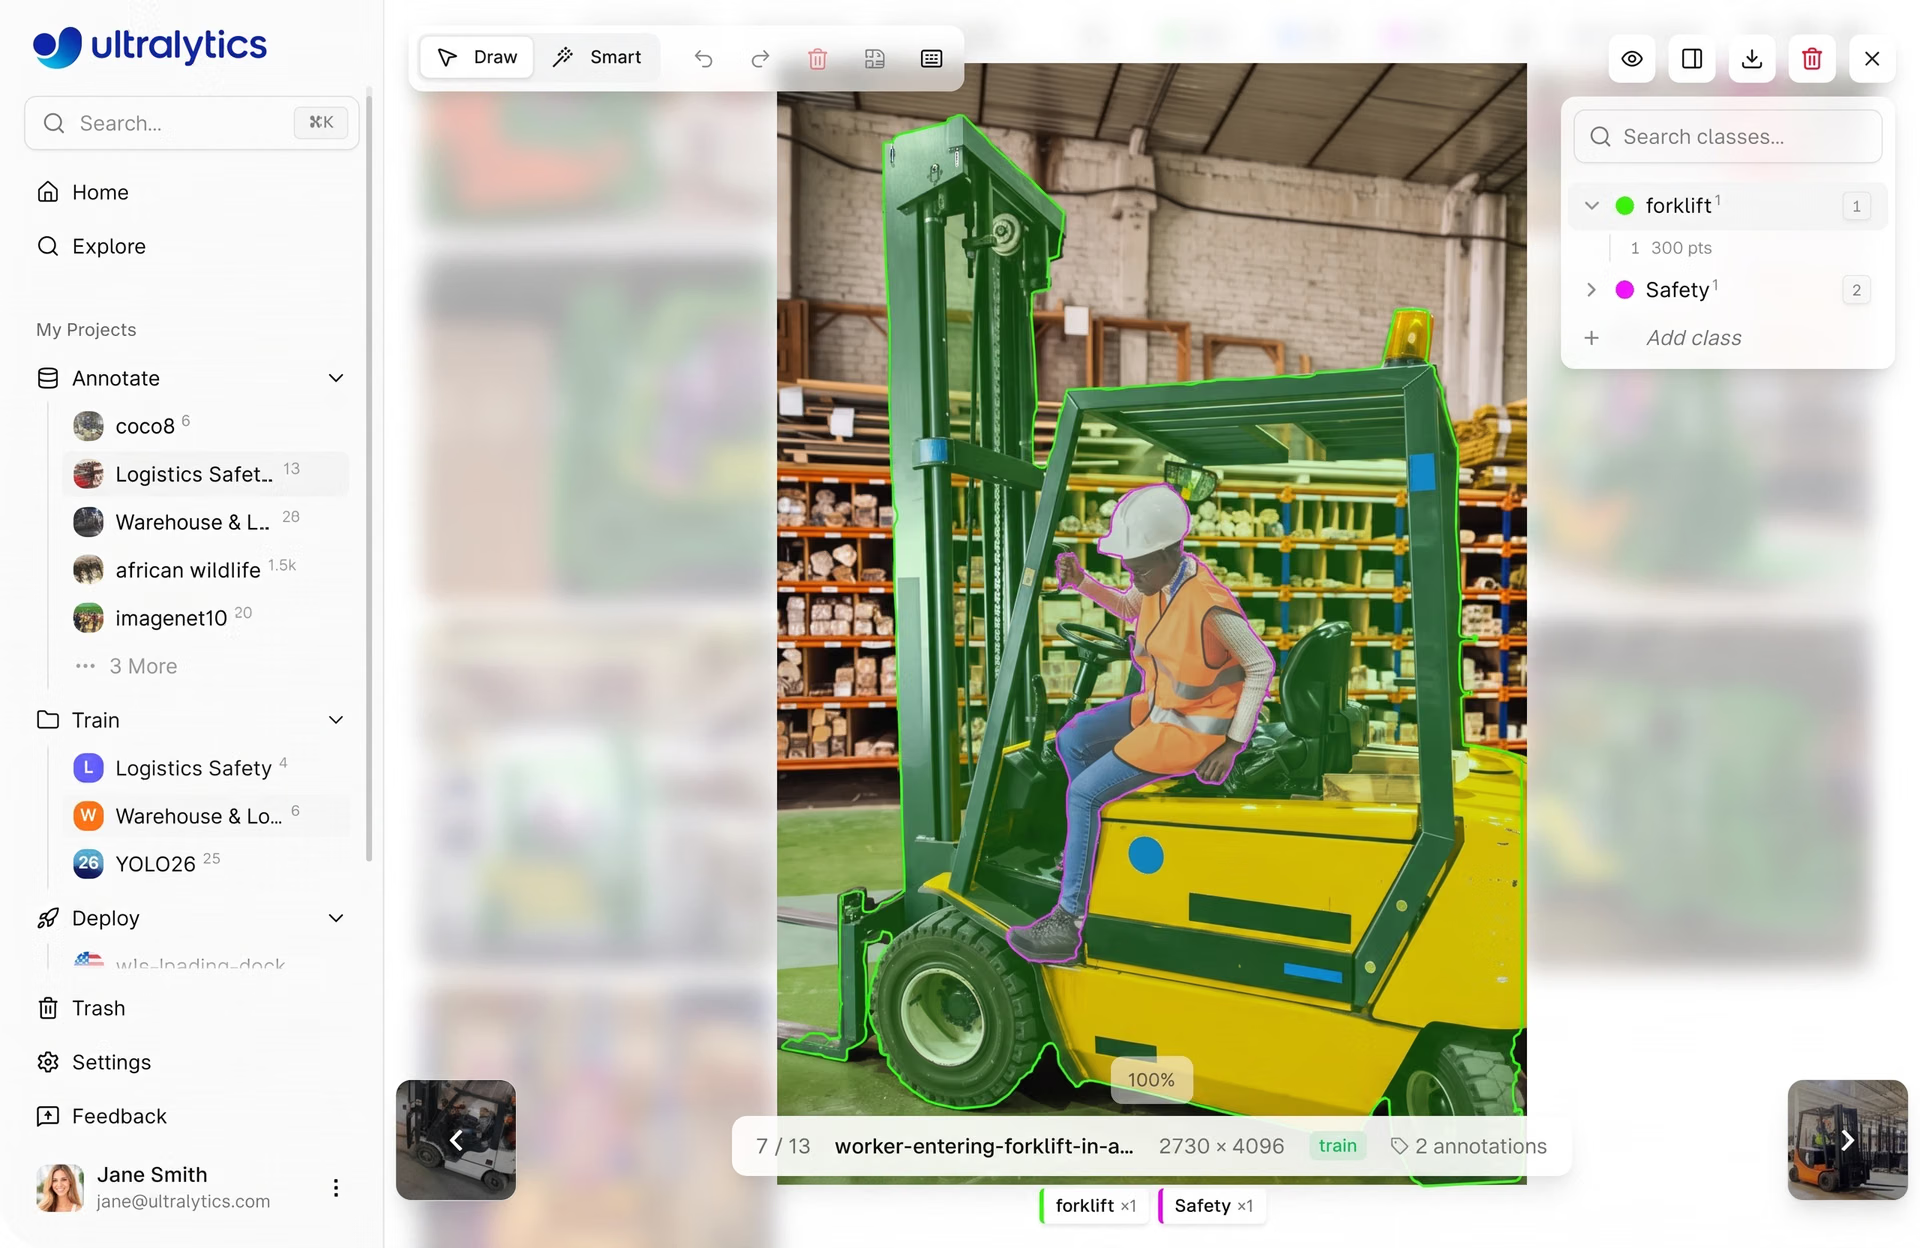
図3. Ultralytics Platformでのアノテーション画面(出典)
AI支援アノテーションと手動アノテーションはデータセット管理やモデルのトレーニングと統合されているため、チームはデータのラベリングからデータセットの整理、モデルのトレーニングまでをシームレスに進められます。これにより、ワークフローが整理され、ツールの切り替えやアノテーションの再フォーマットが不要になります。
このプラットフォームは、Ultralytics YOLO11やUltralytics YOLO26などのUltralytics YOLOモデルにも対応しており、アノテーション済みデータをトレーニングやテストに直接利用できます。これにより、データセットの不足箇所を特定し、アノテーションを調整して、継続的な反復を通じてモデルを再トレーニングしやすくなります。
Ultralytics PlatformにおけるSAMスマートアノテーションの主な機能#
Ultralytics PlatformのSAM搭載スマートアノテーションは、物体検出、インスタンスセグメンテーション、回転境界ボックス(OBB)タスクのアノテーションを高速化するように設計されています。
このプラットフォームでは、SAM 2.1 Tiny、SAM 2.1 Small、SAM 2.1 Base、SAM 2.1 Large、SAM 3など、複数のSAMモデルバリアントを提供しており、ユーザーは速度と精度のバランスを選択できます。
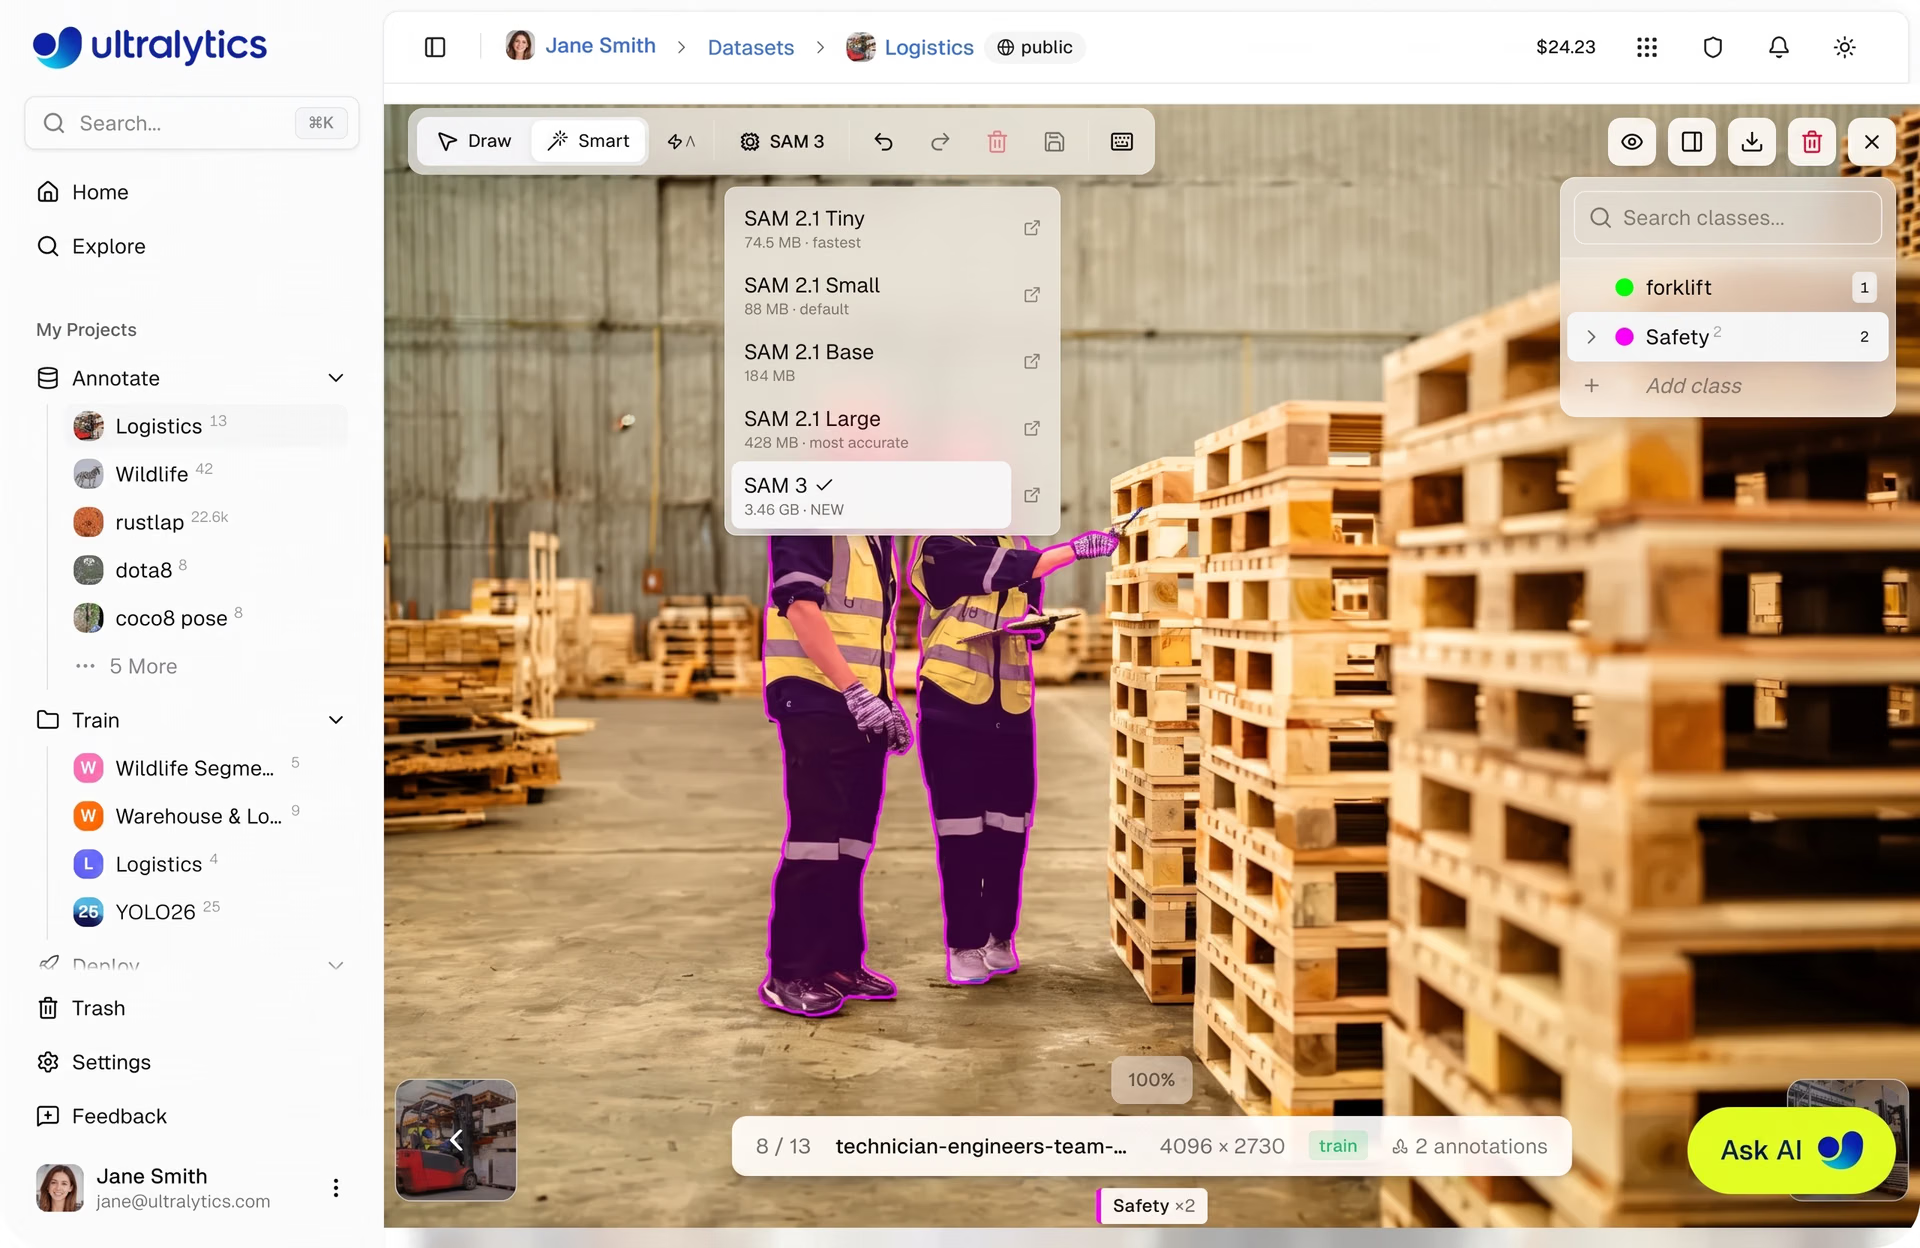
図4. Ultralytics PlatformのSAM搭載スマートアノテーション(出典)
TinyやSmallなどの小型モデルはより高速で、迅速なアノテーションワークフローに適しています。一方、LargeやSAM 3などの大型モデルは、より複雑なシーンで高い精度を発揮します。モデルを切り替えると、アノテーションの動作がすぐに更新されます。
アノテーションエディターでSAMモデルを選択すると、アノテーターはスマートモードに切り替えてラベリングを開始できます。手動で図形を描く代わりに、簡単なポイント入力でモデルをガイドします。
左クリックすると領域を含めるポジティブポイントが追加され、右クリックすると不要な領域を除外するネガティブポイントが追加されます。これらの入力に基づいて、モデルは高精度なマスクをリアルタイムで生成します。
ワークフローを高速化するには、自動適用モードを有効にできます。有効にすると、クリックするたびに手動で確認しなくてもアノテーションが自動生成され、保存されます。より複雑なオブジェクトの場合は、マスクの適用前に「Shift」を押しながら複数のポイントを配置するか、自動適用を無効にして自由にポイントを追加し、「Enter」を押してマスクを適用できます。
Ultralytics PlatformのYOLOスマートアノテーションについて#
SAM搭載スマートアノテーションと同様に、Ultralytics PlatformのYOLOスマートアノテーションもAIを使用してラベリングプロセスを高速化します。クリックでモデルをガイドする代わりに、モデルの予測を利用してアノテーションを自動生成します。
この手法は、物体検出、インスタンスセグメンテーション、回転境界ボックス(OBB)アノテーションなどのタスクに対応しています。Ultralyticsが提供する事前学習済みモデルや、カスタムトレーニング済みのYOLOモデルを含む、Ultralytics YOLOモデル専用の機能です。
アノテーションエディターで、アノテーターはスマートモードに切り替え、モデル選択メニューからYOLOモデルを選んで、「Predict」をクリックできます。モデル選択メニューには現在のデータセットのタスクに一致するYOLOモデルのみが表示されるため、生成されるアノテーションの互換性が保たれます。
モデルは画像を分析し、予測に基づいてアノテーションを生成して、画像に直接追加します。予測が同じクラスの既存のアノテーションと重なり、その重なりが設定されたしきい値を超える場合、重複する検出は自動的にスキップされ、クリーンで一貫性のあるラベルを維持できます。
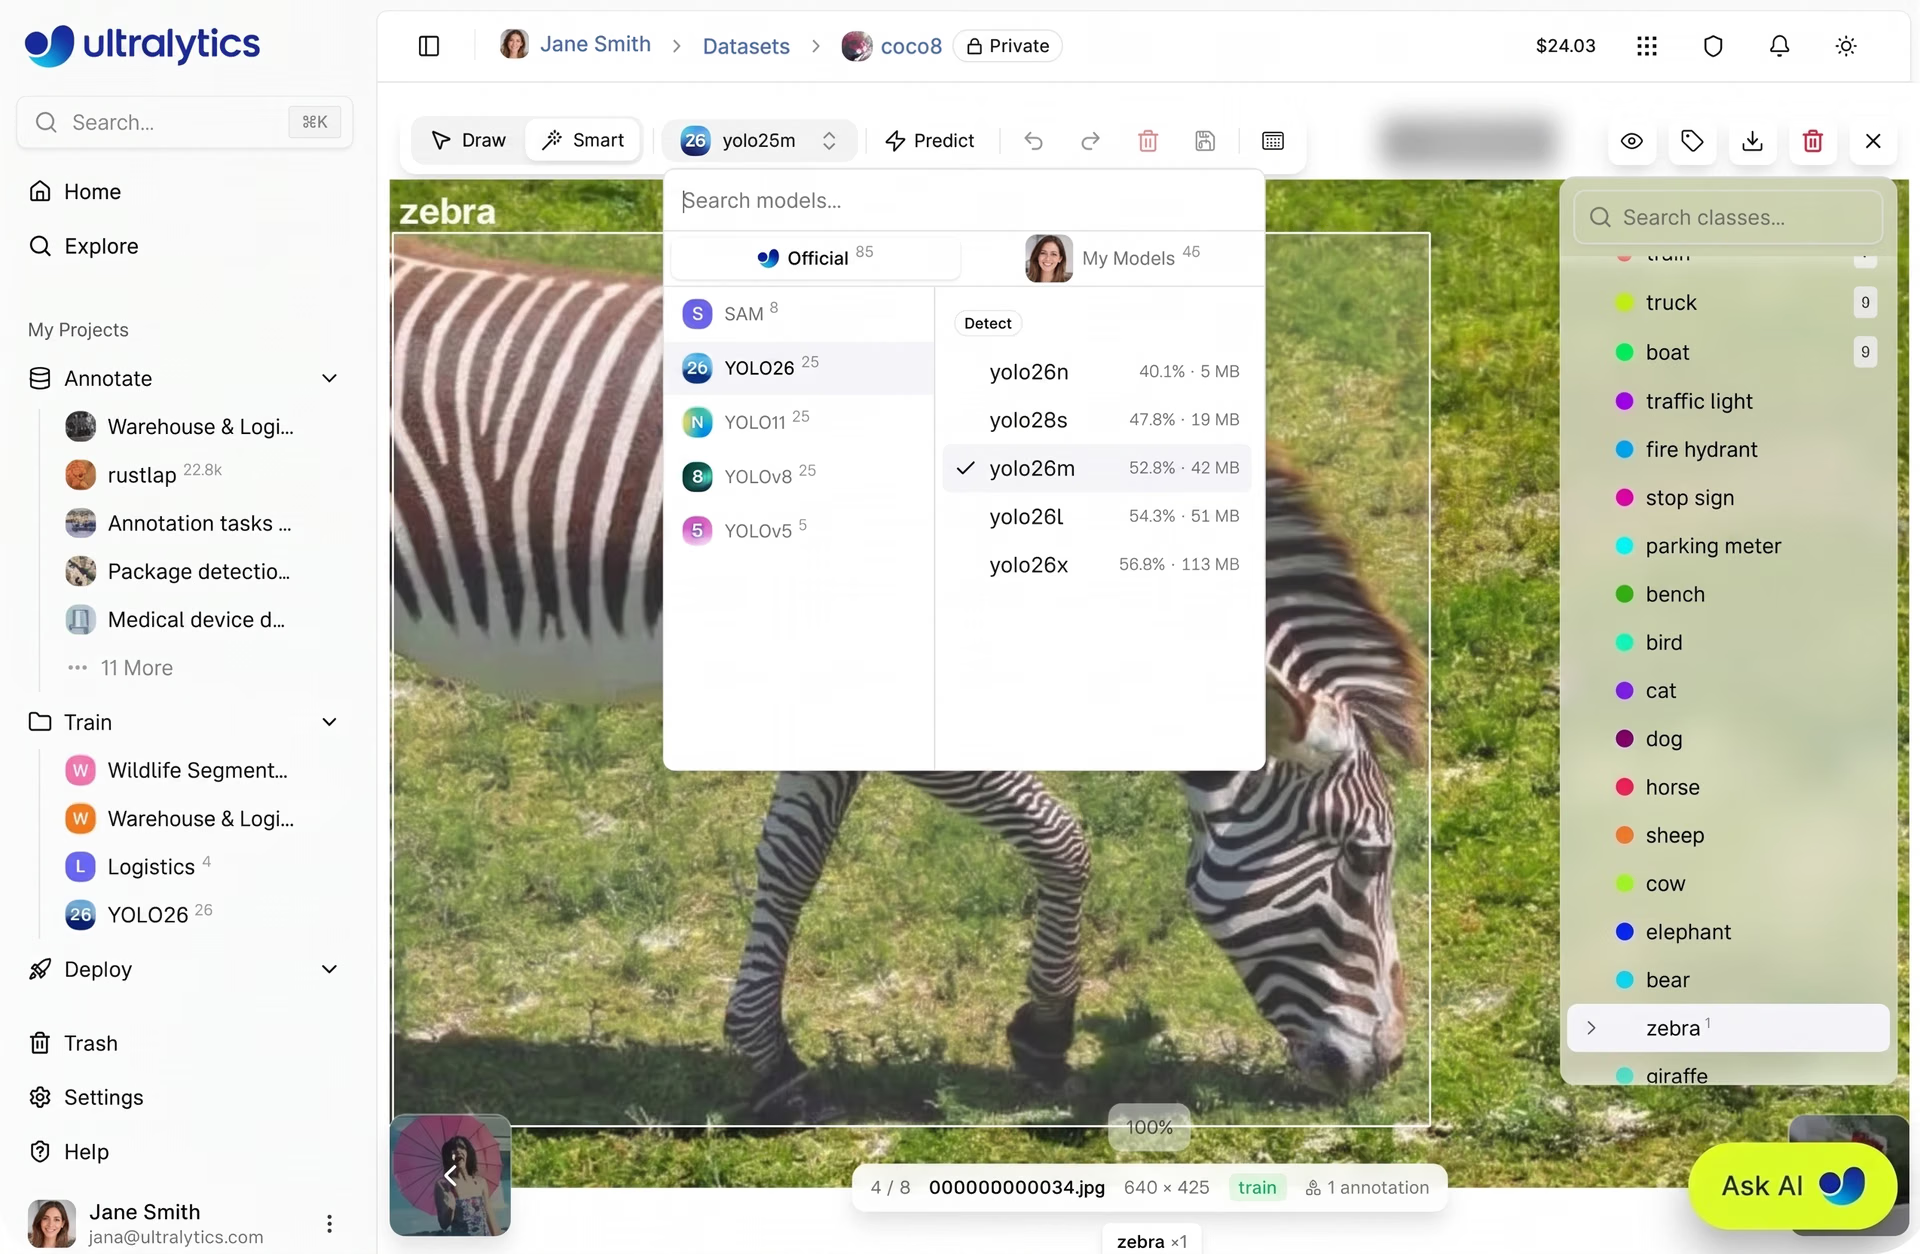
図5. Ultralytics PlatformでUltralytics YOLOモデルを活用したスマートアノテーション(出典)
予測の生成後、human-in-the-loopアノテーターは必要に応じて予測をレビュー、調整、または削除できます。すべてを手動でアノテーションする代わりに、モデルが生成したアノテーションを起点に調整することで、大規模なデータセットをすばやくラベリングできます。
時間の経過とともに、改善されたYOLOモデルを再利用してより良い予測を生成できるため、反復的な自動ラベリングワークフローを実現できます。
実際のパイプラインでAI支援ラベリングを活用する#
次に、Ultralytics Platformが実際のユースケースでデータアノテーションをどのように実現するか、例を見ていきましょう。
自動運転におけるセグメンテーション#
コンピュータービジョンモデルを搭載した自動運転車は、周囲の環境をリアルタイムで理解するために、適切にアノテーションされた視覚データに依存しています。このデータでトレーニングされたモデルは、車両、歩行者、交通標識、道路の境界を検出・セグメント化できます。
セグメンテーションタスクではピクセル単位の正確な境界が必要となるため、アノテーションは不可欠である一方、時間もかかります。大量のセンサーデータを手動でラベリングすると、特に複雑な運転シーンでは、すぐにボトルネックになる可能性があります。
Ultralytics Platformは、SAMモデルとYOLOモデルの両方を用いたAI支援アノテーションにより、このプロセスを効率化します。SAM搭載のスマートアノテーションでは、クリック操作による高精度なマスク作成でセグメンテーションを迅速に行えます。一方、YOLOモデルは画像全体のアノテーションを自動生成するために使用できます。
これらの手法を組み合わせることで、オブジェクトが重なり合う複雑なシーンにも対応しやすくなります。
アノテーションがモデルのトレーニングに直接つながっているため、更新された大規模データセットをすぐにモデルの再トレーニングや評価に利用できます。これにより、チームはパフォーマンスを継続的に改善し、新たな運転状況により効率的に対応できます。
製造業の品質保証システムの強化#
製造業で一貫した品質管理を維持するには、生産中の欠陥を正確に検出することが重要です。リアルタイムで問題を特定するためにコンピュータービジョンモデルがよく使用されますが、その性能はトレーニングデータが実際の生産環境をどれだけ反映しているかに左右されます。
原材料、機械の設定、照明など、製造環境の変化によって、元のトレーニングデータに含まれていない新しい欠陥やまれな欠陥が発生することがあります。その結果、モデルが学習した内容と生産ラインで実際に発生する状況との間にギャップが生じます。
状況に適応するには、高品質な社内アノテーションを用いてデータセットを定期的に更新する必要があります。Ultralytics Platformを使うと、新しい欠陥パターンが現れた際にアノテーションを更新し、データセットを拡張できます。更新されたデータセットでモデルを再トレーニングすれば、変化する生産状況によりすばやく対応できます。
建設現場の監視と安全#
建設現場は、複数のチーム、移動する設備、絶えず変化するレイアウトが存在する、動的な環境です。このような状況で安全を維持するには、明確で適切にアノテーションされた視覚データが欠かせません。
正確なアノテーションはデータ品質を高め、混雑したシーン、変化する背景、さまざまな照明など、幅広い現場の状況で、AIシステムが作業員、設備、安全装備、潜在的な危険を特定するのに役立ちます。
Ultralytics Platformは、現場の状況の変化に合わせてアノテーションを簡単に更新・調整できるようにすることで、これを支援します。新しい画像が得られるたびにデータセットに追加できるため、データセットを現実の状況に沿った状態に保てます。
重要なポイント#
高品質なアノテーションは、信頼性の高いコンピュータービジョンモデルやAIモデルの構築に不可欠ですが、従来のワークフローではチームの作業が滞ることがよくあります。Ultralytics Platformは、自動アノテーションツールとスケーラブルなワークフローでこのプロセスを効率化します。その結果、チームは精度と一貫性を保ちながら、データからモデルへよりすばやく進められます。
コンピュータービジョンについて詳しく知るには、成長を続けるコミュニティやGitHubリポジトリをご覧ください。ビジョンソリューションの構築をご検討の場合は、ライセンスオプションをご確認ください。また、製造業におけるコンピュータービジョンとヘルスケアにおけるAIのメリットについて、ソリューションページをご覧ください。








