Amazon S3データでYOLOをトレーニングし、Ultralytics Platformでホスト型APIとしてデプロイする方法
Ultralytics Platformを使用して、Amazon S3バケット内の画像でUltralytics YOLO26をトレーニングし、ホスト型APIとしてデプロイする手順を、SageMakerと比較しながら順を追って説明します。
 Miles Deans14 分で読めます
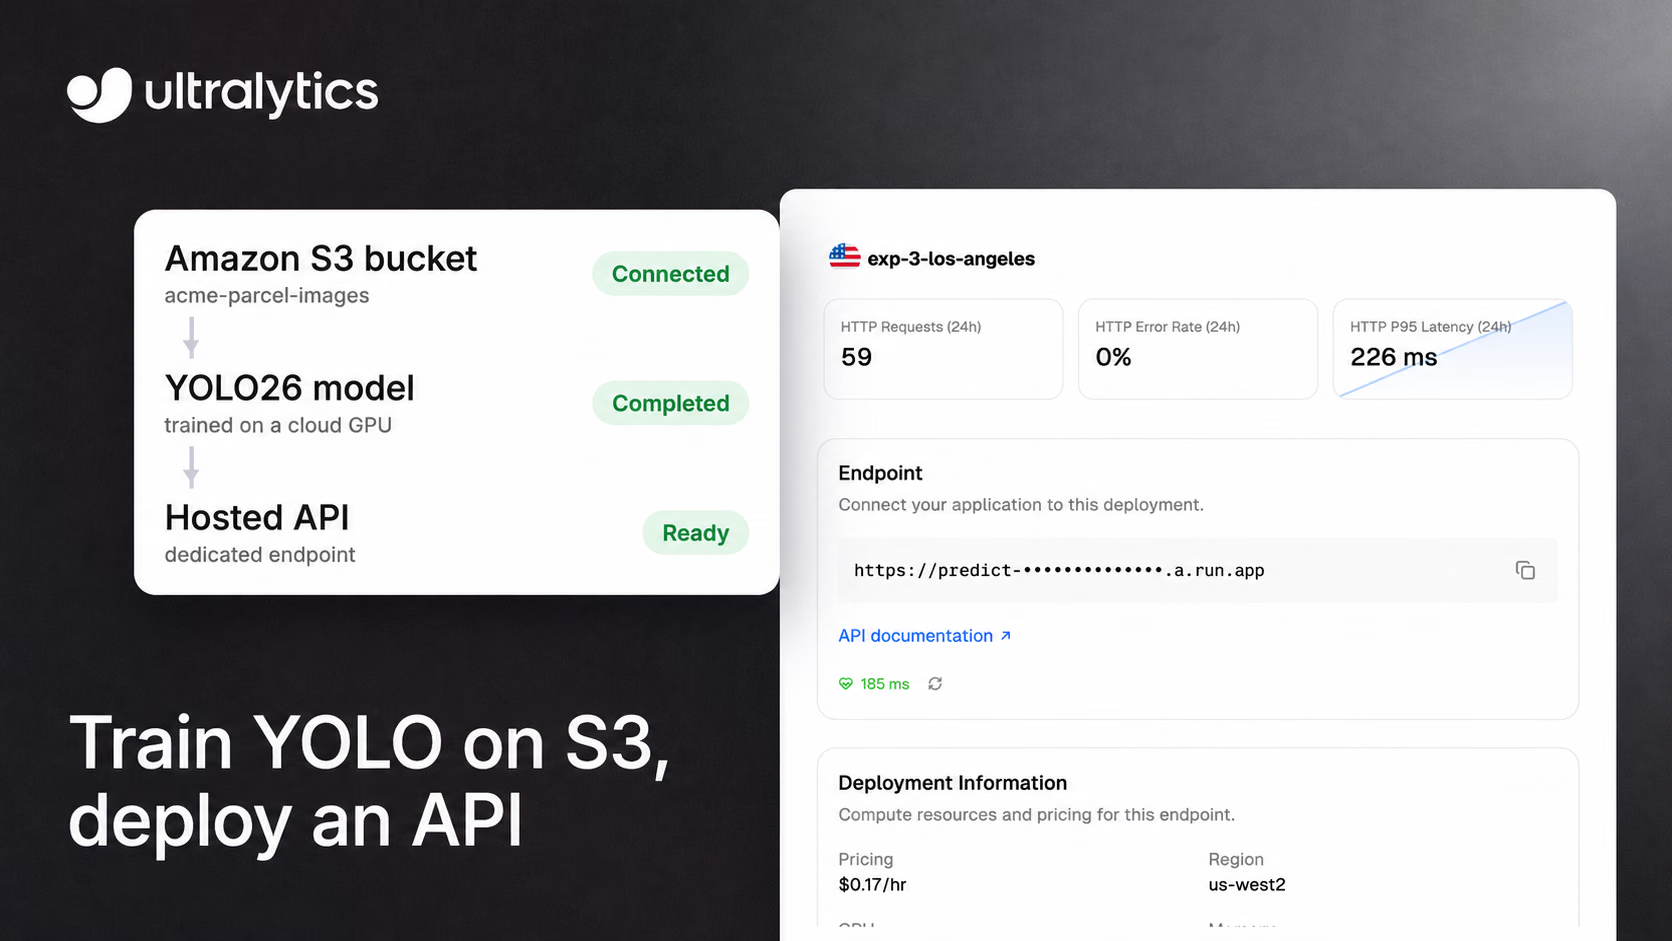
画像がすでにAmazon S3バケットにある場合は、データセットをもう一度アップロードせずに、その画像でUltralytics YOLOモデルをトレーニングし、ホスト型APIとしてデプロイできます。Ultralytics Platformはバケットをその場でインデックス化し、クラウドGPU上でYOLO26のラベル付けとトレーニングを可能にし、トレーニング済みモデルをHTTPS経由で呼び出せる専用エンドポイントにデプロイします。このガイドでは、IAMポリシーの設定から最初の推論まで、各手順を説明し、Amazon SageMaker、Google Vertex AI、Azure Machine Learningとのワークフローの違いも比較します。
同じ手順はGoogle Cloud StorageとAzure Blob Storageでも利用できます。AWSアクセスキーの代わりに、サービスアカウントのJSONキーまたはアカウントのアクセスキー接続文字列を使用します。
ワークフローの全体像#
パイプラインは5つの段階で構成されます。元の画像はバケットに残り、クラウドトレーニングでは実行中のみ一時コピーが使用されます。
- 接続: 読み取り専用IAMユーザーを使用してS3バケットを接続します。
- インデックス化: フォルダーをPlatformのデータセットとして登録します。Platformは画像の寸法と見つかったYOLOラベルを読み取り、画像のコピーは保存しません。
- ラベル付け: ブラウザーで画像にラベルを付けるか、バケット内にあるYOLOラベルをそのまま使用します。
- トレーニング: クラウドGPU上でYOLO26モデルをトレーニングします。トレーニング中は画像の一時コピーが使用されます。
- デプロイ: 42のリージョンから選んだ1つの専用エンドポイントにモデルをデプロイし、APIキーを使用して画像を送信します。
検出、セグメンテーション、姿勢推定、有向バウンディングボックス(OBB)のデータセットは、ラベルの形式から自動的に認識されるため、同じ手順を各コンピュータービジョンタスクに適用できます。
開始前に確認すること: プラン、権限、データの境界#
必要なものは3つです。
- ProまたはEnterpriseのワークスペース。 Amazon S3、Google Cloud Storage、Azure Blob Storageのデータセットには、ProまたはEnterpriseプランが必要です。Proは1シートあたり月額29ドルで、クラウドトレーニングなどの従量制コンピューティングに使えるクレジットが、毎月1シートあたり30ドル分含まれます。
- ワークスペースの管理者またはオーナーのロール。 クラウドストレージの接続に必要です。
- バケットの一覧表示と読み取りが可能なAWS IAMユーザー。
接続する前に、バケット外に送信されるデータを把握しておくと役立ちます。Platformは閲覧やアノテーションのために元画像をオンデマンドでストリーミングし、インデックス化された画像はPlatformのストレージ容量に計上されません。各接続にはAI機能の切り替えがあり、既定で有効になっています。有効な間は、Ultralytics GPUがアノテーション、類似画像検索、クラウドトレーニングのために画像を読み取ることができます。また、ワークスペースのプロバイダーキーを使って、有料のアノテーションモデルを提供する外部AIプロバイダーが画像を処理する場合や、書き込みアクセスが有効な場合に画像生成のために画像が処理される場合があります。クラウドトレーニングでは実行中に一時コピーが使用され、類似画像検索では画像がPlatformから削除されるまで埋め込みが保持されます。機能をオフにすると、新しいAI処理は開始されません(実行中の処理は完了します)が、手動アノテーションとローカルトレーニングは引き続き利用できます。Platformがオブジェクトを変更または削除することはありません。
手順1: 読み取り専用IAMユーザーを作成する#
AWSコンソールでIAM > Usersに移動し、コンソールアクセスを許可しないユーザーを作成して、バケットの一覧表示と読み取りを許可するポリシーをアタッチします。
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}s3:ListAllMyBucketsは任意です。設定するとPlatformがバケットを検出できるため、バケット名を手入力する必要がありません。
次に、ユーザーのSecurity credentialsタブを開き、アクセスキーを作成します。Platformには有効期間の長いIAMユーザーキーが必要です。データセットの接続中に期限切れになるため、ロールセッション認証情報やIAM Identity Centerキーを含む一時的なAWS STS認証情報は拒否されます。この用途専用のユーザーを使用し、root認証情報は使用しないでください。PlatformはキーをAES-256-GCMで保存時に暗号化し、トレーニングワークロードにキーを公開しません。また、IAMでキーを無効化すれば、いつでもアクセスを取り消せます。
手順2: バケットをUltralytics Platformに接続する#
- PlatformでSettings > Integrationsに移動し、Amazon S3を選択します。
- アクセスキーID、シークレットアクセスキー、バケットのリージョンを入力します(例:
us-east-1)。 - Find available bucketsをクリックして接続するバケットを選択するか、ポリシーでバケットの検出が許可されていない場合はバケット名を入力します。
- Connectをクリックします。Platformは保存する前に、各バケットの一覧表示と読み取りが可能であることを確認します。
1つの接続で読み取れるのは1つのリージョン内のバケットです。データが複数のリージョンに分散している場合は、リージョンごとに接続してください。Amazon S3統合ガイドでは、画像生成に使用する任意の書き込み権限について説明しています。
手順3: バケットからデータセットを作成する#
New DatasetをクリックしてCloudタブを開き、バケットを選択します。データがあるフォルダーに移動してデータセットを作成します。Platformはフォルダーを一度一覧表示し、見つかったデータをインデックス化します。
- 画像:
.jpg、.jpeg、.png、.webp、.avifのオブジェクト。 - ラベル: YOLOの
.txtファイル。標準のimages/からlabels/までの構成にあるファイル、または各画像と同じ場所にあるファイルが対応付けられます。 - クラス:
data.yamlファイルでクラス名を指定します。通常のYOLOデータセットと同様です。 - 分割:
train、val、testというフォルダー名に基づいて、分割が自動的に割り当てられます。
1回のインポートでインデックス化できるオブジェクトは最大500,000個です。それを超える大きさのバケットは、複数のデータセットに分割してください。インデックス化されたオブジェクトは不変として扱ってください。各画像はS3オブジェクトのETagに固定され、上書きされた画像はPlatformから提供されなくなります。インデックスはデータセット作成時に一度だけ作成されるため、後からデータを追加する場合は新しいオブジェクトをアップロードし、新しいデータセットを作成してください。
手順4: 画像にラベルを付ける、または確認する#
データセットを開き、アノテーションエディターでインポートされたラベルを確認します。バケットにラベルがまだない場合は、手動でボックスやマスクを描画できます。また、AI機能が有効であれば、スマートアノテーション(検出、セグメンテーション、OBBにはSAM、姿勢推定にはYOLO)や自動アノテーションを使って作業を効率化できます。ラベルはPlatformに保存され、バケット内のオブジェクトは変更されません。
手順5: クラウドGPU上でYOLO26をトレーニングする#
データセットまたはプロジェクトでNew Modelをクリックし、ベースモデルを選択してクラウドでの実行を開始します。
- ベースモデル: 公式のUltralyticsモデル(YOLO26を推奨)またはファインチューニングする独自モデルを選択します。データセットのタスクと互換性のあるモデルのみが表示されます。
- パラメーター: エポック数、画像サイズ、バッチサイズを設定するか、既定値のままにします。
- GPU: Ultralytics CloudからGPUを選択します。開始前にダイアログで時間単価、実行時間の見積もり、合計コストを確認できます。トレードオフを検討する際は、クラウドGPUの選び方に関するガイドを参照してください。
実行中は、メトリクス、コンソール出力、システムチャートがブラウザーにストリーミングされ、チェックポイントは自動的に保存されます。トレーニングが完了すると、モデルページにメトリクスが表示され、検証結果がある場合は混同行列などの詳細な分析も確認できます。
手順6: モデルをホスト型APIとしてデプロイする#
モデルのDeployタブを開きます。マップとテーブルに42のリージョンが表示され、現在地から測定したレイテンシの順に並びます。希望するリージョンのDeployをクリックし、CPU、メモリ、料金を確認してからCreate Deploymentをクリックします。
選択したサイズによって料金が決まります。
- デフォルトサイズ(1 vCPU、2 GiB): 無料で、アイドル時にはゼロまでスケールします。
- カスタムサイズ(最大8 vCPU、32 GiB): インスタンスを1台常時起動状態に保ち、準備完了からエンドポイントを停止するまで、アイドル時間を含めて表示されたリージョン別時間単価で課金されます。
各専用エンドポイントは、独自のURLとモニタリング機能を持つシングルテナントサービスで、ワークスペースの1つのAPIキーに紐付けられます。無料ワークスペースでは3つ、Proでは10個、Enterpriseでは無制限にデプロイを実行できます。専用エンドポイントが共有推論より適している状況については、専用推論と共有推論の比較ガイドをご覧ください。
手順7: エンドポイントを呼び出す#
python -m pip install requestsを使ってRequestsをインストールし、画像をimage.jpgとして保存します。サンプルURLを、コピーしたデプロイURLの末尾に/predictを付けたものに置き換え、YOUR_API_KEYをそのデプロイに紐付けられたキーに置き換えます。
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
同じリクエストをcURLで実行する場合:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
-F "imgsz=640"各エンドポイントには、/docsでインタラクティブなAPIリファレンスが、/healthでヘルスチェックが提供されます。直接リクエストではPlatform APIのレート制限を回避できますが、各エンドポイントを処理するインスタンスは1つです。すぐに処理できないリクエストには、Retry-Afterヘッダーを伴う429が返されます。また、リクエスト本文の上限は32 MBです。エンドポイントが稼働したら、デプロイページからリクエスト、エラー、レイテンシをモニタリングできます。
コスト、制限、セキュリティの概要#
| 項目 | 内容 |
|---|---|
| プラン | S3、Google Cloud Storage、Azure Blobのデータセットには、Pro(1シートあたり月額29ドル)またはEnterpriseが必要です |
| ストレージ | インデックス化された画像はバケットに残り、Platformのストレージ容量を使用しません |
| トレーニング | クレジットからGPU稼働時間分が課金されます。開始前にダイアログでコストを見積もれます |
| エンドポイント | デフォルトサイズは無料でゼロまでスケールし、カスタムサイズは稼働中に時間単位で課金されます |
| インポートサイズ | 1回のインポートにつき最大500,000個のオブジェクト |
| 認証情報 | 有効期間の長いIAMユーザーキーを保存時に暗号化し、トレーニングワークロードには公開しません |
| S3データセットでは利用できません | データセットの複製、バージョンスナップショット、顔のぼかし、他のデータセットからの画像の貼り付け |
Ultralytics PlatformとSageMaker、Vertex AI、Azure MLの比較#
汎用クラウドMLプラットフォームでも、自社ストレージ内のデータを使ってトレーニングし、モデルを提供できます。以下のストレージ列とモデル提供列は各プラットフォームのドキュメントに基づいており、最後の列は当社の評価です。
| プラットフォーム | トレーニングデータの保存場所 | モデル提供の選択肢 | 推奨される用途(当社の評価) |
|---|---|---|---|
| Ultralytics YOLOを使用するUltralytics Platform | S3、Google Cloud Storage、Azure Blobからその場でインデックス化 | 42のリージョンにシングルインスタンスの専用エンドポイントを提供。デフォルトサイズではゼロまでスケール | トレーニングやモデル提供のコードを書かずに、バケットからAPIまでYOLOによる検出、セグメンテーション、姿勢推定、OBBを実現したいチーム |
| Amazon SageMaker AI | トレーニングジョブはAmazon S3、Amazon EFS、Amazon FSx for Lustreからデータを読み取ります | オートスケーリング、サーバーレス、非同期推論に対応するリアルタイムエンドポイント | AWSでMLパイプラインをすでに運用しており、コンテナとモデル提供の選択肢を独自に決めたいチーム |
| Google Vertex AI | サーバーレストレーニングジョブでは、アクセス可能なCloud Storageバケットを/gcs/の下にマウントします | オンライン推論用のマネージドエンドポイント | Google Cloudのデータとツールを標準としているチーム |
| Azure Machine Learning | データストアでは、Blob Storageなどの既存のAzureストレージを参照します | リアルタイム推論用のマネージドオンラインエンドポイント | Azureを標準としているチーム |
SageMakerのトレーニングデータに関するドキュメントでは、S3、EFS、FSx for Lustreを、ストリーミングおよびダウンロードの入力モードに対応するソースとして挙げています。サーバーレス推論ではスケーリングが自動管理され、コールドスタートを許容できるアイドル期間を含むトラフィックに適しています。SageMaker提供のコンテナを使用することも、独自のコンテナを持ち込むこともできます。Vertex AIでは、事前構築済みコンテナまたはカスタムコンテナ上で、Pythonアプリケーションによるカスタムトレーニングを実行できます。Azure Machine Learningはデータストアを通じて既存のAzureストレージに接続し、マネージドオンラインエンドポイントからモデルを提供します。この幅広さが汎用プラットフォームの強みです。当社の評価では、カスタムYOLOワークフローにはより多くの設定が必要です。コンテナ要件は、選択したトレーニングとモデル提供の方法によって異なります。AWSを利用し続ける場合は、SageMakerデプロイガイドでYOLOモデルをそこで提供する方法を説明しています。
Ultralytics Platformは意図的に対象を絞っています。Ultralytics YOLOモデルを中心に構築されているため、上記の手順を使えば、トレーニングスクリプトやモデル提供用コンテナは不要です。組織で各統合に一時的なSTS認証情報が必須の場合や、1つのエンドポイントを高い同時負荷のもとで多数のインスタンスにスケールさせる必要がある場合には適していません。推論の実行場所を検討中の場合は、クラウドとセルフホストの比較ガイドでコスト、レイテンシ、データ管理を比較できます。
よくある質問
Ultralytics Platformでは、S3バケットを接続して画像をその場でインデックス化し、クラウドGPU上でYOLO26をトレーニングして、専用のHTTPSエンドポイントにモデルをデプロイできます。Amazon SageMaker AIもS3からトレーニングでき、モデル提供方法に応じて、SageMaker提供のコンテナまたはカスタムコンテナを使ったリアルタイム、サーバーレス、非同期推論を提供します。Google Vertex AIとAzure Machine Learningでも同様のワークフローを利用できますが、既存のS3バケットではなく、それぞれのストレージであるCloud StorageとAzureストレージを中心としています。
Platformはデータセットのコピーを別途保持しません。画像をインデックス化し、元画像をオンデマンドでストリーミングします。AI機能が有効な場合、クラウドトレーニングでは実行中にバケット外の一時コピーが使用され、類似画像検索では各画像の埋め込みが保持されます。Platformがオブジェクトを変更または削除することはありません。
現在はできません。Platformでは、専用IAMユーザーの有効期間の長いアクセスキーが必要です。データセットの接続中に期限切れになるため、STS認証情報は拒否されます。ユーザーの権限は一覧表示と読み取りのみに制限し、アクセスを取り消すにはIAMでキーを無効化してください。
S3データセットには、Pro(1シートあたり月額29ドル、毎月1シートあたり30ドル分のクレジット付き)またはEnterpriseプランが必要です。トレーニングはGPU稼働時間に応じて課金され、開始前にトレーニングダイアログでコストを見積もれます。デフォルトのエンドポイントサイズは無料でゼロまでスケールし、カスタムサイズは稼働中に時間単位で課金されます。
はい。Google Cloud StorageはサービスアカウントのJSONキーとStorage Object Viewerロールを使用して接続し、Azure Blob StorageはHTTPSアカウントアクセスキーの接続文字列を使用して接続します(SASトークンの文字列は受け付けられません)。データセット、トレーニング、デプロイの手順は同じです。
データセットは作成時に一度だけインデックス化されるため、新しいオブジェクトは自動的に取り込まれません。既存のオブジェクトを上書きせずに新しいオブジェクトを追加し、それらを含む新しいデータセットを作成してから、再度トレーニングまたはファインチューニングを行ってください。
はい。モデルページから重みをダウンロードするか、モデルをONNX、TensorRT、CoreMLなどの形式にエクスポートしてから、Ultralytics Pythonパッケージを使用して独自のサーバーまたはエッジデバイスで実行できます。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









