Claude Fable 5.2 уже доступна, но отказывается анализировать рентгеновские снимки для досмотра
Вышла Claude Fable 5.2, но она отказывается размечать набор данных рентгеновских снимков IEDXray для досмотра на Ultralytics Platform: заблокированы все 10 снимков, тогда как модели с открытыми весами ответили.
 Glenn Jocher14 мин. чтения
Anthropic выпустила Claude Fable 5.2 9 ноября 2026 года и заявила, что она «почти по всем оцененным нами возможностям превосходит Opus 5.5». В тот же день мы проверили ее на UL37 — нашем бенчмарке обнаружения на 36 наборах данных. На одном из этих наборов данных модель отказалась анализировать единственное изображение.
На первом снимке — ноутбук в сумке: через корпус видна печатная плата, а рядом зажаты две батареи. Мы попросили Claude Fable 5.2 нарисовать вокруг них ограничивающие рамки. Менее чем через две секунды API Anthropic вместо ответа выдал блокировку: «Этот запрос вызвал ограничения на контент, связанный с разработкой мощных взрывчатых веществ, и был заблокирован согласно Политике использования Anthropic».
То же произошло со всеми 10 рентгеновскими снимками для досмотра из набора данных, в том числе с пятью снимками, на которых были только обычный телефон, ноутбук, пейджер или рация. Ни одна другая протестированная нами модель не отказалась обработать хотя бы один снимок: ни GPT-6.1, Gemini или Grok, ни одна модель с открытыми весами или китайская модель и даже не собственные Claude Opus 5.5, Sonnet 5.5 и Haiku 5.5 от Anthropic.
Во всех остальных случаях автоканнотирование с Claude Fable 5.2 работает отлично. Модель набрала 0.544 mAP50 и заняла второе место среди 44 моделей в нашем рейтинге VLM, уступив GPT-6.1 Terra, а ее рамки оказались самыми точными из всех измеренных нами. Сегодня она доступна на Ultralytics Platform. Ниже — о том, что она отказывается делать, что у нее получается блестяще и подходит ли она для твоего процесса разметки.
Фильтр Anthropic заблокировал все рентгеновские снимки для досмотра в UL37#
UL37 измеряет, насколько рамки модели совпадают с разметкой людей на 360 изображениях: по 10 из каждого из 36 реальных наборов данных для обнаружения объектов. Один из них — IEDXray, набор рентгеновских снимков багажа со сканеров, созданный для обучения детекторов угроз в аэропортах, на границах и при охране мероприятий. Его 11 классов охватывают обычную электронику (ноутбуки, телефоны, пейджеры, рации, батареи), модифицированные версии этих предметов и взрывчатые вещества.
 Предпросмотр IEDXray Improvised Device X-ray, индекс 1На слое аннотаций отображается 3 метки
 Предпросмотр IEDXray Improvised Device X-ray, индекс 2На слое аннотаций отображается 1 метка
 Предпросмотр IEDXray Improvised Device X-ray, индекс 3На слое аннотаций отображается 2 метки
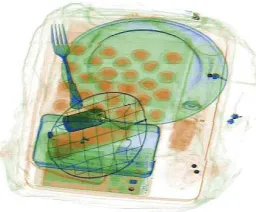 Предпросмотр IEDXray Improvised Device X-ray, индекс 4На слое аннотаций отображается 1 метка
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2 отказалась обрабатывать все 10 изображений. Ответ на каждый запрос приходил за 1,0–4,7 секунды с причиной остановки Anthropic refusal и без рамок. Platform сообщает пользователю, что модель «остановилась до завершения обнаружения объектов (отказ). Попробуй другую модель».
Чтобы точно выяснить причину, 10 ноября мы повторили в API Anthropic рабочие запросы Platform для всех десяти снимков. Все десять запросов завершились одинаково: причина остановки refusal, категория general_harms, ноль выходных токенов и приведенное выше сообщение о «мощных взрывчатых веществах». В сообщении предлагается запросить «исключение с учетом того, как ты используешь Claude» через справочный центр Anthropic. Разработчикам интеграций с API оно указывает на документацию Anthropic об отказах, где рекомендуется настроить резервную модель.
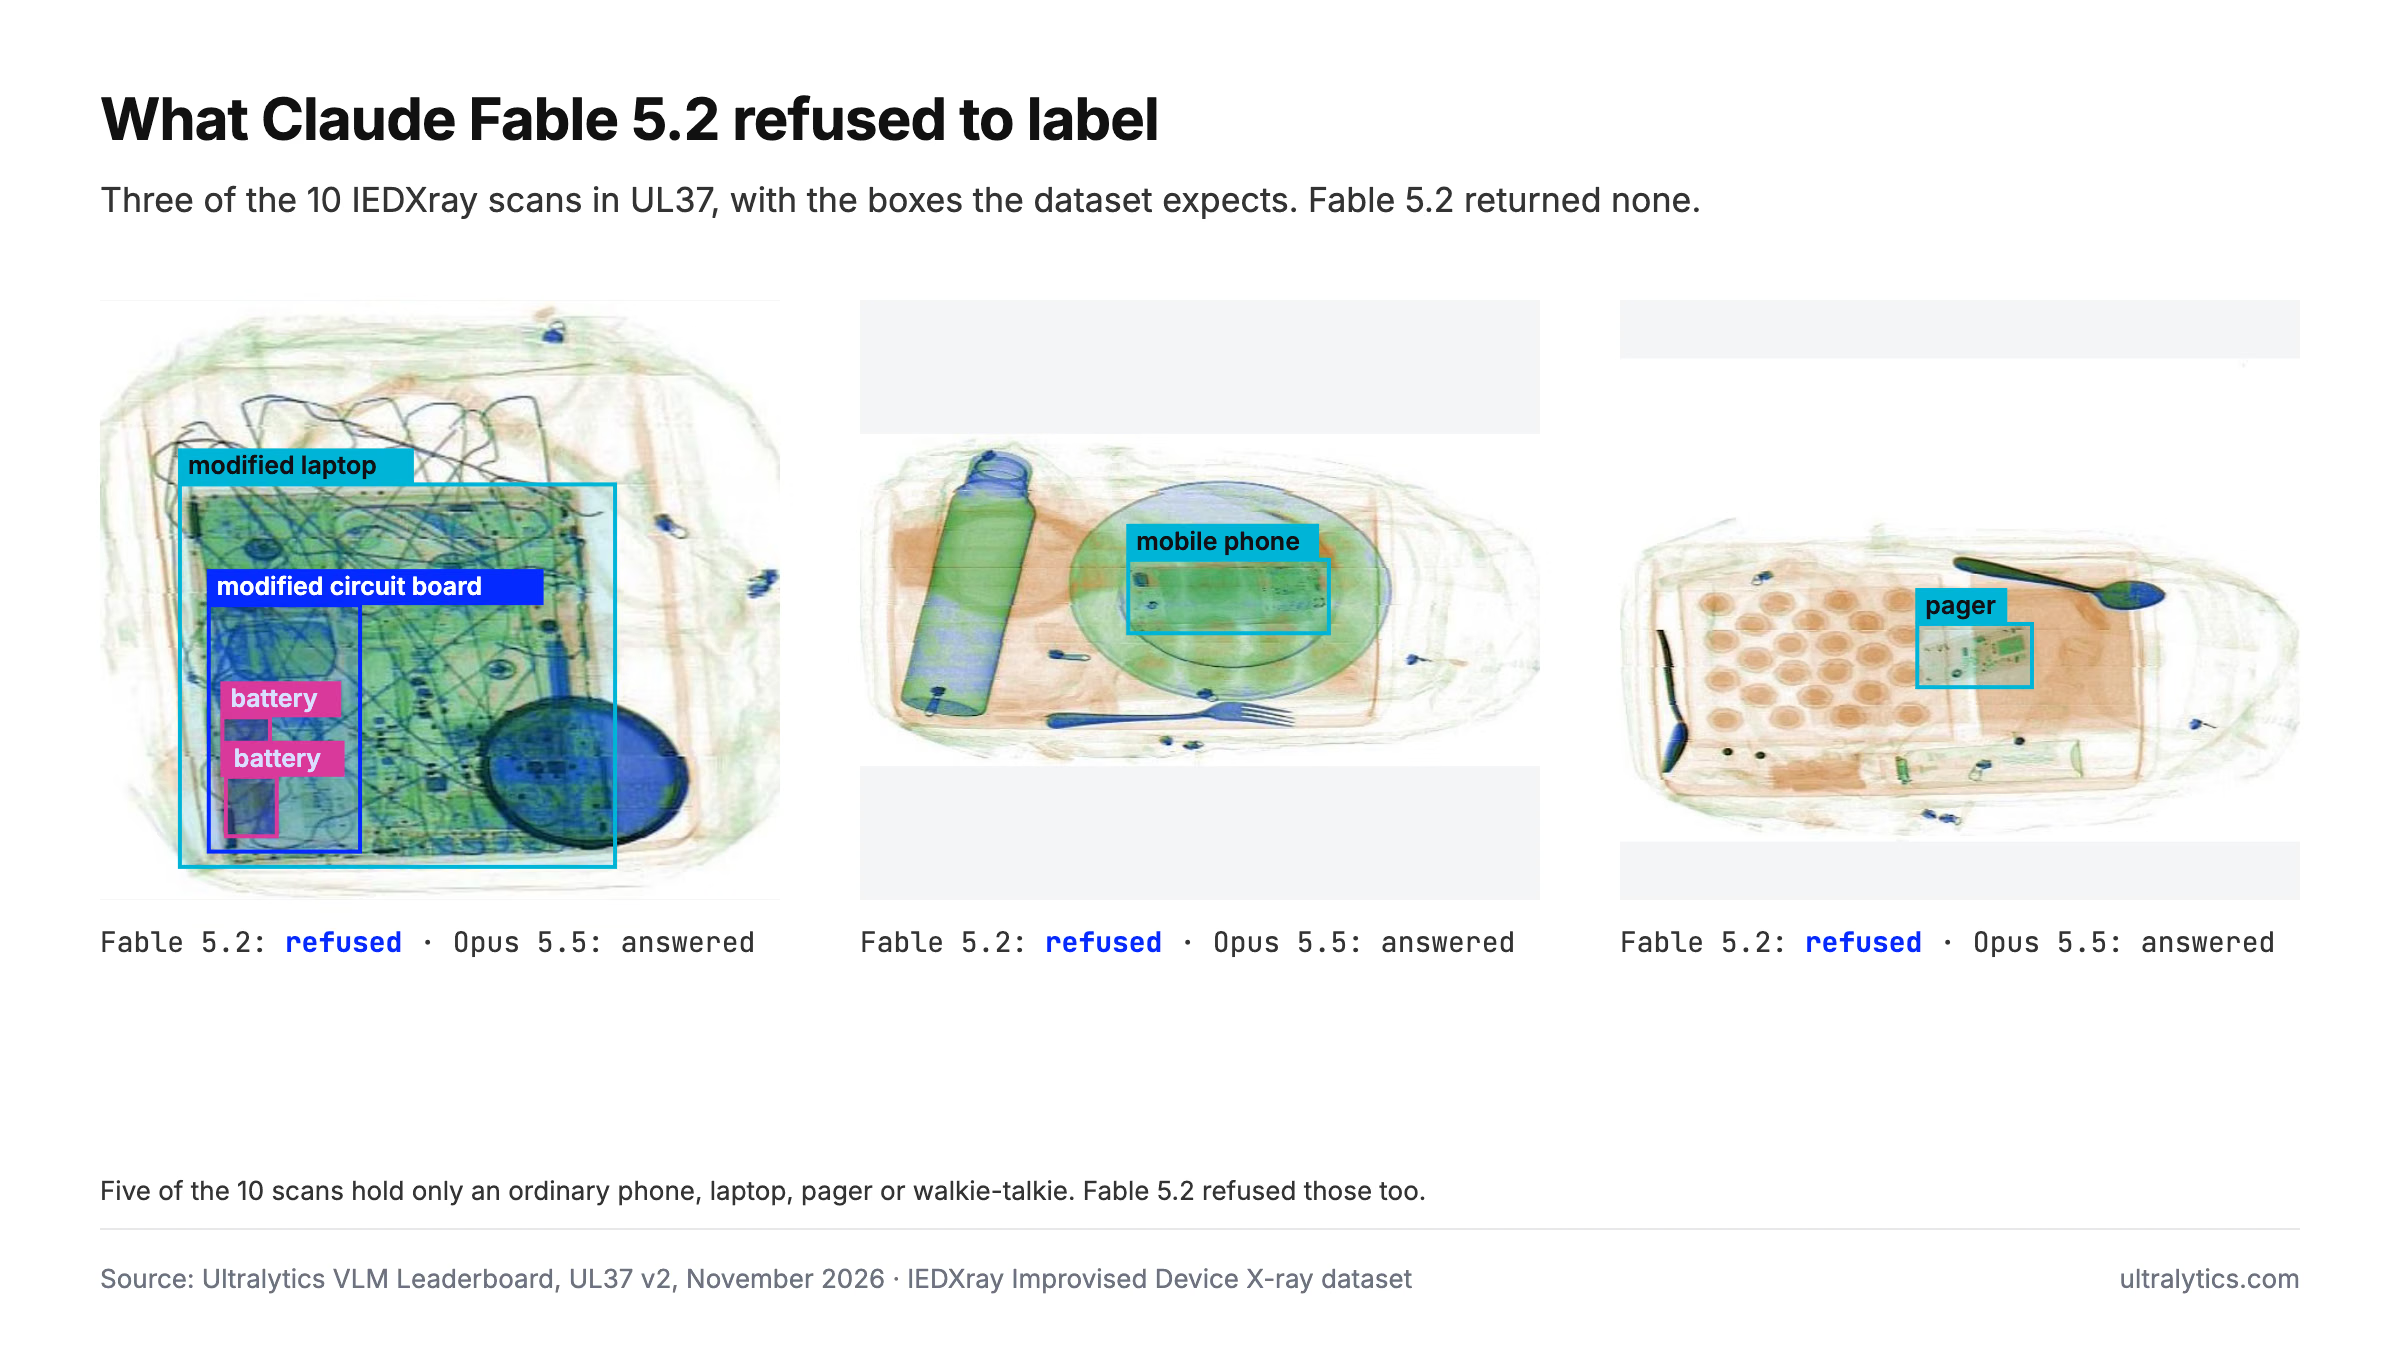
Три из 10 снимков IEDXray с ожидаемыми рамками. Claude Fable 5.2 отказалась обработать все три; Claude Opus 5.5 ответила на все десять снимков в том же запуске.
Блокировка связана не с содержимым изображения. На среднем снимке — просто мобильный телефон. На пяти из десяти снимков нет ни модифицированных устройств, ни взрывчатых веществ, но Fable 5.2 отказалась обработать каждый из них. Похоже, фильтр реагирует на саму задачу: это набор данных для досмотра, в списке классов которого упоминаются взрывчатые вещества.
Fable 5.2 отказывает чаще, чем Fable 5.1, а не реже#
В анонсе запуска Anthropic сказано, что меры защиты Claude Fable 5.2 от киберугроз и биологических угроз «вызывают меньше необоснованных блокировок», чем в Fable 5.1: по ранним тестам, примерно на 55% меньше. На рентгеновских снимках для досмотра мы увидели обратное: Fable 5.1 отказалась обработать один снимок из десяти, а Fable 5.2 — все десять.
Anthropic также утверждает, что Fable 5.2 и Claude Mythos 5.2 — одна и та же базовая модель. Mythos 5.2 поставляется без некоторых мер защиты от киберугроз и биологических угроз и доступна только организациям, прошедшим проверку Anthropic. Иными словами, меры защиты — это отдельный от способности модели видеть слой, который определяет поставщик. Fable 5.1 обработала девять из тех же снимков и набрала 0.15.
Для команды, которая разрабатывает детектор для досмотра багажа, практический вывод прост. Самая дорогая модель Claude не поможет разметить данные, а правила изменились от одной версии к следующей.
Все модели с открытыми весами разметили снимки, которые Fable отклонила#
Среди всех 44 моделей в нашем рейтинге только две когда-либо отказывались обрабатывать снимки IEDXray, и обе — Claude Fable: версия 5.1 отказалась от одного снимка, версия 5.2 — от десяти. Ни одна другая модель не отказала: ни от OpenAI, Google, xAI, Meta, китайской лаборатории, ни из собственных линеек Opus, Sonnet и Haiku Anthropic.
Сюда входят все 19 моделей, размещенных у нас на собственных серверах Platform, а также модели с открытыми весами, такие как Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text и Moondream 3.1. Ни одна из них не отказалась обработать ни один снимок. Moondream 3.1 — модель с открытыми весами, для которой на Platform не нужен ключ API, — набрала на IEDXray 0.27 mAP50, уступив только Gemini 4 Argon с результатом 0.30 и обойдя все модели Claude.
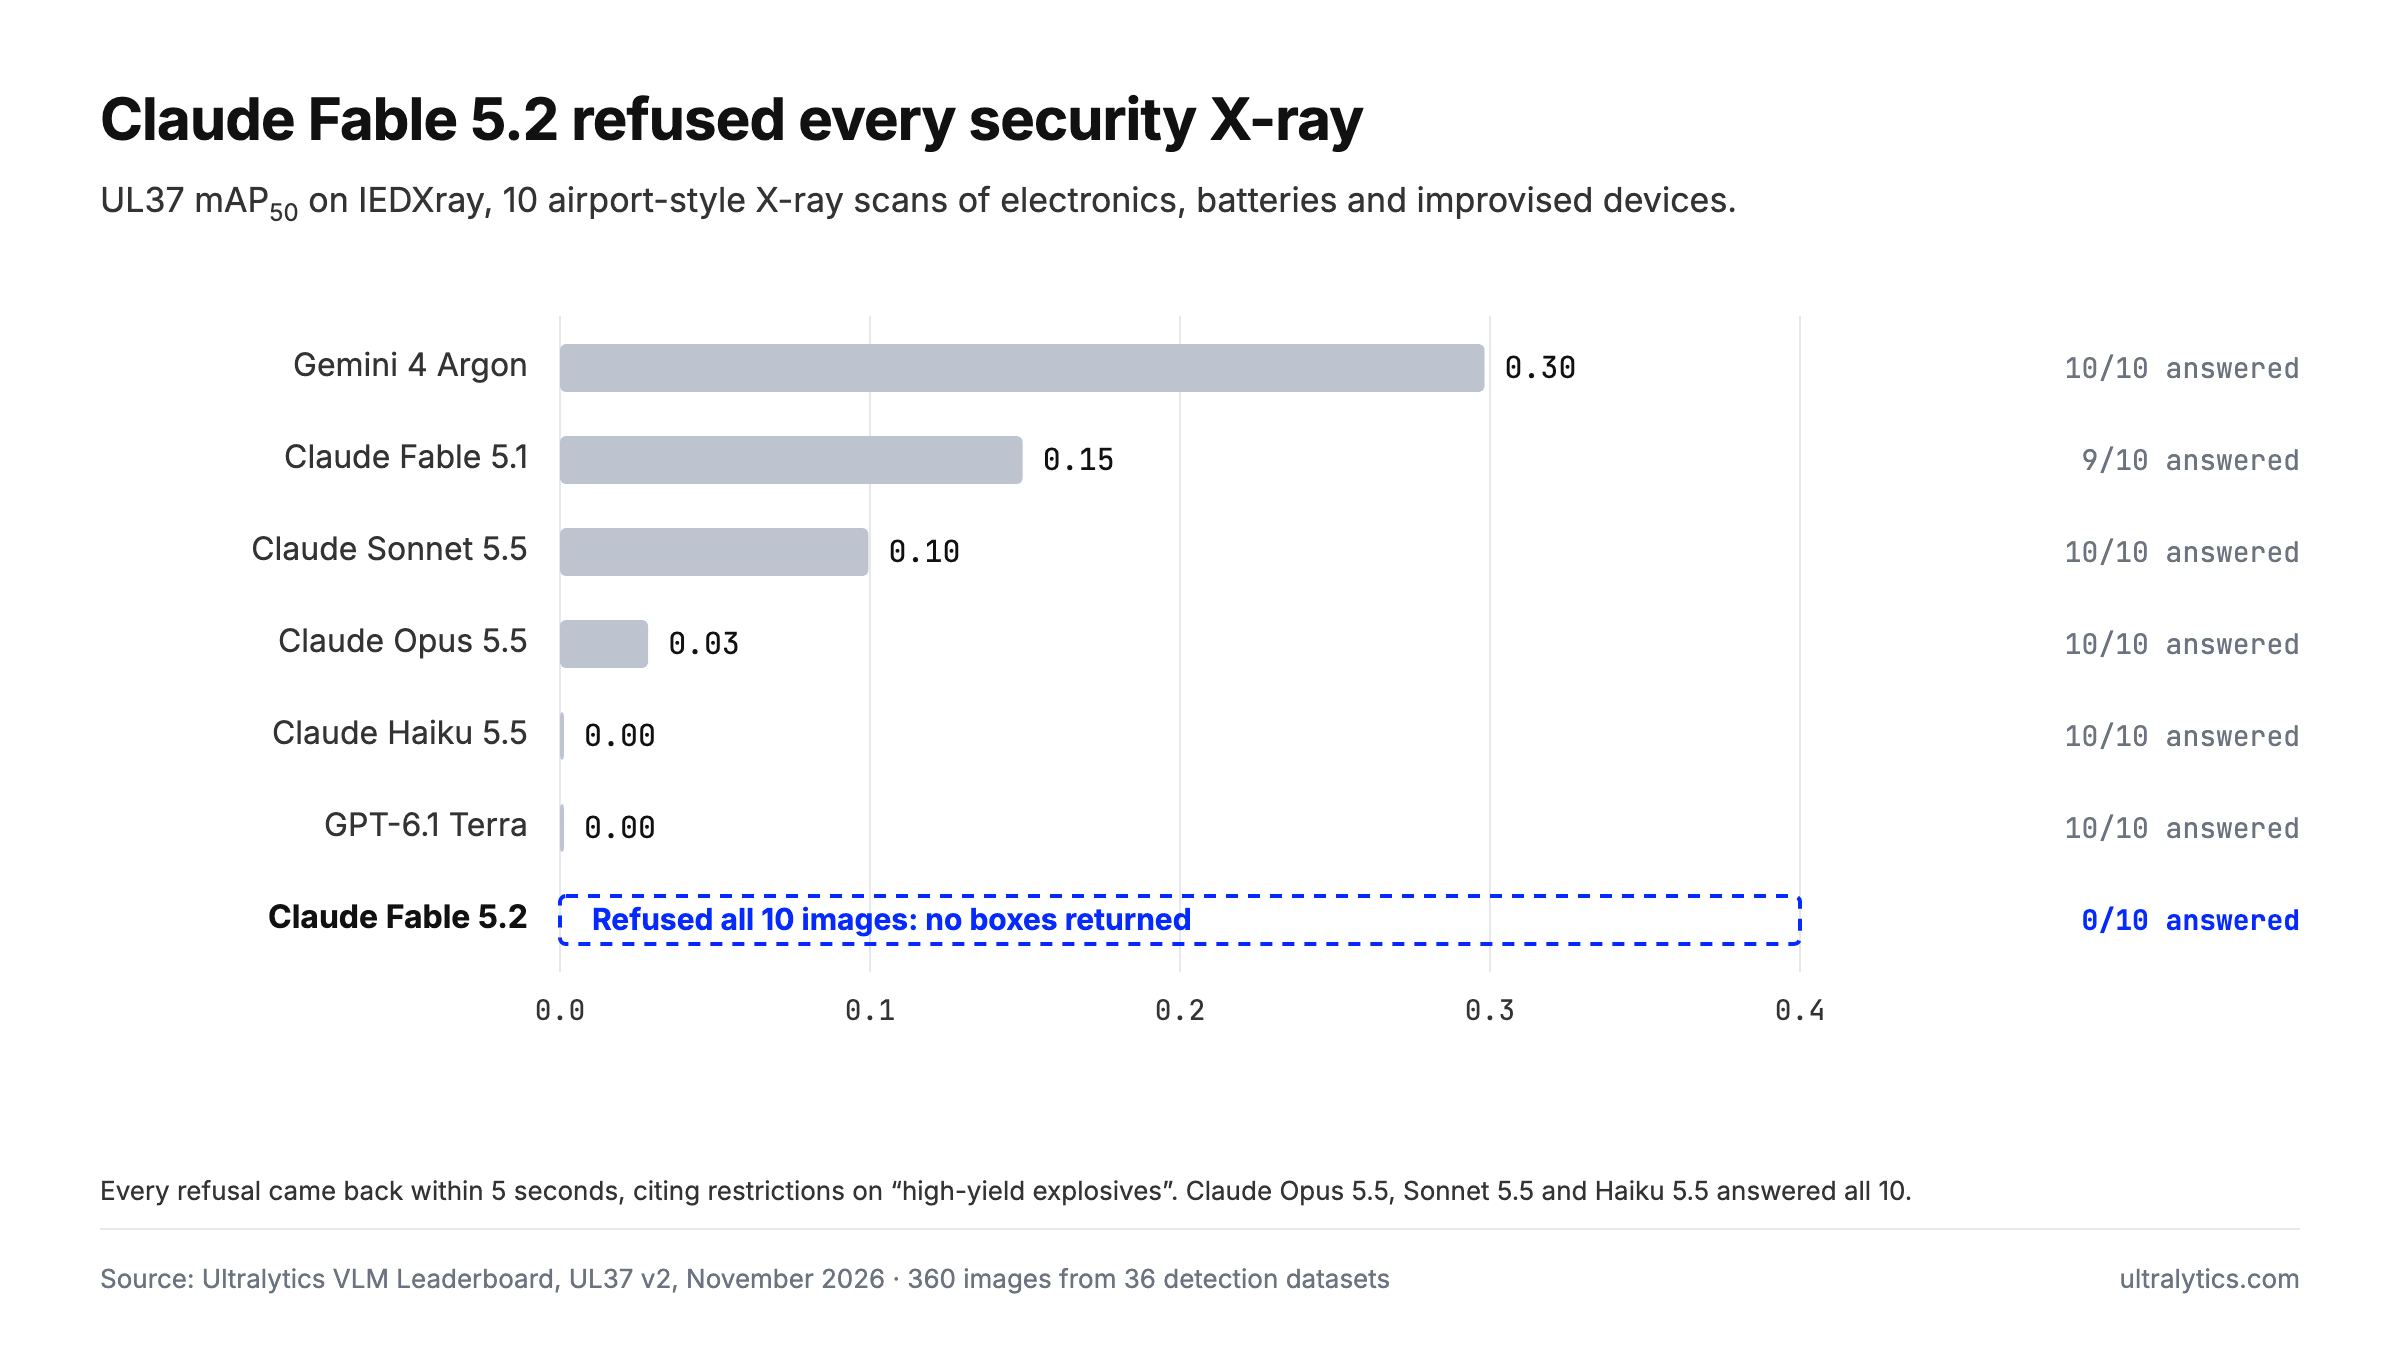
Результаты mAP50 на IEDXray для линейки Anthropic и двух лидеров рейтинга, UL37 v2, стандартный уровень рассуждений. Fable 5.2 не обработала ни один из 10 снимков.
Китайские модели обычно попадают в заголовки из-за того, о чем они отказываются говорить. Здесь всё наоборот: ведущая американская лаборатория подвергла результаты цензуре, тогда как все протестированные нами китайские модели охотно ответили. Alibaba Qwen, Kimi от Moonshot, DeepSeek, GLM от Zhipu, MiMo от Xiaomi, MiniMax и HY4 от Tencent не отказались ни от одного из десяти снимков, а размещенные у нас модели Qwen с открытыми весами ответили на каждый. Флагманская модель Anthropic стоимостью $8 за миллион входных токенов отказалась смотреть.
Рентгеновские снимки для досмотра — сложная задача для любой модели. Большинство набирает на IEDXray меньше 0.15, поэтому рамки любой модели — лишь первый черновик. Но черновик можно исправить в редакторе разметки. После отказа тебе придется рисовать каждую рамку вручную. Открытые веса также означают, что проверенная сегодня модель завтра будет вести себя так же, поскольку между тобой и ее результатами нет политики поставщика. Разметив данные, ты можешь обучить собственный детектор Ultralytics YOLO26 и полностью контролировать развернутую модель.
За пределами рентгеновских снимков для досмотра Claude Fable 5.2 — вторая по качеству модель для разметки из всех протестированных нами#
Все изображения UL37 проходят один и тот же производственный конвейер, который доступен пользователям Platform: используются названия классов из самого набора данных, а затем SAM 3.1 уточняет каждую рамку. Методика опубликована. Вот результаты Fable 5.2:
- mAP50: 0.544, № 2 из 44
- mAP50-95: 0.347, № 1 из 44, немного выше результата GPT-6.1 Terra — 0.345
- Точность и полнота: 0.602 и 0.620
- Стоимость у провайдера: $37.55 за 1000 изображений
- Медианное время обработки изображения: 4,6 с
- Неудачные запросы: 11 из 360: 10 отказов и один запрос, превысивший лимит Platform в 115 секунд
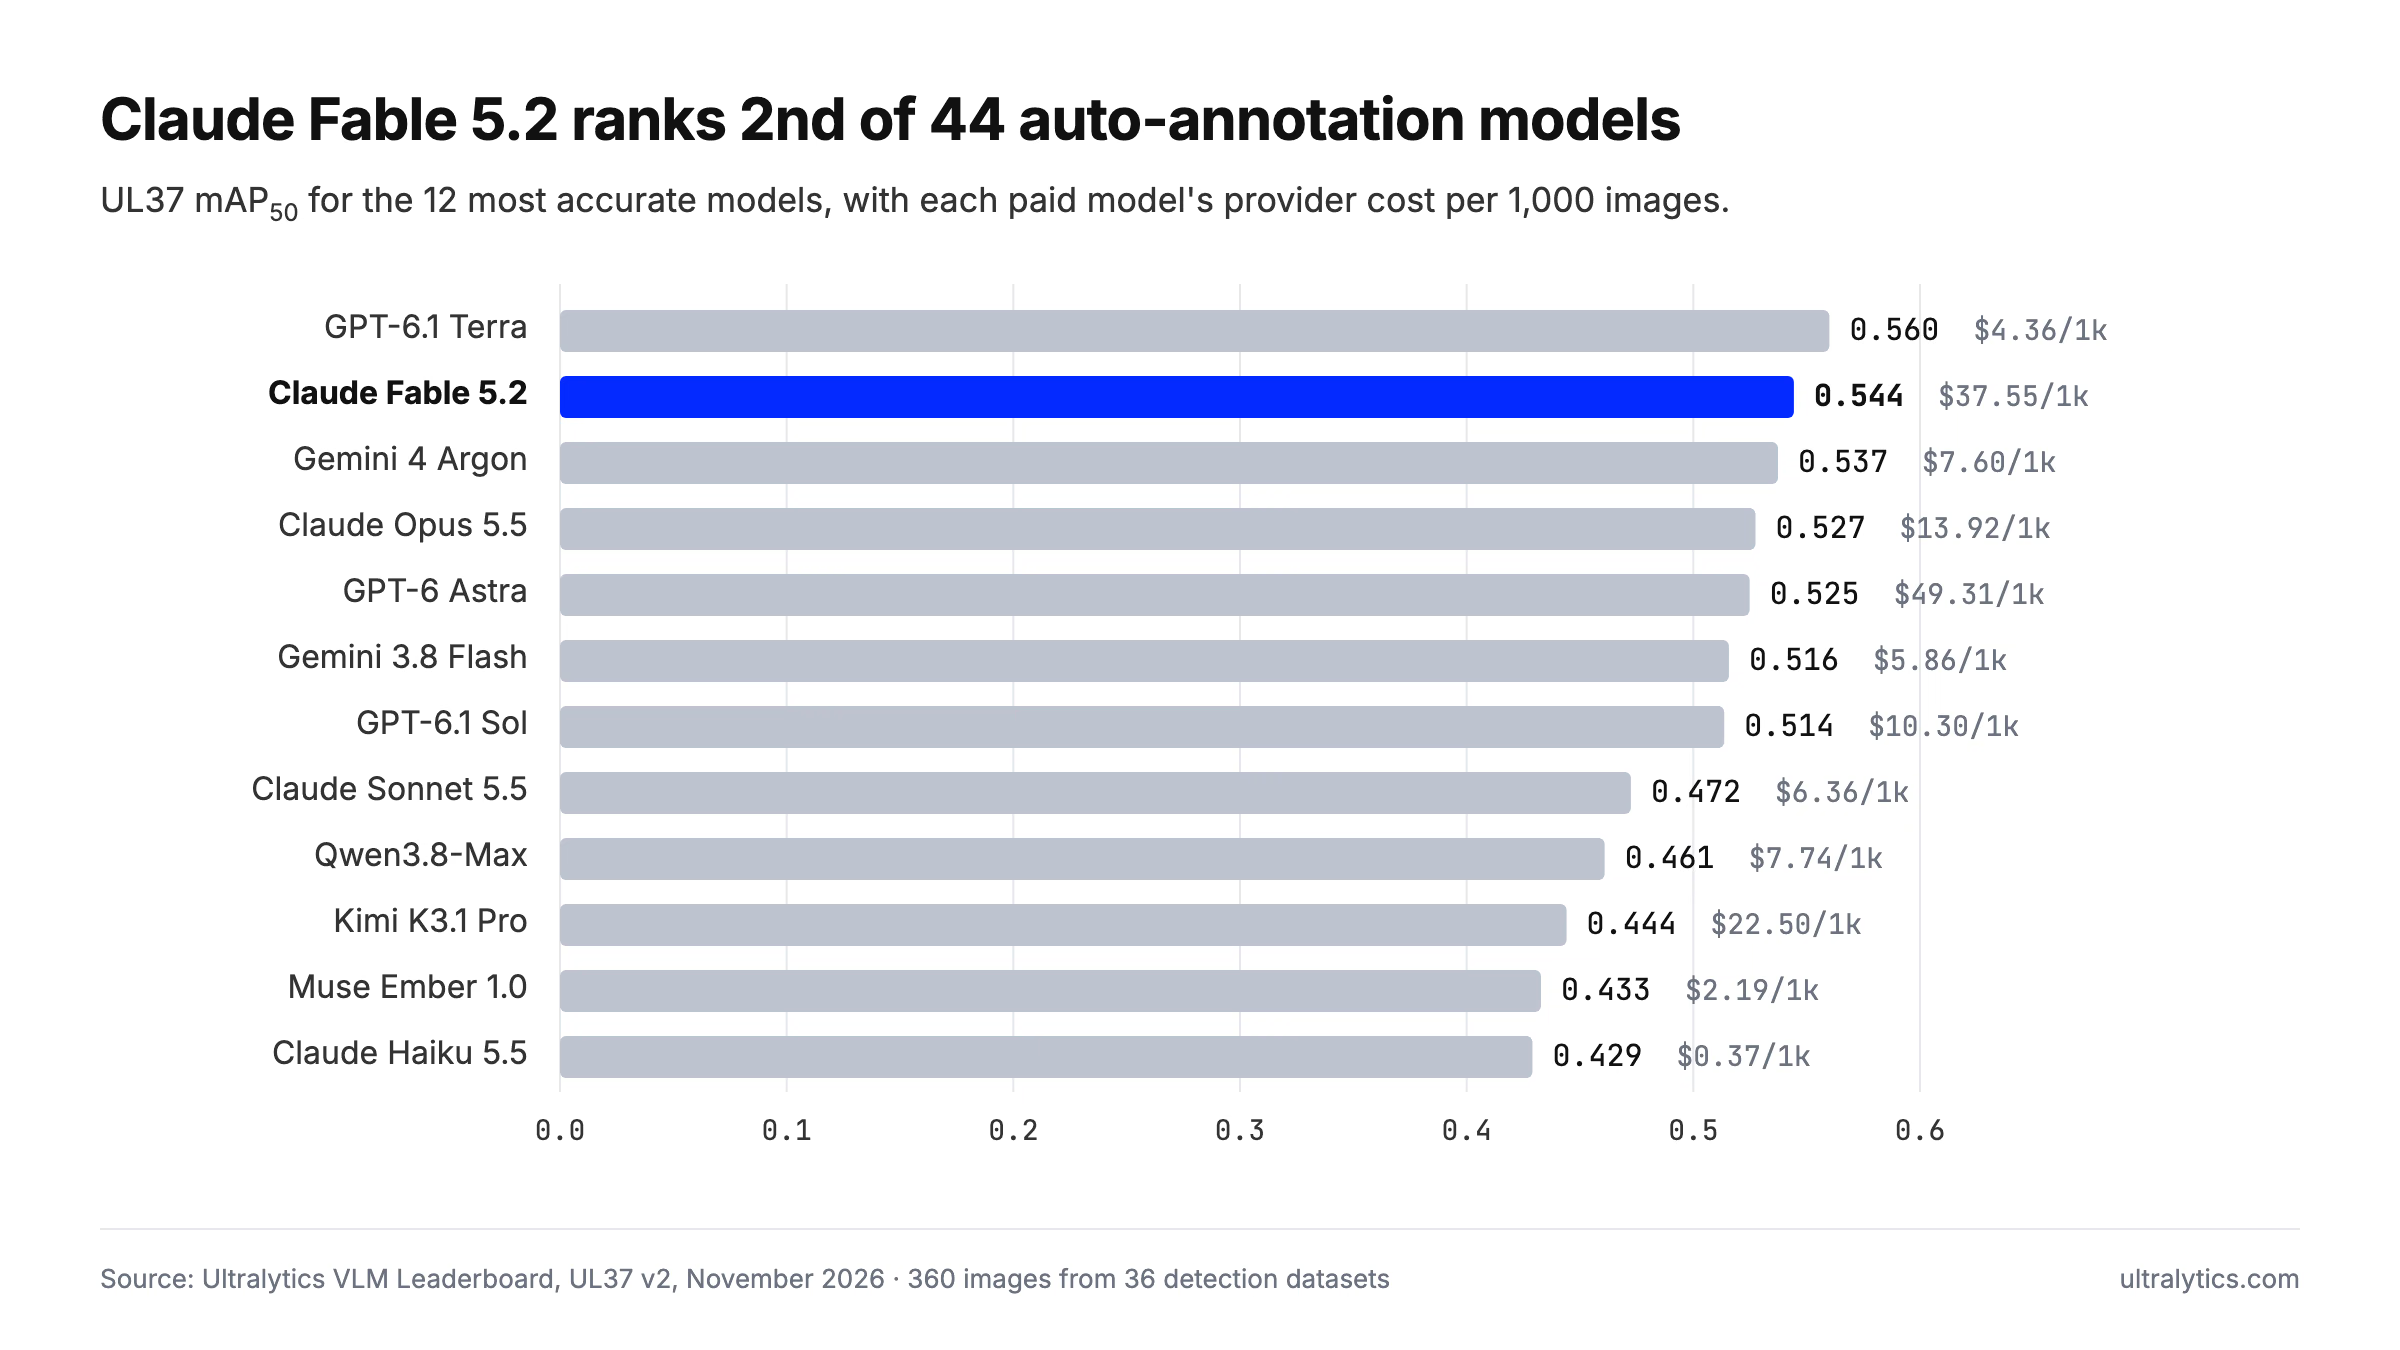
Результаты mAP50 на UL37 для 12 самых точных из 44 моделей и стоимость у провайдера за 1000 изображений, 10 ноября 2026 года.
Первое место по mAP50-95 имеет значение. Эта более строгая метрика усредняет степень перекрытия рамок при порогах от 50% до 95%, поэтому она выше оценивает рамки, точно охватывающие каждый объект, а не просто примерно накрывающие его. Исходные рамки Fable 5.2 уже набирают 0.538 mAP50 до уточнения SAM 3.1, после которого результат повышается до 0.544.
В 22 из 36 наборов данных модель входит в пятерку лучших, а в трех занимает первое место: ланч-поднос из школьной столовой UEC (0.96), обнаружение баскетбольных мячей и колец (0.85) и заболевания листьев в PlantDoc (0.52). По направлениям она лидирует в розничной торговле, а также в естественной среде и сельском хозяйстве, опережая Claude Opus 5.5 с небольшим отрывом. На 10 эталонных изображениях COCO 2017, оцененных отдельно, модель набирает 0.686 — лучший результат среди языковых моделей; выше только модели сегментации SAM 3 и SAM 3.1 Text.
Из-за отказов Fable 5.2 получила полный ноль на одном наборе данных, но не потеряла первое место. Если исключить IEDXray, средний результат Fable 5.2 составляет 0.560, тогда как у Terra, которая также получила там ноль, но не отказала, — 0.576.
Огромный скачок по сравнению с Claude Fable 5.1#
Fable 5.2 превосходит Claude Fable 5.1 на 31 из 36 наборов данных и стоит дешевле в расчете на изображение.
| Результат UL37 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Точность / полнота | 0.602 / 0.620 | 0.506 / 0.485 |
| Место в рейтинге | 2-е место из 44 | 13-е место из 44 |
| Стоимость провайдера на 1 000 изображений | $37.55 | $43.75 |
| Медианное время на изображение | 4.6 s | 2,6 с |
| Отклоненные изображения IEDXray | 10 | 1 |
Точность и полнота выросли одновременно: это означает, что нужно удалять меньше ложных рамок и дорисовывать меньше пропущенных объектов. Наибольшие улучшения впечатляют. На изображениях пшеницы GWHD результат Fable 5.1 составлял 0.24, а Fable 5.2 — 0.77. Товары на кассах розничных магазинов RPC выросли с 0.57 до 0.90, тепловизионные изображения с дронов HIT-UAV — с 0.17 до 0.48, а снимки щитовидной железы на УЗИ TN5000 — с 0.03 до 0.44.
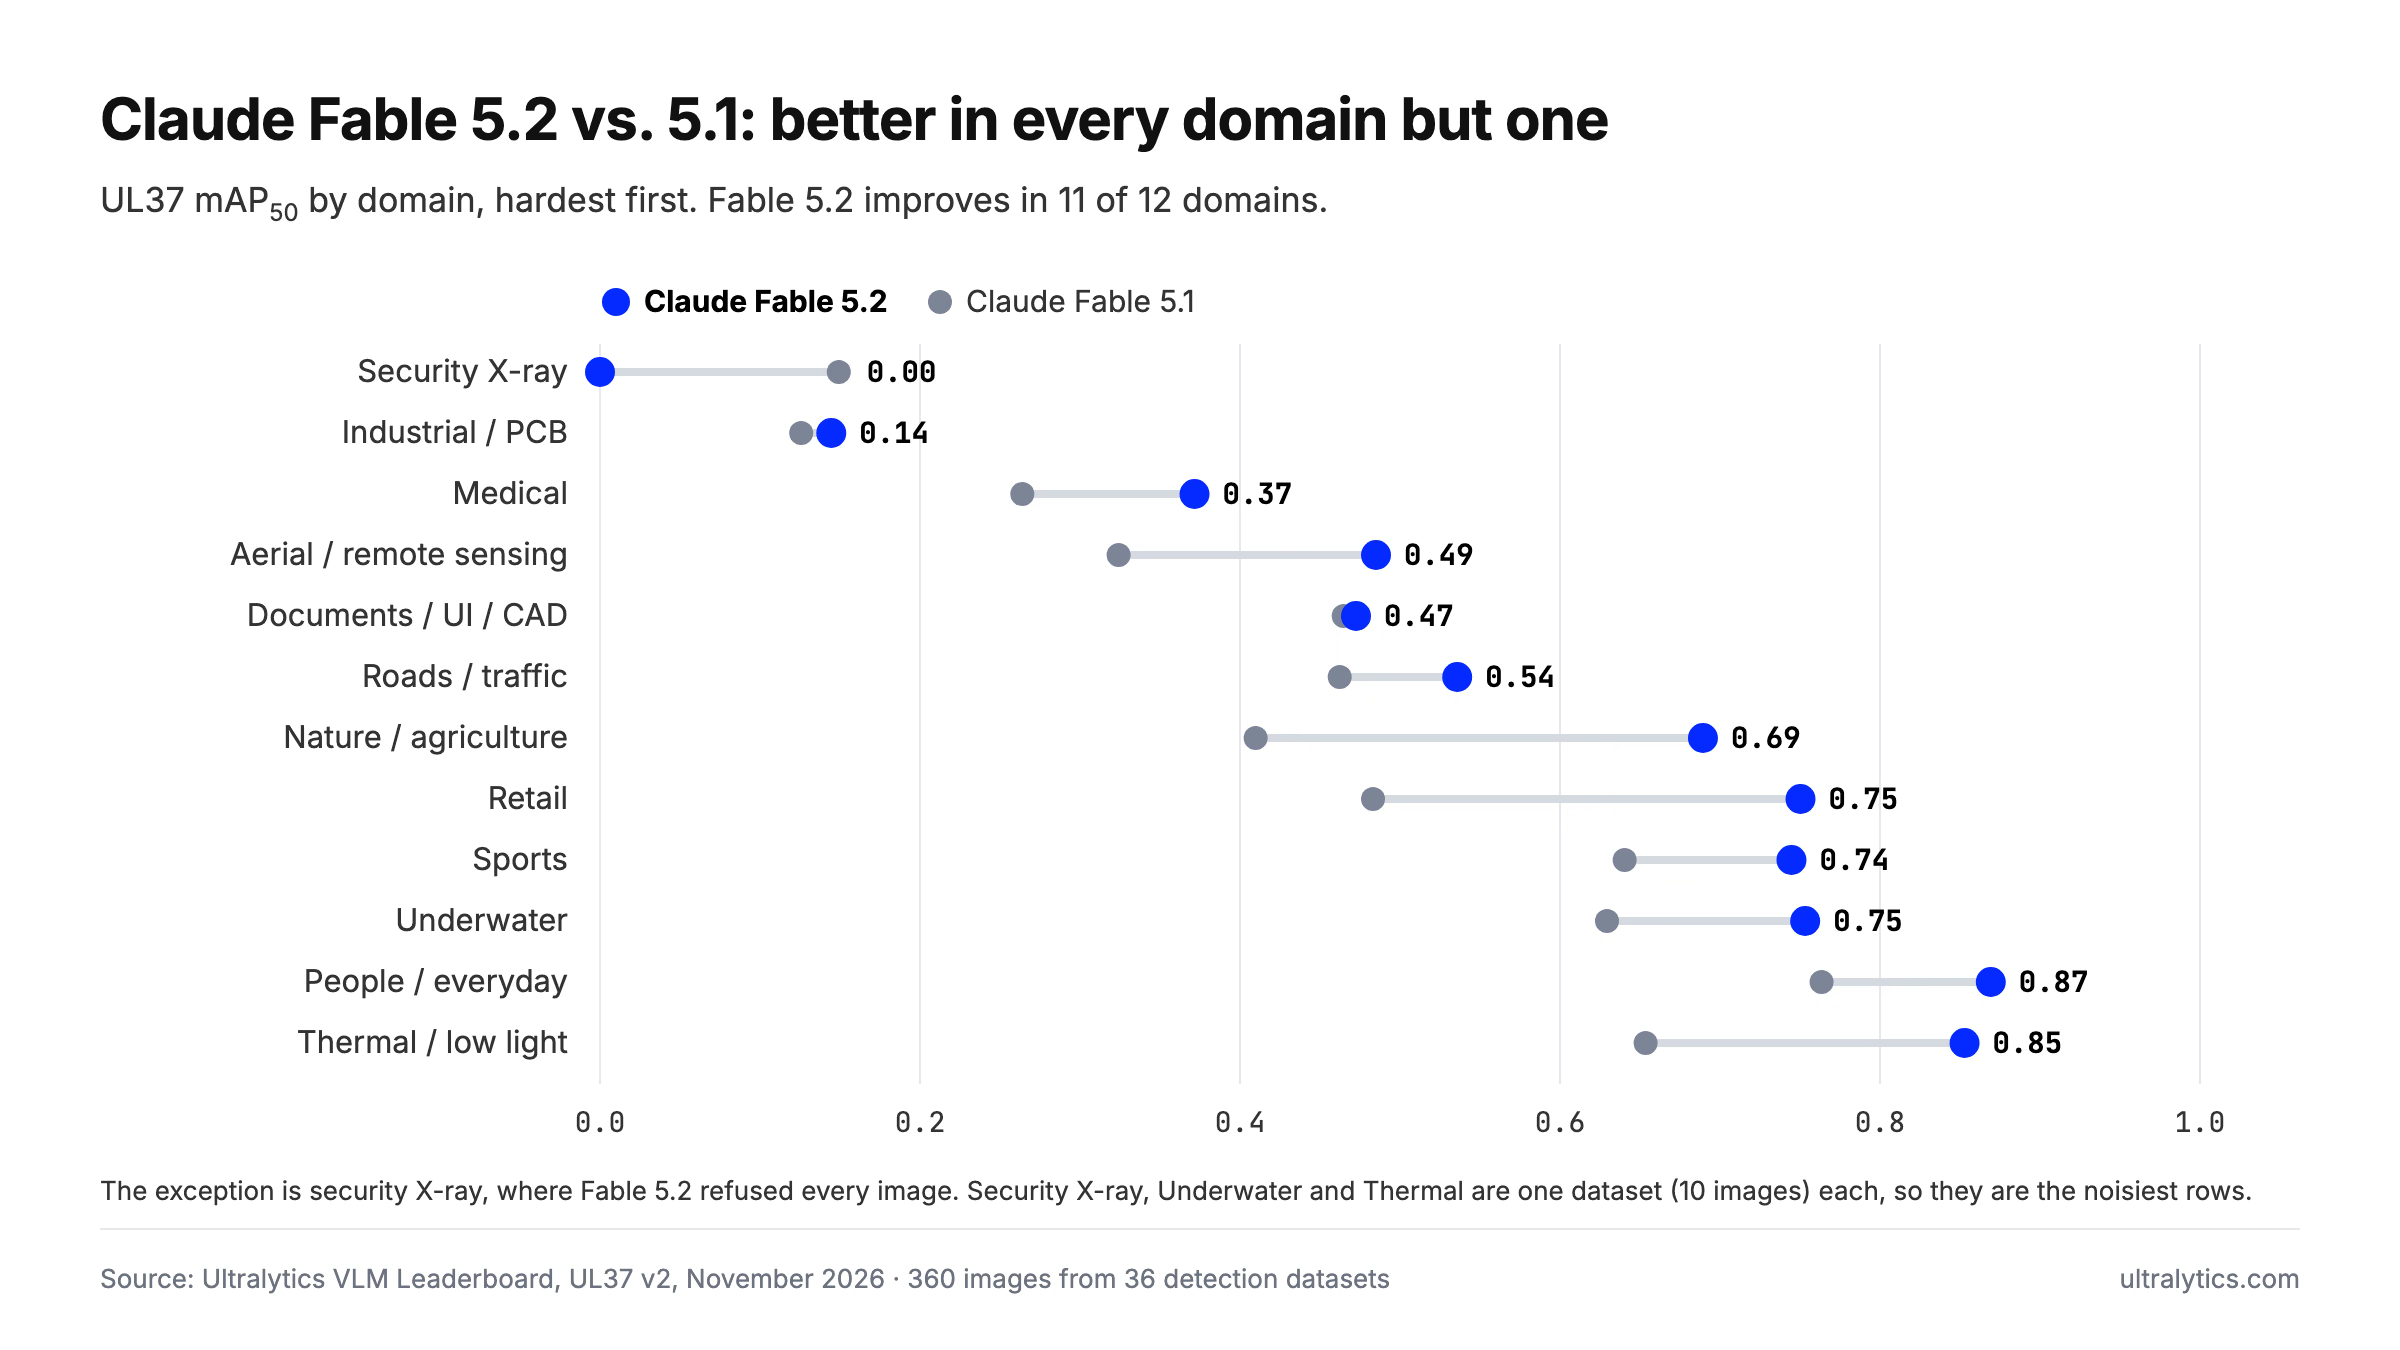
Результаты mAP50 на UL37 по направлениям, от самого сложного к самому простому; Claude Fable 5.2 и Claude Fable 5.1 при стандартном уровне Anthropic.
Результаты улучшились в одиннадцати из двенадцати направлений. Единственное снижение — на рентгеновских снимках для досмотра: с 0.15 до нуля. Причина — отказ, а не неспособность модели видеть. Результат на дорожной разметке CeyMo также снизился с 0.85 до 0.74.
Сравнение Claude Fable 5.2 с GPT-6.1 Terra, Gemini 4 Argon и Claude Opus 5.5#
| Модель | UL37 mAP50 | mAP50-95 | Прецизионность | Полнота | Стоимость на 1 000 изображений | Медианное время на изображение |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 с |
В прямом сравнении Fable 5.2 превосходит Terra на 18 наборах данных и уступает на 16, а на двух результаты одинаковы. Argon она обходит со счетом 21:15, а Opus 5.5 — 22:14. У нее самая высокая полнота из четырех моделей, поэтому она пропускает меньше всего объектов, но точность самая низкая, поэтому придется удалить несколько дополнительных рамок. В нашем руководстве о том, как выбрать VLM с учетом точности и полноты, объясняется, как найти баланс для твоих данных.
Помимо рентгеновских снимков Fable 5.2 хуже справляется с медицинскими изображениями: в среднем 0.372 по восьми наборам данных против 0.505 у Terra; на печатных платах результат DeepPCB составляет 0.00. В каждом наборе данных всего 10 изображений, поэтому рассматривай результаты на отдельных наборах как ориентиры, а не окончательные выводы.
Сама Anthropic рекомендует начинать большинство задач с Claude Opus 5.5, своей «самой мощной универсальной модели», и переходить на Fable только тогда, когда этого требует задача. Для разметки эта рекомендация уместна. Opus 5.5 достигает 97% от mAP50 Fable 5.2 при 37% ее стоимости, отвечает за 2,7 с и не отказалась обработать ни один рентгеновский снимок.
Сколько стоит пакетная обработка в Claude Fable 5.2#
$37.55 за 1000 изображений — это счет провайдера, рассчитанный на основе сведений Anthropic об использовании токенов и ее опубликованных тарифов: $8 за миллион входных токенов и $40 за миллион выходных токенов, согласно странице с тарифами Anthropic. Fable 5.2 работает со стандартным высоким уровнем рассуждений Anthropic. Пакетная разметка добавляет комиссию Platform за обработку в размере $1.00 за 1000 изображений, поэтому обработка 1000 изображений обойдется примерно в $38.55.
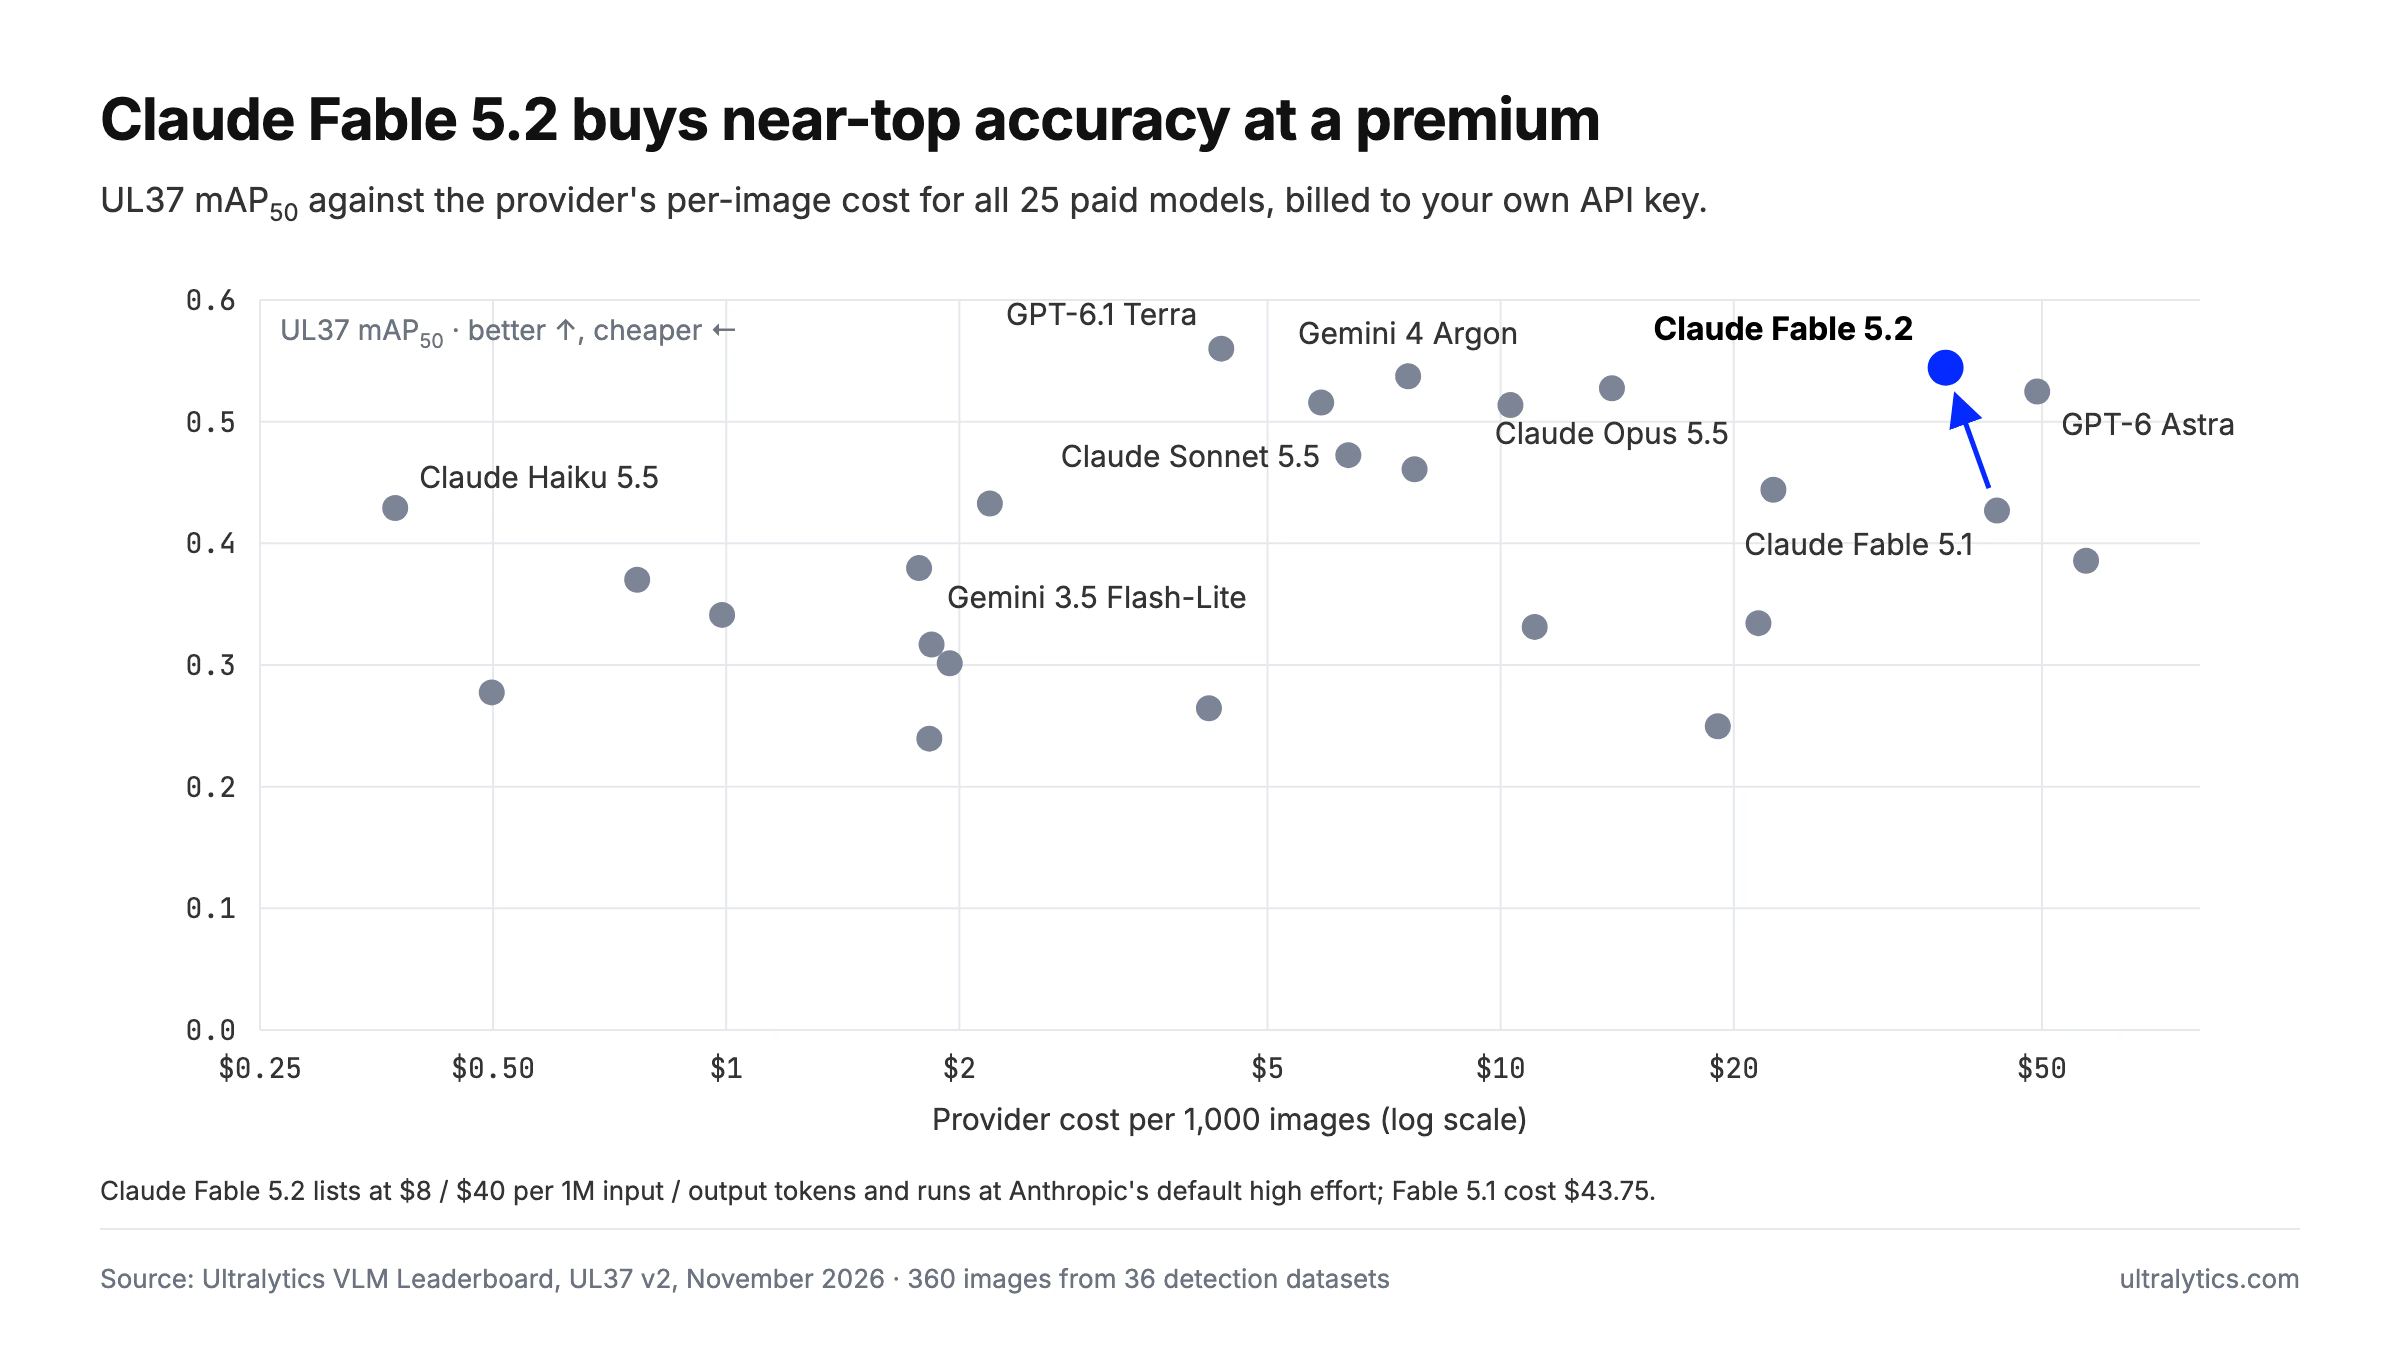
mAP50 на UL37 в зависимости от стоимости у провайдера за 1000 изображений для всех 25 платных моделей; опубликованные цены, 10 ноября 2026 года.
Это более чем в восемь раз дороже Terra ($4.36) при преимуществе всего в 0.016 mAP50. Fable 5.2 оправдывает цену только там, где точность рамок важнее бюджета. Если важна стоимость, Claude Haiku 5.5 набирает 0.429 за $0.37, а для размещенных моделей с открытыми весами ключ API вообще не нужен.
Как запустить автоканнотирование Claude Fable 5.2 на своем наборе данных#
Fable 5.2 — модель с запросами по классам для наборов данных обнаружения с 1–200 классами. Она возвращает рамки для названий классов в твоем наборе данных, а ты проверяешь их перед сохранением.
- Создай ключ на странице ключей Claude API.
- Добавь ключ в разделе Настройки > Ключи API рабочей области Platform, в которой хранится твой набор данных. Anthropic выставляет счет напрямую, Ultralytics не добавляет наценку на токены. Подробности смотри в документации по ключам провайдера.
- В редакторе разметки переключись в режим Smart и выбери Claude Fable 5.2 в разделе Anthropic. Нажми Предсказать или
P, чтобы разметить текущее изображение. - Чтобы разметить все изображения без разметки, выбери Дополнительные действия > Пакетная разметка на странице набора данных. Сначала Platform сохраняет версию набора данных, чтобы ты мог откатить изменения.
- Если для каких-либо изображений получен отказ, запусти пакетную разметку еще раз с другой моделью, например Gemini 4 Argon или размещенной моделью с открытыми весами. Будут размечены только изображения, которые еще не размечены.
- Проверь рамки, сохрани их и обучи модель YOLO26 на полученных данных в той же рабочей области.
Прежде чем фиксировать большой набор данных, открой страницу модели. На ней записанные рамки Fable 5.2 для каждого набора данных бенчмарка сопоставляются с ожидаемыми рамками, а также приводится результат модели на каждом наборе.
Страница модели Claude Fable 5.2
Подробнее о том, как эти модели работают в редакторе, читай в статьях о том, как Ultralytics Platform использует ИИ для автоматизации разметки и почему проверка человеком в цикле остается необходимой.
Кому стоит использовать Claude Fable 5.2#
Выбирай Claude Fable 5.2, когда точность рамок важнее всего, а бюджет — меньше всего: для спорта, розничной торговли, сельского хозяйства и обычных сцен, где она находится на первом месте или близка к нему среди всех протестированных нами моделей. Ее лидерство по mAP50-95 делает ее хорошим вариантом для первого черновика наборов данных, на которых ты планируешь обучать модели при строгих порогах IoU.
Не используй ее для данных о безопасности, обороне и досмотре. Фильтр Anthropic отказался обработать каждый снимок из нашего набора рентгеновских снимков для досмотра, даже те, где был только телефон, и на Platform это никак не обойти. Для таких проектов используй Gemini 4 Argon или модель с открытыми весами, которую контролируешь сам. Для большинства других задач разметки GPT-6.1 Terra или Claude Opus 5.5 дадут почти такие же рамки за малую часть цены.
Часто задаваемые вопросы
API Anthropic блокирует запросы на разметку рентгеновских снимков для досмотра, если они включают классы взрывчатых веществ. Для всех 10 снимков IEDXray в нашем бенчмарке API возвращал причину остановки
refusalи категориюgeneral_harms, ссылаясь на «ограничения на контент, связанный с разработкой мощных взрывчатых веществ», даже для снимков, где были только обычный телефон или ноутбук. Повторное нажатие кнопки «Предсказать» не поможет: для таких изображений используй другую модель.Ни одна другая модель в нашем рейтинге не отказалась обработать снимок IEDXray. Это относится ко всем 19 размещенным у нас моделям, ко всем моделям китайских лабораторий и к Claude Opus 5.5, Sonnet 5.5 и Haiku 5.5 от самой Anthropic. Самый высокий результат показала Gemini 4 Argon — 0.30 mAP50, за ней следует Moondream 3.1 с открытыми весами — 0.27. Все модели плохо справляются с рентгеновскими снимками для досмотра, поэтому проверяй каждую рамку.
Да. Она набирает 0.544 mAP50 на 36 реальных наборах данных для обнаружения, занимает второе место среди 44 моделей и лидирует по более строгой метрике mAP50-95 с результатом 0.347. Лучше всего она работает с розничной торговлей, спортом, сельским хозяйством и обычными сценами, хуже всего — с рентгеновскими снимками для досмотра, медицинскими изображениями и дефектами печатных плат.
Она набирает 0.544 mAP50 против 0.427 у Fable 5.1 и выигрывает на 31 из 36 наборов данных, при этом стоит $37.55 вместо $43.75 за 1000 изображений. Она работает медленнее: 4,6 с на изображение против 2,6 с, а также отказалась обработать все 10 рентгеновских снимков для досмотра, тогда как Fable 5.1 отказалась только от одного.
Около $37.55 за услуги Anthropic, исходя из использования токенов по данным провайдера: $8 за миллион входных токенов и $40 за миллион выходных. Пакетная разметка на Ultralytics Platform добавляет комиссию за обработку в размере $1.00 за 1000 изображений. Ты платишь Anthropic напрямую со своего ключа API.
Terra показывает более высокий результат mAP50: 0.560 против 0.544, и стоит примерно в восемь раз дешевле. У Fable 5.2 рамки немного точнее: 0.347 mAP50-95 против 0.345 у Terra; она выигрывает на 18 наборах данных против 16 у Terra. Для большинства команд Terra — лучший вариант по умолчанию; Fable 5.2 имеет смысл, если точность рамок важнее стоимости.
Автор
Основатель и генеральный директор · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









