Ориентация EXIF в Ultralytics YOLO: почему повёрнутые боком фотографии нарушают работу датасетов
Значения ориентации EXIF от 5 до 8 меняют местами ширину и высоту изображения. Узнай, как пропущенный тег смещает разметку и как Ultralytics теперь правильно отображает изображения с тегом.
 Sergiu Waxmann13 мин. чтения
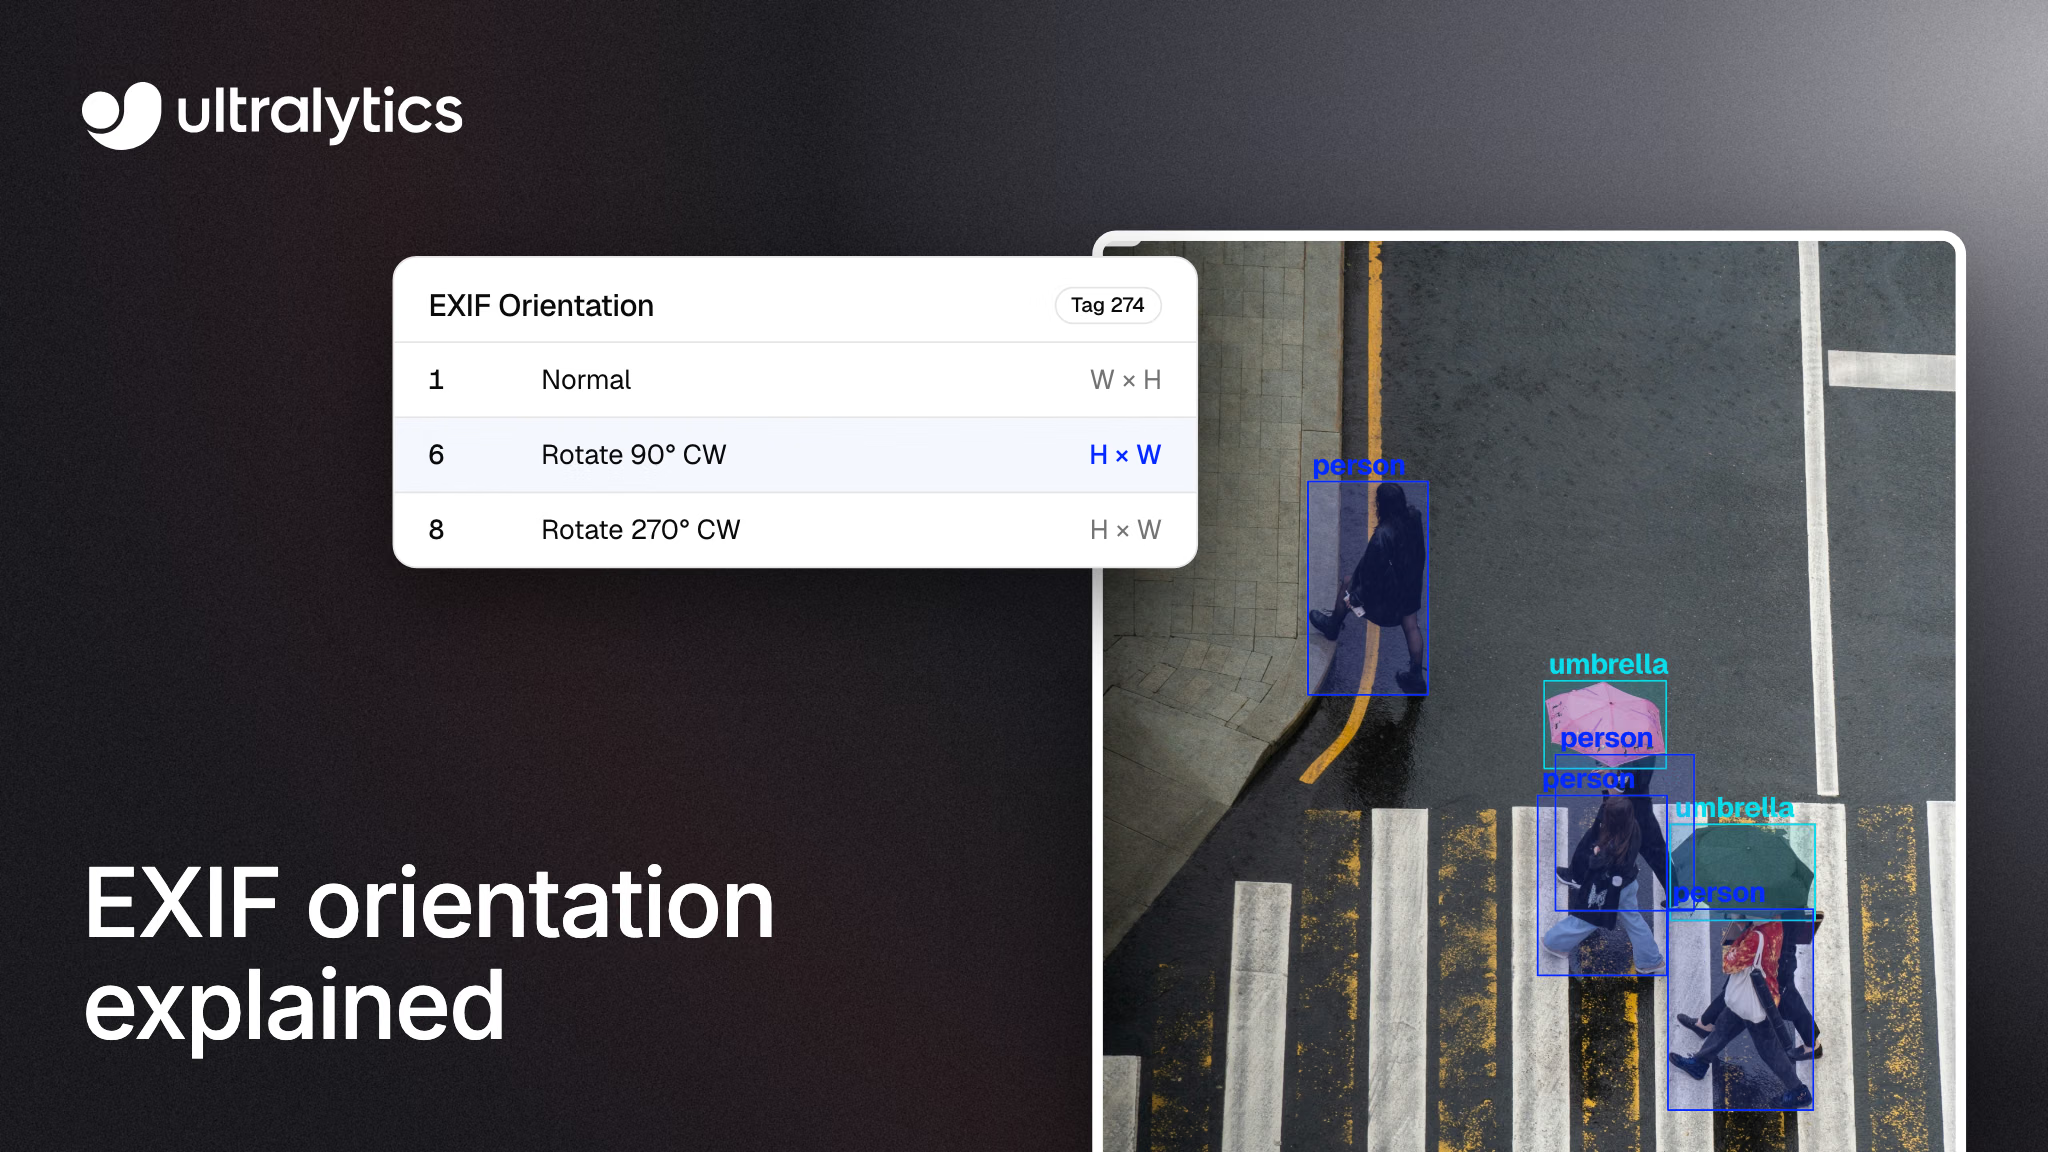
В галерее, браузере и инструменте разметки фотография выглядит правильно. Но затем скрипт обучения считывает её повёрнутой боком, и нарисованные тобой рамки могут оказаться не на тех участках изображения. Ничего не падает. Просто модель обучается на метках, которые больше не соответствуют пикселям.
Метки и пиксели расходятся, когда два инструмента используют для одного файла разные системы координат. Ориентация EXIF — один из примеров: небольшой тег метаданных указывает программам, как повернуть изображение для отображения, а пиксели остаются в том виде, в каком их сохранила камера. Одни считыватели применяют тег, другие — нет. В этом руководстве объясняется, что это за тег, как он нарушает разметку данных и обучение, а также как проверить датасет на его наличие. Здесь также рассказывается о двух недавно выпущенных возможностях: Ultralytics 8.4.214 теперь единообразно учитывает ориентацию EXIF при чтении изображений, а Ultralytics Platform теперь может поворачивать изображение вместе с его аннотациями, если пиксели файла просто расположены боком.
Ориентация EXIF — это инструкция для отображения, а не поворот#
Камера может сохранить пиксели в том виде, в каком их считал сенсор, а в метаданные EXIF файла записать значение Orientation (тег 274, или 0x0112), не поворачивая саму сетку пикселей. Просмотрщик, который учитывает тег, поворачивает изображение перед показом; игнорирующий его просмотрщик показывает исходную сетку. Другие устройства поворачивают пиксели перед сохранением, поэтому наличие тега у конкретной фотографии зависит от устройства и программ, которые обрабатывали её после съёмки.
Тег принимает одно из восьми значений, перечисленных в справочнике тегов EXIF от ExifTool:
| Значение | Описание | Отображаемые ширина и высота |
|---|---|---|
| 1 | Обычное положение, без изменений | Как сохранено |
| 2 | Отразить по горизонтали | Как сохранено |
| 3 | Повернуть на 180° | Как сохранено |
| 4 | Отразить по вертикали | Как сохранено |
| 5 | Отразить по горизонтали и повернуть на 270° по часовой стрелке | Поменяны местами |
| 6 | Повернуть на 90° по часовой стрелке | Поменяны местами |
| 7 | Отразить по горизонтали и повернуть на 90° по часовой стрелке | Поменяны местами |
| 8 | Повернуть на 270° по часовой стрелке | Поменяны местами |
Для компьютерного зрения важны две детали. Значения с 5 по 8 меняют местами отображаемые ширину и высоту, поэтому изображение размером 4000 x 3000 пикселей в сохранённом виде отображается на экране как 3000 x 4000. А значения 2, 4, 5 и 7 включают отражение, поэтому изображение может выглядеть примерно правильно ориентированным, хотя текст и расположение объектов слева и справа будут зеркальными. Классический пример поворота боком — портретная фотография с тегом 6.
Почему повёрнутые боком фотографии незаметно нарушают работу датасетов компьютерного зрения#
Ограничивающие рамки, полигоны и ключевые точки хранятся как координаты относительно изображения, а в формате Ultralytics YOLO эти координаты нормализуются по ширине и высоте изображения. Они имеют смысл, только если все инструменты согласны, к какой системе координат они относятся.
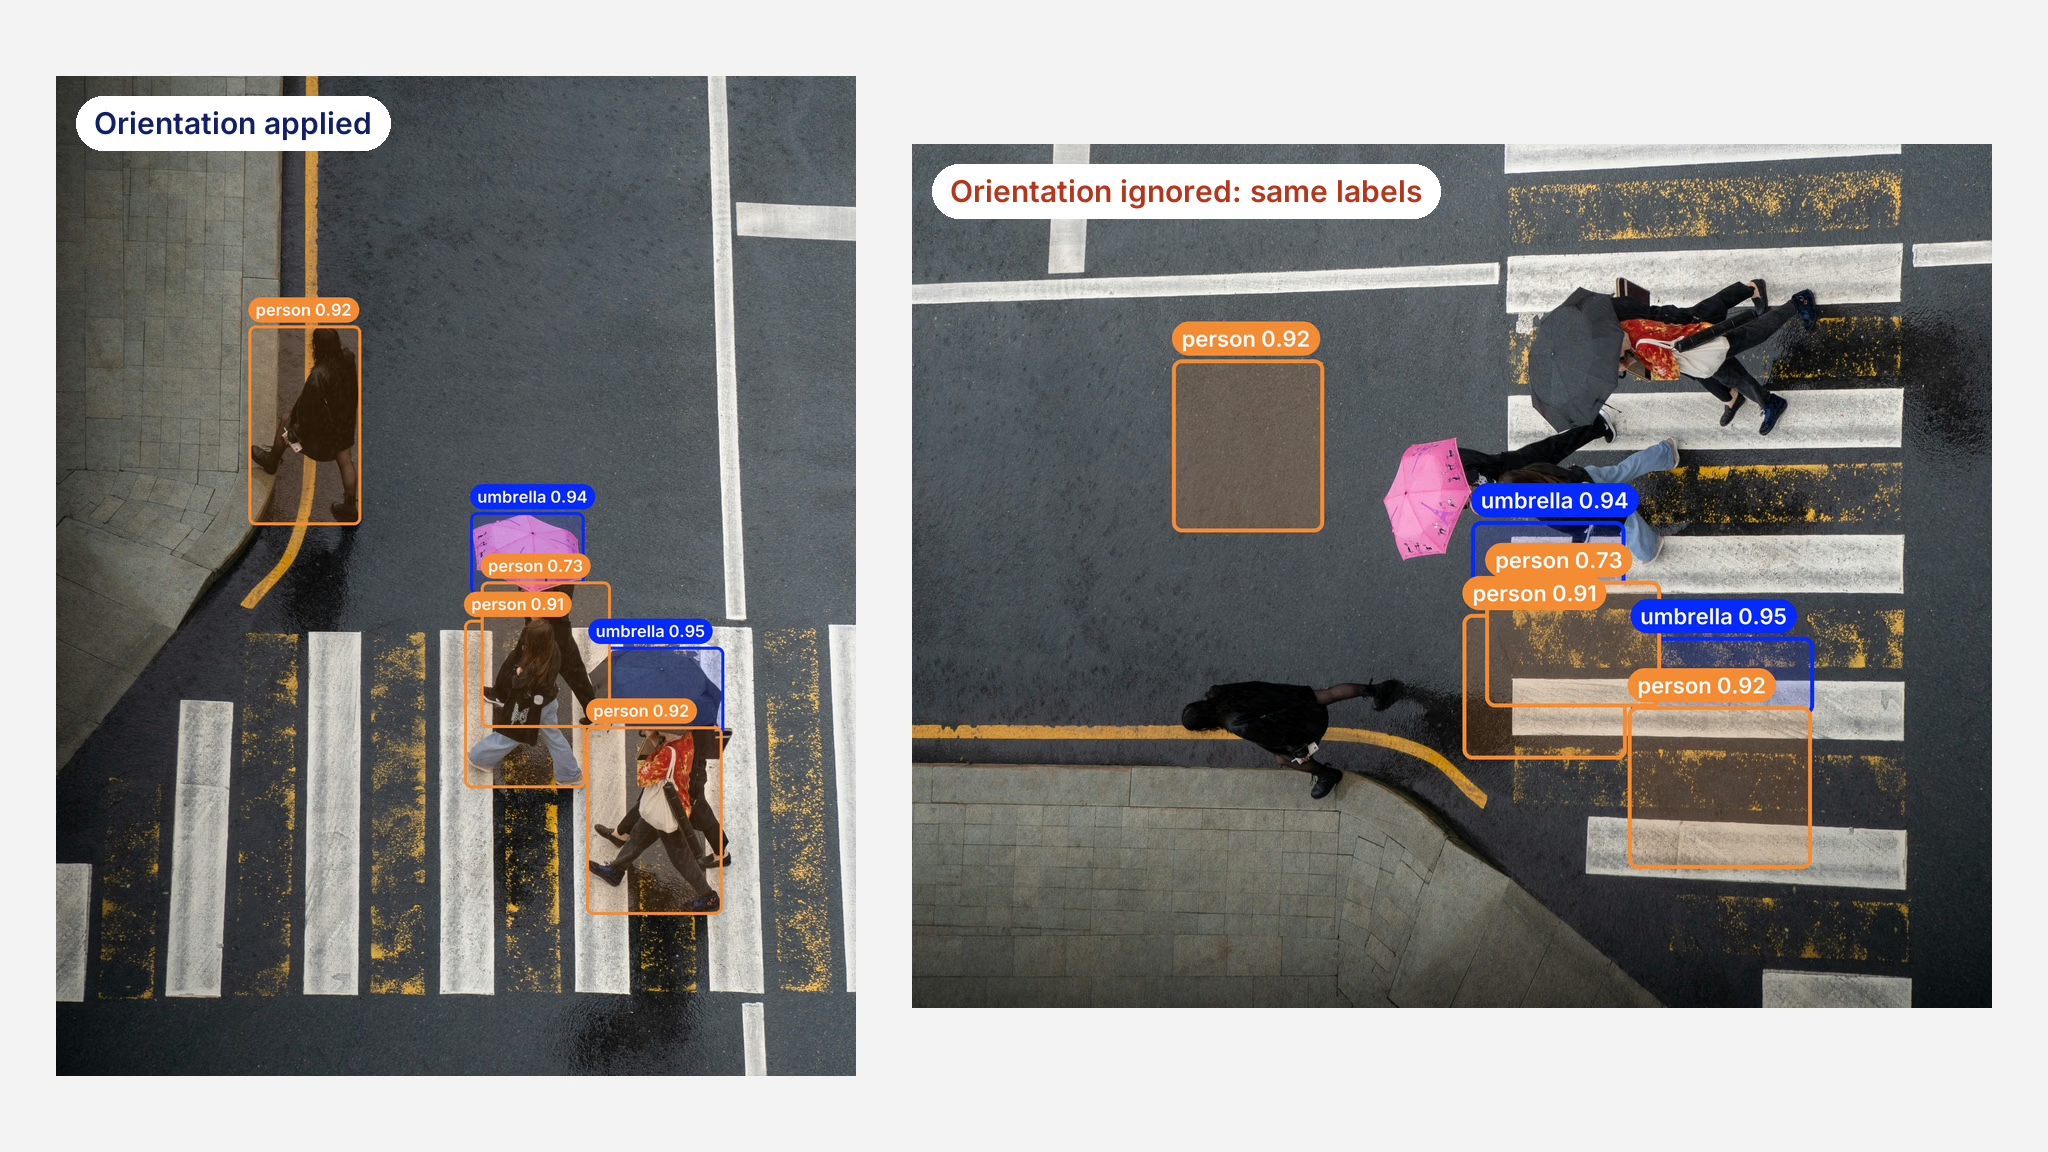
Один JPEG с Orientation 6, прочитанный двумя способами. Слева: с применённой ориентацией и детекциями YOLO26x. Справа: с игнорированием ориентации и теми же нормализованными метками, размещёнными на сохранённых пикселях.
Вот как датасет с изображениями, содержащими тег, может потерять согласованность:
- Разметчик размечает правильно ориентированное изображение. Если браузер или инструмент разметки применяет тег, рамка вокруг человека располагается там, где человек отображается на экране.
- Загрузчик данных для обучения считывает исходную сетку. Если его декодер пропускает тег, та же нормализованная рамка накладывается на пиксели, повёрнутые на 90 градусов, и может охватить не тот объект или вообще пустое место.
- Обучение всё равно запускается. Координаты по-прежнему находятся в диапазоне от 0 до 1, поэтому проверка формата проходит без ошибок. Модель обучается на несоответствующих парах, что может ухудшить её предсказания на реальных изображениях. Если в валидационной выборке есть такое же несоответствие, её средняя точность может ввести тебя в заблуждение, а не указать на проблему.
Зеркальную ориентацию заметить сложнее, потому что отражённое изображение может пройти быструю визуальную проверку. Текст на нём отображается зеркально, а при оценке позы левая и правая ключевые точки тела смещаются относительно своих меток.
Эту проблему также легко не заметить. В датасете, собранном из фотографий, загруженных с телефонов, сделанных во время осмотров на местах или полученных из краудсорсинговых источников, могут смешиваться файлы с тегами и без них. Искажаются только те изображения, которые считываются в другой системе координат, чем их метки. В результате проблема выглядит как шум в разметке, а не ошибка в конвейере.
Один и тот же файл можно прочитать двумя способами в OpenCV#
При чтении изображений с помощью OpenCV применение тега зависит от способа вызова функции. В документации OpenCV по imread указано, что ориентация EXIF применяется, если не передать IMREAD_IGNORE_ORIENTATION или IMREAD_UNCHANGED. До второго флага легко добраться: он нужен, чтобы сохранить альфа-канал или дополнительные каналы.
При проверке пакета Ultralytics мы обнаружили, что способ чтения зависел от флага, формата и версии OpenCV. До выхода PR #27168 функция imread работала со значениями ориентации от 2 до 8 следующим образом:
| Способ чтения | Результат до версии 8.4.214 |
|---|---|
JPEG, PNG или WebP, прочитанные с IMREAD_UNCHANGED (датасеты и модели с channels, отличным от 1 или 3) | Как сохранено, во всех версиях OpenCV |
| WebP с любым флагом, OpenCV до версии 5.0 | Как сохранено |
predict("a.webp") и predict(Image.open("a.webp")), OpenCV до версии 5.0 | Две разные системы координат |
| JPEG и PNG, цветные или в оттенках серого | Правильно ориентировано |
Цветные изображения и изображения JPEG и PNG в оттенках серого уже считывались правильно. Риск возникал при работе с датасетами, где channels отличался от 1 или 3, с файлами WebP в OpenCV 4.x, а также при сравнении предсказаний для файла WebP и изображения PIL. Например, при использовании channels: 4 форма изображения в кэше уже соответствовала правильной ориентации, а сами пиксели — нет. Поэтому для тайлов, прямоугольных батчей и изменения размера масок использовалась транспонированная форма.
Ultralytics 8.4.214 единообразно применяет ориентацию EXIF#
Начиная с версии 8.4.214, выпущенной 15 ноября 2026 года, imread применяет ориентацию EXIF для цветных изображений, изображений в оттенках серого и изображений, считываемых без изменений, во всех поддерживаемых форматах и версиях OpenCV, кроме нескольких крайних случаев, перечисленных ниже. В справочнике imread указана цель: метки и предсказания должны использовать ту же систему координат, что и изображения в просмотрщиках. В документации по датасетам для детекции теперь также говорится о координатах меток, так что это соглашение зафиксировано там, где его ищут авторы датасетов.
Кратко о том, как это работает:
- Единообразное чтение из разных источников. Загрузка изображений датасетов и предсказание по пути к одному изображению выполняются через
imreadвultralytics/utils/patches.py; теперь его также используют датасеты классификации и разделение DOTA. Изображения, переданные вpredictв виде списка путей, открываются с помощью Pillow и транспонируются с учётом EXIF; входные изображения PIL также транспонируются с учётом EXIF. Поэтому, за исключением крайних случаев, перечисленных ниже, все эти способы дают одинаковую правильную ориентацию. - Применение тегов, которые OpenCV пропускает. При чтении без изменений и при чтении любых файлов WebP изображение декодируется с помощью
IMREAD_IGNORE_ORIENTATION, после чего тег применяется к массиву. Поэтому результат не зависит от версии OpenCV. - При обработке EXIF учитывается содержимое файла. Тег применяется к данным JPEG, WebP и PNG с блоком eXIf, даже если расширение не соответствует формату, например JPEG-файл с именем
.webp. Данные TIFF обрабатывает декодер TIFF в OpenCV, который самостоятельно задаёт ориентацию, а для AVIF и HEIC используетсяexif_transposeиз Pillow. - Pillow используется только при необходимости. Сначала сканируются блоки PNG, и Pillow вызывается, только если найден блок eXIf.
Мы проверили это изменение на OpenCV 5.0.0, 4.12.0 и 4.7.0 с Pillow 13.0.0, сравнив пиксели с результатом exif_transpose в Pillow. Все восемь вариантов ориентации правильно считываются для JPEG, PNG (RGB и RGBA) и WebP (RGB и RGBA) в цветном режиме, в оттенках серого и без изменений — всего 45 комбинаций. Нетегированные изображения декодируются в те же массивы, что и раньше.
В нескольких крайних случаях сохраняется исходная ориентация: JPEG с расширением .tif или .tiff (кроме чтения в оттенках серого); изображения JPEG и PNG, прочитанные с намеренно переданным IMREAD_IGNORE_ORIENTATION (файлы WebP всё равно поворачиваются правильно); а также, при стандартном ограничении Pillow на количество пикселей, изображения JPEG или PNG, считываемые без изменений, и изображения WebP размером более примерно 179 мегапикселей. В этих случаях перед обучением нужно записать ориентацию непосредственно в пиксели (см. шаги проверки ниже).
Версия кэша датасета обновлена до 1.0.13, поэтому при следующем запуске кэши меток со старой формой изображений будут перестроены один раз. Есть одно исключение: для PNG, в котором блок eXIf расположен после данных изображения, пиксели считываются с правильной ориентацией, но форма в кэше может остаться исходной. Запиши правильную ориентацию в пиксели таких PNG и перестрой кэш.
Поворачивай изображения вместе с метками в Ultralytics Platform#
Улучшенный считыватель решает проблему с файлами, содержащими тег. Но он не поможет, если сами пиксели ориентированы неверно: например, если скан загрузили боком, фотографию экспортировали вверх ногами или тег удалили на одном из предыдущих этапов, оставив только исходную сетку. По метаданным нельзя определить, как должны быть ориентированы такие изображения. Их нужно действительно повернуть, а метки — повернуть вместе с ними.
Теперь в полноэкранном просмотрщике галереи датасетов Ultralytics Platform это можно сделать. Если у тебя есть доступ к редактированию, нажми R или кнопку поворота, чтобы повернуть изображение и его аннотации на 90 градусов по часовой стрелке. Рамки, полигоны и ключевые точки перемещаются вместе с пикселями, поэтому аннотации остаются на объектах, которые они описывают.
Как обрабатываются данные:
- Без ухудшения качества при повторных поворотах. Platform хранит исходное изображение и отображает каждый поворот на его основе, поэтому повторные повороты не ухудшают качество, а возвращение к правильной ориентации восстанавливает исходное изображение.
- Сохраняются повёрнутые пиксели. Platform поворачивает сохранённые пиксели, а не записывает флаг поворота, поэтому в экспортируемые датасеты не добавляется новое поле, а кнопка Download сохраняет изображение полного размера в отображаемом положении.
Поворот недоступен для датасетов глубины, мультиспектральных датасетов, изображений в формате TIFF, а также датасетов в облачном хранилище и On Premise.
При загрузке Platform нормализует изображения с учётом ориентации EXIF. Если тег правильно описывает файл, изображение загружается с правильной ориентацией, а значения от 5 до 8 меняют местами его ширину и высоту. Используй Rotate, если изображение всё ещё ориентировано неправильно.
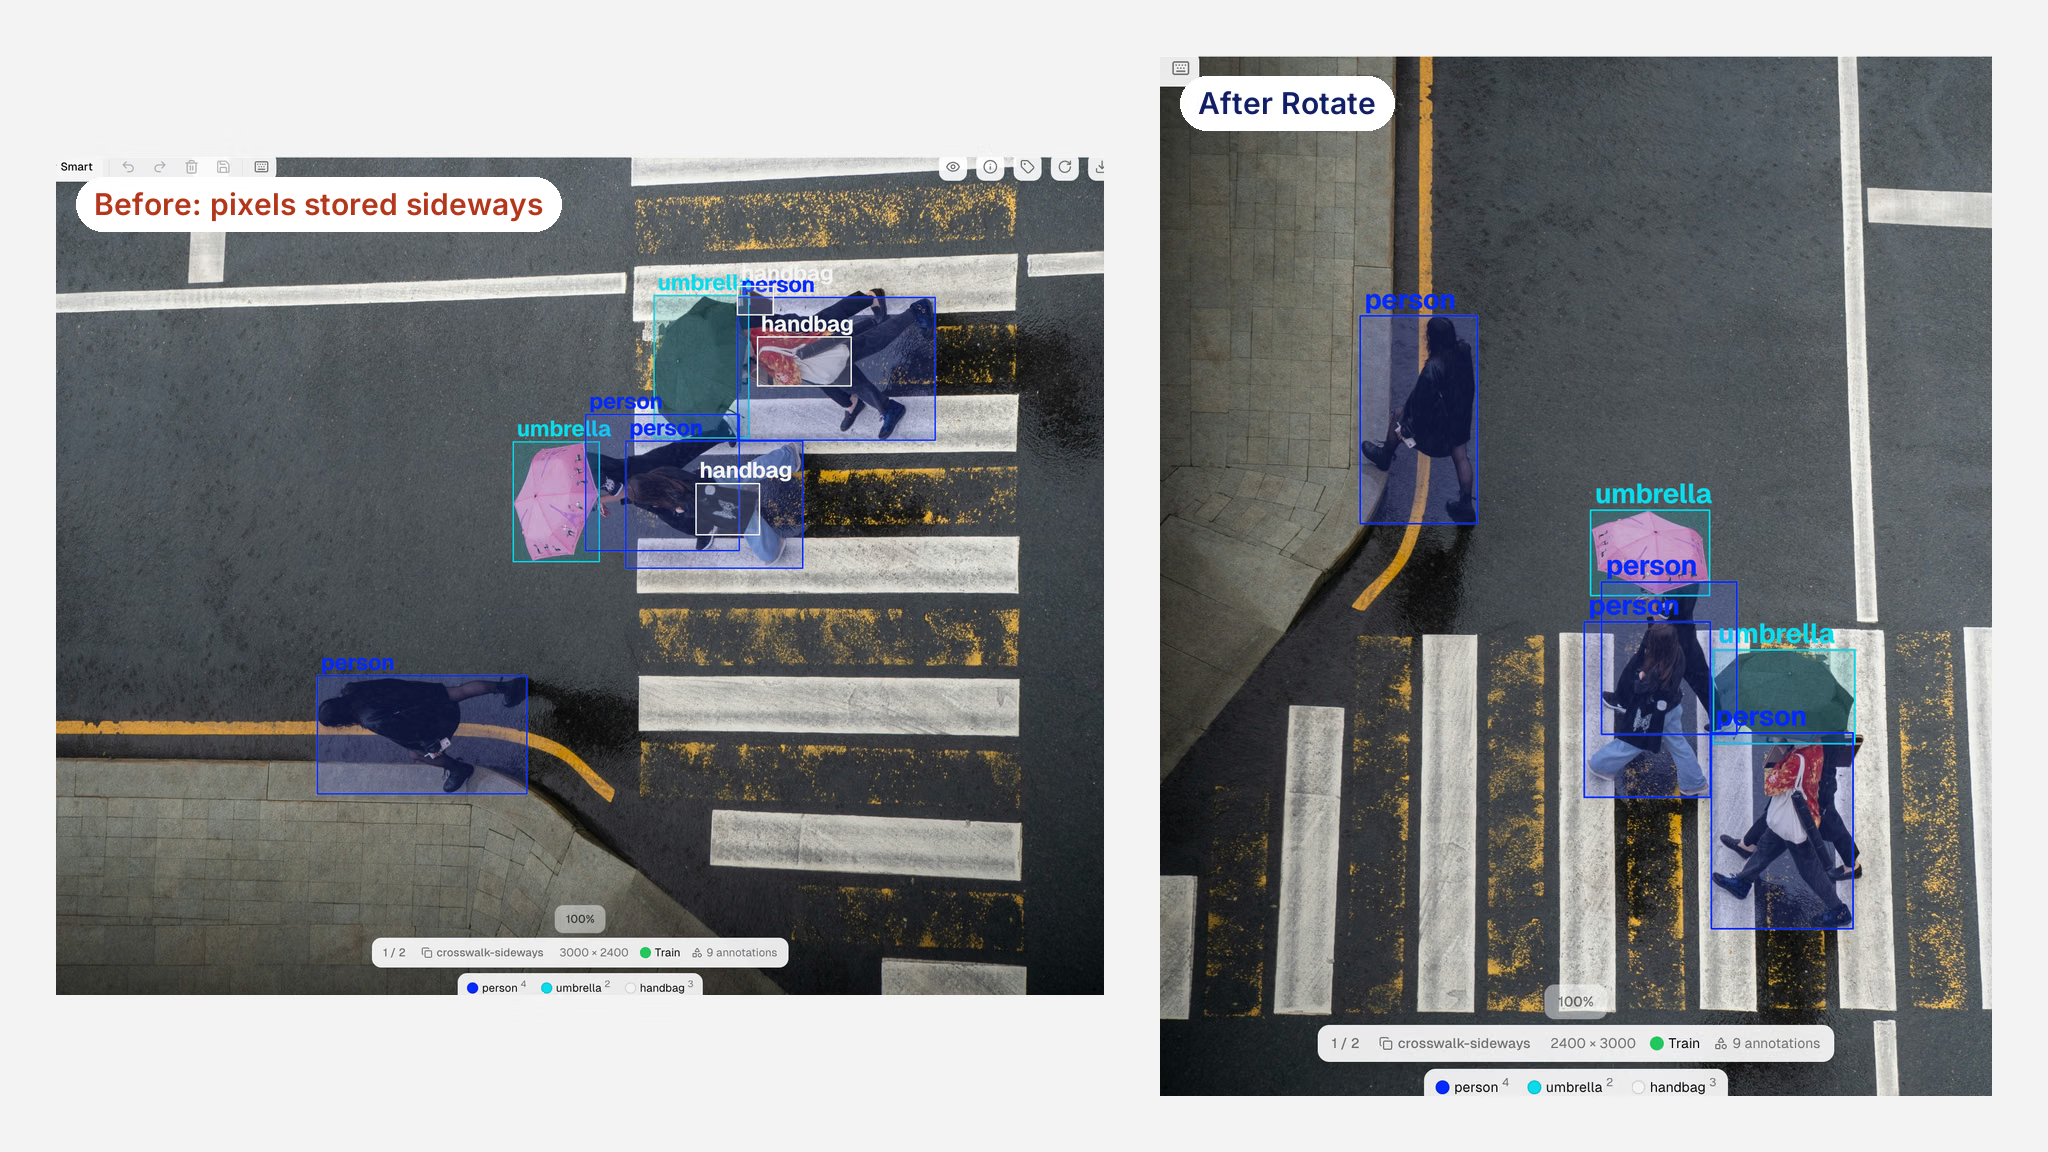
Изображение, повёрнутое боком, в полноэкранном просмотрщике Ultralytics Platform до и после поворота. Размер изображения меняется с 3000 x 2400 на 2400 x 3000 пикселей, а все аннотации поворачиваются вместе с ним.
Как проверить и исправить ориентацию EXIF в датасете#
Сначала проверь наличие тегов. Этот скрипт сообщает о файлах JPEG, PNG и WebP в папке, значение Orientation у которых отличается от 1:
from pathlib import Path

from PIL import Image

for path in Path("datasets/my_data/images").rglob("*"):
    if path.suffix.lower() in {".jpg", ".jpeg", ".png", ".webp"}:
        with Image.open(path) as im:
            orientation = im.getexif().get(274, 1)  # 274 — это тег Orientation в EXIF
        if orientation != 1:
            print(path, orientation)
Если результат чистый, значит, ни у одного из этих файлов значение Orientation не отличается от 1. При этом проверка не обнаруживает файлы с вводящим в заблуждение расширением, изображения с пикселями, расположенными боком, или метки, нарисованные в другой системе координат. Затем проверь, что увидит Ultralytics: в версии 8.4.214 или более поздней imread возвращает изображение в отображаемой системе координат, за исключением перечисленных выше крайних случаев:
import cv2

from ultralytics.utils.patches import imread

img = imread("datasets/my_data/images/train/photo.jpg", cv2.IMREAD_UNCHANGED)
print(img.shape)  # (высота, ширина, каналы) в том виде, как это отображают просмотрщики
Дальнейшие действия зависят от того, как были созданы метки:
- Обнови версию. Запусти
pip install -U ultralytics, чтобы установить версию 8.4.214 или новее. Тогда при обучении, валидации и предсказании файлы изображений с тегами и изображения PIL будут считываться в отображаемой системе координат с учётом перечисленных выше крайних случаев. Массивы NumPy и тензоры не содержат тег EXIF, поэтому передавай их вpredictтолько с правильной ориентацией. - Очисти старые кэши изображений. Если при предыдущих запусках рядом с изображениями были созданы кэши изображений
.npy, удали эти файлы, созданные Ultralytics, перед проверкой или повторным обучением, даже если при следующем запуске используетсяcache=False: загрузчик может выбрать уже существующие кэши. Не трогай посторонние файлы NumPy; кэши меток перестраиваются автоматически. - Сверь несколько изображений с тегами и их метки. Нанеси метки на правильно ориентированное изображение. Если разметчики работали в инструменте, который учитывает тег, рамки будут совпадать с объектами.
- Если метки были нарисованы на исходной сетке, что может произойти при использовании скриптов или инструментов, игнорирующих тег, переразметь эти изображения или преобразуй метки для правильно ориентированного вида. Один лишь поворот пикселей только сохранит несоответствие.
- Исправь изображения, пиксели которых ориентированы неправильно, с помощью действия Rotate в Platform, которое поворачивает вместе с ними и аннотации, а затем запусти обучение заново.
Чтобы файлы выглядели одинаково во всех инструментах и исправить большинство перечисленных выше крайних случаев, запиши ориентацию непосредственно в пиксели с помощью ImageOps.exif_transpose из Pillow и сохрани копию. Сделай это до разметки или преобразуй метки тоже. Pillow предупреждает, если размер изображения превышает установленное по умолчанию ограничение на число пикселей, и отказывается открывать изображения, превышающие это ограничение вдвое, то есть примерно 179 мегапикселей. Для доверенных изображений большего размера задай Image.MAX_IMAGE_PIXELS перед их открытием.
Более широкий контрольный список перед обучением представлен в уроках Академии по контролю качества датасета и качеству аннотаций. В них описаны другие проверки, которые стоит выполнить вместе с этой.
Аугментация поворотом не исправляет несоответствие ориентации#
Может показаться, что случайный поворот при обучении делает ориентацию неважной. Такая аугментация данных, как настройка degrees в аугментации YOLO, одновременно поворачивает изображение и метки, сохраняя их соответствие и помогая модели научиться распознавать наклонённые объекты. Если из-за неправильной обработки EXIF изображения и метки разошлись ещё до аугментации, их совместный поворот после этого не устранит несоответствие.
Та же логика применима к задачам с фиксированным направлением отсчёта. Если модель распознаёт текст, как в нашем руководстве по OCR на Python с Ultralytics YOLO26, или различает левую и правую стороны, зеркальная ориентация меняет смысл изображения, а не просто его угол.
Кому стоит проверять ориентацию EXIF#
Выполни проверку, если к твоим данным относится что-либо из перечисленного:
- Фотографии с телефонов или планшетов, сделанные во время осмотров на местах, аудита розничной торговли, урегулирования страховых случаев или краудсорсингового сбора данных.
- Данные из разных источников, объединённые в один датасет, где некоторые файлы могут содержать теги, а другие — нет.
- Датасеты WebP или датасеты с
channels, отличным от 1 или 3, если обучение проводилось на версиях Ultralytics до 8.4.214. - Отсканированные документы, страницы которых могут быть сохранены боком и требуют настоящего поворота.
После очистки данных ты можешь размечать их и обучать модель Ultralytics YOLO26 в одной рабочей области, чтобы каждая метка располагалась на соответствующих ей пикселях. Подробнее о поддержании качества датасета в Platform читай в статье «Умное управление датасетами с помощью Ultralytics Platform».
Часто задаваемые вопросы
Ориентация EXIF — это значение метаданных от 1 до 8, хранящееся в теге 274 файла изображения. Оно указывает программе, как повернуть или отразить сохранённые пиксели для отображения. Значение 1 означает отсутствие изменений, а 6 — поворот на 90 градусов по часовой стрелке. Сами пиксели не поворачиваются, поэтому инструменты, игнорирующие тег, показывают изображение в сохранённом виде, часто боком.
Часто в файле есть тег Orientation, который принимающий файл инструмент не применяет. Телефон и браузер учитывают этот тег, поэтому фотография выглядит правильно ориентированной, а декодер, игнорирующий его, показывает исходную сетку. Если сохранённые пиксели расположены боком и тег не исправляет их ориентацию, поверни само изображение.
Обычно да.
imreadв OpenCV применяет тег, если не передатьIMREAD_IGNORE_ORIENTATIONилиIMREAD_UNCHANGED. В версиях до 5.0 файлы WebP также оставались в исходном виде. Начиная с версии 8.4.214, собственная функцияimreadв Ultralytics применяет тег при чтении цветных изображений, изображений в оттенках серого и изображений без изменений во всех протестированных нами версиях OpenCV.Да. Начиная с Ultralytics 8.4.214, файлы изображений и изображения PIL считываются с учётом ориентации EXIF, за исключением нескольких крайних случаев, например JPEG с расширением
.tif. Координаты меток относятся к той же системе координат, что и отображаемое изображение. Массивы NumPy и тензоры не содержат тег EXIF, поэтому перед предсказанием их нужно правильно ориентировать.Открой изображение в полноэкранном просмотрщике набора данных и нажми
Rили кнопку поворота; каждое нажатие поворачивает изображение и его аннотации на 90 градусов по часовой стрелке. Тебе нужен доступ на редактирование; поворот недоступен для изображений глубины, мультиспектральных изображений и изображений TIFF, а также для наборов данных в облачном хранилище и локального размещения.
Автор
Ведущий инженер-программист · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









