Jetson Orin Nano Super или Raspberry Pi 5 для детекции объектов с YOLO26
Инференс YOLO26n: 4,57 мс на Jetson Orin Nano Super (TensorRT FP16) против 67,03 мс на CPU Pi 5 в отдельных тестах. Выбирай плату с учётом модели, FPS и количества камер.
 Onuralp Sezer15 мин. чтения
Что выбрать для детекции объектов: Raspberry Pi 5 или NVIDIA Jetson Orin Nano? Для одной камеры, невысокой целевой частоты кадров и небольшой модели может хватить CPU Pi 5: в нашем опубликованном бенчмарке Ultralytics YOLO26n, экспортированная в NCNN, выполняет инференс изображения за 67,03 мс на четырёх ядрах Arm — это около 15 кадров инференса в секунду. Если тебе нужно больше камер, модель крупнее или больший запас по частоте кадров, чем может обеспечить Pi, выбирай Jetson: на Jetson Orin Nano Super Developer Kit та же модель выполняет инференс за 4,57 мс как движок TensorRT FP16.
Ultralytics публикует это сравнение и разрабатывает YOLO26, которая работает на обеих платах; сами платы мы не производим. Данные по Jetson получены на Orin Nano Super Developer Kit, начальном комплекте разработчика Orin от NVIDIA, а данные по Pi — на Raspberry Pi 5; тесты проводились отдельно. Многие по-прежнему ищут «Jetson Nano» — исходную плату 2019 года. Она запускает YOLO26 через JetPack 4, но в нашем руководстве по Jetson нет бенчмарков YOLO26 для неё, поэтому здесь она упоминается только в разделе характеристик.
Ниже сравниваем платы с учётом размера модели, целевой частоты кадров и количества видеопотоков с камер, объясняем, почему FPS падает при добавлении камер, рассказываем, как самостоятельно протестировать обе платы и выбрать подходящую для твоего проекта. Инструкции по настройке есть в руководстве по NVIDIA Jetson и руководстве по Raspberry Pi, а наш разбор детекции объектов на CPU Raspberry Pi 5 подробно рассказывает о Pi.
Pi 5 запускает YOLO на CPU, а Orin Nano Super оснащён GPU#
Платы решают одну и ту же задачу, но используют разные чипы. Raspberry Pi 5 — компьютер общего назначения с четырьмя ядрами Arm Cortex-A76 и без специализированного ускорителя ИИ, поэтому в наших бенчмарках на Pi YOLO запускается на CPU. Jetson Orin Nano Super Developer Kit объединяет модуль Orin Nano на базе GPU Ampere с несущей платой, а среда выполнения TensorRT от NVIDIA компилирует модели для этого GPU. Это платформа периферийного ИИ, предназначенная для подобных задач.
| Jetson Nano 4GB (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| Вычислительные ресурсы для YOLO | GPU Maxwell с 128 ядрами | GPU Ampere с 1024 ядрами, 32 Tensor Cores | CPU Arm Cortex-A76 с 4 ядрами |
| CPU | 4-ядерный Cortex-A57, 1,43 ГГц | 6-ядерный Cortex-A78AE, до 1,7 ГГц | 4-ядерный Cortex-A76, до 2,4 ГГц |
| Память | 4 ГБ LPDDR4, 25,6 ГБ/с | 8 ГБ LPDDR5, 102 ГБ/с | Зависит от модели |
| Производительность ИИ (пиковое значение NVIDIA) | 472 GFLOPS | 67 разреженных INT8 TOPS | — |
| JetPack / ОС | Только JetPack 4 | JetPack 5–7 | Raspberry Pi OS |
| Способ развёртывания Ultralytics | TensorRT, включая DeepStream | TensorRT (самый быстрый в нашем бенчмарке) | NCNN (самый быстрый в нашем бенчмарке) |
Характеристики, а не результаты измерений; проверены 19 ноября 2026 года. В пиковых показателях NVIDIA используются разные форматы чисел, поэтому сравнивать их напрямую нельзя. Для Orin Nano Super значение 67 TOPS — это показатель для разреженных вычислений INT8; NVIDIA указывает 33 TOPS для плотных вычислений. Данные по Jetson взяты из таблиц сравнения и JetPack в руководстве по NVIDIA Jetson и из руководства по DeepStream; данные по Pi 5 — из документации Raspberry Pi.
При выборе учитывай и энергопотребление. NVIDIA указывает для Orin Nano Super Developer Kit диапазон от 7 до 25 Вт. Если на плату записана конфигурация с поддержкой Super, Orin Nano 8GB предлагает режимы питания 15 Вт, 25 Вт и MAXN SUPER; с конфигурацией по умолчанию сохраняются исходные режимы 7 Вт и 15 Вт. Какую бы плату ты ни выбрал, измерь энергопотребление всей системы с подключёнными камерами: именно на него должны быть рассчитаны блок питания и корпус.
Оценивай стоимость всей сборки, а не только платы: накопитель, питание, охлаждение и камеры увеличивают расходы в обоих случаях. Raspberry Pi несколько раз повышала цены на Pi 5 в 2026 году из-за роста стоимости памяти. По состоянию на ноябрь 2026 года Pi 5 с 2 ГБ памяти стоит $77.50, а плата с 16 ГБ — $385. Актуальные цены и наличие Jetson смотри на странице комплектов разработчика NVIDIA; также учти стоимость ускорителя, который может понадобиться Pi, например Raspberry Pi AI HAT+. Для производства NVIDIA продаёт модули Jetson для установки на собственную несущую плату; протестированный нами комплект разработчика предназначен для разработки и создания прототипов.
CPU Pi 5 подойдёт для задач с YOLO26n и низким FPS#
Pi 5 справляется с детекцией с одной камеры без дополнительного оборудования, если тебе достаточно невысокой частоты кадров. В бенчмарке Ultralytics (экспорт FP32, входное изображение 640 пикселей, COCO128, Ultralytics 8.4.108, только время инференса) NCNN оказался самым быстрым форматом экспорта: 67,03 мс на изображение для YOLO26n при 0,4784 mAP50-95. Это около 15 FPS инференса — может подойти для станции подсчёта, камеры у полки или прототипа робота, которому не нужно отслеживать быстрое движение. Проверь весь конвейер обработки изображения с камеры, а не только инференс. Arm также публикует среду выполнения с открытым исходным кодом для YOLO26n на Pi 5 и сообщает, что в собственном тесте она работала быстрее NCNN; в нашем разборе Raspberry Pi 5 сравниваются оба варианта.
На крупных моделях Pi начинает не справляться. Для YOLO26s на Pi 5 с NCNN требуется 172,88 мс — меньше 6 FPS инференса. Сравнение нескольких форматов в руководстве по Raspberry Pi (Ultralytics 8.4.108) охватывает только модели n и s. В более старом сравнении ONNX (Ultralytics 8.4.14) также приводятся результаты для m, l и x; там YOLO26m выполняет инференс за 993,78 мс. Если мелкие объекты или трудноразличимые классы вынуждают использовать более крупную модель или большее входное разрешение, протестируй её на плате до того, как примешь решение.
Установка AI HAT+ на Pi 5#
Есть и третий вариант: Pi 5 с AI HAT+ от Raspberry Pi, в котором установлен ускоритель Hailo на 13 TOPS или 26 TOPS. В бенчмарке интеграции Hailo от Ultralytics (Ultralytics 8.4.174, COCO128) YOLO26n, экспортированная для версии Hailo-8 на 26 TOPS, выполняет инференс изображения за 21,7 мс при 0,455 mAP50-95; для модели PyTorch без экспорта на той же Pi требуется 364,6 мс. В этом тесте не указано входное разрешение и используется INT8, поэтому рассматривай его отдельно от результатов в таблице ниже. Для моделей Hailo требуется этап компиляции; после экспорта проверь точность на собственных изображениях.
На Orin Nano Super инференс YOLO26n–YOLO26l занимает меньше 18 мс#
На Jetson можно использовать более крупные модели. В бенчмарках Ultralytics на Orin Nano Super Developer Kit (входное изображение 640 пикселей, COCO128, Ultralytics 8.4.33, только инференс) все модели от n до l выполняют инференс изображения менее чем за 18 мс как движки TensorRT FP16:
| Модель YOLO26 | CPU Raspberry Pi 5 (мс/изображение) | Orin Nano Super, TensorRT FP16 (мс/изображение) | Orin Nano Super, mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67,03 (NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172,88 (NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993,78 (старый тест ONNX, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259,46 (старый тест ONNX, 8.4.14) | 17.42 | 0.6225 |
Опубликованные результаты отдельных тестов. Orin Nano Super: Ultralytics 8.4.33. Для всех строк — входное изображение 640 пикселей, только время инференса, без предварительной и последующей обработки.
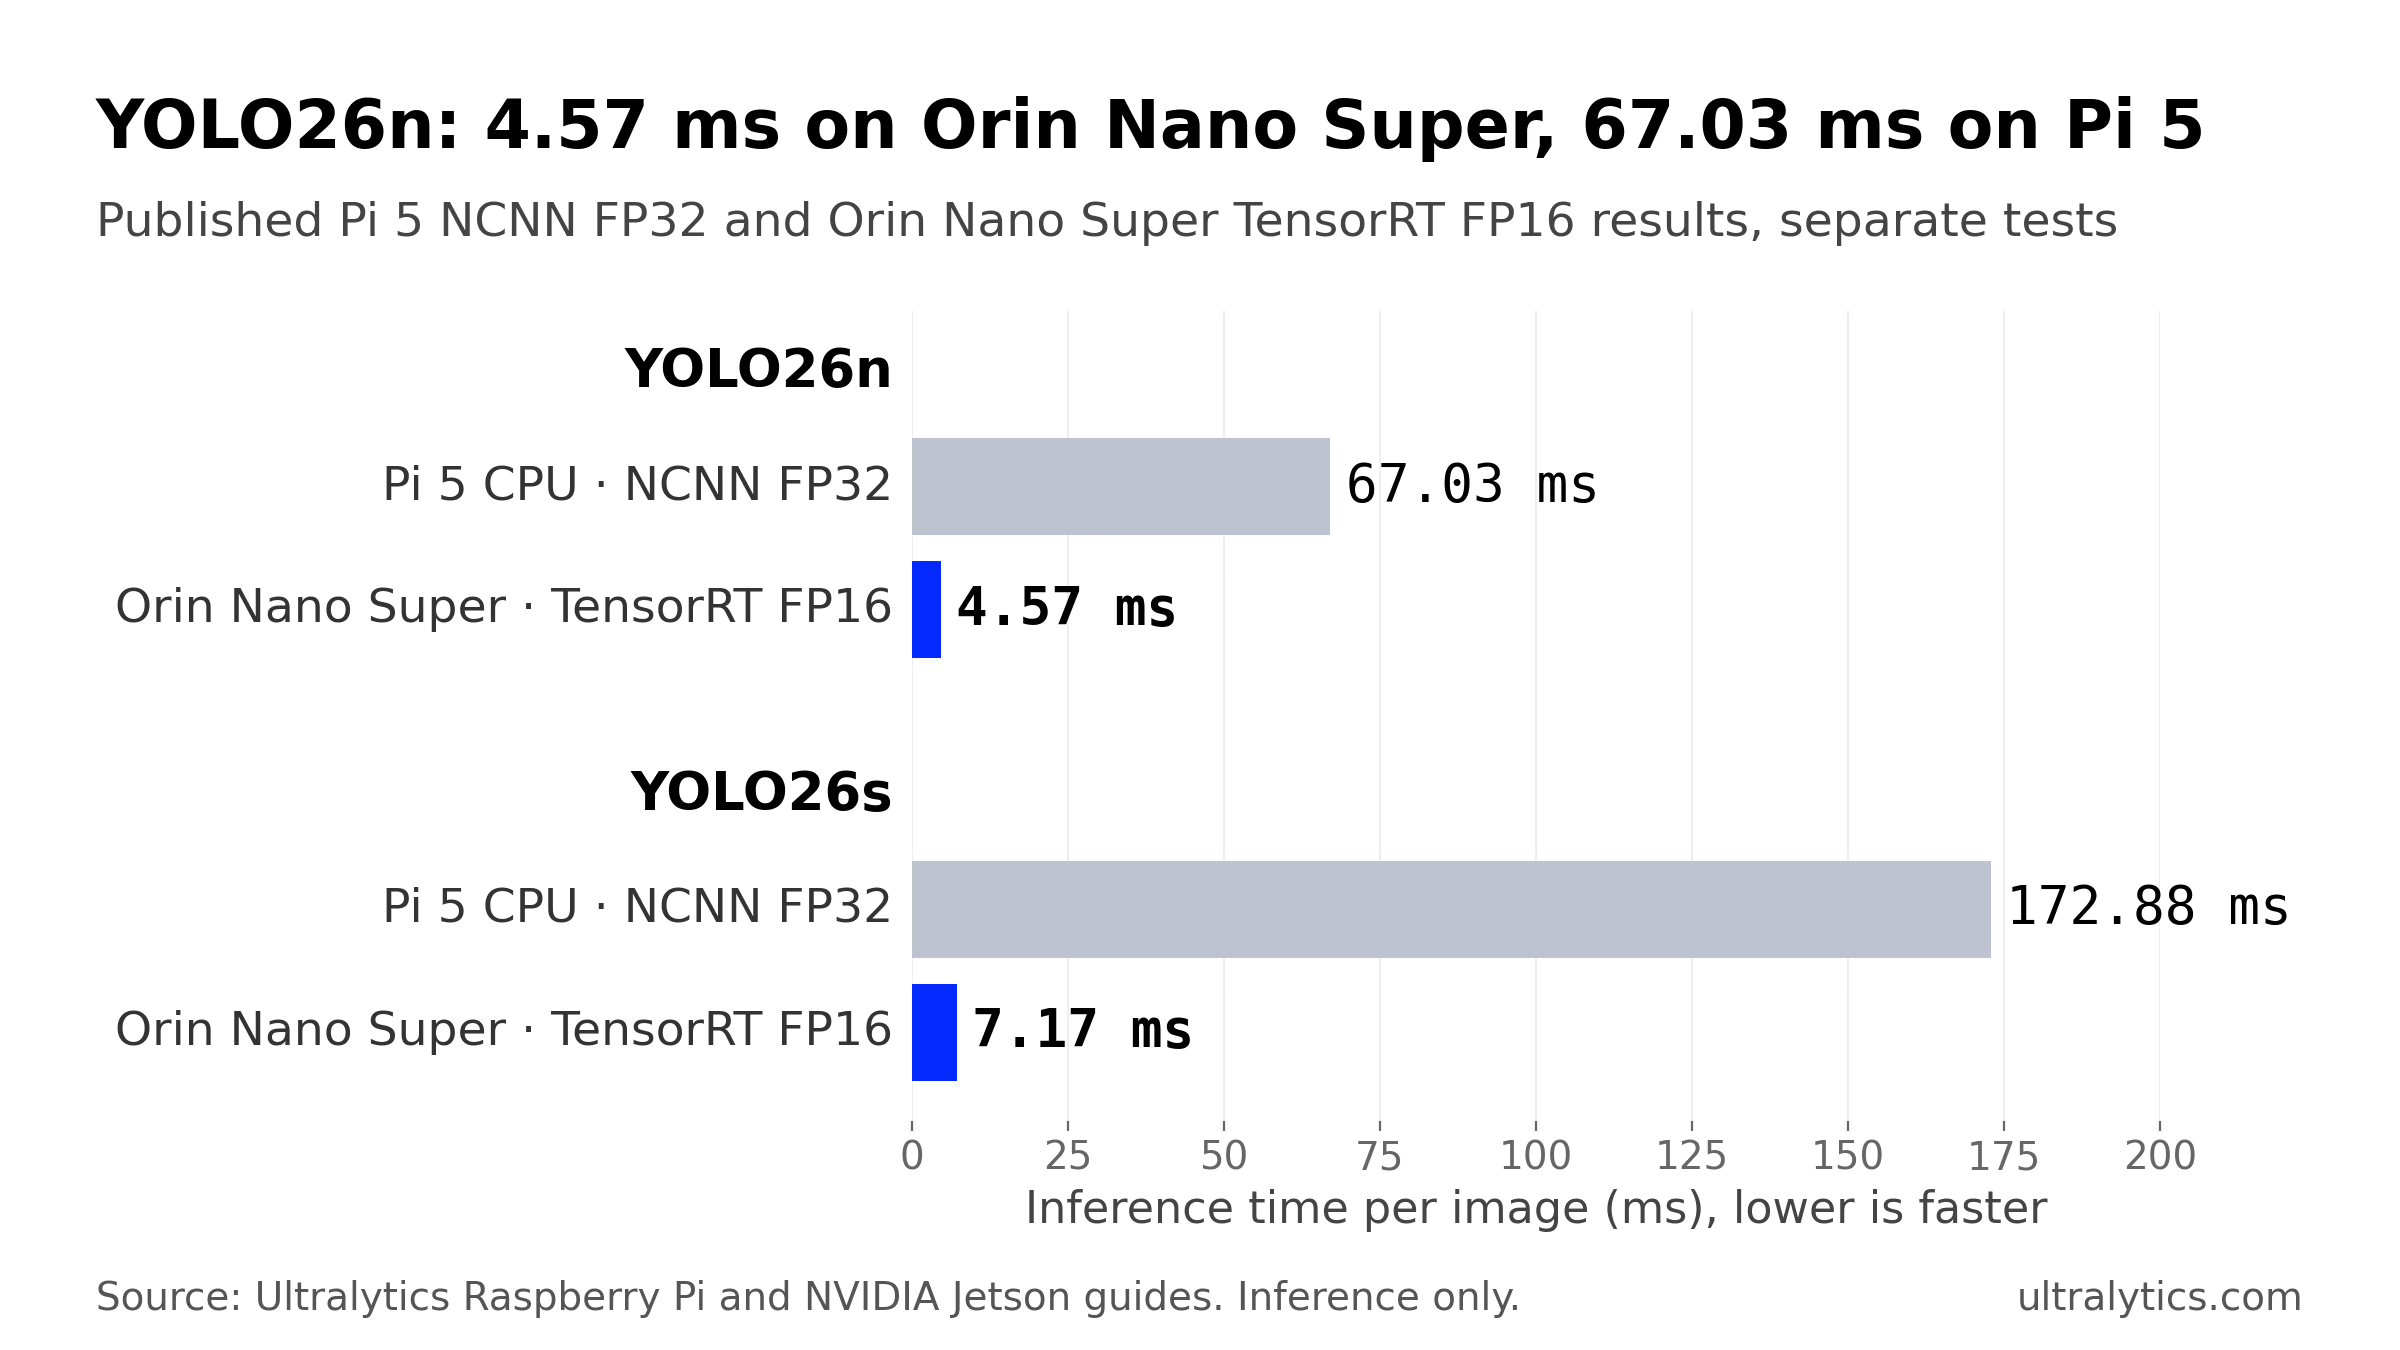
Опубликованные результаты NCNN FP32 и TensorRT FP16, полученные в отдельных тестах: Raspberry Pi 5 с Ultralytics 8.4.108, Orin Nano Super Developer Kit с Ultralytics 8.4.33. Только инференс, без предварительной и последующей обработки. Источник: руководства Ultralytics по Raspberry Pi и NVIDIA Jetson.
Для YOLO26n время инференса примерно на 93% меньше, чем на CPU Pi 5. На разницу отчасти влияет точность вычислений, поэтому сравним также экспорты FP32: движку TensorRT FP32 на Orin Nano Super требуется 7,53 мс — он всё равно почти в девять раз быстрее экспорта NCNN FP32 на Pi, хотя среды выполнения и версии тестов различаются. Ещё важнее результат YOLO26m: 0,6225 mAP50-95 за 13,59 мс; в более старом тесте ONNX CPU Pi 5 выполнял инференс этой модели примерно со скоростью один кадр в секунду.
INT8 позволяет немного ускорить инференс. Для YOLO26n требуется 3,80 мс как движку INT8, но показатель mAP50-95 на COCO128 снижается с 0,4800 до 0,4490. Сначала используй FP16 и переходи к квантованию INT8, только если FP16 не укладывается в твои ограничения и ты можешь выполнить калибровку на изображениях со своих камер. На уроке Academy об оптимизации с TensorRT подробно разбирается, как принять такое решение.
При добавлении камер FPS падает, потому что все видеопотоки используют общий вычислительный ресурс#
При масштабировании часто происходит следующее: одна камера работает плавно, но с добавлением третьей или четвёртой частота обработанных кадров падает. Для каждого кадра нужны декодирование, предварительная обработка, инференс и последующая обработка, а все камеры используют общий вычислительный ресурс. На Pi 5 одни и те же четыре ядра CPU декодируют видео и запускают модель, поэтому каждый дополнительный поток отнимает время у обеих задач.
Ultralytics берёт на себя настройку обработки потоков. Укажи по одному источнику на строку в файле .streams и передай его в режим Predict: для каждого потока создаётся отдельный поток чтения, а загрузчик собирает в один батч последние кадры со всех камер. Поэтому один медленный или прерванный источник может задержать весь батч. Бэкенды с поддержкой батчей выполняют его за один прямой проход; NCNN обрабатывает кадры по одному, а батч движка TensorRT с фиксированной формой входных данных разбивается или дополняется до размера, заданного при экспорте. По умолчанию (stream_buffer=False) медленная модель пропускает устаревшие кадры, а не ставит их в очередь, поэтому очередь в приложении остаётся небольшой. Однако буферизация в камере, декодере или сети всё ещё может добавить задержку.
Задержка обработки одного изображения — только отправная точка, а не способ определить допустимое количество камер. Батчинг меняет пропускную способность, а декодирование, отслеживание и отрисовка требуют дополнительных ресурсов. На уроке Ultralytics Academy по инференсу с несколькими потоками приводится правило расчёта: количество потоков на устройстве примерно равно устойчивой пропускной способности при реальном размере батча, делённой на требуемый FPS каждого потока, с запасом 20–30% на пиковую нагрузку. Измерь пропускную способность на плате с подключёнными камерами — ниже показано, как это сделать. Для обработки нескольких камер на Jetson DeepStream запускает несколько источников через один движок TensorRT в рамках одного приложения с плиточной компоновкой.
Выбирай по измеренному FPS на камеру, размеру модели и точности#
Начни с самой недорогой платы, которая может подойти, протестируй её на своих камерах и переходи на более мощную, только если её возможностей не хватает:
| Если результаты измерений показывают, что… | Начни с |
|---|---|
| YOLO26n обеспечивает нужную точность и требуемый FPS на камеру | CPU Pi 5 с NCNN. Для задачи с низким FPS может хватить и нескольких камер. |
| Частоты кадров Pi не хватает, но ты хочешь продолжать использовать эту плату | Pi 5 с ускорителем, например Hailo-8 AI HAT+ или DEEPX DX-M1. Оба запускают квантованные модели и требуют дополнительного этапа компиляции, поэтому проверь точность после экспорта. |
| Тебе нужна более крупная модель с высоким FPS, больше потоков, чем может стабильно обрабатывать Pi, или свободное время CPU для другого ПО | Jetson Orin Nano Super с TensorRT; переходи на Orin NX или AGX Orin, если измеренной пропускной способности не хватает. |
Частота кадров — это бизнес-требование, а не просто число из бенчмарка. В нашем руководстве по FPS в компьютерном зрении объясняется, как определить целевой показатель с учётом скорости наблюдаемого объекта, а в статье о выборе подходящего периферийного устройства рассматриваются и другие платы.
Протестируй обе платы со своими камерами#
Приведённые выше результаты измерены в фиксированных условиях; у тебя они будут отличаться в зависимости от охлаждения, режима питания, образа ОС, версии ПО и используемой модели. Пакет Ultralytics использует один и тот же API на обеих платах, поэтому измерения можно выполнить одинаково. Команды ниже проверены на Ultralytics 8.4.215.
Шаг 1. Проверь форматы экспорта на каждой плате#
Запусти yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 на плате. Режим Benchmark показывает размер, mAP50-95 и время инференса для каждого поддерживаемого платой формата экспорта; добавь quantize=16 или quantize=8, чтобы измерить FP16 или INT8, если формат их поддерживает. На Orin Nano Super Developer Kit с записанной конфигурацией Super сначала выбери режим питания MAXN SUPER; в публикации NVIDIA о режиме Super для JetPack 6.2 на Orin Nano это sudo nvpmodel -m 2. Затем запусти sudo jetson_clocks. Во время длительных запусков следи за температурой.
Шаг 2. Экспортируй модель в самый быстрый формат для каждой платы#
На Raspberry Pi 5 экспортируй модель в NCNN, как показано в нашем разборе Raspberry Pi 5. На Jetson собери движок непосредственно на устройстве, поскольку движки TensorRT привязаны к GPU и версии TensorRT, использованным при сборке. Движок, экспортированный без dynamic, имеет фиксированную форму входных данных. Можно задать batch равным количеству камер и повторно экспортировать модель с меньшим imgsz, если нужна более высокая скорость:
from ultralytics import YOLO

# Только для Jetson: требуется GPU NVIDIA. Движок TensorRT FP16, разрешение 640 пикселей, батч из четырёх камер
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # записывает yolo26n.engine
Шаг 3. Измерь обработанный FPS на камеру#
Укажи по одному URL RTSP на строку в cams.streams, запусти на нём модель платы примерно на минуту и сравни обработанный FPS каждой камеры с частотой отправки кадров. Таймер запускается после первого полного батча, когда потоки подключены, а модель прогрета, и останавливается после завершения полного батча:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
Это измерение пропускной способности конвейера по обработанным результатам. Если при добавлении потоков обработанный FPS камеры заметно ниже частоты кадров, значит, плата не справляется. Подтверди результат с помощью явных счётчиков пропущенных кадров для каждого потока из примера «производитель — потребитель» на уроке Academy по обработке нескольких потоков. Добавь необходимое приложению отслеживание или отрисовку, затем повторно экспортируй модель с меньшим imgsz, выбери модель поменьше или более быстрый формат экспорта либо перейди на более мощное оборудование и повтори измерения.
Если ты не хочешь настраивать среду сборки, вкладка Export в Ultralytics Platform позволяет собирать движки TensorRT для целевых устройств Jetson, в том числе для Orin Nano 8GB Super. Варианты Orin собираются на AGX Orin, а проверка на самом Orin Nano ещё не завершена. Поэтому убедись, что версии TensorRT и CUDA на устройстве совместимы с движком, и проверь каждый движок на целевом устройстве. Сравнение ONNX Runtime и TensorRT на GPU NVIDIA смотри в статье ONNX и TensorRT.
Какую плату выбрать#
Выбирай Raspberry Pi 5, если YOLO26n обеспечивает нужную точность, а измеренного на плате обработанного FPS хватает для всех нужных тебе камер. При скорости около 15 FPS инференса это простой вариант для касс в розничных магазинах, подсчёта товаров на конвейере, камер наблюдения за дикой природой и дома, а также ранних прототипов роботов. Если тебе нужно больше кадров, но ты хочешь остаться на Pi, добавь ускоритель.
Выбирай Jetson Orin Nano Super, если тебе нужна модель крупнее nano с практичной частотой кадров, больше потоков, чем может стабильно обрабатывать Pi, или свободное время CPU для отслеживания объектов, навигации и других задач приложения. Инференс YOLO26s–YOLO26l занимает менее 18 мс на изображение, и этот запас позволяет добавлять камеры. Проверь это, измерив производительность всего приложения.
Какую роль играет Ultralytics#
Ultralytics не производит ни одну из этих плат; мы разрабатываем модели и инструменты для обеих. Одни и те же веса YOLO26 можно экспортировать в NCNN для Pi 5, в Hailo для Pi с AI HAT+ и в TensorRT для Jetson. Поэтому ты можешь создать прототип на Pi и перейти на Jetson, когда вырастет нагрузка, без повторного обучения; после каждого экспорта проверяй точность. Ultralytics Platform помогает выполнить подготовительные шаги: разметить набор данных, обучить модель в облаке, если проекту требуется больше вычислительных ресурсов для обучения, чем доступно локально, и экспортировать модель для любой из этих плат.
Ограничения: наши опубликованные бенчмарки измеряют только инференс на указанных тестовых устройствах, а не на твоих камерах, в твоём корпусе или на производственном модуле; в руководстве по Jetson также нет результатов YOLO26 для исходной Jetson Nano. Ultralytics YOLO доступна по лицензии AGPL-3.0 или корпоративной лицензии Ultralytics; о требованиях к развёртыванию читай в разделе лицензирования Ultralytics.
Часто задаваемые вопросы
Инференс одного изображения на нём значительно быстрее. В наших опубликованных бенчмарках, полученных в отдельных тестах, YOLO26n выполняет инференс за 4,57 мс как движок TensorRT FP16 на Jetson Orin Nano Super Developer Kit против 67,03 мс на CPU Raspberry Pi 5 с NCNN (входное изображение 640 пикселей, только инференс); YOLO26m выполняет инференс на Jetson за 13,59 мс. Нужна ли тебе такая скорость, зависит от модели, количества камер и целевого FPS: если Pi 5 справляется с ними по результатам твоих измерений, её проще использовать.
Нет. Исходная Jetson Nano вышла в 2019 году с GPU Maxwell на 128 ядер и 4 ГБ памяти и поддерживает только JetPack 4. Jetson Orin Nano — более новый модуль с GPU Ampere на 1024 ядра; протестированный нами Jetson Orin Nano Super Developer Kit оснащён 8 ГБ памяти и поддерживает JetPack 5–7. В этой статье сравнивается производительность Orin Nano Super, а не исходной Nano.
Да. Jetson Nano 2019 года поддерживает JetPack 4, Ultralytics предоставляет Docker-образ для JetPack 4, а наше руководство по DeepStream для YOLO26 с TensorRT протестировано на Jetson Nano 4GB с JetPack 4.6.4. В руководстве по Jetson нет бенчмарка YOLO26 для этой платы, а её оборудование значительно уступает Orin Nano Super.
Все потоки используют общие вычислительные ресурсы платы: для каждой добавленной камеры нужны декодирование, предварительная обработка, инференс и последующая обработка. Если использовать файл
.streams, Ultralytics группирует кадры со всех камер в батчи и пропускает устаревшие кадры, когда модель не успевает. Поэтому обработанный FPS каждой камеры может снизиться, если общий конвейер станет узким местом. Повысить FPS поможет более быстрый формат экспорта, модель поменьше илиimgsz, а также более мощное оборудование.Да. Обучи модель один раз, затем экспортируй те же веса с помощью
format="ncnn"для Pi 5 иformat="engine"для Jetson. Движок TensorRT собери непосредственно на целевом устройстве или для него. После каждого экспорта проверь точность на собственных данных.
Автор
Старший инженер по машинному обучению · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









