Сравнение платформ управляемого обучения и собственных GPU для компьютерного зрения
Сравни платформы управляемого обучения на GPU, облачные ML-сервисы, аренду GPU и собственное оборудование для компьютерного зрения: стоимость, настройку, точку окупаемости и ситуации, в которых подходит каждый вариант.
 Miles Deans10 мин. чтения
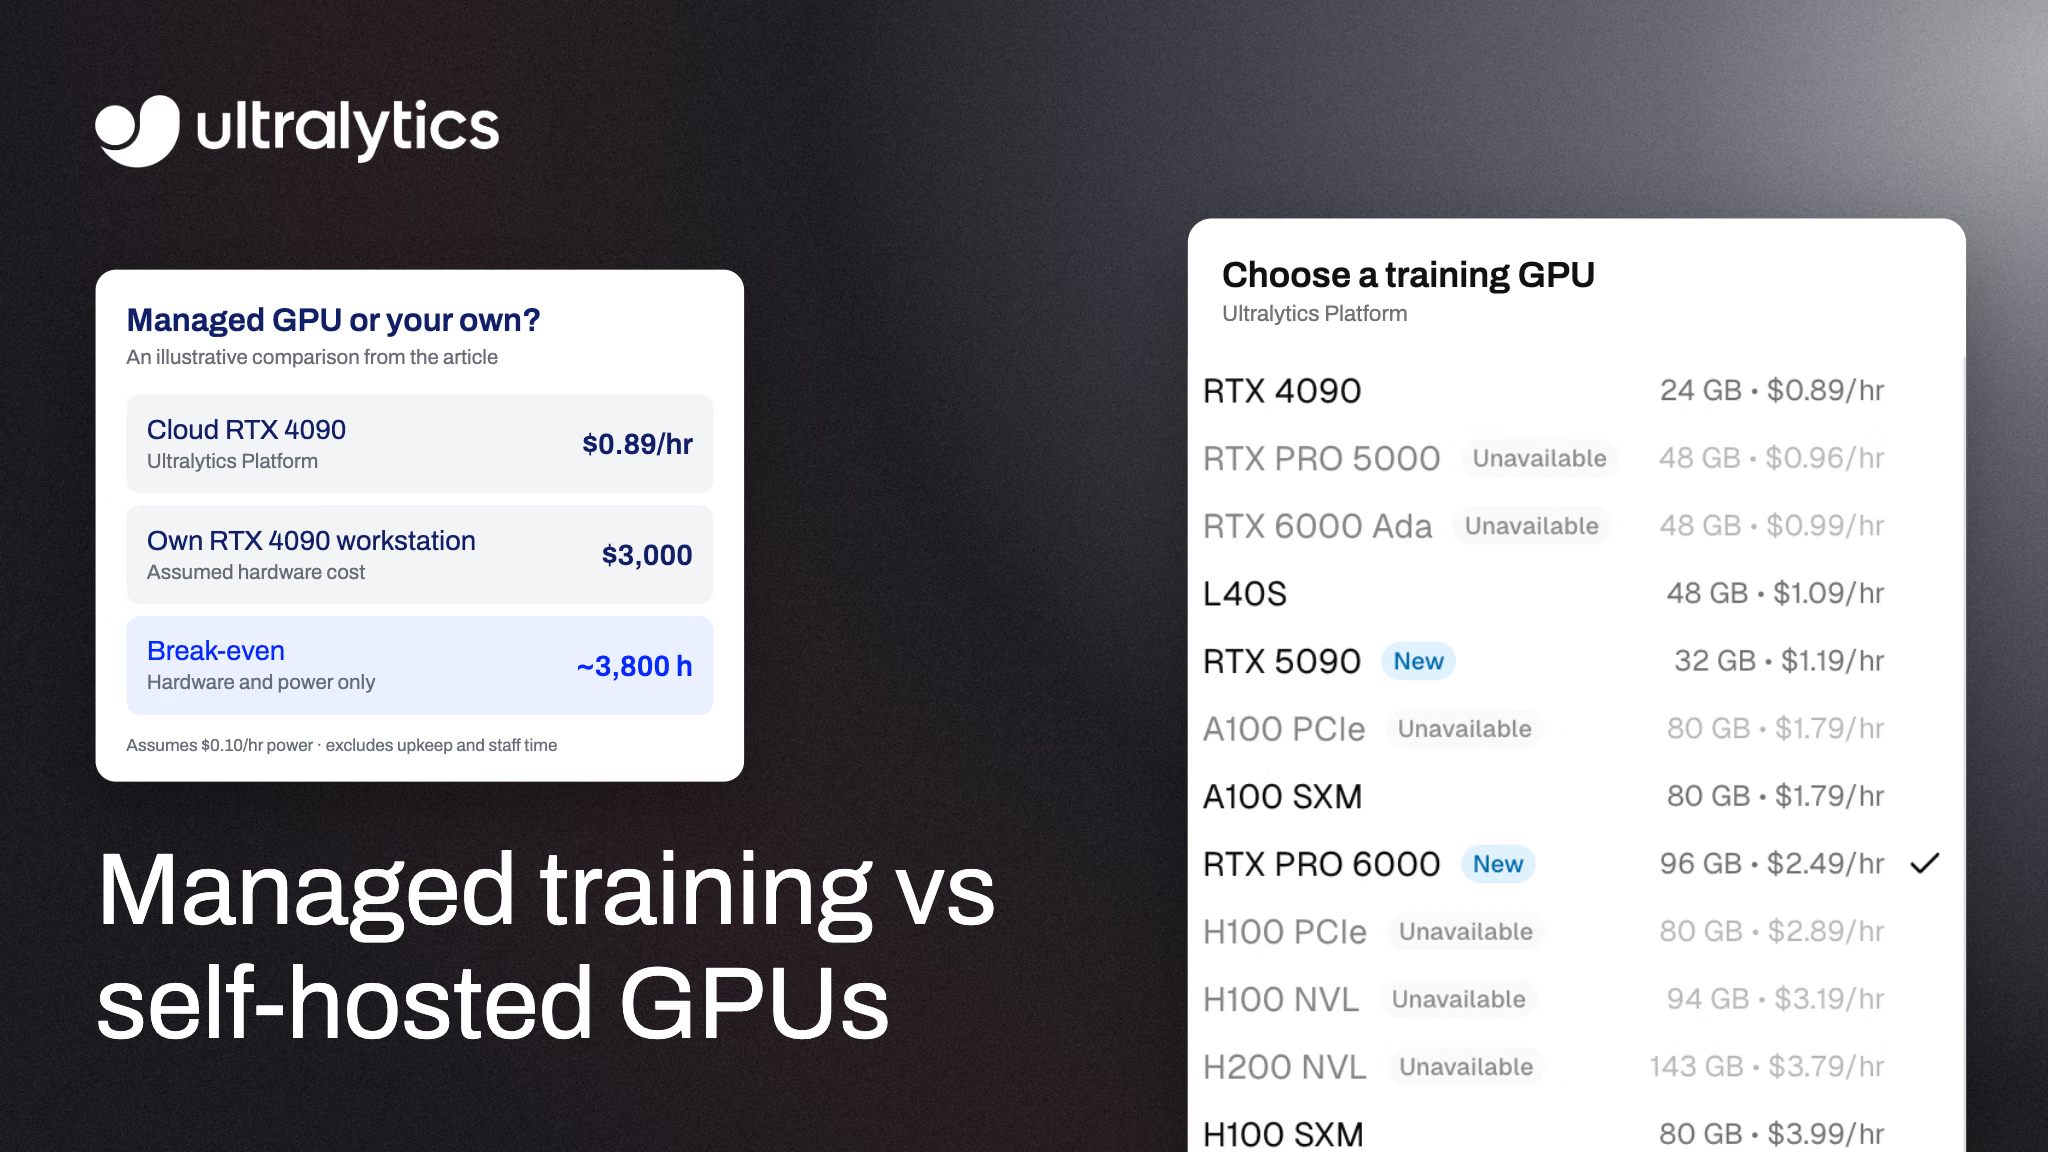
Платформы управляемого обучения берут на себя инфраструктуру для обучения и выставляют счёт за время работы GPU; при использовании собственных GPU ваша команда отвечает за оборудование и окружение — независимо от того, арендуете вы машины или владеете ими. Управляемое обучение обычно подходит для непостоянных нагрузок и команд, которые хотят тратить меньше времени на инфраструктуру. Собственные GPU могут обходиться дешевле при стабильной загрузке, но итог зависит от того, насколько загружено оборудование, как долго оно служит, а также от расходов на электричество и инженерное время.
В этом руководстве сравниваются четыре распространённых варианта обучения моделей компьютерного зрения в 2026 году, показано, как рассчитать точку окупаемости для твоей нагрузки, и объясняется, где здесь Ultralytics Platform.
Четыре варианта обучения модели компьютерного зрения#
За формулировкой «управляемое или собственное» обычно скрываются четыре разных варианта:
- Платформа управляемого обучения моделей компьютерного зрения. Ты загружаешь набор данных или подключаешь его, выбираешь модель и GPU, а платформа запускает обучение. Так работает Ultralytics Platform для моделей YOLO.
- Универсальная ML-платформа. Такие сервисы, как Amazon SageMaker, Google Vertex AI и Azure Machine Learning, запускают задания обучения на облачных инстансах для множества фреймворков. Ты настраиваешь задание обучения, его окружение, разрешения и хранилище, а вычислительные ресурсы и сопутствующие сервисы оплачиваются отдельно. Поэтому сравнивай официальные страницы с ценами каждого провайдера, а не только тарифы на GPU.
- Аренда облачного GPU. Облачные сервисы GPU, такие как RunPod и Lambda, сдают тебе машину в аренду с оплатой за время использования. Если в образе провайдера уже нет всего необходимого, тебе нужно настроить драйверы, CUDA, пакеты Python и код обучения, а после завершения остановить инстанс.
- Собственный GPU. Рабочая станция или сервер в офисе либо центре обработки данных. Ты один раз покупаешь оборудование и оплачиваешь электричество, охлаждение, обслуживание и время, затраченное на поддержание его работоспособности.
Сравнение управляемого обучения и собственных GPU вкратце#
| Критерий выбора | Платформа управляемого обучения компьютерного зрения | Универсальная ML-платформа | Аренда облачного GPU | Собственный GPU |
|---|---|---|---|---|
| Нужна ли покупка оборудования | Нет | Нет | Нет | Да |
| За что ты платишь | За использованное время GPU | За время работы инстанса и сопутствующие сервисы | За время работы инстанса | За оборудование, электричество и обслуживание |
| Настройка перед первым запуском | Выбрать набор данных, модель и GPU | Настроить задание, окружение, разрешения и хранилище | Настроить или проверить окружение, код и зависимости | Оборудование, ОС, драйверы, пакеты |
| Среда обучения | Платформа запускает обучение, ты выбираешь настройки | Обязанности разделены между сервисом и твоей командой | Преимущественно ответственность твоей команды | Твоя команда |
| Как получить более мощный GPU | Выбрать другой доступный GPU | Выбрать другой тип инстанса | Арендовать ещё одну машину | Купить ещё один GPU |
| Где находятся данные | В хранилище платформы, подключённом облачном бакете (планы Pro и Enterprise) или локально (план Enterprise) | В твоём облачном аккаунте | Там, куда ты скопируешь данные | На твоей площадке |
| Когда стоит рассмотреть | Быстрое и воспроизводимое обучение моделей компьютерного зрения | Команды, уже стандартизировавшие ML-инструменты одного облачного провайдера | Инженеры, которым удобно управлять машинами | Постоянное или почти непрерывное обучение либо строгие требования к размещению данных на своей площадке |
Как рассчитывается стоимость управляемого обучения на GPU#
На Ultralytics Platform стоимость GPU для одного запуска обучения легко оценить:
GPU cost = selected GPU hourly rate × billable GPU hoursСравнивая провайдеров, используй одинаковую нагрузку и целевую точность, а сверху добавь стоимость подписки, хранилища, передачи данных и инженерного времени.
На Ultralytics Platform доступно 26 типов GPU NVIDIA по цене от $0.24/hr, без минимального срока и обязательств; в плане Free доступны 24 GPU, а в планах Pro и Enterprise — все 26. Вот несколько распространённых вариантов:
| GPU | Объём VRAM | Цена за час |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (рекомендуемый вариант по умолчанию) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (планы Pro и Enterprise) | 180 GB | $7.99 |
Стоимость рассчитывается по фактическому времени работы GPU. За завершённые и отменённые запуски, а также за запуски, завершившиеся с ошибкой после старта GPU, взимается плата за прошедшее время работы GPU; если ошибка произошла до запуска GPU, плата не взимается. Перед запуском диалог обучения оценивает его длительность и стоимость, причём для каждой оценки резервируется не менее 15 минут работы GPU из твоего баланса; от этого резерва зависит сумма, необходимая для старта, а фактическая оплата рассчитывается по реальному времени работы GPU.
Для ориентира: согласно типичному времени обучения Ultralytics, обучение на RTX PRO 6000 на 1 000 изображениях в течение 100 эпох занимает около 15 минут для YOLO26m и около 30 минут для YOLO26x. При цене $2.49 в час это примерно $0.62 и $1.25 за время работы GPU. Реальная длительность зависит от размера изображений, аугментаций и размера пакета, поэтому используй эти значения как отправную точку, а не как точную смету.
Сколько на самом деле стоят собственные GPU#
За собственный GPU не выставляют почасовой счёт, но каждый запуск не становится бесплатным. Общие затраты включают:
- Оборудование и остальные компоненты рабочей станции или сервера, в котором установлен GPU.
- Электричество и охлаждение за каждый час обучения.
- Инженерное время на драйверы, версии CUDA, конфликты пакетов и неисправные окружения.
- Простой. Если GPU обучает модель два часа в день, всё остальное время он простаивает, и стоимость часа обучения соответственно растёт.
- Ограничения по мощности. Если модели нужно больше VRAM, чем у тебя есть, или несколько экспериментов должны идти одновременно, придётся ждать или покупать дополнительное оборудование.
Упрощённое сравнение затрат на оборудование и электричество при условии, что собственный GPU обучает модель с той же скоростью, что и облачный:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)Рассмотрим пример с условными числами: допустим, рабочая станция с RTX 4090 стоит тебе $3,000, а электричество обходится примерно в $0.10 за час обучения. Если аренда RTX 4090 стоит $0.89 в час, точка окупаемости наступит примерно через 3 800 часов обучения: это около 5,3 месяца непрерывной работы или 15,8 месяца при работе по восемь часов каждый день. В расчёт не входят охлаждение, расход электричества в простое, ремонт, финансирование, перепродажа и твоё время. Покупка оборудования окупится, только если за срок его полезной эксплуатации наберётся столько часов обучения. Используй фактическую стоимость оборудования, цену электричества и ожидаемое число часов обучения: загрузка сильно влияет на результат.
Когда имеет смысл использовать собственные GPU#
Собственное оборудование подходит лучше, когда:
- Твои GPU постоянно загружены. Регулярное переобучение, масштабный поиск гиперпараметров или совместная работа команды на одной машине в течение всего дня повышают загрузку и приближают точку окупаемости.
- Данные нельзя выносить за пределы твоей площадки. Некоторые регулируемые среды или системы с физической изоляцией от сети полностью исключают обучение в облаке.
- У тебя уже есть оборудование. Если мощный GPU простаивает, сравни стоимость его эксплуатации и время обучения с облачными вариантами, прежде чем платить за новое оборудование.
- Тебе нужен полный контроль над драйверами, ядрами или пользовательским кодом обучения, который не поддерживает управляемая платформа.
Когда имеет смысл управляемое обучение#
Управляемая платформа подходит лучше, когда:
- Обучение требуется время от времени. Ты обучаешь модель после обновления данных, а затем несколько дней не запускаешь обучение.
- Ты хочешь начать сегодня. Перед первым запуском не нужно устанавливать драйверы, разбираться с несовместимыми версиями CUDA или отлаживать окружение.
- Размеры моделей различаются. Ты можешь обучать крошечную модель на небольшом GPU, а крупную — на GPU с 80 ГБ или больше, не покупая ни один из них.
- Обучением занимаются несколько человек. Запуски, метрики и контрольные точки хранятся в одном месте, а не на отдельных машинах.
Гибридный вариант: собственные GPU и управляемая панель управления#
Необязательно выбирать только один вариант. Ultralytics Platform поддерживает удалённое обучение: ты обучаешь модель на собственном GPU с пакетом ultralytics, передаёшь метрики в реальном времени на ту же панель управления Platform, которая используется для облачных запусков, и загружаешь итоговые веса по завершении обучения. При удалённом обучении используется собственный GPU, а не облачные GPU Ultralytics, поэтому время работы облачного GPU не расходуется.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # твой проект на Platform
    name="local-gpu-run",
)
Сначала укажи API-ключ с помощью export ULTRALYTICS_API_KEY="YOUR_API_KEY". Для интеграции с Platform требуется Python версии 3.11 или новее и ultralytics версии 8.4.120 или новее. Распространённый подход: запускать быстрые эксперименты на локальном GPU, а более масштабные или срочные — на облачном GPU, когда локальная машина занята.
Как обучить YOLO26 на управляемом GPU с Ultralytics Platform#
- Создай аккаунт на platform.ultralytics.com. Новые аккаунты получают $5 в виде бонуса за регистрацию или $25 после подтверждения рабочей электронной почты.
- Добавь набор данных: загрузи изображения и метки или подключи бакет Amazon S3 в плане Pro или Enterprise.
- Открой диалог обучения, выбери модель YOLO26 и укажи число эпох и размер изображения.
- Выбери GPU. Рекомендуемый вариант по умолчанию — RTX PRO 6000; о компромиссах при выборе облачного GPU читай в соответствующем руководстве.
- Проверь оценку стоимости, запусти обучение и следи за метриками в реальном времени до завершения запуска.
В плане Free можно одновременно запускать до 3 заданий обучения в облаке. План Pro за $29 за пользователя в месяц увеличивает лимит до 10 заданий и ежемесячно предоставляет $30 бонуса каждому пользователю.
После обучения можно экспортировать модель или развернуть её как API. Если ты также решаешь, где запускать инференс, в нашем руководстве об облачном и локальном ИИ для компьютерного зрения сравниваются стоимость, задержка и контроль над данными при развёртывании.
Часто задаваемые вопросы
Иногда да, особенно если обучение требуется время от времени: ты платишь только за использованные часы GPU. Сравни общую стоимость и время выполнения одинаковой задачи. Расчёт точки окупаемости выше (стоимость оборудования, делённая на почасовую ставку облачного GPU за вычетом стоимости электричества в час) — это лишь отправная точка, а не гарантия.
Арендуя облачный GPU, ты получаешь машину, а твоя команда настраивает нагрузку обучения и проверяет либо устанавливает окружение. Управляемая платформа берёт на себя большую часть процесса: на Ultralytics Platform ты выбираешь набор данных, модель и GPU, а платформа выделяет GPU, запускает обучение, передаёт метрики и сохраняет контрольные точки.
На Ultralytics Platform за запуск, завершившийся с ошибкой после старта облачного GPU, взимается плата за прошедшее время его работы; если ошибка произошла до запуска GPU, плата не взимается. За отменённые запуски взимается плата за время работы GPU до отмены.
Да. Удалённое обучение выполняется на собственном оборудовании, передаёт метрики в реальном времени на Platform и загружает итоговые веса, поэтому время работы облачного GPU не расходуется.
RTX PRO 6000 (96 ГБ) — рекомендуемый вариант по умолчанию для большинства задач. Ultralytics рекомендует RTX 4090 для обычного обучения, A100 SXM — для больших размеров пакета или крупных моделей, а GPU H100, H200, B200 и B300 — для срочных задач, требующих много памяти, и самых масштабных нагрузок.
Новые аккаунты Ultralytics Platform получают бонус в размере $5 при регистрации, а после подтверждения рабочего адреса электронной почты — $25. В планы Pro входит кредит на сумму $30 на каждое место ежемесячно.
Нет. Kubernetes может планировать выполнение задач с использованием GPU, но для этого в его документации по планированию GPU требуются драйверы GPU и плагин устройства производителя на узлах. Для кластера обучения, которым ты управляешь самостоятельно, всё равно понадобится человек, отвечающий за окружения, разрешения, мониторинг задач и контрольные точки, поэтому учитывай эти затраты наряду с вычислительными ресурсами.
Автор
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









