ONNX и TensorRT для инференса в компьютерном зрении: бенчмарки и рекомендации по выбору
ONNX Runtime и TensorRT для инференса в компьютерном зрении: измеренные скорость и точность Ultralytics YOLO26 на 19 GPU NVIDIA и рекомендации по выбору.
 Miles Deans11 мин. чтения
ONNX и TensorRT — не совсем конкуренты. ONNX — это формат модели, а TensorRT — движок инференса NVIDIA, который обычно получает на вход файл ONNX. Реальный выбор заключается в том, как запускать этот файл: с помощью ONNX Runtime, который работает на разном оборудовании и даже может передавать задачи TensorRT, или с помощью скомпилированного автономного движка TensorRT, который работает только на GPU NVIDIA. В бенчмарках Ultralytics Platform для Ultralytics YOLO26 на 19 GPU NVIDIA TensorRT FP16 оказался быстрее опубликованных результатов ONNX FP16 на всех GPU и для всех размеров моделей, при этом разница в точности не превышала 0.001 mAP50-95. Медианное ускорение для моделей разных размеров составляло от 1.85x до 2.55x. В бенчмарке не указано, какой провайдер выполнения ONNX Runtime использовался для получения результатов ONNX, поэтому он не дает общего ответа на вопрос о сравнении ONNX Runtime с TensorRT или с его провайдером выполнения TensorRT. Для Ultralytics YOLO на GPU NVIDIA начни с TensorRT FP16, если важна задержка, и используй ONNX Runtime, если одна модель должна работать на разных типах оборудования. Ultralytics YOLO экспортируется в оба формата с помощью одного аргумента.
С чего начать работу с Ultralytics YOLO:
| Развертывание | Начни с | Экспорт Ultralytics YOLO |
|---|---|---|
| GPU NVIDIA, важна задержка | TensorRT FP16 | format="engine", quantize=16 |
| CPU, оборудование не NVIDIA или смешанный парк устройств | ONNX Runtime | format="onnx" |
| API ONNX Runtime на GPU NVIDIA | ONNX Runtime с провайдером выполнения TensorRT | format="onnx" |
ONNX и TensorRT: формат, среда выполнения и движок#
За этим сравнением скрываются три разные вещи:
- ONNX (Обмен открытыми нейронными сетями) — это формат файла, в котором граф и веса обученной модели хранятся независимо от фреймворка. Ты экспортируешь модель из PyTorch в ONNX, чтобы другие инструменты могли ее читать.
- ONNX Runtime запускает модели ONNX. Он передает задачи аппаратным бэкендам, называемым провайдерами выполнения, например CPU, CUDA и TensorRT, поэтому один и тот же файл можно запускать как на CPU ноутбука, так и на облачном GPU.
- TensorRT считывает модель, обычно файл ONNX, с помощью своего парсера ONNX. Он объединяет слои, выбирает самое быстрое ядро для каждой операции на GPU, для которого собирается, и создает оптимизированный движок.
Итак, на самом деле речь идет о сравнении ONNX Runtime и TensorRT. ONNX Runtime также может вызывать TensorRT через свой провайдер выполнения TensorRT, позволяя использовать API ONNX Runtime, пока TensorRT выполняет поддерживаемые им подграфы. ONNX Runtime рекомендует регистрировать провайдер выполнения CUDA после него, чтобы узлы, не поддерживаемые TensorRT, могли выполняться на CUDA.
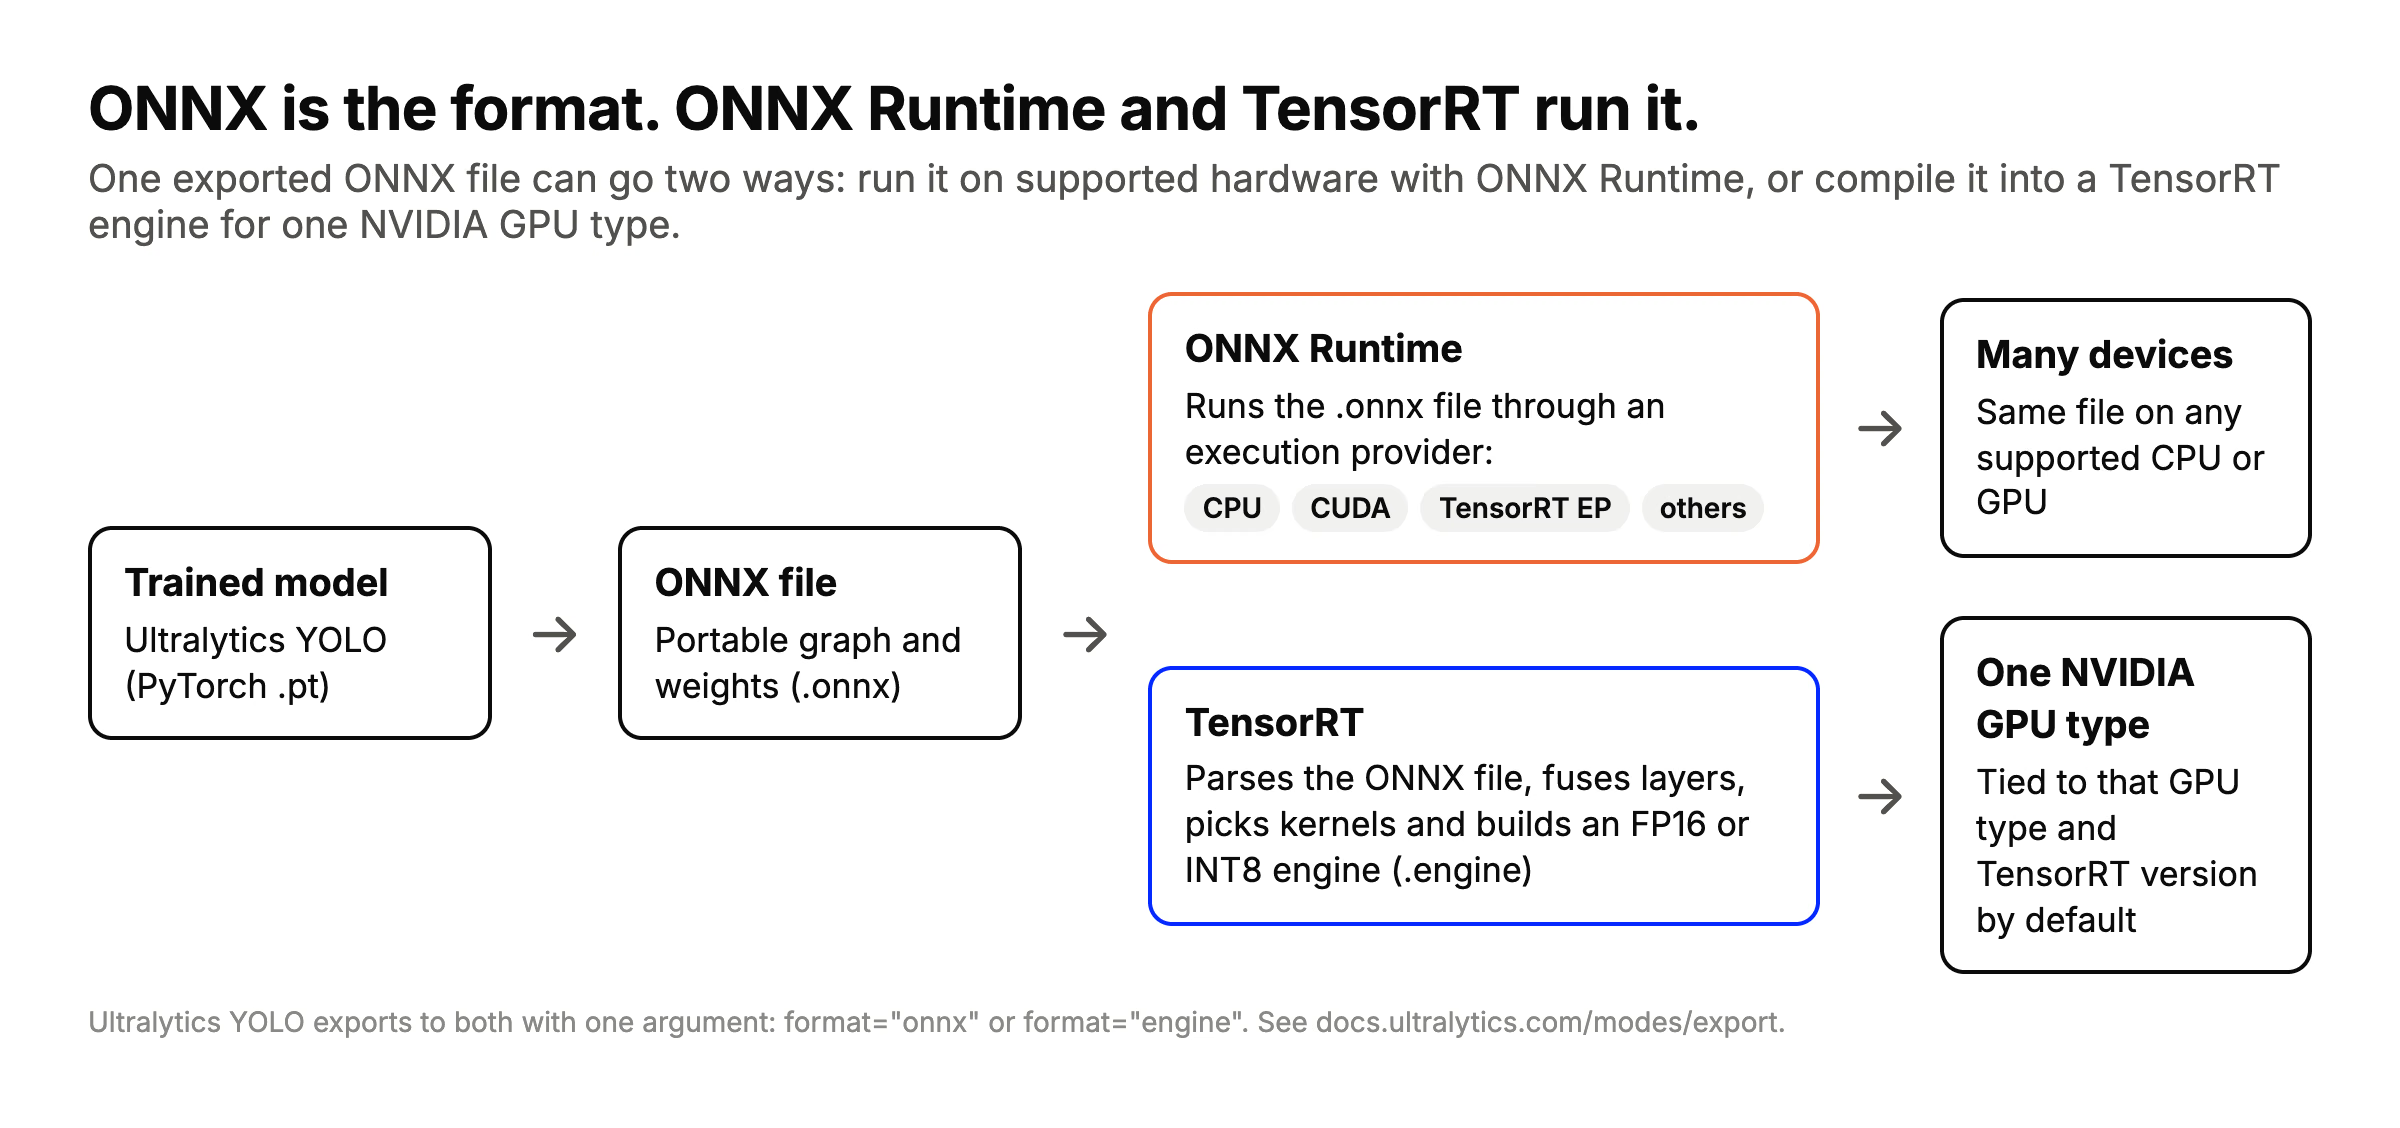
Один файл ONNX — два способа запуска: ONNX Runtime запускает его на поддерживаемом оборудовании, а TensorRT компилирует его в движок для одного типа GPU NVIDIA. Ultralytics YOLO экспортируется в оба формата.
Бенчмарки: YOLO26 на ONNX Runtime и TensorRT#
Данные ниже взяты из бенчмарков инференса Ultralytics Platform. Каждая модель детекции Ultralytics YOLO26 была экспортирована в указанный формат, после чего на GPU Ultralytics Platform измерялась ее задержка инференса при batch 1 и размере 640 пикселей на COCO val2017; время прогрева исключалось, а время отдельных запусков фильтровалось методом сигма-клиппинга. Точность — это mAP50-95 на COCO val2017, измеренная один раз для каждого формата и уровня точности. В сравнении используются 19 GPU NVIDIA (Ampere, Ada и Hopper), для которых есть результаты во всех четырех форматах.
На странице бенчмарков не указано, какой провайдер выполнения ONNX Runtime использовался для получения результатов ONNX, и ни один результат не помечен как полученный с провайдером выполнения TensorRT в ONNX Runtime, который передает поддерживаемые части модели TensorRT. Эти результаты ONNX описывают конфигурацию, использованную в бенчмарке; производительность может зависеть от провайдера выполнения ONNX Runtime. Если тебе нужен API ONNX Runtime с TensorRT под капотом, проверь эту комбинацию на своем оборудовании.
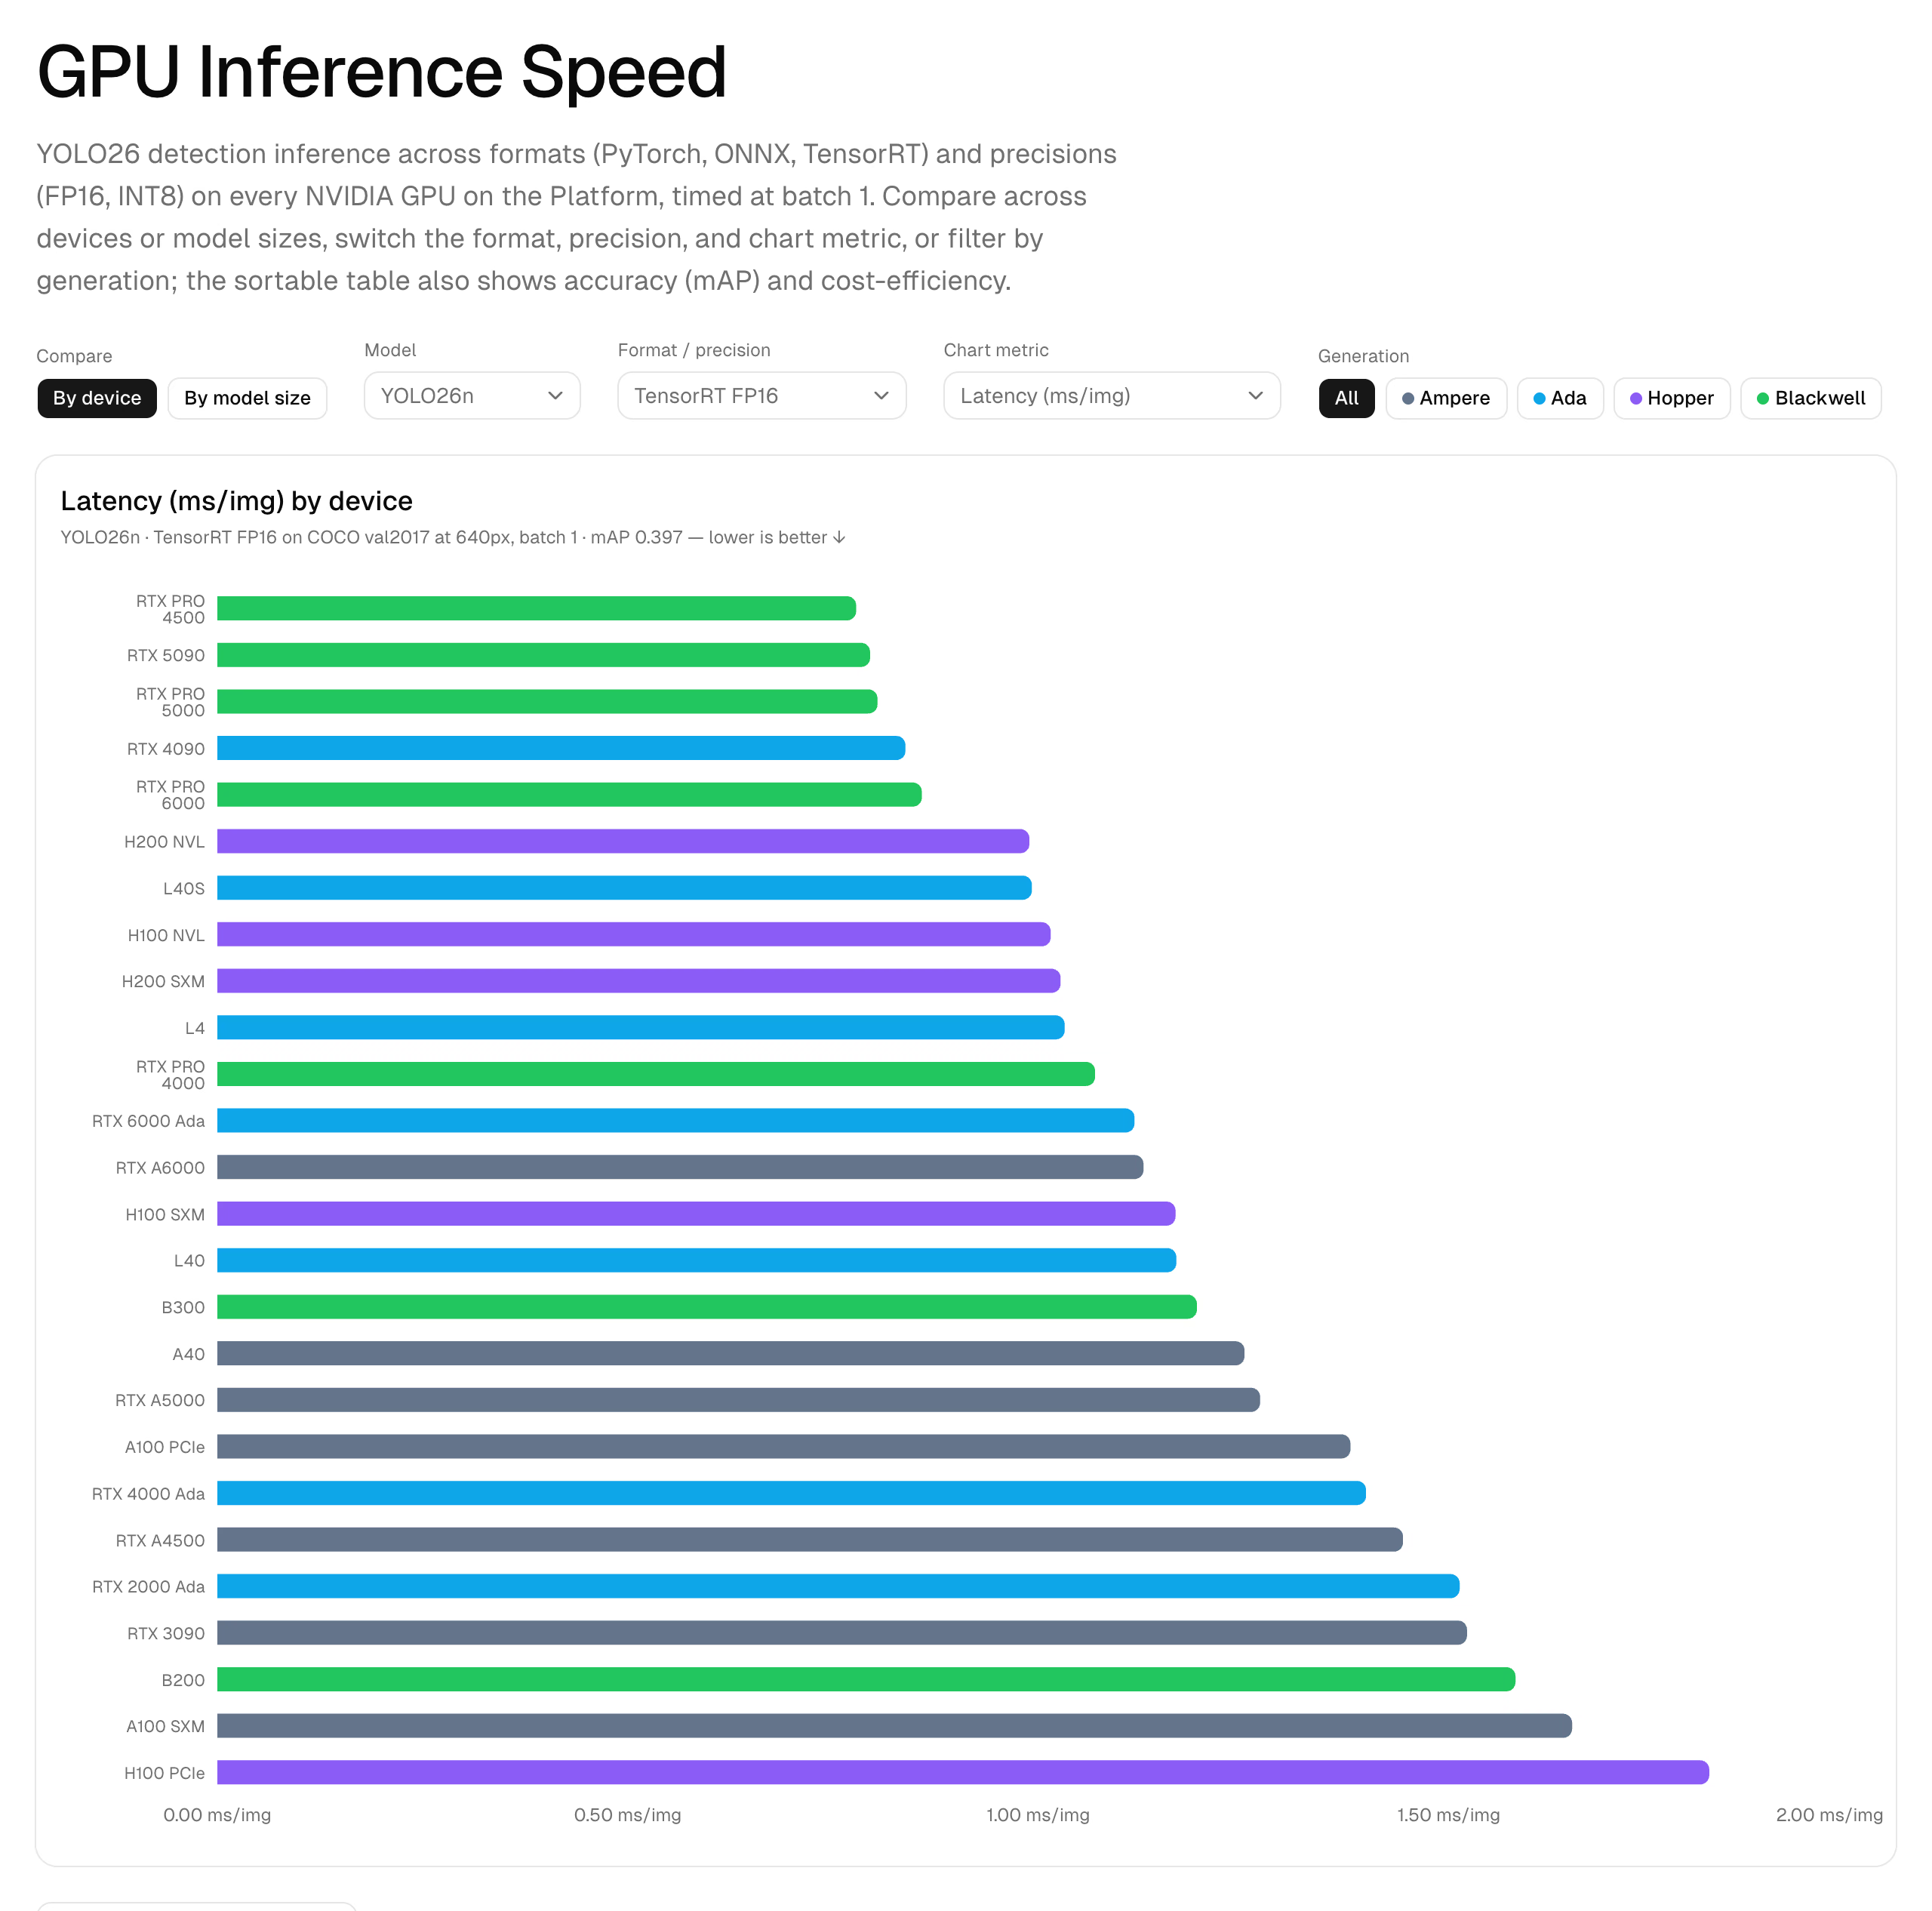
На вкладке Inference можно менять размер модели, формат и точность, а затем сортировать все GPU по задержке, точности или стоимости.
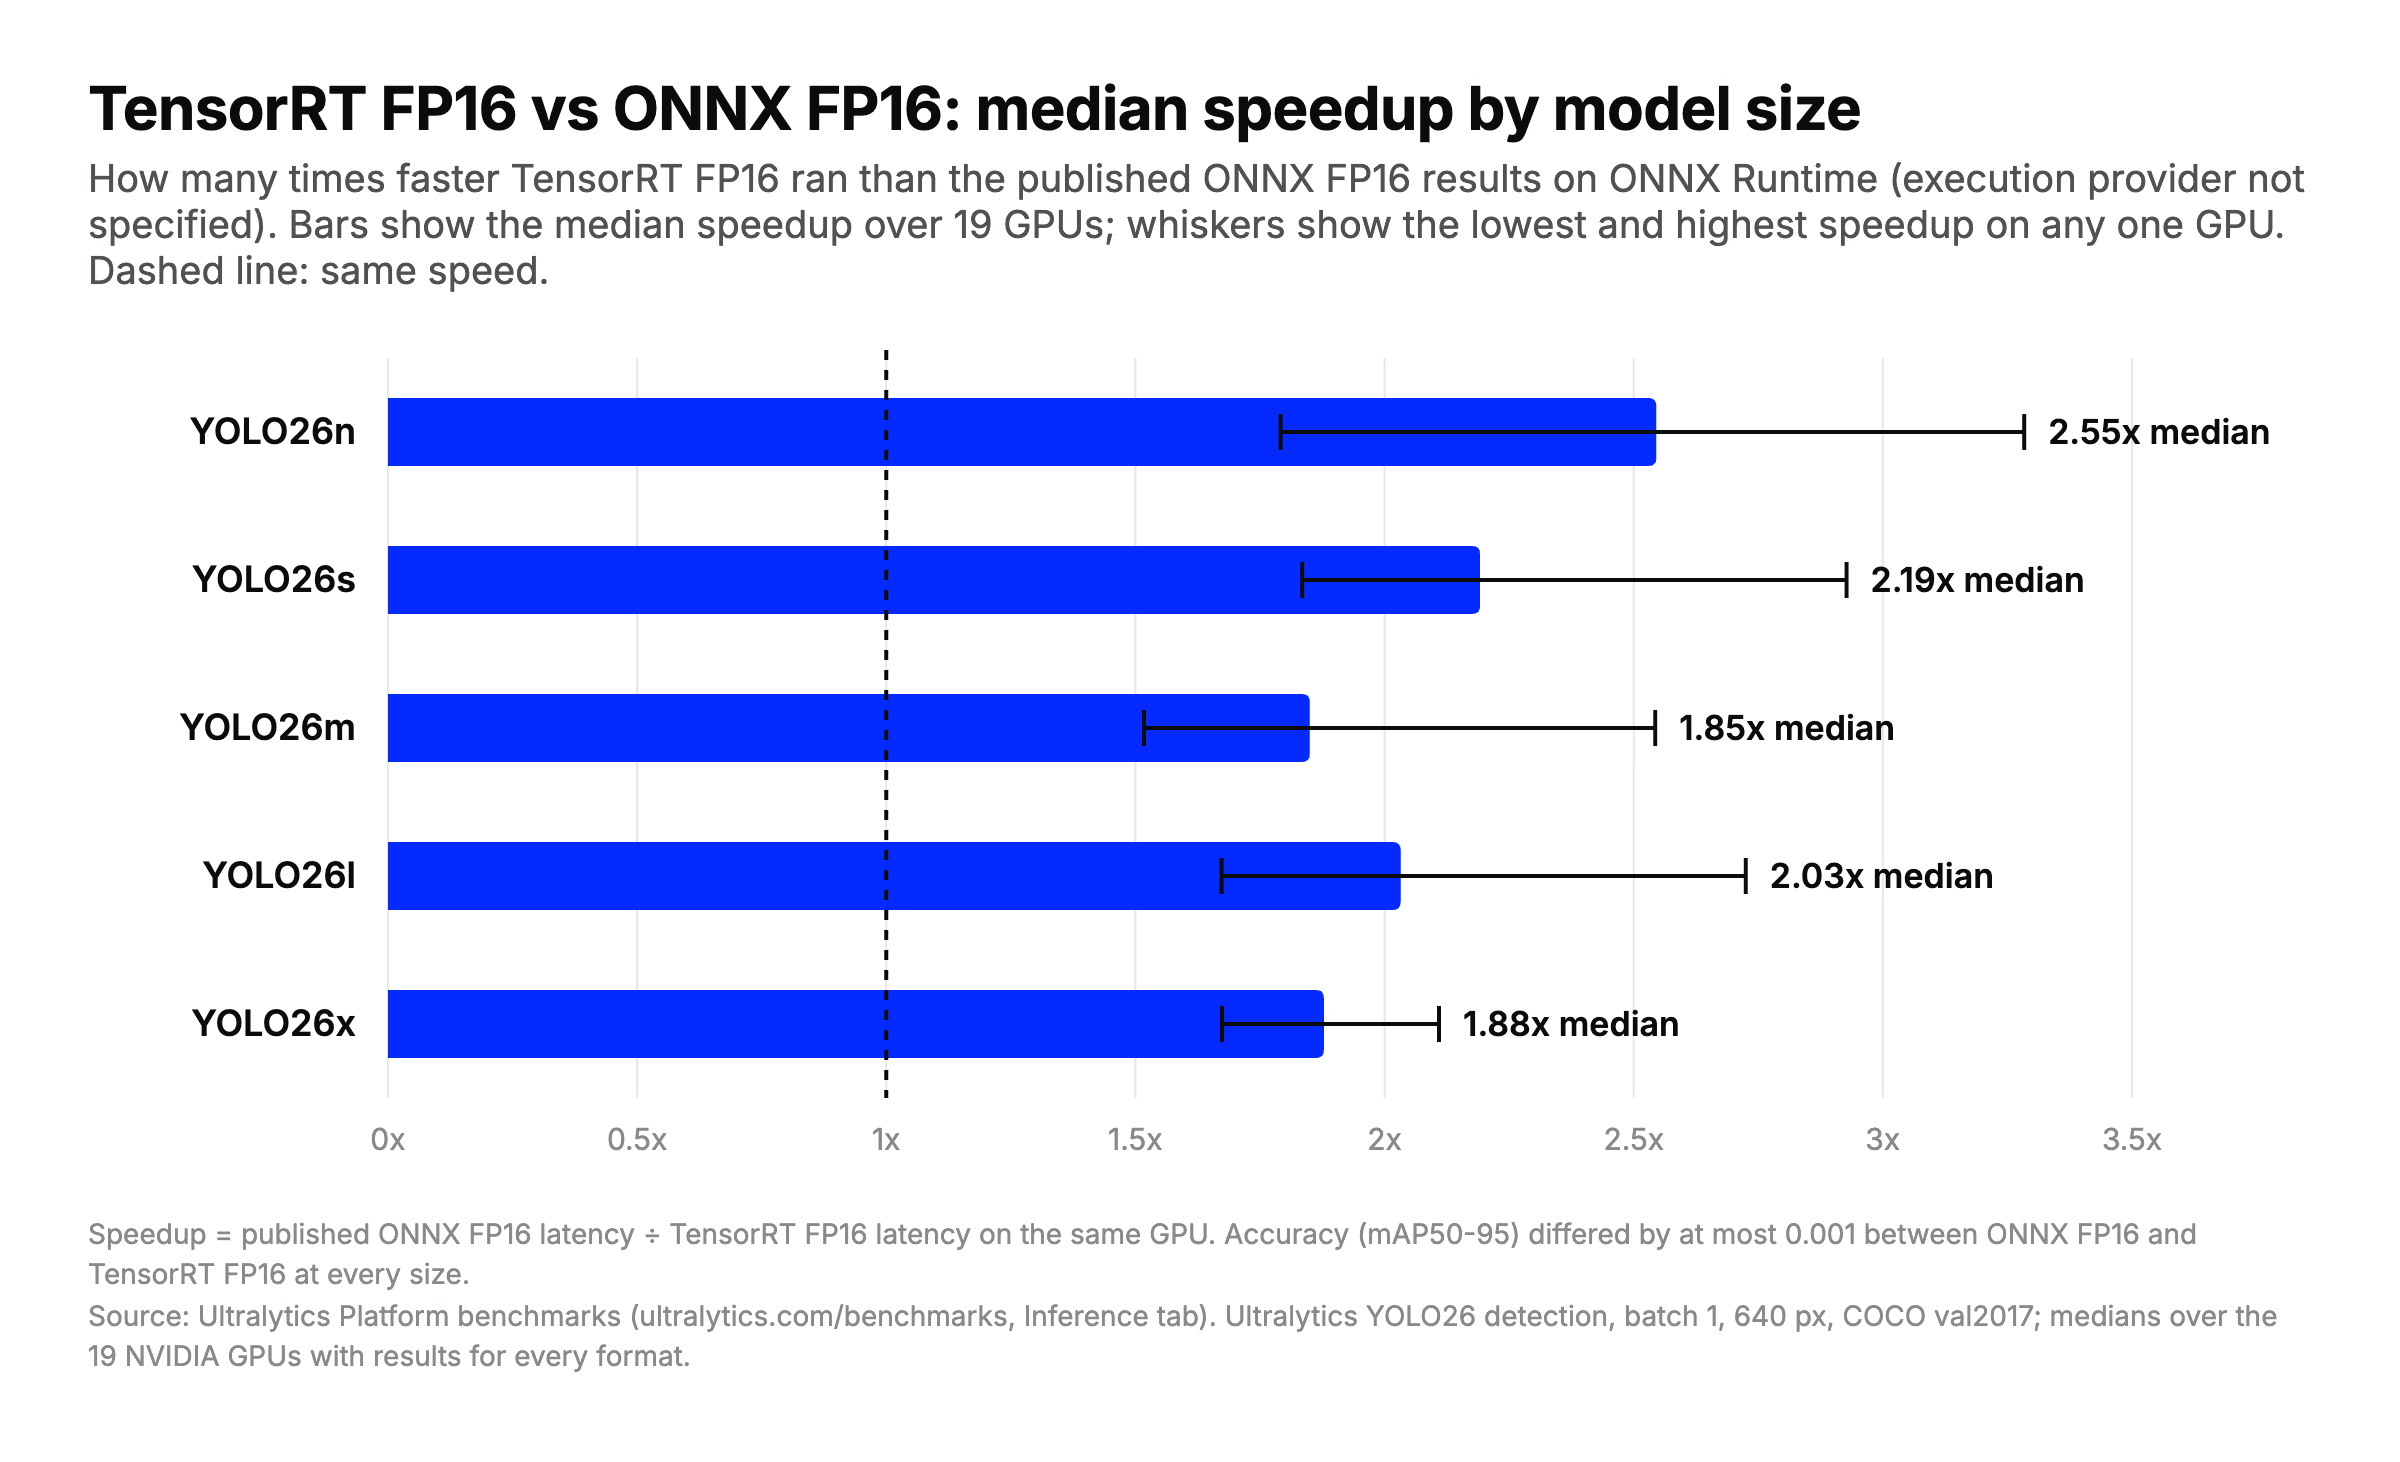
TensorRT FP16 оказался быстрее опубликованных результатов ONNX FP16 на всех GPU и для всех размеров моделей; на странице не указано, какой провайдер выполнения ONNX Runtime использовался для их получения. Столбцы показывают медианное ускорение на 19 GPU; планки погрешностей показывают минимальное и максимальное ускорение на отдельных GPU. Рассчитано по бенчмаркам инференса Ultralytics Platform.
| Модель | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | Ускорение TensorRT FP16 относительно ONNX FP16 (медиана, диапазон) | Ускорение TensorRT INT8 относительно TensorRT FP16 (медиана, диапазон) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Рассчитано по бенчмаркам инференса Ultralytics Platform. Ускорение — это задержка ONNX FP16 ÷ задержка TensorRT FP16 или задержка TensorRT FP16 ÷ задержка TensorRT INT8 на одном и том же GPU, поэтому значения выше 1x означают, что TensorRT FP16 (или INT8) был быстрее. Медианные значения рассчитаны по 19 GPU NVIDIA, для которых есть результаты во всех четырех форматах; диапазон — минимальное и максимальное отношение среди этих GPU. Точность — указанное значение mAP50-95 для каждого формата и уровня точности. ONNX FP16 означает опубликованные результаты ONNX Runtime, для которых провайдер выполнения не указан.
Задержка на четырех распространенных GPU, в миллисекундах на изображение, согласно данным на странице бенчмарков:
| GPU | Модель | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Выделяются три момента:
- TensorRT FP16 превзошел опубликованные результаты ONNX FP16 на всех GPU и для всех размеров моделей; разница в точности не превышала 0.001 mAP50-95. Если ты развертываешь модели на этих GPU NVIDIA и тебе нужна низкая задержка, начни с TensorRT FP16.
- INT8 не всегда дает выигрыш. Для YOLO26n он оказался медленнее TensorRT FP16 на 17 из 19 GPU, а точность снизилась на 0.04 mAP50-95. Для более крупных моделей INT8 помогал чаще: ускорение достигало 1.67x для YOLO26x на L4, но точность снижалась на 0.034–0.076 mAP50-95.
- Для семи GPU Blackwell нет результатов ONNX. На странице бенчмарков это объясняется тем, что в тестовой среде ONNX Runtime нет ядер для Blackwell. TensorRT работал на всех семи GPU.
Эти результаты относятся к конфигурации, указанной на странице бенчмарков, при batch 1 и размере 640 пикселей, поэтому перед выбором протестируй собственную модель на целевом устройстве и своих данных.
FP16 и INT8 в TensorRT#
Понижение точности — еще один важный способ ускорить работу, и бенчмарк показывает, почему его нужно проверять:
- FP16 (половинная точность) вдвое уменьшает размер весов и активаций по сравнению с FP32. В бенчмарках Ultralytics Platform точность TensorRT FP16 отличалась от ONNX FP16 и PyTorch FP16 не более чем на 0.003 mAP50-95.
- INT8 хранит веса и активации в виде 8-битных целых чисел — это разновидность квантования модели. Для этого нужна калибровка: через модель пропускают репрезентативный набор изображений, чтобы измерить диапазоны активаций. В бенчмарке Ultralytics Platform для калибровки использовались NVIDIA ModelOpt и COCO128.
Как отмечено в методике бенчмарка, INT8 особенно эффективен для более крупных моделей, ограниченных вычислительными ресурсами. На самых маленьких моделях дополнительные затраты на квантование могут сравняться с затратами на FP16 или даже замедлить работу. Выполни калибровку на изображениях из своей предметной области, затем проверь точность на собственных данных до развертывания движка INT8.
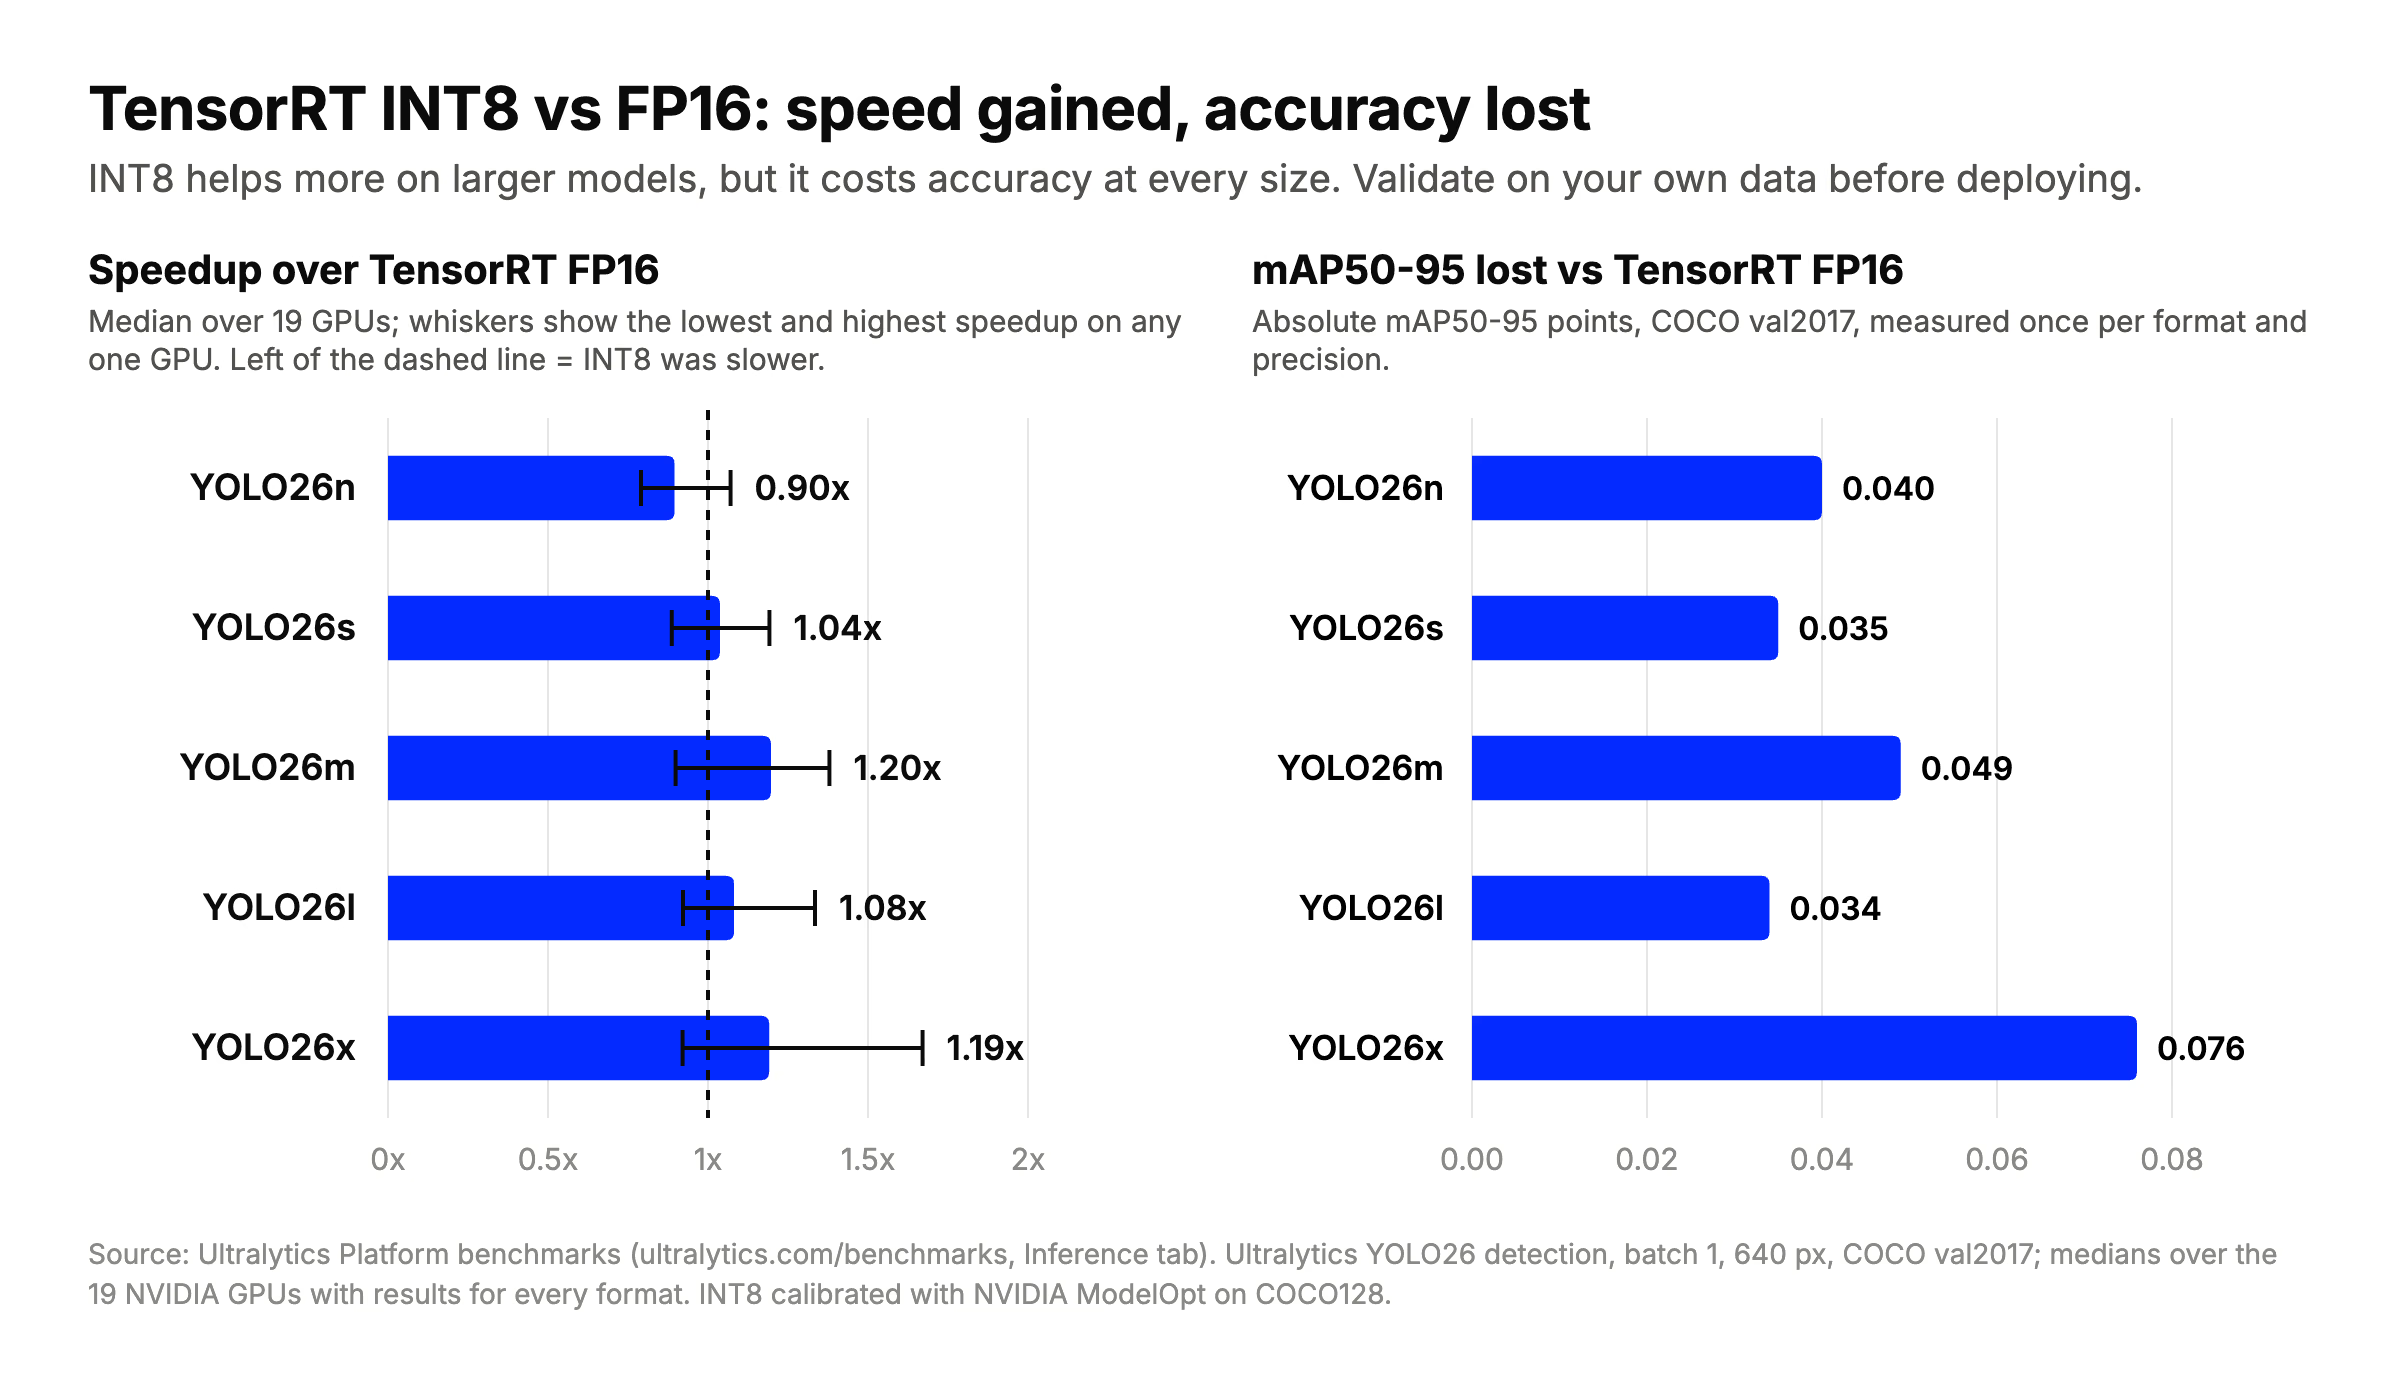
Медианное значение показывает, что INT8 был медленнее FP16 для YOLO26n и до примерно 1.2x быстрее для более крупных моделей на 19 GPU, при этом точность для всех размеров снижалась на 0.034–0.076 mAP50-95. Рассчитано по бенчмаркам инференса Ultralytics Platform.
Переносимость движков и динамические размеры входных данных#
По умолчанию движок TensorRT привязан к GPU, на котором он собран, и к версии TensorRT, использованной при сборке, поэтому движок, собранный на RTX 4090, не предназначен для переноса на H100 или Jetson. В TensorRT есть параметры совместимости оборудования и версий, которые ослабляют это ограничение, но надежнее всего собирать движок на целевом устройстве или для него и пересобирать после обновления TensorRT. По этой причине на вкладке Export Ultralytics Platform при экспорте в TensorRT предлагает выбрать тип GPU. Файл ONNX таких ограничений не имеет: один и тот же файл работает везде, где доступны ONNX Runtime и подходящий провайдер выполнения.
Оба формата поддерживают переменные размеры входных данных. Для TensorRT динамические формы требуют профиля оптимизации, задающего минимальные, оптимальные и максимальные размеры входных данных; во время выполнения входные данные должны укладываться в эти границы. При экспорте моделей Ultralytics YOLO параметр dynamic=True включает динамические формы входных данных для ONNX и TensorRT. Фиксированные формы дают TensorRT больше возможностей для оптимизации, как объясняется в руководстве NVIDIA по динамическим формам, поэтому используй динамические формы, только если размеры входных данных действительно меняются, и сравни результаты обоих вариантов.
Когда выбирать ONNX Runtime, а когда — TensorRT#
- GPU NVIDIA в облаке или локально, важна задержка: TensorRT, начиная с FP16. Попробуй INT8 на более крупных моделях после калибровки и проверки.
- NVIDIA Jetson на периферии: TensorRT. См. руководство по NVIDIA Jetson.
- CPU, оборудование не NVIDIA или смешанный парк устройств: ONNX с ONNX Runtime, используя провайдер выполнения, который поддерживает каждая машина.
- Ты еще не знаешь, на каком оборудовании будет развернута модель: сначала экспортируй ее в ONNX. Позже ты сможешь собрать движок TensorRT из той же модели.
- CPU, GPU или NPU Intel: рассмотри OpenVINO, инструментарий Intel для инференса.
Полный список форматов и их сравнение см. в руководстве по вариантам развертывания моделей. Точность — не единственный фактор: важны также размер модели и разрешение входных данных, а в нашем руководстве по прунингу и квантованию описаны еще два способа уменьшить модель.
Экспорт Ultralytics YOLO в ONNX и TensorRT#
Ultralytics YOLO экспортируется в оба формата с помощью одного аргумента format, а запускать предсказание или проверку можно непосредственно на экспортированной модели:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16 для ONNX Runtime
model.export(format="engine", quantize=16)  # Движок TensorRT FP16, собранный на этом GPU
# Чтобы использовать INT8, выполни калибровку с помощью YAML-файла набора данных (coco8.yaml — небольшой демонстрационный набор; используй собственный набор):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 выбирает FP16, а quantize=8 — INT8. При экспорте обоих движков создается yolo26n.engine, поэтому запускай только один из них. Для INT8 укажи в data YAML-файл собственного набора данных, чтобы при калибровке использовались изображения, похожие на те, с которыми ты будешь работать. Все параметры см. в аргументах экспорта и руководствах по интеграции с ONNX и TensorRT; также ознакомься с пошаговыми публикациями об экспорте в ONNX и оптимизации с помощью TensorRT. Ты также можешь экспортировать обученные модели в браузере на Ultralytics Platform.
Часто задаваемые вопросы
ONNX — это формат модели, а не движок, поэтому корректно сравнивать ONNX Runtime и TensorRT. В бенчмарках Ultralytics Platform для Ultralytics YOLO26 на 19 GPU NVIDIA TensorRT FP16 оказался быстрее опубликованных результатов ONNX FP16 в ONNX Runtime на всех GPU; рассчитанное медианное ускорение для моделей разных размеров составило от 1.85x до 2.55x, а разница в mAP50-95 не превышала 0.001. В бенчмарке не указано, какой провайдер выполнения ONNX Runtime использовался для получения результатов ONNX; ни один результат не помечен как полученный с провайдером выполнения TensorRT, поэтому, если тебе нужен API ONNX Runtime, проверь эту комбинацию самостоятельно.
Да. Обычно TensorRT получает на вход модель ONNX: его парсер ONNX считывает модель и создает на ее основе движок. ONNX Runtime также может вызывать TensorRT через провайдер выполнения TensorRT.
Нет. В бенчмарках Ultralytics Platform TensorRT INT8 для YOLO26n оказался медленнее TensorRT FP16 на 17 из 19 GPU. Для более крупных моделей он чаще был быстрее: медианное ускорение составляло около 1.2x для YOLO26m и YOLO26x на 19 GPU, где запускались все форматы. При этом точность каждый раз снижалась на 0.034–0.076 mAP50-95, поэтому сначала проверь модель INT8 на собственных данных.
Не рассчитывай на это. По умолчанию движок TensorRT привязан к GPU и версии TensorRT, использованным при его сборке, поэтому собирай его на целевом устройстве или для него. Сохрани файл ONNX как переносимую копию и пересобирай движок для каждого целевого устройства.
Обычно выбирают TensorRT: в NVIDIA JetPack входит TensorRT, а сборка движка на самом Jetson позволяет оптимизировать его для этого устройства. В приведенные выше бенчмарки Jetson не входит, поэтому прежде чем принять решение, проведи измерения на своем модуле. В руководстве по NVIDIA Jetson описаны настройка и экспорт Ultralytics YOLO.
Автор
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









