Qwen4-Max для автоаннотирования: выдающиеся результаты на отдельных наборах данных и неравномерный прирост
Qwen4-Max занимает 13-е место из 51 в нашем бенчмарке автоаннотирования, первое — на рентгеновских снимках запястья и второе — на изображениях торговых полок. Точность, стоимость и запуск.
 Miles Deans12 мин. чтения
Alibaba выпустила Qwen4-Max 16 ноября 2026 года, назвав его самой мощной на сегодняшний день моделью семейства Qwen с поддержкой обработки изображений и контекстным окном в один миллион токенов. В тот же день мы проверили модель на UL37 — нашем бенчмарке детекции на 36 наборах данных бенчмарке.
В целом Qwen4-Max занимает 13-е место среди 51 модели в нашем рейтинге VLM: 0,474 mAP50 при стоимости $5.68 за 1 000 изображений. Но среднее значение скрывает более впечатляющие результаты. На рентгеновских снимках детских запястий модель набрала больше всех моделей, которые мы тестировали, а на подводных сценах и плотно заставленных товарами торговых полках уступила только Gemini 4 Carbon.
Теперь Qwen4-Max доступен для автоаннотирования от Alibaba в Ultralytics Platform, заменив Qwen3.8-Max. Ниже рассказываем, в чём модель сильна, где уступает, как соотносится с моделями, которые ты мог бы рассматривать вместо неё, и сколько стоит разметка пакета изображений.
Qwen4-Max занимает 13-е место из 51 на UL37 и первое — на рентгеновских снимках запястья#
UL37 измеряет, насколько рамки модели совпадают с человеческой разметкой на 360 изображениях: по 10 изображений из каждого из 36 реальных наборов данных для детекции объектов — от медицинских снимков и аэрофотосъёмки до торговых полок, спорта и печатных плат. Все наборы данных имеют одинаковый вес при расчёте среднего значения. Каждое изображение проходит через тот же производственный конвейер, что и для пользователей Platform: используются имена классов из соответствующего набора данных, а SAM 3.1 уточняет каждую рамку. Поэтому результаты отражают работу всего конвейера с уточнением, а не исходные выходные данные модели. Методология доступна публично.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Место в рейтинге | #13 из 51 | #15 из 51 | #3 из 51 | #11 из 51 | #16 из 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Точность | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Полнота | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Стоимость провайдера на 1 000 изображений | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Медианное время на изображение | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Неудачные запросы | 0% | 1.7% | 0% | 0% | 6.4% |
Результаты UL37 из рейтинга VLM Ultralytics, обновлённые 19 ноября 2026 года. Qwen3.8-Max больше не предлагается в Platform.
Qwen4-Max превосходит Qwen3.8-Max по всем основным метрикам, стоит дешевле за изображение и успешно выполнил все запросы бенчмарка. Однако по среднему результату модель всё ещё значительно уступает лидерам: GPT-6.1 Terra набирает 0,560 за меньшую стоимость и менее чем за половину времени.
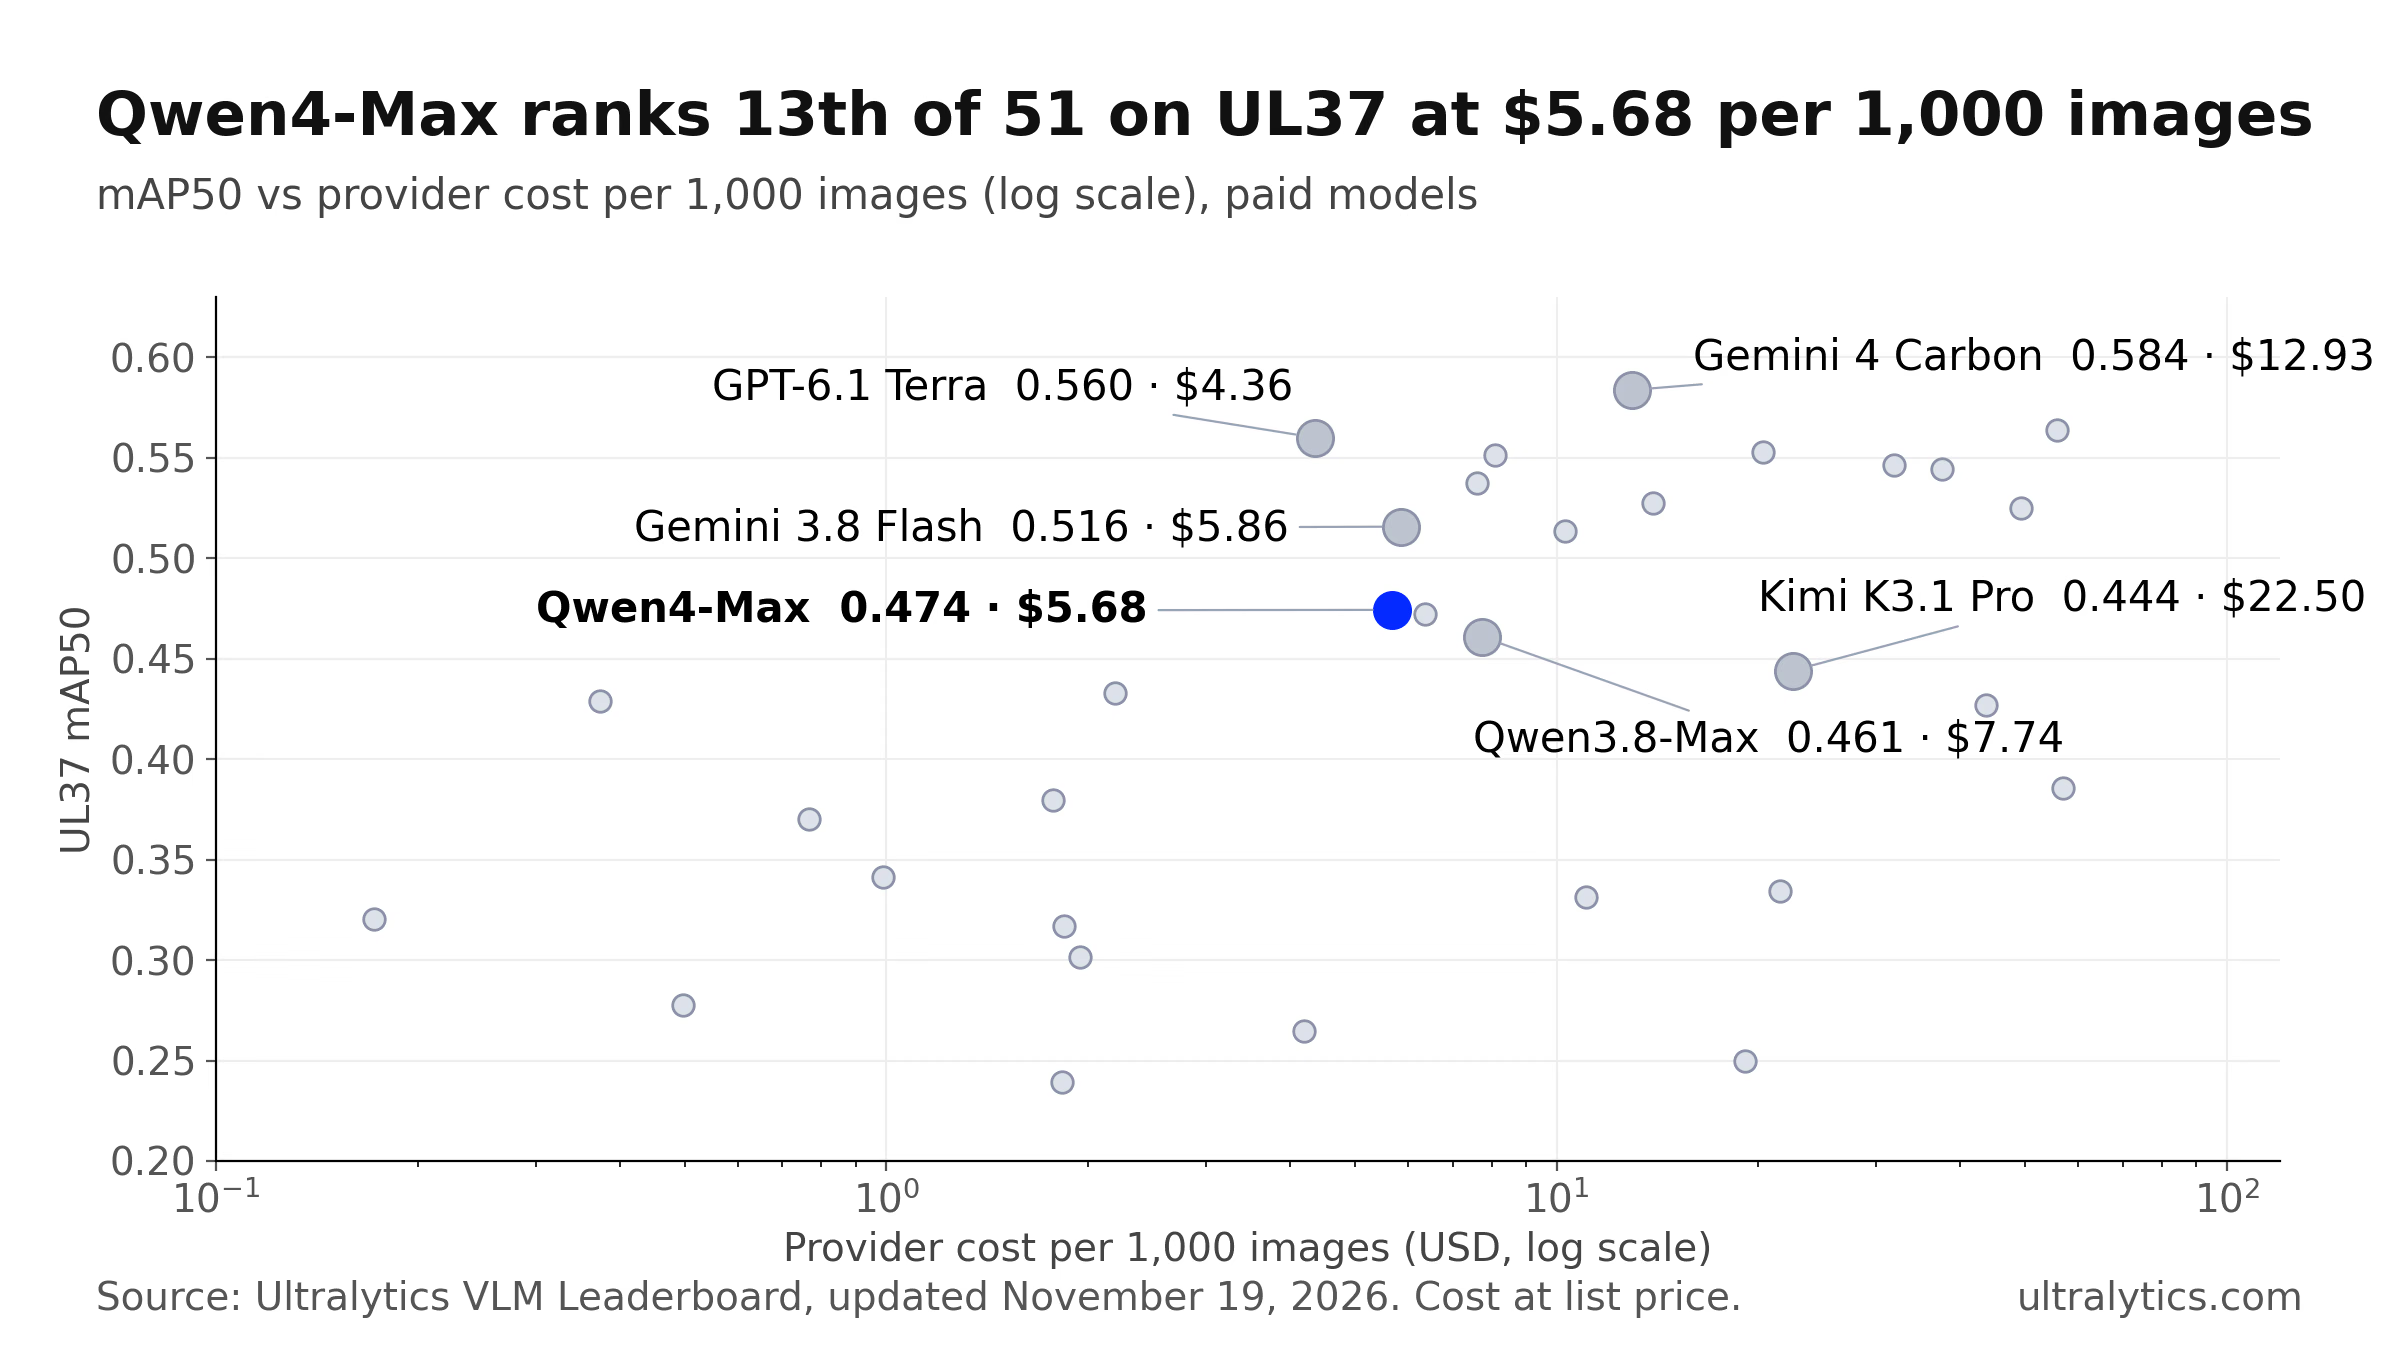
Каждая точка — платная модель из рейтинга VLM Ultralytics.
Для чего Alibaba создала Qwen4-Max#
В анонсе запуска Alibaba описывает Qwen4-Max как разреженную модель со смесью экспертов и 2,4 триллиона параметров в общей сложности, из которых 71 миллиард активен для каждого токена; модель также поддерживает обработку изображений. Среди её сильных сторон компания отмечает программирование, агентные задачи и визуальное рассуждение. По данным Alibaba, на собственном бенчмарке Work360 Qwen4-Max превосходит Qwen3.8-Max, одновременно снижая среднюю стоимость задачи примерно на 60%.
В примечаниях к выпуску Alibaba Cloud модель названа «флагманской мультимодальной моделью нового поколения семейства Qwen, объединяющей генерацию текста, понимание изображений и видео и глубокое рассуждение». Её международная цена составляет $1.50 за миллион входных токенов и $4.50 за миллион выходных — по сравнению с $2 и $6 у Qwen3.8-Max. Модель доступна через API Alibaba; компания сообщает, что позже выпустит модели Qwen4 с открытыми весами меньшего размера.
В анонсе и примечаниях к выпуску нет результатов по детекции объектов, поэтому мы измерили их сами.
Qwen4-Max и Qwen3.8-Max: дешевле, но улучшения неравномерны#
Qwen4-Max превосходит предшественника на 19 наборах данных, уступает на 16 и показывает равный результат на одном. Средний прирост в 0,013 mAP50 складывается из значительных улучшений на одних наборах данных, которые перевешивают заметное снижение результатов на других.
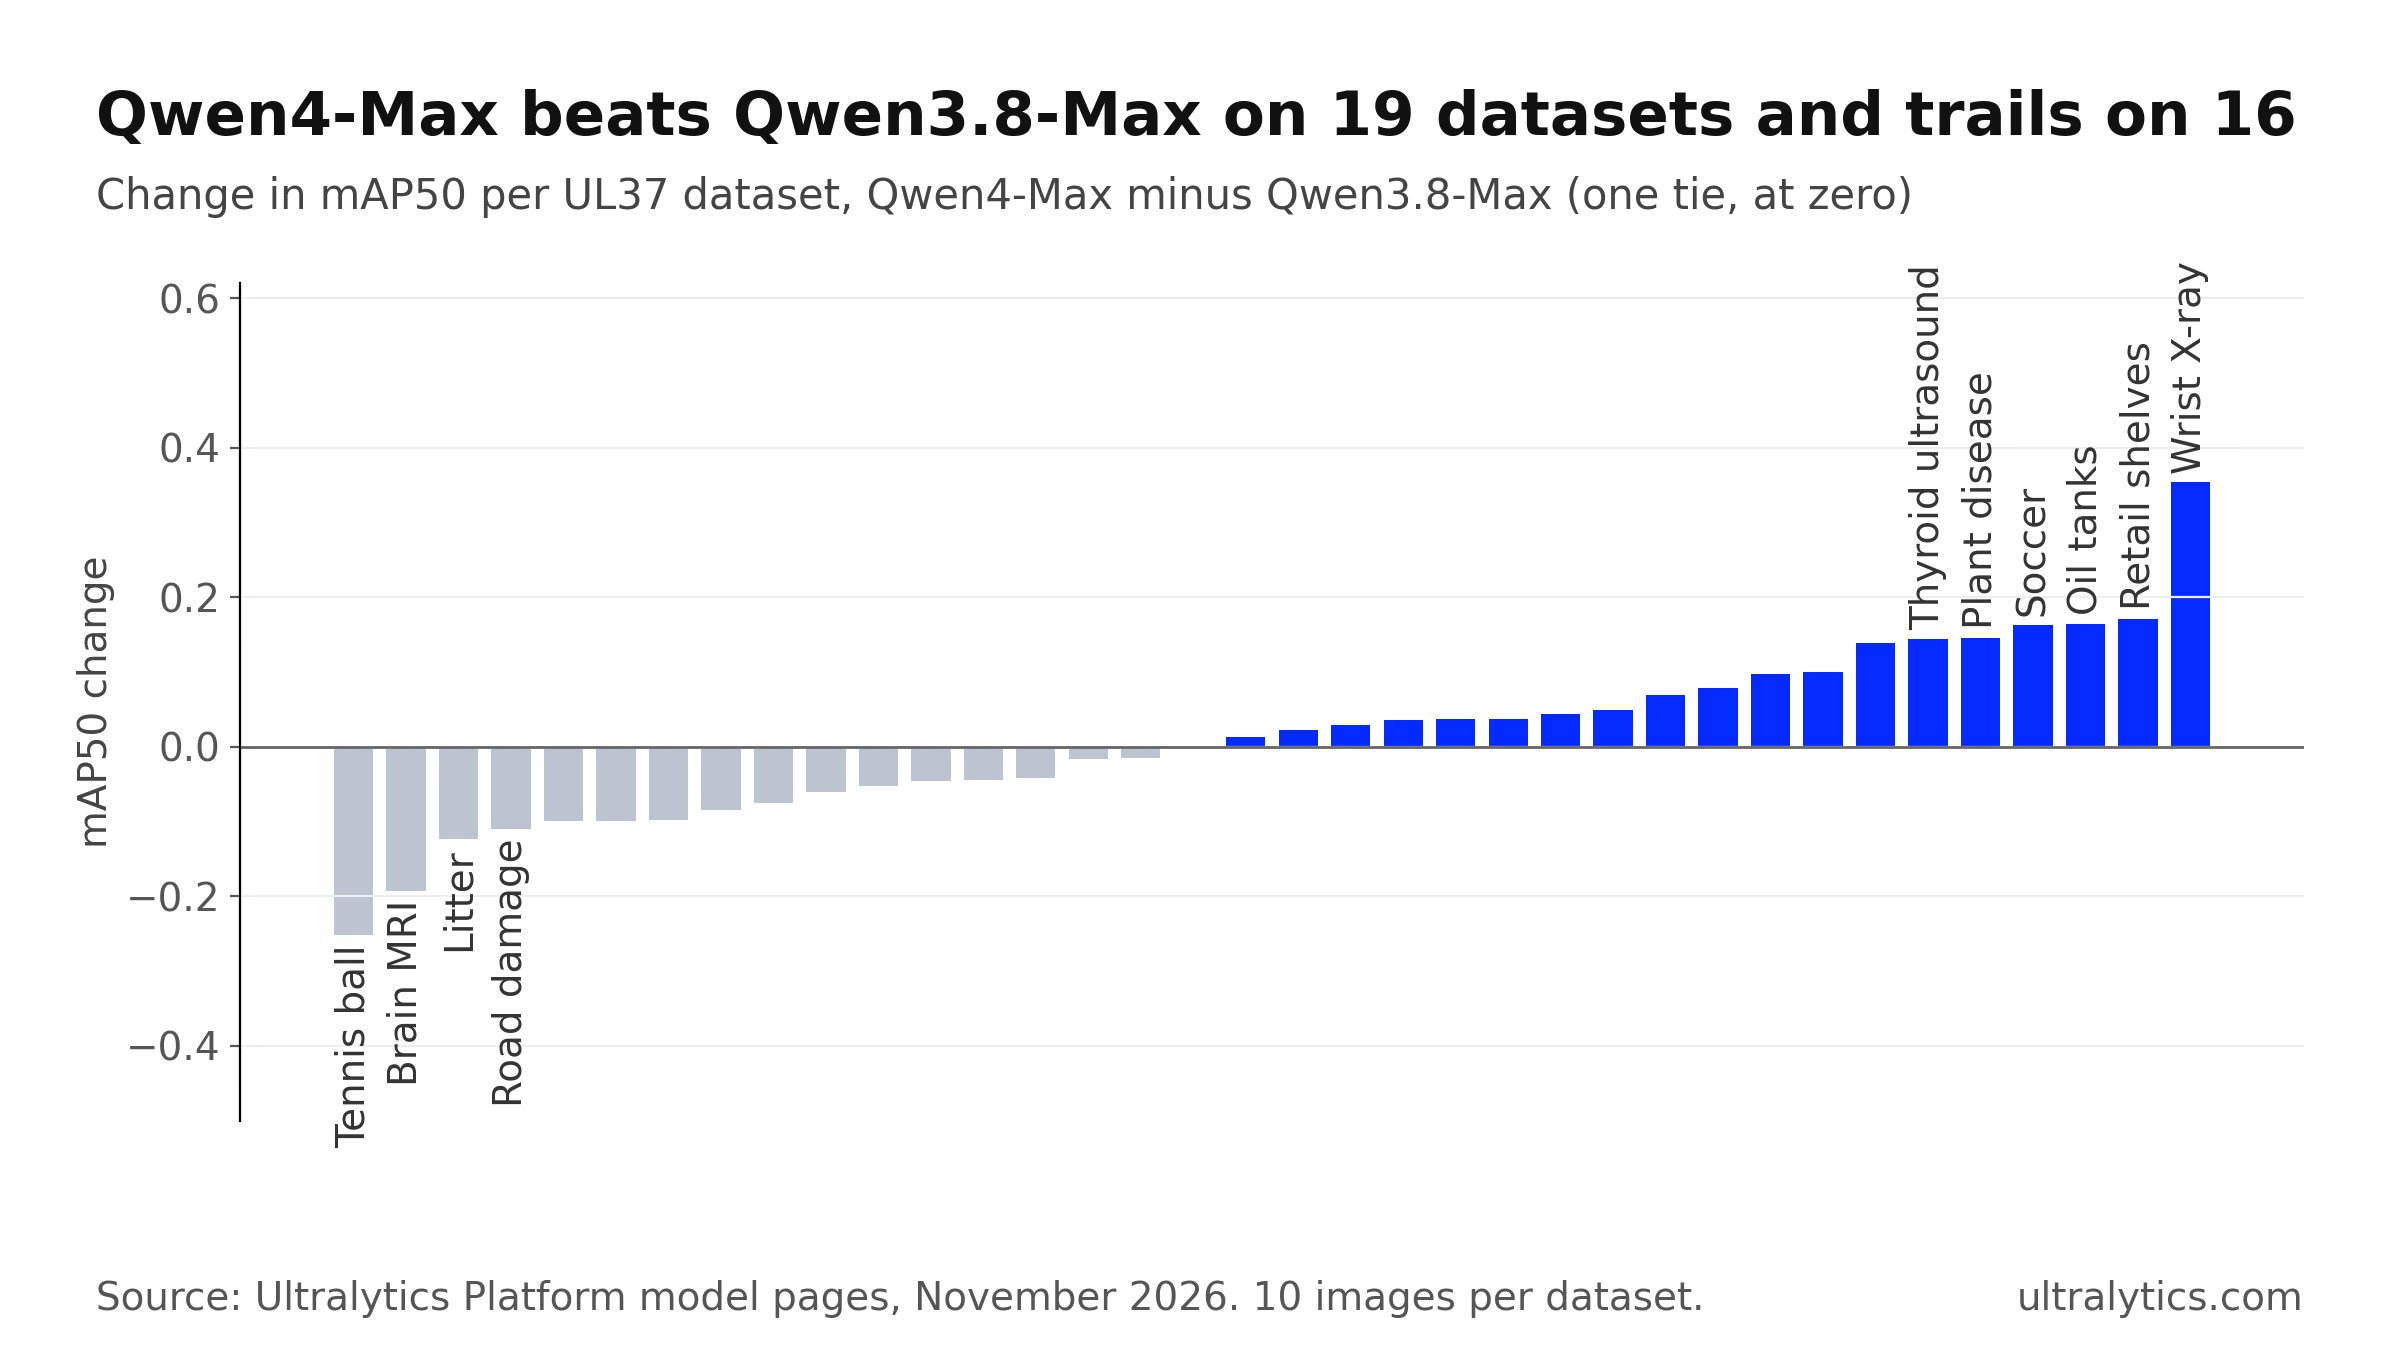
Каждый столбец соответствует одному набору данных UL37; столбцы отсортированы от наибольшего снижения к наибольшему приросту.
| Набор данных | Qwen4-Max | Qwen3.8-Max | Изменение |
|---|---|---|---|
| GRAZPEDWRI-DX рентгеновские снимки запястий детей | 0.4975 | 0.1437 | +0.3538 |
| SKU110K плотно заставленные торговые полки | 0.6230 | 0.4516 | +0.1714 |
| Airbus резервуары для хранения нефти | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB футбол | 0.8345 | 0.6715 | +0.1630 |
| RacketVision теннисные мячи | 0.3775 | 0.6299 | −0.2524 |
| Cheng МРТ опухоли мозга | 0.4421 | 0.6350 | −0.1929 |
mAP50 UL37 для каждого набора данных, по 10 изображений в каждом; значения приведены до четырёх знаков после запятой, чтобы изменение соответствовало разнице двух оценок.
Снижение стоимости заметнее. В нашем запуске Qwen4-Max стоил $5.68 за 1 000 изображений против $7.74 — примерно на 27% меньше за изображение. Собственная оценка Alibaba — около 60% — получена на другом бенчмарке и при других настройках, поэтому напрямую сравнивать эти показатели нельзя.
В чём Qwen4-Max особенно хорош#
Три результата выводят Qwen4-Max в число лидеров всего рейтинга, а не только семейства Qwen.
| Набор данных | Qwen4-Max | Место среди 51 модели | Лидер |
|---|---|---|---|
| GRAZPEDWRI-DX: рентгеновские снимки запястий детей | 0.4975 | 1st | Qwen4-Max (следом Muse Ember 1.0 с результатом 0,378) |
| RUOD подводные объекты | 0.774 | 2nd | Gemini 4 Carbon, 0,788 |
| SKU110K: плотно заставленные торговые полки | 0.623 | 2nd | Gemini 4 Carbon, 0,671 |
mAP50 UL37 по каждому набору данных. Место среди всех 51 модели рейтинга VLM Ultralytics.
Рентгеновские снимки запястья. На рентгеновских снимках детских запястий после травм Qwen4-Max набирает 0,4975 — больше всех протестированных нами моделей и более чем втрое больше Qwen3.8-Max. В каждом наборе данных всего 10 изображений, поэтому считай этот результат веским основанием для тестирования, а не окончательным выводом. Это также не диагноз и не клиническая валидация: для исследовательской разметки в анализе медицинских изображений Qwen4-Max может создать черновые рамки, которые клинические специалисты проверят и исправят.
Торговые полки. В среднем по двум наборам данных UL37 с торговыми полками Qwen4-Max набирает 0,752, опережая GPT-6.1 Terra с результатом 0,724. На SKU110K, где полки плотно заставлены товарами, относящимися к одному классу, модель уступает только Gemini 4 Carbon.
Подводные сцены. На подводных объектах из RUOD результат модели составляет 0,774 — второе место из 51, выше, чем 0,658 у GPT-6.1 Terra.
В чём Qwen4-Max уступает#
Слабые стороны не менее заметны, чем успехи. Qwen4-Max набирает 0,000 на DeepPCB для поиска дефектов на голых печатных платах и 0,05 на IEDXray для досмотра багажа, тогда как модели Gemini показывают около 0,30. Результат на рентгеновских снимках грудной клетки для выявления туберкулёза — 0,037, а на наборе данных с МРТ опухоли мозга модель уступает GPT-6.1 Terra: 0,442 против 0,904.
Если усреднить результаты по областям, Qwen4-Max также уступает GPT-6.1 Terra на документах, пользовательских интерфейсах и чертежах САПР (0,357 против 0,494), на дорогах и в дорожном движении (0,396 против 0,572) и в медицинской визуализации в целом (0,325 против 0,505). Прежде чем размечать большой набор данных в любой из этих областей, открой страницу модели Qwen4-Max: там записанные рамки модели воспроизводятся на каждом наборе данных бенчмарка рядом с эталонной разметкой.
Qwen4-Max и GPT-6.1 Terra, Gemini 3.8 Flash и Kimi K3.1 Pro#
| Сравнение на 36 наборах данных UL37 | Победы Qwen4-Max | Поражения | Ничьи |
|---|---|---|---|
| против GPT-6.1 Terra | 11 | 23 | 2 |
| против Gemini 3.8 Flash | 17 | 18 | 1 |
| против Kimi K3.1 Pro | 21 | 14 | 1 |
| против Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra — более сильный универсальный выбор: он побеждает на 23 наборах данных против 11 у Qwen4-Max, стоит дешевле, а медианное время ответа у него более чем вдвое меньше. Gemini 3.8 Flash почти не уступает на наборах данных при сопоставимой цене и показывает более высокий средний результат. В сравнении с Kimi K3.1 Pro Qwen4-Max побеждает на 21 наборе данных против 14, обходясь примерно вчетверо дешевле за изображение.
Как Ultralytics Platform запускает Qwen4-Max#
На результаты Qwen4-Max в Platform влияют две настройки. Во-первых, модель работает с «низким» уровнем рассуждения Alibaba вместо значения по умолчанию — «высокого». В тестировании Ultralytics на 370 изображениях бенчмарка (360 изображений, по которым рассчитывается оценка, и 10 эталонных изображений COCO) режим по умолчанию не уложился в установленный Platform лимит запроса в 115 секунд для 11 изображений, а режим «низкий» — для 3; при этом mAP50 не изменился. Во-вторых, Platform запрашивает у моделей Qwen компактный вывод в JSON, поскольку без него их mAP50 снижается примерно на 0,02.
Тебе не нужно ничего настраивать: выбери Qwen4-Max в списке моделей, и Platform применит обе настройки.
Сколько стоит пакет аннотаций Qwen4-Max#
Стоимость провайдера рассчитывается на основе заявленного Alibaba расхода токенов по тарифам модели в Platform за 1 000 успешно размеченных изображений; на твоих изображениях может расходоваться больше или меньше токенов. За пакетную разметку Platform взимает дополнительную плату за обработку — $1.00 за 1 000 изображений, минимум $0.01 за запуск.
| За 1 000 изображений | Qwen4-Max |
|---|---|
| Стоимость Alibaba | $5.68 |
| Плата за обработку в Ultralytics Platform | $1.00 |
| Итого | $6.68 |
Ты платишь Alibaba напрямую, используя собственный API-ключ, в том числе за тестовые предсказания, которые запускаешь в первую очередь; Ultralytics не добавляет наценку на токены. Если ты вообще не хочешь использовать платный ключ, размещённая в Platform модель Qwen3.8 27B работает без него и набирает на UL37 0,351 mAP50.
Как запустить автоаннотирование с Qwen4-Max в Ultralytics Platform#
Qwen4-Max — модель с подсказками по классам для наборов данных детекции с количеством классов от 1 до 200. Она возвращает ограничивающие рамки для имён классов из твоего набора данных, которые затем можно проверить и исправить.
- Создай API-ключ в Model Studio Alibaba Cloud для международного региона (Сингапур), чей адрес Platform использует как конечную точку.
- Попроси владельца рабочего пространства добавить ключ в разделе Alibaba на странице Настройки > API Keys рабочего пространства, где хранится твой набор данных. Подробности есть в документации по ключам провайдера.
- В редакторе аннотаций переключись в режим Smart и выбери Qwen4-Max в разделе Alibaba в списке моделей.
- Нажми Предсказать или
Pдля нескольких изображений, характерных для твоих данных. - Когда результат тебя устроит, открой страницу набора данных и выбери More actions > Batch Annotation, чтобы разметить все изображения без меток. Batch Annotation работает с наборами данных, размещёнными на Platform, если в них не больше трёх каналов изображения. Перед началом Platform сохраняет версию набора данных, поэтому ты сможешь откатить изменения.
- Проверь рамки, сохрани их и обучи модель Ultralytics YOLO26 на полученном наборе в том же рабочем пространстве.
В документации по разметке подробно описаны режим Smart и Batch Annotation, а наше руководство по выбору VLM с учётом точности и полноты поможет подобрать модель для твоего процесса проверки разметки.
Кому стоит использовать Qwen4-Max#
| Если тебе нужны… | Начни с |
|---|---|
| Универсальная платная модель для разметки | GPT-6.1 Terra: более высокий результат UL37, ниже стоимость и быстрее работа, чем у Qwen4-Max |
| Черновая разметка рентгеновских снимков детских запястий для проверки специалистами | Qwen4-Max: лучший результат UL37 среди 51 модели на этом наборе данных |
| Плотно заставленные торговые полки или подводные сцены | Qwen4-Max; сравни результат с Gemini 4 Carbon на своих изображениях |
| Модель Alibaba или переход с Qwen3.8-Max | Qwen4-Max: более высокие результаты, ниже стоимость за изображение, ни одного неудачного запроса в нашем запуске |
| Нет платного API-ключа | Размещённые в Platform Qwen3.8 27B, Gemma 4 26B или SAM 3.1 Text |
Для большинства задач разметки GPT-6.1 Terra по-прежнему остаётся лучшим выбором по умолчанию. Qwen4-Max стоит выбрать, если твои данные похожи на те, где модель показала лучшие результаты, поэтому сначала протестируй её на примере собственных изображений.
Часто задаваемые вопросы
Модель занимает 13-е место из 51 в нашем бенчмарке и показывает несколько выдающихся результатов. На бенчмарке UL37 её показатель составляет 0,474 mAP50; среди 51 модели она также занимает 13-е место и не допускает ошибок запросов. Qwen4-Max занимает первое место из 51 на рентгеновских снимках детских запястий и второе — на подводных объектах и плотно заставленных торговых полках, но плохо справляется с дефектами печатных плат и рентгеновскими снимками для досмотра.
В среднем — да. Qwen4-Max набирает 0,474 mAP50 против 0,461, стоит $5.68 против $7.74 за 1 000 изображений и успешно выполняет все запросы, тогда как Qwen3.8-Max не справилась с 1,7% запросов. Улучшения неравномерны: Qwen4-Max превосходит Qwen3.8-Max на 19 наборах данных и уступает на 16, заметно хуже справляясь с обнаружением теннисных мячей и анализом МРТ мозга.
Для разметки общего назначения GPT-6.1 Terra набирает 0.560 mAP50, превосходит Qwen4-Max на 23 из 36 наборов данных, стоит $4.36 за 1 000 изображений, а медианное время ответа составляет 5.1 секунды. Выбирай Qwen4-Max, если твои данные похожи на те наборы, где модель показывает лучшие результаты, например рентгеновские снимки запястий, плотно заполненные полки магазинов или подводные сцены, и проверяй результаты на собственных изображениях.
Модель может подготовить черновые рамки для исследовательской разметки, которые проверят специалисты; она не ставит диагнозы. Среди 51 модели она набирает наивысший балл UL37 на рентгеновских снимках запястий детей — 0.4975 mAP50, но её средний результат на восьми наших медицинских наборах данных составляет 0.325, что ниже 0.505 у GPT-6.1 Terra; на рентгеновских снимках грудной клетки модель показывает низкие результаты.
Около $5.68 по тарифам Alibaba: стоимость рассчитана на 1 000 успешно размеченных изображений по сообщённому Alibaba использованию токенов и тарифам Platform для этой модели. Международная цена Alibaba составляет $1.50 за миллион входных токенов и $4.50 за миллион выходных токенов. Ultralytics Platform дополнительно взимает плату $1.00 за пакетную разметку 1 000 изображений, поэтому общая стоимость составляет около $6.68.
Создай ключ API для международной версии Alibaba Cloud Model Studio, попроси владельца рабочей области добавить его в разделе Alibaba в Settings > API Keys, а затем выбери Qwen4-Max в режиме Smart в редакторе разметки. Проверь несколько изображений, запусти пакетную разметку, проверь рамки и обучи модель Ultralytics YOLO26 в той же рабочей области.
Автор
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









