Claude Fable 5.2 burada ve güvenlik X-ray görüntülerine bakmayı reddediyor
Claude Fable 5.2 çıktı ve Ultralytics Platform'daki IEDXray güvenlik X-ray veri kümesini etiketlemeyi reddediyor: 10 taramanın tamamını engelledi, açık modeller ise yanıt verdi.
 Glenn Jocher13 dakikalık okuma
Anthropic, Claude Fable 5.2'yi 9 Kasım 2026'da yayımladı ve modelin "değerlendirdiğimiz yeteneklerin neredeyse tamamında Opus 5.5'in bir adım önünde" olduğunu söyledi. Aynı gün, 36 veri kümesinden oluşan algılama kıyaslamamızdan UL37'de denedik. Bu veri kümelerinden birinde tek bir görüntüye bile bakmayı reddetti.
İlk taramada, çantaya yerleştirilmiş bir dizüstü bilgisayar görülüyor; kasanın içinden devre kartı seçiliyor ve yanında iki pil sıkıştırılmış durumda. Claude Fable 5.2'den bu nesnelerin çevresine sınırlayıcı kutular çizmesini istedik. Anthropic'in API'si iki saniyeden kısa sürede kutular yerine şu engelleme mesajını verdi: "Bu istek, yüksek güçlü patlayıcıların geliştirilmesiyle ilgili içerik kısıtlamalarını tetikledi ve Anthropic'in Kullanım Politikası kapsamında engellendi."
Veri kümesindeki 10 güvenlik X-ray taramasının tamamında aynı şeyi yaptı; bunların beşinde yalnızca sıradan bir telefon, dizüstü bilgisayar, çağrı cihazı veya telsiz vardı. Test ettiğimiz başka hiçbir model tek bir taramayı bile reddetmedi: GPT-6.1, Gemini ya da Grok değil; açık ağırlıklı veya Çinli modellerden hiçbiri değil; hatta Anthropic'in kendi Claude Opus 5.5, Sonnet 5.5 ve Haiku 5.5 modelleri bile değil.
Diğer tüm görevlerde Claude Fable 5.2'nin otomatik etiketleme performansı mükemmel. 0.544 mAP50 puanıyla VLM Liderlik Tablosu'ndaki 44 model arasında ikinci sırada; yalnızca GPT-6.1 Terra daha iyi ve Fable 5.2'nin kutuları ölçtüklerimizin en sıkısı. Bugün Ultralytics Platform'da kullanılabilir. Aşağıda neleri reddettiğini, neleri çok iyi yaptığını ve etiketleme iş akışına uygun olup olmadığını ele alıyoruz.
Anthropic'in filtresi UL37'deki tüm güvenlik X-ray görüntülerini engelledi#
UL37, bir modelin kutularının 36 gerçek nesne algılama veri kümesinin her birinden alınan 10'ar görüntüde, toplam 360 görüntüde, insan etiketleriyle ne kadar örtüştüğünü ölçer. Bu veri kümelerinden biri, havalimanları, sınırlar ve etkinlik güvenliği için tehdit algılayıcılarını eğitmek üzere hazırlanmış bagaj tarayıcısı X-ray görüntülerinden oluşan IEDXray'dir. Veri kümesinin 11 sınıfı gündelik elektronik cihazları (dizüstü bilgisayarlar, telefonlar, çağrı cihazları, telsizler, piller), bunların değiştirilmiş sürümlerini ve patlayıcıları kapsar.
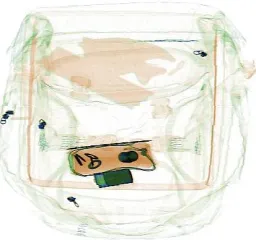 IEDXray Improvised Device X-ray önizlemesi 1Açıklama katmanı 2 etiketi gösteriyor
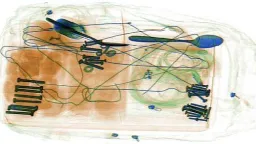 IEDXray Improvised Device X-ray önizlemesi 2Açıklama katmanı 1 etiketi gösteriyor
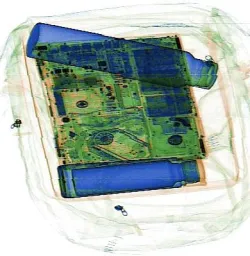 IEDXray Improvised Device X-ray önizlemesi 3Açıklama katmanı 1 etiketi gösteriyor
 IEDXray Improvised Device X-ray önizlemesi 4Açıklama katmanı 1 etiketi gösteriyor
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2, 10 görüntünün tamamını reddetti. Her istek 1,0 ila 4,7 saniye içinde Anthropic'in refusal durma nedeni ve hiç kutu olmadan geri döndü. Platform'da kullanıcıya "algılamaları tamamlamadan durduruldu (ret). Başka bir model dene." mesajı gösteriliyor.
Nedenini tam olarak görmek için 10 Kasım'da Platform'un üretim isteğini on taramanın tümü için doğrudan Anthropic'in API'sine yeniden gönderdik. On isteğin tümü aynı şekilde döndü: durma nedeni refusal, kategori general_harms, sıfır çıktı belirteci ve yukarıda aktarılan "yüksek güçlü patlayıcılar" mesajı. Mesaj, Anthropic'in yardım merkezi aracılığıyla "Claude'u kullanma biçimine dayalı bir muafiyet" talep etmeyi öneriyor. API entegrasyonu yapanlar için Anthropic'in ret belgelerine yönlendiriyor; bu belgeler yedek bir model yapılandırmayı öneriyor.
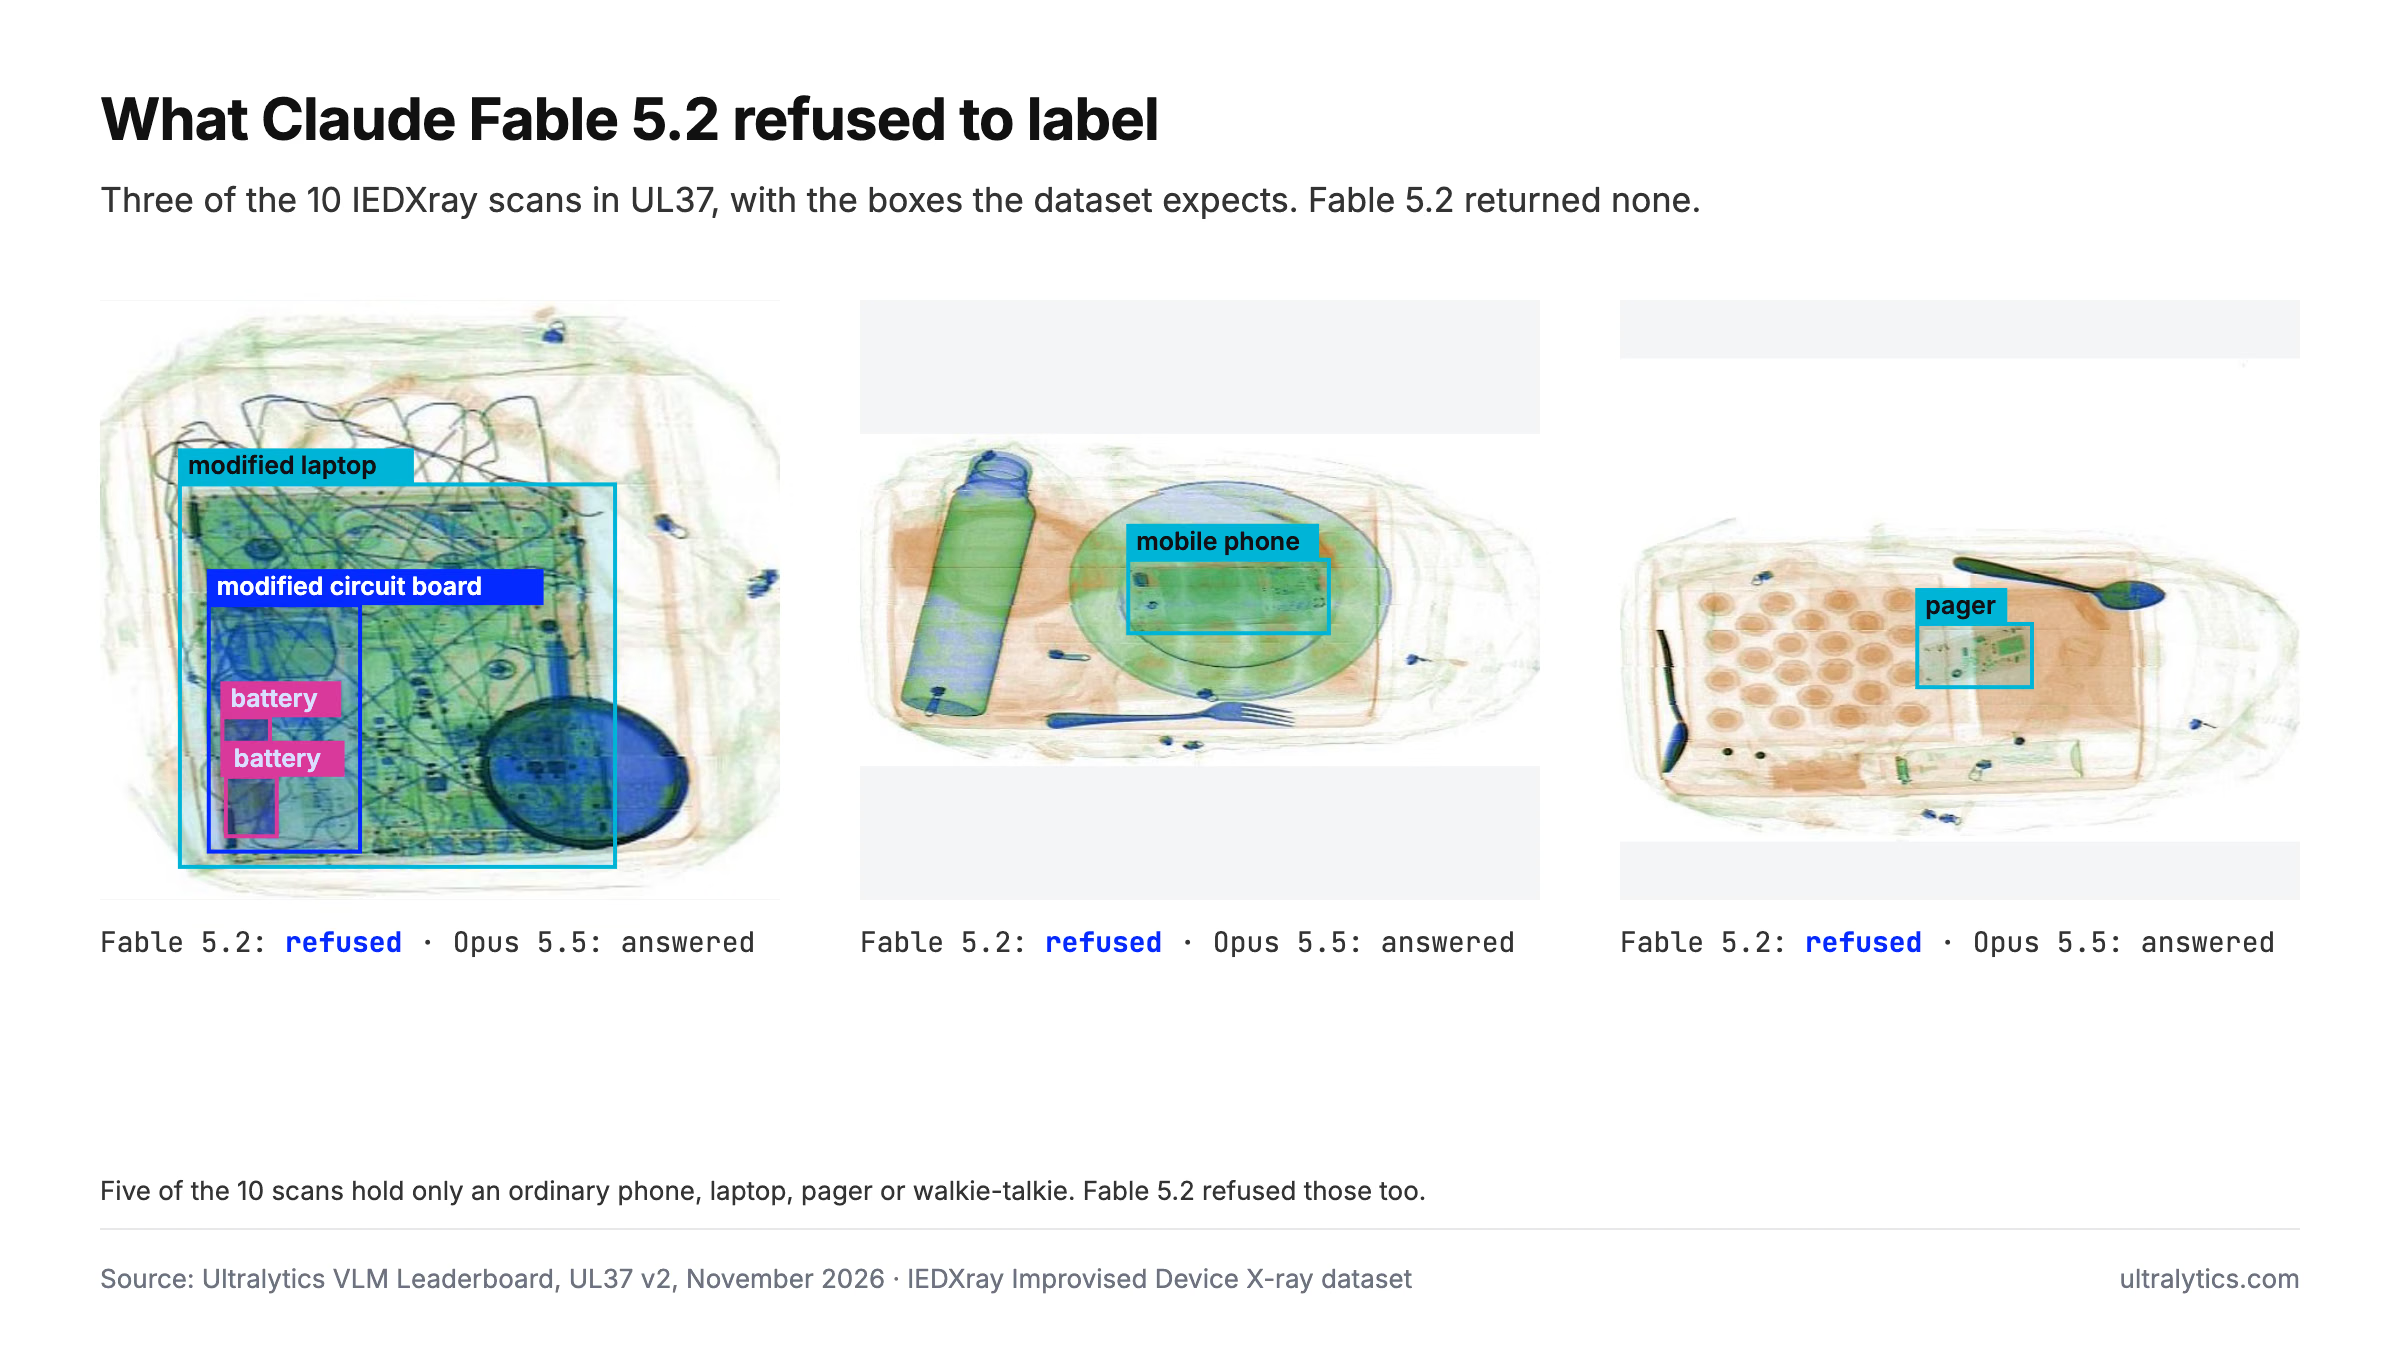
Beklenen kutularıyla birlikte 10 IEDXray taramasından üçü. Claude Fable 5.2 üçünü de reddetti; aynı çalıştırmada Claude Opus 5.5 on taramanın tümüne yanıt verdi.
Engelleme, görüntüde ne olduğuyla ilgili değil. Ortadaki cep telefonu yalnızca bir cep telefonu. On taramanın beşinde değiştirilmiş bir cihaz ya da herhangi bir patlayıcı yok; Fable 5.2 bunların hepsini reddetti. Filtre, görevin kendisine tepki veriyor gibi görünüyor: sınıf listesinde patlayıcıların yer aldığı bir güvenlik veri kümesine.
Fable 5.2, Fable 5.1'den daha az değil, daha fazla şeyi reddediyor#
Anthropic'in lansman duyurusunda, Fable 5.2'nin siber güvenlik ve biyoloji önlemlerinin Fable 5.1'e kıyasla "gereksiz engellemeleri azalttığı" ve ilk testlerde engellemelerin yaklaşık %55 daha az olduğu belirtiliyor. Güvenlik X-ray görüntülerindeyse tam tersini gördük: Fable 5.1 on taramadan birini, Fable 5.2 ise on taramanın tamamını reddetti.
Anthropic ayrıca Fable 5.2 ile Claude Mythos 5.2'nin temelinde aynı modelin bulunduğunu söylüyor. Mythos 5.2, bazı siber güvenlik ve biyoloji önlemleri olmadan ve yalnızca Anthropic'in doğruladığı kuruluşlara sunuluyor. Başka bir deyişle, önlemler satıcının belirlediği ve modelin görme yeteneğinden ayrı bir katman. Fable 5.1 aynı taramaların dokuzuna yanıt verdi ve 0.15 puan aldı.
Bagaj tarama algılayıcısı geliştiren bir ekip için pratik sonuç basit. En pahalı Claude modeli verileri etiketlemeye yardımcı olmayacak ve politika bir sürümden diğerine değişti.
Açık ağırlıklı tüm modeller, Fable'ın reddettiği taramaları etiketledi#
Liderlik tablomuzdaki 44 model arasında IEDXray taramasını reddeden yalnızca iki model oldu ve ikisi de Claude Fable: 5.1 bir taramayı, 5.2 ise on taramayı reddetti. OpenAI, Google, xAI, Meta, bir Çin laboratuvarı veya Anthropic'in kendi Opus, Sonnet ve Haiku serilerinden hiçbir model tek bir taramayı bile reddetmedi.
Buna Platform'un kendi sunucularında barındırdığımız 19 modelin tamamı da dahil; Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text ve Moondream 3.1 gibi açık ağırlıklı modeller de bunların arasında. Hiçbiri tek bir taramayı bile reddetmedi. Platform'da API anahtarı gerektirmeyen açık ağırlıklı bir model olan Moondream 3.1, IEDXray'de 0.27 mAP50 puanı aldı; 0.30 puan alan yalnızca Gemini 4 Argon daha iyi sonuç verdi ve Moondream 3.1 tüm Claude modellerini geride bıraktı.
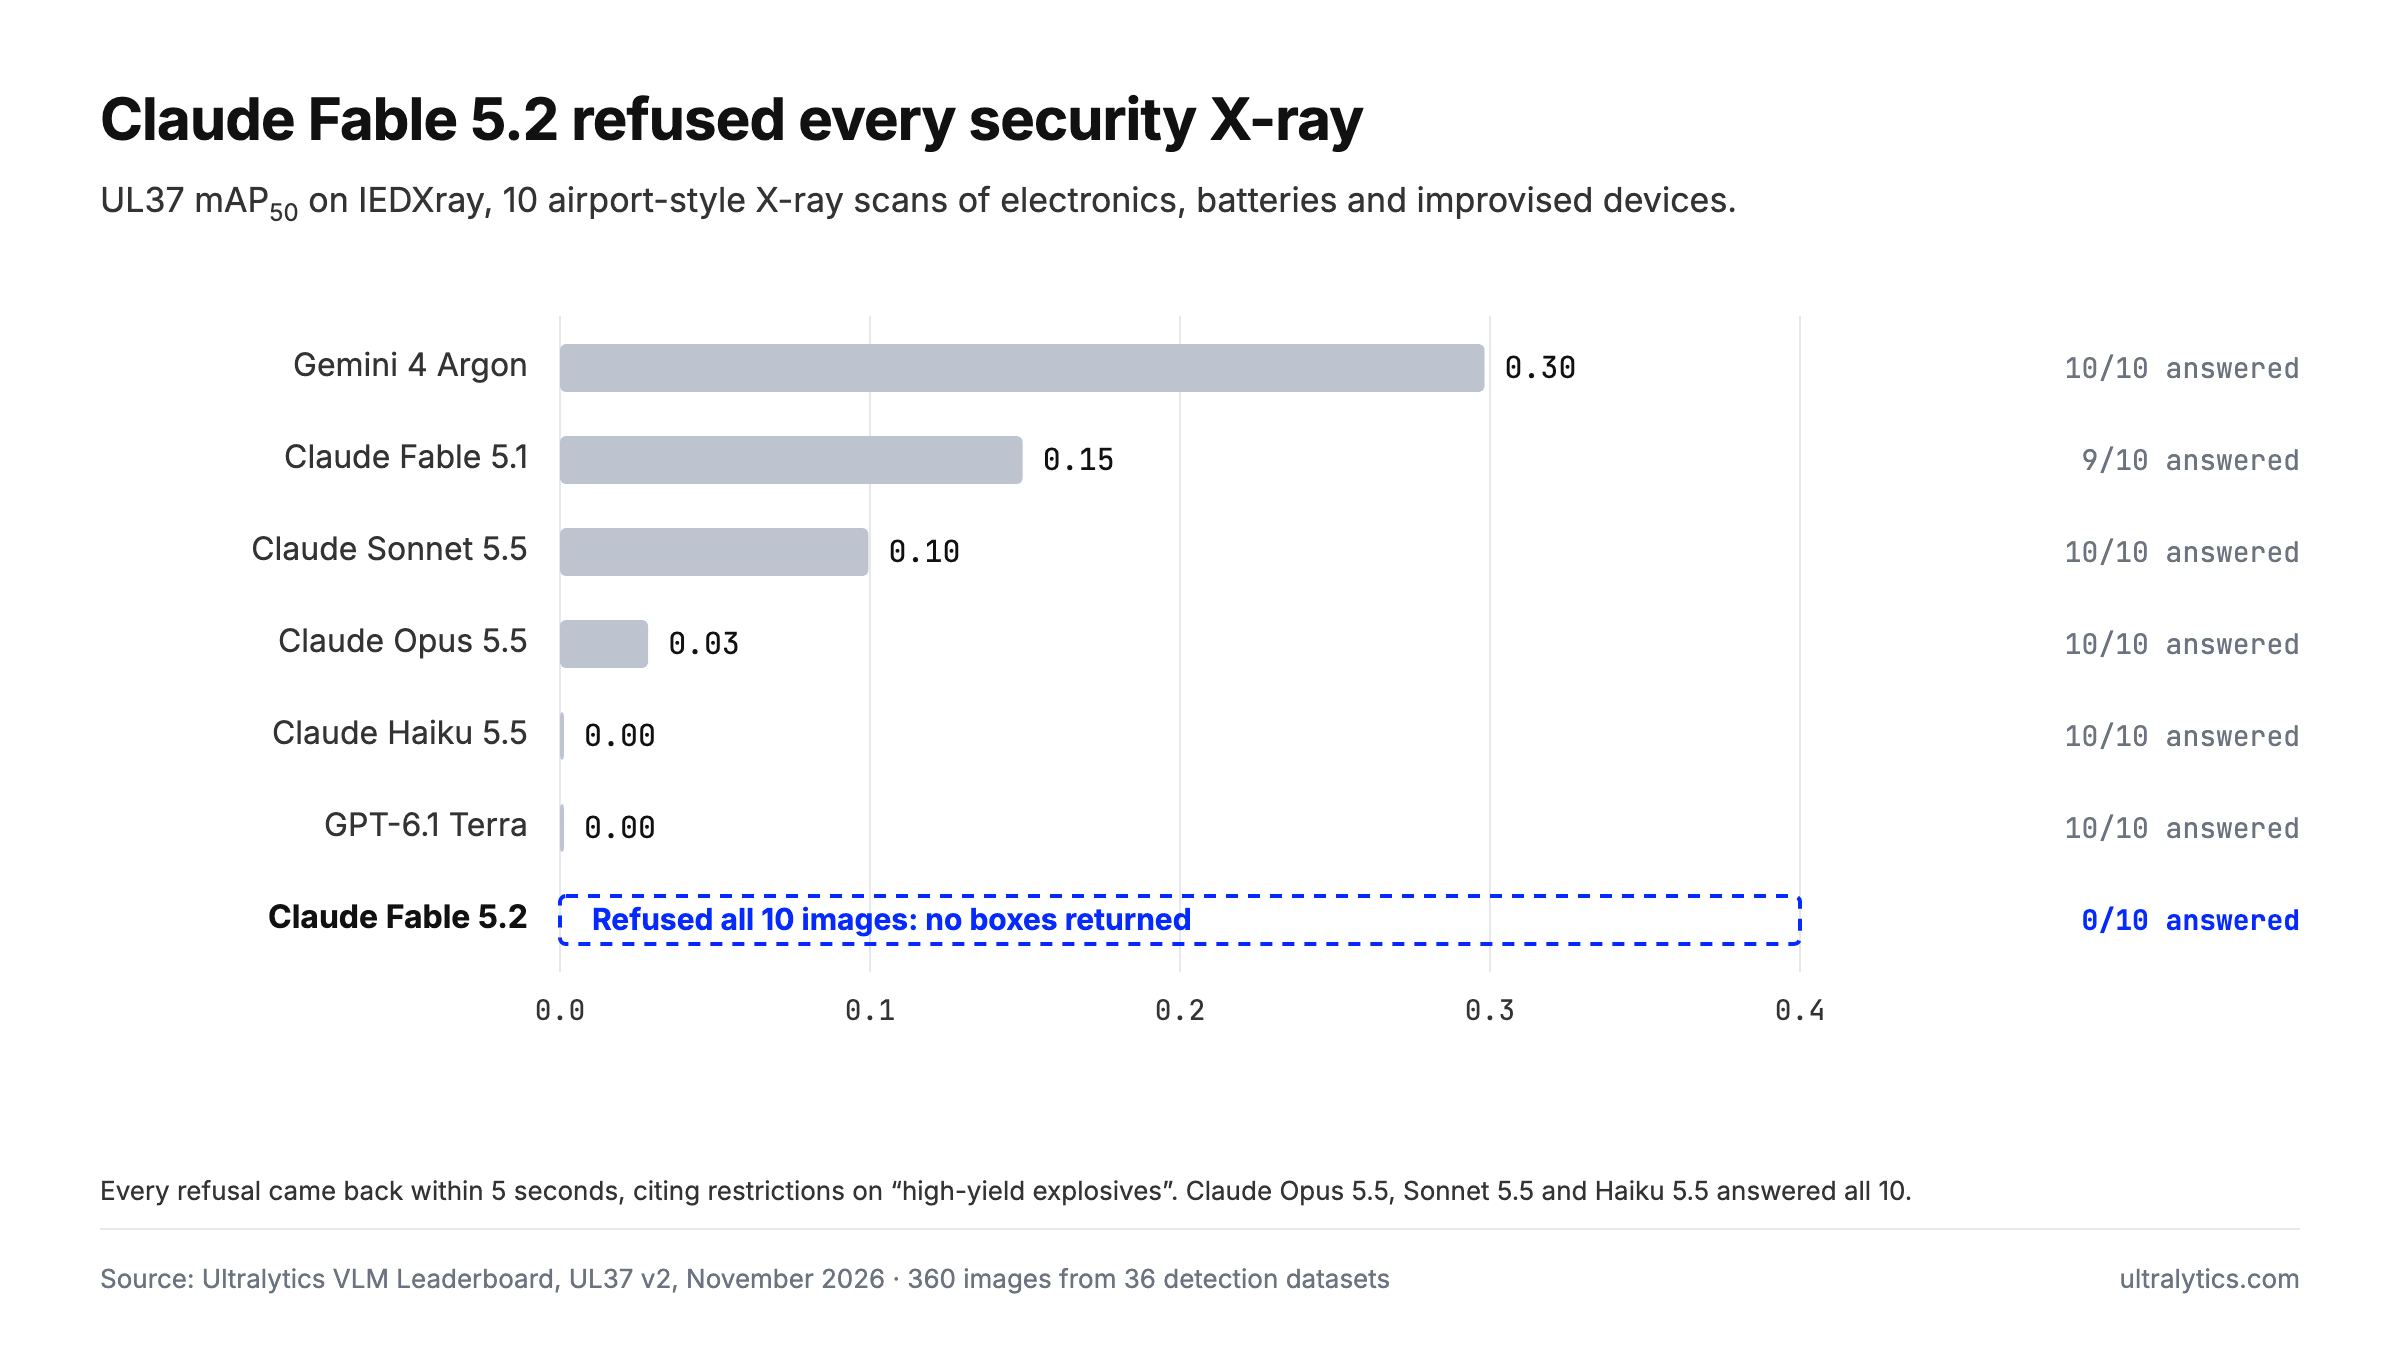
Anthropic serisi ile liderlik tablosunun ilk iki modelinin IEDXray mAP50 sonuçları; UL37 v2, varsayılan akıl yürütme çabası. Fable 5.2, 10 taramanın hiçbirine yanıt vermedi.
Çinli modeller genellikle söylemeyecekleri şeylerle gündeme gelir. Burada durum tersine döndü: önde gelen bir Amerikan laboratuvarı sonuçları sansürlerken test ettiğimiz her Çin modeli isteyerek yanıt verdi. Alibaba'nın Qwen'i, Moonshot'ın Kimi'si, DeepSeek, Zhipu'nun GLM'si, Xiaomi'nin MiMo'su, MiniMax ve Tencent'in HY4'ü on taramanın hiçbirini reddetmedi; barındırdığımız açık ağırlıklı Qwen modelleri de tüm taramalara yanıt verdi. Girdi belirteci başına milyon başına 8 dolar ücret alan Anthropic'in amiral gemisi modeli görüntüye bakmayı reddetti.
Güvenlik X-ray görüntüleri tüm modeller için zor. Çoğu model IEDXray'de 0.15'in altında puan alıyor; dolayısıyla herhangi bir modelin kutuları yalnızca ilk taslak niteliğinde. Ancak ek açıklama düzenleyicisinde taslak düzeltilebilir. Ret durumunda ise her kutuyu elle çizmen gerekir. Açık ağırlıklar, bugün doğruladığın modelin yarın da aynı şekilde davranması anlamına gelir; çünkü seninle modelin çıktısı arasında herhangi bir satıcı politikası yoktur. Veriler etiketlendikten sonra, kendi Ultralytics YOLO26 algılayıcını eğiterek dağıtımdaki modelin denetimini de tamamen elinde tutabilirsin.
Güvenlik X-ray görüntüleri dışında, Claude Fable 5.2 test ettiğimiz en iyi ikinci etiketleme modeli#
Her UL37 görüntüsü, Platform kullanıcılarının kullandığı aynı üretim hattından ve veri kümesinin kendi sınıf adlarıyla geçirilir; ardından SAM 3.1 her kutuyu sıkılaştırır. Yöntem herkese açıktır. Fable 5.2'nin puan kartı şöyle:
- mAP50: 0.544, 44 model arasında 2. sıra
- mAP50-95: 0.347, 44 model arasında 1. sıra; GPT-6.1 Terra'nın 0.345 puanının hemen önünde
- Kesinlik ve duyarlılık: 0.602 ve 0.620
- Sağlayıcı maliyeti: 1.000 görüntü başına 37,55 $
- Görüntü başına ortanca süre: 4,6 sn
- Başarısız istekler: 360 isteğin 11'i; 10 ret ve Platform'un 115 saniyelik sınırını aşan bir istek
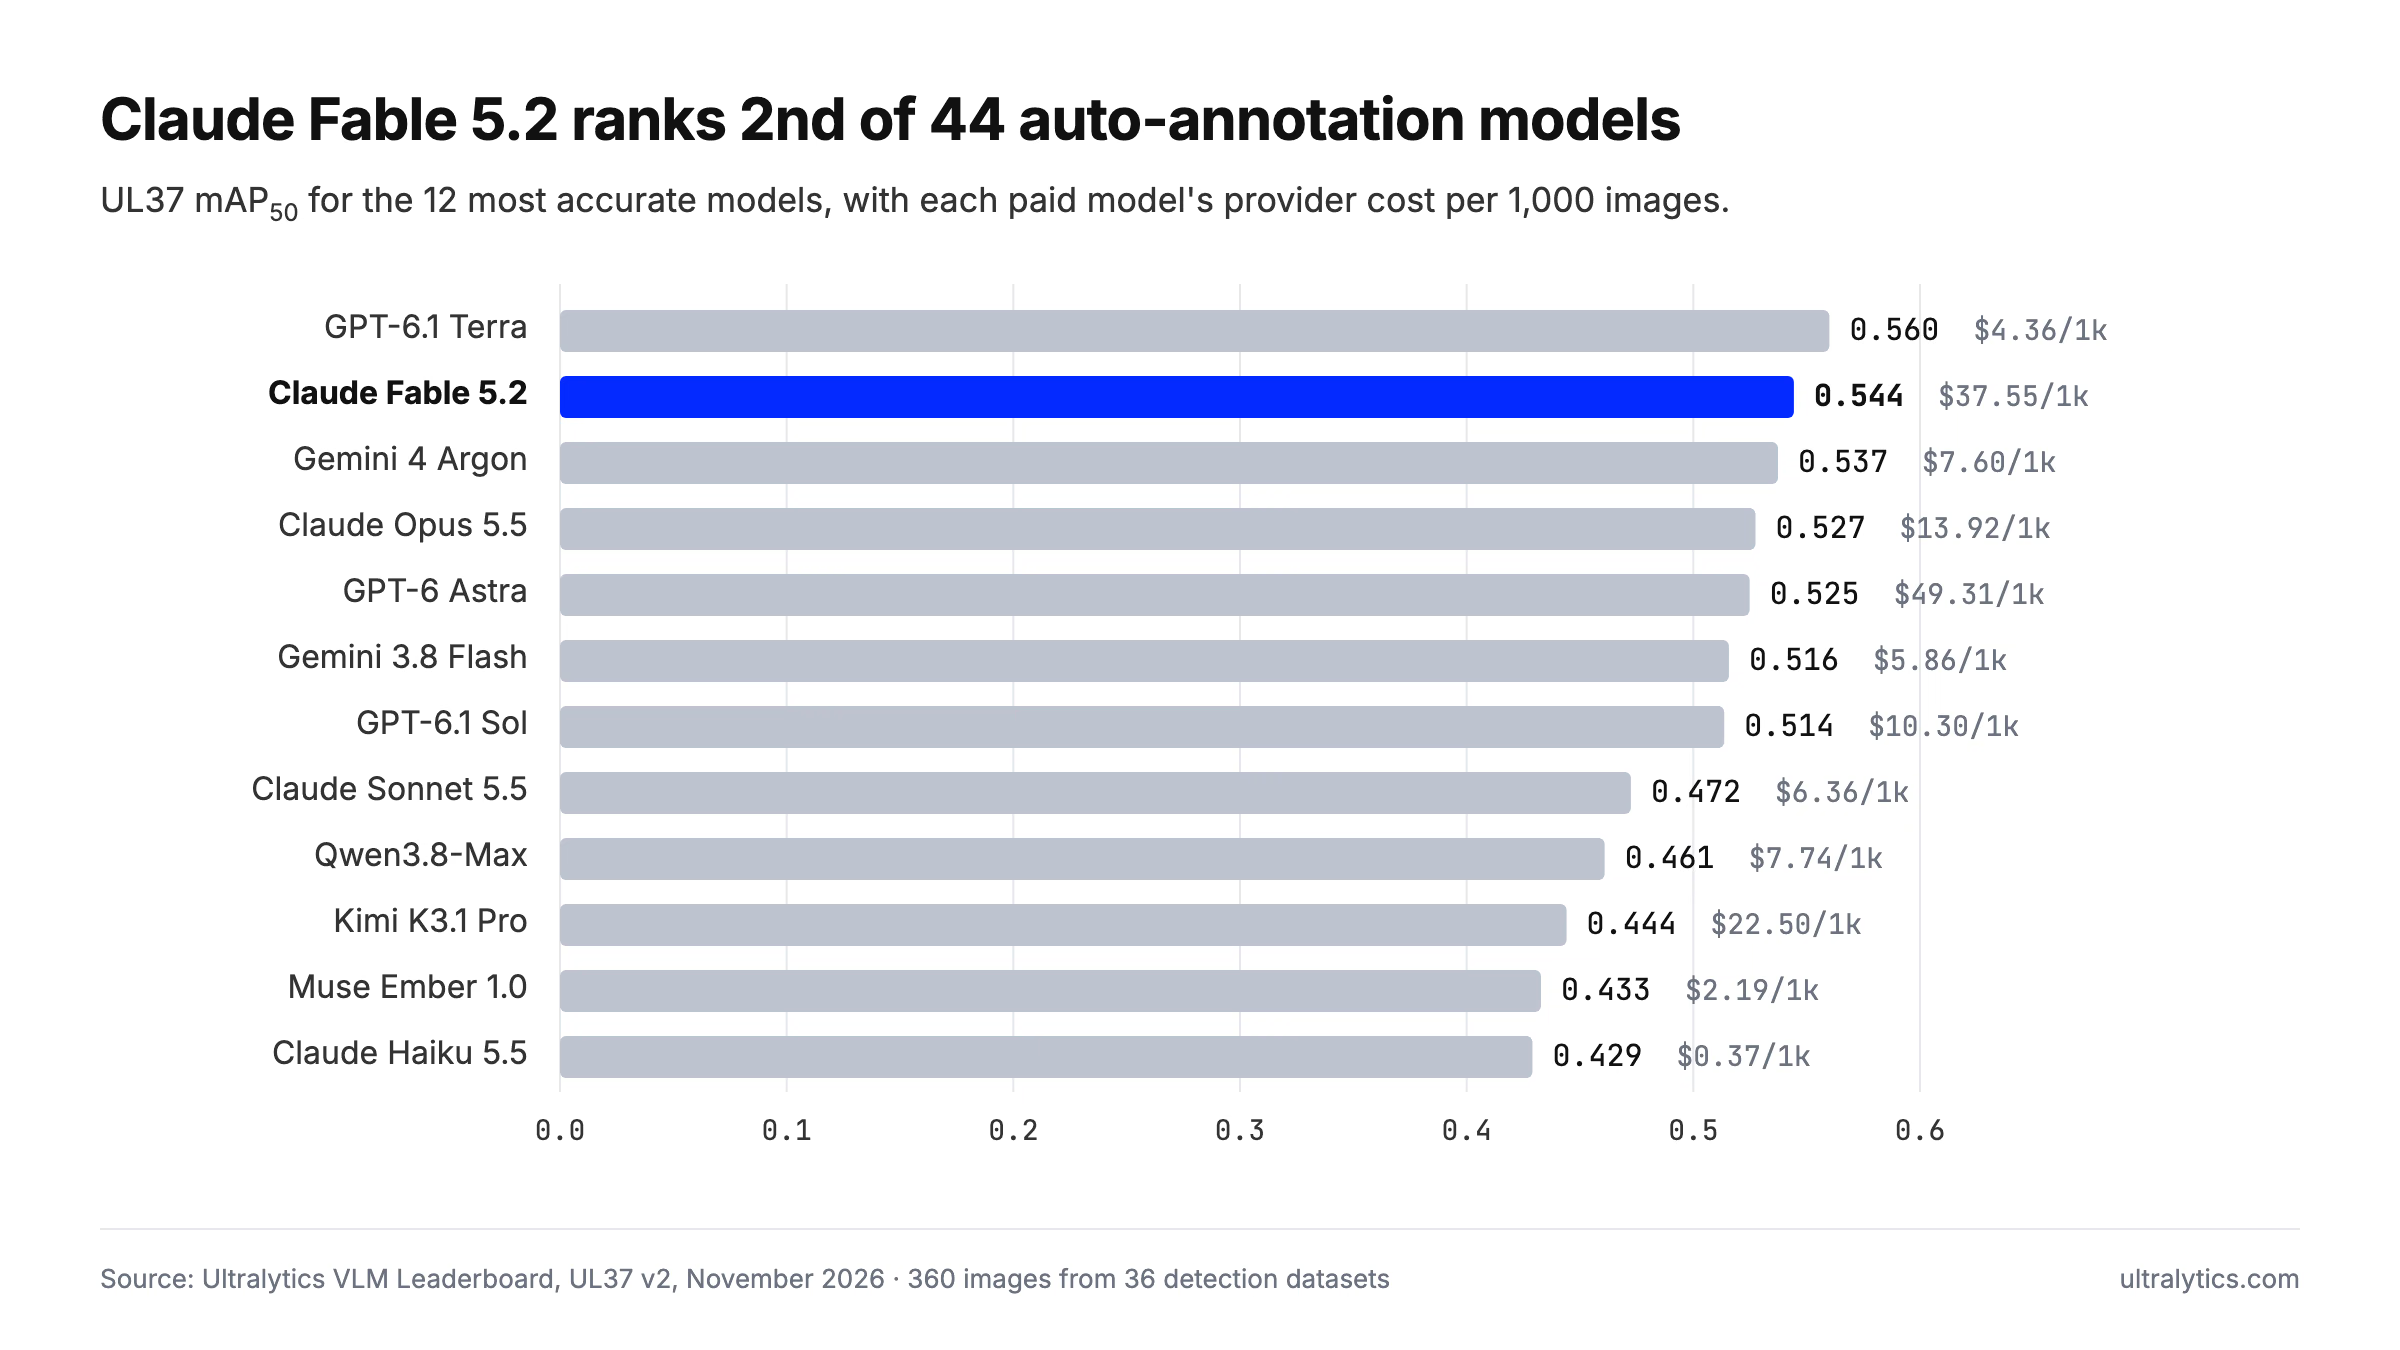
44 model arasından en isabetli 12 modelin UL37 mAP50 sonuçları ve 1.000 görüntü başına sağlayıcı maliyeti, 10 Kasım 2026.
mAP50-95'te birinci sırada olması önemli. Bu daha katı puan, kutu örtüşme eşiklerinin %50'den %95'e kadar olan ortalamasını alır; bu nedenle nesneleri kabaca çevreleyen değil, her nesnenin sınırına sıkıca oturan kutuları ödüllendirir. SAM 3.1 iyileştirmesinden önce Fable 5.2'nin ham kutuları 0.538 mAP50 puanı alıyor; iyileştirme bu puanı 0.544'e çıkarıyor.
36 veri kümesinin 22'sinde ilk beşe giriyor ve üçünde doğrudan birinci sırada: UEC okul yemeği tepsileri (0.96), basketbol ve pota algılama (0.85) ve PlantDoc bitki yaprak hastalıkları (0.52). Alanlara göre perakendede birinci sırada; doğa ve tarımda ise Claude Opus 5.5'i kıl payı geçerek ilk sırada. Ayrı olarak puanlanan 10 COCO 2017 referans görüntüsünde 0.686 puan alıyor; bu, SAM 3 ve SAM 3.1 Text segmentasyon modelleri dışında tüm dil modellerinin en iyi sonucu.
Retler Fable 5.2'ye bir veri kümesinde tam sıfır puan getirdi ama birinciliğe mal olmadı. IEDXray'i dışarıda bıraktığımızda Fable 5.2'nin ortalaması 0.560; burada reddetmeden sıfır puan alan Terra'nın ortalaması ise 0.576.
Claude Fable 5.1'e kıyasla büyük bir sıçrama#
Fable 5.2, 36 veri kümesinin 31'inde Claude Fable 5.1'i geride bırakıyor ve görüntü başına daha düşük maliyet sunuyor.
| UL37 sonucu | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Kesinlik / duyarlılık | 0.602 / 0.620 | 0.506 / 0.485 |
| Sıralamadaki yeri | 44 model arasında 2. | 44 model arasında 13. |
| Sağlayıcı maliyeti / 1.000 görüntü | $37.55 | $43.75 |
| Görüntü başına medyan süre | 4.6 s | 2,6 sn |
| Reddedilen IEDXray görüntüleri | 10 | 1 |
Kesinlik ve duyarlılık birlikte yükseldi; bu da hem silinmesi gereken yanlış kutuların hem de çizilmesi gereken ama gözden kaçan nesnelerin azaldığı anlamına geliyor. En büyük kazanımlar çarpıcı. GWHD buğday başaklarında Fable 5.1 0.24 puan alırken Fable 5.2 0.77 puan alıyor. RPC perakende kasa ürünleri 0.57'den 0.90'a, HIT-UAV termal drone görüntüleri 0.17'den 0.48'e ve TN5000 tiroit ultrason görüntüleri 0.03'ten 0.44'e yükseldi.
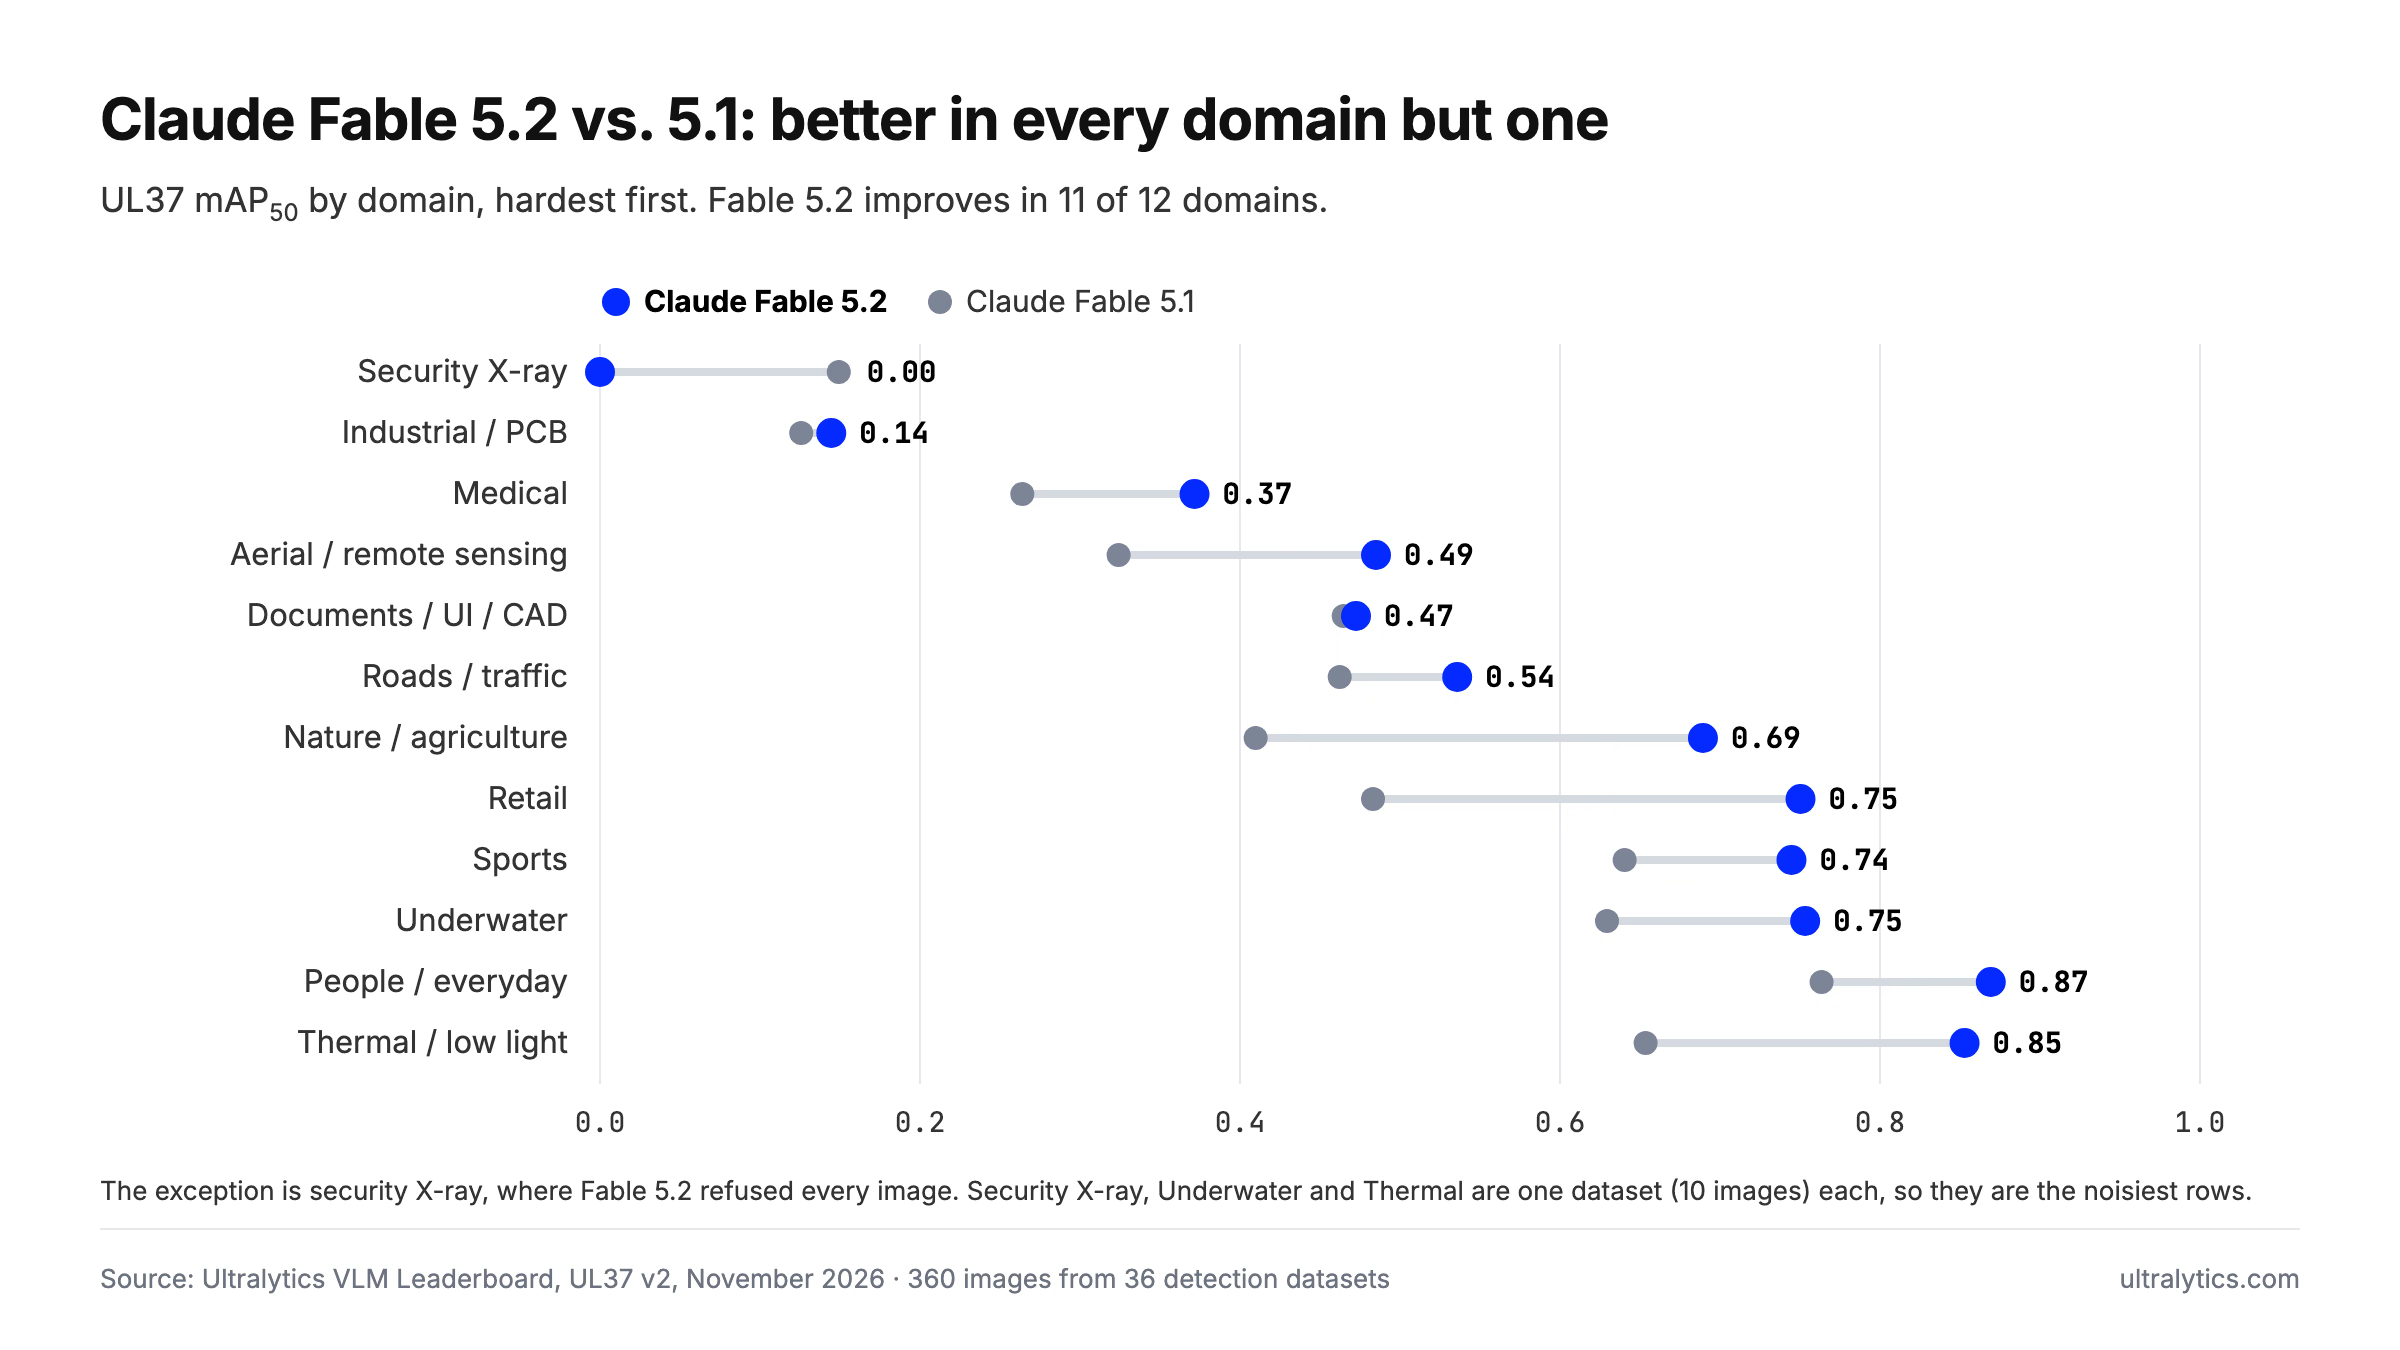
En zordan başlayarak alanlara göre UL37 mAP50; Anthropic'in varsayılan çabasında Claude Fable 5.2 ve Claude Fable 5.1 karşılaştırması.
On iki alanın on birinde iyileşme var. Gerilemenin görüldüğü tek alan güvenlik X-ray görüntüleri: puan 0.15'ten sıfıra düştü. Bunun nedeni modelin görme yeteneği değil, ret. CeyMo yol işaretlerinde de puan 0.85'ten 0.74'e geriledi.
Claude Fable 5.2 ile GPT-6.1 Terra, Gemini 4 Argon ve Claude Opus 5.5 karşılaştırması#
| Model | UL37 mAP50 | mAP50-95 | Kesinlik | Duyarlılık | 1.000 görüntü başına maliyet | Görüntü başına medyan süre |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 sn |
Doğrudan karşılaştırmada Fable 5.2, Terra'yı 18 veri kümesinde yeniyor, 16'sında kaybediyor ve iki veri kümesinde berabere kalıyor. Argon'u 21'e 15, Opus 5.5'i ise 22'ye 14 geçiyor. Dört model arasında en yüksek duyarlılığa sahip; yani en az nesneyi gözden kaçırıyor. Ancak kesinliği en düşük model; bu yüzden silmen gereken birkaç kutu daha olabilir. Kesinlik ve duyarlılığa göre VLM seçme kılavuzumuz, bu ödünleşimi verilerin için nasıl değerlendireceğini açıklıyor.
Fable 5.2'nin X-ray görüntülerinin yanı sıra yetersiz kaldığı alanlar: sekiz veri kümesindeki ortalamasının 0.372 olduğu tıbbi görüntüleme (Terra'nın puanı 0.505) ve DeepPCB'de 0.00 puan aldığı devre kartları. Her veri kümesinde yalnızca 10 görüntü bulunduğundan, tek bir veri kümesinin puanlarını kesin sonuç değil, gösterge olarak değerlendir.
Anthropic de çoğu işe Claude Opus 5.5 ile başlamayı, yani bu modeli "günlük kullanım için en güçlü model" olarak seçmeyi ve yalnızca görev gerektirdiğinde Fable'a geçmeyi öneriyor. Etiketleme için de bu öneri geçerli. Opus 5.5, Fable 5.2'nin mAP50 puanının %97'sine maliyetin %37'siyle ulaşıyor, 2,7 saniyede yanıt veriyor ve X-ray görüntülerinin hiçbirini reddetmedi.
Claude Fable 5.2 ile bir çalıştırmanın maliyeti#
1.000 görüntü başına 37,55 $, sağlayıcının faturalandırdığı tutardır. Anthropic'in fiyatlandırma sayfasına göre bu tutar, bildirilen belirteç kullanımına ve girdi belirteci başına milyon başına 8 $, çıktı belirteci başına milyon başına 40 $ liste fiyatına dayanarak hesaplanmıştır. Fable 5.2, Anthropic'in varsayılan yüksek akıl yürütme çabası ayarında çalışır. Toplu Etiketleme, 1.000 görüntü başına 1,00 $ Platform işleme ücreti ekler; böylece 1.000 görüntülük bir çalıştırmanın toplamı yaklaşık 38,55 $ olur.
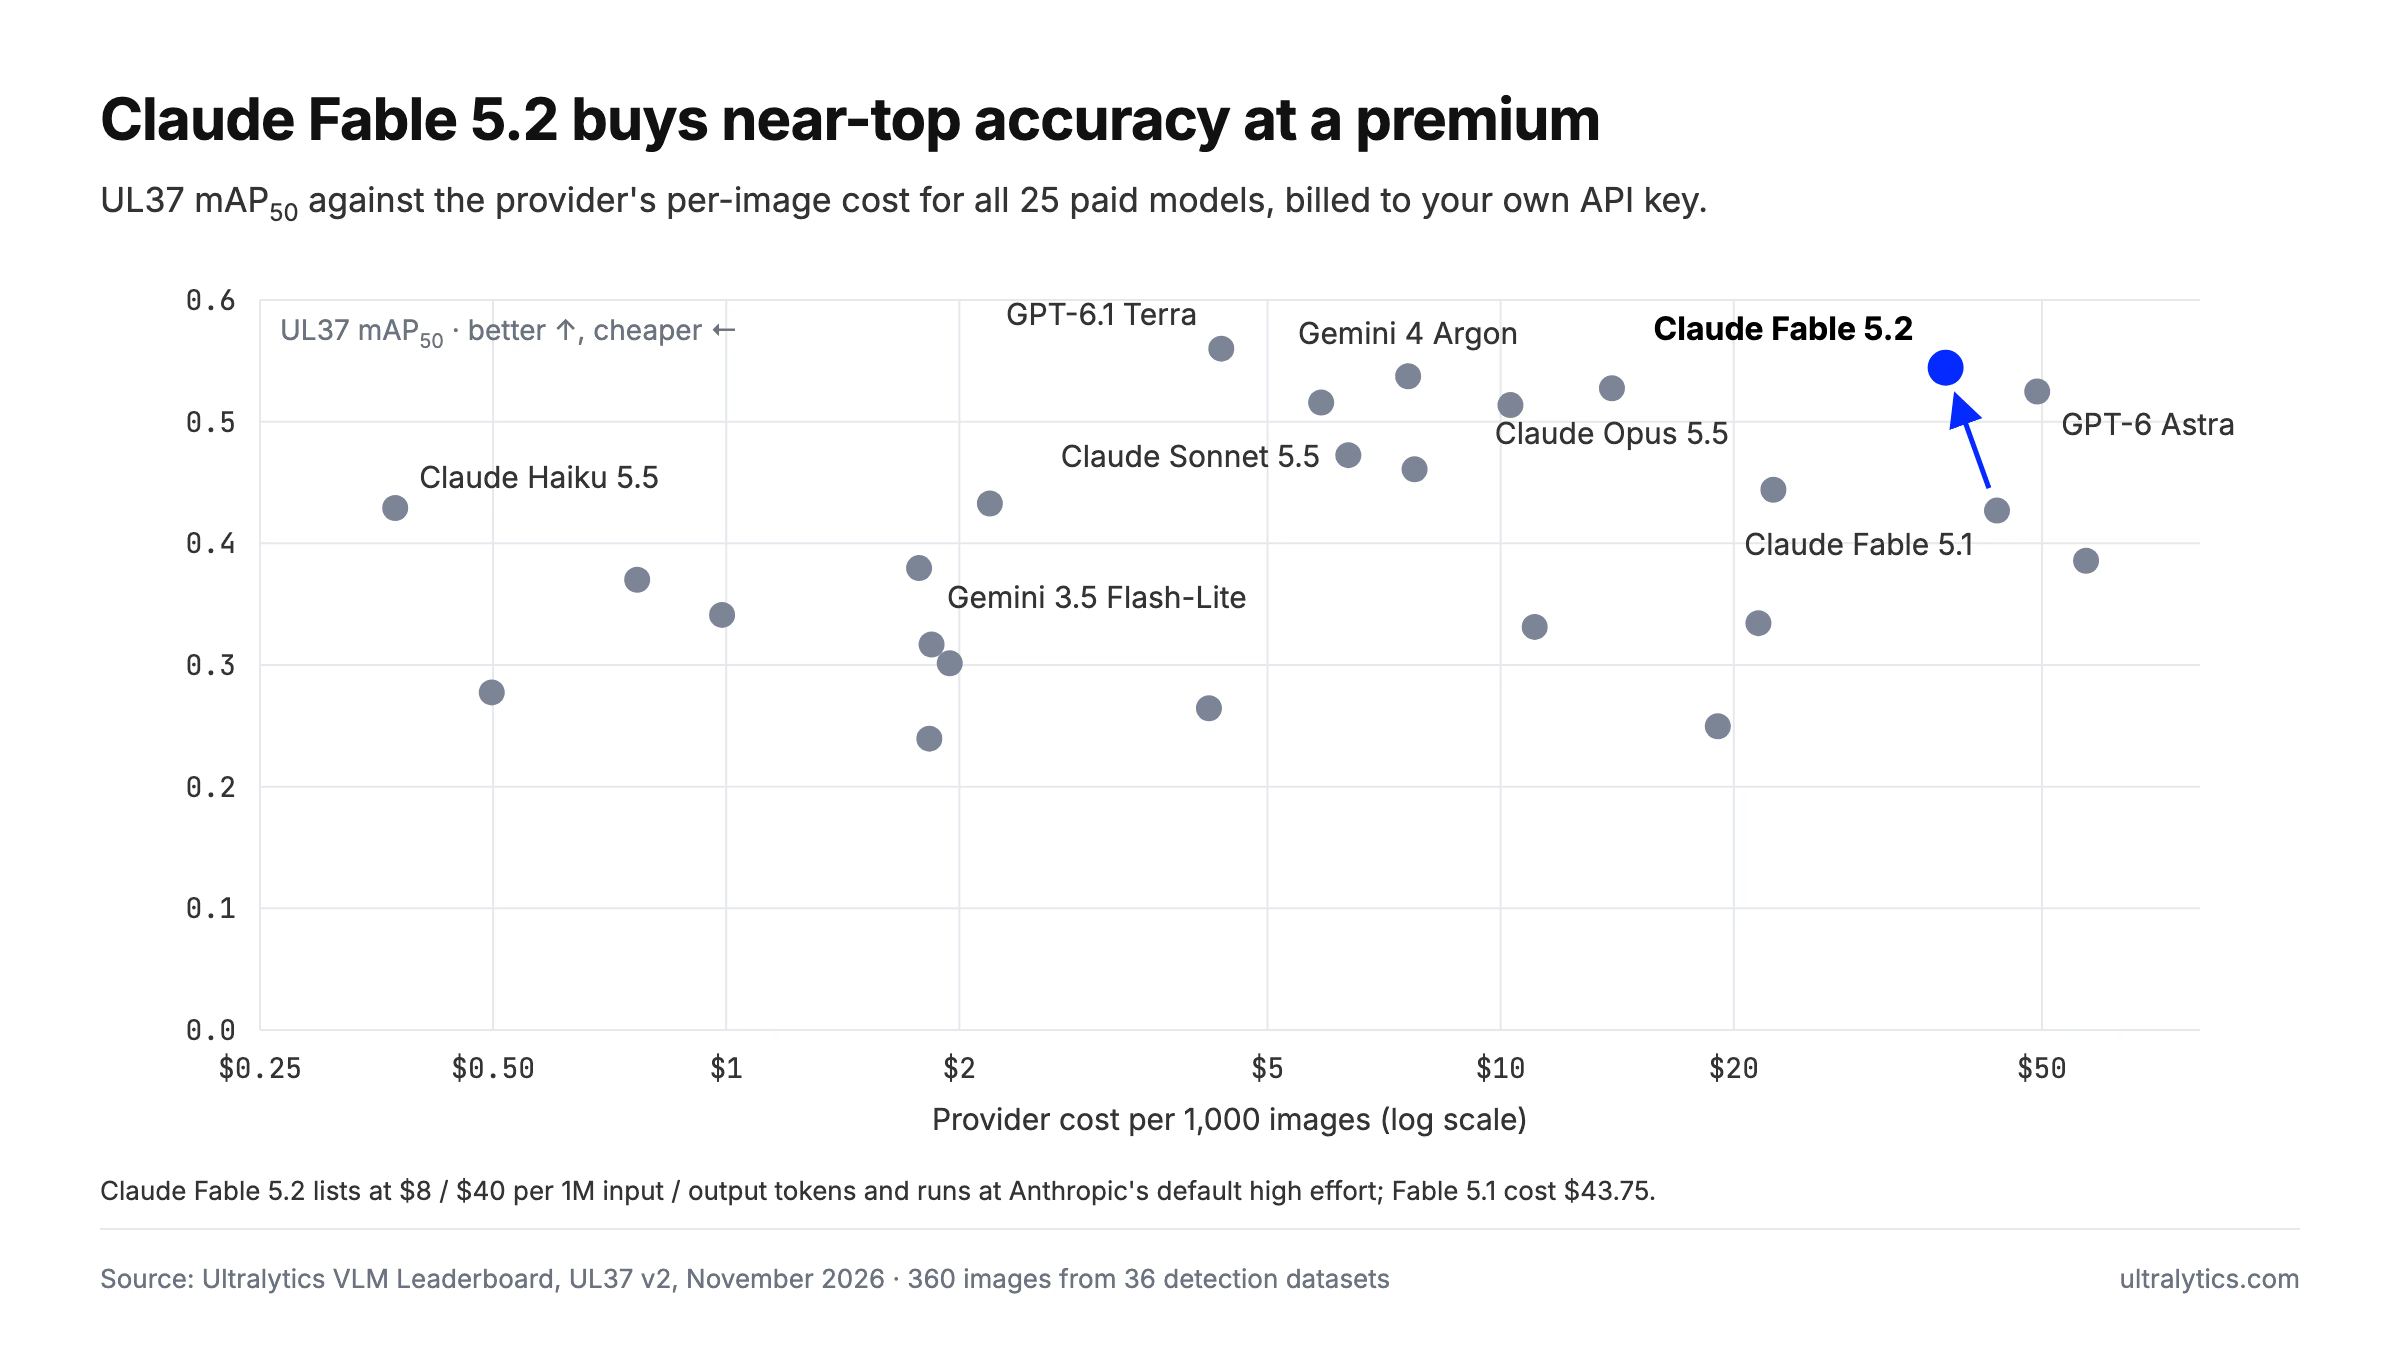
Ücretli 25 modelin tamamı için 1.000 görüntü başına sağlayıcı maliyetine karşı UL37 mAP50; liste fiyatları, 10 Kasım 2026.
Bu, Terra'nın 4,36 $'lık maliyetinden sekiz kattan fazla; karşılığında mAP50 puanı yalnızca 0.016 daha düşük. Fable 5.2, ancak sıkı kutuların bütçeden daha önemli olduğu durumlarda fiyatını hak ediyor. Maliyet önemliyse Claude Haiku 5.5, 0,37 $ karşılığında 0.429 puan alıyor; barındırılan açık ağırlıklı modeller ise hiç API anahtarı gerektirmiyor.
Veri kümen üzerinde Claude Fable 5.2 ile otomatik etiketleme nasıl yapılır#
Fable 5.2, 1 ila 200 sınıf içeren algılama veri kümeleri için sınıf istemleriyle çalışan bir modeldir. Veri kümenin kendi sınıf adları için kutular döndürür ve sen de kaydetmeden önce bunları gözden geçirirsin.
- Claude API anahtarları sayfasında bir anahtar oluştur.
- Anahtarı, veri kümenin sahibi olan Platform çalışma alanında Ayarlar > API Anahtarları bölümüne ekle. Faturayı doğrudan Anthropic gönderir; Ultralytics belirteçlere ek ücret uygulamaz. Ayrıntılar için sağlayıcı anahtarı belgelerine bak.
- Ek açıklama düzenleyicisinde Smart moduna geç ve Anthropic altından Claude Fable 5.2'yi seç. Geçerli görüntüyü etiketlemek için Predict düğmesine veya
Pseçeneğine bas. - Etiketlenmemiş tüm görüntüleri etiketlemek için veri kümesi sayfasında Diğer işlemler > Toplu Etiketleme'yi seç. Platform önce bir veri kümesi sürümü kaydeder; böylece önceki sürüme dönebilirsin.
- Bazı görüntüler reddedilirse Toplu Etiketleme'yi Gemini 4 Argon veya barındırılan bir açık ağırlıklı model gibi başka bir modelle yeniden çalıştır. Yalnızca hâlâ etiketlenmemiş görüntüler etiketlenir.
- Kutuları gözden geçirip kaydet ve aynı çalışma alanında sonuçla bir YOLO26 modeli eğit.
Büyük bir veri kümesini işleme koymadan önce model sayfasını aç. Bu sayfa, Fable 5.2'nin kaydedilmiş kutularını kıyaslama veri kümelerinin her birinde beklenen kutularla birlikte gösterir ve her birindeki puanını listeler.
Claude Fable 5.2 model sayfası
Bu modellerin düzenleyicide nasıl çalıştığı hakkında daha fazla bilgi için Ultralytics Platform'un ek açıklamaları otomatikleştirmek üzere yapay zekâyı nasıl kullandığına ve insan denetimli incelemenin neden vazgeçilmez olduğuna göz at.
Claude Fable 5.2'yi kimler kullanmalı#
Kutu sıkılığı en önemli, bütçe ise en az önemli olduğunda Claude Fable 5.2'yi seç: test ettiğimiz tüm modeller arasında en üst sırada ya da en üst sıraya yakın olduğu spor, perakende, tarım ve gündelik sahneler için uygundur. mAP50-95'teki liderliği, katı IoU eşiklerinde eğitmeyi planladığın veri kümeleri için güçlü bir ilk taslak sunar.
Güvenlik, savunma ve tarama verileri için bu modeli kullanma. Anthropic'in filtresi, yalnızca telefon içerenler de dahil olmak üzere güvenlik X-ray veri kümemizdeki tüm taramaları reddetti ve Platform'daki hiçbir özellik bu engeli aşamıyor. Bu projeler için Gemini 4 Argon'u veya denetimini elinde tuttuğun açık ağırlıklı bir modeli kullan. Diğer etiketleme işlerinin çoğunda GPT-6.1 Terra veya Claude Opus 5.5, fiyatın çok küçük bir bölümü karşılığında neredeyse aynı kutuları sunar.
Sık sorulan sorular
Anthropic'in API'si, patlayıcı sınıflarını içeren güvenlik X-ray ek açıklama isteklerini engelliyor. Kıyaslamamızdaki 10 IEDXray taramasının tümünde
refusaldurma nedenini vegeneral_harmskategorisini döndürerek "yüksek güçlü patlayıcıların geliştirilmesiyle ilgili içerik kısıtlamalarını" gerekçe gösterdi; bu, yalnızca sıradan bir telefon veya dizüstü bilgisayar içeren taramalar için bile geçerliydi. Predict düğmesine yeniden basmak işe yaramaz; bu görüntüler için başka bir model kullan.Liderlik tablomuzdaki başka hiçbir model IEDXray taramasını reddetmedi. Buna barındırdığımız 19 modelin tümü, Çin laboratuvarlarından gelen her model ve Anthropic'in kendi Claude Opus 5.5, Sonnet 5.5 ve Haiku 5.5 modelleri de dahil. Gemini 4 Argon 0.30 mAP50 ile en yüksek puanı aldı; onu 0.27 puanla açık ağırlıklı Moondream 3.1 izledi. Güvenlik X-ray görüntülerinde tüm modellerin doğruluğu düşük olduğundan her kutuyu gözden geçir.
Evet. Gerçek dünya algılama görevlerine ait 36 veri kümesinde 0.544 mAP50 puanıyla 44 model arasında ikinci sırada ve daha katı mAP50-95 ölçütünde 0.347 puanla ilk sırada. Perakende, spor, tarım ve gündelik sahnelerde en iyi; güvenlik X-ray görüntüleri, tıbbi görüntüleme ve devre kartı kusurlarında ise en zayıf performansı gösteriyor.
Fable 5.1'in 0.427 puanına karşılık 0.544 mAP50 alıyor ve 36 veri kümesinin 31'inde kazanıyor; üstelik 1.000 görüntü başına 43,75 $ yerine 37,55 $ maliyet sunuyor. Görüntü başına 4,6 saniyeyle daha yavaş; Fable 5.1'in birini reddettiği güvenlik X-ray görüntülerinin 10'unu da reddetti.
Anthropic'in girdi belirteci başına milyon başına 8 $ ve çıktı belirteci başına milyon başına 40 $ ücretleriyle, sağlayıcının bildirdiği belirteç kullanımına göre yaklaşık 37,55 $. Ultralytics Platform'daki Toplu Etiketleme, 1.000 görüntü başına 1,00 $ işleme ücreti ekler. Kendi API anahtarın üzerinden ödemeyi doğrudan Anthropic'e yaparsın.
Terra, 0.544'e karşı 0.560 mAP50 puanıyla daha yüksek sonuç alıyor ve maliyeti yaklaşık sekizde bir. Fable 5.2'nin kutuları biraz daha sıkı: Terra'nın 0.345 puanına karşı 0.347 mAP50-95 alıyor ve veri kümelerinin 18'ini kazanırken Terra 16'sını kazanıyor. Çoğu ekip için Terra daha iyi bir varsayılan seçim; kutu kesinliği maliyetten daha önemliyse Fable 5.2 mantıklı bir tercih.
Yazan
Kurucu ve CEO · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









