Bilgisayarlı görü çıkarımı için ONNX ve TensorRT: kıyaslamalar ve seçim rehberi
Bilgisayarlı görü çıkarımı için ONNX Runtime ve TensorRT karşılaştırması: 19 NVIDIA GPU’da ölçülen Ultralytics YOLO26 hızı ve doğruluğu ve hangisini seçeceğin.
 Miles Deans10 dakikalık okuma
ONNX ve TensorRT aslında rakip değil. ONNX bir model biçimidir; TensorRT ise genellikle girdi olarak bir ONNX dosyası alan NVIDIA çıkarım motorudur. Asıl tercih, bu dosyayı nasıl çalıştıracağındır: farklı donanımlarda çalışan ve işi TensorRT’ye bile devredebilen ONNX Runtime ile mi, yoksa yalnızca NVIDIA GPU’larda çalışan bağımsız bir TensorRT engine’ine derleyerek mi? 19 NVIDIA GPU’da Ultralytics YOLO26 için yapılan Ultralytics Platform kıyaslamalarında, TensorRT FP16 her GPU ve model boyutunda yayımlanmış ONNX FP16 sonuçlarından daha hızlıydı; doğruluk farkı 0.001 mAP50-95 içinde kaldı. Model boyutlarına göre medyan hız artışı 1.85x ile 2.55x arasında değişti. Kıyaslama sayfası, ONNX sonuçlarını hangi ONNX Runtime yürütme sağlayıcısının ürettiğini belirtmediğinden, bu sonuçlar ONNX Runtime’ın genel olarak veya TensorRT yürütme sağlayıcısıyla nasıl karşılaştırıldığını ortaya koymuyor. NVIDIA GPU’larda Ultralytics YOLO26 kullanırken gecikme önemliyse TensorRT FP16 ile başla; tek bir model dosyasının birden fazla donanım türünde çalışması gerekiyorsa ONNX Runtime’ı kullan. Ultralytics YOLO, tek bir argümanla her iki biçime de aktarım yapar.
Ultralytics YOLO ile başlamak için:
| Dağıtım | Şununla başla: | Ultralytics YOLO aktarımı |
|---|---|---|
| NVIDIA GPU, gecikme önemli | TensorRT FP16 | format="engine", quantize=16 |
| CPU, NVIDIA dışı donanım veya karma filolar | ONNX Runtime | format="onnx" |
| NVIDIA GPU’da ONNX Runtime API’si | TensorRT yürütme sağlayıcısıyla ONNX Runtime | format="onnx" |
ONNX ve TensorRT: biçim, çalışma zamanı ve engine#
Bu karşılaştırmanın ardında üç farklı şey var:
- Açık Sinir Ağı Değişimi (ONNX), eğitilmiş bir modelin grafiğini ve ağırlıklarını çerçeveden bağımsız biçimde saklayan dosya biçimidir. Modeli diğer araçların okuyabilmesi için PyTorch’tan ONNX’e aktarırsın.
- ONNX Runtime, ONNX modellerini çalıştırır. Aynı dosyanın bir dizüstü bilgisayarın CPU’sunda veya bir bulut GPU’sunda çalışabilmesi için işleri CPU, CUDA ve TensorRT gibi yürütme sağlayıcıları adı verilen donanım arka uçlarına devreder.
- TensorRT, genellikle bir ONNX dosyası olan modeli ONNX ayrıştırıcısı üzerinden okur. Katmanları birleştirir, üzerine derlendiği GPU’daki her işlem için en hızlı çekirdeği seçer ve optimize edilmiş bir engine yazar.
Dolayısıyla asıl soru ONNX Runtime ve TensorRT karşılaştırmasıdır. ONNX Runtime, TensorRT yürütme sağlayıcısı aracılığıyla TensorRT’yi de çağırabilir; böylece ONNX Runtime API’sini kullanmaya devam ederken desteklediği alt grafikleri TensorRT çalıştırır. ONNX Runtime, TensorRT’nin desteklemediği düğümlerin bunun yerine CUDA’da çalışabilmesi için CUDA yürütme sağlayıcısının TensorRT’den sonra kaydedilmesini önerir.
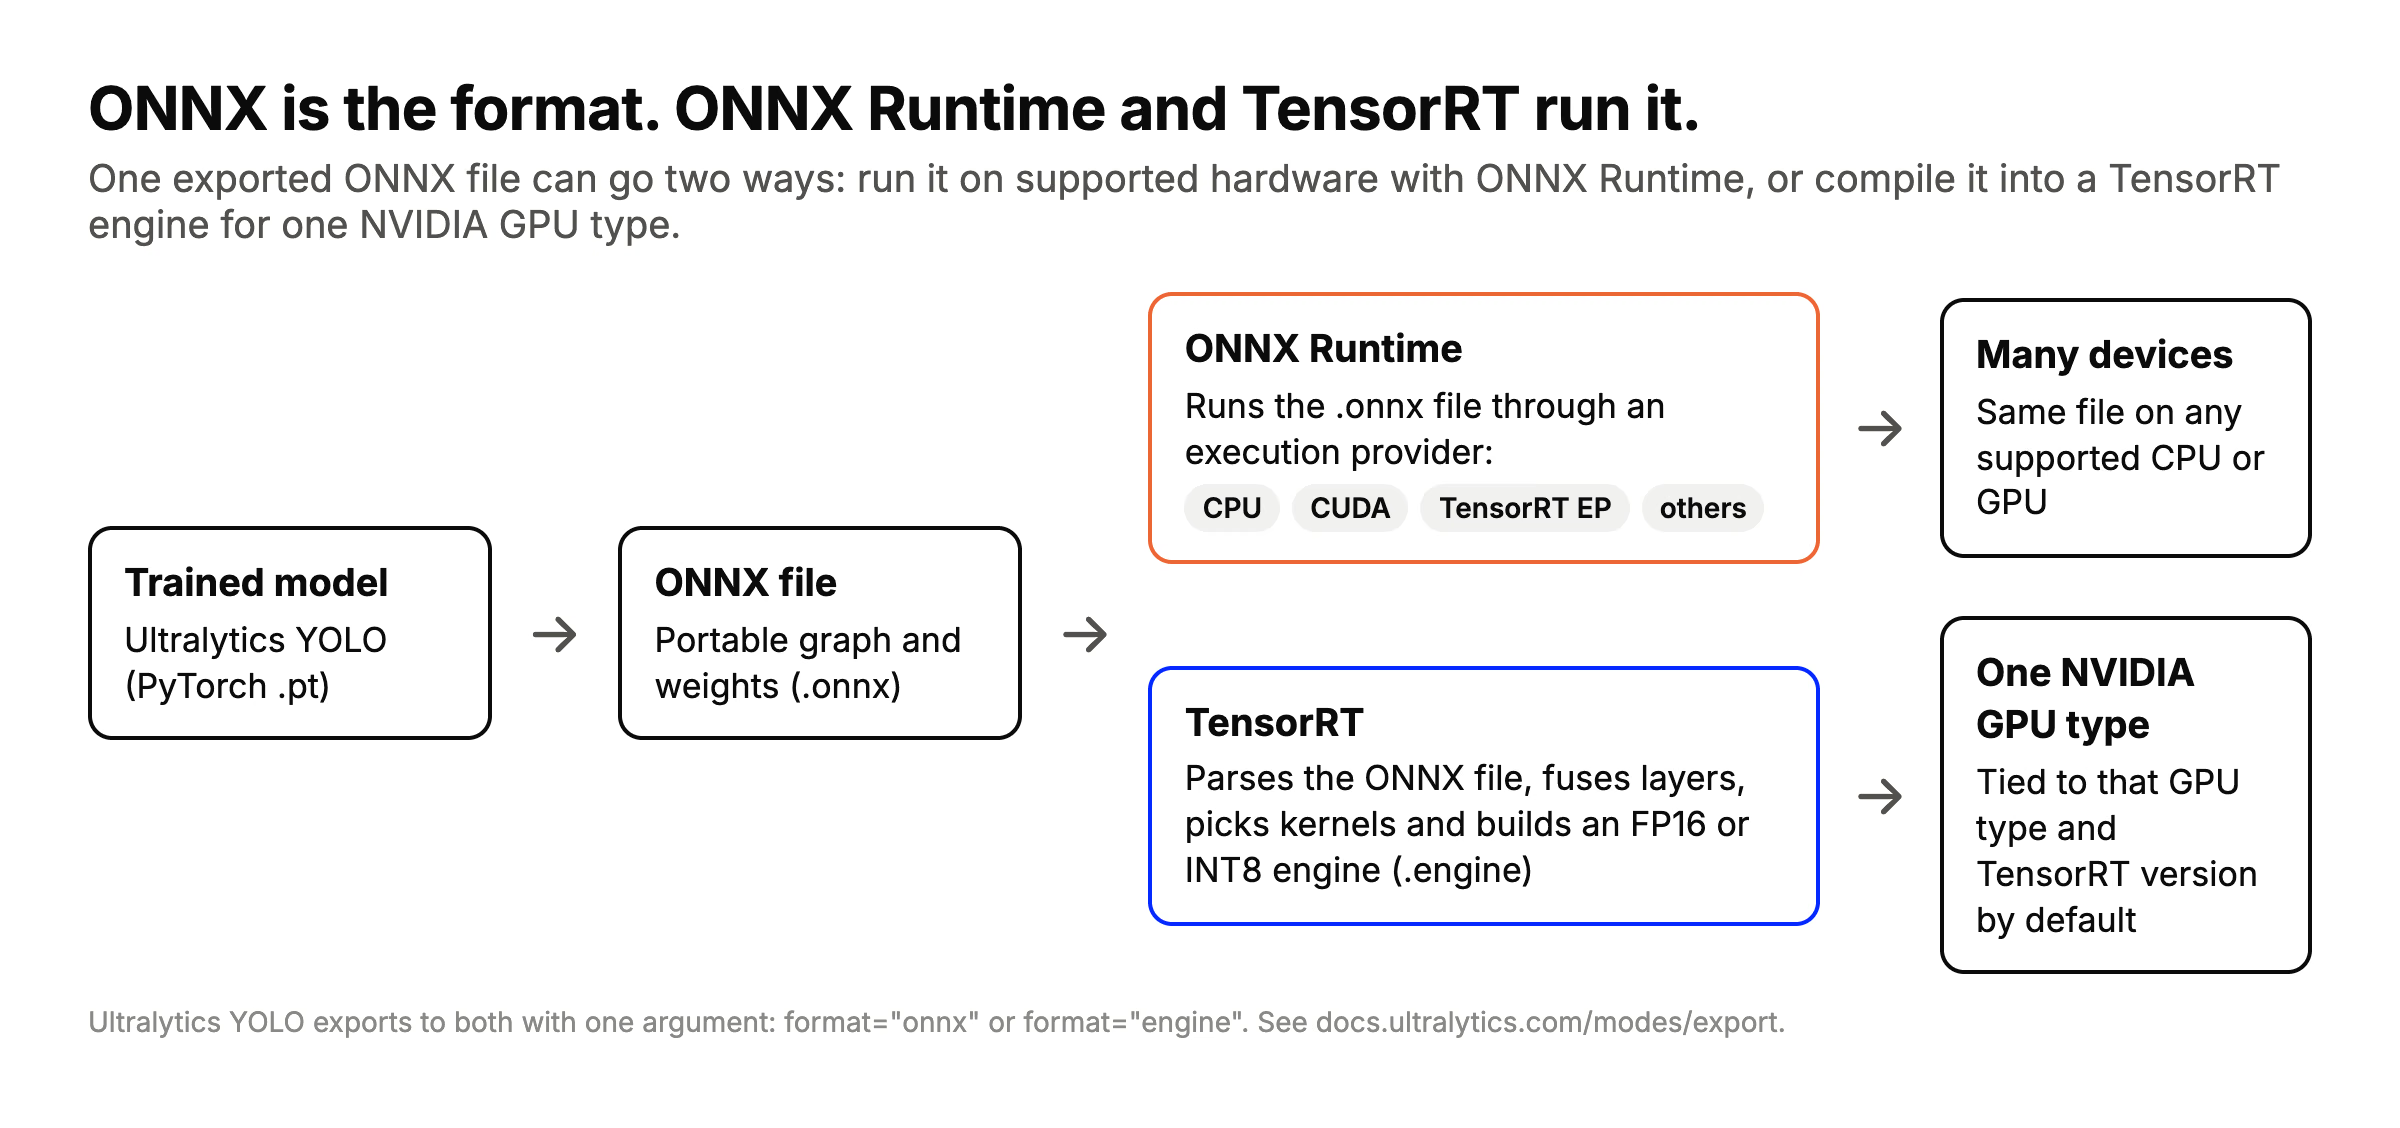
Tek bir ONNX dosyası, iki yol: ONNX Runtime dosyayı desteklenen donanımlarda çalıştırırken TensorRT, dosyayı tek bir NVIDIA GPU türüne yönelik bir engine’e derler. Ultralytics YOLO her iki biçime de aktarım yapar.
Kıyaslamalar: ONNX Runtime ve TensorRT üzerinde YOLO26#
Aşağıdaki sayılar Ultralytics Platform çıkarım kıyaslamalarından alınmıştır. Her Ultralytics YOLO26 tespit modeli gösterilen biçime aktarıldı; ardından çıkarım gecikmesi, Ultralytics Platform GPU’larında COCO val2017 üzerinde 1’lik batch boyutu ve 640 piksel çözünürlükte ölçüldü; ısınma süresi ölçüme katılmadı ve her çalıştırmanın sürelerine sigma kırpma uygulandı. Doğruluk, COCO val2017 üzerinde her biçim ve hassasiyet için bir kez ölçülen mAP50-95 değeridir. Karşılaştırmada dört biçimin tümü için sonuç bulunan 19 NVIDIA GPU (Ampere, Ada ve Hopper) kullanılıyor.
Kıyaslama sayfası, ONNX sonuçlarını hangi ONNX Runtime yürütme sağlayıcısının ürettiğini belirtmiyor ve desteklenen model bölümlerini TensorRT’ye devreden ONNX Runtime’ın TensorRT yürütme sağlayıcısıyla alınmış sonuçları etiketlemiyor. Bu ONNX sonuçları kıyaslamada kullanılan yapılandırmayı gösteriyor; performans, ONNX Runtime yürütme sağlayıcısına göre değişebilir. TensorRT’yi altta kullanan ONNX Runtime API’sini istiyorsan bu birleşimi kendi donanımında kıyasla.
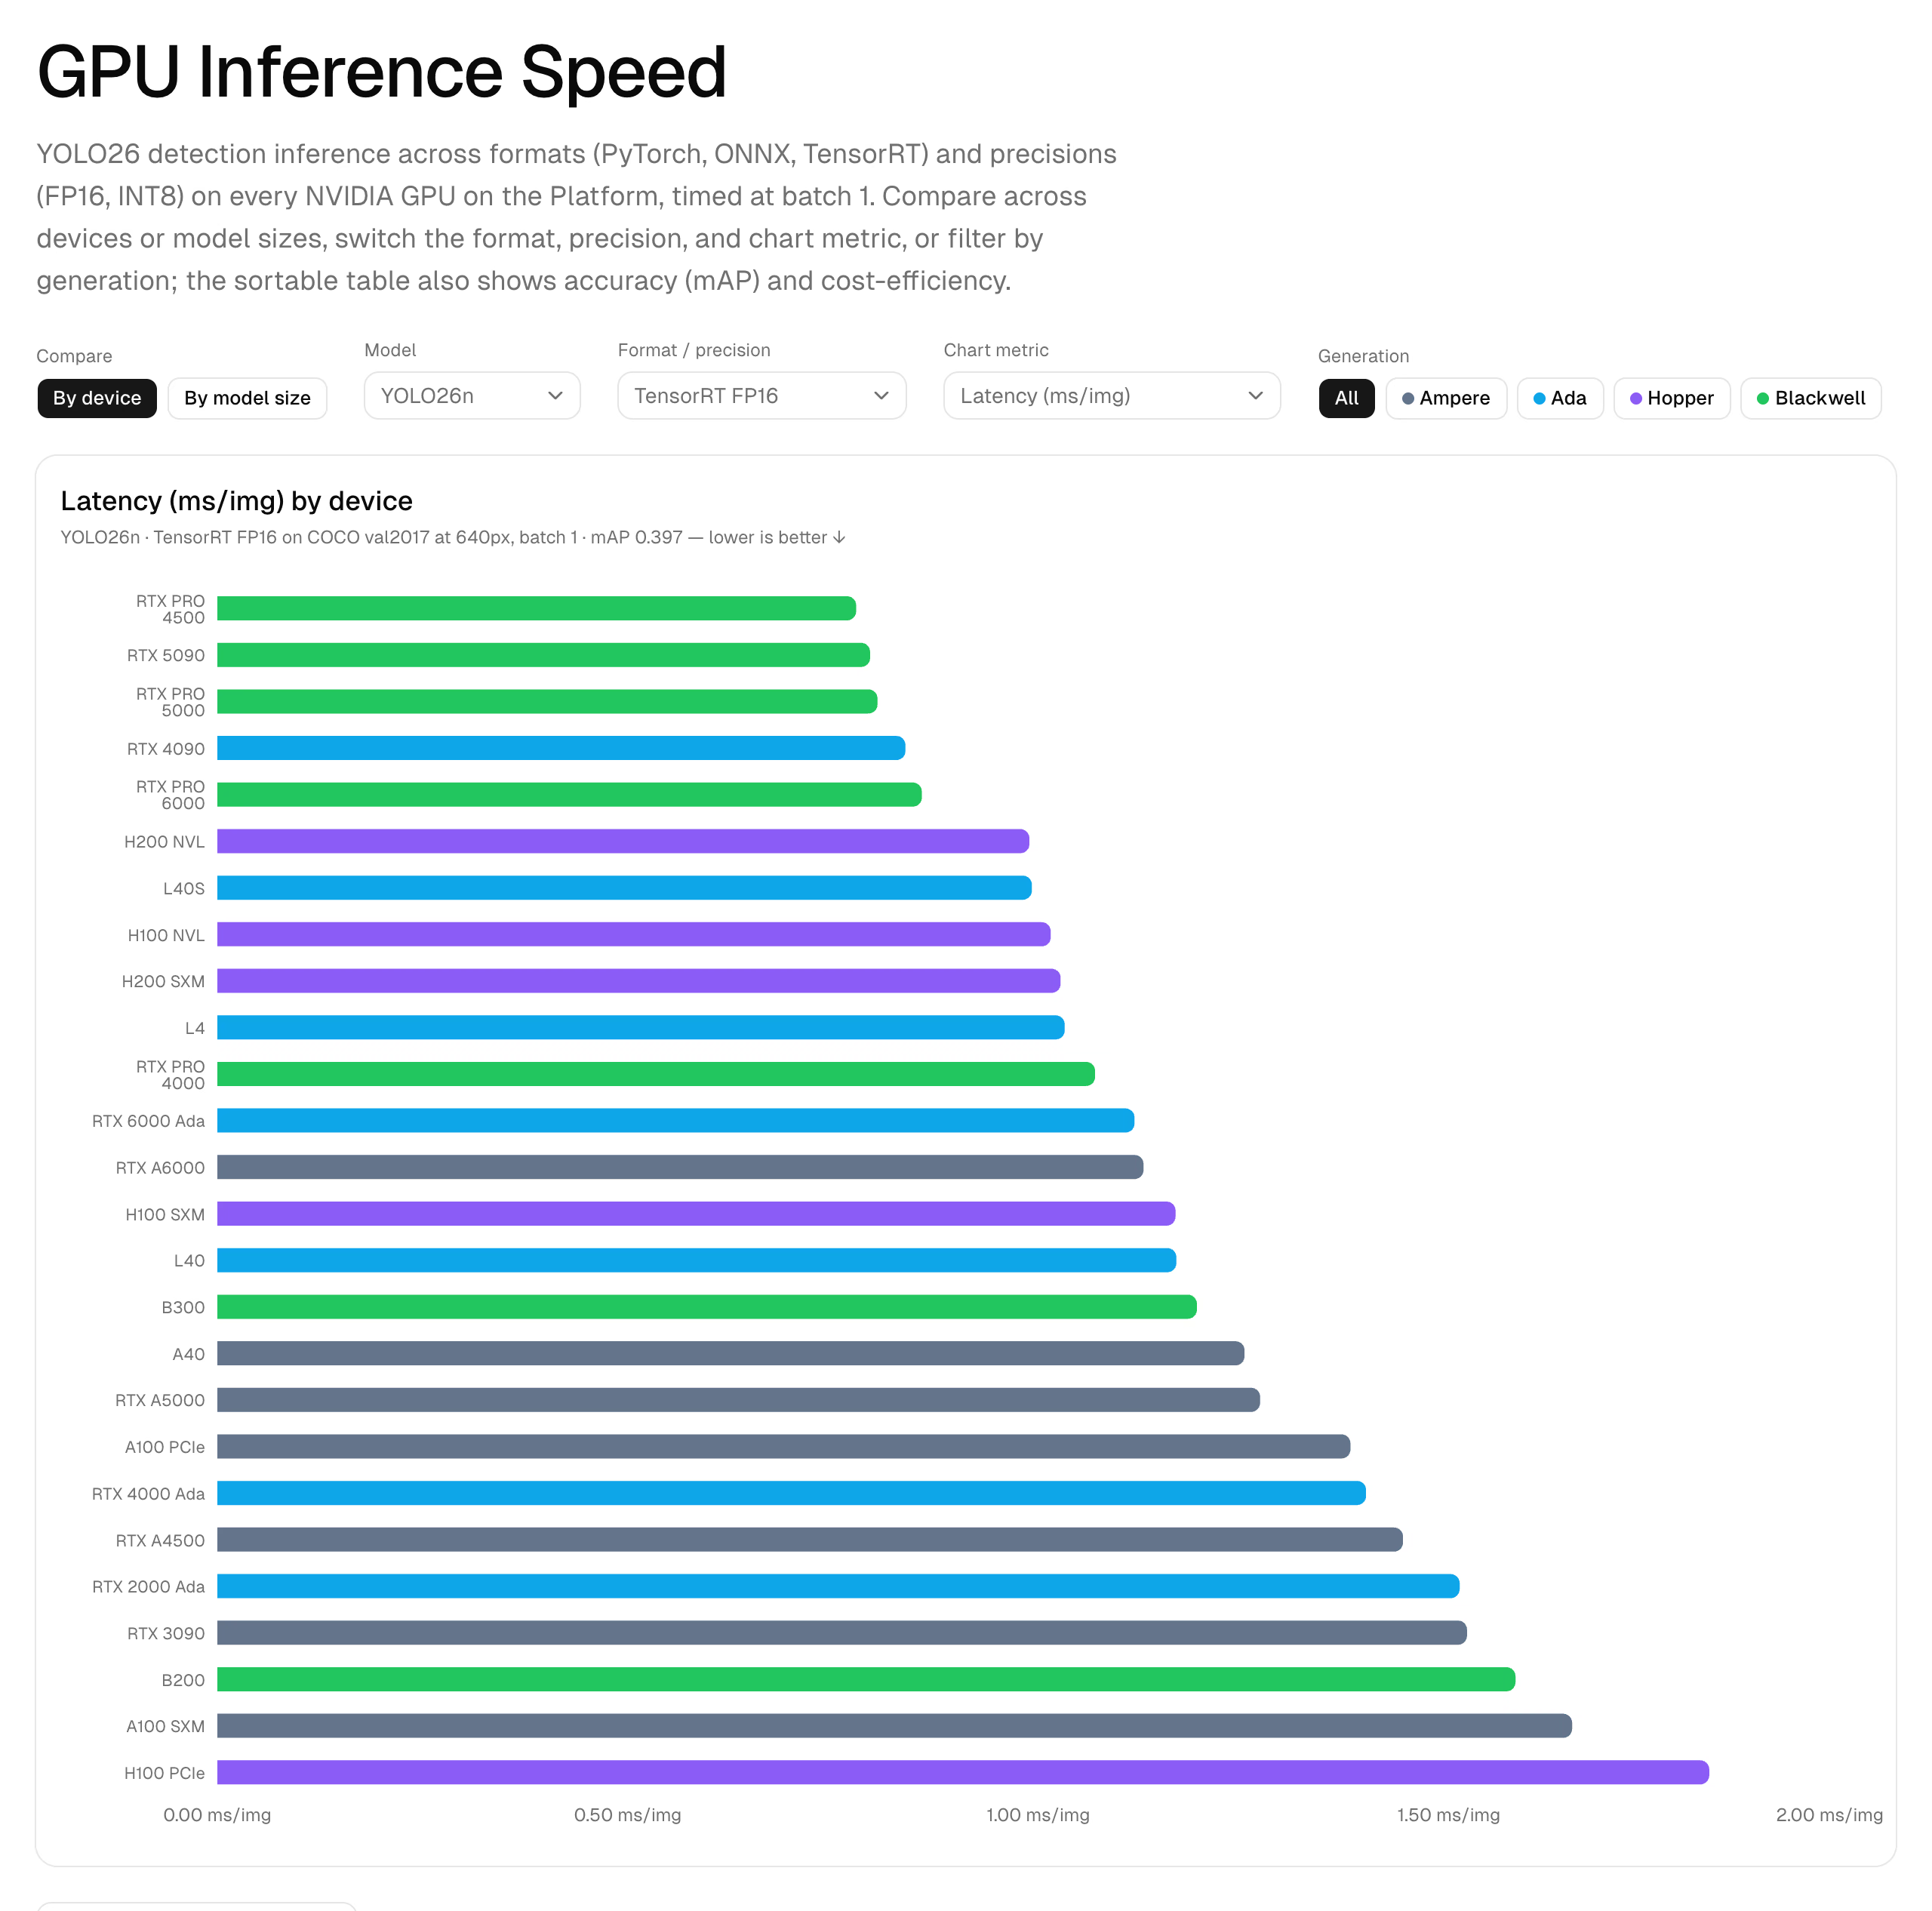
Model boyutunu, biçimi ve hassasiyeti değiştirmek; ardından her GPU’yu gecikme, doğruluk veya maliyete göre sıralamak için Inference sekmesini kullan.
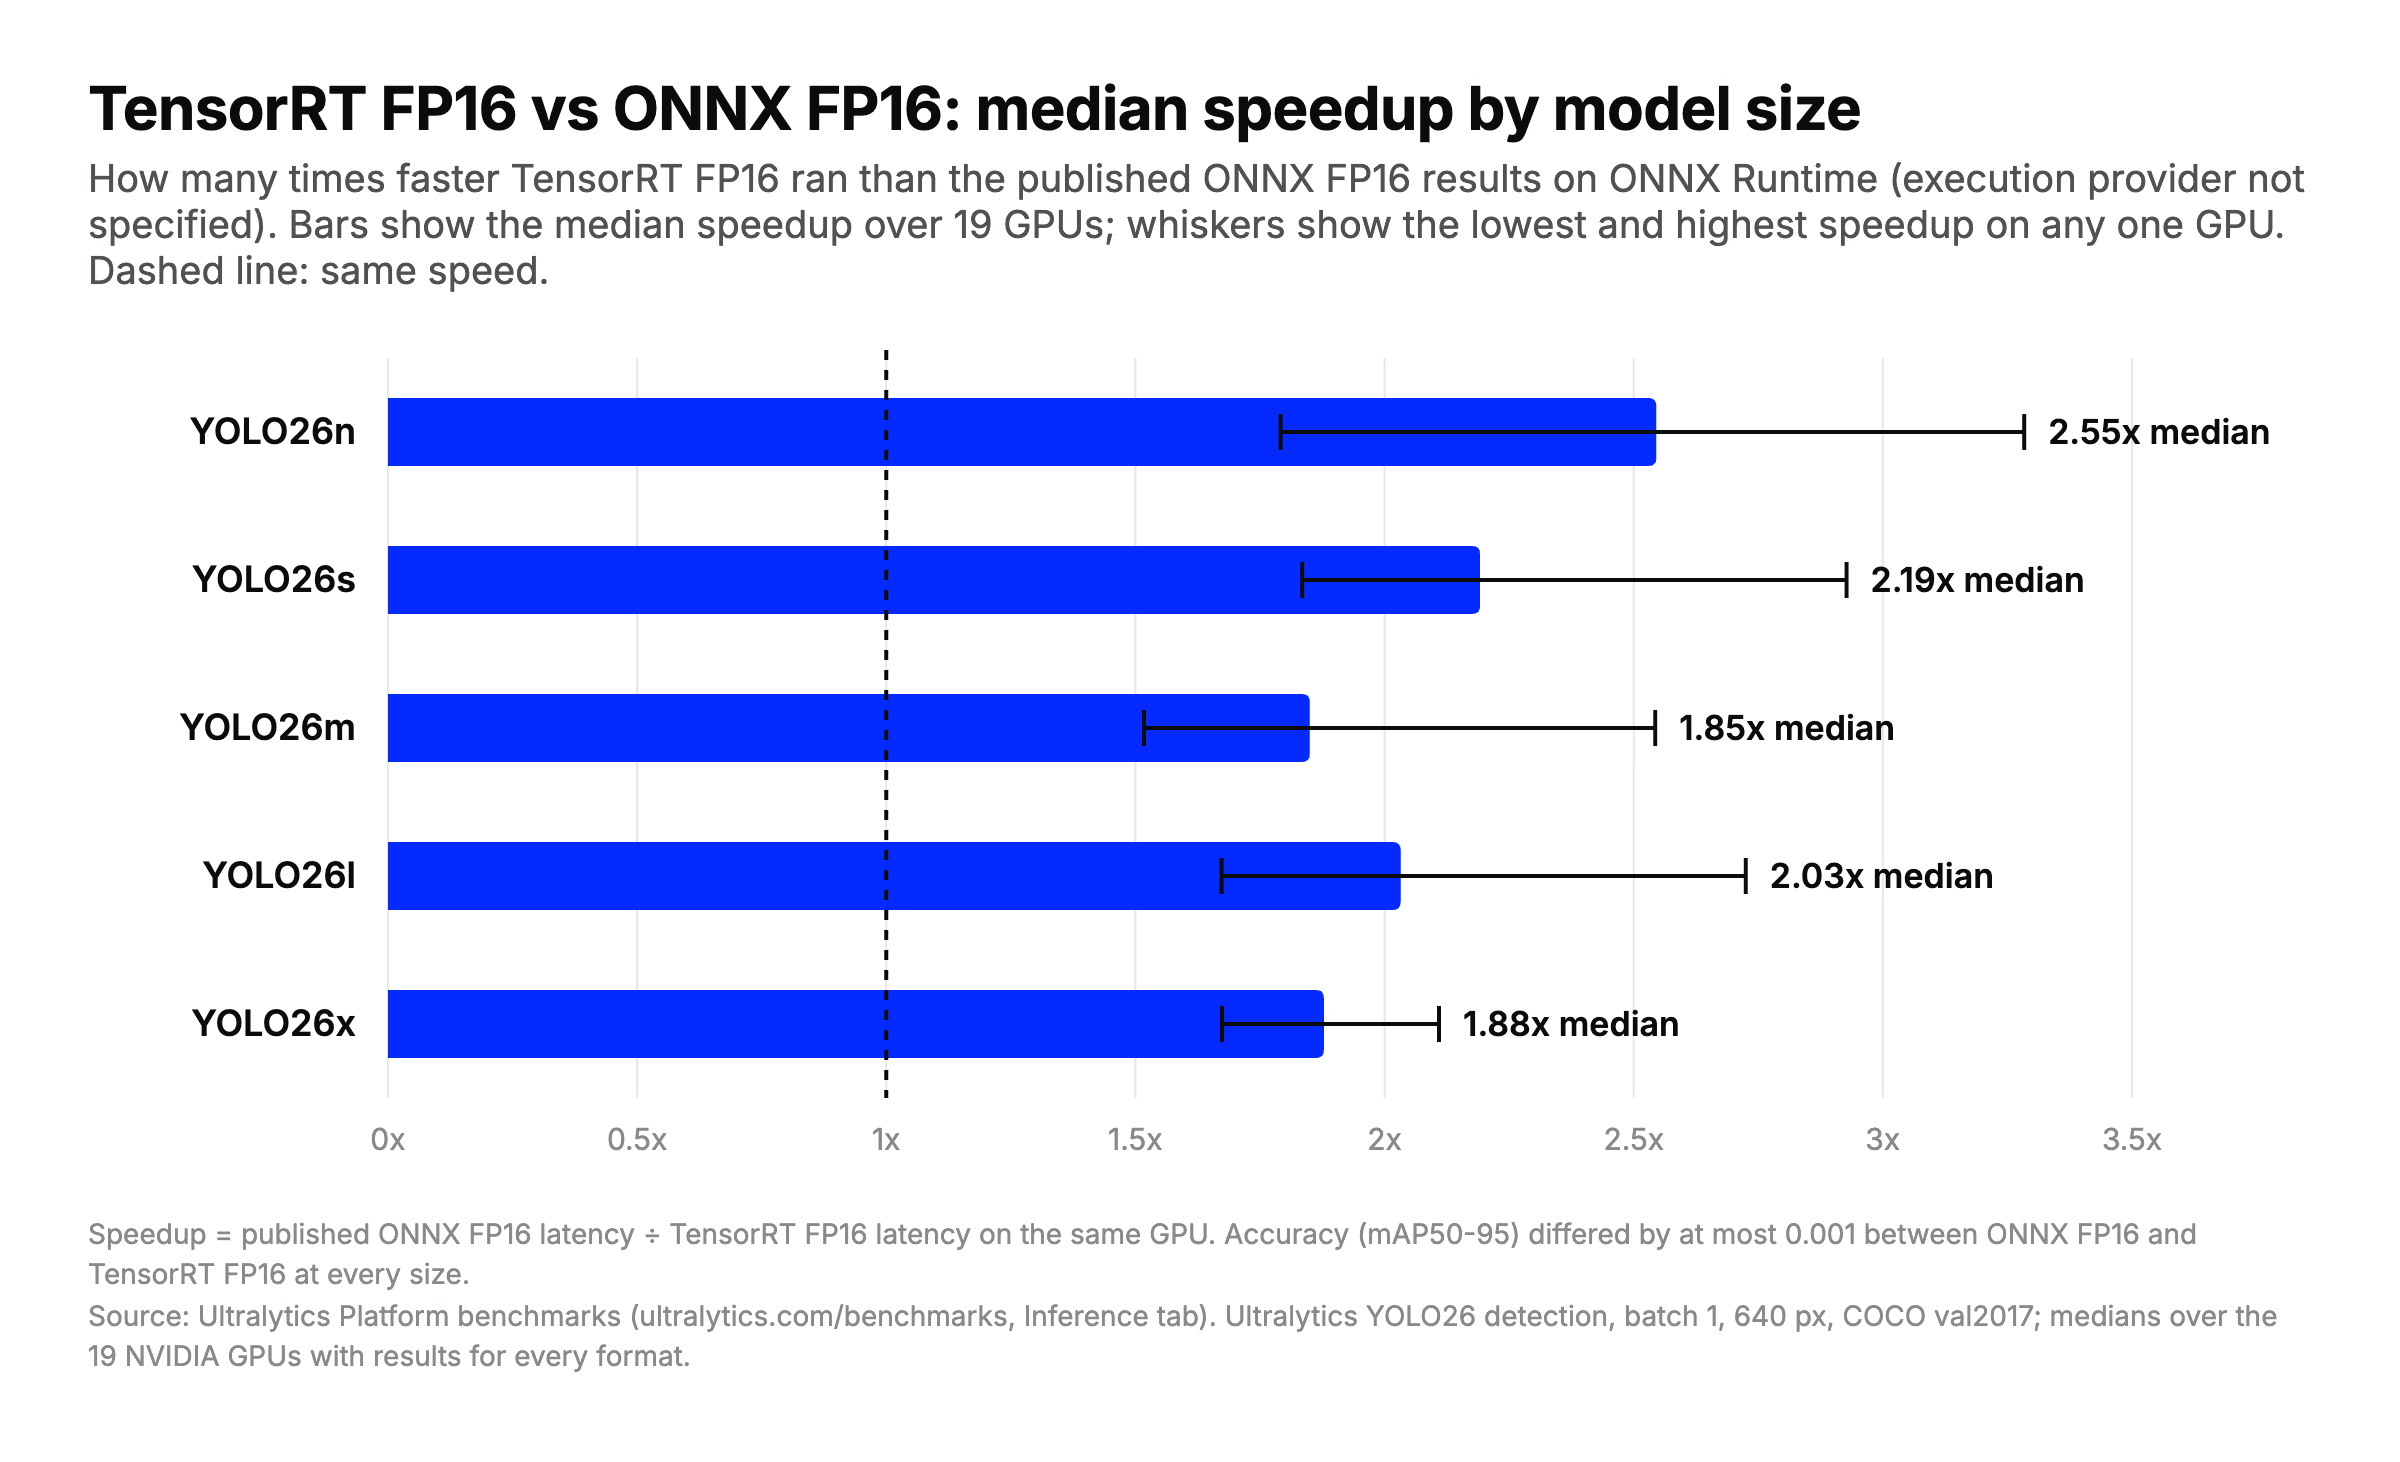
TensorRT FP16, her model boyutunda ve her GPU’da yayımlanan ONNX FP16 sonuçlarından daha hızlıydı; sayfa, sonuçları hangi ONNX Runtime yürütme sağlayıcısının ürettiğini belirtmiyor. Çubuklar 19 GPU genelindeki medyan hız artışını, bıyıklar ise herhangi bir GPU’daki en düşük ve en yüksek hız artışını gösteriyor. Ultralytics Platform çıkarım kıyaslamalarından hesaplandı.
| Model | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | TensorRT FP16’nın ONNX FP16’ya göre hız artışı (medyan, aralık) | TensorRT INT8’in TensorRT FP16’ya göre hız artışı (medyan, aralık) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Ultralytics Platform çıkarım kıyaslamalarından hesaplandı. Hız artışı, aynı GPU’daki ONNX FP16 gecikmesinin TensorRT FP16 gecikmesine veya TensorRT FP16 gecikmesinin TensorRT INT8 gecikmesine bölünmesiyle hesaplanır; dolayısıyla 1x üzerindeki değerler TensorRT FP16’nın (veya INT8’in) daha hızlı olduğu anlamına gelir. Medyanlar, dört biçimin tümünde sonuç bulunan 19 NVIDIA GPU’yu kullanır; aralıklar bu GPU’lar arasındaki en küçük ve en büyük oranlardır. Doğruluk, her biçim ve hassasiyet için bildirilen mAP50-95 değeridir. ONNX FP16, yürütme sağlayıcısı belirtilmeyen yayımlanmış ONNX Runtime sonuçlarını ifade eder.
Kıyaslama sayfasında yayımlandığı şekliyle, yaygın dört GPU’da görüntü başına milisaniye cinsinden gecikme:
| GPU | Model | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Öne çıkan üç nokta var:
- TensorRT FP16, her GPU’da ve her model boyutunda yayımlanan ONNX FP16 sonuçlarından daha iyi performans gösterdi; doğruluk farkı 0.001 mAP50-95 içinde kaldı. Bu NVIDIA GPU’larına dağıtım yapıyorsan ve düşük gecikmeye ihtiyacın varsa TensorRT FP16 ile başla.
- INT8 her zaman daha iyi sonuç vermez. YOLO26n’de 19 GPU’nun 17’sinde TensorRT FP16’dan daha yavaştı ve 0.04 mAP50-95 kayba yol açtı. Büyük modellerde daha sık fayda sağladı; L4 üzerinde YOLO26x’te 1.67x’e kadar çıktı, ancak 0.034 ile 0.076 mAP50-95 arasında kayba neden oldu.
- Yedi Blackwell GPU için ONNX sonucu yok. Kıyaslama sayfası bunu, test ortamında ONNX Runtime’ın Blackwell çekirdeklerine sahip olmamasına bağlıyor. TensorRT yedi GPU’nun tümünde çalıştı.
Bu sonuçlar kıyaslama sayfasındaki yapılandırmayı, 640 pikselde 1’lik batch boyutunu kapsıyor; bu nedenle seçimini yapmadan önce kendi modelini, kendi verilerinle dağıtım cihazında kıyasla.
TensorRT ile FP16 ve INT8#
Daha düşük hassasiyet diğer önemli ayardır ve kıyaslama, neden test edilmesi gerektiğini gösteriyor:
- FP16 (yarı hassasiyet), ağırlıkların ve aktivasyonların boyutunu FP32’ye kıyasla yarıya indirir. Ultralytics Platform kıyaslamalarında TensorRT FP16’nın doğruluğu, ONNX FP16 ve PyTorch FP16 ile 0.003 mAP50-95 içinde eşleşti.
- INT8, ağırlıkları ve aktivasyonları 8 bitlik tam sayılar olarak saklar; bu, bir model nicemleme biçimidir. Kalibrasyon gerekir: aktivasyon aralıklarını ölçmek için temsili bir görüntü kümesi modelden geçirilir. Ultralytics Platform kıyaslamasında kalibrasyon verisi olarak COCO128 ile NVIDIA ModelOpt kullanıldı.
Kıyaslama metodolojisinde belirtildiği gibi, INT8 en çok büyük ve hesaplama ağırlıklı modellerde fayda sağlar. En küçük modellerde ek nicemleme işlemi FP16 ile aynı performansı verebilir, hatta FP16’yı yavaşlatabilir. Dağıtıma çıkmadan önce kendi alanından görüntülerle kalibrasyon yap ve INT8 engine’in doğruluğunu kendi verilerinle doğrula.
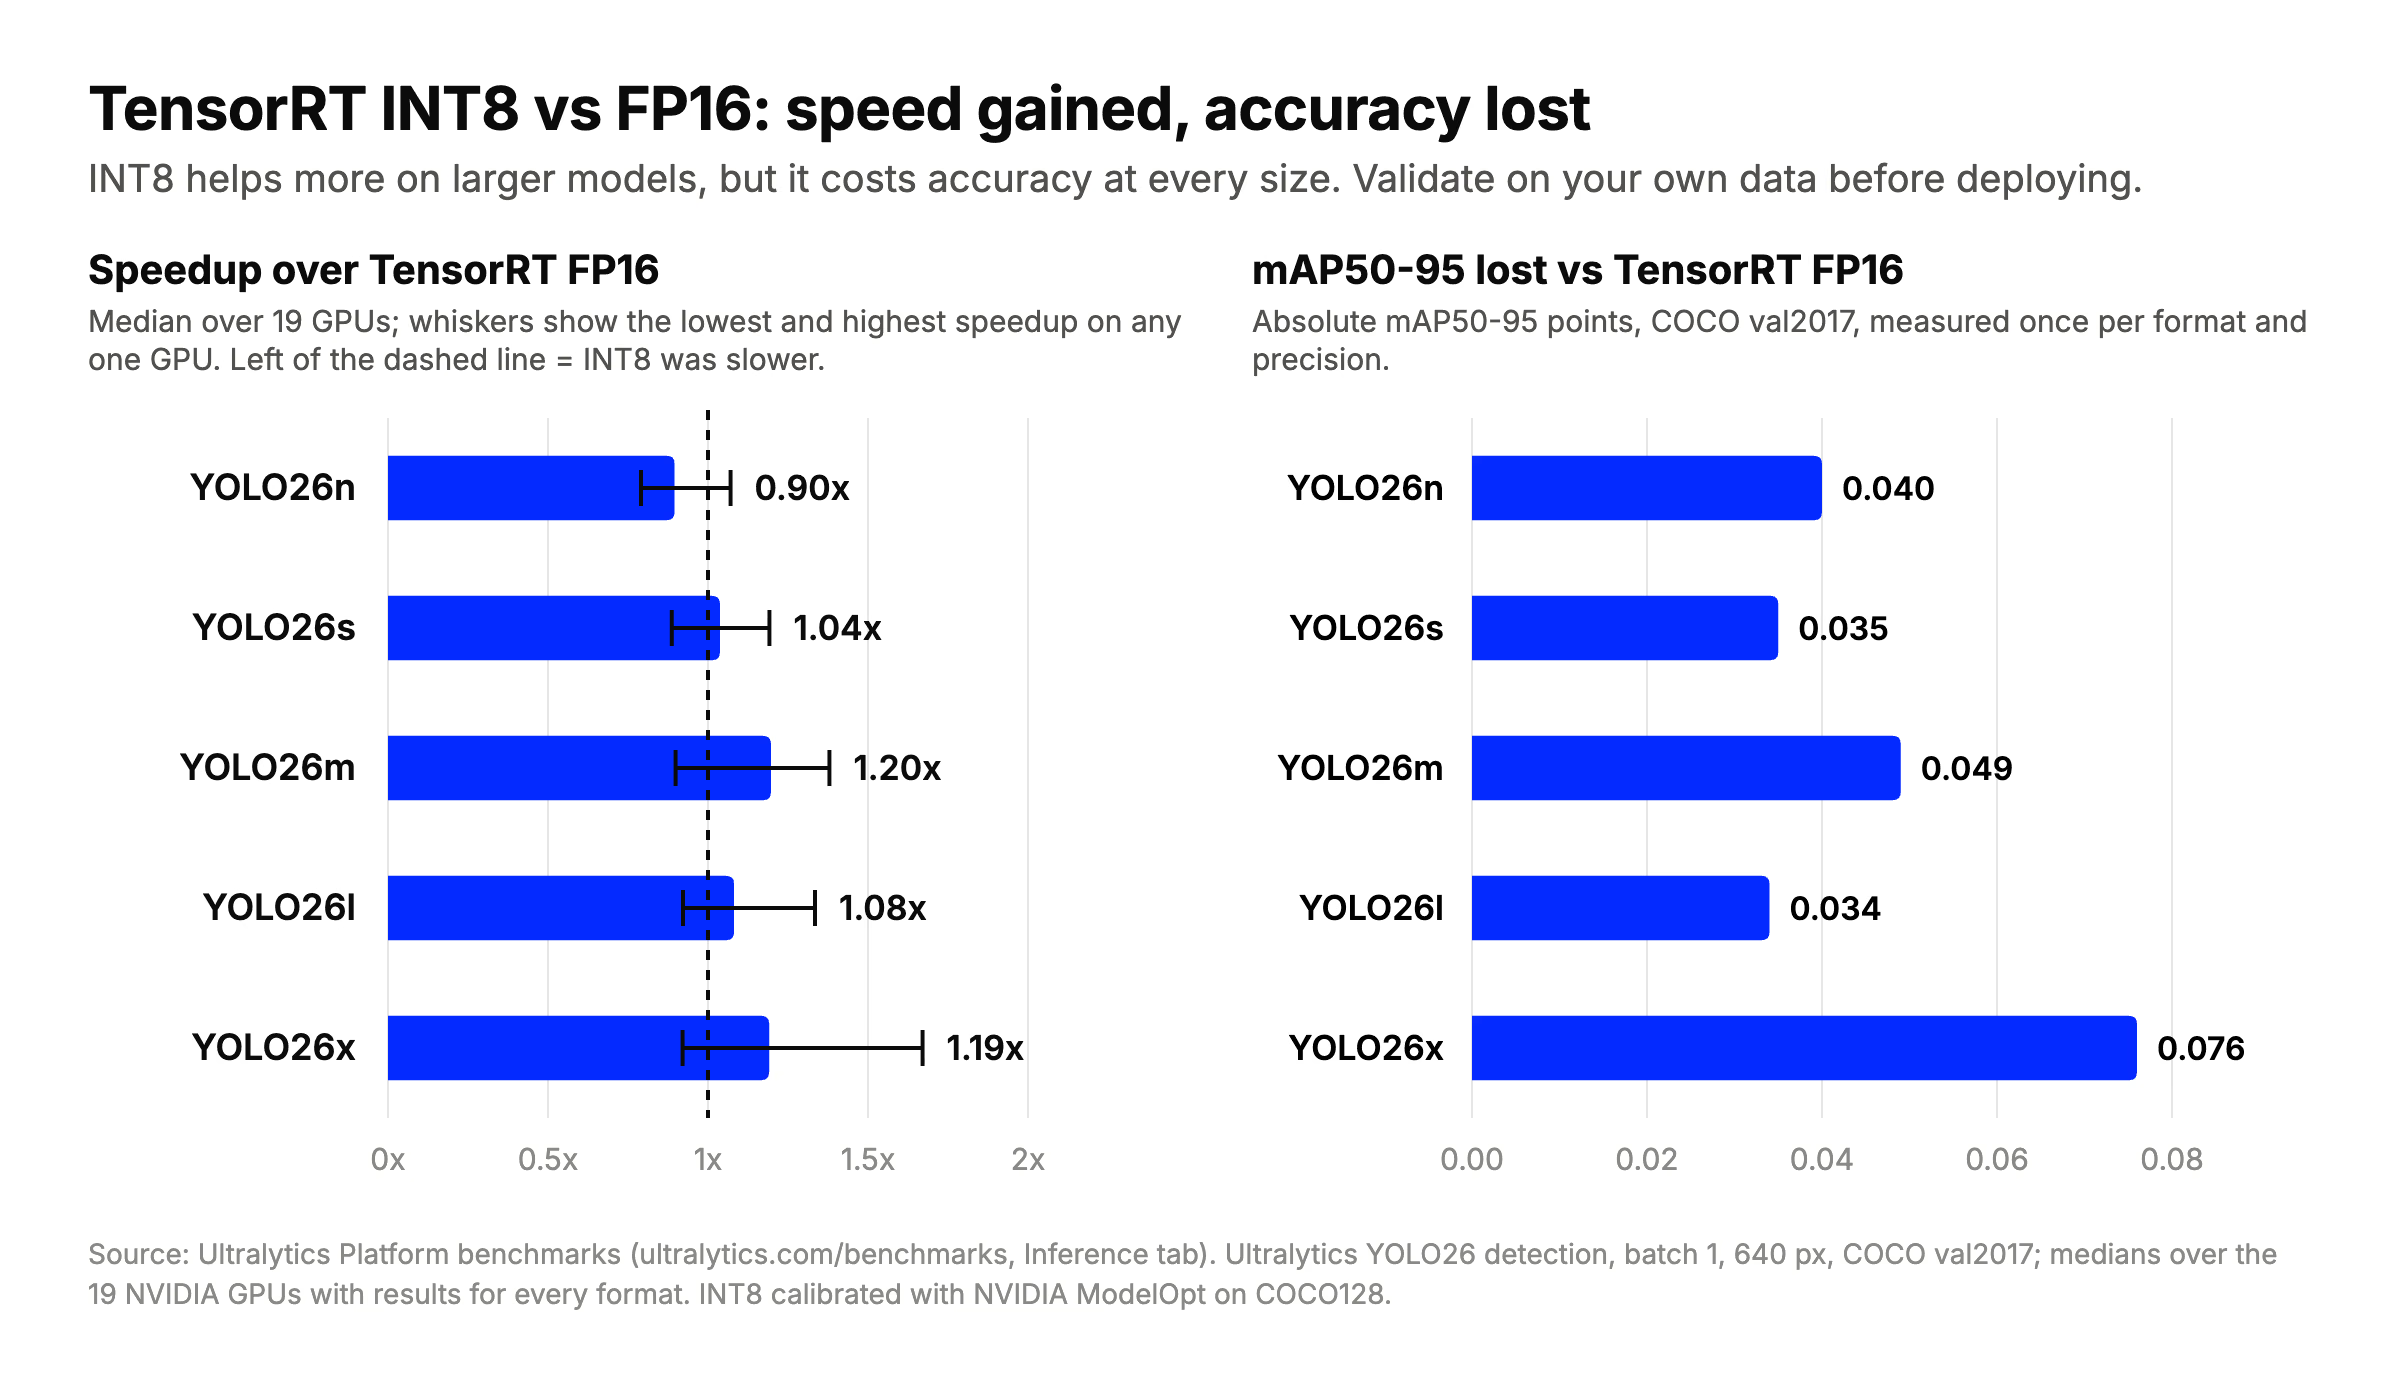
Medyan değerlere göre INT8, YOLO26n’de FP16’dan daha yavaştı; 19 GPU genelinde büyük modellerde ise yaklaşık 1.2x’e kadar daha hızlıydı. Buna karşılık her boyutta 0.034 ile 0.076 mAP50-95 arasında kayba yol açtı. Ultralytics Platform çıkarım kıyaslamalarından hesaplandı.
Engine taşınabilirliği ve dinamik girdi boyutları#
Varsayılan olarak TensorRT engine’i, oluşturulduğu GPU’ya ve onu oluşturan TensorRT sürümüne bağlıdır; bu nedenle RTX 4090’da oluşturulan bir engine’in H100’e veya Jetson’a kopyalanması amaçlanmaz. TensorRT’de bu kısıtlamaları gevşeten donanım ve sürüm uyumluluğu seçenekleri bulunur; ancak varsayılan güvenli yaklaşım, engine’i dağıtım yapacağın cihazda veya bu cihaz için oluşturmak ve TensorRT’yi yükselttikten sonra yeniden oluşturmaktır. Ultralytics Platform’da Export sekmesi, bu nedenle TensorRT aktarımlarında GPU türünü seçmeni ister. ONNX dosyası böyle bir kısıtlamaya sahip değildir: ONNX Runtime ve uygun bir yürütme sağlayıcısının bulunduğu her yerde aynı dosya çalışır.
Her iki biçim de değişken girdi boyutlarını destekler. TensorRT’de dinamik şekiller, en küçük, en uygun ve en büyük girdi boyutlarını belirleyen bir optimizasyon profili gerektirir; çalışma zamanındaki girdilerin bu profile uyması gerekir. Ultralytics YOLO modellerini aktarırken dynamic=True, ONNX ve TensorRT için dinamik girdi şekillerini etkinleştirir. NVIDIA’nın dinamik şekiller kılavuzunda açıklandığı gibi sabit şekiller, TensorRT’ye daha fazla optimizasyon olanağı sağlar; bu nedenle dinamik şekilleri yalnızca girdilerin gerçekten değiştiği durumlarda kullan ve her iki seçeneği de kıyasla.
ONNX Runtime ve TensorRT’yi ne zaman seçmeli?#
- Bulutta veya şirket içinde NVIDIA GPU, gecikme önemli: Önce FP16 ile TensorRT kullan. Daha büyük modellerde INT8’i deneyip kalibrasyonunu yap ve doğrula.
- Uçta NVIDIA Jetson: TensorRT. NVIDIA Jetson kılavuzuna göz at.
- CPU, NVIDIA dışı donanım veya karma filolar: Her makinenin desteklediği yürütme sağlayıcısını kullanarak ONNX’i ONNX Runtime ile çalıştır.
- Dağıtım donanımını henüz bilmiyorsun: Önce ONNX’e aktar. Aynı modelden daha sonra bir TensorRT engine oluşturabilirsin.
- Intel CPU’lar, GPU’lar veya NPU’lar: Intel’in çıkarım araç seti olan OpenVINO’yu değerlendirebilirsin.
Biçimlerin tam listesi ve karşılaştırmaları için model dağıtım seçenekleri kılavuzuna bak. Tek ayar hassasiyet değil: model boyutu ve girdi çözünürlüğü de önemli; ayrıca budama ve nicemleme kılavuzumuz, modeli küçültmenin iki başka yolunu ele alıyor.
Ultralytics YOLO’yu ONNX ve TensorRT’ye aktarma#
Ultralytics YOLO, tek bir format argümanıyla her iki biçime de aktarım yapar; aktarılan model üzerinde doğrudan tahmin veya doğrulama çalıştırabilirsin:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX Runtime için ONNX FP16
model.export(format="engine", quantize=16)  # Bu GPU’da oluşturulan TensorRT FP16 engine’i
# Bunun yerine INT8 kullanacaksan bir veri kümesi YAML dosyasıyla kalibrasyon yap (coco8.yaml küçük bir demo kümesidir; kendi veri kümeni kullan):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 FP16’yı, quantize=8 ise INT8’i seçer. Her iki engine aktarımı da yolo26n.engine dosyasını oluşturur; bu nedenle bunlardan yalnızca birini çalıştır. INT8 için kalibrasyonda dağıtımda kullanacağın görüntülere benzer görüntülerin kullanılması amacıyla data değerini kendi veri kümesi YAML dosyana ayarla. Tüm seçenekler için aktarım argümanlarına, ONNX ve TensorRT entegrasyon kılavuzlarına göz at veya ONNX’e aktarım ve TensorRT ile optimizasyon hakkındaki adım adım yazılarımızı izle. Ultralytics Platform’da eğitilmiş modelleri tarayıcında da aktarabilirsin.
Sık sorulan sorular
ONNX bir model biçimidir, engine değildir; bu nedenle adil karşılaştırma ONNX Runtime ve TensorRT arasındadır. 19 NVIDIA GPU’da Ultralytics YOLO26 için yapılan Ultralytics Platform kıyaslamalarında, TensorRT FP16 her GPU’da ONNX Runtime üzerindeki yayımlanmış ONNX FP16 sonuçlarından daha hızlıydı. Model boyutlarına göre hesaplanan medyan hız artışı 1.85x ile 2.55x arasında, mAP50-95 farkı ise en fazla 0.001’di. Kıyaslama, ONNX sonuçlarını hangi ONNX Runtime yürütme sağlayıcısının ürettiğini belirtmiyor ve hiçbir sonucu ONNX Runtime’ın TensorRT yürütme sağlayıcısını kullanıyor olarak etiketlemiyor; bu nedenle ONNX Runtime API’sine ihtiyacın varsa bu birleşimi kendin test et.
Evet. ONNX, TensorRT’nin olağan girdisidir: ONNX ayrıştırıcısı modeli okur ve modelden bir engine oluşturur. ONNX Runtime, TensorRT yürütme sağlayıcısı aracılığıyla TensorRT’yi de çağırabilir.
Hayır. Ultralytics Platform kıyaslamalarında, TensorRT INT8, 19 GPU’nun 17’sinde YOLO26n için TensorRT FP16’dan daha yavaştı. Her biçimi çalıştıran 19 GPU genelinde medyan hız artışı YOLO26m ve YOLO26x’te yaklaşık 1.2x olmak üzere, büyük modellerde daha sık hızlıydı. Her seferinde 0.034 ile 0.076 mAP50-95 arasında kayba yol açtı; bu nedenle INT8 modelini önce kendi verilerinle doğrula.
Buna güvenme. Varsayılan olarak TensorRT engine’i oluşturulduğu GPU’ya ve TensorRT sürümüne bağlıdır; bu nedenle engine’i dağıtım yapacağın cihazda veya bu cihaz için oluştur. ONNX dosyasını taşınabilir kopya olarak sakla ve her hedef cihaz için engine’i yeniden oluştur.
Genellikle TensorRT tercih edilir: NVIDIA JetPack TensorRT’yi içerir ve engine’i Jetson’ın kendisinde oluşturmak cihaz için optimizasyon sağlar. Yukarıdaki kıyaslamalarda Jetson yer almadığından karar vermeden önce kendi modülünde ölçüm yap. NVIDIA Jetson kılavuzu, Ultralytics YOLO için kurulum ve aktarım adımlarını anlatır.
Yazan
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









