Otomatik etiketleme için Qwen4-Max: öne çıkan veri kümeleri, dengesiz kazanımlar
Qwen4-Max, otomatik etiketleme kıyaslamamızda 51 model arasında 13. sırada; bilek röntgenlerinde birinci, perakende raflarında ikinci. Doğruluk, maliyet ve nasıl çalıştırılacağı.
 Miles Deans11 dakikalık okuma
Alibaba, Qwen ailesinin bugüne kadarki en yetenekli modeli olduğunu belirttiği; yerel görme yeteneğine ve bir milyon tokenlık bağlam penceresine sahip Qwen4-Max'i 16 Kasım 2026'da yayımladı. Aynı gün modeli 36 veri kümeli nesne algılama kıyaslamamızdan geçirdik.
Genel olarak Qwen4-Max, VLM Sıralama Tablosu'nda 51 model arasında 13. sırada yer alıyor; 1.000 görüntü başına 5,68 $ maliyetle 0.474 mAP50 puanı alıyor. Bu ortalama, daha çarpıcı bir sonucu gizliyor. Çocuk bileği röntgenlerinde test ettiğimiz tüm modeller arasında en yüksek puanı alıyor; su altı sahnelerinde ve yoğun perakende raflarında ise yalnızca Gemini 4 Carbon'un gerisinde kalıyor.
Qwen4-Max, Ultralytics Platform'da artık otomatik etiketleme için Alibaba'nın sunduğu seçenek ve Qwen3.8-Max'in yerini alıyor. Aşağıda modelin nerelerde öne çıktığını, nerelerde yetersiz kaldığını, karşılaştırabileceğin modeller arasındaki yerini ve bir etiketleme grubunun maliyetini bulabilirsin.
Qwen4-Max, UL37'de 51 model arasında 13. sırada, bilek röntgenlerinde ise birinci#
UL37, model kutularının 360 görüntüdeki insan etiketleriyle ne kadar örtüştüğünü ölçer: tıbbi taramalardan hava görüntülerine, perakende raflarından spora ve devre kartlarına uzanan 36 gerçek nesne algılama veri kümesinin her birinden 10 görüntü. Her veri kümesi ortalamada eşit ağırlığa sahiptir ve her görüntü, veri kümesinin kendi sınıf adları ve her kutuyu iyileştiren SAM 3.1 ile Platform kullanıcılarının kullandığı üretim sürecinden geçirilir; dolayısıyla puanlar ham model çıktısını değil, bu iyileştirilmiş süreci yansıtır. Yöntem herkese açıktır.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Sıralamadaki yeri | #51 model arasında 13. | #51 model arasında 15. | #51 model arasında 3. | #51 model arasında 11. | #51 model arasında 16. |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Kesinlik | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Duyarlılık | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Sağlayıcı maliyeti / 1.000 görüntü | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Görüntü başına medyan süre | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Başarısız istekler | 0% | 1.7% | 0% | 0% | 6.4% |
19 Kasım 2026'da güncellenen Ultralytics VLM Sıralama Tablosu'ndaki UL37 sonuçları. Qwen3.8-Max artık Platform'da sunulmuyor.
Qwen4-Max, tüm temel metriklerde Qwen3.8-Max'ten daha iyi sonuç veriyor, görüntü başına daha ucuza mal oluyor ve tüm kıyaslama isteklerini tamamladı. Yine de ortalamada liderlerin oldukça gerisinde: GPT-6.1 Terra, daha düşük maliyetle ve sürenin yarısından çok daha kısa bir zamanda 0.560 puan alıyor.
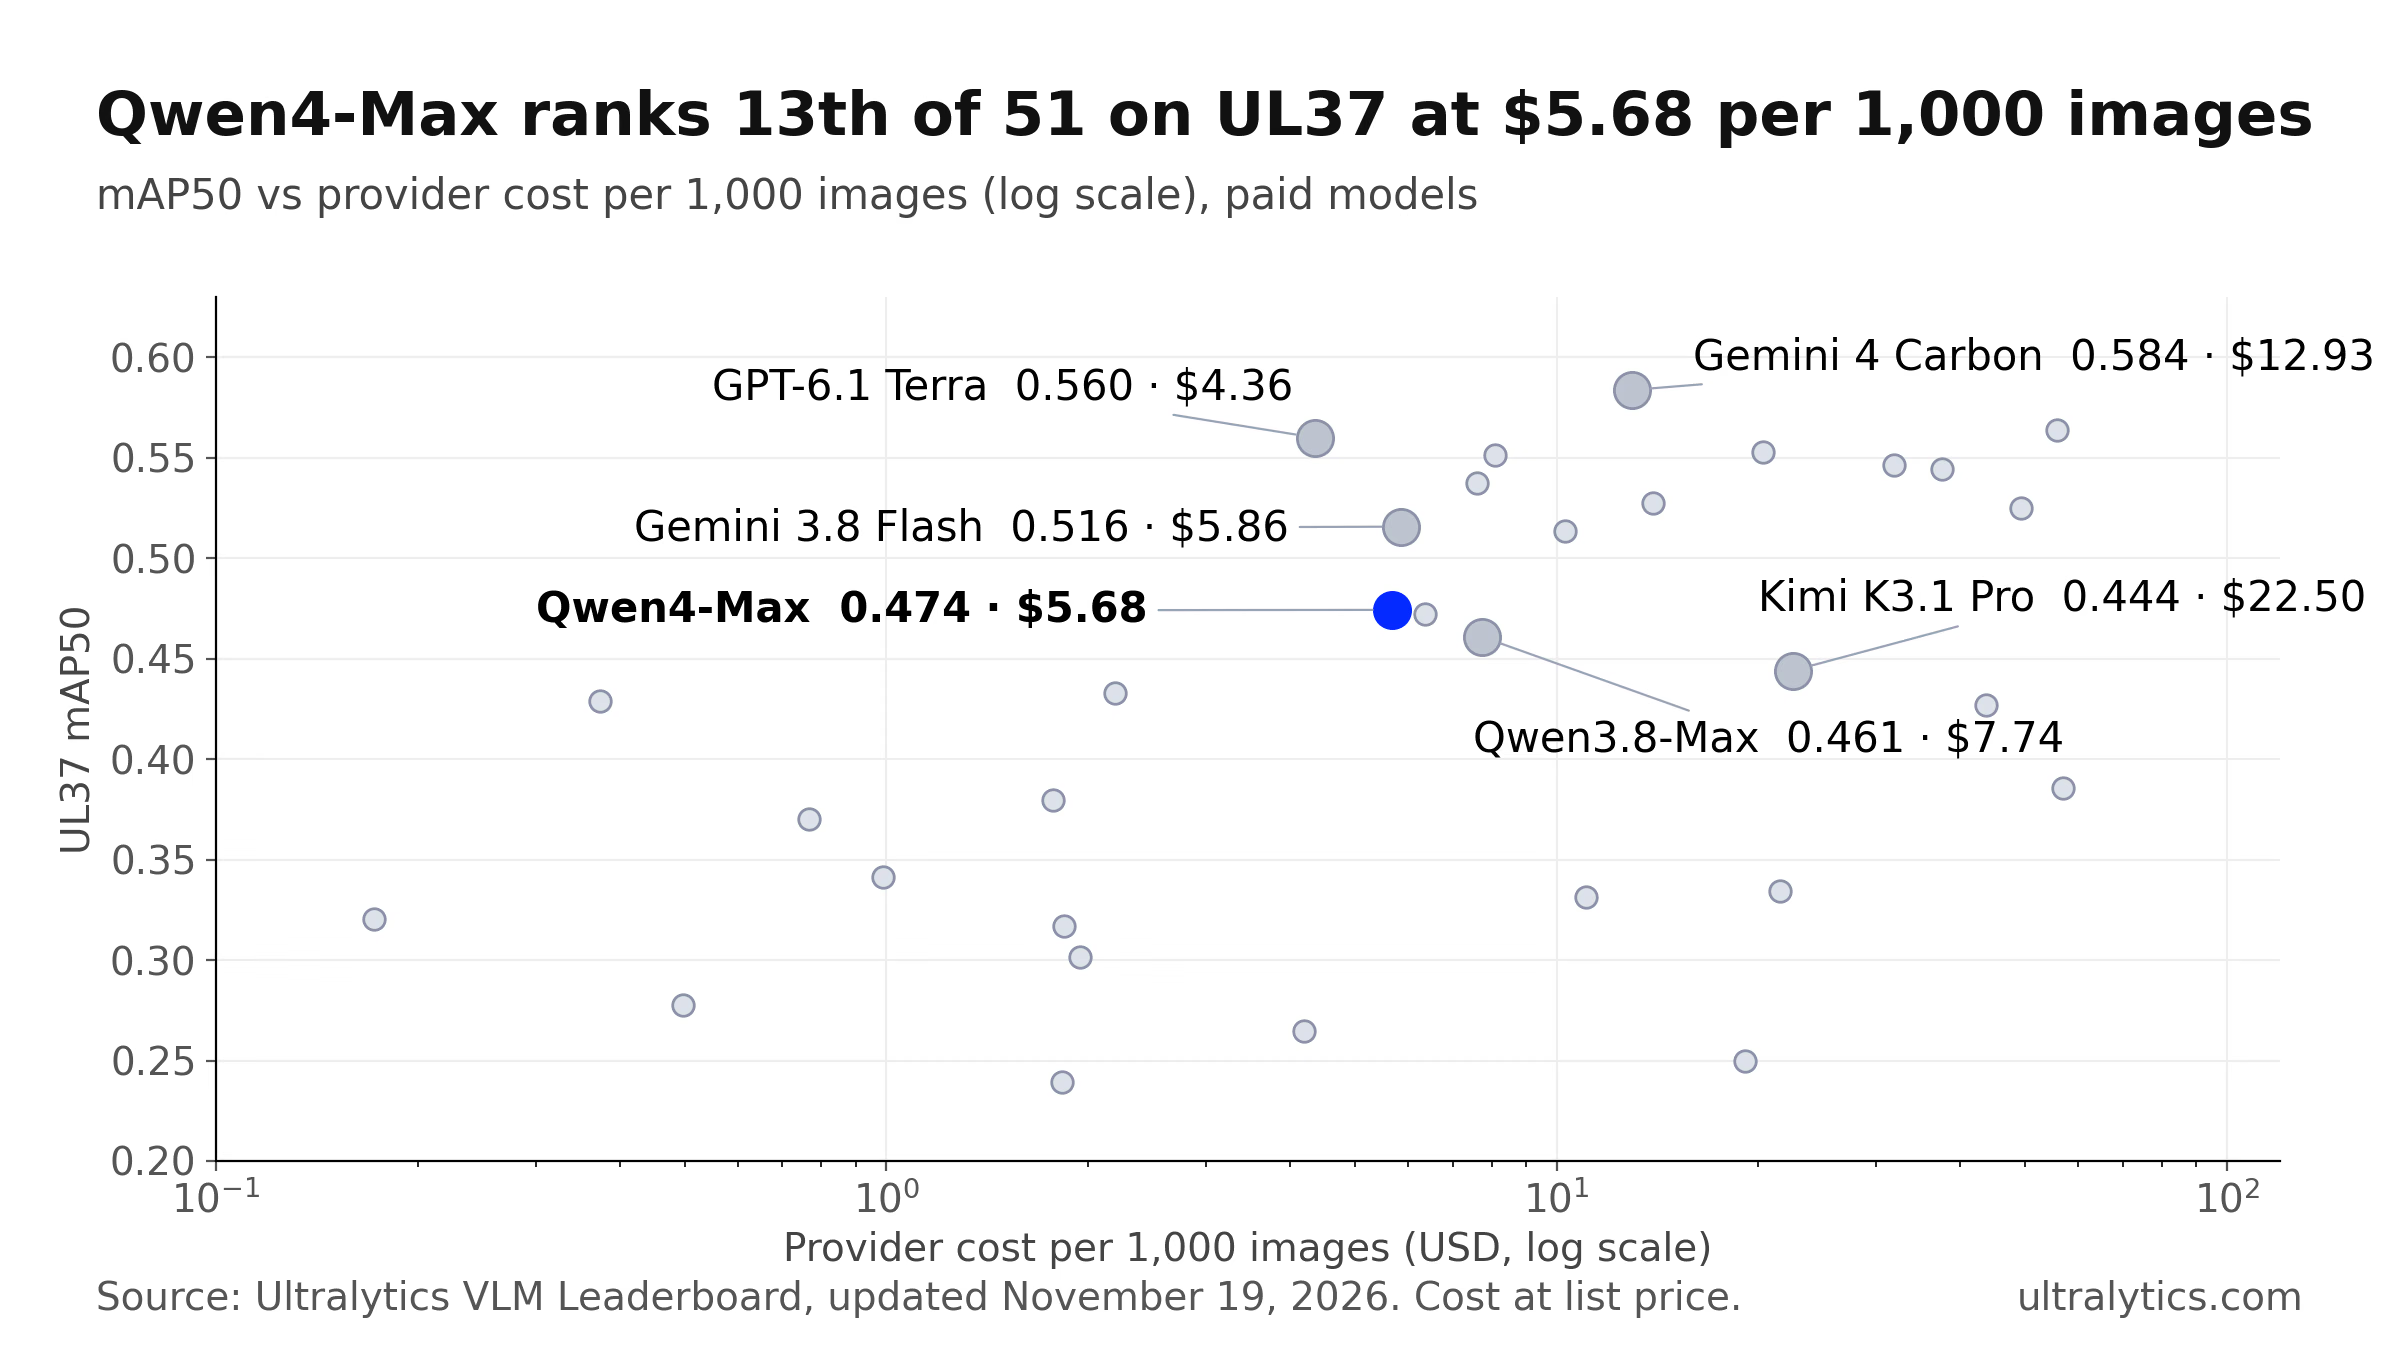
Her nokta, Ultralytics VLM Sıralama Tablosu'ndaki ücretli bir modeli gösterir.
Alibaba, Qwen4-Max'i ne için geliştirdi?#
Alibaba, lansman duyurusunda Qwen4-Max'i toplam 2,4 trilyon parametreye sahip, her token için 71 milyar parametresi etkin olan ve yerel görme yeteneği bulunan seyrek bir Uzmanlar Karışımı modeli olarak tanımlıyor. Kodlama, ajan görevleri ve görsel akıl yürütme becerilerini vurguluyor ve kendi Work360 kıyaslamasında Qwen4-Max'in Qwen3.8-Max'ten daha iyi sonuç verirken görev başına ortalama maliyeti yaklaşık %60 azalttığını bildiriyor.
Alibaba Cloud'un Model Studio sürüm notlarında model, "Qwen ailesinin metin üretimini, görüntü ve video anlama yeteneklerini ve derin akıl yürütmeyi bir araya getiren yeni nesil amiral gemisi çok modlu modeli" olarak tanımlanıyor. Uluslararası fiyatı, Qwen3.8-Max için 2 $ ve 6 $ iken, milyon giriş token'ı başına 1,50 $, milyon çıkış token'ı başına 4,50 $. Model Alibaba'nın API'si üzerinden sunuluyor; Alibaba, daha küçük açık ağırlıklı Qwen4 modellerinin de geleceğini söylüyor.
Ne duyuruda ne de sürüm notlarında nesne algılama sonuçları bildiriliyor; biz de bunu ölçtük.
Qwen4-Max ve Qwen3.8-Max: daha ucuz, kazanımları dengesiz#
Qwen4-Max, 19 veri kümesinde öncülünü geçiyor, 16'sında geride kalıyor ve birinde berabere kalıyor. Ortalama 0.013 mAP50 kazanımı, bazı veri kümelerindeki büyük iyileşmelerin diğerlerindeki belirgin düşüşlerden ağır basmasıyla elde ediliyor.
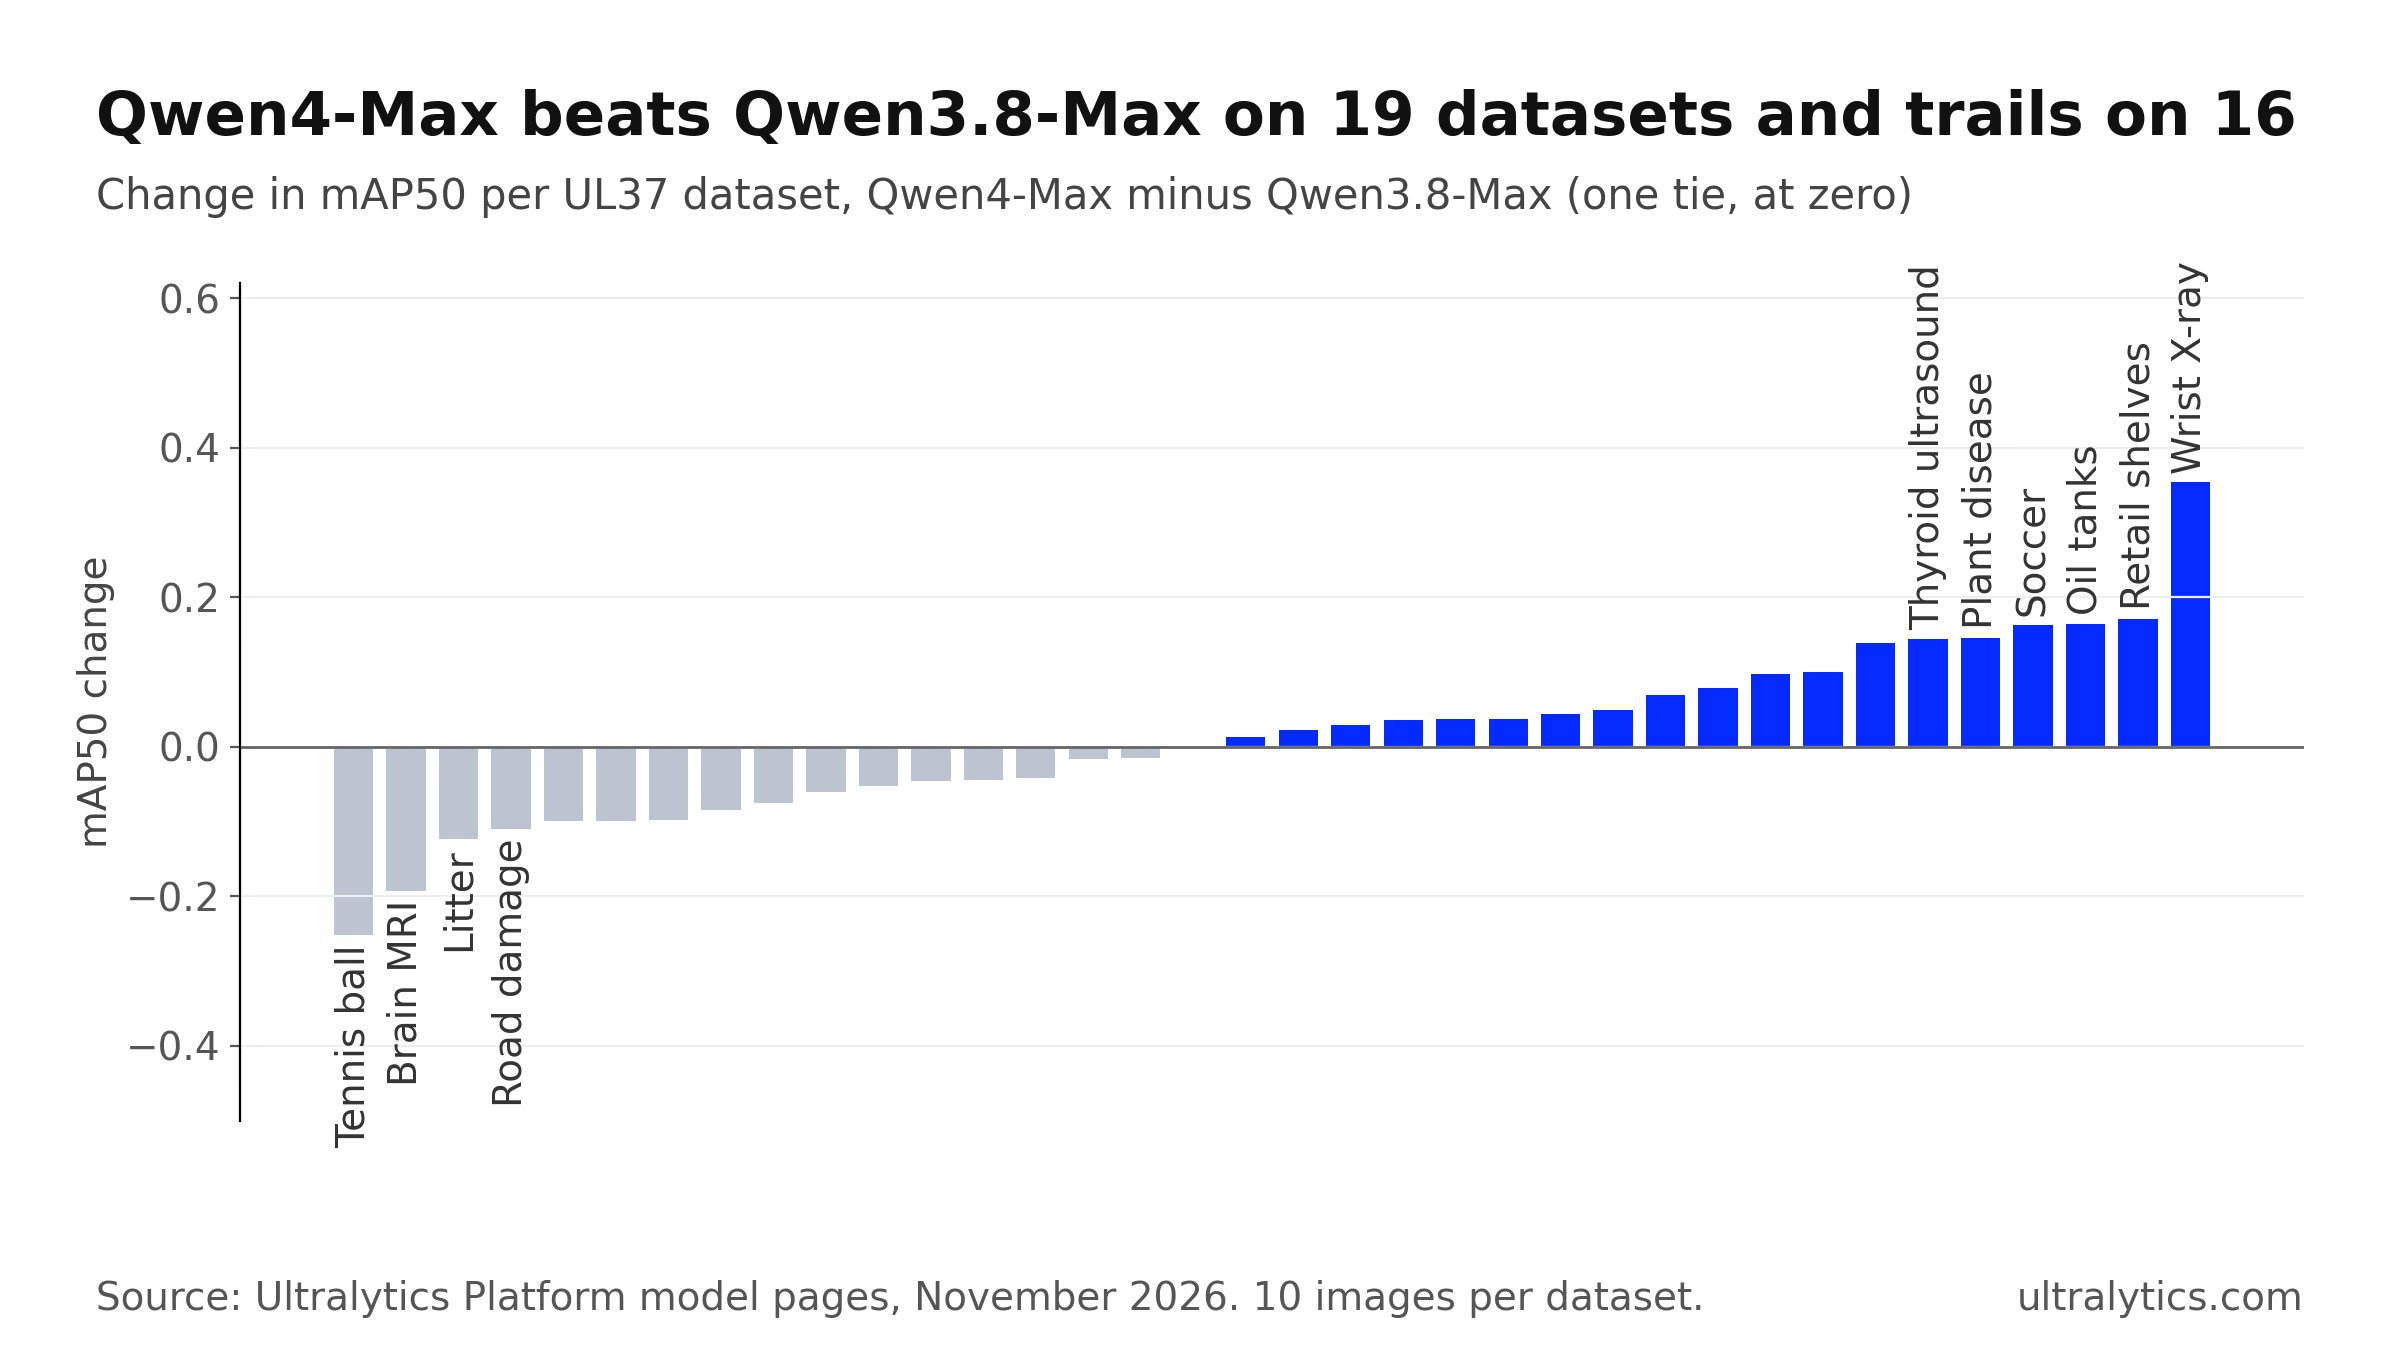
Her çubuk bir UL37 veri kümesini gösterir; en büyük düşüşten en büyük kazanıma doğru sıralanmıştır.
| Veri kümesi | Qwen4-Max | Qwen3.8-Max | Değişim |
|---|---|---|---|
| GRAZPEDWRI-DX çocuk bileği röntgeni | 0.4975 | 0.1437 | +0.3538 |
| SKU110K yoğun perakende rafları | 0.6230 | 0.4516 | +0.1714 |
| Airbus petrol depolama tankları | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB futbol | 0.8345 | 0.6715 | +0.1630 |
| RacketVision tenis topu | 0.3775 | 0.6299 | −0.2524 |
| Cheng beyin tümörü MRI | 0.4421 | 0.6350 | −0.1929 |
Her veri kümesinden 10 görüntüyle, her değişimin iki puanla eşleşmesi için dört ondalık basamakla gösterilen veri kümesi başına UL37 mAP50.
Maliyet düşüşü daha belirgin. 1.000 görüntü başına 7,74 $ yerine 5,68 $ maliyetle Qwen4-Max, çalıştırmamızda görüntü başına yaklaşık %27 daha ucuza geliyor. Alibaba'nın yaklaşık %60'lık kendi verisi, farklı ayarlara sahip başka bir kıyaslamadan geliyor; bu nedenle iki değer doğrudan karşılaştırılamaz.
Qwen4-Max'in öne çıktığı alanlar#
Üç sonuç, Qwen4-Max'i yalnızca Qwen ailesinin değil, tüm sıralama tablosunun üst sıralarına taşıyor.
| Veri kümesi | Qwen4-Max | 51 model arasındaki sırası | Lider |
|---|---|---|---|
| GRAZPEDWRI-DX çocuk bileği röntgeni | 0.4975 | 1st | Qwen4-Max (sonraki: Muse Ember 1.0, 0.378) |
| RUOD su altı nesneleri | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| SKU110K yoğun perakende rafları | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
Veri kümesi başına UL37 mAP50. Ultralytics VLM Sıralama Tablosu'ndaki 51 model arasındaki sırası.
Bilek röntgenleri. Çocuklarda bilek travması röntgenlerinde Qwen4-Max 0.4975 puan alıyor; test ettiğimiz diğer tüm modellerin önünde ve Qwen3.8-Max'in üç katından fazla. Her veri kümesine 10 görüntü katkı sağlıyor; bu nedenle sonucu kesin hüküm değil, denemeye değer güçlü bir işaret olarak değerlendir. Bu bir teşhis veya klinik doğrulama da değildir: tıbbi görüntü analizi araştırmalarındaki etiketleme çalışmaları için Qwen4-Max, klinik uzmanların kontrol edip düzelteceği kutular oluşturabilir.
Perakende rafları. UL37'nin iki perakende veri kümesinin ortalamasında Qwen4-Max 0.752 puan alıyor; GPT-6.1 Terra'nın 0.724 puanının önünde. Rafların tek bir sınıfa ait ürünlerle uçtan uca dolu olduğu SKU110K'de yalnızca Gemini 4 Carbon'un gerisinde kalıyor.
Su altı sahneleri. RUOD'un su altı nesnelerinde aldığı 0.774 puanla 51 model arasında ikinci sırada ve GPT-6.1 Terra'nın 0.658 puanının önünde.
Qwen4-Max'in yetersiz kaldığı alanlar#
Eksiklikler de başarılar kadar belirgin. Qwen4-Max, DeepPCB çıplak devre kartı kusurlarında 0.000, IEDXray güvenlik taramalarında 0.05 puan alıyor; Gemini 4 modelleri bu alanlarda yaklaşık 0.30'a ulaşıyor. Tüberküloz için göğüs röntgenlerinde puanı 0.037; beyin tümörü MRI veri kümesinde ise GPT-6.1 Terra'nın gerisinde, 0.442'ye karşı 0.904 puan alıyor.
Alan bazında ortalama alındığında da belgeler, kullanıcı arayüzü ve CAD çizimlerinde (0.357'ye karşı 0.494), yollar ve trafikte (0.396'ya karşı 0.572) ve genel olarak tıbbi görüntülemede (0.325'e karşı 0.505) GPT-6.1 Terra'nın gerisinde kalıyor. Bu alanlardan herhangi birinde büyük bir veri kümesini etiketlemeden önce, kaydedilmiş kutularını beklenen etiketlerin yanında her kıyaslama veri kümesinde yeniden gösteren Qwen4-Max model sayfasını aç.
Qwen4-Max ve GPT-6.1 Terra, Gemini 3.8 Flash ve Kimi K3.1 Pro karşılaştırması#
| Bire bir karşılaştırma, 36 UL37 veri kümesi | Qwen4-Max kazanır | Kaybeder | Berabere |
|---|---|---|---|
| GPT-6.1 Terra ile | 11 | 23 | 2 |
| Gemini 3.8 Flash ile | 17 | 18 | 1 |
| Kimi K3.1 Pro ile | 21 | 14 | 1 |
| Qwen3.8-Max ile | 19 | 16 | 1 |
GPT-6.1 Terra genel kullanım için daha güçlü bir seçenek: Qwen4-Max'in 11 veri kümesine karşı 23 veri kümesinde kazanıyor, daha ucuza mal oluyor ve medyan yanıt süresi yarıdan daha kısa. Gemini 3.8 Flash, benzer fiyata veri kümelerinde neredeyse başa baş sonuç veriyor ve ortalama puanı daha yüksek. Kimi K3.1 Pro karşısında Qwen4-Max, görüntü başına yaklaşık dörtte bir maliyetle 14'e karşı 21 veri kümesinde kazanıyor.
Ultralytics Platform, Qwen4-Max'i nasıl çalıştırıyor?#
Platform'daki Qwen4-Max sonuçlarını iki ayar şekillendiriyor. İlk olarak, Alibaba'nın varsayılan "high" ayarı yerine "low" akıl yürütme düzeyinde çalışıyor. Ultralytics'in 370 kıyaslama görüntüsüyle yaptığı testlerde (puanlanan 360 görüntü ve 10 COCO referans görüntüsü), varsayılan ayar Platform'un 115 saniyelik istek sınırını 11 görüntüde, "low" ayarı ise 3 görüntüde aştı; her iki ayarın mAP50 değeri aynıydı. İkinci olarak, Platform Qwen modellerinden kompakt JSON çıktısı istiyor; çünkü bu çıktı olmadığında modeller yaklaşık 0.02 mAP50 kaybediyor.
Bu ayarların ikisi için de herhangi bir şey yapman gerekmiyor: model seçicisinden Qwen4-Max'i seç, Platform ikisini de uygular.
Qwen4-Max ile bir etiketleme grubunun maliyeti#
Sağlayıcı maliyeti, Alibaba'nın bildirdiği token kullanımının model için Platform ücretleri üzerinden hesaplanan, başarıyla etiketlenmiş 1.000 görüntü başına tutarıdır; kendi görüntülerin daha fazla veya daha az token kullanabilir. Toplu Etiketleme, her 1.000 görüntü için 1,00 $ Platform işlem ücreti ekler; çalışma başına en düşük ücret 0,01 $'dır.
| 1.000 görüntü başına | Qwen4-Max |
|---|---|
| Alibaba'nın ücreti | $5.68 |
| Ultralytics Platform işlem ücreti | $1.00 |
| Toplam | $6.68 |
Önce çalıştırdığın test tahminleri de dahil olmak üzere ödemeyi kendi API anahtarınla doğrudan Alibaba'ya yaparsın; Ultralytics token ücretlerine ek ücret koymaz. Ücretli bir anahtar hiç kullanmamayı tercih edersen Platform'da barındırılan Qwen3.8 27B, UL37'de 0.351 mAP50 puanıyla anahtar olmadan çalışır.
Ultralytics Platform'da Qwen4-Max otomatik etiketleme nasıl çalıştırılır?#
Qwen4-Max, 1 ila 200 sınıflı algılama veri kümeleri için sınıf istemiyle çalışan bir modeldir. Veri kümenin kendi sınıf adları için sınırlayıcı kutular döndürür; bunları daha sonra gözden geçirip düzeltirsin.
- Platform'un kullandığı uç noktanın bulunduğu uluslararası (Singapur) bölgesi için Alibaba Cloud Model Studio'da bir API anahtarı oluştur.
- Çalışma alanı sahibinden, veri kümenin bulunduğu çalışma alanındaki Settings > API Keys bölümünde Alibaba altında anahtarı eklemesini iste. Ayrıntılar için sağlayıcı anahtarı belgelerine bak.
- Etiketleme düzenleyicisinde Smart moduna geç ve model seçicisinde Alibaba altından Qwen4-Max'i seç.
- Birkaç temsilî görüntüde Predict düğmesine veya
Pöğesine bas. - Sonuçtan memnun kaldığında veri kümesi sayfasını aç ve etiketlenmemiş tüm görüntüleri etiketlemek için Diğer işlemler > Toplu Etiketleme seçeneğini belirle. Batch Annotation, en fazla üç görüntü kanalına sahip ve Platform'da barındırılan veri kümelerinde çalışır. Platform önce bir veri kümesi sürümü kaydeder; böylece önceki sürüme dönebilirsin.
- Kutuları gözden geçir, kaydet ve aynı çalışma alanında elde ettiğin sonuçla bir Ultralytics YOLO26 modeli eğit.
Etiketleme belgeleri, Smart modu ve Batch Annotation'ı ayrıntılı olarak açıklar; kesinlik ve duyarlılığa göre VLM seçme rehberimiz ise inceleme iş akışına uygun modeli seçmene yardımcı olur.
Qwen4-Max'i kimler kullanmalı?#
| Şuna ihtiyacın varsa… | Şununla başla: |
|---|---|
| Genel amaçlı ücretli bir etiketleyici | GPT-6.1 Terra: UL37 puanı daha yüksek, maliyeti daha düşük ve Qwen4-Max'ten daha hızlı |
| Uzman incelemesi için çocuk bileği röntgeni taslakları | Qwen4-Max: bu veri kümesinde 51 model arasındaki en yüksek UL37 puanı |
| Yoğun perakende rafları veya su altı sahneleri | Qwen4-Max'i dene ve kendi görüntülerinde Gemini 4 Carbon ile karşılaştır |
| Alibaba modeli arayanlar veya Qwen3.8-Max'ten geçiş yapanlar | Qwen4-Max: daha yüksek puanlar, görüntü başına daha düşük maliyet, çalıştırmamızda başarısız istek yok |
| Ücretli API anahtarı kullanmak istemeyenler | Platform'da barındırılan Qwen3.8 27B, Gemma 4 26B veya SAM 3.1 Text |
Etiketleme çalışmalarının çoğunda GPT-6.1 Terra hâlâ daha iyi bir varsayılan seçenek. Qwen4-Max, verilerin öne çıktığı veri kümelerine benzediğinde tercih edilmeye değer; bu nedenle önce kendi görüntülerinden bir örnekle dene.
Sık sorulan sorular
Birkaç dikkat çekici sonucu olan Qwen4-Max, kıyaslamamızda 51 model arasında 13. sırada yer alıyor. UL37 kıyaslamamızda 0.474 mAP50 puanı alıyor ve hiçbir isteği başarısız olmuyor. Çocuk bileği röntgenlerinde 51 model arasında birinci, su altı nesnelerinde ve yoğun perakende raflarında ikinci sırada; ancak devre kartı kusurlarında ve güvenlik röntgenlerinde düşük puan alıyor.
Ortalama olarak evet. Qwen4-Max, Qwen3.8-Max'in 0.461 puanına karşılık 0.474 mAP50 alıyor; 1.000 görüntü başına 7,74 $ yerine 5,68 $'a mal oluyor ve Qwen3.8-Max'in %1,7 başarısız olduğu tüm istekleri tamamlıyor. Kazanımlar dengesiz: 19 veri kümesinde Qwen3.8-Max'i geçiyor, 16'sında geride kalıyor; tenis topu ve beyin MRI algılamasında büyük düşüşler var.
Genel etiketleme için GPT-6.1 Terra: 0.560 mAP50 puanı alıyor, Qwen4-Max'i 36 veri kümesinin 23'ünde geride bırakıyor, 1.000 görüntü başına 4,36 ABD dolarına mal oluyor ve medyan yanıt süresi 5,1 saniye. Verilerin bilek röntgenleri, yoğun perakende rafları veya su altı sahneleri gibi en güçlü olduğu veri kümelerine benziyorsa Qwen4-Max'i seç ve kendi görüntülerinle doğrula.
Uzmanların inceleyeceği araştırma etiketlemesi için kutu taslakları oluşturabilir; teşhis koymaz. Çocuk bilek röntgenlerinde 51 model arasındaki en yüksek UL37 puanına, 0.4975 mAP50'ye ulaşıyor ancak sekiz tıbbi veri kümemizde ortalama 0.325 puan alıyor; bu, GPT-6.1 Terra'nın 0.505 puanının altında ve göğüs röntgenlerinde performansı düşük.
Alibaba'nın ücretleri yaklaşık 5,68 ABD doları: Alibaba'nın bildirdiği token kullanımı, model için Platform ücretleri üzerinden, başarıyla etiketlenen 1.000 görüntü başına hesaplanır. Alibaba'nın uluslararası liste fiyatı, milyon girdi token'ı başına 1,50 ABD doları ve milyon çıktı token'ı başına 4,50 ABD dolarıdır. Ultralytics Platform, 1.000 görüntü başına 1,00 ABD doları Toplu Etiketleme ücreti ekler; toplam maliyet yaklaşık 6,68 ABD doları olur.
Uluslararası bir Alibaba Cloud Model Studio API anahtarı oluştur, çalışma alanının sahibinden bu anahtarı Ayarlar > API Anahtarları bölümündeki Alibaba alanına eklemesini iste, ardından etiketleme düzenleyicisinde Akıllı mod'u seçip Qwen4-Max'i seç. Birkaç görüntüyle test et, Toplu Etiketleme'yi çalıştır, kutuları gözden geçir ve aynı çalışma alanında bir Ultralytics YOLO26 modeli eğit.
Yazan
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









