GPT-6.1 Terra đứng đầu về tự động gán nhãn, vượt qua các model hàng đầu của chính OpenAI
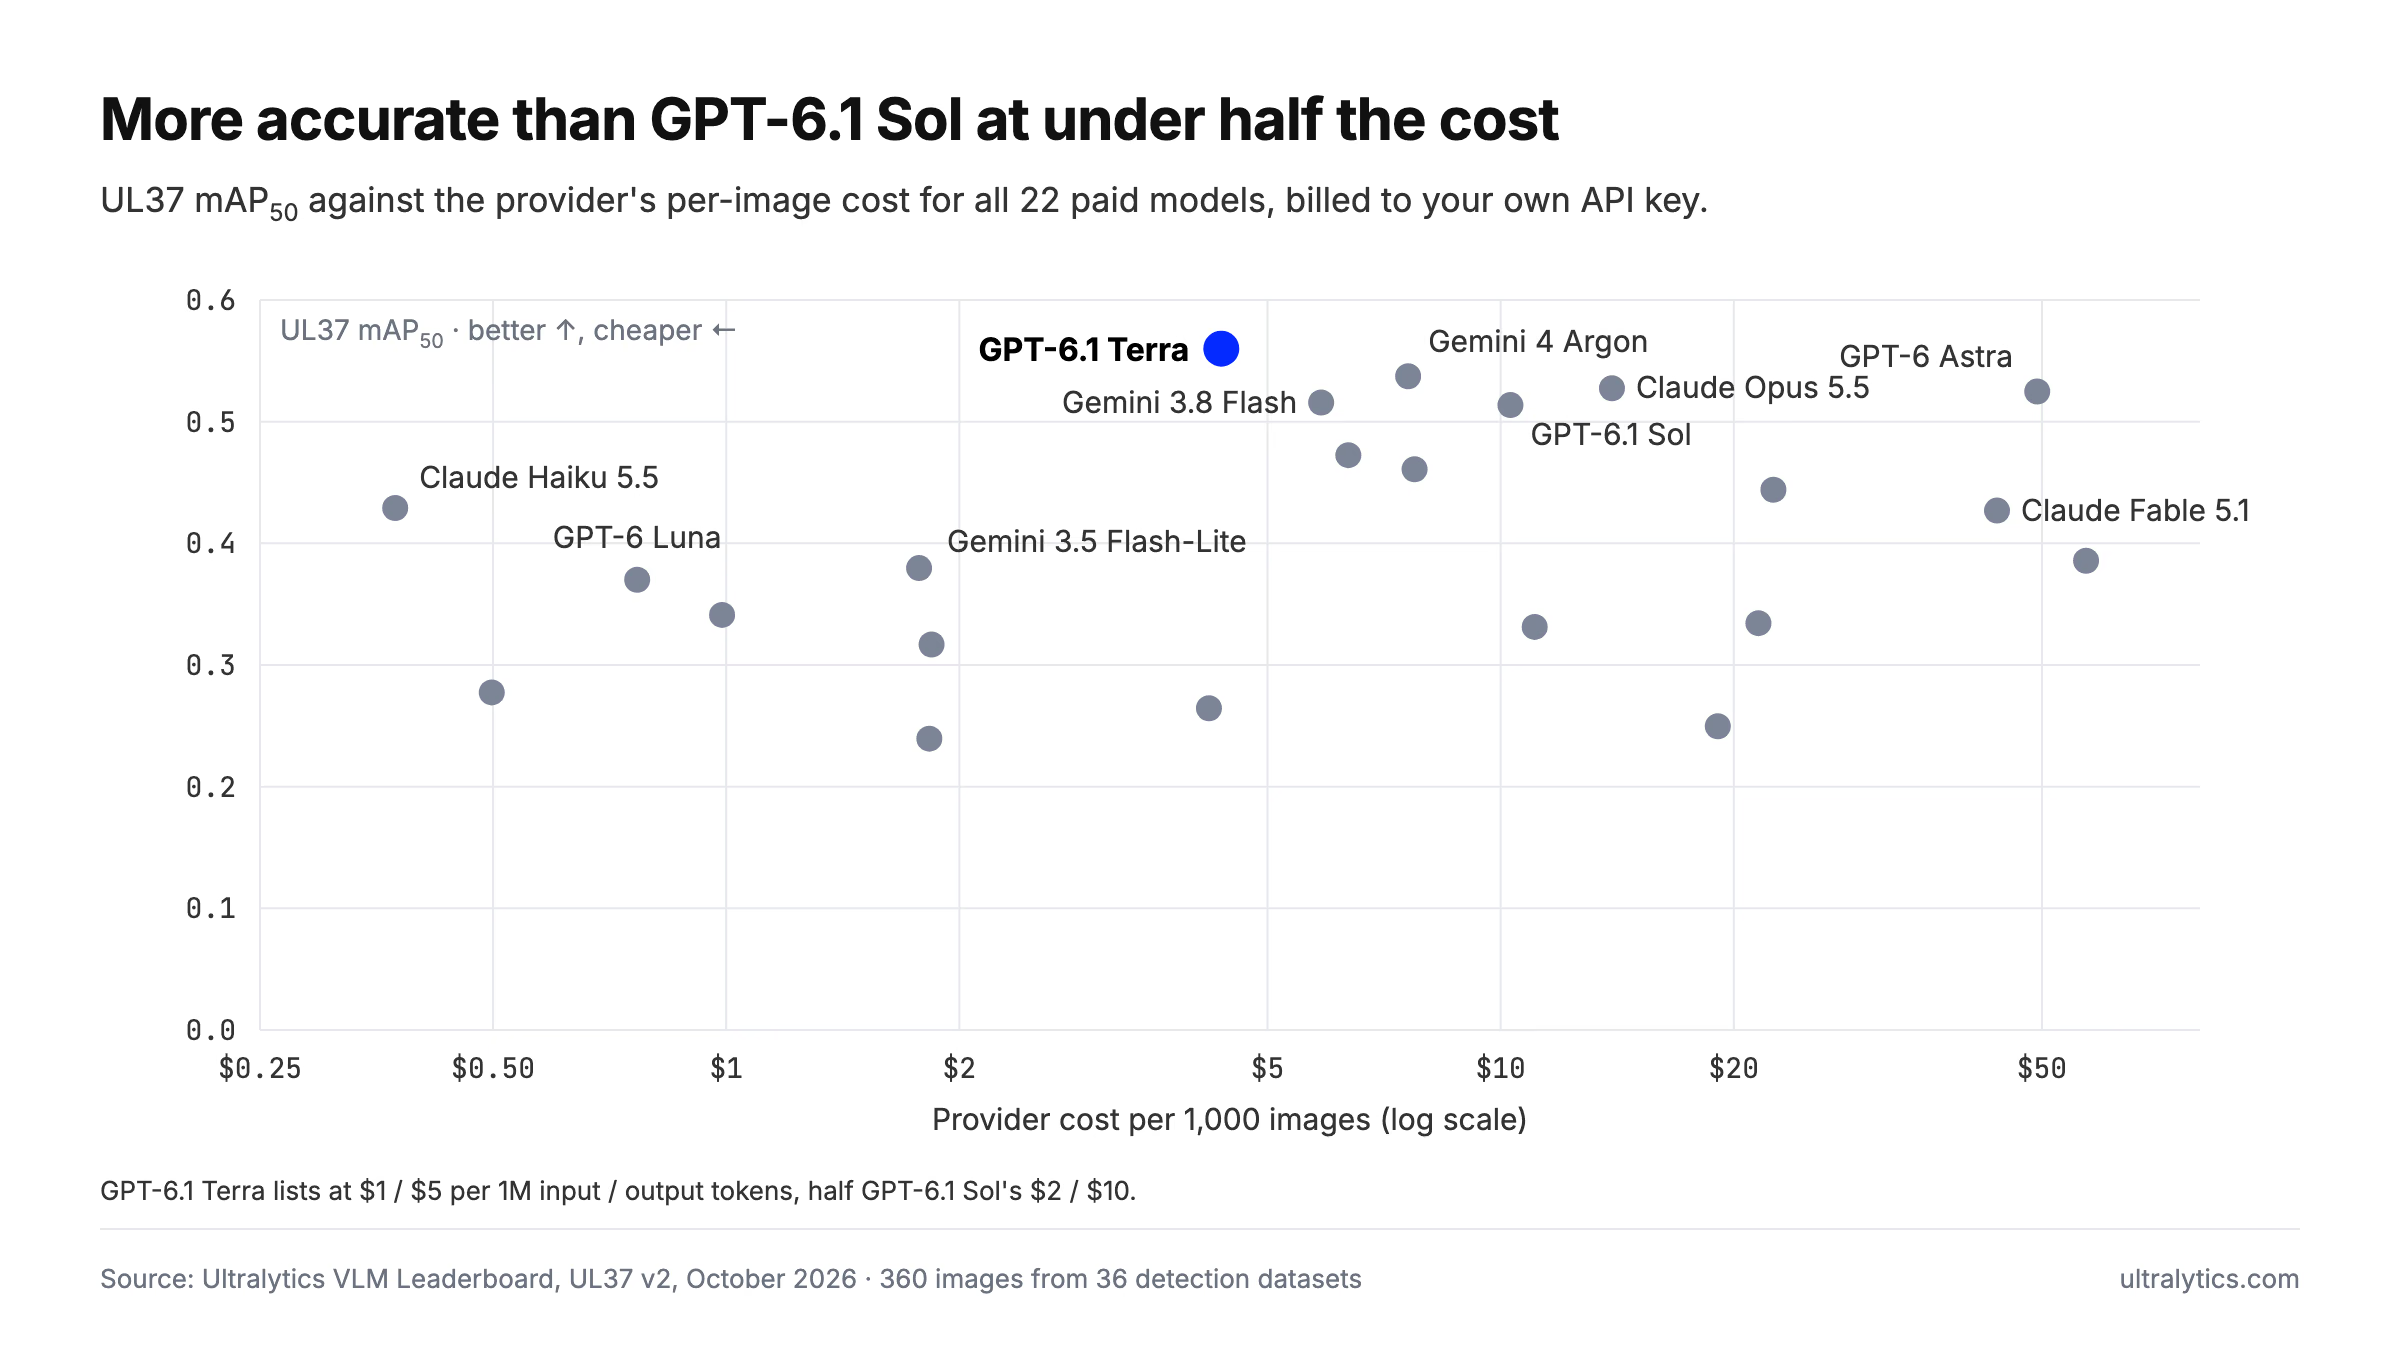
Tự động gán nhãn bằng GPT-6.1 Terra vượt qua 39 model trên Bảng xếp hạng VLM của chúng tôi: đạt 0.560 mAP50 với chi phí $4.36 cho mỗi 1.000 ảnh, cao hơn GPT-6.1 Sol và Gemini 4 Argon.
Tài liệu ra mắt của OpenAI cho biết GPT-6.1 Terra gần bắt kịp các model lớn hơn của hãng về suy luận thị giác. Khi yêu cầu model vẽ bounding box, chúng tôi nhận ra “gần” không phải là từ chính xác.
Ngày 26 tháng 10 năm 2026, ngày OpenAI phát hành model, chúng tôi đã chạy GPT-6.1 Terra để tự động gán nhãn trên UL37, benchmark phát hiện gồm 36 bộ dữ liệu của chúng tôi. Model đạt 0.560 mAP50, kết quả tốt nhất trong số 39 model trên Bảng xếp hạng VLM của chúng tôi. Model tầm trung của OpenAI vượt GPT-6.1 Sol, model flagship GPT-6 Astra và Gemini 4 Argon, model giữ vị trí đầu bảng cho đến tuần này.
Model đạt kết quả đó với chi phí $4.36 cho mỗi 1.000 ảnh, tốc độ 5.1 giây mỗi ảnh và không có yêu cầu nào thất bại. Bạn có thể sử dụng model ngay hôm nay trên Ultralytics Platform. Dưới đây là những điểm mạnh, điểm yếu và cách quyết định xem model có phù hợp với quy trình gán nhãn của bạn hay không.
GPT-6.1 Terra đứng đầu trên UL37#
UL37 đo mức độ khớp giữa các bounding box của model và nhãn do con người gán trên 360 ảnh: 10 ảnh từ mỗi trong số 36 bộ dữ liệu phát hiện đối tượng thực tế, bao gồm ảnh quét y tế, ảnh trên không, kệ hàng bán lẻ, thể thao, tài liệu, bảng mạch và nhiều lĩnh vực khác. Mỗi ảnh đi qua cùng một pipeline production mà người dùng Platform sử dụng, với tên lớp riêng của bộ dữ liệu và SAM 3.1 tinh chỉnh từng bounding box. Phương pháp đánh giá được công khai.
Bảng điểm của Terra như sau:
- mAP50: 0.560, xếp #1/39
- mAP50-95: 0.345, cũng xếp #1; điều này có nghĩa là bounding box của model khớp sát chứ không chỉ gần đúng
- Precision và recall: 0.646 và 0.613
- Chi phí nhà cung cấp: $4.36 cho mỗi 1.000 ảnh
- Thời gian trung vị mỗi ảnh: 5.1 giây
- Yêu cầu thất bại: không có
Sáu model đạt trên 0.51 trên UL37, trong đó Claude Opus 5.5 xếp thứ ba. Terra có độ chính xác cao nhất trong sáu model và cũng là model rẻ nhất.
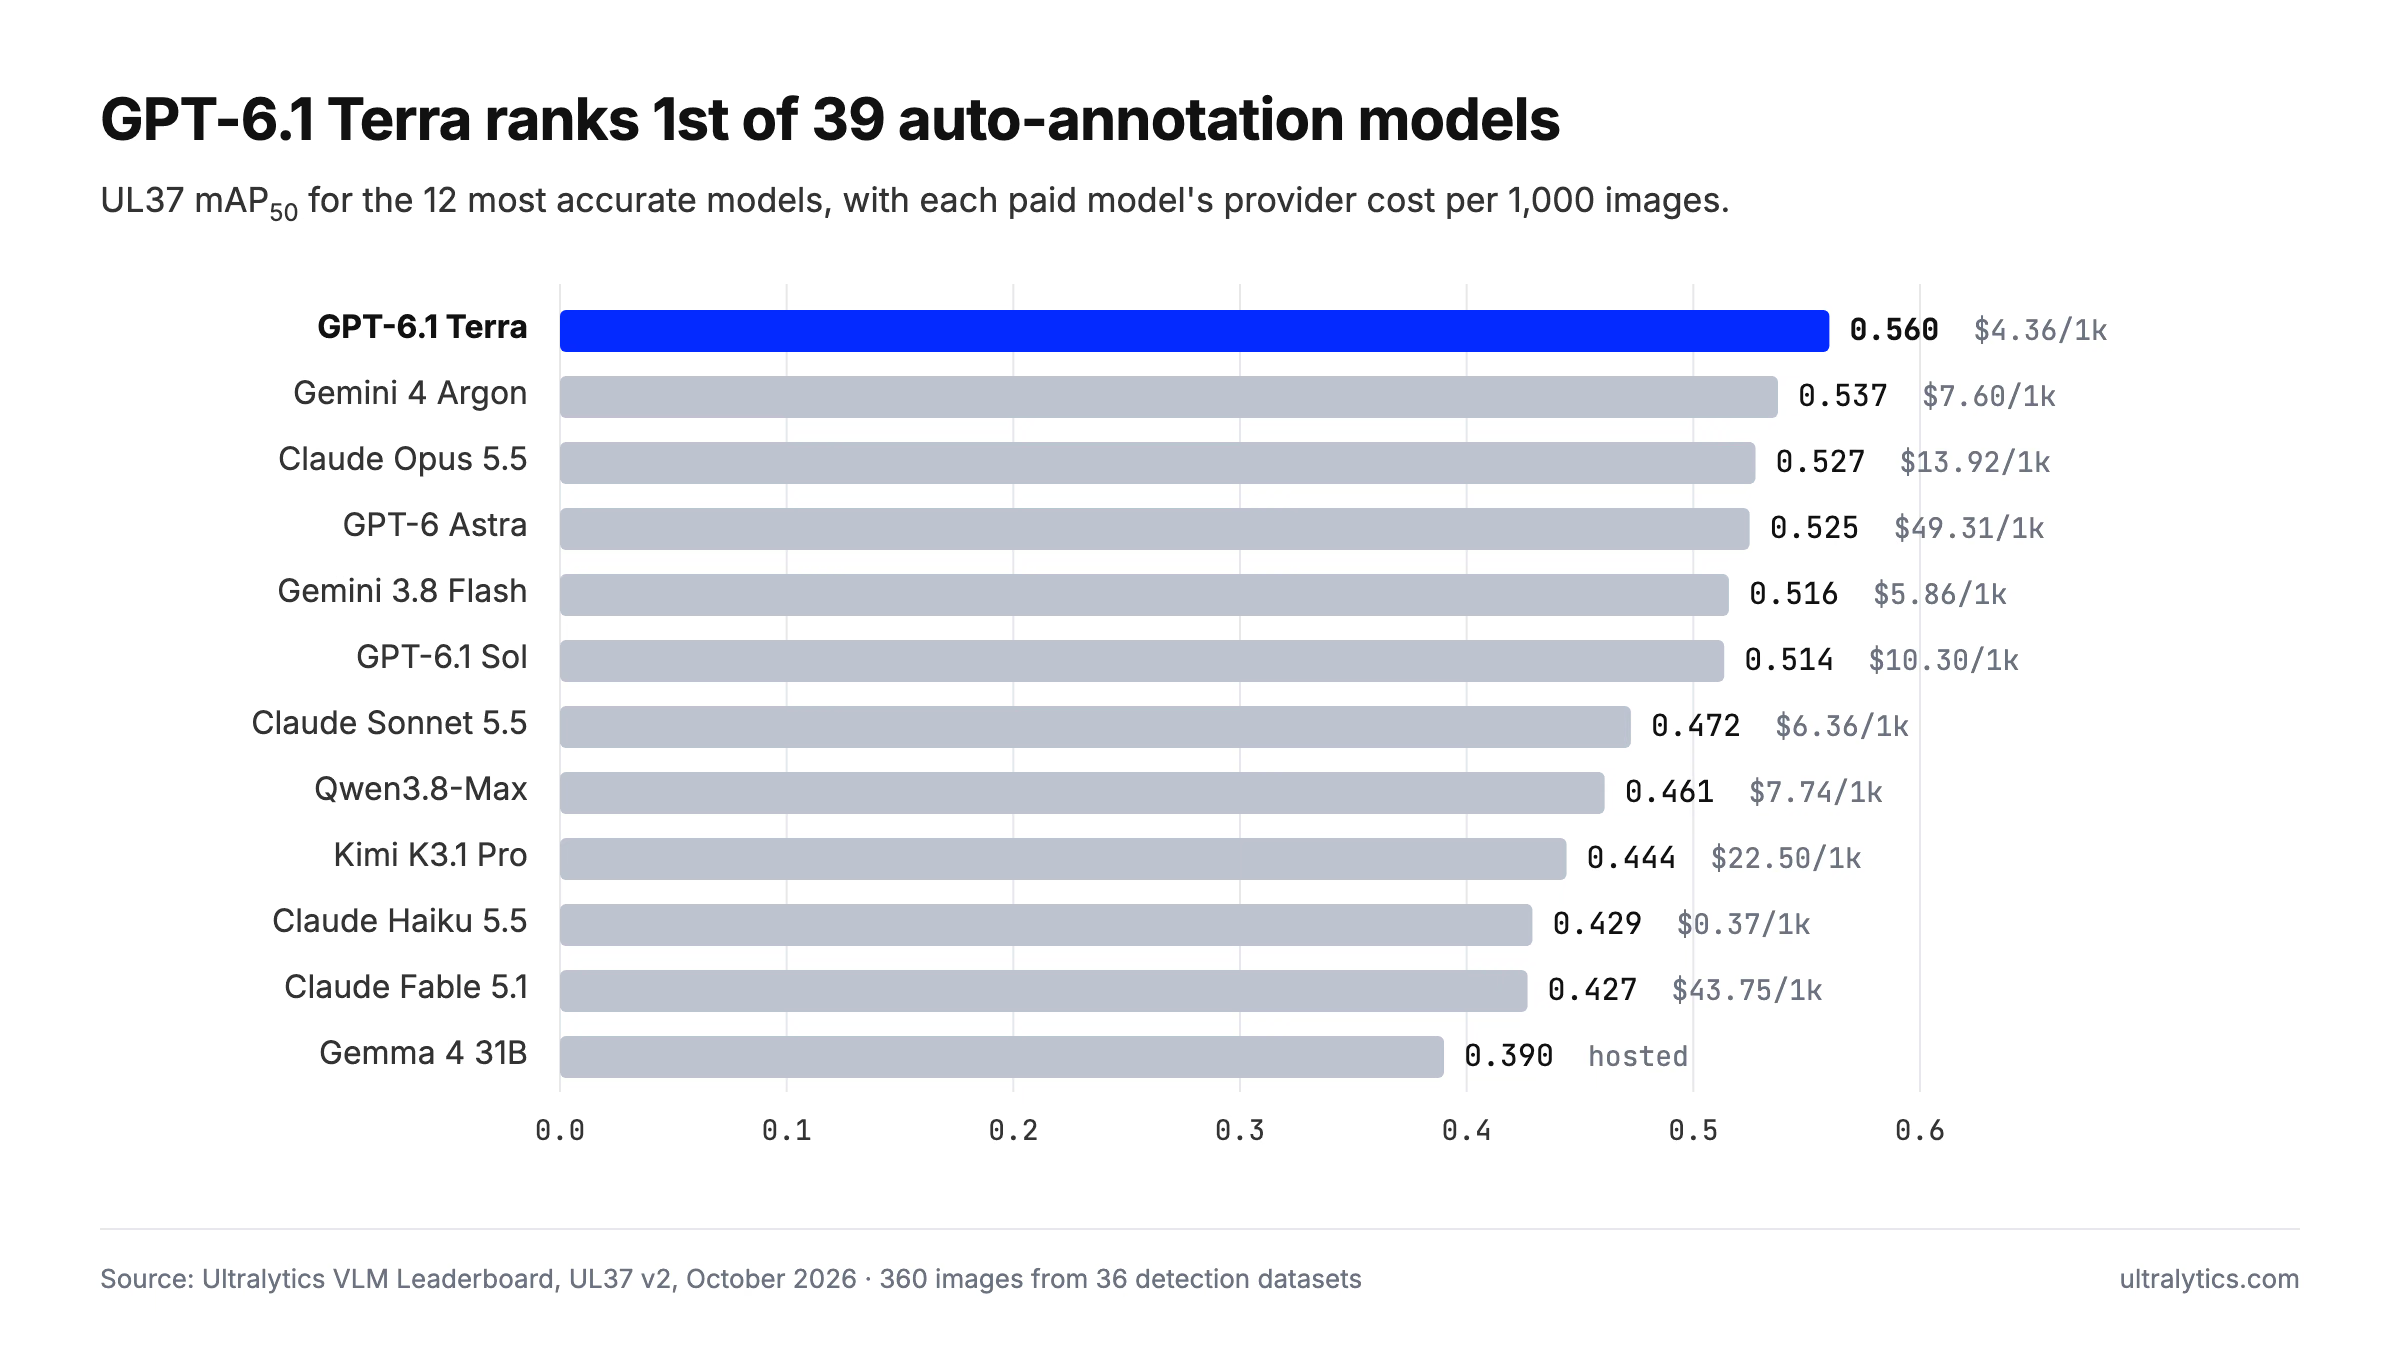
Kết quả này không phụ thuộc vào một mẹo tinh chỉnh nào. Terra chạy với mức nỗ lực suy luận mặc định của OpenAI, được nêu là medium trong tài liệu model. Model nhận cùng một yêu cầu như mọi model OpenAI khác trên Platform, với tọa độ bounding box trên lưới 0–1000. Chúng tôi tích hợp model và model lập tức đứng đầu.
Model tầm trung đạt điểm cao hơn các model flagship của OpenAI#
OpenAI định vị GPT-6.1 Terra là model tầm trung nhanh và hiệu quả trong danh mục sản phẩm. Theo các bài đưa tin về thời điểm ra mắt từ The Decoder và BleepingComputer, model kế nhiệm GPT-5.6 Terra và hướng đến các tác vụ sử dụng máy tính, suy luận thị giác, lập trình và công việc thường ngày. Model có sẵn qua API với tên gpt-6.1-terra và trong ChatGPT Work cùng Codex dành cho người dùng Plus, Pro, Enterprise và Edu. Tài liệu của OpenAI mô tả model là “model nhanh, hiệu quả cho suy luận thị giác, sử dụng máy tính chính xác và khả năng viết rõ ràng, tự nhiên”, hỗ trợ đầu vào văn bản và hình ảnh cùng cửa sổ ngữ cảnh 1,050,000 token.
Giá là $1 cho mỗi triệu token đầu vào và $5 cho mỗi triệu token đầu ra, còn đầu vào được lưu trong cache có giá $0.05. Mức giá này chỉ bằng một nửa so với $2 và $10 của GPT-6.1 Sol, và bằng một phần mười so với $10 và $50 của GPT-6 Astra, theo các trang GPT-6.1 Sol và GPT-6 Astra của OpenAI.
Các benchmark ra mắt của OpenAI mô tả Terra có hiệu năng gần bằng các model lớn hơn, chứ không vượt qua chúng. Trên MMMU-Pro, bài kiểm tra suy luận thị giác, OpenAI báo cáo Terra gần bắt kịp Astra và Sol. Trên Terminal-Bench 4.0, OpenAI báo cáo model đạt 50.3%, tăng từ 21.5% của GPT-5.6 Terra. OpenAI vẫn khuyến nghị Sol hoặc Astra cho các tác vụ lập trình khó nhất.
Xét trên lý thuyết, Terra là lựa chọn dung hòa. Trên benchmark của chúng tôi, đây là model phát hiện tốt nhất của OpenAI.
| Model OpenAI | UL37 mAP50 | Chi phí cho mỗi 1.000 ảnh | Thời gian trung vị mỗi ảnh |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5.1 giây |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra có chi phí mỗi ảnh chưa bằng một nửa GPT-6.1 Sol và chưa bằng một phần mười GPT-6 Astra. Model cũng phản hồi nhanh gần gấp đôi so với cả hai. Khi so sánh trực tiếp, Terra vượt Sol trên 22 trong số 36 bộ dữ liệu.
OpenAI cho biết Terra hoàn thành tác vụ nhanh hơn Sol và Astra hơn ba lần; tuyên bố này nói về khối lượng công việc của agent. Gán nhãn là một công việc khác, và trong bài kiểm tra đó, chúng tôi đo được tốc độ nhanh hơn Sol khoảng 2 lần, một khác biệt đáng kể khi bạn gán nhãn hàng nghìn ảnh.
Ưu thế của Terra so với Sol nằm ở precision#
Hai model tìm thấy tỷ lệ đối tượng được gán nhãn tương đương nhau. Recall của Terra là 0.613, còn Sol là 0.618. Khác biệt thể hiện rõ ở precision: Terra đạt 0.646 so với 0.551 của Sol. Tỷ lệ bounding box của Terra khớp với một đối tượng thực và có nhãn chính xác cao hơn nhiều.
SKU110K cho thấy rõ khác biệt. Ảnh trong bộ dữ liệu là các kệ siêu thị kín đặc sản phẩm từ đầu này sang đầu kia, tất cả đều thuộc một lớp. Hai model đạt recall tương tự nhau trên bộ dữ liệu này: Terra đạt 0.73 và Sol đạt 0.77. Tuy nhiên, precision của Sol trên các kệ hàng đó là 0.49, trong khi Terra đạt 0.79. Khoảng một nửa số bounding box của Sol là cảnh báo sai, so với khoảng một phần năm của Terra. mAP50 0.62 của Terra trên SKU110K là mức cao nhất mà bất kỳ model nào đạt được.
Điều này quan trọng với việc gán nhãn dữ liệu vì các lỗi không có chi phí như nhau. Bỏ sót một sản phẩm nghĩa là phải vẽ thêm một bounding box. Một bounding box sai buộc người đánh giá phải tìm nó giữa hàng chục bounding box đúng rồi xóa đi. Ít cảnh báo sai hơn giúp người đánh giá có bản nháp ban đầu sạch hơn.
Chẩn đoán hình ảnh y tế là thế mạnh nổi bật của GPT-6.1 Terra#
Mẫu hình nổi bật nhất trong kết quả của Terra nằm ở lĩnh vực y tế. UL37 bao gồm tám bộ dữ liệu y tế, và Terra đạt trung bình 0.505 mAP50 trên các bộ dữ liệu này, xếp #1/39. Hai model tiếp theo là Gemini 3.8 Flash với 0.387 và Gemini 4 Argon với 0.379. Không model nào khác trên bảng xếp hạng dẫn trước trong bất kỳ lĩnh vực nào với khoảng cách lớn hơn.
Dưới đây là điểm số của Terra trên cả tám bộ dữ liệu, so với model tốt nhất trong số 38 model còn lại trên từng bộ:
| Bộ dữ liệu | GPT-6.1 Terra | Model khác tốt nhất |
|---|---|---|
| Siêu âm tuyến giáp (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| MRI u não (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Kính hiển vi tế bào máu (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Nội soi polyp đại tràng (Kvasir-SEG) | 0.71 | Bảy model đồng hạng, bao gồm Gemini 4 Argon, 0.81 |
| X-quang cổ tay trẻ em (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| X-quang ngực, lao (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Tổn thương võng mạc (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| X-quang nha khoa (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
Ba hàng đầu tạo nên kết quả nổi bật, và không hàng nào chỉ đơn thuần là tìm đúng vị trí. Trên TN5000, mỗi bounding box còn mang nhãn nốt lành tính hoặc ác tính của bộ dữ liệu — chính là dạng đánh giá mà bác sĩ cần xác nhận. Gemini 4 Argon đạt 0.29 ở đây, còn GPT-6.1 Sol đạt 0.53. Các lớp trong bộ MRI não là u màng não, u thần kinh đệm và u tuyến yên; Sol đạt 0.52 trên bộ này. Bộ dữ liệu tế bào máu yêu cầu Terra phân loại bạch cầu, hồng cầu và tiểu cầu.
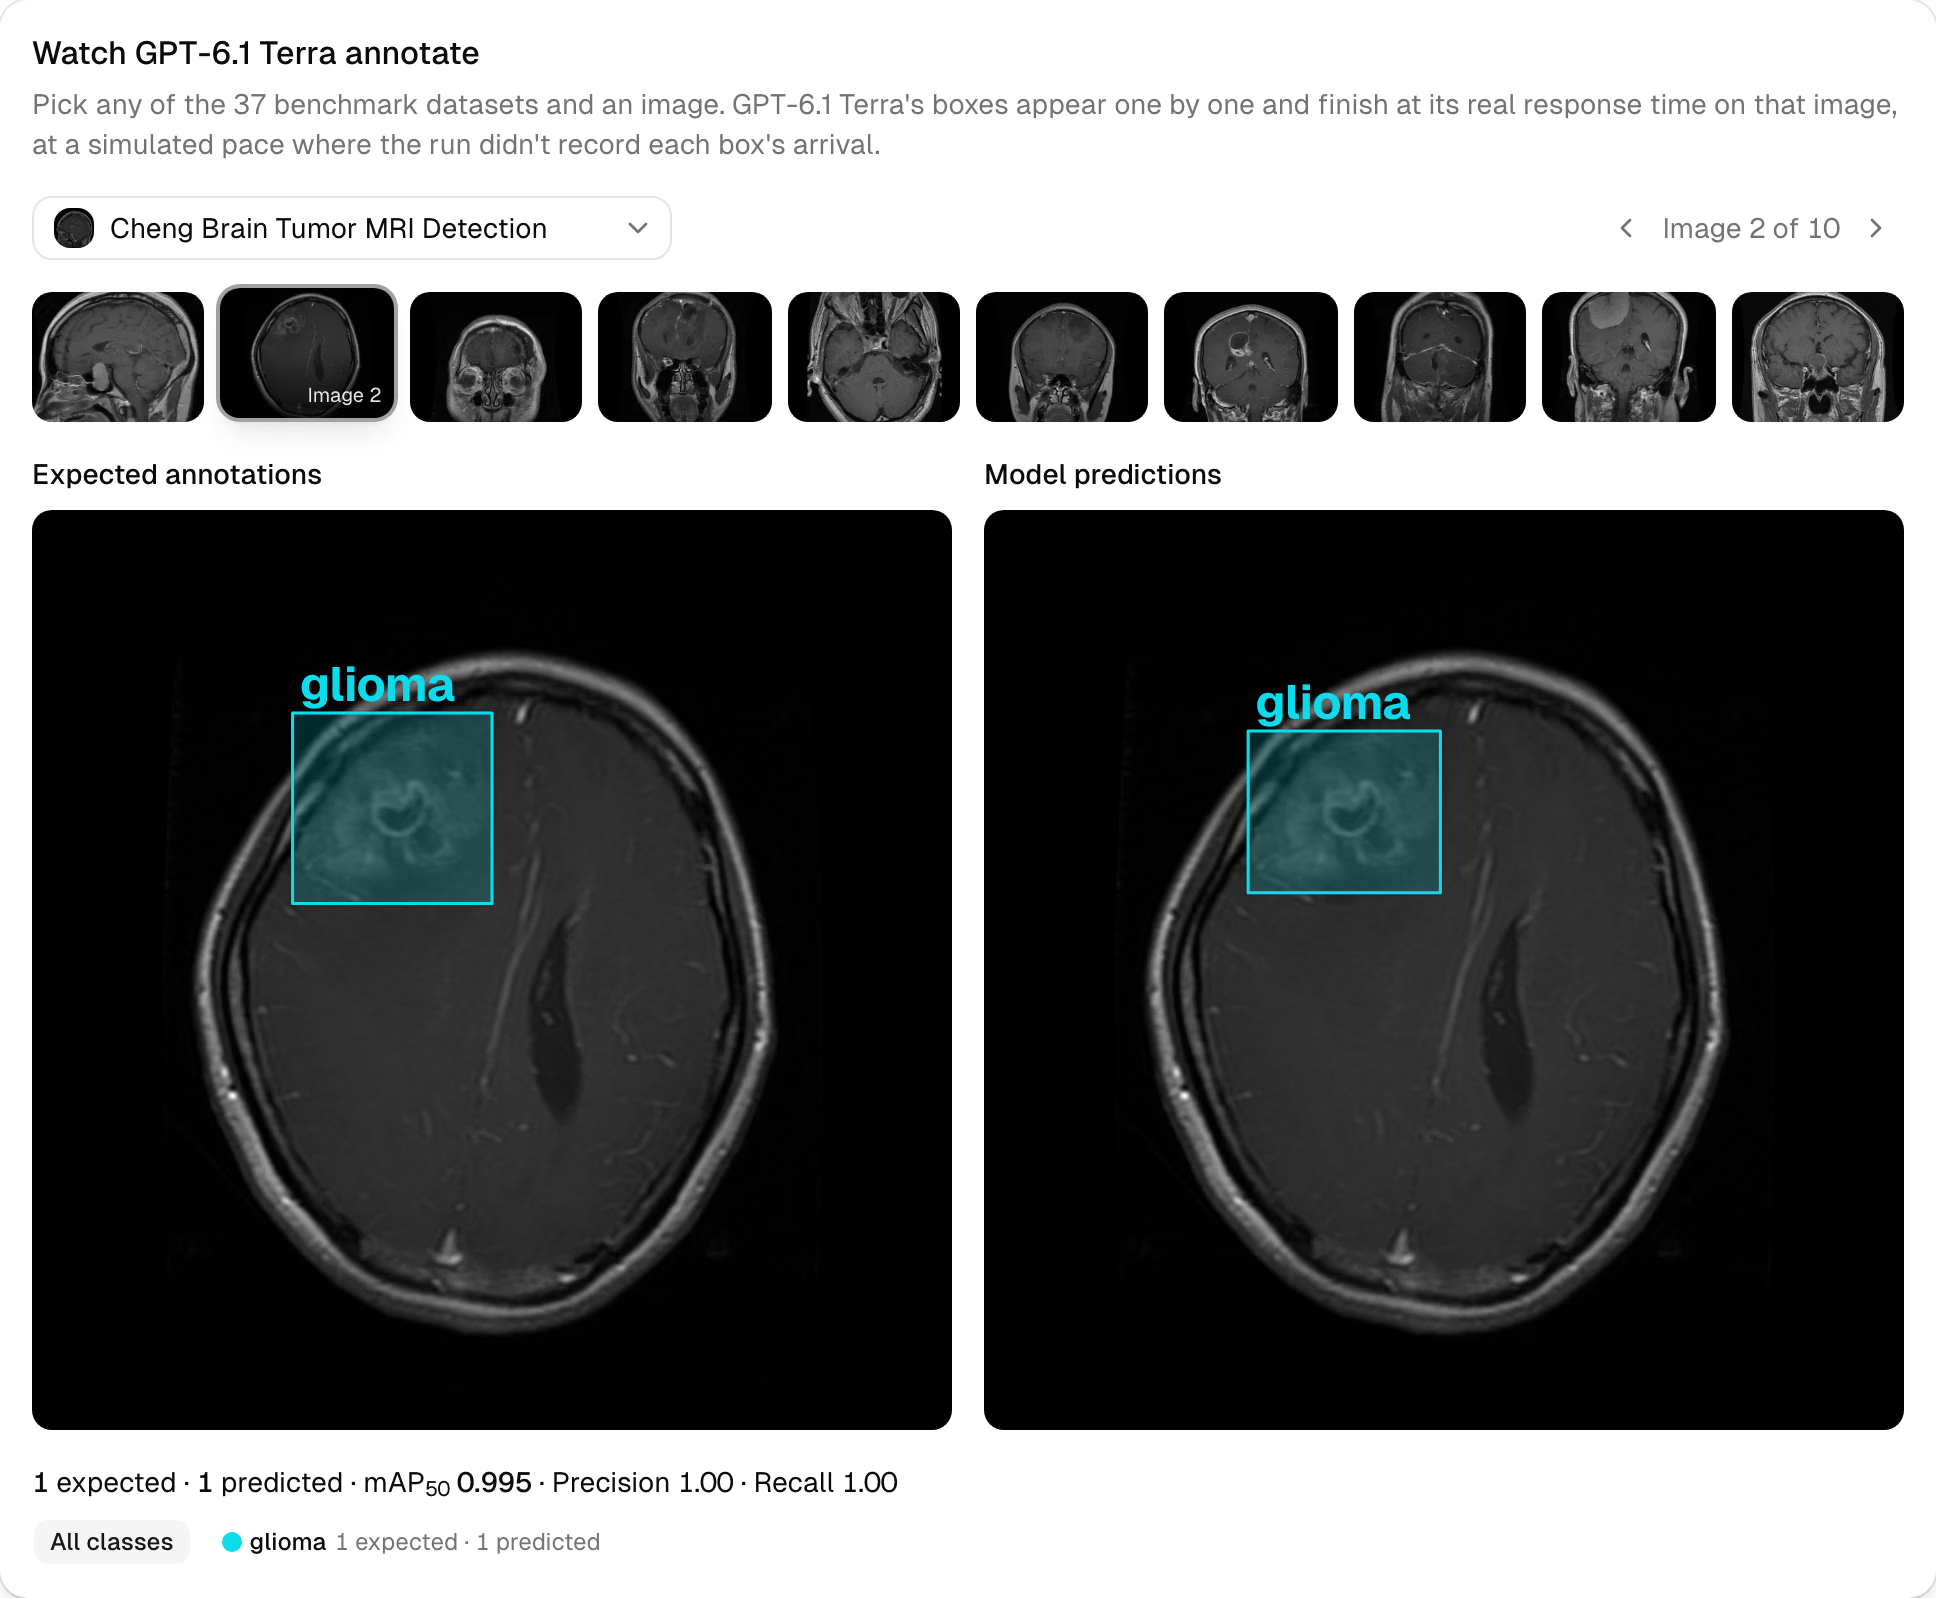
Bản phát lại phía trên từ trang model của Terra cho thấy một kết quả đúng điển hình: một u thần kinh đệm trên ảnh MRI não, một bounding box do Terra tạo ra, được đặt và gán nhãn khớp với annotation dự kiến.
Có hai điểm cần lưu ý khi xem các con số này. Thứ nhất, mỗi bộ dữ liệu chỉ đóng góp 10 ảnh, vì vậy điểm số của một bộ dữ liệu đơn lẻ là tín hiệu cần tìm hiểu thêm, không phải kết luận cuối cùng. Thứ hai, kết quả này không dùng để chẩn đoán. Với một nhóm phân tích ảnh y tế, Terra là công cụ nhanh để tạo bản nháp bounding box trên ảnh siêu âm, MRI và kính hiển vi; sau đó chuyên gia lâm sàng kiểm tra, chỉnh sửa và phê duyệt. Quy trình đánh giá có con người tham gia chính là mục tiêu của workflow, không phải phần bổ sung tùy chọn.
Điểm yếu của GPT-6.1 Terra: ảnh X-quang và bảng mạch#
Các hàng cuối của bảng cho thấy một xu hướng rõ rệt. Trên mọi bộ dữ liệu X-quang trong UL37, bất kể thuộc lĩnh vực y tế hay không, có model khác làm tốt hơn. Terra kém hơn model dẫn đầu trên ảnh X-quang cổ tay trẻ em, ngực và nha khoa; kết quả còn tệ hơn với ảnh X-quang an ninh: model đạt 0.00 trên IEDXray, trong khi Gemini 4 Argon đạt 0.30.
IEDXray là trường hợp Terra bỏ sót rõ nhất. Các ảnh quét cho thấy máy tính xách tay, điện thoại, máy nhắn tin, pin và thiết bị tự chế; Terra không tạo được bounding box chính xác nào trên các ảnh này.
Bảng mạch là điểm mù còn lại. Terra đạt trung bình 0.13 trên các bộ dữ liệu PCB công nghiệp của chúng tôi, trong khi GPT-6.1 Sol đạt 0.39. Trên DeepPCB, bộ dữ liệu bao gồm các lỗi bảng mạch trần như mạch hở, ngắn mạch, vết khuyết do chuột cắn và phần đồng thừa, Terra đạt 0.03 so với 0.39 của Sol. Với dữ liệu kiểm tra PCB, Sol là lựa chọn tốt hơn của OpenAI.
Trước khi gán nhãn một bộ dữ liệu lớn thuộc bất kỳ lĩnh vực nào trong số này, hãy mở trang model GPT-6.1 Terra. Trang này phát lại các bounding box đã ghi nhận của Terra trên toàn bộ 36 bộ dữ liệu benchmark và COCO, đặt cạnh các bounding box dự kiến, đồng thời liệt kê điểm số của model trên từng bộ.
GPT-6.1 Terra và Gemini 4 Argon: cuộc đua sít sao hơn thứ hạng thể hiện#
Gemini 4 Argon dẫn đầu bảng xếp hạng cho đến khi Terra xuất hiện, và hai model có kết quả sát nút. Terra đạt điểm cao hơn trên 19 bộ dữ liệu, Argon trên 16 bộ, và hai model hòa trên một bộ.
Phần lớn lợi thế 0.023 điểm của Terra đến từ một bộ dữ liệu. Trên dữ liệu siêu âm tuyến giáp TN5000, Terra đạt 0.94 còn Argon đạt 0.29. Nếu loại bộ dữ liệu này, điểm trung bình lần lượt là 0.549 cho Terra và 0.544 cho Argon, gần như ngang nhau. Terra thực sự đứng đầu, và vị trí này chủ yếu dựa vào khả năng xử lý ảnh y tế.
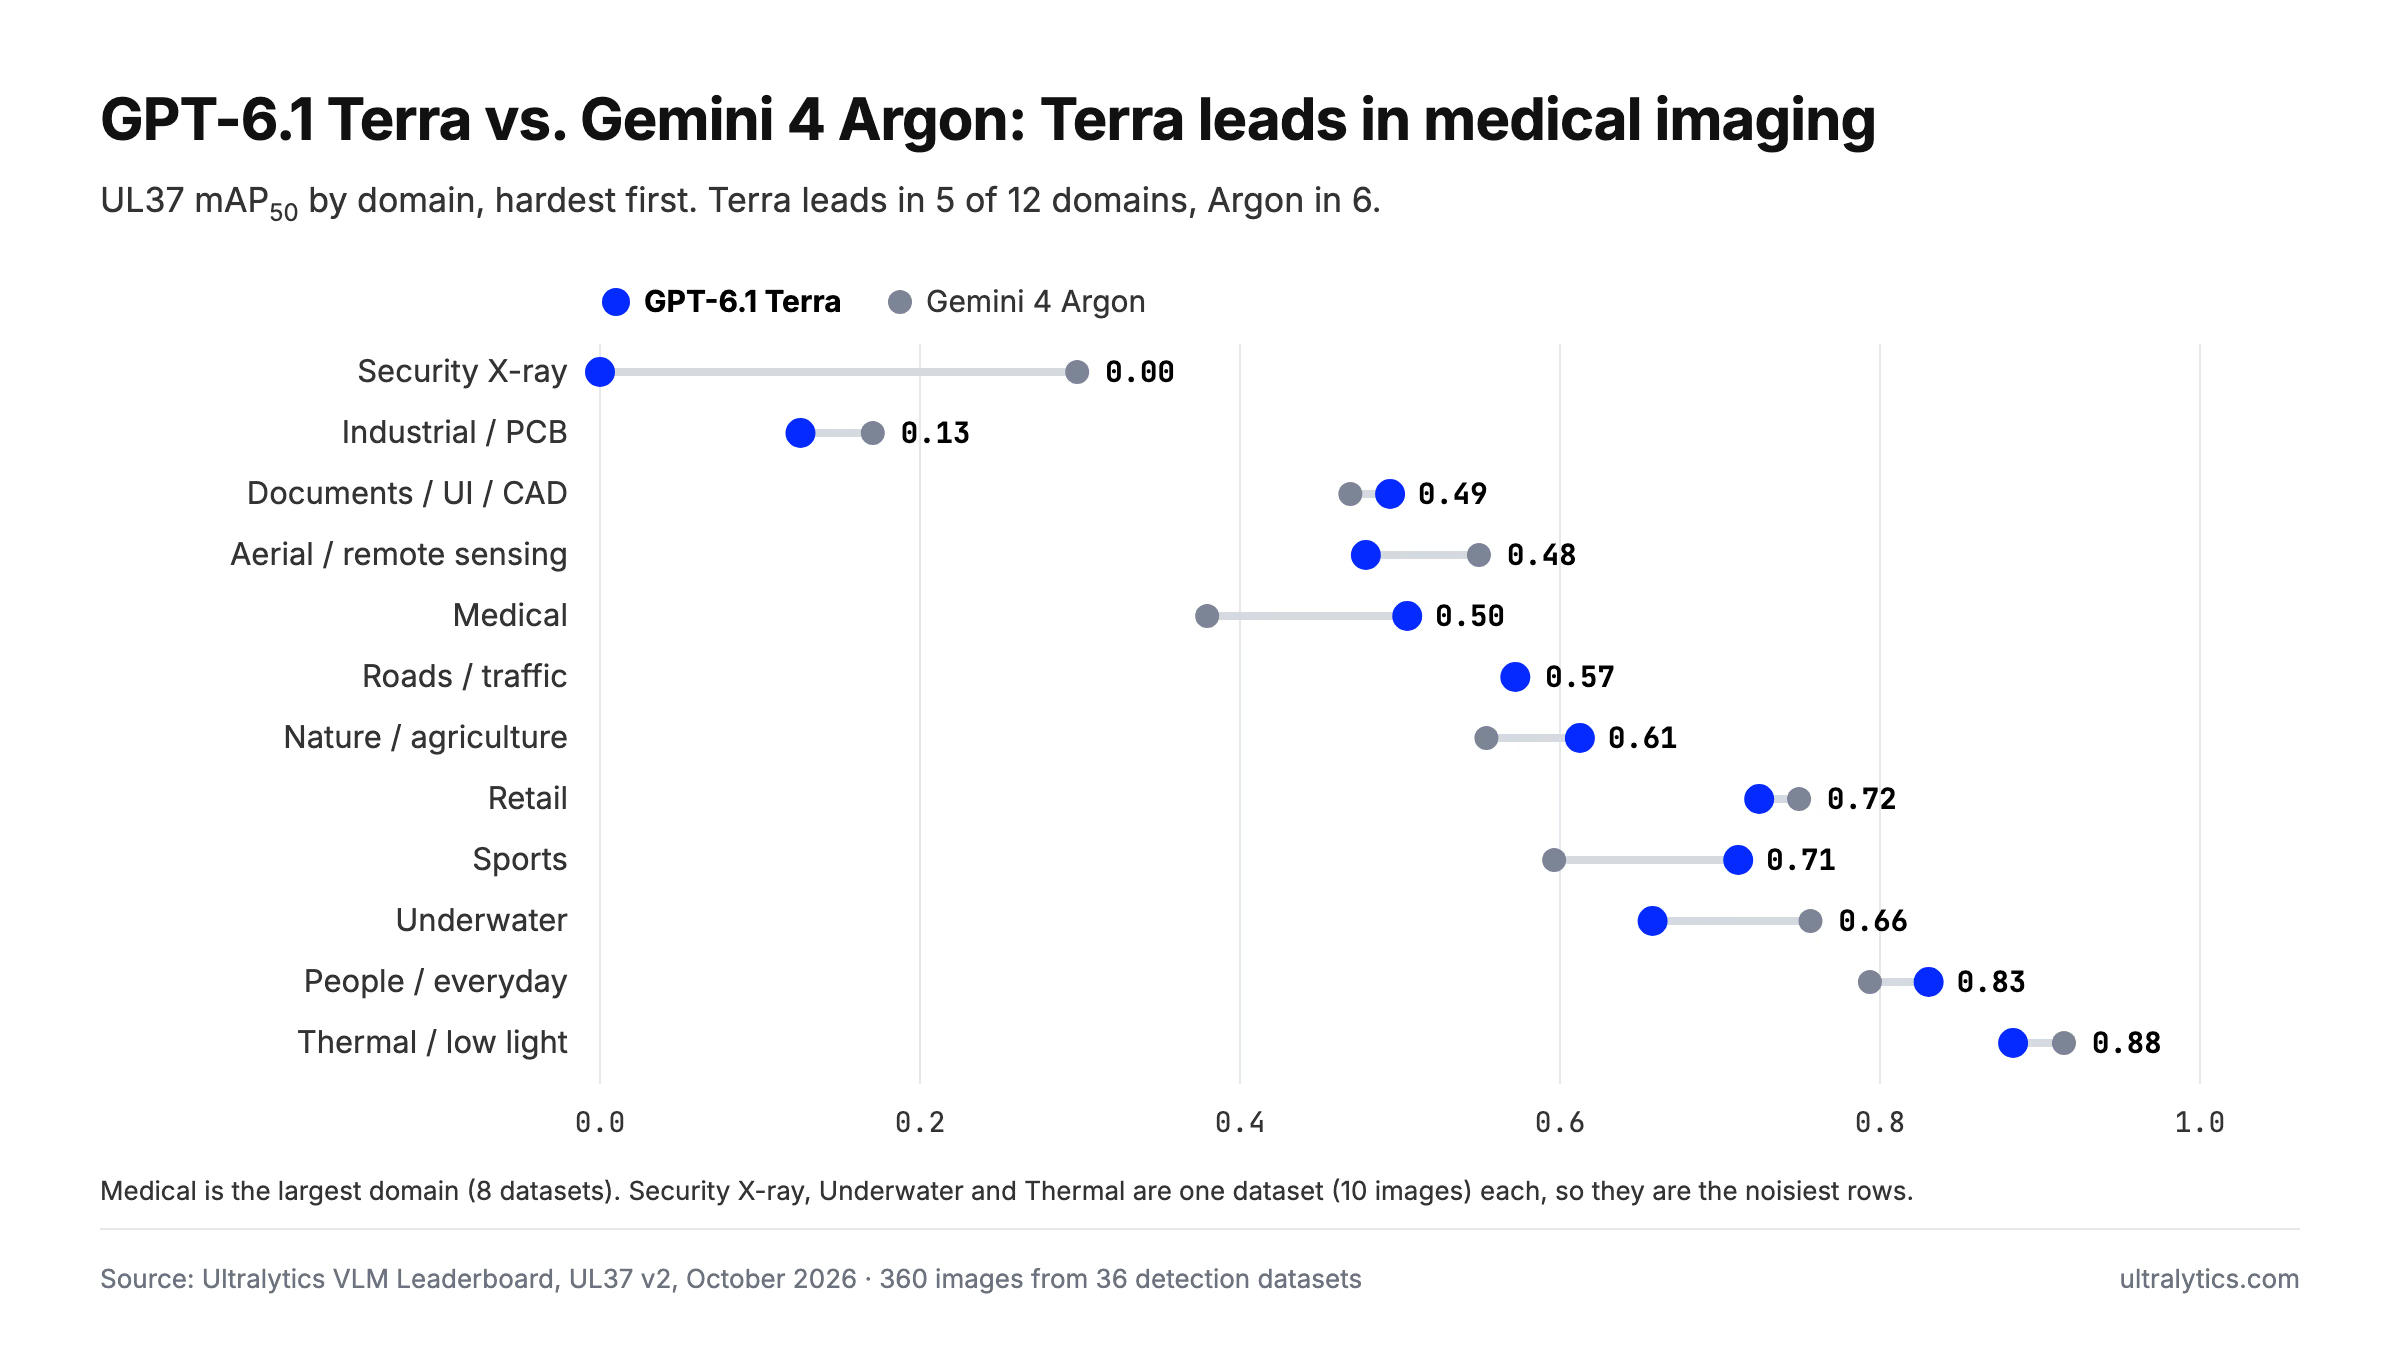
Theo từng lĩnh vực, Terra dẫn đầu ở năm lĩnh vực và đứng đầu trong số cả 39 model ở hai lĩnh vực: y tế và tài liệu, giao diện người dùng cùng CAD. Argon dẫn đầu ở sáu lĩnh vực, đồng thời vẫn đứng đầu các nhóm ảnh trên không, dưới nước và ảnh nhiệt. Hai model hòa ở lĩnh vực đường sá và giao thông.
Hai model cũng mắc các kiểu lỗi khác nhau. Argon có precision nhỉnh hơn đôi chút, 0.667 so với 0.646, trong khi Terra tìm được nhiều đối tượng hơn với recall 0.613 so với 0.585. Terra có chi phí $4.36 cho mỗi 1.000 ảnh, so với $7.60 của Argon theo giá ra mắt của Google. Argon nhanh hơn một chút, ở mức 4.6 giây mỗi ảnh.
Gợi ý lựa chọn thực tế: chọn Terra cho ảnh y tế, tài liệu và thể thao. Chọn Argon cho ảnh trên không, dưới nước, ảnh nhiệt và ảnh an ninh. Kết quả tự động gán nhãn bằng Gemini 4 Argon của chúng tôi trình bày chi tiết về model này.
Chi phí cho một batch GPT-6.1 Terra#
Chi phí $4.36 cho mỗi 1.000 ảnh là khoản thanh toán cho nhà cung cấp, được tính từ mức sử dụng token do OpenAI báo cáo theo giá niêm yết. Một ảnh trung vị sử dụng khoảng 1.300 token đầu vào và 370 token đầu ra. Batch Annotation tính thêm phí xử lý Platform là $1.00 cho mỗi 1.000 ảnh, vì vậy một lượt xử lý 1.000 ảnh có tổng chi phí khoảng $5.36.
Ba chi tiết khác từ lần chạy này:
- Không có yêu cầu thất bại. Tất cả yêu cầu benchmark của Terra đều hoàn tất trong giới hạn 115 giây của Platform. GPT-6.1 Sol thất bại trên 2 ảnh và GPT-6 Astra trên 4 ảnh.
- Bounding box thô đã có chất lượng tốt. Trước khi tinh chỉnh bằng SAM 3.1, bounding box của Terra đạt 0.559 mAP50. Sau tinh chỉnh, điểm tăng lên 0.560, nghĩa là model tự xử lý gần như toàn bộ công việc.
- Không cần cấu hình. Model chỉ cần mức nỗ lực suy luận mặc định và yêu cầu OpenAI tiêu chuẩn.
Nếu ngân sách quan trọng hơn vài điểm accuracy cuối cùng, có những lựa chọn rẻ hơn. Claude Haiku 5.5 đạt 0.429 với chi phí $0.37 cho mỗi 1.000 ảnh, còn Gemini 3.5 Flash-Lite đạt 0.380 với chi phí $1.77. Các model được lưu trữ như Qwen3.8 27B, Gemma 4 26B và SAM 3.1 Text không cần API key, các model Ultralytics YOLO của riêng bạn cũng vậy.
Từ API key OpenAI đến bộ dữ liệu đã gán nhãn#
GPT-6.1 Terra là model dùng prompt tên lớp cho các bộ dữ liệu phát hiện có từ 1 đến 200 lớp. Model trả về bounding box theo tên lớp riêng của bộ dữ liệu, để bạn xem xét trước khi lưu. Cách thiết lập:
- Tạo key tại trang API keys của OpenAI.
- Thêm key trong mục Settings > API Keys của workspace Platform quản lý bộ dữ liệu. OpenAI tính phí trực tiếp cho bạn, còn Ultralytics không cộng thêm phí vào token. Tài liệu về provider key trình bày chi tiết.
- Trong trình chỉnh sửa annotation, chuyển sang chế độ Smart và chọn GPT-6.1 Terra trong mục OpenAI của bộ chọn model.
- Nhấn Predict hoặc
Pđể gán nhãn ảnh hiện tại. Hãy thử với một vài ảnh đại diện cho dữ liệu của bạn trước khi mở rộng quy mô. - Khi đã hài lòng với kết quả, hãy mở trang bộ dữ liệu và chọn More actions > Batch Annotation để gán nhãn cùng lúc cho mọi ảnh chưa có nhãn. Platform lưu một phiên bản bộ dữ liệu trước, để bạn có thể khôi phục phiên bản cũ.
- Xem lại các bounding box, lưu chúng rồi huấn luyện model Ultralytics YOLO26 trên kết quả trong cùng workspace. Tài liệu huấn luyện hướng dẫn chi tiết quy trình.
Để hiểu rõ hơn cách các model này được tích hợp vào trình chỉnh sửa, hãy xem cách Ultralytics Platform dùng AI để tự động hóa annotation và bài giới thiệu về model ngôn ngữ thị giác.
Ai nên chuyển sang GPT-6.1 Terra#
Hãy chọn GPT-6.1 Terra làm model trả phí mặc định để gán nhãn phát hiện đối tượng nói chung. Đây là model chính xác nhất trong số các model chúng tôi đã benchmark, rẻ nhất trong sáu model dẫn đầu và không có yêu cầu nào thất bại trong lần chạy của chúng tôi.
Đây là model tạo bản nháp annotation đặc biệt hiệu quả cho ảnh siêu âm, MRI và kính hiển vi cần chuyên gia đánh giá, cũng như ảnh kệ bán lẻ dày đặc sản phẩm, nơi các bounding box sai nhanh chóng tích tụ. Hãy chọn model khác cho mọi loại ảnh X-quang và lỗi PCB; Gemini 4 Argon, GPT-6 Astra hoặc GPT-6.1 Sol xử lý các trường hợp này tốt hơn.
Nếu hiện bạn đang trả phí cho Sol hoặc Astra chỉ để gán nhãn ảnh, việc chuyển đổi rất đơn giản: Terra tạo bounding box tốt hơn với chi phí chưa bằng một nửa Sol.
Câu hỏi thường gặp
Có. Trên benchmark UL37 của chúng tôi, GPT-6.1 Terra đạt trung bình 0.560 mAP50 trên 36 bộ dữ liệu phát hiện thực tế, cao nhất trong số 39 model trên Bảng xếp hạng VLM của Ultralytics. Model cũng đứng đầu theo chỉ số nghiêm ngặt hơn là mAP50-95, đạt 0.345. Các điểm yếu nhất của model là ảnh X-quang và lỗi bảng mạch.
Có, theo benchmark của chúng tôi. Terra đạt 0.560 mAP50 so với 0.514 của Sol, thắng trên 22 trong số 36 bộ dữ liệu và có chi phí $4.36 cho mỗi 1.000 ảnh so với $10.30, đồng thời chạy nhanh hơn khoảng hai lần. Sol vẫn là lựa chọn OpenAI tốt hơn để phát hiện lỗi PCB.
Terra dẫn trước với 0.560 so với 0.537 mAP50 và có chi phí mỗi ảnh thấp hơn, nhưng cuộc đua sít sao: Terra thắng trên 19 bộ dữ liệu, Argon trên 16 bộ, và hai model hòa trên một bộ. Nếu không tính bộ dữ liệu siêu âm tuyến giáp TN5000, hai model gần như ngang nhau. Chọn Terra cho ảnh y tế và tài liệu, còn Argon cho ảnh trên không, dưới nước, ảnh nhiệt và ảnh X-quang an ninh.
Khoảng $4.36 phí OpenAI, dựa trên lượng token do nhà cung cấp báo cáo với mức giá niêm yết $1 cho mỗi triệu token đầu vào và $5 cho mỗi triệu token đầu ra. Batch Annotation trong Ultralytics Platform tính phí xử lý $1.00 cho mỗi 1.000 hình ảnh. Bạn thanh toán trực tiếp cho OpenAI bằng API key của mình.
Đây là model mạnh nhất trên tám bộ dữ liệu y tế của chúng tôi, đạt mAP50 trung bình 0.505, với điểm số cao nhất trên ảnh siêu âm tuyến giáp, MRI u não và ảnh hiển vi tế bào máu. Model yếu hơn nhiều trên ảnh X-quang và có kết quả kém hơn trên ảnh nội soi polyp đại tràng. Hãy dùng model để tạo bản nháp các bounding box cho chuyên gia rà soát, tuyệt đối không dùng làm công cụ chẩn đoán.
Không. Platform gọi model với mức độ suy luận mặc định medium của OpenAI, sử dụng cùng yêu cầu tạo bounding box như với mọi model OpenAI, sau đó SAM 3.1 tinh chỉnh từng bounding box. Yêu cầu trung vị trong benchmark của chúng tôi mất 5.1 giây và không có yêu cầu nào thất bại.









