Ultralytics YOLO وNVIDIA Cosmos Data Factory: بيانات اصطناعية لاكتشاف العيوب
تساعد البيانات الاصطناعية من NVIDIA Cosmos Data Factory وحلقة التدريب الآلية المعززة بالبيانات، والمدعومة بعوامل ذكية من NVIDIA، نماذج Ultralytics YOLO على تحقيق دقة مجموعة البيانات كاملة باستخدام جزء بسيط من التسميات.
تعاونت Ultralytics وNVIDIA لإظهار ما يمكن أن تحققه بيانات التدريب المستهدفة لنماذج Ultralytics YOLO. تحدد حلقة التدريب المعززة بالبيانات والعوامل الذكية من NVIDIA الصور التي يحتاج إليها النموذج، وتنشئ NVIDIA Cosmos Data Factory الصور التي لم تُلتقط بعد، ثم يُدرَّب نموذج Ultralytics YOLO على الناتج. اختبر فريق تعلّم الآلة (ML) لدينا هذه المنظومة على 19 معيارًا عامًا لفحص المنتجات الصناعية، وقارن بين Ultralytics YOLO26 المدرَّب باستخدام خط أنابيب NVIDIA المعزز بالعوامل الذكية والبيانات الاصطناعية من Cosmos Data Factory، والنموذج نفسه المدرَّب بالطريقة التقليدية. يعرض هذا المنشور النتائج.
المزيد من البيانات ليس الحل. البيانات المناسبة هي الحل.#
تعرف فرق الفحص النمط جيدًا. يؤدي نموذج اكتشاف العيوب أداءً جيدًا في العيوب التي رآها مرارًا، ثم يفوته خدش نادر أو إضاءة غير مألوفة أو زاوية تصوير غريبة، مع أن هذه الحالات هي الأهم على خط الإنتاج. والحل المعتاد هو جمع المزيد من كل شيء وتسميته، وهي عملية بطيئة ومكلفة، وتضيف في معظمها صورًا يتعامل معها النموذج جيدًا بالفعل.
يتبع التدريب الآلي المعزز بالعوامل الذكية والمدعوم من NVIDIA نهجًا مختلفًا: إذ يحدد مواطن الضعف المحددة في مجموعة البيانات ويعالجها، باستخدام صور حقيقية موجودة بالفعل أو صور اصطناعية من Cosmos Data Factory عندما لا تتوفر أمثلة حقيقية. وعند دمج ذلك مع Ultralytics YOLO، نحصل على نموذج يُدرَّب بالضبط على البيانات التي تنقصه.
كيف تعمل حلقة التدريب المعززة بالبيانات من NVIDIA؟#
حلقة التدريب المعززة بالبيانات والعوامل الذكية من NVIDIA الخاصة بـ Ultralytics YOLO هي خط أنابيب لتحسين النموذج يحيط بحلقة التدريب ويحدد البيانات التي يحتاج إليها النموذج بعد ذلك:
• تنقّب عن البيانات الحقيقية. تبحث في مستودعات الصور الحالية عن أمثلة حقيقية تسد ثغرات محددة في مجموعة التدريب.
• تنشئ بيانات اصطناعية. وعندما لا تتوفر أمثلة حقيقية، تنشئ صورًا لحالات حدية باستخدام Cosmos Data Factory.
• تضع التسميات تلقائيًا. يضع مكوّن يُسمى AnomalyGen تسميات للصور الاصطناعية، فلا حاجة إلى التعليق التوضيحي اليدوي قبل إعادة التدريب.
تتمثل الفكرة الموجهة في استهداف البيانات بدلًا من كفاءة البيانات. فالهدف ليس مجرد التدريب على بيانات أقل، بل سد ثغرات مجموعة البيانات التي يضعف فيها النموذج بدقة، عن طريق التنقيب عن البيانات أو توليدها، ثم إعادة التدريب على المجموعة المعززة. وغالبًا ما يكون التدريب على عدد أقل من الصور نتيجة جانبية لتطبيق هذا النهج جيدًا، كما تُظهر النتائج أدناه.
اختُبر خط الأنابيب بالتفصيل باستخدام Ultralytics YOLO، وتستخدم جميع النتائج في هذه المقالة Ultralytics YOLO26.
دور NVIDIA Cosmos Data Factory#
Cosmos Data Factory هي منصة NVIDIA لتنظيم البيانات ومعالجتها وتوليدها، وهي مبنية على نماذج العالم Cosmos التابعة لها. وفي حلقة التدريب المعززة بالعوامل الذكية، تتمثل مهمتها في توليد صور لسيناريوهات لا تغطيها مجموعة البيانات الحقيقية جيدًا، مثل أنواع معينة من العيوب في التصنيع أو تشوهات عدسات عين السمكة في لقطات النقل.
عملية التسليم بسيطة. ينشئ Cosmos صور الحالات الحدية، ويضع AnomalyGen تسميات عليها، ثم يُعاد تدريب Ultralytics YOLO على المجموعة المدمجة من الصور الحقيقية والاصطناعية باستخدام خط أنابيب التدريب القياسي من Ultralytics.
اختبار Cosmos Data Factory على 19 مجموعة بيانات عامة#
لمعرفة مدى إمكانات Cosmos Data Factory + Ultralytics YOLO، شغّل فريق تعلّم الآلة لدينا خط أنابيب الضبط الدقيق المعزز بالبيانات والعوامل الذكية على 19 مجموعة بيانات عامة لفحص المنتجات الصناعية، تغطي الفولاذ ولوحات الدوائر المطبوعة والأقمشة والأسطح المعدنية والمنتجات الاستهلاكية، وتضم نحو 91,000 صورة تدريب إجمالًا. استخدم كل تشغيل مضيفًا واحدًا مزودًا بـ 8 وحدات GPU.
المقارنة صارمة عن قصد. دُرّب النموذج الأساسي ونموذج Cosmos Data Factory باستخدام وصفة متطابقة: Ultralytics YOLO26x، و100 حقبة، والمحسّن نفسه ومعدل التعلّم والبذرة نفسها، كما قُيّم كلاهما على مجموعة الاختبار المحجوبة نفسها. والاختلاف الوحيد هو الصور التي تدرب عليها كل نموذج. يتدرب النموذج الأساسي على كل صورة تحمل تسمية (وفي اختبار البيانات الاصطناعية، على الصور الحقيقية فقط).
1. الدقة نفسها باستخدام جزء بسيط من التسميات#
في 11 مجموعة من مجموعات البيانات الـ19، حقق Ultralytics YOLO26x المدرَّب بخط الأنابيب المعزز بالعوامل الذكية أداءً مماثلًا للنموذج نفسه المدرَّب على مجموعة البيانات كاملة. ولم تكن هناك حاجة إلى 53% من الصور الموسومة في هذه المجموعات الإحدى عشرة.
| مجموعة البيانات | الموسوم | المستخدم | غير مطلوب | mAP@0.5 على المجموعة كاملة | mAP@0.5 بعد التنظيم |
|---|---|---|---|---|---|
| dagm الفئة 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagm الفئة 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagm الفئة 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagm الفئة 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagm الفئة 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagm الفئة 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagm الفئة 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagm الفئة 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
الجدول 1. مجموعات البيانات التي حقق فيها Cosmos Data Factory أداءً مماثلًا للنموذج المدرَّب على البيانات كاملة. mAP@0.5 على مجموعة الاختبار المحجوبة نفسها.
في مجموعات بيانات DAGM، حقق خط الأنابيب المعزز بالعوامل الذكية قيمة mAP@0.5 نفسها باستخدام عُشر التسميات، بل وتقدم قليلًا على النموذج المدرَّب على البيانات كاملة في فئتين. وفي pcb-defect، استبعد 7,000 من أصل 20,924 صورة، مع فارق في الدقة يقل أربع مرات عن ضجيج التشغيلات المتكررة.
بالنسبة إلى الفرق التي تدفع مقابل التعليق التوضيحي، فهذه هي الخلاصة الأهم: معظم ميزانية وضع التسميات في مجموعات البيانات هذه أُنفقت على صور لم تغيّر النتيجة.
2. تدريب أسرع بنسبة تصل إلى 74%#
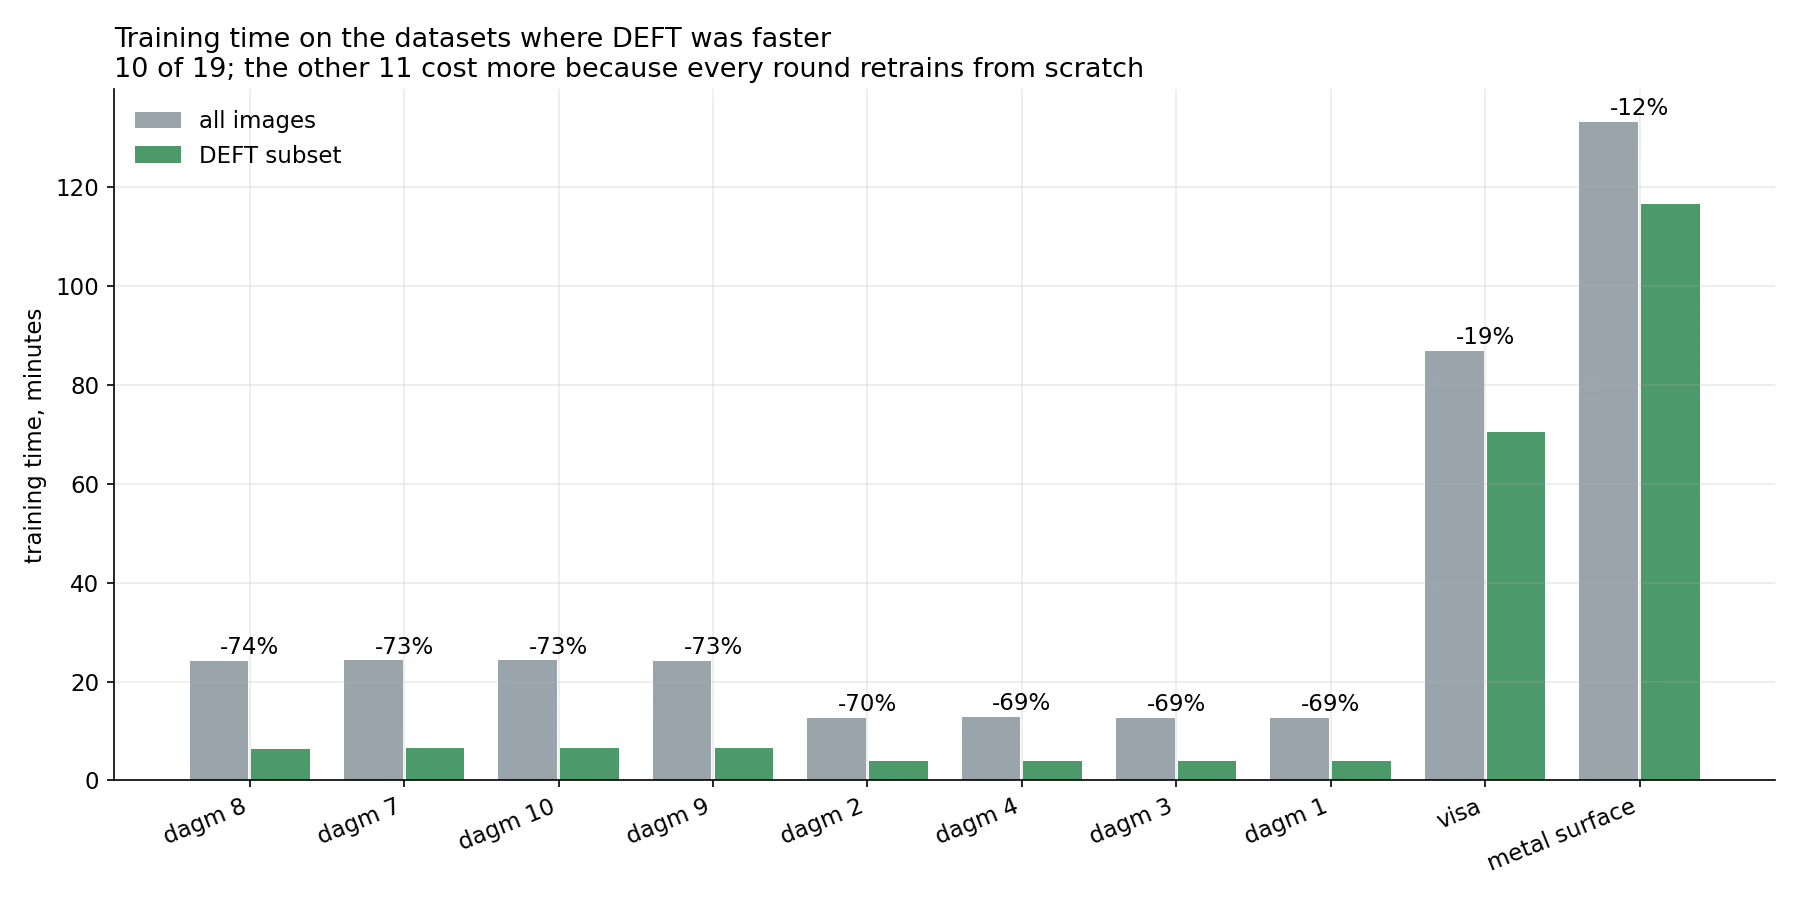
الشكل 1. زمن التدريب على مجموعة البيانات كاملة مقابل مجموعة Cosmos Data Factory الفرعية، لمجموعات البيانات التي كان التدريب فيها أسرع باستخدام Cosmos Data Factory.
يقلل تدريب Ultralytics YOLO على مجموعة أصغر ومستهدفة من الحوسبة أيضًا. كان التدريب أسرع باستخدام خط الأنابيب المعزز بالعوامل الذكية في 10 من مجموعات البيانات الـ19. وفي DAGM، انخفض زمن التدريب من 13–24 دقيقة إلى 4–7 دقائق، أي بنسبة 69–74%. أما مجموعات البيانات الأكبر فحققت وفورات أقل لكنها ملموسة: 19% في VisA و12% في metal-surface-defect.
لا تتحقق الوفورات في جميع الحالات. ففي مجموعات البيانات التسع المتبقية، استغرق خط الأنابيب المعزز بالعوامل الذكية وقتًا أطول من تشغيل واحد على البيانات كاملة، لأن كل جولة تنظيم تعيد التدريب من الصفر. وعندما لا تكون المجموعة الفرعية المنظمة أصغر بكثير من الأصلية، تفوق الجولات الإضافية ما تحققه من وفورات.
3. العيوب المُولّدة تحسّن دقة الصناديق#
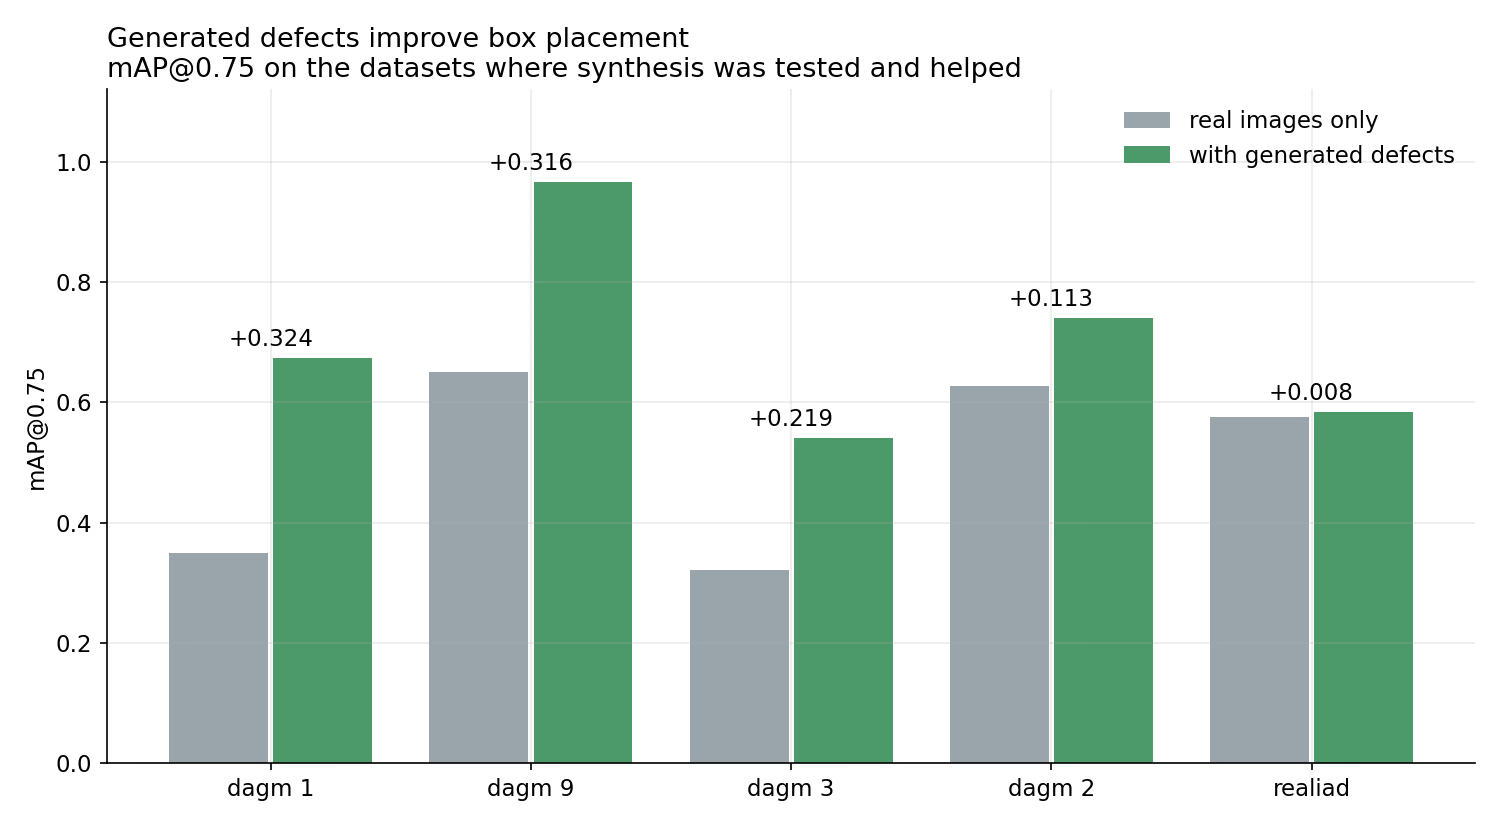
الشكل 2. mAP@0.75 باستخدام الصور الحقيقية فقط مقارنةً باستخدام العيوب المُولّدة، في مجموعات البيانات التي اختُبر فيها التوليد وأفاد.
يعزل الاختبار الثالث أثر البيانات الاصطناعية. ففي مجموعات البيانات ذات التعليقات التوضيحية متعددة الأضلاع، أضفنا عيوبًا ولّدها Cosmos Data Factory ووضع AnomalyGen تسميات عليها، ثم قارنا نموذج Ultralytics YOLO الناتج بنموذج مدرَّب على الصور الحقيقية فقط.
نعرض mAP@0.75، وهو مقياس أكثر صرامة من mAP@0.5: لا يُحتسب التنبؤ إلا إذا تداخل صندوقه مع العيب الحقيقي بنسبة 75% على الأقل. ويقيس هذا المقياس مدى دقة تحديد النموذج لموضع العيب، لا مجرد اكتشافه. أدت إضافة العيوب المُولّدة إلى رفع mAP@0.75 بمقدار يتراوح بين 0.11 و0.32 في فئات DAGM، كما تحسّن الاستدعاء في كل مجموعة بيانات اختُبرت. وكانت أكبر قفزة في DAGM الفئة 9، من 0.650 إلى 0.966. أما في Real-IAD، فكان التحسن هامشيًا (+0.008).
العيوب نادرة بطبيعتها، لذا فإن الأمثلة الحقيقية على نوع معين من العيوب شحيحة دائمًا. ويسمح توليدها مع وضع التسميات عليها مسبقًا لـ Ultralytics YOLO بتعلّم الشكل الدقيق للعيب ومداه من دون أن يرسم أحد مضلعًا.
كمية البيانات الاصطناعية المستخدمة#
تُنفذ كل عملية توليد في ثلاث خطوات. يعثر Cosmos Data Factory أولًا على مواقع محتملة للعيوب في الصور الحقيقية (موضوعة)، ثم يرسم المولّد صور العيوب في تلك المواقع (مُولّدة)، ولا يدخل مجموعة التدريب إلا عدد لا يتجاوز حدًا محددًا (محتفظ به). اختبرنا حدين: صور اصطناعية تعادل 25% أو 100% من الصور الحقيقية في مجموعة التدريب.
ولّدت المنظومة 11,448 صورة عبر 18 جولة توليد (9 أساسية و9 اصطناعية). ولم يُحتفظ إلا بـ1,481 صورة منها، أي نحو صورة واحدة من كل ثمانٍ، لذا حدّد الحد مقدار البيانات الاصطناعية التي شاهدها كل نموذج من Ultralytics YOLO، لا ناتج المولّد. عند الحد البالغ 100%، ضمت كل مجموعة تدريب صورة اصطناعية واحدة لكل صورة حقيقية؛ وعند 25%، صورة اصطناعية واحدة تقريبًا لكل أربع صور حقيقية. والأعداد المطلقة صغيرة: ففي DAGM، استُخدمت 90–180 صورة حقيقية، إضافةً إلى عدد مماثل كحد أقصى من الصور الاصطناعية.
| مجموعة البيانات | الحد | موضوعة | مُولّدة | مستبعدة | محتفظ بها | حقيقية | النسبة |
|---|---|---|---|---|---|---|---|
| dagm الفئة 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagm الفئة 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagm الفئة 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagm الفئة 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagm الفئة 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagm الفئة 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagm الفئة 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| الإجمالي | 11,448 | 0 | 1,481 |
الجدول 2. الصور المُولّدة والنسبة بين الصور الحقيقية والاصطناعية، وفق سجلات التوليد والقبول لكل تشغيل.
ما الذي يعنيه هذا للفرق التي تبني نماذج الفحص؟#
بالنسبة إلى الفرق التي تدرب Ultralytics YOLO بالفعل، يندمج Cosmos Data Factory والتدريب الآلي المعزز بالعوامل الذكية والمدعوم من NVIDIA في سير العمل الذي تستخدمه وتعرفه: النماذج نفسها، ووصفة التدريب نفسها، مع إدخال بيانات أذكى.
• غطِّ الحالات الحدية التي لا يمكنك جمعها. تساعد العيوب الاصطناعية الموسومة تلقائيًا Ultralytics YOLO على تحديد مواضع العيوب التي تندر أمثلتها الحقيقية.
• أنفق ميزانية وضع التسميات حيث تحقق أثرًا. كانت معظم التسميات زائدة عن الحاجة في أكثر من نصف مجموعات البيانات المختبرة. ويساعد الاختيار المستهدف على العثور على الصور المهمة.
• كرر التجارب بوتيرة أسرع. تعني مجموعات التدريب الأصغر والمنظمة فترات تدريب أقصر لـ Ultralytics YOLO وتجارب أسرع على العديد من مجموعات البيانات.
التوافر#
تتوفر خطوة التوليد الاصطناعي القائمة على Cosmos حاليًا كنموذج تجريبي وعرض توضيحي، ولم تُطرح بعد كتكامل رسمي.
لتجربة Cosmos Data Factory مع نماذج Ultralytics YOLO الخاصة بك، تواصل مع فرق Ultralytics. وسنواصل العمل مع NVIDIA مع اقتراب خطوة التوليد الاصطناعي من التكامل الكامل.
ملحق: إعداد الاختبارات ومجموعات البيانات#
جميع التشغيلات: Ultralytics YOLO26x، و100 حقبة، ومحسّن ومعدل تعلّم وبذرة متطابقة للنموذج الأساسي وCosmos Data Factory؛ ومضيف واحد مزود بـ 8 وحدات GPU؛ ومجموعة الاختبار المحجوبة نفسها لكل مجموعة بيانات. ويمكن استخدام العيوب المُولّدة مع مجموعات البيانات الإحدى عشرة ذات التعليقات التوضيحية متعددة الأضلاع.
| مجموعة البيانات | صور التدريب | التعليق التوضيحي | المصدر |
|---|---|---|---|
| dagm الفئة 1 و2 و3 و4 | 1,035 لكل فئة | مضلّع | DAGM 2007 |
| dagm الفئة 7 و8 و9 و10 | 2,070 لكل فئة | مضلّع | DAGM 2007 |
| pcb-defect | 20,924 | صندوق | PCB defect |
| dspcbsd | 6,575 | صندوق | DsPCBSD+ |
| deeppcb | 1,000 | صندوق | DeepPCB |
| hripcb | 559 | صندوق | HRIPCB |
| metal-surface-defect | 11,845 | صندوق | NEU surface defect |
| tianchifabric | 10,332 | صندوق | Tianchi fabric |
| severstal | 10,061 | مضلّع | Severstal steel |
| mvtec-ad | 4,637 | صندوق | MVTec AD |
| visa | 7,794 | مضلّع | VisA |
| realiad-bottle-cap | 3,581 | مضلّع | Real-IAD |
| شق | 1,290 | صندوق | تقسيم الشقوق |
الجدول 3. مجموعات البيانات الـ19 (تُحتسب DAGM على أنها ثماني مجموعات، واحدة لكل فئة).









