Semantische oder Instanzsegmentierung: So wählst du die passende Aufgabe
Bei der semantischen Segmentierung wird jedes Pixel einer Klasse zugeordnet; bei der Instanzsegmentierung wird jedes Objekt einzeln erkannt. Erfahre, welche Aufgabe zu deinem Computer-Vision-Projekt passt und warum.
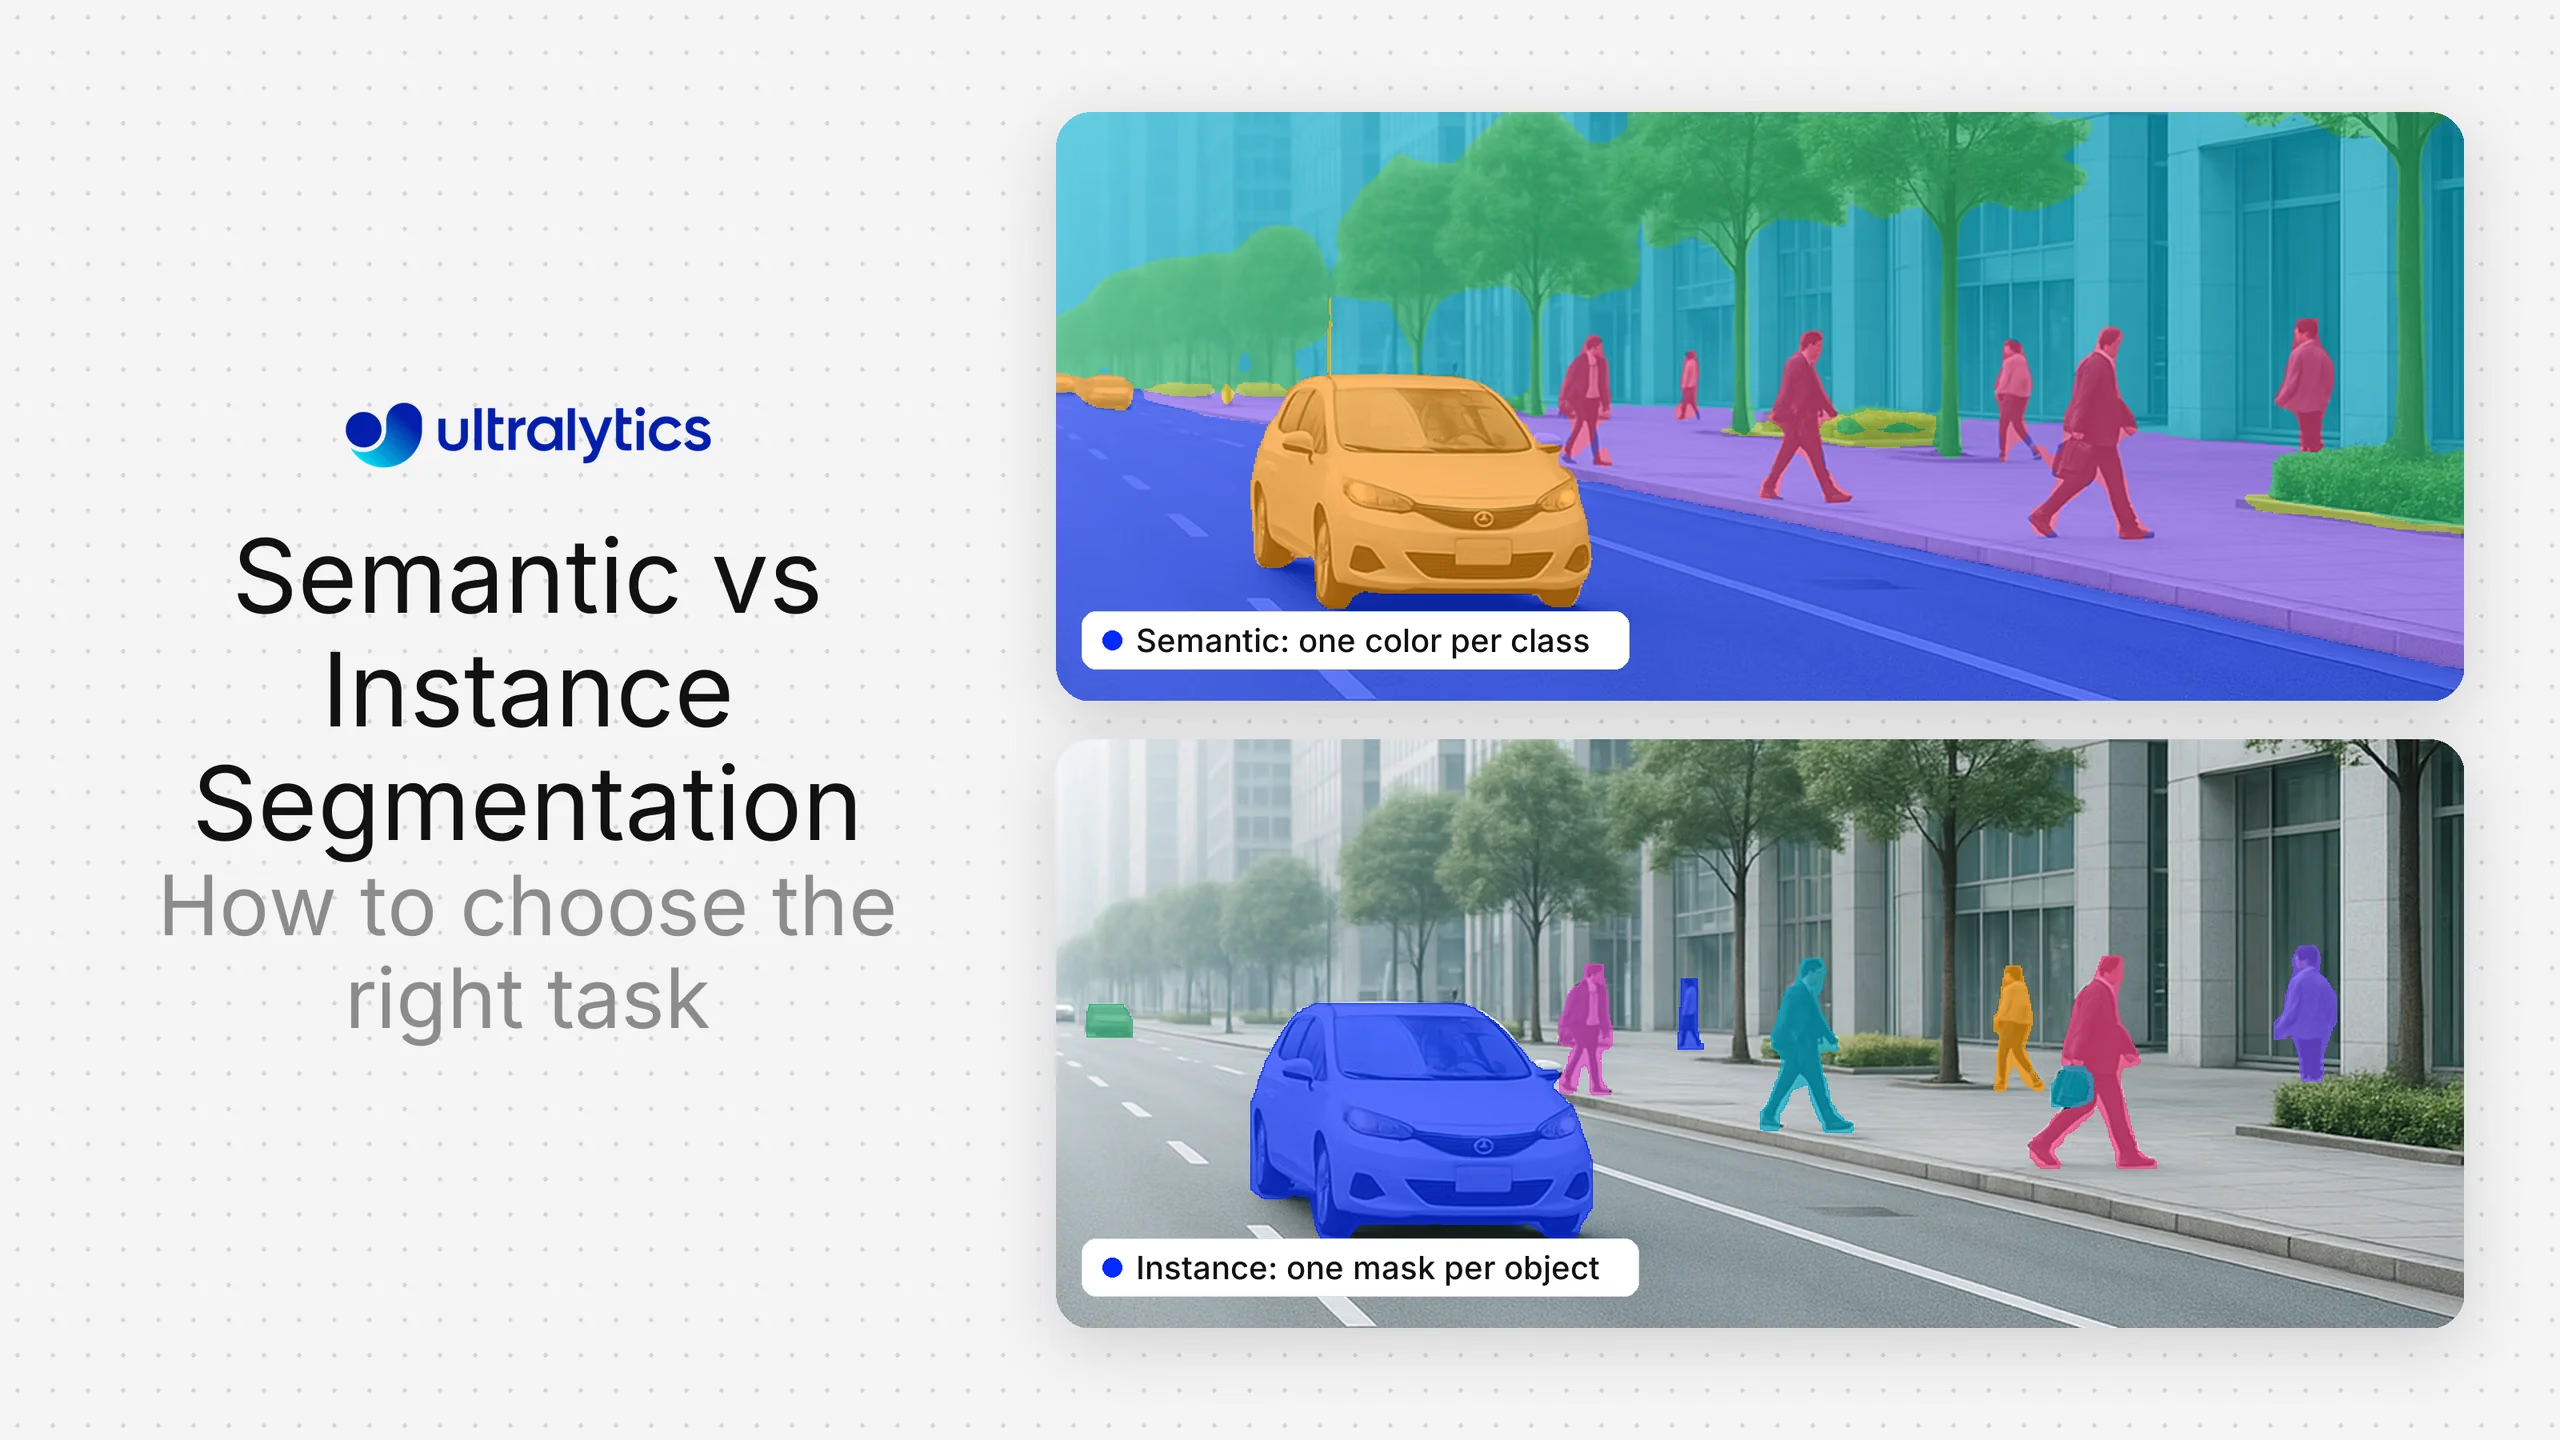
Semantische Segmentierung und Instanzsegmentierung kennzeichnen Bilder beide auf Pixelebene, beantworten aber unterschiedliche Fragen. Semantische Segmentierung ordnet jedem Pixel eine Klasse zu, sodass alle Autos in einer Szene zu einer einzigen „Auto“-Region werden. Instanzsegmentierung trennt jedes Objekt, sodass jedes Auto eine eigene Maske erhält. Die Wahl hängt von einer Frage ab: Musst du wissen, was sich an jedem Pixel befindet, oder zu welchem Objekt jedes Pixel gehört? Diese Anleitung hilft dir bei der Entscheidung. Sie behandelt auch den Aufwand für das Labeln und die Evaluierung der einzelnen Aufgaben. Ultralytics YOLO unterstützt beide Aufgaben innerhalb desselben Frameworks.
Der Unterschied in einem Satz#
- Semantische Segmentierung ordnet jedem Pixel eine Kategorie wie Straße, Himmel, Person oder Auto zu. Objekte derselben Klasse werden zu einer Region zusammengefasst. Sieh dir den Glossareintrag zur semantischen Segmentierung an.
- Instanzsegmentierung findet jedes einzelne Objekt und weist ihm eine eigene Maske und ID zu. Sie erfasst üblicherweise zählbare Objekte und ignoriert Hintergründe wie Himmel oder Gras. Sieh dir den Glossareintrag zur Instanzsegmentierung an.
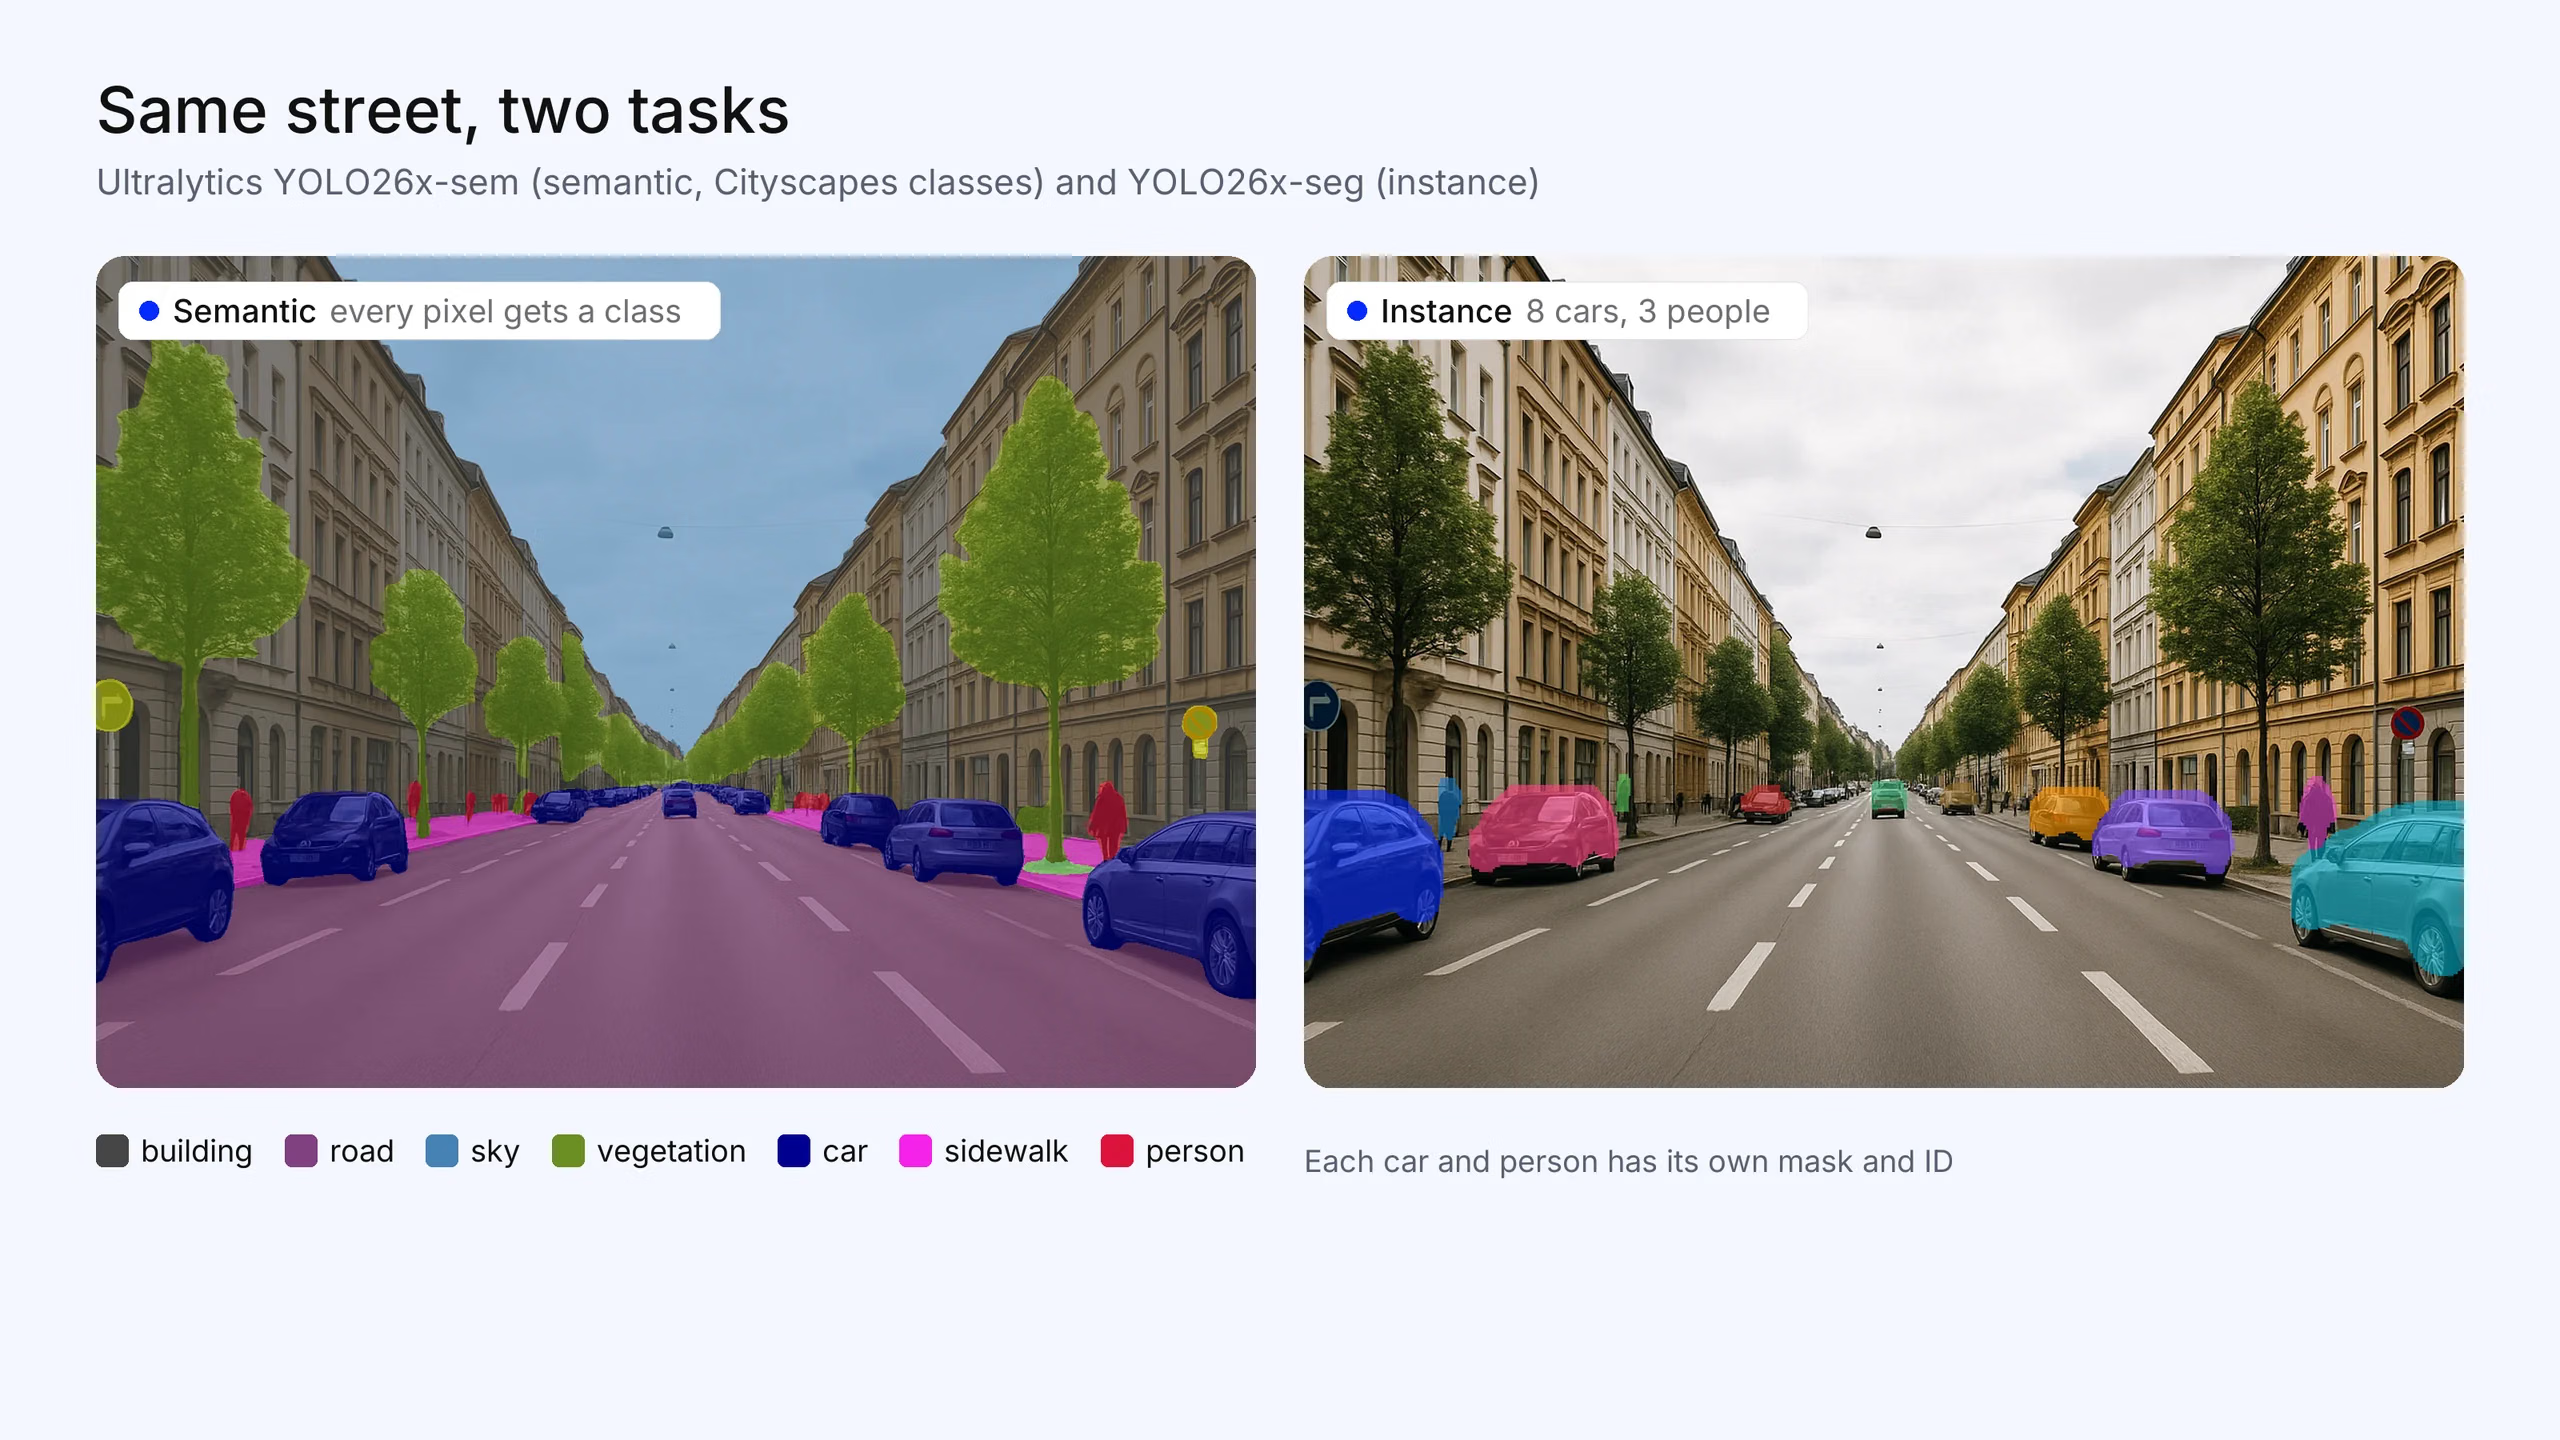
Abb. 1. Dieselbe Straße mit beiden Aufgaben. Ultralytics YOLO26x-sem (Cityscapes-Klassen) kennzeichnet jedes Pixel, sodass alle Autos dieselbe Klasse „Auto“ erhalten. Ultralytics YOLO26x-seg weist jedem der 8 Autos und 3 Personen, die das Modell gefunden hat, eine eigene Maske zu (Konfidenz von mindestens 0,5). Das Foto wurde für diesen Artikel erstellt; die Masken sind echte Modellausgaben.
Welche Aufgabe braucht dein Projekt?#
Ausgangspunkt ist die Frage, die deine Anwendung beantworten muss:
| Wenn deine Anwendung Folgendes ermitteln muss … | Verwende | Beispiel |
|---|---|---|
| Wissen, wie viel von der Szene einer bestimmten Klasse angehört | Semantische Segmentierung | Befahrbare Straßenfläche, Anteil von Nutzpflanzen und Unkraut, Landbedeckung |
| Hintergrundbereiche ebenso sorgfältig wie Objekte kennzeichnen | Semantische Segmentierung | Himmel, Wasser, Vegetation, Gewebetypen in einem Scan |
| Objekte zählen | Instanzsegmentierung | Früchte an einem Baum, Menschen in einer Warteschlange |
| Objekte über Videobilder hinweg verfolgen | Instanzsegmentierung plus Tracker | Menschen oder Fahrzeuge, die sich durch eine Szene bewegen |
| Einzelne Objekte vermessen oder bearbeiten | Instanzsegmentierung | Ein Roboter, der ein einzelnes Teil aus einem Haufen greift; jeden Defekt einzeln vermessen |
| Beides: die gesamte Szene abdecken und einzelne Objekte trennen | Panoptische Segmentierung | Straßenszenen für autonomes Fahren |
Wenn du unsicher bist, überlege, ob zwei einander berührende Objekte derselben Klasse unterschieden werden müssen. Wenn ja, brauchst du Instanzsegmentierung (oder panoptische Segmentierung). Wenn nein, ist semantische Segmentierung einfacher und in der Regel kostengünstiger im Betrieb.
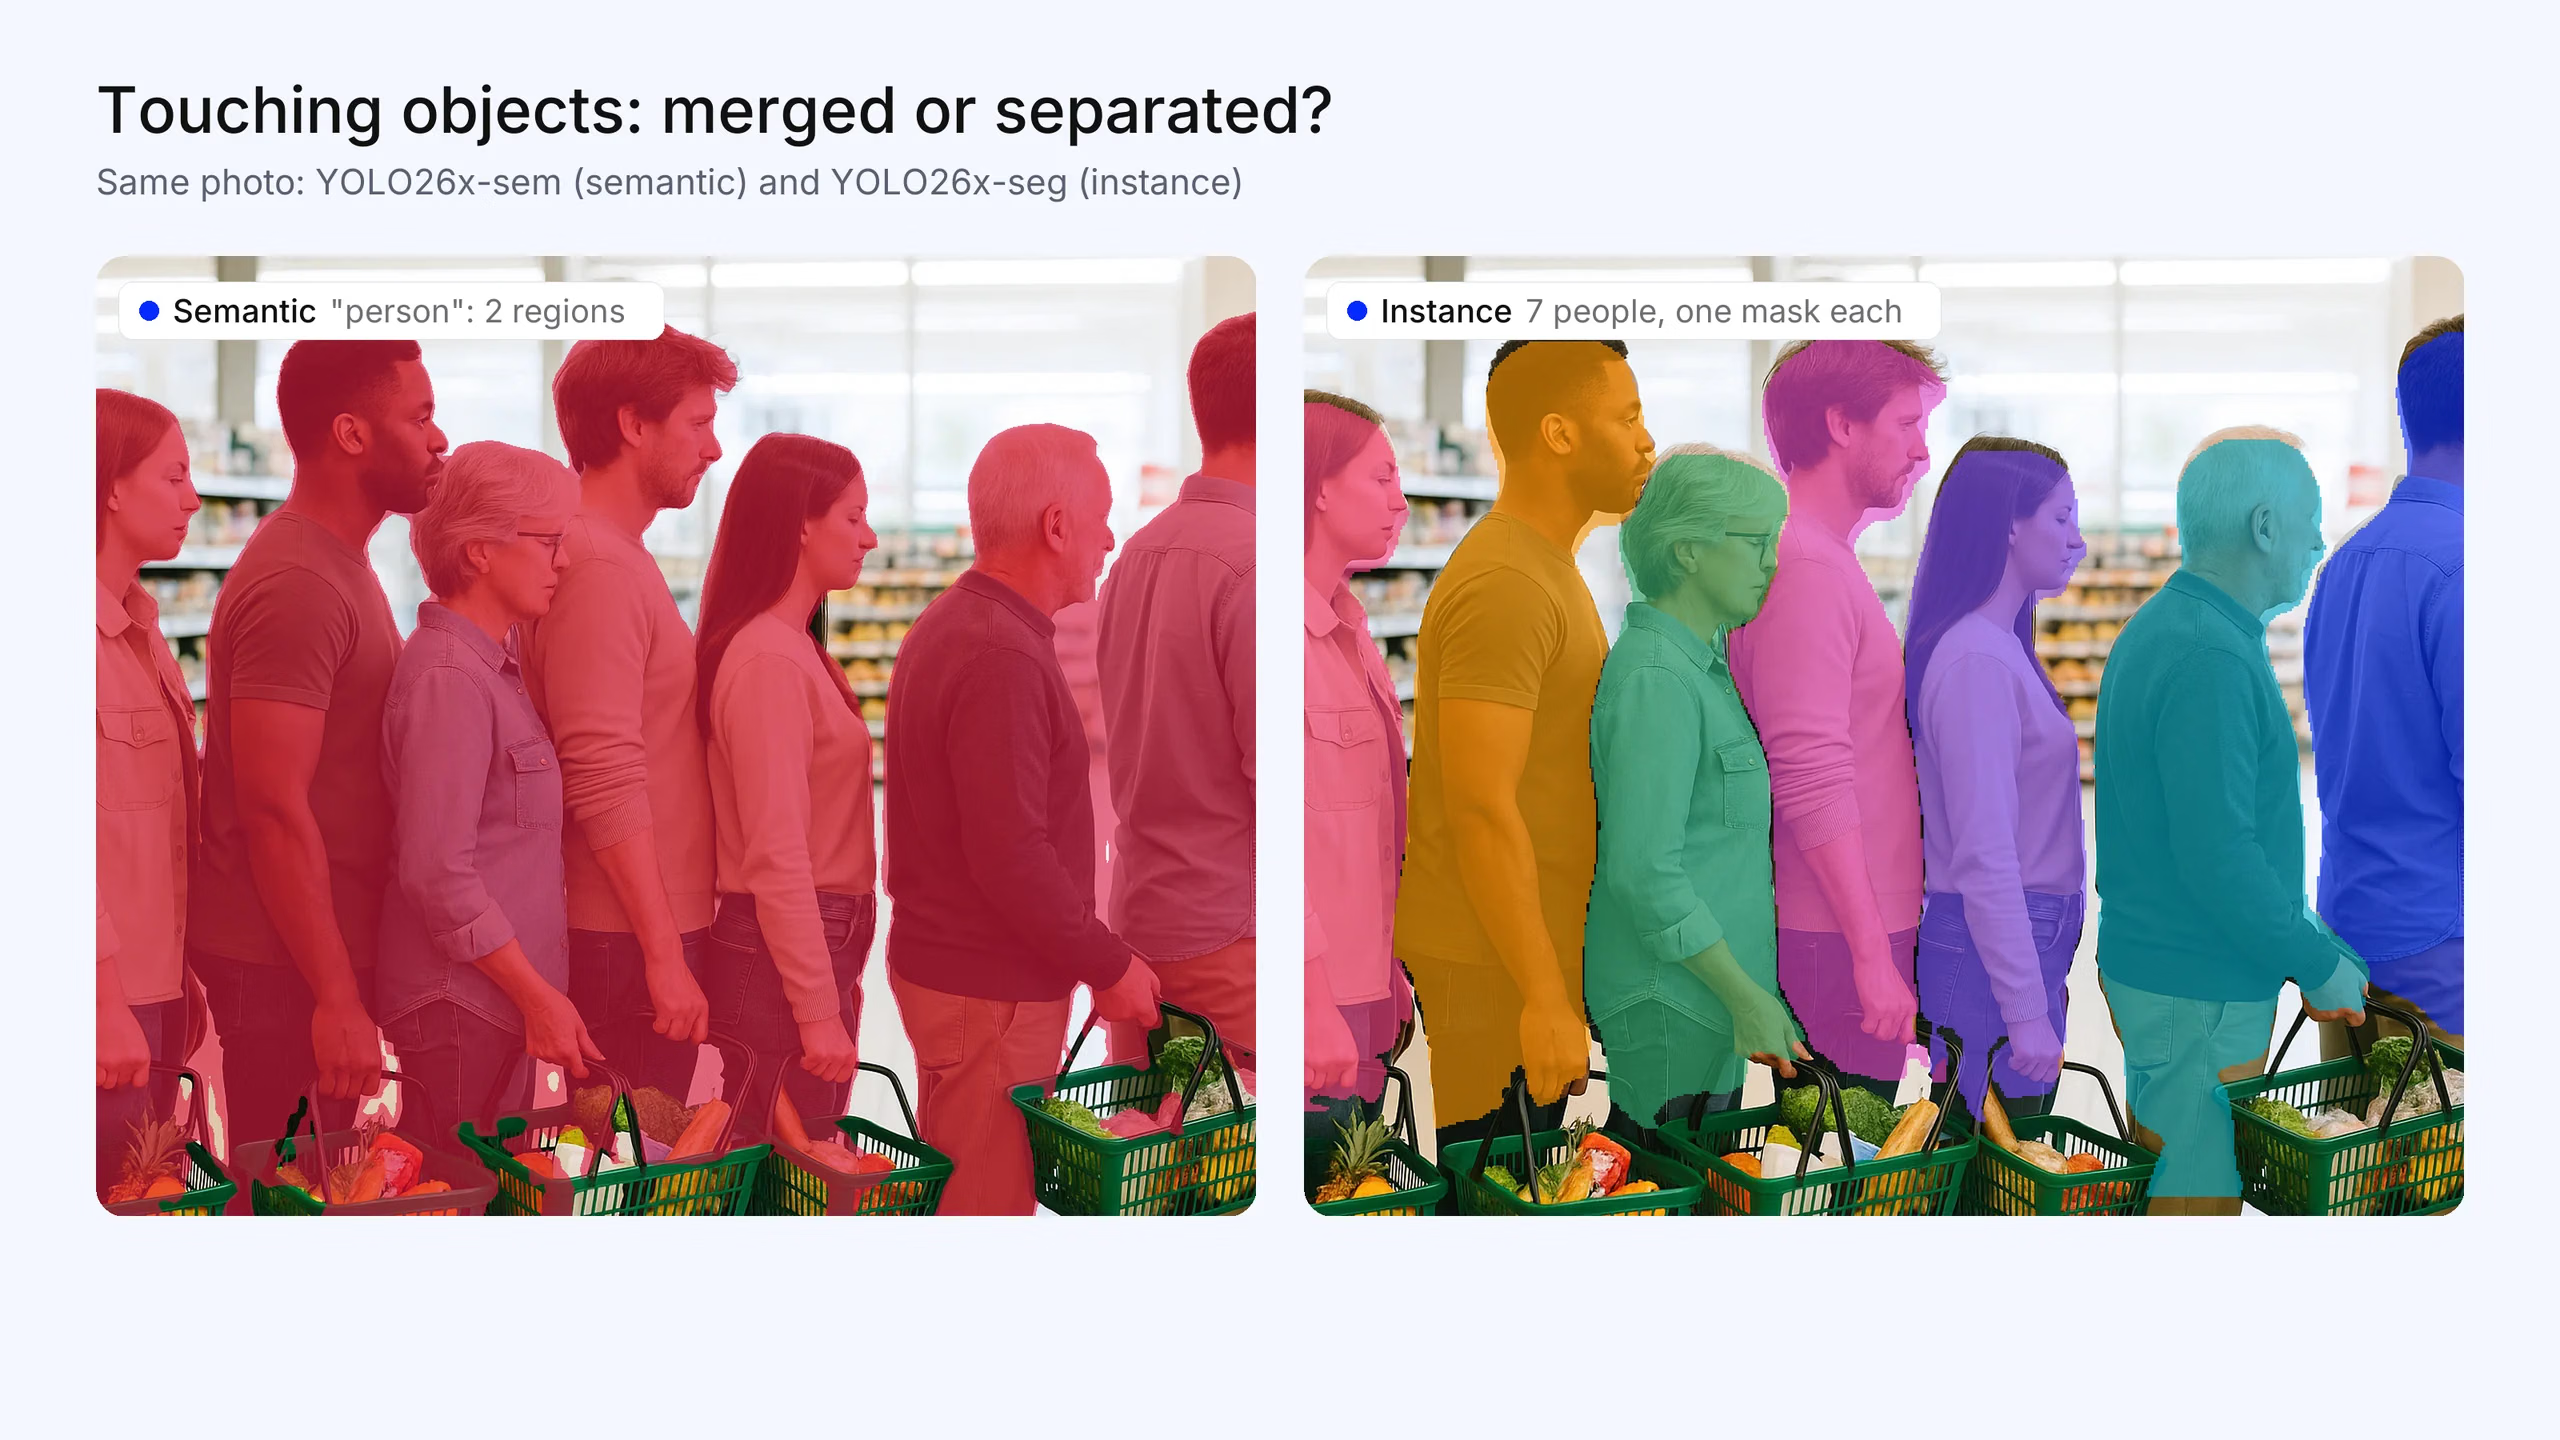
Abb. 2. Sieben dicht beieinanderstehende Kundinnen und Kunden in einer Warteschlange. In der semantischen Ausgabe (Ultralytics YOLO26x-sem) werden sie zu zwei verbundenen „Person“-Regionen zusammengefasst und lassen sich daher nicht zählen. Die Instanzausgabe (Ultralytics YOLO26x-seg) trennt alle 7 Personen. Das Foto wurde für diesen Artikel erstellt; die Masken sind echte Modellausgaben.
Die wichtigsten Unterschiede auf einen Blick#
| Kriterium | Semantische Segmentierung | Instanzsegmentierung |
|---|---|---|
| Beantwortete Frage | Zu welcher Klasse gehört jedes Pixel? | Zu welchem Objekt gehört jedes Pixel? |
| Objekte derselben Klasse | Zu einer Region zusammengefasst | Getrennt; jedes Objekt hat eine eigene Maske und ID |
| Abdeckung | Jedes Pixel, einschließlich Hintergrund | In der Regel nur die interessierenden Objekte |
| Ausgabe | Eine Klassenkarte in Bildgröße | Eine Liste von Masken, jeweils mit Klasse und Konfidenz |
| Kannst du Objekte zählen? | Nicht direkt | Ja |
| Wichtigste Metrik | Mittlere Schnittmenge über Vereinigungsmenge (mIoU) | Mittlere Average Precision für Masken (mask mAP) |
| Relative Komplexität | Geringer: Klassifizierung pro Pixel | Höher: Detektion plus Masken pro Objekt |
Aufwand für das Labeln der einzelnen Aufgaben#
In der Praxis entscheidet oft der Aufwand für das Labeln über die Wahl.
- Semantische Datensätze weisen jedem Pixel jedes Bildes eine Klasse zu, einschließlich des Hintergrunds. Sie werden üblicherweise als einkanalige Maskenbilder gespeichert. Jedes Bild ist vollständig gelabelt, sodass kein Pixel ausgelassen werden kann, sofern es nicht ausdrücklich als „ignorieren“ markiert ist.
- Instanzdatensätze umgrenzen jedes relevante Objekt einzeln als Polygon oder Maske. Der Hintergrund kann unlabeled bleiben, aber jedes Objekt braucht eine eigene Umrandung, und bei dicht gedrängten Szenen steigt der Arbeitsaufwand entsprechend.
Beide Aufgaben sind arbeitsintensiv. Unterstützte Annotation, bei der ein Klick oder eine Box in eine Maske umgewandelt wird, reduziert den Aufwand für beide Aufgaben. Wenn du nur Antworten auf Regionsebene brauchst, solltest du nicht für Instanzlabels bezahlen.
So werden die einzelnen Aufgaben bewertet#
- Semantische Segmentierung wird hauptsächlich anhand des mIoU gemessen: der Überlappung zwischen vorhergesagten und tatsächlichen Regionen, gemittelt über alle Klassen. Auch die Pixelgenauigkeit wird angegeben. IoU ist dieselbe Überlappungsmetrik wie bei der Detektion.
- Instanzsegmentierung wird anhand des mask mAP gemessen, der mittleren Average Precision, die auch bei der Detektion verwendet, dort aber anhand der Maskenüberlappung berechnet wird. Die Metrik honoriert das Finden jedes einzelnen Objekts und nicht nur die Abdeckung der richtigen Pixel.
Diese Metriken lassen sich nicht direkt miteinander vergleichen. Ein hoher mIoU sagt nichts darüber aus, ob einzelne Objekte voneinander getrennt wurden.
Panoptische Segmentierung: wenn du beides brauchst#
Panoptische Segmentierung weist jedem Pixel eine Klasse und zählbaren Objekten zusätzlich eine Instanz-ID zu. Hintergrundbereiche wie Straßen und Himmel werden semantisch gekennzeichnet. Vordergrundobjekte wie Autos und Personen werden einzeln getrennt. Die Bewertung erfolgt anhand der Panoptic Quality (PQ). Wähle diese Methode, wenn du gleichzeitig die gesamte Szene abdecken und einzelne Objekte trennen musst. Sieh dir die panoptische Segmentierung an.
Funktionsweise der einzelnen Aufgaben – kurz erklärt#
Modelle für semantische Segmentierung sind in der Regel Encoder-Decoder-Netzwerke, die jedem Pixel eine Klasse zuweisen. U-Net, DeepLab und SegFormer sind bekannte Beispiele. Modelle für die Instanzsegmentierung bauen üblicherweise auf der Objekterkennung auf. Mask R-CNN sagt für jede erkannte Box eine Maske voraus, während einstufige Modelle wie YOLACT und die Ultralytics YOLO-Segmentierungsmodelle Boxen und Masken in einem Durchlauf für den Echtzeiteinsatz vorhersagen. Universelle Architekturen wie Mask2Former verarbeiten semantische, Instanz- und panoptische Segmentierung in einem Modell. Weitere Informationen zur Instanzsegmentierung findest du unter Was ist Instanzsegmentierung?.
Beide Aufgaben in Ultralytics YOLO#
Ultralytics YOLO führt beide Aufgaben über dieselbe Python-API und CLI aus:
- Instanzsegmentierung verwendet die Aufgabe
segmenttask. - Semantische Segmentierung verwendet die Aufgabe
semantictask. Semantische YOLO26-Modelle tragen das Suffix-semund werden mit Cityscapes und ADE20K vortrainiert. Die Aufgabenseite enthält eine Tabelle, die genau zeigt, wie sich die Ausgaben der beiden Aufgaben im Code unterscheiden.
Beide Aufgaben lassen sich lokal oder in der Cloud auf der Ultralytics Platform trainieren.
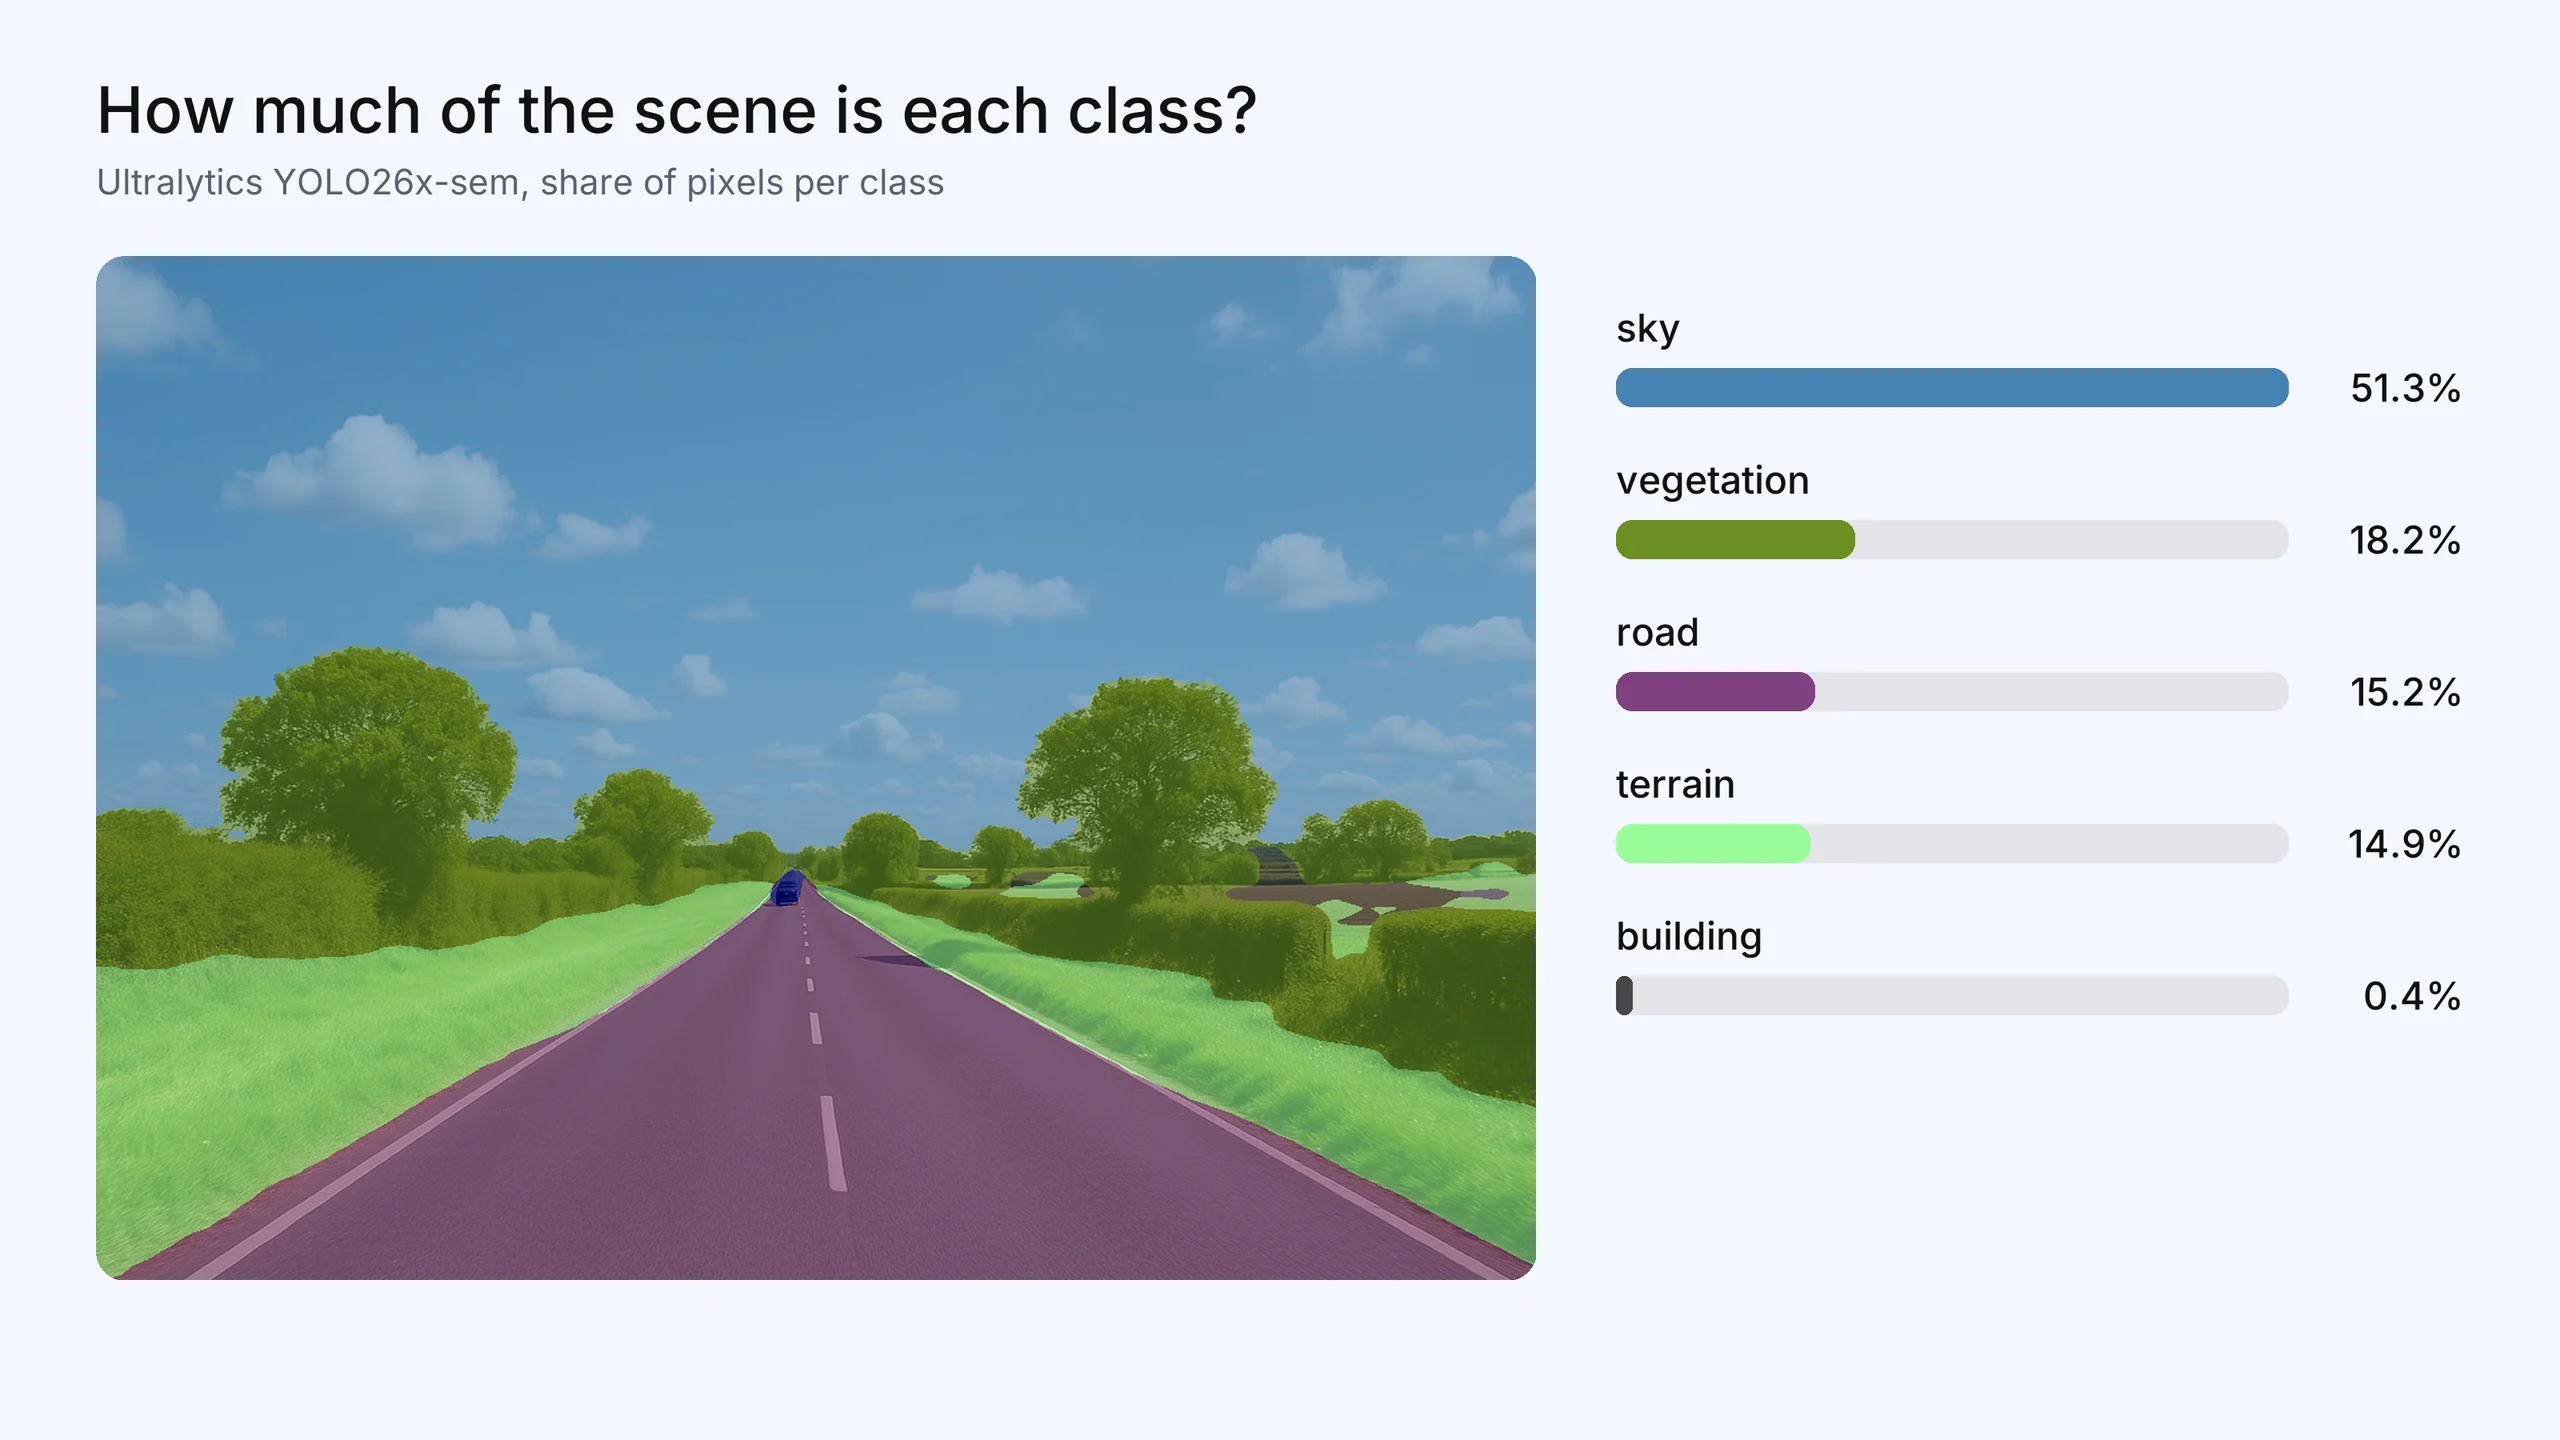
Abb. 3. Die semantische Segmentierung beantwortet die Frage: „Welchen Anteil der Szene nimmt jede Klasse ein?“ Ultralytics YOLO26x-sem kennzeichnet 51,3 % dieser Ansicht als Himmel, 18,2 % als Vegetation, 15,2 % als Straße und 14,9 % als Gelände. Das Foto wurde für diesen Artikel erstellt; die Klassenkarte und die Anteile stammen aus echten Modellausgaben.
Häufig gestellte Fragen
Bei der semantischen Segmentierung wird jedes Pixel einer Klasse zugeordnet, aber alle Objekte derselben Klasse werden als ein Bereich behandelt. Bei der Instanzsegmentierung erhält jedes Objekt eine eigene Maske, sodass Objekte derselben Klasse einzeln gezählt und verfolgt werden können.
Überlege, ob zwei sich berührende Objekte derselben Klasse voneinander unterschieden werden müssen. Wenn du einzelne Objekte zählen, verfolgen oder gezielt bearbeiten musst, verwende die Instanzsegmentierung. Wenn du nur wissen musst, welche Bereiche zu welcher Klasse gehören, ist die semantische Segmentierung einfacher.
Mask R-CNN ist ein Modell für Instanzsegmentierung. Es erkennt jedes Objekt und sagt dann eine separate Pixelmaske innerhalb der Bounding Box dieses Objekts voraus.
Instanzsegmentierung ist im Allgemeinen schwieriger. Dabei müssen Pixel klassifiziert und außerdem Objekte derselben Klasse voneinander getrennt werden, wofür sowohl Erkennung als auch Segmentierung erforderlich sind.
Meistens mit der mittleren Schnittmenge über Vereinigungsmenge (mIoU), also der durchschnittlichen Überlappung zwischen vorhergesagten und tatsächlichen Bereichen über alle Klassen hinweg. Bei der Instanzsegmentierung wird die Masken-mAP verwendet, bei der panoptischen Segmentierung die panoptische Qualität (PQ).









