Die besten Bildklassifizierungsmodelle: So triffst du die richtige Wahl
Vergleiche führende Bildklassifizierungsmodelle – von ConvNeXt V2 und DINOv3 bis EfficientNetV2, ViT und Ultralytics YOLO26-cls – und erfahre, wie du das passende Modell auswählst.
Es gibt nicht das eine beste Bildklassifizierungsmodell. Welches Modell passt, hängt davon ab, wie viele annotierte Daten du hast, wo das Modell ausgeführt werden muss und ob die Lizenz eine Nutzung erlaubt. Im Jahr 2026 konzentriert sich die Forschung mit Fokus auf Genauigkeit auf große Transformer- und selbstüberwachte Backbones wie DINOv3 und EVA-02. Für den Einsatz auf begrenzter Hardware sind kleinere, überwiegend faltungsbasierte Modelle wie ConvNeXt V2, EfficientNetV2, MobileNetV4 und Ultralytics YOLO26-cls oft praktischer – je nach Größe des Checkpoints, Trainingskonfiguration und Zielhardware. Vergleiche ihre Genauigkeit und Latenz mit deiner eigenen Arbeitslast. Dieser Leitfaden erläutert die vier Modellfamilien, vergleicht zehn weit verbreitete Modelle und zeigt dir, wie du das passende Modell auswählst.
Wenn du die Aufgabe selbst noch nicht kennst, beginne mit einer Erklärung der Bildklassifizierung. Auf dieser Seite geht es darum, ein Modell auszuwählen.
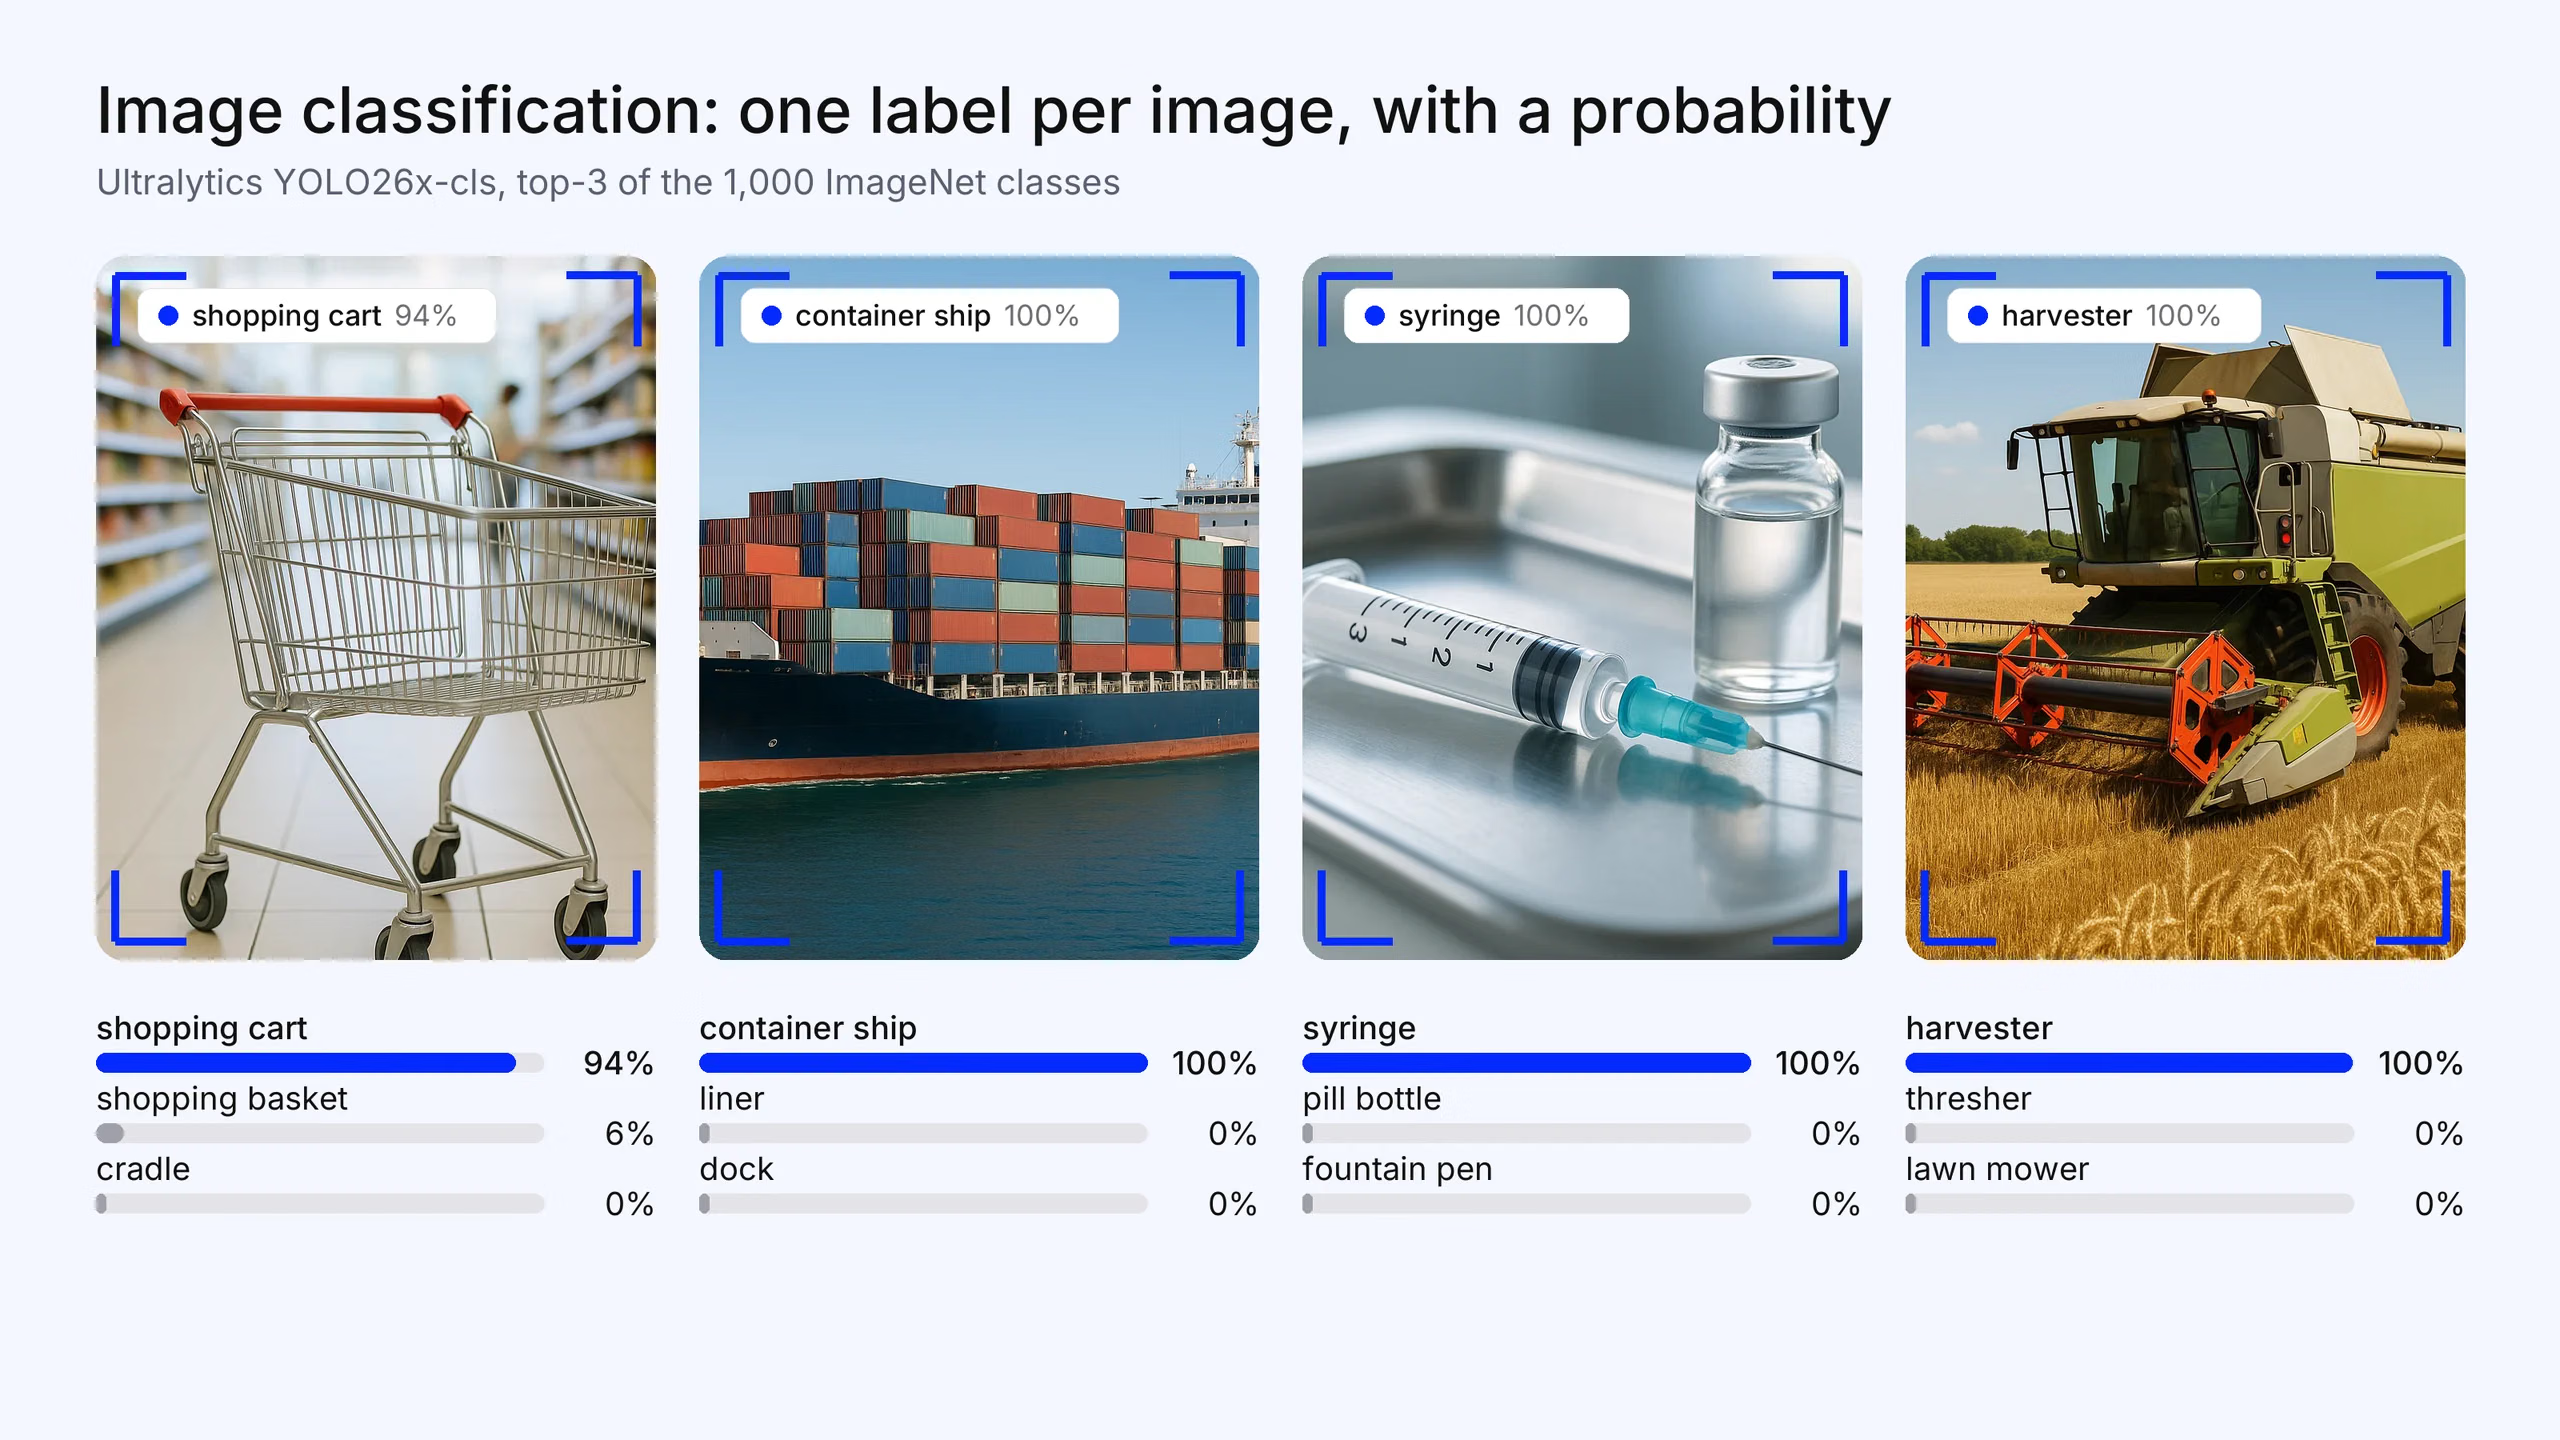
Abb. 1. Die Bildklassifizierung gibt ein Label für das gesamte Bild und eine Wahrscheinlichkeit für jede Klasse aus: Beispiele aus den Bereichen Einzelhandel, Logistik, Gesundheitswesen und Landwirtschaft. Die drei wahrscheinlichsten Vorhersagen stammen von Ultralytics YOLO26x-cls, das mit den 1.000 ImageNet-Klassen vortrainiert wurde. Die Fotos wurden für diesen Artikel erstellt; die Vorhersagen sind echte Modellausgaben.
Was „am besten“ bei einem Bildklassifizierungsmodell bedeutet#
Ranglisten sortieren Modelle nach ihrer Top-1-Genauigkeit auf dem ImageNet-Validierungsdatensatz. Dieser Wert ist nützlich, wird aber bei einer festen Auflösung und auf einem einzigen Datensatz gemessen, oft nach einem umfangreichen Vortraining. In realen Projekten entscheiden meist vier weitere Faktoren:
- Daten. Wie viele annotierte Bilder du pro Klasse hast und wie ähnlich sie den Vortrainingsdaten sind.
- Rechenleistung und Latenz. Ob die Inferenz auf einer GPU im Rechenzentrum, einer CPU oder einer NPU in einem Smartphone oder einer Kamera ausgeführt wird.
- Bereitstellung. Ob sich das Modell problemlos in das benötigte Laufzeitsystem exportieren lässt, zum Beispiel ONNX, TensorRT, Core ML oder TFLite.
- Lizenz. Ob der Code und – davon unabhängig – die vortrainierten Gewichte deine geplante Nutzung erlauben.
Ein Modell, das bei ImageNet ein paar Prozentpunkte schlechter abschneidet, sich aber gut mit deinen Bildern feinabstimmen lässt und in Echtzeit auf deiner Hardware läuft, ist meist die bessere Wahl.
Die vier Familien von Bildklassifizierungsmodellen#
Faltungsneuronale Netze (CNNs)#
CNNs wenden gelernte Filter über das gesamte Bild an und setzen dabei voraus, dass benachbarte Pixel zusammenhängen. Diese eingebaute Annahme (ein induktiver Bias) ermöglicht es ihnen, mit kleinen und mittelgroßen Datensätzen gut zu lernen und auf weniger leistungsfähiger Hardware effizient zu laufen. ResNet und EfficientNet sind klassische Beispiele.
- Stärken: effizient beim Datenbedarf, schnell sowie leicht zu quantisieren und bereitzustellen.
- Nachteile: weniger globaler Kontext pro Schicht; die Leistungssteigerungen durch Skalierung flachen meist früher ab als bei Transformern.
Vision Transformer (ViTs)#
Ein Vision Transformer unterteilt ein Bild in Bildausschnitte und verarbeitet sie mithilfe von Self-Attention als Sequenz. So kann jeder Ausschnitt mit jedem anderen in Beziehung gesetzt werden. ViTs erzielen die besten Ergebnisse, wenn sie mit großen Datenmengen vortrainiert und anschließend übertragen werden.
- Stärken: skaliert gut mit Datenmenge und Modellgröße; starke Übertragbarkeit; eine natürliche Grundlage für selbstüberwachtes und multimodales Training.
- Nachteile: benötigt ein umfangreiches Vortraining oder starke Regularisierung; ist bei der Inferenz meist langsamer und rechenintensiver als ein CNN mit ähnlicher Genauigkeit.
Hybride CNN-Transformer-Modelle#
Hybride Modelle nutzen in den frühen Stufen Faltungen für lokale Details und in den späteren Stufen Attention für den globalen Kontext. CoAtNet ist das Referenzdesign: Die Autoren stellten fest, dass das gezielte Aufeinanderstapeln von Faltungs- und Attention-Schichten die Generalisierung, Kapazität und Effizienz verbessert.
- Stärken: eine gute Balance bei mittelgroßen Datensätzen.
- Nachteile: komplexer zu implementieren, abzustimmen und zu exportieren als die beiden reinen Ansätze.
Selbstüberwachte und Vision-Language-Backbones#
Die neueste Familie zeichnet sich nicht durch ihre Architektur aus, sondern durch die Art des Trainings. Selbstüberwachte Modelle wie DINOv2 und DINOv3 lernen aus nicht annotierten Bildern. Vision-Language-Encoder wie SigLIP 2 lernen aus Bild-Text-Paaren. Beide erzeugen vielseitig einsetzbare Merkmale, die du mit einem kleinen linearen Klassifikationskopf oder – bei Vision-Language-Modellen – mit Text-Prompts ganz ohne Training klassifizieren kannst (Zero-Shot-Lernen). Meta trainierte DINOv3 mit 7 Milliarden Parametern auf 1,7 Milliarden Bildern; DINOv2 hatte 1,1 Milliarden Parameter und wurde auf 142 Millionen Bildern trainiert.
- Stärken: leistungsfähige Merkmale bei wenigen annotierten Daten; ein Backbone für viele Aufgaben.
- Nachteile: Die größten Checkpoints sind für Edge-Geräte viel zu rechenintensiv; die Lizenzen unterscheiden sich und müssen geprüft werden.
Bildklassifizierungsmodelle im Vergleich#
Die Modelle sind alphabetisch und nicht nach Rangfolge aufgeführt. Wir haben keine Genauigkeitswerte aufgenommen: Veröffentlichte ImageNet-Ergebnisse unterscheiden sich je nach Auflösung, Vortrainingsdaten und Evaluierungsverfahren und sind daher in diesen Zeilen nicht vergleichbar. Im jeweiligen Paper oder in der unten verlinkten Dokumentation findest du die Angaben zum Modell.
| Modell | Familie | Von | Vortraining | Am besten geeignet für | Wichtigster Nachteil |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Selbstüberwachtes maskiertes Autoencoding (FCMAE), anschließend überwachtes Feinabstimmen | Genaues, gut bereitstellbares CNN in vielen Größen | ImageNet-Gewichte unter CC-BY-NC (nicht kommerziell) |
| DINOv3 | Selbstüberwacht (ViT und ConvNeXt) | Meta | Selbstüberwacht mit 1,7 Mrd. Bildern trainiert | Leistungsfähige eingefrorene Merkmale, wenige annotierte Daten erforderlich | Eigene DINOv3-Lizenz; größtes Modell mit 7 Mrd. Parametern |
| EfficientNetV2 | CNN | Überwacht | Schnelles Training, effizientes Feinabstimmen | Älteres Design; neuere Backbones erzielen höhere Genauigkeit | |
| EVA-02 | ViT | BAAI | Maskiertes Bildmodellieren mit CLIP-Merkmalen | Forschung und Feinabstimmung mit Fokus auf Genauigkeit | Große Varianten sind bei der Inferenz rechenintensiv |
| MobileNetV4 | CNN und Hybridmodell (mobil) | Überwacht | Smartphones, NPUs und Edge-Beschleuniger | Geringere erreichbare Genauigkeit als bei Modellen für Server | |
| ResNet | CNN | Microsoft Research | Überwacht | Referenzmodelle, Lehre, bestehende Verarbeitungspipelines | Beim Verhältnis von Genauigkeit zu FLOPs nicht mehr konkurrenzfähig |
| SigLIP 2 | Vision-Language (ViT) | Bild-Text-Paare, mehrsprachig | Zero-Shot- und Open-Vocabulary-Klassifizierung | Validiere Zero-Shot-Ergebnisse für deine vorgesehenen Klassen, bevor du dich darauf verlässt | |
| Swin Transformer | ViT (hierarchisch) | Microsoft Research | Überwacht | Eingaben mit höherer Auflösung, Wiederverwendung des Backbones | Rechenintensiver als CNNs mit ähnlicher Genauigkeit |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Überwacht mit ImageNet trainiert | Schnelle benutzerdefinierte Klassifikatoren, Export für Edge-Geräte, eine API für Erkennung und Klassifizierung | Geringere erreichbare Genauigkeit als bei großen vortrainierten Transformern |
| ViT | ViT | Überwacht, oft mit großen Datensätzen | Transferlernen im großen Maßstab | Ohne umfangreiches Vortraining hoher Datenbedarf |
Die Modelle im Detail#
Alphabetisch aufgeführt.
ConvNeXt V2#
ConvNeXt V2 kombiniert einen vollständig faltungsbasierten maskierten Autoencoder (FCMAE) mit einer Global Response Normalization-Schicht. Das Modell ist in acht Größen verfügbar, von Atto (3,7 Mio. Parameter) bis Huge (660 Mio. Parameter), sodass die Familie Geräte vom Edge-Bereich bis zum Server abdeckt. Es ist eine überzeugende Standardwahl, wenn du eine Genauigkeit wie bei Transformern mit der Bereitstellung eines CNN verbinden möchtest. Nachteil: Der Code steht unter der MIT-Lizenz, die vortrainierten und feinabgestimmten ImageNet-Gewichte jedoch unter CC-BY-NC, wodurch ihre kommerzielle Nutzung ausgeschlossen ist.
DINOv3#
DINOv3 ist Metas selbstüberwachtes Vision-Backbone. Es ist als ViT-Modell von ViT-S/16 bis ViT-7B/16 verfügbar, außerdem gibt es destillierte ConvNeXt-Modelle für den Einsatz auf Geräten. Meta evaluiert das Modell mit eingefrorenem Backbone; außerdem enthält das Repository einen ImageNet-Klassifizierungskopf für das 7B-Modell. DINOv3 solltest du ausprobieren, wenn du nur wenige Labels hast und übertragbare Merkmale benötigst. Nachteil: Das Modell steht unter einer eigenen DINOv3-Lizenz statt einer gängigen Open-Source-Lizenz, und die herausragenden Ergebnisse stammen vom größten Modell.
EfficientNetV2#
EfficientNetV2 von Google nutzt progressives Lernen: Während des Trainings wird die Bildgröße schrittweise erhöht und die Regularisierung entsprechend angepasst. Dadurch lässt sich das Modell schneller trainieren und benötigt weniger Parameter als frühere Modelle. Für die Feinabstimmung auf kleinen bis mittelgroßen Datensätzen ist es nach wie vor eine zuverlässige Wahl. Nachteil: Das Modell stammt aus der Zeit vor den Backbones von 2023 bis 2025 und ist bei der Genauigkeit nicht mehr führend. Hintergrund zum ursprünglichen Design findest du in unserer Übersicht zu EfficientNet.
EVA-02#
EVA-02 ist ein einfacher Transformer, der mit maskiertem Bildmodellieren vortrainiert wurde, um Merkmale eines großen CLIP-Vision-Encoders zu rekonstruieren. Die vier Größen reichen von 6 Mio. bis 304 Mio. Parametern. Für die Feinabstimmung ist das Modell in timm verfügbar. Nachteil: Die großen Varianten sind bei der Feinabstimmung und Bereitstellung kostspielig und für einfache Klassifizierer auf bestimmte Anwendungsbereiche überdimensioniert.
MobileNetV4#
MobileNetV4 ist Googles neueste Modellfamilie für Mobilgeräte. Sie ist auf Effizienz bei mobilen CPUs, DSPs, GPUs, der Apple Neural Engine und dem Google Pixel EdgeTPU ausgelegt. Für Smartphones oder stromsparende Beschleuniger ist das Modell eine naheliegende Wahl. Nachteil: Für eine geringere Latenz wird auf maximale Genauigkeit verzichtet.
ResNet#
ResNet führte Residualverbindungen ein und ist nach wie vor das Standard-Referenzmodell, das von jedem Framework unterstützt wird. Nachteil: Neuere CNNs erzielen bei gleichem Rechenaufwand eine höhere Genauigkeit. In unserer Erklärung zu ResNet-50 erfährst du mehr über die Architektur.
SigLIP 2#
SigLIP 2 (siehe unseren Glossareintrag zu SigLIP) ist Googles Familie mehrsprachiger Vision-Language-Encoder. Das Modell kann Bilder ohne Training anhand einer Liste von Text-Labels klassifizieren (ähnlich wie CLIP); die NaFlex-Variante behält außerdem das ursprüngliche Seitenverhältnis der Eingabe bei. SigLIP 2 eignet sich am besten, wenn sich deine Label-Liste häufig ändert oder du noch keine annotierten Daten hast. Nachteil: Die Zero-Shot-Qualität variiert je nach Anwendungsbereich. Validiere sie daher anhand deiner vorgesehenen Klassen, etwa Fehlertypen, bevor du dich darauf verlässt. Falls die Ergebnisse nicht ausreichen, trainiere einen Klassifizierungskopf oder stimme das Modell fein ab.
Swin Transformer#
Swin Transformer berechnet die Attention innerhalb verschobener lokaler Fenster. Dadurch wächst der Rechenaufwand linear mit der Bildgröße, was sich für Eingaben mit höherer Auflösung eignet. Nachteil: Das Modell ist rechenintensiver als ein CNN mit ähnlicher Genauigkeit; ConvNeXt wurde so entwickelt, dass es mit einfachen Faltungen dagegen konkurrieren kann.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls ist die Klassifizierungsvariante von Ultralytics YOLO26. Sie ist in fünf Größen verfügbar (n, s, m, l, x), umfasst 2,8 Mio. bis 29,6 Mio. Parameter (fusioniert), verarbeitet Eingaben mit 224 Pixeln und wurde mit ImageNet vortrainiert. Die Dokumentation nennt die Top-1- und Top-5-Genauigkeit auf dem ImageNet-Validierungsdatensatz sowie die CPU- und GPU-Latenz für jede Größe. Über dieselbe Python-API und CLI kannst du Klassifizierungs-, Erkennungs-, Segmentierungs- und Posenschätzungsmodelle trainieren, validieren und exportieren. Klassifizierer lassen sich unter anderem in die Formate ONNX, TensorRT, Core ML, OpenVINO und LiteRT exportieren. Die früheren YOLO11-cls-Modelle verwenden dieselben fünf Größen und dieselbe Eingabegröße. Nachteile:
- Genauigkeitsgrenze. Selbst das x-Modell ist im Vergleich zu großen vortrainierten Transformern wie EVA-02 oder DINOv3 klein und eignet sich daher nicht für Forschung mit Fokus auf Genauigkeit.
- Standardmäßig quadratische Zuschnitte. Beim Training kommt ein zufälliger Zuschnitt mit Größenänderung zum Einsatz, bei der Validierung ein mittiger Zuschnitt. Dadurch können Teile von Bildern mit extremen Seitenverhältnissen abgeschnitten werden. In der Dokumentation erfährst du, wie du stattdessen eine einfache Größenänderung verwendest.
- Lizenz. Ultralytics-Modelle stehen unter AGPL-3.0. Für die kommerzielle Nutzung in proprietärer Software ist eine Ultralytics-Enterprise-Lizenz erforderlich.
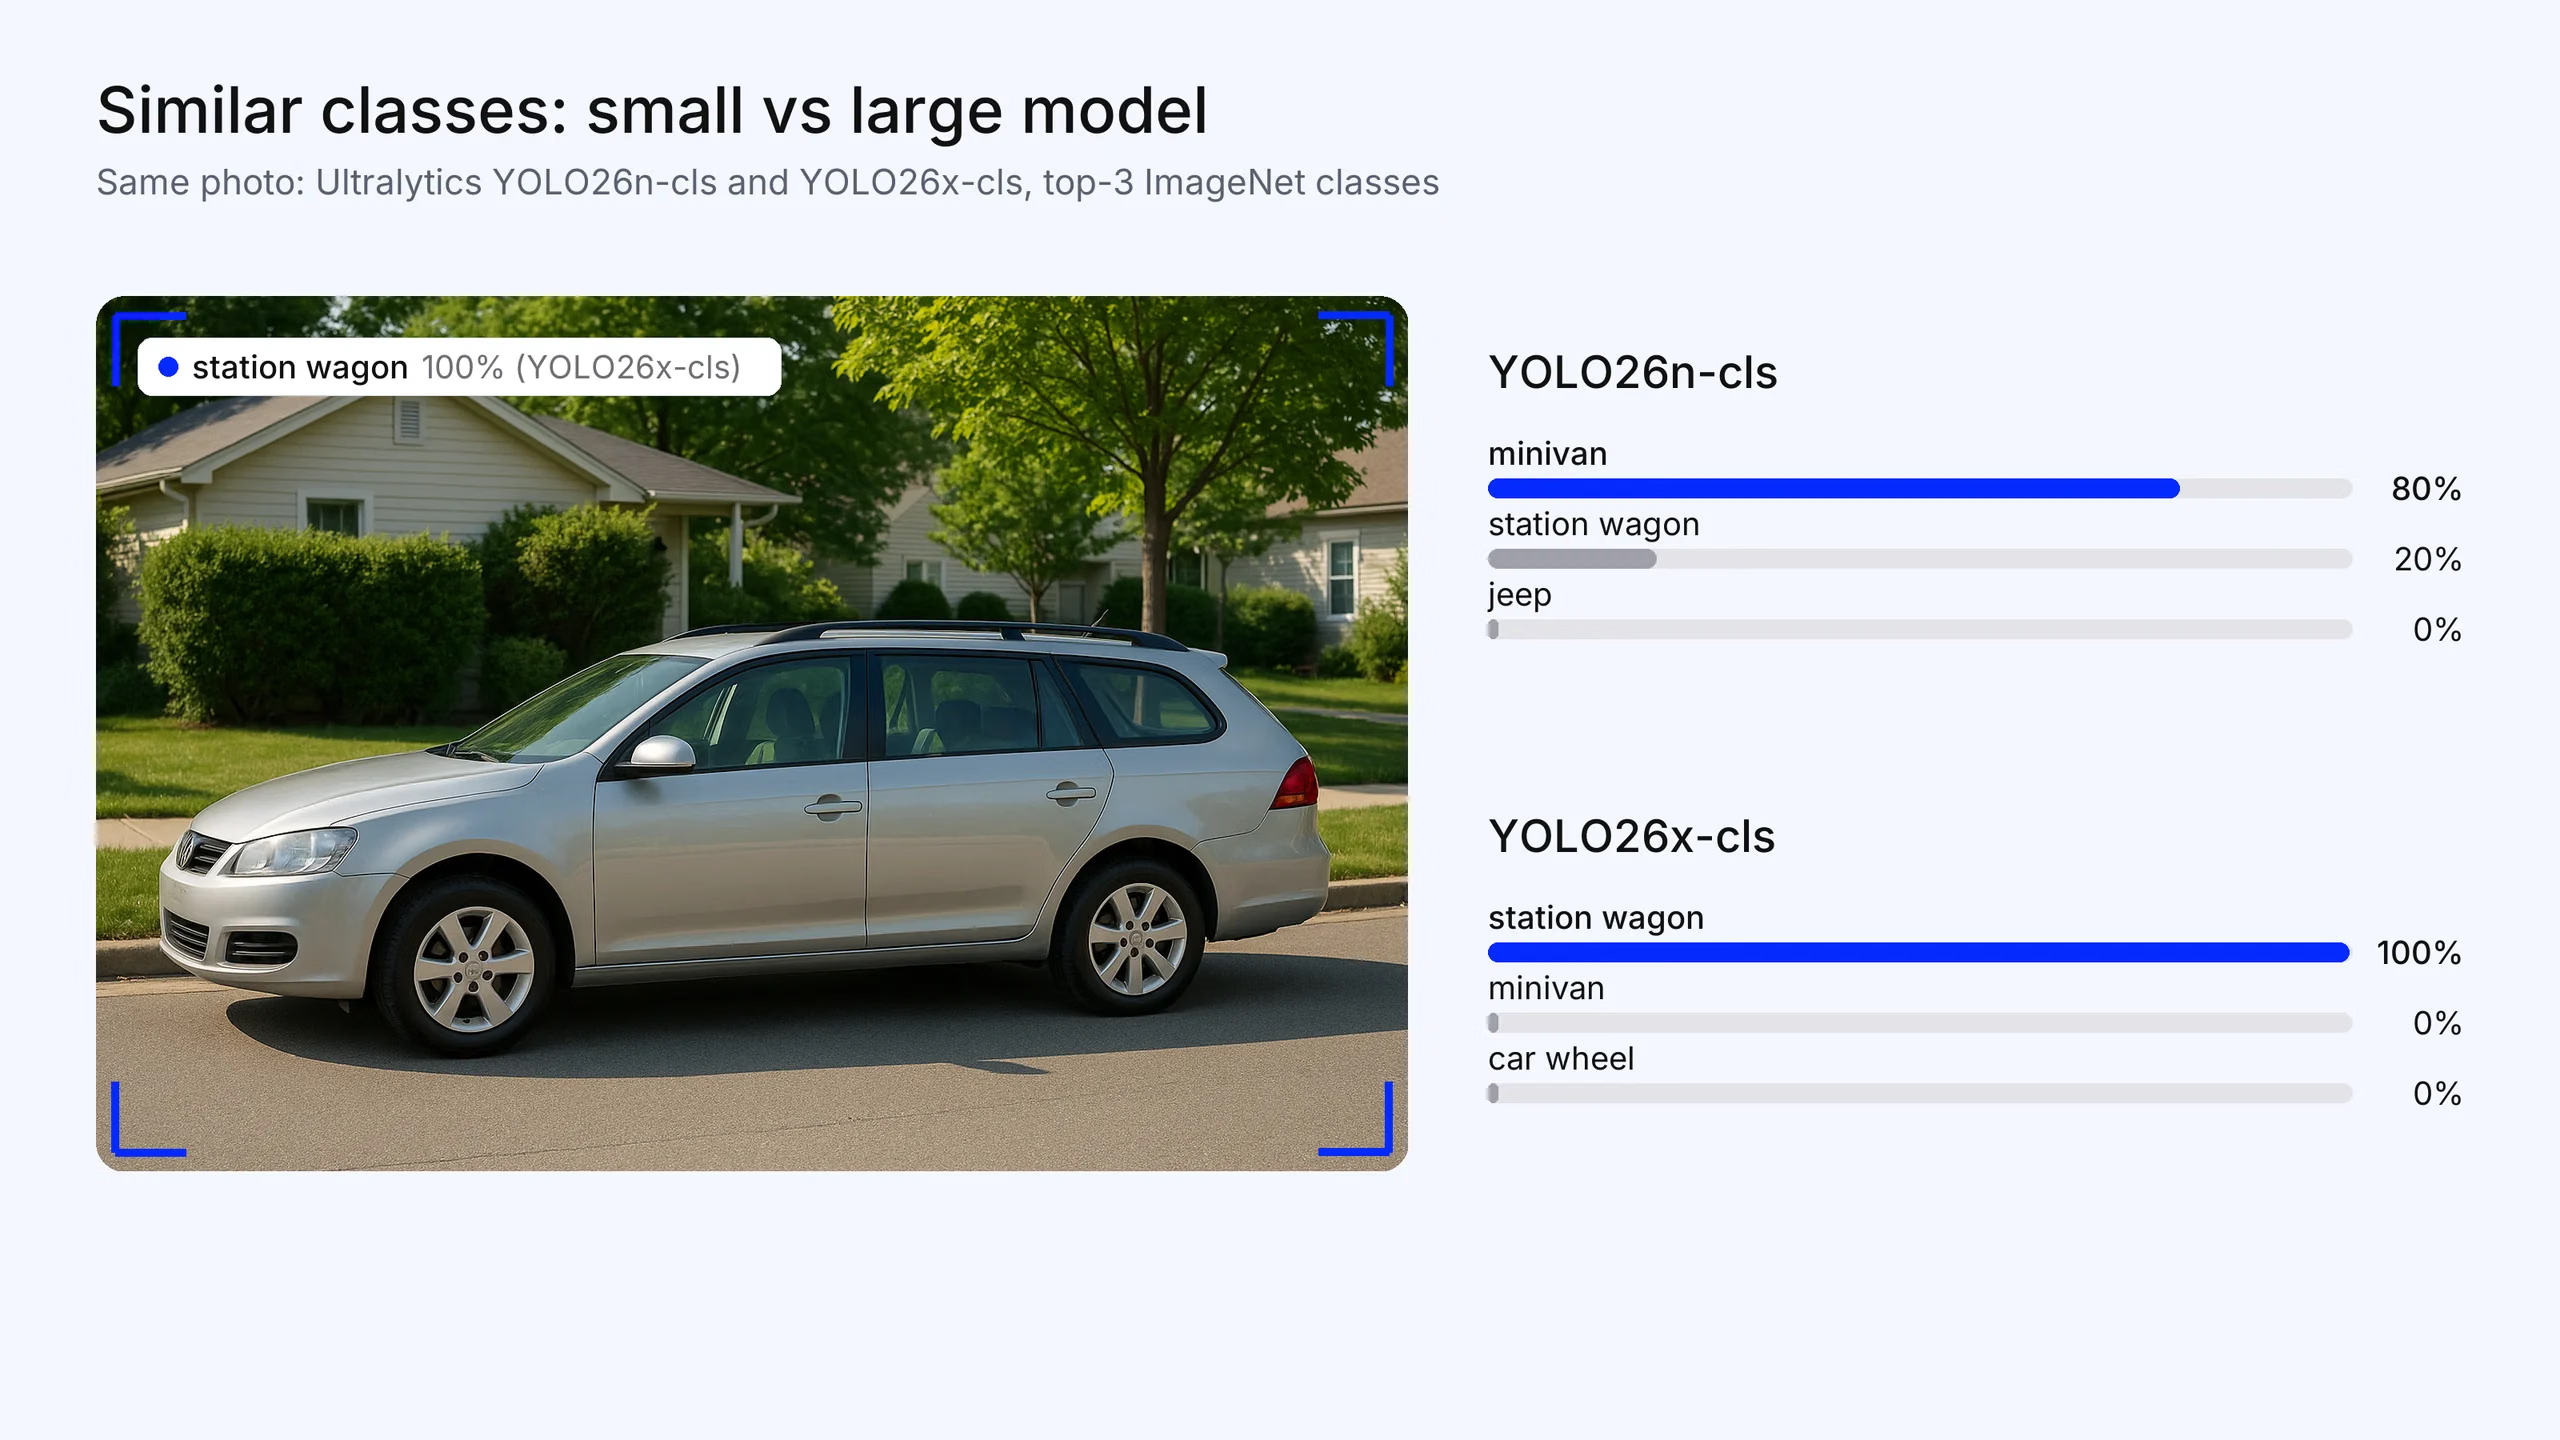
Abb. 2. Bei ähnlichen Klassen zeigt sich der Einfluss der Modellgröße. Auf diesem Foto eines Kombis stuft Ultralytics YOLO26n-cls „Minivan“ an erster Stelle ein (80 %), während YOLO26x-cls den Kombi an erster Stelle einordnet (100 %, angezeigt als ImageNet-Klasse „beach wagon, station wagon“). Prüfe solche feinkörnigen Klassen mit deinem eigenen Validierungsdatensatz. Das Foto wurde für diesen Artikel erstellt; die Vorhersagen sind echte Modellausgaben.
ViT#
Der ursprüngliche Vision Transformer von Google zeigte, dass ein reiner Transformer auf Bildausschnitten mit CNNs mithalten oder sie übertreffen kann, wenn er mit großen Datenmengen vortrainiert wird. Kompromiss: Ohne Vortraining mit großen Datenmengen schneidet er bei kleinen Datensätzen schlechter ab als CNNs und benötigt bei der Inferenz mehr Rechenleistung.
So wählst du ein Bildklassifizierungsmodell aus#
Gehe diese Fragen der Reihe nach durch:
- Hast du gelabelte Daten? Wenn du keine gelabelten Beispiele hast, starte mit einem Vision-Language-Modell wie SigLIP 2 für Zero-Shot-Klassifizierung. Bei einem kleinen gelabelten Datensatz solltest du auch einen eingefrorenen DINOv3-Backbone mit einem trainierten linearen Klassifikator prüfen.
- Wo soll das Modell laufen? Auf einem Smartphone oder einer NPU solltest du MobileNetV4 oder ein kleines CNN wie YOLO26n-cls oder ein kleines ConvNeXt V2 in Betracht ziehen. Für Echtzeitverarbeitung auf einer Edge-GPU oder CPU kommen YOLO26-cls, EfficientNetV2 oder ConvNeXt V2 infrage. Auf einem Server ohne strenge Latenzvorgaben solltest du EVA-02, Swin oder ein DINOv3 ViT erwägen.
- Wie viele gelabelte Daten hast du pro Klasse? Bei einigen Hundert bis wenigen Tausend Bildern ist Transfer Learning mit einem vortrainierten CNN oder einem eingefrorenen selbstüberwachten Backbone der sicherste Weg. Bei Zehntausenden Bildern oder mehr lohnt sich der vollständige Feinschliff von Transformern.
- Darfst du die Lizenz nutzen? Prüfe die Gewichte, nicht nur den Code: Die ImageNet-Gewichte von ConvNeXt V2 sind nicht für die kommerzielle Nutzung freigegeben, DINOv3 hat eine eigene Lizenz, und Ultralytics-Modelle stehen unter AGPL-3.0, sofern du keine Enterprise-Lizenz hast.
- Kann das Modell in deine Laufzeitumgebung exportiert werden? Vergewissere dich vor deiner Entscheidung, dass ein unterstützter Exportweg zu ONNX, TensorRT, Core ML oder TFLite verfügbar ist.
Führe anschließend einen Feinschliff an zwei oder drei Modellen aus deiner engeren Auswahl durch und vergleiche sie mit deiner eigenen Validierungsaufteilung.
Wann ein anderes Modell besser für dich geeignet ist als YOLO#
YOLO26-cls wurde für schnelle, einfach bereitzustellende benutzerdefinierte Klassifizierer entwickelt. Für manche Aufgaben ist ein anderes Modell die bessere Wahl:
- Forschung oder Benchmarking mit Fokus auf Genauigkeit: Verwende EVA-02, ConvNeXt V2 oder ein ViT über timm, wenn es Trainingsrezepte und Gewichte gibt, mit denen sich Ergebnisse auf ImageNet-Niveau reproduzieren lassen.
- Sehr wenige Labels oder viele nachgelagerte Aufgaben mit einem Backbone: Verwende DINOv3-Merkmale mit einem linearen Klassifikator.
- Offene oder häufig wechselnde Label-Sets: Verwende SigLIP 2 im Zero-Shot-Verfahren.
- Smartphone-NPUs wie die Apple Neural Engine oder EdgeTPU: MobileNetV4 wurde genau für diese Zielplattformen entwickelt und getestet.
Wenn du zusätzlich herausfinden musst, wo sich Objekte befinden, und nicht nur, was das Bild zeigt, brauchst du einen Detektor. Sieh dir unseren Vergleich der Objekterkennungsmodelle an.
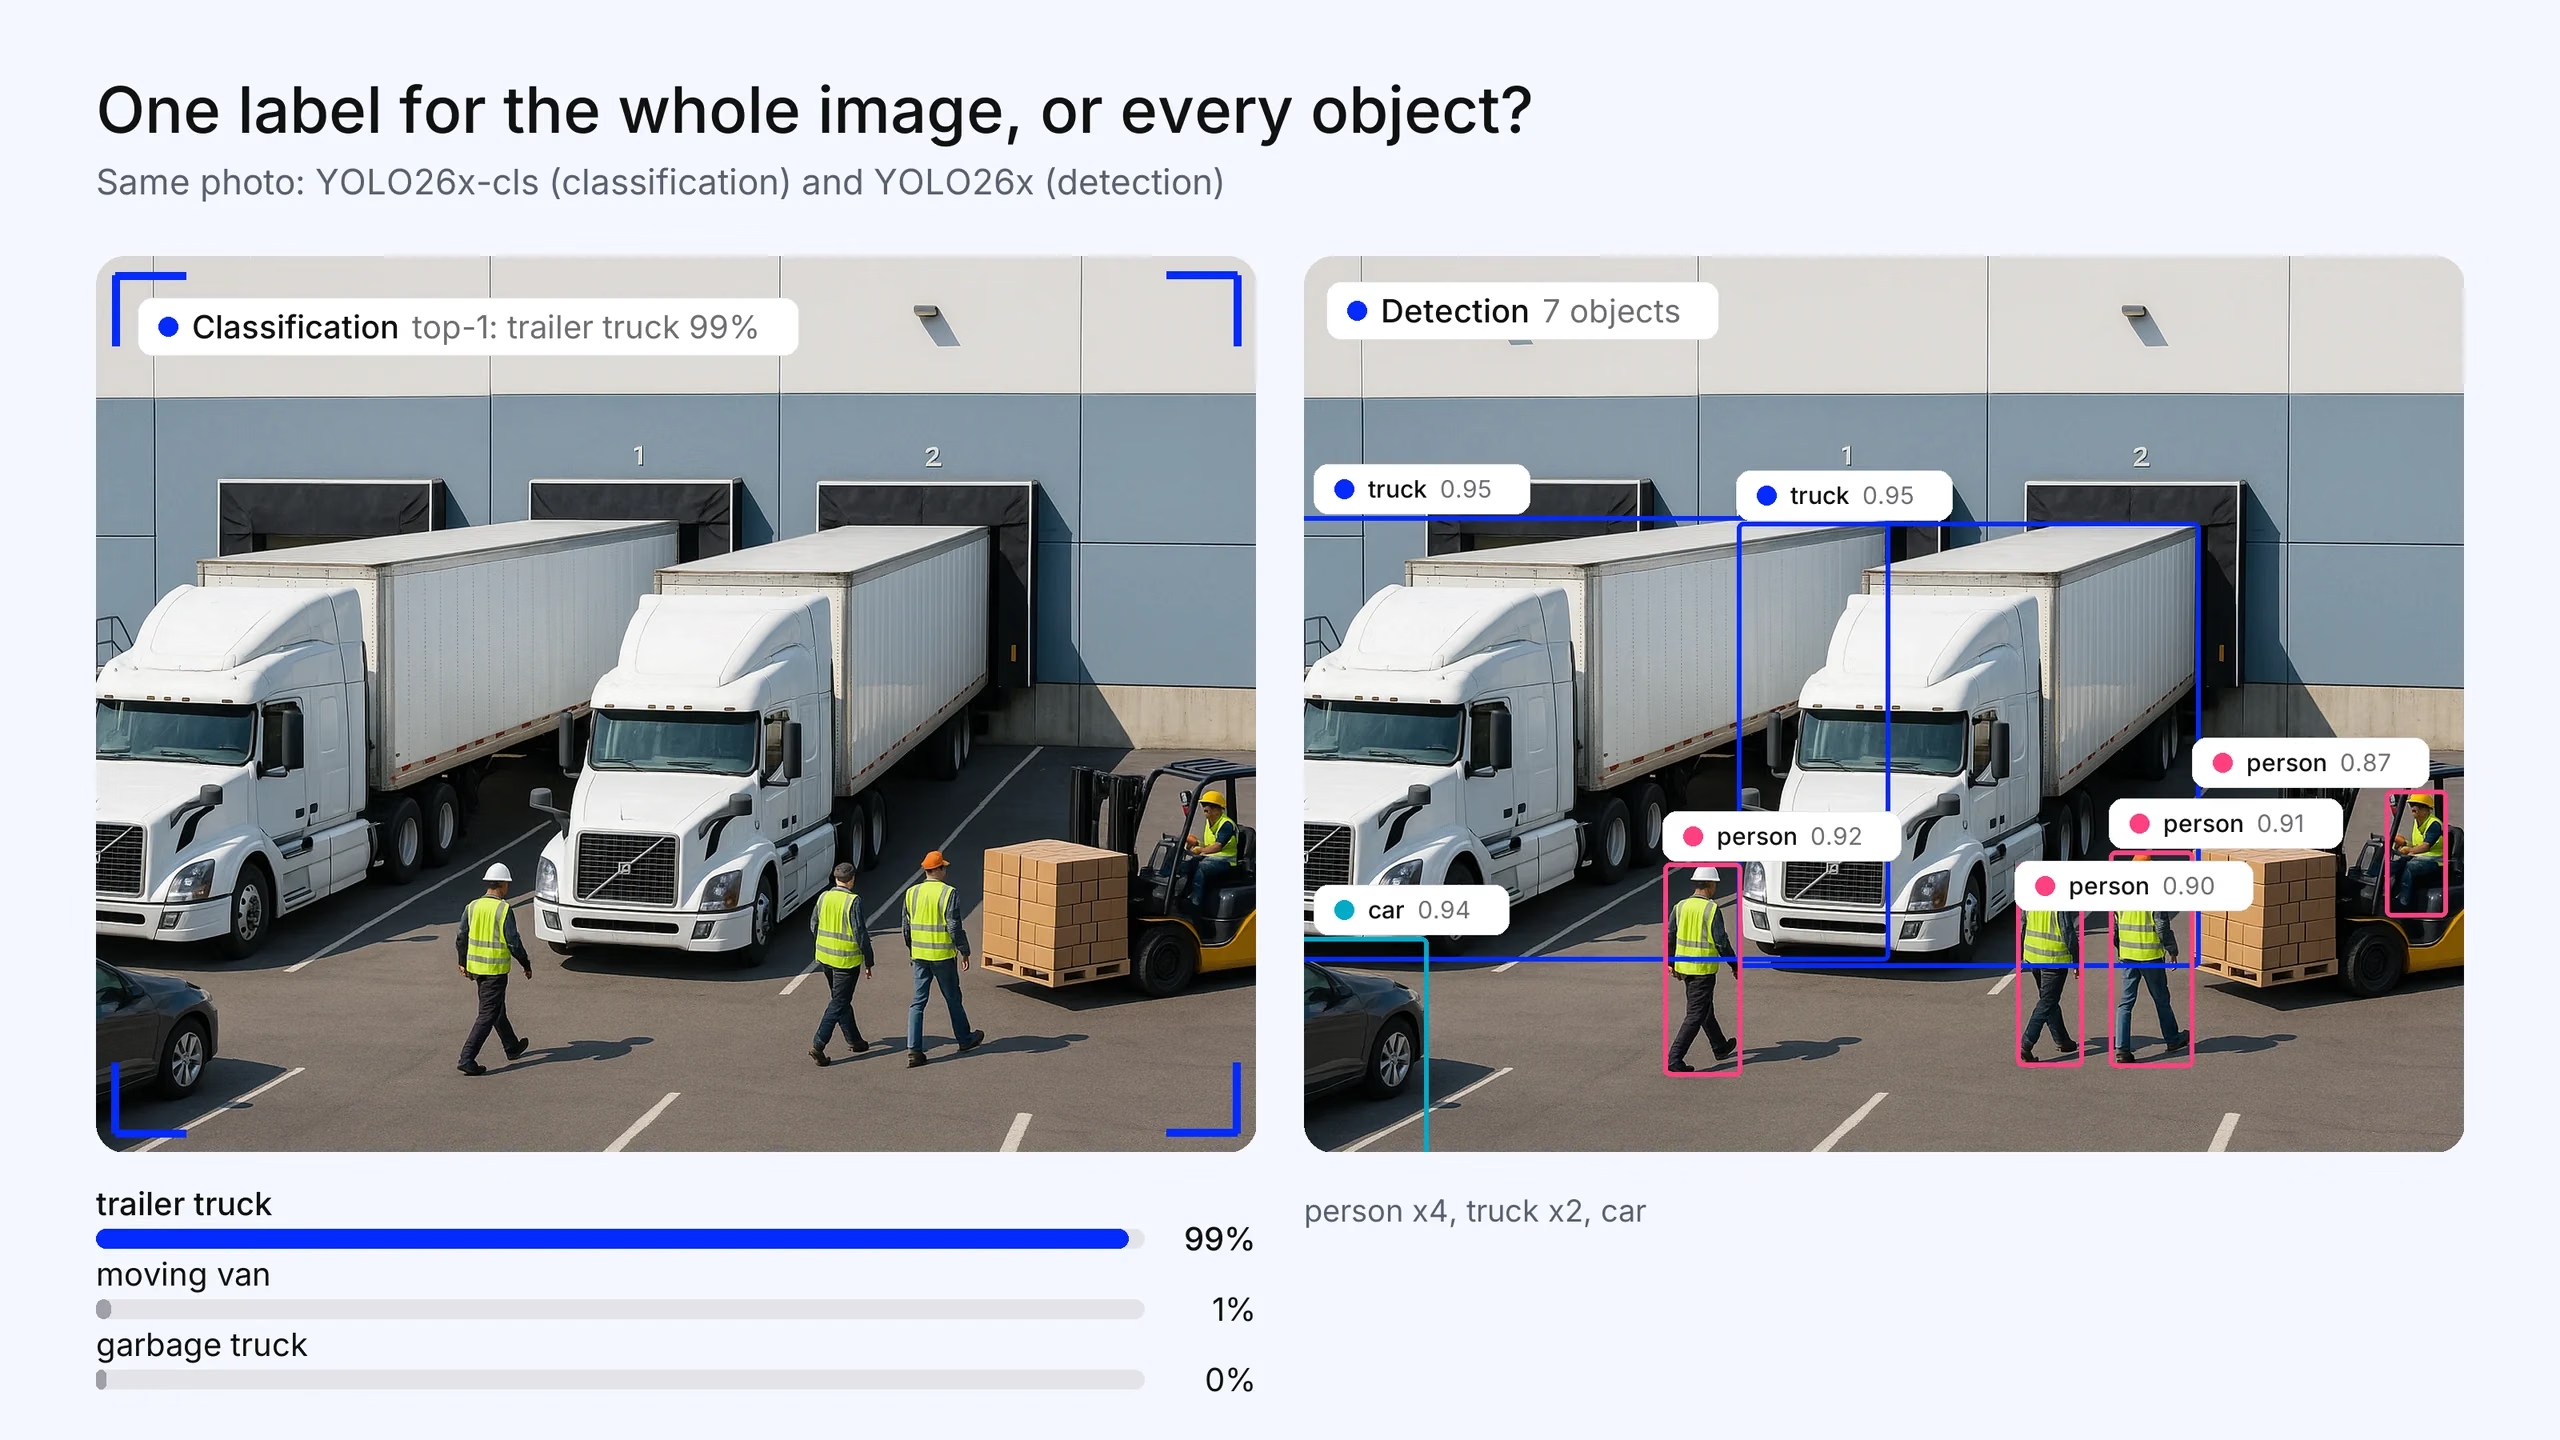
Abb. 3. In einer Szene mit vielen Objekten gibt ein Klassifizierer dennoch nur ein Label aus: Ultralytics YOLO26x-cls kennzeichnet diesen Güterumschlagplatz mit 99 % als „Sattelzug“. Die Objekterkennung von Ultralytics YOLO26 findet 7 Objekte: 4 Personen, 2 Lkw und ein Auto, jeweils mit einer eigenen Box (Konfidenz von mindestens 0,5). Das Foto wurde für diesen Artikel erstellt; die Ausgaben sind echt.
Wo du vortrainierte Modelle findest und eigene trainierst#
- timm (PyTorch Image Models) bündelt die meisten der oben genannten Backbones, von ViT und ConvNeXt bis hin zu MobileNetV4, EVA und DINOv3, sowie Trainings- und Evaluierungsskripte. Der Code steht unter Apache 2.0; die Lizenzen der Gewichte unterscheiden sich.
- Hugging Face hostet die meisten Transformer-Klassifizierer, darunter SigLIP 2 und DINOv3, mit sofort einsatzbereiten Pipelines für Zero-Shot- und Bildklassifizierung.
- Das Ultralytics Python-Paket trainiert YOLO26-cls mit einem nach Klassen sortierten Bildordner. Sieh dir das Format für Klassifizierungsdatensätze und die Anleitung zur Klassifizierungsaufgabe an.
- Die Ultralytics Platform ergänzt dieselben Modelle um Annotation und Cloud-Training. Sie wurde 2026 eingeführt und ist damit neuer als etablierte gehostete Trainingsdienste. Für die Bereitstellung von Modellen nach dem Training findest du hier unseren Vergleich der Inferenzplattformen für Computer Vision.
Häufig gestellte Fragen
Ein Modell eignet sich nicht für alle Fälle. Bei Aufgaben mit Fokus auf Genauigkeit und reichlich Rechenleistung solltest du zuerst große Transformer- und selbstüberwachte Backbones wie EVA-02 und DINOv3 prüfen. Für den Produktionseinsatz auf begrenzter Hardware sind CNNs wie ConvNeXt V2, EfficientNetV2, MobileNetV4 und Ultralytics YOLO26-cls praktischer. Für Klassifizierung ohne gelabelte Daten unterstützt SigLIP 2 Zero-Shot-Klassifizierung.
Transformer schneiden tendenziell besser ab, wenn sie mit sehr großen Datensätzen vortrainiert wurden und die Rechenleistung nicht knapp ist. CNNs sind bei kleinen bis mittelgroßen Datensätzen und auf Edge-Hardware meist überlegen, weil ihre eingebauten Annahmen über lokale Strukturen sie dateneffizient und schnell machen. Moderne CNNs wie ConvNeXt haben den Genauigkeitsunterschied verkleinert, und hybride Modelle wie CoAtNet kombinieren beide Ansätze.
Ja. DINOv3 ist ein universell einsetzbarer Backbone. Du extrahierst Merkmale mit dem eingefrorenen Modell und trainierst darauf einen kleinen linearen Klassifizierer. Das Repository von Meta enthält außerdem einen ImageNet-Klassifizierungskopf für das größte Modell. Prüfe vor der kommerziellen Nutzung die DINOv3-Lizenz.
Vor allem mit der Top-1-Genauigkeit (die oberste Vorhersage ist korrekt) und der Top-5-Genauigkeit (die korrekte Klasse gehört zu den fünf Vorhersagen mit der höchsten Bewertung), üblicherweise anhand des ImageNet-Validierungsdatensatzes. Bei unausgewogenen benutzerdefinierten Datensätzen sind Präzision, Trefferquote oder F1-Wert pro Klasse aussagekräftiger als die Gesamtgenauigkeit.









