Ultralytics YOLO26 frente a otros modelos Ultralytics YOLO para la estimación de pose
Descubre cómo Ultralytics YOLO26 mejora la estimación de pose gracias a una mejor compatibilidad con puntos clave no humanos, una convergencia más rápida, una gestión mejorada de las oclusiones y una implementación eficiente en tiempo real.
Cuando observas la postura de alguien, es fácil notar si está encorvado, inclinado hacia delante o erguido. Las personas entendemos rápidamente cómo se relacionan entre sí las distintas partes del cuerpo.
Es una parte intrínseca de cómo interpretamos el movimiento y el lenguaje corporal en la vida cotidiana. Sin embargo, para las máquinas, este tipo de comprensión visual no es automática. Enseñar a un sistema a reconocer el movimiento y la estructura requiere técnicas avanzadas de aprendizaje profundo y visión artificial que le permitan interpretar las imágenes de forma significativa.
En concreto, la estimación de pose es una técnica de IA visual que permite que un modelo de visión artificial adquiera una comprensión similar. En lugar de limitarse a detectar un objeto en una imagen, el modelo predice puntos clave que representan referencias estructurales importantes.
Estos puntos clave pueden corresponder a articulaciones del cuerpo, extremidades de animales, componentes de maquinaria o incluso puntos fijos, como las esquinas de una pista. Al identificar y seguir estos puntos, el sistema puede comprender la posición, la alineación y el movimiento de forma estructurada y cuantificable.
A medida que la estimación de pose se aplica a más situaciones reales, los modelos deben gestionar con mayor eficacia puntos clave no humanos, escenas complejas y conjuntos de datos personalizados. Por ejemplo, modelos de última generación como Ultralytics YOLO26 admiten tareas de visión artificial como la estimación de pose y se basan en modelos YOLO de pose anteriores, con mejoras arquitectónicas y de entrenamiento diseñadas para aumentar la flexibilidad y el rendimiento general.
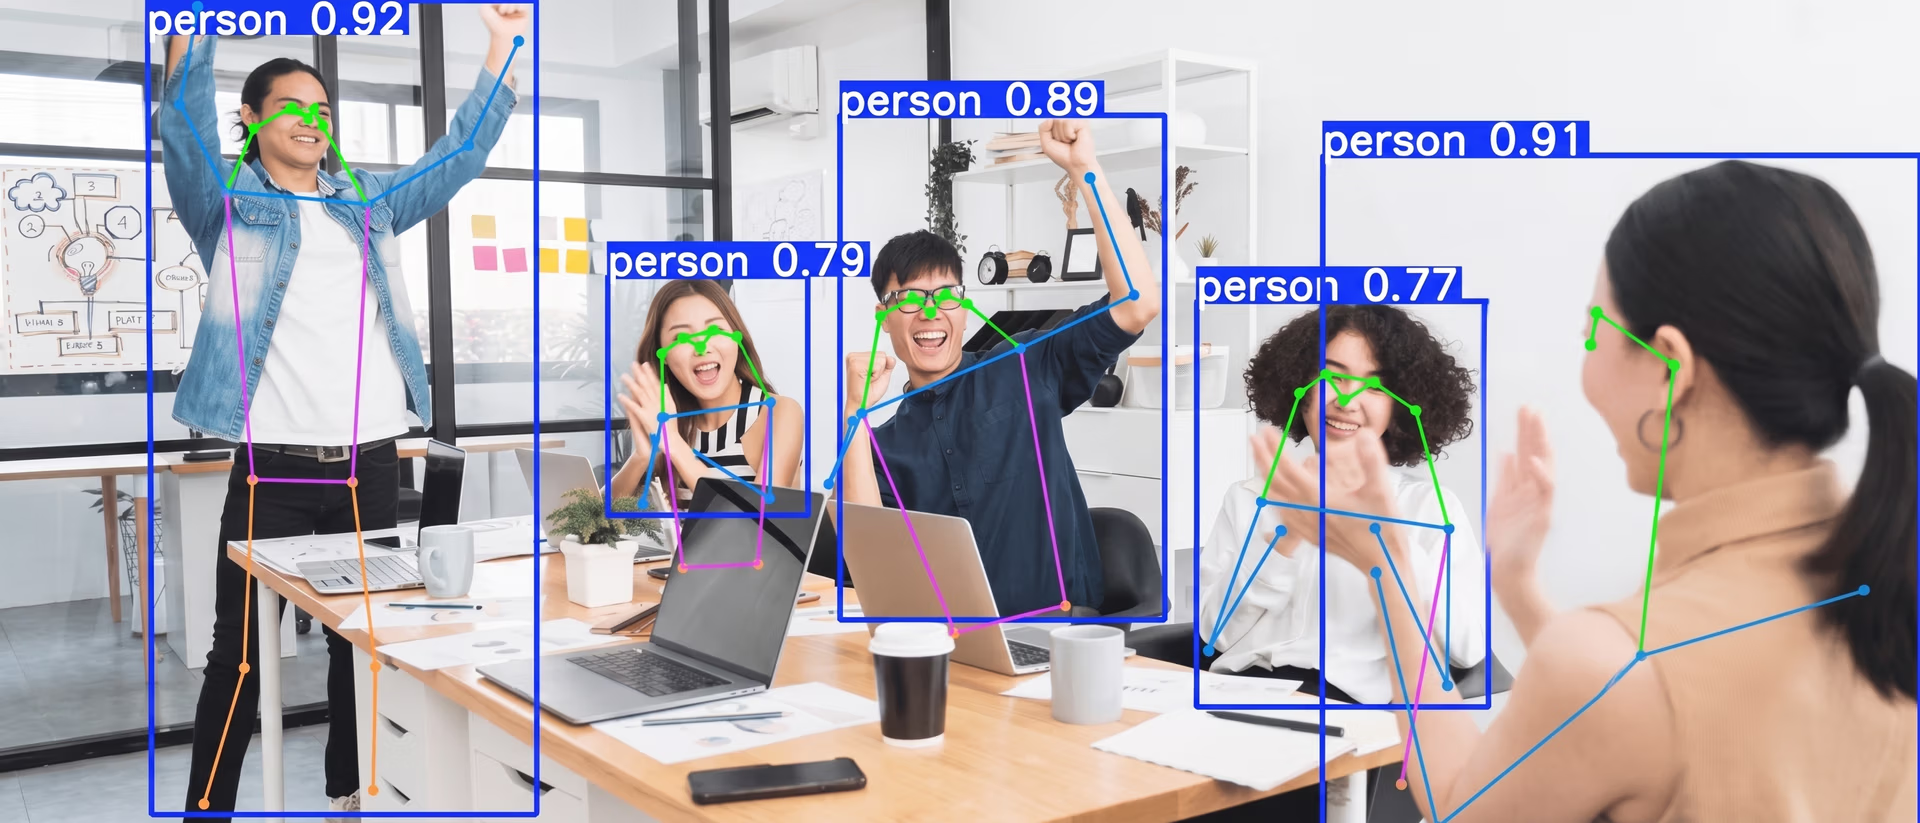
Fig. 1. Ejemplo de estimación de pose con YOLO (Fuente)
En este artículo compararemos YOLO26-pose con los modelos Ultralytics YOLO de pose anteriores y veremos cómo mejora la flexibilidad, la velocidad de convergencia y el rendimiento en escenas complejas. ¡Empecemos!
¿Qué es la estimación de poses?#
Antes de ponernos a comparar los modelos de estimación de pose de Ultralytics YOLO, veamos más de cerca qué significa realmente la estimación de pose en el contexto de la visión artificial.
La estimación de pose es una técnica que se utiliza para detectar y seguir puntos clave específicos en una imagen o un fotograma de vídeo. Estos puntos pueden representar referencias estructurales importantes, como las articulaciones de un cuerpo humano, las extremidades de un animal, los componentes de una máquina o puntos de referencia fijos de una escena.
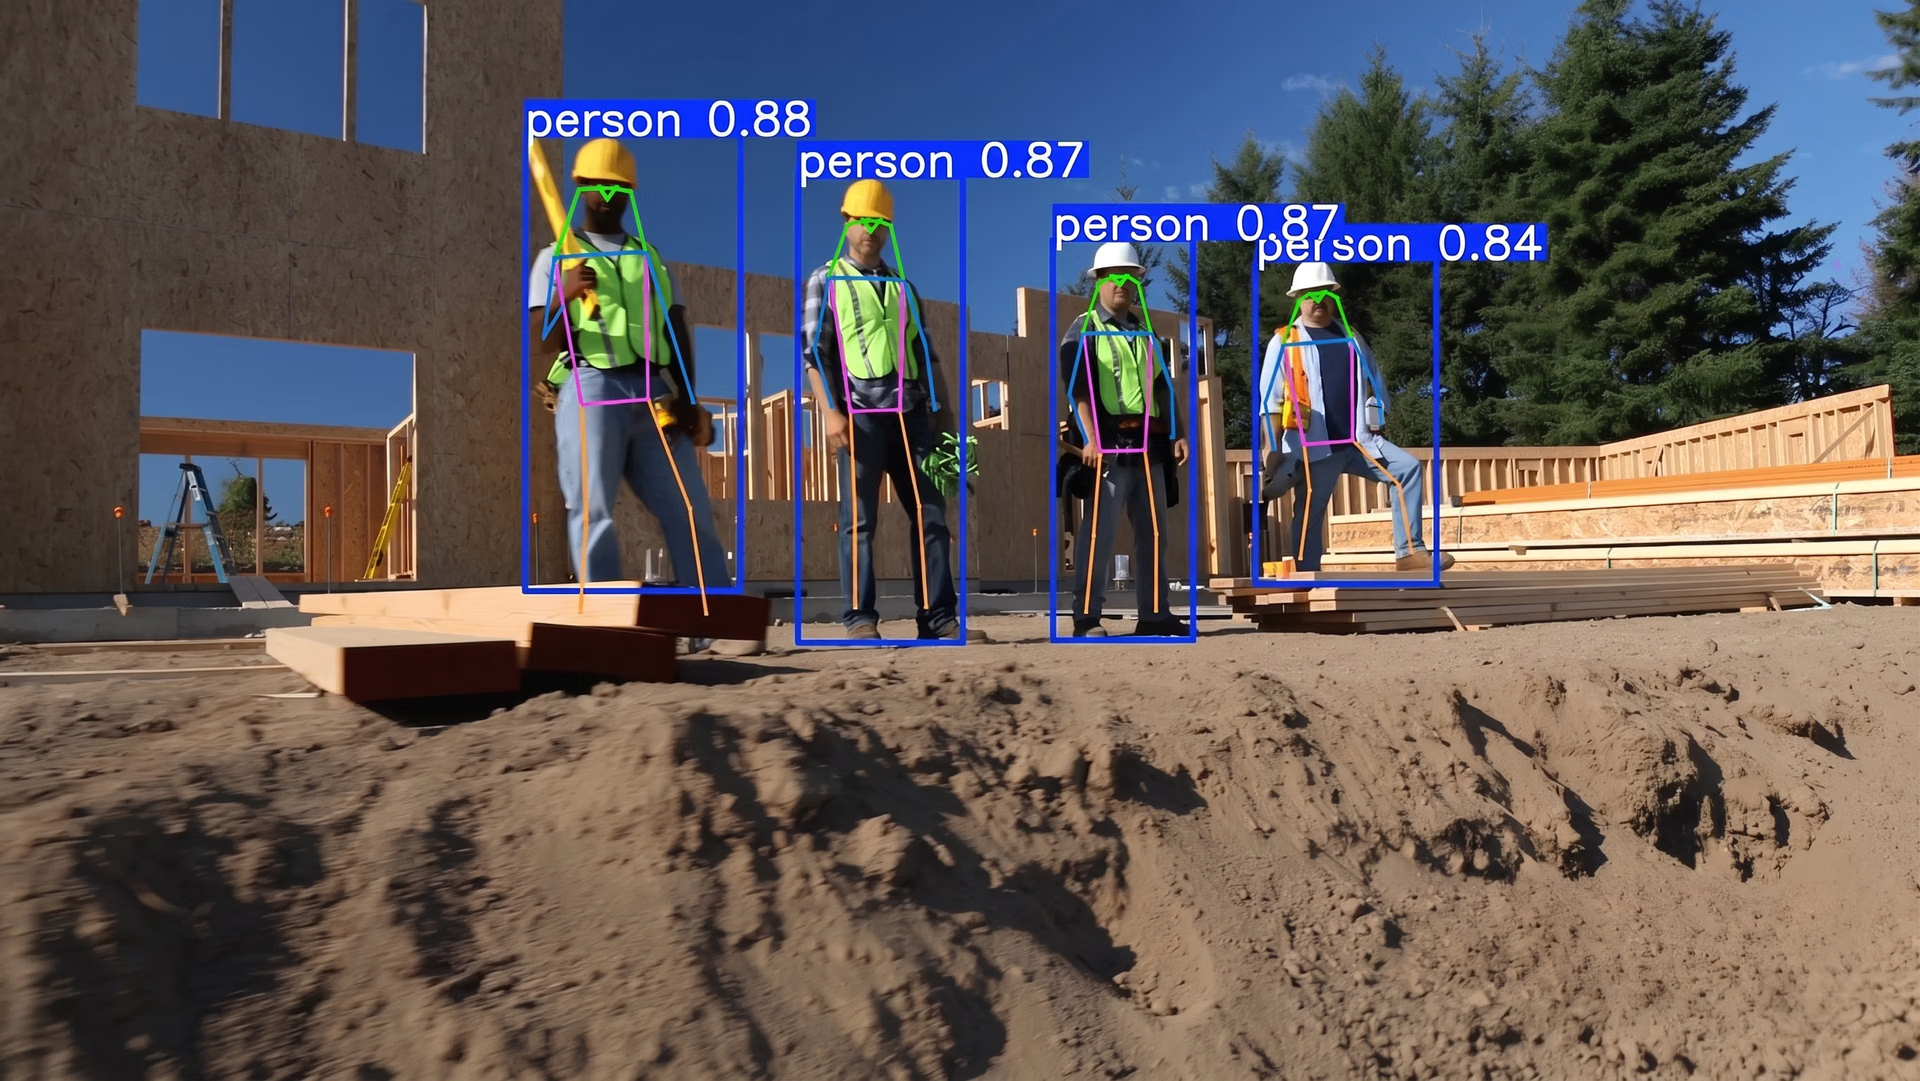
Fig. 2. Estimación de la pose de trabajadores mediante la estimación de pose humana (Fuente)
Al identificar las coordenadas de estos puntos, un modelo puede comprender cómo está colocado un objeto y cómo se mueve con el tiempo. A diferencia de la clasificación de imágenes, que asigna una sola etiqueta a toda una imagen, o de los modelos de detección de objetos, que se centran en dibujar cuadros delimitadores alrededor de los objetos, la estimación de pose proporciona información espacial más detallada sobre la estructura y el movimiento.
Descripción general de Ultralytics YOLO26-pose#
YOLO26-pose está disponible en varias variantes o tamaños de modelo, incluidas opciones ligeras como YOLO26n-pose y modelos más grandes, como YOLO26m-pose, YOLO26l-pose y YOLO26x-pose. Esto permite a los equipos elegir el equilibrio adecuado entre velocidad y precisión según el hardware y los requisitos de rendimiento.
Ultralytics también ofrece modelos de pose preentrenados con grandes conjuntos de datos generales, como COCO; en concreto, con las anotaciones COCO-Pose (puntos clave de COCO) para estimar la pose humana, por lo que no tienes que empezar desde cero. En la mayoría de los casos, los equipos ajustan estos modelos con sus propios conjuntos de datos para adaptarlos a puntos clave, distribuciones o entornos específicos.
Esto suele implicar preparar archivos de anotación personalizados que definan las coordenadas de los puntos clave y las etiquetas de clase en un formato estructurado. Estas anotaciones asignan los puntos clave a coordenadas de píxel específicas de cada imagen, lo que permite al modelo aprender relaciones espaciales precisas durante el entrenamiento.
El uso de modelos preentrenados acelera el entrenamiento, reduce los requisitos de datos y ayuda a llevar los proyectos a producción con mayor eficiencia.
Aplicaciones reales de la estimación de pose humana#
Aquí tienes algunos ejemplos de aplicaciones reales en las que la estimación de pose desempeña un papel importante:
- Sanidad y rehabilitación: Los profesionales clínicos pueden utilizar modelos de pose para evaluar la postura, supervisar la recuperación y analizar patrones de movimiento durante la fisioterapia.
- Sistemas autónomos: Los drones y las cámaras inteligentes pueden utilizar información de pose para comprender mejor la orientación y el movimiento de los objetos en escenas dinámicas.
- Seguridad en el trabajo: Las organizaciones pueden supervisar la posición corporal y los movimientos repetitivos para ayudar a identificar posibles riesgos para la seguridad.
- Entrenamiento físico y personal: Las aplicaciones de fitness utilizan la estimación de pose para seguir la técnica de los ejercicios, contar las repeticiones y ofrecer información en tiempo real sobre la postura y el movimiento durante las sesiones de entrenamiento.
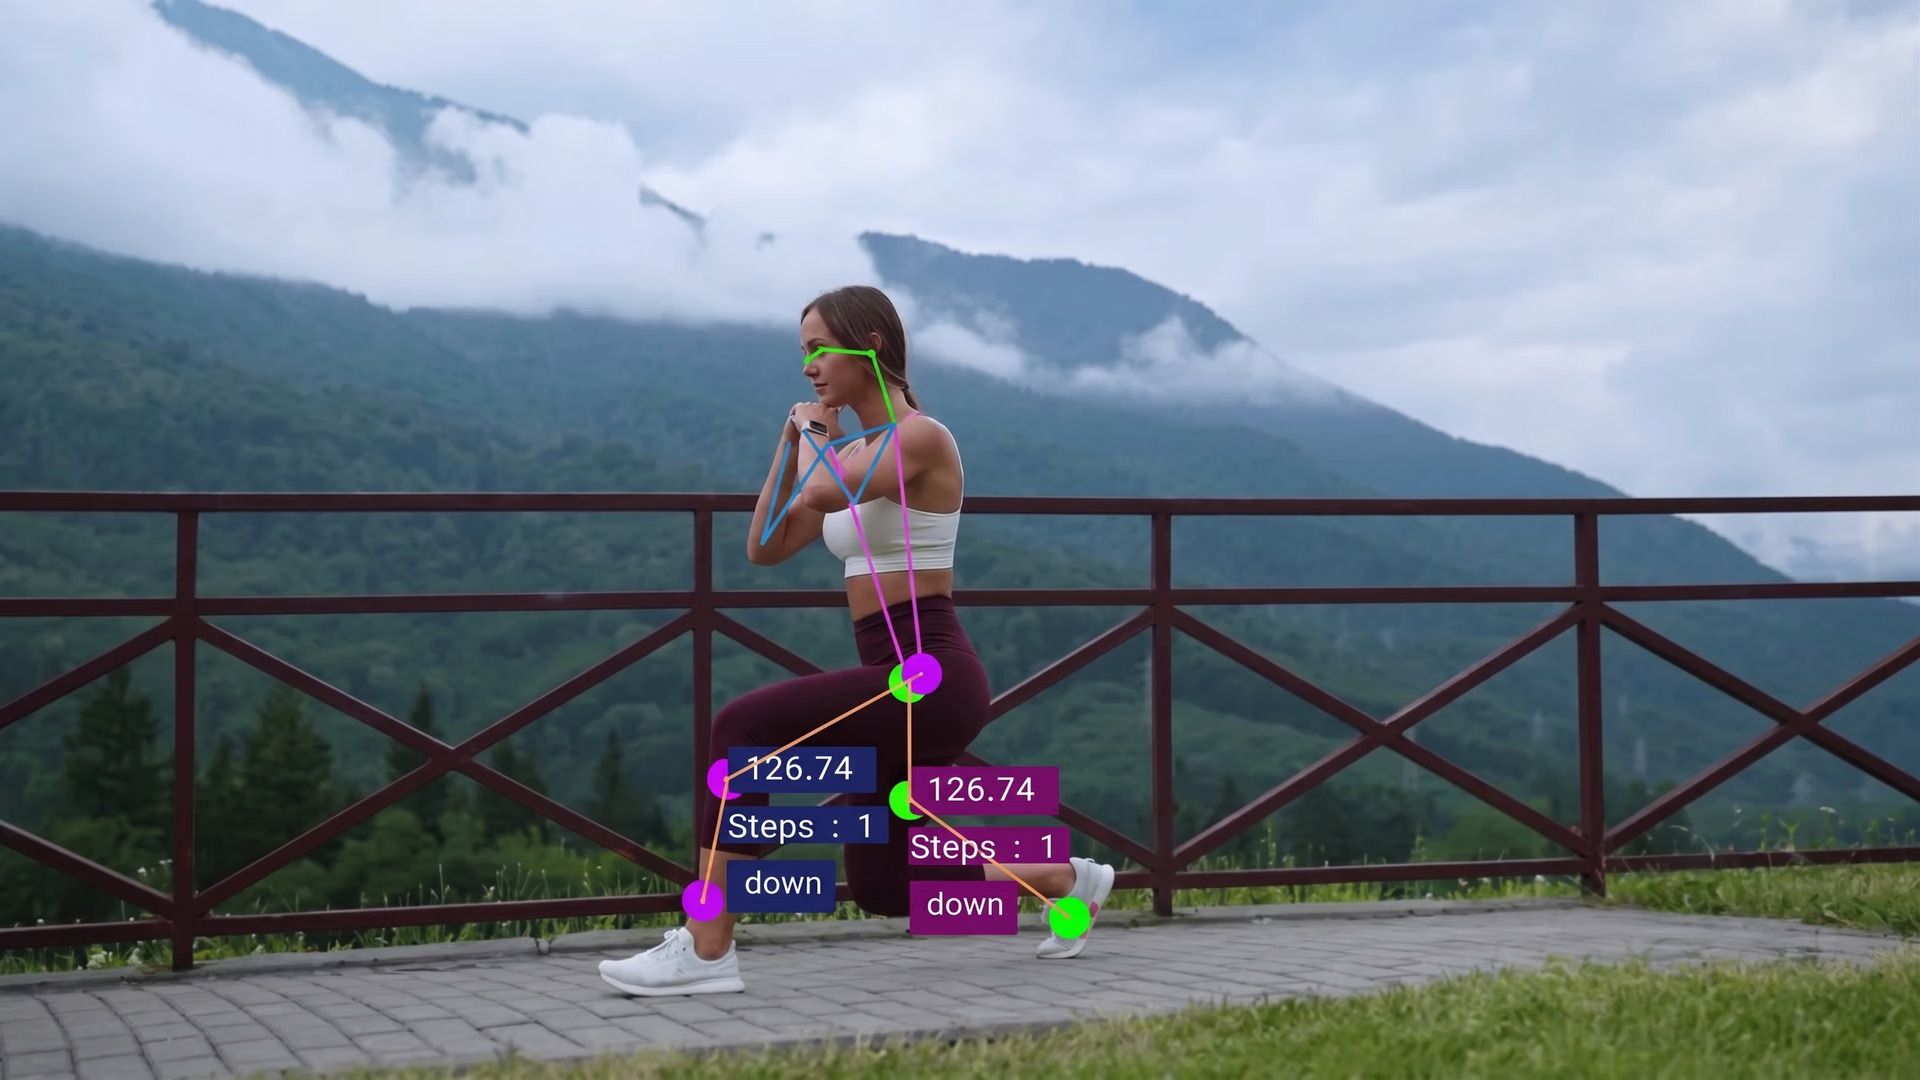
Fig. 3. La estimación de pose puede ayudar a seguir puntos clave del cuerpo durante el movimiento atlético. (Fuente)
Novedades sobre la compatibilidad de Ultralytics YOLO26 con la estimación de pose#
Ultralytics YOLO26 se basa en modelos Ultralytics YOLO anteriores e incorpora actualizaciones diseñadas para que el entrenamiento y la implementación sean más prácticos.
Al igual que las versiones anteriores, admite la estimación de pose dentro de un marco unificado. La principal diferencia es que Ultralytics YOLO26 está diseñado para ser más flexible y estable en una gama más amplia de aplicaciones reales.
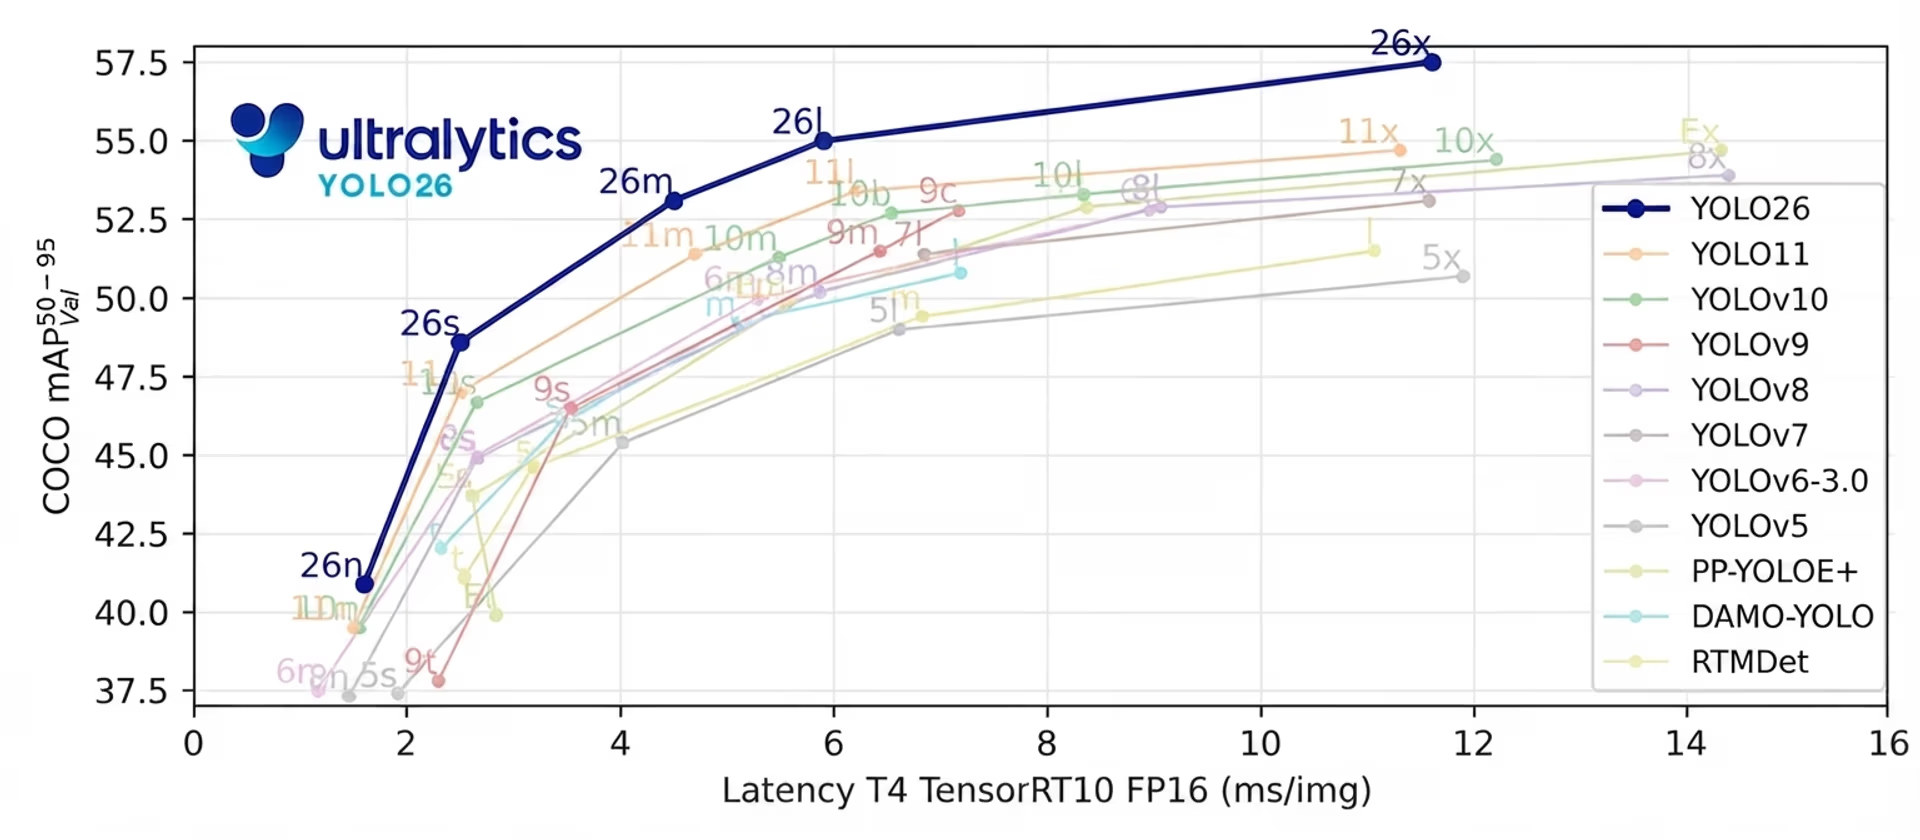
Fig. 4. Evaluación comparativa de YOLO26 (Fuente)
Los modelos Ultralytics YOLO de pose anteriores estaban muy condicionados por los conjuntos de datos de pose humana, por lo que algunos aspectos de los métodos anteriores se optimizaban en torno a las estructuras articulares humanas. YOLO26 elimina esas suposiciones específicas de las personas.
Por eso, es más adecuado para puntos clave no humanos, como detectar las esquinas de una pista de tenis u otras referencias estructurales personalizadas. Esto es importante porque, de forma predeterminada, los modelos Ultralytics YOLO26-pose preentrenados se entrenan con conjuntos de datos como COCO-pose y predicen puntos clave humanos definidos en las anotaciones del conjunto de datos.
Sin embargo, cuando los equipos quieren detectar distintos tipos de referencias, como componentes de maquinaria, marcadores de campos deportivos o puntos de infraestructuras, normalmente hay que ajustar el modelo con un conjunto de datos personalizado en el que se hayan anotado esos puntos clave específicos.
Como Ultralytics YOLO26 no está condicionado por suposiciones sobre las estructuras articulares humanas, puede adaptarse mejor durante el ajuste. Esta flexibilidad permite que el modelo aprenda distribuciones de puntos clave personalizadas con mayor fiabilidad, lo que mejora las métricas de evaluación al validarlo con conjuntos de datos que presentan configuraciones de puntos clave únicas.
Ultralytics YOLO26-pose también está diseñado para mejorar la localización de puntos clave cuando algunas partes de un objeto están parcialmente ocultas o aparecen a una escala muy pequeña. En escenas reales con sujetos lejanos, imágenes captadas por drones o situaciones con objetos pequeños, esto puede dar lugar a predicciones de puntos clave más precisas que las de modelos de pose anteriores.
Otra actualización importante es la mejora de la formulación de la función de pérdida utilizada durante el entrenamiento. La función de pérdida determina cómo corrige el modelo sus errores mientras aprende.
En el caso de Ultralytics YOLO26-pose, este proceso es más eficaz, lo que ayuda al modelo a aprender más rápido y alcanzar una gran precisión en menos épocas, donde una época corresponde a una pasada completa por el conjunto de datos de entrenamiento.
En general, YOLO26-pose se basa en los modelos de pose anteriores de Ultralytics YOLO y ofrece mejoras más claras en el soporte de puntos clave no humanos y la convergencia del entrenamiento, manteniendo el mismo flujo de trabajo conocido.
Comparativa entre YOLO26-pose y Ultralytics YOLOv5#
La primera versión de los modelos Ultralytics YOLO, Ultralytics YOLOv5, se diseñó principalmente para la detección de objetos. Aunque YOLOv5 amplió posteriormente sus capacidades para admitir la segmentación de instancias, no incluye un cabezal de estimación de pose nativo y especializado en el marco oficial de Ultralytics.
Los equipos que necesitaban detectar puntos clave solían recurrir a implementaciones independientes o modificaciones personalizadas. Ultralytics YOLO26 incluye la estimación de pose como tarea integrada, con un cabezal arquitectónico específico para predecir puntos clave.
Esto significa que los modelos Ultralytics YOLO26-pose se pueden entrenar, validar y desplegar con el mismo flujo de trabajo unificado que se usa para la detección y la segmentación. Para los proyectos centrados en la detección estructurada de puntos clave, YOLO26 ofrece compatibilidad nativa con la estimación de pose y una arquitectura específica para esta tarea que YOLOv5 no ofrece de serie.
Diferencias clave: YOLO26-pose frente a Ultralytics YOLOv8-pose#
Ultralytics YOLOv8 incorporó la estimación de pose nativa al marco unificado de Ultralytics, lo que facilita entrenar y desplegar modelos de puntos clave mediante el mismo flujo de trabajo que se usa para la detección y la segmentación. Se basa en una canalización tradicional de posprocesamiento con supresión no máxima (NMS) y utiliza formulaciones de pérdida anteriores para la regresión de cuadros delimitadores y el entrenamiento.
Ultralytics YOLO26 se basa en estos cimientos e incorpora actualizaciones arquitectónicas y de entrenamiento que influyen directamente en la estimación de pose. Una de las principales diferencias es su diseño integral. YOLO26 elimina la necesidad de aplicar NMS externo durante la inferencia, lo que simplifica el despliegue y mejora la coherencia de la latencia, especialmente en CPU y dispositivos periféricos.
Otra mejora clave está en la metodología de entrenamiento. Ultralytics YOLO26 incorpora el optimizador MuSGD y estrategias de pérdida actualizadas. Para las tareas de estimación de pose, integra la estimación residual de log-verosimilitud, que mejora el modelado de la incertidumbre de los puntos clave. En conjunto, estos cambios pueden acelerar la convergencia y estabilizar las predicciones de puntos clave, especialmente en escenas complejas o con oclusiones parciales.
En resumen, Ultralytics YOLOv8-pose estableció una base sólida y versátil. YOLO26-pose perfecciona esa base con una mayor eficiencia de entrenamiento, un mejor tratamiento de las oclusiones y más flexibilidad para aplicaciones de estimación de pose no humana en el mundo real.
YOLO26-pose frente a Ultralytics YOLO11-pose: ¿qué ha mejorado?#
Ultralytics YOLO11 se basa en Ultralytics YOLOv8 y perfecciona el backbone y las capas de extracción de características. Redujo los FLOPs, mejoró la eficiencia de los parámetros y ofreció un mAP mayor, manteniendo un sólido rendimiento en tiempo real. En las tareas de estimación de pose, esto se tradujo en una mayor precisión de los puntos clave con una arquitectura más ligera.
YOLO26-pose continúa esa evolución con un cambio arquitectónico más profundo. En pocas palabras, YOLO11 mejoró la eficiencia y la precisión de YOLOv8, y YOLO26 se basa en esos cimientos con actualizaciones arquitectónicas y de entrenamiento destinadas a acelerar la convergencia, estabilizar la inferencia y mejorar la precisión de la estimación de pose en situaciones complejas.
¿Por qué deberías empezar a usar el modelo Ultralytics YOLO26 para la estimación de pose?#
Al explorar las diferencias entre los modelos Ultralytics YOLO, quizá te preguntes si deberías pasarte a YOLO26-pose.
La respuesta breve es que actualizar es fácil. Si ya usas Ultralytics YOLOv8-pose o Ultralytics YOLO11-pose, pasarte a YOLO26-pose normalmente solo implica cambiar la versión del modelo, no reconstruir la canalización.
Puedes beneficiarte de un mejor soporte para puntos clave no humanos, una convergencia más rápida durante el entrenamiento y un mejor tratamiento de los puntos ocluidos, sin salir del marco de Ultralytics. Para la mayoría de los proyectos de estimación de pose, tanto nuevos como ya existentes, pasarse a YOLO26-pose es una forma sencilla de obtener estas mejoras con las mínimas complicaciones.
Además, YOLO26-pose cuenta con compatibilidad completa en el paquete Python de Ultralytics, basado en PyTorch y diseñado para facilitar el entrenamiento, la validación y el despliegue. Los modelos se pueden exportar a formatos como ONNX, TensorRT, OpenVINO, CoreML y TFLite, lo que facilita su despliegue en GPU, CPU y dispositivos periféricos sin cambiar el flujo de trabajo general.
Conclusiones clave#
Ultralytics YOLO26-pose hace que la estimación de pose sea más flexible y fiable, sobre todo al trabajar con puntos clave no humanos o escenas complejas. Se entrena más rápido, gestiona mejor las oclusiones y ofrece resultados más coherentes con distintos conjuntos de datos. Para los equipos que ya usan modelos de pose Ultralytics YOLO, YOLO26 aporta mejoras claras sin cambiar los flujos de trabajo existentes.
¿Quieres saber más sobre IA? Echa un vistazo a nuestra comunidad y a nuestro repositorio de GitHub. Explora nuestras páginas de soluciones para descubrir la IA en robótica y la visión artificial en la agricultura. Descubre nuestras opciones de licencia y empieza hoy mismo a crear con visión artificial.









