Explorer l’apprentissage supervisé et non supervisé en vision par ordinateur
Découvre les différences entre l’apprentissage supervisé et non supervisé en vision par ordinateur, et comment choisir l’approche adaptée à tes données et aux objectifs de ton projet.
L’intelligence artificielle (IA) repose sur le principe fondamental d’apprendre aux machines à apprendre et à raisonner d’une manière qui s’apparente à l’intelligence humaine. Tout comme les personnes apprennent de différentes façons, par exemple grâce à des consignes directes ou en observant des schémas et des expériences, les systèmes d’IA et d’apprentissage automatique sont conçus pour suivre ces mêmes approches.
Plus précisément, les algorithmes d’apprentissage automatique entraînent les systèmes à apprendre à partir de données, plutôt que de les programmer explicitement pour chaque tâche. Au lieu de s’appuyer sur des règles fixes, les modèles d’apprentissage automatique repèrent des schémas dans les données et les utilisent pour faire des prédictions ou prendre des décisions.
Par exemple, la vision par ordinateur est une branche de l’IA et de l’apprentissage automatique qui vise à permettre aux systèmes d’interpréter et de comprendre les informations visuelles, comme les images et les vidéos. De la reconnaissance d’objets à l’identification de schémas cachés dans de grands jeux de données, ces systèmes dépendent largement de la manière dont ils sont entraînés à apprendre.
Diverses techniques d’apprentissage de l’IA servent à entraîner ces systèmes, selon le type de données disponibles et le problème à résoudre.
Certains modèles de vision par ordinateur apprennent à partir de données étiquetées, où chaque entrée est associée à la bonne réponse : chaque image ou point de données possède ainsi une étiquette prédéfinie qui indique ce qu’il représente. Le modèle peut alors apprendre la relation entre l’entrée et la sortie attendue, ce qui améliore sa capacité à faire des prédictions précises sur de nouvelles données qu’il n’a jamais vues.
D’autres modèles de vision apprennent à partir de données non étiquetées, sans réponses prédéfinies, et se concentrent plutôt sur l’identification des schémas et des relations présents dans les données elles-mêmes. Ces approches sont respectivement appelées apprentissage supervisé et apprentissage non supervisé, et constituent les fondements de nombreux systèmes de vision par ordinateur de pointe.
Dans cet article, nous allons explorer l’apprentissage supervisé et non supervisé, leur utilisation en vision par ordinateur et la manière de choisir l’approche la mieux adaptée à ton projet d’IA visuelle. C’est parti !
Comment les approches d’apprentissage de l’IA alimentent la vision par ordinateur#
Tu peux voir l’intelligence artificielle comme un grand parapluie qui couvre un ensemble de technologies permettant aux machines d’effectuer des tâches nécessitant habituellement l’intelligence humaine. Sous ce parapluie, l’apprentissage automatique est un domaine clé qui permet aux systèmes d’apprendre à partir de données au lieu de s’appuyer uniquement sur des règles fixes.
Dans le domaine de l’apprentissage automatique, différentes techniques déterminent comment un modèle apprend et s’améliore au fil du temps. Des approches comme l’apprentissage supervisé (apprentissage à partir de données étiquetées avec les bonnes réponses), l’apprentissage non supervisé (identification de schémas dans des données non étiquetées), l’apprentissage par renforcement (apprentissage par essais et erreurs à partir de retours ou de récompenses) et l’apprentissage semi-supervisé (combinaison d’une petite quantité de données étiquetées et d’une grande quantité de données non étiquetées) définissent la manière dont les systèmes traitent les données d’entrée et génèrent les données de sortie.
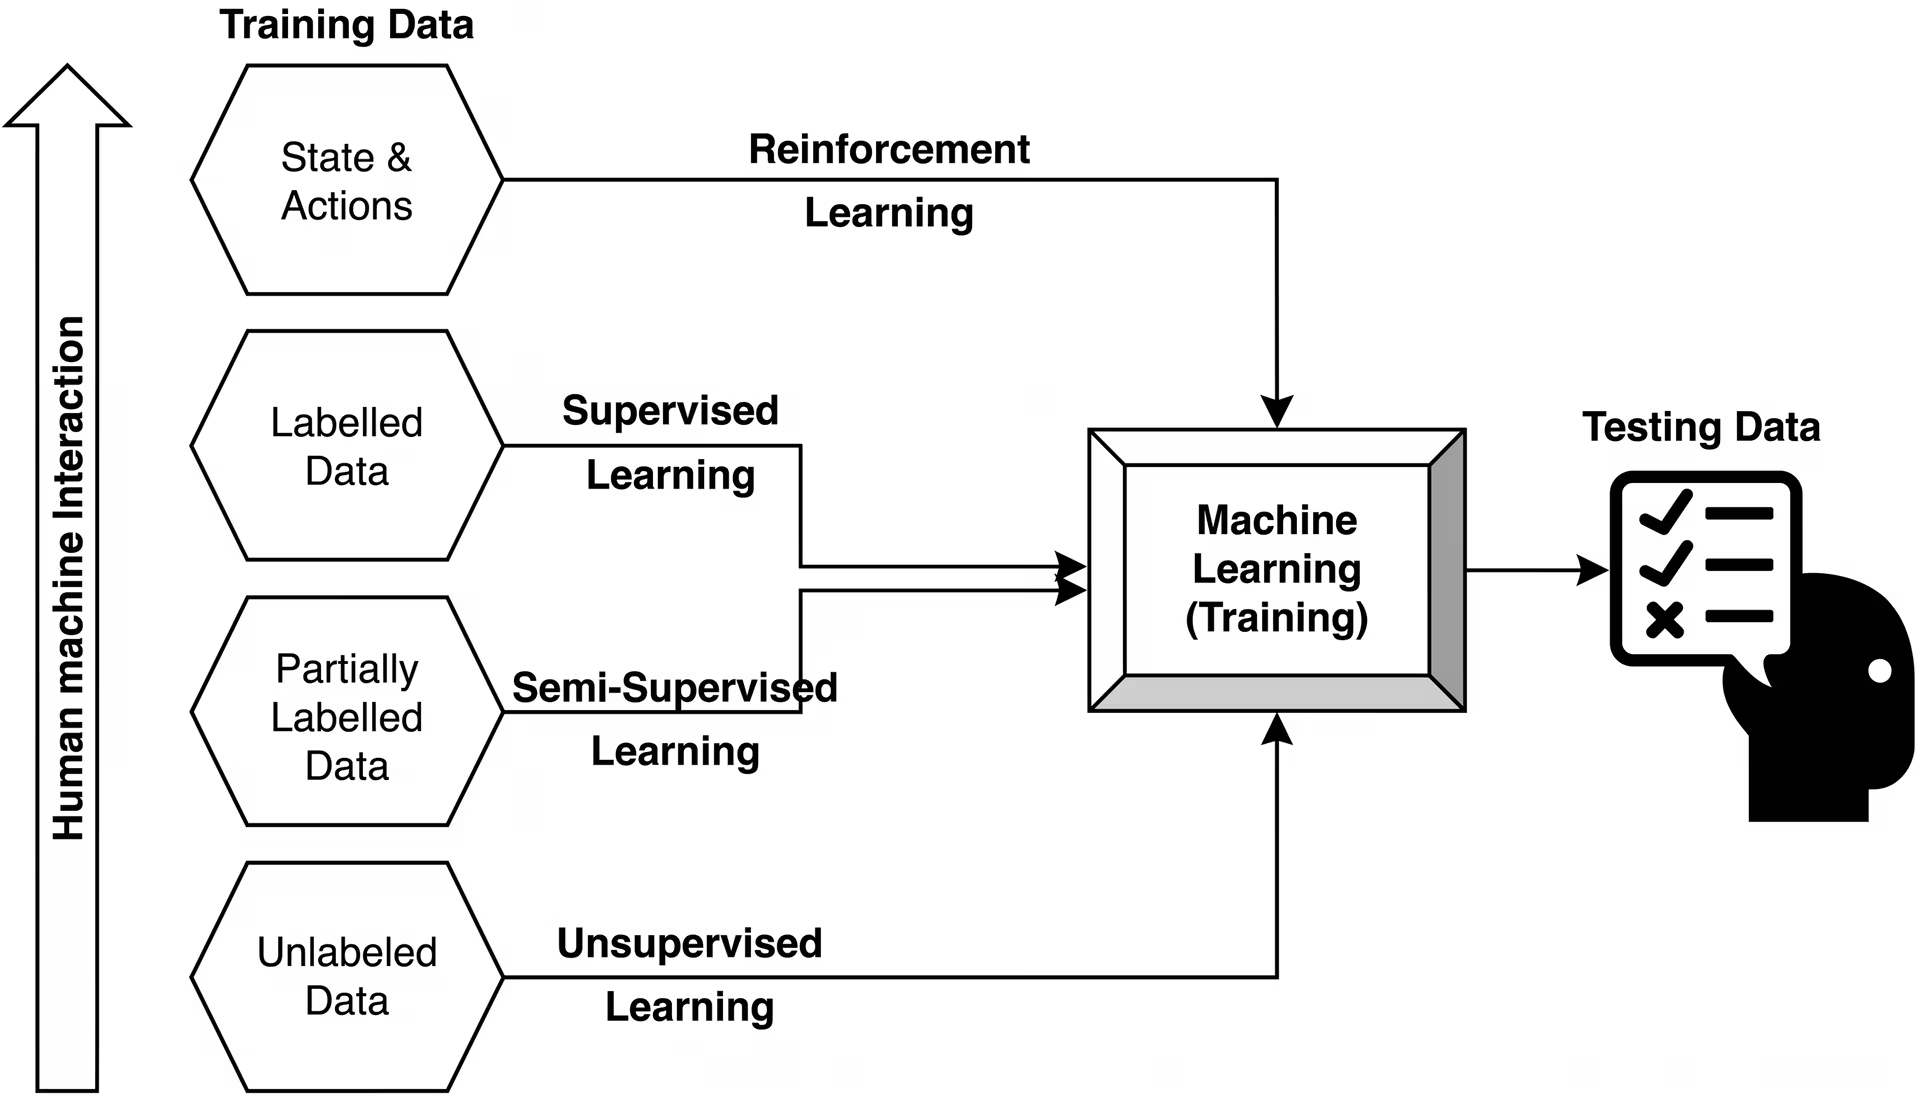
Fig. 1. Vue d’ensemble des méthodes d’apprentissage de l’IA (Source)
En particulier, les systèmes de vision par ordinateur sont conçus à l’aide de ces approches d’apprentissage pour interpréter et comprendre les données visuelles. L’apprentissage supervisé est la méthode la plus couramment utilisée, car il permet aux modèles d’apprendre à partir d’exemples clairement étiquetés et de produire des résultats précis et fiables.
Par exemple, un modèle peut être entraîné sur des images étiquetées « chat » et « chien ». Il apprend alors des caractéristiques comme la forme, les oreilles et la structure du visage afin de classer correctement de nouvelles images à l’aide d’algorithmes de classification. L’apprentissage non supervisé et semi-supervisé est également utilisé en vision par ordinateur, souvent pour explorer les schémas présents dans les données ou améliorer les performances lorsque les données étiquetées sont limitées.
Utilisation des modèles d’apprentissage supervisé en vision par ordinateur#
Tu peux comparer les algorithmes d’apprentissage supervisé à une salle de classe, où un enseignant fournit des exemples accompagnés des bonnes réponses pour que les élèves apprennent à distinguer le vrai du faux. En apprentissage automatique, les modèles apprennent de façon similaire à partir de données étiquetées, où chaque entrée est associée à une sortie connue.
Imaginons que tu travailles à la création d’un système de vision par ordinateur qui automatise l’analyse de matchs de baseball. Tu pourrais entraîner un modèle comme Ultralytics YOLO26 sur des images ou des images vidéo où des objets tels que la balle, la batte et les joueurs sont étiquetés.
Chaque objet serait marqué avec son emplacement et sa catégorie, ce qui permettrait au modèle d’apprendre ce qu’il doit rechercher. Au fil du temps, le modèle pourrait détecter et localiser ces objets dans de nouvelles séquences vidéo, facilitant des cas d’utilisation comme le suivi de la balle et la détection des joueurs d’une image à l’autre.
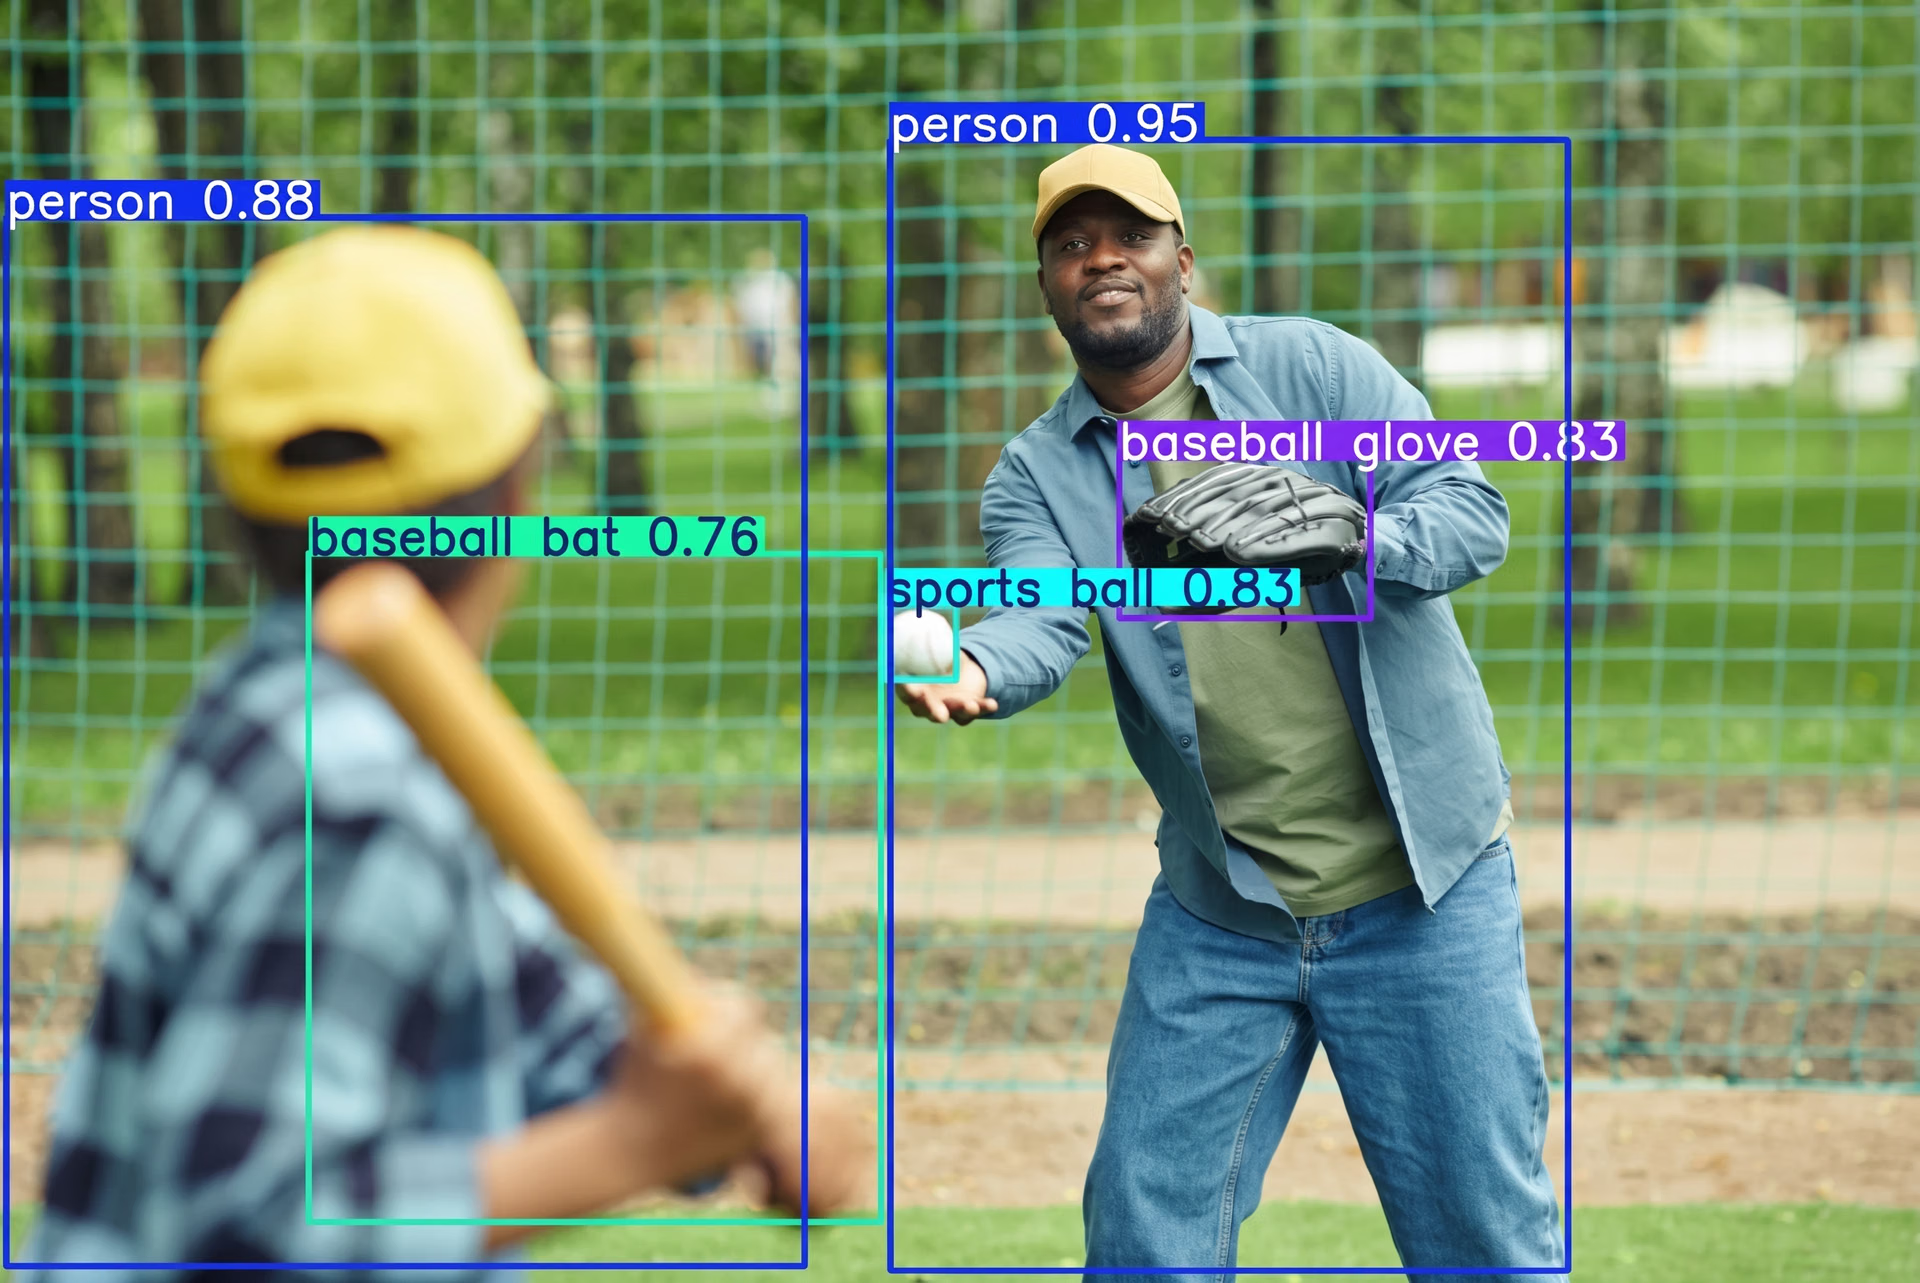
Fig. 2. Exemple de détection d’objets rendue possible par l’apprentissage supervisé (Source)
Au-delà de la détection d’objets, l’apprentissage supervisé est largement utilisé pour diverses tâches de vision par ordinateur, comme la classification d’images, la segmentation d’instances et l’estimation de pose, où la précision et la cohérence sont importantes. Pour chacune de ces tâches, les modèles apprennent à partir de données étiquetées afin d’identifier des schémas précis et de faire des prédictions fiables sur de nouvelles entrées.
Ces modèles sont généralement construits à l’aide de l’apprentissage profond, un type d’apprentissage automatique qui utilise des réseaux de neurones pour apprendre directement les schémas présents dans les données. Les réseaux de neurones sont conçus pour traiter l’information d’une manière qui s’inspire librement du fonctionnement du cerveau humain, ce qui permet aux modèles d’apprendre des caractéristiques visuelles complexes à partir de grands jeux de données.
Les premières approches de vision par ordinateur reposaient souvent sur des caractéristiques conçues manuellement et combinées à des algorithmes comme les machines à vecteurs de support (les SVM sont des modèles qui classent les données en trouvant la meilleure frontière entre les catégories) ou les arbres de décision (des modèles qui prennent des décisions en répartissant les données en branches).
À l’inverse, les modèles de vision par ordinateur actuels utilisent l’apprentissage profond pour apprendre automatiquement ces caractéristiques à partir des données, ce qui les rend plus efficaces pour traiter des tâches visuelles à grande échelle et très détaillées.
Comprendre l’intérêt des modèles d’apprentissage non supervisé en IA visuelle#
Bien que l’apprentissage supervisé soit l’approche de prédilection en vision par ordinateur, certaines applications de vision ne disposent pas de données étiquetées, ou leur création est trop coûteuse et chronophage.
Dans ces cas, les algorithmes d’apprentissage non supervisé peuvent constituer une solution de rechange utile. Imaginons que tu disposes d’une grande collection de photos non étiquetées provenant d’un piège photographique pour la faune.
Aucune étiquette n’indique ce que contient chaque image, mais tu souhaites tout de même organiser ou comprendre les données. Un modèle non supervisé peut analyser ces images et regrouper celles qui se ressemblent, en séparant les animaux d’apparence similaire en clusters, même sans connaître leurs étiquettes exactes.
Fonctionnement de l’apprentissage non supervisé en vision par ordinateur#
Alors, comment fonctionne l’apprentissage automatique non supervisé ? Au lieu d’apprendre à partir de bonnes réponses, le modèle apprend en identifiant de lui-même les schémas et la structure des données. Il recherche les similitudes et les différences dans les données sans s’appuyer sur des exemples étiquetés.
La détection d’anomalies est un cas d’utilisation courant : le modèle apprend à quoi ressemblent les données normales, puis repère tout ce qui s’en écarte. La détection d’anomalies et de valeurs aberrantes compte parmi les applications industrielles les plus importantes. On peut notamment repérer des articles défectueux sur une chaîne de fabrication, signaler des examens médicaux inhabituels à faire vérifier par un radiologue ou détecter des activités suspectes dans des images de vidéosurveillance. Comme les défauts et les anomalies sont souvent rares et variés, il est peu réaliste d’étiqueter tous les cas possibles, ce qui fait des approches non supervisées un choix naturel.
Pour cela, des techniques comme le clustering et la réduction de dimensionnalité sont souvent utilisées, généralement sur des caractéristiques extraites des images plutôt que sur les images brutes elles-mêmes. Les méthodes de clustering, comme le clustering k-means, regroupent les images similaires en fonction de schémas communs, tandis que les techniques de réduction de dimensionnalité, comme l’analyse en composantes principales (PCA), simplifient les données en se concentrant sur les caractéristiques les plus importantes.
Le modèle peut ainsi repérer plus facilement des schémas et une structure pertinents dans de grands jeux de données complexes. Le principal avantage de l’apprentissage non supervisé est qu’il fonctionne bien avec des données non étiquetées et peut révéler des schémas qui ne sont pas immédiatement évidents. Cependant, son évaluation est plus difficile et il offre moins de contrôle sur le résultat final que l’apprentissage supervisé.
Apprentissage auto-supervisé et semi-supervisé en vision par ordinateur#
En explorant l’apprentissage supervisé et non supervisé, tu te demandes peut-être s’il existe une voie intermédiaire. Il est intéressant de noter que l’apprentissage auto-supervisé et semi-supervisé comble le fossé entre l’apprentissage supervisé et non supervisé.
Ces approches permettent aux modèles d’apprendre plus efficacement à partir de données non étiquetées. Au lieu de s’appuyer uniquement sur des exemples étiquetés, les modèles créent leurs propres tâches d’apprentissage à partir des données ou combinent un petit jeu de données étiquetées avec un jeu de données non étiquetées plus volumineux.
En apprentissage auto-supervisé, le modèle apprend en résolvant des tâches créées à partir des données elles-mêmes. Par exemple, on peut lui fournir une image dont une partie manque et lui demander de prédire ce qui devrait occuper cet espace, ou lui apprendre à reconnaître différentes vues d’un même objet. Le modèle peut ainsi apprendre des caractéristiques utiles sans avoir besoin d’étiquettes manuelles.
En revanche, l’apprentissage semi-supervisé utilise une petite quantité de données étiquetées avec un ensemble plus vaste de données non étiquetées afin d’améliorer les performances. Dans certains cas, le modèle peut générer des étiquettes pour les données non étiquetées et poursuivre son apprentissage à partir de celles-ci.
Le principal avantage de ces approches est qu’elles réduisent le besoin de grands jeux de données étiquetées, dont la création est souvent coûteuse et chronophage. Cependant, elles peuvent être plus complexes à concevoir et à évaluer que les méthodes entièrement supervisées.
Principales différences entre l’apprentissage supervisé et non supervisé#
La différence entre l’apprentissage supervisé et non supervisé tient à la manière dont un modèle apprend et à son objectif. L’apprentissage supervisé s’appuie sur des données étiquetées et des indications claires pour apprendre des tâches précises, tandis que l’apprentissage non supervisé fonctionne sans réponses prédéfinies et se concentre sur la découverte de schémas et de structures dans les données.
Par exemple, dans un système de surveillance du trafic, un modèle d’apprentissage supervisé peut être entraîné sur des images étiquetées pour détecter des véhicules, des piétons ou des feux de circulation. À l’inverse, un modèle non supervisé peut analyser de grandes quantités d’images vidéo pour regrouper des schémas de circulation similaires ou repérer des événements inhabituels, comme des embouteillages inattendus ou des déplacements anormaux, sans qu’on lui indique explicitement ce qu’il doit rechercher.
Quand utiliser l’apprentissage supervisé en vision par ordinateur#
L’apprentissage supervisé est une excellente option pour les tâches de vision par ordinateur dont l’objectif est clairement défini et où le modèle doit associer les données d’entrée à des sorties précises. Il fonctionne particulièrement bien lorsque tu disposes d’un jeu de données étiquetées fiable et que tu as besoin de résultats cohérents et prévisibles.
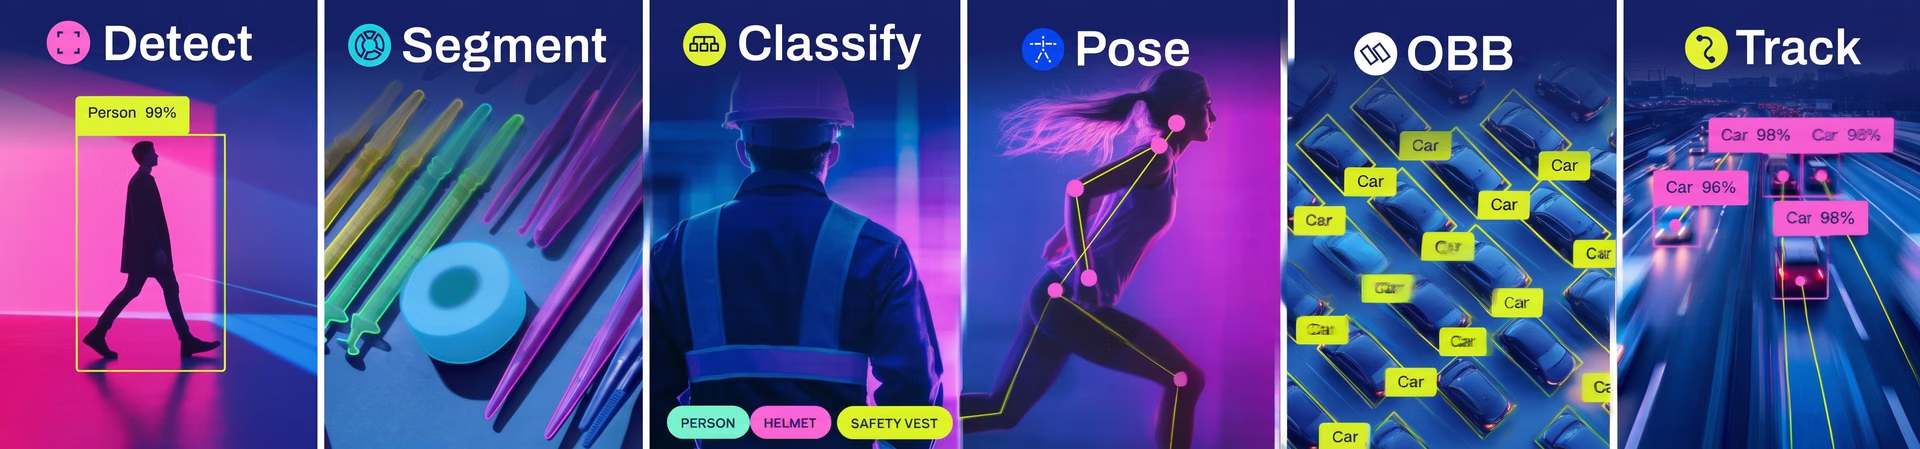
Fig. 3. Tâches de vision par ordinateur reposant sur l’apprentissage supervisé (Source)
Cette méthode est couramment utilisée pour les problèmes où le modèle doit distinguer des catégories connues ou prédire des résultats précis. Plutôt que d’explorer des schémas, l’objectif est d’apprendre des relations précises à partir de données étiquetées, ce qui permet de guider plus facilement le modèle vers le résultat souhaité.
Le contrôle est un autre avantage clé. Avec l’apprentissage supervisé, il est plus facile de mesurer les performances à l’aide de métriques claires, d’ajuster le modèle et de garantir un comportement stable lors du déploiement. Cette méthode est donc idéale pour les systèmes qui doivent rester cohérents et fiables au fil du temps.
Cette approche a toutefois un inconvénient. Le modèle dépend fortement de la qualité et du volume des données étiquetées, dont la collecte et l’annotation peuvent prendre beaucoup de temps.
Exemples concrets de vision par ordinateur supervisée#
Les modèles d’IA visuelle comme les modèles Ultralytics YOLO utilisent l’apprentissage supervisé pour effectuer des tâches telles que la détection d’objets avec une grande précision, notamment dans les applications en temps réel. Voici quelques cas d’utilisation courants de la vision dans le monde réel où l’apprentissage supervisé fait la différence :
- Santé et imagerie médicale : Les médecins peuvent utiliser des systèmes de vision par ordinateur entraînés sur des examens étiquetés, comme des radiographies ou des IRM, où des classificateurs repèrent des problèmes tels que des tumeurs ou des fractures, ce qui favorise des diagnostics plus rapides et plus précis.
- Contrôle qualité industriel : Dans les environnements de fabrication, les systèmes de vision entraînés sur des données étiquetées peuvent inspecter les produits en analysant plusieurs caractéristiques liées à la qualité, comme la forme, les défauts de surface, la texture et la taille. En apprenant à partir d’exemples de produits conformes et défectueux, ces systèmes peuvent repérer les anomalies de manière cohérente et maintenir les normes de production.
- Conduite autonome : Les systèmes de conduite autonome s’appuient sur des modèles entraînés à partir de données de conduite étiquetées pour reconnaître les voies, les véhicules, les piétons et les panneaux de signalisation, ce qui aide les véhicules à circuler en toute sécurité en temps réel.
- Commerce de détail et systèmes de caisse : Les magasins utilisent des modèles entraînés sur des images de produits étiquetées pour identifier les articles en rayon ou à la caisse, ce qui permet d’automatiser la facturation et d’améliorer la gestion des stocks. Associés à des données supplémentaires, ces systèmes peuvent également faciliter des tâches comme la segmentation de la clientèle et aider les entreprises à mieux comprendre les habitudes d’achat.
- Agriculture et suivi des cultures : Les agriculteurs peuvent utiliser des modèles entraînés sur des images étiquetées pour détecter et classer les cultures, par exemple en identifiant et en comptant les pommes de terre saines et endommagées, afin d’améliorer le contrôle qualité et de réduire les pertes.
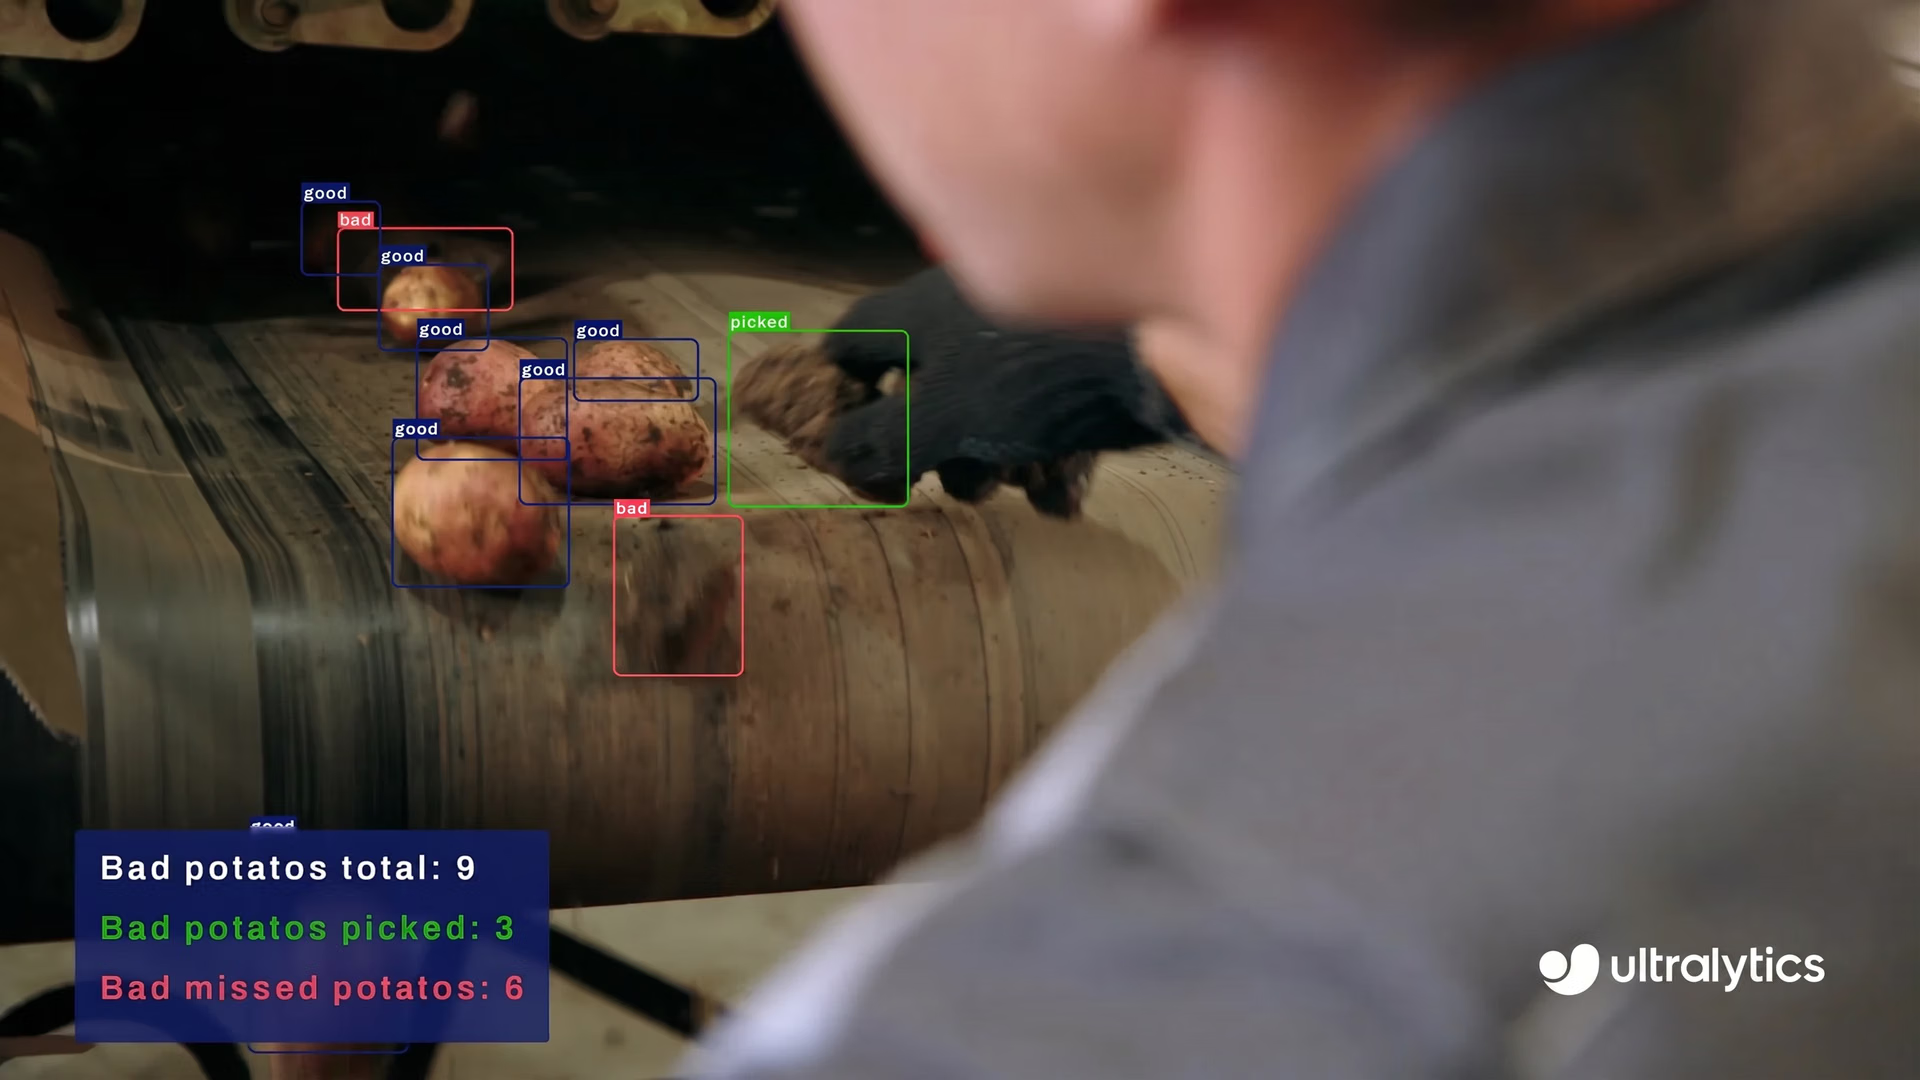
Fig. 4. Utiliser YOLO pour détecter et compter les pommes de terre saines et défectueuses
Quels types de problèmes de vision par ordinateur l’apprentissage non supervisé peut-il résoudre ?#
L’apprentissage non supervisé est utile lorsque tu ne disposes pas de suffisamment de données étiquetées ou que tes données ne sont pas accompagnées de réponses claires. Dans ces situations, l’objectif n’est pas de faire des prédictions exactes, mais de comprendre les schémas et la structure des données.
On l’utilise souvent pour explorer un jeu de données non étiquetées pour la première fois. Au lieu d’indiquer au modèle ce qu’il doit rechercher, tu le laisses repérer les similitudes, regrouper les images apparentées ou mettre en évidence des schémas inhabituels de lui-même.
Dans une grande collection d’images, une approche non supervisée peut aider à regrouper les images similaires ou à signaler les valeurs aberrantes qui nécessitent une analyse plus approfondie. C’est donc un point de départ utile pour les projets de science des données.
Les modèles génératifs, notamment les GAN, les autoencodeurs variationnels et les modèles de diffusion, apprennent la distribution sous-jacente des images pour en créer de nouvelles. Ils alimentent des applications comme la synthèse d’images, l’inpainting, la super-résolution et le transfert de style, et constituent le socle des systèmes d’IA générative actuels.
En segmentation non supervisée, certaines méthodes regroupent les pixels ou les régions en segments cohérents sans s’appuyer sur des masques étiquetés. Cette approche est utile lorsque l’annotation est trop coûteuse ou que l’objectif est de découvrir une structure plutôt que de correspondre à des catégories prédéfinies.
L’apprentissage non supervisé est également pertinent pour travailler sur de grands jeux de données dont l’étiquetage prend beaucoup de temps ou n’est pas réalisable. Il permet alors de tirer des enseignements des données sans s’appuyer sur des données d’entraînement étiquetées.
Il est également couramment utilisé dans des domaines comme l’IA générative (des modèles qui créent de nouvelles données, telles que des images, du texte ou de l’audio) et l’apprentissage de représentations (des modèles qui apprennent des caractéristiques ou des schémas utiles à partir de données brutes), où les modèles apprennent des caractéristiques générales à partir de grandes quantités de données. En résumé, si ton problème implique de l’exploration, la découverte de schémas ou le traitement de données non étiquetées, l’apprentissage non supervisé est une approche souple et pratique à envisager.
Exemples concrets d’apprentissage non supervisé en vision par ordinateur#
Voici quelques exemples d’applications de l’apprentissage non supervisé en vision par ordinateur :
- Détection d’anomalies dans la fabrication : Les modèles peuvent apprendre à quoi ressemblent les produits normaux et signaler les défauts ou irrégularités sans avoir besoin d’exemples étiquetés de chaque défaut possible.
- Organisation et recherche d’images : De grandes collections d’images, comme des photothèques ou des catalogues de commerce en ligne, peuvent être automatiquement regroupées selon leur similarité visuelle. Les spécialistes en science des données peuvent ainsi organiser, explorer et parcourir plus facilement de grands jeux de données.
- Surveillance et sécurité : Les systèmes peuvent analyser des séquences vidéo afin de repérer des schémas ou des comportements inhabituels, comme des déplacements inattendus ou des changements dans la foule, sans avoir été explicitement entraînés sur des événements étiquetés.
- Prétraitement et exploration des données : Les méthodes non supervisées servent souvent à explorer et à structurer des données d’image brutes avant d’entraîner des modèles supervisés, ce qui contribue à améliorer la qualité des données et à réduire le travail manuel.
Limites pratiques de l’apprentissage supervisé et non supervisé#
Malgré les avantages des deux approches d’apprentissage, certaines limites sont à prendre en compte. Voici quelques facteurs pratiques à garder à l’esprit lors de la création de modèles de vision par ordinateur :
- Surapprentissage des modèles supervisés : En apprentissage supervisé, un modèle peut apprendre les données d’entraînement par cœur au lieu d’en dégager des schémas généraux. Cela se produit souvent lorsque le jeu de données est petit ou pas assez diversifié. Par exemple, un modèle entraîné à détecter les défauts d’un type de produit peut échouer lorsqu’il est testé sur de nouvelles données comprenant des produits ou des conditions d’éclairage légèrement différents.
- Difficultés liées aux algorithmes de clustering : En apprentissage non supervisé, un modèle peut regrouper des points de données similaires. Toutefois, cette approche peut échouer si les données sont bruitées, incohérentes ou dépourvues de structure claire. Par exemple, dans une tâche de regroupement d’images, des images aux couleurs similaires mais représentant des objets différents peuvent être regroupées à tort.
- Importance d’un prétraitement adapté : Avant l’entraînement, les données doivent être nettoyées et préparées. Cette étape est généralement réalisée à l’aide de bibliothèques Python qui gèrent le traitement des images et la transformation des données. Elle est particulièrement importante en vision par ordinateur, où la taille, la qualité et l’éclairage des images peuvent varier. Sans prétraitement adapté, les modèles risquent d’apprendre à partir du bruit plutôt que de schémas pertinents, ce qui entraîne de mauvaises performances.
Points clés à retenir#
En vision par ordinateur, l’apprentissage supervisé et non supervisé jouent tous deux un rôle important. Le choix de la bonne approche dépend du type de données dont tu disposes, qu’elles soient étiquetées ou non, ainsi que du problème que tu cherches à résoudre et de tes besoins en matière de déploiement.
Si ton objectif est d’obtenir une grande précision et des sorties clairement définies, l’apprentissage automatique supervisé est souvent le meilleur choix. Si tu explores des données ou travailles sans étiquettes, l’apprentissage non supervisé peut être plus adapté.
Tu veux en savoir plus sur l’IA ? Découvre notre communauté et notre dépôt GitHub. Explore nos pages de solutions pour en savoir plus sur l’IA en robotique et la vision par ordinateur dans l’agriculture. Découvre nos options de licence et commence dès aujourd’hui à créer des solutions de vision par ordinateur !









